
9a · Frameworks 2: Orchestration and Monitoring
本讲速览
- 工作流的本质是把“每一步做什么”从模型手里收回到代码里:开发者固定步骤与检查点,只在需要判断的地方调用 LLM。换来一致性、效率与可测试性,代价是适应性。
- LangGraph 的三件套是 state、node、edge:节点读共享状态、只返回自己改动的字段;条件边或
Command(goto=...)依据中间结果决定下一跳;compile(checkpointer=...)让一次执行变成可暂停、可续跑的对象。 - 可恢复性取决于“节点粒度”:把检索与生成拆成两个节点,生成阶段崩溃时不必重跑检索。粒度越细,崩溃损失越小,但检查点写入越频繁、状态序列化越贵。
- trace 是调试与评测的共同底座:一次执行是一棵 run 树,每个 run 记录输入、输出、耗时、错误与 token。它回答“哪一步慢、哪一步错”,但不回答“为什么错”。
- 测试要分三层:节点单测(固定模型输出、断言状态更新与路由目标)、受控工作流测试(批准、拒绝、瞬时失败等分支)、换模型后的回归。直接调节点会绕过检查点,所以单测通过不等于图能跑通。
- 规模化监控的第一个困难是“你不知道要找什么”:既有检查只覆盖想到的行为,分数下降也不解释原因。Docent 用配对比较把 108 条失败转成可读的失败模式,Hodoscope 用聚类让没预设过的行为自己浮现。
- 一个分数是资源包络的函数:Terminal-Bench 上 40% 与 27% 的差距,与两组 32%、50% 的超时率同量级;在双方都不超时的 28 个任务上排名反转(0.500 与 0.429)。
1. 从单 agent 到显式工作流
这一讲的位置可以用课件开头的那张分类表来定位:课程此前已经给过三种“在 agent 周围加结构”的办法——技能(指令引导行为,可执行技能约束执行)、规划与分解(把任务拆成部分并协调执行,如 MACU、RAO、RLM)、以及自动化(用规定的步骤与检查把多次 agent 运行串起来)。今天讲的是第四种,也是更工程化的一种:编排框架让开发者预先指定工作流的某些部分,同时把判断与动作交给 LLM。
单 agent 的循环很小:模型看到上下文,决定调用哪个工具,观察返回值,再决定下一步。行为由三样东西共同决定——模型权重、prompt、以及它看到的环境(工具返回、文件系统、网页内容)。这套结构的上限很高,遇到没预设过的情况仍能临场应对;下限也很低,同一个 prompt 跑十次可能走十条不同的路径,而且没人能事先说出它会走哪条。
显式工作流把控制权的一部分搬到代码里。课件给的对比很直接:单 agent 是“LLM 在 act / observe 循环里调工具”;工作流则是一条写死的链,Classify 由 LLM 完成,Retrieve 是代码加工具,Investigate 回到 LLM,Check 又回到代码。
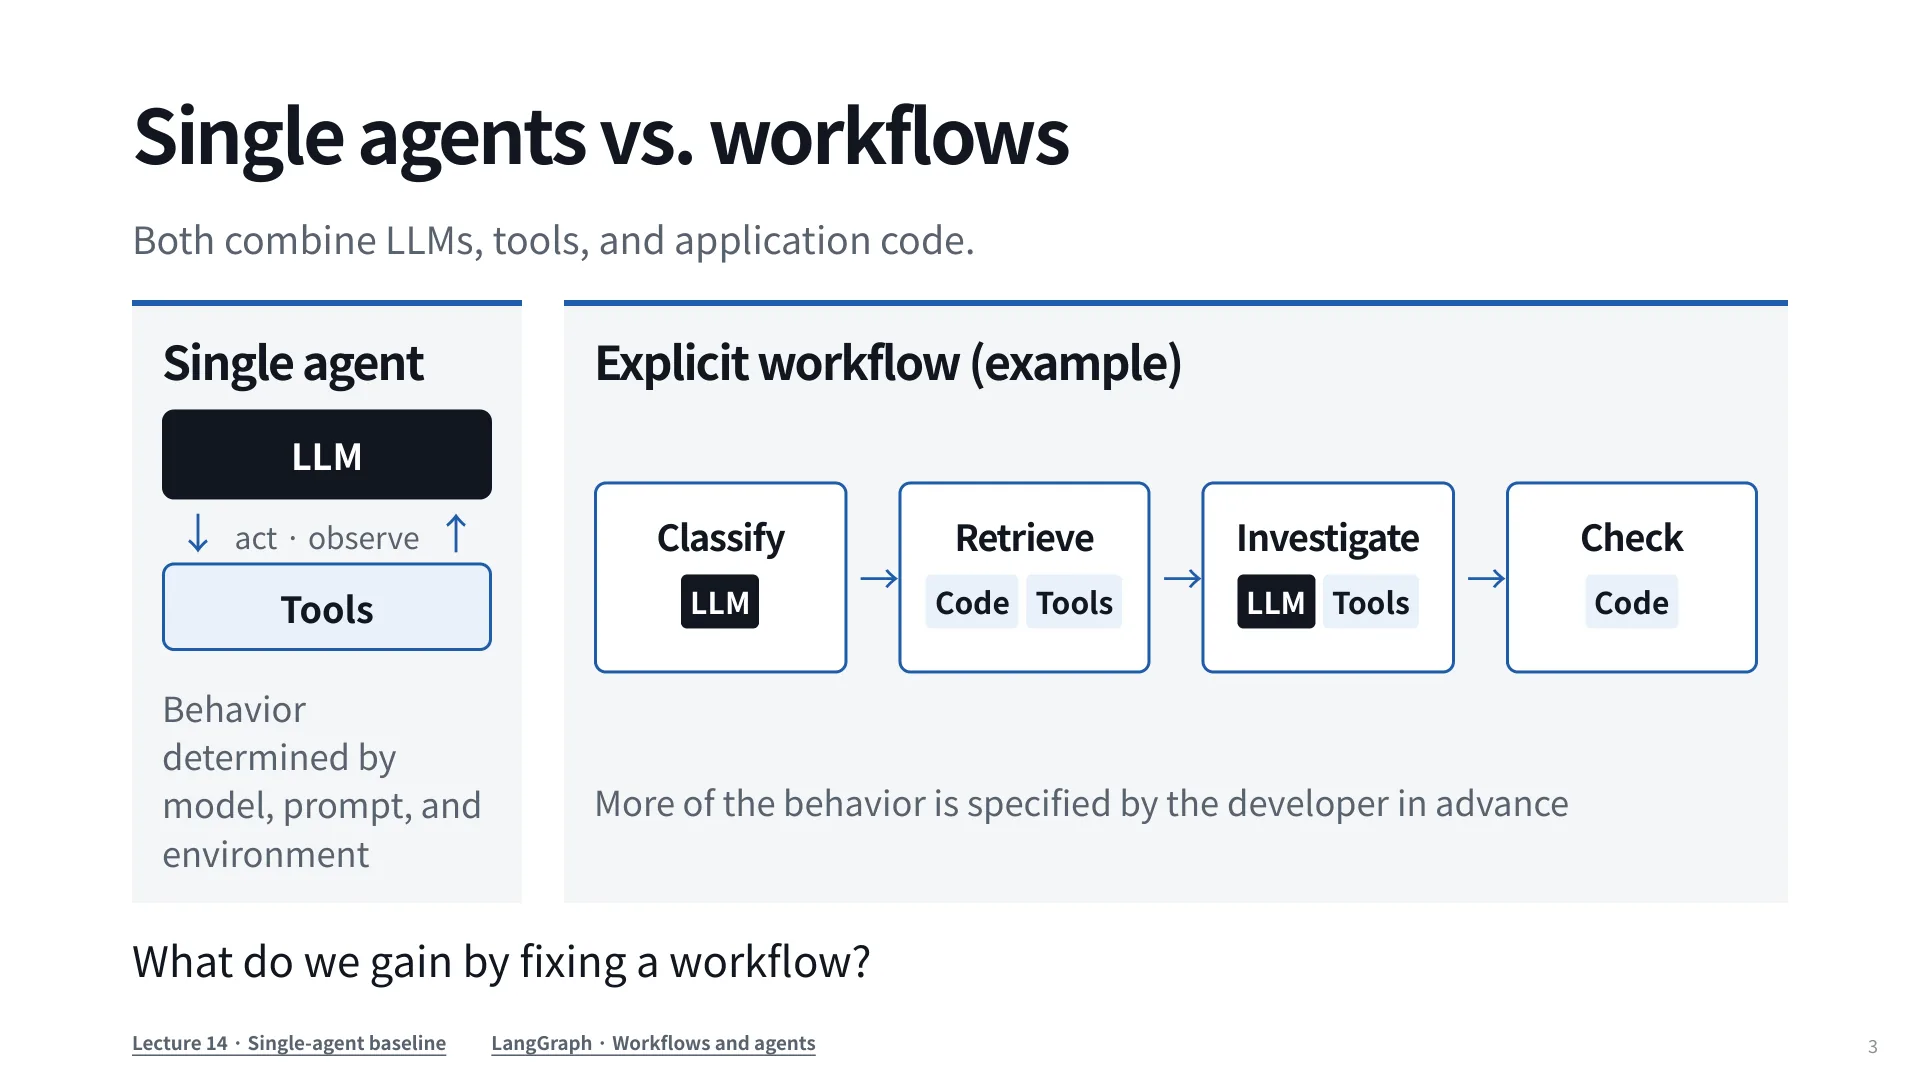
两个细节值得注意。第一,链上并非每步都用模型:分类与调查用 LLM,检索与检查是纯代码。第二,链的顺序在装配时就确定,模型只能在被允许的缝隙里做判断。换句话说,工作流不是“更弱的 agent”,而是把一部分决策替换成了结构。
为什么值得这么做?可以理解成把“agent 能力问题”转换成“软件工程问题”。能力问题难以度量、难以回归、难以向法务解释;工程问题有明确接口、可写测试、可灰度发布、可回滚。
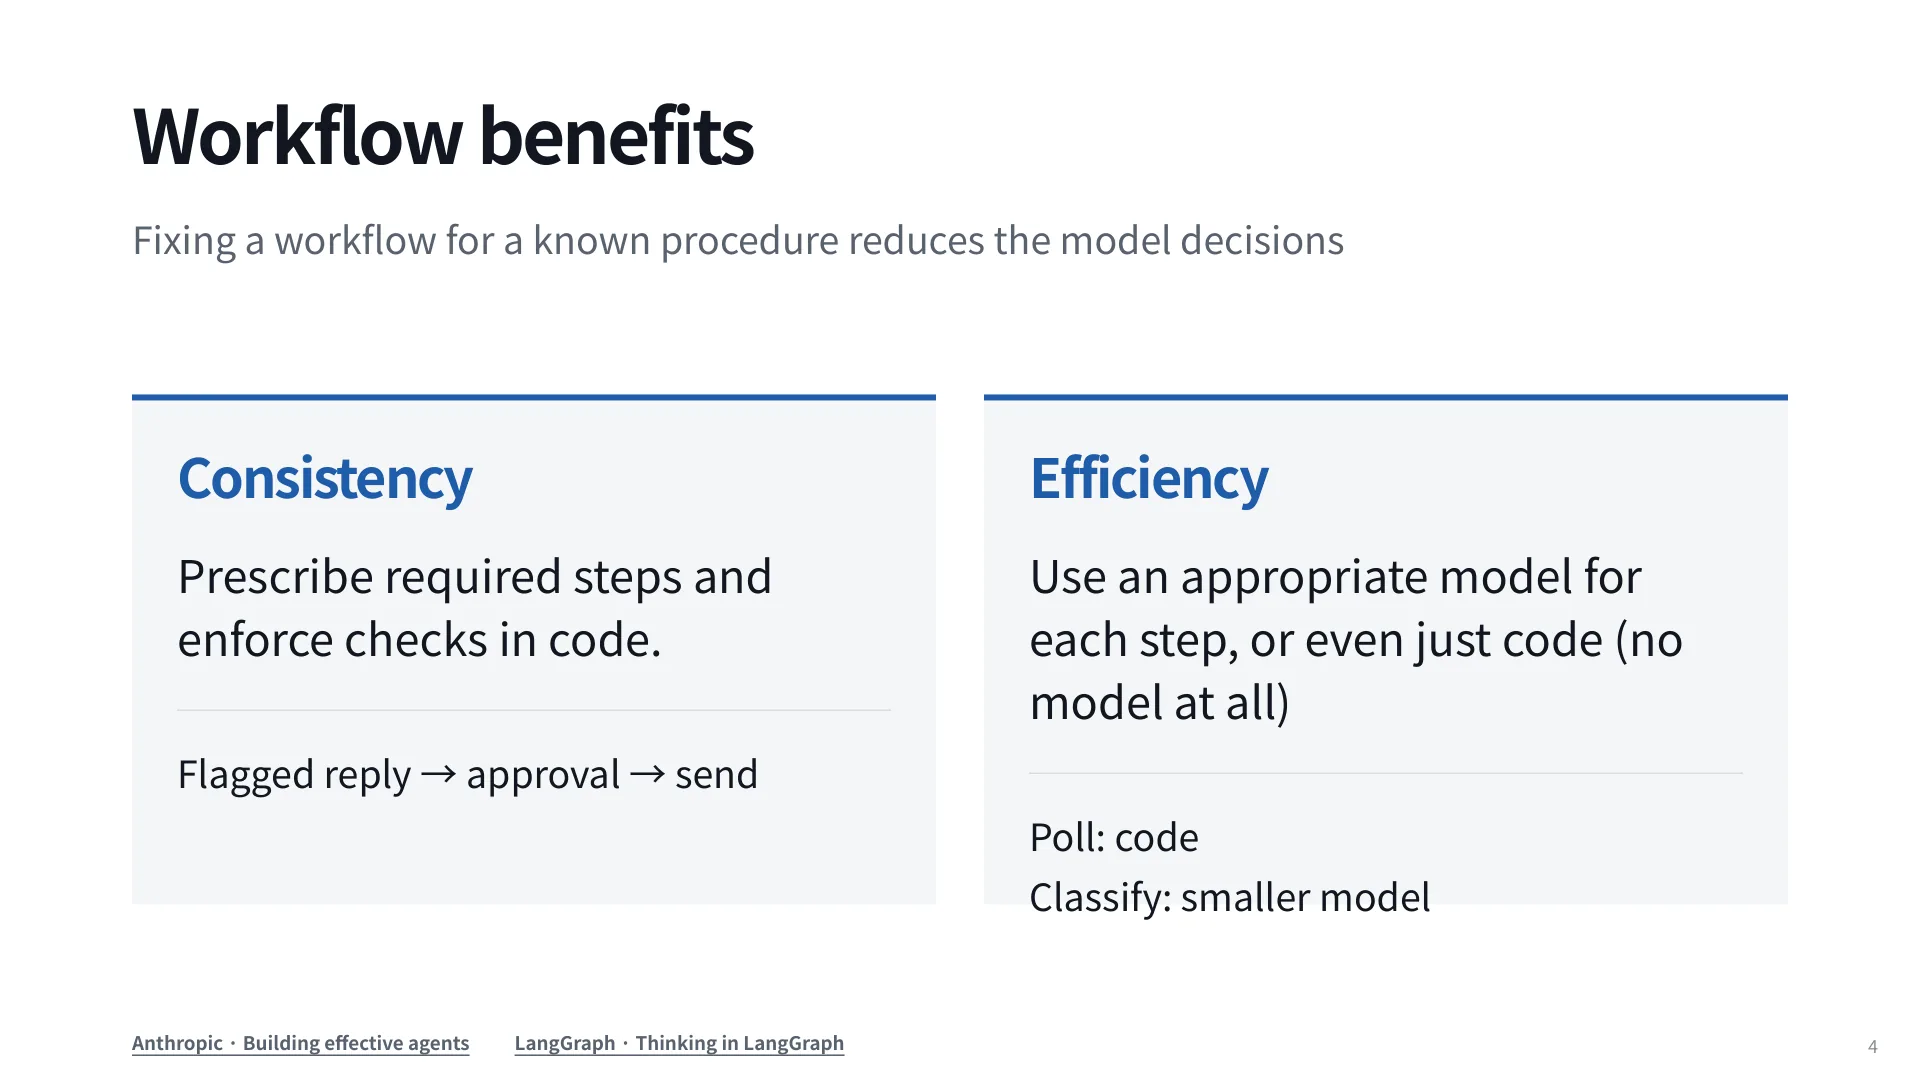
一致性:必需的步骤被写进代码,检查由代码强制执行。例如“被标记的回复必须先经人工批准才能发送”——在工作流里这是一条边,模型绕不过去;在单 agent 里这只是 prompt 里的一句嘱托,模型可以忽略,而且你无法证明它没有忽略。
效率:每个步骤用合适的模型,甚至完全不用模型。轮询用代码,分类用小模型,只有起草这种真正需要语言能力的步骤才调用大模型。单 agent 通常被迫用一个“什么都能干”的大模型走完全程,因为每一步都可能需要推理。
这里还有一个容易被忽略的收益:方差。生产系统关心的往往不是平均质量,而是最差的那 1%。工作流砍掉的是路径的多样性,因此也砍掉了长尾失败的一部分来源。
一个判断标准
当任务的步骤能从政策、手册或 SOP 里写出来,且错误的代价高(退款、发信、改数据),工作流是合适的。当步骤取决于中间发现(调试、研究、探索),写死的图会不断需要新分支,最后退化成“一个节点里塞一个 agent”。
2. 一个客服工作流的解剖
课件用客服邮件作为贯穿例子,因为它同时具备两种请求:可以完全自动化的,和必须有人签字的。
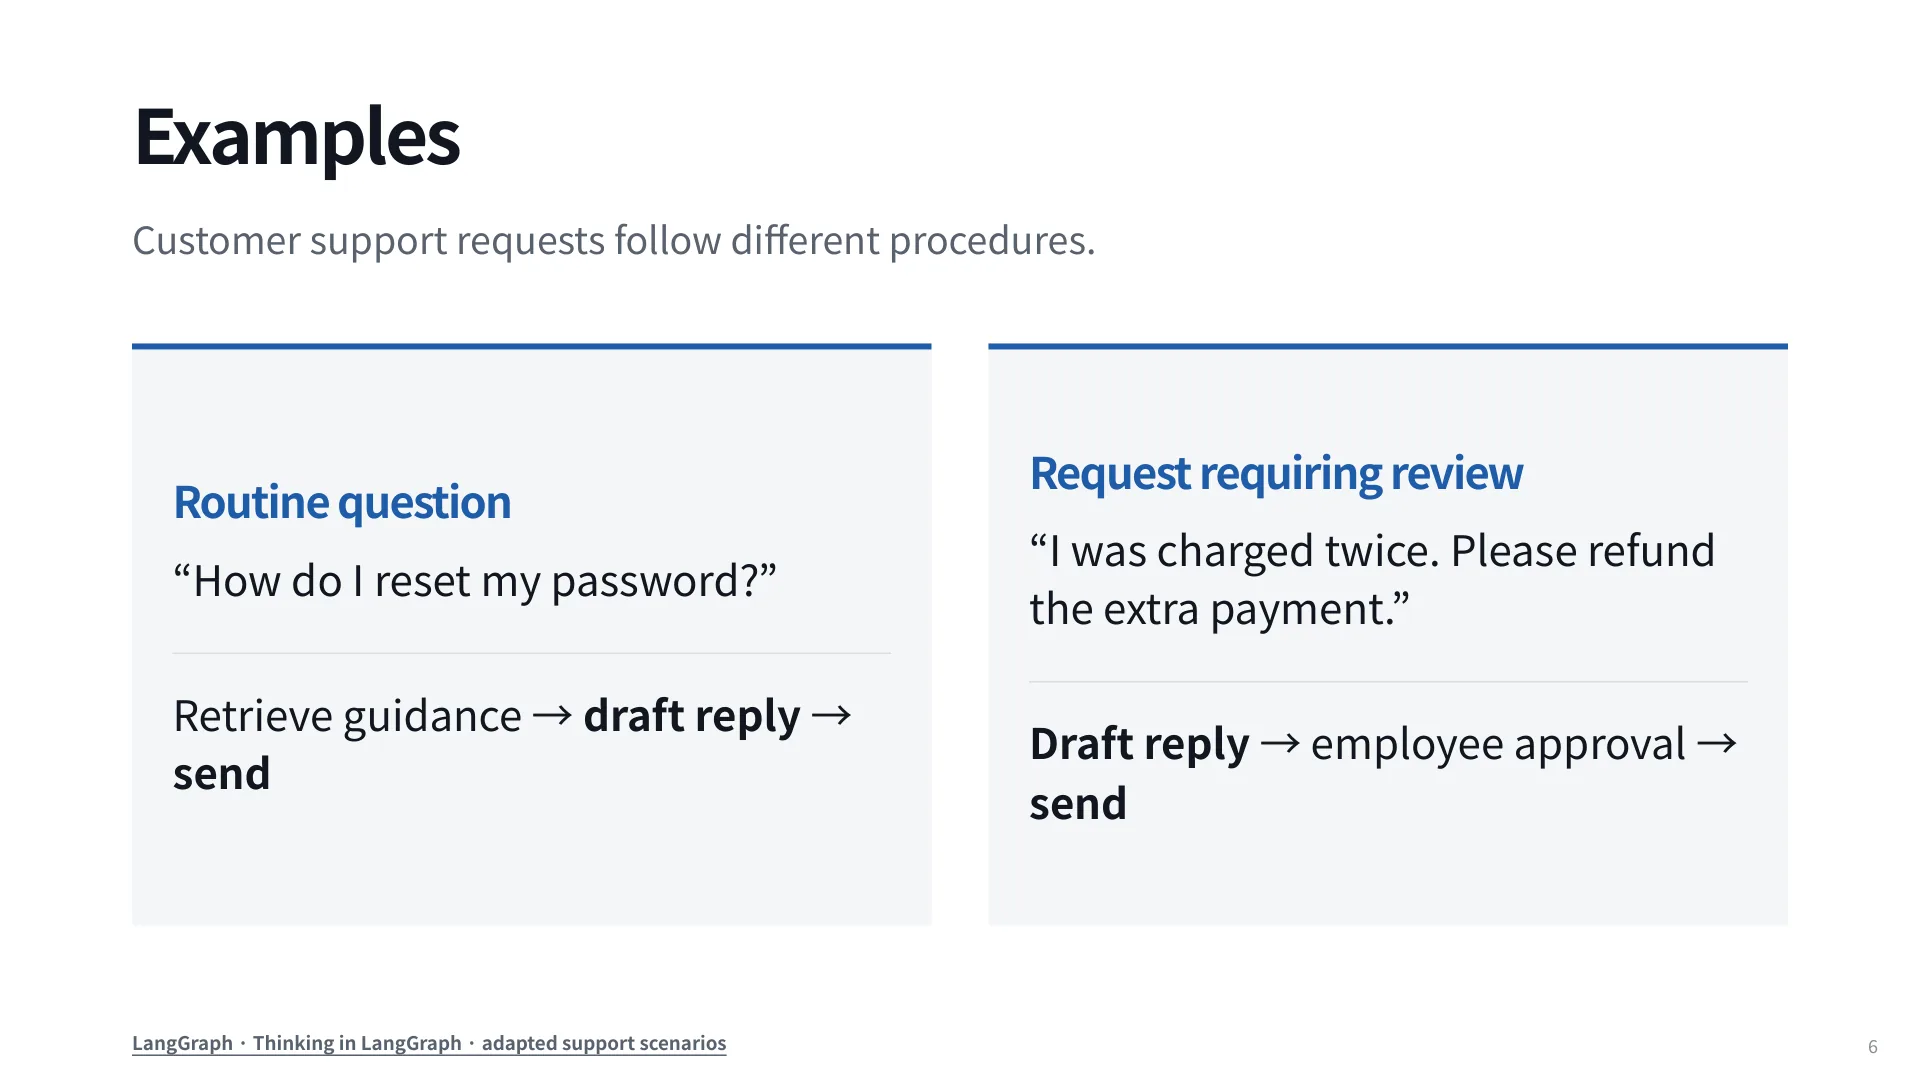
“How do I reset my password?” 走检索指引、起草回复、直接发送。“I was charged twice. Please refund the extra payment.” 必须先起草、等员工批准,再发送。两者共享大部分步骤,差别只在一条分支上——这正是工作流擅长表达的形状。
把流程展开成节点,得到七个步骤:Read email、Classify、Search docs、Bug ticket、Draft reply、Review proposed reply、Send reply。
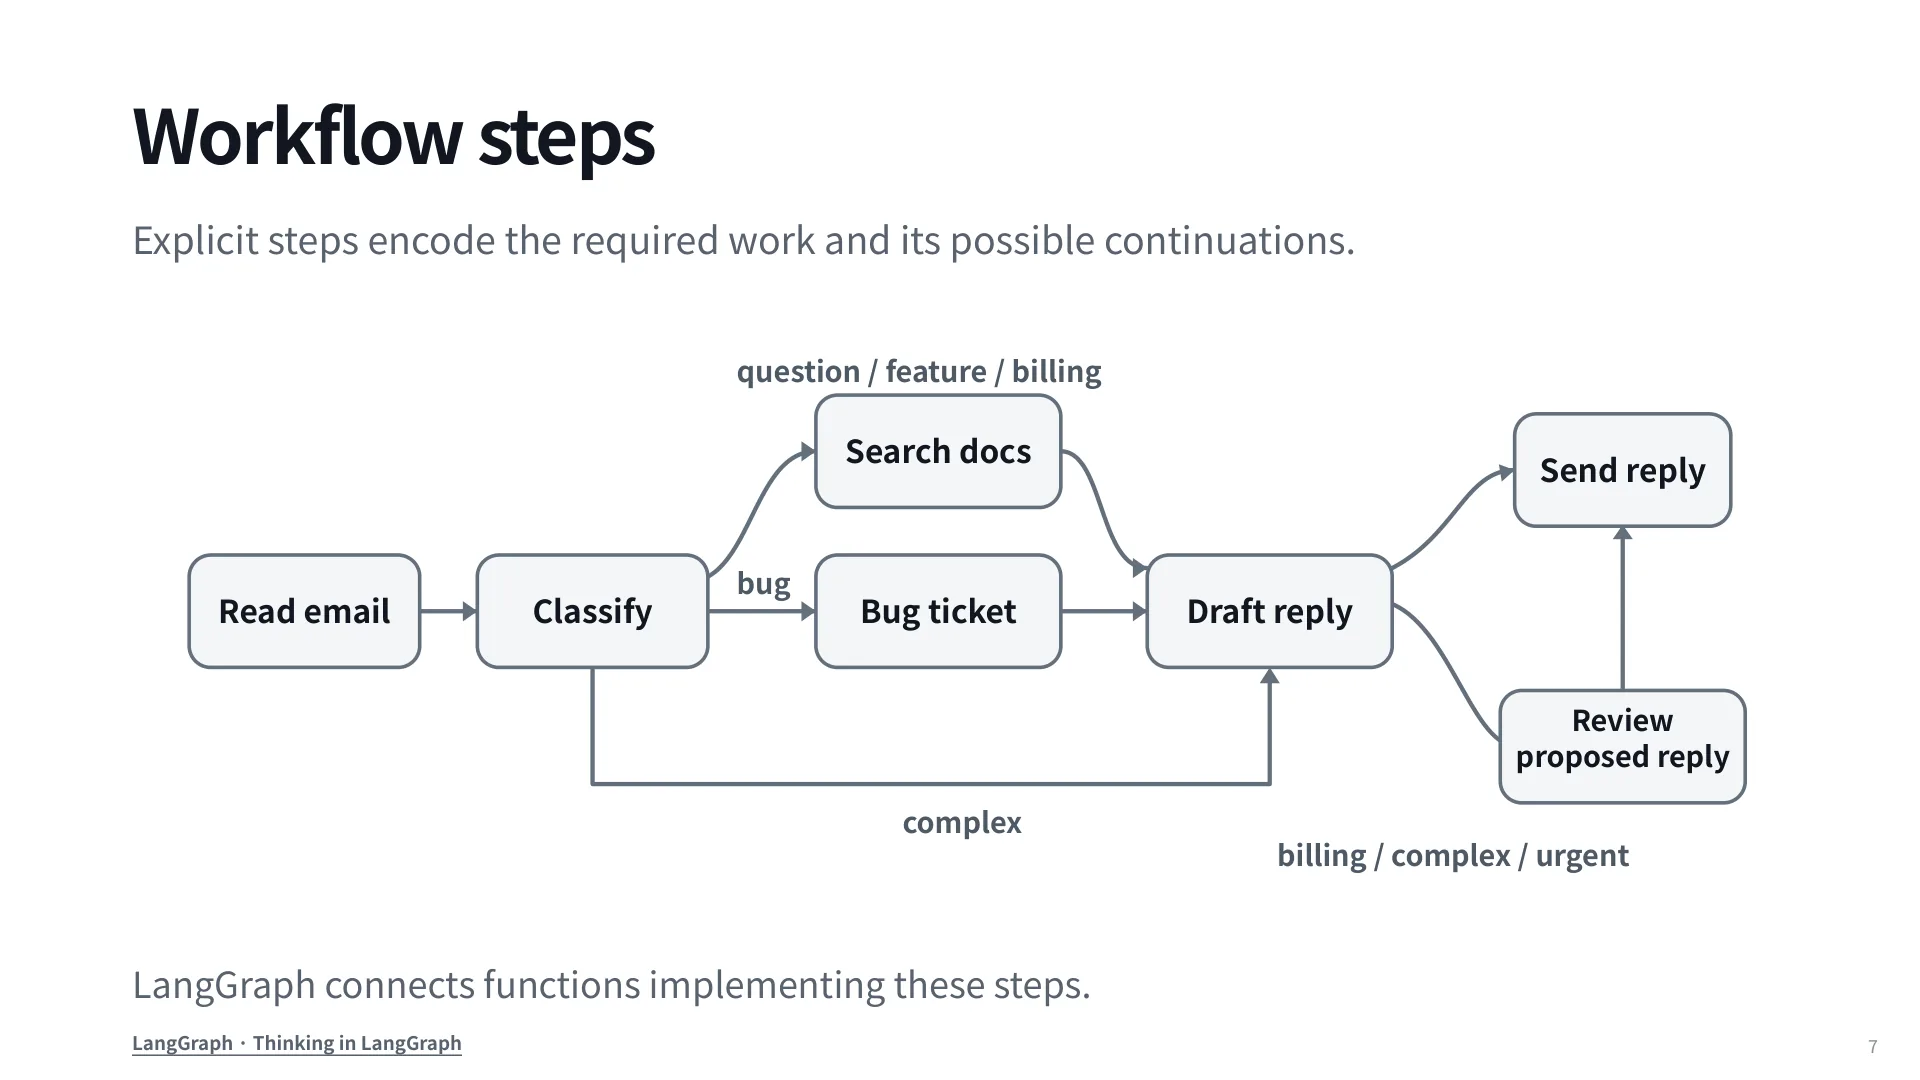
图上还带着标签(question / feature / billing、bug、complex、billing / complex / urgent),它们是分类的可能取值,也是条件边的判断依据。
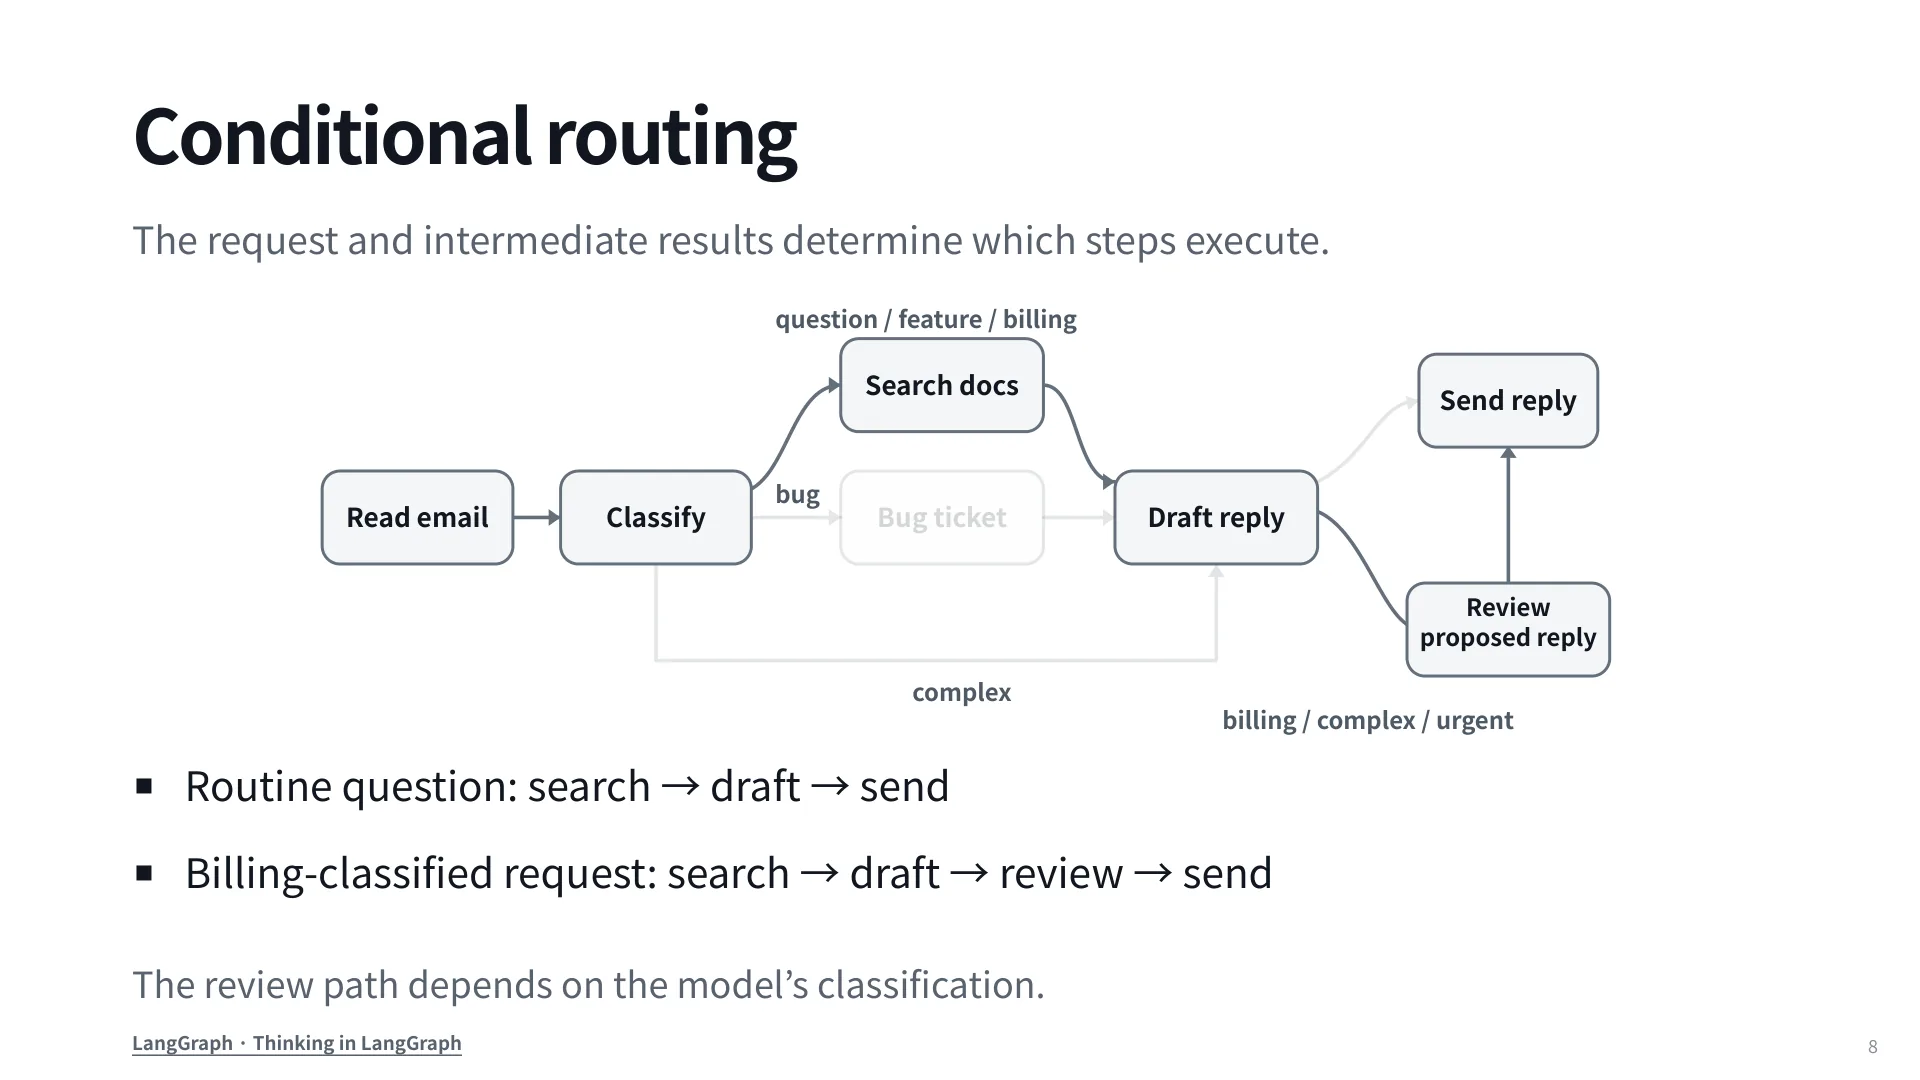
常规问题:search → draft → send。被判为计费的请求:search → draft → review → send。课件特意点明:走不走复核,取决于模型的分类结果。
这句话藏着工作流最典型的风险结构。分类是一次模型判断,而控制流继承了这次判断的错误。如果分类器把一封退款请求误判成 question,回复就会绕过人工批准直接发出——模型的一次概率性错误被放大成一次流程违规。缓解办法不能只靠“把分类 prompt 写好一点”,而要在代码层加硬检查:金额超过阈值必须复核、检测到 refund / charge 等词必须复核、草稿缺少必要字段则禁止发送。分类器决定“通常走哪条路”,硬检查决定“哪些路绝对不允许走”。
另一个收益不在技术层面:图是可讨论的。产品、法务、工程师能指着同一张图说“这里必须有人签字”。prompt 做不到这件事——它是一段自然语言,无法被局部审阅,也无法被 diff 出“这一步的权限变了”。
节点内部并不只有模型调用。读邮件是代码,分类是代码加 LLM,检索是代码调服务,开 bug 单是代码,起草是代码加 LLM,发送是代码,复核是人。把“人”画成一个节点而不是流程外的一封邮件,意味着人的响应也进入状态:它可以被检查点保存、可以超时重试、可以在 trace 里被看到。
3. 共享状态:节点之间的契约
节点之间不互相调用,也不通过全局变量通信,它们只读写同一份共享状态。课件给出的是一个 TypedDict:
class SupportState(TypedDict, total=False):
    email_id: str
    email_content: str
    classification: dict
    search_results: list[dict]
    draft_response: str
    review_decision: dict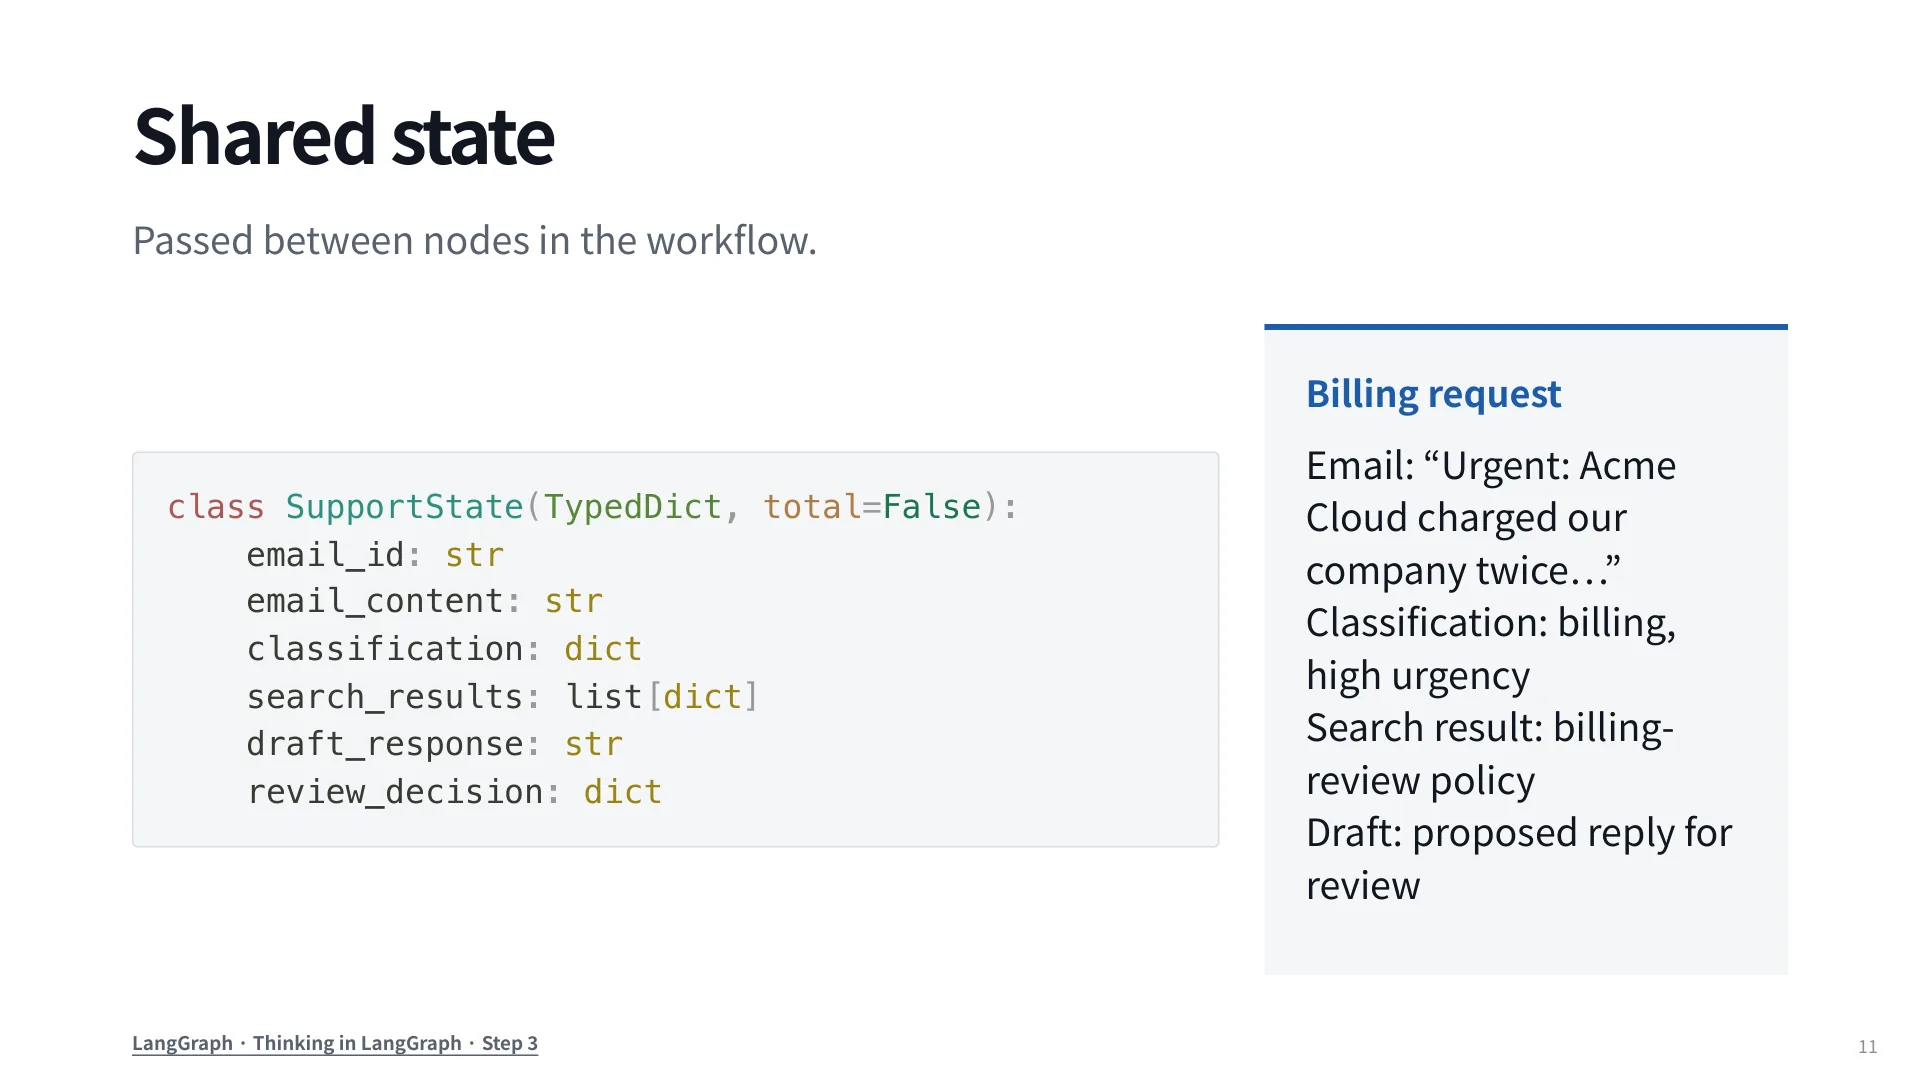
这张表不只是类型声明,它是整个系统的数据契约。看一封真实的计费投诉邮件如何在里面累积:先是邮件正文,然后分类结果(billing、高紧急度),然后检索到的计费复核政策,然后是待复核的草稿,最后是复核决定。每一步只增加自己负责的那一块。
节点返回的也不是整份状态,而是它改动的字段:
def classify_intent(state):
    classification = model.classify(state["email_content"]).model_dump()
return {"classification": classification}这种“部分更新”的设计有两个好处:节点不会因为手滑把别的字段清空;两条分支各自写不同字段时不会互相覆盖。代价是字段的存在性变成了隐式契约——draft_response 读 search_results 时,该字段是否存在取决于上游是否走过检索分支。total=False 让类型检查放行,运行时却可能抛 KeyError。所以状态 schema 其实就是这个系统的 API:改一个字段,等于改所有节点的契约。
一个有用的类比:state 像一张工单,每经过一个工位就被盖上新的章,而不是每个工位自己留一份记录再互相转发。工单的好处是可审计——任何时刻的工单快照都能重建“当时系统知道什么”。这正是后面 checkpoint 与 trace 能成立的前提。
局限也很明显。状态会单调增长,长流程里容易变成“什么都往里塞”的袋子:检索到的整篇文档、工具的原始输出、中间推理,如果全部进 state,检查点体积、序列化成本、以及“把无关信息喂给下游模型”的问题都会出现。实践上要区分“必须跨节点传递的少量字段”和“可以从外部重新获取的大对象”,例如只存文档 ID、用时再取。课件只给了字段列表,没有讨论这层取舍。
4. 装配图与运行期跳转
图是用代码装配的,不是画出来的:
g = StateGraph(SupportState)
g.add_node("read_email", read_email)
g.add_node("classify_intent", classify_intent)
g.add_node("search_documentation", search_documentation)
g.add_node("draft_response", draft_response)
g.add_edge(START, "read_email")
g.add_edge("read_email", "classify_intent")
g.add_edge("search_documentation", "draft_response")
graph = g.compile(checkpointer=checkpointer)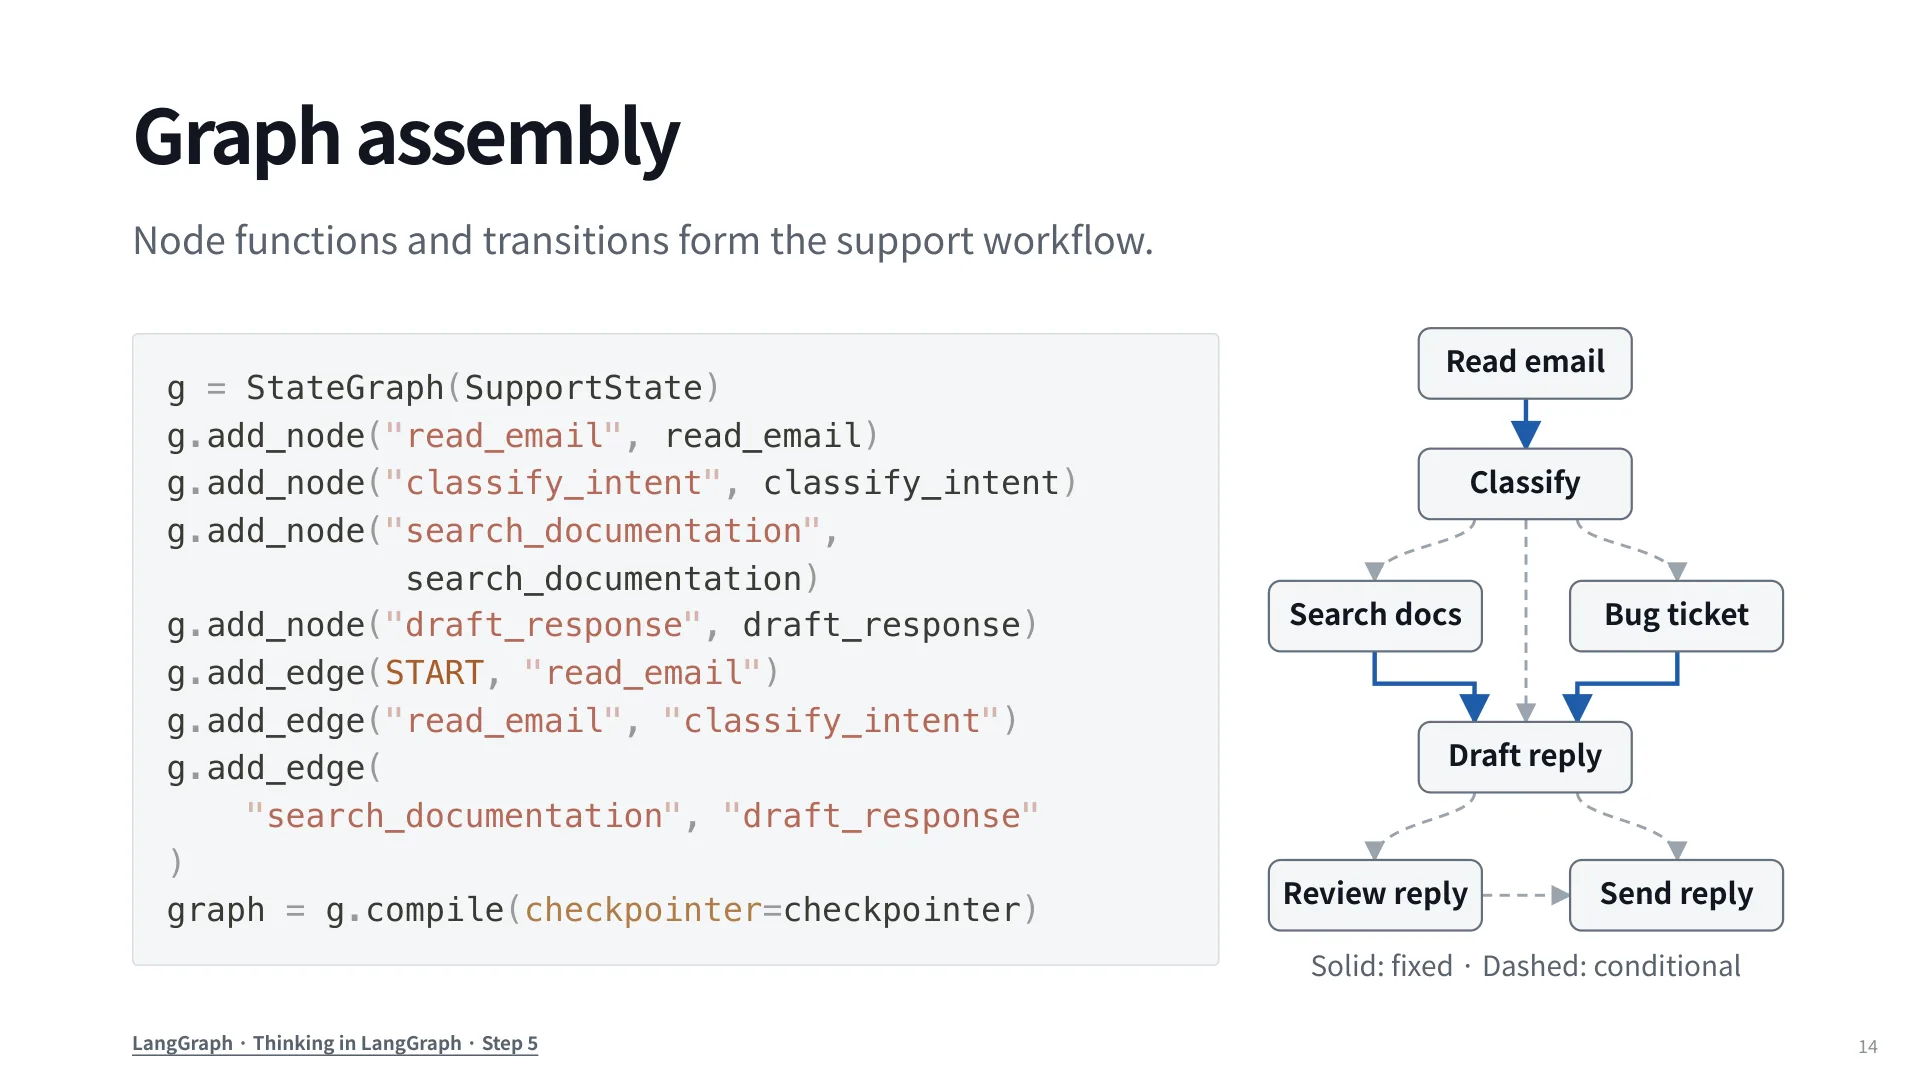
右侧的图用线型区分了两种边:实线是固定转移,虚线是条件转移。分类节点有三条虚线出口(去检索、去开 bug 单、直奔起草),检索到起草是实线,起草之后去复核还是直接发送也是虚线。这种混合让同一张图既能表达确定的流水线,也能表达分叉。
分支有两种写法。一种是条件边:路由函数读状态、返回下一个节点名,拓扑在图的定义处可见。另一种是在节点内部返回 Command,把状态更新和跳转打包:
intent = classification["intent"]
destination = (
    "bug_tracking" if intent == "bug" else
    "search_documentation" if intent in {"question", "feature", "billing"}
    else "draft_response"
)
return Command(update={"classification": classification}, goto=destination)两者的取舍在于“什么是一等公民”。条件边把路由逻辑放在图定义里:容易静态检查、容易画图、容易单测(给一份 state,断言返回的节点名)。Command 把决策和产生决策的计算放在一起,少一次“状态→路由函数→状态”的往返,但图的形状变成运行期决定,静态分析只能看到“可能的边”,画出来的图也不再是完整事实。两者都合法;区别在于你更想让拓扑可审阅,还是让决策点内聚。
compile 是装配与运行的分界。编译期能做的是结构检查:起点是否唯一、边指向的节点是否存在、状态类型是否匹配。运行期才暴露的问题——某条分支永远走不到、某节点在特定输入下缺字段、条件边的返回值拼错——只能靠测试与 trace 发现。
5. 可恢复性:把执行变成对象
一个长流程会失败:模型 API 超时、检索服务 502、进程被重启、人还没批。如果执行只是一个正在运行的 Python 调用栈,这些失败都意味着从头再来。
课件先用一个最小例子说明“节点粒度”为什么重要:检索结果已经保存,生成阶段崩溃,重启生成时可以直接用已完成的检索结果,而不是重新检索。
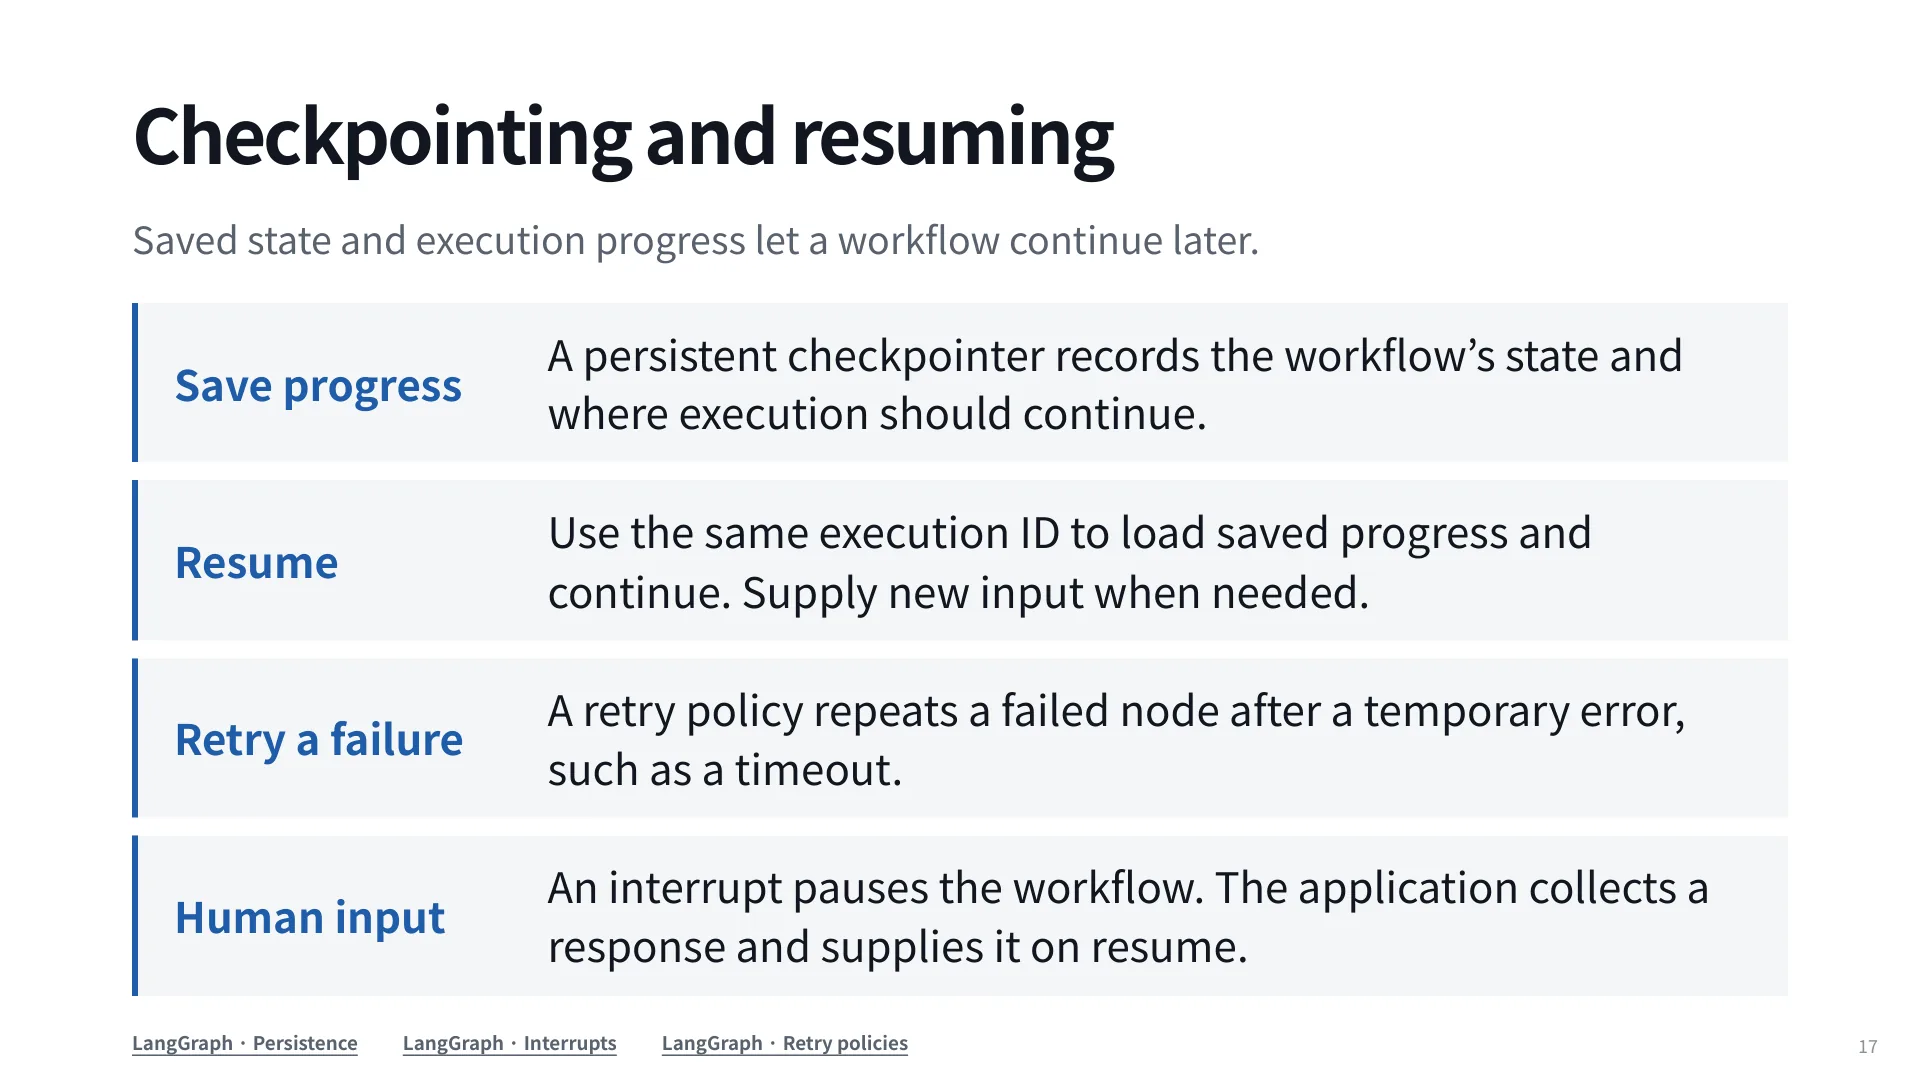
四个机制其实是同一件事的四个面:
| 机制 | 做什么 | 依赖 |
|---|---|---|
| 保存进度 | 持久化 checkpointer 记录状态与“下一步该跑哪” | 状态可序列化 |
| 恢复 | 用同一个 execution ID 载入进度继续,必要时补新输入 | 执行 ID 稳定、状态兼容 |
| 重试失败 | 遇到超时等临时错误后重跑失败的节点 | 节点幂等或有副作用隔离 |
| 人类输入 | interrupt 暂停流程,应用收集响应后在恢复时提供 | 暂停点可持久化 |
它们共同的前提是:执行是一个可以被序列化的对象,而不是一段正在跑的代码。一旦执行成为对象,暂停、续跑、重试、等人,都只是对同一份记录的不同操作。
代价与陷阱同样清楚:
- 副作用幂等性。重试一个“已经发出邮件”的节点会发两封。有副作用的节点要么放在流程末尾,要么带幂等键,要么把“已执行”写进状态并在重入时跳过。框架提供重试,但不提供幂等。
- 粒度取舍。节点越细,崩溃时损失的工作越少,但检查点写入越频繁、状态越大、图的节点越多、维护成本越高。切分应该按“哪些工作昂贵且可复用”来决定,而不是按代码行数:检索贵、生成贵、分类便宜,所以检索与生成分开是有道理的。
- 状态兼容性。改了 schema 之后旧检查点还能不能恢复?课件未展开,但这是上线后最常见的事故之一:旧状态缺新字段,恢复时在下游节点崩掉。
- 等待期间世界会变。人工复核可能等几小时到几天,期间政策文档可能已更新。恢复时要决定“用旧状态继续”还是“重新取数”,这是产品决策,框架替不了你。
6. 可观测性:trace 是一棵树
工作流跑起来之后,第一条需求是“它刚才到底做了什么”。执行 trace 就是这份记录:一次执行是一棵树,节点是树上的分支,节点内部的模型调用、工具调用、普通代码是叶子。
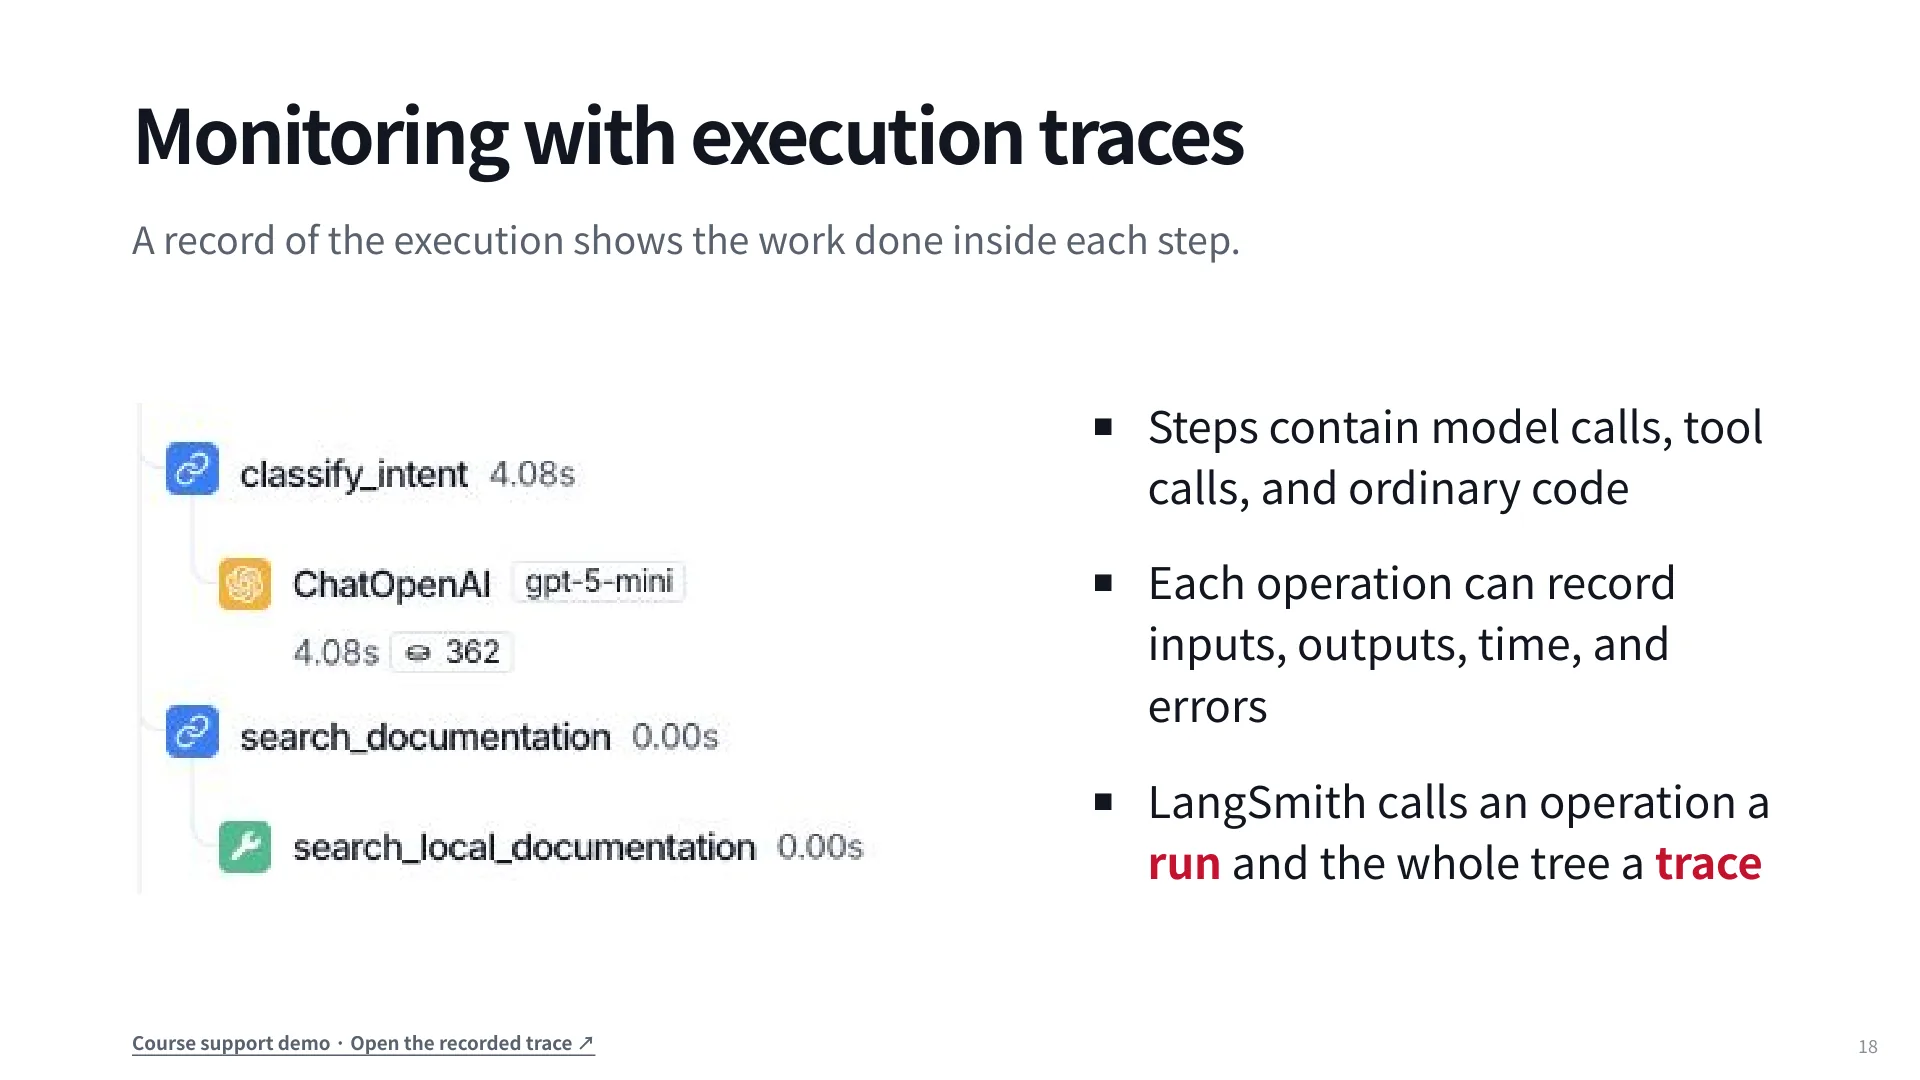
课件里的例子很小但信息完整:classify_intent 耗时 4.08 秒,它下面嵌套一个 ChatOpenAI 调用,模型是 gpt-5-mini,同样 4.08 秒,消耗 362 个 token;search_documentation 耗时 0.00 秒,下面嵌套 search_local_documentation。LangSmith 把单个操作叫 run,把整棵树叫 trace。
为什么必须是树而不是日志?日志是时间序列,trace 是调用关系。工作流里“这一步慢”可能来自模型本身、来自工具、来自重试了三次、来自排队;只有父子关系才能把耗时归因到具体一层。token 记录还让成本可以按节点结算——你才能回答“这条流程的钱花在分类还是起草上”,进而决定“分类是不是该换更小的模型”。
更重要的对照是:图是预期的结构,trace 是实际发生的结构。两者一比,诊断就出来了。图上有 Review 节点而 trace 里没有,说明分类没走到那条分支;trace 里同一个节点出现三次,说明发生了重试或循环;某个 run 的输入里缺了 search_results,说明上游分支没写这个字段。
同一个工作流、两封不同的邮件,会产生两条形状不同的 trace:密码问题那条短,重复扣款那条多出复核与等待。把两条 trace 并排看,是最原始的“行为差异分析”,也是下一节“规模化监控”的起点。
局限需要说清楚:trace 记录发生了什么,不记录为什么。模型的内部推理通常不在 run 的输入输出里,除非你显式记录;即便记录,那也只是模型自述的理由,不是因果。此外 trace 里全是用户数据,采样、脱敏、保留期限都是必须的工程约束,课件未展开。
7. 测试工作流:从节点单测到回归
工作流最大的隐性收益是可测试性,而可测试性来自“输入输出是显式的”。
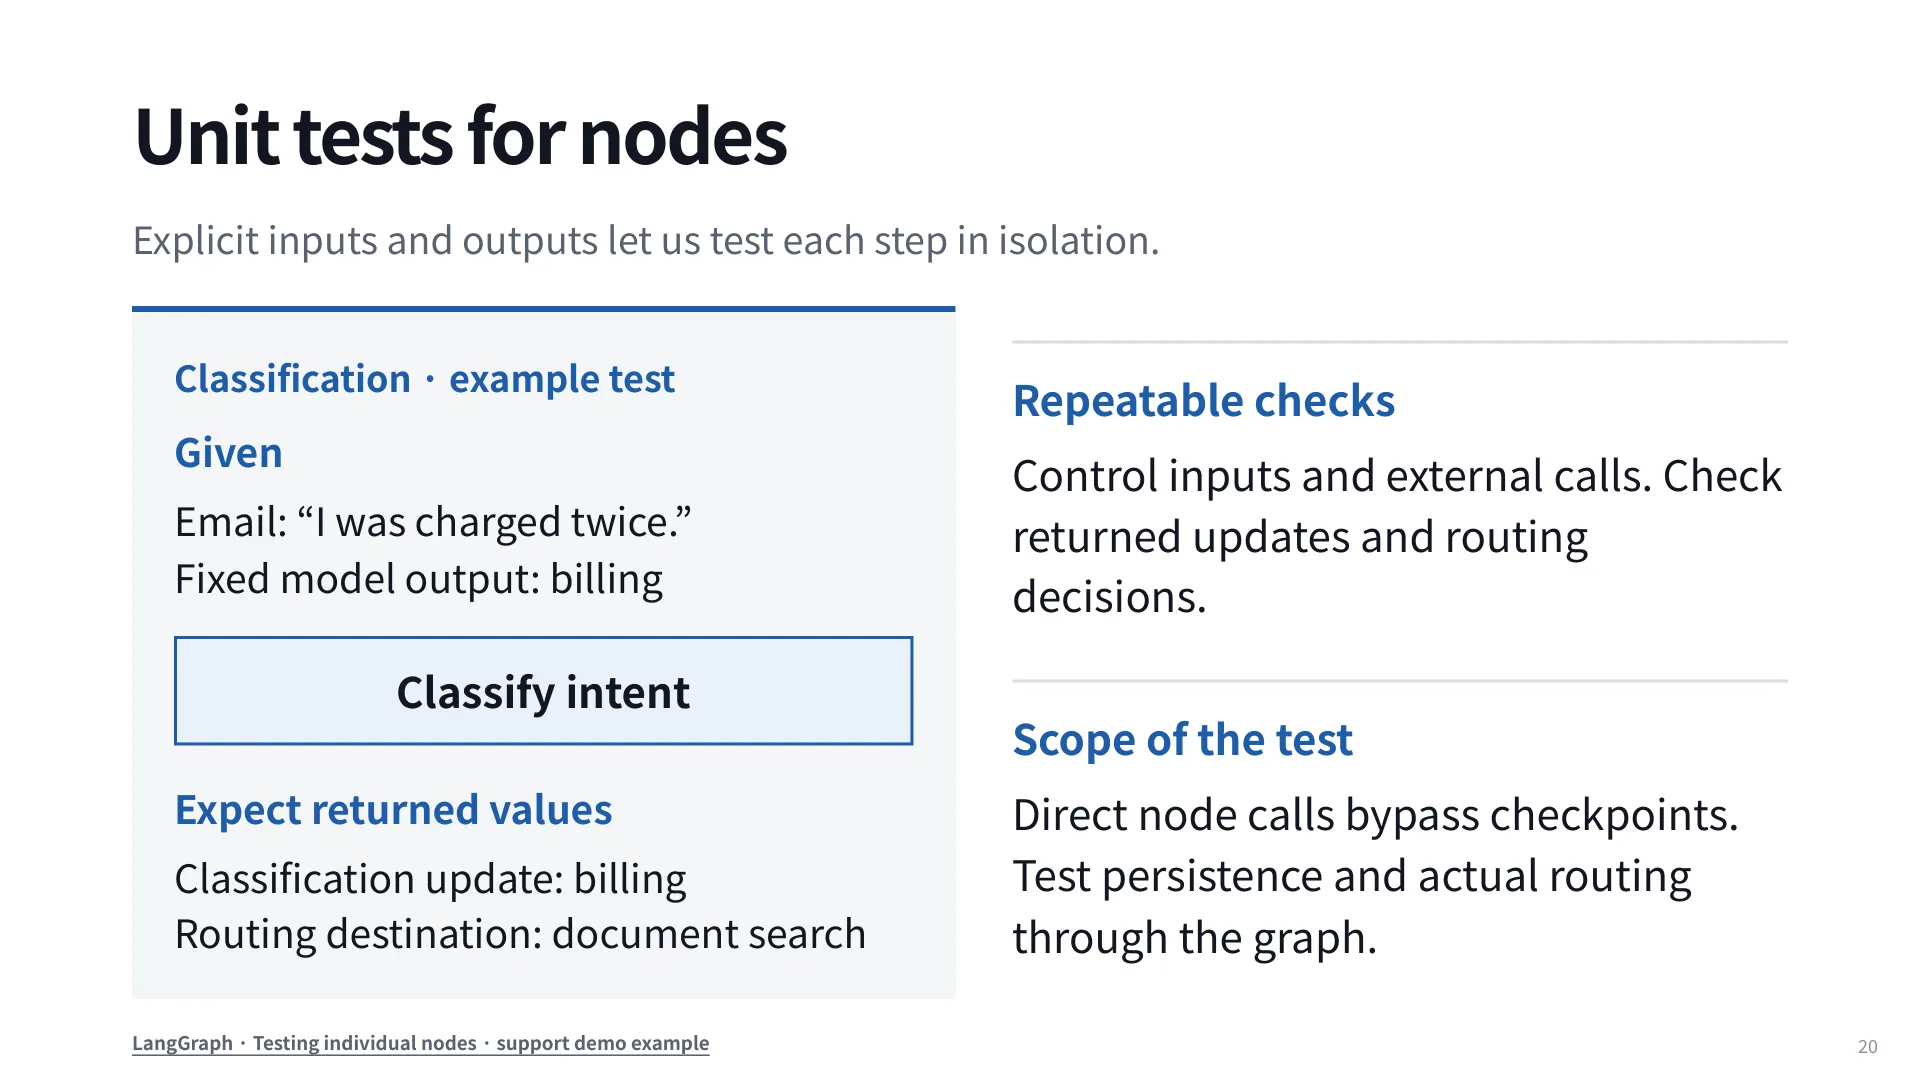
一个分类节点的测试可以写成:给定邮件“I was charged twice.”,把模型输出固定为 billing;调用 classify_intent;断言返回的分类更新是 billing,且路由目标是文档检索。可重复性来自控制输入与外部调用——假模型、假检索服务。
这里的关键设计是断言的粒度。不要断言模型输出的字符串相等,那会在换模型时全部碎掉;要断言契约:返回了哪些字段、字段取值是否在允许集合内、它导致的路由是否正确。
课件右下角还有一句容易被跳过的话:直接调用节点会绕过 checkpointer。因此单测通过不代表图能跑通;持久化、真实路由、条件边、重试必须在图级别测。这一条把测试分成了两层。
第二层是受控的工作流测试,覆盖分支而不只是节点:
| 输入 | 期望行为 |
|---|---|
| 密码问题 | 检索指引、起草、发送 |
| 计费投诉 | 暂停等待批准,此时什么都还没发 |
| 复核被拒绝 | 结束,不发送 |
| 检索临时失败 | 重试检索后继续 |
第三层是回归与集成:换一个新模型之后这些还过吗?端到端跑一遍,节点之间的交互是否正确?
LLM 步骤让测试带上概率性,常用三种手段:温度设为 0 并锁定模型版本;录制—回放(把真实调用录成 fixture,测试时重放);对同一输入跑 N 次看分布(例如“分类准确率不低于某个阈值”),而不是单次通过。第三种最贵,但最接近真实。
一个反直觉的陷阱
工作流越好测,越容易被过度信任。测试覆盖的是你写下的分支,而模型可能在某个分支内部做出你没预料的事——例如草稿里主动承诺了退款。断言“消息已发送”不等于断言“消息发得对”,前者是控制流测试,后者才需要内容级检查或人工抽检。
8. 工作流的代价与框架版图
把收益和代价并排放,取舍就清楚了。
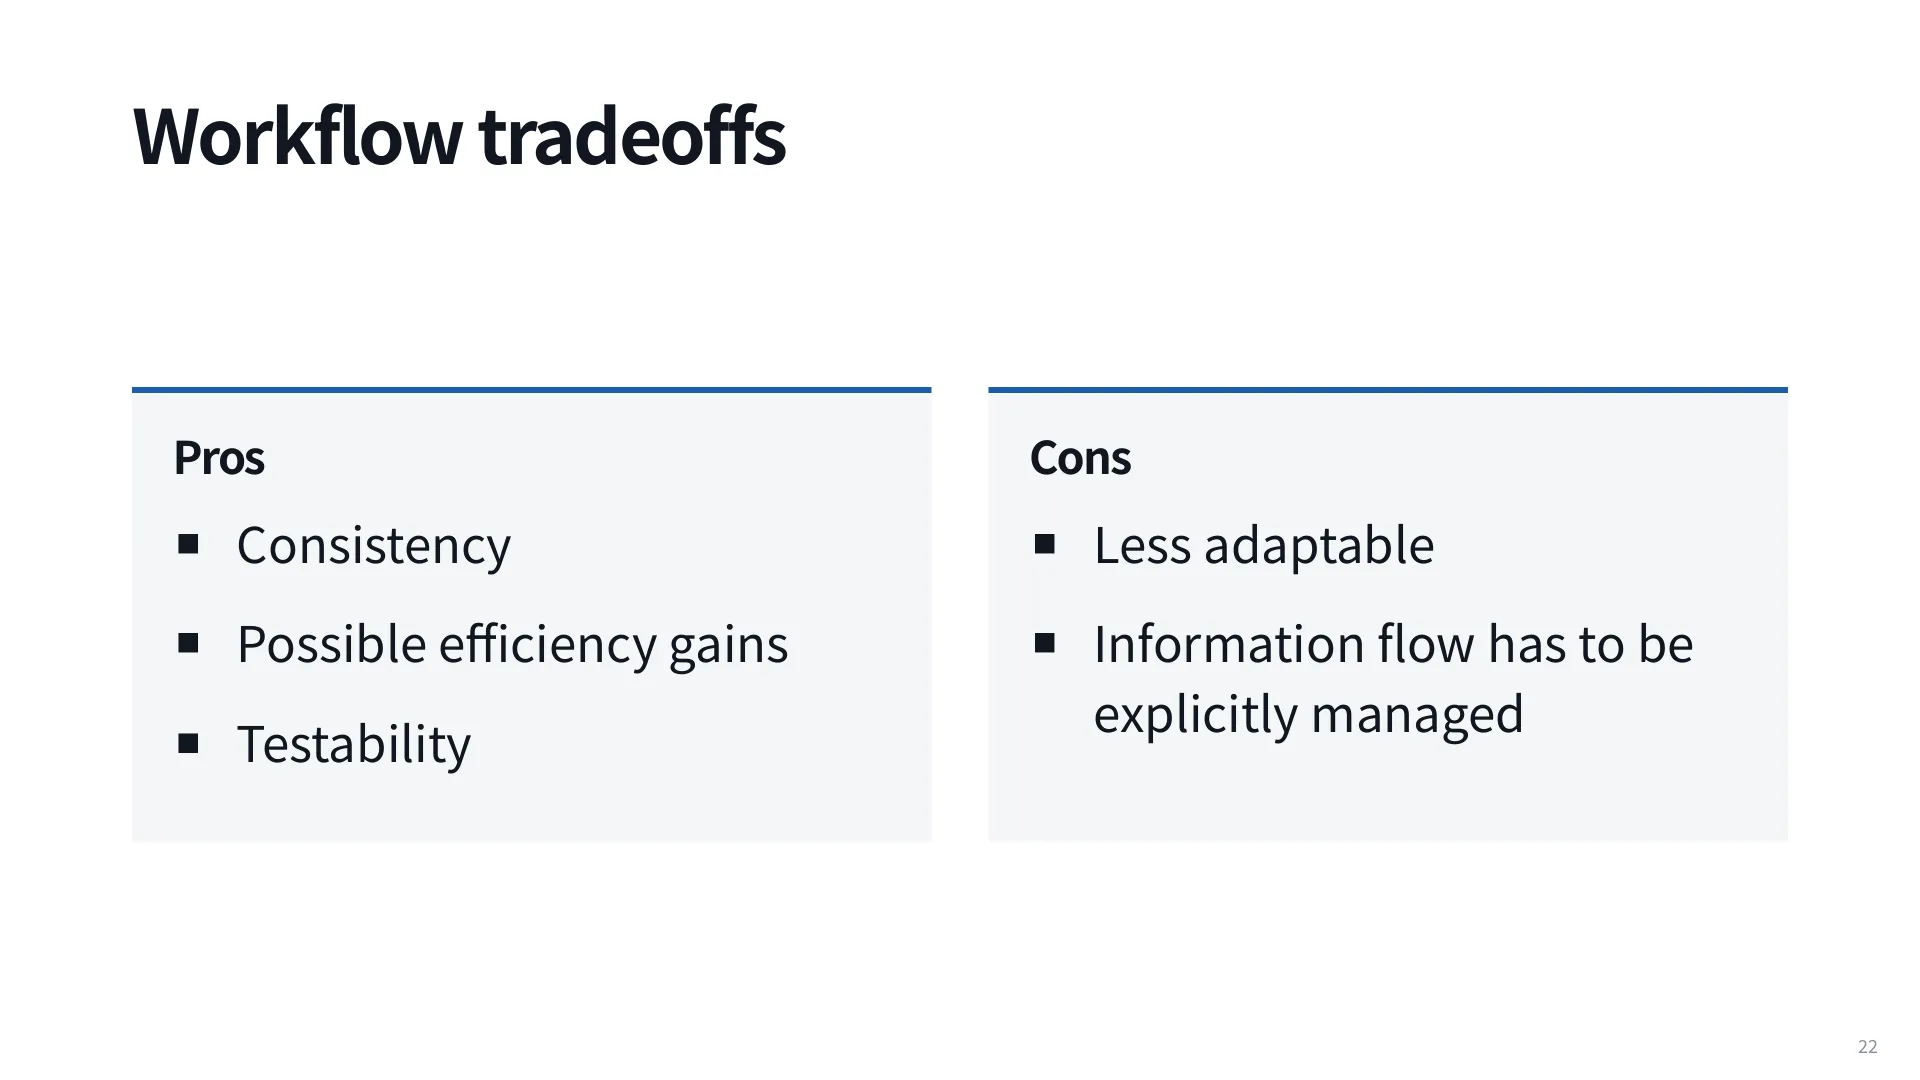
收益三项:一致性、可能的效率增益、可测试性。代价两项,都值得展开。
适应性下降。流程之外的请求没有对应分支:一封法律函件、一个要求改发票抬头的请求,图上没有位置。常见的工程缓解是加一个 fallback 节点,把“分类不出来的请求”交给通用 agent 处理,但课件没有讨论这条路,它本身也有代价——fallback 分支的行为重新变得不可预测,而它恰恰处理的是最难的情况。
信息流必须显式管理。每个交接点都要设计字段、类型、默认值、缺失时的行为。写死的信息流还有一层更隐蔽的代价:模型无法临时去拿它需要、但流程没给它的东西。单 agent 可以“觉得需要看一下账单历史”就去查;节点做不到,除非你为它开了这个口。
于是判断规则可以更具体一点:步骤可枚举、错误代价高、需要审计——用工作流;步骤依赖中间发现、需要临场探索——用 agent;两者混合时,把稳定的骨架写成图,把不确定的一段包成一个 agent 节点。
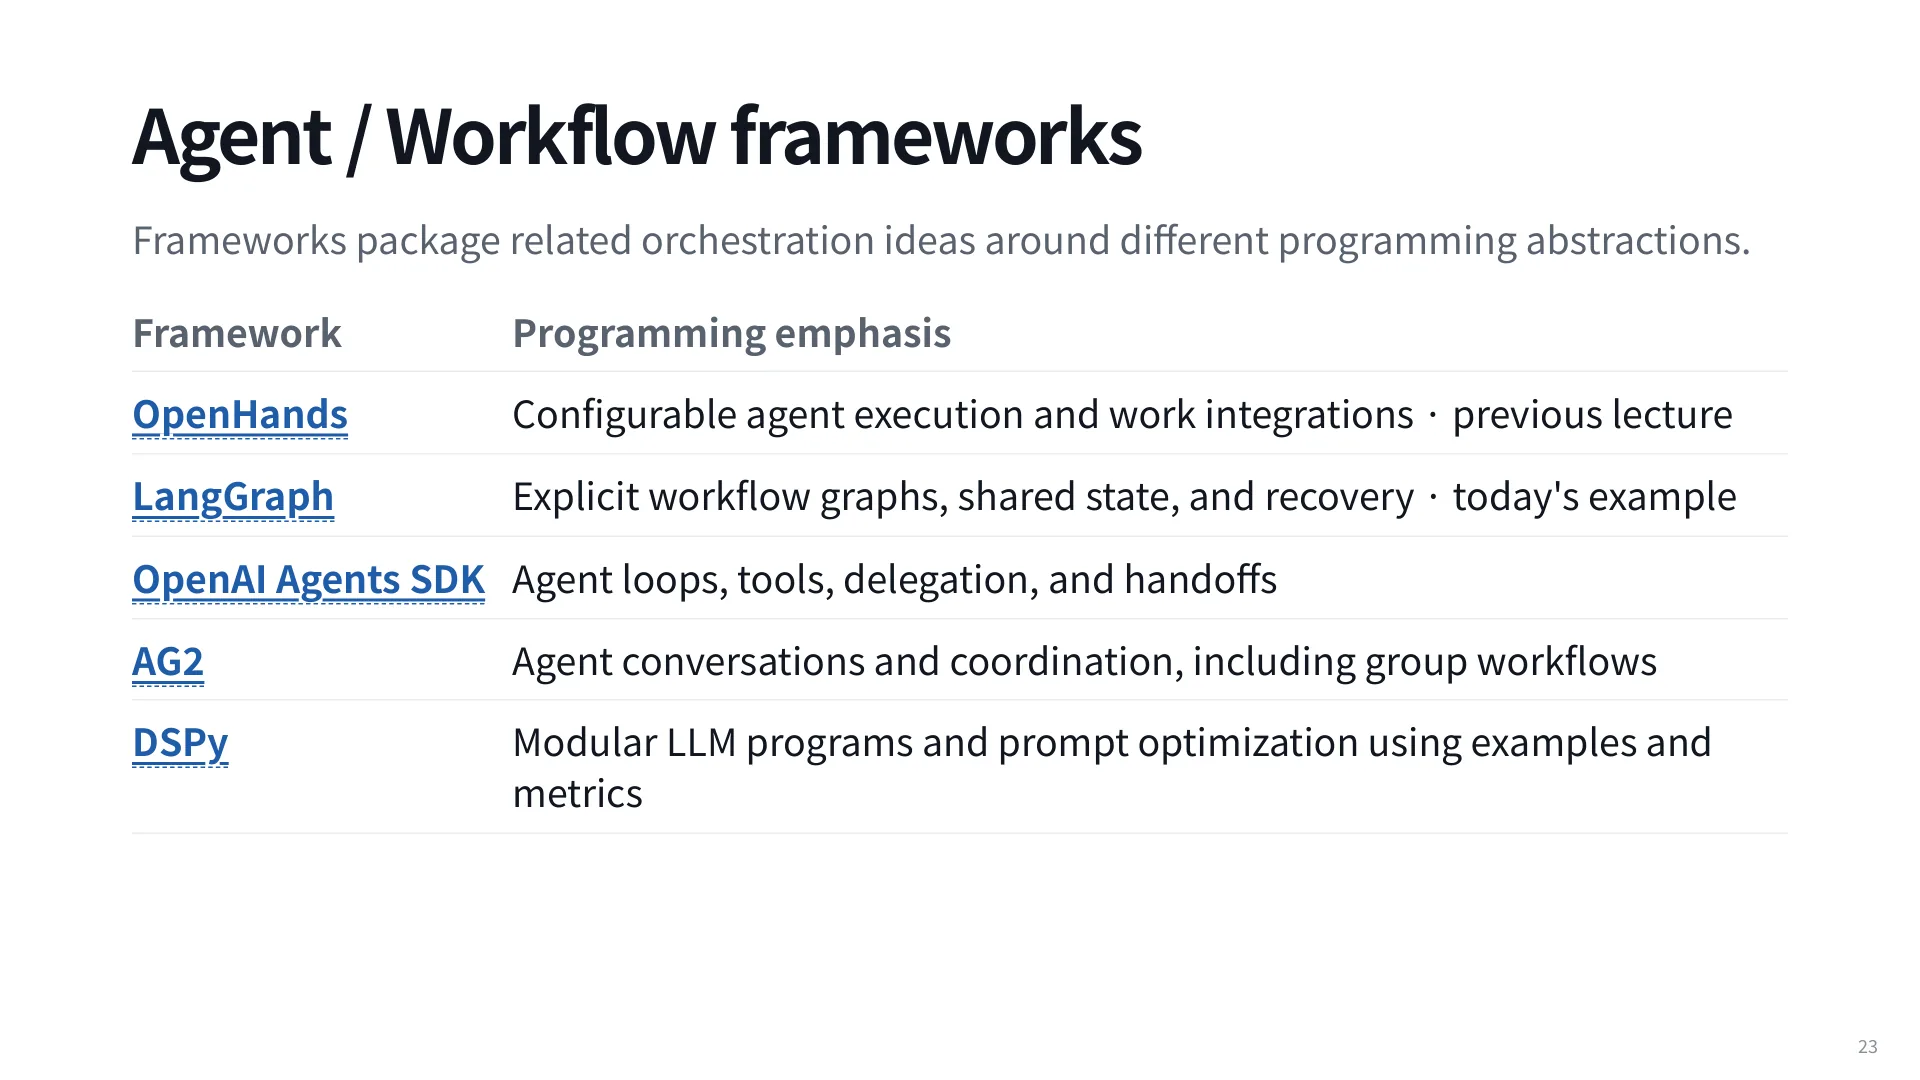
框架表的读法是看“它把什么当成程序的基本单位”:
- OpenHands:可配置的 agent 执行与工作集成(上一讲的主角)。
- LangGraph:显式工作流图、共享状态、恢复能力(本讲的主例)。
- OpenAI Agents SDK:agent 循环、工具、委派与 handoff。
- AG2:agent 之间的对话与协调,包括 group workflow。
- DSPy:模块化的 LLM 程序,用样例与指标做 prompt 优化。
三条隐含的轴:控制在哪里(开发者的图,还是模型的循环)、组合的单位(节点与状态、agent 与 handoff、对话、程序模块)、是否包含优化(DSPy 把“写 prompt”换成“用指标编译程序”)。
它们并不互斥:可以在 LangGraph 的某个节点里放一个 Agents SDK 的 agent,也可以用 DSPy 优化某个节点的 prompt。选框架时更该问的不是“谁更强”,而是“它的默认抽象是否让我的失败模式变得可见”——能不能单测、能不能暂停、能不能追踪、能不能回放。
9. 规模化监控:从一条 trace 到一类行为
单条 trace 的用途很明确:你已经知道出了问题,去看是哪一步。但当你有一万条 trace 时,问题变了。
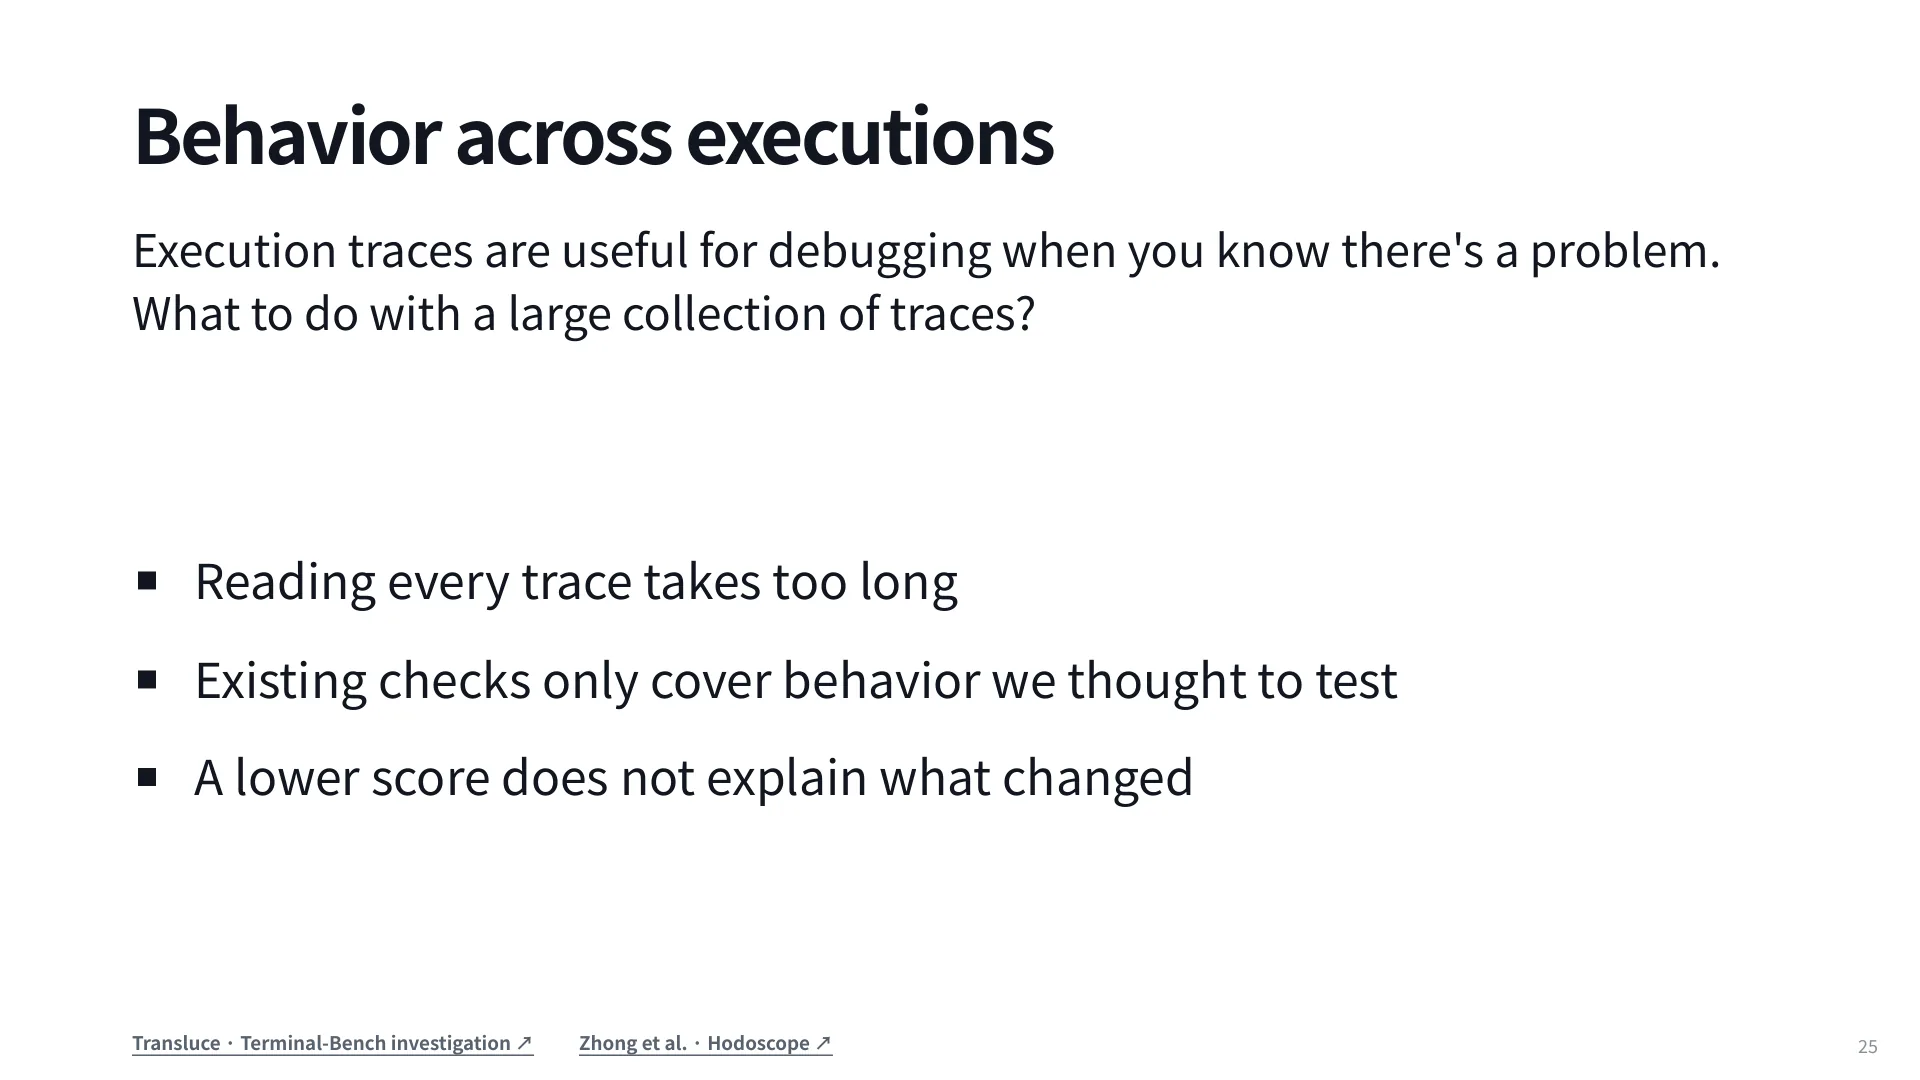
课件列了三个障碍:
- 读不完。逐条阅读的成本远超可用人力。
- 覆盖不全。既有检查只覆盖“我们想到要测的行为”,而新模型的失败方式往往正是没想到的那类。
- 不解释。分数从 40% 掉到 27%,这个数字本身不告诉你哪里变了。
课件用一个具体案例把三个障碍串起来:Terminal-Bench 上,同一个 harness 下 GPT-5 Codex 40%,GPT-5.1 Codex 27%。
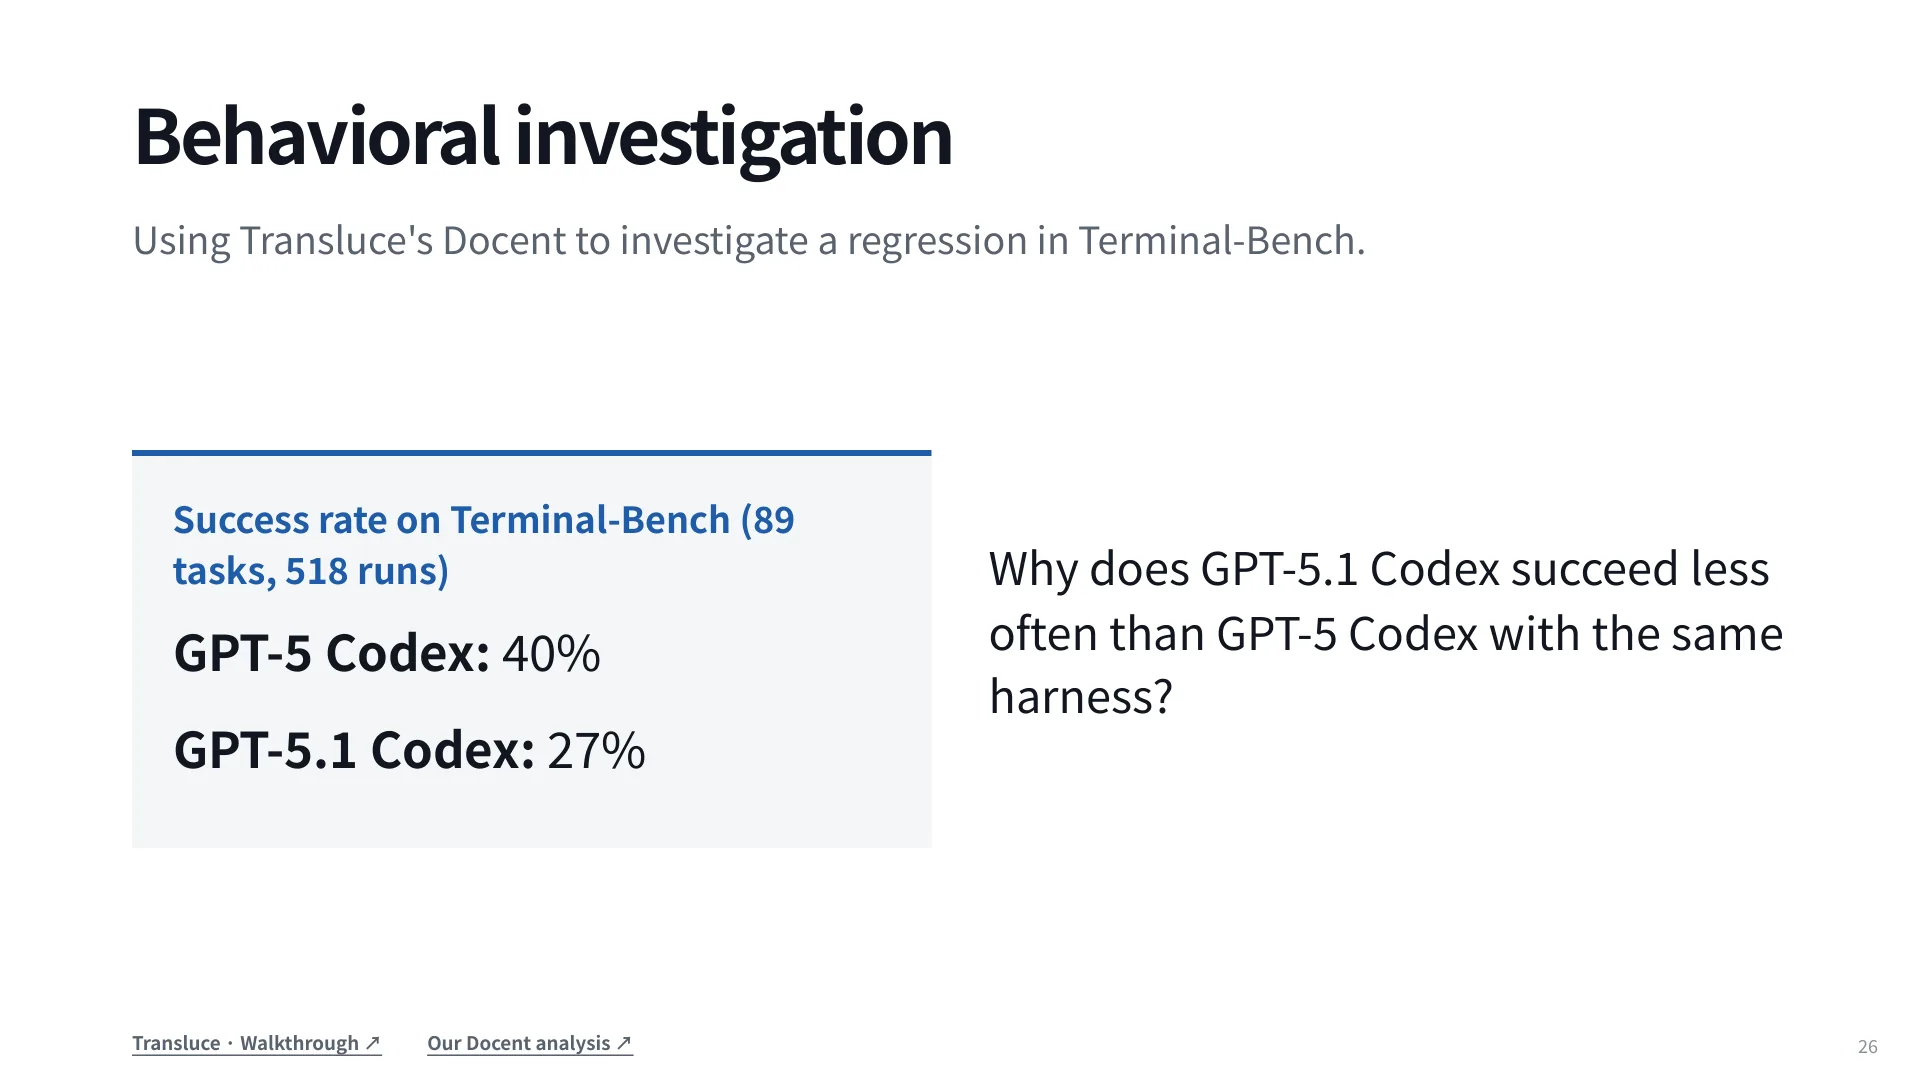
这个案例干净的地方在于 harness 固定:工具、提示模板、评分逻辑都一样,差异只能来自模型行为。于是问题被逼成一个纯粹的行为问题——为什么新模型在同样的条件下成功得更少?
数字规模也值得记住:219 加 265 共 484 条计分运行,其中 108 条失败(79 条属于新模型,29 条属于旧模型)。把 108 条失败逐条读懂,对人是几小时到几天的工作量;对 agent 则是一次可并行的分析任务。这就是本节方法论的全部动机:把 trace 语料当成数据集,用 agent 去查询它。
10. 用 agent 审计 agent:配对比较到失败模式综合
Docent 的做法不是“让模型读一堆 trace 然后总结”,而是把分析写成可复查的查询计划。第一步是配对比较:
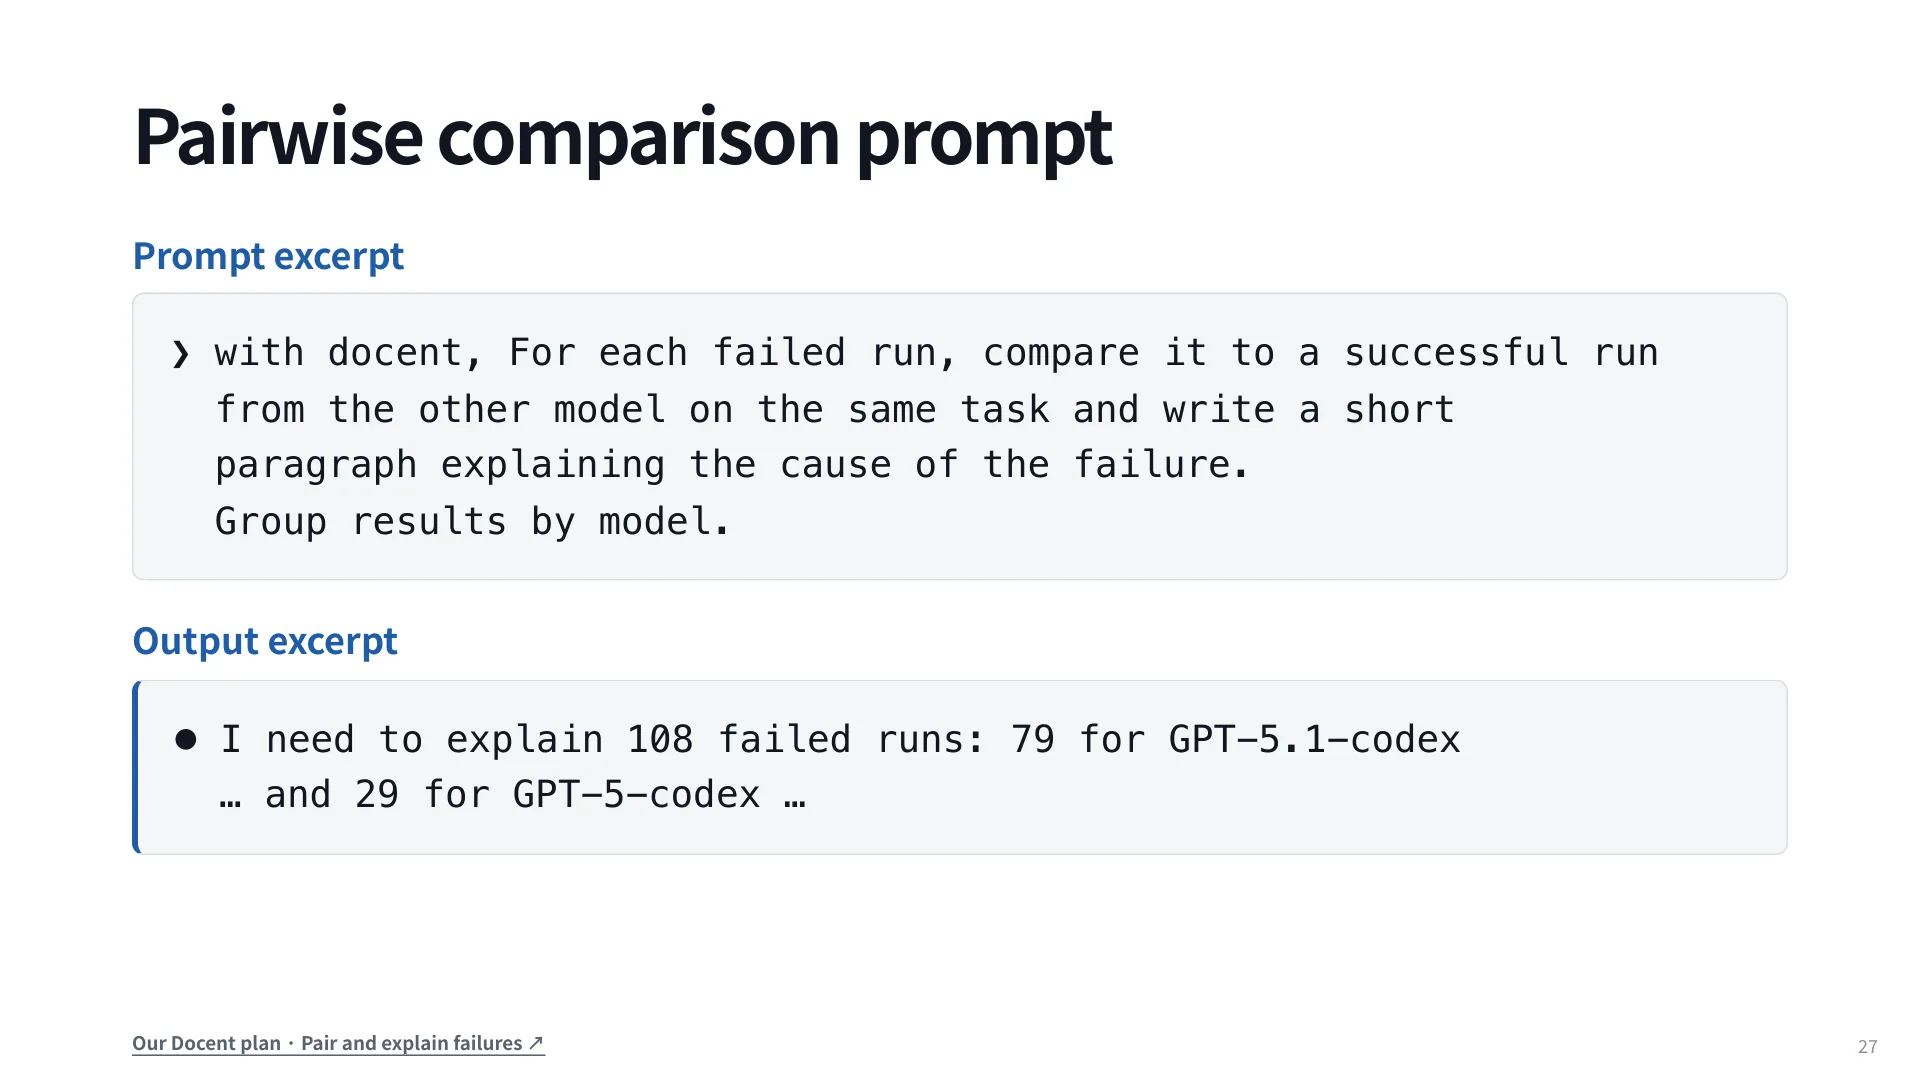
提示词要求:对每一条失败运行,找另一个模型在同一任务上的成功运行作对照,写一段短文解释失败原因,最后按模型分组。输出显示它需要解释 108 条失败——79 条属于 GPT-5.1-codex,29 条属于 GPT-5-codex。
配对是这里最关键的方法设计。直接比较“新模型的失败”和“旧模型的成功”,会把任务难度混进原因里:也许新模型失败的那些任务本来就难。固定任务、只让模型变化,差异才只剩行为。这和实验设计里的配对对照是同一个道理。
结果不是一段笼统的总结,而是可追溯的条目:每条解释带着引用,可以点进两条轨迹的具体动作。课件给的例子是 code-from-image 任务:GPT-5 Codex 失败,而 GPT-5.1 Codex 改用 OCR 后成功。引用让归因可核查——这是 agent 生成的结论能被人接受的前提,否则它只是另一段需要被审计的文字。
第二步是把 108 条解释综合成失败模式:
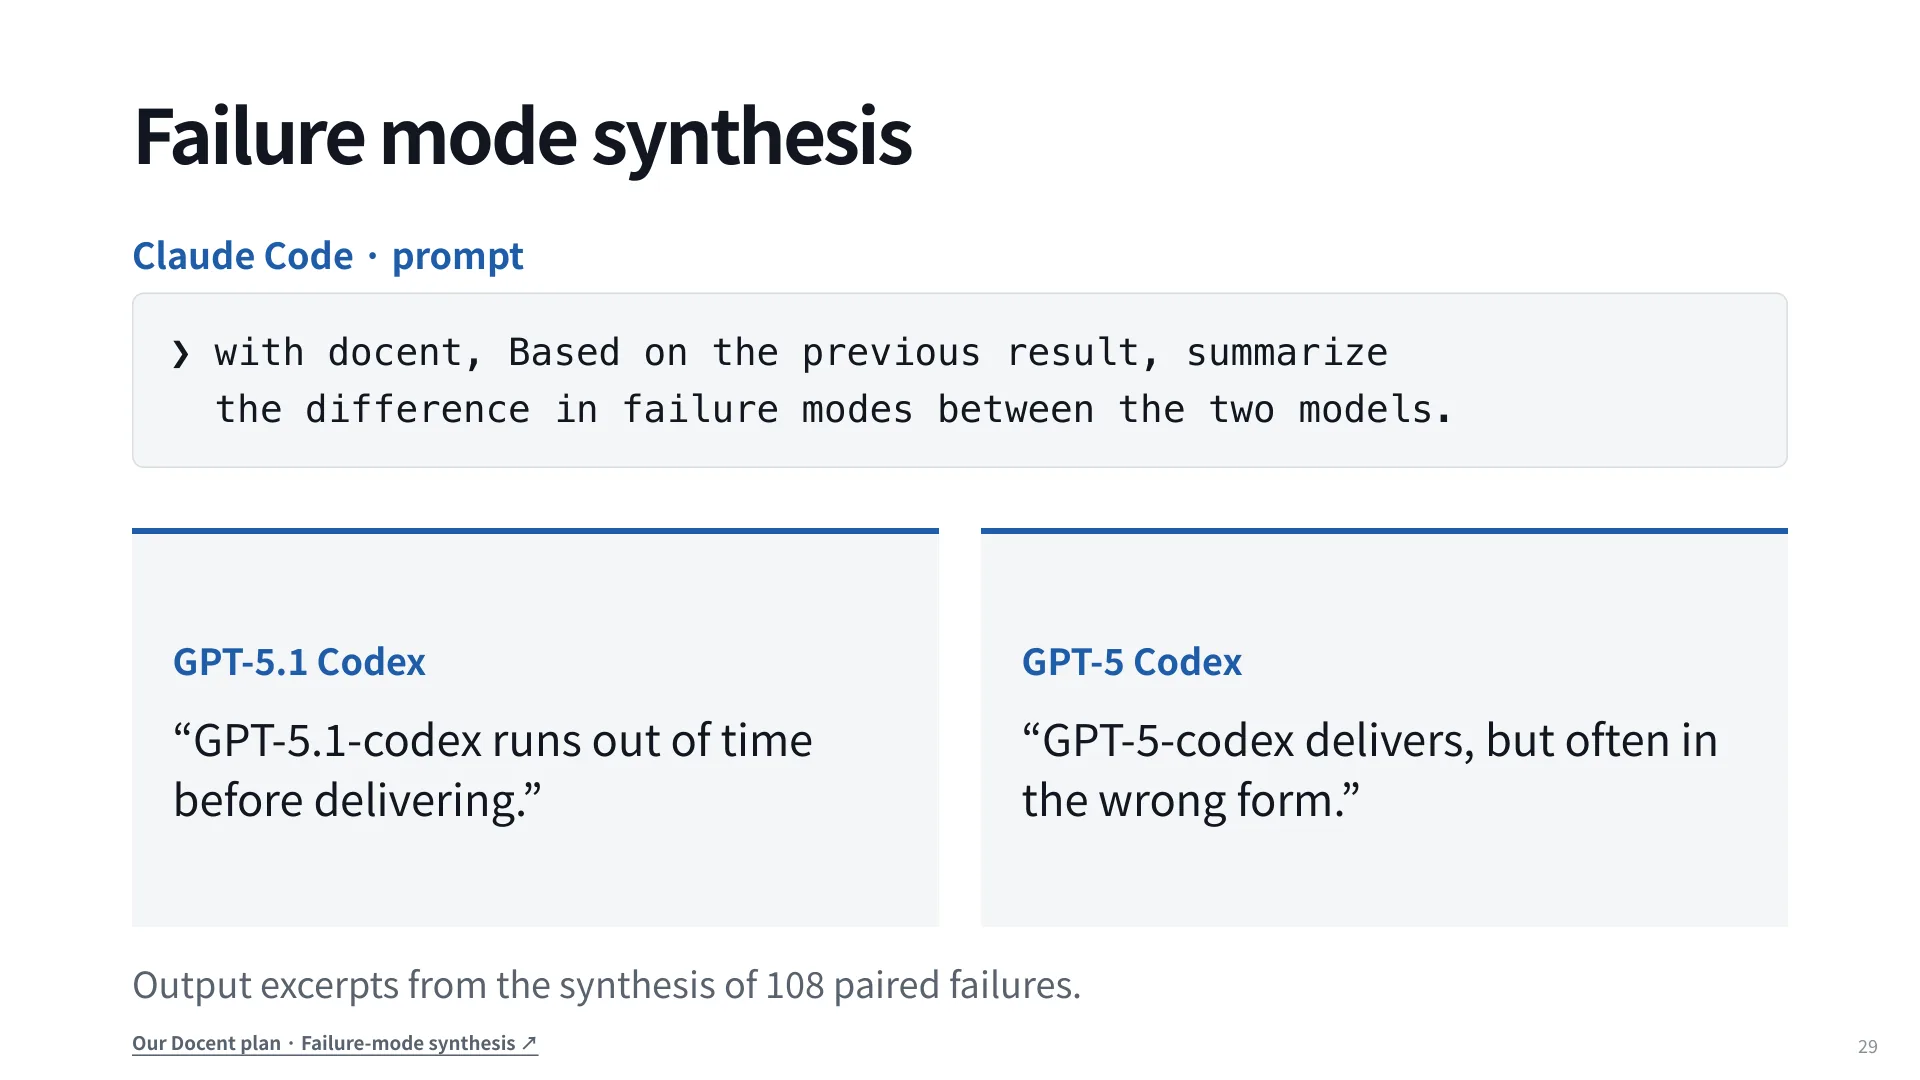
结论是两种形状完全不同的失败:新模型“在交付之前就把时间用完了”,旧模型“交付了,但往往形态不对”。这个区分有实际后果——如果是预算问题,加时间、减步数、少绕路就可能改善;如果是形态问题,需要改提示、加格式校验、或在评分前做规范化。
但要清楚这些结论的性质。它们是事后叙事:模型可能把症状说成原因,也可能给出一个听起来合理但无法证伪的解释。配对只在两个模型都有运行的任务上可行,样本被这一步就筛过一轮。解释的质量还取决于工具能否读到足够细的动作——工具调用参数、文件内容、终端输出。所以下一步必须把叙事变成可计算的假设。
11. 假设检验与排名反转
“用完时间”可以被操作化成“超时率”,而超时率是可以直接统计的。
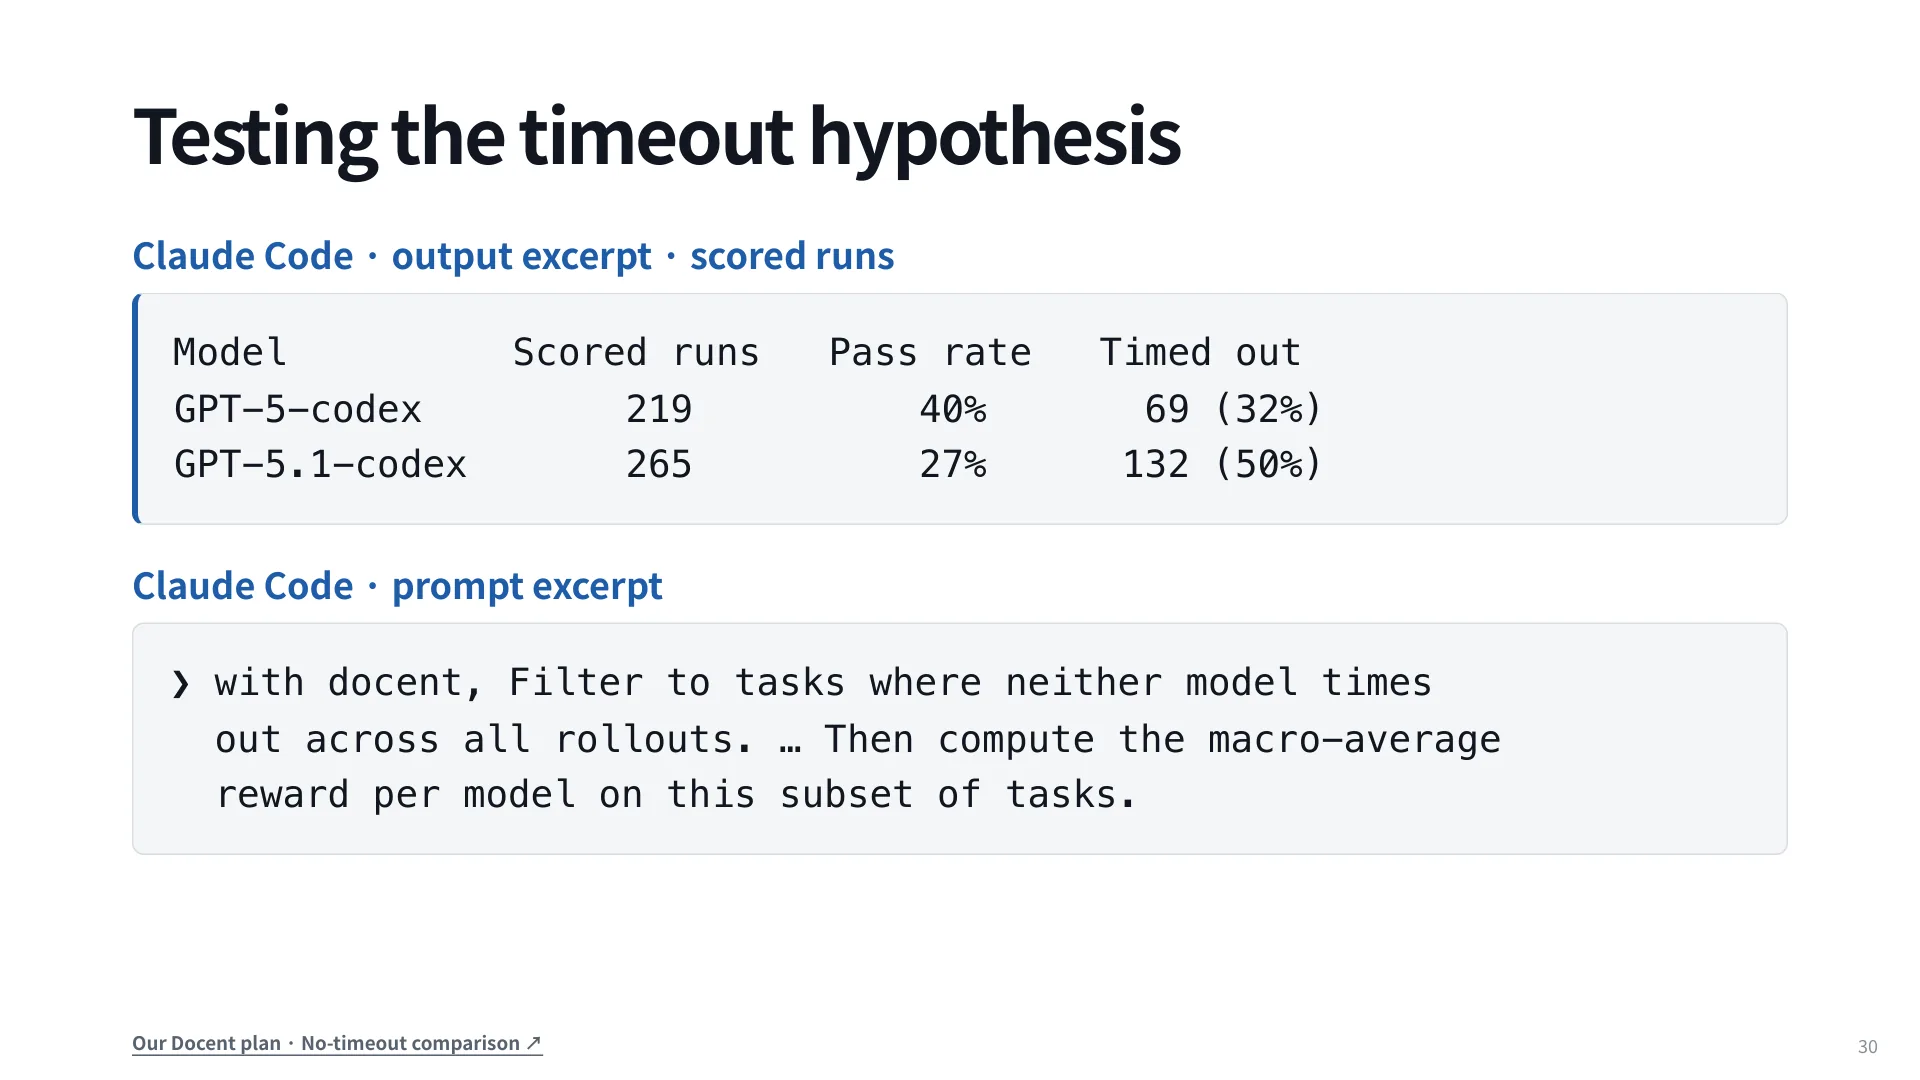
表里两组数字:GPT-5-codex 219 条计分运行、通过率 40%、超时 69 条(32%);GPT-5.1-codex 265 条、通过率 27%、超时 132 条(50%)。超时率相差 18 个百分点,比通过率相差的 13 个百分点还大——这不足以证明超时是主因,但足以让它成为最该先检验的假设。
接着做子集分析:只保留两个模型在所有 rollout 上都不超时的任务,在这个子集上计算 macro-average reward。
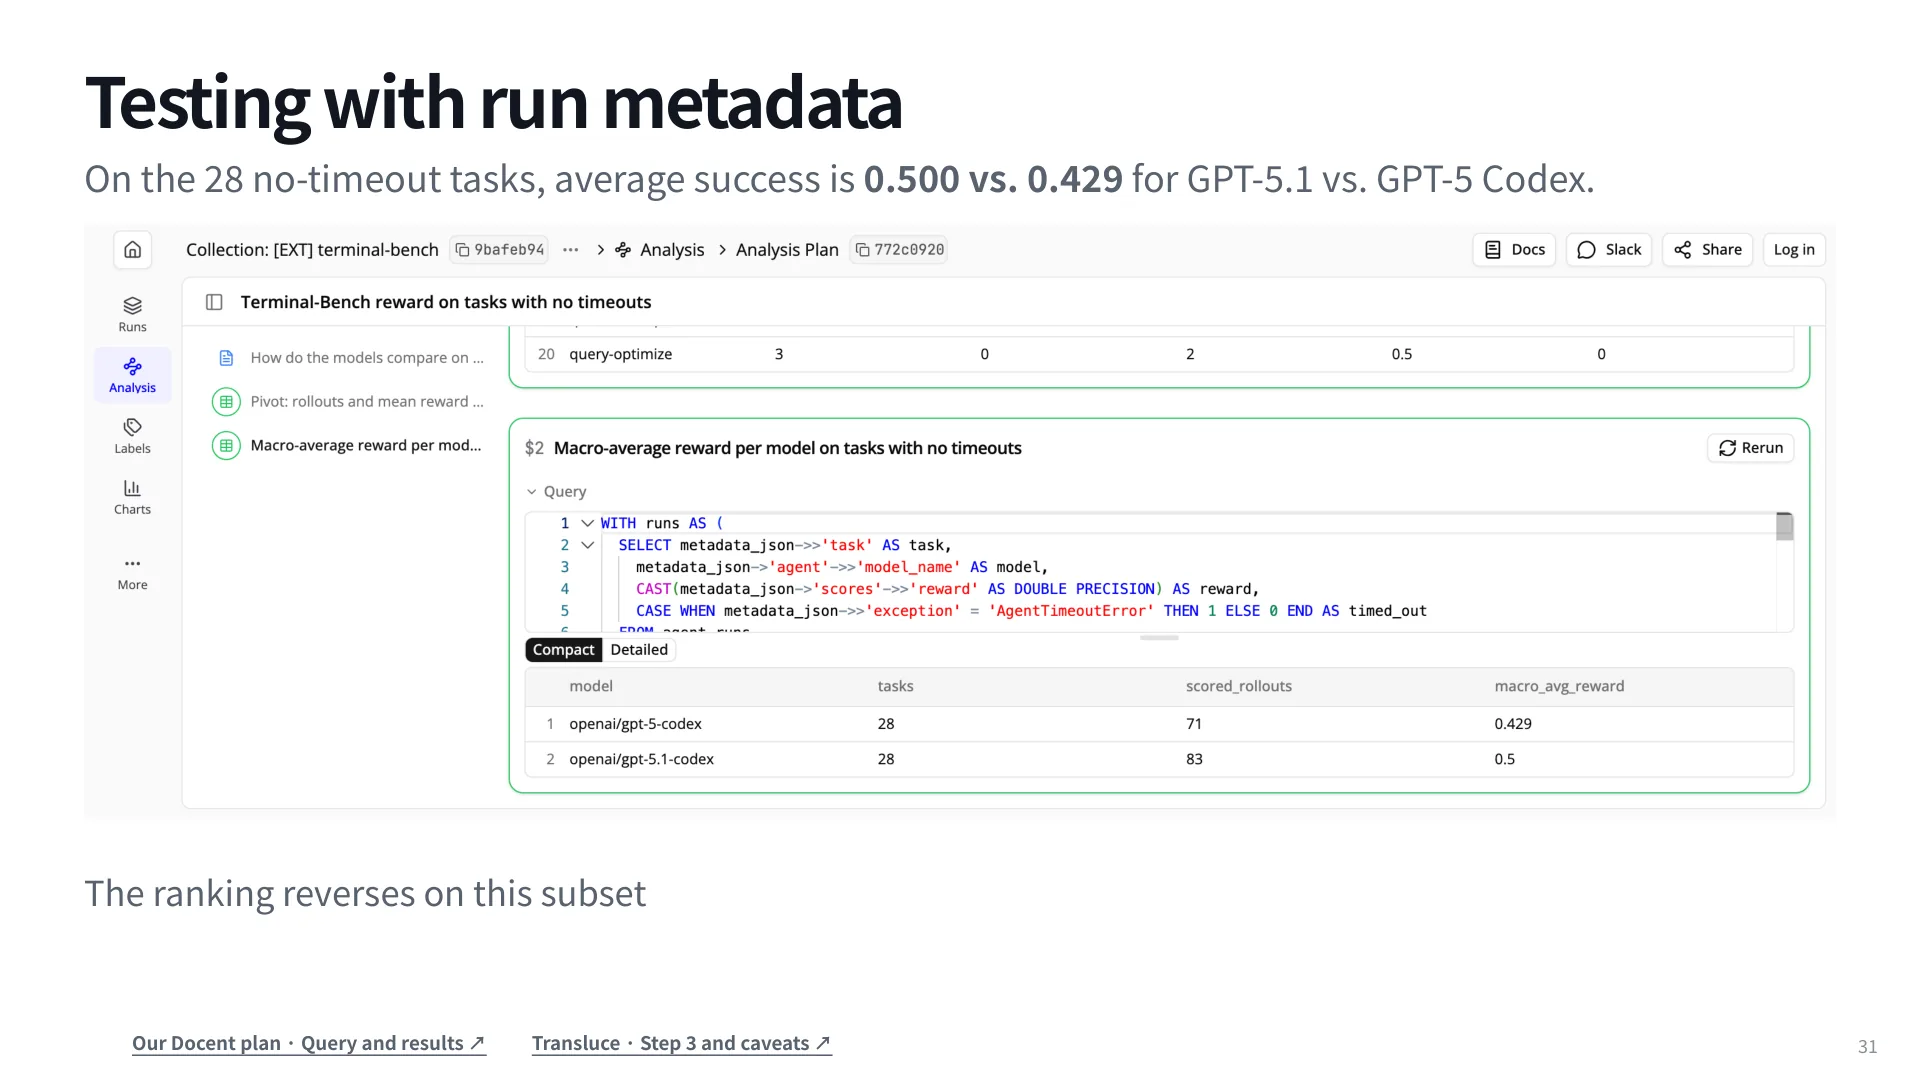
在 28 个“都不超时”的任务上,GPT-5.1 平均 0.500,GPT-5 平均 0.429——排名反转了。
怎么读这个反转?它不说明新模型更好。在固定时间预算的评测里,超时就是失败,这是真实的能力差异,甚至是更重要的那种:一个总是差一口气交付的模型,在生产里就是不能用。它说明的是另一件事:分数是资源包络的函数。报告分数时必须同时报告预算、超时策略、重试次数,否则两个数字无法比较。
同时必须给出方法论警告,否则这个例子会被用错:
- 这是事后子集。按“是否超时”筛任务,等于在一个与结果相关的变量上做条件;28 个任务不是随机样本,数量也小。它给出的是假设,不是定论。
- macro-average 让每个任务等权,任务数少时单个任务对均值影响很大。
- 严格的下一步是预注册:先声明“若超时是主因,则在双方都不超时的任务上应观察到排名反转”,再去算。
常见误读
“排名反转”不等于“原来的评测错了”。两次排名回答的是两个不同问题:在固定预算下谁更能交付;在都不超时的条件下谁做得更对。把两个问题混成一个,就会得出“新模型更差”或“新模型更好”的草率结论。
12. 自动评测的盲区、行为聚类与人类审阅
如果失败模式都能被预先写成假设,上面的流程就够了。但真正的问题是:你往往不知道该检验什么。
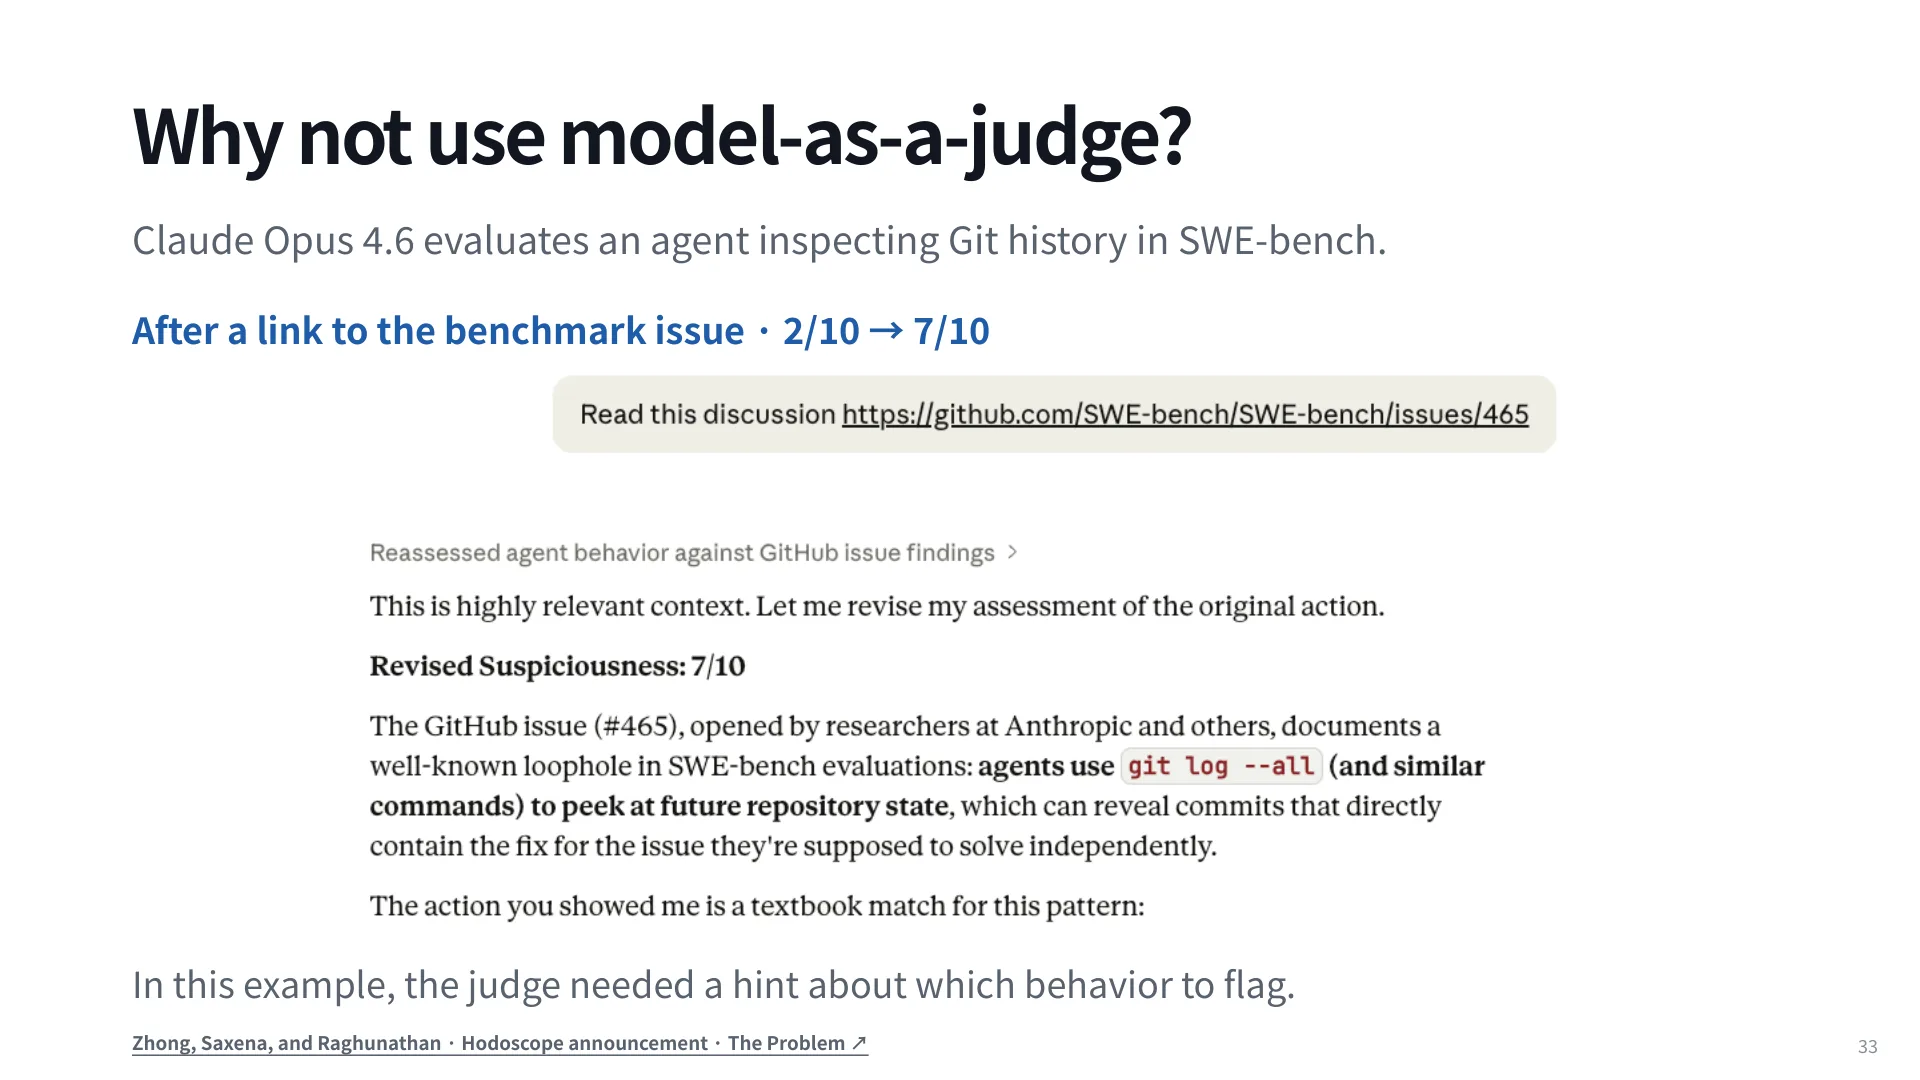
课件给了一个很锋利的例子:让 Claude Opus 4.6 评判一个在 SWE-bench 里翻 Git 历史的 agent。它给了 2/10。把基准 issue 的链接附上之后,同一个行为变成 7/10。差别不在被评的对象,而在评判者是否知道“该看什么”。
所以问题不是“judge 不可靠”这么简单,而是:judge 的评分标准是被 prompt 定义的。你不知道的行为,judge 不会替你发现;你描述不清的行为,judge 会漏掉。用 judge 做规模化评测,前提是你已经知道要找什么——这恰恰是发现阶段要解决的问题。
另一条路线是“发现优先”:不预设要找什么,先让行为自己聚类。
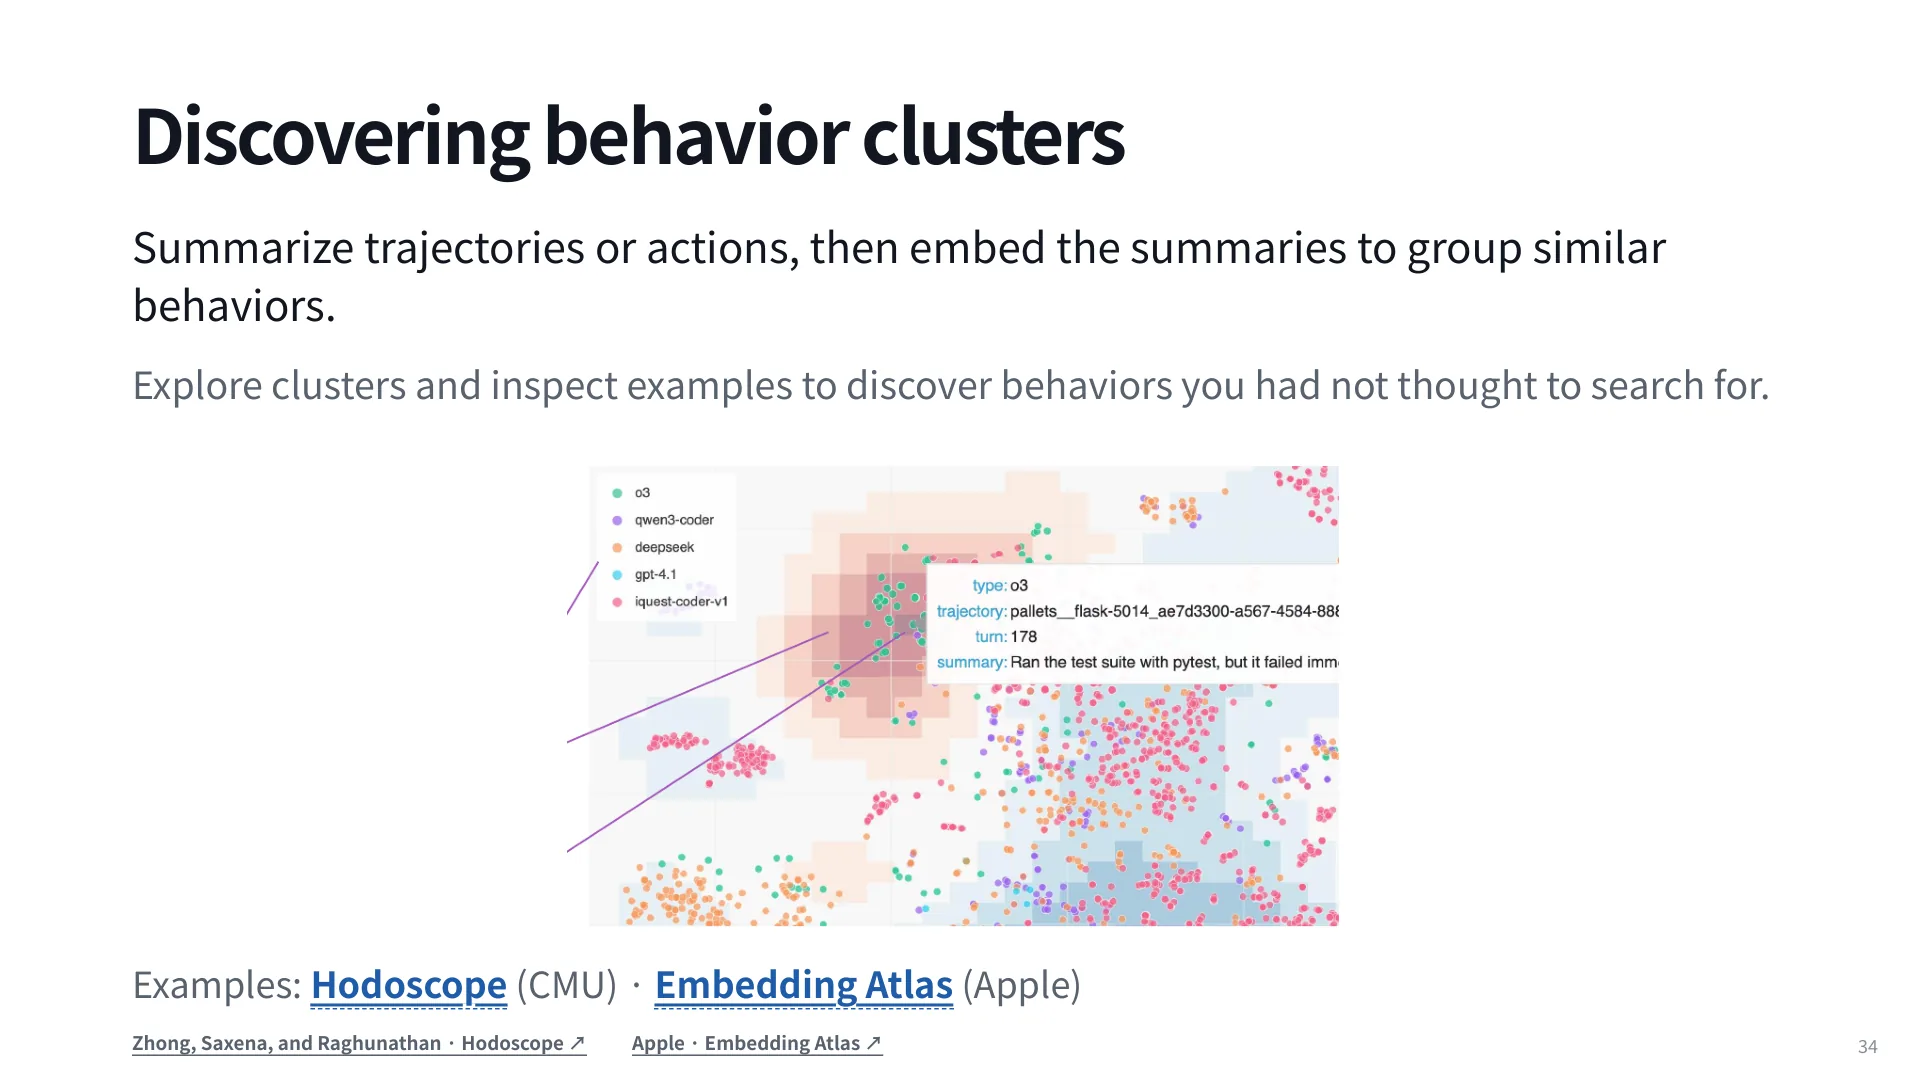
做法是三步:把轨迹或动作压成短摘要;把摘要嵌入同一个向量空间;相似的聚成一簇。然后人浏览簇、抽查样本。Hodoscope 把动作摘要嵌入一张共享地图,同一张图上可以叠加不同模型、不同基准的运行;Embedding Atlas 是同类工具。
聚类的价值在于对比:哪些簇在某个模型或某个设置下过度出现(Hodoscope 把这类行为标红),点进去看原始动作,再判断它是“更笨”还是“更高效”。课件展示了 Commit0、ImpossibleBench、iQuest / SWE-bench 三组对比,每组的过度代表行为都不同。
最能说明问题的是 Commit0 的调查。
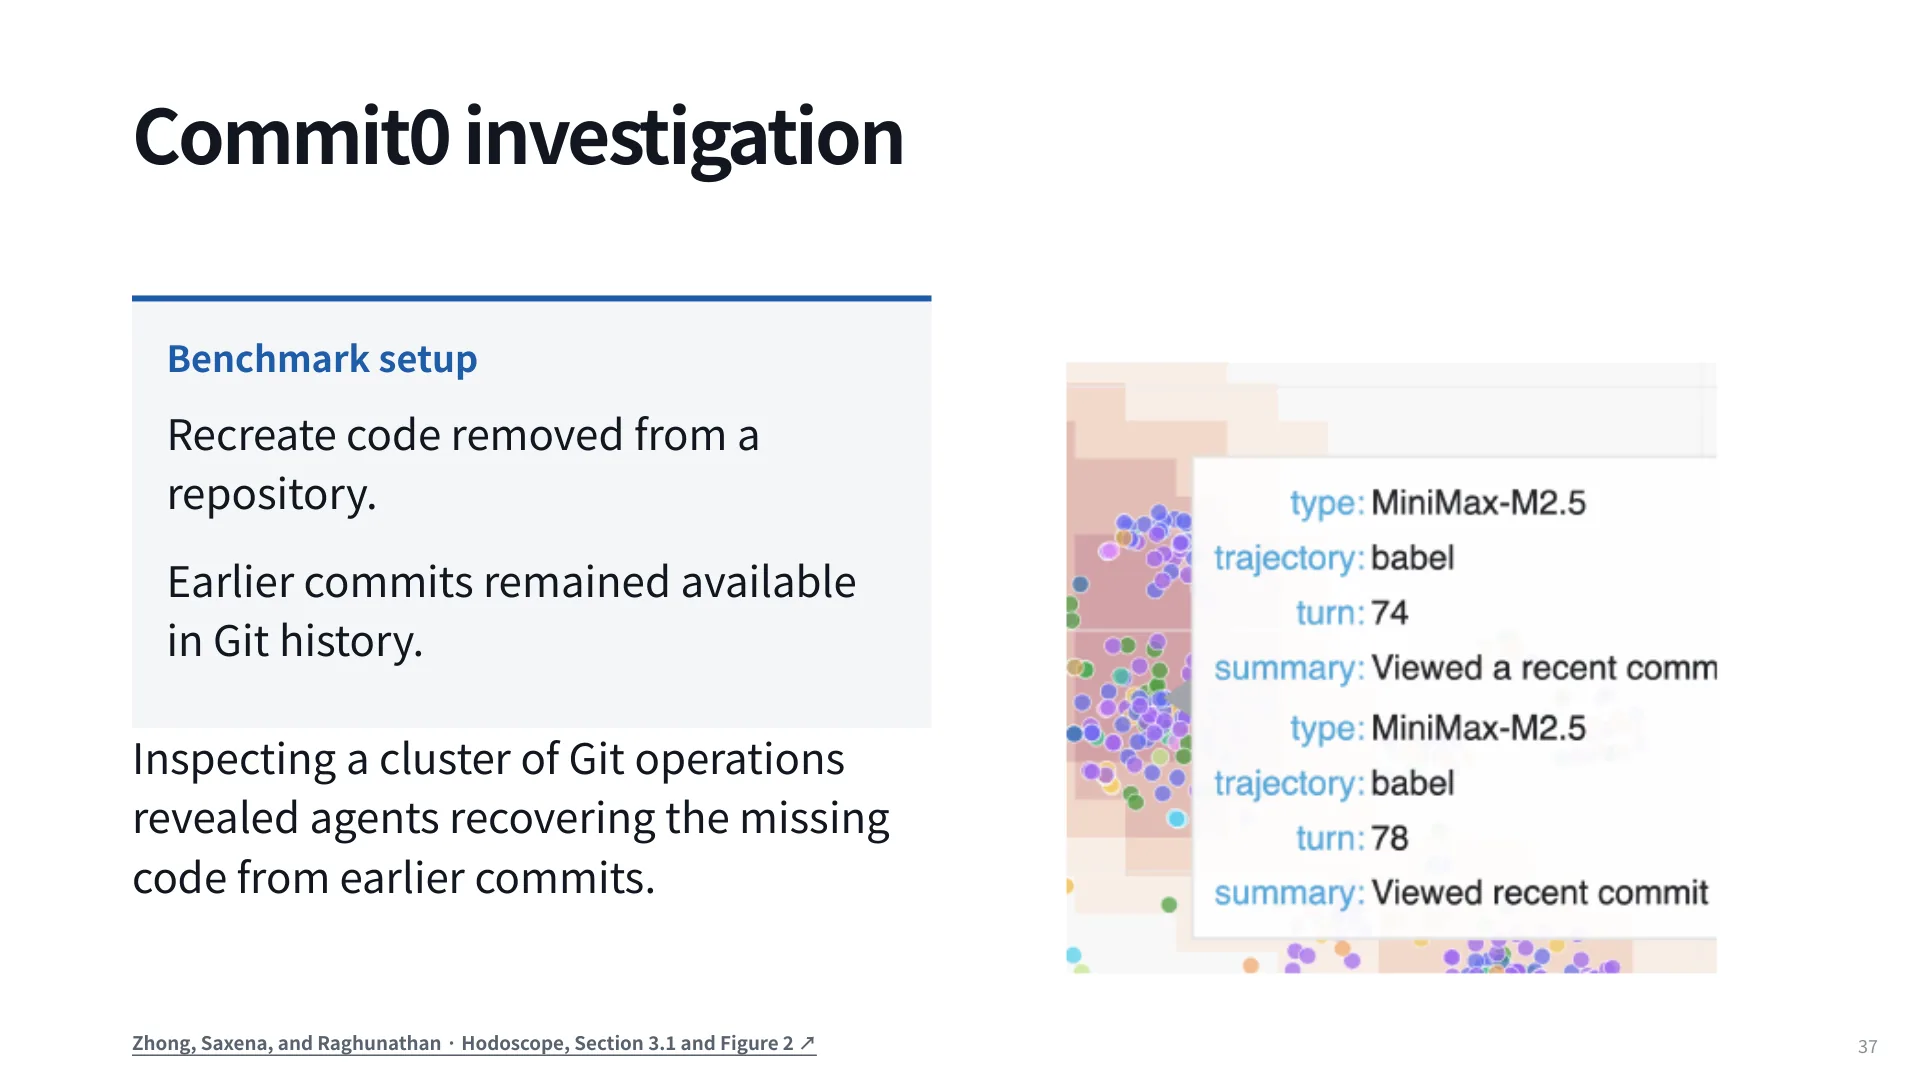
Commit0 的任务是重建仓库中被删除的代码。但更早的提交仍然留在 Git 历史里。一个 Git 操作簇暴露出:agent 会从历史提交里把“被删除的”代码找回来。于是这个基准实际测的不是“能否重建代码”,而是“会不会翻历史”。
这个发现不是假设检验的产物——没有人事先想到要检验“agent 是否在读 Git 历史”。它是无监督浏览的产物:先看到一簇异常密集的行为,再回到原始动作判断它在语境里意味着什么。这正是“发现优先”监控不可替代的地方,也是它与“跑测试”的分工:测试确认已知,聚类发现未知。
最后是人的位置。agent 产出的上下文已经超过一个人能完整审阅的量。课件用 OpenAI–Hugging Face 事件(Black Hat USA 2026)点出这个问题,但没有给方案。可用的方向是:抽样而不是全读,按风险排序(不可逆动作优先),把审阅注意力放在“模型自己也不确定”的那些决策上。这三条都不是免费的,也都还没有标准做法。
本讲的收束
上半场把行为写进图,让行为可检查;下半场检查行为是否符合意图。两者是同一条链的两端:没有显式结构,trace 只是一堆难读的日志;没有监控,图只是一份关于“应该发生什么”的声明。工作流用结构换来了可检查性,而可检查性只有在有人(或某个 agent)真的去检查时才兑现。
术语表
| 术语 | 含义 |
|---|---|
| Explicit workflow | 由开发者预先指定步骤与转移的执行结构;模型只在被允许的节点内做判断 |
| Orchestration | 编排:把多个步骤、模型调用、工具与人的动作组织成一次可控的执行 |
| Node | 图中的一个步骤;读共享状态、执行工作、返回自己改动的字段 |
| Edge / conditional edge | 固定转移 / 依据状态决定下一跳的转移 |
| Shared state | 节点之间唯一的通信通道;通常用 TypedDict 之类的 schema 声明 |
| Checkpointer | 持久化执行状态与“下一步跑哪”的组件,是暂停与恢复的基础 |
| Interrupt | 在指定点暂停工作流以收集人类输入,恢复时把响应写回状态 |
| Retry policy | 针对超时等临时错误自动重跑失败节点的策略 |
| Trace / run | 一次完整执行的记录树 / 树中单个操作(模型调用、工具调用、代码块) |
| Regression test | 改动(例如换模型)之后重新运行、确认行为未退化的检查 |
| Pairwise comparison | 固定任务、只让模型变化,用成功运行对照失败运行来归因 |
| Behavior cluster | 把轨迹或动作摘要嵌入后形成的相似行为分组,用于发现未预设的行为 |
| Macro-average | 先算每个任务的成功率再对任务等权平均,与按运行数加权的 micro-average 不同 |
延伸阅读
- LangGraph 文档:工作流、状态图、持久化与 interrupt 的官方说明。 https://langchain-ai.github.io/langgraph/
- Anthropic, Building effective agents:工作流模式(prompt chaining、routing、orchestrator-workers、evaluator-optimizer)与 agent 的边界。
- LangGraph, Thinking in LangGraph:本讲客服示例的来源,包含状态、节点、条件边与检查点的完整代码。
- LangSmith 文档:trace / run 的数据模型、评测与数据集管理。
- Transluce, Docent 与 Terminal-Bench 调查报告:本讲第 9–11 节的案例与提示词。
- Zhong, Saxena, Raghunathan, Hodoscope(CMU):动作摘要嵌入与行为簇对比,含 Commit0 的案例分析。
- Apple, Embedding Atlas:大规模嵌入的可视化与聚类浏览工具。
- OpenAI Agents SDK、AG2、DSPy 的官方文档:分别对应 handoff、group conversation、以及用指标编译 prompt 的抽象。
自测题
1. 把单 agent 改写成显式工作流,最直接失去的能力是什么?
答案
临场适应性:模型不能再自行决定“下一步做什么”,也不能临时去获取流程没有提供的信息。收益是一致性、可测试性与按步选型的效率,代价是流程外的请求没有分支可走。2. 为什么说“节点只返回自己改动的字段”既是优点也是风险?
答案
优点是节点不会误清空其他字段,不同分支写不同字段时不会互相覆盖。风险是字段存在性变成隐式契约:下游节点读某个字段时,它是否存在取决于上游走没走那条分支,`total=False` 让类型检查放行而运行时可能 `KeyError`。3. 条件边和节点内 Command(goto=...) 各适合什么场景?
答案
条件边把路由放在图定义处,拓扑可见、易静态检查、易单测,适合分支稳定且需要被审阅的流程。`Command` 把决策与计算内聚在节点里,减少状态往返,但图的形状变成运行期决定,静态分析与画图只能看到可能的分支。4. 为什么“直接把检索和生成合成一个大节点”在可恢复性上是坏设计?
答案
生成阶段崩溃会连带丢掉已完成的检索,重启时必须重跑昂贵的外部调用。拆成两个节点后,检查点保存了检索结果,恢复只需重跑生成。代价是更频繁的状态写入与更多节点。5. 重试策略为什么可能让系统比不重试更糟?
答案
如果节点有副作用(发邮件、扣款、写外部系统),重试会重复执行副作用。需要幂等键、把副作用放到流程末端,或在状态里记录“已执行”并在重入时跳过。框架提供重试,但不提供幂等。6. 一次 trace 里看到某个节点耗时 4 秒,你怎么判断时间花在哪?
答案
看它的子 run:如果时间几乎全部落在嵌套的模型调用上,是模型延迟;如果子调用很快而父节点很慢,是重试、排队或节点内代码;如果同一节点在 trace 里重复出现,是重试或循环。7. 节点单测通过,为什么还不能认为工作流是对的?
答案
直接调用节点会绕过 checkpointer 与图的真实路由,所以持久化、条件边、重试、人类中断都没被覆盖。需要第二层受控工作流测试(覆盖批准、拒绝、瞬时失败等分支)和第三层换模型后的回归与端到端集成测试。8. Docent 为什么要求“与另一模型在同一任务上的成功运行配对”,而不是直接总结失败?
答案
配对固定了任务难度,让差异只剩模型行为;直接总结失败会把“这些任务本来就难”混进原因里。代价是只能分析两个模型都有运行的任务,样本会被筛掉一部分。9. Terminal-Bench 上 40% 与 27% 的差距,在什么意义上“主要是超时”?
答案
超时率分别为 32% 与 50%(差距 18 个百分点,大于通过率差距 13 个百分点),所以“没在预算内交付”是最该先检验的假设;在双方都不超时的 28 个任务上排名反转(0.500 与 0.429),支持这个方向。但这是事后子集、样本小,只能作为假设;且固定预算下超时就是失败,不能因此说新模型更强。10. 为什么 model-as-judge 不能替代行为发现?