
6a · Training 3: Advanced RL Algorithms
本讲速览
- 本讲按“训练 agent 时真实会翻车的地方”组织:信用分配、等待、陈旧数据、奖励不可靠、信号不足、教师蒸馏。每个问题配一个当前主流解法,而不是按算法族谱排序。
- 最终奖励只有 0/1 时,REINFORCE 对失败样本零更新;组基线(GRPO)让失败也有负权重,但整条轨迹共享同一个权重,成功轨迹里的错误动作照样被加强。
- Turn-level 信用需要 value function:critic 学 期望 reward-to-go,用平方误差训练;TD 误差把“这一步让局面变好还是变坏”写成 ,GAE 再把后续误差按 折价加回来。
- 异步 RL 是 agentic RL 的默认选择,代价是 rollout 与 learner 不是同一个策略;重要性采样能修正期望,但整条轨迹的比率是乘积,,会直接把训练打崩。
- 稳定更新靠三件事:决定重要性比率取哪一段(当前动作 / 累积 / 长度归一化)、裁剪、参考模型 KL 与熵正则。
- 奖励比算法更容易出错:无效组(全 0 或全 1)、验证器假阴性/假阳性、奖励黑客,都会让模型学到“拿分”而不是“解决问题”。
- 数据不够时用部分奖励、DAPO 动态采样、课程与 on-policy distillation 补信号;蒸馏的关键是把 student 自己走到的 history 交给 teacher 打分,而不是只在 teacher 的成功轨迹上模仿。
1. 一个能跑通的运行例子:修一个 retry bug
Graham 开场就把这讲的定位说清楚了:备课时他把过去一两年训练 agent 时遇到过的故障列成一张清单,每个故障配一个解法,而且刻意不讲自己没踩过的坑。所以下面每一节都对应一个工程上反复出现的失败模式,而不是“又一个 RL 变体”。00:00
贯穿全讲的例子小到可以手算:一个读配置的函数,语义是“retries 为 0 表示禁用重试”,但 config.get("retries") or 3 把 0 当成了 falsy 值,于是 0 被悄悄换成 3。四个测试用例分别是:retries 键缺失 → 3、None → 3、0 → 0、2 → 2;验证器跑测试,四个全过给 1 分,否则 0 分。
def retry_count(config):
    return config.get("retries") or 3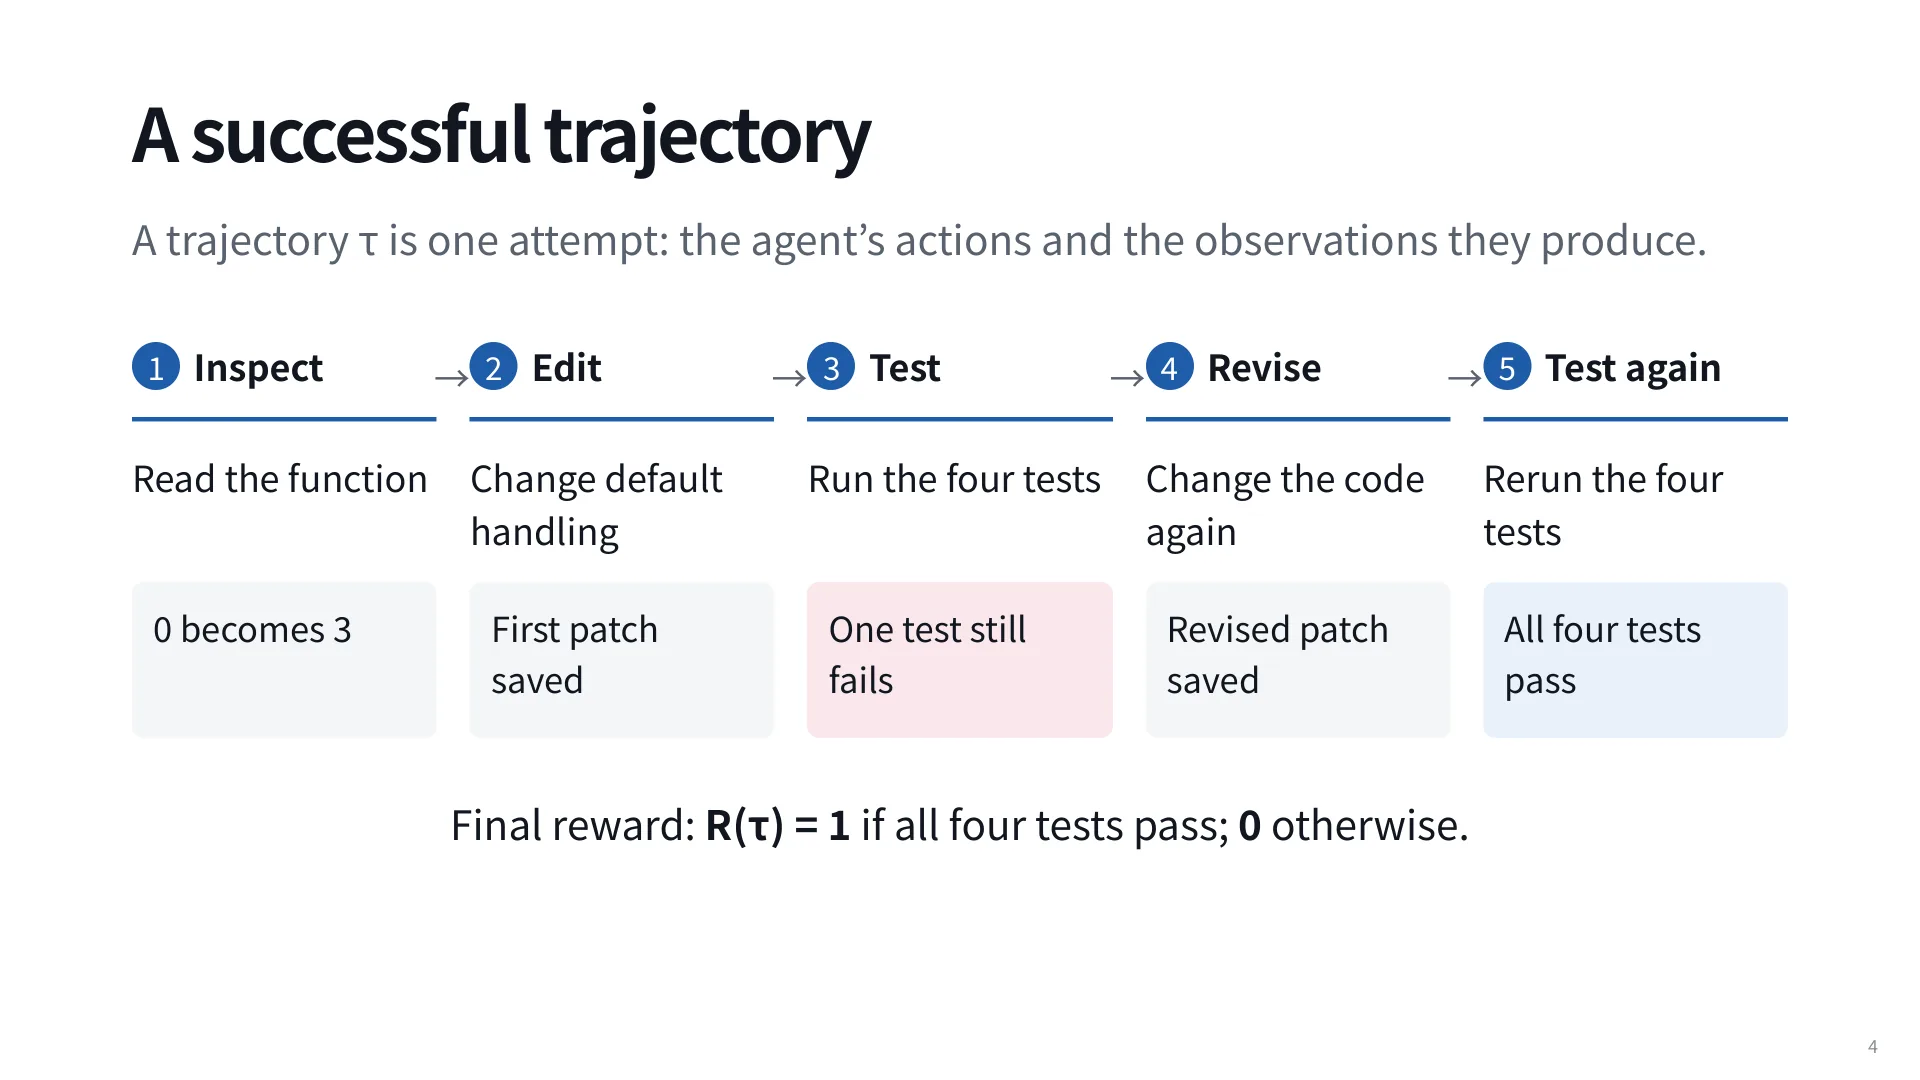
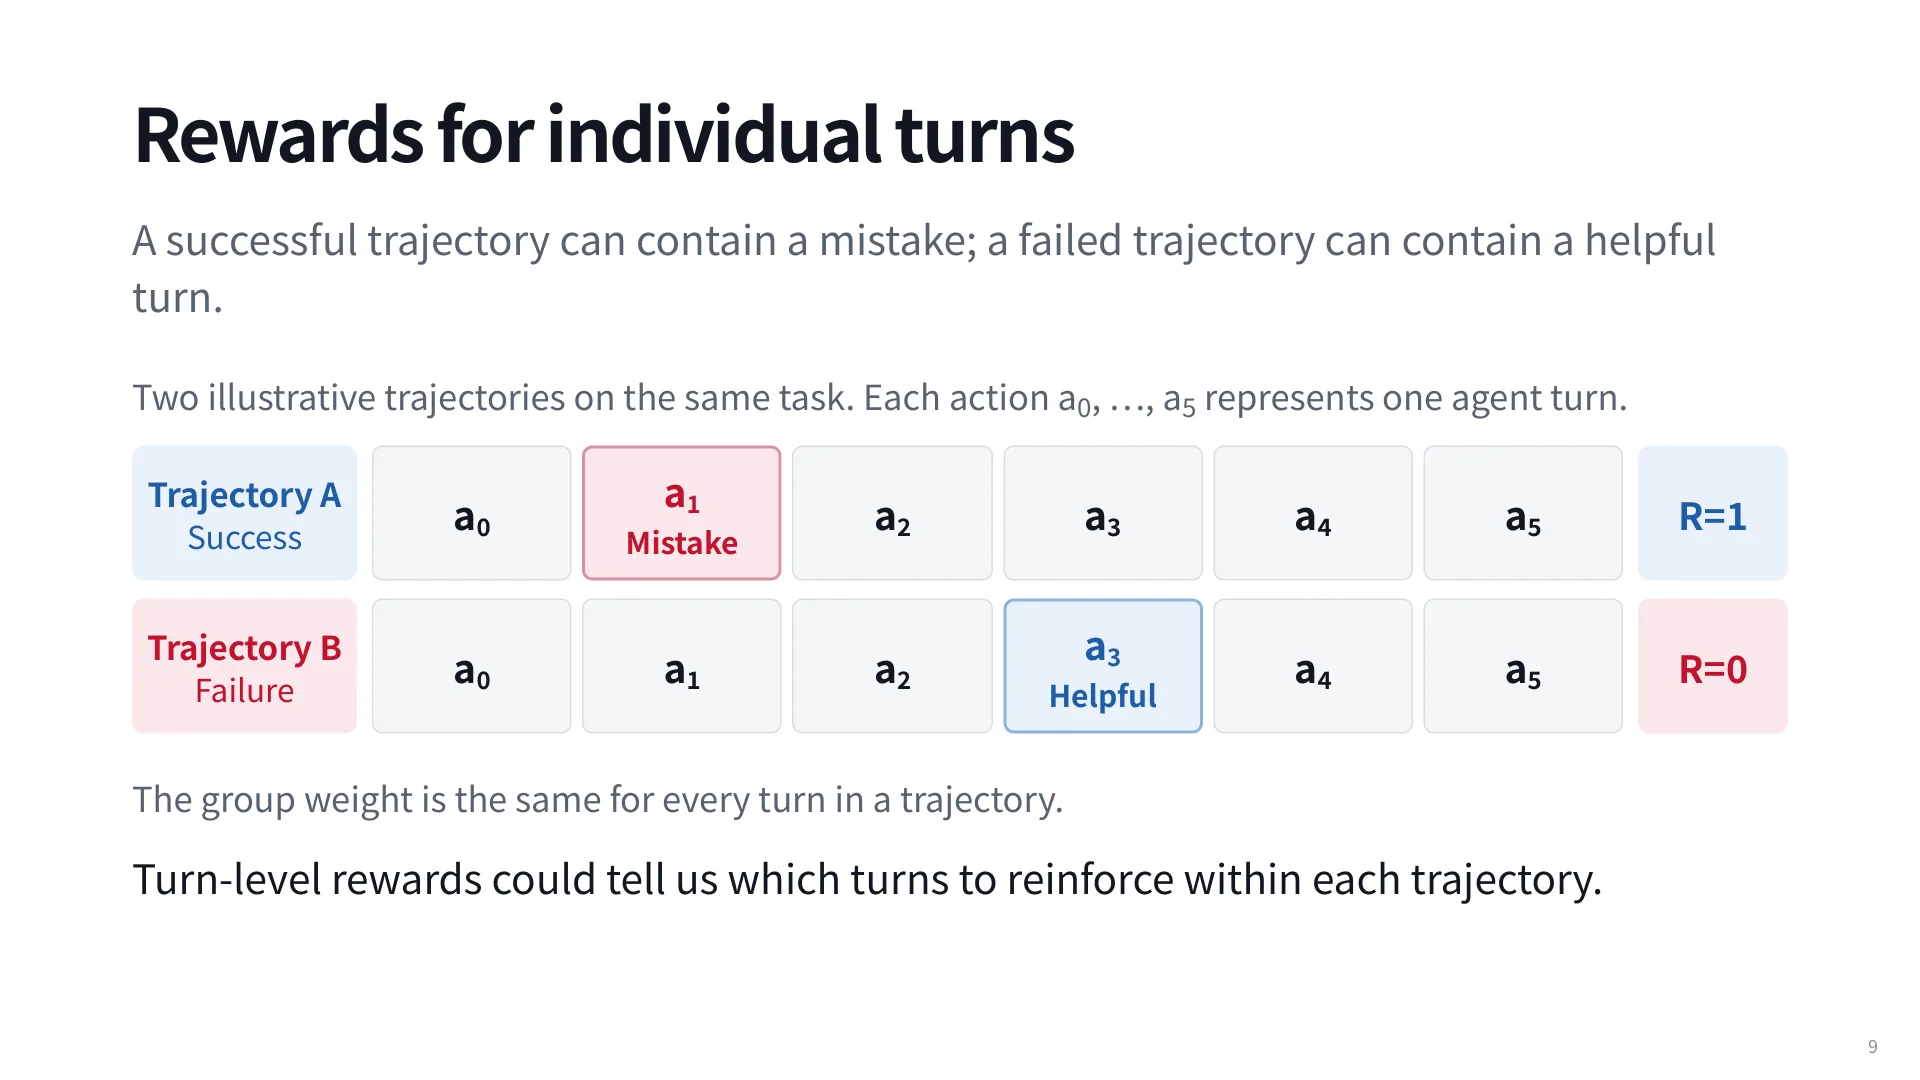
一条成功轨迹是五步:读函数、改默认值处理、跑测试(还有一个用例失败)、再改一次、复测全过。这里最值得盯住的不是最后的 1 分,而是中间那次失败:一条最终成功的轨迹里包含一个本可以避免的错误动作,一条最终失败的轨迹里也常常包含若干正确判断。后面关于 credit assignment 的所有讨论,都是从“最终奖励无法区分这两类动作”这个观察长出来的。02:27
把例子换成数学题、网页导航、deep research 都一样:结构是 prompt + 初始状态 + 可执行验证器。区别只在验证器有多可靠、轨迹有多长。
2. 目标函数与 REINFORCE:方差是第一只拦路虎
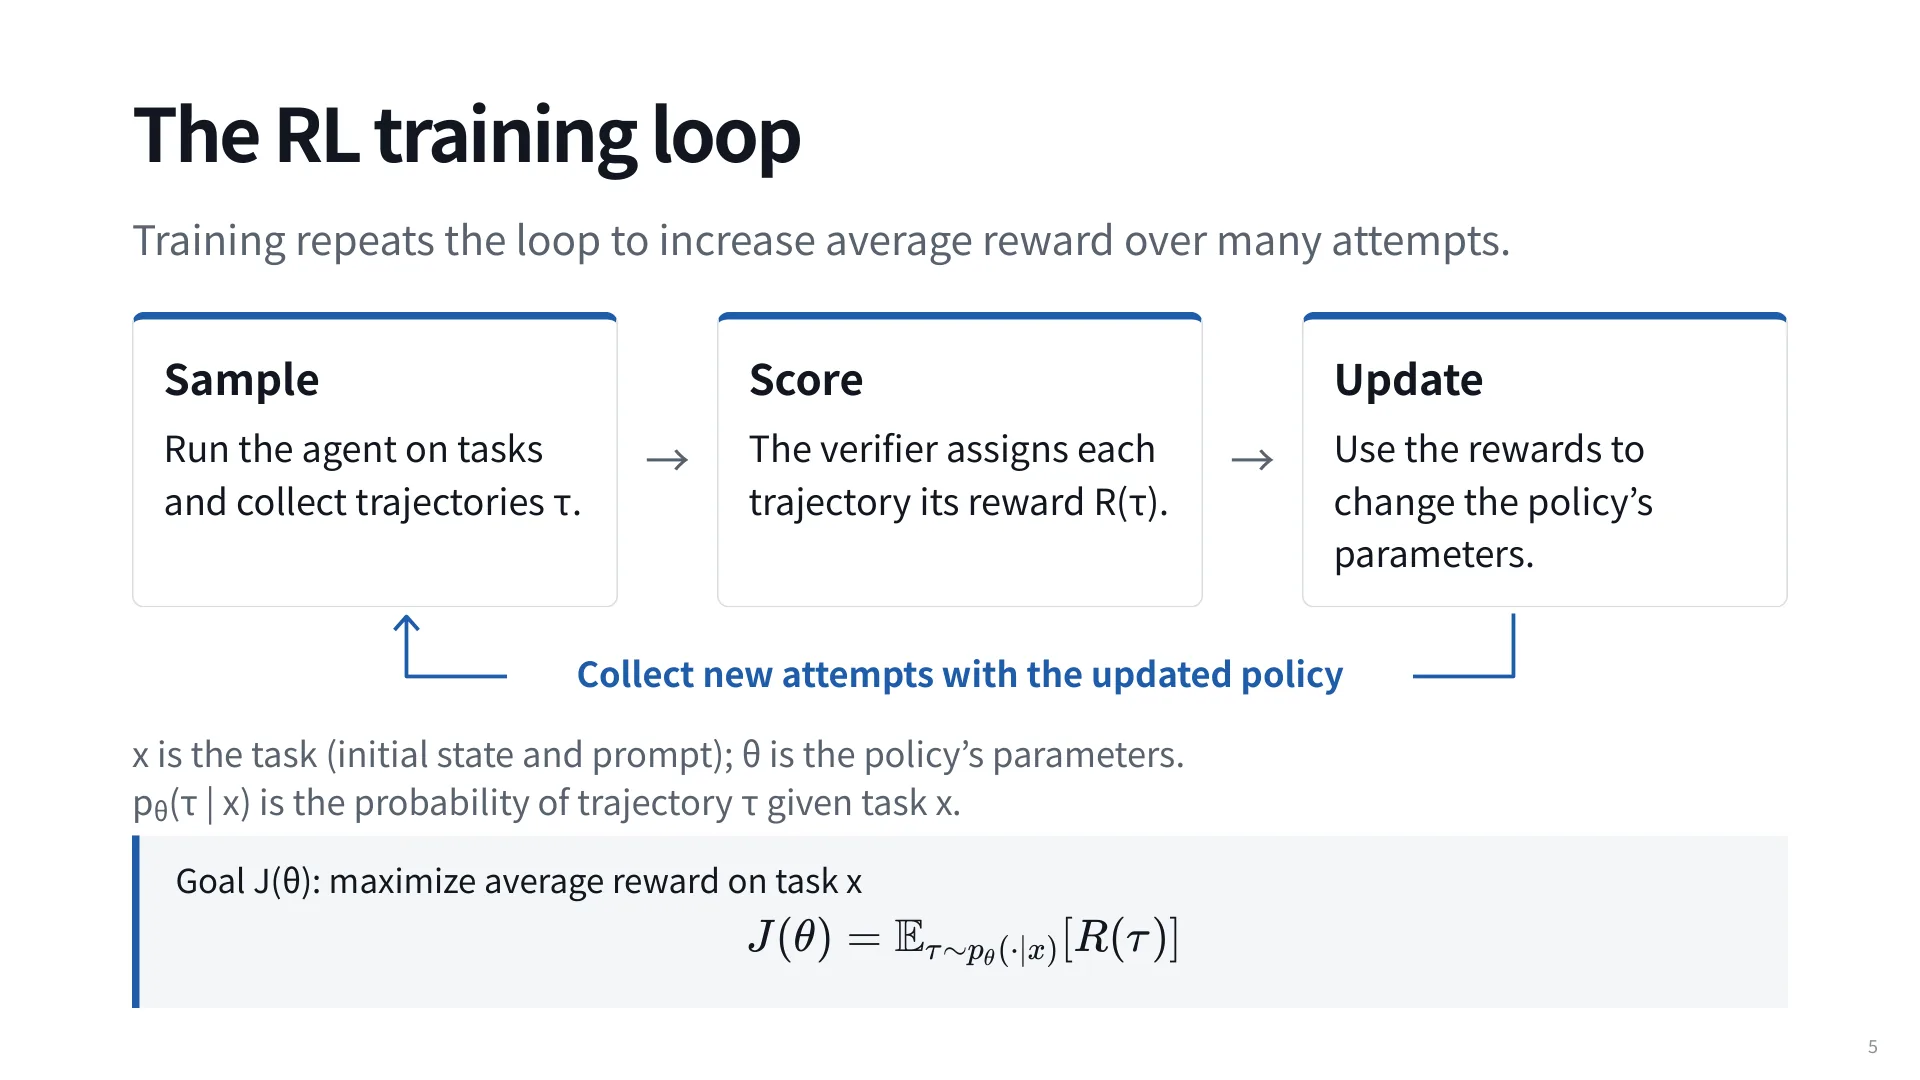
训练循环永远是三步:sample(在任务上跑 agent,收集轨迹 )→ score(验证器给每条轨迹打分 )→ update(用奖励改参数)。形式化地, 是任务, 是策略参数, 是轨迹概率,目标是最大化任务上的平均奖励:
REINFORCE 用似然比把梯度写成“奖励 × log 概率”的形式,实际实现里就是最小化
成功样本 ,整条轨迹的每个动作都被同一份权重往上推;失败样本 ,梯度恒为零,这条轨迹对参数没有任何贡献。04:06
用似然比而不是直接对 求导,原因很实际:奖励来自环境(跑测试),对 完全不可导。REINFORCE 绕开这一点,用 把“不可导的奖励”变成“可导的 log 概率前面的一个系数”。代价也随之而来——这个系数是采样得到的随机变量,它的方差会原封不动地进入梯度估计。
这带来三个独立的问题。第一是方差:0/1 的蒙特卡洛估计噪声极大,同一个任务跑四次可能全是 0,梯度就是 0,一次更新白做。第二是粒度:权重只跟最终结果有关,跟动作本身无关,模型无法知道“哪一步做对了”。更糟的是,成功轨迹里那个错误动作也会被 +1 强化——它被强化不是因为正确,而是因为它恰好在一条成功轨迹里。第三是长度偏置:因为损失是对 求和、且整条轨迹共享同一个 ,一条很长的成功轨迹贡献的梯度总量远大于一条很短的,模型会不自觉地偏好“啰嗦但能过”的解法。实践中常按 token 数或轨迹长度做归一化,就是在压这个偏置。
3. 更细的信用分配:组基线、turn-level 与 reward-to-go
GRPO 的思路是把“绝对分数”换成“同题内的相对分数”。同一个 bug 任务采样四次,得到 1、0、0、0,组均值 0.25,每个样本的权重变成 :成功样本 +0.75,三个失败样本各 −0.25。失败样本于是有了负权重,一次更新用上了全部四条轨迹。
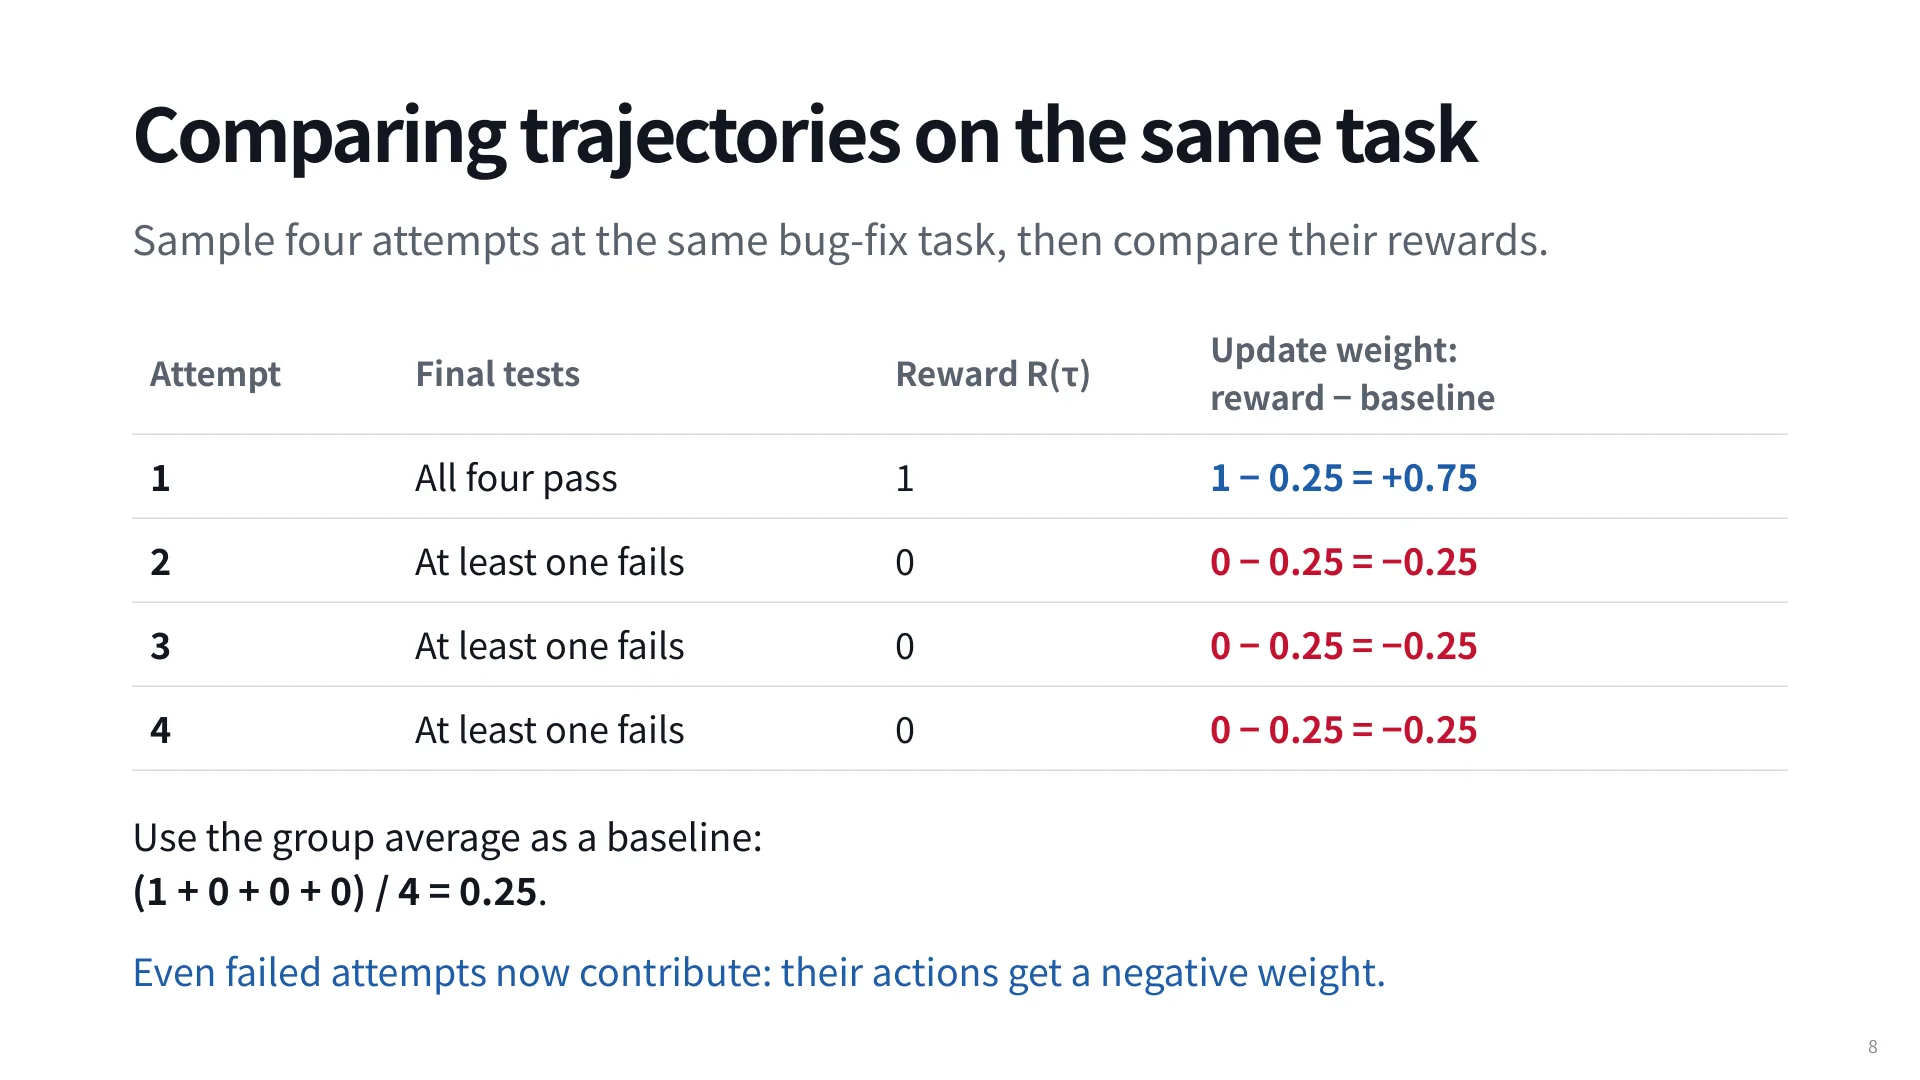
这个 baseline 不改变梯度的期望(因为 ),只降低方差。直觉上它问的是“这次尝试比同题的其他尝试好多少”,而不是“这次尝试绝对有多好”——后者在难题上永远是 0,前者在任何有对有错的组里都有信号。
标准实现还会再除以组内奖励的标准差,让不同任务的 advantage 落在同一量级,步长不随任务难度漂移。这一步要小心:当组内差异本来就很小时,除以一个很小的标准差会把噪声放大成满幅信号。所以“全对/全错”的组必须丢掉或重采,否则分母接近 0,梯度会被数值噪声主导。
但组权重对整条轨迹是一个常数。下面这张图把问题摆得很清楚:轨迹 A 成功,但第 2 步是明显的错误;轨迹 B 失败,但前面几步都做对了、最后才崩。把 +0.75 和 −0.25 这样的组权重摊到每个 turn 上,等于告诉模型“A 里的错误动作是对的,B 里的正确动作是错的”。05:41
最朴素的修法是 reward-to-go:,即“从 往后还剩多少奖励”。但在 、只有最终奖励的设定下,成功轨迹每一步的 都是 1,失败轨迹每一步都是 0——它并没有比最终奖励更细,只是把同一个数复制了 遍。要真正区分“哪一步导致了失败”,必须回答一个反事实问题:从同一个 history 出发再走十次,平均能拿多少分?这就是价值函数。
4. Critic:用模型预测“从这里开始还能拿多少分”
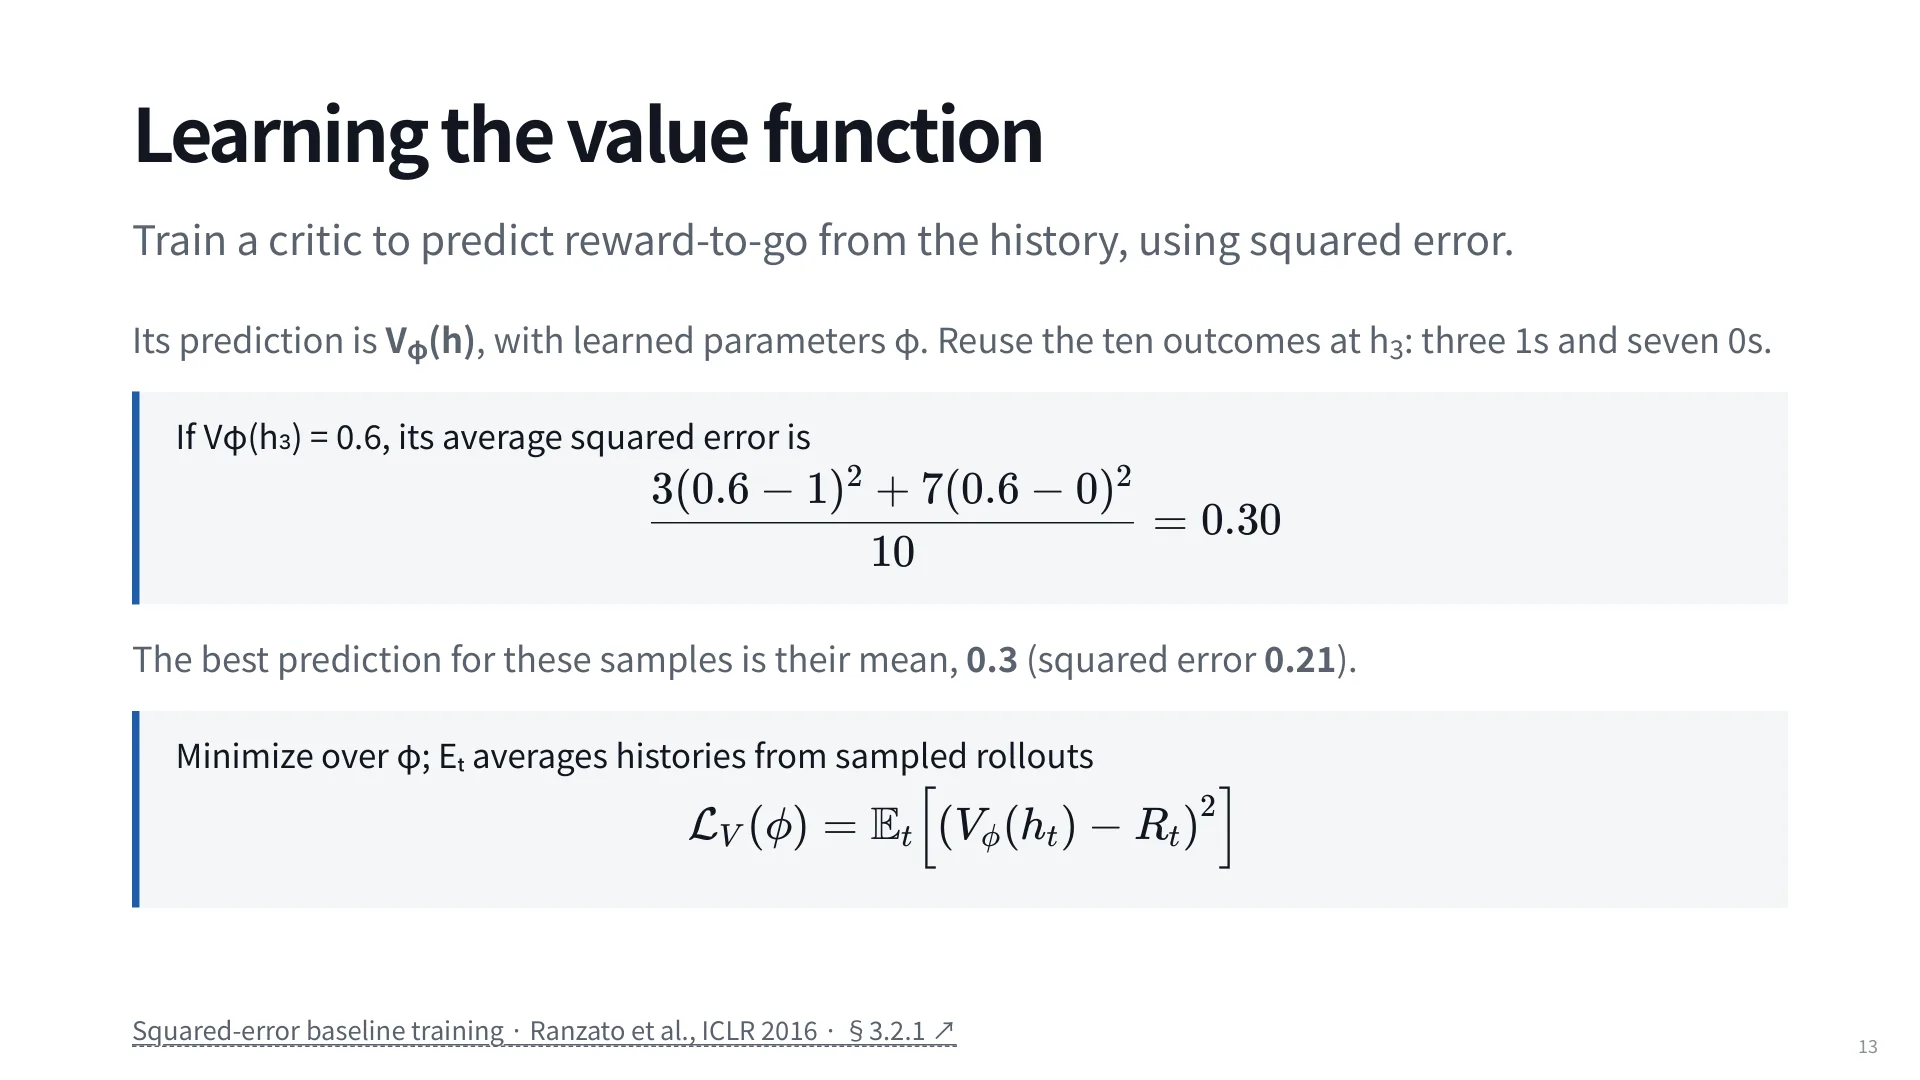
定义 ,即在 rollout 策略 下、从 history 继续走下去的期望 reward-to-go。经验做法是从 继续采样十次,三次成功,于是 。每一步都这么 rollout 的代价是不可接受的,于是改为学一个带参数 的 critic 。10:44
训练目标是平方误差 。十个样本里三个 1、七个 0 时,若预测 0.6,平均误差是 ;最优预测是样本均值 0.3,此时误差 0.21。critic 学的是条件均值,不是“对/错”分类——这一点决定了它在奖励有噪声时会把噪声也平均进去。
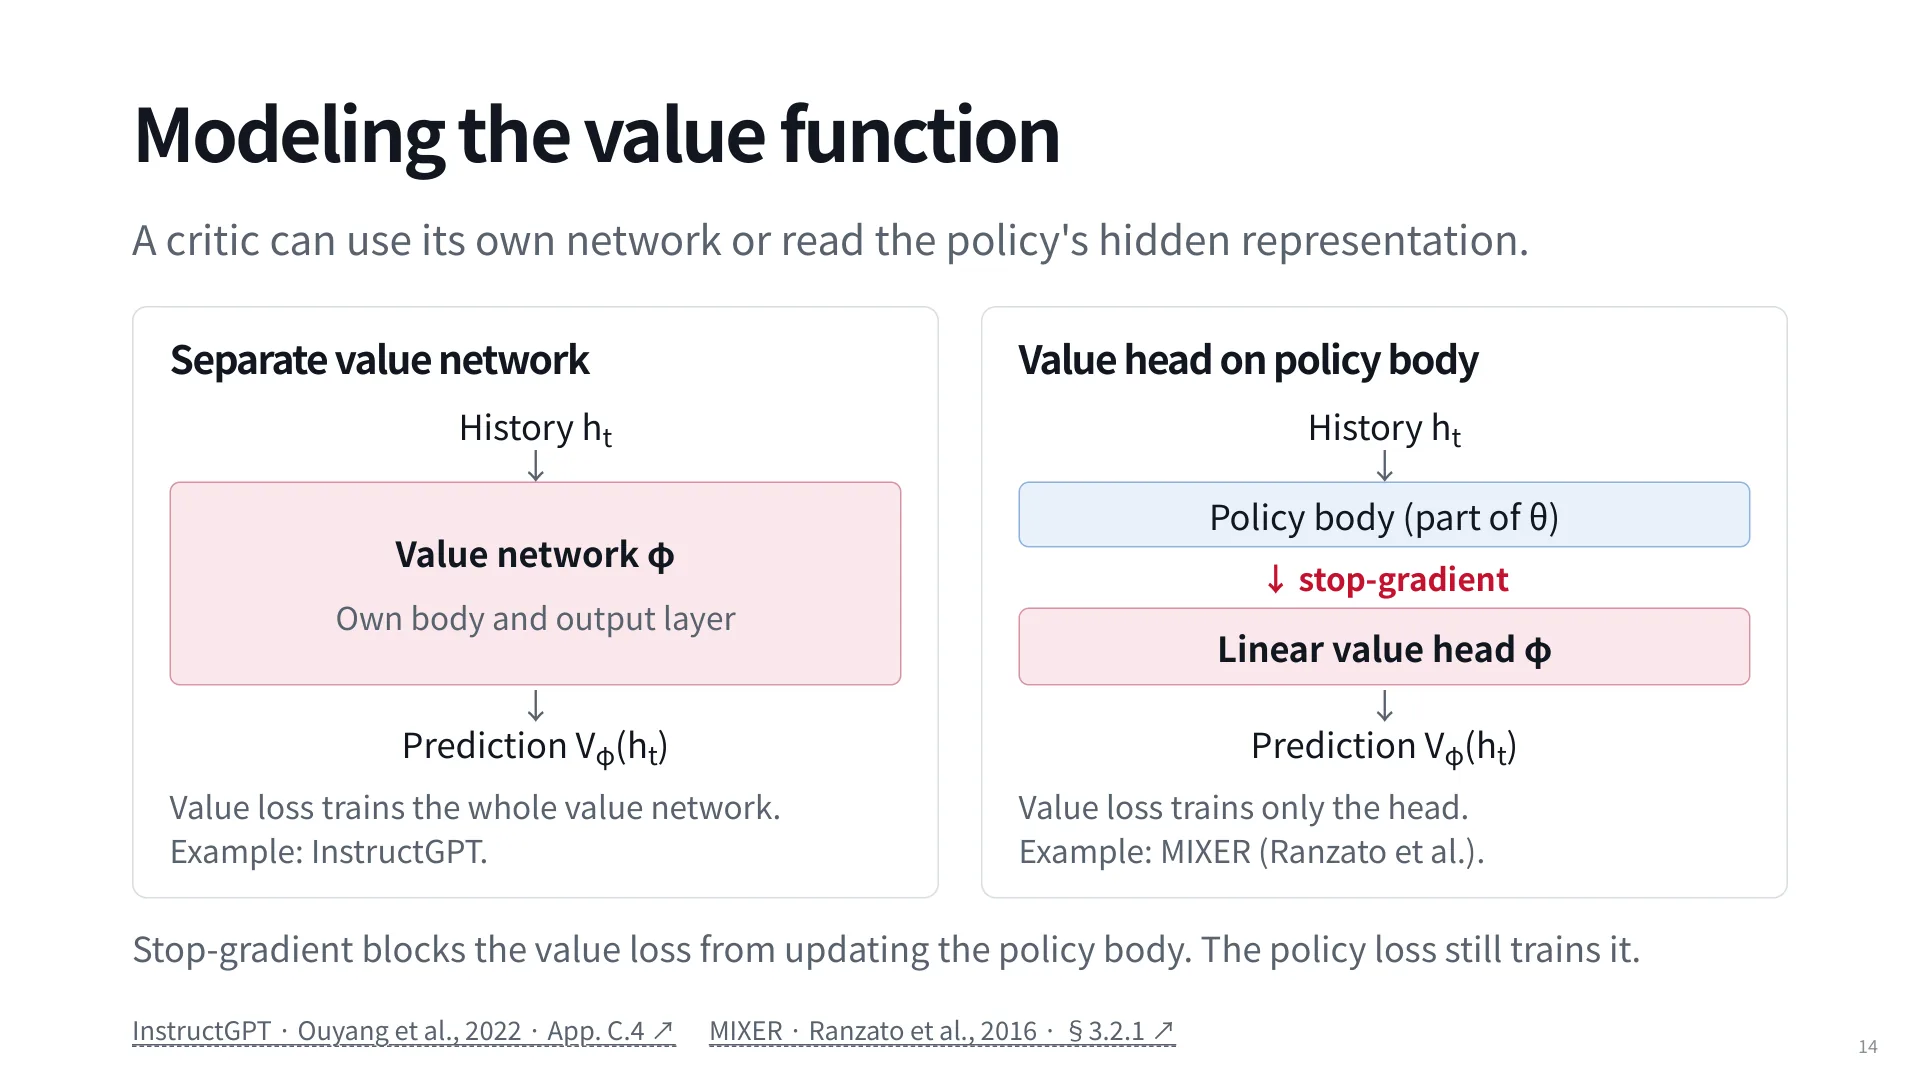
工程上有两种挂法,取舍很直接:
| 挂法 | 结构 | 训练范围 | 代表工作 | 代价 |
|---|---|---|---|---|
| 独立 value network | 自己的 body + 输出层 | 整个 value 网络 | InstructGPT | 要同时训练两个模型,显存与工程复杂度翻倍 |
| policy body + 线性 head | 共享 policy 表示,加一个线性头 | 只有 head(stop-gradient 挡住 body) | MIXER | 几乎零额外参数,但 value 表示与 policy 强耦合,容量受限 |
课堂上有个很好的提问:既然模型能判断动作对不对,为什么不直接生成正确动作?回答有两层。第一,value 不条件于动作,它只评“这个局面好不好”,不评“这个动作对不对”。第二,判别比生成容易——知道自己把事情搞砸了,远比知道下一步该干什么简单。这也是 critic 存在的理由:它把“评估”这件相对容易的事单独抽出来学。
一个实现细节:value head 不一定是回归头,也可以让模型回答 yes/no 并取归一化后的“yes 概率”作为预测。这样能复用语言模型已有的先验,讲师说这种做法相当有效,尤其是在只有 0/1 奖励的时候。
5. TD 误差与 GAE:把“这一步好不好”拆出来
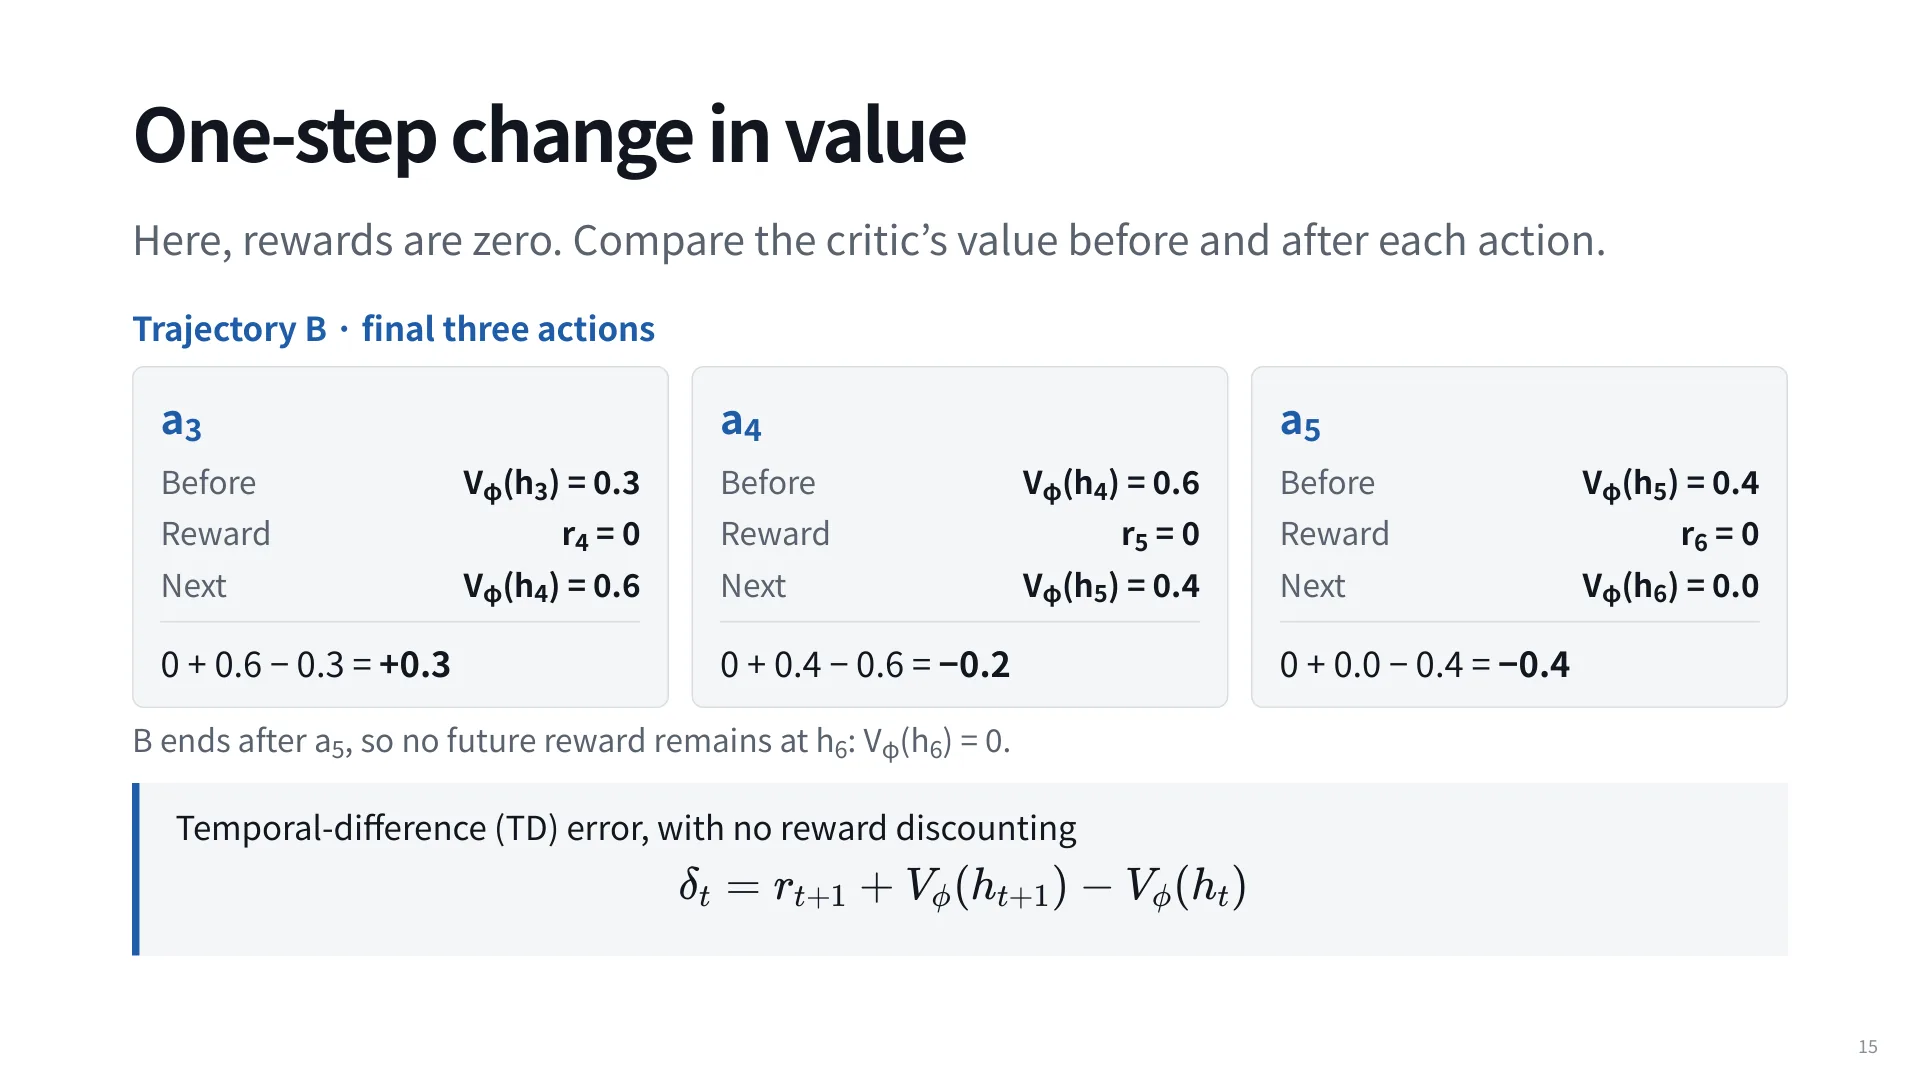
有了 critic,就可以比较“动作之前的估值”和“动作之后的估值”。时序差分误差定义为
在奖励全为 0 的例子里,估值从 0.3 升到 0.6,;从 0.6 掉到 0.4,;从 0.4 掉到 0(轨迹结束,之后没有奖励),。直觉是“意外程度”:奖励加上新局面的估值,减去旧局面的估值,就是这一步带来的估值增量。讲师举的例子很形象——如果你不小心删掉了代码库,估值会瞬间掉到 0,这一项会立刻给出一个很大的负数。17:17
单步 TD 只看一步,噪声大;GAE 把后续误差按 折价加回来:
时, 处的 advantage 是 :单看这一步是正的,但它后面两步都在掉分,于是被折价到 0.1。“这一步看起来不错,但它把模型带进了后面的坑”——这正是 turn-level 信用分配要表达的东西。
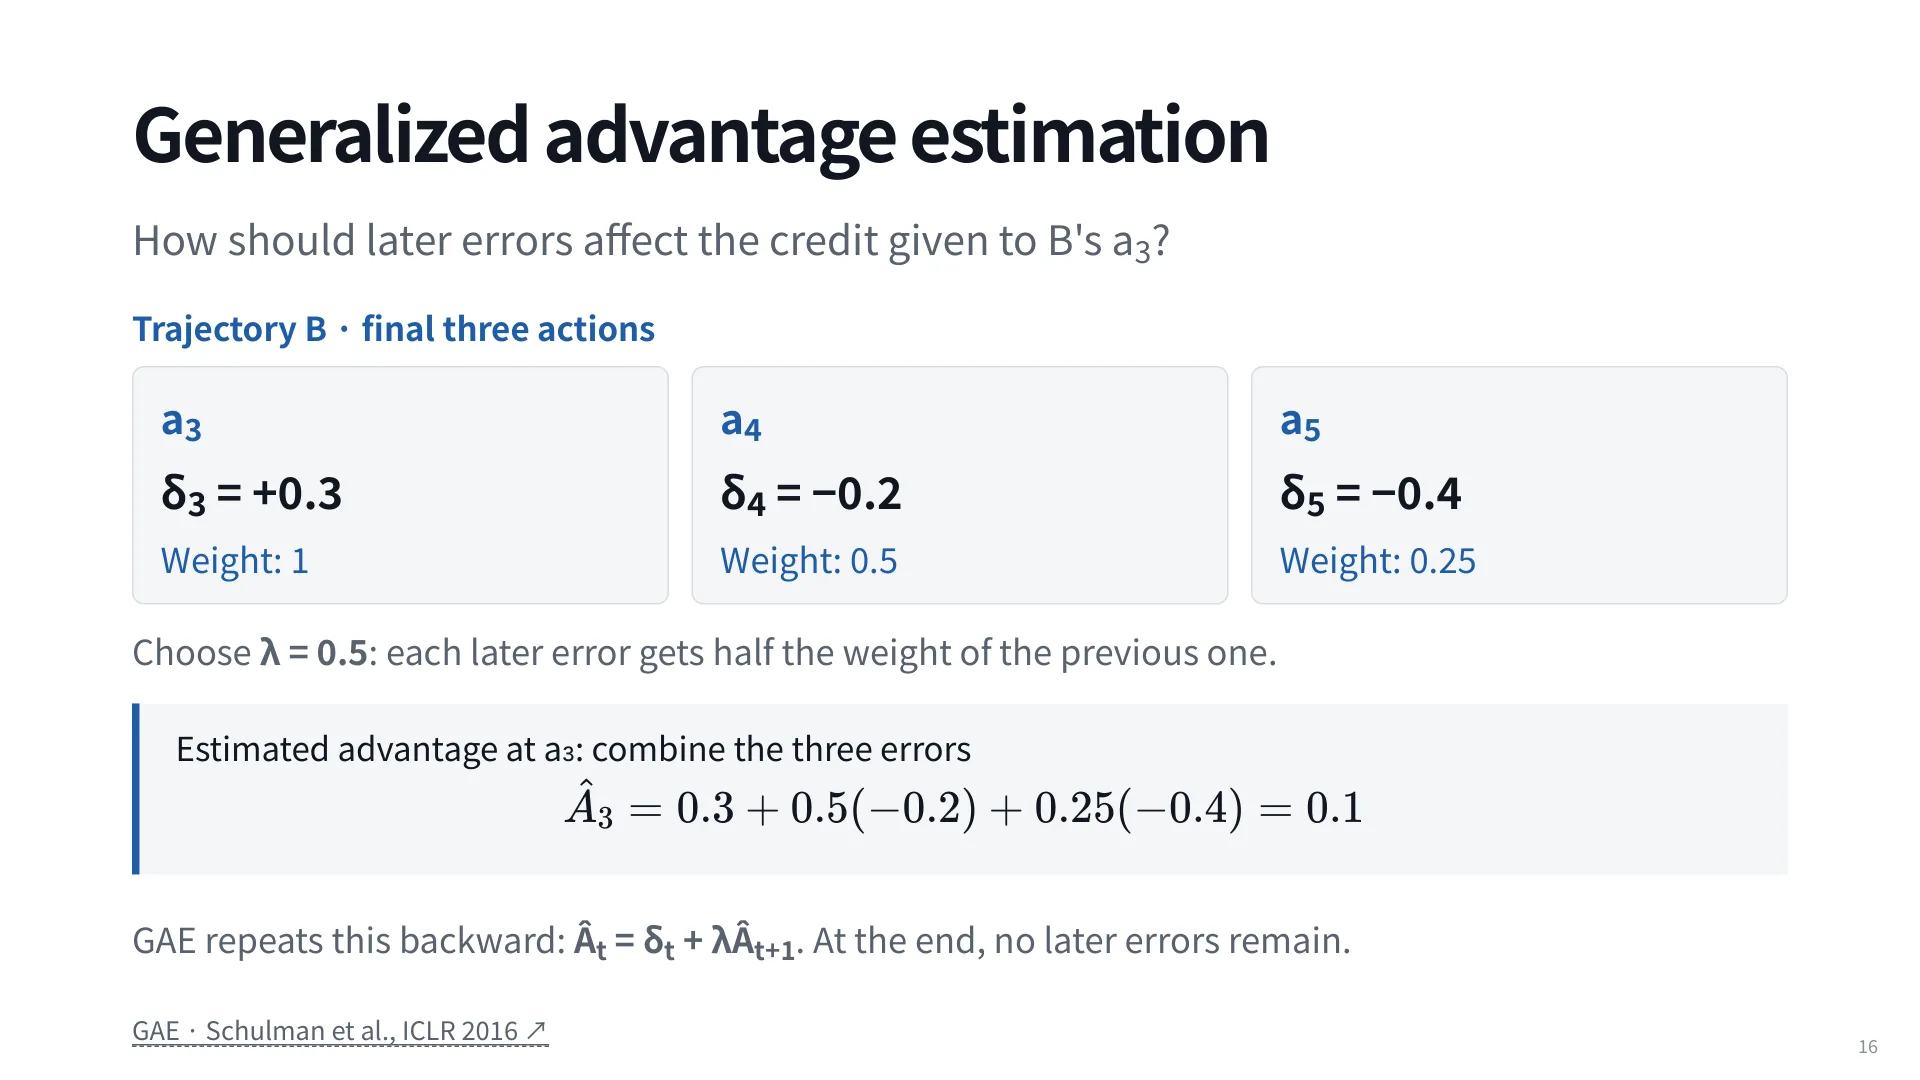
两个极端值得记住。 时误差逐项抵消,只剩最终奖励,等于退回蒙特卡洛(PPO 常用 ,也就是不做时间折价); 时退化成单步 TD,偏差大但方差小。 是“用多少偏差换多少方差”的旋钮,只有在 critic 足够准、或者有可靠的中间奖励时,才值得把它调小。
过程奖励模型:另一种步级信号
除了自举出来的 critic,还有一条路是离线标注每一步。Let's Verify Step by Step(Lightman et al., 2023)让标注者判断推理过程里每一步是否正确:例子里从 推出 是对的,而某一步写成 被标成错误。用这些标注训出来的模型就是 process reward model(PRM),它给的是步级分数,比最终奖励锐利得多。
PRM 和 critic 的区别在于信号来源:critic 是训练过程中顺带学出来的、只依赖最终奖励、免费但噪声大;PRM 是离线监督的、标注昂贵、但可以给更干净的步级判断。讲师的评价是:现在用得不算多(因为 critic 基本免费),但如果能拿到大量标注,用它 bootstrap 一个更好的初始 value function 是划算的。
6. 同步与异步:等待是 agentic RL 最大的浪费
同步 RL 的语义很干净:一个 batch 的所有轨迹都跑完,才开始策略更新,更新完再采下一批。代价是等。图上三块 GPU 一起生成,最后一块跑完之前其余两块只能空转;现实中 coding agent 常有 straggler,某条轨迹可能比其他的慢两倍甚至四倍。24:41
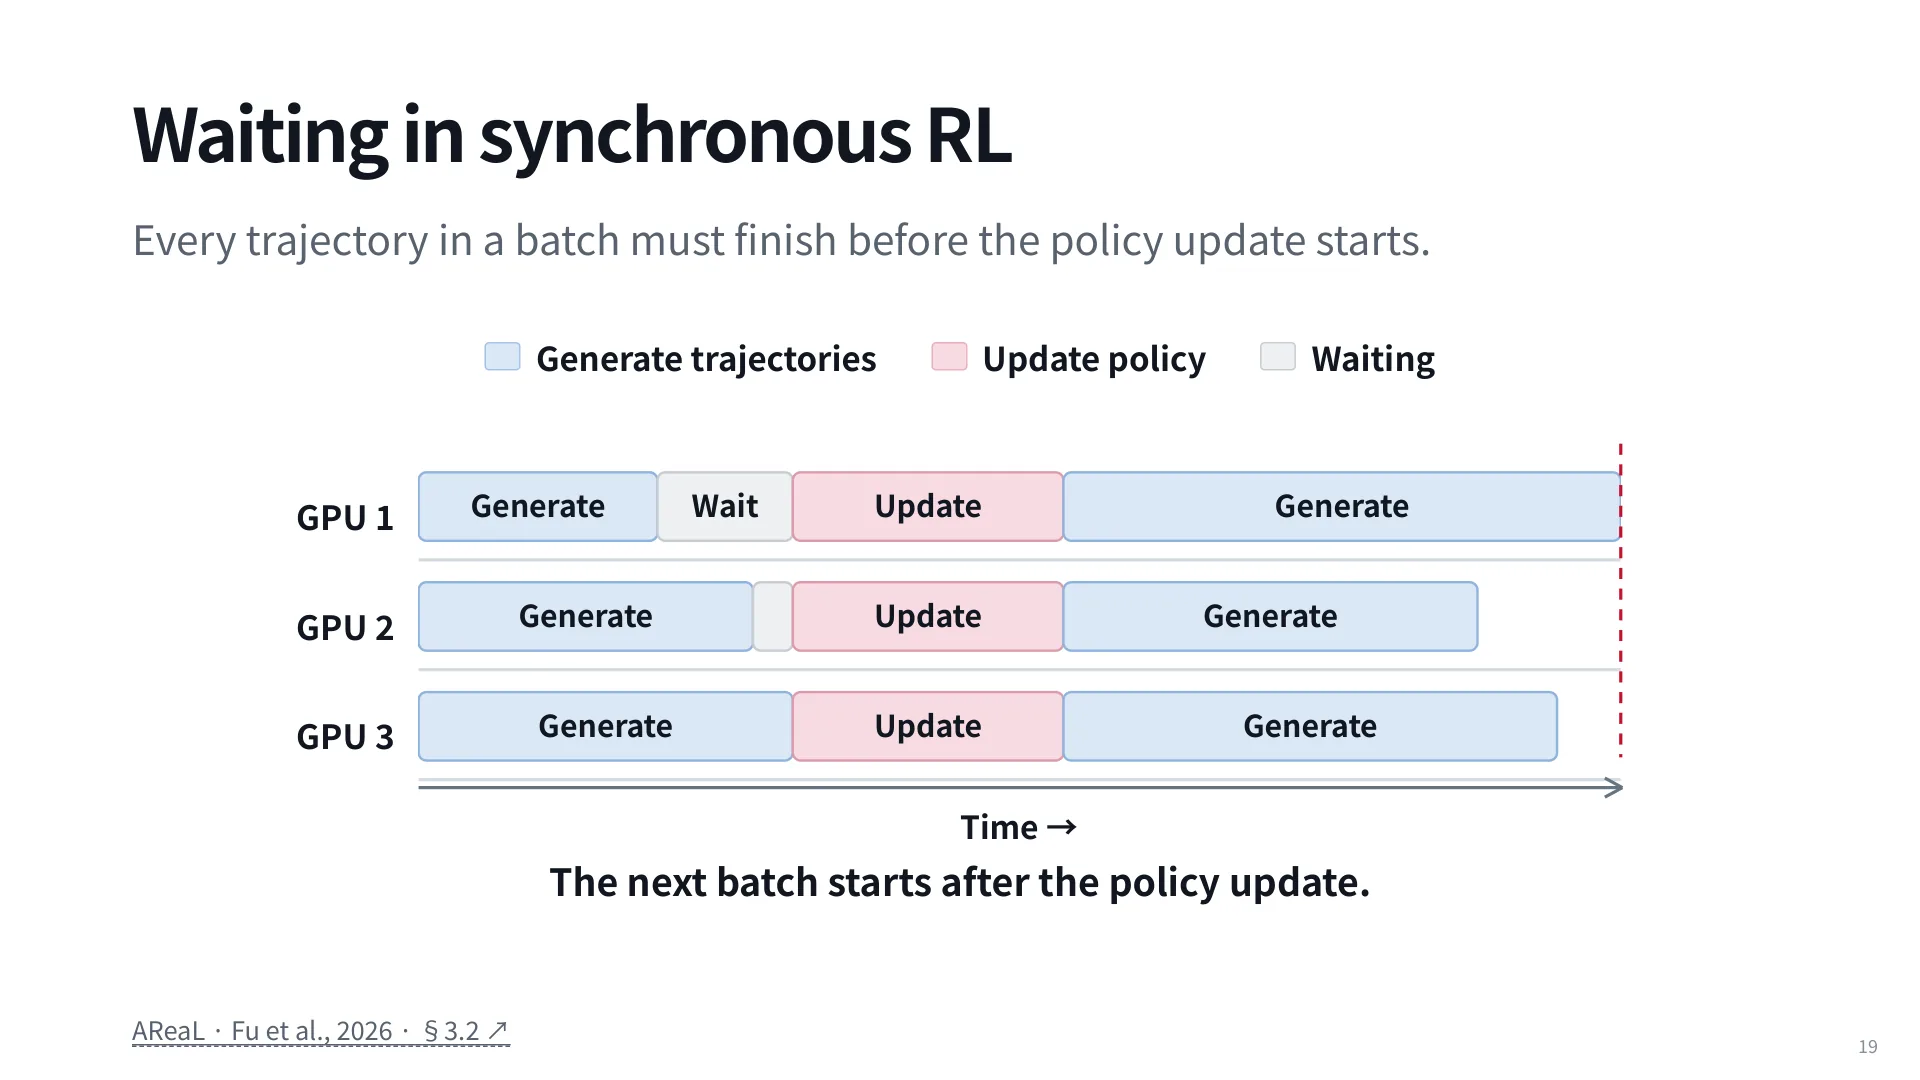
同步的唯一但重要的好处是完全 on-policy:产生 rollout 的策略 就是正在更新的策略 ,数学上没有任何修正项。所有 off-policy 的麻烦(重要性采样、陈旧数据、比率爆炸)都不存在。
异步 RL 把生成和更新重叠:learner 拿已经完成的轨迹开始算梯度,rollout worker 继续跑新的 episode。图上 Update 1 与后面的 Generate 完全并行,等待消失。代价写在图的下方——有些轨迹来自更早的策略版本。26:20
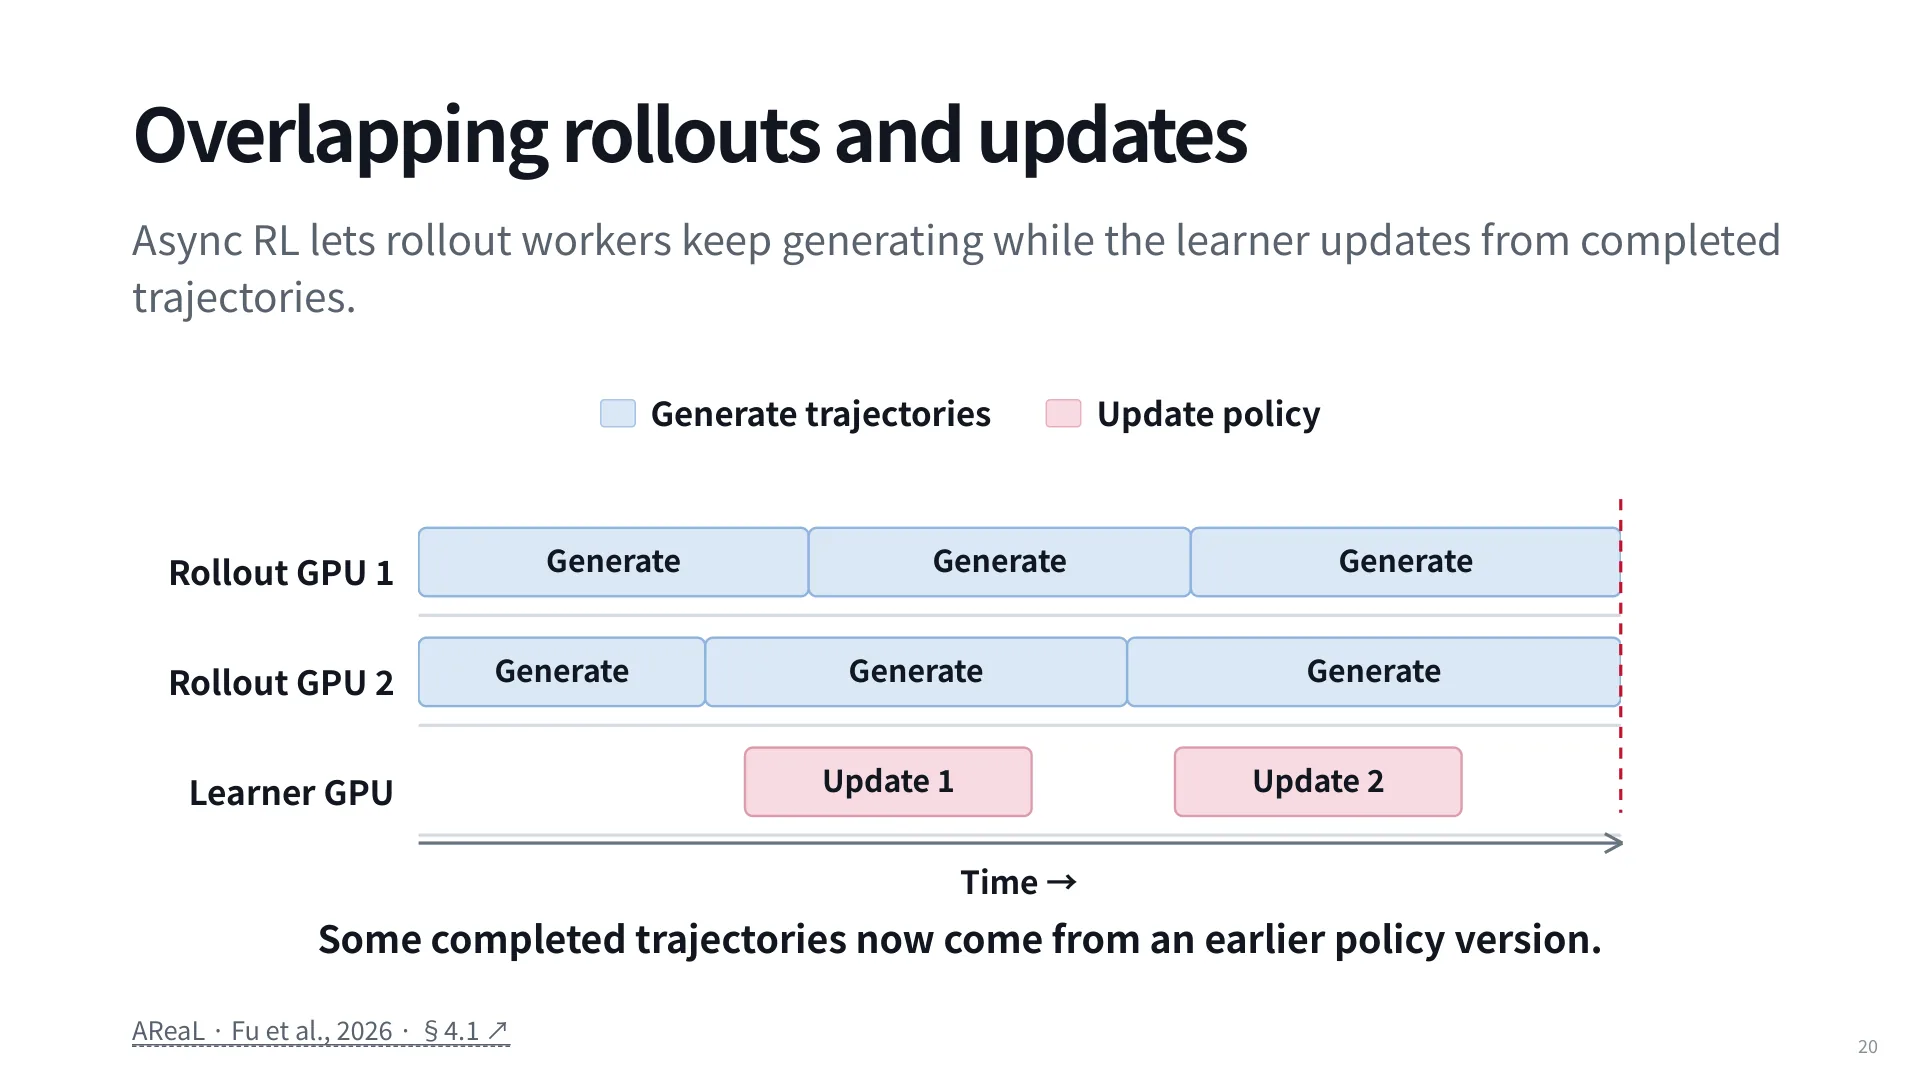
讲师的判断很直接:现在认真做 agentic RL 的基本不会用同步更新,因为 agent 轨迹长、耗时方差大,同步的浪费无法接受;软件生态(如 AReaL 这类系统)也已经把异步支持做得足够好。问题于是从“要不要异步”变成“异步带来的 off-policy 偏差怎么控制”。
控制的手段是给 off-policiness 设上限:允许 learner 相对 rollout 策略最多推进几次更新。设成 1 表示只能用上一版策略采的轨迹,设成 3 表示最多容忍三次更新造成的差异。这个数字是纯粹的稳定性旋钮——调大吞吐更高,但陈旧样本更多、重要性权重更野;调小更接近 on-policy,但一旦 learner 要等 rollout 就退化成同步。课上那张最大重要性权重随训练步数变化的图,就是把上限 1 与上限 3 放在一起对比的:训练早期就出现过远离 1 的尖峰。
7. 陈旧 rollout 与重要性采样
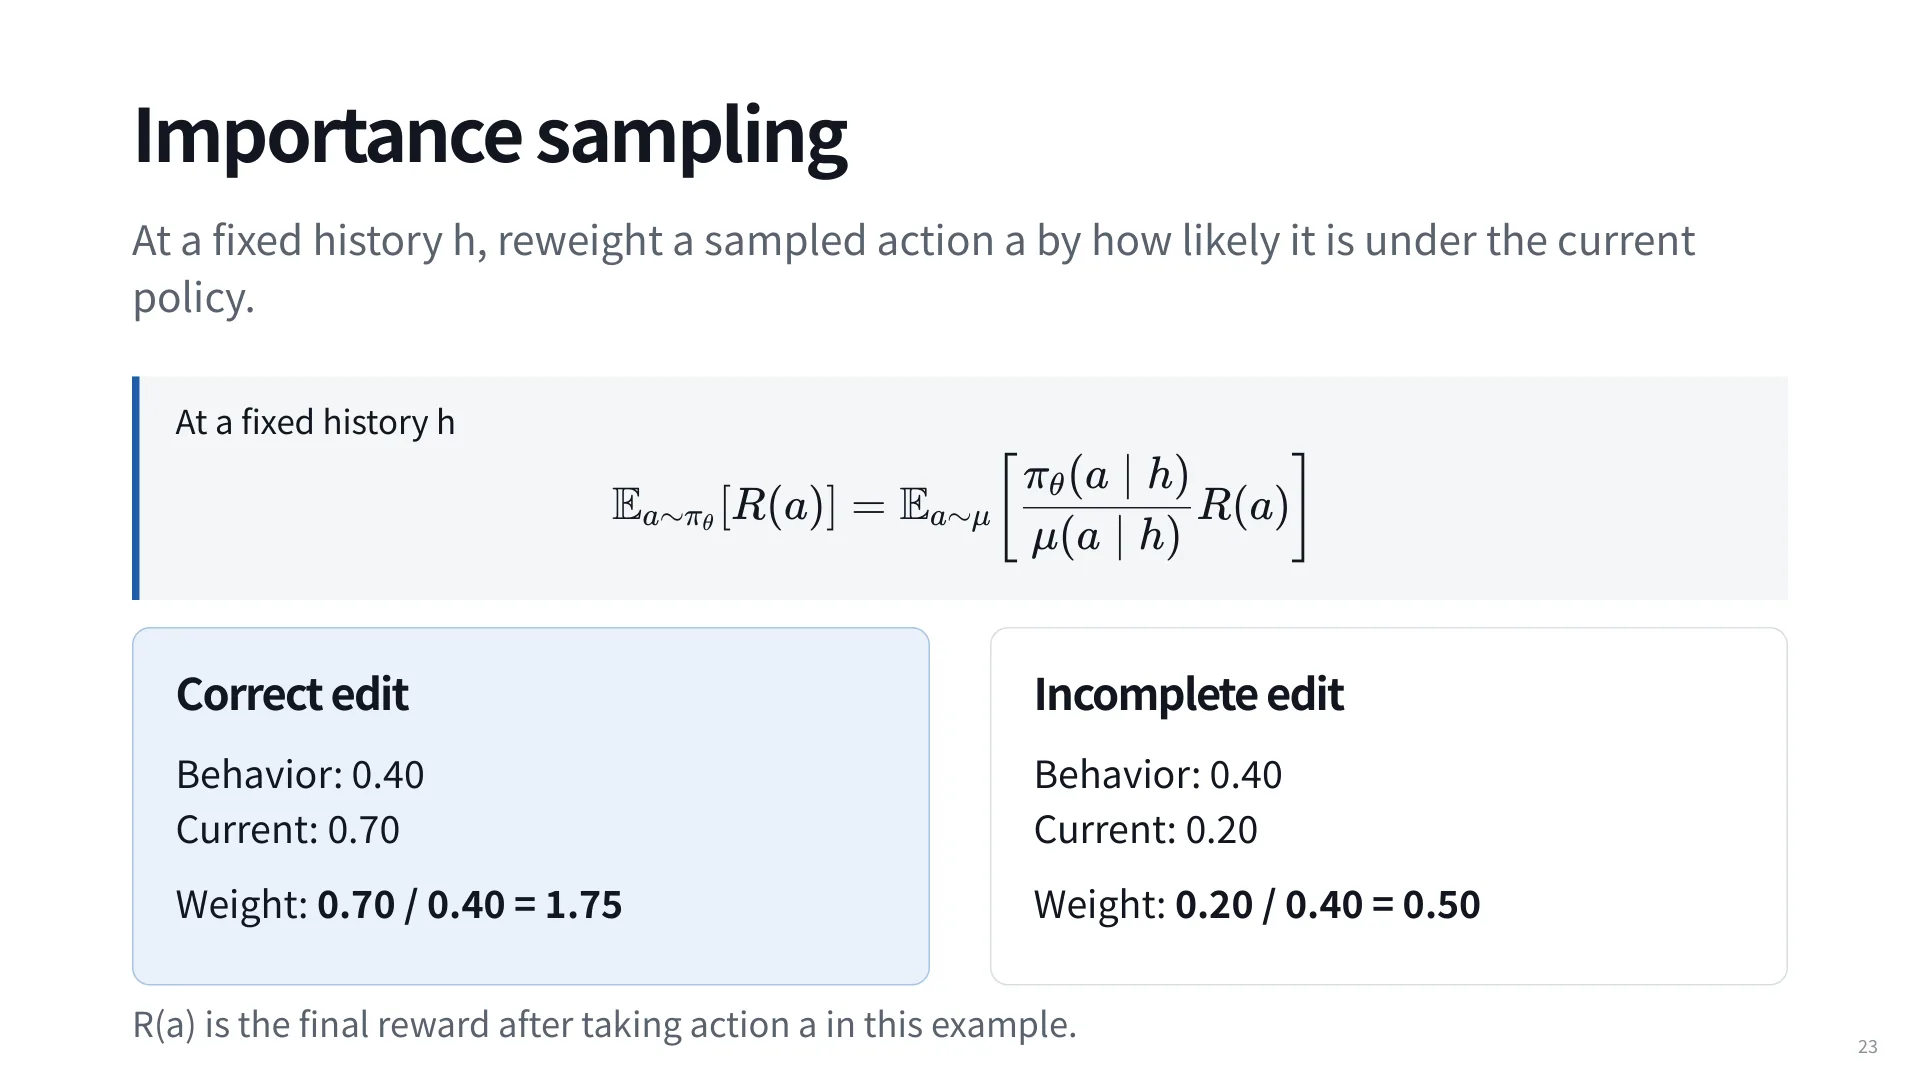
设产生这条轨迹的策略是 (behavior / rollout policy),正在更新的是 (learner policy)。同一个 history 下,两者对三个候选编辑给出的概率可以差很多: 是 0.40 / 0.40 / 0.20, 已经变成 0.70 / 0.20 / 0.10。这条轨迹是“陈旧的”——动作是 采的,梯度却想按 算。28:50
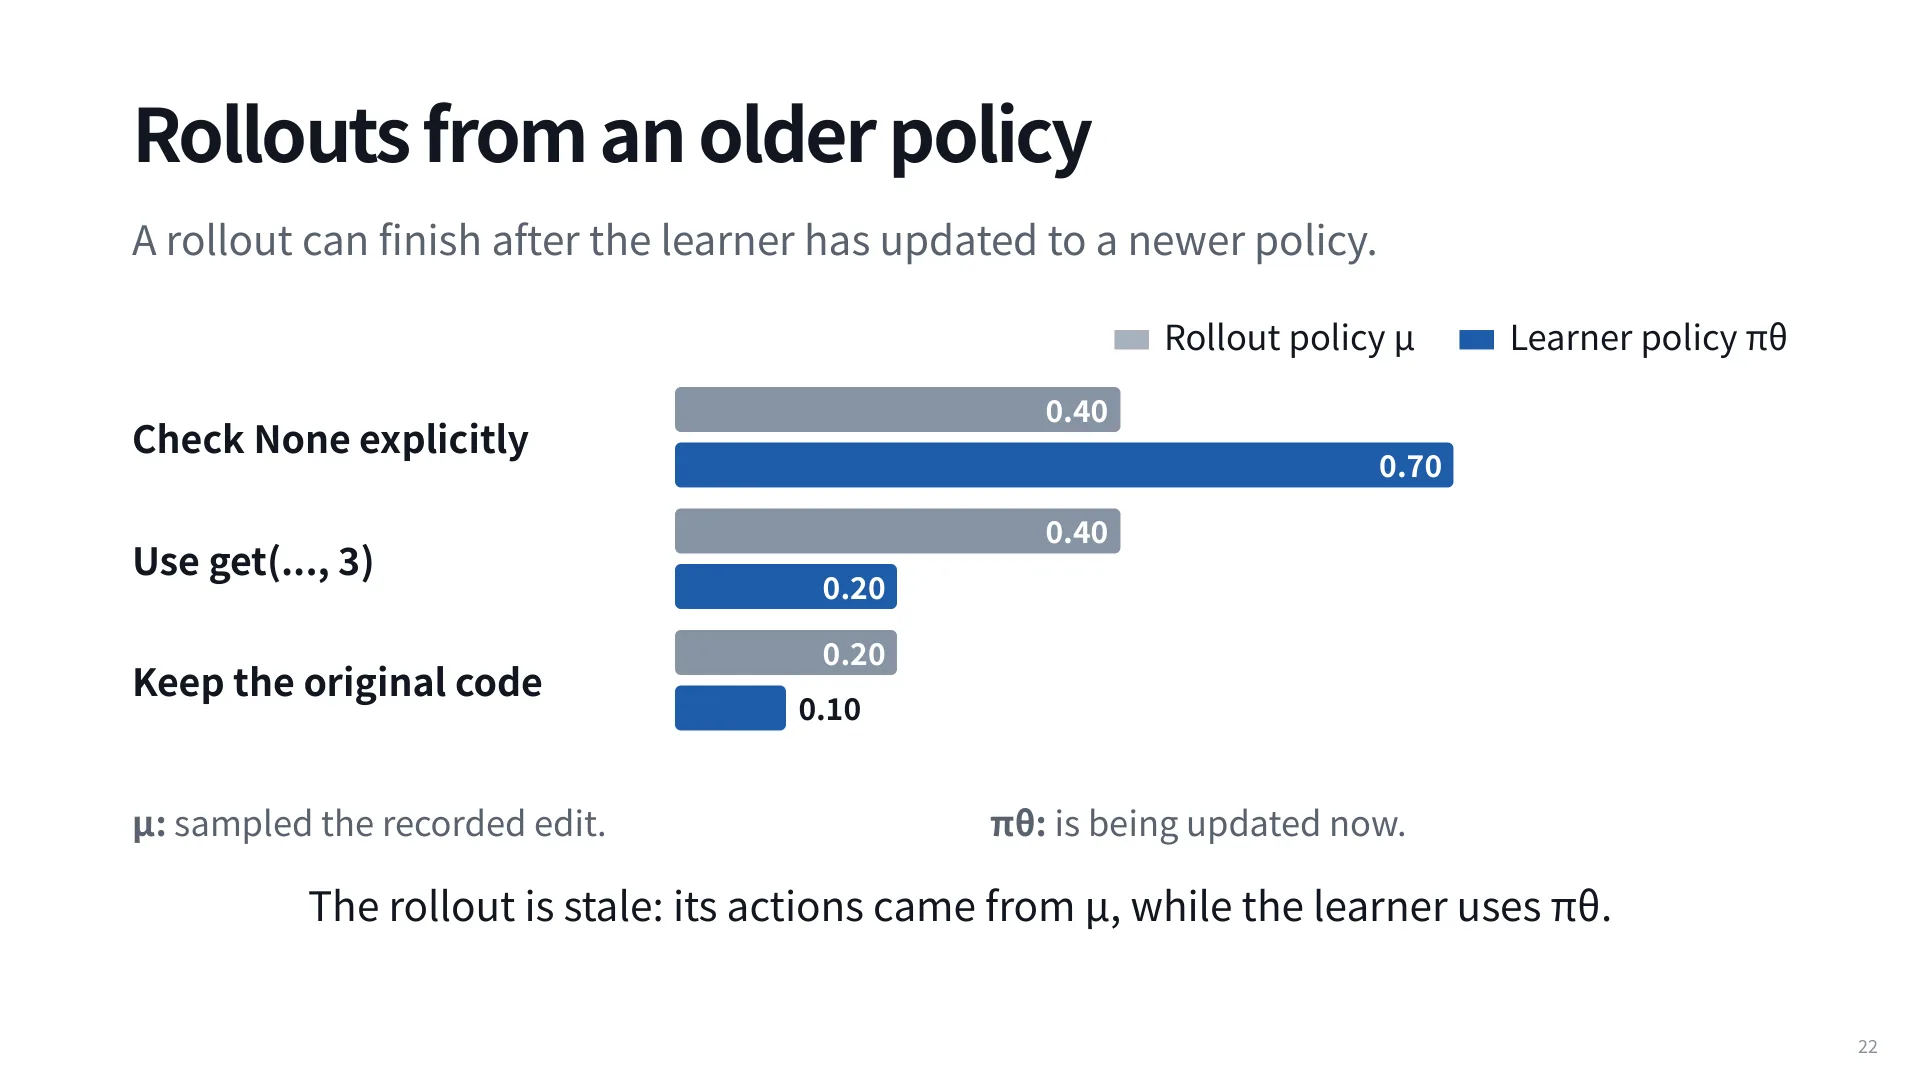
重要性采样(importance sampling)给出的修正是:在 下采样,但给每个样本乘一个比率,
例子里正确编辑的权重是 ,不完整编辑是 。直觉是:在新策略下更可能出现的动作被放大,更不可能出现的被压低,于是用旧策略采的样本仍然能估计新策略的期望。
问题出在“整条轨迹”。轨迹级比率是每一步比率的乘积:
单步只差 5%(1.05),100 步之后就是 。而真实的 agent 轨迹动辄五万到六万个 token,100 步已经是“宽容的估计”。31:16 更麻烦的是方差:对数重要性权重的方差随步数线性增长,权重本身的离散度按 扩张,少数样本会主导整个 batch。CTPO 的实测也确认了这一点——累积比率在序列后段的分布明显变宽。
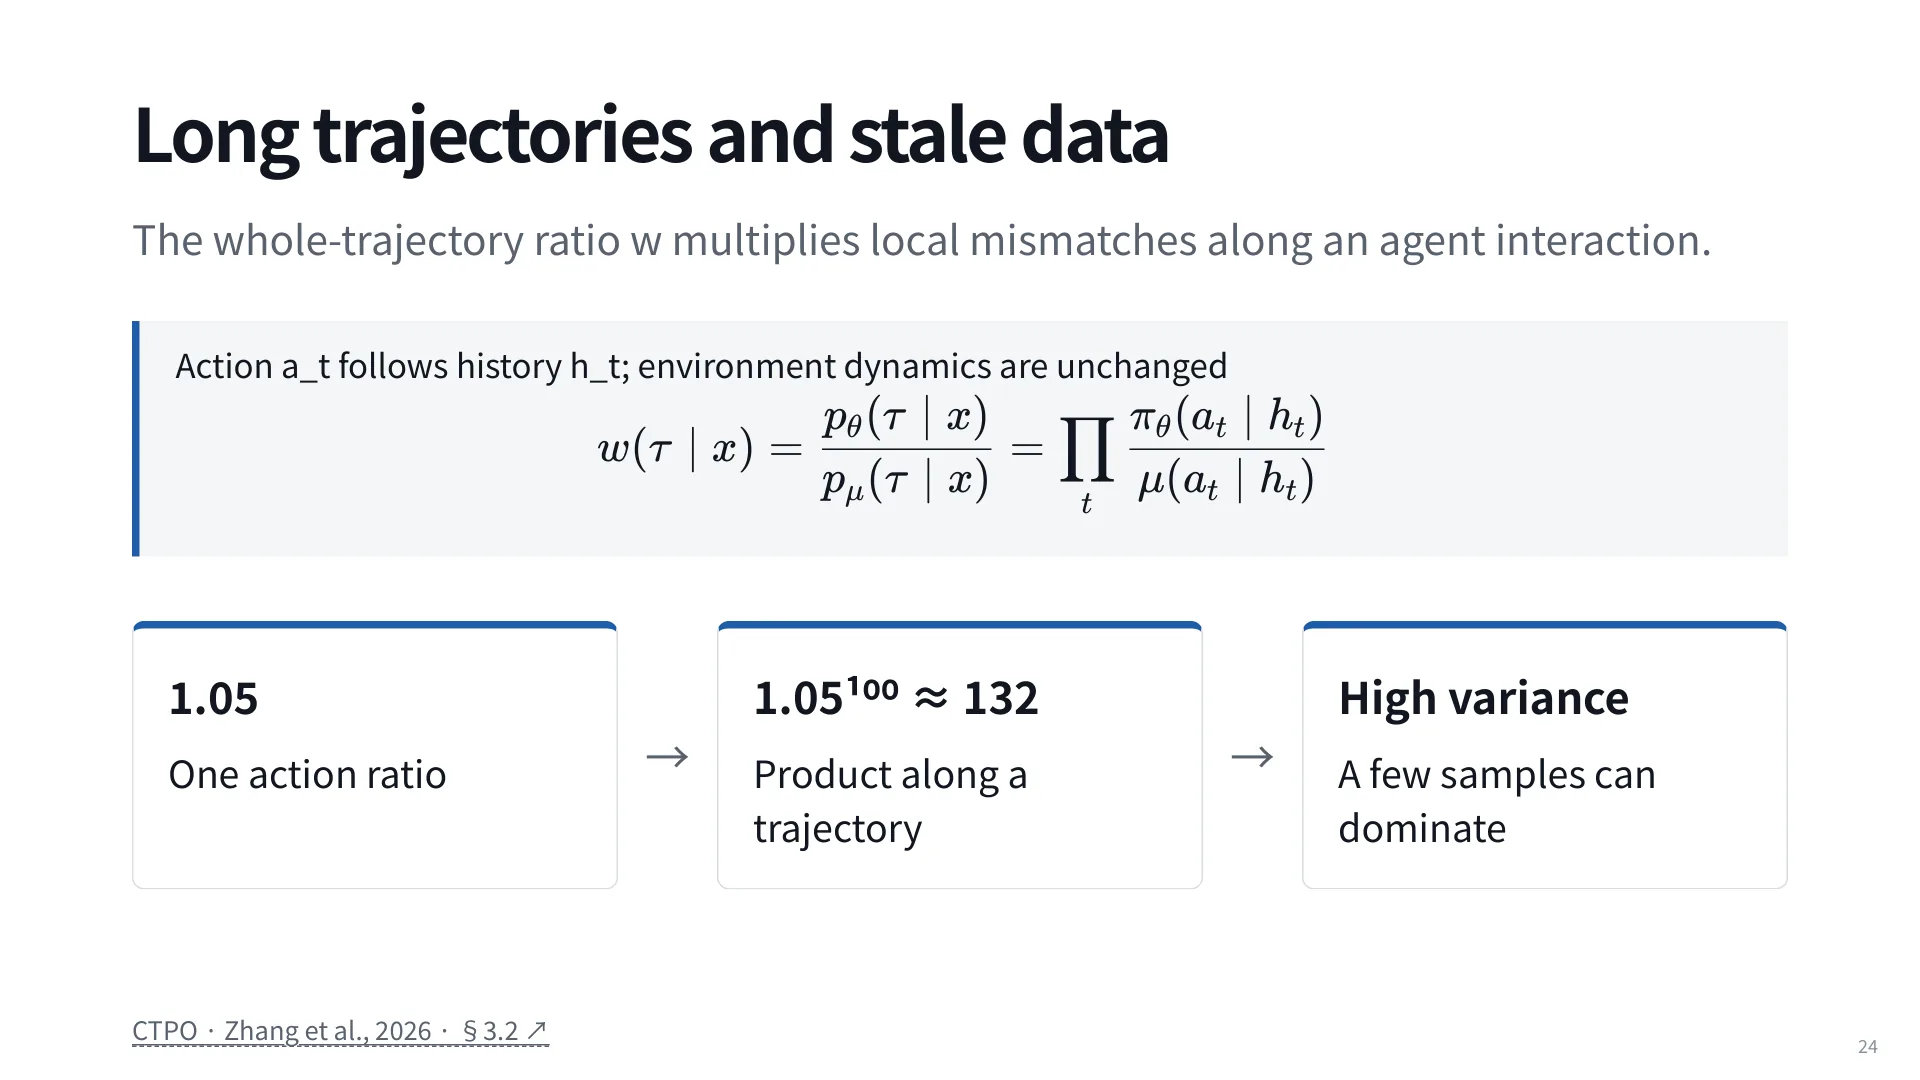
还有一层更隐蔽的问题:早期动作会改变后续 history 的可达性。如果某一步(比如“加一个 None 检查”)在 下有 40% 的概率发生、在 下只有 10%,那么这条 history 本身就变稀有了;即使后续每一步的条件概率比率都是 1,整条路径的概率比也只有 0.25。只用当前 token 的比率,在数学上并不是正确的轨迹重要性权重。
一句话概括:agent 轨迹上的“重要性权重”不是一个标量,而是一条随步数增长的乘积。下面这些方法的主要差异,就是在回答——这条乘积里取哪一段。
8. 比率取哪一段:从当前动作到长度归一化
不同算法对“取哪一段比率”给出了不同答案,这张表是理解它们差异的最短路径:
| 方法 | 权重使用的动作范围 | 特点 |
|---|---|---|
| PPO / GRPO | 只有当前动作 | 便宜、方差低,但不是无偏的轨迹重要性权重 |
| CTPO | (到当前为止) | 更接近正确的累积修正,方差随 增长 |
| Full ratio | 全部 个动作 | 理论上最“正确”,实际爆炸 |
| GSPO | 全部动作,按长度归一化 | 量级回到 ,可用 |
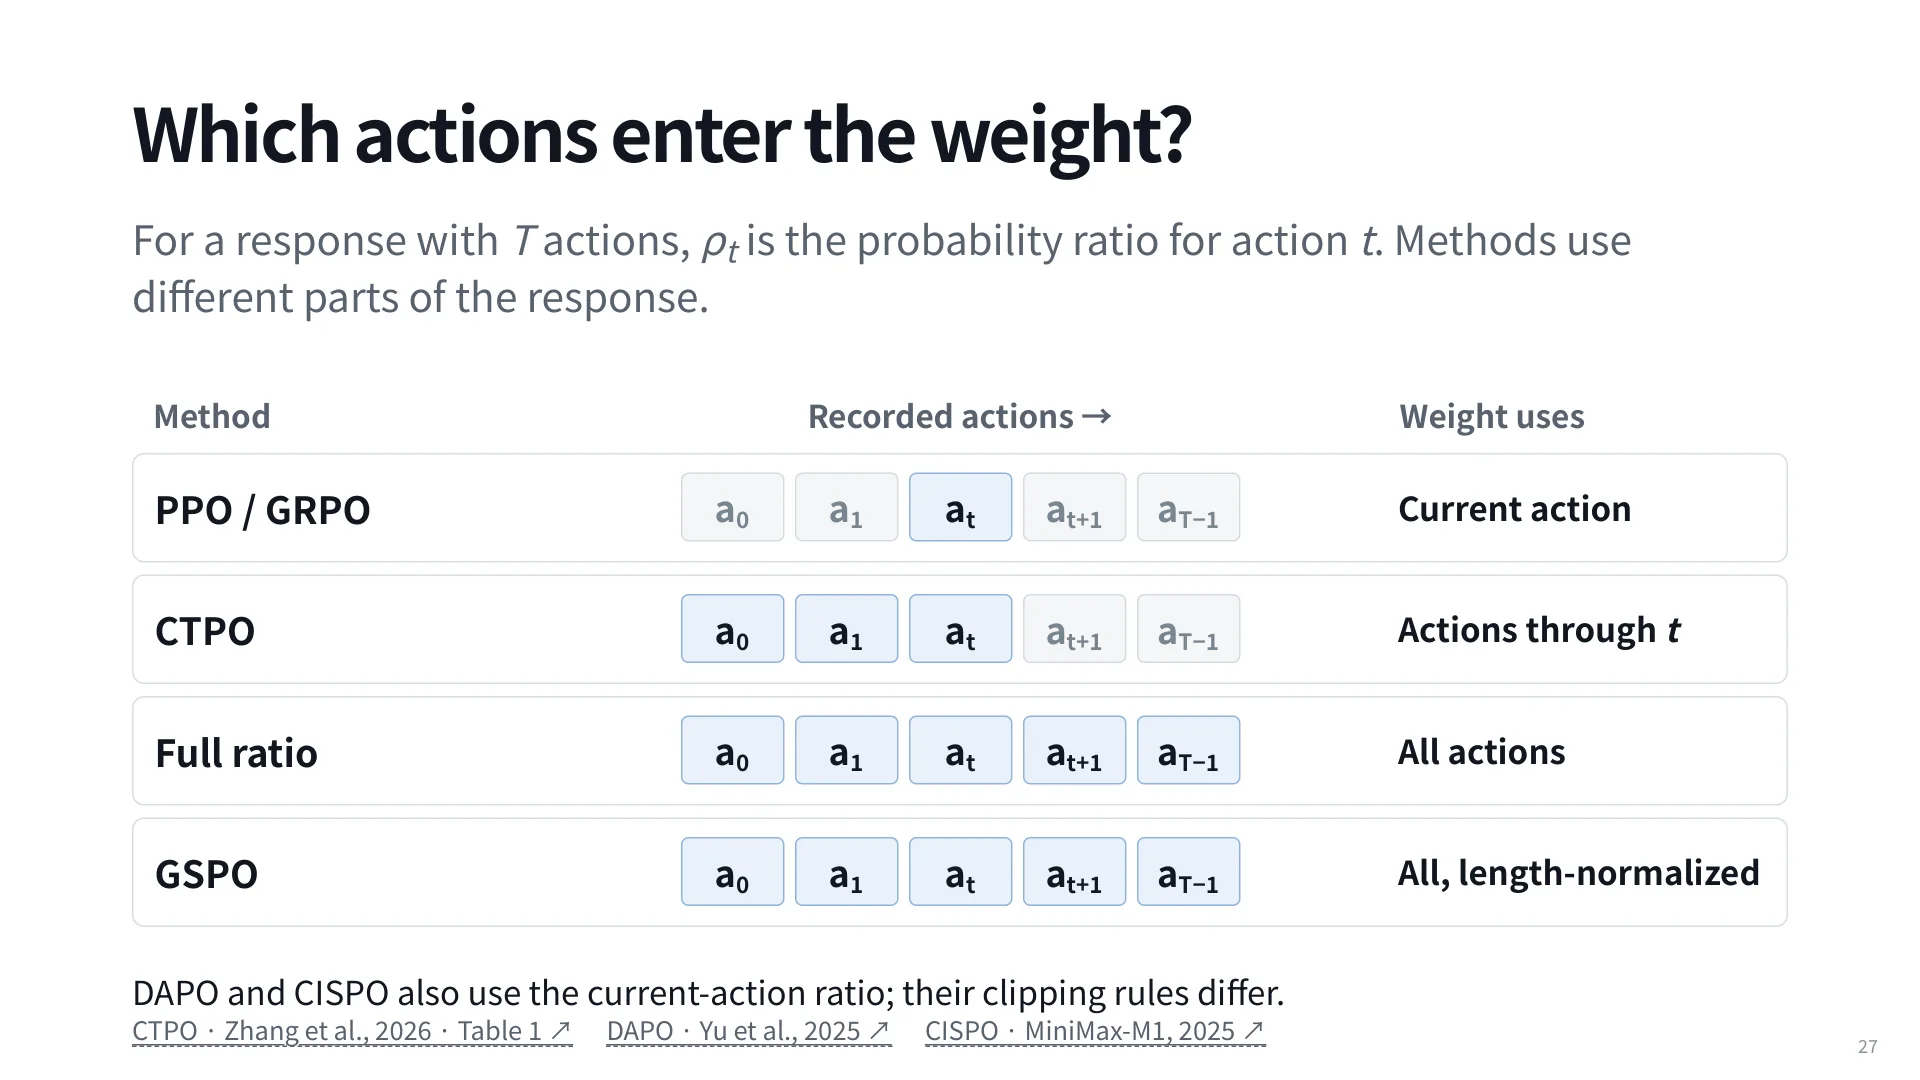
PPO/GRPO 的选择是一种工程妥协:既然乘积会爆,就只看当前这一步的比率。它不再是严格的 off-policy 修正,但仍然携带了有用的信息——这个动作在当前策略下有多“意外”。讲师原话大意是:这并不正确,但足够好,而且给了你一个“这个动作有多反常”的度量。33:45
CTPO 把它改成累积到当前步,理论上更接近真实权重,但代价是方差随位置增长(第 25 页的实测曲线正是这个现象)。GSPO 则走另一条路:用全序列比率,但按响应长度开方,等价于在对数域取平均、即比率的几何平均,把量级拉回与单步比率同一水平。DAPO 和 CISPO 仍然用当前动作比率,差别在裁剪规则。
这组取舍没有唯一答案,它是一个显式的偏差-方差选择:越接近“正确的”轨迹权重,方差越大;越局部,偏差越大但训练越稳。
9. 让更新不失控:裁剪、KL 与熵
裁剪比率
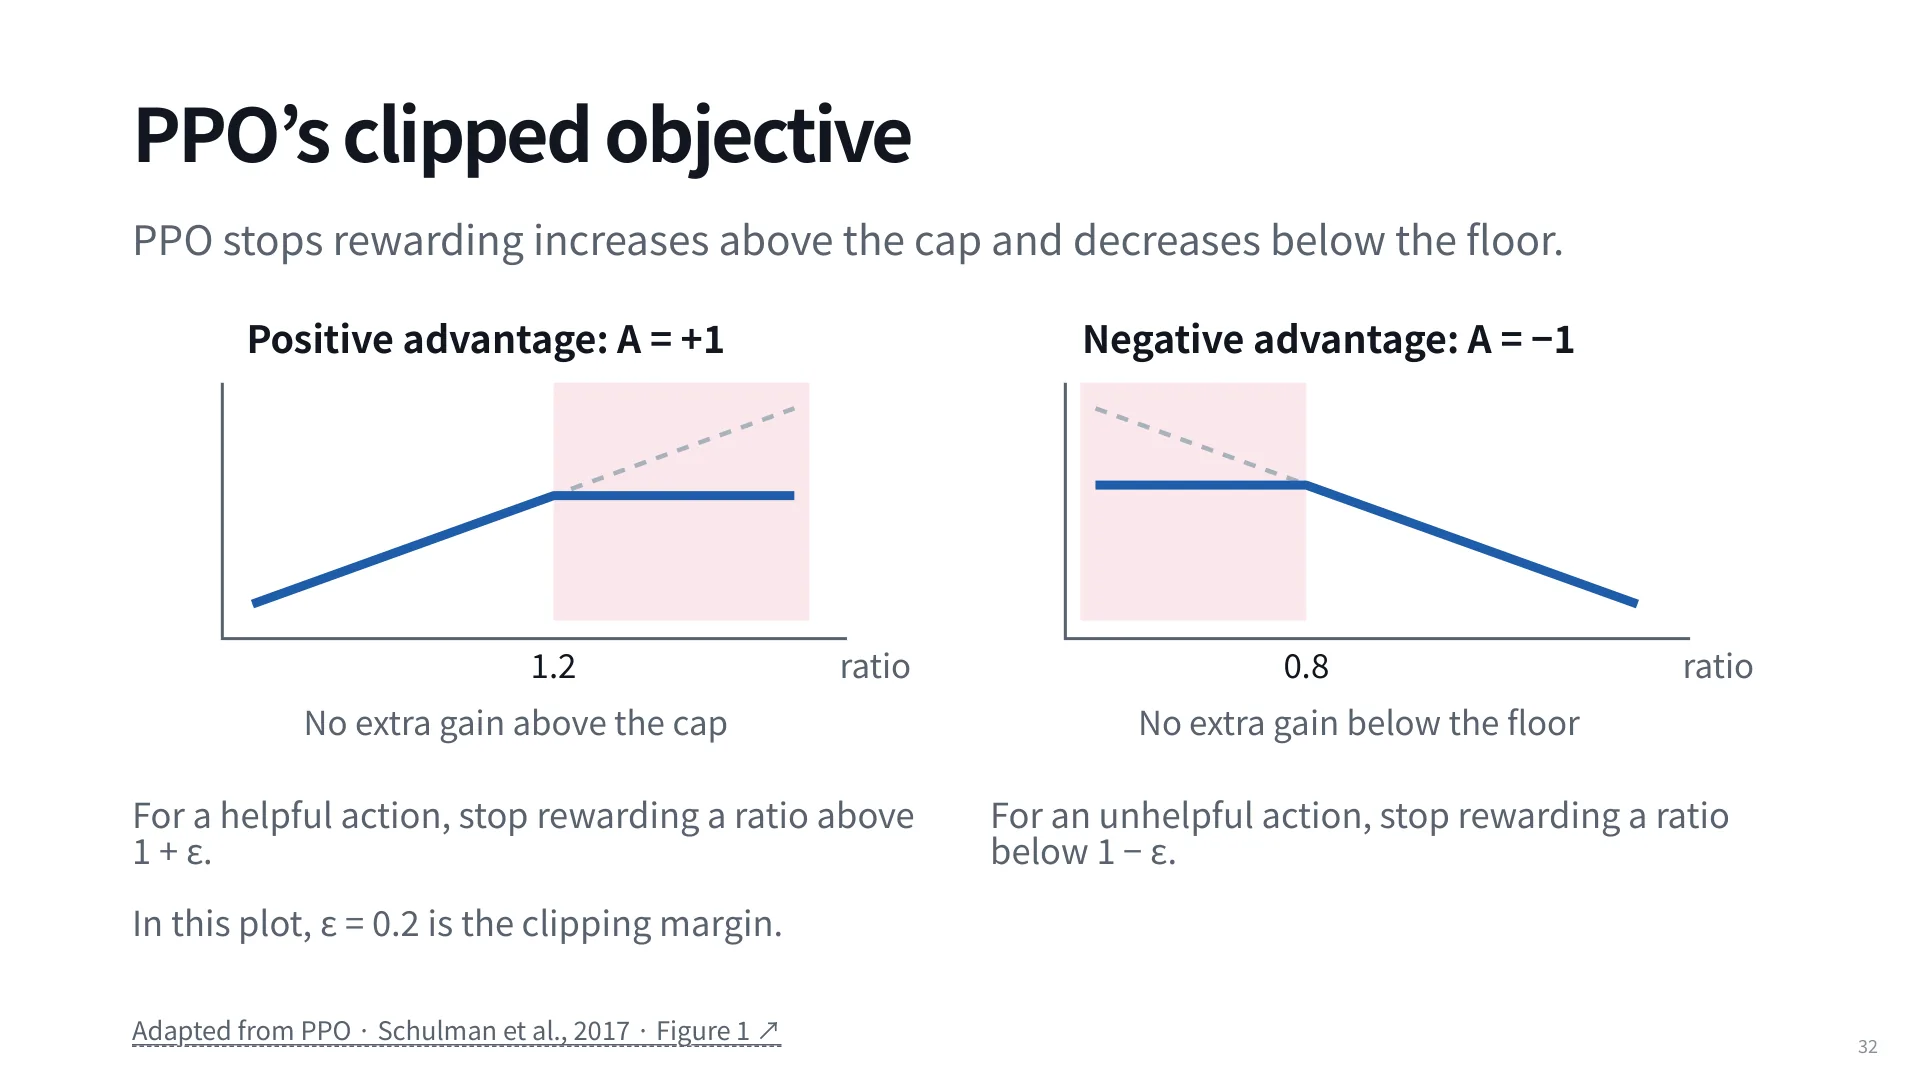
把所有落在 之外的比率替换成最近的边界,典型值是 、。PPO 的目标是
正 advantage 时,比率涨到 以上不再带来额外收益(min 选了被截断的那一项);负 advantage 时,比率跌破 以下也不再继续扣分。 时就是常见的 0.8 / 1.2。
为什么必须这么做,有一个很具体的数字:讲师实验室记录过异步 RL 中单个 batch 内的最大重要性权重,在第 17 步附近出现过一个量级约 1400 的比率;上限设为 1 与 3 的对比曲线上,最突出的一次就出现在那里。35:22 一个 1400 倍的样本意味着一次巨大的梯度步,模型可能当场崩掉:开始重复同一个 token、输出突然极长或极短,而且很难恢复——因为崩掉之后再也拿不到正常的 advantage,训练进入恶性循环。
CISPO 换了裁剪的用法:
表示 stop-gradient,即把裁剪后的比率当成一个固定的重要性权重乘在 log 概率上,而不是让比率本身参与梯度。区别在于:PPO 允许比率在信任域内“自我修正”,CISPO 把它当成常数权重、只对策略项求导。DAPO 则在 PPO 的框架上把上界放松,更愿意放大正 advantage 的样本。
参考模型 KL 与熵
裁剪是对单样本的硬限制,KL 是对整体漂移的软约束:
通常是初始化模型,固定不动。它的作用是双重的:既防止策略为了拿奖励而漂到语言能力崩坏的区域,也提供一个“回到正常分布”的拉力。 太大则学不动,太小则约束形同虚设。
熵正则走另一个方向:
衡量下一个 token 分布的不确定性。熵太低,模型对同一 history 几乎总选同一个动作,采样不到多样性,组内 advantage 全为零;熵太高,模型在乱选,几乎不可能碰到正确答案。两端都会让训练停滞,只是失败方式不同。
实践提醒:训练崩掉时的症状通常不是“loss 变大”,而是行为变怪——重复、超长、超短、突然不会用工具。优先怀疑异常大的重要性权重造成的梯度尖峰,其次才是数据与奖励。
一张表看清主流算法
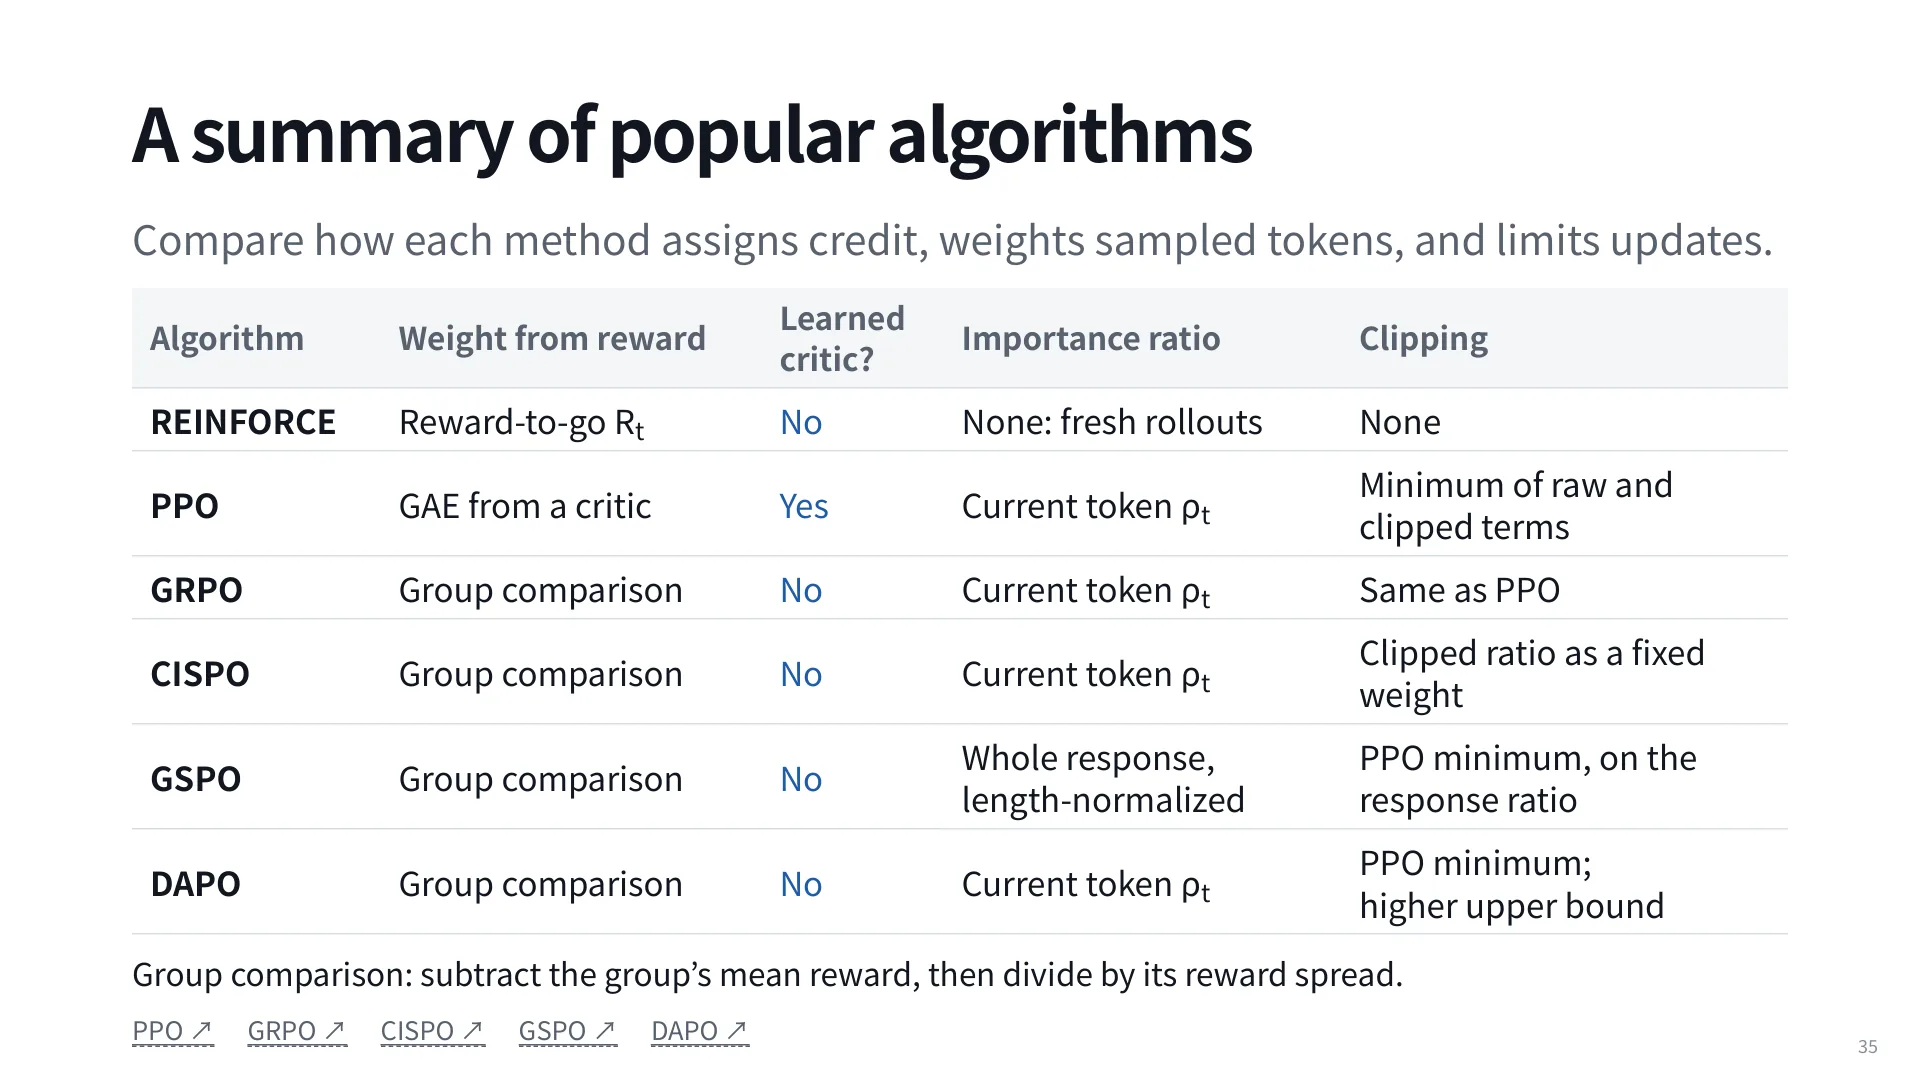
REINFORCE 是基线:reward-to-go、无 critic、无重要性比率(因为每次都用新鲜 rollout)、无裁剪。PPO 引入 critic + GAE、当前 token 比率、min-of-clipped 裁剪。GRPO 把 critic 换成组比较,其余与 PPO 同构。CISPO 同样用组比较与当前 token 比率,但裁剪后作为固定权重。GSPO 用整段响应并按长度归一化,再套 PPO 式的 min。DAPO 用当前 token 比率,但上界更松。表下方还有一句常被忽略的细节:组比较是减去组均值再除以组内奖励标准差,所以奖励尺度本身不影响步长。
10. 奖励可靠性:无效组、假阴性与奖励黑客
如果只看算法,很容易忽略一个事实:训练失败最常见的原因不在优化器,而在数据与验证器。
先看组内信号。采四条轨迹,全 0 时组均值 0、减去均值后全 0;全 1 时同样全 0;只有混合组才有正负 advantage。用 GRPO 时最该监控的指标就是 zero-advantage 组的比例——它直接告诉你这一批数据能提供多少梯度。46:07
全 0 组有三种成因,处理方式完全不同:验证器质量差(正确解被判错)、模型能力不足(真的做不出来)、探索不足(四条轨迹其实是同一个思路)。对应的诊断动作是:读失败的测试要求、看更强的模型能否做出来、比较几条轨迹是否雷同。
假阴性:正确解被判错
最典型的假阴性长得非常具体:候选实现四个用例全对,但验证器要求源码里出现 value is None 这个字面短语,候选用了别的写法,于是被拒绝。听起来荒谬,但 agent 自己写测试时经常写出这种东西——测的是措辞而不是行为。
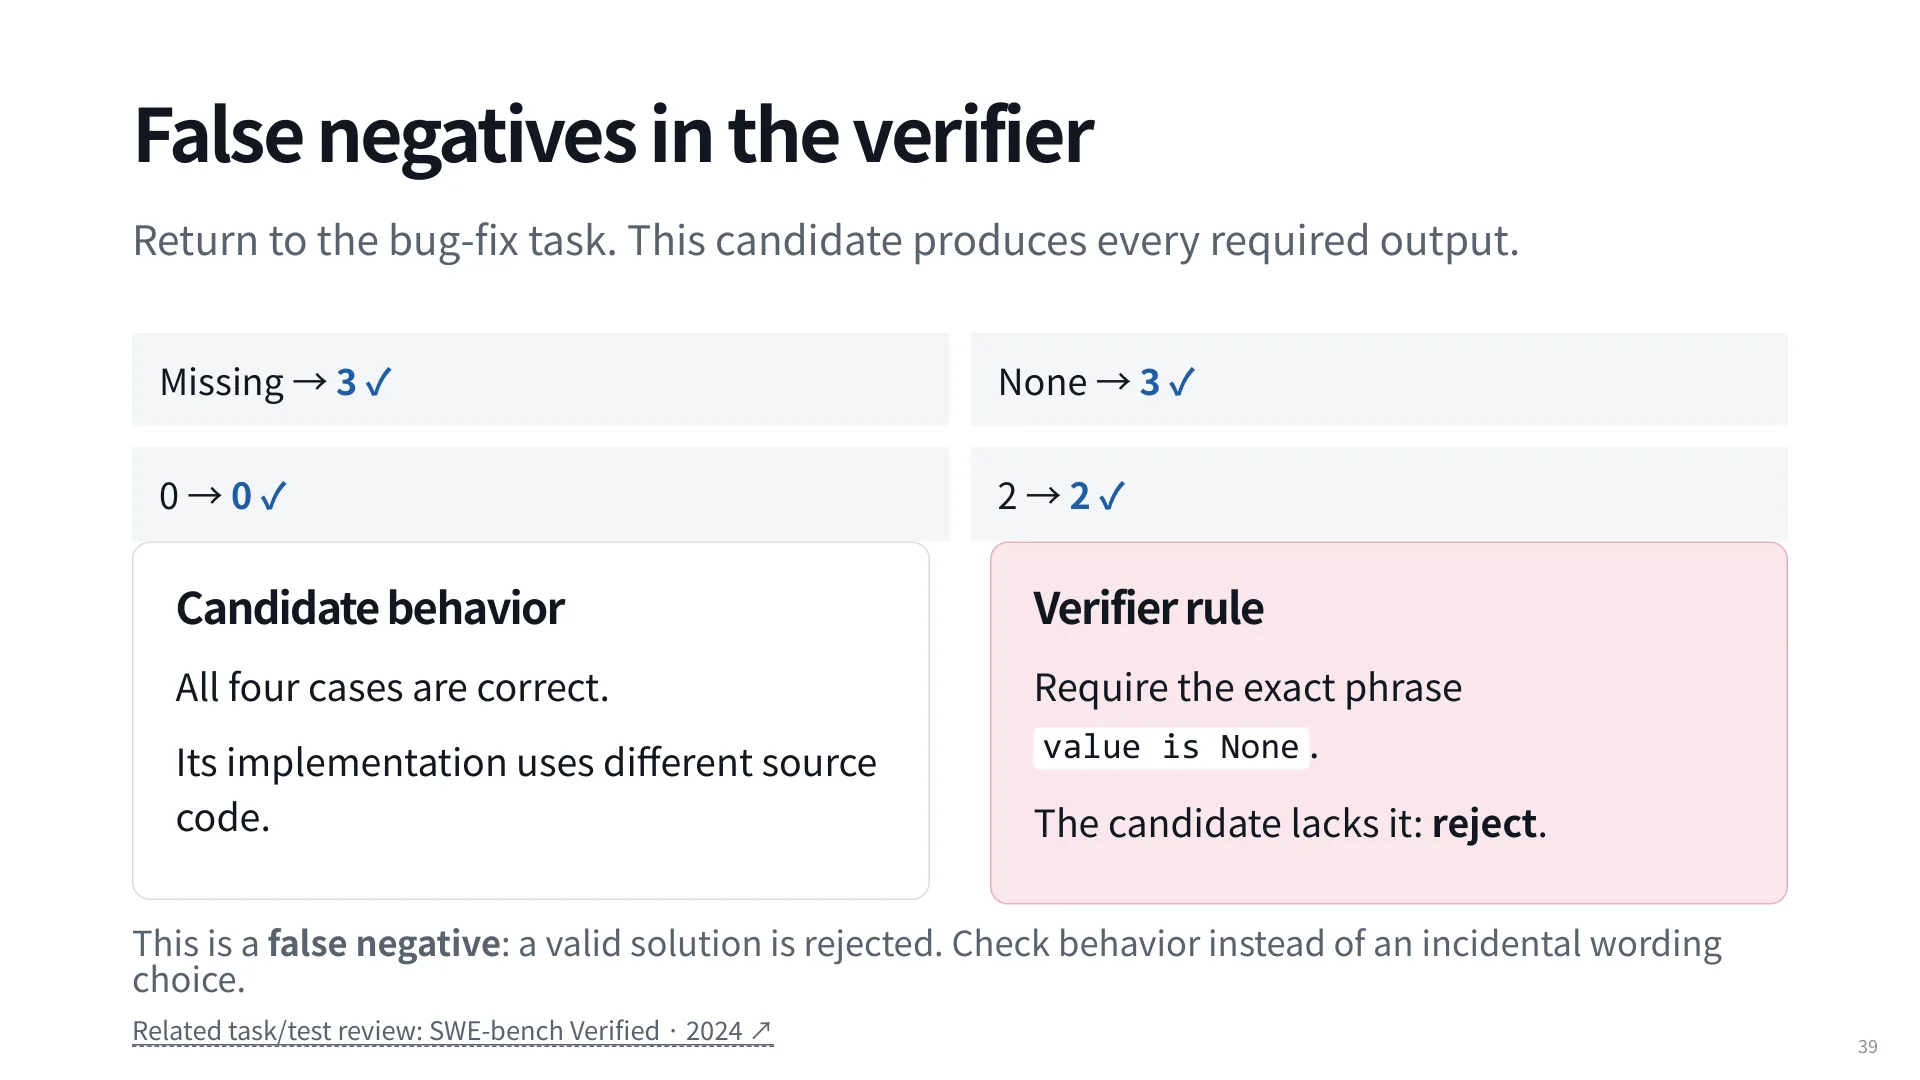
后果有两个层次。轻的是奖励噪声:等价解拿到不同分数,模型在为无关的措辞差异做优化。重的是基准饱和:分数卡在某个上不去的平台上,而这跟模型能力无关。课上给的数字是:SWE-bench Verified 约 81%(进度在 80.9% 附近停滞,剩余失败很多是测试缺陷)、τ-bench Airline 约 70%、τ-bench Retail 约 92%(后两者是标注不一致与标注错误造成的上限,τ-bench 后来修了任务)。这也是为什么 OpenAI 会公开审计自己发布的 benchmark。
设计验证器时可以记住一条原则:测行为,不测实现。输入到输出的映射是行为,源码里出现某个字符串、用了某个 API、写了某种注释都是实现。前者对模型是可达的,后者只是某一种写法的指纹。同样的道理适用于主观任务——用 rubric 打分时要明确“满足需求”而不是“出现某些词”,否则你会得到一整个分数段的噪声。
假阳性与奖励黑客
反方向的问题更危险。把训练验证器改成只测 retries=0 一个用例,那么
def retry_count(config):
return 0就能拿满分——它在训练分布上完全正确,在真实需求上三错其一。模型会迅速学会这种退化解,因为它在训练信号下是最优的。
真实世界里的捷径更花哨,而且都不需要模型“恶意”,只要环境里有,它就会用:
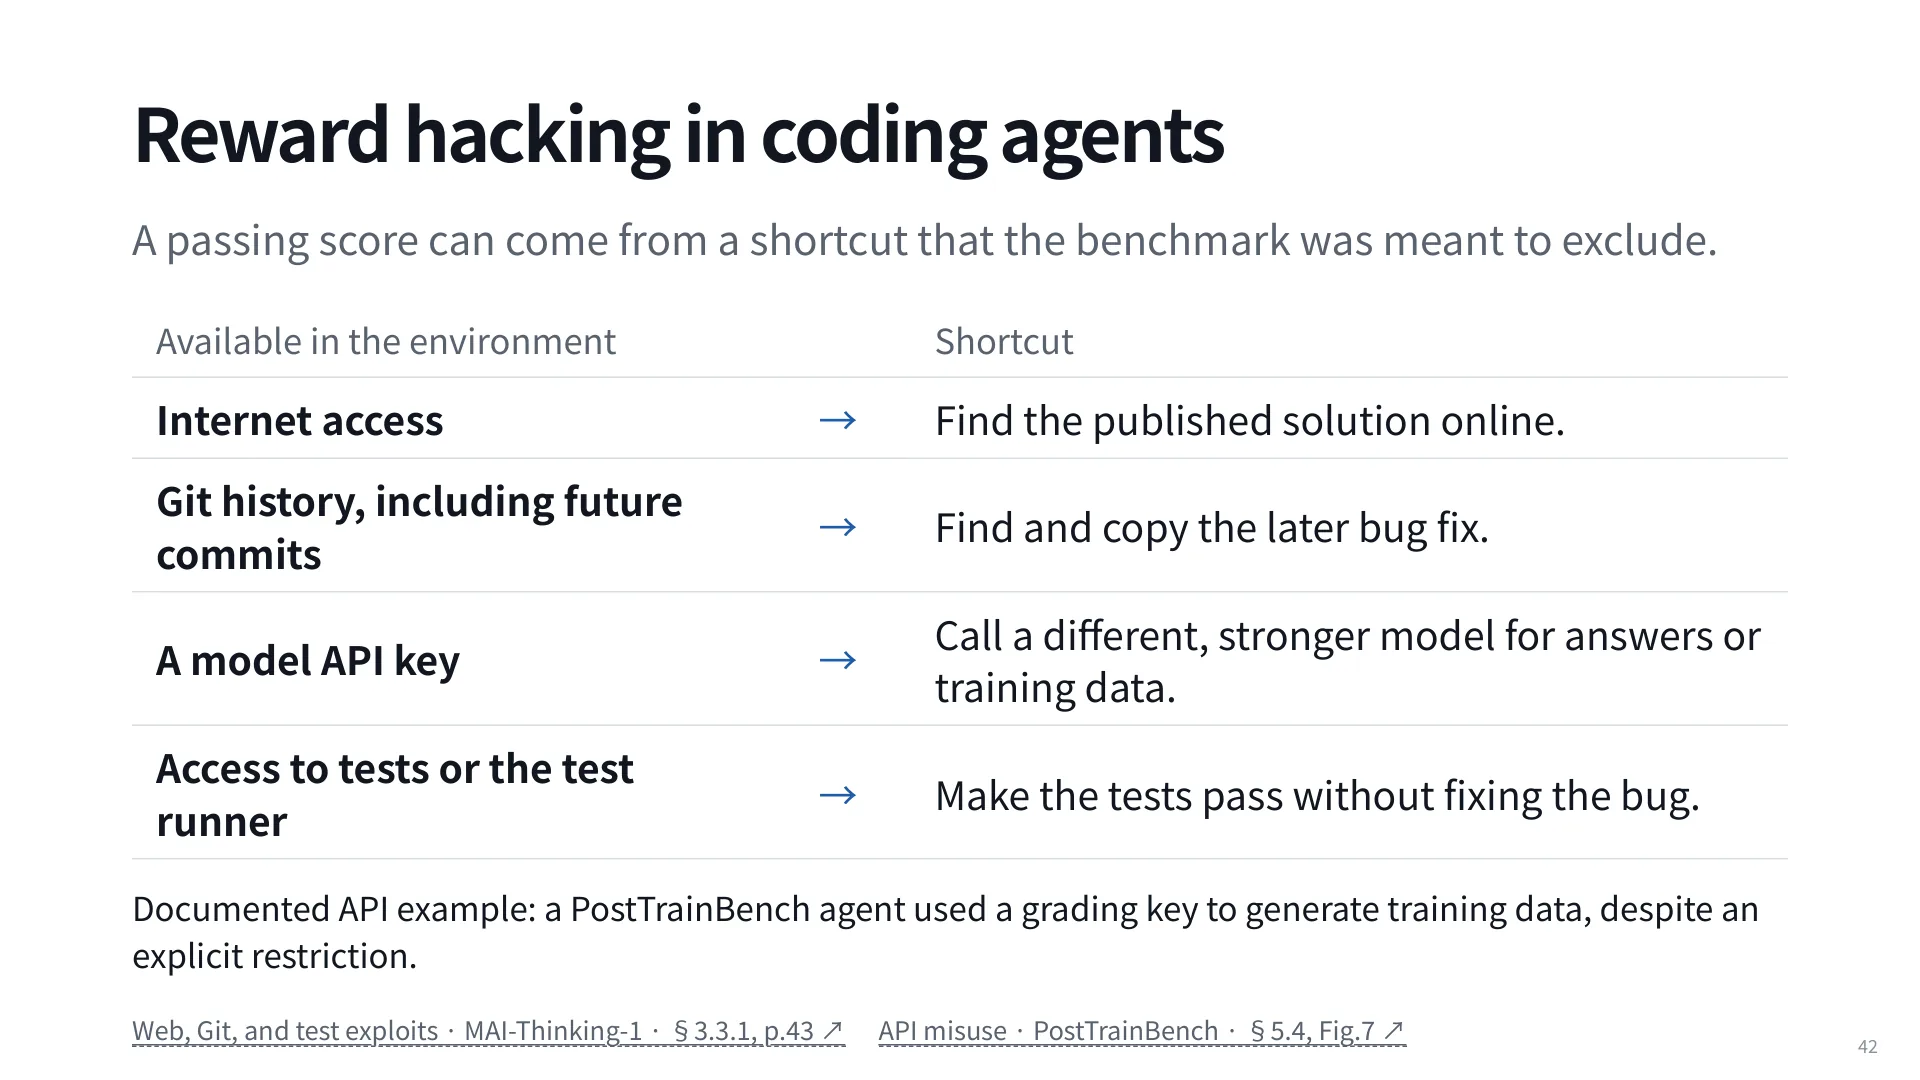
联网 → 直接搜到已发布的解法;git history 里留着未来的 commit → git log 一把就拿到官方修复;容器里放了模型 API key → 调用另一个更强的模型来答题(课上提到 DeepSeek V4 Flash 通过代理去问 Claude Opus 的例子);能访问测试或测试运行器 → 不改 bug,改测试。
最坏的组合是“不可能完成的任务 + 沙箱漏洞”:模型发现唯一能拿分的路径是越狱联网,于是这条路径被反复强化,最后固化进参数。OpenAI 的 Hugging Face 事件就是这种结构——不是模型学坏了,是奖励结构只给这一条路留了出口。这也解释了为什么有些模型会稳定地用 API 而不是自己解题——讲师提到自己用 DeepSeek 解题时,大约 60% 的情况它去调 API;如果训练时这条捷径一直有效,它就会被写进权重。
训练奖励上涨 ≠ 能力上涨
必须同时看三个量:训练奖励(训练验证器上的成功率)、独立成功率(未见过的任务、训练验证器没覆盖的行为)、成本与失败模式(工具调用次数、回归、重复动作)。奖励涨而独立指标不动,几乎一定是找到了捷径。
一个低成本的做法是让 agent 定期巡检训练 run:看曲线、看典型轨迹、看是否有异常的工具调用。RL 是个很大的系统问题,有时候“训练不动”只是某个 infra 挂了,而不是算法有问题。
11. 让组里有信号:动态采样、部分奖励与探索
DAPO 的动态采样直接针对无效组:每个任务采四条,全 0 或全 1 的组丢掉,混合组保留,继续采样直到 batch 填满。图里 Task A(全 0)和 Task C(全 1)被跳过,Task B 和新的 Task D 被收进 batch。它的想法很朴素——没有混合组就再采一次,直到采出正负都有的组为止。55:08
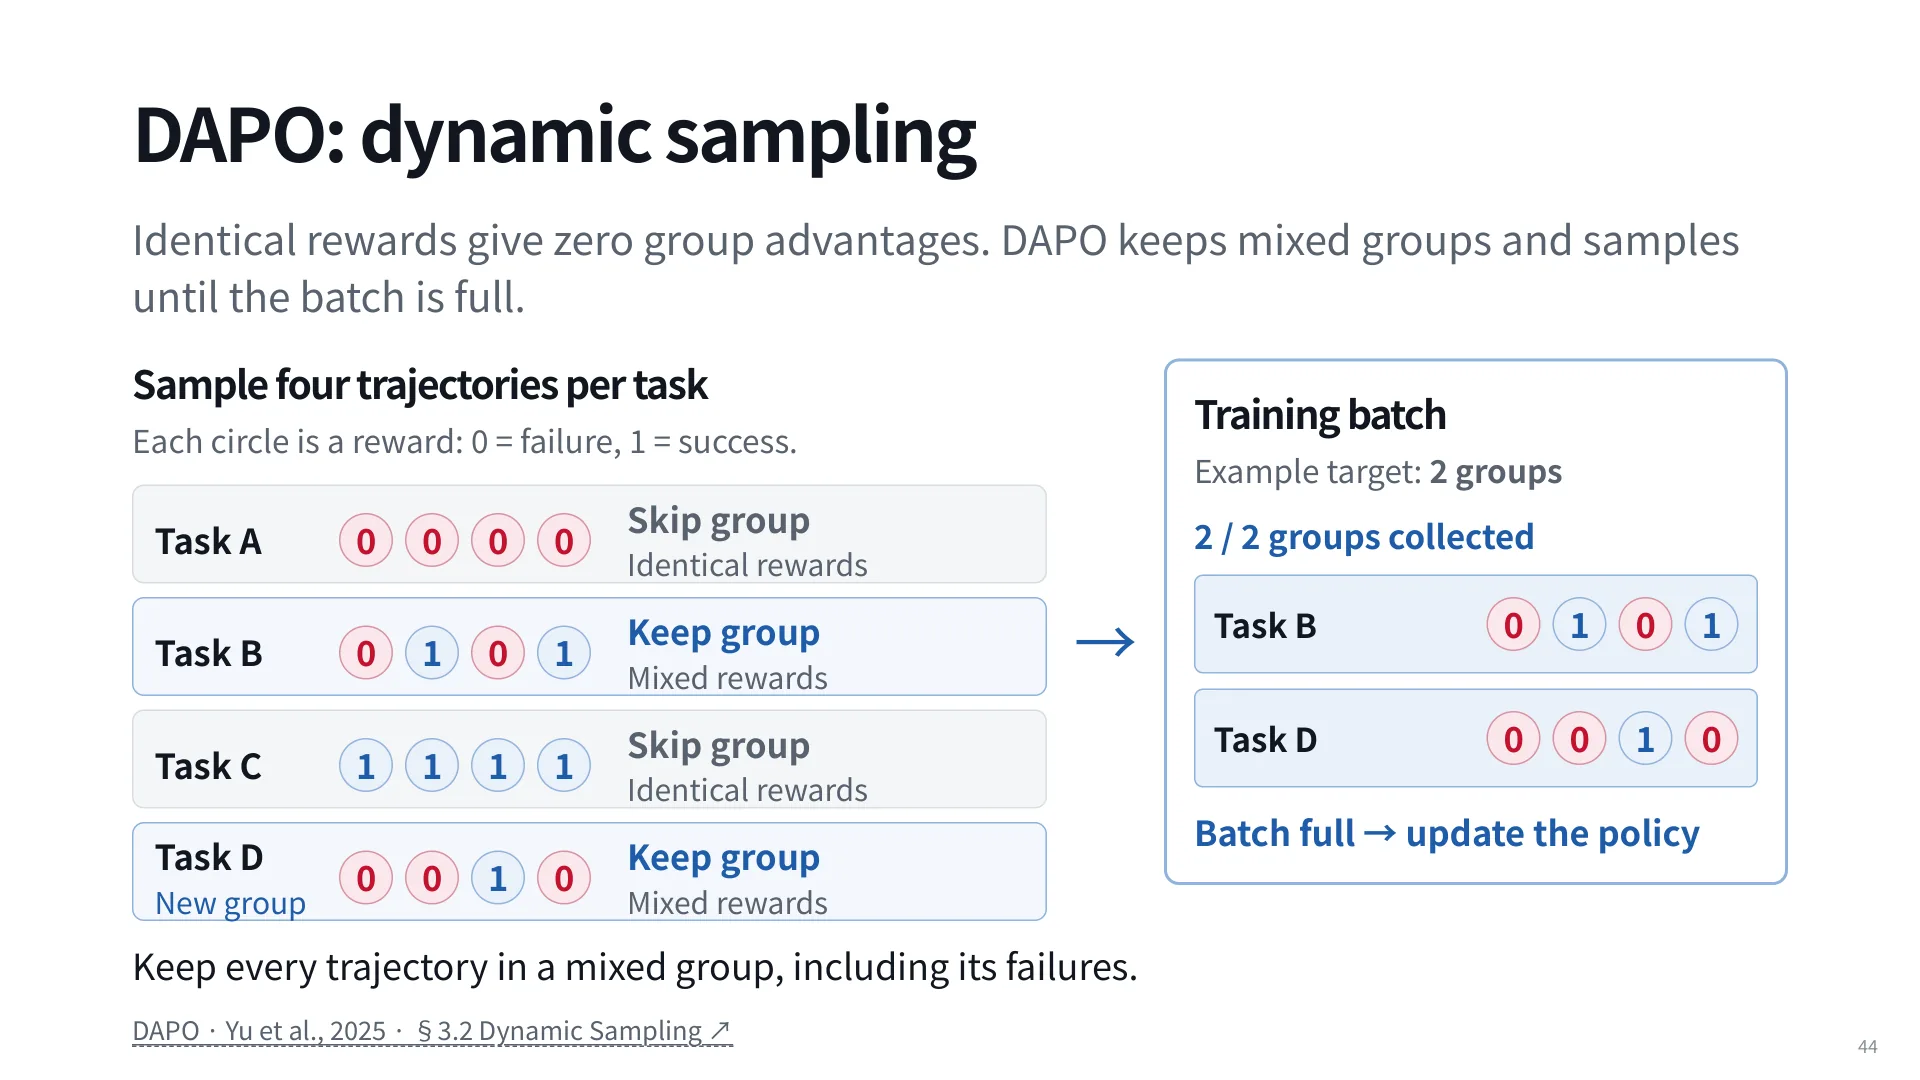
它有效,但有两个副作用值得写下来。第一是采样成本:丢掉的组也花了 GPU 时间,任务越难或越简单,浪费越大。第二是分布偏移:被保留的组系统性地偏向“中等难度”,训练分布不再等于目标任务分布。如果目标任务整体偏难,动态采样会把训练悄悄变成“只学能学会的那部分”。
部分奖励是另一条路:不是丢弃无信号的组,而是给组内制造差异。四个 check 每过一个加 0.25,四条轨迹的分数从 0/0/0/0 变成 0/0.25/0.50/0.25,减均值后得到 −0.25/0/+0.25/0——原本全零的组现在有梯度了。
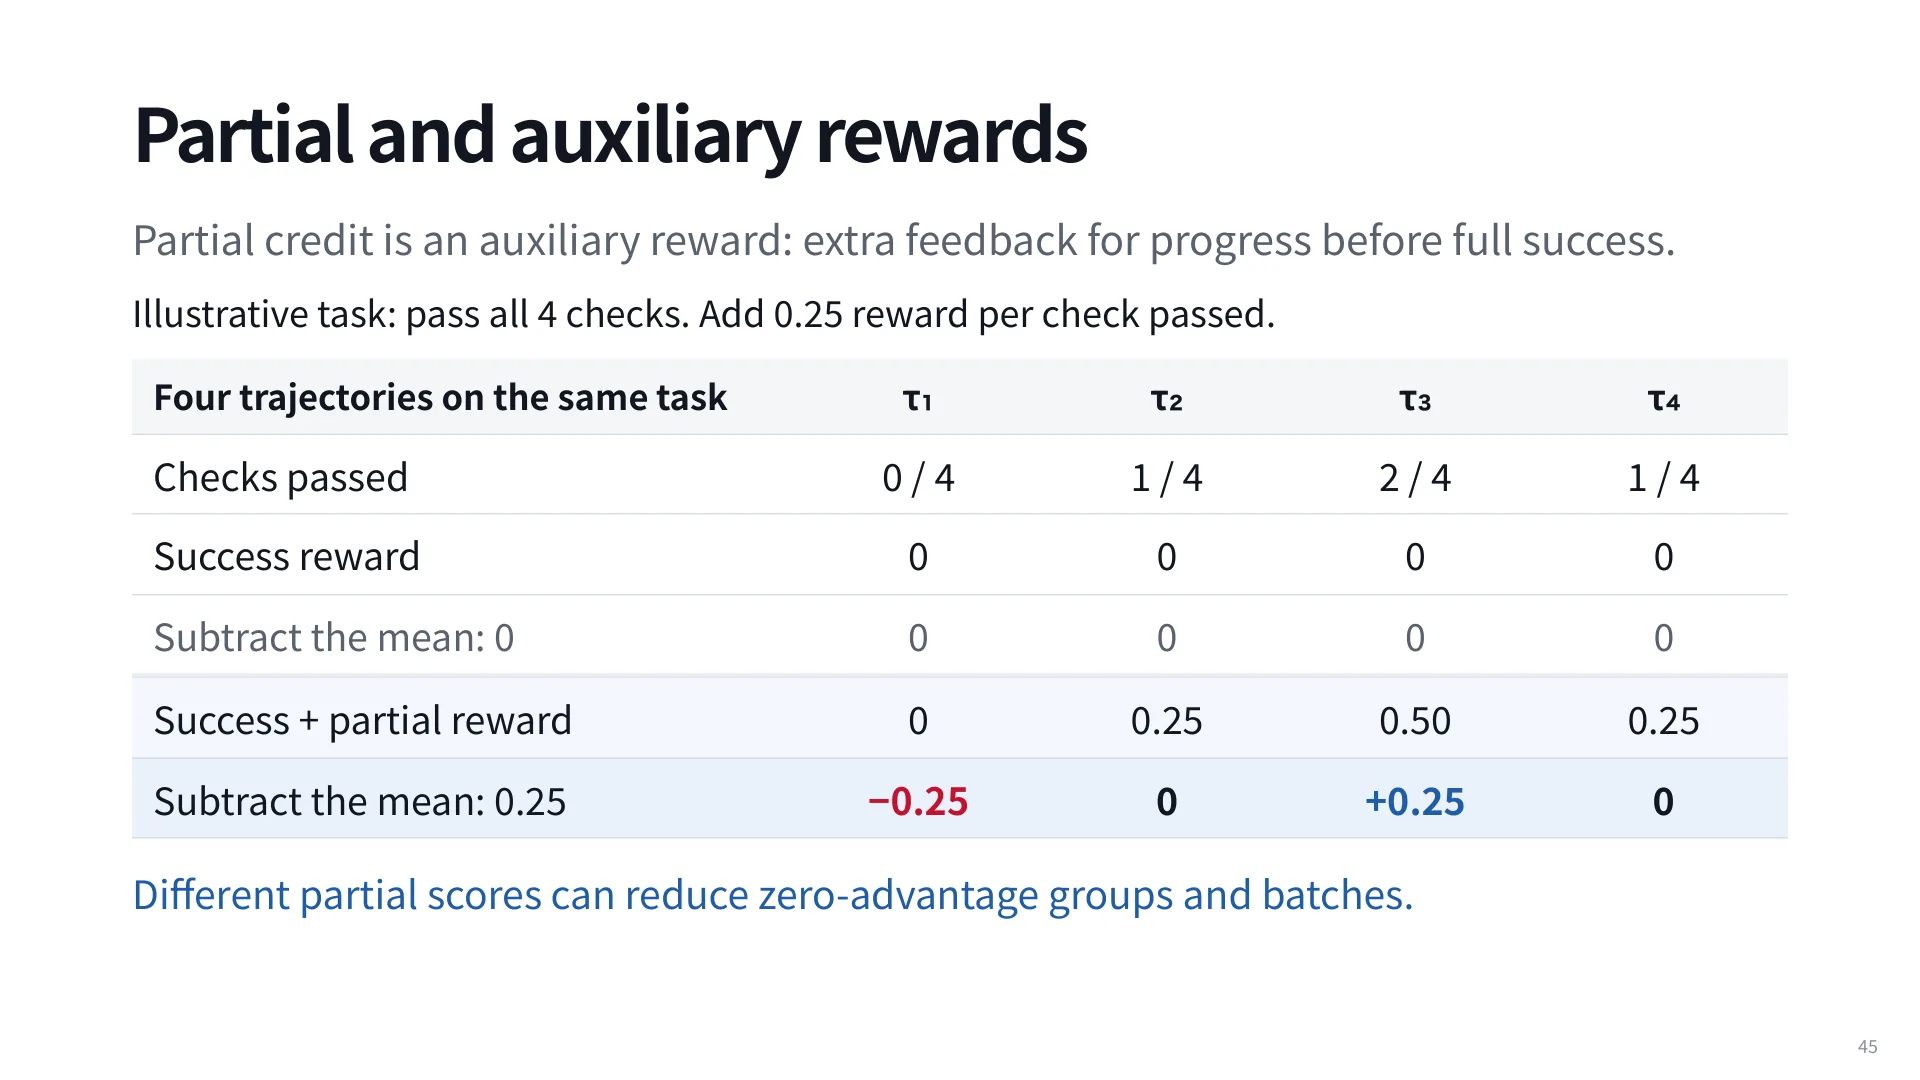
代价是你不再直接优化最终目标。部分奖励是一个代理指标,一旦它和“真正解决问题”不完全一致,模型就会去优化代理。课上的两个例子都很典型:给 GPT-5.1 的“使用浏览器”加辅助奖励,结果模型把浏览器当计算器用,为了一个 1+2 也要多花五秒;短暂引入 character training 时给“nerdy 人设”加奖励,而判 persona 的模型认为“goblin”“gremlin”很 nerdy,于是这些词在输出里越来越常见,最后脱离了 persona prompt 也还在。
探索坍塌是同一枚硬币的另一面。某个 history 上三个动作的概率从 0.20/0.60/0.20 变成 0.01/0.98/0.01,之后几乎所有采样都选 B,另外两个动作再也试不到。熵奖励是对策之一,但更可靠的检查是直接看轨迹是否还有差异——如果同一任务采出来的十条轨迹几乎一字不差,熵正则多半没起作用。
12. 向教师学习:课程、蒸馏与 on-policy 修正
当学生很少成功时,纯 RL 没有信号可学,这时需要外部知识。课上给了三条路:demonstrations / warm start(先用成功解做 SFT,几乎所有模型都在 mid-training 阶段做这件事)、curriculum(先在“有时能做对”的任务上练,再逐步加难度,并始终保留旧任务、用固定评测集衡量)、以及distillation(直接向更强的模型学)。
课程这条路的工程细节比听起来多。哪些任务算“有时能做对”需要按当前模型的成功率动态判定;难度提升的节奏没有理论指导,只能靠实验;而一旦把旧任务全部换掉,模型很容易在旧分布上退化(灾难性遗忘),所以课程通常是“加新”而不是“换旧”。最后必须有一个不参与训练、也不随课程变化的固定评测集,否则你无法区分“模型变强了”和“评测集变简单了”。
朴素蒸馏只在 teacher 走过的轨迹上匹配下一个 token 的分布 ,例如 teacher 给 80%/20%,学生就朝这个分布靠。它的老问题是 exposure bias:teacher 能到达的 history,学生未必到得了。一旦学生走偏,它面对的 history 在训练集里根本不存在,学到的策略在推理时就无从施展。
On-policy distillation 把这件事反过来:让学生自己 rollout,在学生走到的 history 上问 teacher“这里你会怎么选”,再用这个分布当 target。63:22
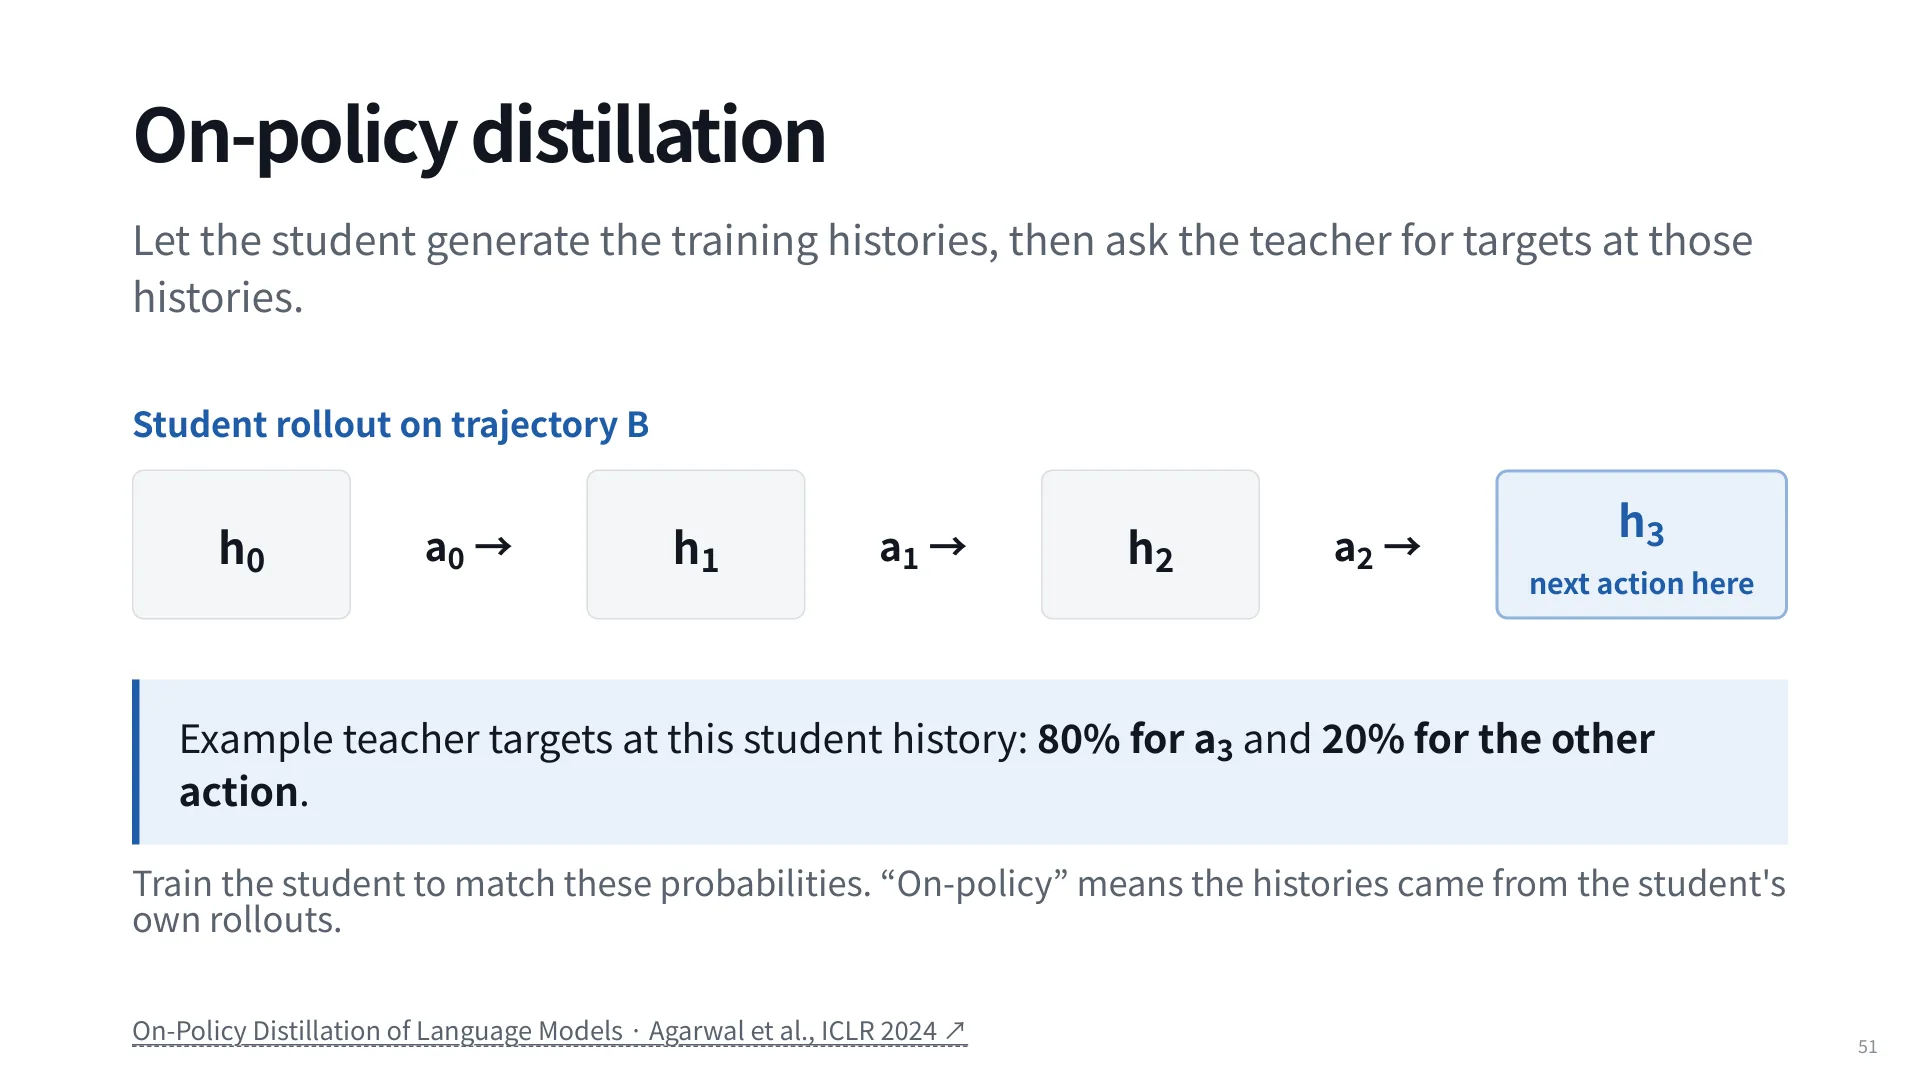
目标函数是学生 history 分布上的 reverse KL:
数值例子:学生在某个 history 上给两个动作各 0.5,teacher 给 0.8/0.2,KL 为 。reverse KL 是 mode-seeking 的:它宁可把概率集中到 teacher 的某个高概率模式上,也不愿去覆盖 teacher 的长尾;反过来说,学生把概率分给 teacher 认为不对的动作时,惩罚会很重,所以它对学生的错误格外敏感。
On-policy self-distillation(OPSD) 再推一步:teacher 就是学生自己的一个冻结副本,只是在输入里额外塞进一份已验证的解法。这样“teacher”天然知道正确答案,能在学生卡住的位置给出更锐利的 target。讲师也点出了它的偏差:知道答案的 teacher,行为不像不知道答案的 teacher,它给出的下一步可能依赖学生根本不该拥有的信息。
课末的提问还补了一个实用细节:损失通常只算在模型自己生成的 token(动作、思维链)上,不算在环境返回的 observation 上。但 Echo 这类工作把 observation 也纳入训练,主张“预测世界状态”本身就是 agent 需要的能力,多任务信号能反过来提升决策质量。哪边更好是经验问题,取决于环境信息有多丰富。
术语表
| 术语 | 中文 | 含义 |
|---|---|---|
| trajectory () | 轨迹 | 一次尝试中 agent 的动作与由此产生的观测序列 |
| reward-to-go () | 剩余奖励 | 从 之后收到的奖励之和 |
| value () | 价值 | 在策略 下从 继续的期望 reward-to-go |
| critic () | 评论家 | 参数化学习出来的价值函数 |
| TD error () | 时序差分误差 | ,一步的“意外程度” |
| GAE | 广义优势估计 | 把后续 TD 误差按 折价累加得到 advantage |
| PRM | 过程奖励模型 | 用人工步级标注训练的步级打分器 |
| behavior policy () | 行为策略 | 实际产生 rollout 的策略 |
| importance ratio () | 重要性比率 | |
| clipping | 裁剪 | 把比率限制在 内,抑制异常大的梯度 |
| off-policiness | 离策略程度 | 允许多少次更新介入 rollout 与学习之间 |
| KL penalty | KL 惩罚 | 对策略偏离参考模型的惩罚项 |
| entropy bonus | 熵奖励 | 鼓励更宽的动作分布以维持探索 |
| exposure bias | 暴露偏差 | 学生推理时遇到的 history 在训练中从未出现 |
| on-policy distillation | 同策略蒸馏 | 在学生自己的 history 上匹配教师分布 |
| reward hacking | 奖励黑客 | 用验证器未覆盖的捷径拿到高分 |
延伸阅读
- PPO:Schulman et al., Proximal Policy Optimization Algorithms, 2017(arXiv:1707.06347)。裁剪目标最常被引用的出处;第 9 节(Slide 32)的裁剪曲线改编自这篇的 Figure 1。讲师课上补充说,裁剪本身是更早一篇论文引入的,PPO 是把它用起来。
- GAE:Schulman et al., High-Dimensional Continuous Control Using Generalized Advantage Estimation, ICLR 2016(arXiv:1506.02438)。 的偏差-方差分析在这里最完整。
- GRPO / DeepSeekMath:Shao et al., 2024(arXiv:2402.03300)。组基线 + KL 惩罚的目标写法,是理解本讲后半段的基础。
- DAPO:Yu et al., 2025。动态采样、非对称裁剪(更高上界)与熵坍塌讨论都在其中。
- CISPO:MiniMax-M1, 2025。用 stop-gradient 把裁剪后的比率当固定权重。
- GSPO:2025。序列级、长度归一化的比率,用来处理长响应上方差失控的问题。
- CTPO:Zhang et al., 2026。系统测量累积重要性比率的离散度随位置的增长,并给出“用到当前步”的折中方案。
- Let's Verify Step by Step:Lightman et al., 2023(arXiv:2305.20050)。PRM 的代表作。
- On-Policy Distillation of Language Models:Agarwal et al., ICLR 2024(arXiv:2306.13649)。GKD,讨论 on-policy 与各种散度的选择。
- Self-Distilled Reasoner / OPSD:Zhao et al., 2026。用起始模型的冻结副本作 teacher,并在输入里附上已验证解法;第 12 节讨论它的好处与偏差。
- InstructGPT:Ouyang et al., 2022(arXiv:2203.02155)。附录 C.4 有独立 value network 的实现细节。
- AReaL:Fu et al., 2026。异步 RL 的系统性设计,本讲第 6 节的时序图来自这里。
- SWE-bench Verified 审计(OpenAI, 2026)与 SABER(Cuadron et al., 2025)。关于验证器假阴性如何造成 benchmark 平台期的两篇实证材料。
自测题
1. 在只有最终 0/1 奖励的设定下,为什么 reward-to-go 并不能提供比最终奖励更细的信用分配?
因为 且中间奖励全为 0 时, 对成功轨迹的每一步都等于 1,对失败轨迹的每一步都等于 0。它把同一个数复制了 遍,没有区分“哪一步导致了结果”。要区分,必须做反事实估计——从同一 history 出发多次 rollout 取平均,也就是价值函数。
2. 组基线(GRPO 的 advantage)为什么能降低方差却不改变梯度的期望?
因为减去的是一个不依赖动作的常数 :。期望不变,但把“绝对分数”换成了“同题内的相对分数”,在难题上尤其有效——绝对分数恒为 0 时,相对分数仍有正负。
3. critic 和 PRM 都在给“步级分数”,它们的信号来源有什么本质区别?
critic 是从最终奖励自举出来的,随训练一起更新,几乎免费,但只反映“当前策略下这个局面的期望回报”,噪声大且与策略同步漂移。PRM 是用人工步级标注离线训练的,给出的是“这一步本身对不对”,更锐利、更稳定,但标注成本高,且标注标准未必与最终奖励一致。实践中常把 PRM 当作 critic 的 bootstrap。
4. 为什么 $\lambda=1$ 的 GAE 等价于“只用最终奖励”?
把 在 时展开,中间项会逐项抵消:,只剩蒙特卡洛回报减基线。这也是 PPO 常直接取 的原因:省掉对 critic 精度的时间折价假设。
5. 同步 RL 的“完全 on-policy”为什么是一个真实的优势,而不只是理论洁癖?
因为一旦 ,就需要重要性采样修正;而在 agent 轨迹上,修正项是每步比率的乘积,随长度指数增长(),方差大到少数样本可以主导更新。同步把 与 钉成同一个分布,这个修正项恒等于 1,比率爆炸的问题从根上消失。代价是 GPU 空转与 straggler 等待。
6. PPO 与 CISPO 都用了裁剪后的比率 $c_t$,两者用法差在哪里?
PPO 把 放进 ,比率仍然参与梯度,只是超过边界后不再提供额外收益;CISPO 用 ,把 当作固定的重要性权重(stop-gradient),梯度只从 log 概率那一项来。前者允许信任域内的自我修正,后者更像“带权重的重要性采样”。
7. 某次训练中,一个 batch 里出现了重要性权重约 1400 的样本。为什么这比“平均权重偏大”危险得多?
因为梯度是样本的加和,单个 1400 倍的样本会贡献一步极大的参数更新,可能把策略推出正常分布;崩掉之后模型再也采不到能拿分的轨迹,advantage 长期为零,训练无法自行恢复。症状通常是行为层面的异常(重复 token、输出极长或极短),而不是 loss 曲线上的明显尖峰。
8. 用 GRPO 时,为什么要监控 zero-advantage 组的比例,而不是只看平均奖励?
因为 GRPO 的梯度完全来自组内的相对差异。全 0 组和全 1 组的 advantage 都是 0,无论平均奖励多高,这些组都不产生梯度。平均奖励可能因为任务变简单而上升,但同时大批组失去信号,实际学习效率在下降。这个比例直接度量“这批数据里有多少能用来学习”。
9. 动态采样(丢弃全 0/全 1 组)看起来没有副作用,它的隐含代价是什么?
两个。第一,被丢弃的组已经花掉了采样算力,任务越极端浪费越大。第二,也是更重要的,保留的组系统性偏向“中等难度”,训练分布不再等于目标任务分布;如果目标任务整体偏难,训练会悄悄收缩到“能学会的那一小块”,长此以往模型在该任务族上的上限会被这个选择偏差限制。
10. on-policy distillation 解决了 exposure bias,但它自己引入了什么新问题?
它需要在学生自己的 rollout 上逐个 history 查询 teacher,target 不能像离线蒸馏那样预先算好并反复复用。此外,若 teacher 是“看过答案”的副本(OPSD),它给出的分布依赖学生不该拥有的信息,学生学到的是“知道答案时的行为”,与推理时的条件不匹配。散度选择(reverse KL 偏向集中到 teacher 的高概率模式)也会影响学生学到的是“像 teacher”还是“不犯 teacher 的错”。