
5b · Domains 3: Deep Research Agents
本讲速览
- Deep research 的本质是“信息需求超出单次检索能力”。当一个问题没有单一文档能回答时,系统必须反复规划、检索、反思,最后写成带引用的长答案;这与一次检索加一次生成的 RAG 是不同的物种。
- 经典 QA 基准在四个维度上失效:检索复杂度、领域专长、答案形态、证据支撑。近三年的基准基本上是逐条补齐这四个缺口。
- 把问题造难是有代价的:BrowseComp 从答案反推线索,题目接近谜题;为了可复现,BrowseComp-Plus 干脆冻结语料,把“开放网络”换成 830 题 / 10 万篇文档的封闭世界。
- 长文答案不能用相似度评。ROUGE/BERTScore/BLEURT 选出的“更好答案”只有 57%–62% 与专家偏好一致,接近抛硬币;rubric(评分细则)是当前主流替代方案,但 rubric 本身也会错,必须被审计。
- 训练配方是 mid-training → SFT → RL 三段式,数据来自知识图谱采样出的合成问题 + 强教师模型的轨迹;SFT 让模型“像教师一样做”,RL 让模型“从自己的尝试里学”。
- 短答案可以用 exact match 奖励,开放式报告不行。DR Tulu 用“随策略一起演化的 rubric”给报告打分,绕开“没有唯一正确答案”的困境。
- 检索底座是被低估的一环。传统检索器只看到最新 query,丢掉了 agent 的意图;把当前 reasoning 一起送进去并针对性训练,可以在更少检索次数下拿到更高准确率。
1. 定位:一次检索不够用的时候
这一讲接着 Domains 系列,把镜头从“单个任务上的 agent”移到“以信息获取为核心的长程任务”。Akari Asai 用一个非常朴素的对比开场:问她办公室号码(“What is Akari Asai's office number at CMU?”),打开 LTI 的教师主页就能看到 GHC 5507——一次搜索、一次抽取,RAG 流水线足够。
但“AI agent 能否像人类专家一样综合科学文献”这样的问题,没有任何单一页面能回答。要回答它,系统需要先想清楚“我需要找哪几类证据”,发出检索请求,读回一批论文,判断这些论文是否真的回答了问题,发现“这些研究的对照方式不同,基准分数高并不等于与人类专家持平”,于是改写查询再搜一轮。Akari 把这个循环概括为 plan → search → reflect → search again → synthesize,并把最终产物定义为“带外部引用的答案”。02:25
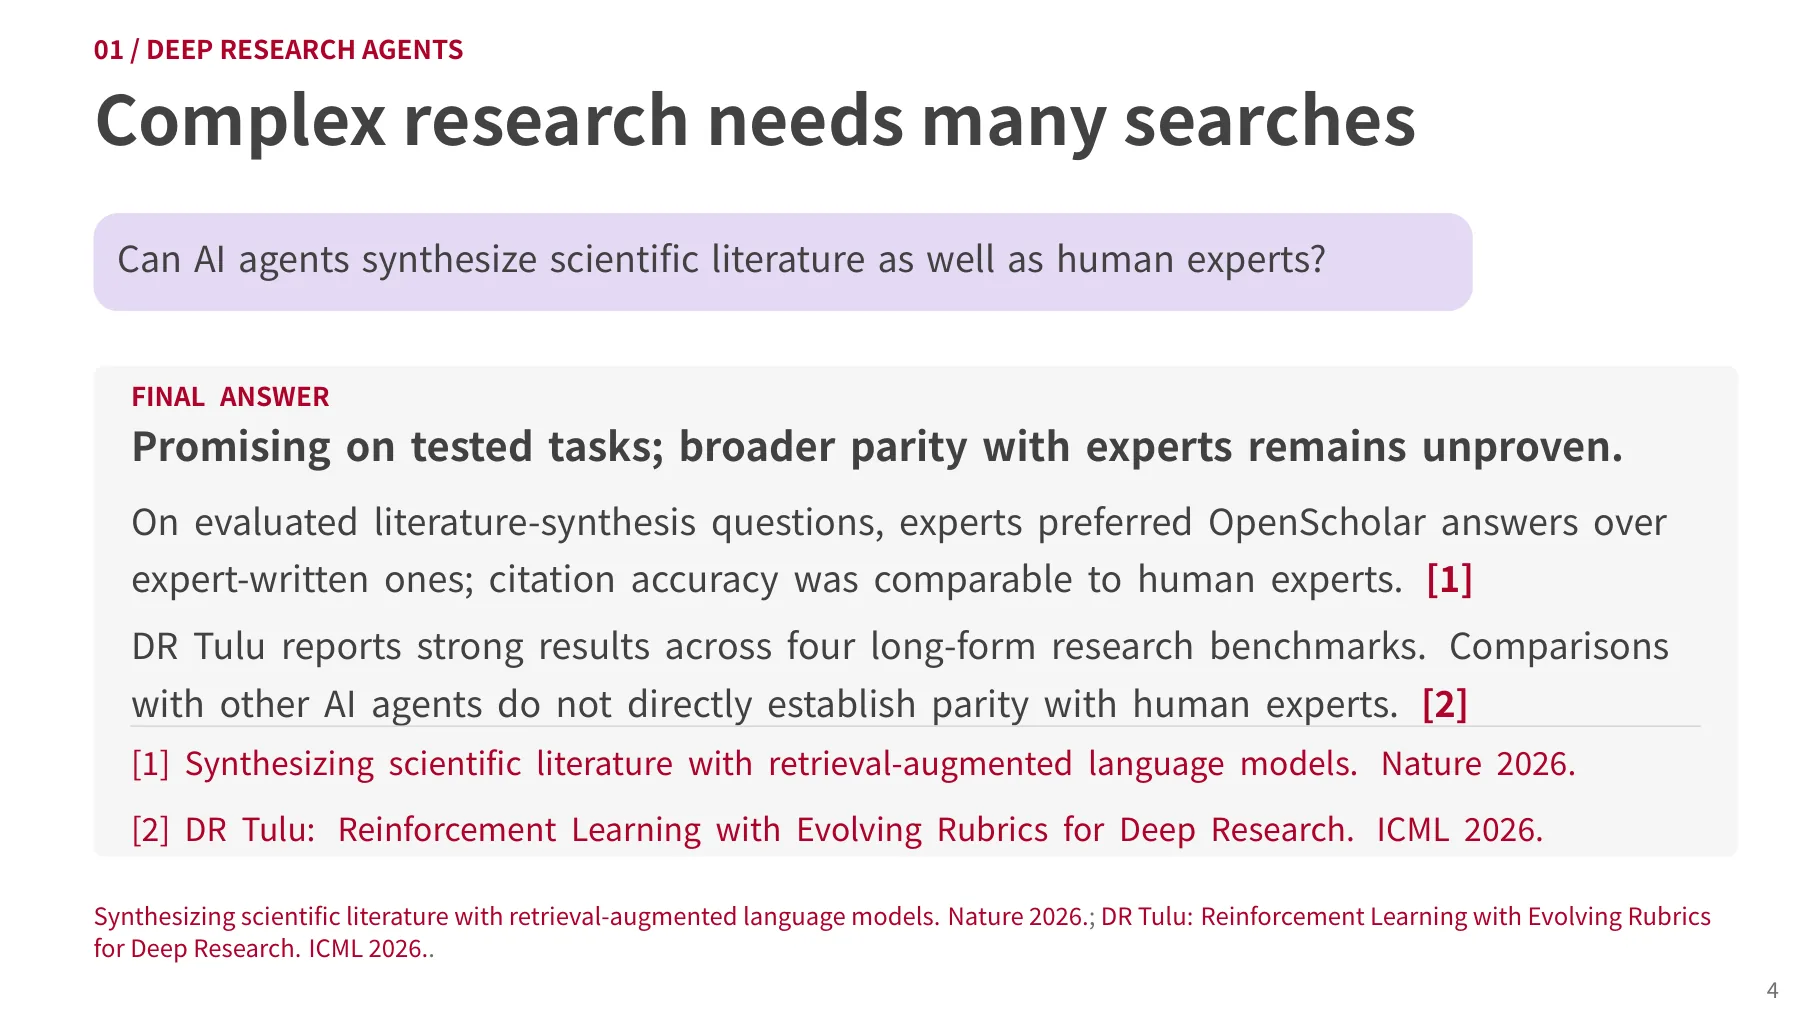
这张最终答案值得细看,因为它示范了 deep research 与“自信地胡说”的区别。答案的第一句是限定过的结论:“在已评测的任务上有希望,但与专家全面持平仍未获证明。”下面两条论据各自带编号引用:OpenScholar 在文献综合问题上被专家偏好,引用准确率与人类专家相当;DR Tulu 在四个长文研究基准上表现强,但“与其他 AI 系统比较”不等于“与人类专家持平”。这是一个把“证据支持什么”和“证据不支持什么”分开陈述的模板——也正是后面评测部分要反复量化的东西:结论的限定性(qualification)和引用支撑(citation support)。
理解这一讲的位置,可以借用课程的三分法(Slide 12):Evaluation(基准、rubric、引用支撑)、Modeling(学会搜索、推理、综合)、Retrieval(为下一步找到证据)。三者不是并列的技术模块,而是互为前提:没有可靠评测就不知道往哪优化;没有训练信号就学不会长程行为;没有好的检索,再强的策略也只能在噪声里打转。
本讲的主线
Deep research agent 的能力上限由三件事共同决定:基准是否真的测到了难点、奖励是否能表达“好报告”、检索器是否理解 agent 当下的意图。这三件事目前都还没有标准答案。
2. 经典 QA 基准的四个缺口
Natural Questions 是问答研究的基石:它收集真实用户的 Google 查询,标注者基于 2018 年前后的 Wikipedia 版本给出答案。“who wrote the score for the force awakens”的答案是 John Williams,证据是那一条 Wikipedia 修订版。04:01
这类基准的问题不在于“太简单”这个笼统判断,而在于它把四个维度同时固定在了低难度上。
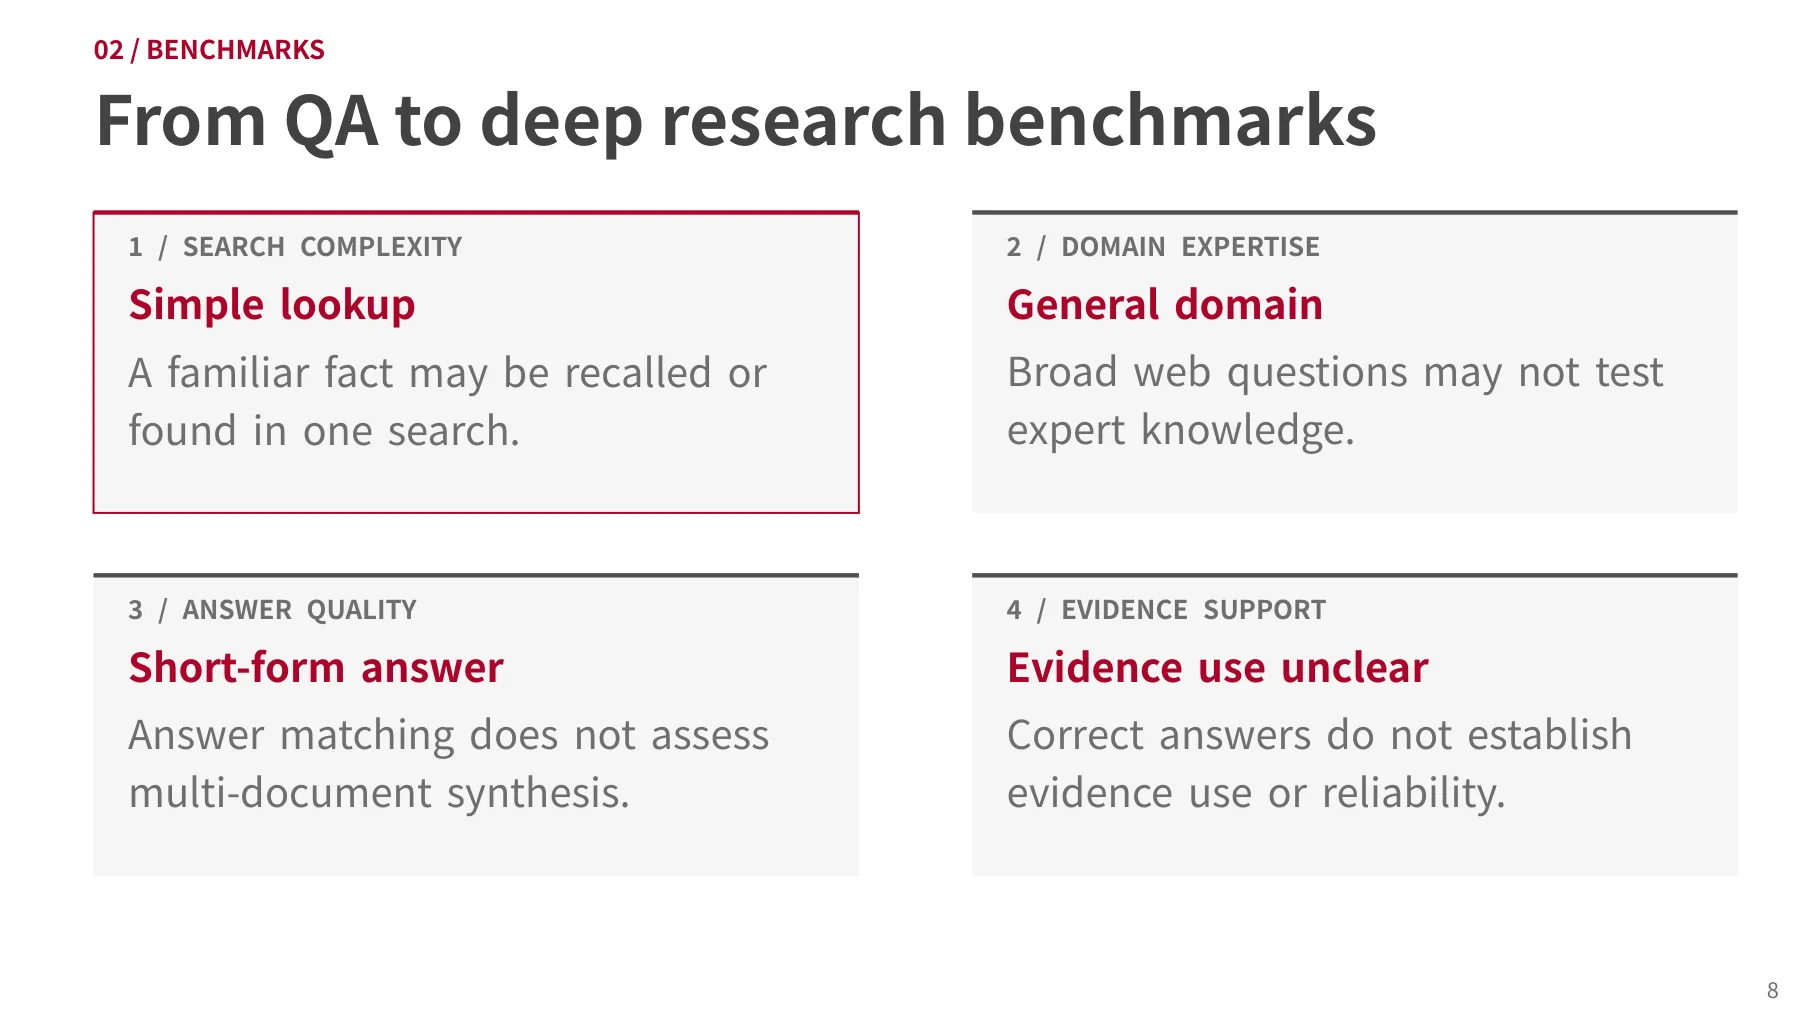
| 维度 | 经典基准的设定 | 为什么不足以描述 deep research |
|---|---|---|
| Search complexity | 一次检索即可命中 | 真实研究问题需要几十到上百次检索,且后一次检索依赖前一次读到的内容 |
| Domain expertise | 通用领域、娱乐体育为主 | 医学、金融、科研检索需要领域知识才能读懂证据、构造查询 |
| Answer quality | 短答案、实体匹配 | 研究报告是多文档综合,答案匹配无法衡量覆盖度与取舍 |
| Evidence support | 证据来源不明确 | 答对不等于用对了证据;没有引用就无法审计可靠性 |
值得强调的是第四点。传统 QA 只问“答案对不对”,而信息搜寻场景里,用户真正想知道的是“我凭什么相信这个答案”。这不是把评测变严格一点的问题,而是评测对象变了:从答案字符串变成答案加证据链。后面 DeepResearch Bench 的 FACT 框架、ScholarQABench 的 rubric,都是围绕这个转变设计的。
一个值得记住的区分:基准的难度是相对当时系统而言的。当一个基准被饱和,它往往不是“被解决了”,而是“被绕过了”——模型可能记住了答案,也可能只是学会了这个基准的题型。
3. BrowseComp:从答案倒着造题
要让问题“必须多次检索”,最干净的做法是反过来造:先选一个确定答案(某个人物、事件、器物),再把它拆成若干条互不重叠的事实线索,去掉名字,让线索共同唯一地指向答案。这就是 BrowseComp 的构造方式,1,266 道人工撰写的题目。06:25
造完之后要验证难度,分两道关:先用语言模型加检索去试,确保“直接问模型答不出”“五次 Google 搜索不够”;再抽一部分题让人类在十分钟内尝试,仍然解不出才算通过。
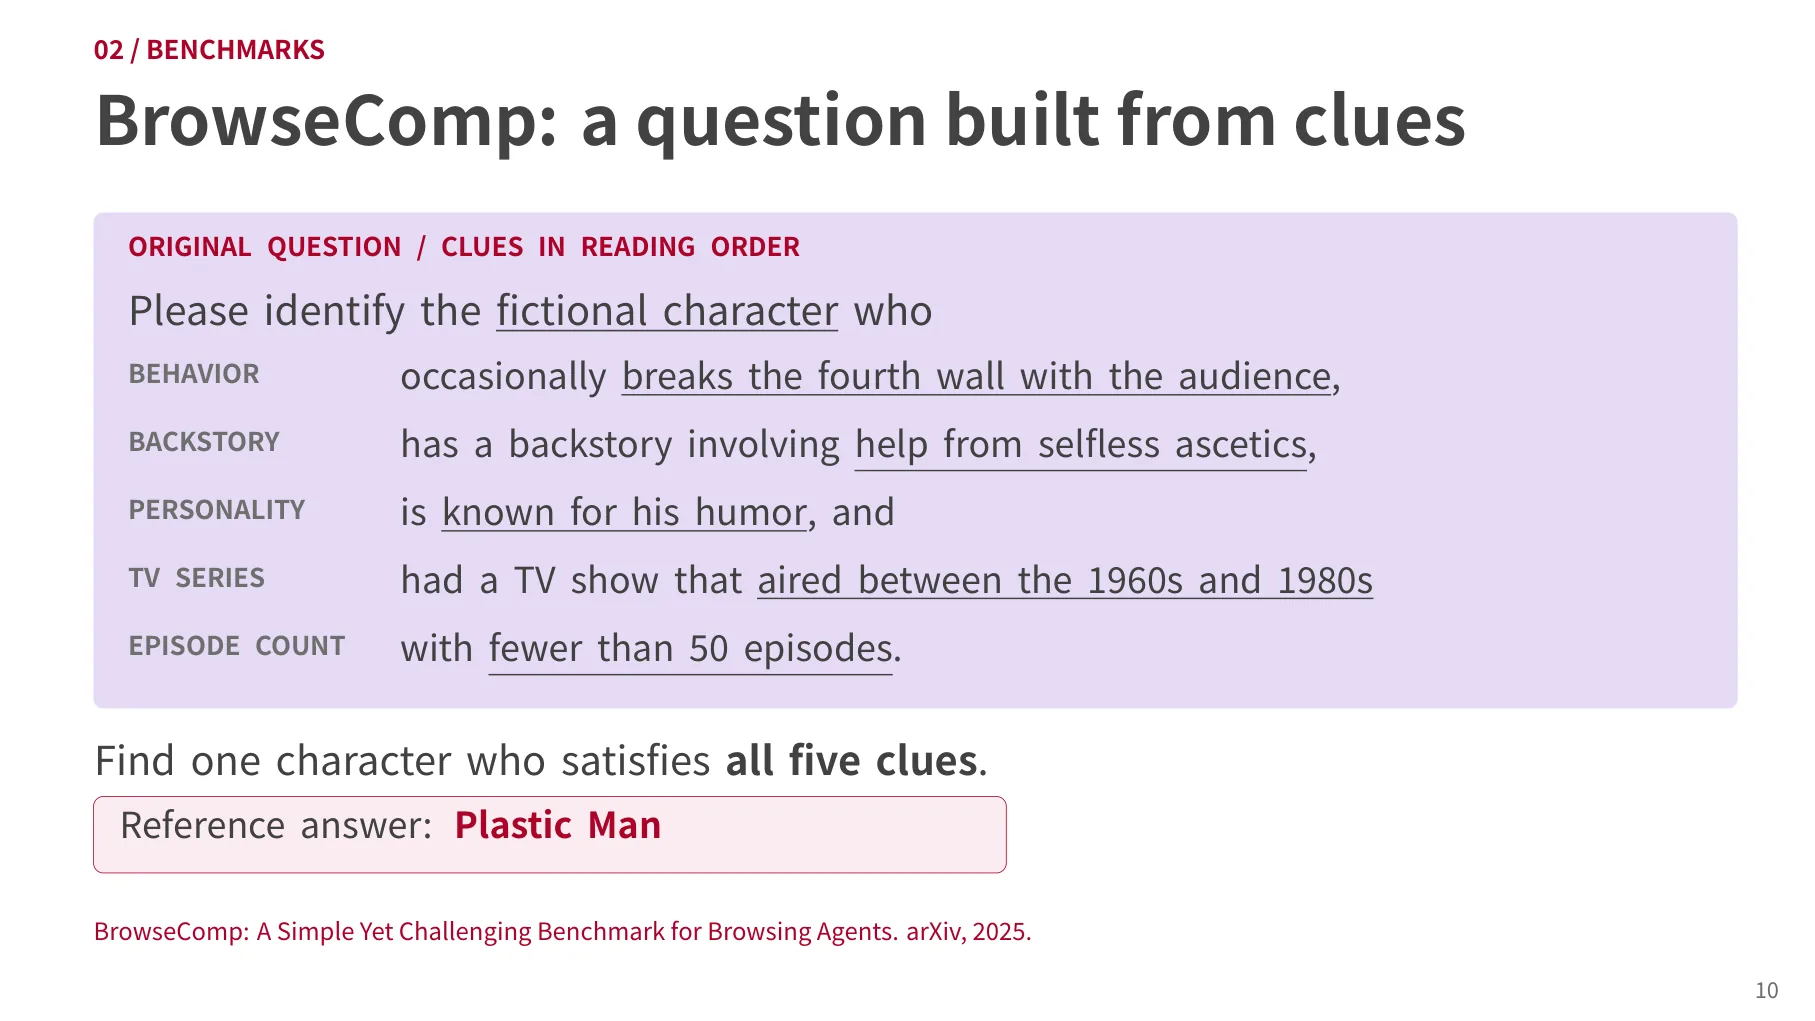
这道题的五个条件分别约束行为(偶尔打破第四面墙)、背景(受过无私苦行者的帮助)、性格(以幽默著称)、剧集(1960–1980 年代播出)、集数(少于 50 集)。单看任何一条都有大量候选,只有同时满足才唯一。答案“Plastic Man”是一个短实体,因此可以用“参考答案是否出现在模型输出里”来自动判分——这是它被大量使用的重要原因:难,但可验证。
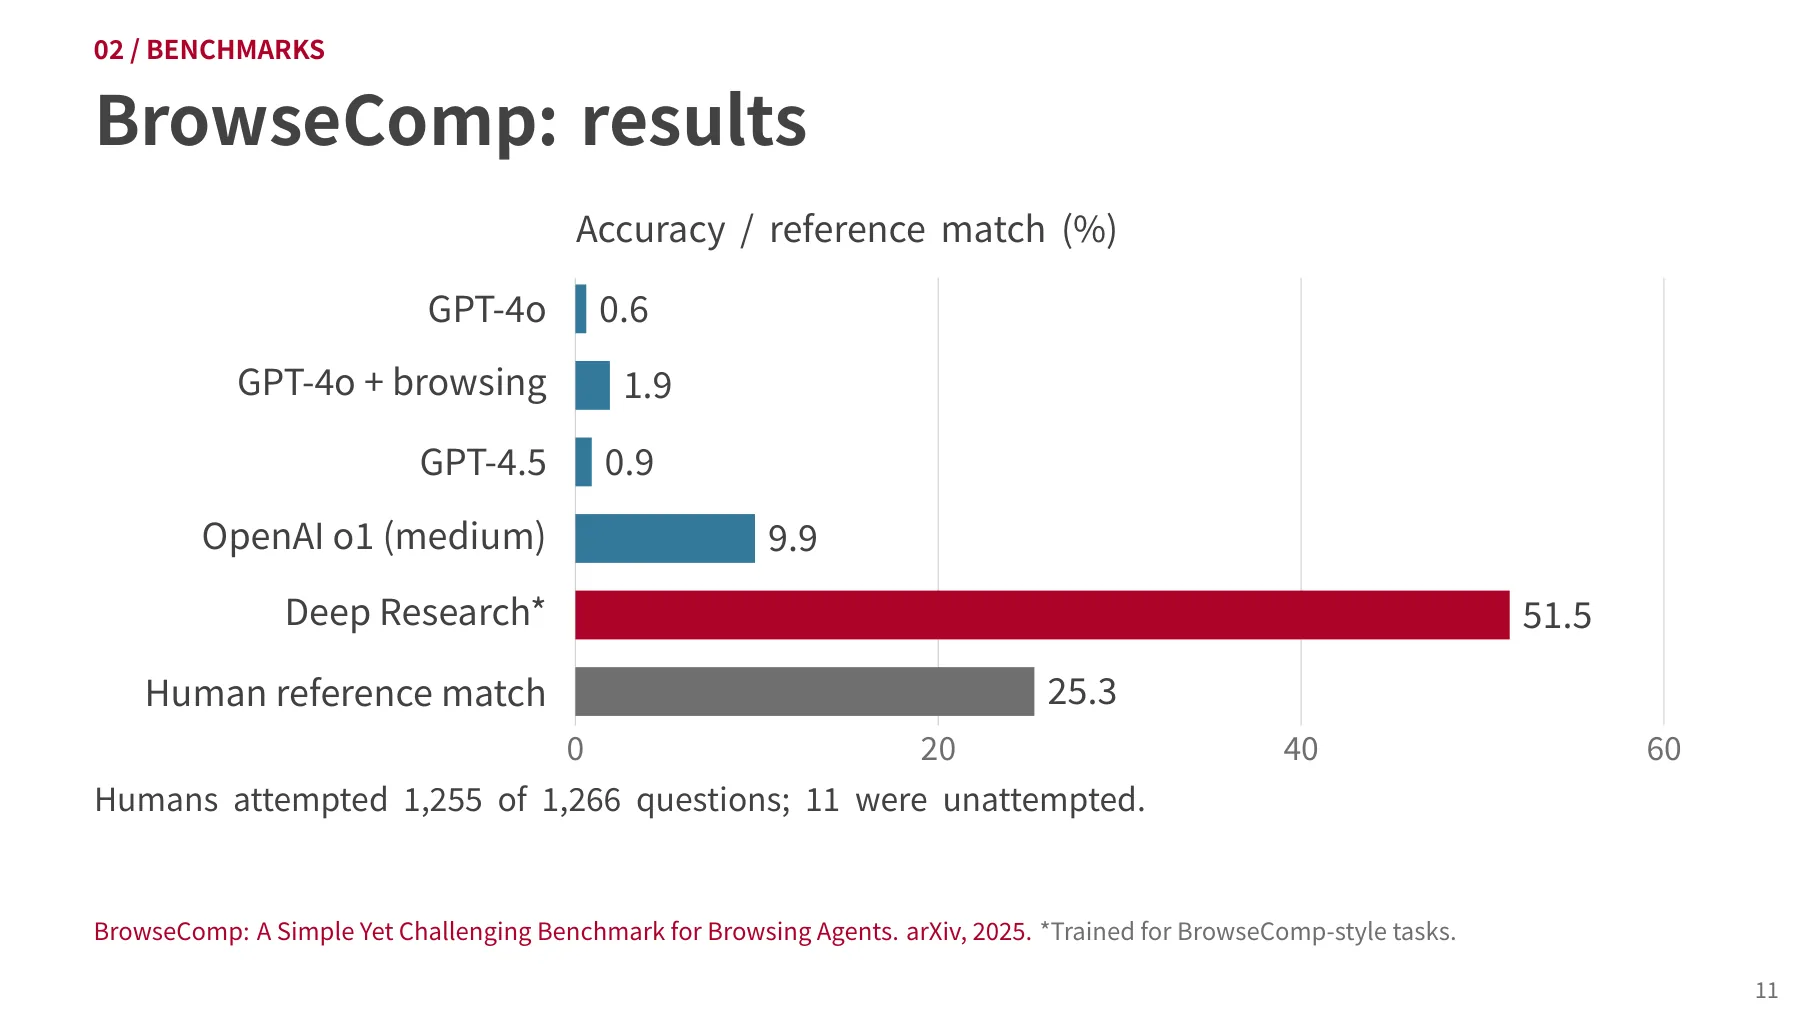
结果很有信息量,也有陷阱。GPT-4o 0.6%,加了 browsing 也只有 1.9%,GPT-4.5 0.9%,o1 (medium) 9.9%;而标星号的 Deep Research 拿到 51.5%——星号注明它“针对 BrowseComp 风格任务训练过”。人类在 1,266 题中尝试了 1,255 题(11 题未尝试),参考匹配为 25.3%。08:01
把 51.5% 与 25.3% 并排看,很容易误读成“AI 已经超过人类一倍”。更准确的读法是:人类不擅长做谜题,但擅长做研究。BrowseComp 测的是“在开放网络上做约束满足式搜索”的能力,人类受限于耐心和检索技巧;而模型的 51.5% 里,有多少来自通用研究能力、有多少来自对题型和分布的适配,课件没有拆开。这也是后面“基准污染”讨论的伏笔。
难度的另一面是成本。Tongyi DeepResearch 的消融显示:上下文上限设成 8K 时准确率几乎为 0,扩到 128K 才爬到 40% 左右;训练数据里超过 20% 的 SFT 样本含 10 次以上工具调用,评测时最多允许 128 次工具调用。
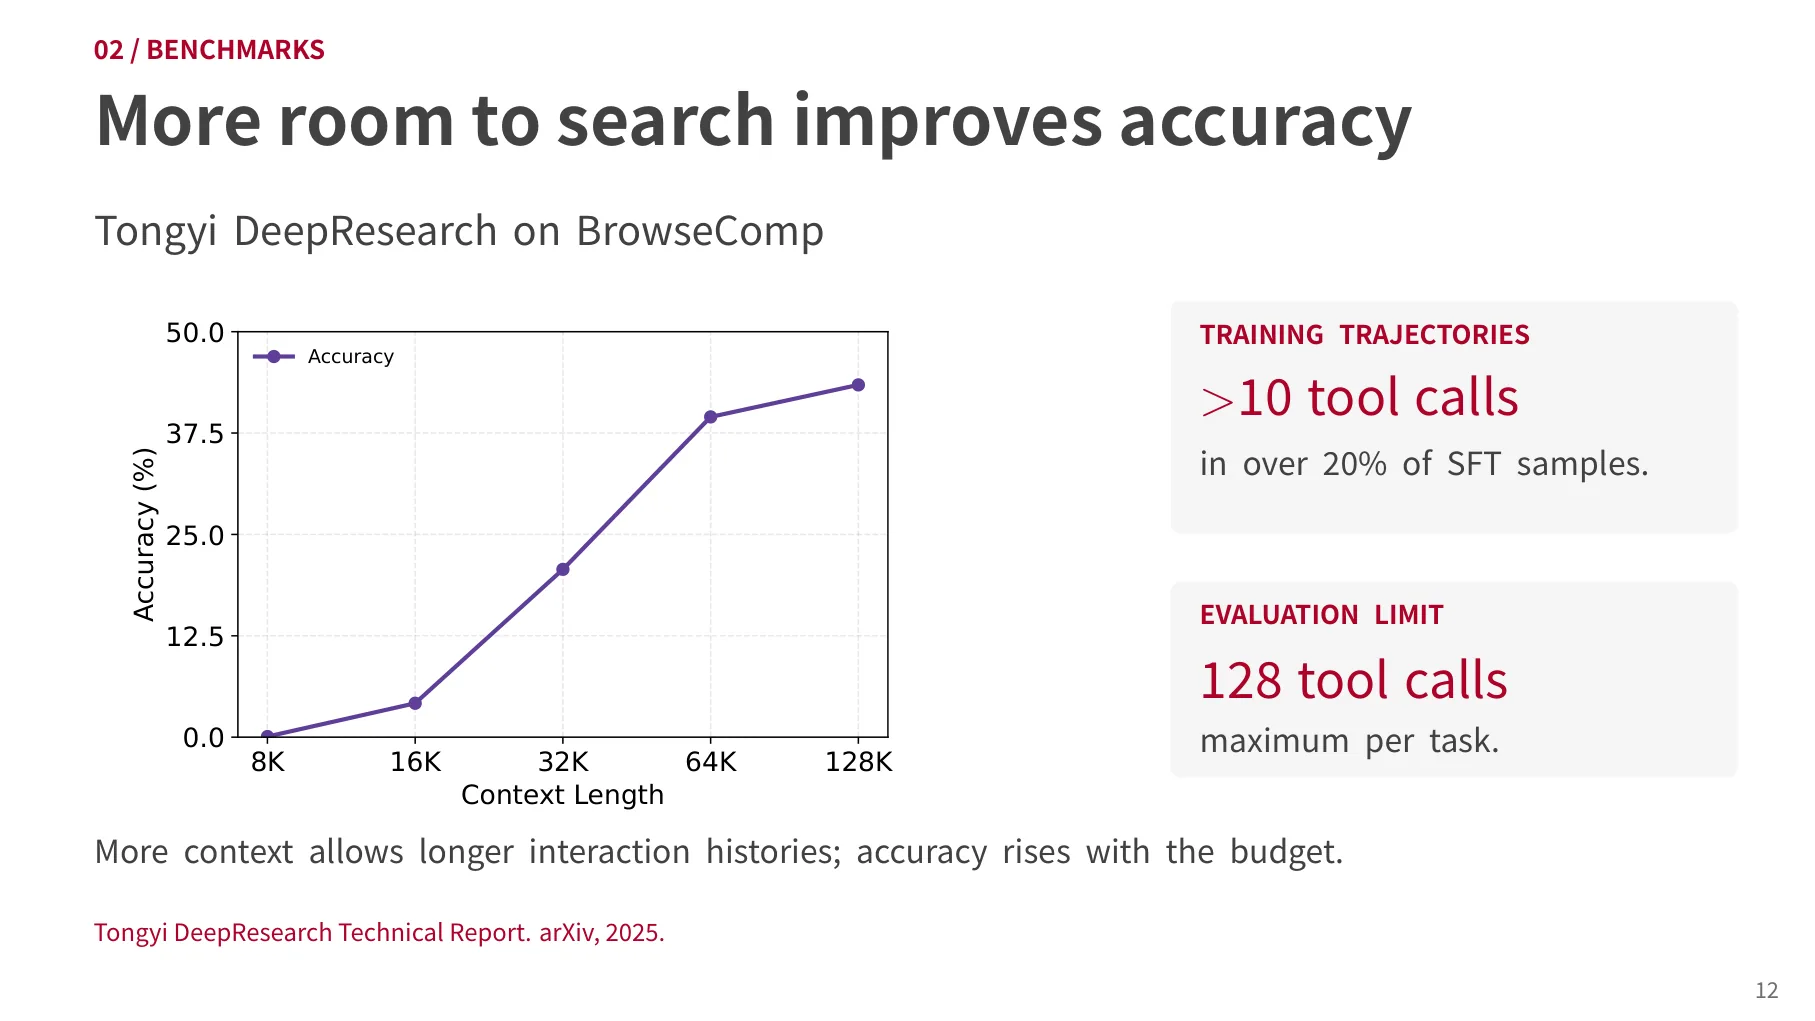
这条曲线解释了一个工程现实:deep research 的成绩是用 token 和工具调用买来的。每个任务上百次搜索,每次搜索要走外部 API,既慢又花钱;更麻烦的是生产级搜索接口的结果每天都在变,同一份轨迹今天能复现、下周就未必。可复现性因此成了评测问题,而不只是工程问题。
4. BrowseComp-Plus:把开放网络换成冻结语料
BrowseComp-Plus 的解法很直接:不再让 agent 访问真实网络,而是先为每道题准备一个固定的文档集合,让它在封闭世界里检索。构造分三步:用 o3 找出可能回答该题的证据页面;由人工标注 supporting spans、逐条核对线索、标出答案文档;再混入“看起来相关但缺一条线索”的 hard negatives。10:30
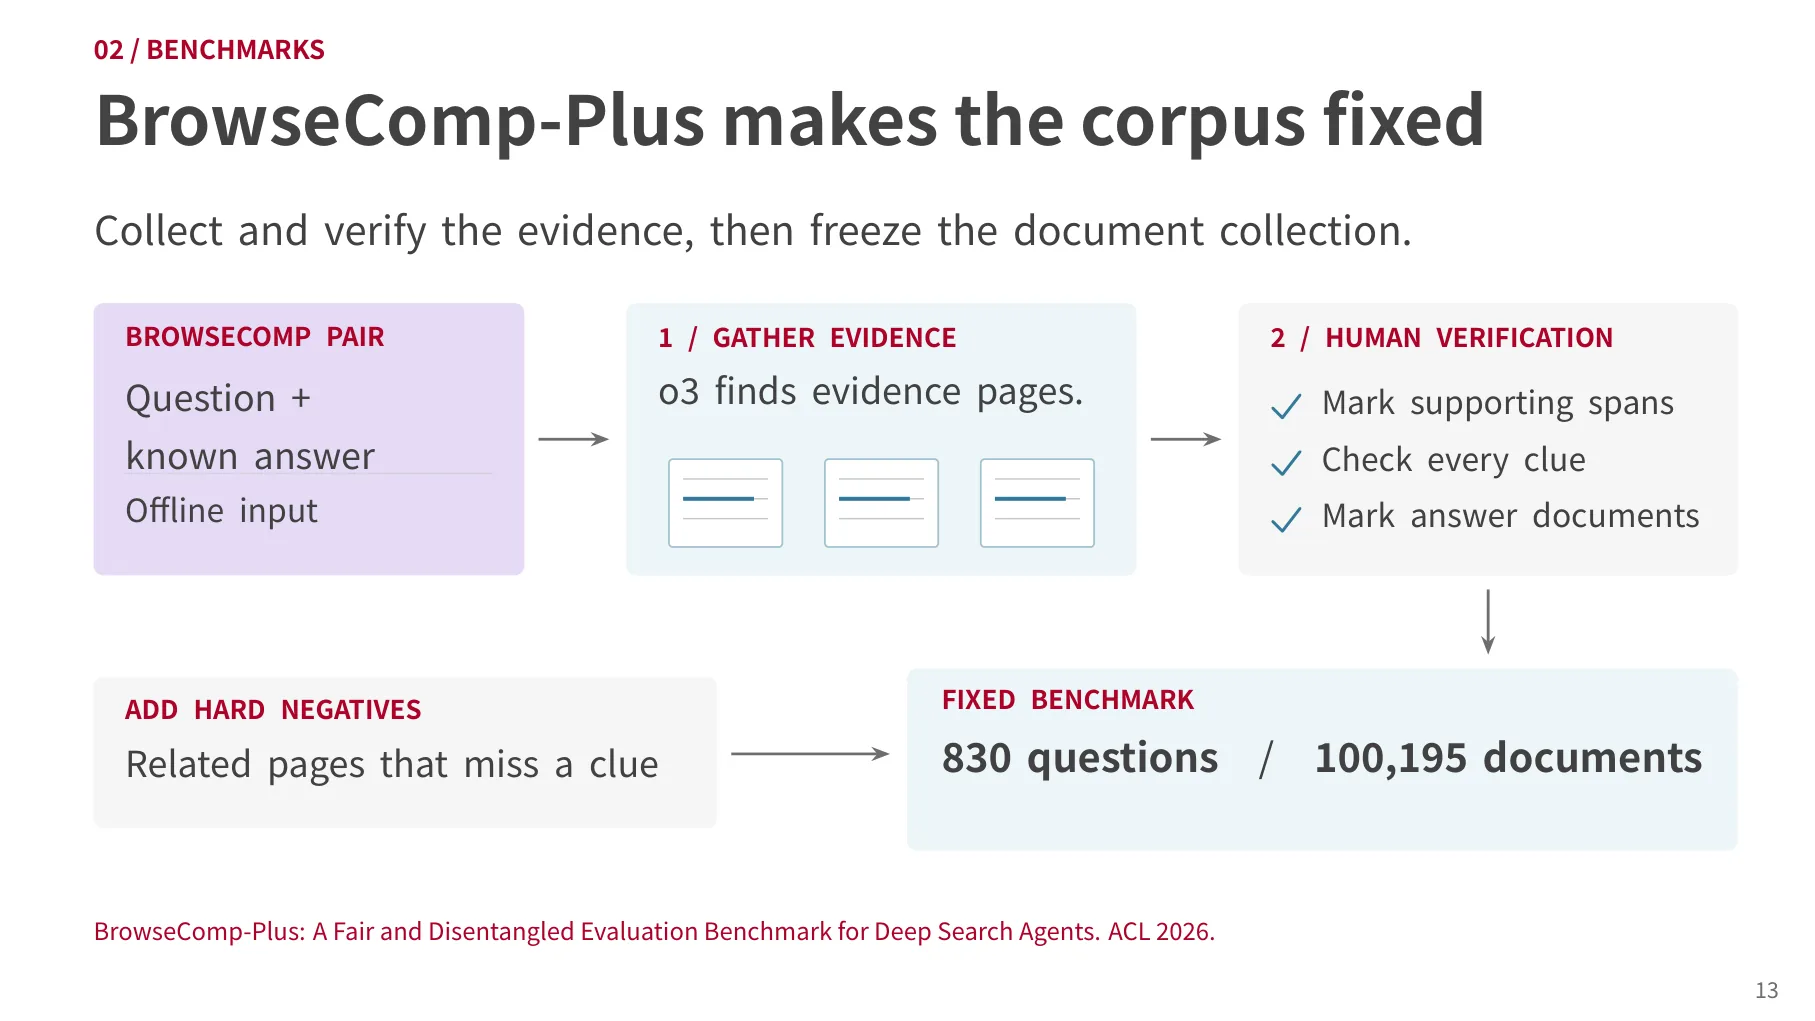
最终规模是 830 道题、100,195 篇文档。这个设计换来三件事:可复现(语料不变,分数可比)、可分离(检索失败与推理失败可以分开归因)、可训练(可以用它训练和评测自己的检索器,而不只是评测端到端 agent)。最后一点在第九节会展开——AgentIR 的训练数据就是在这类固定语料上合成的。
代价同样明显。封闭语料把“找不到正确文档”这种真实失败模式替换成了“在给定候选里排序”,难度被 hard negatives 的质量重新定义;而且 agent 无法通过换一个信息源来绕过死路。换句话说,可控性和真实性在这里是直接对立的,选哪个取决于你要回答什么问题:比较方法、调试检索,用 Plus;宣称“能研究开放网络”,就得回到 BrowseComp 那种真实但不可复现的设定。
5. 专家领域基准:把“读得懂”变成硬门槛
通用域的谜题测不出领域专长。FinSearchComp 的做法是让有金融背景的专家(MBA、从业多年的人)从真实工作场景或已核验的财务表出发写题,答案要检索可靠数据、做计算、交叉验证,再由另一组专家独立求解,分歧要解决后才入库。12:07
课件给的例子是“强生 2022–2024 年国际收入占比逐年如何变化”。这类题目有三个特征:答案不在任何单一页面上(要拼接多年财报)、需要算术(占比、同比)、错一步就全错。它把“检索”和“计算”绑在一起,也对应 Tongyi 工具集里为什么专门列了一项 Python 执行(Slide 100)。
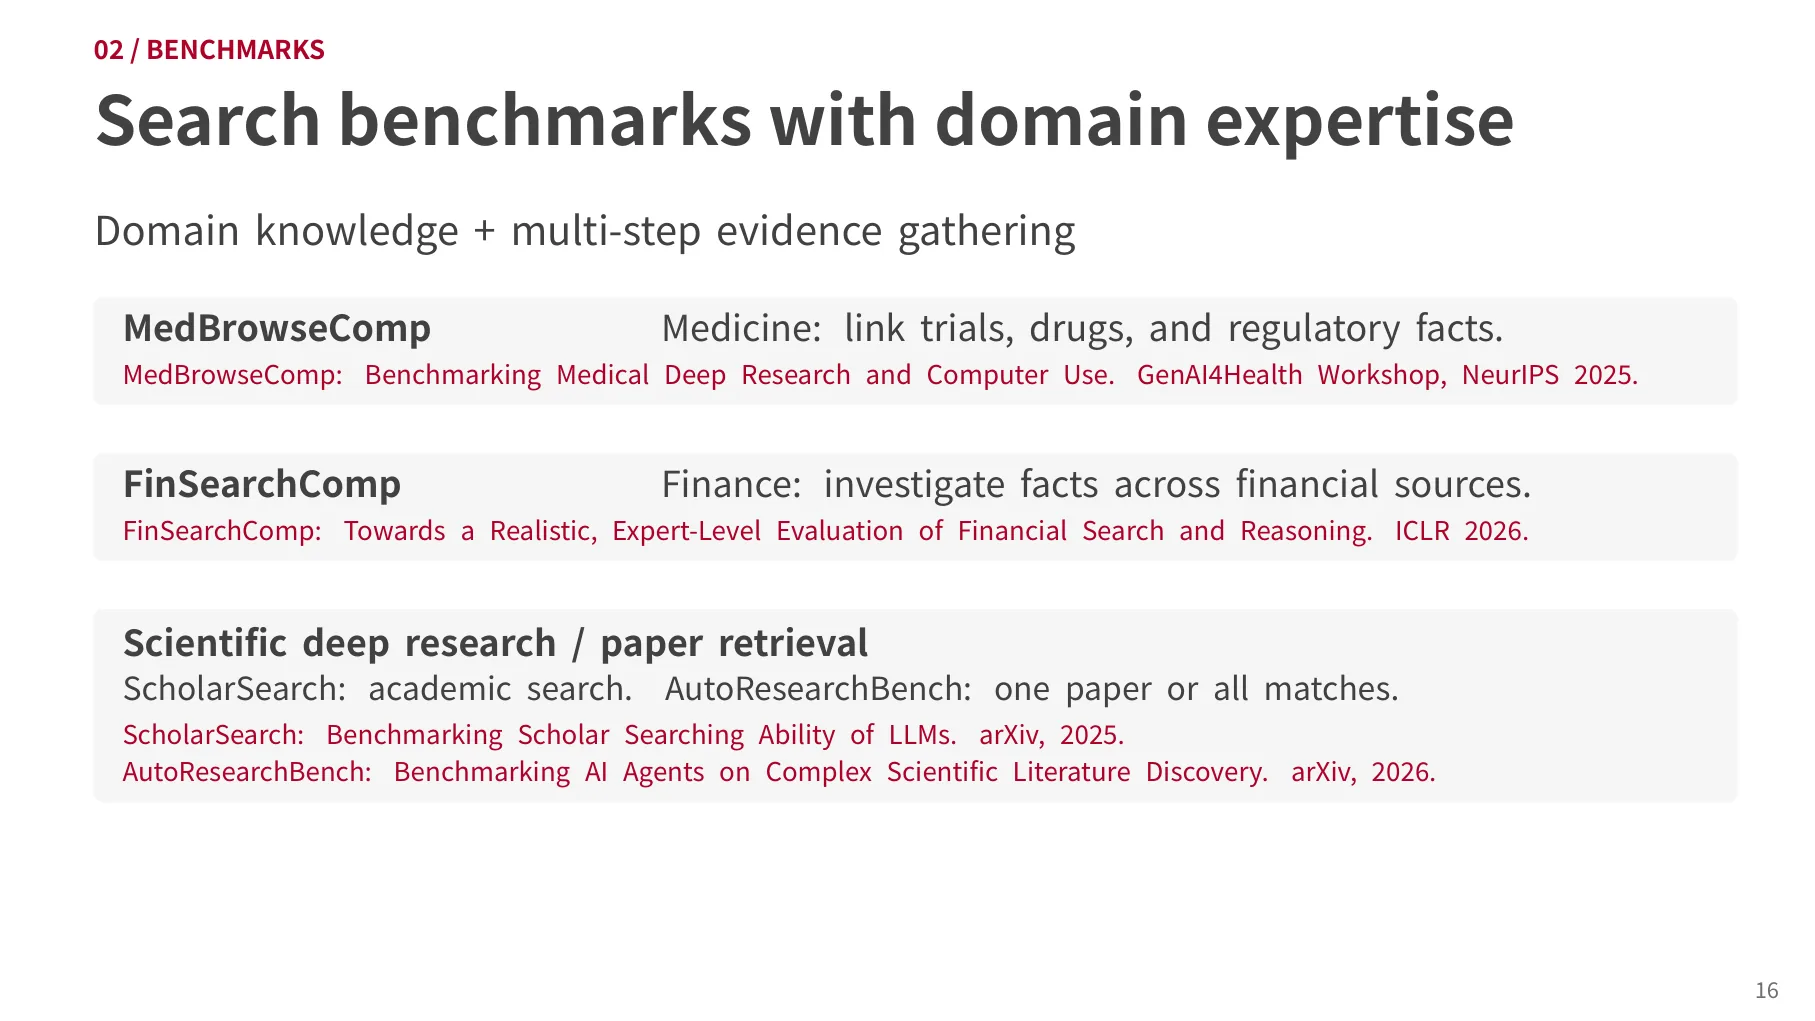
同一思路延伸到其他领域:MedBrowseComp 要求在临床试验、药物与监管事实之间连线;学术检索方向有 ScholarSearch(学者式搜索)和 AutoResearchBench(找出满足多个条件的那一篇论文,或列出全部匹配)。它们的共同点是问题由专家写、答案由专家验,因此规模化要贵得多——这是高质量领域基准的固有成本。
这里有一个容易被忽略的评测设计原则:领域基准真正测的是“能不能读懂领域证据”,而不只是“能不能搜到”。一个模型可能检索到了正确的财报页面,却把“国际收入”和“总营收”弄混;这种错误在通用基准里不会出现,在 FinSearchComp 里会立刻暴露。
6. 长文答案怎么评:相似度失效与 rubric 兴起
前面两类基准都还是短答案。真实的研究报告是长文,评测难度立刻上一个台阶:同一问题可以有多种正确写法,你无法穷举参考答案;就算能穷举,也没法用字符串相似度比较。
Akari 给了一个很有说服力的反例:第二个回答与参考答案词汇高度重叠,但主要结论完全错误——例如把“在某些研究中被专家偏好”说成“在所有领域都已证明等价”,语义相反,相似度指标却会给高分。
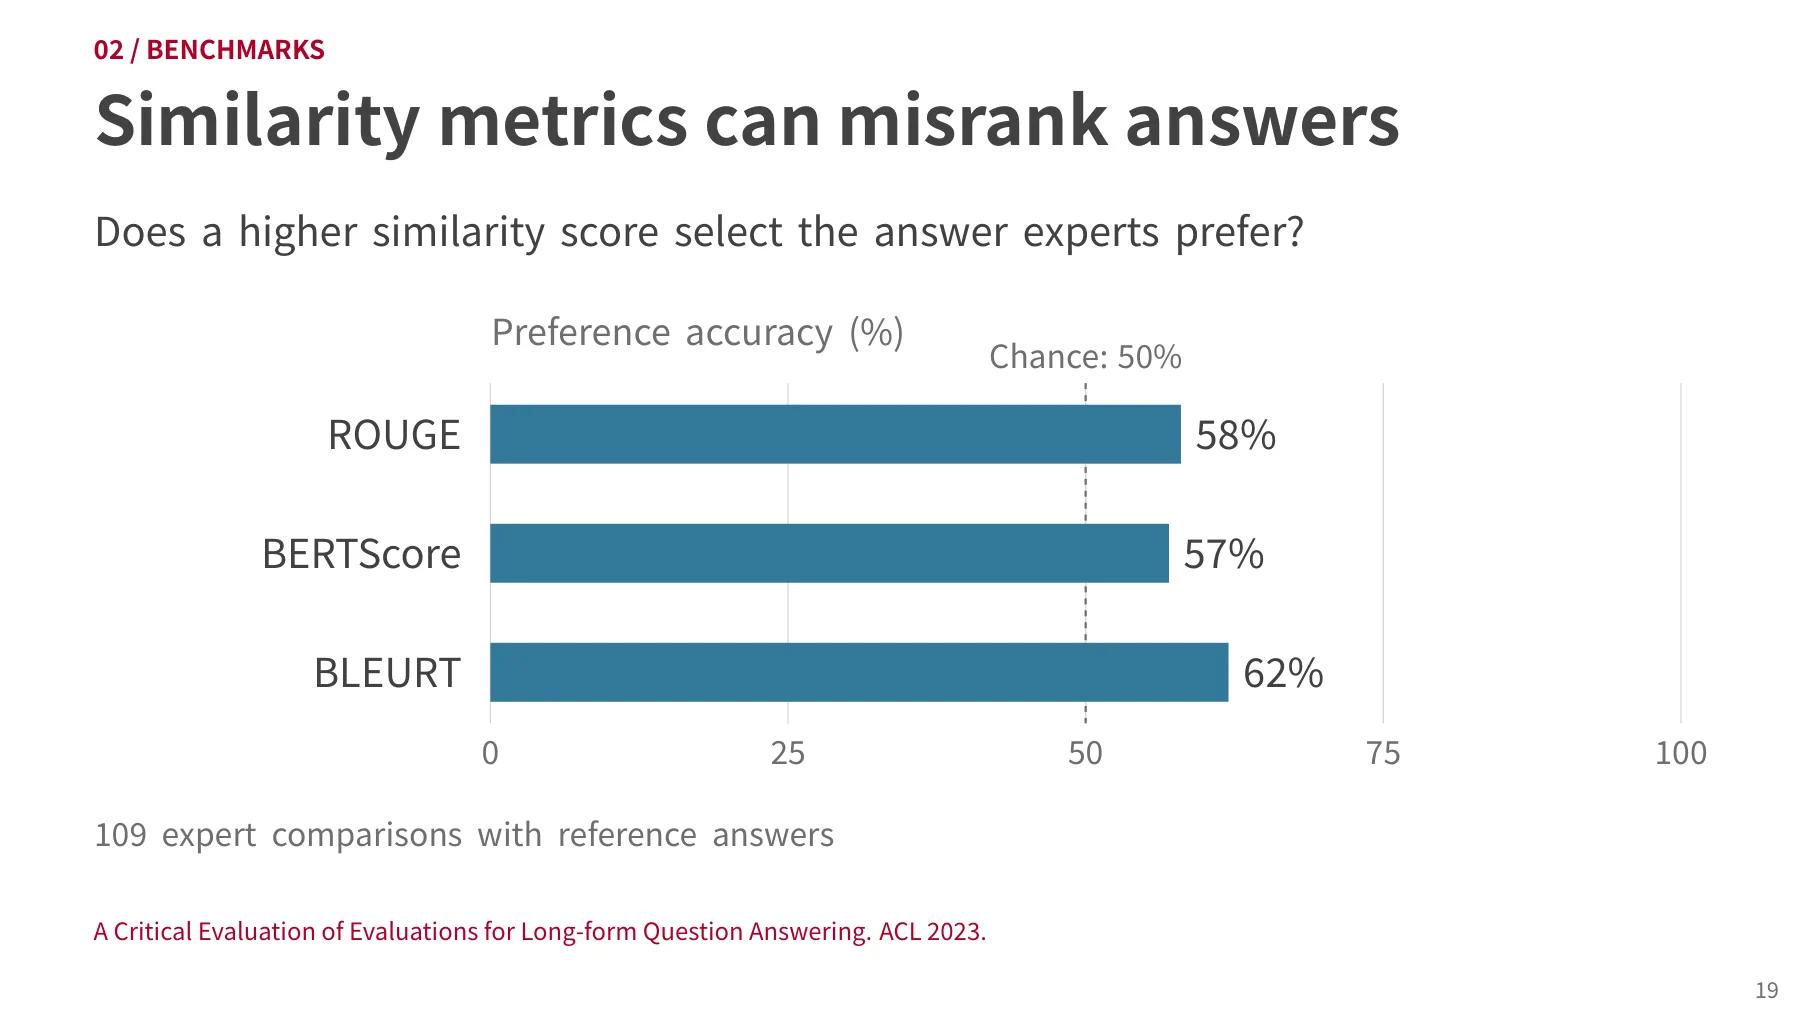
在 109 组专家比较上,ROUGE 选出“专家更喜欢的那个答案”的准确率是 58%,BERTScore 57%,BLEURT 62%,而随机基线是 50%。也就是说,这些指标只比抛硬币好一点点。结论不是“指标没用”,而是它们测的是表层重合,不是结论正确性,在开放式研究任务上不能作为主指标。16:12
替代方案是把评测从“和参考答案比”改成“对照检查表”。专家不写标准答案,而是写一组评分条目(rubric item),每条描述“好答案应该包含什么”并给权重;评测时用语言模型逐条判断候选答案是否满足,再加权汇总。
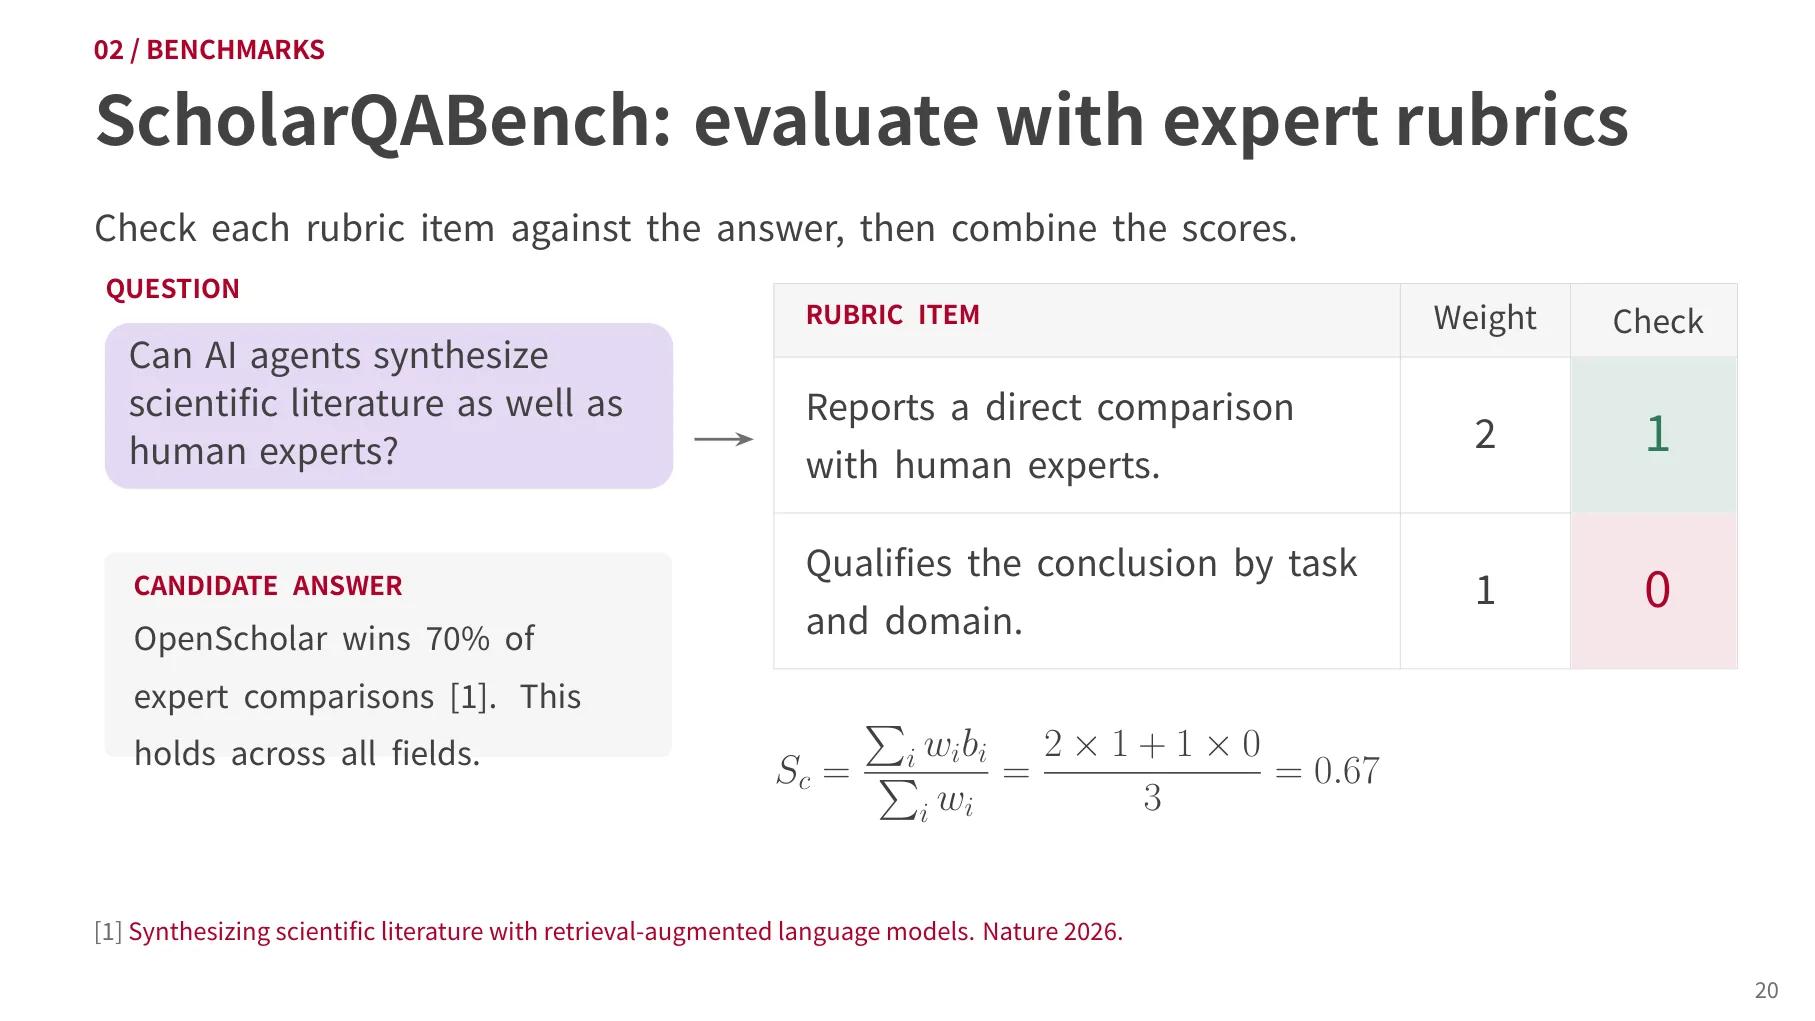
课件算例里两条条目权重分别是 2 和 1:答案报告了与人类专家的直接比较(满足,1),但没有按任务和领域限定结论(不满足,0),于是
这个设计的妙处在于它奖励“限定”。同一个答案如果把结论夸大成“在所有领域都成立”,第一条仍得 1 分、第二条得 0 分,总分被压低——而这正是人类专家最在意、相似度指标最看不见的东西。
那么语言模型的判定可信吗?在 12 个问题、2 个系统、每个答案 2 位评分者的设定下,专家与专家的一致率是 80%,专家与语言模型的一致率是 79%。这个数字的意义是:当 rubric 质量足够高时,LM 判分可以作为可扩展的代理,它引入的噪声与人与人之间的分歧同量级。
问题是 rubric 从哪来。专家写一条 rubric 平均需要近一小时,无法支撑成千上万题的评测,更无法支撑训练。ResearchQA 尝试从综述论文里自动挖掘:让模型读综述,生成研究问题和对应评分条目,从而扩到 21K 问题、75 个领域、160K 条 rubric。
代价是质量。专家审计发现,15% 的生成式 rubric 条目是空洞、错误或含糊的。
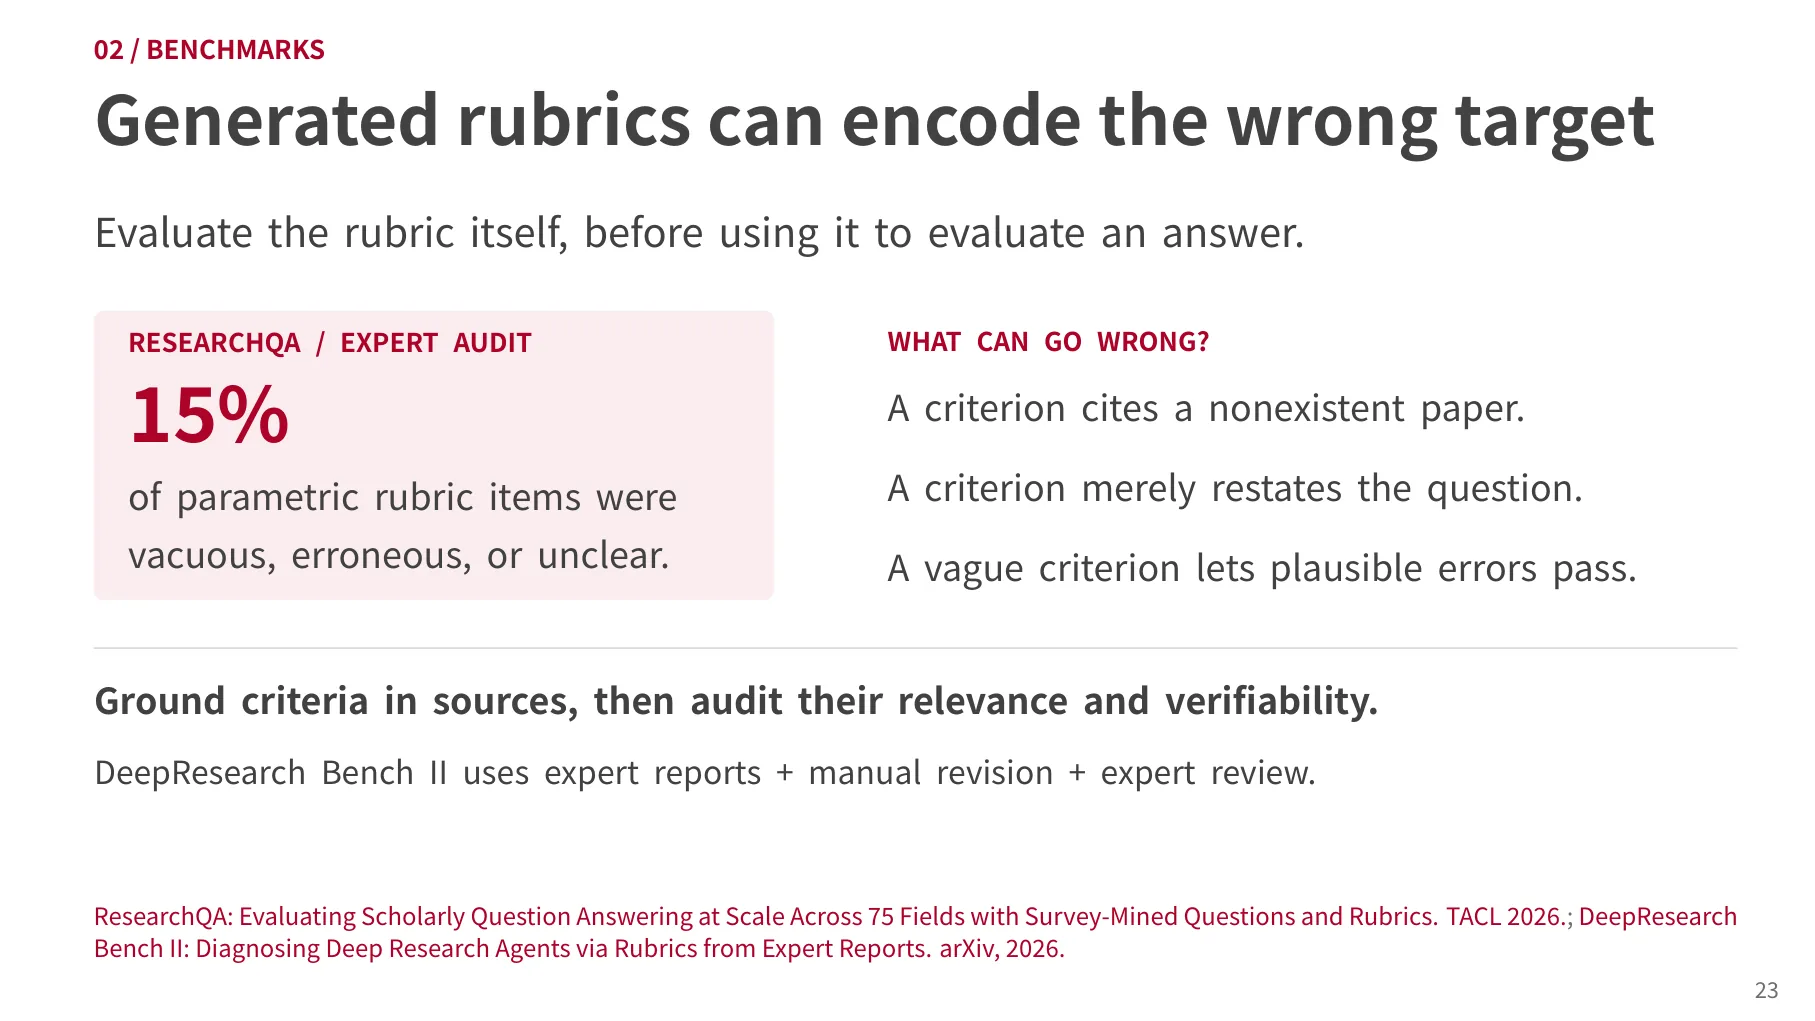
三类典型失败:条目引用了不存在的论文(模型编造了一个该引用的文献);条目只是把问题重述一遍(“答案应该正确”这种废话);条目过于笼统,让似是而非的错误也能通过。对应的方法论是先把条目锚定在来源上(ground in sources),再审计它的相关性与可验证性。DeepResearch Bench II 走的是更重的人工路线:专家报告 → 人工改写 → 专家复核。
评测的元问题
Rubric 把“评答案”变成了“评条目是否被满足”,于是风险从“判分模型不可靠”转移到了“条目本身写错了目标”。任何 rubric 基准都应该先报告一次 rubric 审计,否则分数无法解释。已有研究还指出 rubric 判分存在长度偏好等系统性偏差。
7. 引用支撑:FACT 与“有效引用”
即使报告流畅、结论合理,也可能错误地归因证据。DeepResearch Bench 的 FACT 框架专门查这一层,流程只有三步:抽取“论断 + 引用 URL”的配对;抓取被引页面;判断该页面是否支持该论断。21:03
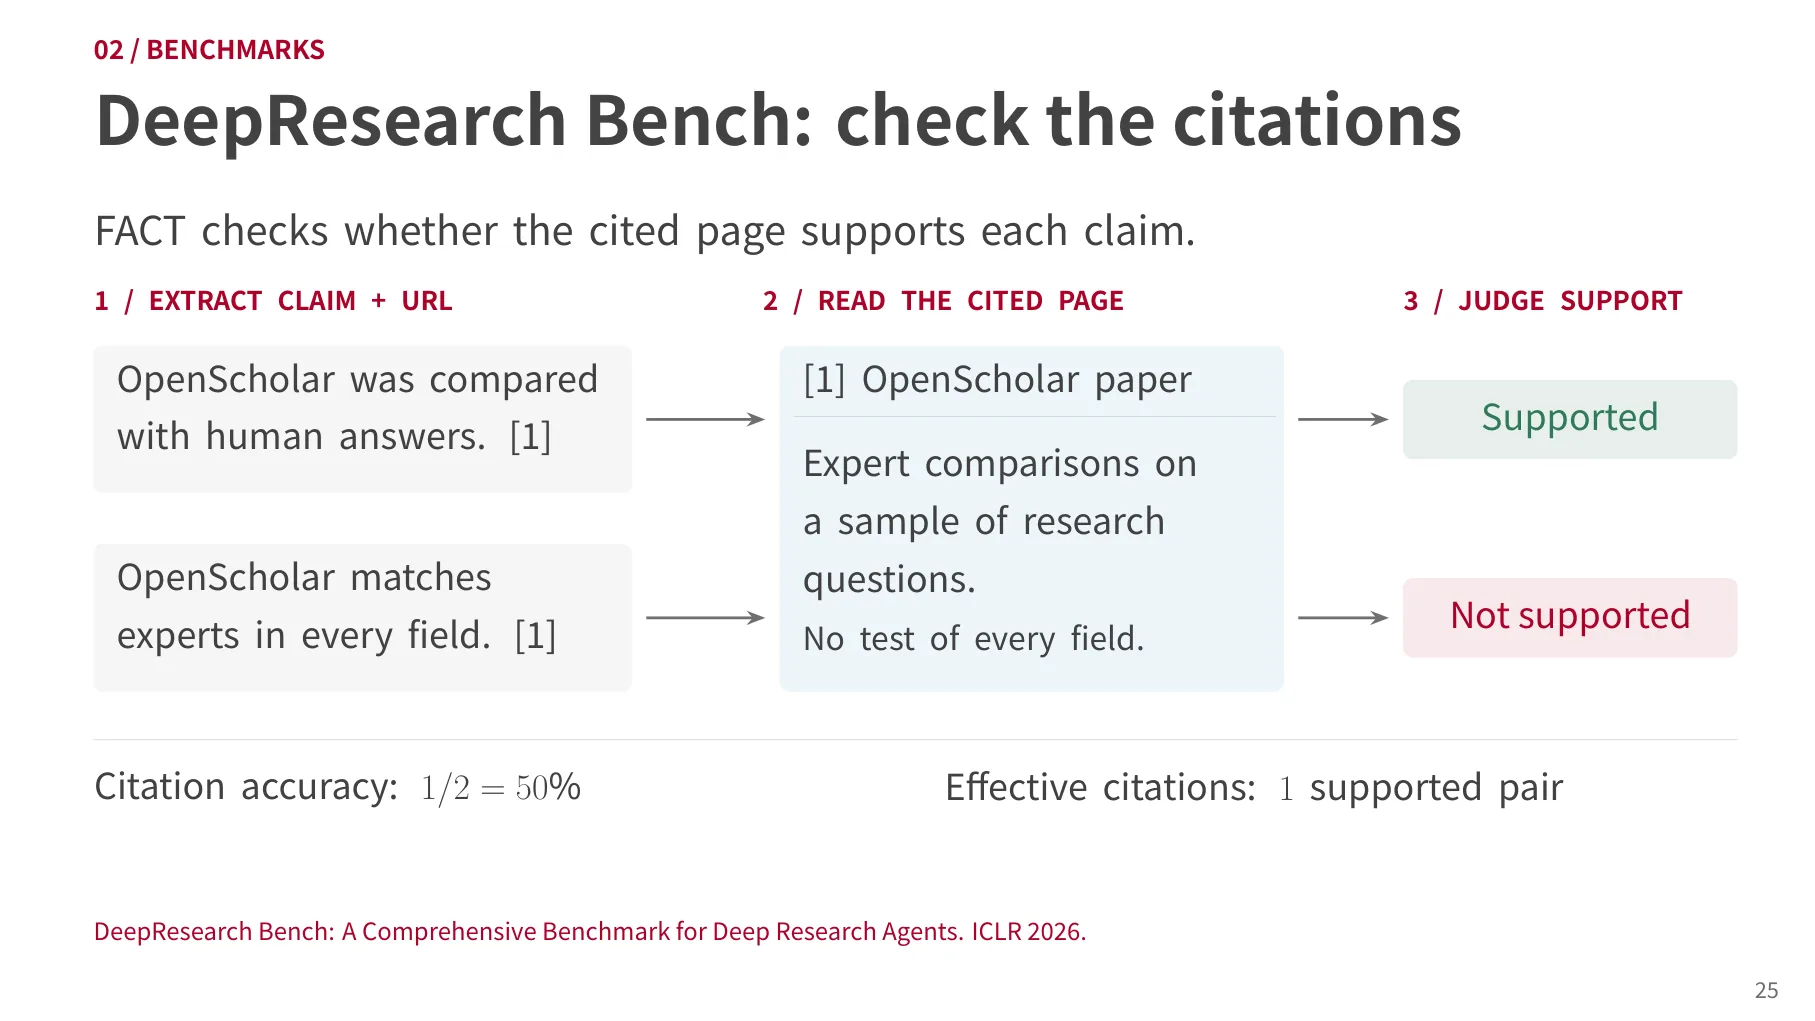
课件例子里两个论断共用同一引用:一个说“OpenScholar 曾与人类答案比较过”(支持),另一个说“OpenScholar 在每个领域都匹敌专家”(不支持,原文只在小样本问题上做了比较)。于是引用准确率是 1/2 = 50%,有效引用数为 1。把“准确率”和“有效引用数”并列报告是个好设计:前者惩罚乱引,后者惩罚“只引一条却写满全篇”。
这个框架也有边界。它只检查“引用的页面是否支持论断”,不检查页面本身是否权威(一篇博客和一篇 Nature 论文同权);它无法发现“该引而未引”的遗漏;而且判断依赖抓取到的页面内容,页面改版就会影响结果。更根本的是,citation accuracy 高不代表研究质量高——可以写一篇全部引用正确、但毫无综合与取舍的报告。
8. 推理循环与三阶段训练配方
把 agent 的一次迭代拆开看,就是一个标准的 tool-use 轨迹(Slides 52–57):模型先产生 reasoning token(“要回答这个问题,我得先找专家比较的研究”),再生成工具调用 search("expert comparisons"),工具返回文档列表,返回内容被追加进上下文,模型基于新证据继续推理,最后写出带引用的答案。
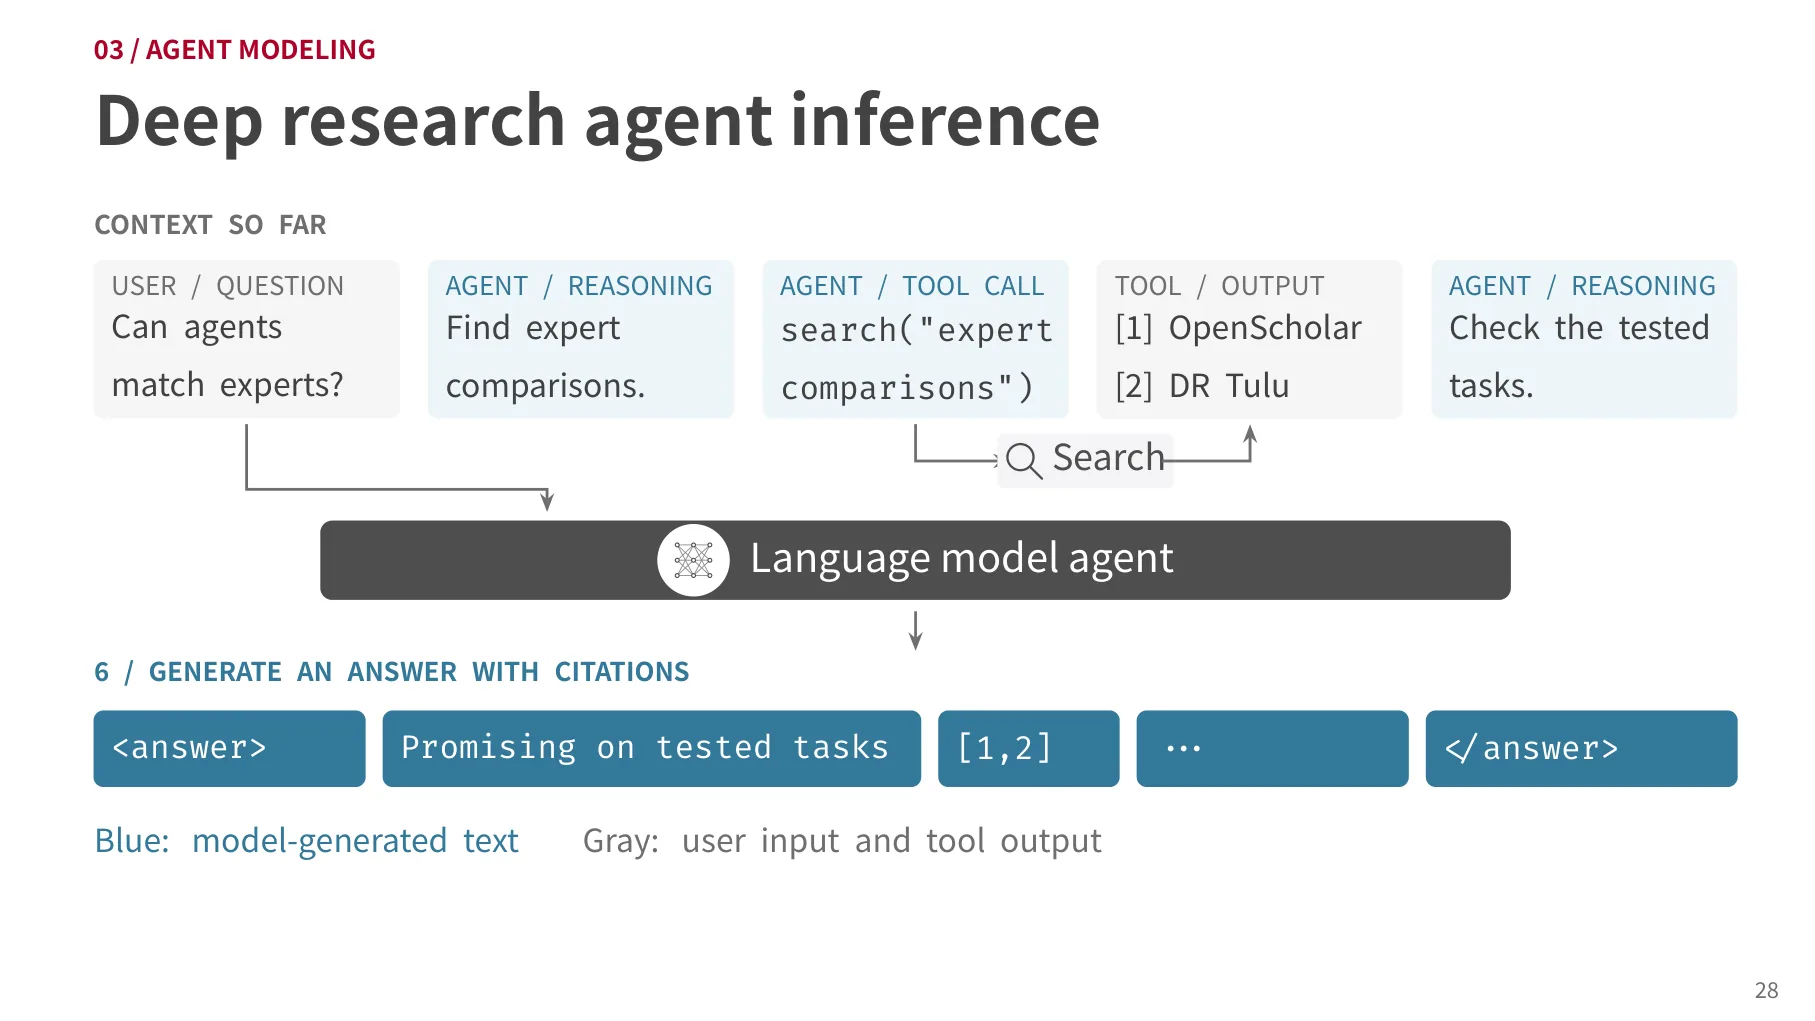
工程上要注意的是颜色编码背后的所有权:蓝色文本由模型生成,灰色文本来自用户与工具。课件没有展开损失掩码,但配色本身提示了一个实现约定:构造 SFT 数据时通常只对模型生成的 token 计算损失,把工具输出当作给定上下文。这个约定在后面的 SFT 数据构造里很关键。
那么怎么把这种能力训出来?Tongyi DeepResearch 的配方是三段式:mid-training(大规模暴露 agent 行为)→ supervised fine-tuning(模仿成功示范)→ reinforcement learning(从自己的尝试中学)。25:55
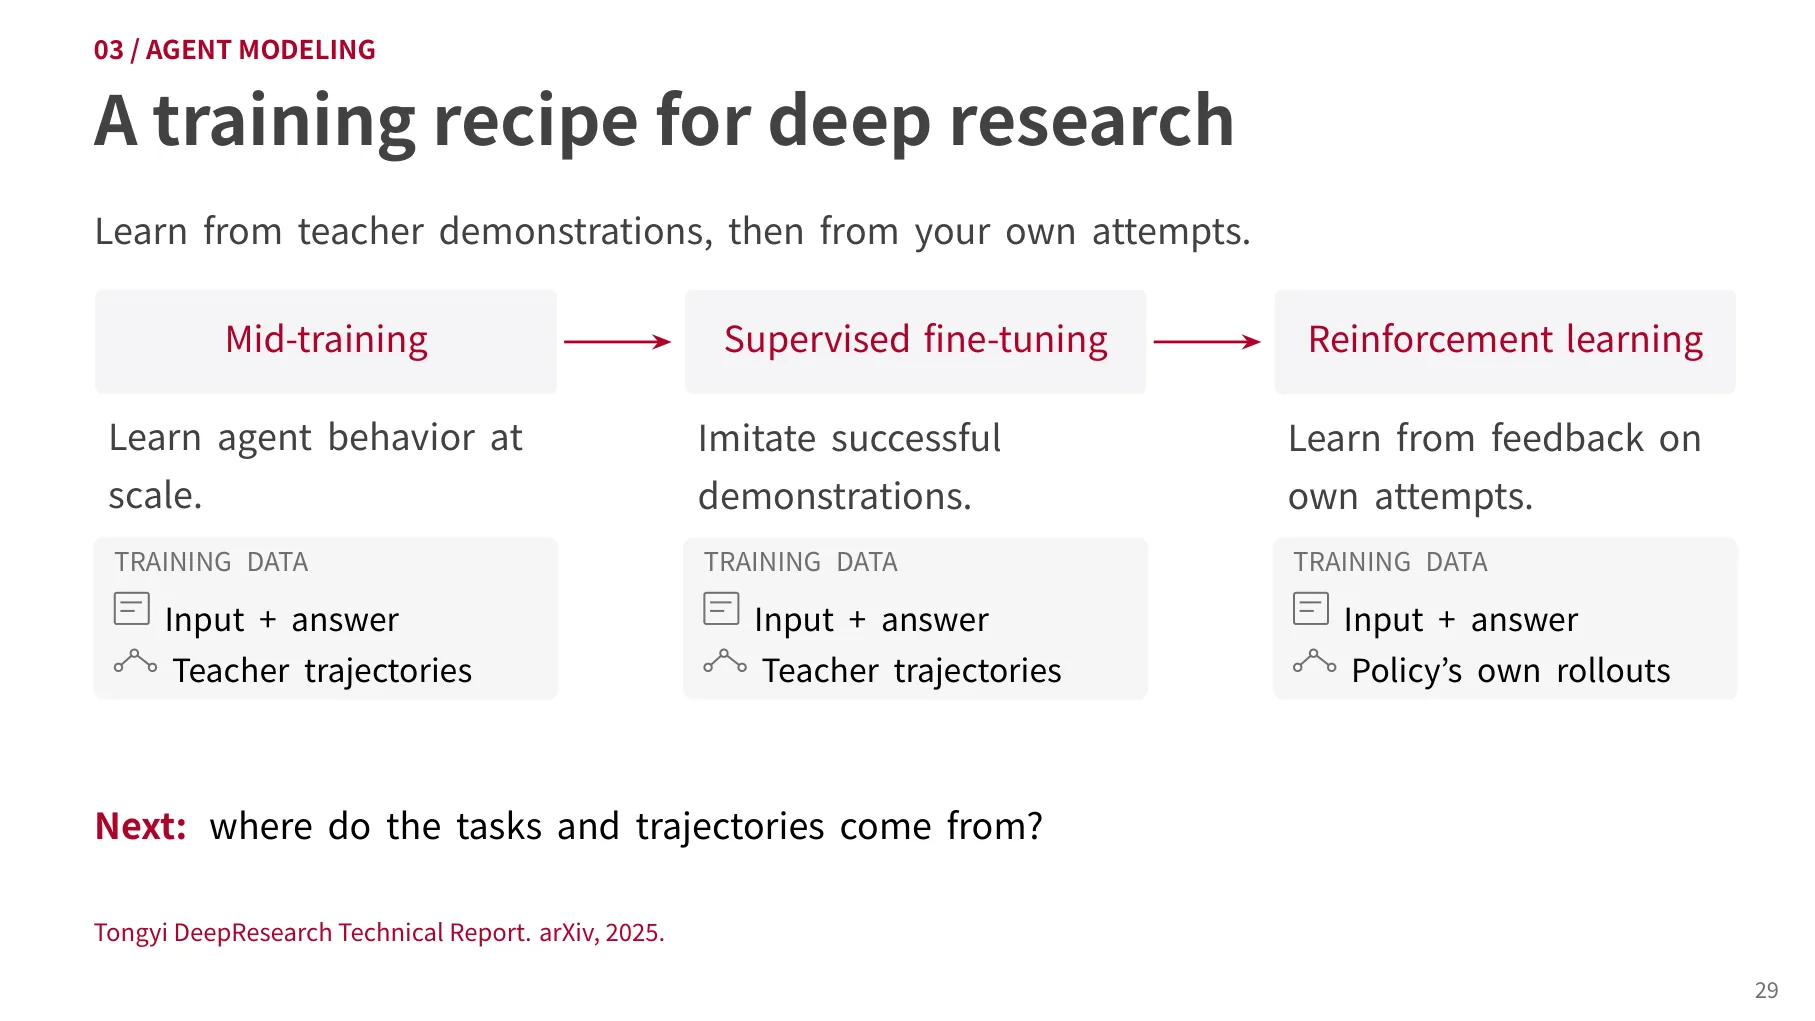
三个阶段的数据需求不同,这是最容易被忽略的一点。前两段都需要“问题 + 已知答案 + 教师轨迹”,第三段只需要“问题 + 已知答案”,轨迹由策略自己采样。三段都依赖同一个前提:存在可验证的答案。这就是为什么短答案基准(BrowseComp 类)先把训练配方跑通了,而开放式报告的训练要晚一步。
问题与答案从哪来?回到知识图谱:节点是实体,带标签的有向边是关系。Allen Newell 是 CMU 的 faculty,与 Herbert Simon 合著《Human Problem Solving》(1972),二人共享 1975 年图灵奖,Simon 1978 年获诺贝尔经济学奖——这些边串成一个连通子图,就可以反向生成一道题。
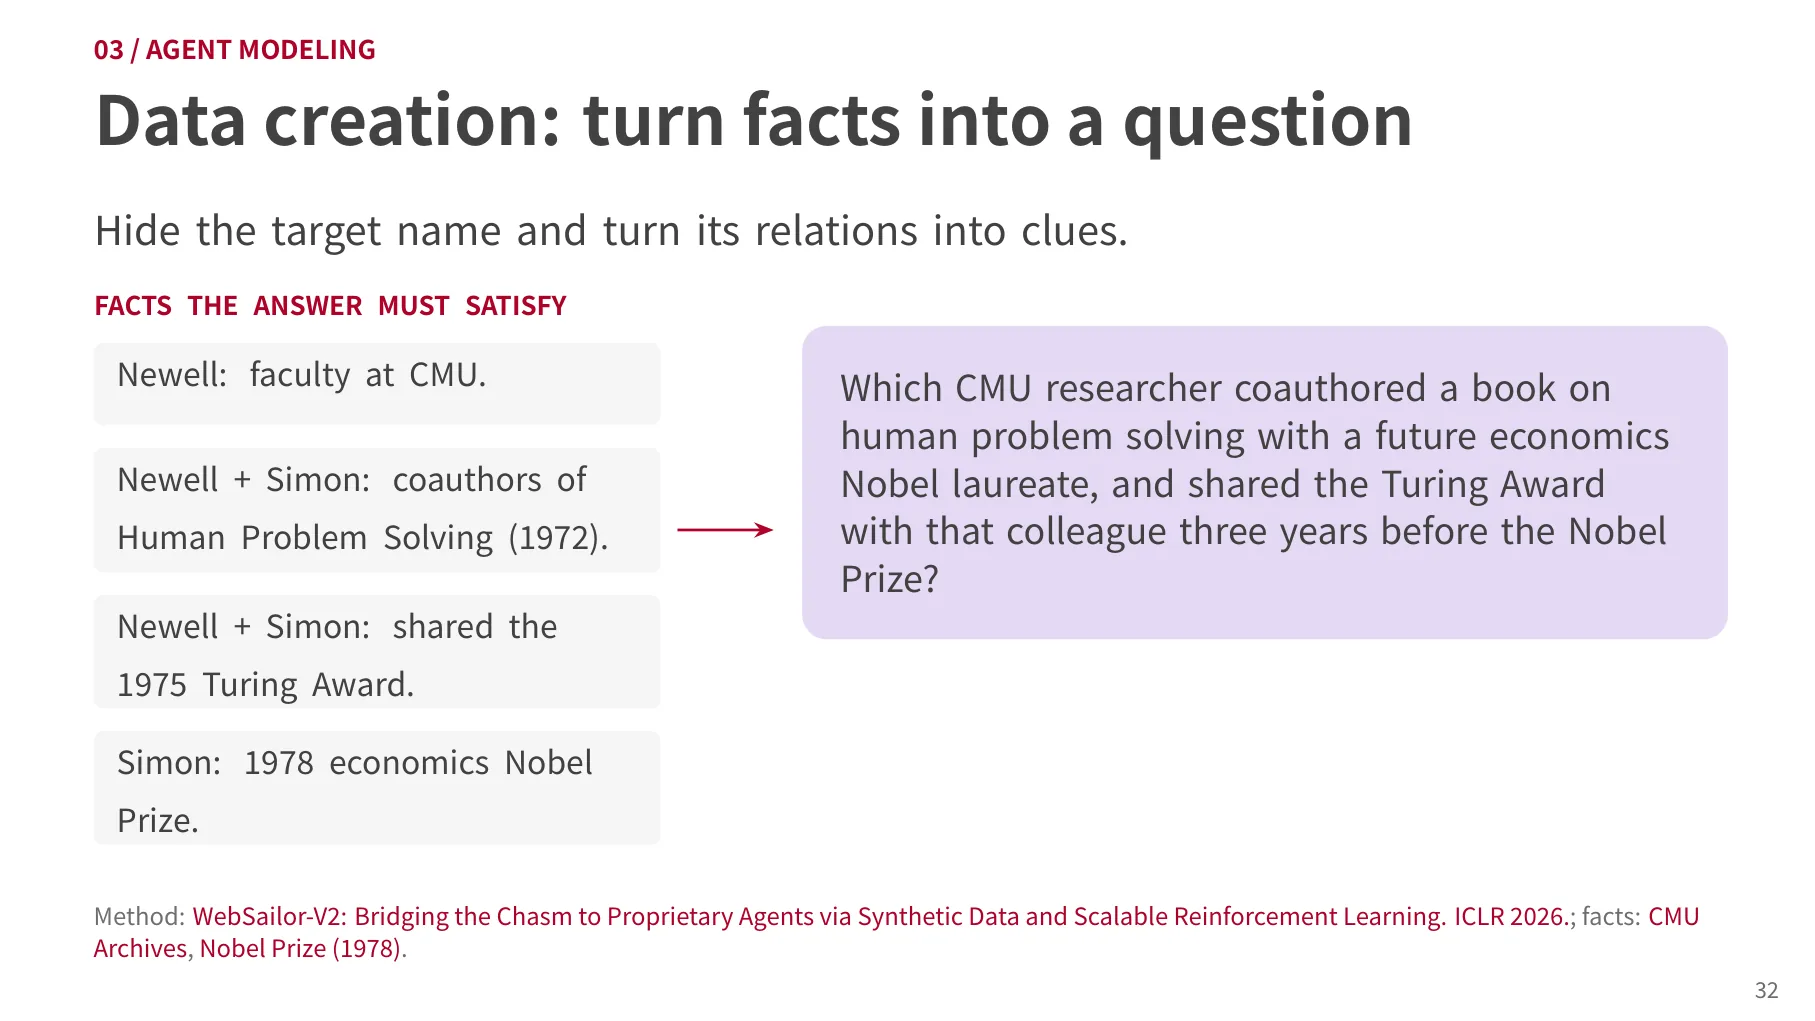
生成出的题目是:“哪位 CMU 研究者与一位未来的经济学诺奖得主合著了一本关于人类问题求解的书,并在后者获奖三年前与其共享图灵奖?”答案是 Allen Newell。可以看到,这与 BrowseComp 的人工造题逻辑完全同构:隐去名字、把关系转成约束、用起始实体作 gold answer。差别只在于一个靠人写、一个靠图采样,后者可规模化。
轨迹则由更强的教师模型(专有模型或大得多的开源模型)采样,再过滤:答案正确、格式合法、轨迹连贯三者同时满足才保留,然后在这些成功轨迹上做 SFT。这里有个隐含风险:过滤只保留成功轨迹,模型学到的是“正确答案长什么样”,而不是“走到死路后怎么退回来”。失败轨迹里其实藏着纠错能力,目前多数配方把它们丢了。
mid-training 的思路更朴素:把大量 agent 轨迹混进继续预训练语料,和通用数据一起做 next-token prediction,得到一个“agent-ready”的基座,再做同样的下游 SFT。效果如何?在完全相同的 SFT 数据下比较两种初始化,复杂基准上的差距很明显。30:49
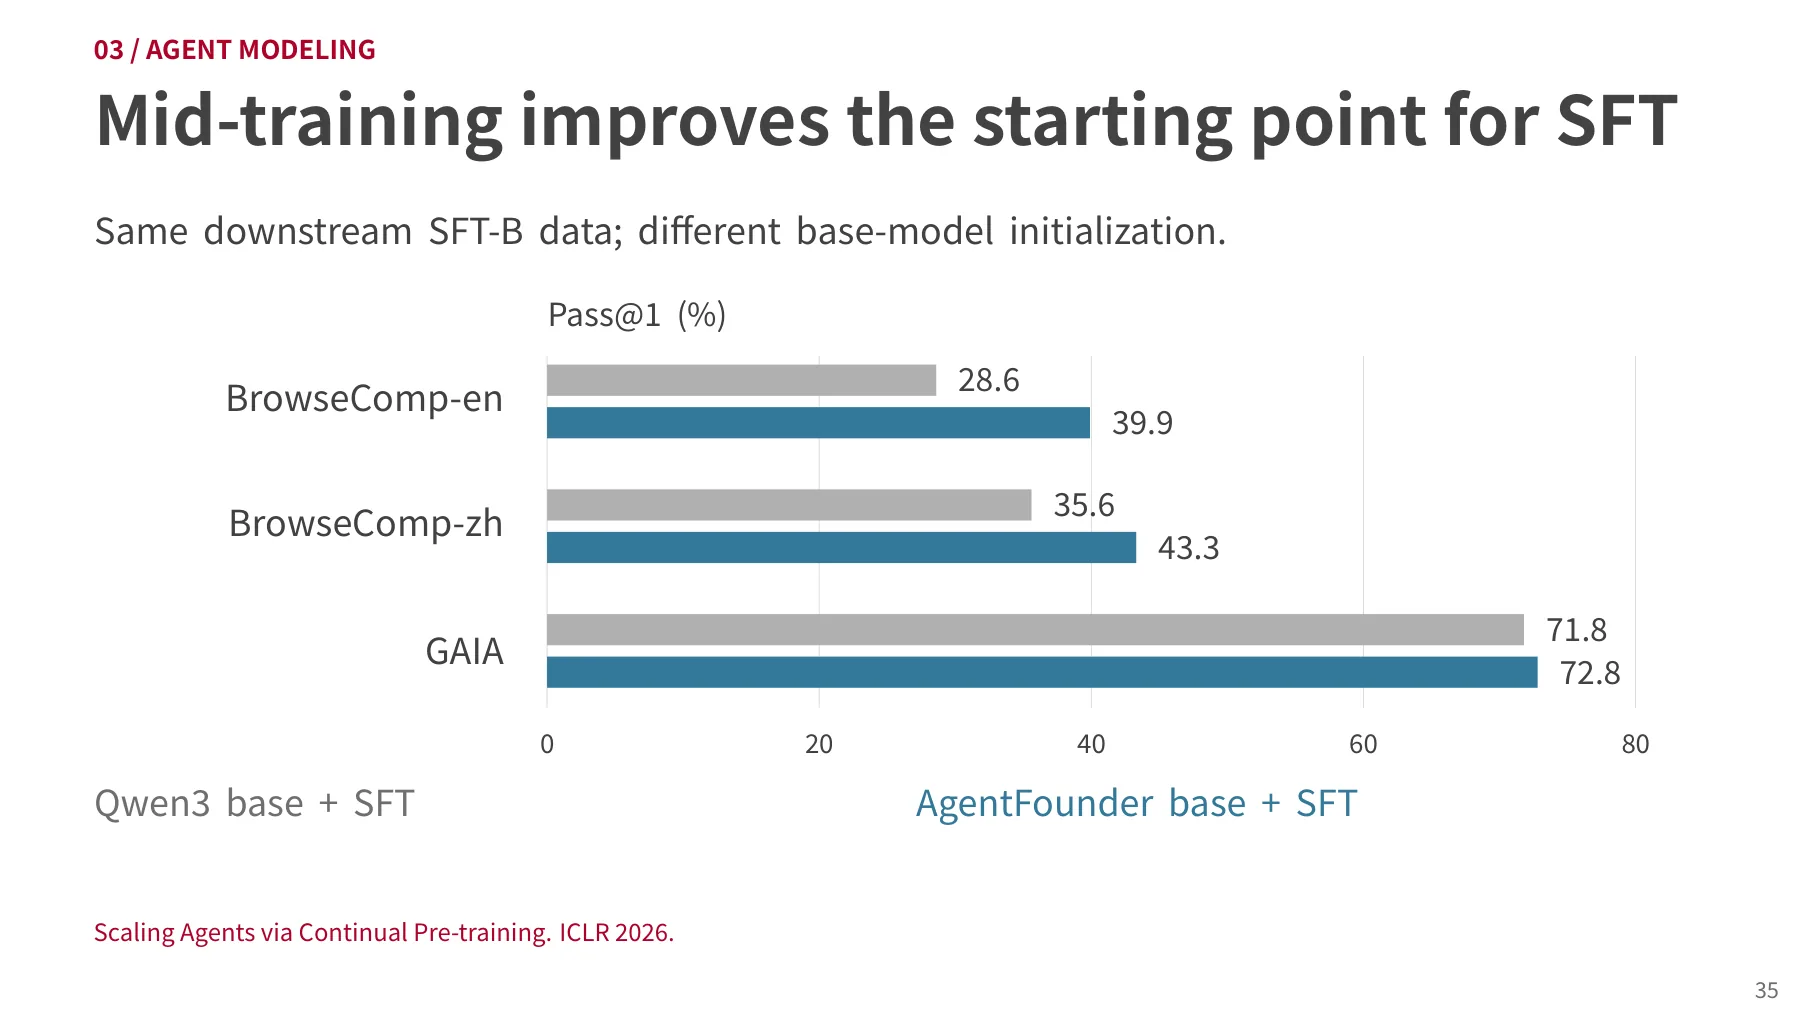
BrowseComp-en 从 28.6 升到 39.9,zh 从 35.6 升到 43.3,GAIA 从 71.8 到 72.8。规律是:任务越复杂、越依赖长程工具使用,mid-training 的收益越大;GAIA 这类相对短程的任务几乎没变。一种解读是:mid-training 补的主要不是知识,而是“agent 工作流的格式与节奏”——什么时候该调用工具、输出该怎么组织。
公平地说,这套方法有明确的循环论证风险:训练数据是照着目标基准的构造方式逆向生成的,那么在这些基准上变好,未必意味着在真实信息需求上变好。课件把“这种数据构造能否迁移到其他 deep research 基准”明确列为开放问题。
9. 从 exact match 到可演化的 rubric
有了可验证答案,RL 就顺理成章:对同一问题采样多条轨迹,用最终答案的 exact match(或 LM judge)给 0/1 奖励,再更新策略。这就是 RLVR 的思路,Search-R1 是较早把它用在搜索 agent 上的工作。
GRPO 是当前最常用的具体算法。它对同一问题采样一组回答 ,用组内相对表现构造优势 :
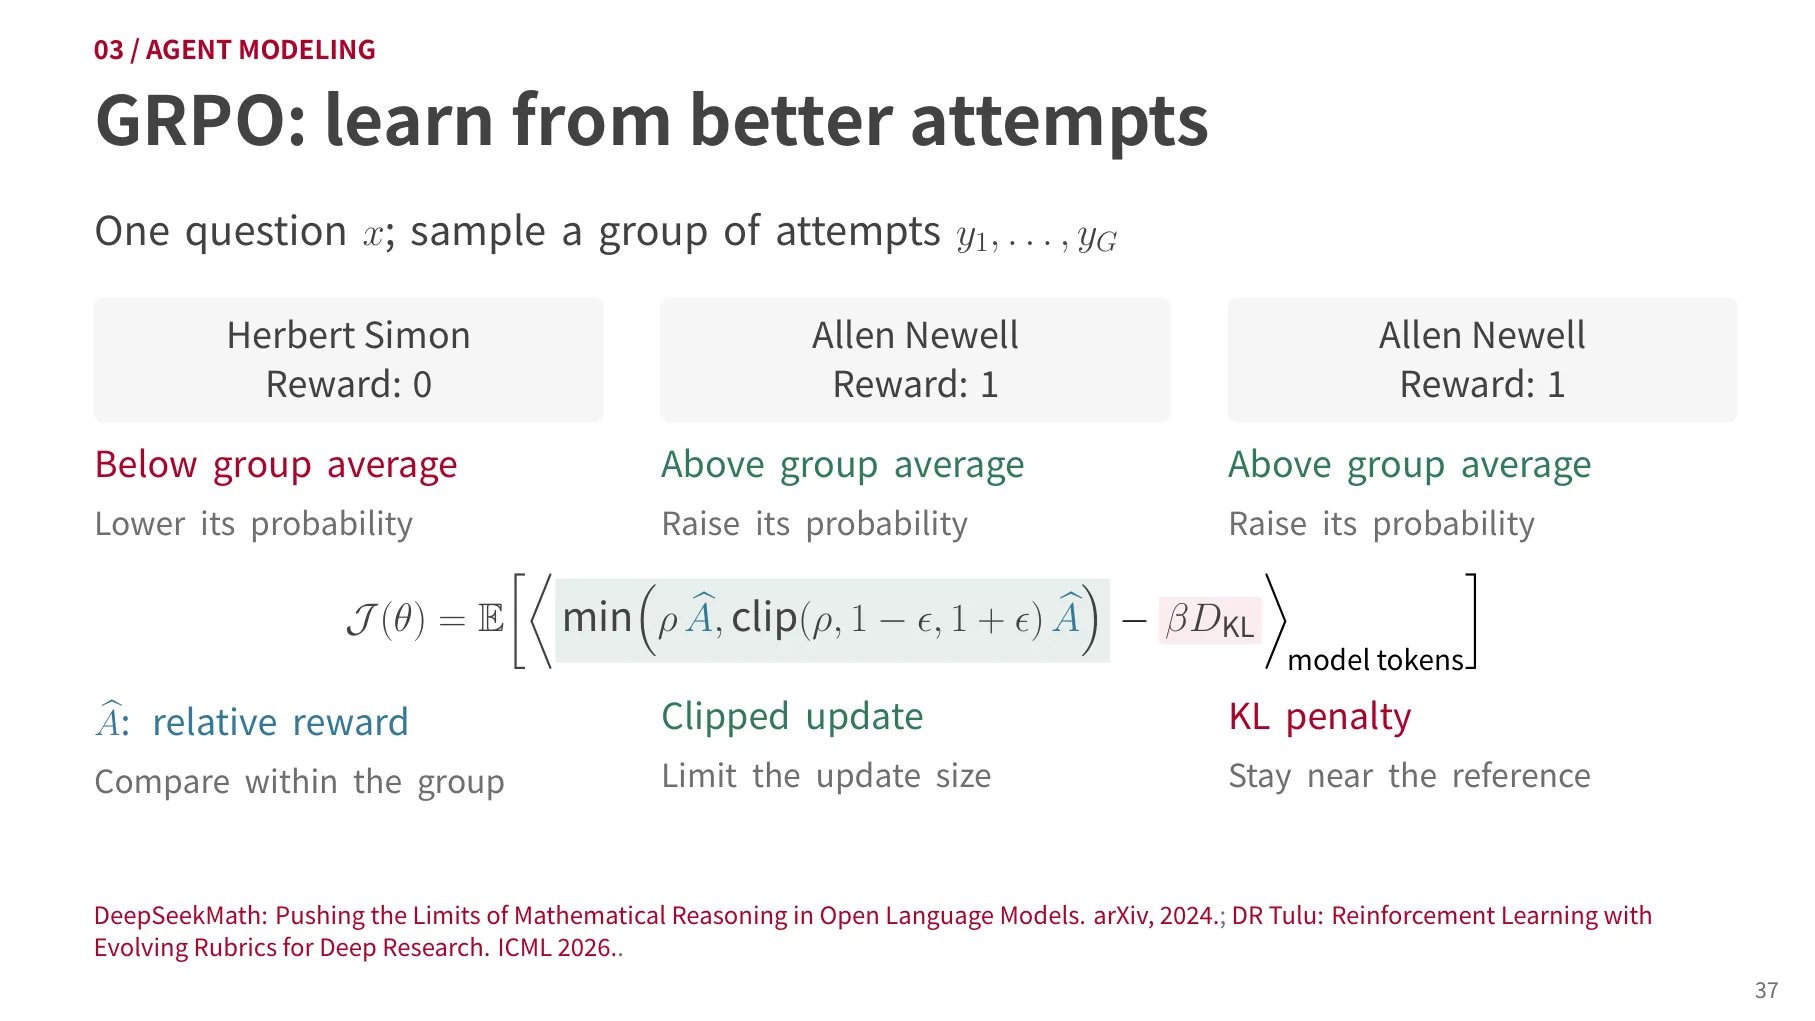
三个部件各司其职:组内比较用同一问题的多次尝试互为基线,因此不再需要 PPO 式单独学习的价值函数(critic);裁剪限制单次更新幅度;KL 惩罚防止策略跑离参考模型太远。在 agent 场景里,讲师特别强调后两项约束在大规模训练中的重要性。
训练效率是这类工作的隐形门槛。一条轨迹可能包含上百次工具调用,每次都要等外部 API 返回;如果串行等待,GPU 大部分时间在空转。常见解法是异步 rollout:多条轨迹并行推进,谁先完成就先打分,凑够一个 batch 就更新策略;再配合工具结果缓存、更健壮的 API 调用,以及用本地索引或模拟环境替代真实网络等工程手段。这些细节下一讲(RL 系统)会展开,但这里要点明:deep research 的 RL 首先是吞吐问题,其次才是算法问题。Akari 在问答里提到,在 BrowseComp 规模上跑一次 RL 可能要花 3,000–4,000 美元,这个量级直接决定了多数实验室只能在固定语料上做实验。
奖励设计的麻烦出现在开放式任务上。文献综述没有唯一答案,“覆盖率、相关性、事实性、论断是否有引用支撑”这些维度无法压成一个 0/1。DR Tulu 的方案是把评测用的 rubric 直接变成奖励函数,并且让 rubric 随训练演化。36:37
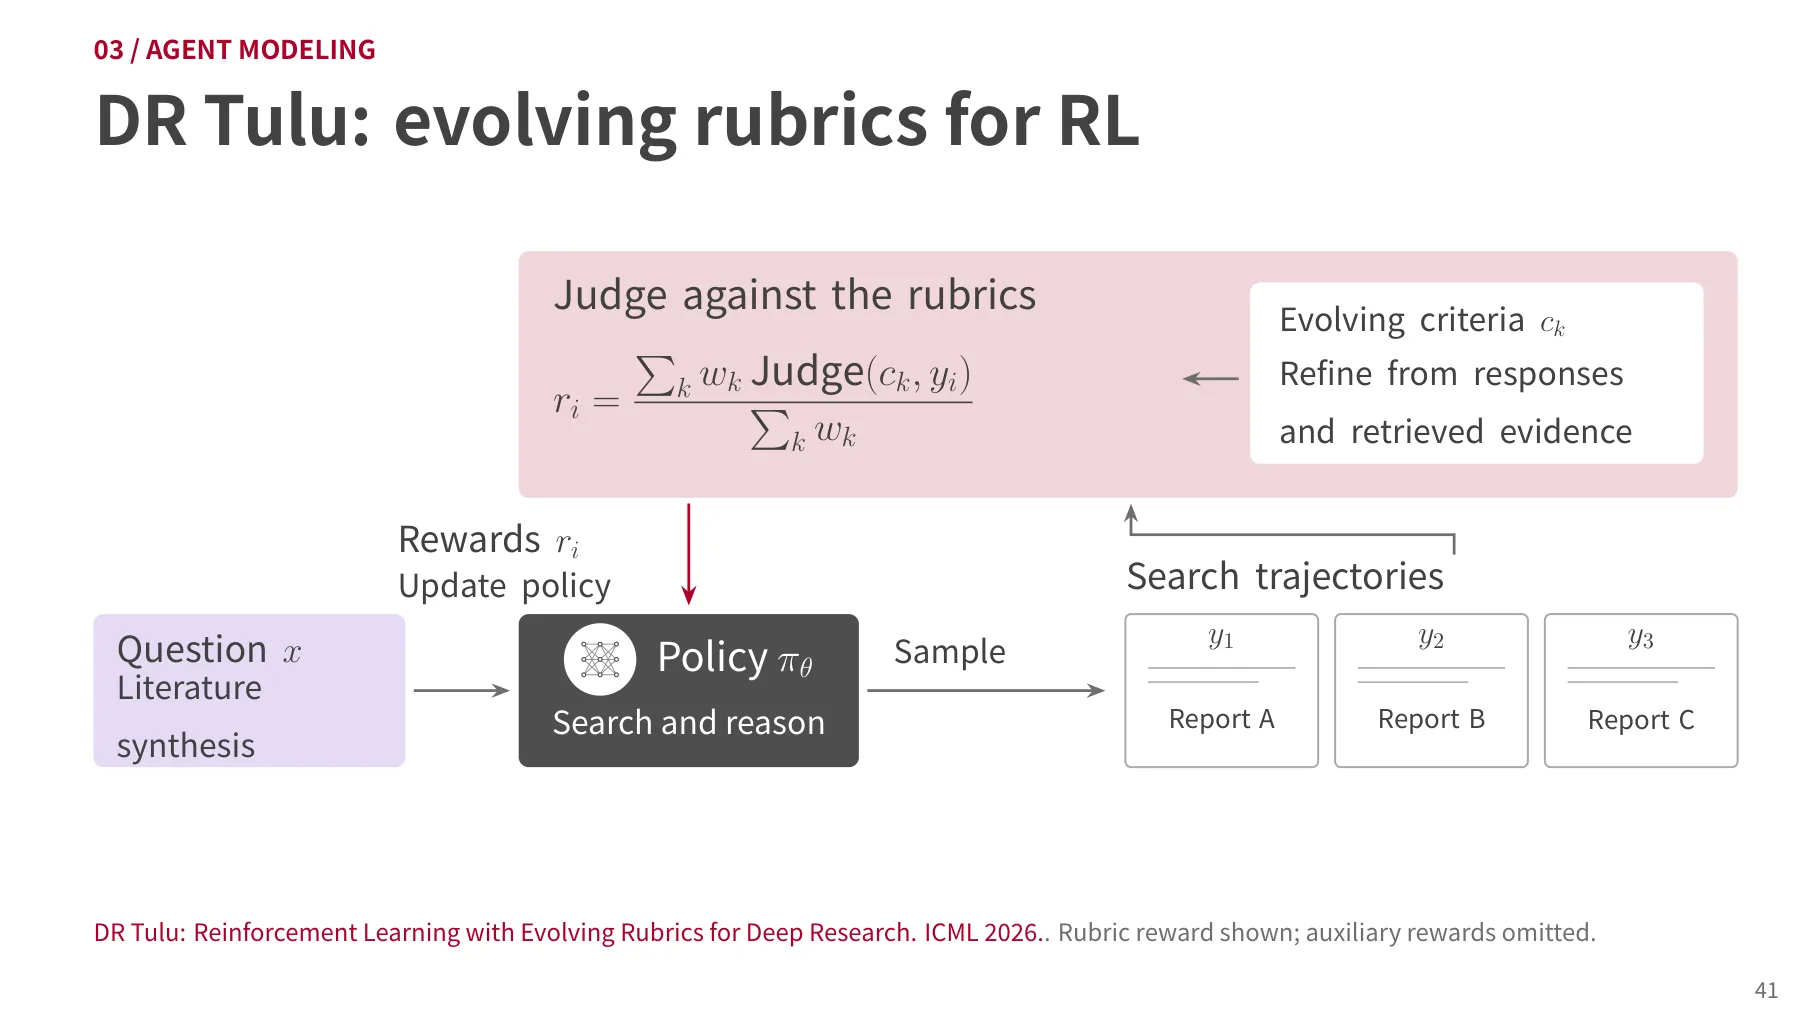
流程是:初始 rubric 锚定在外部检索到的证据上;策略对同一问题采样多条报告(训练时用 8 条);让语言模型对比这些报告,生成新的正/负条目——正条目奖励可取行为,负条目惩罚具体错误;条目进入缓冲区,用于打分与策略更新。随着策略变强,它能犯的错误也在变化,rubric 跟着更新,于是反馈信号与模型同步生长,而不是在训练开始时就冻结。
为什么必须演化?课件给了消融:用随机奖励训练完全没有提升;只用初始 rubric 有明显提升;演化 rubric 提升更大,而且训练越久优势越明显。这说明初始 rubric 的质量和它的可适应性是两个独立的收益来源。
SFT 的作用在开放式任务上更突出。DR Tulu 比较了四种起点:无 SFT、只用 5% 数据的“欠训练 SFT”、on-policy SFT、完整 SFT 混合。41:32
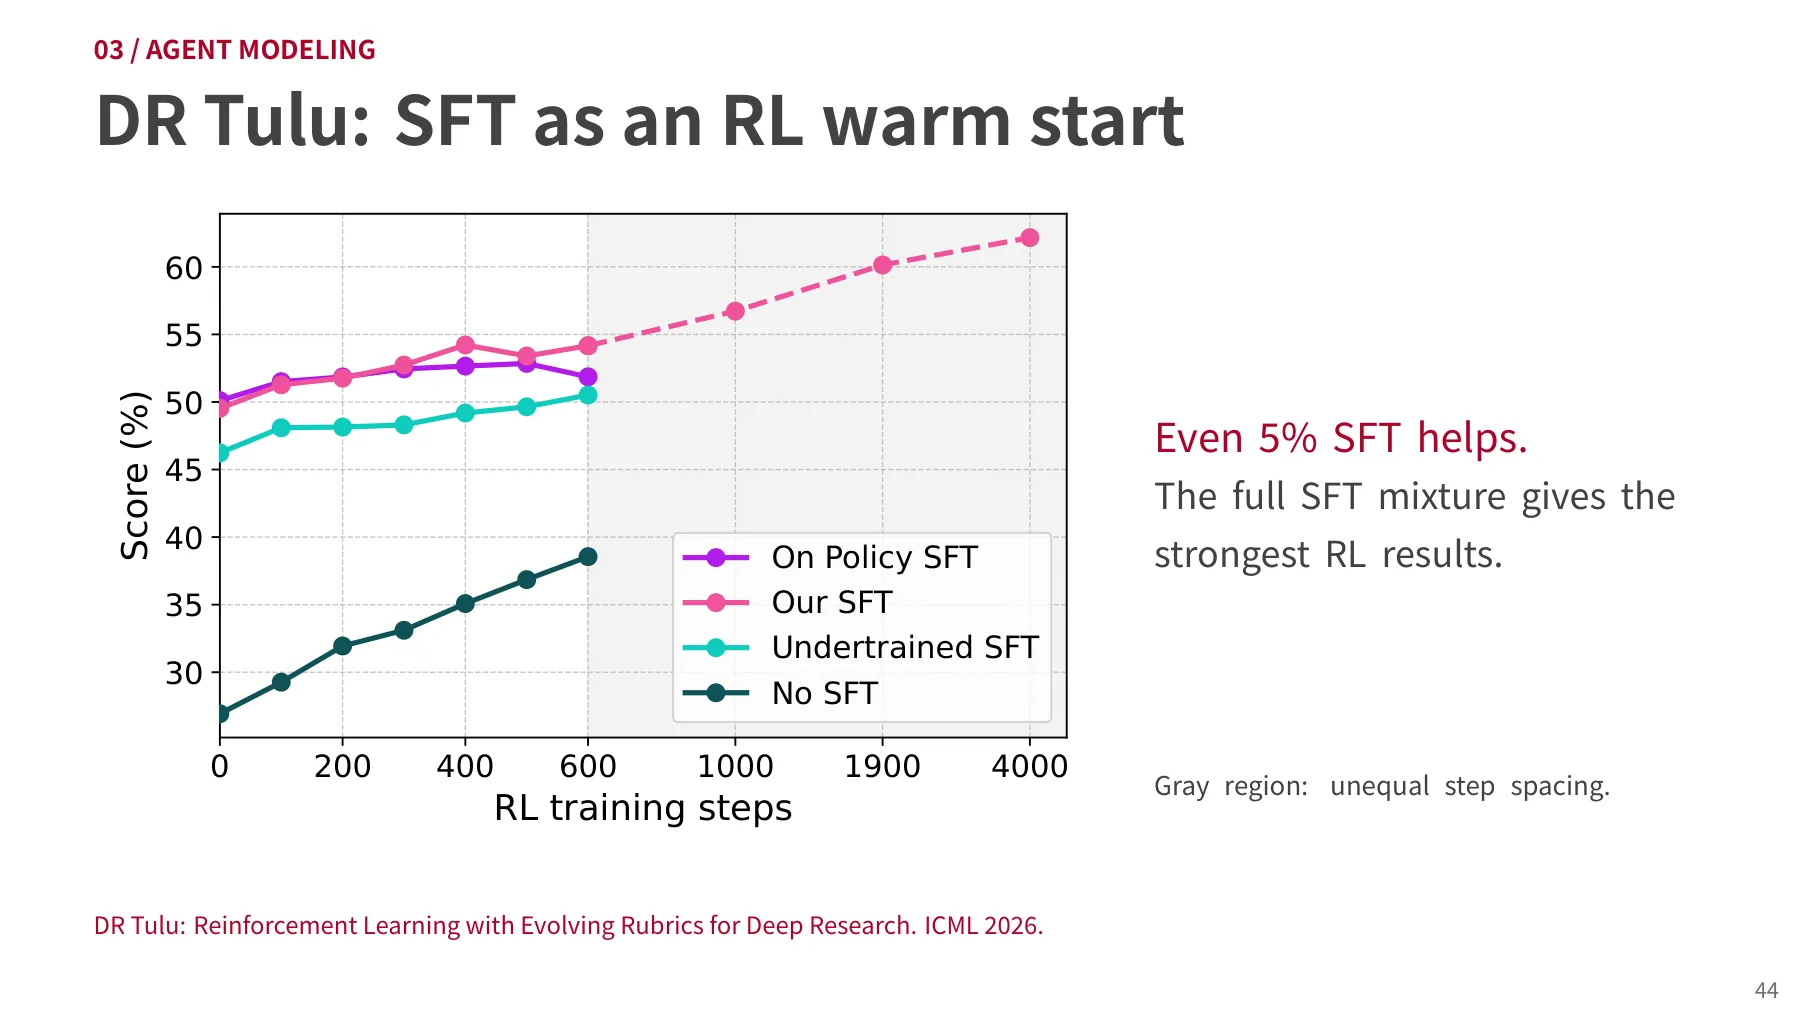
600 步时,无 SFT 的模型只有 39% 左右,而用 5% SFT 数据热身后能高出约 10 个百分点;完整 SFT 混合给出最强的 RL 结果,长跑到 4,000 步仍在涨。直觉是:RL 只在“偶尔能采样到正确行为”时才有梯度信号;纯基座模型在长程任务上几乎不可能偶然走对一次,于是无论怎么采样都拿不到正奖励。SFT 的作用不是教会任务,而是把策略抬到“能偶然成功”的高度。
经验法则
短答案、可验证:SFT + RLVR(exact match 或 judge)足够,重点在数据规模与异步吞吐。开放式报告:先把 rubric 做扎实(并审计),再让 rubric 随策略演化;SFT 必须有,哪怕只有 5% 的数据。
10. 检索底座:检索器不知道 agent 想要什么
前面所有训练都默认“检索工具是可靠的”。事实并非如此。deep research 系统可用的检索工具大致分三类:本地检索(BM25 这类词法检索器、用 embedding 模型做稠密检索)、黑盒 API(web_search、browse)、领域工具(Tongyi 的 Python 执行、Tongyi 与 DR Tulu 的学术检索)。选哪种取决于任务:FinSearchComp 这类任务更适合自建金融文档库,通用开放问题只能走 web API。
稠密检索的机制值得复习一遍,因为后面的改进都建立在它之上:文档离线编码进向量索引,查询在线编码,按内积打分取 top-k:
训练用对比学习,让相关段落 的分数相对负例 更高:
负例可以来自同一 batch 内其他问题的正例(in-batch negatives),也可以是用 BM25 挖出的难负例。这些是 IR 课的内容,这里只需记住一个结论:embedding 的质量取决于“正例定义得对不对”。
问题就出在这个定义上。在 agent 里,检索器的输入通常只有最新一句 query,而 agent 的上下文里有原始任务、上一轮的推理、上一轮的查询、上一轮读到的证据。
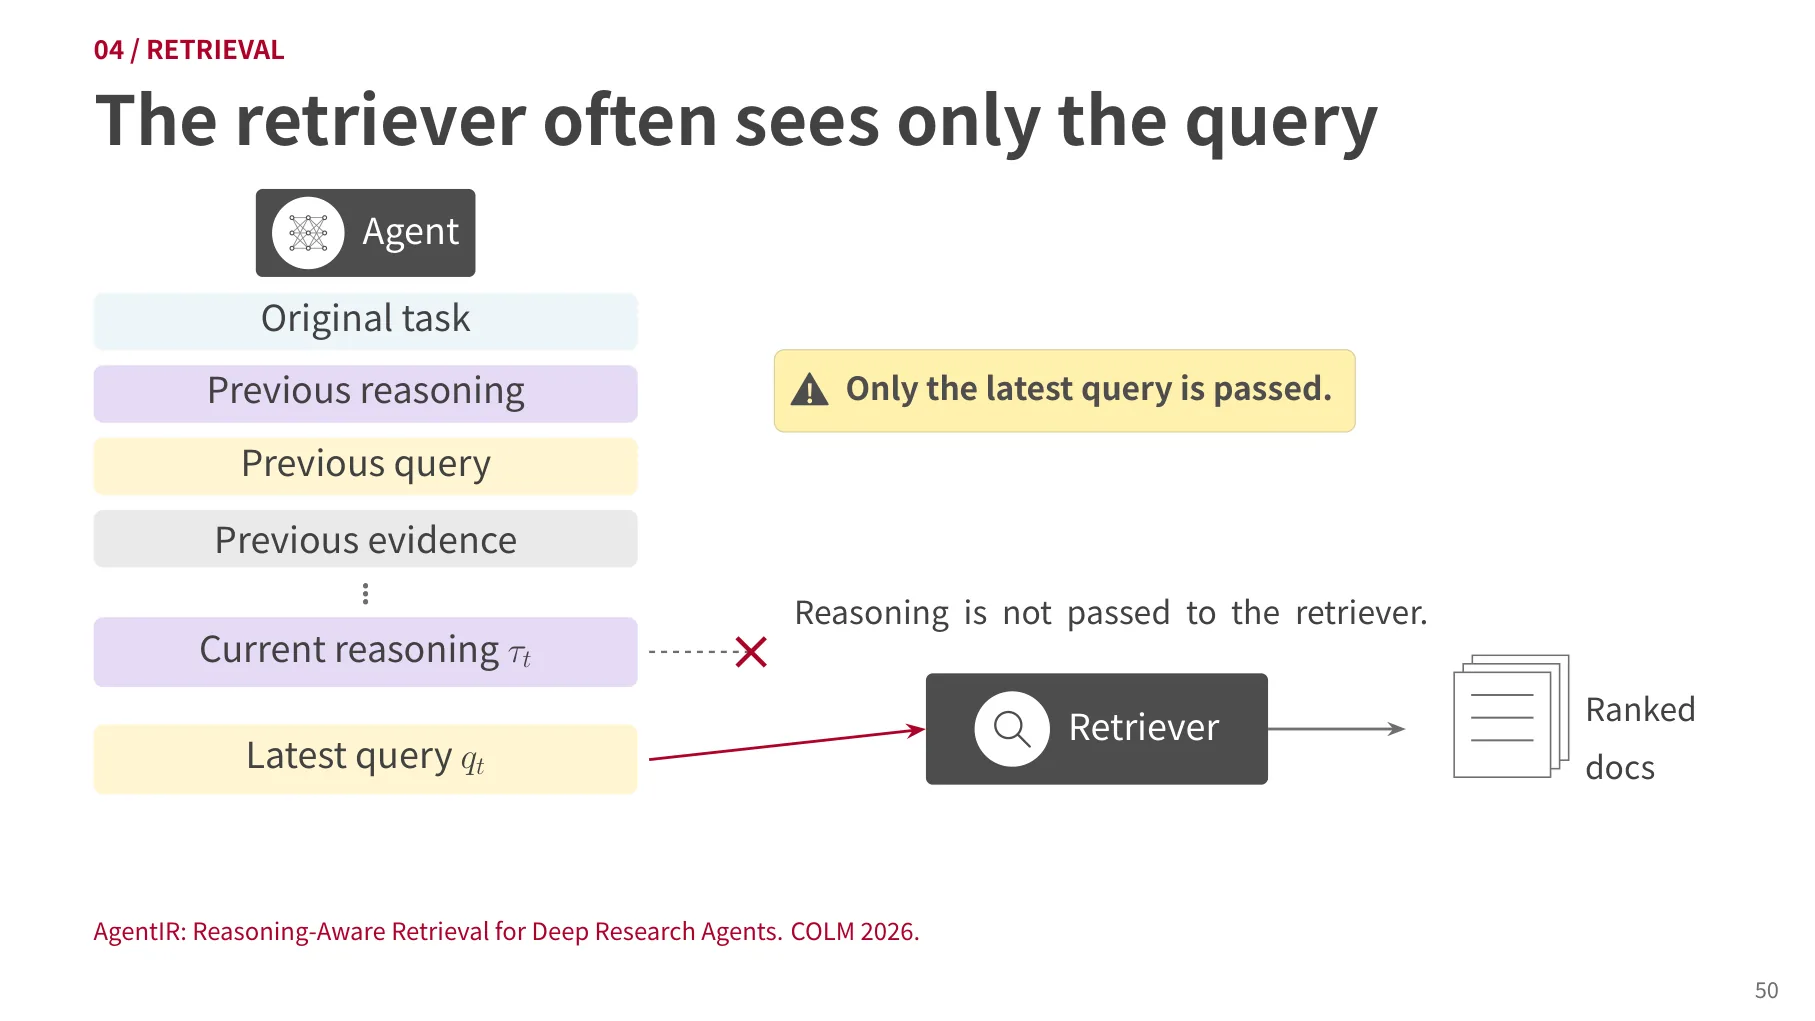
后果是查询欠指定。“2022 年”这三个字在一个已经知道“我在查强生国际收入占比”的 agent 眼里含义完全不同,但对只看到 query 的检索器来说,它只是一个年份过滤条件。更根本的是,这些检索器是在“人类写一句 query”的分布上训练的,而 agent 的中间查询来自另一套分布。
AgentIR 的改动很小:把当前 reasoning 和 query 一起送进检索器——reasoning 里通常已经写明了意图、上一轮发现了什么、这一轮还缺什么。真正的难点不在输入,而在训练数据:轨迹中的中间检索步没有 relevance 标签,只有最终答案是对的。
DR-Synth 就是为此设计的合成标注流程:它绕开“全局问题—文档”的相关性标签,针对轨迹中的每一步判断“这份文档是否有助于这一轮推理”,从而为中间检索步造出局部的正负例。在这批数据上微调检索器,就得到 reasoning-aware 的检索能力。
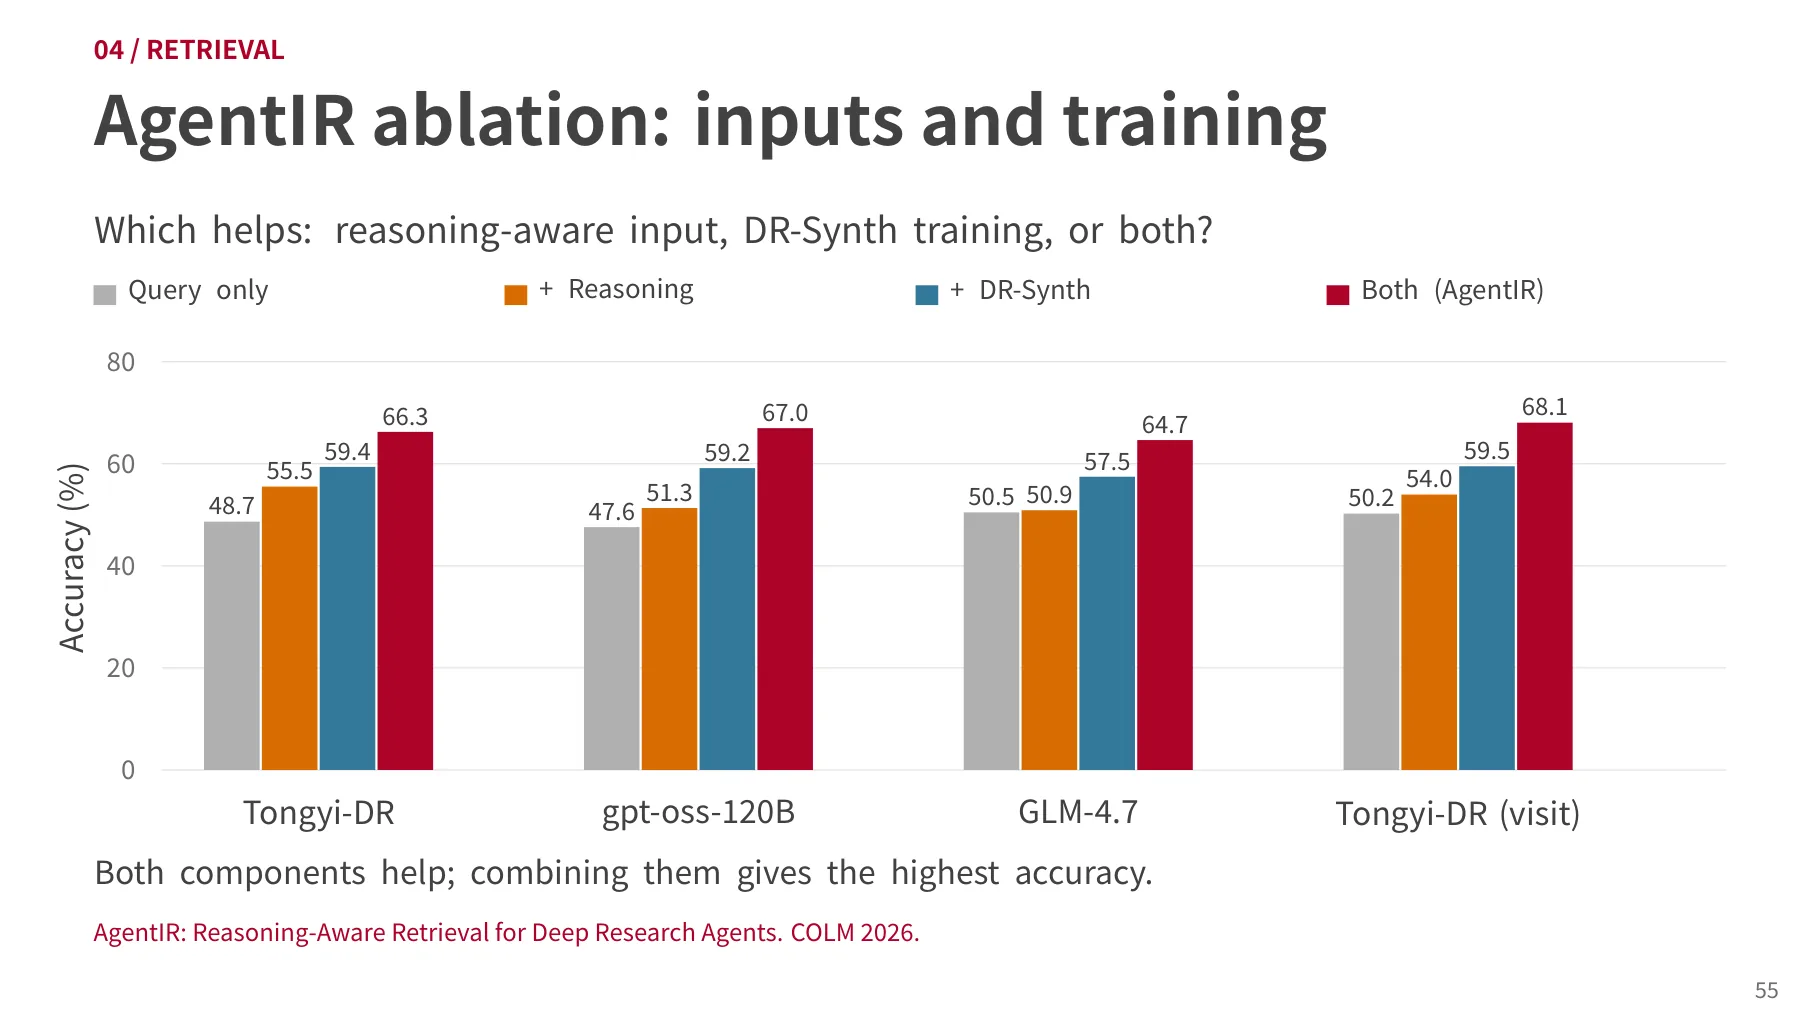
四组柱子的对比很干净。以 Tongyi-DR 为例:只用 query 48.7,加入 reasoning 55.5,只用 DR-Synth 训练 59.4,两者结合 66.3。四个 agent 后端(Tongyi-DR、gpt-oss-120B、GLM-4.7、Tongyi-DR visit)趋势一致,说明这不是某个模型的偶然收益。值得注意的是,仅改输入在四个后端上提升 0.4–6.8 点,Tongyi-DR 上最大、GLM-4.7 上几乎为零;在只看 query 的基础上加 DR-Synth 训练则提升 7.0–11.6 点。两个收益不是同一回事:reasoning 里确实写明了意图,但检索器还得见过这种输入。
历史上下文该给多少?答案是“给推理,不要给文档”。55:23
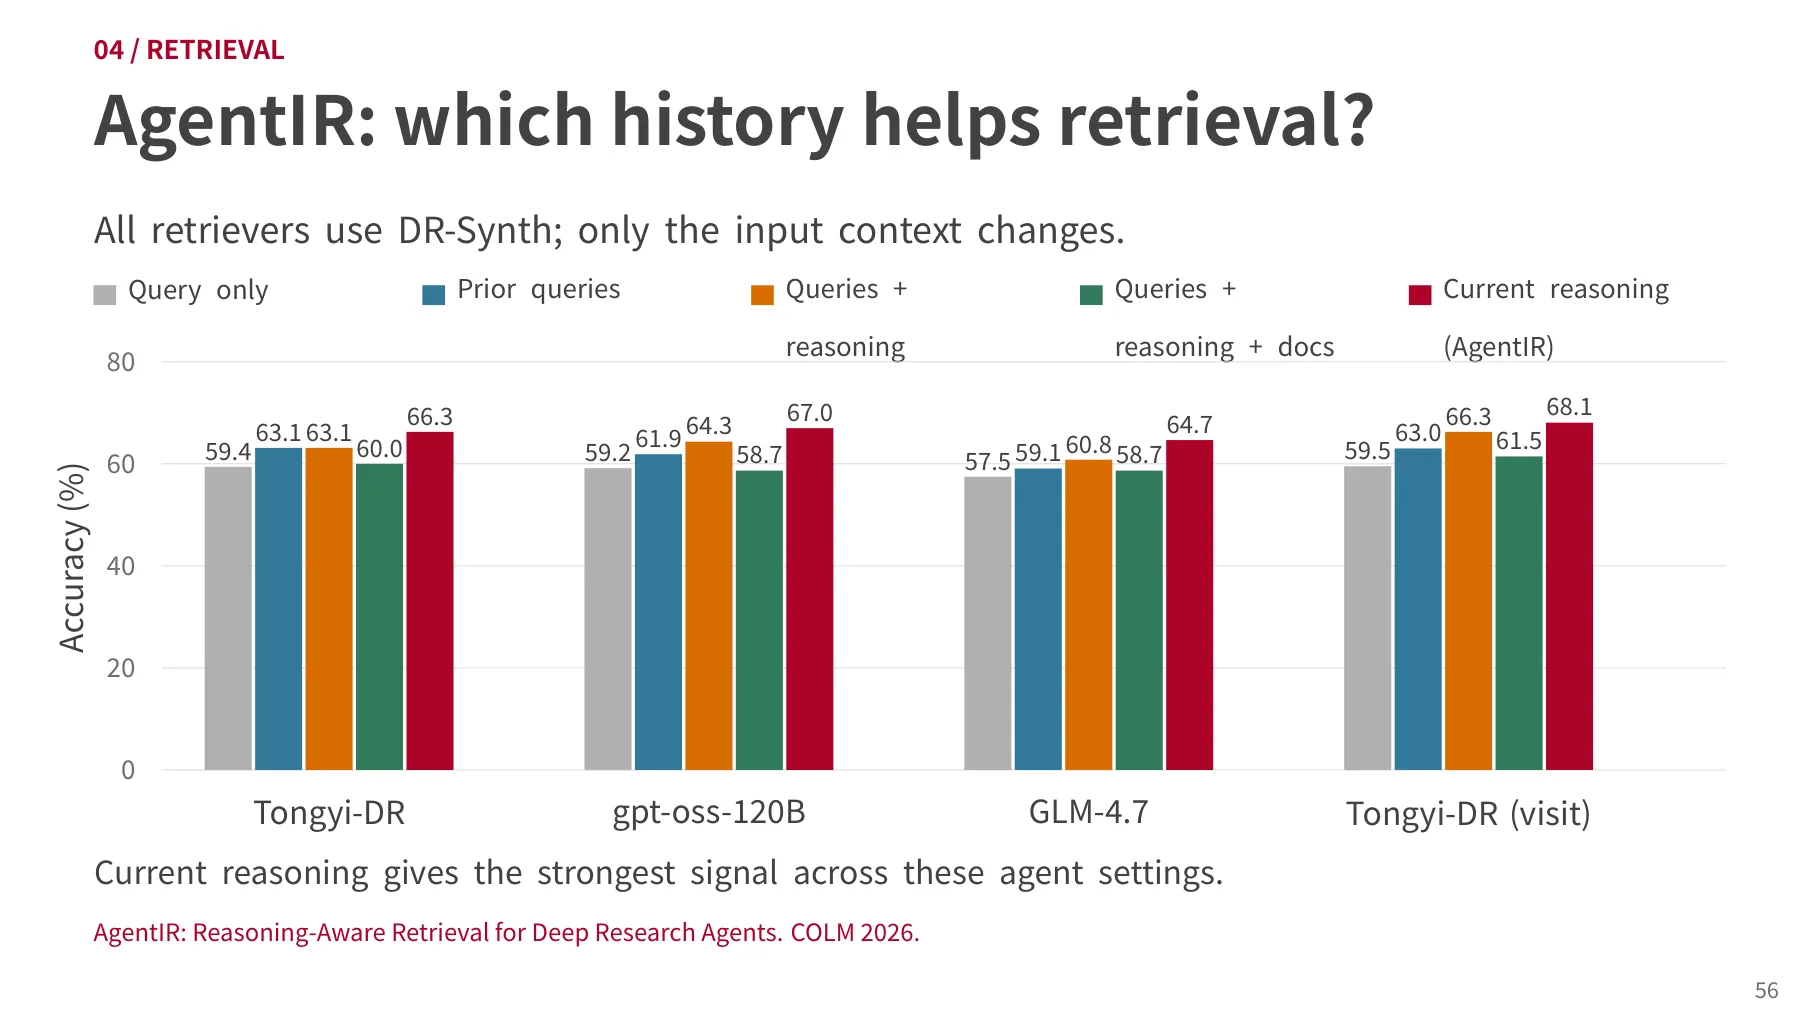
Tongyi-DR 上:只用 query 59.4;加上历史 query 63.1;再加对应 reasoning 仍是 63.1;把历史文档也拼进去掉到 60.0;只给当前 reasoning 则达 66.3。解释是上下文长度:embedding 模型的输入窗口有限,塞进文档会稀释真正的意图信号;而“上一轮的 reasoning”恰好是对任务与已有发现的高密度摘要。这个发现有点反直觉——我们习惯认为“信息越多越好”,但在检索器这一侧,信息的密度比数量重要。
还有一个容易被忽略的点:AgentIR 是一个 4B 的 embedding 模型,比作为基线的 8B Qwen embedding 更小,却效果更好;训练数据只来自 BrowseComp-Plus 上 Tongyi 的轨迹,却能迁移到 gpt-oss-120B 和 GLM-4.7 上。这说明“让检索器理解 agent 意图”是一种模型无关的接口改进,而不是对某个策略的过拟合。
11. 局限、开放问题与实践建议
把这一讲的内容放回研究现状,会看到几个结构性的空缺。
第一,评测仍是瓶颈。 Akari 在问答中把“评测”列为当前最大的瓶颈,理由很实在:短答案基准之所以进步快,是因为目标明确、可以直接逆向工程,还能照搬数学与代码 RL 的成熟配方;而开放式报告连“什么叫好”都没有共识,rubric 有长度偏好等系统性偏差,于是训练信号也无从谈起。66:00
第二,基准污染难以排除。 BrowseComp 这类题在构造时验证过“当时的模型答不出”,但无法保证未来的预训练语料里没有这些题。更实际的漏洞是:agent 可能直接检索到数据集本身(HuggingFace 上的原始 json),而不是去研究问题。DR Tulu 的项目里就遇到过这种情况,讲师也说不确定这条结果最终有没有写进论文;工程上的对策是维护黑名单、屏蔽数据集托管站点。相关研究显示,禁止外部检索后新一代模型在 BrowseComp 上仍低于 20%,这说明记忆不是主要来源,但也无法完全排除。
第三,题目形态与真实需求的偏离。 BrowseComp 的题接近谜题,FinSearchComp 的题接近分析师的日常,两者测的能力并不相同。更进一步,现有基准大多只评“最终报告的质量”,而真实使用中人们是拿报告去做下一步决策——报告是否真的帮人做对了事,目前没有基准在测。
第四,小模型与大模型的能力差距是分层的。 在需要管理上百次工具调用与超长上下文的基准上,8B 级模型即使经过大量 SFT 也难以追上前沿模型;但在开放式综合任务上差距明显更小,因为那里的核心是“收集够信息并组织成文”,而不是“在长程搜索中保持计划不崩”。想做出有价值的系统工作,选对基准比堆算力更重要。
实践层面,这一讲给出的建议相当具体:做短答案可验证任务,BrowseComp 是好起点,适合研究上下文管理与推理时扩展;想省推理成本、或想研究检索器,用 BrowseComp-Plus;做开放式任务,优先看 DeepResearch Bench II 这类由专家报告出发、经人工复核构造 rubric 的基准(DeepResearch Bench 已被广泛使用,但分数已经很高);做领域任务,FinSearchComp 质量较高。检索侧,训练时用 Serper 这类稳定的搜索 API,或干脆用本地索引(BM25、4B 级 embedding)替代真实网络以控制成本;选 embedding 时可以查 MTEB 榜单,Qwen 4B/8B 系列是常见基线。
12. 收束:四个待答的问题
如果用一句话概括这一讲的立场:deep research 的进展速度,取决于我们能不能把“好研究”拆成可测量的部件。四个部件对应四个尚未解决的问题:
- 任务:多轮检索加证据综合,已经是共识;但“多难才算真实”仍无标准,谜题式与分析师式题目各测一半。
- 评测:答案质量与引用支撑要一起看,而 rubric 本身必须被审计——评测的对象不只是模型,也包括评测。
- 训练:先模仿示范、再从自身尝试中学习,这条路径在短答案上已跑通;开放式任务的关键是让奖励信号与策略共同演化。
- 检索:把 agent 的信息需求(而不只是最后一句话)交给检索器,并为这种输入训练它,是当前性价比最高的一步。
Akari 在结尾把四者的现状串了一遍:任务形态尚无共识,评测方法本身就是研究问题,训练信号要与策略共同演化,检索器则要重新理解 agent 的意图。56:11 这也解释了为什么这一讲把大量篇幅给了“怎么评”而不是“怎么训”:在目标函数不清楚的问题上,评测方法就是研究方法。
术语表
| 术语 | 含义 |
|---|---|
| Deep research agent | 面向复杂信息需求、反复规划—检索—反思并产出带引用长报告的系统 |
| RAG | Retrieval-Augmented Generation,一次检索加一次生成的经典流水线 |
| BrowseComp | 1,266 道人工撰写、由多条线索共同约束到唯一实体的检索基准 |
| BrowseComp-Plus | 冻结语料的版本,830 题 / 100,195 篇文档,含人工验证的 hard negatives |
| FinSearchComp | 金融领域专家撰写与复核的 deep search 基准,需计算与跨源核对 |
| MedBrowseComp | 医学领域 deep research 基准,连接试验、药物与监管事实 |
| ScholarQABench | 文献综合基准,2,967 条专家问题与 208 篇长答案,配 rubric 评测 |
| ResearchQA | 从综述论文自动挖掘问题与 rubric 的大规模基准,75 个领域 |
| Rubric | 评分细则:一组带权重的判据,逐条判断答案是否满足后加权汇总 |
| FACT | DeepResearch Bench 的引用核查框架:抽 claim+URL、读页面、判是否支撑 |
| Citation accuracy | 被引页面确实支撑对应论断的引用比例 |
| Effective citations | 通过支撑性检验的有效引用条数 |
| RLVR | Reinforcement Learning with Verifiable Rewards,用可验证答案作奖励 |
| GRPO | Group Relative Policy Optimization,组内相对优势 + 裁剪 + KL 约束 |
| Mid-training | 在继续预训练中混入 agent 轨迹,得到 agent-ready 基座模型 |
| Teacher trajectory | 强模型采样的完整工具使用轨迹,经筛选后用于 SFT |
| Asynchronous rollout | 多条轨迹并行推进、完成即打分,以提高 RL 吞吐 |
| DR-Synth | 为轨迹中间检索步合成相关性标签的数据构造方法 |
| Reasoning-aware retrieval | 把当前推理与查询一起送入检索器的做法(AgentIR) |
| Hard negative | 表面相关、实际不满足条件的负例文档,用于抬高检索难度 |
| Contamination | 基准题目泄漏进训练语料,导致分数虚高 |
延伸阅读
按主题整理本讲涉及的代表性工作(链接为按标题检索的入口,便于找原文):
基准与评测
- BrowseComp: A Simple Yet Challenging Benchmark for Browsing Agents · OpenAI,2025
- BrowseComp-Plus: A Fair and Disentangled Evaluation Benchmark for Deep Search Agents · ACL 2026
- FinSearchComp: Towards a Realistic, Expert-Level Evaluation of Financial Search and Reasoning · ICLR 2026
- MedBrowseComp: Benchmarking Medical Deep Research and Computer Use · NeurIPS 2025 Workshop
- DeepResearch Bench: A Comprehensive Benchmark for Deep Research Agents · ICLR 2026
- DeepResearch Bench II: Diagnosing Deep Research Agents via Rubrics from Expert Reports · arXiv 2026
- ResearchQA: Evaluating Scholarly Question Answering at Scale Across 75 Fields · TACL 2026
- A Critical Evaluation of Evaluations for Long-form Question Answering · ACL 2023
模型与训练
- Synthesizing scientific literature with retrieval-augmented language models · Nature 2026(OpenScholar)
- DR Tulu: Reinforcement Learning with Evolving Rubrics for Deep Research · ICML 2026
- Tongyi DeepResearch Technical Report · arXiv 2025
- WebDancer: Towards Autonomous Information Seeking Agency · NeurIPS 2025
- Search-R1: Training LLMs to Reason and Leverage Search Engines with Reinforcement Learning · COLM 2025
- WebSailor-V2: Bridging the Chasm to Proprietary Agents via Synthetic Data and Scalable RL · ICLR 2026
- Scaling Agents via Continual Pre-training · ICLR 2026
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models · arXiv 2024(GRPO)
检索
- Dense Passage Retrieval for Open-Domain Question Answering · EMNLP 2020
- AgentIR: Reasoning-Aware Retrieval for Deep Research Agents · COLM 2026
- ScholarSearch: Benchmarking Scholar Searching Ability of LLMs · arXiv 2025
- AutoResearchBench: Benchmarking AI Agents on Complex Scientific Literature Discovery · arXiv 2026
自测题
1. 为什么说 deep research agent 不能简单看作“更长的 RAG”?
RAG 的检索次数、上下文与工具调用是固定的(通常一次检索一次生成);deep research 中这些量是策略自己决定的变量,且后一步检索依赖前一步读到什么。评测对象也随之变化:不再只是答案字符串,而是答案加证据链,还要看结论是否被恰当限定。训练上则出现信用分配问题——最终报告的分数要归因到几十次中间决策。
2. Natural Questions 这类基准在哪些维度上“太简单”?补齐每个维度各需要什么设计?
四个维度:检索复杂度(需多步、后一步依赖前一步 → 需多跳题与长轨迹)、领域专长(需读懂领域证据 → 需专家撰写与复核的领域基准)、答案形态(需长文综合 → 需 rubric 或成对偏好评测)、证据支撑(需可审计 → 需 claim–citation 配对与支撑性判断)。这四条正好对应 BrowseComp / FinSearchComp / ScholarQABench / DeepResearch Bench 的分工。
3. BrowseComp 的 25.3% 人类分数与 Deep Research 的 51.5% 应当如何解读?
不能读成“AI 研究能力是人类两倍”。人类分数低部分是因为题目是约束满足式谜题,人类受检索技巧与耐心限制;且 51.5% 的系统标注为“针对 BrowseComp 风格任务训练过”,说明其中包含对题型的适配。更合理的结论是:在“开放网络上做多约束搜索并给出短实体答案”这一具体能力上,专用系统已超过普通人类被试;这不等于在真实研究任务上达到专家水平。
4. BrowseComp-Plus 冻结语料换来了什么,又失去了什么?
换来可复现(分数可比)、可分离归因(检索失败 vs 推理失败)、可训练(能训练并评测自己的检索器)。失去的是真实开放网络的失败模式:找不到正确文档被替换成在候选里排序,难度由 hard negatives 的质量重新定义,agent 也无法通过换信息源绕过死路。可控性与真实性在此直接对立。
5. 为什么 ROUGE/BERTScore/BLEURT 不适合作为长文研究的评测主指标?
它们度量与参考答案的表层或嵌入相似度,而开放式问题有多种正确写法,且“词汇高度重叠但结论被夸大/反转”的答案会得高分。实验中它们选出专家偏好答案的准确率仅 57%–62%(随机 50%)。它们可以作为辅助信号,但不能替代对结论正确性、限定性与引用支撑的判断。
6. 写出 rubric 打分的公式,并解释为什么这个设计能惩罚“过度概括”的结论。
,其中 表示第 条判据是否被满足, 是权重。若 rubric 里有一条“按任务与领域限定结论”且权重非零,那么把“某研究里专家更偏好”写成“所有领域都已证明等价”时该条判 0,总分被拉低。相似度指标看不到这种差别,rubric 通过显式条目把它变成可扣分项。
7. ResearchQA 用 LM 生成 rubric 扩到了很大规模,代价是什么?三类典型错误是什么?
代价是质量:专家审计发现 15% 的生成式条目空洞、错误或含糊。三类典型错误:(a) 引用了不存在的论文;(b) 只是把问题重述一遍(同义反复,无法区分好坏答案);(c) 过于笼统,让似是而非的错误也能通过。缓解方向是把条目锚定在来源证据上,并对条目本身做相关性、可验证性审计。
8. 为什么 deep research 的 RL 训练要先做 mid-training 和 SFT?只用 RL 会怎样?
RL 需要“偶尔采样到正确行为”才能产生梯度。纯基座模型在需要上百次工具调用的任务上几乎不可能偶然成功,奖励全是 0,策略无从改进。mid-training 让模型先熟悉 agent 工作流的格式与节奏(复杂任务收益大、短程任务几乎无收益),SFT 把策略抬到“能偶然成功”的高度;实验显示即使只用 5% 的 SFT 数据,600 步 RL 后的分数也比无 SFT 高约 10 个点。
9. DR Tulu 为什么让 rubric 随训练演化?消融结果说明了什么?
开放式报告没有唯一答案,只能靠 rubric 打分;而固定 rubric 会与变强的策略脱节——策略不再犯旧错误,旧条目就不再提供信号。做法是用多条 rollout 对比生成新的正/负条目,存入缓冲区并持续更新。消融显示:随机奖励无提升;初始 rubric 有提升;演化 rubric 提升更大,且训练越久优势越明显,说明“初始质量”与“可适应性”是两个独立收益来源。
10. AgentIR 只改了两件事,为什么能同时提高准确率并减少检索次数?历史文档为什么反而有害?
两件事是:把当前 reasoning 与 query 一起作为检索器输入;用 DR-Synth 为中间检索步合成局部相关性标签并微调。reasoning 里包含意图、已发现的事实与当前缺口,弥补了短 query 的欠指定。消融显示仅改输入在四个后端上提升 0.4–6.8 点;在只看 query 的基础上加 DR-Synth 训练提升 7.0–11.6 点,两者结合最高(Tongyi-DR 66.3%)。课件还报告:在 BrowseComp-Plus 上把 BM25 换成这类检索器后,准确率上升的同时总检索次数下降,说明收益不只是“更准”,也是“更省”。历史文档有害是因为 embedding 输入窗口有限,塞入文档会稀释意图信号(在“queries + reasoning”上再加文档,Tongyi-DR 从 63.1 掉到 60.0);“上一轮 reasoning”是对任务与发现的高密度摘要,因此最有效。