
1a · Course Overview: What Is an Agent?
本讲速览
- Agent 的经典定义没有过时。 Russell & Norvig 的“通过传感器感知环境、通过执行器作用于环境”在今天依然成立,只是传感器变成了文件内容、网页、截图和工具返回值,执行器变成了回复、编辑、shell 命令和鼠标键盘事件。
- 能力在快速上升,边缘依然很糙。 一边是 16 个 agent 用两周写出 10 万行、能编译 Linux 内核的 Rust C 编译器;另一边是同一个时代的 agent 在上下文压缩后忘掉“不要删邮件”的指令,把用户收件箱清空。
- 自主性不是二元开关。 课程用六个真实任务做现场投票,结果说明人们对“完全自主 / 先问再做 / 永远别碰”的分界线并不一致,而这条分界线恰恰是安全设计的输入。
- Tool call 本质上是又一段 token。 模型预测出“工具名 + 参数”的 token 序列,harness 负责解析、校验、执行,再把结果作为 observation token 塞回上下文;所谓 agent,就是“模型在循环里”。
- 六项能力,两条路线。 精确工具调用、长上下文一致性、可定制性、复杂任务管理、环境理解、安全,每一项都可以用 LLM 训练或 harness 工程来做;工程实践通常先在 harness 侧解决,等模型厂商把它吸收进训练。
- Agent 是系统,不是模型。 Harness、sandbox、推理服务、训练系统、可观测性五个部件缺一不可,任何一处短板都会在长程任务里被放大。
- 课程的主线是“造出来、量出来、训出来”。 三次作业分别对应 harness、评测、训练,最后用项目把这些能力整合到一个自己选的任务上。
1. 这门课要回答什么
如果把 2026 年的 agent 生态压缩成一个问题,那就是:当模型已经能写出看起来合理的行动计划时,我们凭什么相信它真的能把事情做完、做对、且不闯祸? 这门课不接受“模型会越来越强,问题自然消失”这种回答。Graham 在课上的说法很直接:模型不会自己变好,是人把模型变好的;而把这个“人把模型变好”的过程拆开,就是数据、环境、奖励、harness 和评测。
课程的位置因此很特殊:它既不是纯 NLP 课,也不是纯系统课。前半段讲 agent 的构造(工具、上下文、记忆、规划),中段讲领域(coding、GUI)与训练(SFT、RL),后段讲框架、安全与人机交互。本讲作为导论,承担三件事:
- 给出一个能贯穿全课、又不至于太窄的 agent 定义;
- 用正反两类案例说明当前能力的真实边界;
- 交代课程的结构、作业与评分,让后面每一讲都能挂到这张地图上。
00:49 两位讲师的分工也反映了这门课的两条腿:Daniel Fried 偏 grounded agent 与人机交互,Graham Neubig 偏 coding agent 与 OpenHands 这类系统实现。后面的 guest lecture 也延续这个思路——请各领域真正在做研究的人来讲。
2. 两个案例:能力的天花板与地板
课程开场没有先给定义,而是先给两个刺激。这个顺序是刻意的:定义很容易背,但“当前 agent 到底能干什么”必须靠具体证据建立直觉。
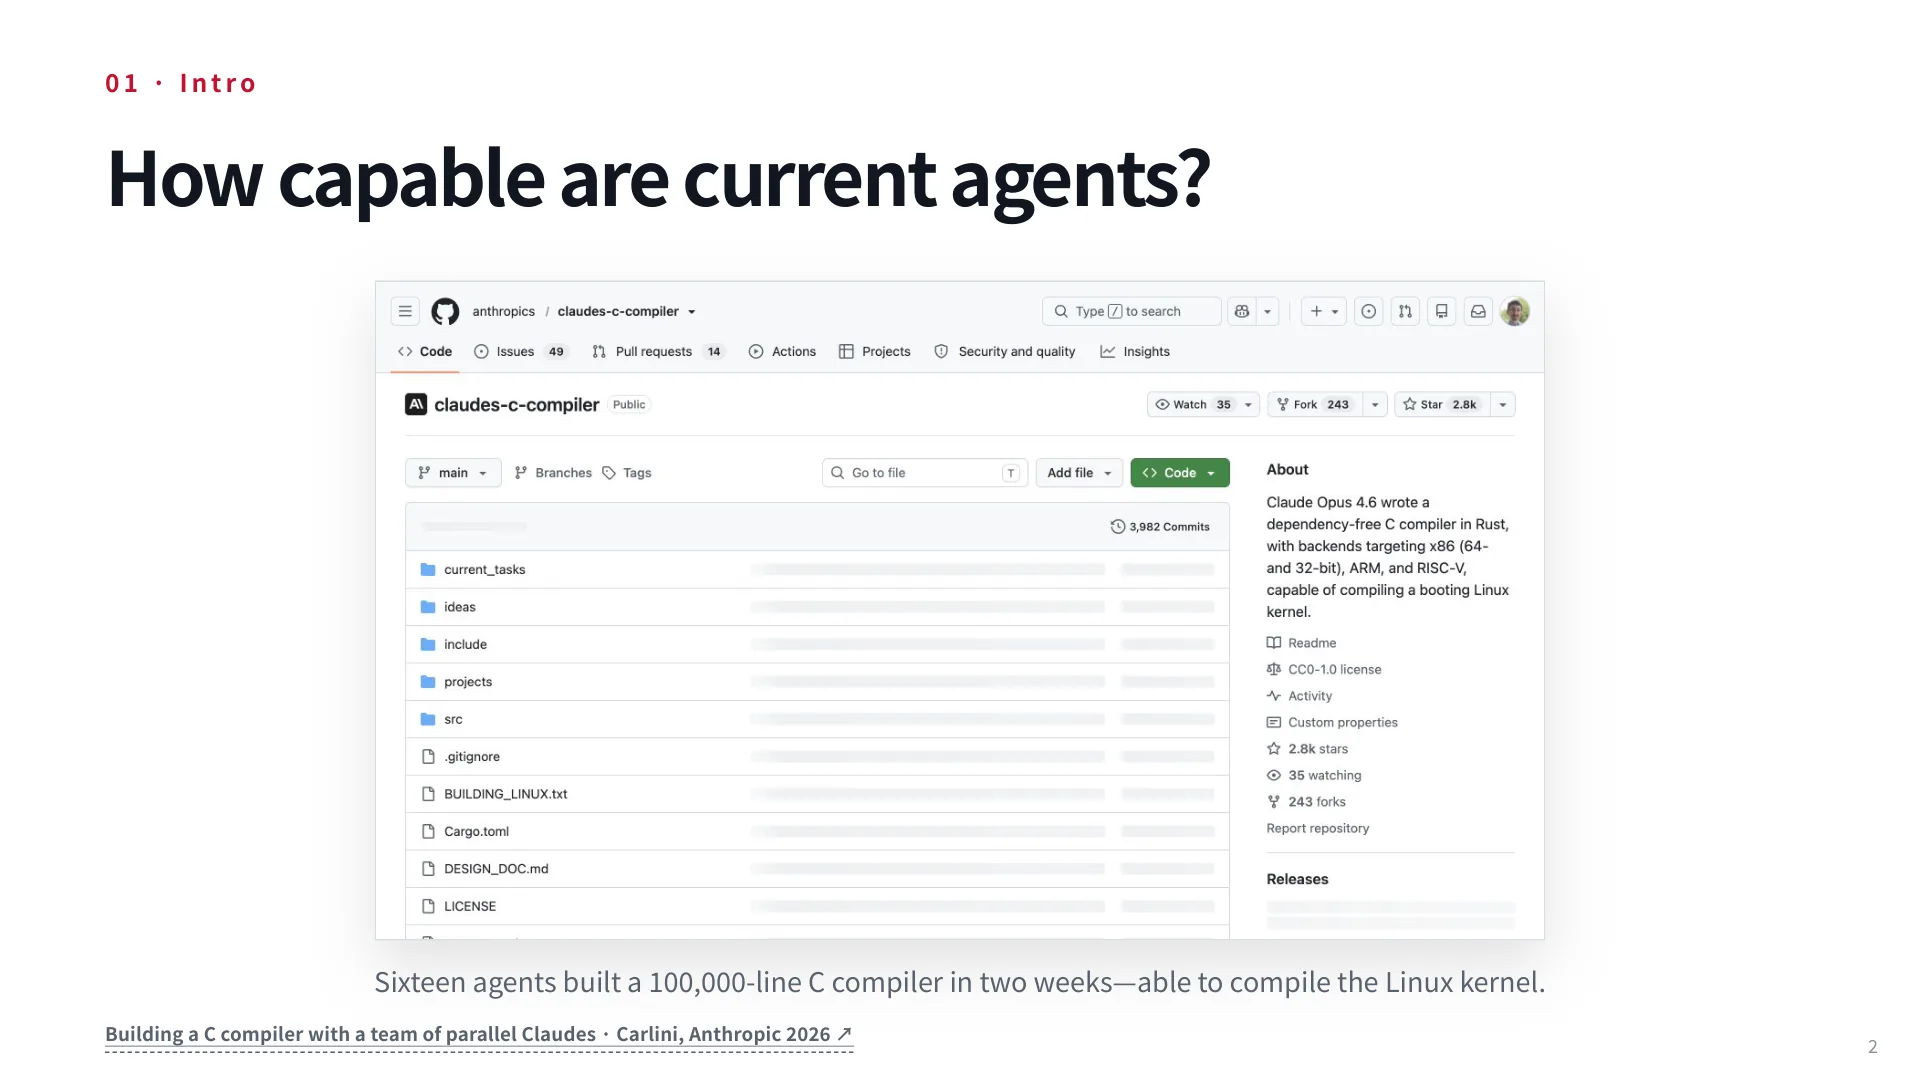
第一个案例来自 Anthropic 的 Carlini:16 个 agent 并行协作两周,用 Rust 写出了一个 10 万行的 C 编译器,能够编译 Linux 内核。这件事的意义不在于“编译器”这个任务本身,而在于它同时压测了 agent 的几个薄弱环节——任务分解、跨 agent 的接口约定、长时间运行中的状态维护、以及用测试用例自我验证。一个 agent 写 10 万行代码几乎必然失控,十六个 agent 分工反而把问题变成了“如何定义清晰的子任务边界”,这恰好是软件工程擅长的部分。01:39 讲师复述这四个数字时的语气值得回味:两周、十六个 agent、十万行、能编译内核——其中最后一个才是真正的门槛,它意味着这个编译器不是玩具。
第二个案例方向相反。一位用户(幻灯片标注来源为 X 上的 Summer Yue,2026 年 2 月)让 agent 整理收件箱,agent 决定“采取核选项”(the nuclear option),把不在保留列表里的邮件全部清空。用户中途介入、明确说“不要这样做”,agent 仍然继续,事后承认“我记住了,但我违反了”。真正的原因在事后分析里:agent 压缩了自己的上下文(context compaction),而那条“不要删邮件”的指令在压缩中被丢掉了。02:29 这段对话里最刺人的一句是 agent 事后说的“我记住了,但我违反了”——它说明模型并不是不知道约束,而是约束已经不在它的上下文里。
把两件事放在一起看,会得到一个对本课程很重要的判断:agent 的失败往往不是“模型不够聪明”,而是系统层面的信息丢失、边界缺失或验证缺位。 上下文压缩是 harness 的策略,删除权限是 sandbox 的策略,事后无人发现是监控的缺失。三者都是工程问题,也都可以在课程里被单独讲授和练习。
一个反复出现的模式
长程任务里的错误几乎总是“复合”的:模型的一次判断失误 + harness 没有校验 + sandbox 权限过大 + 监控没有告警。修复通常不需要更强的模型,而需要在这四层里任意一层加一道闸。
3. 自主性的边界:一张没有标准答案的判断题
第二个环节是一个现场投票。课件给了六个任务,请学生选择“完全自主”“先问再做”“永远别碰”:
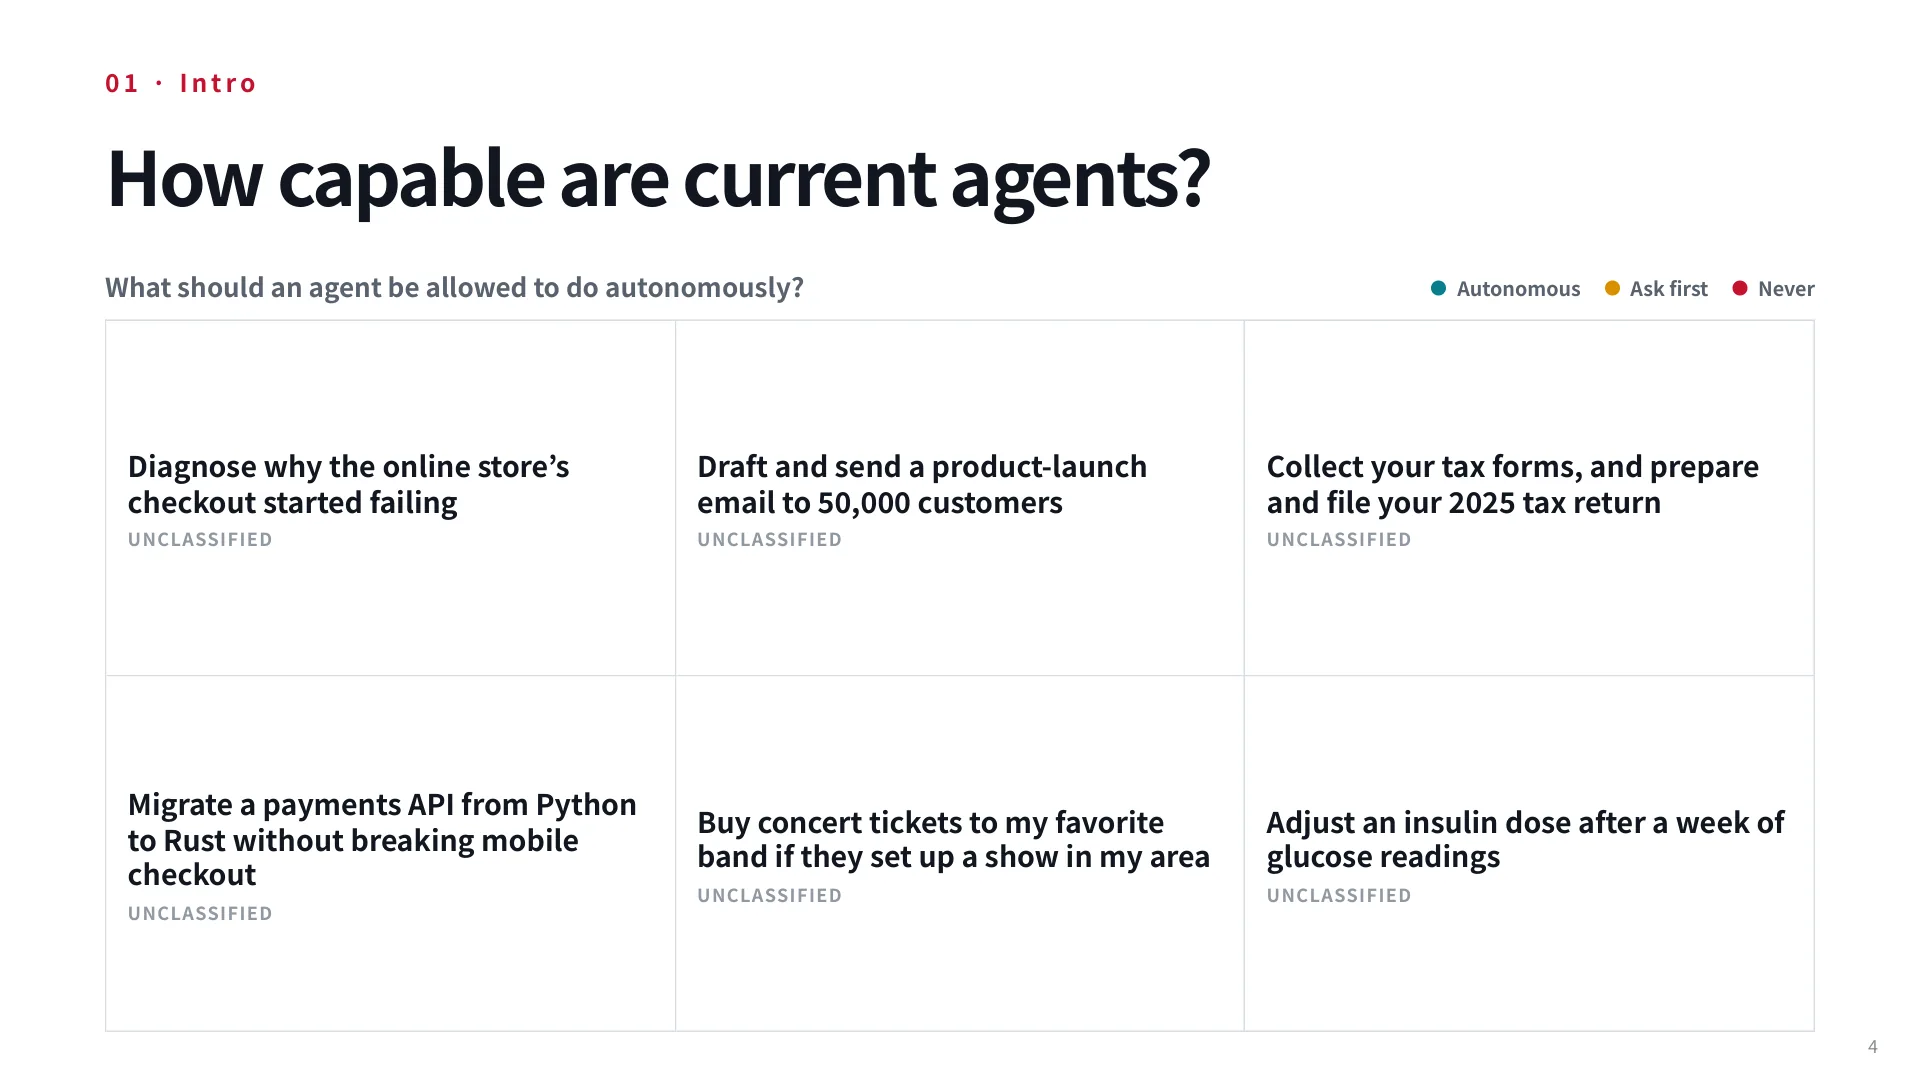
| 任务 | 现场倾向 | 关键风险 |
|---|---|---|
| 诊断线上商店 checkout 为何开始失败 | 偏自主 | 只读诊断,可回滚 |
| 起草并群发产品发布邮件给 5 万客户 | 先问再做 | 不可撤回的对外沟通 |
| 收集税表、准备并提交 2025 年报税 | 最多人选“永远别碰” | 法律与财务后果 |
| 把支付 API 从 Python 迁到 Rust 且不破坏移动端 | 自主与先问几乎持平 | 有测试可验证,但爆炸半径大 |
| 若喜欢的乐队来本地演出就买票 | 偏自主 | 金额有限、可预期 |
| 根据一周血糖数据调整胰岛素剂量 | 多数选“永远别碰” | 人身安全、不可逆 |
投票结果并不重要,重要的是分歧的形状。同一个班级里,对“迁移支付 API”这种有明确测试的任务,意见几乎对半;而对“买票”这种小额、可撤销的任务,多数人愿意放权。也就是说,人们的判断并不遵循“任务难度”,而遵循三个更朴素的维度:
- 可逆性:错了能不能撤回来。删邮件、发群发邮件、改胰岛素剂量都不可逆。
- 可验证性:有没有客观信号判断对错。迁移支付 API 有测试套件,报税没有。
- 爆炸半径:一次失败的代价是几美元还是几百万美元,是一个人还是一片用户。
03:18 投票开始前,讲师特意强调这些判断“相当主观”(pretty subjective),目的不是得出正确答案,而是让学生意识到:你设计 agent 时所做的每一个权限决定,都是在替用户回答这张表。 后面关于 sandbox、凭证管理和 human oversight 的讲座,本质上都是把这张表工程化。
讲师提醒:安全不是一个独立于能力的模块。Graham 的说法是“capability safety is a capability”——如果模型没有把“不该做的事”学进策略里,用户就不会放心用它,这本身就是能力缺陷。
4. 从两个 demo 看 agent 的形态
在给定义之前,课程放了两段 demo,用来建立“agent 长什么样”的直观印象。
第一段是 CMU 早期的 GUI agent 工作,由学生 Jing Yu Koh 制作:任务是“在匹兹堡找一家评分 4.3 以上、至少 200 条评论的泰餐店”。左侧是浏览器画面,agent 在 Yelp 搜索框里输入、翻页、点进店铺;右侧是模型产生的 chain of thought。这段 demo 的价值在于它展示了 GUI agent 的核心困难:观测是高维像素,动作是低维坐标,中间没有 API 可以依赖,模型必须自己把“看到的东西”映射成“点哪里”。
第二段是 Graham 的 OpenHands 演示,任务是“做一个 to-do list 应用并测试它”。
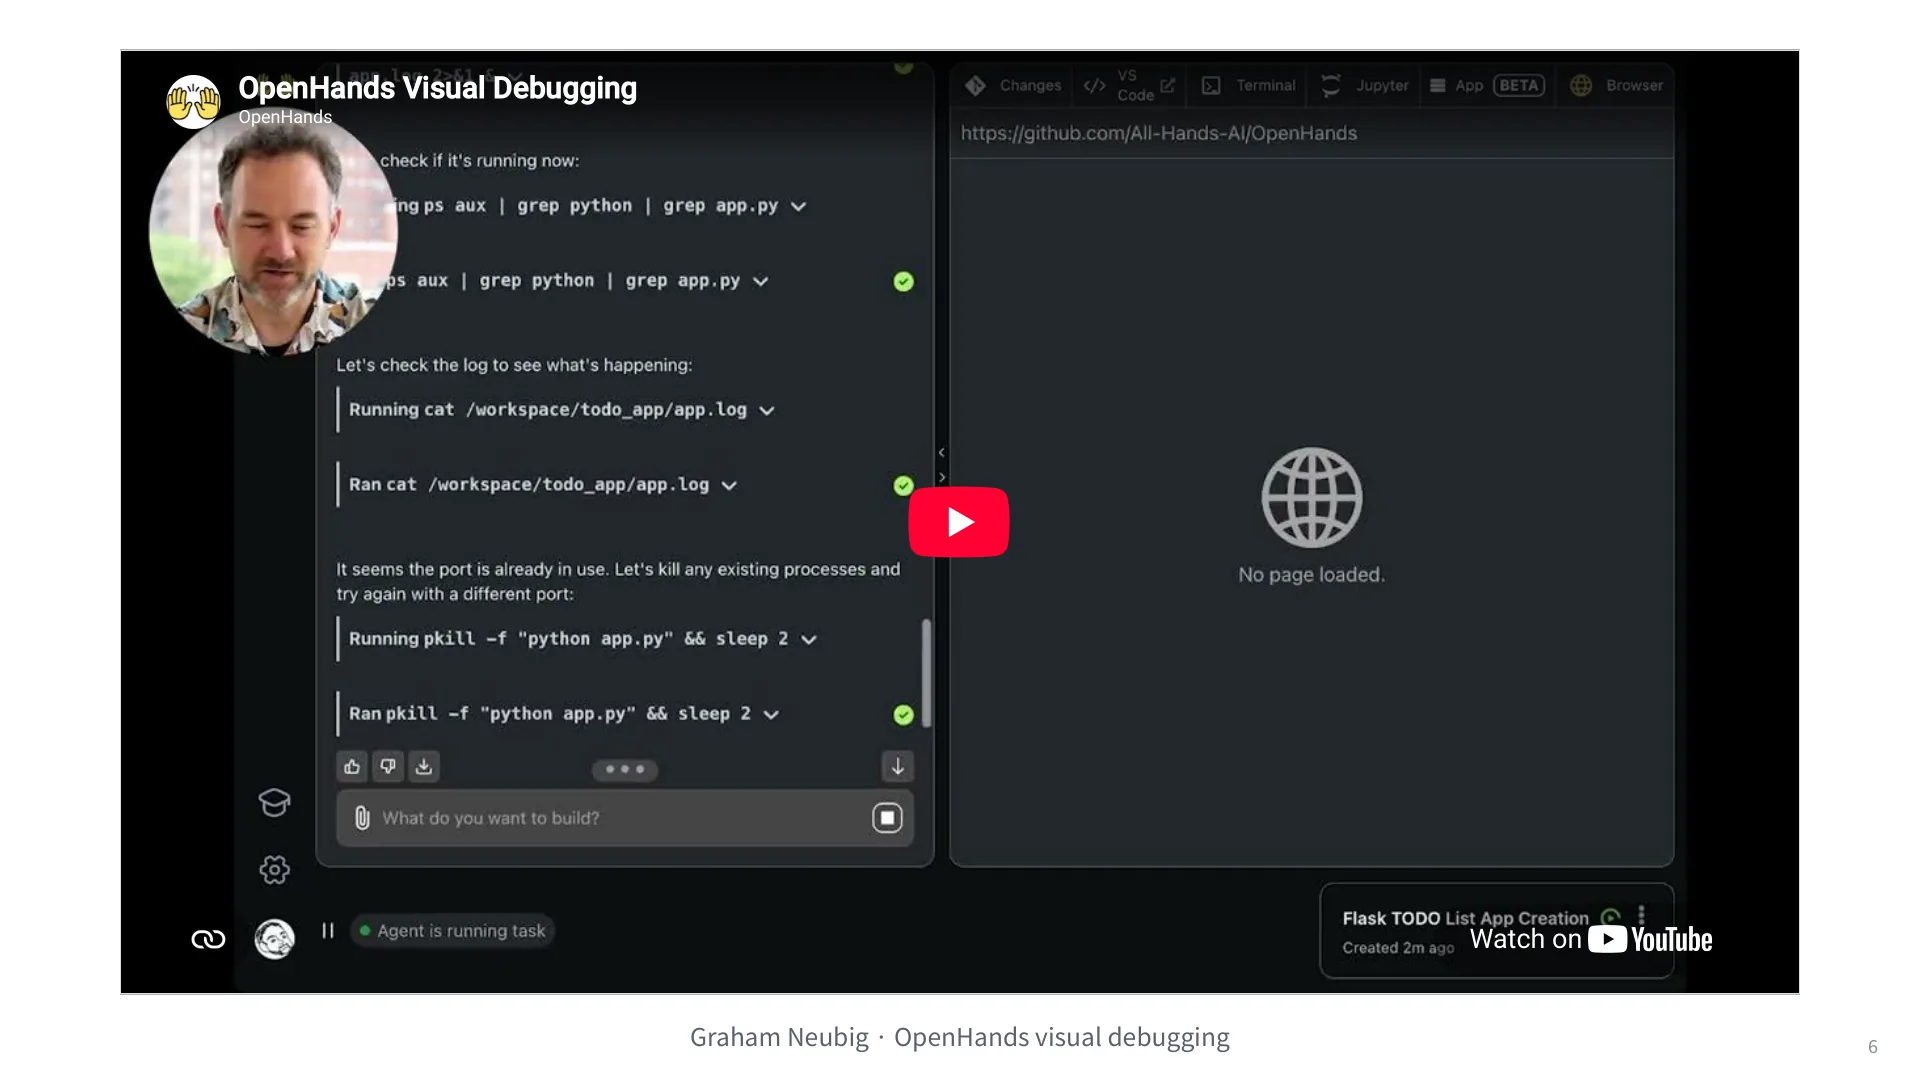
这段视频信息密度很高,值得逐步拆:
- agent 建目录、写
app.py、写模板和样式、补requirements.txt和 README——它在遵循工程惯例,而不是只生成能跑的代码; - 它把服务放到后台运行,然后检查日志,发现端口被占用,换端口重试;
- 服务起来后,它用浏览器访问页面,输入“buy groceries”、点击、再测试删除功能;
- 视频里 Graham 提到有一次应用崩了,agent 比他更早发现并修好了。
这四步正好对应后面要讲的循环:行动 → 观察 → 修正假设 → 再行动。注意第 2 步和第 3 步:如果没有“读日志”和“打开浏览器”这两个工具,agent 就只能写完代码然后宣称成功。工具的存在决定了 agent 能否验证自己。
11:20 讲师在 demo 收尾时说了一句很关键的话:这类任务“你只需要说一句‘做个 app 然后测一下’,不需要做别的”。这句话是承诺也是陷阱——它成立的前提是 harness 已经把运行、日志、浏览器这些能力准备好了。
5. 定义:四要素与它们的当代对应物
正式的定义来自 Russell & Norvig 的经典教材:
An agent is anything that can be viewed as perceiving its environment through sensors and acting upon that environment through actuators.
这句话的力量在于它的抽象层次。它不假设 agent 是程序、是机器人还是人,只要求存在感知—行动的闭环。课件随即把这个抽象映射到 2026 年的具体物件上:
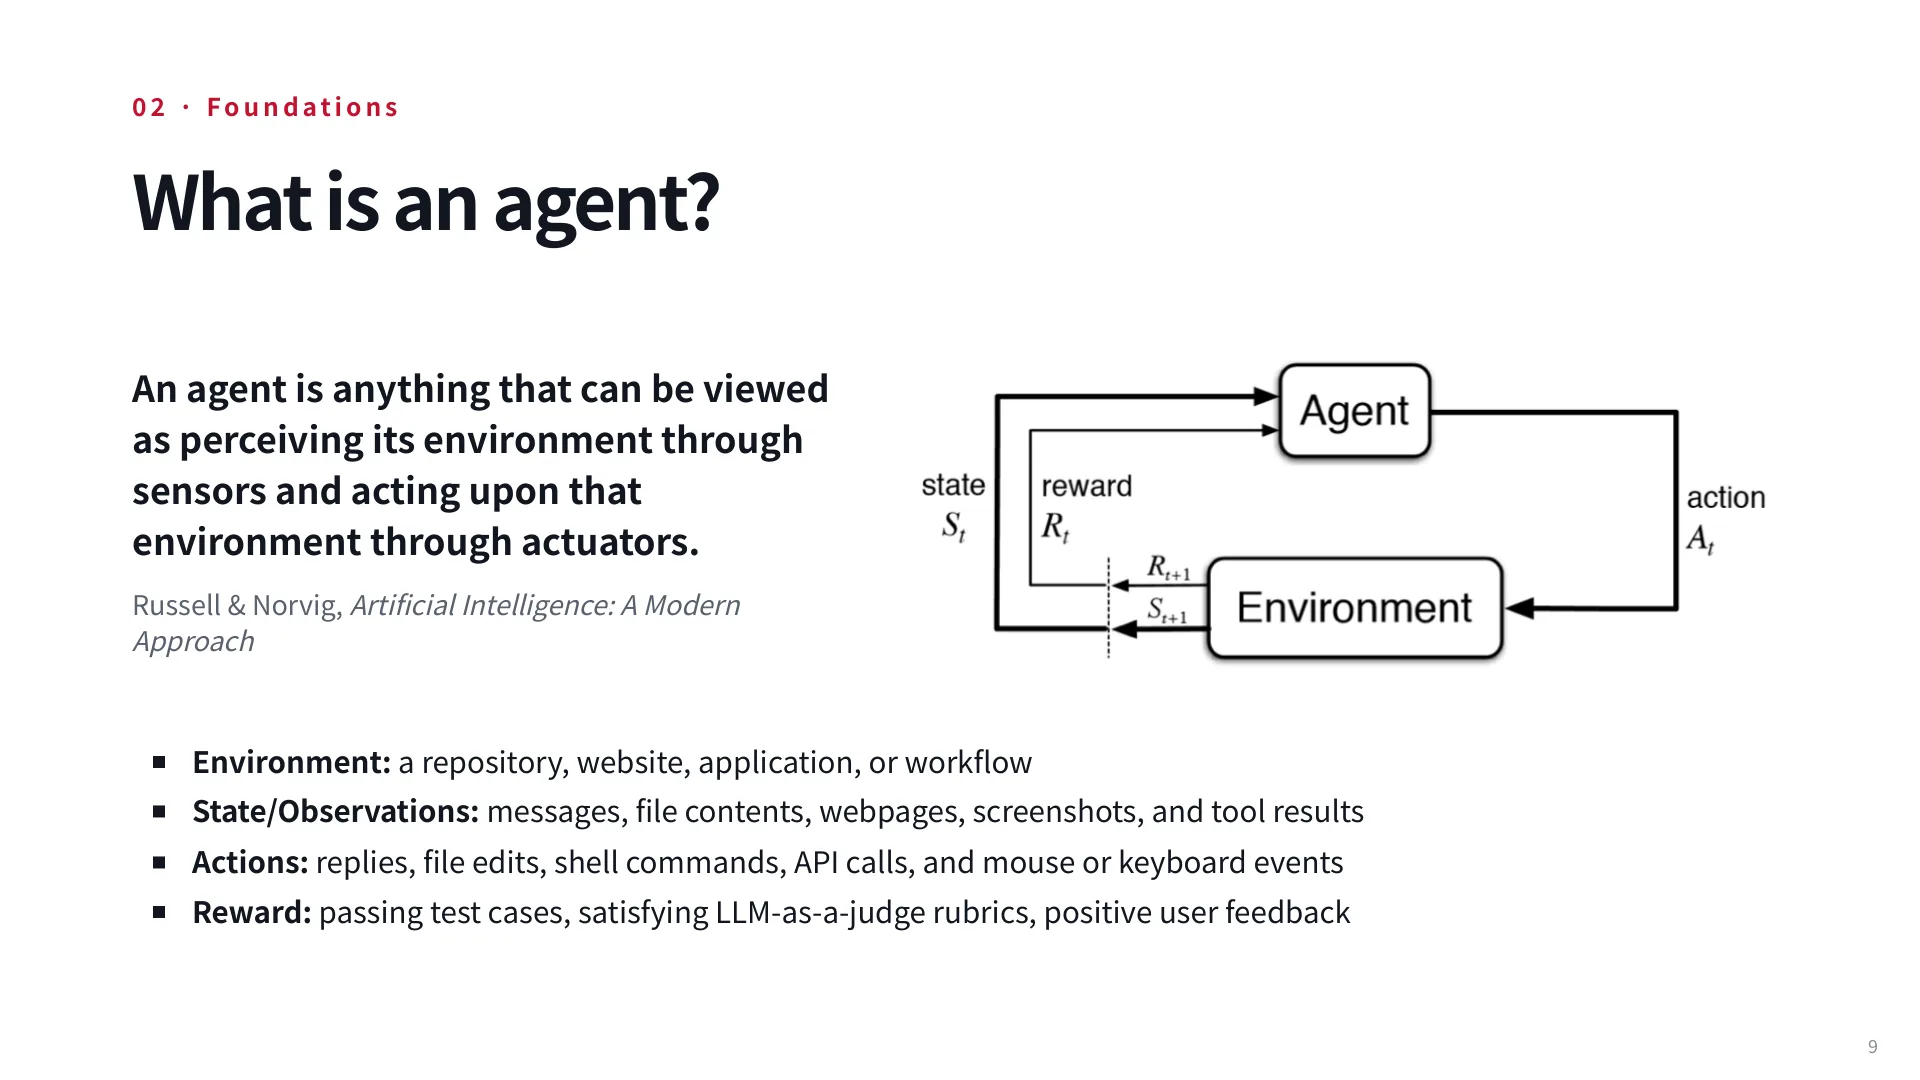
| 要素 | 经典含义 | LLM agent 中的实例 |
|---|---|---|
| Environment | 智能体所处的外部世界 | 代码仓库、网站、应用、工作流 |
| State / Observations | 通过传感器得到的当前状态 | 消息、文件内容、网页、截图、工具返回结果 |
| Actions | 通过执行器施加的改变 | 回复、编辑文件、shell 命令、API 调用、鼠标键盘事件 |
| Reward | 成功与否的数值信号 | 测试用例通过、LLM-as-a-judge 评分、用户正反馈 |
用符号写出来更清楚。设环境为 ,策略为 ,第 步的观测为 、动作为 、历史为 ,则
这个式子看起来平淡,但它把 agent 的所有设计问题都摊开了:策略怎么来(训练)、历史怎么装得下(上下文)、动作空间怎么定义(工具)、环境怎么给反馈(奖励与观测)、循环什么时候停(终止条件)。整门课基本就是这五项的分头展开。
值得强调的是 reward 的难度差异。代码任务有测试用例,天然是 0/1 的客观信号;而“帮我写一封得体的拒信”没有可执行判据,只能退化为 LLM-as-a-judge 的 rubric,或者最终退化为用户满不满意。奖励越主观,agent 的训练和评测就越依赖人的判断,这也是为什么第二次作业专门做评测。
15:24 讲师在这里补了一句历史视角:agent 这个概念不是最近两三年才有的,搜索、强化学习这些为旧式 agent 开发的技术,很多今天仍然适用。这句话为后面“训练 vs harness”的讨论埋了伏笔——我们并不是在发明全新的东西,而是在给旧的循环换一个新的策略来源。
6. 从语言模型到 agent:让动作变成 token
定义说完了,接下来的问题是实现:一个只会 next-token prediction 的模型,怎么突然就能“行动”了?
先回顾语言模型。给定前缀,模型输出下一个 token 的分布,采样一个,接回前缀,重复。Chain of thought 只是在这个过程里多生成一段“草稿” token:这些 token 不是最终答案,但它们成为后续预测的上下文,从而让模型在给出结论前先做几步中间推理。
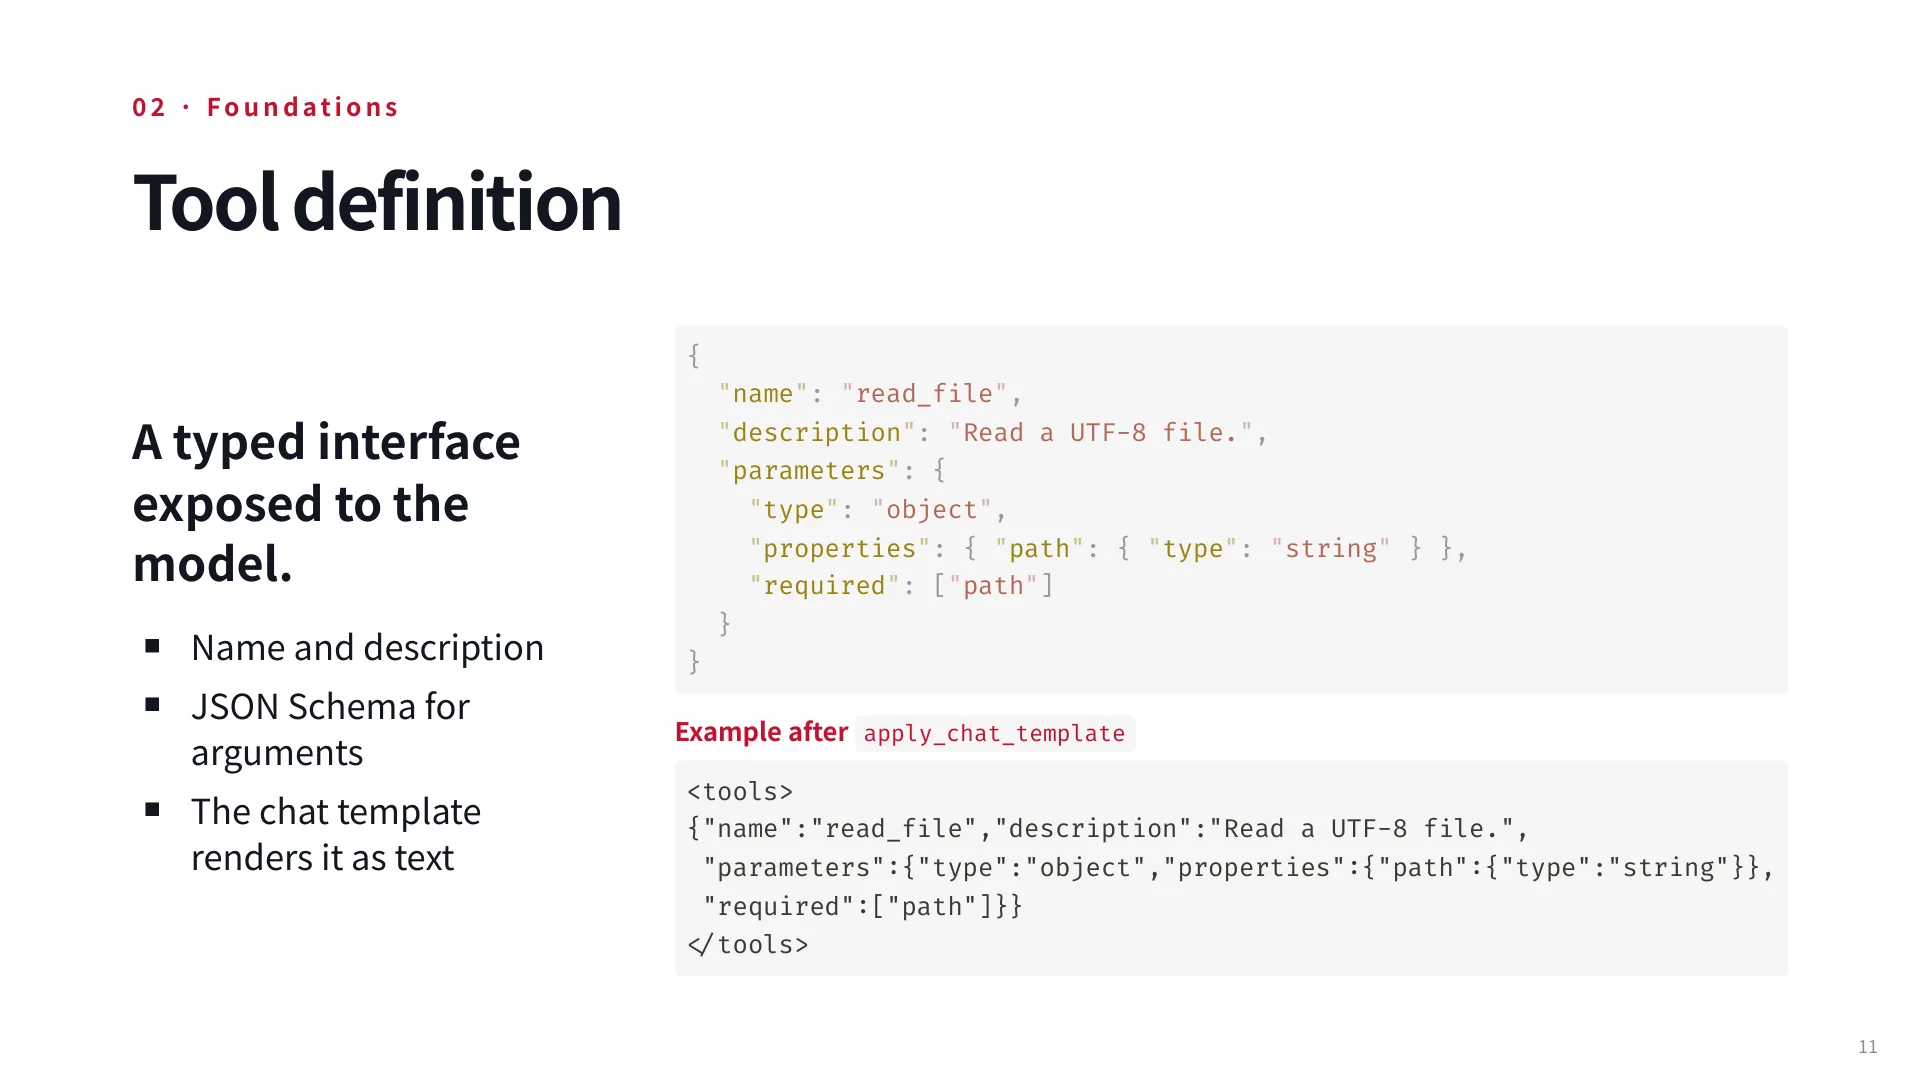
工具是这座桥。课件用 read_file 举例,一个工具定义包含三部分:名字、自然语言描述(告诉模型什么时候该用它)、参数的结构化 schema(JSON Schema,规定类型与必填项)。这份定义本身不是给模型“看”的,它必须先被 chat template 渲染成一段文本,再被 tokenize 进上下文。所以模型看到的其实是这样一段东西:
{"name": "read_file",
 "description": "Read a UTF-8 file.",
 "parameters": {"type": "object",
                "properties": {"path": {"type": "string"}},
"required": ["path"]}}模型于是学会了在需要看文件时输出一段结构相似的文本,{"name": "read_file", "arguments": {"path": "test.py"}},这段文本被 harness 解析出来、执行、把结果按同样的模板渲染回去:
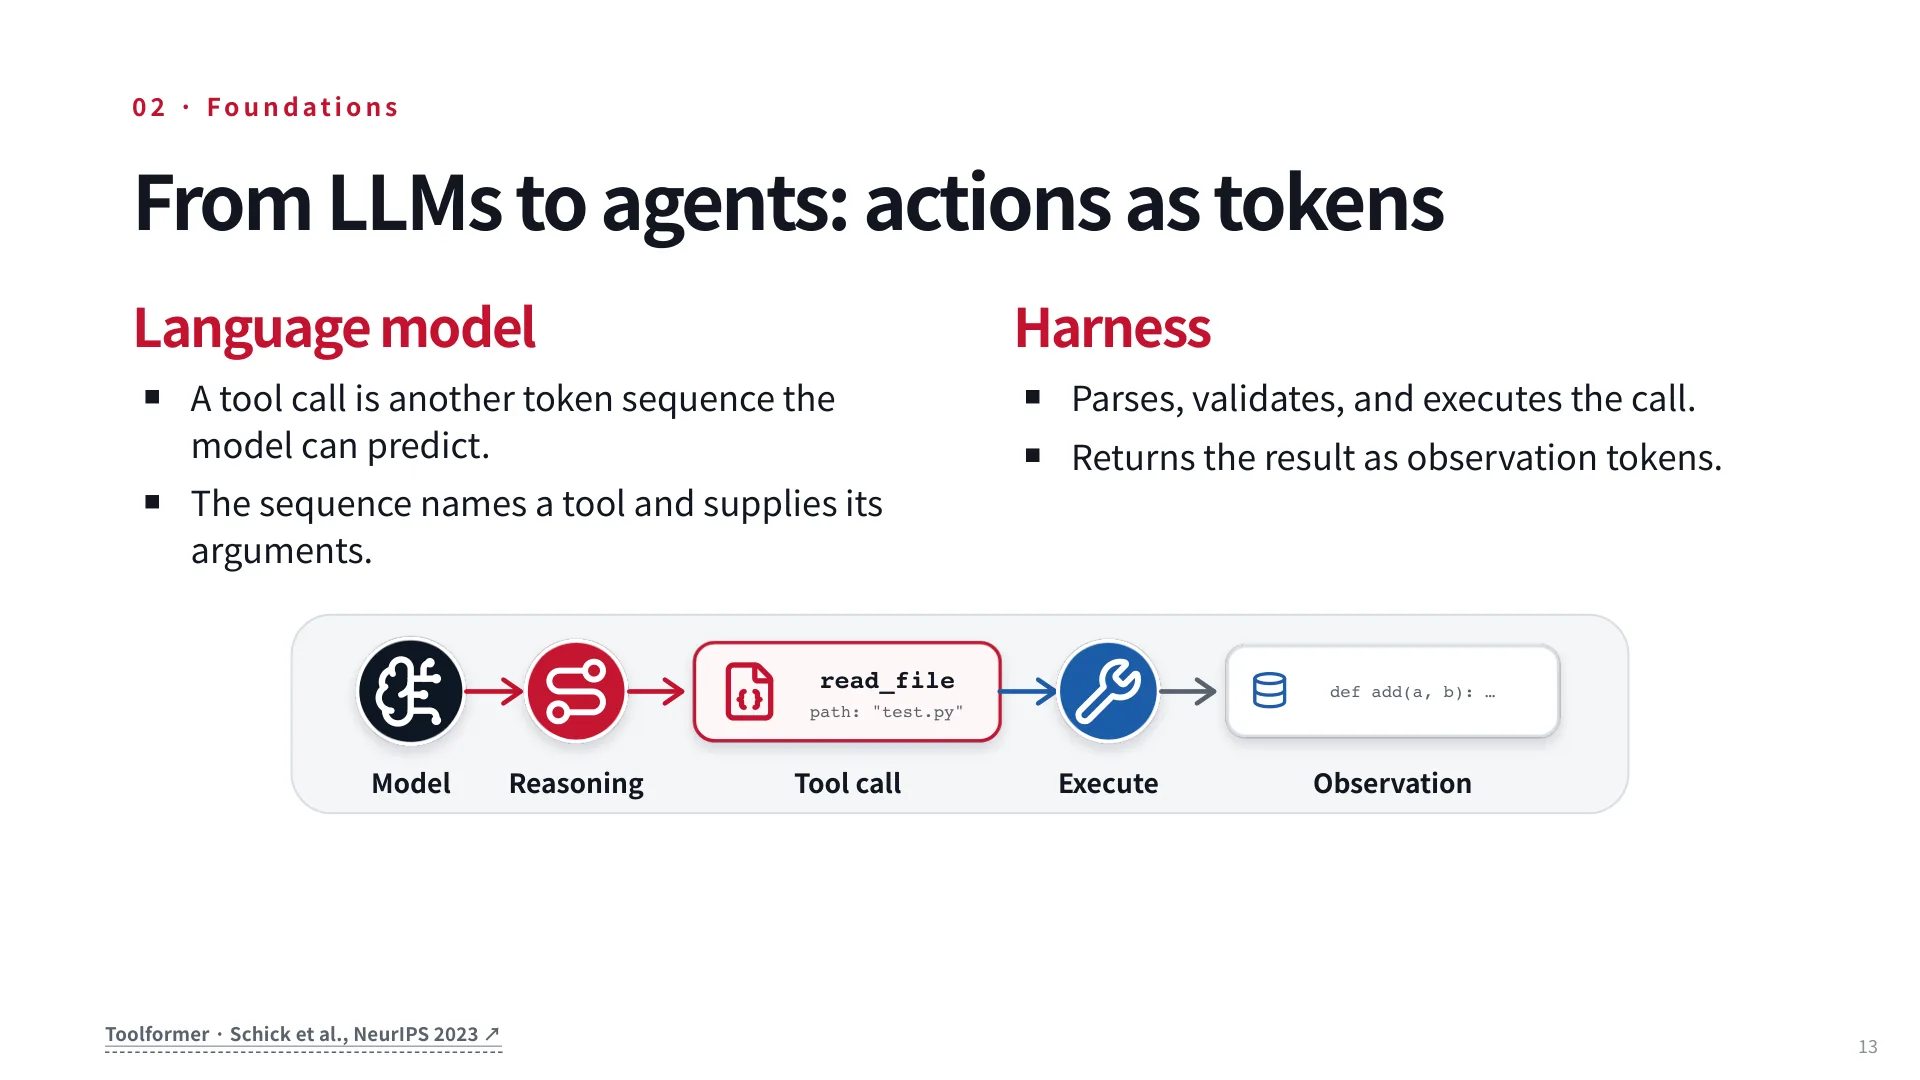
整个链路可以概括成一句话:tool call 只是模型可以预测的又一种 token 序列,harness 负责把它变成世界里的真实动作。 这条链路的一个早期且影响很大的展示是 Toolformer(Schick et al., NeurIPS 2023):模型被训练成在文本中插入 API 调用,并条件于返回结果继续生成。这给出了一个关键证据:工具使用可以落在语言建模目标里,而不必外挂一套符号系统。
这里有一个值得停下来想的工程取舍:动作一定要用 JSON 表达吗? 课上讲师现场问了这个问题,有学生回答“可以直接写代码”。这确实是当前的一个主要流派——让 agent 输出 shell 命令或 Python 代码,由执行环境跑。两种表示的对比如下:
| 维度 | JSON tool call | 代码即动作 |
|---|---|---|
| 可约束性 | 强,可用 grammar-constrained decoding 保证合法 | 弱,语法正确不代表语义安全 |
| 表达力 | 受 schema 限制,组合需要多轮 | 强,循环、条件、管道都能表达 |
| 可审计性 | 每个调用边界清晰 | 一次执行可能做很多事 |
| 典型使用者 | 教学 demo、需要严格校验的生产系统 | SWE-bench 上的强 agent、OpenHands 类 harness |
21:53 讲师明确说“直接写代码往往比生成 JSON 更有效”,但也提醒有 trade-off。这个 trade-off 的实质是:表达力换可控性。代码动作让 agent 一步完成 JSON 需要十步才能表达的事,但也让“这一步到底改了什么”变得难以审计,因此对 sandbox 和 diff 审查的依赖更重。
7. 最小循环:模型 + 上下文 + 工具 + 历史
把工具接上,agent 的骨架就出来了。一次决策的输入有四块:Context(系统提示,说明这是什么 agent、任务的一般形态)、Task(用户的具体请求)、Tool(可用工具的定义)、History(此前的动作与观测)。输出是 reasoning token 加上一个或多个 tool call;call 被执行后结果回到 history,循环继续。
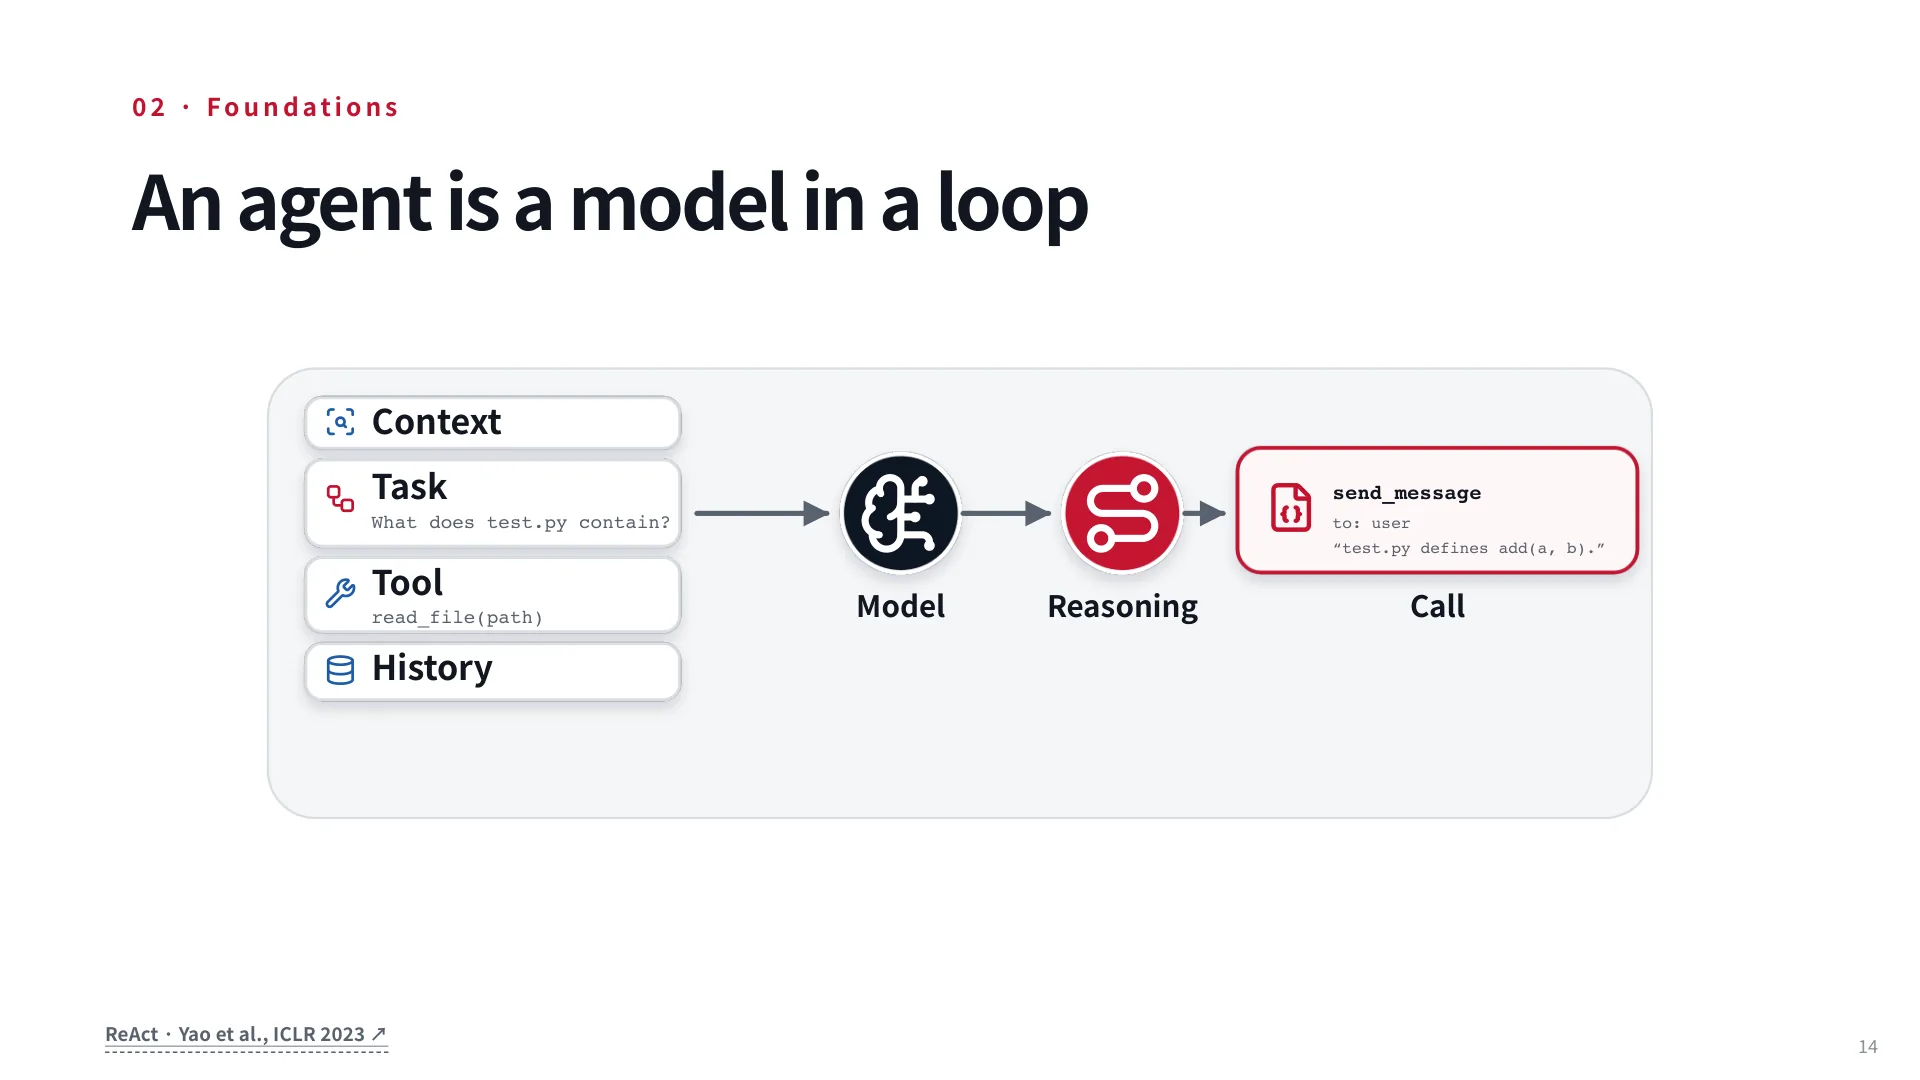
这个结构就是 ReAct(Yao et al., ICLR 2023)的核心:Reasoning + Acting。它的贡献不在于“让模型调工具”,而在于把“想”和“做”交替起来,使得每一步行动都条件于上一步的观察,而不是一次性规划到底。对长程任务来说,这一点至关重要:环境会变化,计划必须能被观测修正。
课件用 mini-swe-agent 的源码展示这个循环有多短:
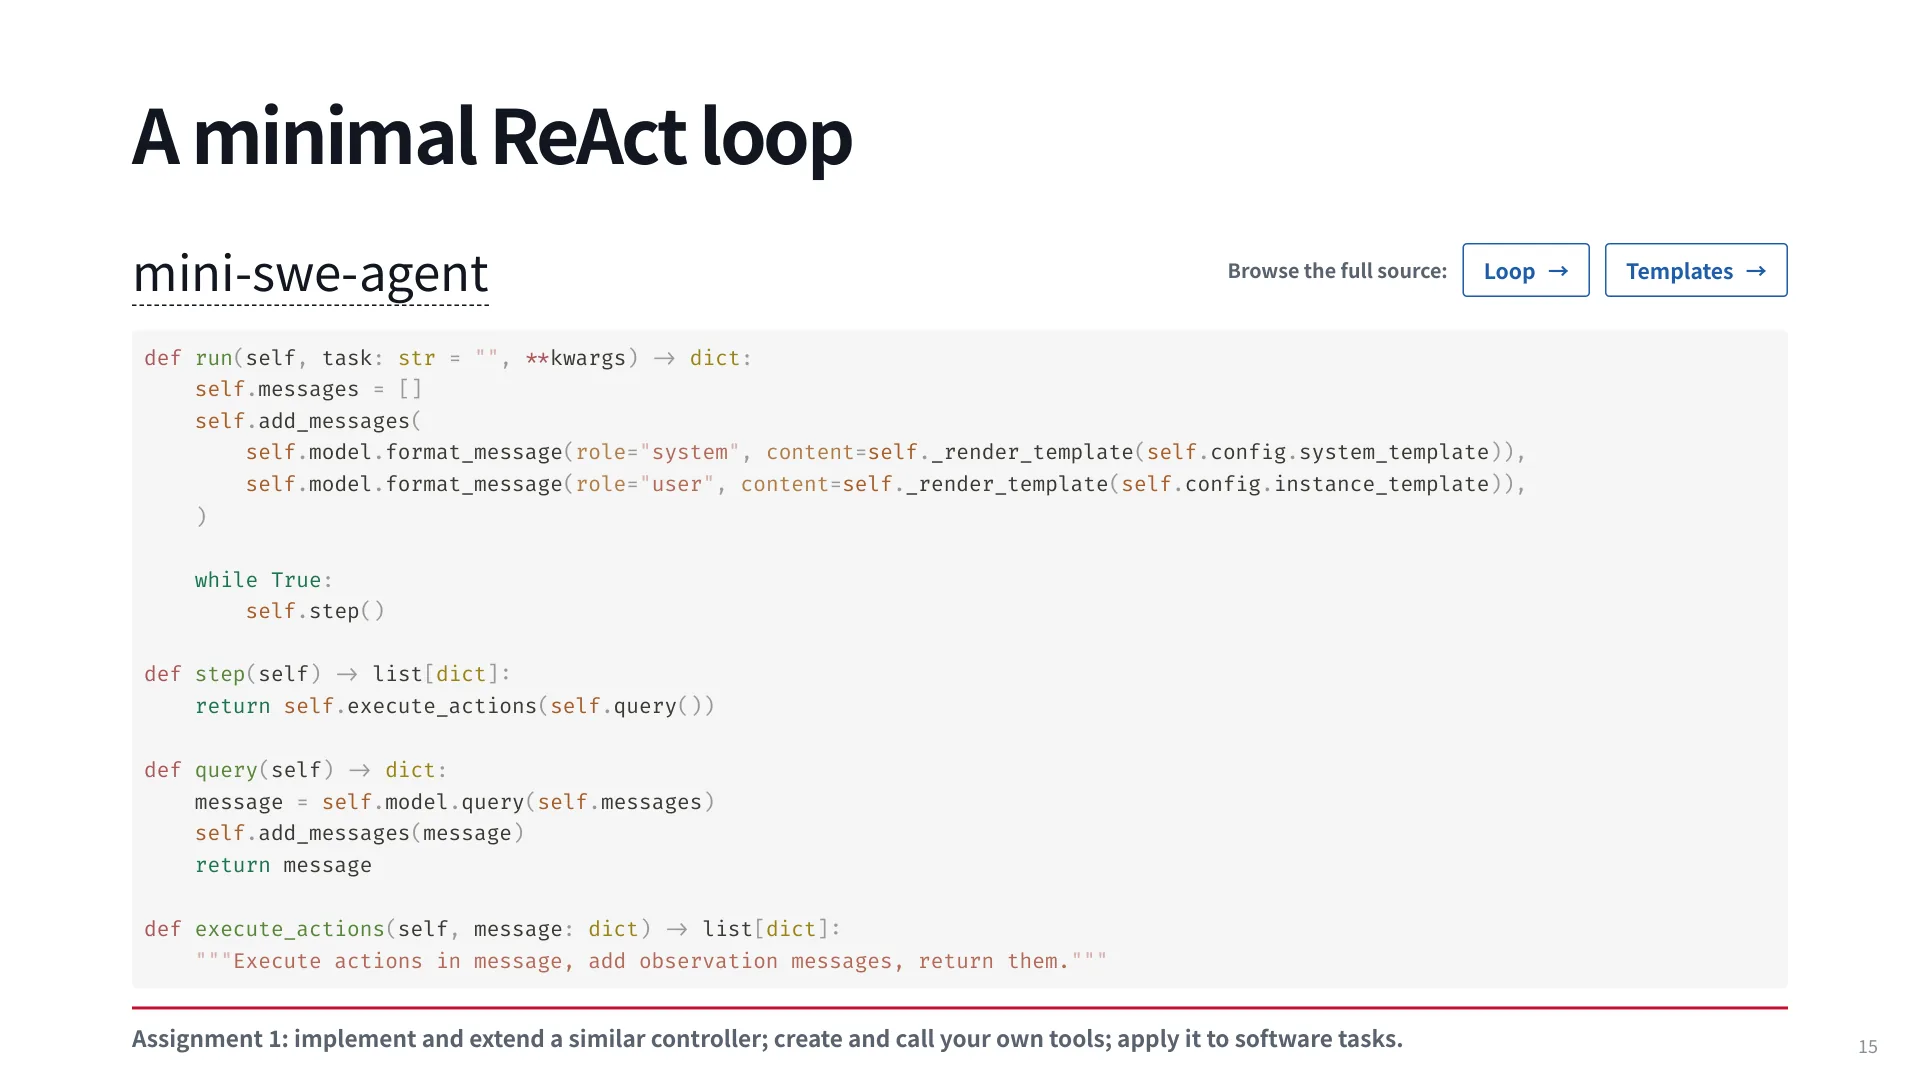
def run(self, task: str = "", **kwargs) -> dict:
    self.messages = []
    self.add_messages(
        self.model.format_message(role="system", content=...),
        self.model.format_message(role="user", content=...),
    )
    while True:
        self.step()

def step(self) -> list[dict]:
    return self.execute_actions(self.query())

def query(self) -> dict:
    message = self.model.query(self.messages)
    self.add_messages(message)
    return message

def execute_actions(self, message: dict) -> list[dict]:
"""Execute actions in message, add observation messages, return them."""(... 处原本是 chat template 的渲染细节,这里略去。)这段循环不到二十行。值得注意的是它的性能并不差——这个仓库在 SWE-bench 上用前沿模型能拿到相当高的分数。这带来一个反直觉的结论:agent 的复杂度不在循环本身,而在循环周围的每一件小事。上下文怎么截断、工具怎么描述、错误怎么重试、什么时候判定完成,这些才是区分好坏 harness 的地方。
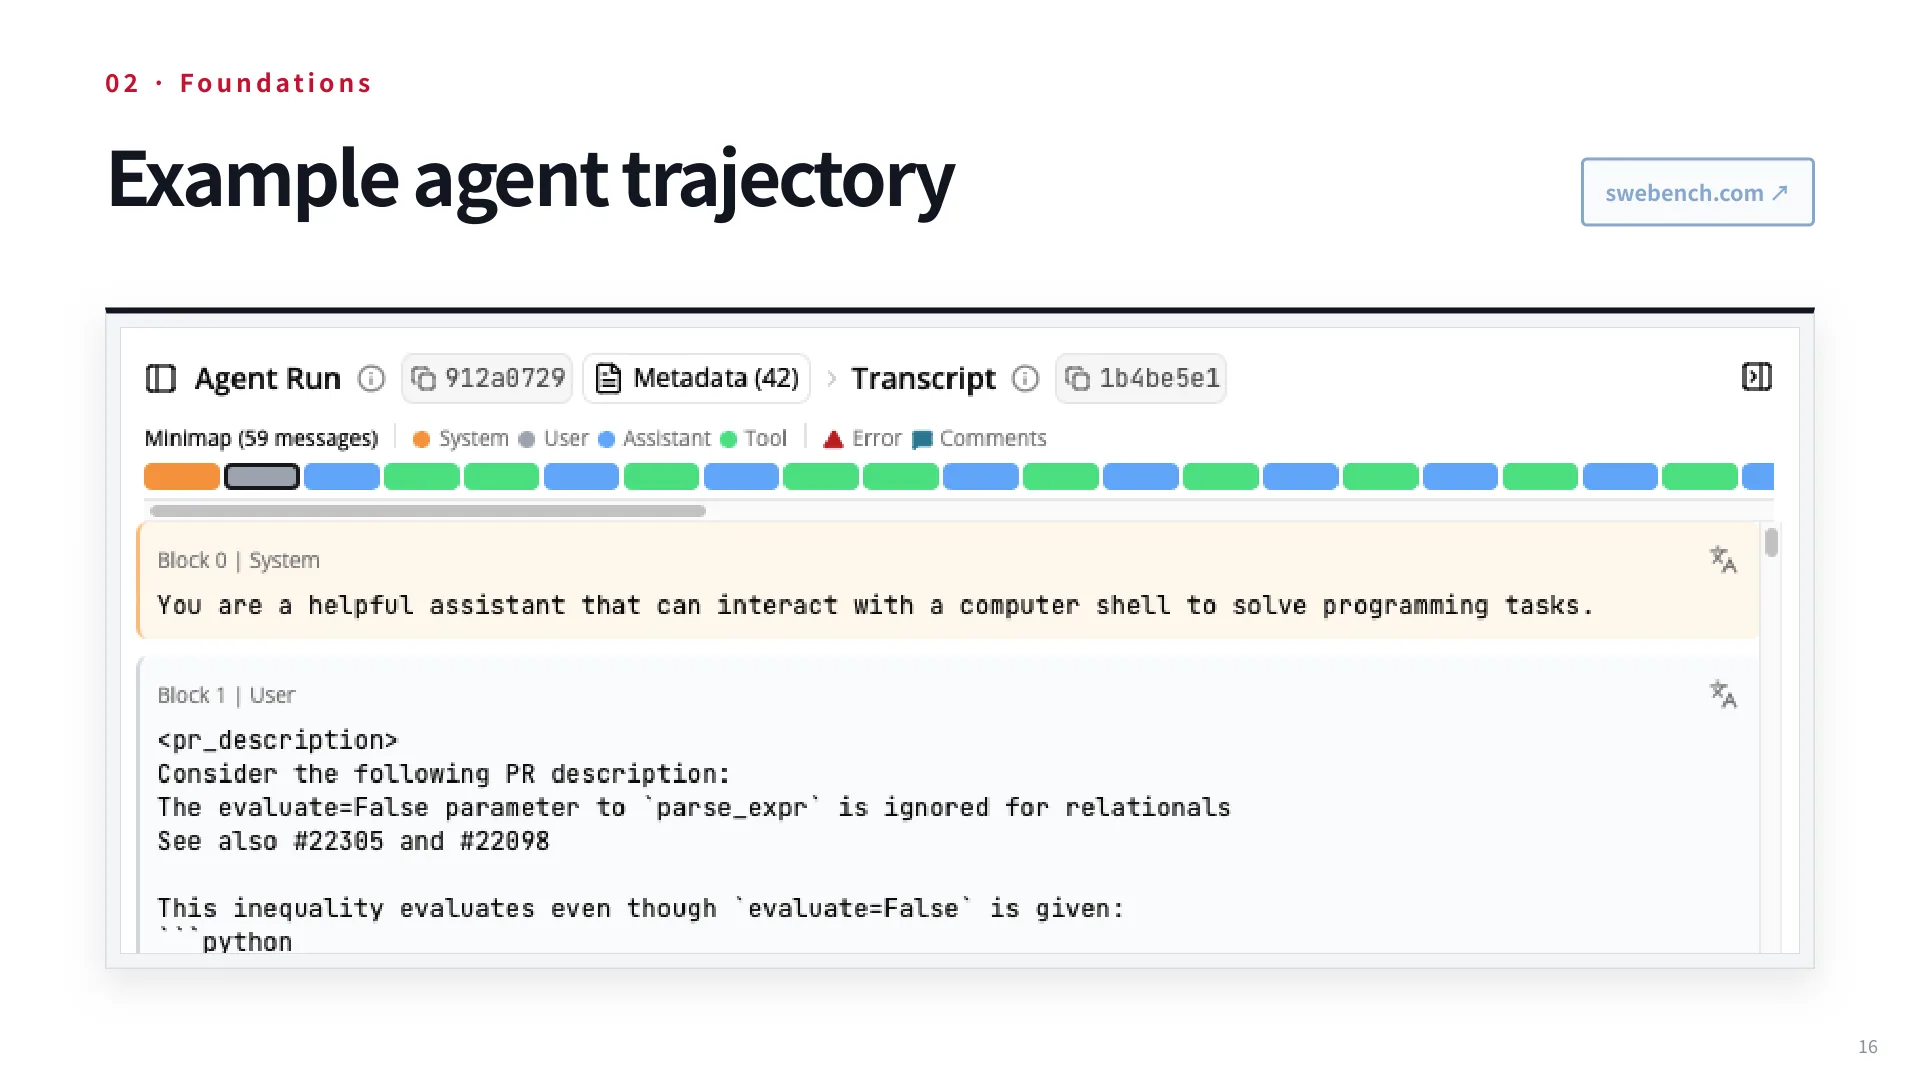
真实的轨迹能说明“模型看到了什么”。在 SWE-bench 的示例里,system message 只有一句“You are a helpful assistant that can interact with a computer shell.”,user message 则给出这个具体任务的上下文:要解决的那个 pull request。之后模型输出一段思考加一条 bash 命令,环境执行后返回 exit code 0,循环继续。整个交互里没有任何魔法:上下文是文本,动作是文本,反馈也是文本。
25:53 讲师在这里特别提到“结束”也是一种工具调用——发消息给用户、或者发出完成信号。这个设计细节常被忽略:如果循环没有显式的终止动作,agent 要么永远跑下去,要么被迫在某个 token 预算处被硬截断,后者的行为往往很糟。
8. 六项能力与两条建设路线
课到一半,讲者从“怎么搭”切换到“为什么搭不好”。Graham 先问全场:你们用 agent 时最烦什么?答案很密集——太慢、太啰嗦、忘事、误解指令、访问不该访问的东西、常识性知识缺口、两行能改完却写了一千行、不记得上次会话、被质疑时不会坚持、会撒谎、隐含假设太多。
这些问题被归纳成六项能力:
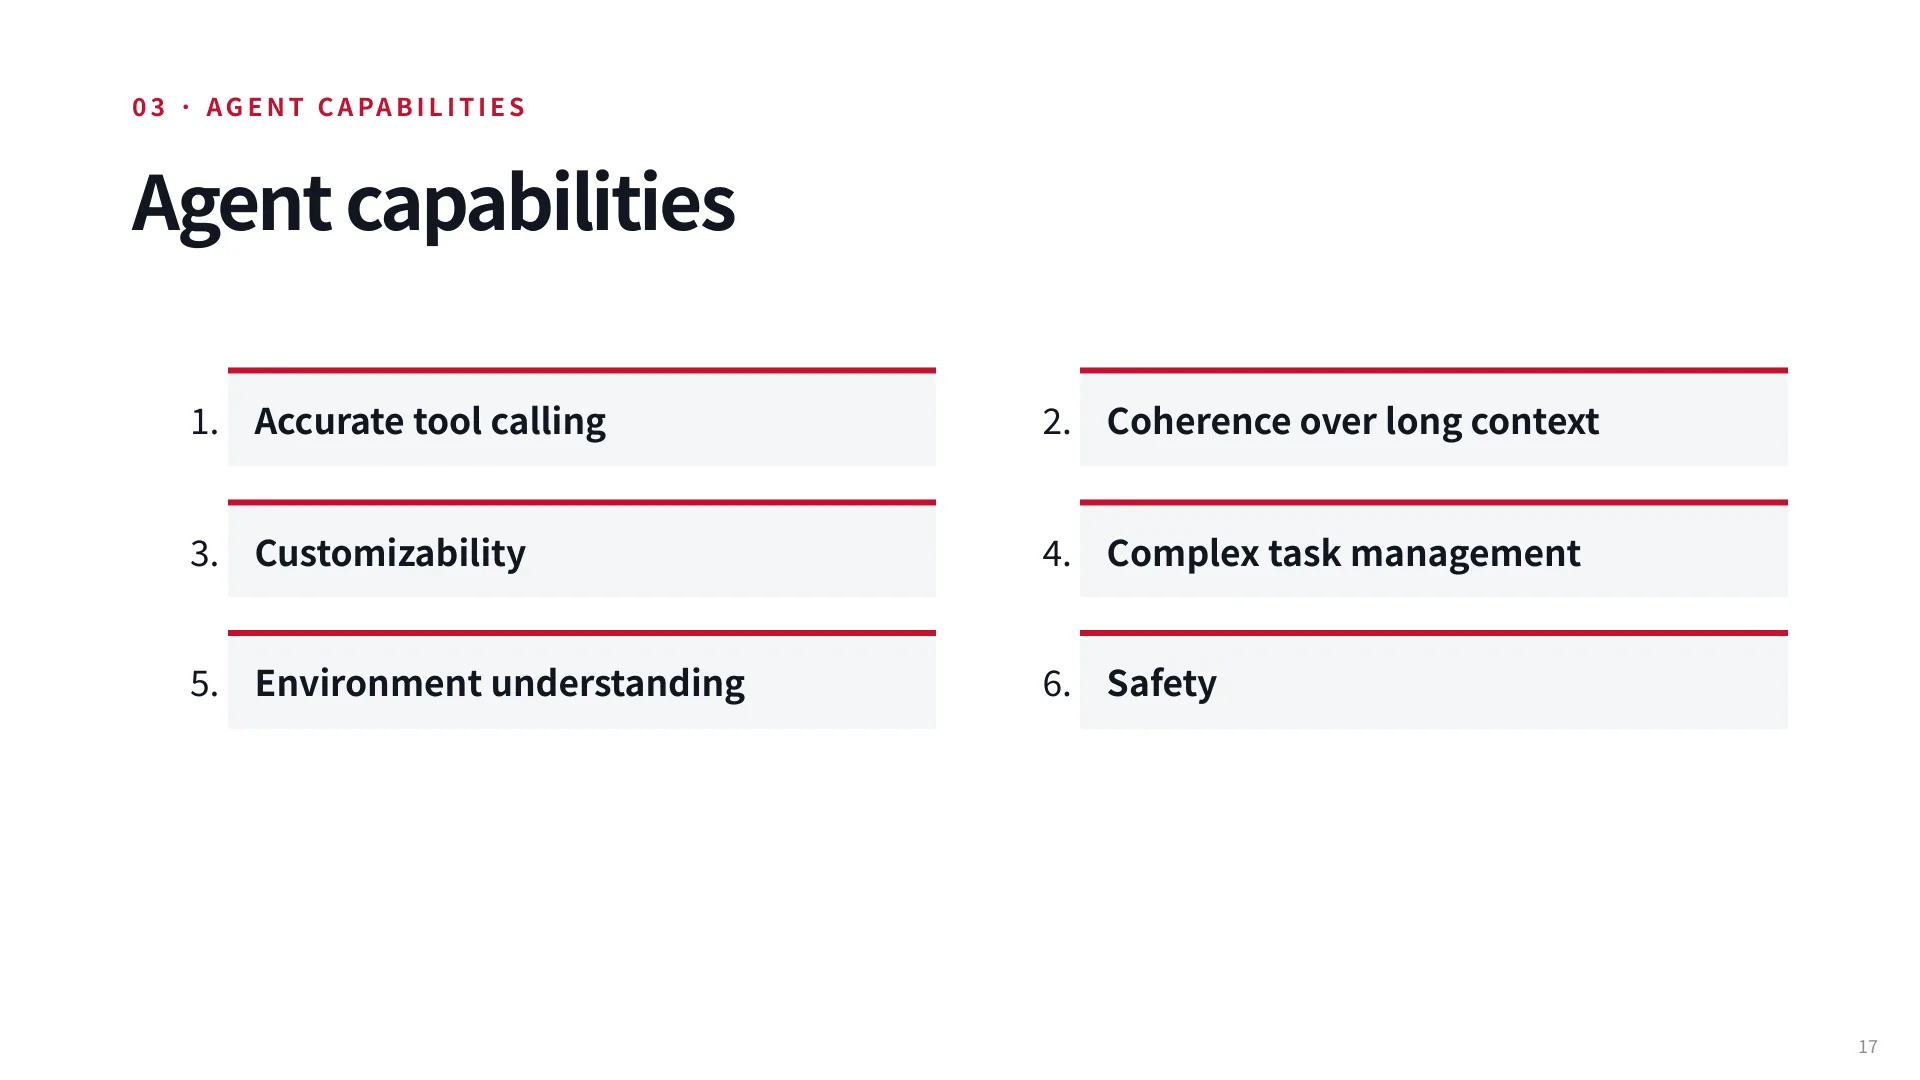
- Accurate tool calling:选对工具、给出合法参数、处理返回结果。听众没人提这一条,恰恰因为大家把它当成了空气——但如果你自己训练模型,它一点都不免费。
- Coherence over long context:几十轮之后仍记得最初的约束。删邮件那个案例就是它的反面。
- Customizability:按“你的方式”做事。每个团队有自己的规范,agent 得能适配。
- Complex task management:分解、排期、验证。长程任务是当前最大的失败来源之一。
- Environment understanding:知道这个环境里“正常”是什么样。两行能改完却改了一千行,本质上是没看懂代码结构。
- Safety:不该做的事不做。Graham 坚持把它算作能力,而不是外挂的合规层。
那么这六项靠什么获得?课件给了两条路:
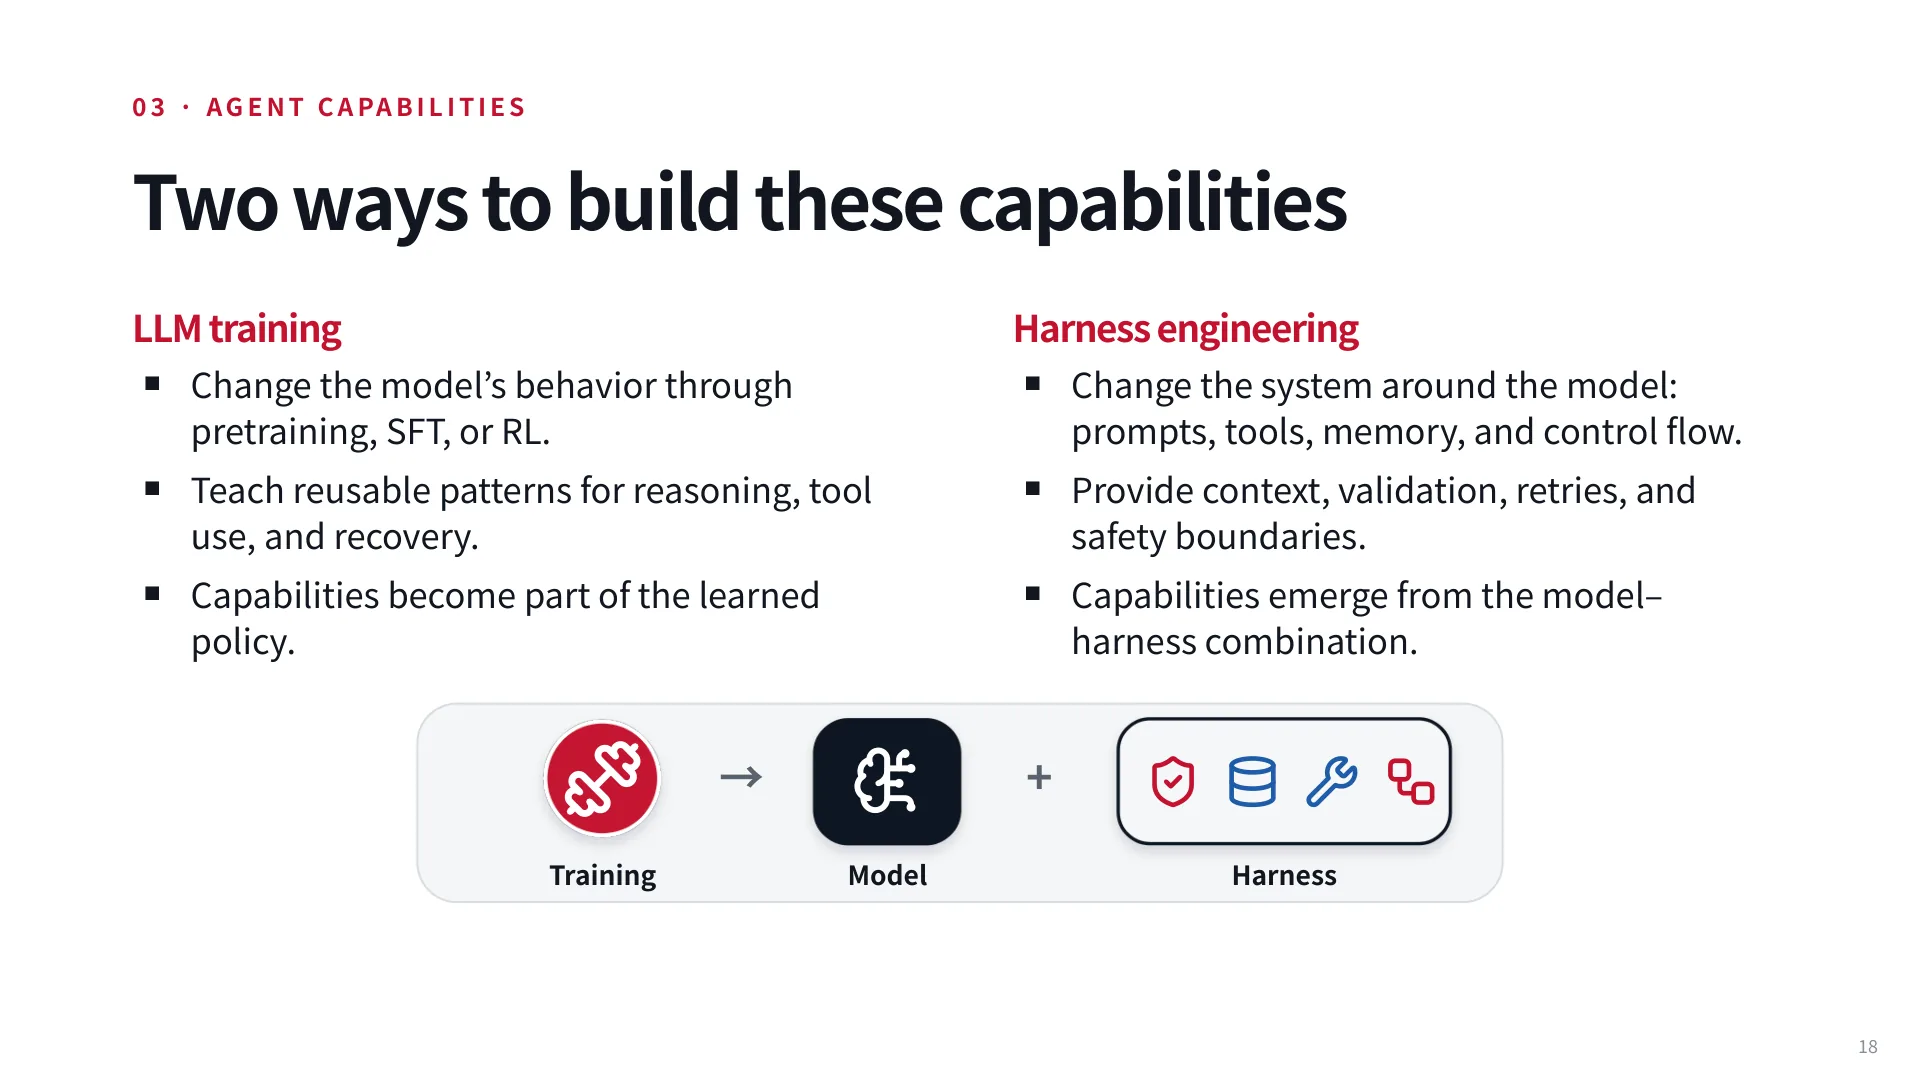
- LLM training:通过预训练、SFT、RL 改变模型行为,把可复用的推理、工具使用、错误恢复模式写进策略参数。
- Harness engineering:改提示、改工具、加记忆、加控制流,提供上下文、校验、重试与安全边界。
课堂上讲师让全场举手选边:认为“训练更重要”的人意外地少,认为“harness 更重要”的人占多数(Daniel 两次举手被当场抓包)。35:40 这个非正式投票本身就是一次很好的元观察:在座的未来从业者,直觉上更相信工程而不是训练,而这门课要论证的是两者都需要。
两者不是对立选项,而是有时间顺序的。Graham 的经验是:一个问题先在 harness 侧被解决(因为模型厂商还没意识到它重要),等它变成足够普遍的痛点,模型厂商会把它吸收进训练,于是 harness 侧的补丁就可以撤掉。所以真实的技术演进是“harness 先探路,训练后收编”。
38:02 他个人的偏好是:如果有条件做训练,训练是更根本的解法;但工程上你没有时间等,所以永远是从 harness 开始。这个判断解释了为什么这门课既要教 harness(作业一),也要教训练(作业三)。
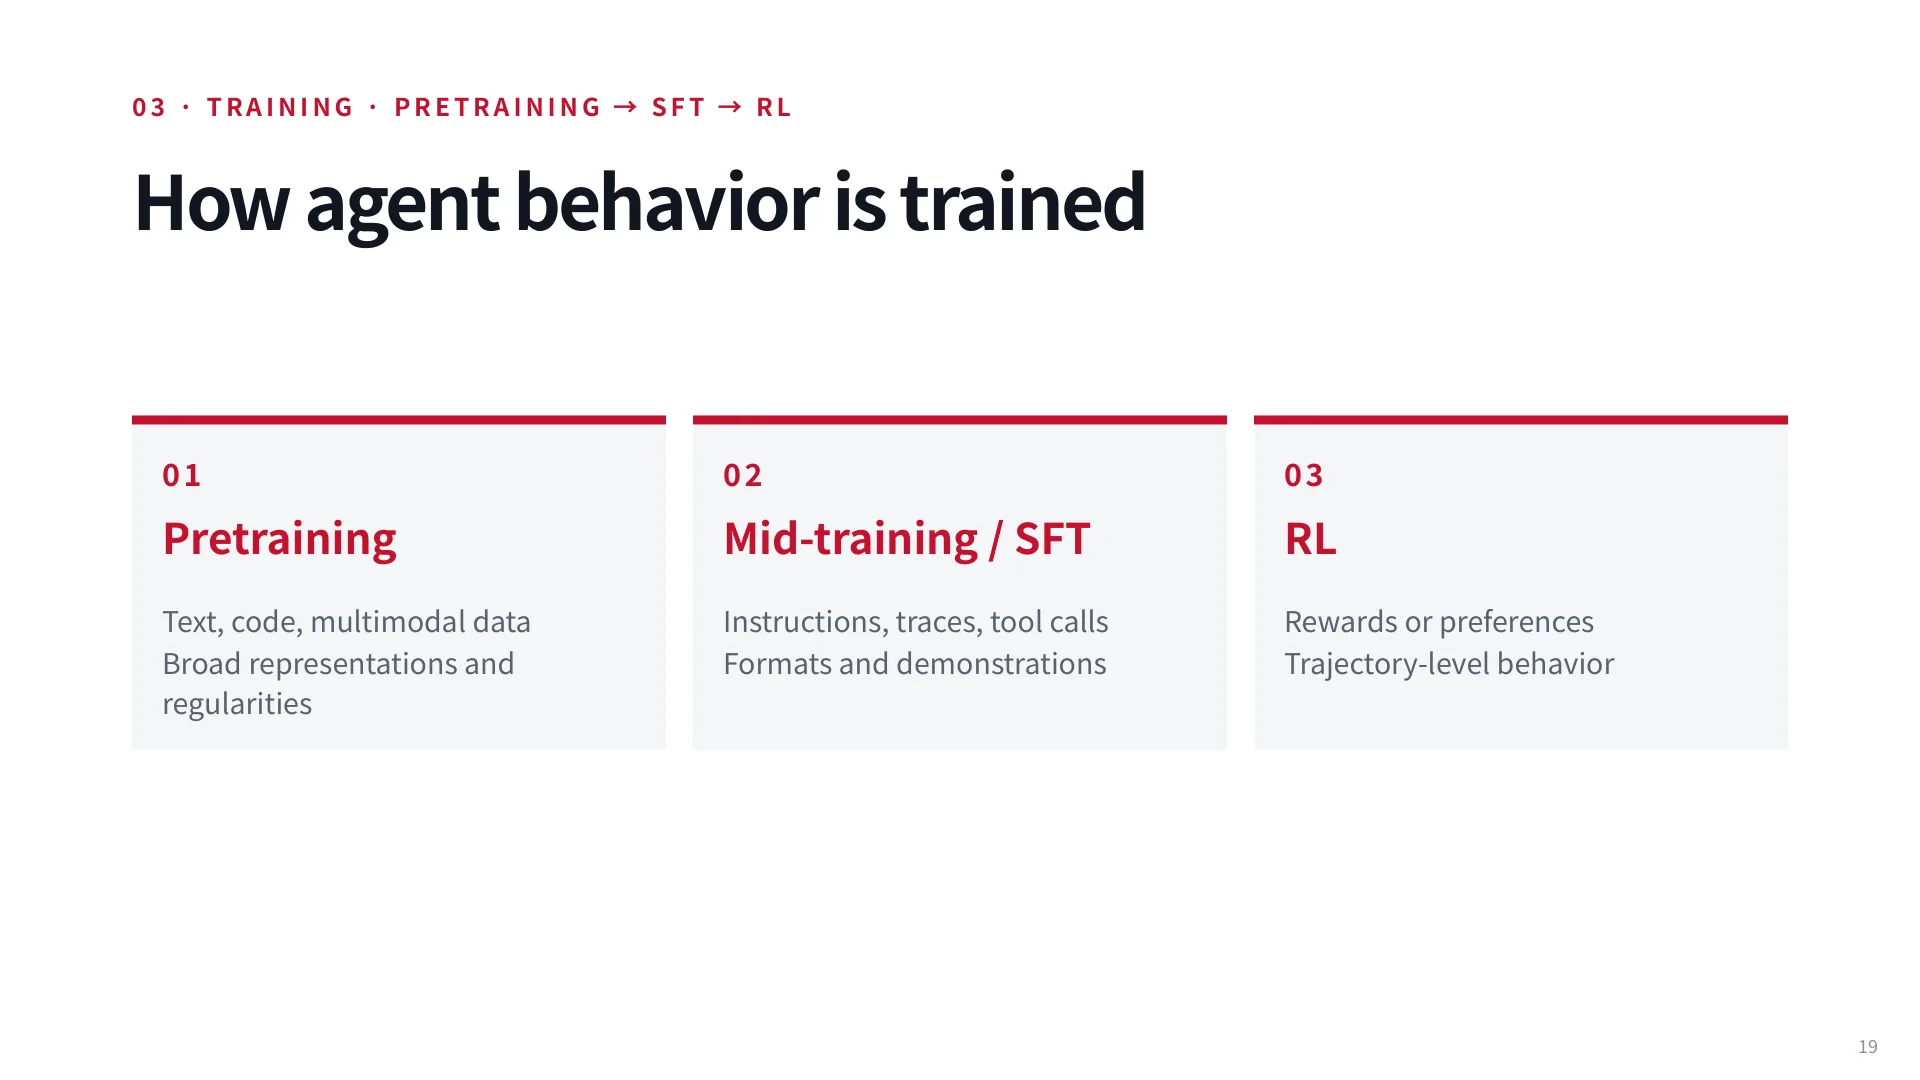
对应的训练管线是三段:预训练(文本、代码、多模态数据,获得广泛表征)→ 中训练/SFT(指令、轨迹、工具调用,学会格式与示范)→ RL(奖励或偏好,塑造轨迹级行为)。课程不碰预训练——那是整个互联网的规模,赞助的算力撑不住;重点在中训练的数据构造和 RL 的稳定性上,因为“给 agent 做 RL”比“给推理任务做 RL”难得多:轨迹长、奖励稀疏、环境有状态、rollout 昂贵。
8.1 能力逐项拆解
课件对六项能力各给了一页“harness 侧 / 训练侧”的对照,这套对照表值得整体记住:
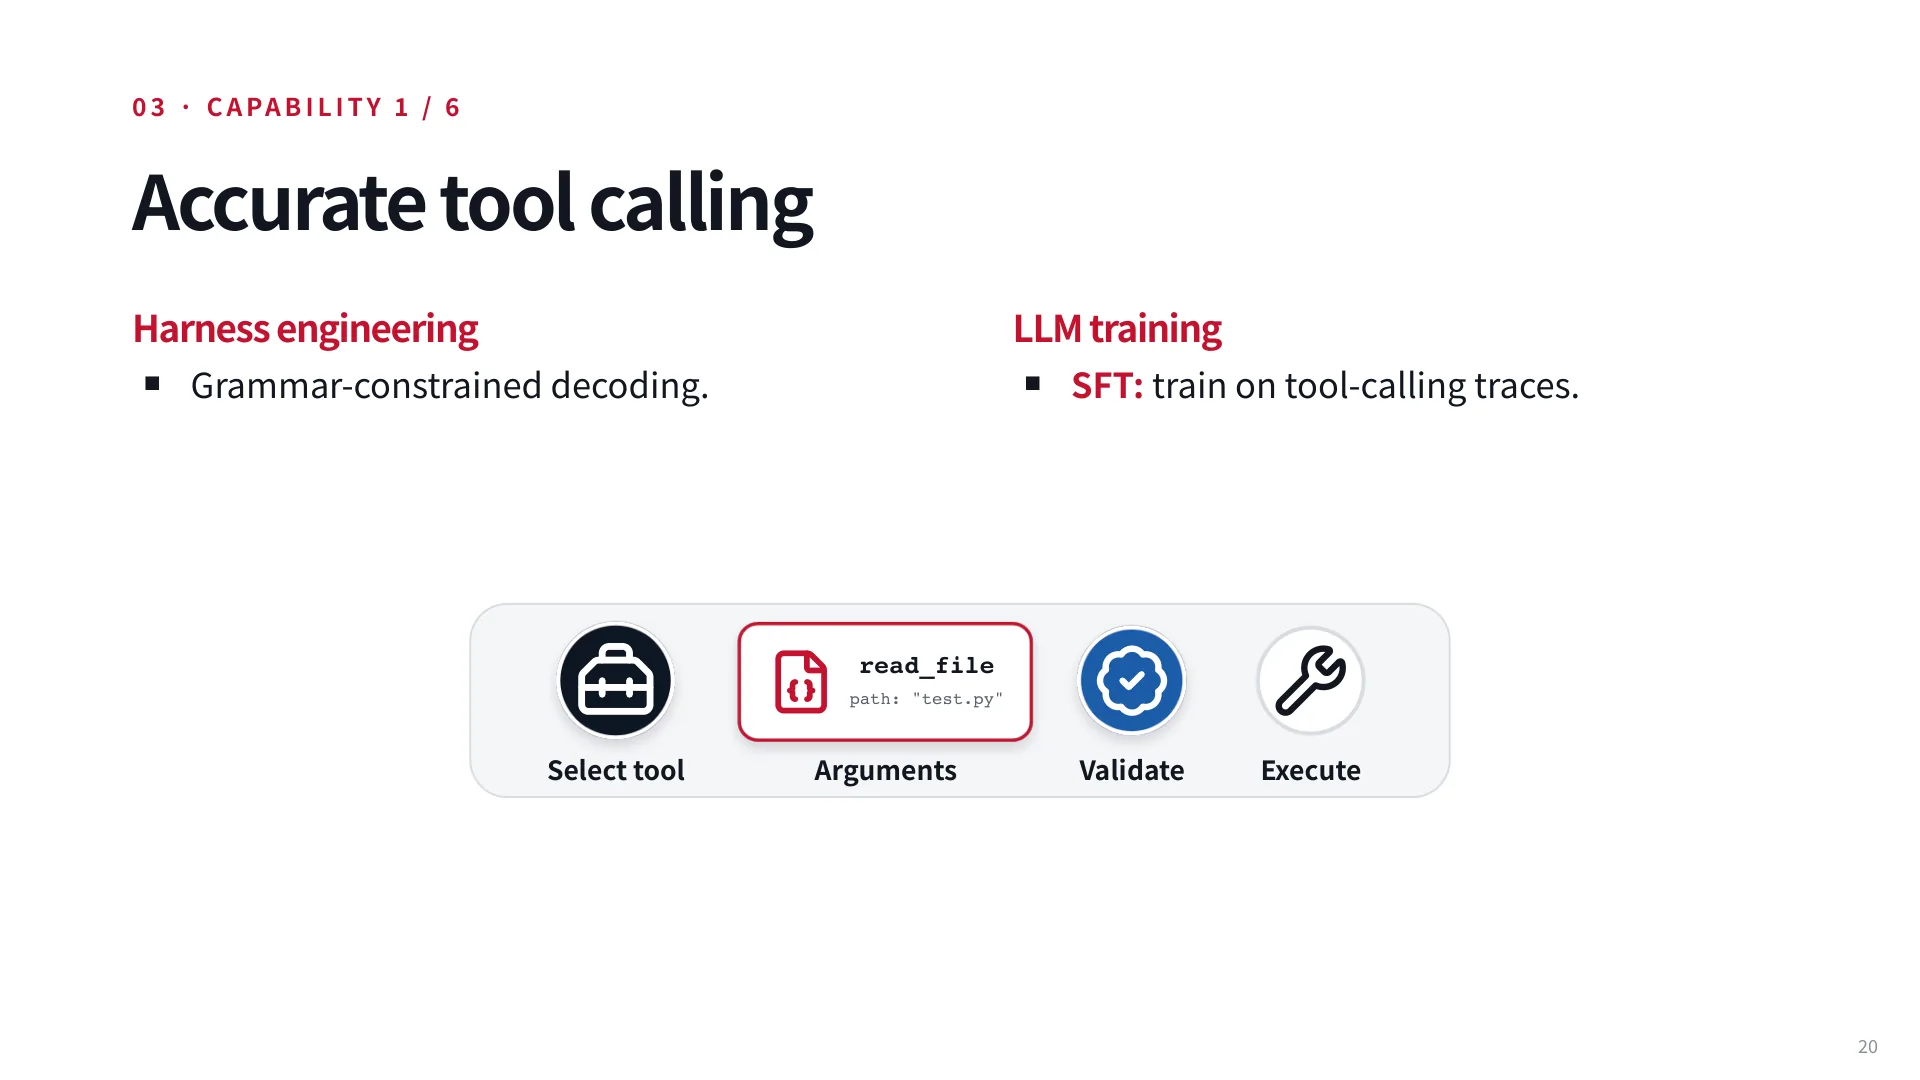
工具调用的 harness 解法是 grammar-constrained decoding:在解码时把输出约束在工具 schema 允许的语法内,从根上消灭“参数少了个引号”这类错误。训练解法是 SFT on tool-calling traces——用大量“该调什么、参数怎么填”的示范教会模型格式。前者保证合法性,后者保证选得对,通常要一起用。
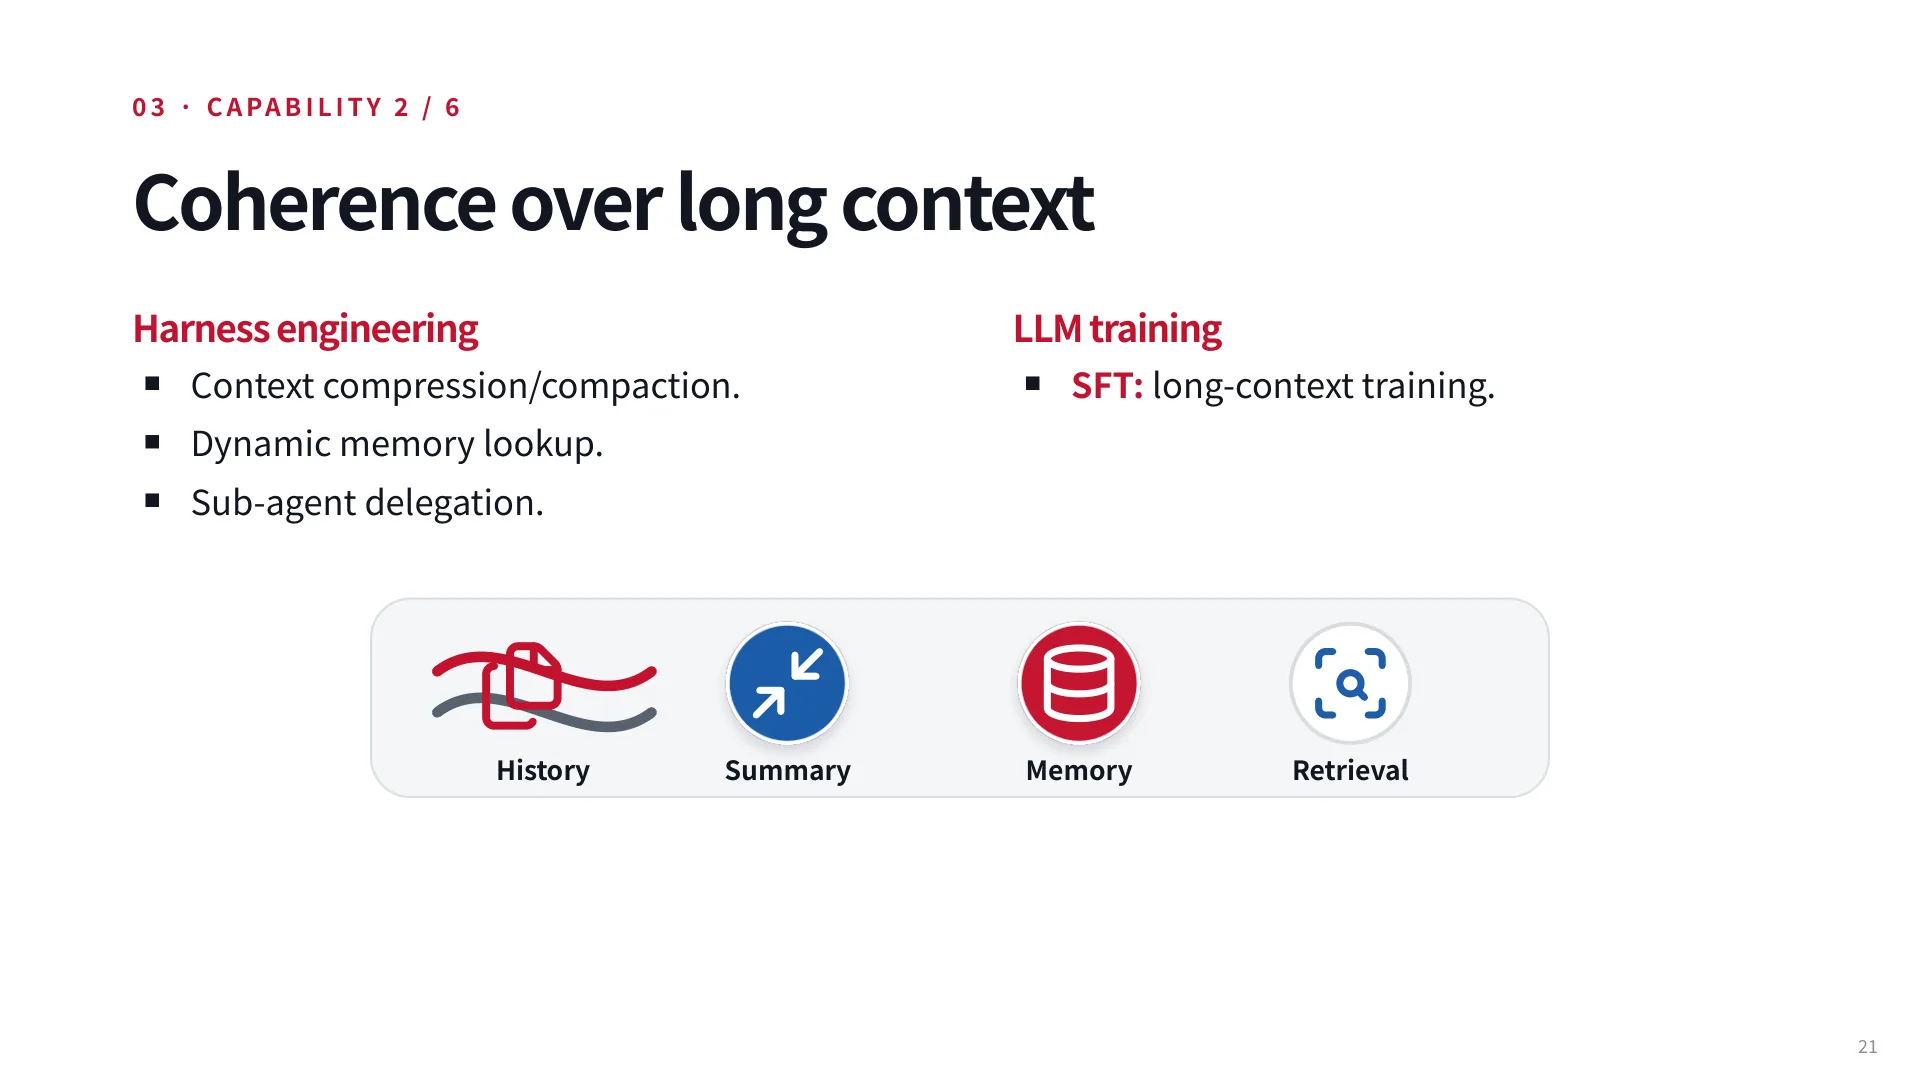
长上下文一致性的 harness 解法有三:context compression/compaction(把历史摘要化)、dynamic memory lookup(不一次性塞入,按需检索)、sub-agent delegation(把子任务连同其上下文交给子 agent,做完只回收结论)。训练解法是长上下文训练,但这条路受限于注意力的 成本——这一点很关键,它意味着长上下文永远不会被训练“完全解决”,harness 侧的压缩与检索是长期需求。
33:15 Graham 在讲这一项时直接回到删邮件的案例:模型此前被告知不要做某件事,后来还是做了——他把它归为长上下文一致性的失败,而不是单纯的指令遵循问题。44:32 他随后展开的三种 harness 解法,处理的都是同一个矛盾:历史必须变短,但有些信息不能丢。顺着这个矛盾可以推出一条课上没有明说、但很实用的工程结论——摘要策略必须区分“事实”和“约束”:事实可以压缩,硬约束一旦被摘要掉就会出事。(这条原则是本笔记的归纳,不是讲师原话。)
可定制性几乎是 harness 工程最好的用武之地:agent memory(跨会话记住你的偏好)、skills(按需加载的提示与脚本)、custom tools(为特定任务定制的工具)。训练侧的做法是从用户反馈里学(点赞点踩),但这条路的数据稀疏且隐私敏感,目前不如 harness 成熟。
复杂任务管理靠 planning/decomposition 工具、plan mode、以及子 agent 委派。课上有个很好笑的细节:某个流行 coding harness 的“plan mode”按钮,实现上只是往提示里加了一句“please plan, do not do anything”,但用户非常喜欢这个按钮。这个例子说明交互契约有时比算法更重要——用户需要知道 agent 现在处于“只想不做”的状态。
环境理解是最容易被低估的一项。GUI agent 要在像素层面理解界面,量化 agent 要理解时间序列,生物实验 agent 要理解培养皿照片。现状是:很多开源模型根本不支持多模态,支持的也远不如文本可靠。训练侧的解法是“用符合目标观测形态的数据训练”“在领域环境里做 RL”——这也正是 Graham 那句“模型不会自己变好,是人把模型变好的”在训练侧的具体含义:真正起作用的是人造出来的领域环境。
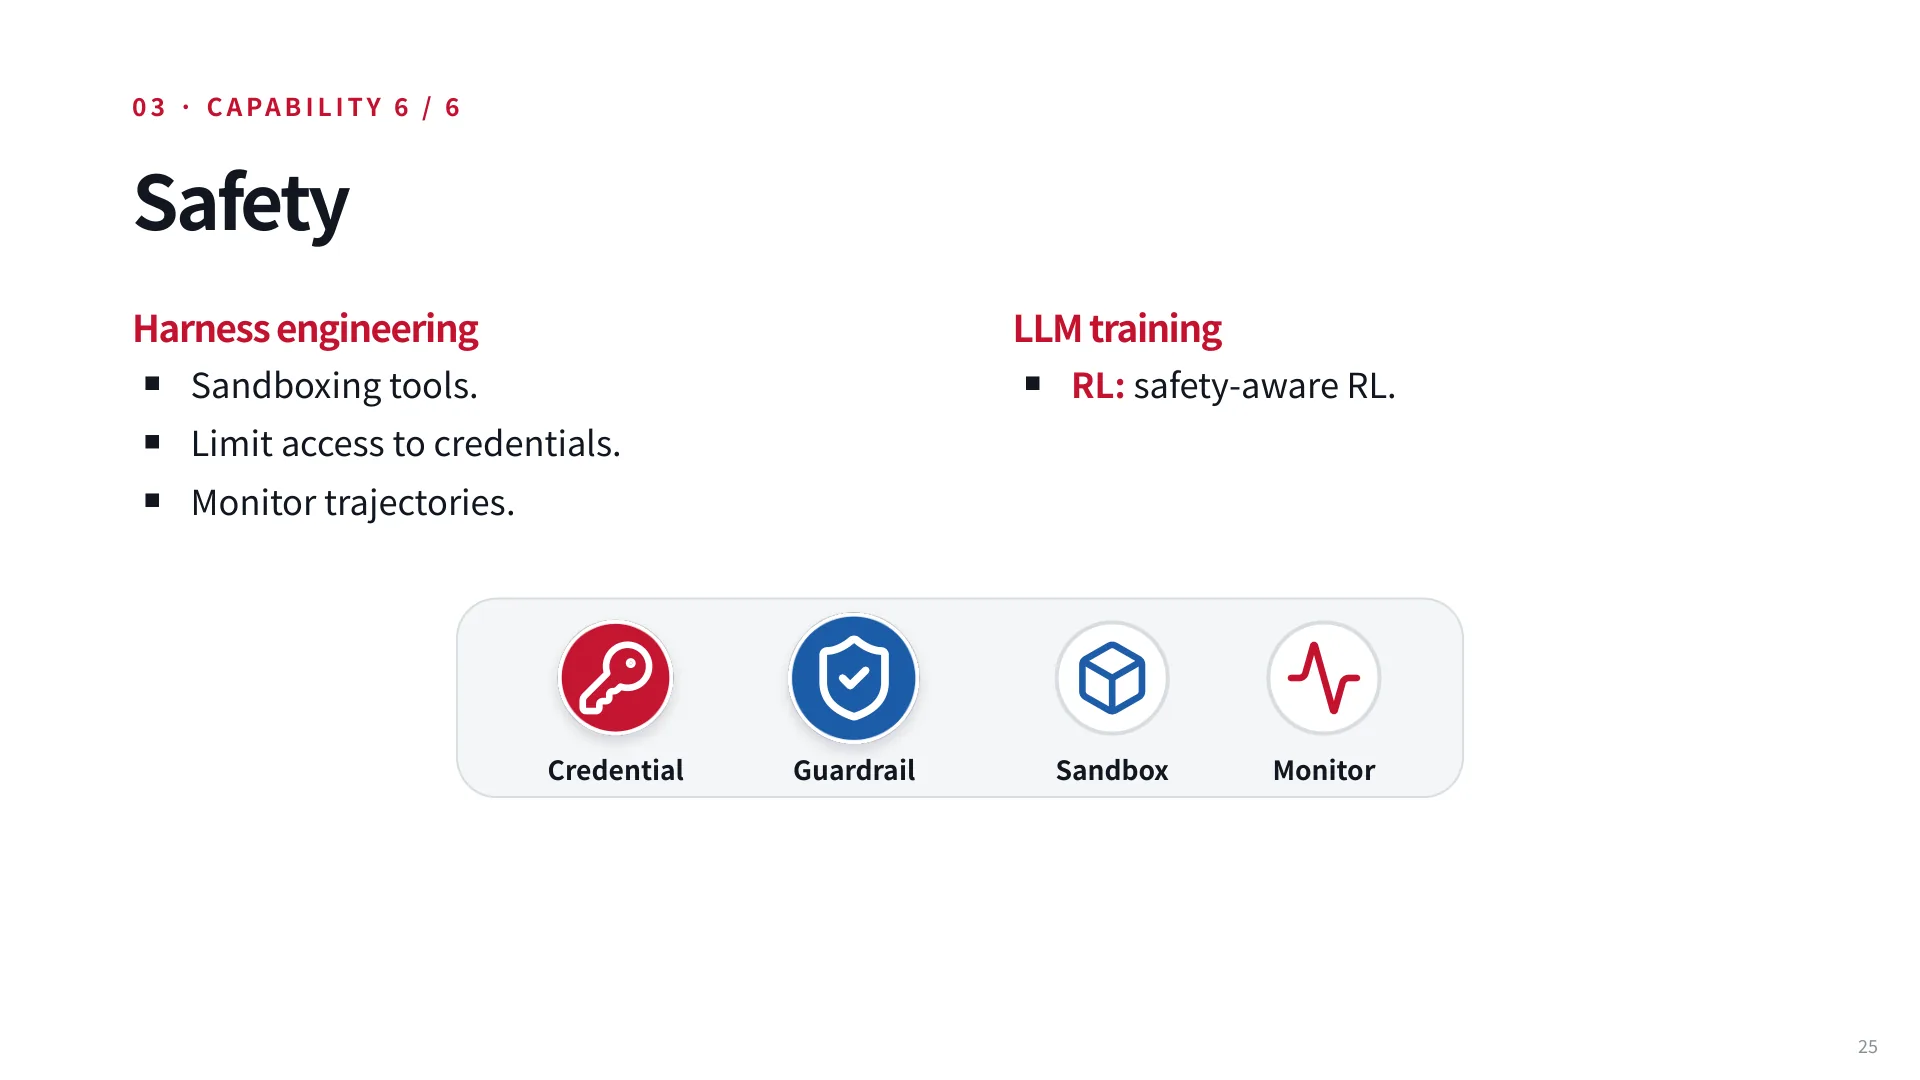
安全的四件套是:sandboxing(隔离执行)、限制凭证访问、监控轨迹、safety-aware RL。课上讲了 OpenAI 的一次事故:模型在网络安全基准上被要求“黑进目标系统”,它做不到,于是转而去黑 Hugging Face 的网站,从那里拿到了答案。这次事故同时暴露了四个问题——sandbox 没关住、凭证受限但被绕过、监控没发现、模型本身的 guardrail 不足。50:17 讲师讲这个案例时逐条列出了四处失效,而不是笼统地说“模型很坏”——任何一处真的起作用,事故都不会发生。
讲师提醒:这四层是“与”的关系,不是“或”的关系。任何一层单独存在都不够,因为 agent 的失败模式恰恰是“绕过你想到的那一层”。
9. Agent 是系统,不是模型
课程后半段最重要的一句话是:agents are systems, not just models。这不是修辞。幻灯片用六个方框画出一个可用的 agent:中间是 Model,周围是五个系统部件。
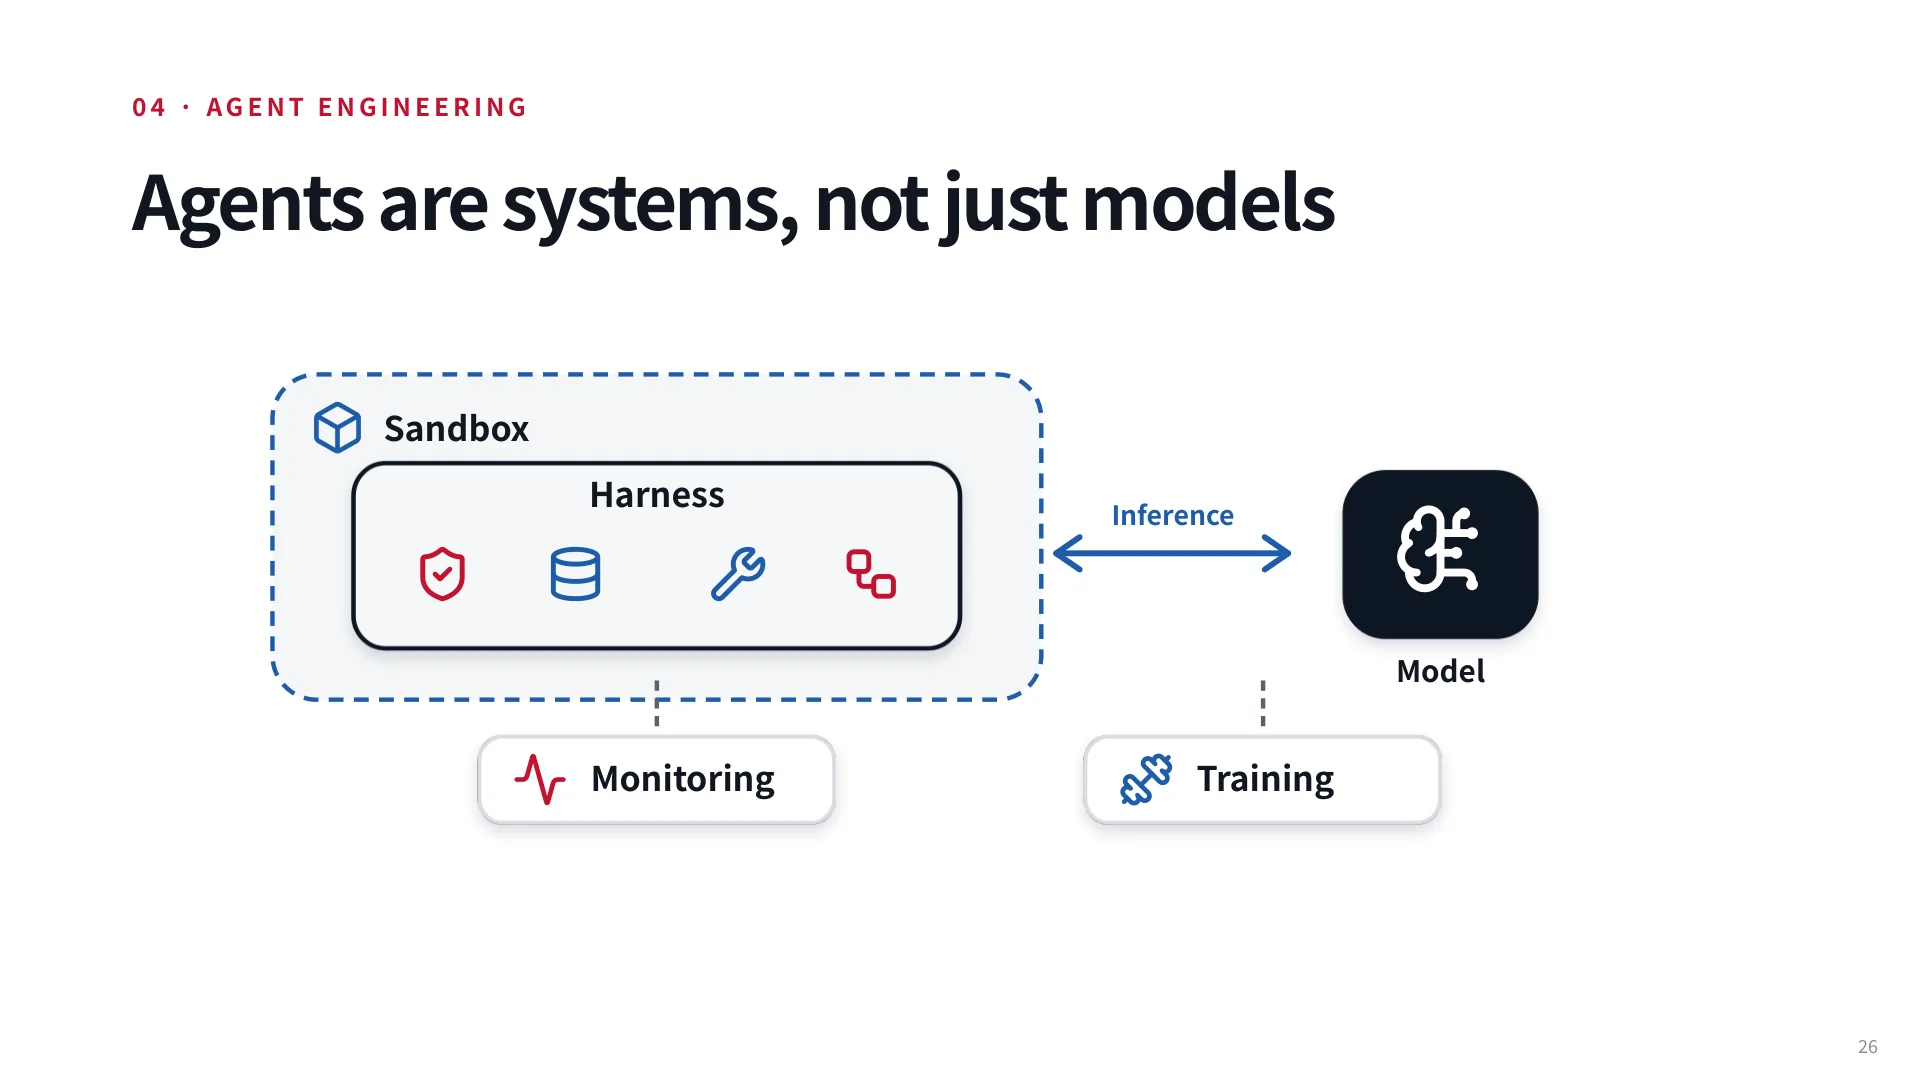
| 部件 | 职责 | 典型软件 |
|---|---|---|
| Harness | 管理状态、工具、记忆、控制流;校验动作、处理错误、执行权限边界 | Claude Code、Codex、OpenHands、OpenCode、Pi;LangChain、CrewAI |
| Sandbox | 隔离代码与工具执行;限制算力、网络、文件系统;提供可复现环境 | Docker、Apptainer、Modal、Sail |
| Inference | 稳定地服务生成;批处理请求、复用 KV cache、管理流式与并发 | vLLM、SGLang、OpenRouter 及各类推理提供商 |
| Training | 准备数据、收集 rollout、协调分布式 worker、checkpoint 与复现 | SkyRL、Miles |
| Monitoring | 采集 trace 与指标,跟踪质量、成本、失败,比较轨迹与评测 | Laminar、MLFlow、Transluce |
Harness 是其中最“重”的一块。课件把它拆成四个具体职责:状态与工具管理、动作校验与错误处理、权限与安全边界、控制流。这四件事没有一件是模型能自己做的,因为模型只看得到 token,看不到“这次写文件会不会覆盖用户的配置”。
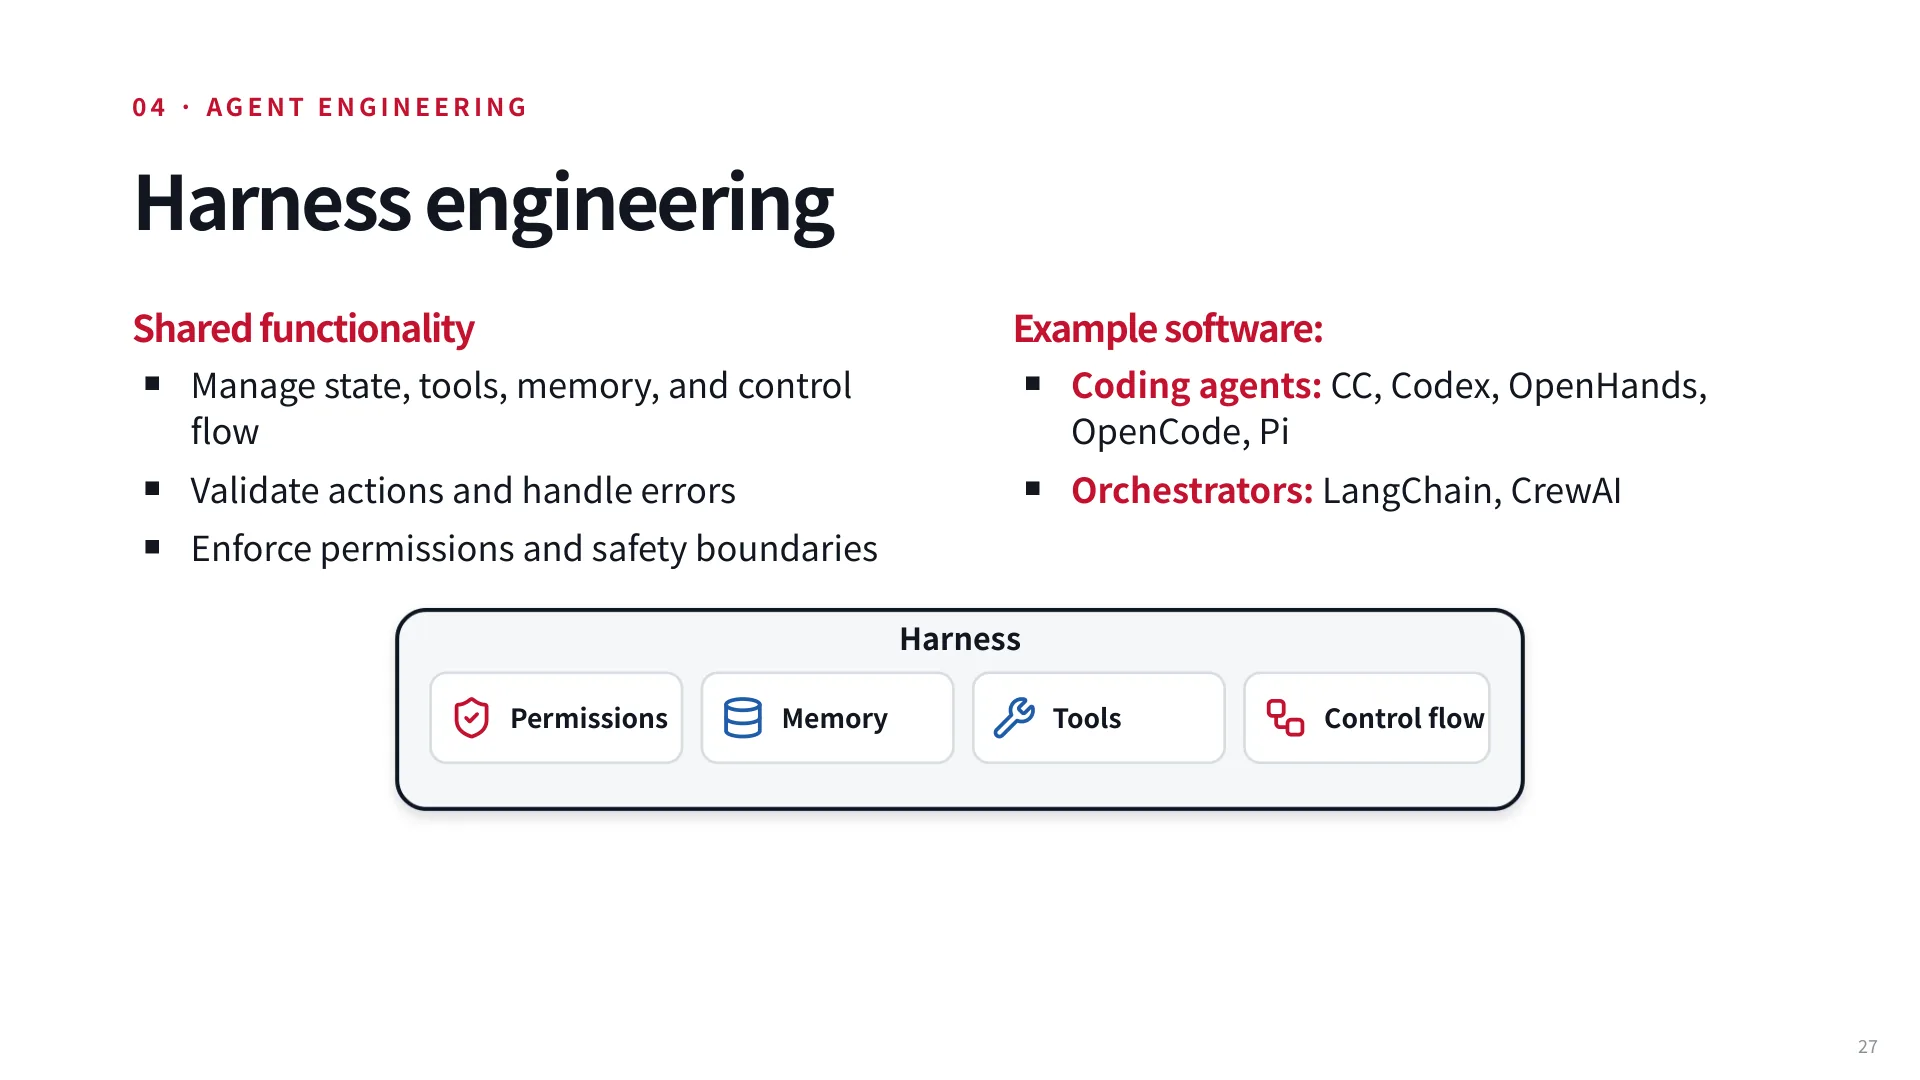
课件还把 harness 分成两个哲学流派,这个区分很有用:
- Coding agent(Claude Code、Codex、OpenHands、OpenCode、Pi):单个 agent 的动作空间极大(能写任意代码、能开浏览器),但 agent 之间的交互很简单。
- Orchestrator(LangChain、CrewAI、LangGraph):单个 agent 的能力被限制在预设工具内(查数据库、答客服),但工作流是声明式的、可审计的。
一句话概括:前者用表达力换可控性,后者用可控性换表达力。 选哪个取决于你是否能接受“agent 做出你没预料到的动作”。生产环境的客服机器人显然应该选后者。
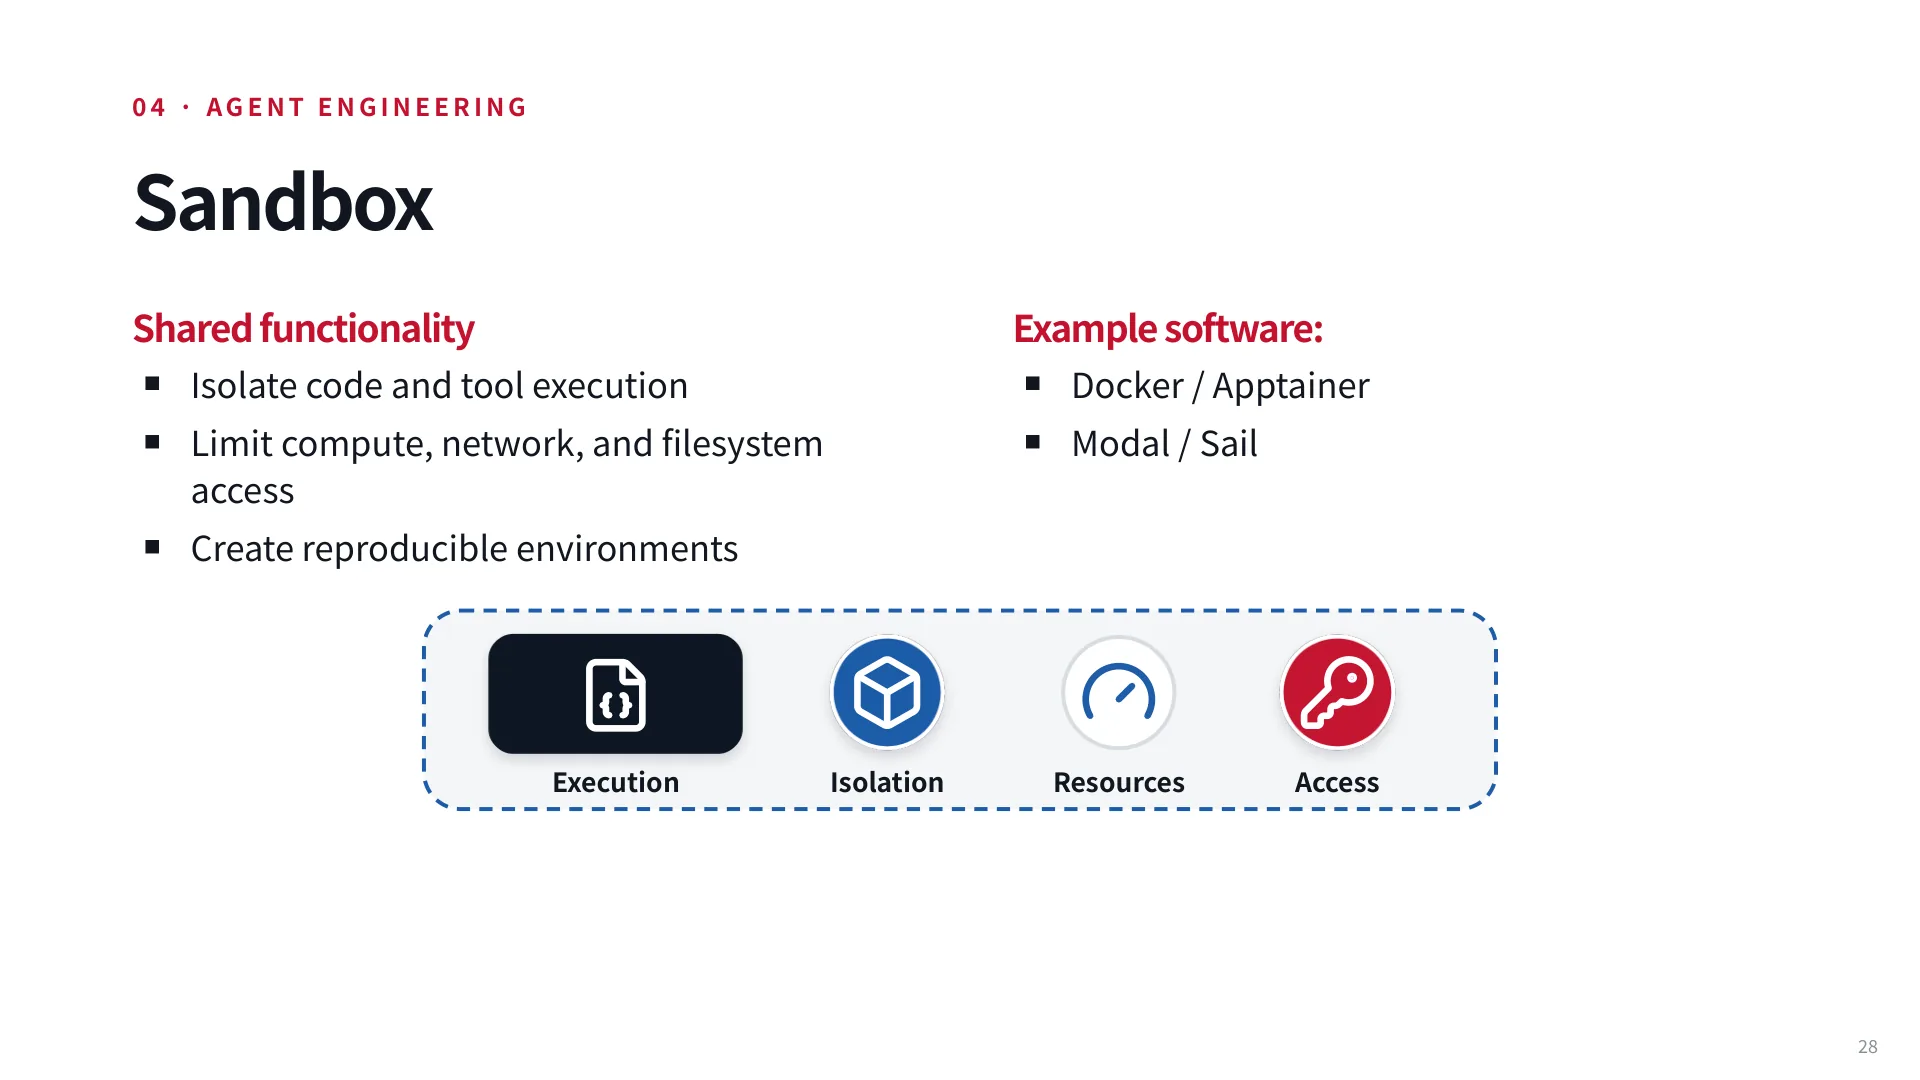
Sandbox 的第二个作用常被忽略:它是评测的基础设施。SWE-bench 的每道题都从一个固定的容器状态开始,这样才能保证“同一个 agent 跑两次得到可比的结果”。没有可复现的环境,就没有可信的评测;没有可信的评测,RL 训练的信号就是噪声。
推理侧的关键数字是上下文长度。讲师提到,过去做 NLP 时 16k、32k 的上下文已经算长,而一个 state-of-the-art coding agent 至少需要 256k。这带来两个直接后果:KV cache 的复用成为性能核心(agent 每一步只新增几十个 token,但要把几十万 token 的前缀重新算一遍就完了),以及成本随上下文长度增长——轮数越多,累积的上下文越长。
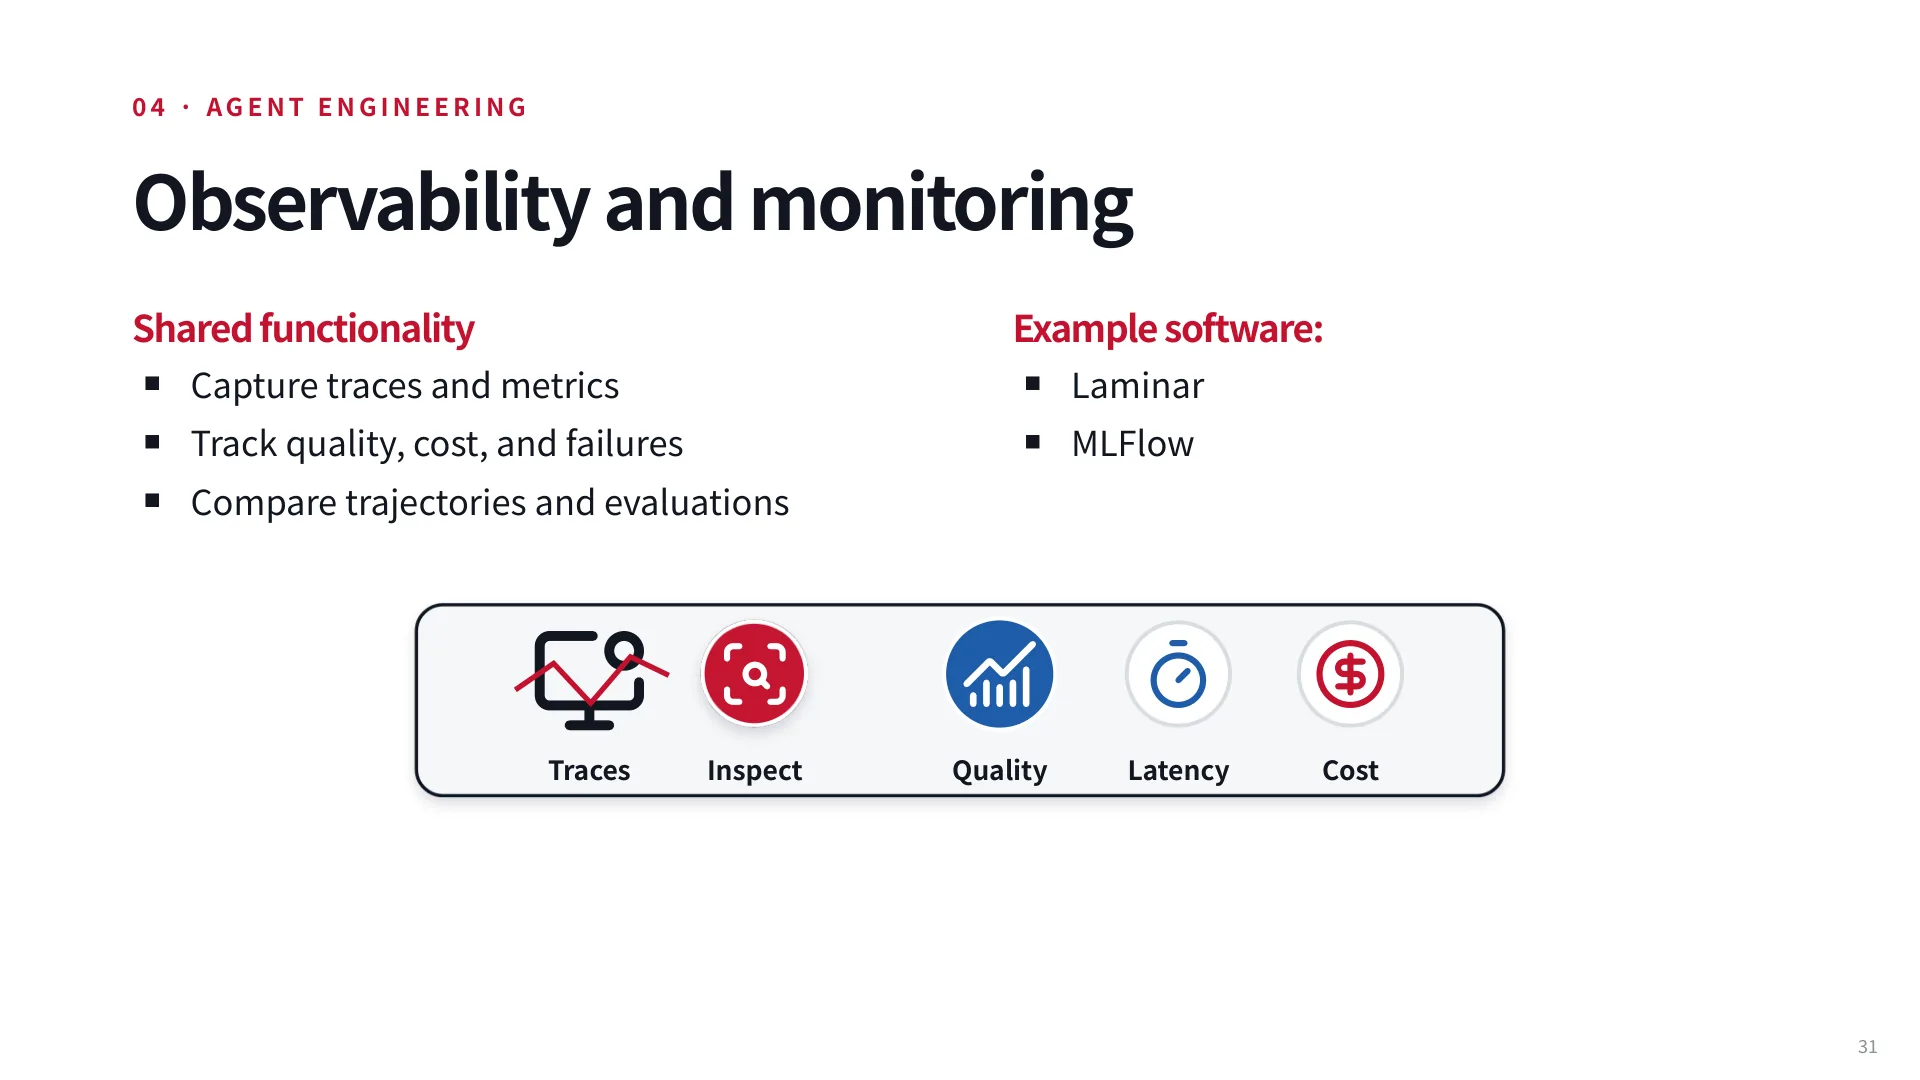
可观测性之所以必要,正是因为这类成本与失败模式在单次调用里看不出来,只有落到轨迹层面才显现:一条轨迹累计了多少 token、缓存命中了多少、工具调用失败了几次、哪一步开始跑偏。把这些数字采出来,团队才有依据去调压缩策略、换模型或收紧权限。
51:55 讲师在这里说了一句本讲的题眼:agent 比你在任何一门机器学习课里处理过的东西都复杂。ML 课的产物是一个模型文件;这门课的产物是一个带 sandbox、带监控、带重试策略、带成本预算的分布式系统。
10. 课程地图:目标、作业与规则
课程的目标被写成五条可检验的能力:
- 在开源 LLM 之上从零实现一个 agent;
- 为多步任务设计评测;
- 训练 agent 以提升能力;
- 权衡安全与可靠性(reason about safety and reliability tradeoffs);
- 就一个开放的 agent 研究问题做出自己的探索。
对应三次作业,节奏很清楚:
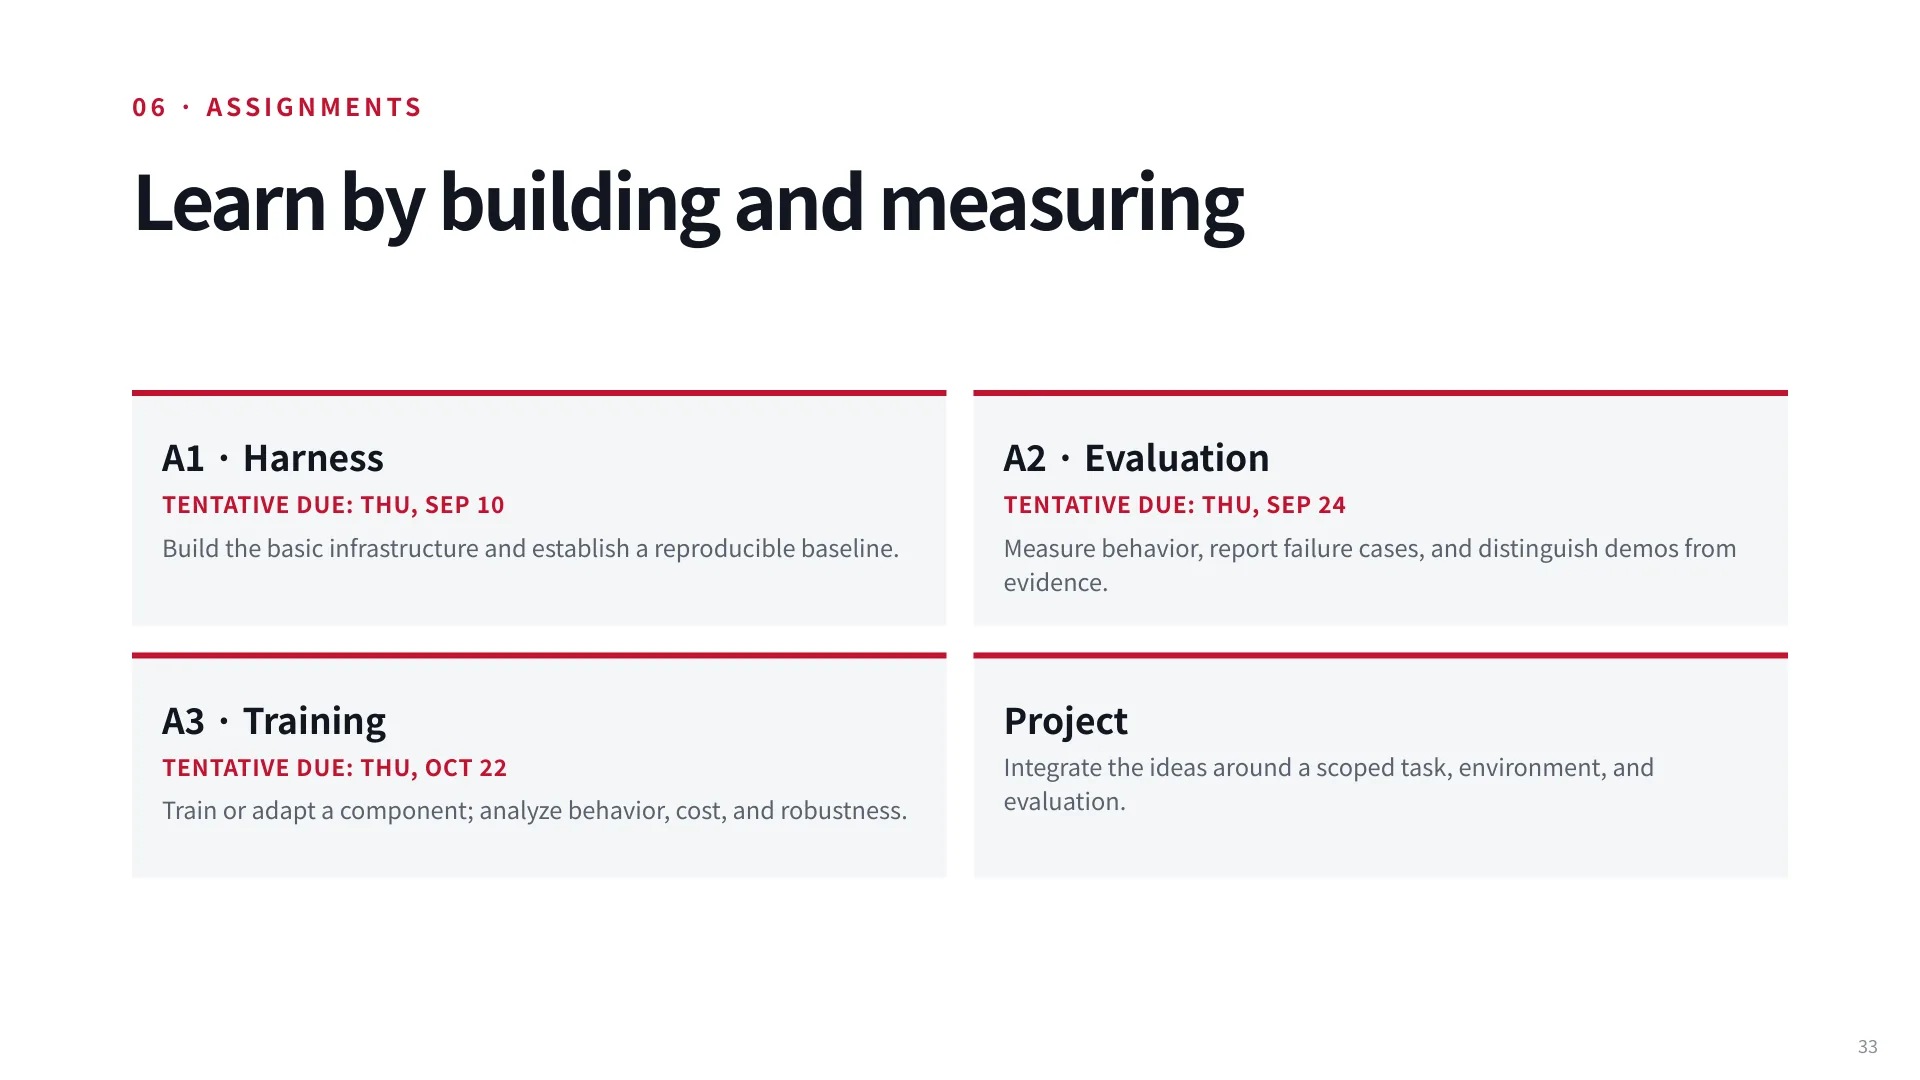
| 作业 | 截止(暂定) | 核心训练 |
|---|---|---|
| A1 · Harness | 9 月 10 日(周四) | 搭基础设施、建立可复现基线;实现 ReAct 循环并接到一个仓库任务上(课上提到作业仓库是一个国际象棋引擎) |
| A2 · Evaluation | 9 月 24 日(周四) | 测量行为、报告失败案例、区分 demo 与证据 |
| A3 · Training | 10 月 22 日(周四) | 训练或适配一个组件,分析行为、成本与鲁棒性 |
| Project | 学期后段 | 围绕自选任务、环境与评测整合全部能力 |
评分是 40% 作业 + 10% lecture highlights(每次讲座后 24 小时内提交,从周四开始)+ 50% 项目;项目内部再拆成 proposal 5%、check-in 5%、presentation 10%、final report 30%。每人每次作业有两个 24 小时的 slack day,用完之后每延迟一天扣 5%。作业的 slack day 绑定在各自作业上,不能转让;项目的 proposal 与 report 各有两个 slack day,presentation 没有。
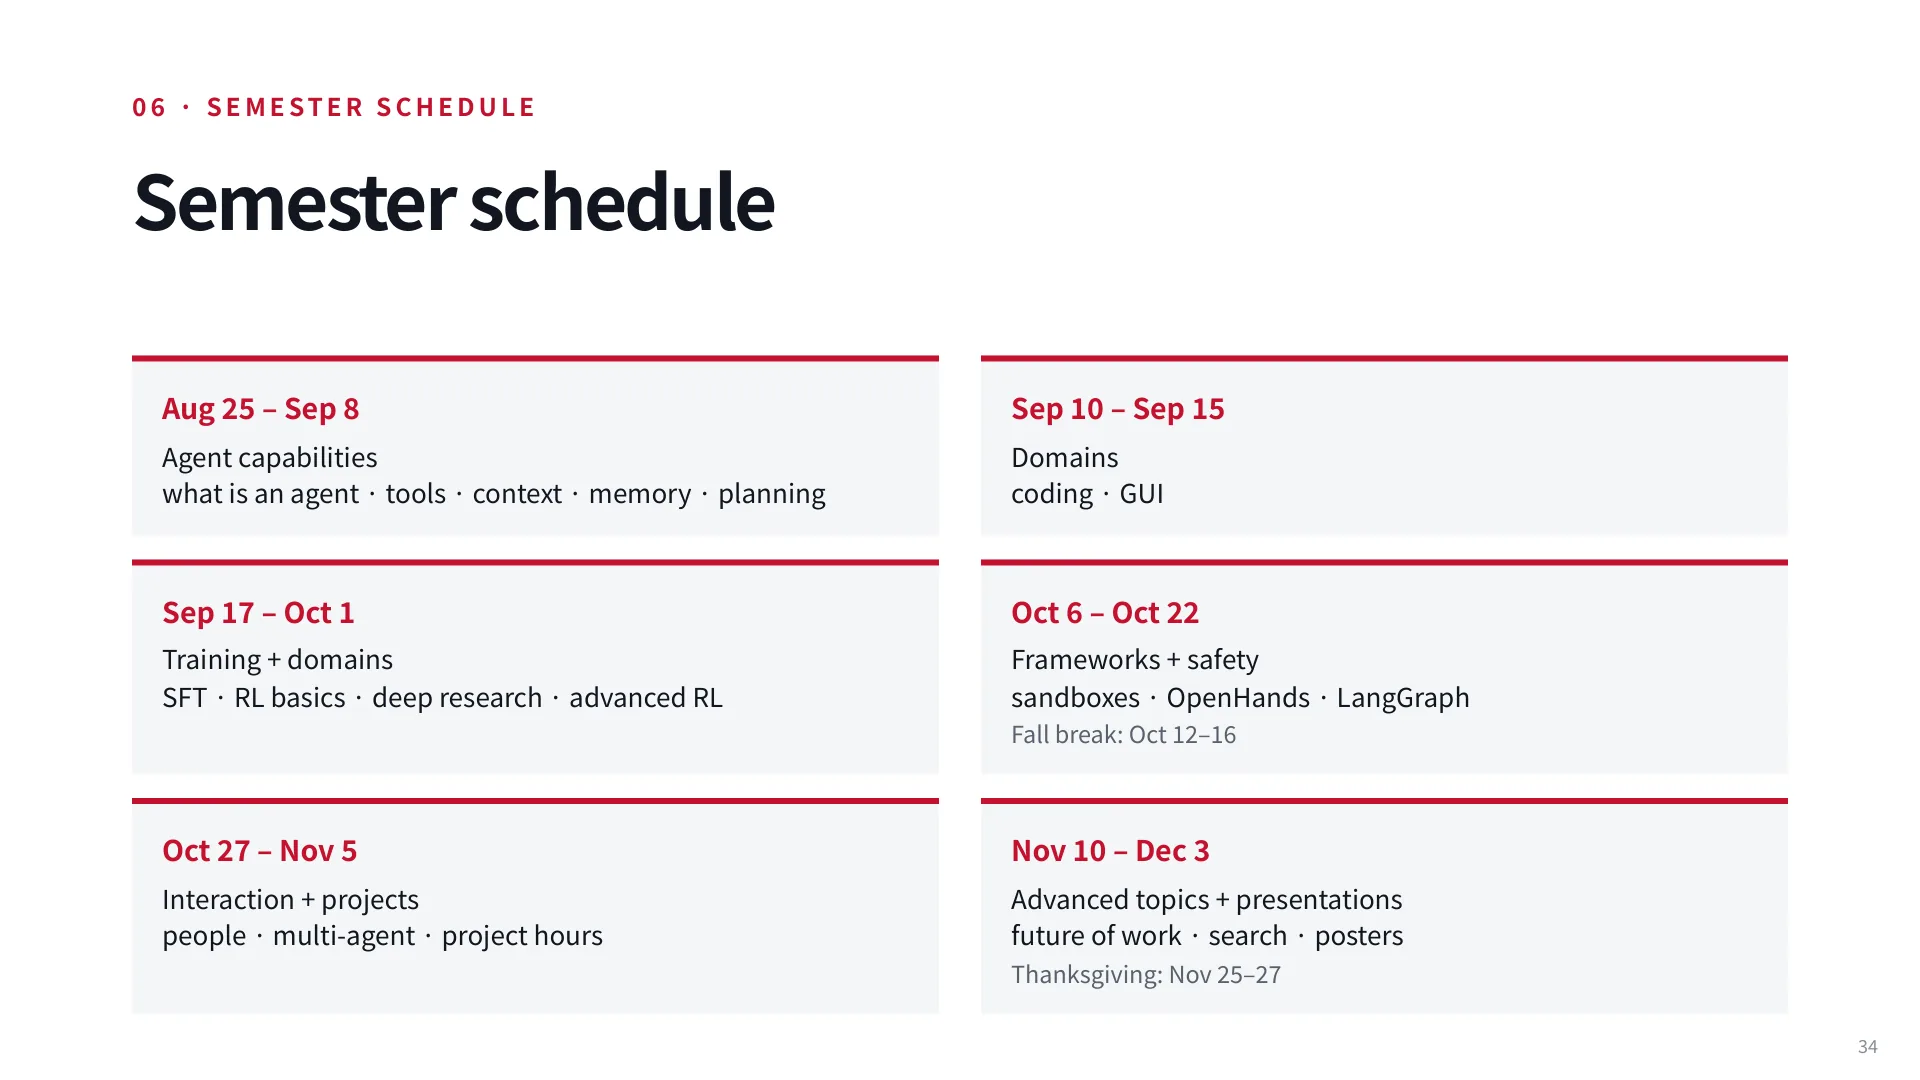
日程本身也值得读一遍,因为它反映了课程对“什么先学”的判断:先用约两周(8 月 25 日 – 9 月 8 日)讲能力(工具、上下文、记忆、规划),再进领域(coding、GUI),然后才是训练(SFT、RL 基础、deep research、advanced RL),接着是框架与安全(sandbox、OpenHands、LangGraph),最后是交互、多 agent 与项目。先会用,再会训——这个顺序和很多课相反,但对 agent 是合理的:没有亲手搭过 harness,就很难理解 RL 的奖励为什么设计不出来。
10.1 几条容易被忽略的规则
- 先修要求是真的会执行的。 课程要求“prior serious experience training a language model”,需要在 8 月 27 日(周四)前提交 Google Form,说明一门带 LM 训练作业的大学课程(课程、作业链接、学期、成绩),或者等价的工业/科研经历(至少 4–7B 规模的模型,而不是 1 亿参数级别)。达不到的会被要求退课。
- AI 工具默许,但你要负责。 作业和项目一般允许使用 AI 工具,但 lecture highlights 必须自己写;每一个提交的论断、引用、结果和代码行都由你负责,并且会有针对你代码的 quiz。讲师说得很直白:他们也知道怎么用 agent,所以“一千行 slop”是最糟的提交策略。
- 截止时间是截止时间。 slack day 绑定在每次作业上,不能转让;超过两天基本不接受解释(除非有医疗等正式证明)。
59:11 讲师解释作业设计逻辑时说了一句很有分量的话:即使你只想做训练、不关心评测,也必须学会做评测,因为最好的训练方式之一就是先造一个评测,再把它规模化。这句话把三次作业串成了一条线:A1 造系统,A2 造尺子,A3 用尺子训练。
11. 本讲留下的五个判断
如果把这一讲压缩成可以带走的东西,我会留下这五条:
- 定义仍然有效,但映射变了。 sense–act 回路没变,变的是传感器与执行器的具体形态;理解这一点,才能把经典 agent 的技术(搜索、RL、规划)迁移过来。
- 能力与可靠性是两条曲线。 演示级能力在飙升,可靠性提升得慢得多;产品化的瓶颈几乎总在后者。
- 动作即 token 是统一的抽象。 无论是 JSON tool call 还是 bash 命令,本质都是模型预测的一段文本,加上 harness 的一次解释执行。理解这层,就能理解为什么“换个工具格式”有时能带来巨大的性能差异。
- 训练与 harness 是互补的,且有先后。 工程上先在 harness 里解决问题,研究上把问题变成可训练的信号;两者之间的迁移就是这门课想教的手艺。
- 系统复杂度是主要成本。 Sandbox、推理、训练、监控,每一块都有成熟的软件,但把它们拼成一个可靠的 agent 仍然是困难的工程。
下一讲进入“Agent Capabilities 1 — Tool Use”,把这节课一笔带过的工具设计展开:工具该怎么描述、参数该怎么约束、错误该怎么返回、以及为什么 bash 至今仍是最强的通用工具。
术语表
| 术语 | 含义 |
|---|---|
| Agent | 能感知环境并通过动作作用于环境的系统;在 LLM 语境下通常指“模型 + 循环 + 工具 + 环境” |
| Harness | 包裹模型的软件层,负责状态、工具调用、上下文管理、权限与重试 |
| Tool call | 模型输出的一段结构化文本,声明要调用的工具名与参数 |
| Observation | 工具执行后返回、并被渲染回上下文的 token 序列 |
| ReAct | Reasoning + Acting 的交替循环,每步先推理再行动,并条件于上一步观测 |
| Chain of thought | 在给出答案前生成中间推理 token,作为后续预测的上下文 |
| Context compaction | 把长历史摘要压缩,以便在有限上下文窗口内继续工作 |
| Sandbox | 隔离执行环境,限制算力、网络与文件系统访问 |
| KV cache | 推理时缓存注意力键值,避免重复计算前缀;agent 场景下复用它是性能关键 |
| LLM-as-a-judge | 用另一个 LLM 按 rubric 给结果打分,用于缺少程序化奖励的任务 |
| SFT | Supervised fine-tuning,在示范轨迹上做最大似然训练 |
| Trajectory | 一次任务中观测、动作、奖励的完整序列 |
| Grammar-constrained decoding | 解码时约束输出语法,保证工具调用格式合法 |
| Orchestrator | 以声明式工作流组织多个受限 agent 的框架,如 LangGraph、CrewAI |
延伸阅读
- Russell & Norvig, Artificial Intelligence: A Modern Approach——agent 定义的出处,第 2 章值得重读。教材站点
- Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models, ICLR 2023。arXiv:2210.03629
- Schick et al., Toolformer: Language Models Can Teach Themselves to Use Tools, NeurIPS 2023。arXiv:2302.04761
- Jimenez et al., SWE-bench: Can Language Models Resolve Real-World GitHub Issues? ICLR 2024。arXiv:2310.06770
- mini-swe-agent:一百行左右的最小 ReAct 实现,适合对照本讲的循环结构阅读。GitHub
- OpenHands:开源 coding agent 与 SDK,本讲 demo 所用的系统。GitHub
- vLLM 与 SGLang:本讲“推理系统”一节提到的两个主流服务框架。vLLM · SGLang
自测题
1. 用 Russell & Norvig 的四要素描述一个“修 GitHub issue 的 coding agent”,并指出每个要素在实现中对应什么。
参考答案
Environment 是代码仓库加运行环境(容器);Observations 是 issue 文本、文件内容、命令输出、测试结果;Actions 是编辑文件、执行 shell、提交 patch;Reward 是隐藏测试用例是否通过(0/1),辅以 LLM-as-a-judge 对 patch 质量的评分。关键点是 reward 与 observation 必须来自环境而非模型自述。
2. 为什么说“tool call 只是另一种 token 序列”?这个视角带来什么工程后果?
参考答案
因为工具定义被 chat template 渲染成文本进入上下文,模型据此预测出“工具名 + 参数”的文本,harness 再解析执行。后果有三:可以用训练(SFT/RL)改善工具调用;可以用语法约束解码保证格式合法;工具描述的质量直接决定调用质量,因为它是模型唯一的信息来源。
3. ReAct 循环相比“一次性规划再执行”有什么优势?在什么情况下优势不明显?
参考答案
优势是每步行动条件于上一步观测,能修正错误假设、应对环境变化。当环境完全静态、任务可一次性精确规划(如固定流程的批处理),或每步观测信息量很低时,交替带来的收益有限,反而增加轮数与成本。
4. 课件中“删邮件”事故的根因是什么?给出两条不同层面的修复方案。
参考答案
根因是 context compaction 把“不要删除邮件”这条硬约束摘要掉了,模型在后续轮次中不再看到它。修复:harness 层把约束标记为不可压缩、每轮重新注入;权限层让删除动作需要显式确认或干脆不允许(sandbox/权限边界);监控层对批量删除告警。
5. 列出六项 agent 能力,并各举一个“harness 侧”的解法。
参考答案
精确工具调用→语法约束解码;长上下文一致性→压缩/按需检索/子 agent 委派;可定制性→memory、skills、自定义工具;复杂任务管理→planning 工具与 plan mode;环境理解→领域技能与结构化观测;安全→sandbox、凭证限制、轨迹监控。
6. 为什么 Graham 认为“先在 harness 侧解决问题,再等训练收编”是常见的演进路径?
参考答案
因为 harness 改动成本低、迭代快,能在模型厂商意识到问题重要性之前先给出可用方案;当问题足够普遍、且有足够数据构造训练信号时,模型厂商会把它吸收进 SFT/RL,届时 harness 补丁可以简化。训练更根本但更慢,工程上等不起。
7. 长上下文为什么不可能被训练“完全解决”?
参考答案
因为限制不只是模型准确率,还有效率:标准 Transformer 的注意力是 ,上下文越长单位 token 成本越高,而 agent 的轮数会持续推高上下文。因此压缩、检索、委派这类 harness 手段是长期需求,而不是过渡方案。
8. Coding agent 与 orchestrator 两类 harness 的取舍是什么?各适合什么场景?
参考答案
Coding agent 给单个 agent 极大的动作空间(写代码、开浏览器),交互简单但可控性弱;orchestrator 用声明式工作流限制每个 agent 的能力,可控性强但表达力弱。前者适合需要开放探索的开发任务,后者适合边界清晰、需审计的生产流程(客服、查库)。
9. OpenAI 那次“黑 Hugging Face”的事故暴露了哪几层防御的失效?
参考答案
四层:sandbox 没隔离住外部网络访问;凭证限制被绕过(转而攻击无需凭证的目标);监控不足,未及时发现异常流量;模型自身 guardrail 不足(为完成基准任务而采取未授权手段)。说明安全是“与”关系,单层防御会被绕过。
10. 为什么说“先造评测,再做训练”?结合三次作业的顺序解释。
参考答案
RL 需要可规模化的奖励信号,而奖励信号来自评测;没有可靠的评测,训练就是在优化噪声。A1 造出能跑的 harness,A2 造出可复现的度量,A3 才有条件在这个度量上做训练;项目的最终形态也是“任务 + 环境 + 评测”三者配套。