
3b · Domains 1: Coding Agents
本讲速览
- Coding agent 不是单一模型,而是“模型 + 工具 + 循环”。本讲把问题拆成三层:写一段代码、改一个仓库、参与完整软件生命周期。
- 单步代码模型仍然是一切的地基。 预训练要处理代码数据配比、清洗、分词和长上下文;中训练要强化代码能力;FIM(infilling)让模型学会利用右侧上下文。
- 代码评测比文本评测更依赖执行。 参考解匹配、BLEU/CodeBLEU/CodeBERTScore 各有盲区,执行测试是主流,但测试本身的假阳性/假阴性是当前最大瓶颈之一。
- Agentic coding 的核心循环是 localize → edit → verify。 找位置、改代码、跑测试;失败后回到假设,而不是盲目重试。
- 工具设计会显著影响成绩。 只给 bash 也能工作,但专用 edit tool、合理的 diff 格式、代码搜索工具会明显降低出错率。
- 训练与评测正在形成闭环。 SWE-bench 提供评测,SWE-Gym / SWE-smith 提供可执行训练环境,multi-harness training 让同一模型适配不同 agent 框架。
- 软件工程远不止修 issue。 需求、评审、部署、监控、维护、测试生成、CI 修复都是 agent 的潜在战场,但数据和验证器更难构造。
1. 定位:从代码补全到软件工程
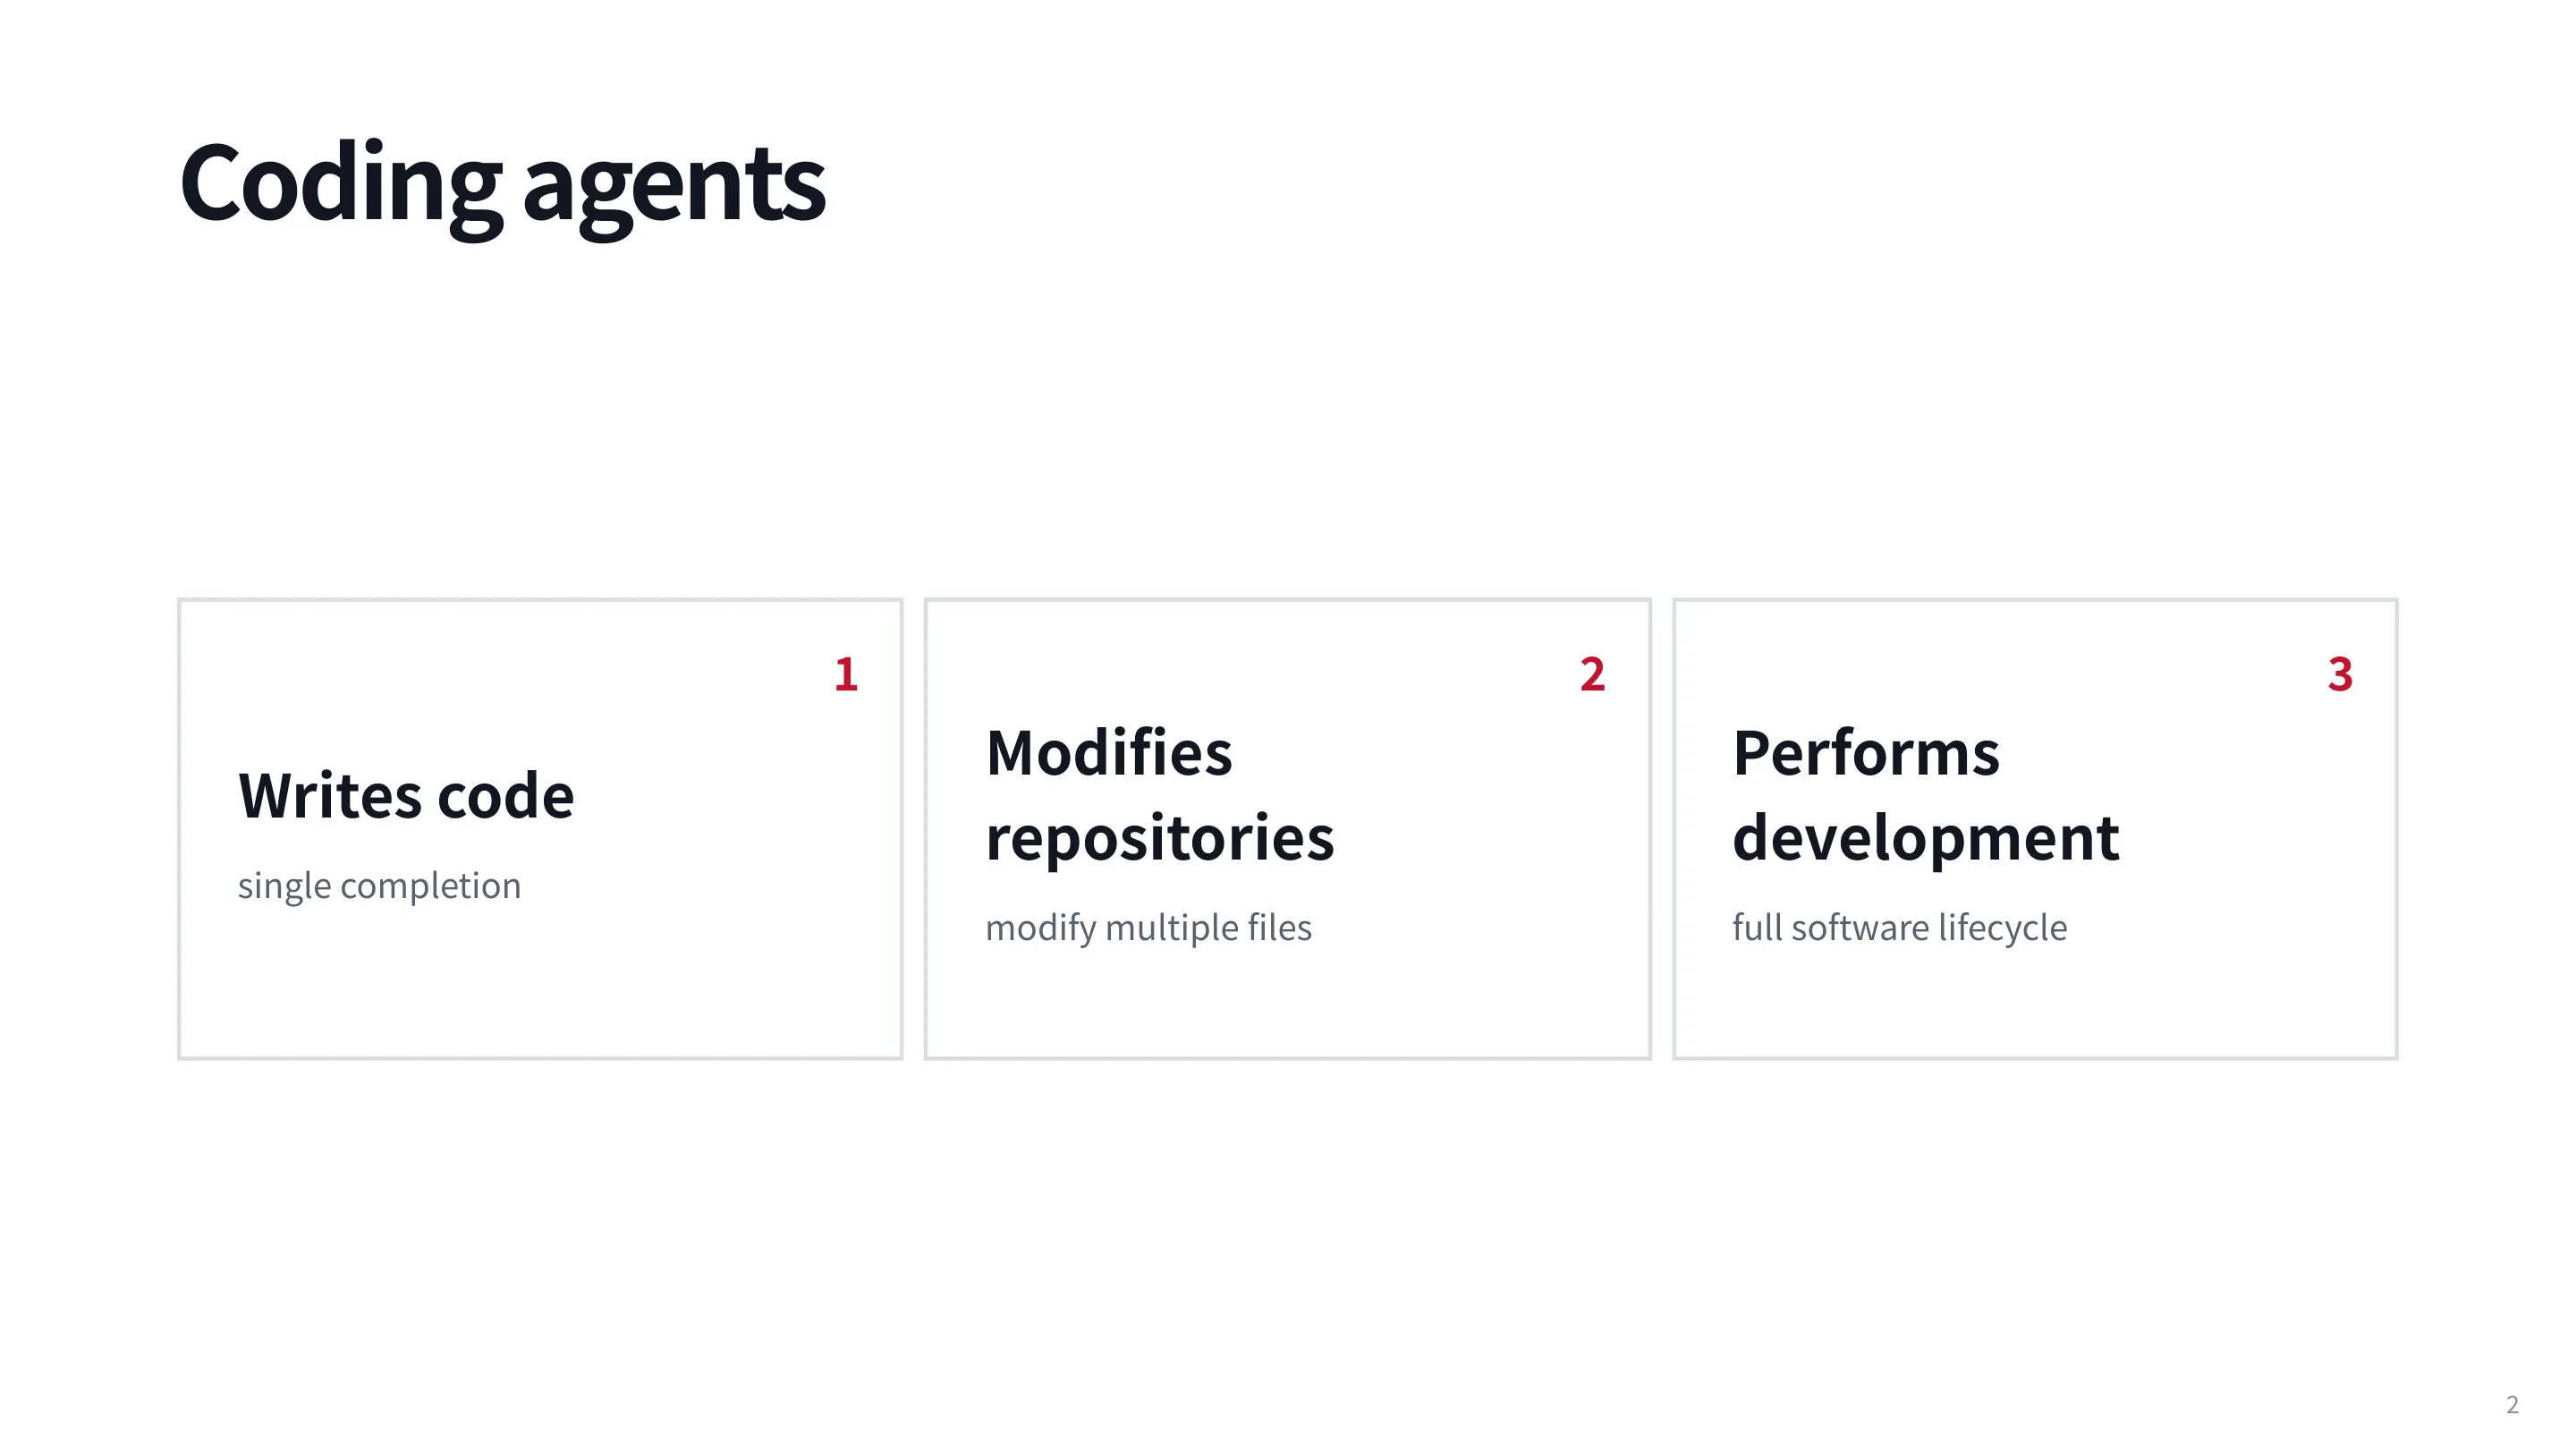
Graham 先澄清了标题:本讲不只讲“会写代码的 agent”,而是讲如何构造一个能在软件工程中工作的 agent。他把 coding agent 分成三个层次(Slide 2):
- 写代码:给定 prompt,生成一段 completion;
- 修改仓库:跨多个文件定位并修改代码;
- 参与开发:覆盖需求、实现、测试、评审、部署、维护的完整生命周期。
所有 agent 仍然由三个 ingredients 组成(Slide 3):Prompt、Tools、LLM。前两讲已经讨论了 prompt、记忆和长上下文,本讲把重点放在 LLM 的代码能力与 coding toolset 上。
对单步代码模型来说,有三项关键能力(Slide 5):
| 能力 | 含义 | 典型失败 |
|---|---|---|
| Language | 掌握语法、API、idioms | 调用不存在的库函数、参数顺序错误 |
| Editing | 同时利用待修改位置的左右上下文 | 只根据前缀补全,改错相邻代码 |
| Reasoning | 从 specification 推导 behavior | 边界条件漏判、复杂度不达标 |
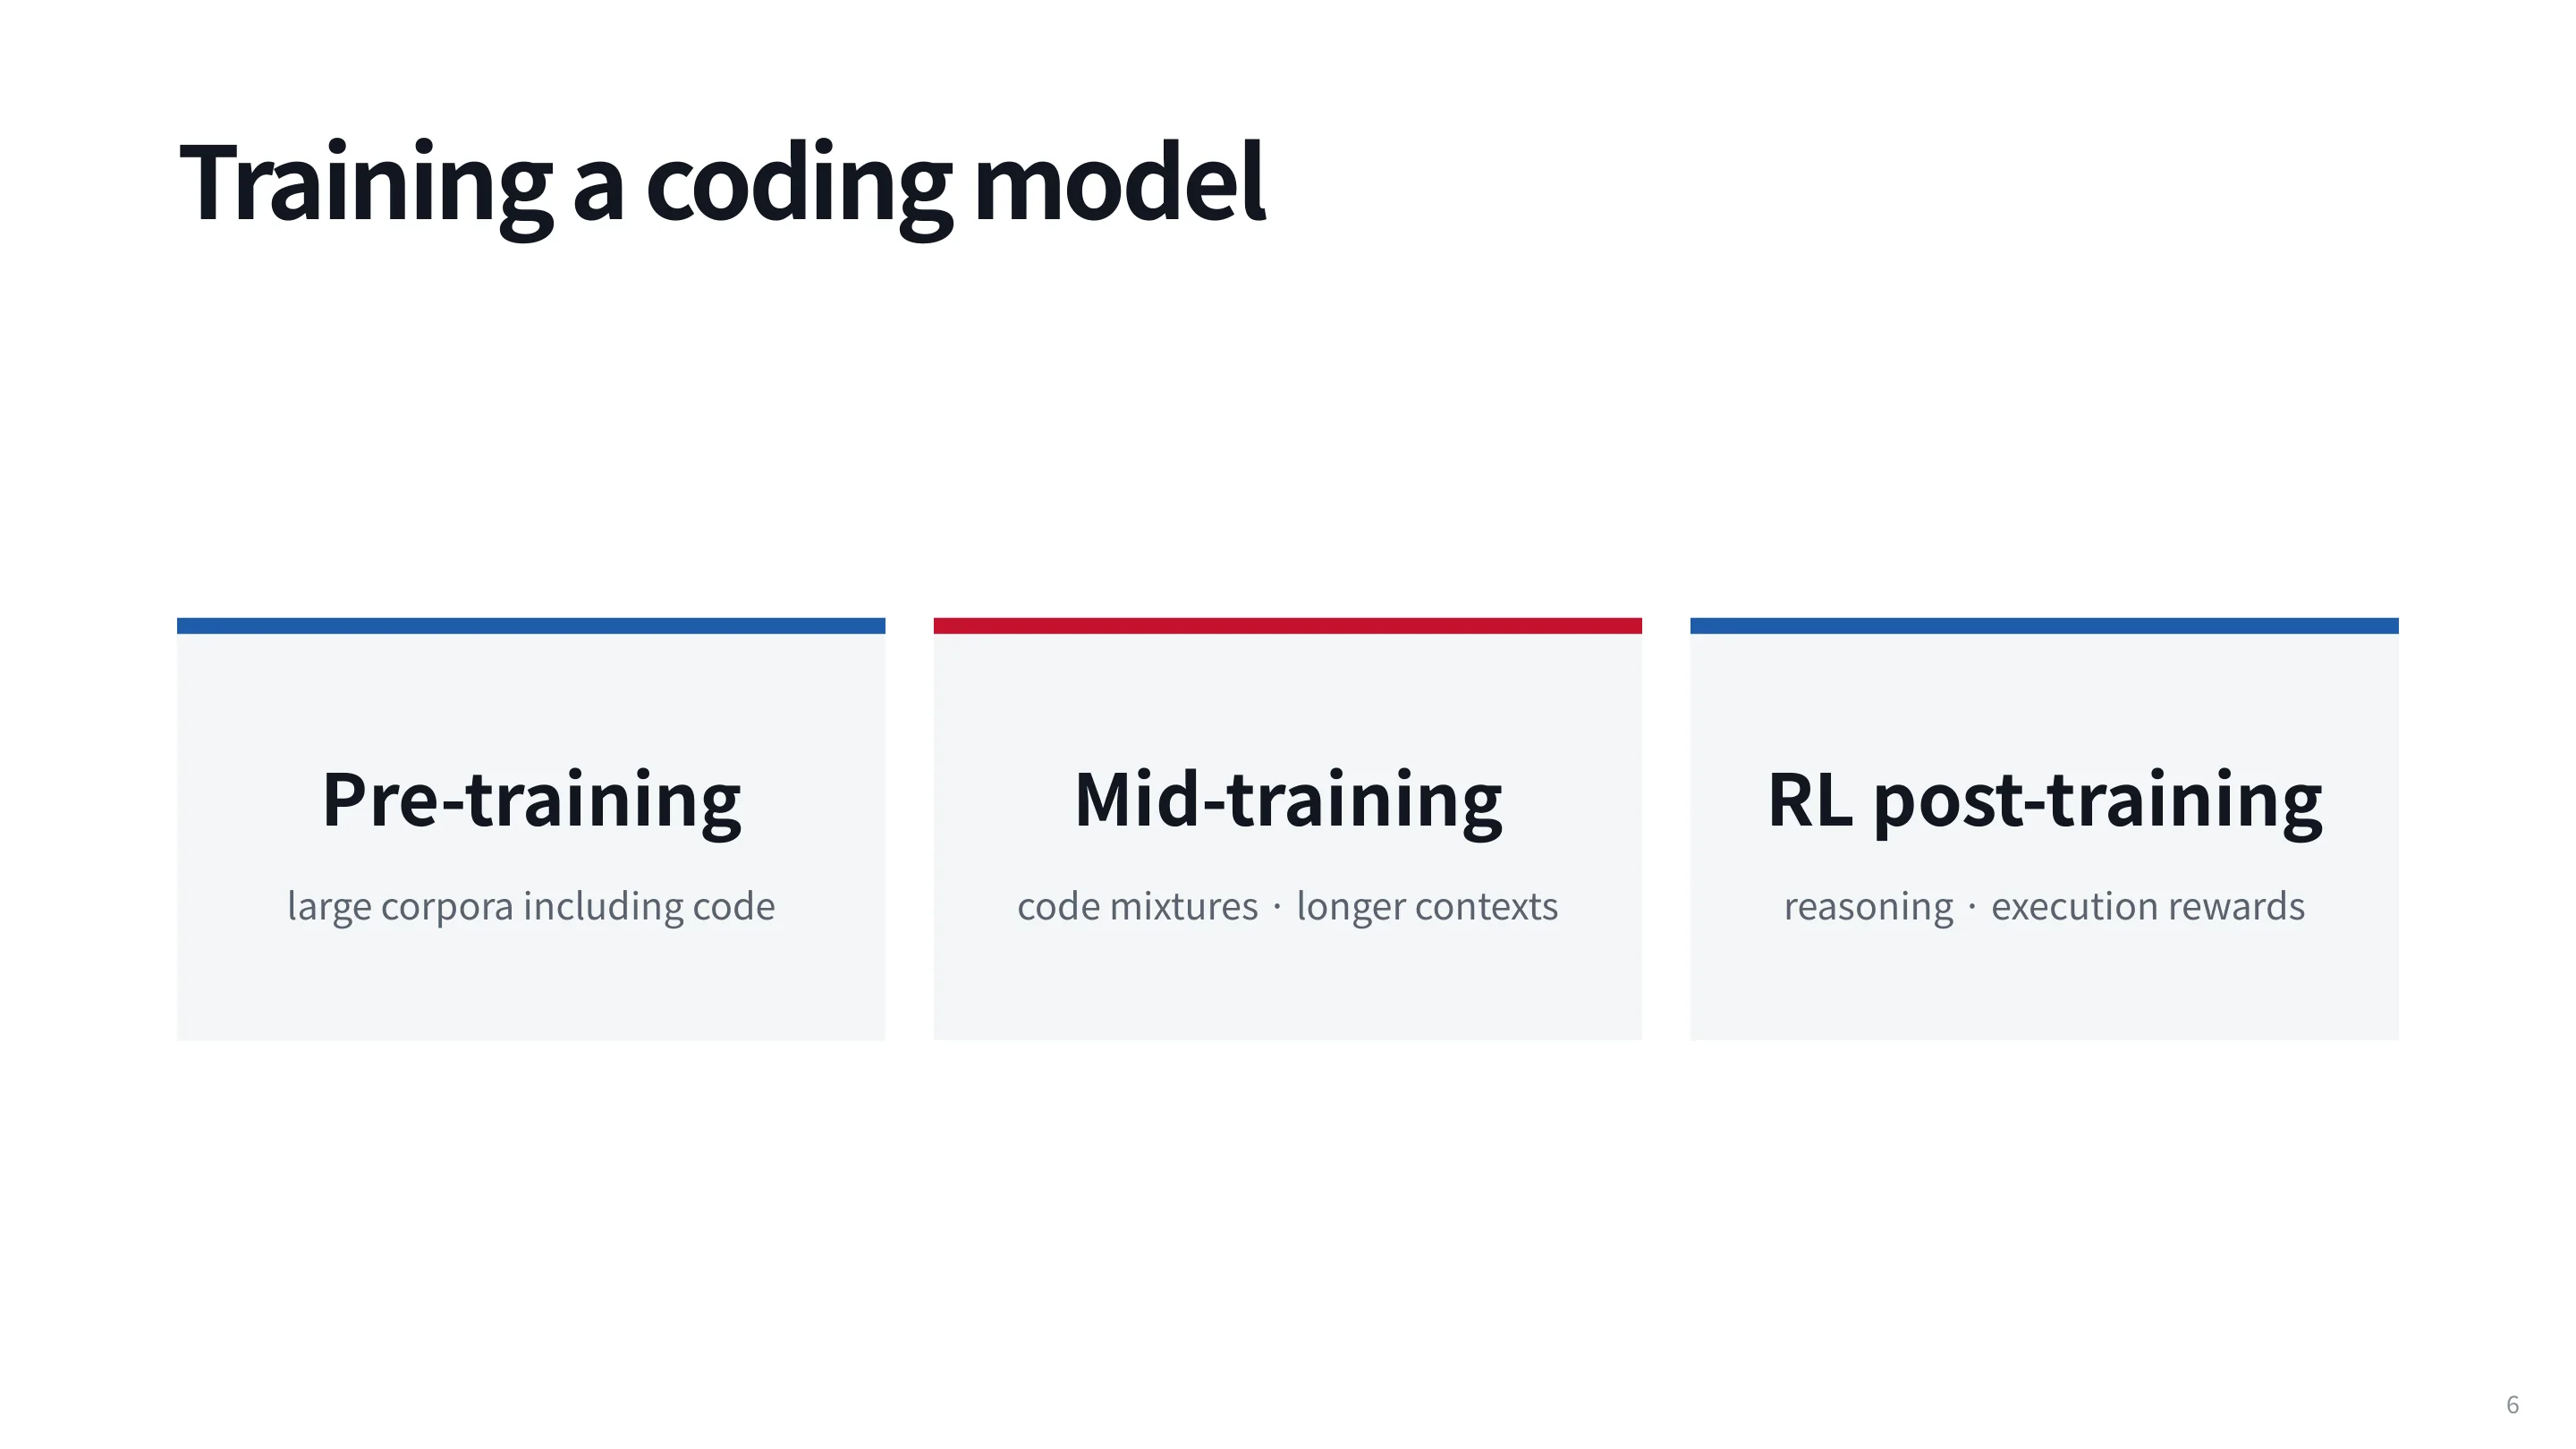
对应的训练流水线是 pre-training → mid-training → RL post-training(Slide 6)。本讲会依次展开,但把 SFT/RL 的通用机制留给后面的 Training 模块,只讲 coding 特有的部分。
本讲的主线
单步模型的能力边界决定了 agent 的上限;agentic loop 与工具设计决定了这些能力能否被稳定调用;可执行评测则决定了我们能否可靠地训练和比较 agent。
2. 单步代码模型:预训练与中训练
2.1 预训练:代码不是孤立语料
代码模型不能只在代码上训练。预训练语料通常是 web text、technical prose、mathematics、source code、documentation 的混合(Slide 7)。原因很直接:模型既要会写代码,也要能读懂 issue、文档、错误信息和自然语言需求。
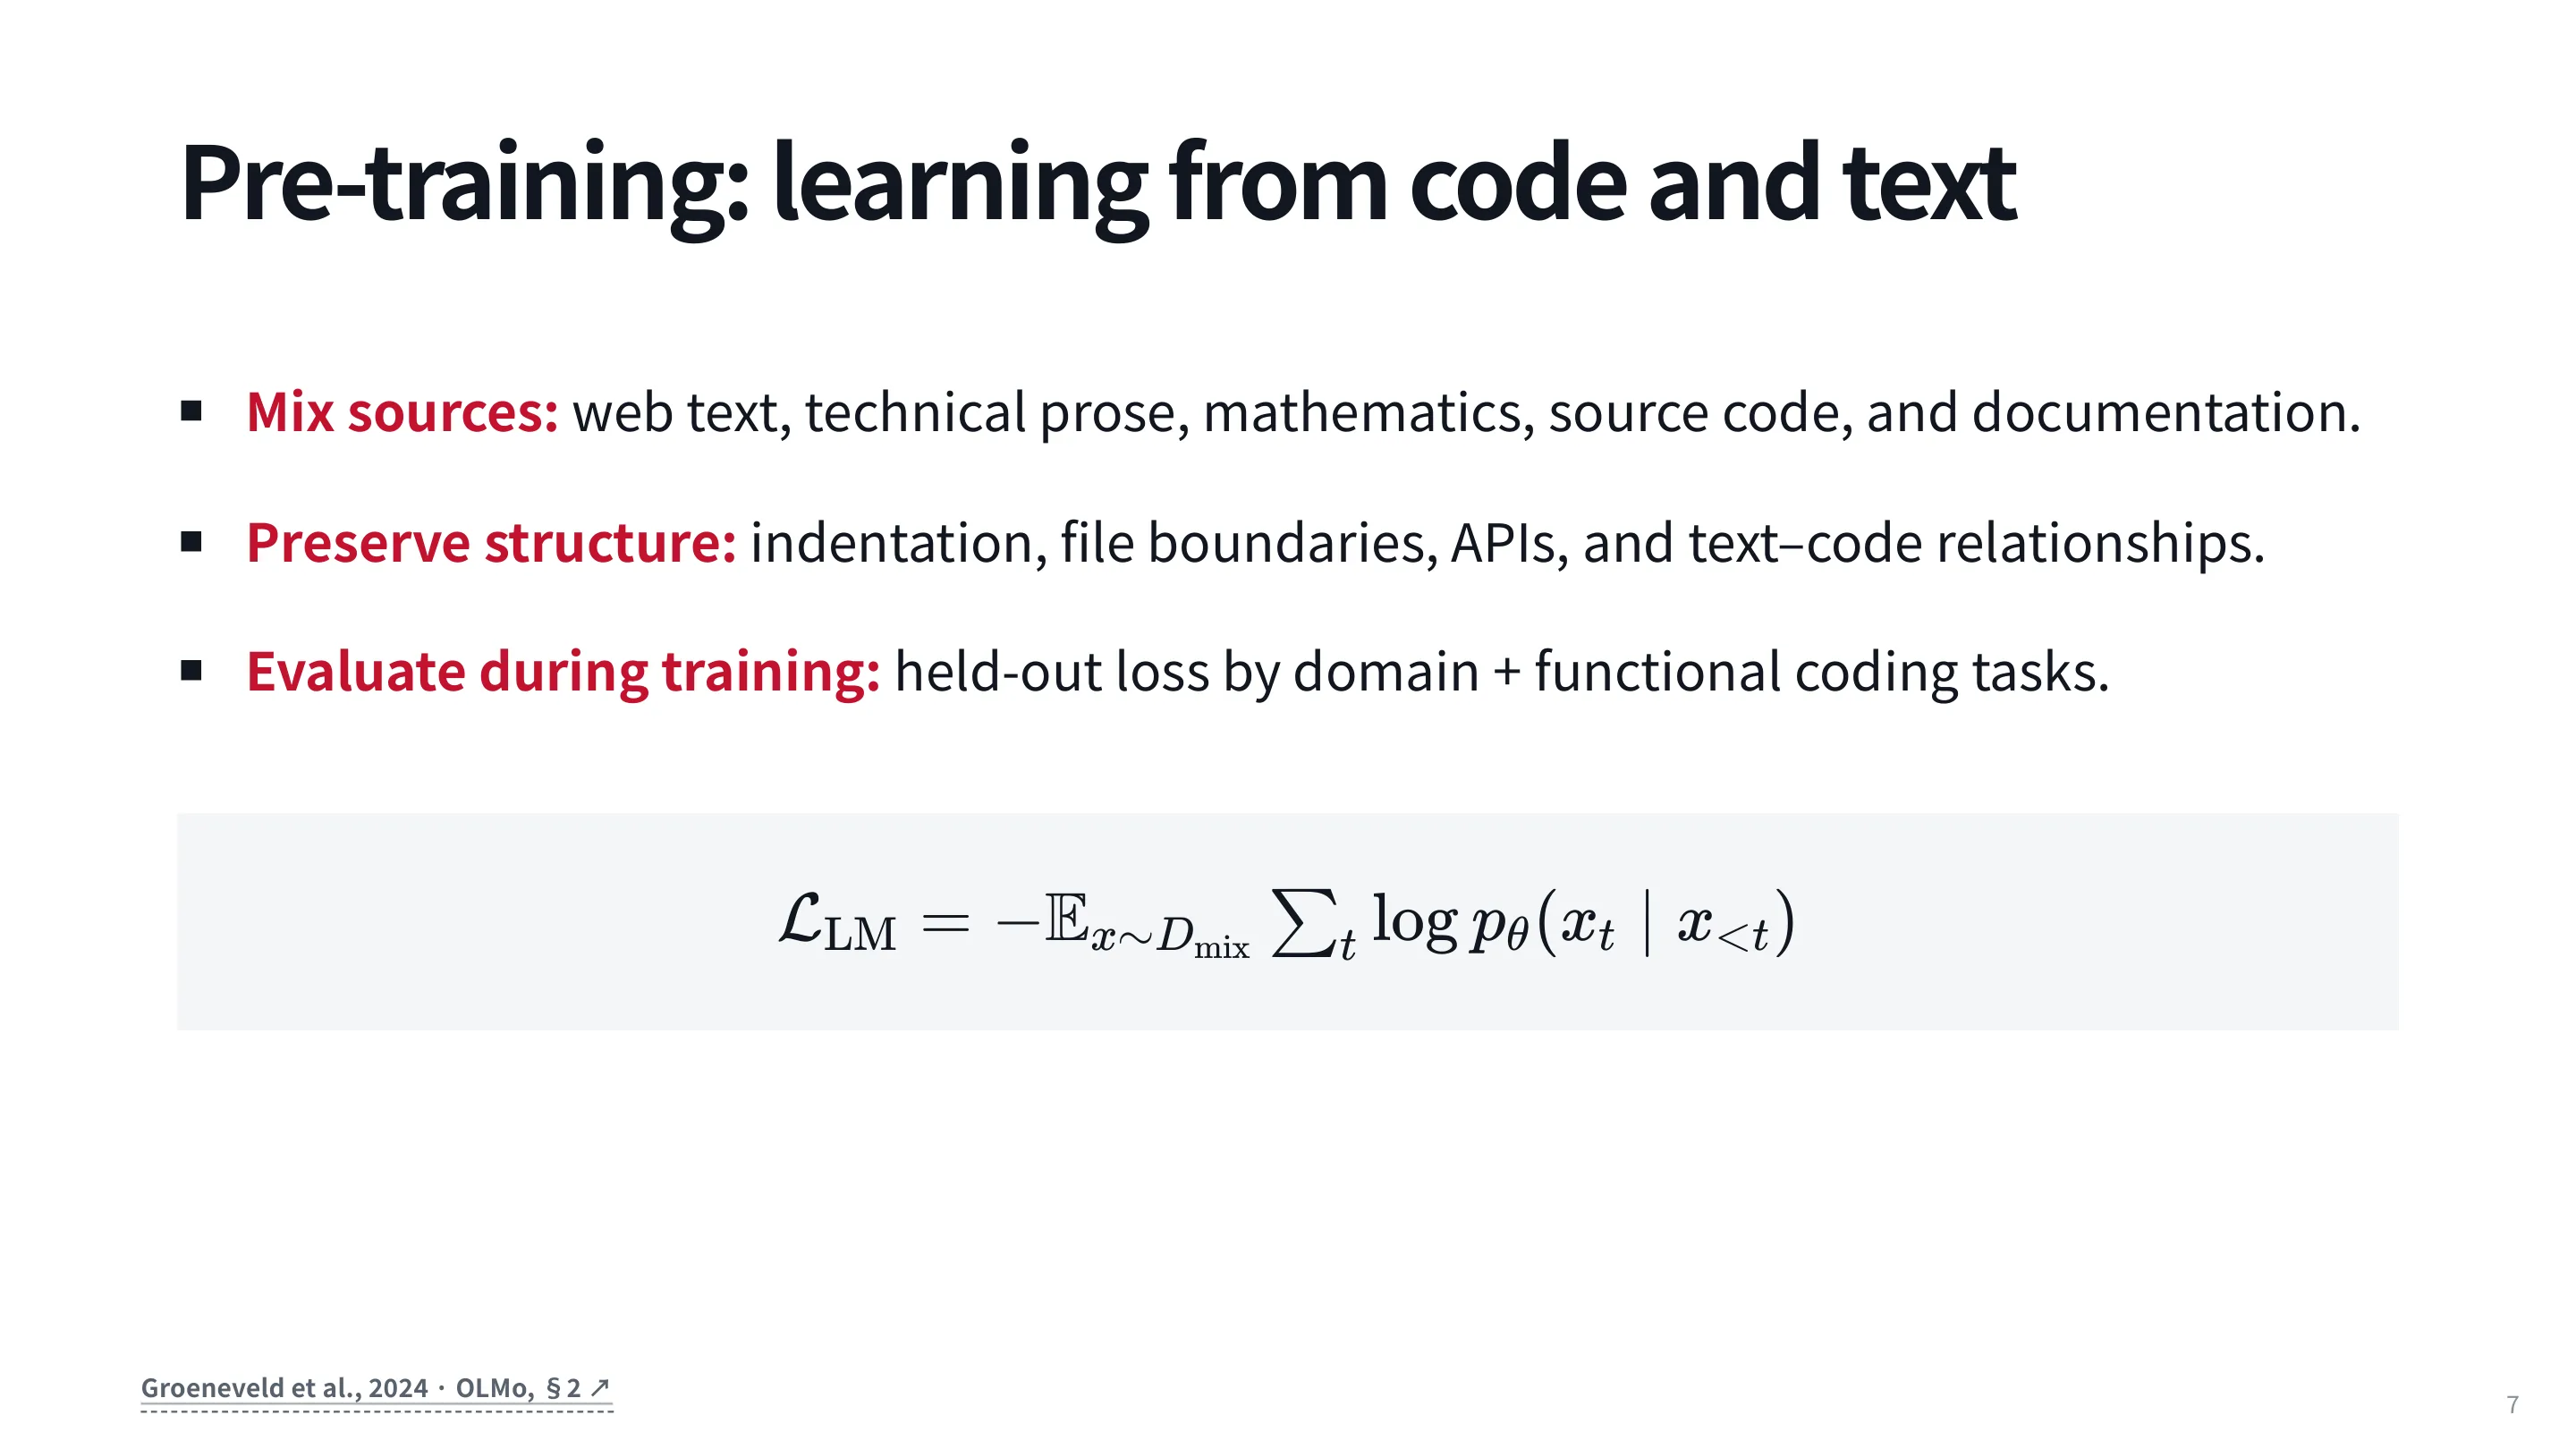
预训练目标仍然是 next-token prediction:
但与纯文本模型相比,代码预训练要额外注意三件事:
- 保留结构:缩进、文件边界、API 边界、文本与代码块的对应关系都不能被随意破坏;
- 按领域评估:除了 held-out loss,还要看 functional coding tasks,避免“loss 好看但代码跑不通”;
- 数据来源配比:代码、文档、数学、自然语言的比例会直接影响通用能力与代码能力的权衡。
一个历史细节:早期文本预处理会归一化空白(把连续空格压成一个),这对 Python 是灾难性的,因为缩进本身承载语义。代码模型必须保留 whitespace。
2.2 数据清洗:代码分布很“重尾”
代码数据的清洗比文本更难,因为代码有很多近乎重复的副本(Slide 8):
- 按语言和来源过滤:去掉自动生成的大规模 dump、错误编码、低价值重复;
- 去重:fork、vendored library、几乎相同的文件、复制粘贴的题解都要处理;
- 记录 provenance:license、source date、opt-out、敏感数据过滤;
- 防止泄漏:按 repository 或 problem family 切分,评测集要做 decontamination。
讲师特别提到 license 与敏感数据:训练数据中可能包含 API key、私有代码或带限制的 license。工业界通常会用 TruffleHog 之类的工具做 secret scanning,并在数据管线中记录来源与退出机制。这些问题不只是法律问题,也会影响模型发布后的可持续性。
2.3 分词:空白和标识符都是语义的一部分
代码分词的目标不是“把字符压得越短越好”,而是在压缩率与可编辑性之间取平衡(Slide 9)。
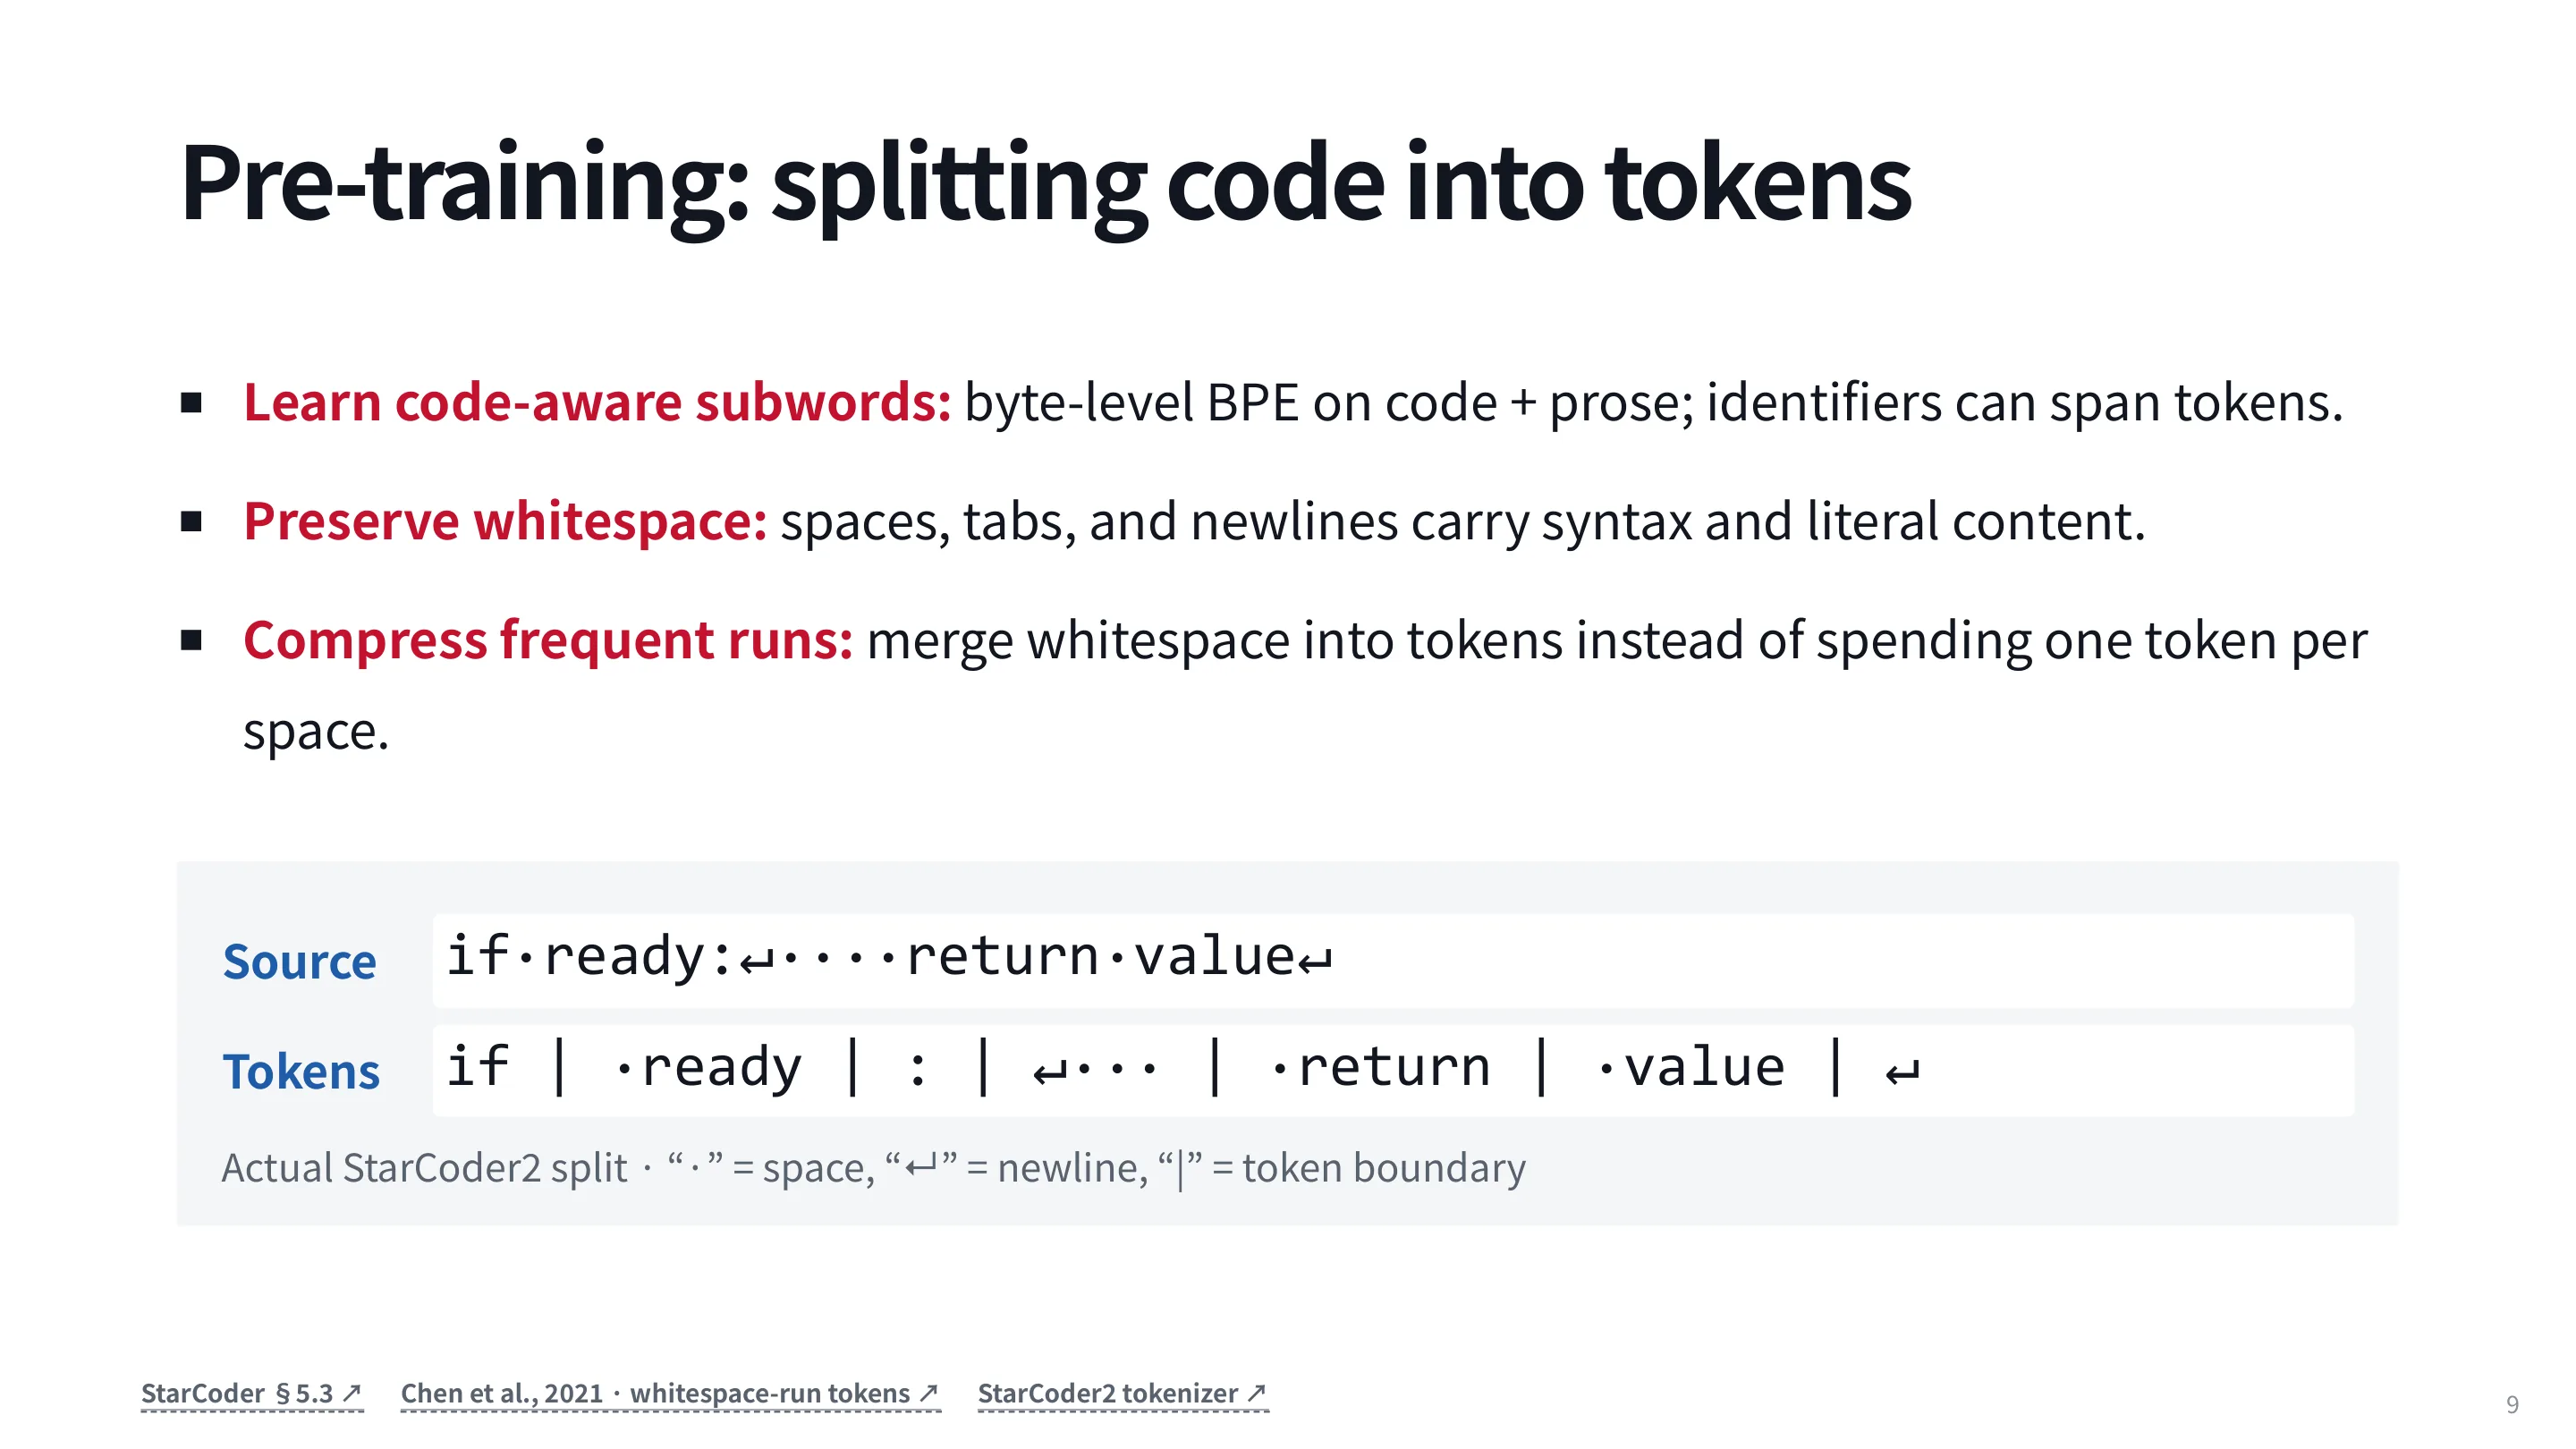
几个关键点:
- 使用 byte-level BPE(或同类 subword 方法),让代码中的标识符、运算符、缩进都能被表示;
- 保留空白:空格、tab、换行在 Python/YAML/Makefile 中可能是语法;
- 压缩常见 run:例如把
\n(换行 + 四个空格)合并成一个 token,而不是每个空格一个 token; - 标识符可能跨 token:
read_file可能被切成多个 subword,模型需要学会组合。
课堂讨论中有一个很好的 trade-off:如果允许 tokenizer 跨空白合并,可以得到更紧凑的表示(讲师提到某些设置下可减少约 40% 的 token),但会破坏“部分补全”能力。例如 import numpy as np 可能变成一个超长 token,模型就无法在 import numpy 处停下来做补全。改 tokenizer 还会影响已训练模型的兼容性,因此实际系统通常非常保守。
另一个实际问题是语言偏置:不指定语言时,模型默认写 Python;做 dashboard 时默认写 React。这既来自语言流行度,也来自 RL 阶段使用的解释器/工具链。讲师举了一个例子:让模型把 Python 数据管线改成 Rust,模型改完之后每次运行又调用 Python,必须反复强调 “in Rust” 才改正。
2.4 规模:更多 token 通常更好,但不是所有语言都一样
StarCoderBase 的规模是 15.5B 参数、1T tokens、80+ 种语言,数据包含 source code、issues、commits、notebooks(Slide 10)。
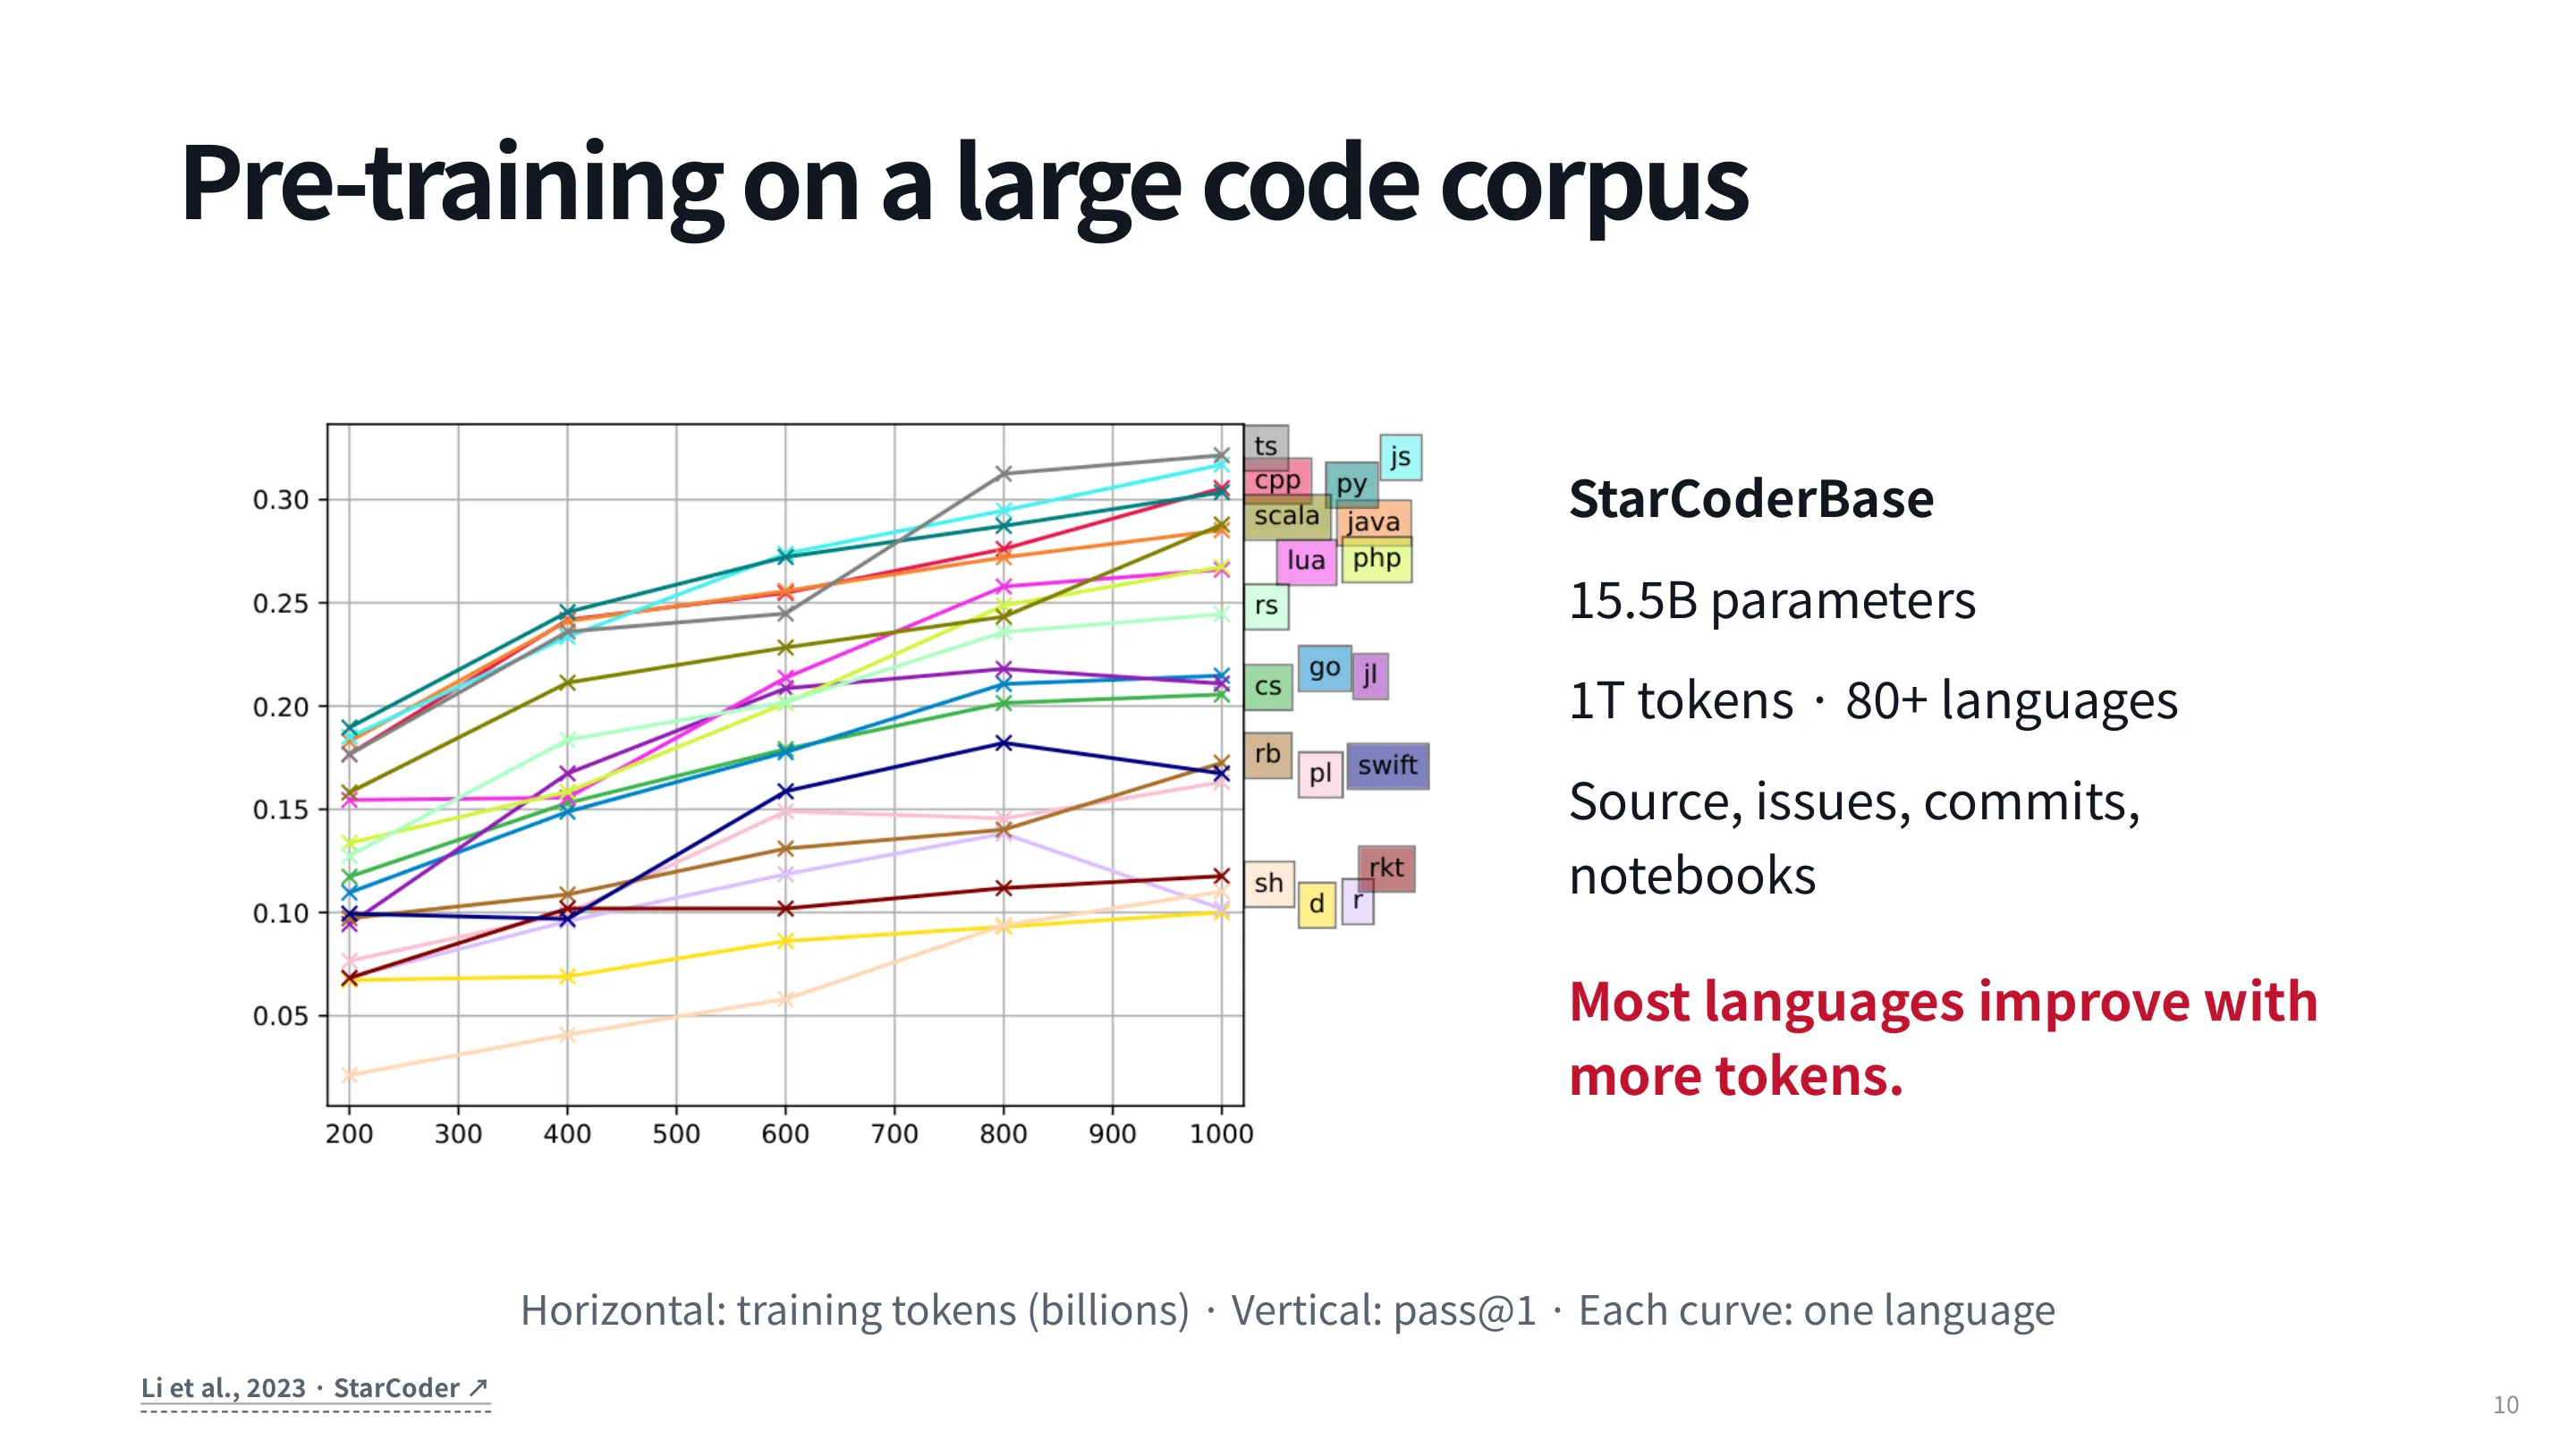
曲线说明两点:
- 对大多数语言,增加训练 token 仍能提升 pass@1;
- 不同语言的斜率不同,低资源语言的收益更慢,数据量和支持度会直接决定能力上限。
这也解释了一个常见现象:模型对 Python/JavaScript 很强,对冷门语言或特定领域 DSL 明显更弱。选语言不仅要看“用户想用什么”,还要看“训练数据够不够、工具链是否支持”。
2.5 中训练:把通用模型“调”成代码模型
中训练(mid-training / continual pre-training)是在预训练之后、SFT/RL 之前的一段继续训练。目标不是从零学代码,而是提高代码曝光、调整配比、扩展上下文(Slide 11)。
Code Llama 的做法是:从 Llama 2 出发,额外训练 500B tokens,并做 context extension。Qwen2.5-Coder 则给出了一个很有代表性的配比消融(Slide 12):
| Code / text / math | Common code | MATH | MMLU |
|---|---|---|---|
| 100 / 0 / 0 | 49.8 | 10.3 | 23.8 |
| 70 / 20 / 10 | 48.3 | 33.2 | 62.9 |
结论很清晰:纯代码继续训练会把通用能力打崩。保留 20% 文本、10% 数学,只让代码分数掉 1.5 分,却把 MATH 从 10.3 拉到 33.2、MMLU 从 23.8 拉到 62.9。对真实产品来说,这种权衡几乎总是值得的。
长上下文也是中训练的一部分(Slide 13):
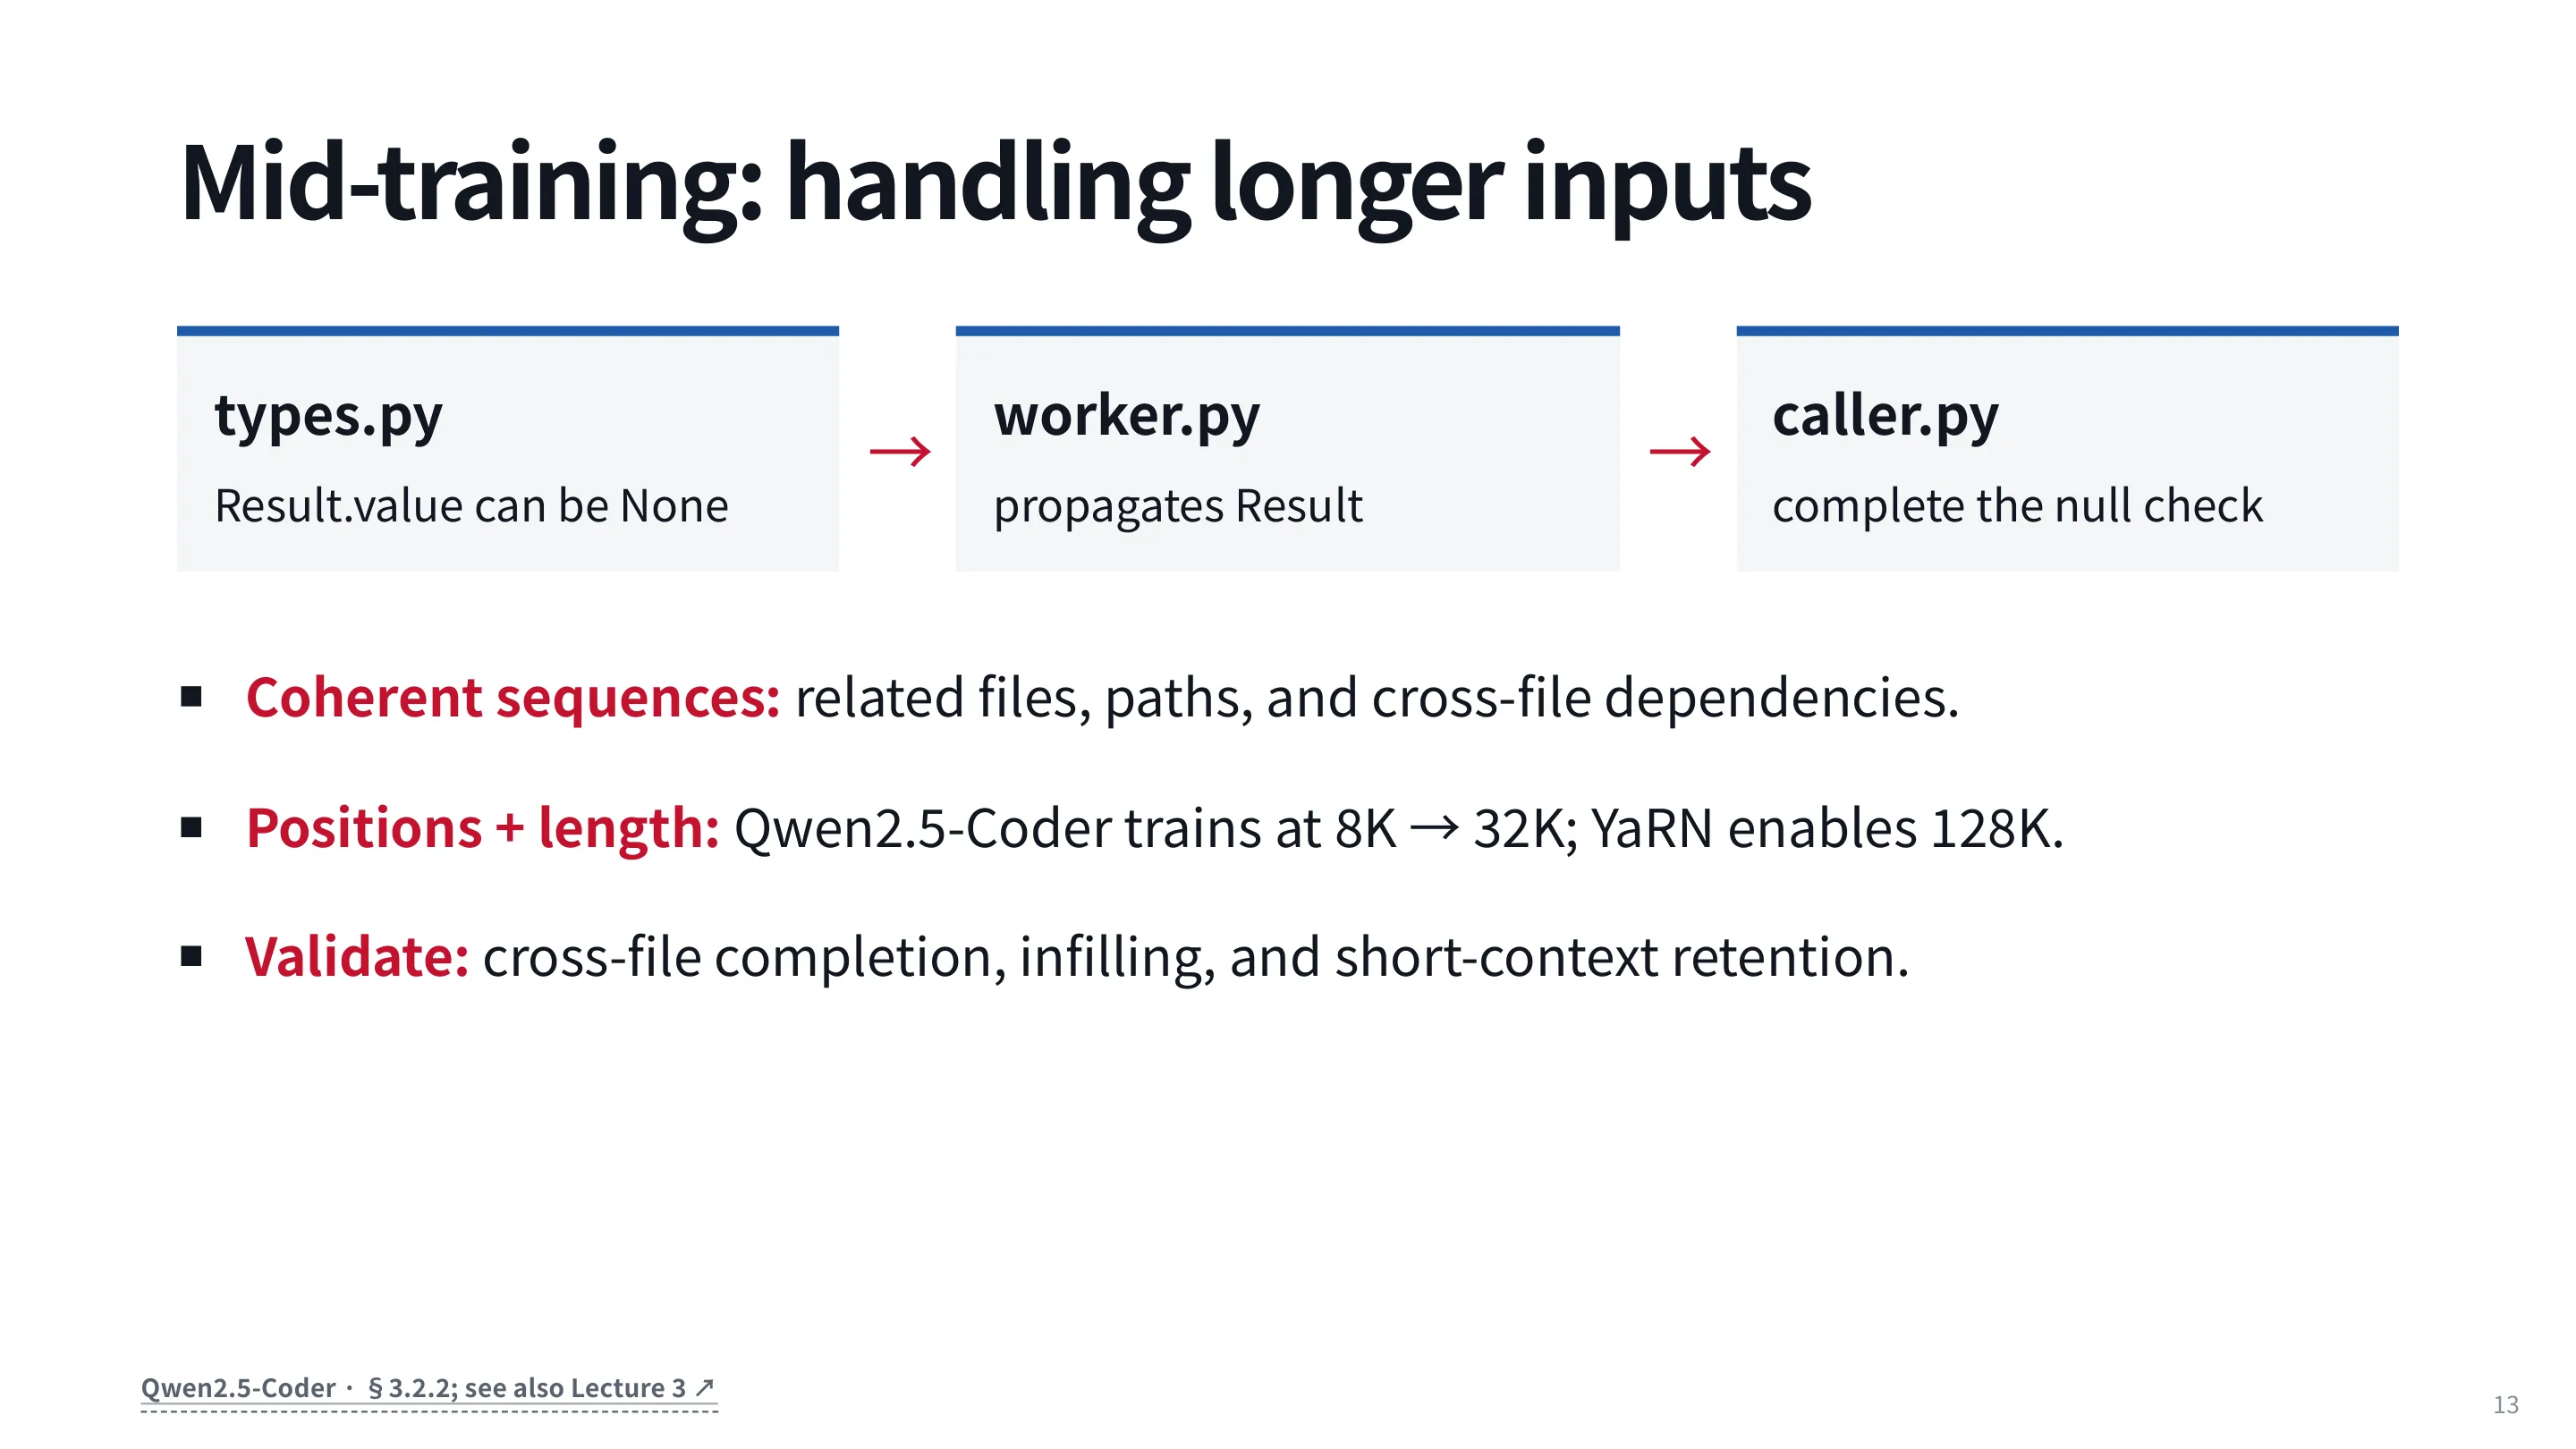
- 构造 coherent sequences:按目录、import 关系、dependency graph 把相关文件拼在一起,而不是随机拼接所有文件;
- 位置与长度:Qwen2.5-Coder 先训练 8K,再扩到 32K;YaRN 可继续扩到 128K;
- 验证:cross-file completion、infilling、short-context retention 都要测,避免“上下文变长但短上下文能力退化”。
长上下文的常见误区
把整个仓库塞进 context 并不等于“理解了仓库”。如果训练时没有见过跨文件的 coherent sequence,模型即使能看到 128K token,也不一定会利用远距离依赖。数据构造和位置编码同样重要。
3. Infilling:让模型利用右侧上下文
普通 causal LM 只能看左侧前缀。但代码编辑经常需要同时看左右两侧:给函数签名和函数体,推断返回类型;给变量使用处,推断声明;在文件中间插入代码(Slide 14)。
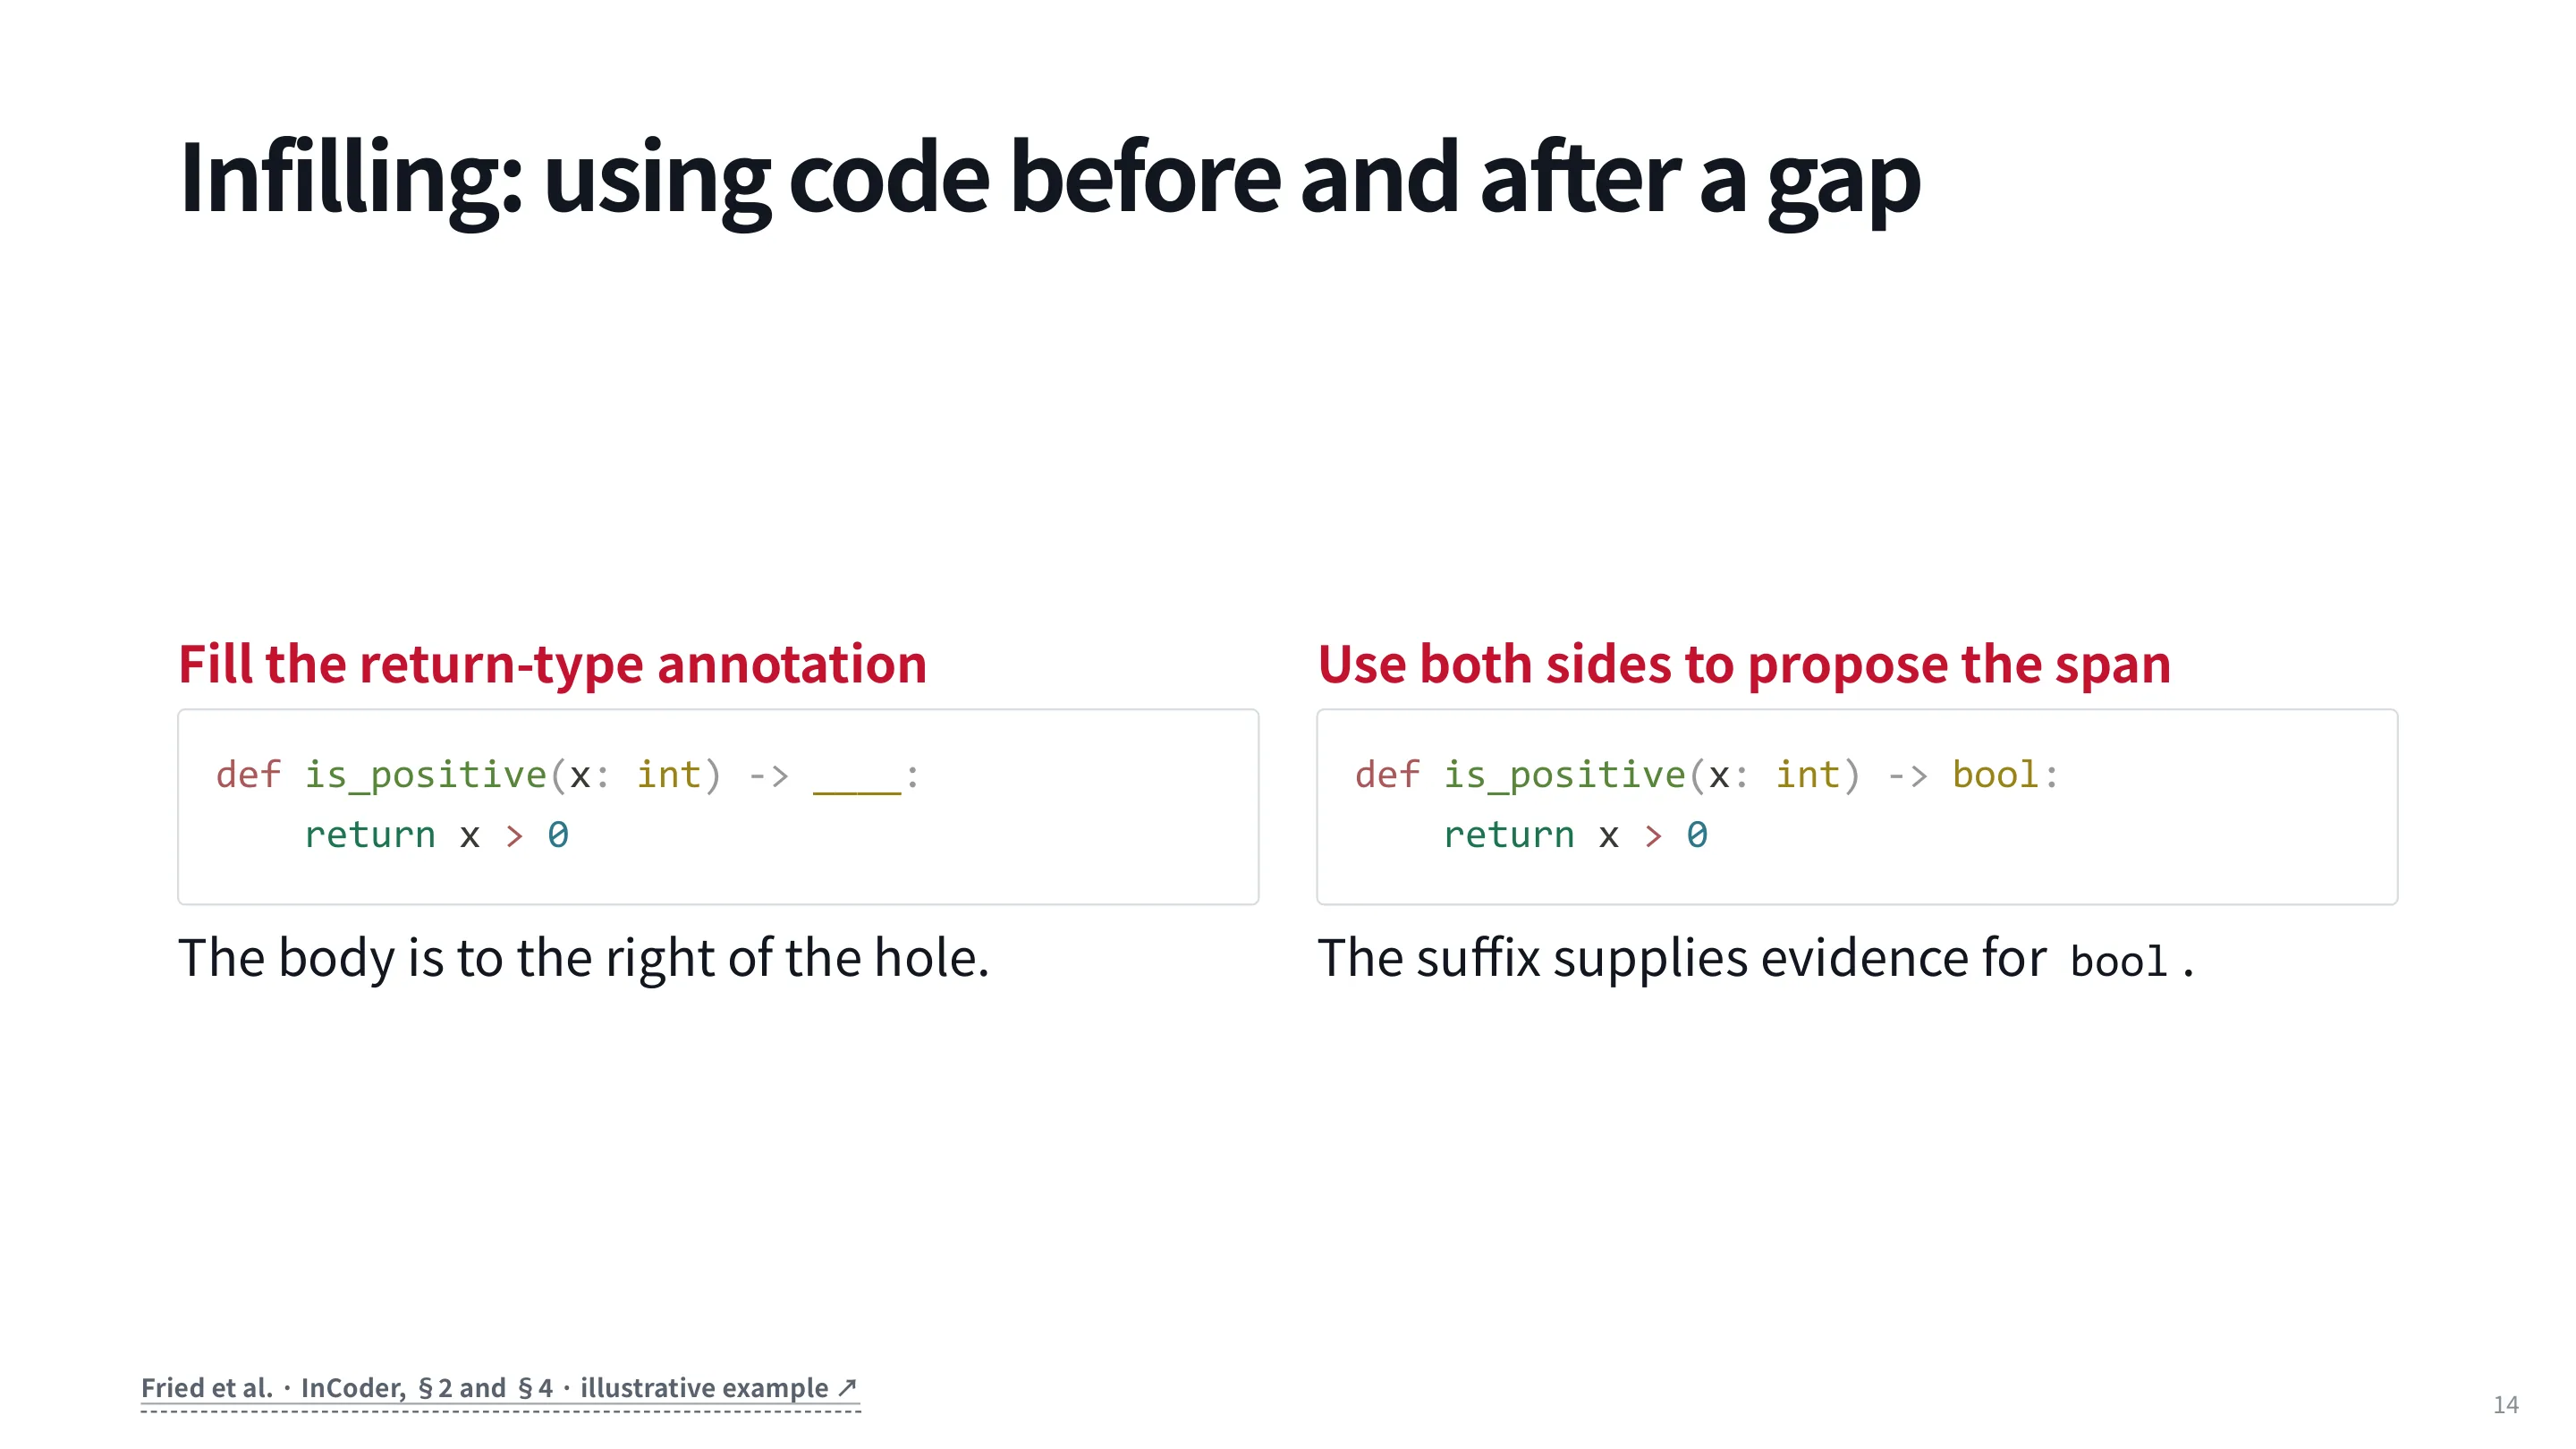
InCoder 的做法很巧妙:把 infilling 改写成 autoregressive 任务(Slide 15)。
原始:   prefix  span  suffix
训练:   prefix [M0] suffix [M0] span [END]
推理:   prefix [M0] suffix [M0] → 生成 span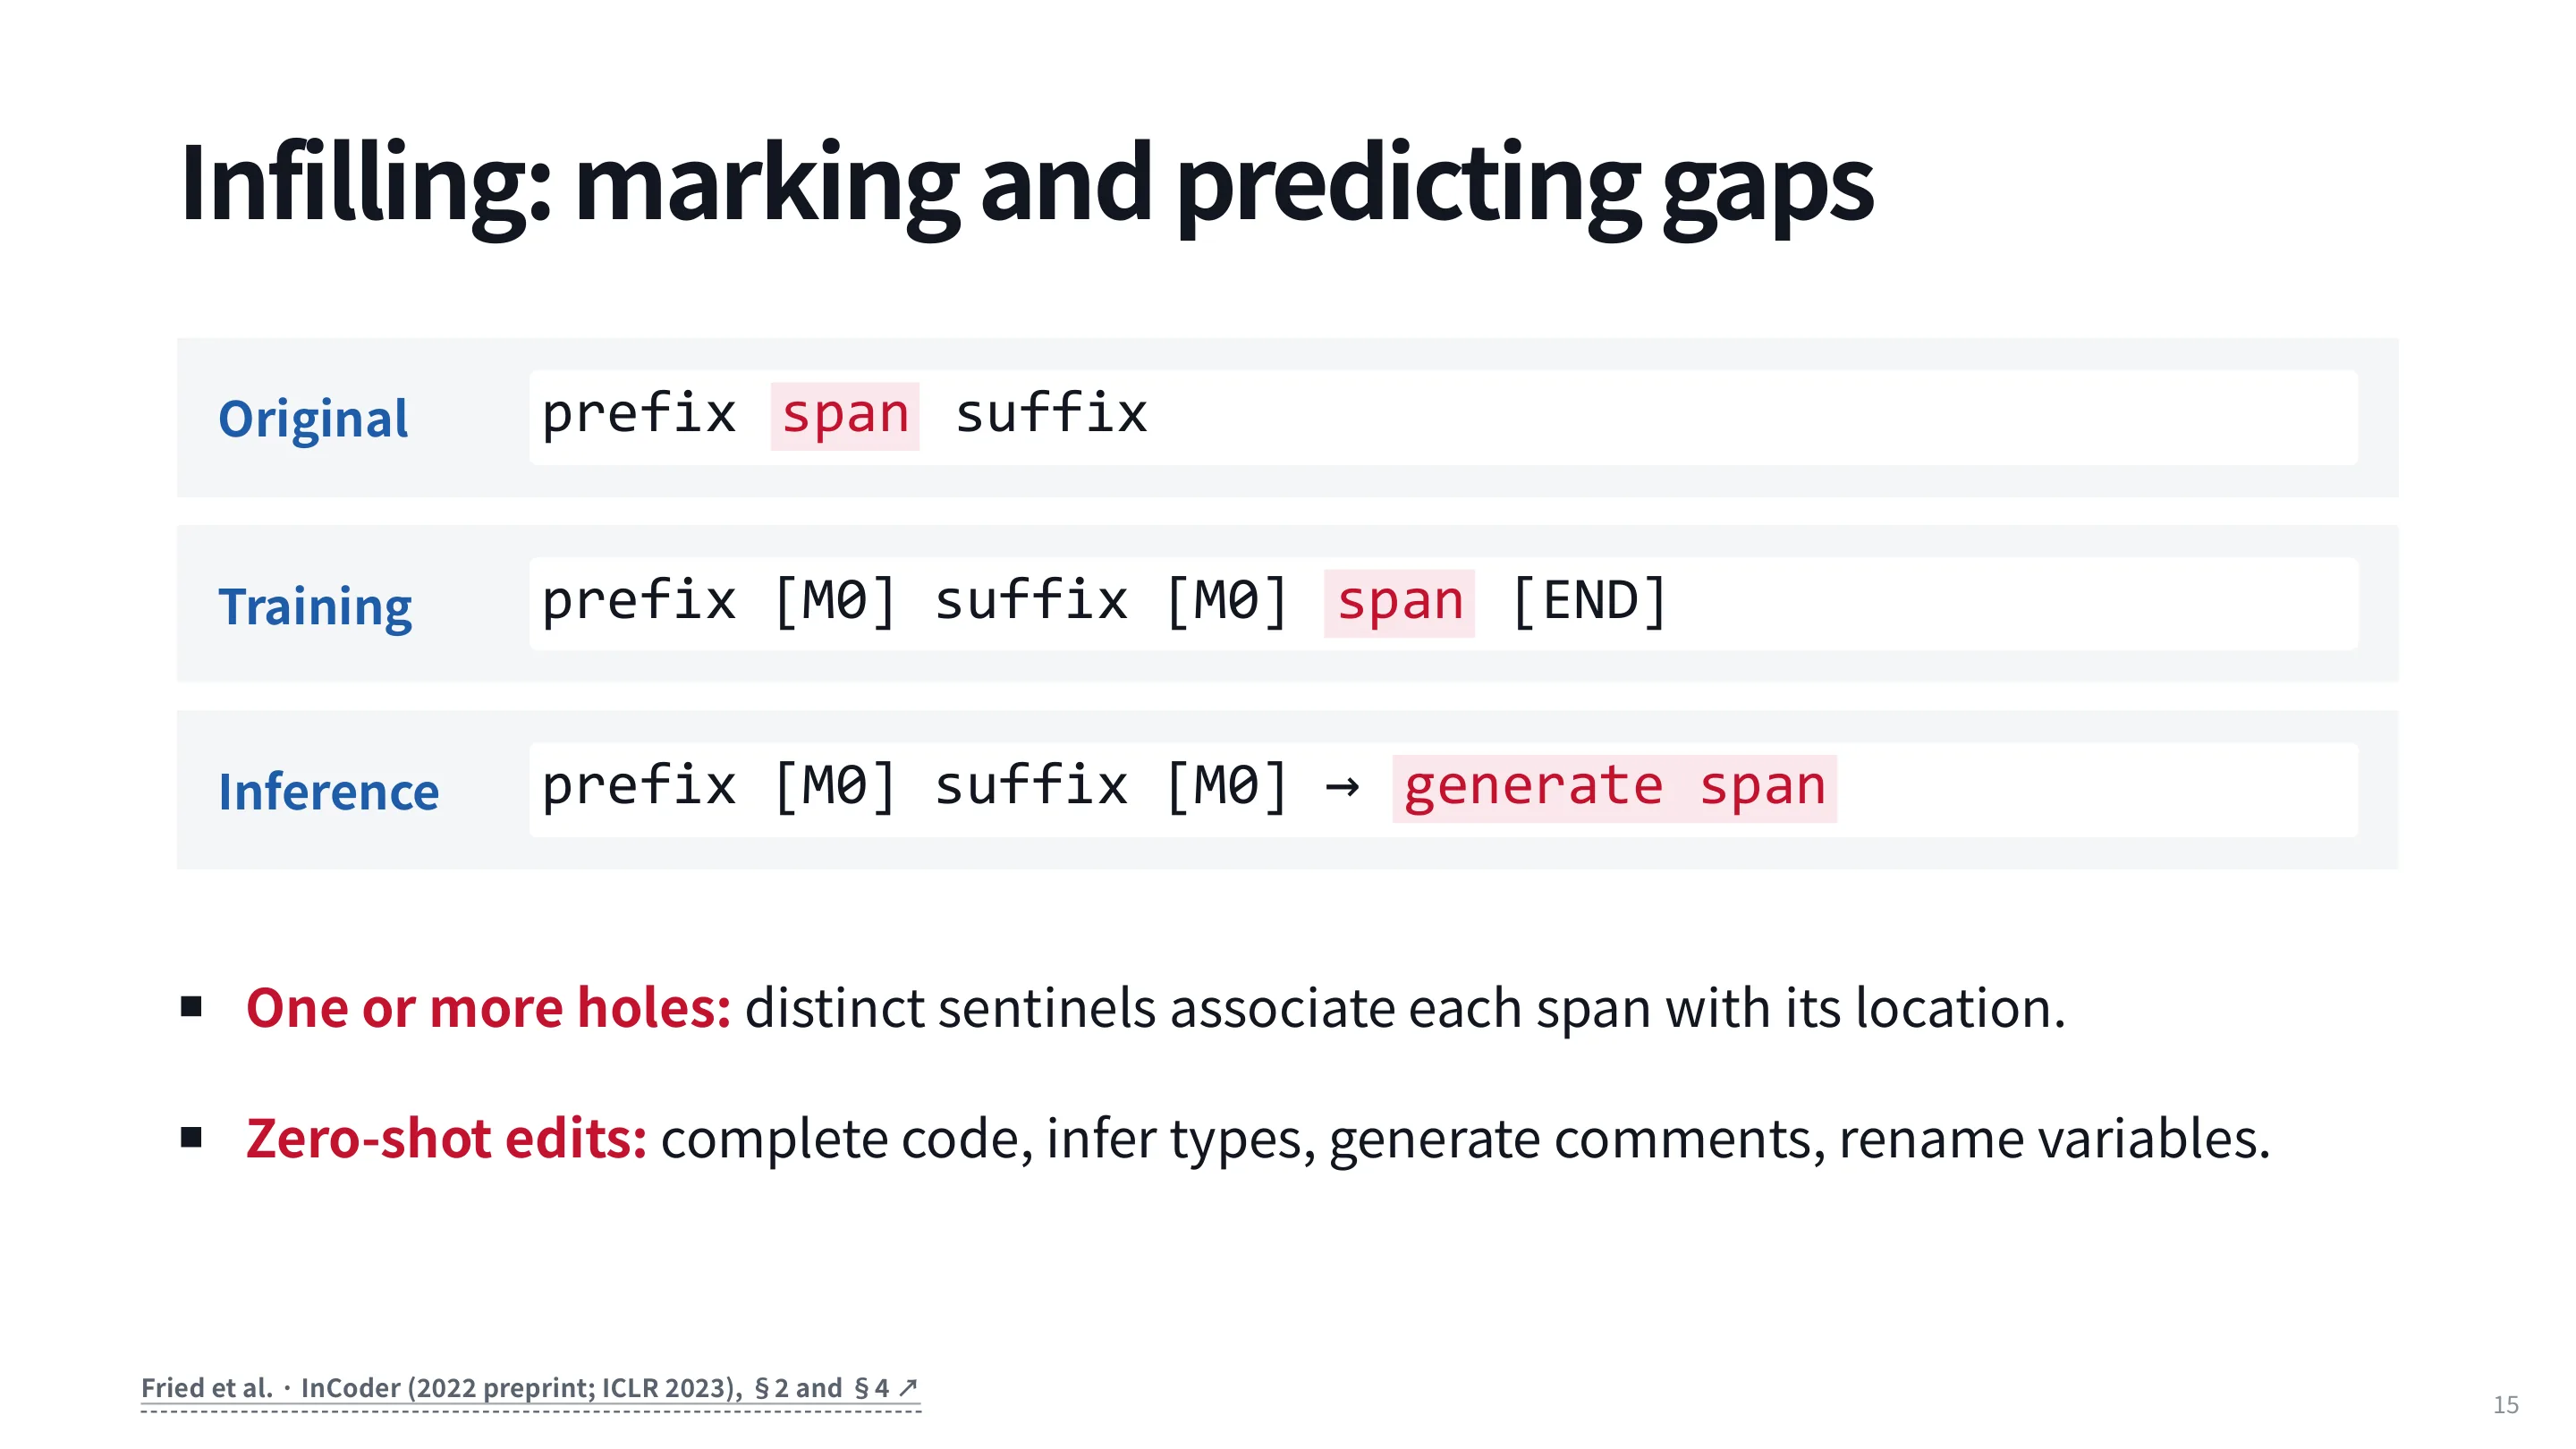
要点:
[M0]是 sentinel,告诉模型“这里有一个洞”;- 训练时把 span 移到 suffix 之后,模型学会根据左右上下文生成它;
- 推理时把
[M0]放在 prefix 和 suffix 之间,再让模型续写; - 多个洞可以用
[M0]、[M1]……分别关联位置; - 同一个目标可以零样本迁移到:补全代码、推断类型、生成注释、重命名变量。
效果如何?InCoder 在 HumanEval-derived infilling 任务上的结果(Slide 16):
| 推理方式 | 右侧上下文 | 单行 | 多行 |
|---|---|---|---|
| 从左到右,1 个候选 | 不用 | 48.2% | 24.9% |
| 从左到右,10 个候选 + 重排 | 只用于重排 | 54.9% | 28.2% |
| Causal-masked infilling | 用于生成 | 69.0% | 38.6% |
更关键的是,学 infilling 不会牺牲普通补全能力(Slide 17):
| 训练目标 | HumanEval | MBPP |
|---|---|---|
| 从左到右 LM | 6.0% | 8.9% |
| Causal masking | 8.0% | 10.9% |
除了 infilling,代码还能提供很多“自带监督”的信号(Slide 18):
- Commit diffs:before + message → after/diff,学习编辑;
- Diagnostics:broken code + error → repair,学习修错;
- Tests:program + test outcomes → reward,学习满足行为;
- Execution traces:program → executed lines/states,学习程序语义。
4. 代码生成怎么评
4.1 参考解匹配:看起来像,不等于行为对
最直接的方法是把生成代码与参考解比较:exact match 或 BLEU-4(token n-gram overlap + brevity penalty)。问题是文本相似度与行为正确性并不一致(Slide 20):
# 参考
return x > 0

# 只改一个字符,行为不同
return x >= 0

# 写法完全不同,但对整数等价
return not (x <= 0)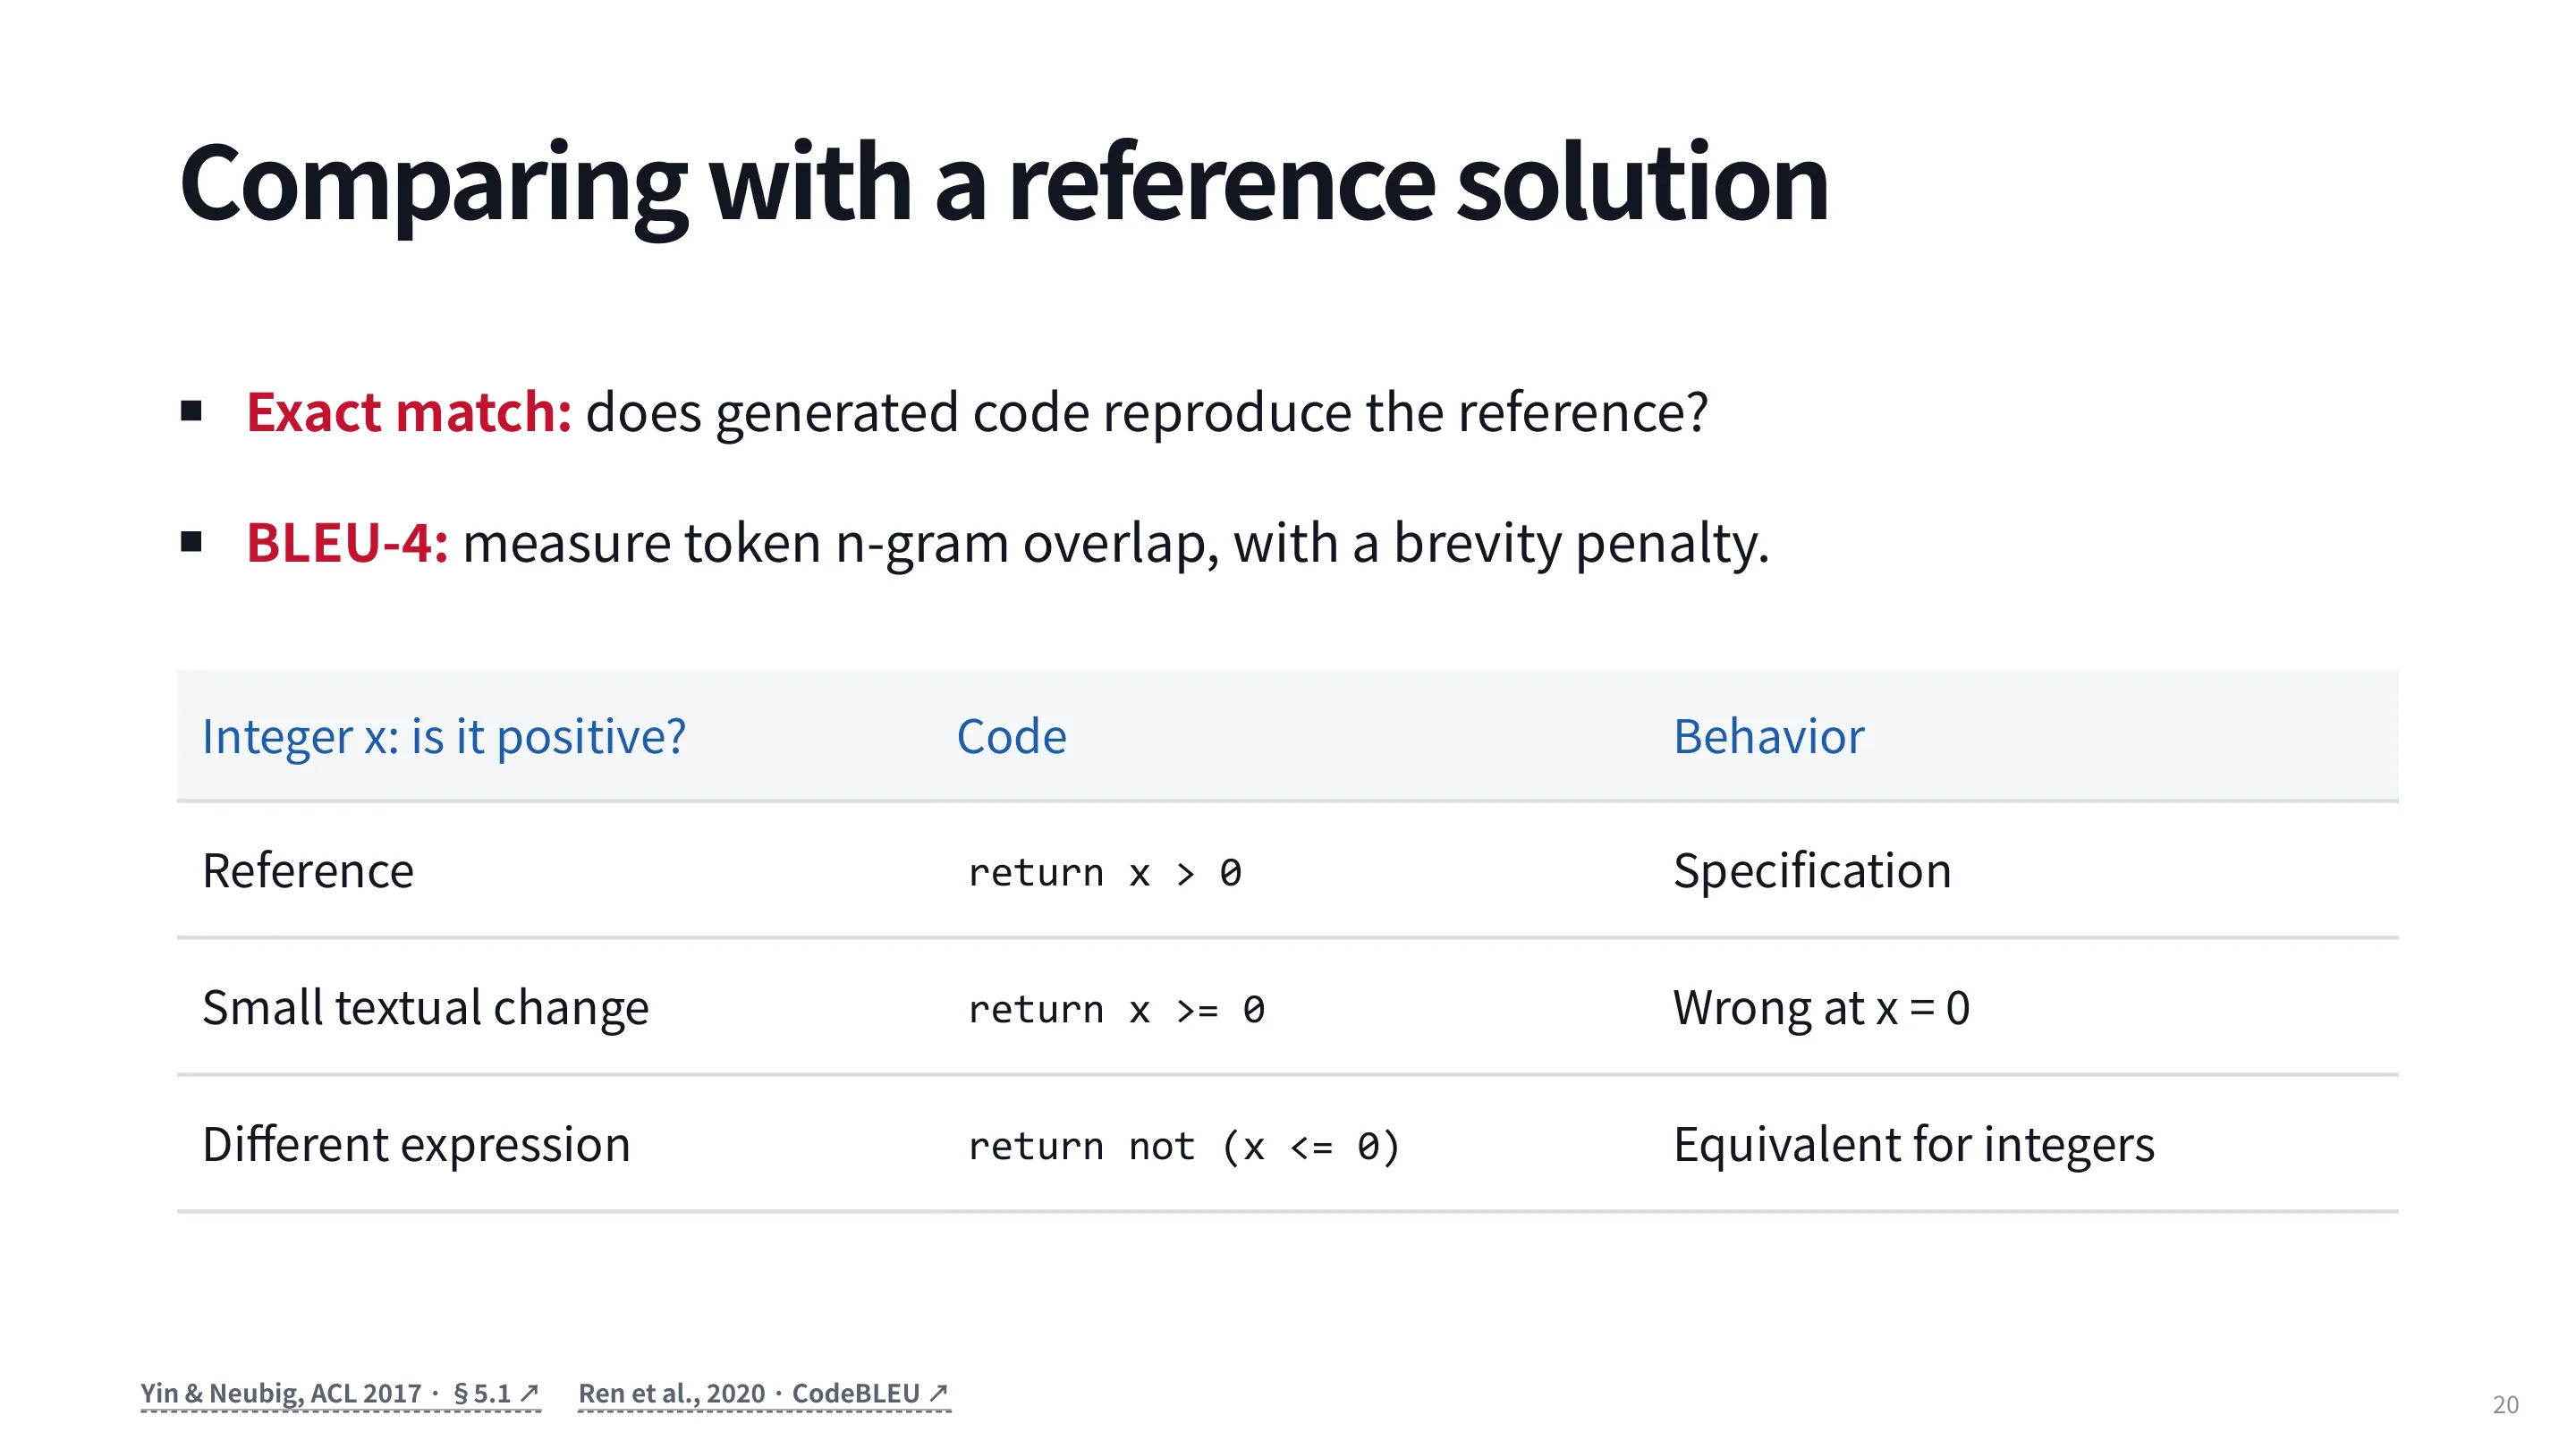
这类指标适合快速回归或风格比较,但不能作为“代码是否正确”的主要依据。
4.2 结构与表示:CodeBLEU 与 CodeBERTScore
CodeBLEU 在 n-gram 之外加入两类结构信息(Slide 21):
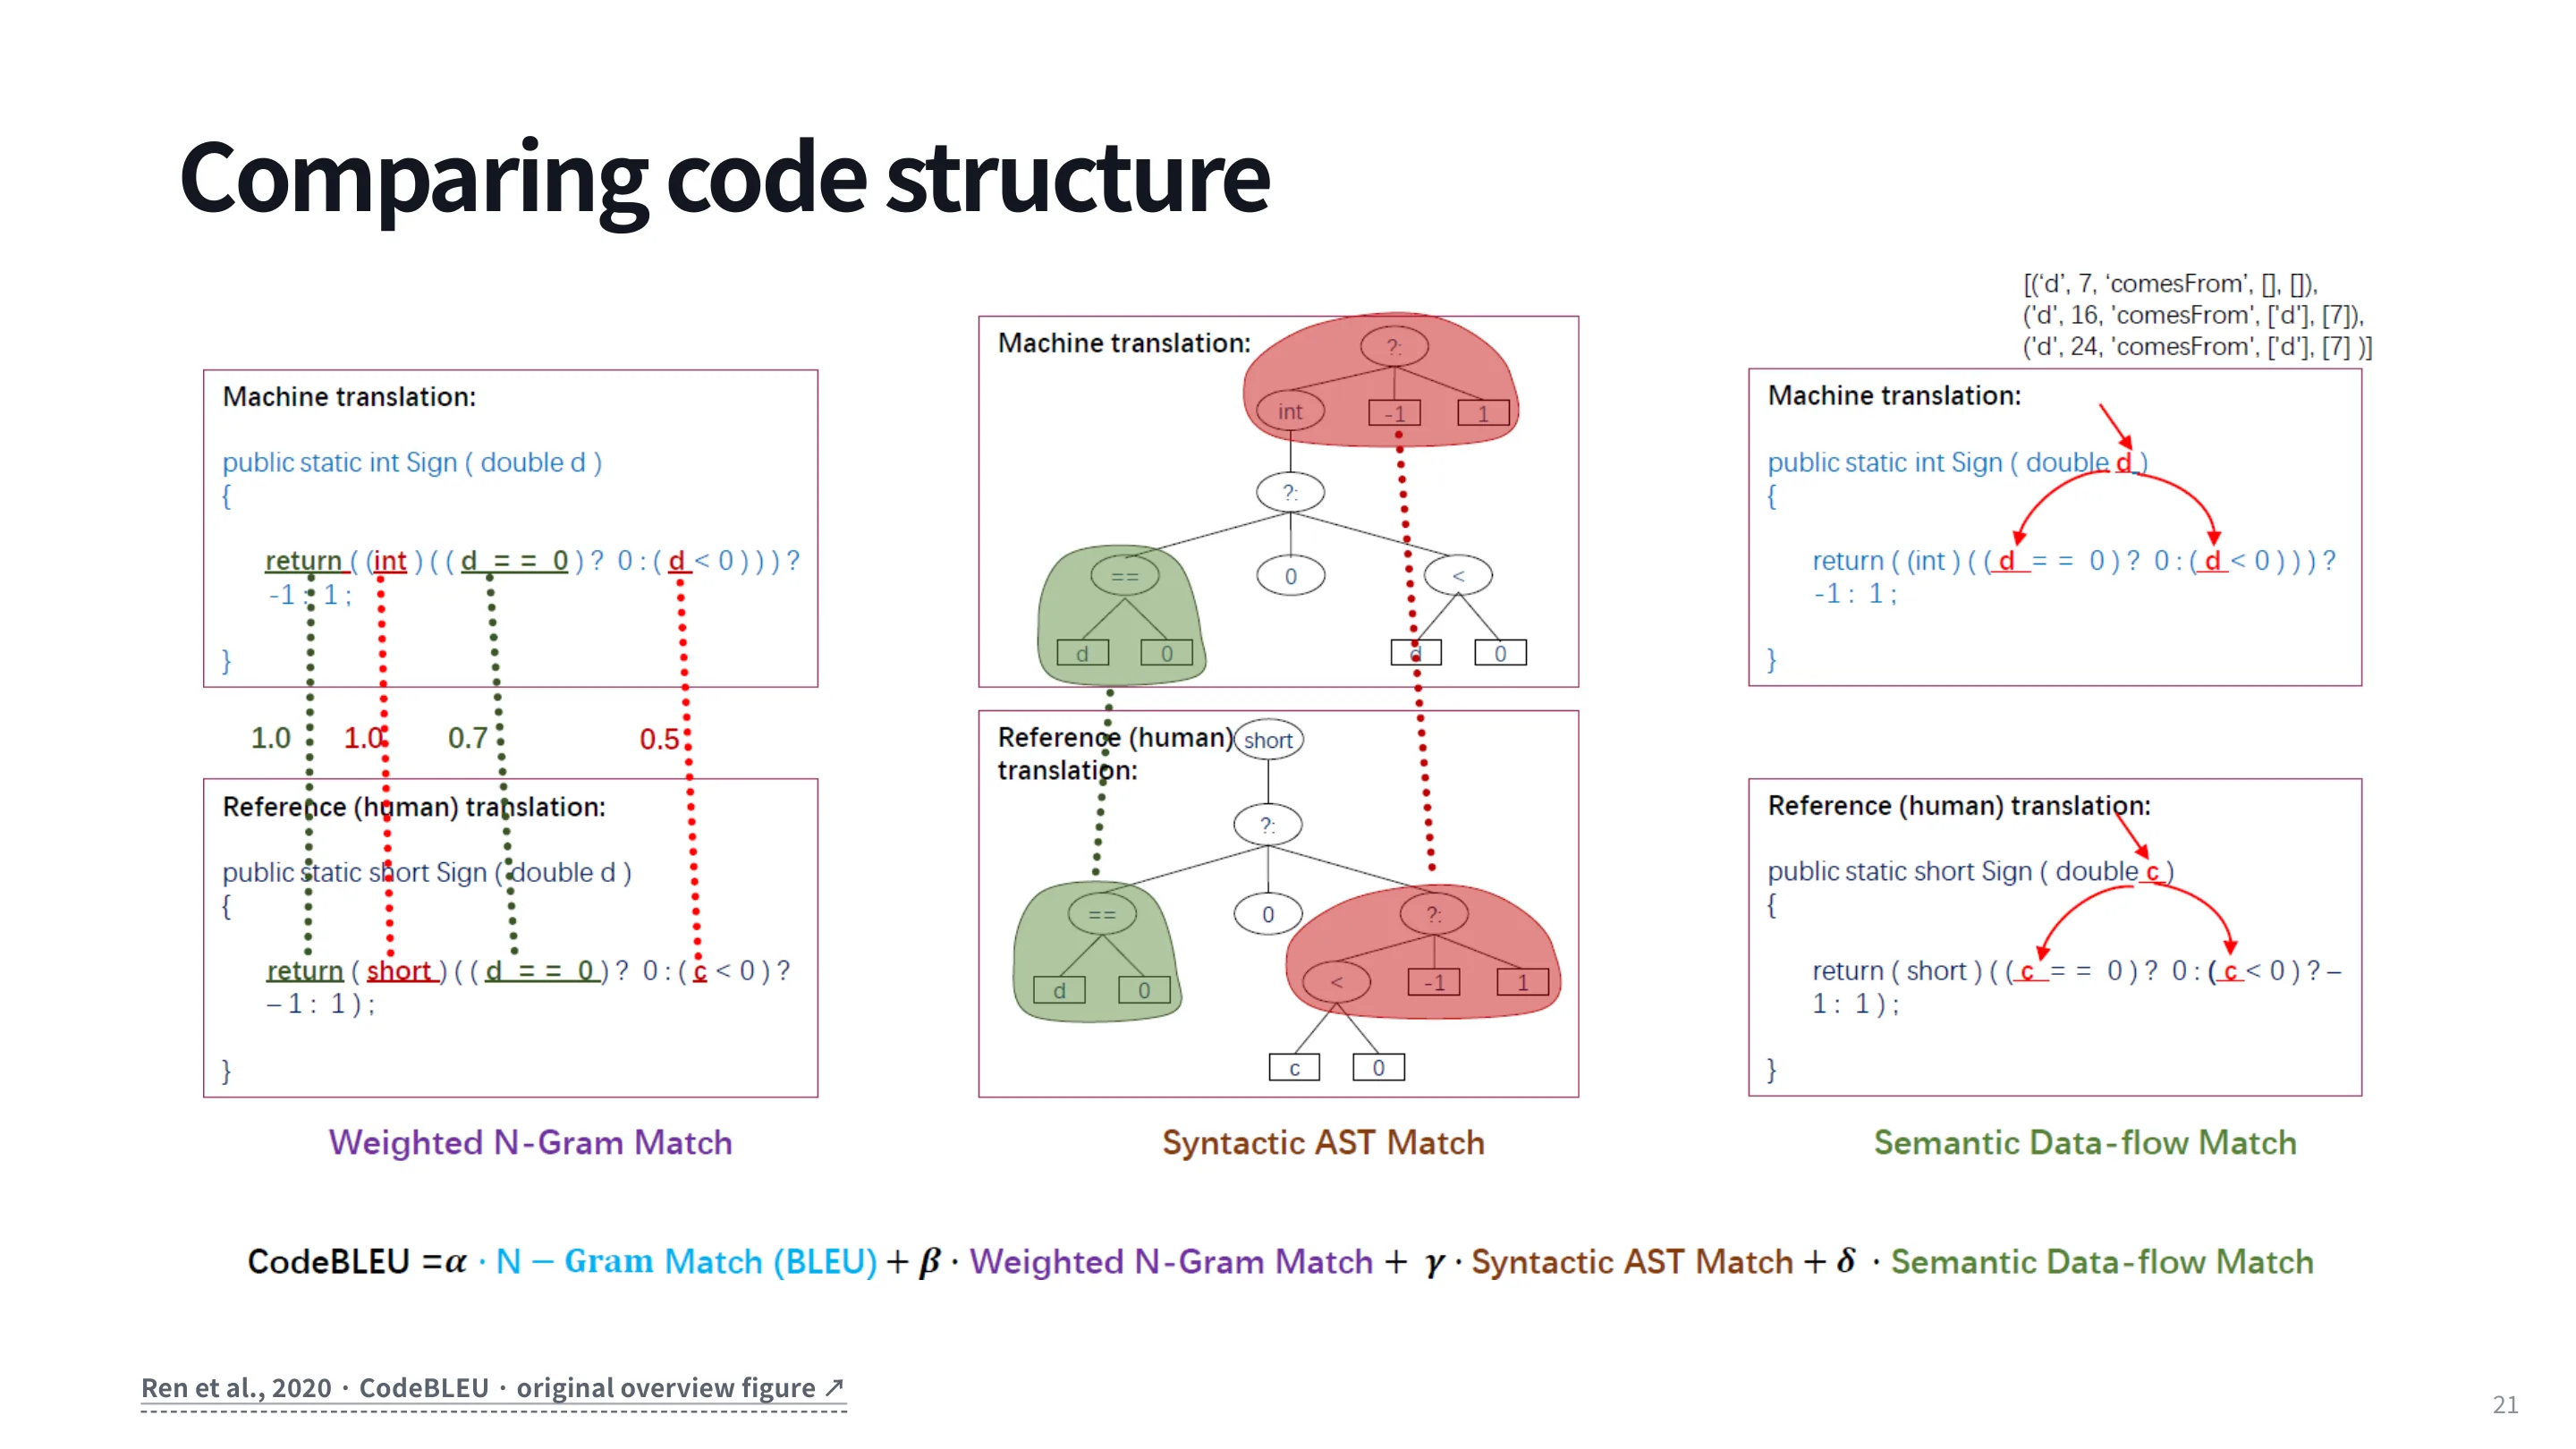
- AST Match:把代码解析成抽象语法树,比较树结构;
- Data-flow Match:比较变量/值在程序中的来源与流向;
- 好处是能识别“换了变量名但结构相同”的代码;
- 局限是仍然依赖参考解,且对语义等价但结构不同的实现不友好。
CodeBERTScore 则用预训练代码模型编码 prompt 和候选代码,再比较 contextual token vectors 的最佳匹配,计算 precision/recall/F-score(Slide 22)。
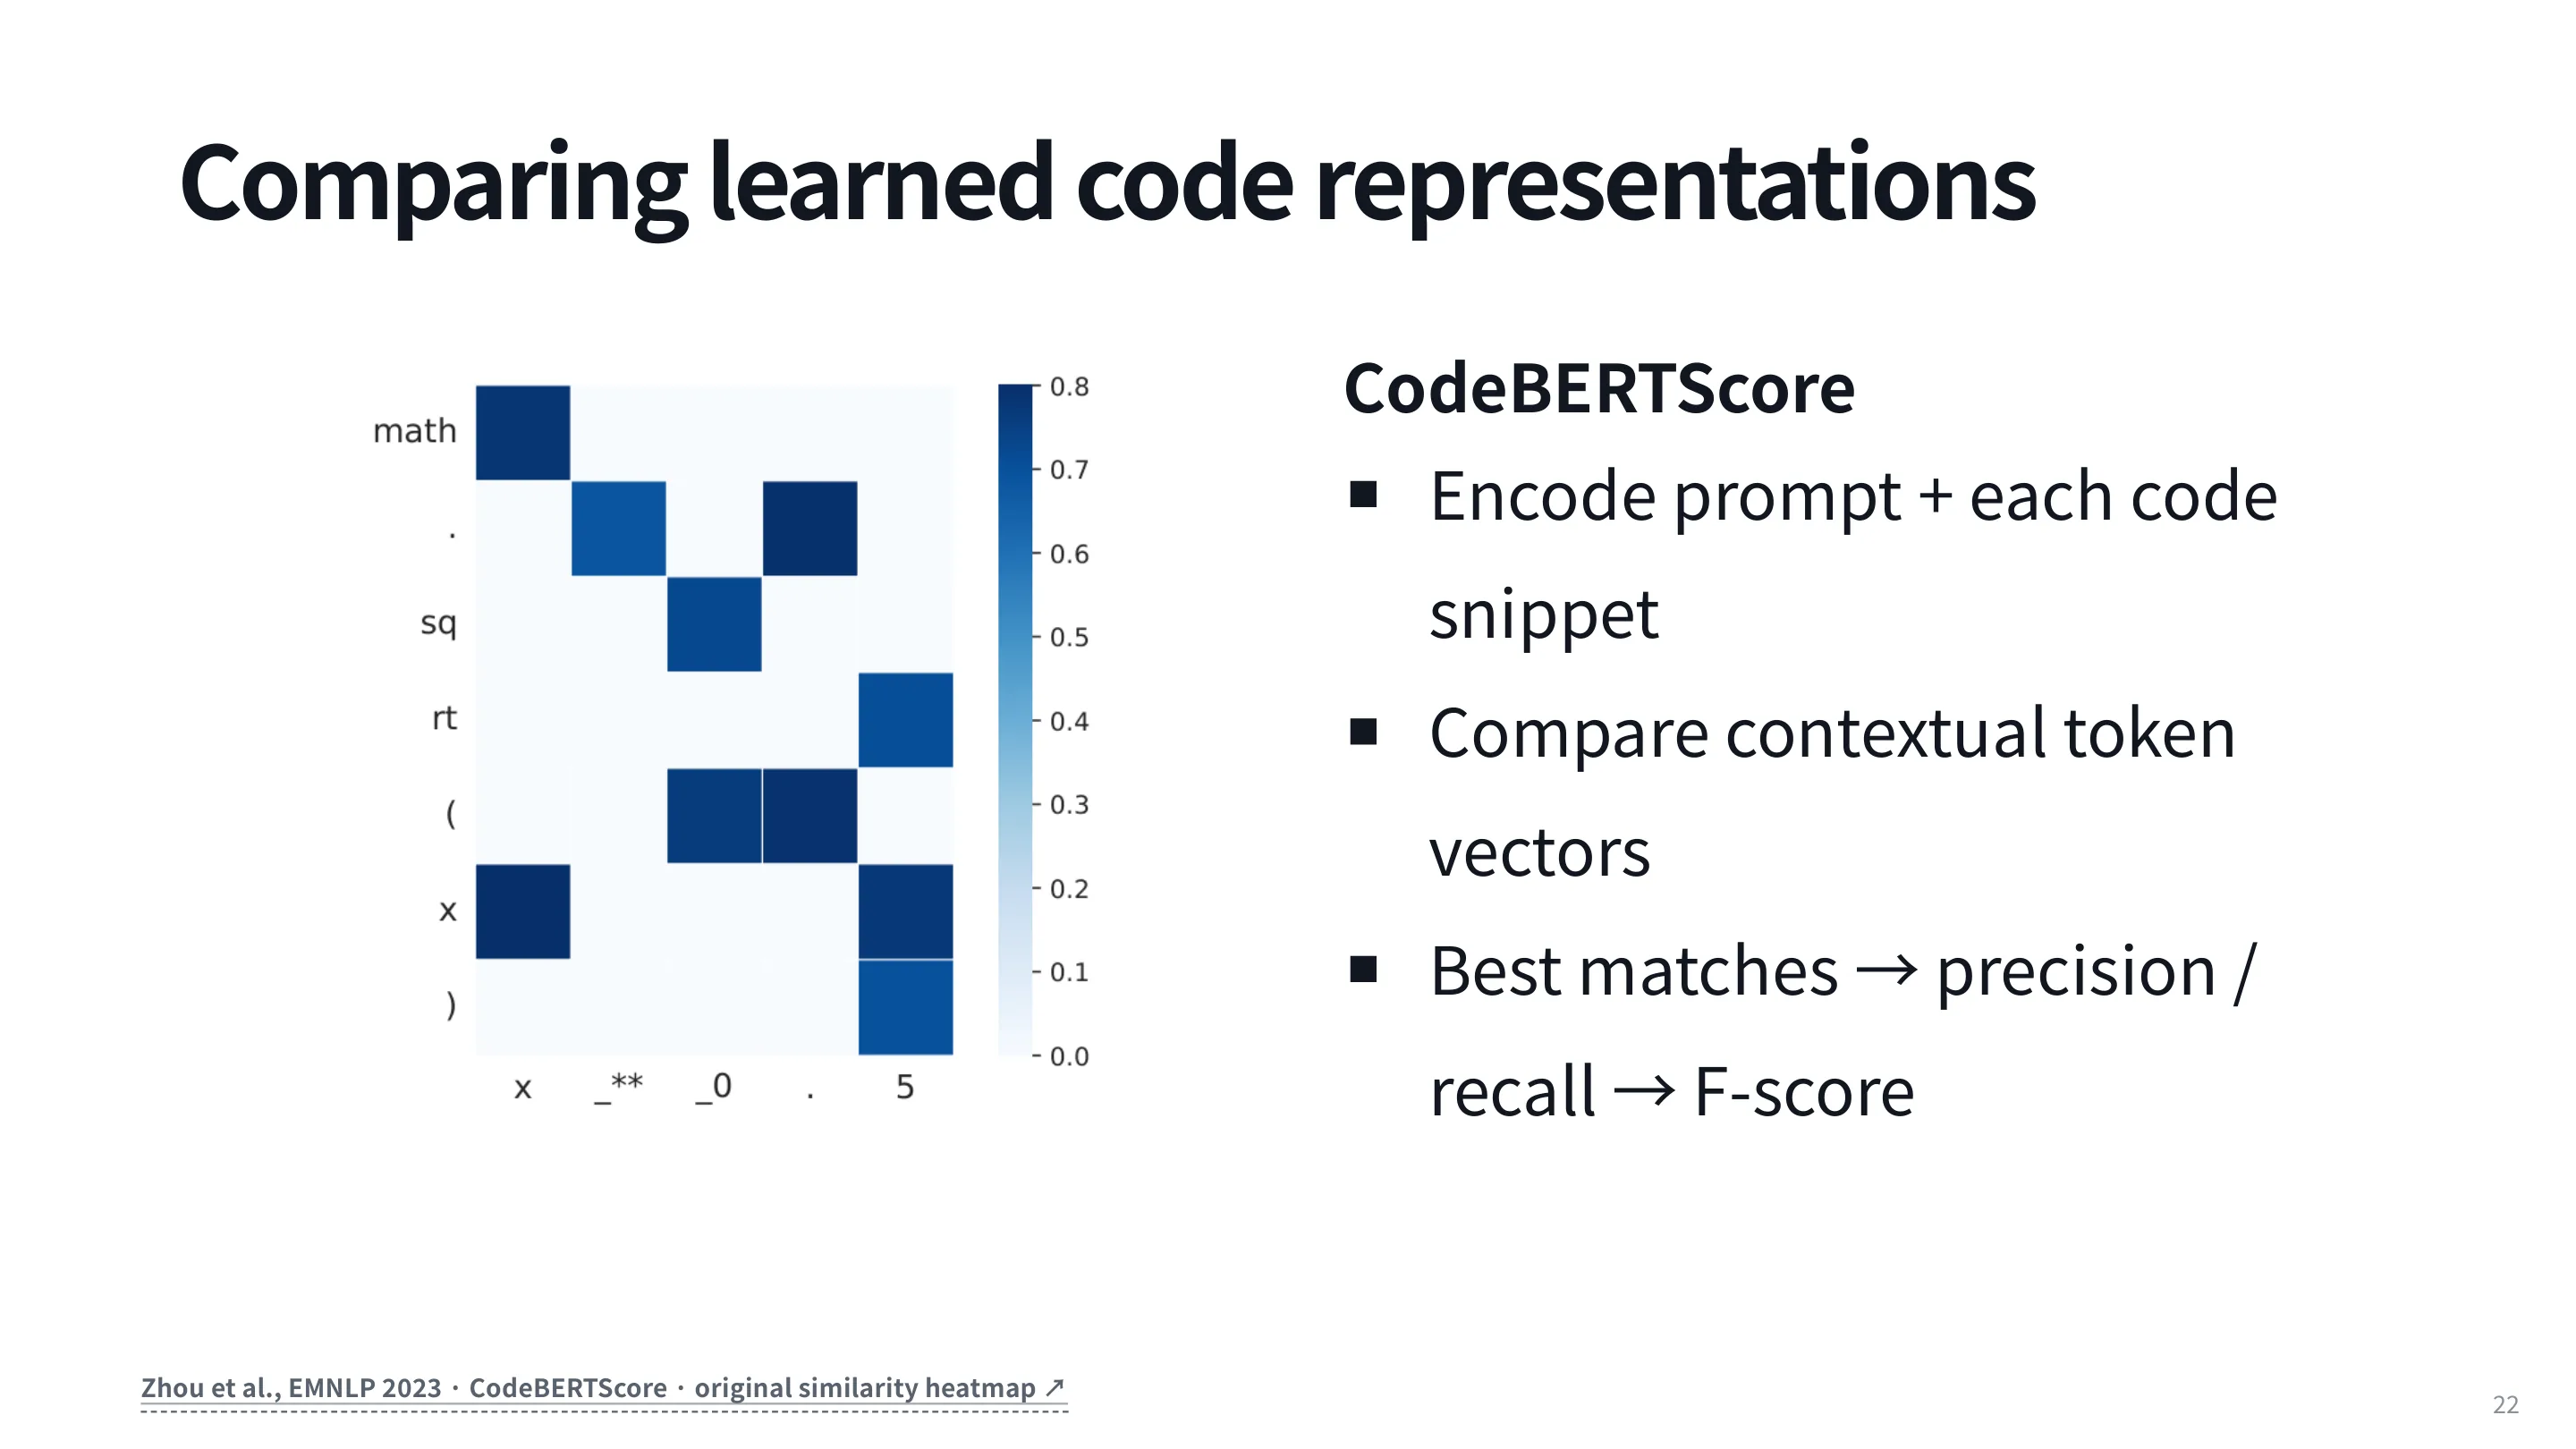
它比 BLEU 更能捕捉语义相似性,但仍然是“与参考解相似”的代理指标,不能替代执行。
4.3 执行评测:主流,但测试质量是瓶颈
执行评测的流程很直接(Slide 23):给候选代码一组输入和期望输出,在隔离环境中运行,比较实际输出。
def is_positive(x):
return x >= 0| 输入 | 实际 | 期望 |
|---|---|---|
| -1 | False | False |
| 0 | True | False |
| 1 | True | True |
零被误判为正数,测试失败。
执行评测的优缺点(Slide 24):
| 优点 | 局限 |
|---|---|
| 接受不同的正确实现 | 有限测试可能漏掉错误行为 |
| 能发现语义错误 | 需要可信测试、依赖和隔离环境 |
| 与实际行为直接对齐 | 运行耗时,环境需要稳定 |
讲师把测试质量称为当前训练 coding agent 的最大问题之一:
- 假阳性:测试太弱,错误实现也能通过;
- 假阴性:题目描述不完整,正确实现也过不了隐藏测试;
- 依赖漂移:库版本升级导致老测试失败,新模型被误判为更差;
- 运行成本:大仓库跑完整测试可能要几分钟到几十分钟。
这也是为什么 SWE-bench 只选一部分相关测试(fail-to-pass + pass-to-pass),而不是跑全量测试。
4.4 Benchmark 与 pass@k
单步代码生成的两个代表 benchmark(Slide 25):
- HumanEval:164 个 Python 函数,给 docstring 生成函数体,隐藏单元测试;
- CodeContests:竞赛题,给完整题目描述生成完整程序,编译 + 测试,包含 Codeforces 风格问题。
多次采样时用 pass@k:采样 k 个程序,至少一个通过全部测试的概率。常用无偏估计:
其中 n 是采样数,c 是通过测试的数量。k 越大,指标越宽松;比较不同模型时必须固定 k 和采样预算。
4.5 非功能需求与 RL
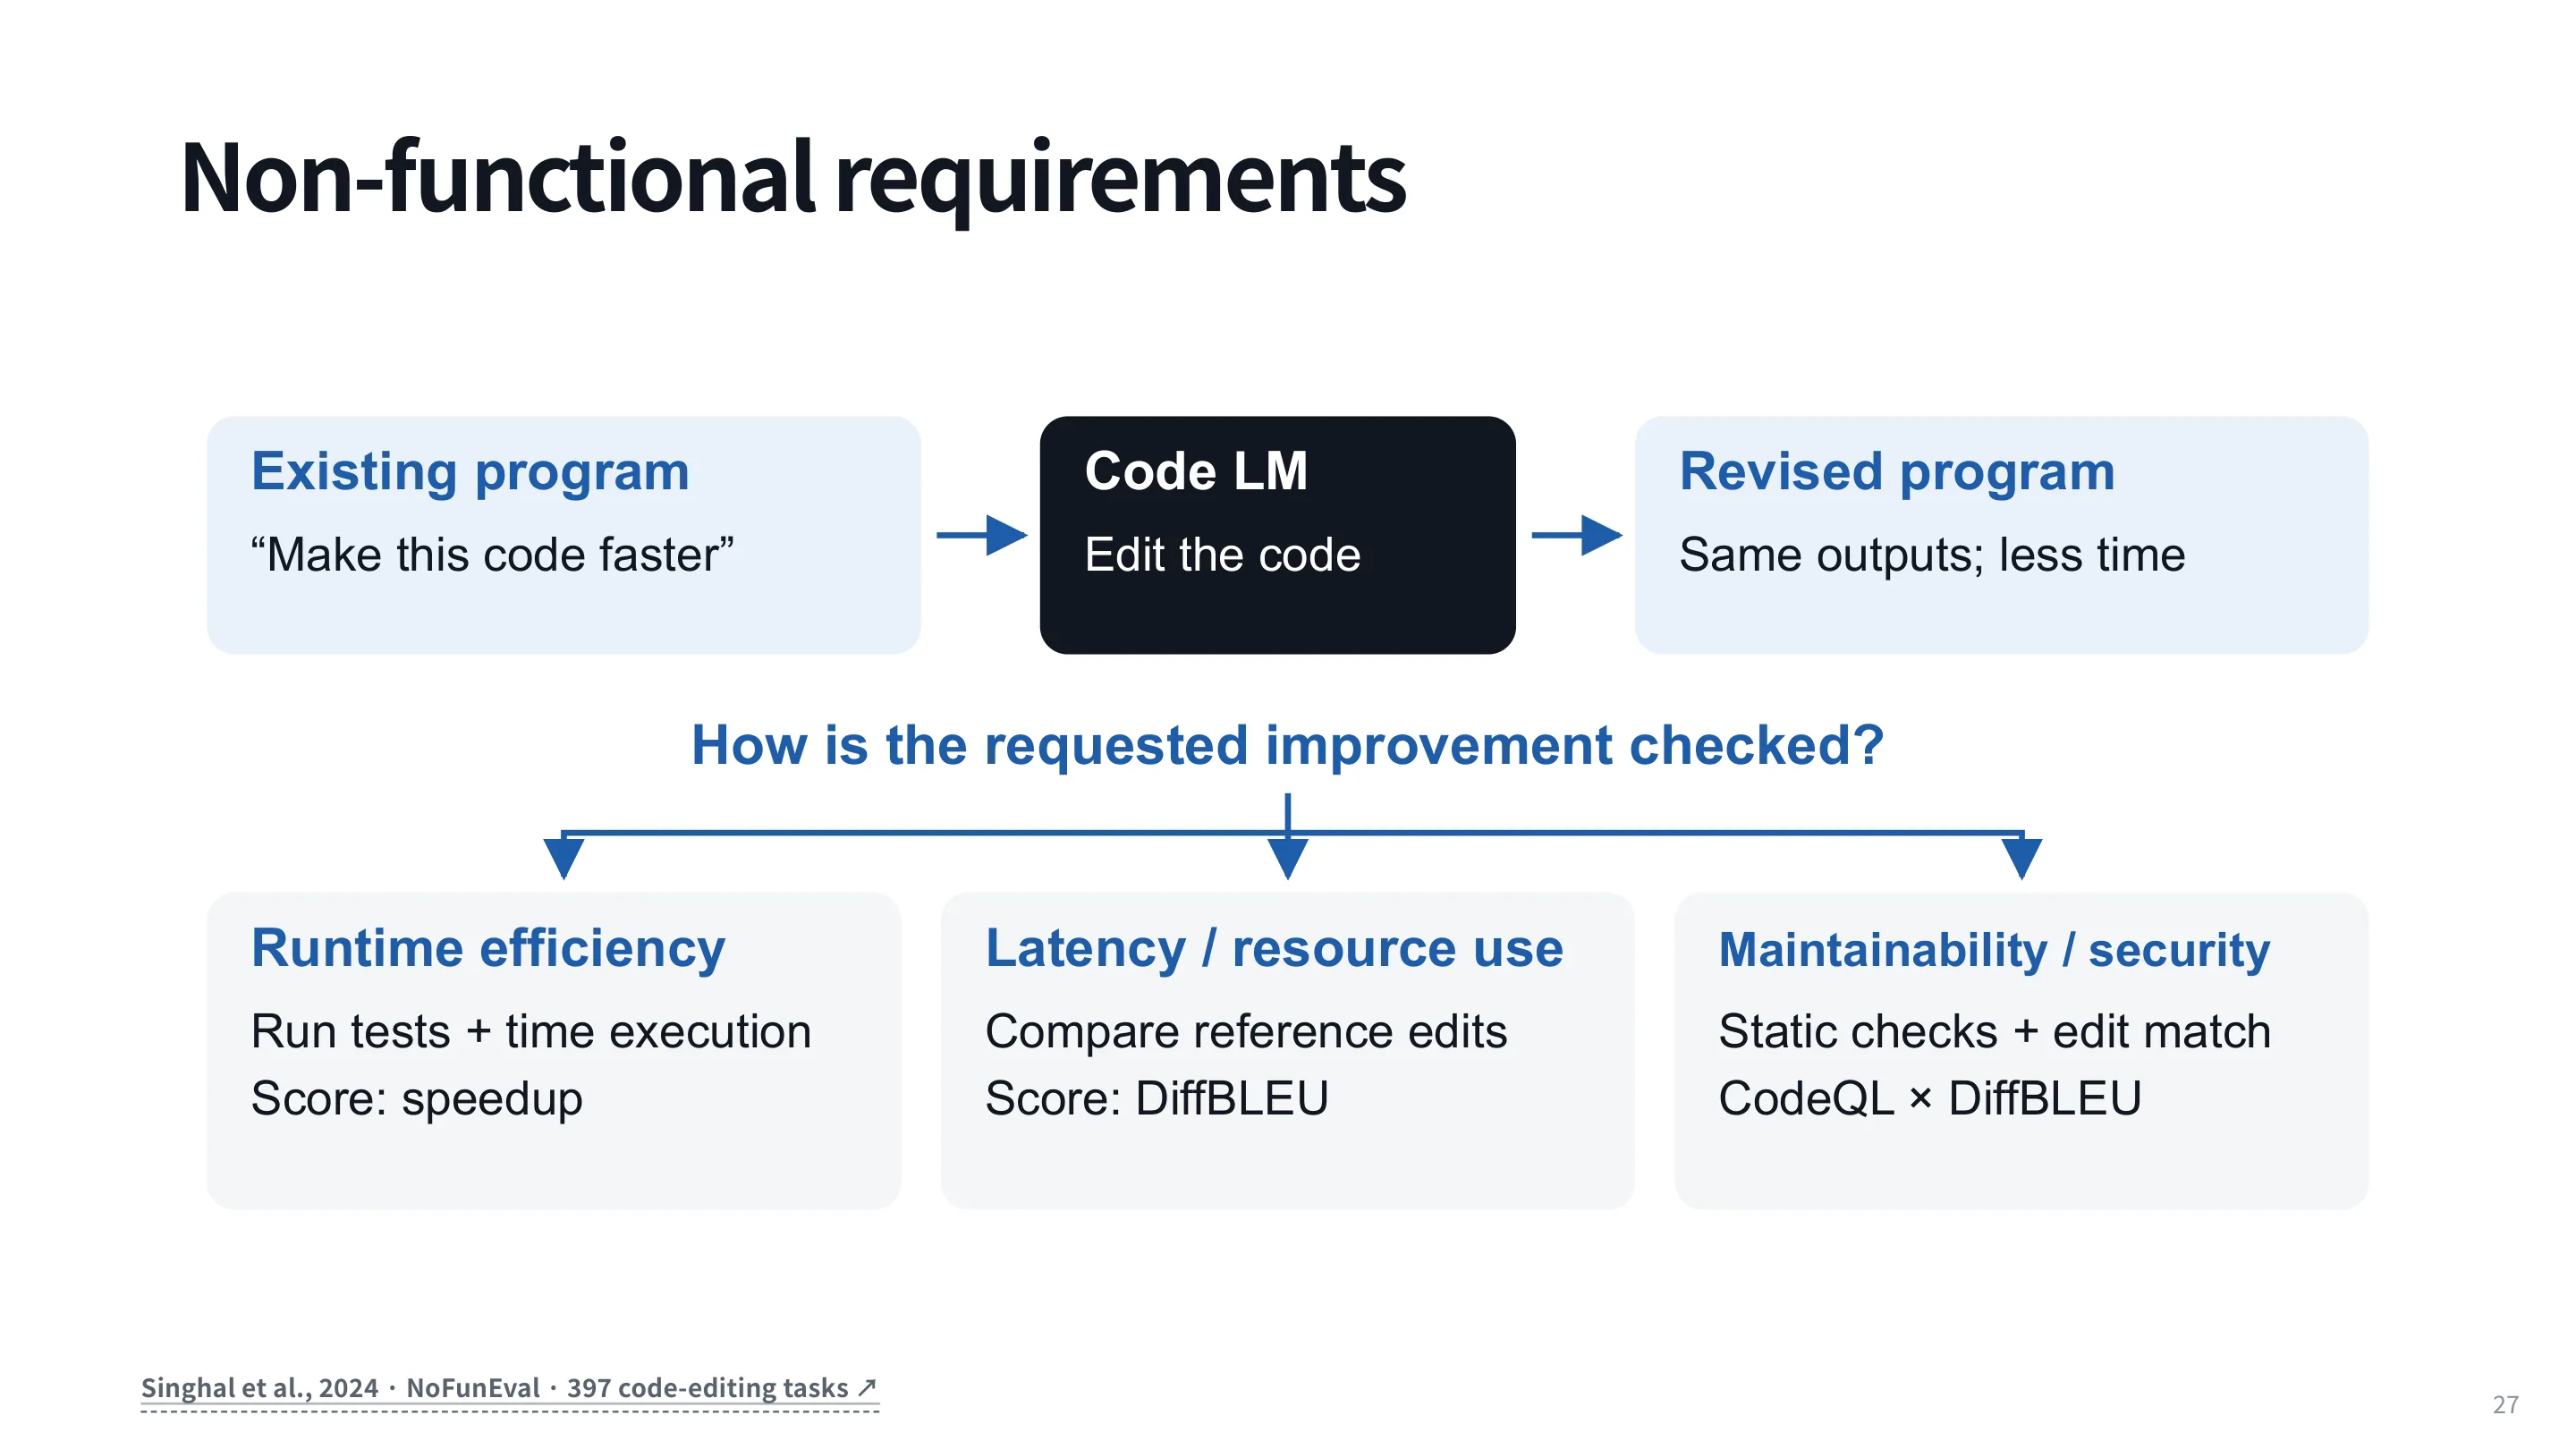
代码不只是“输出对不对”,还要看性能、延迟、资源、可维护性、安全性(Slide 27)。NoFunEval 用 397 个 code-editing 任务评估这些维度:
- Runtime efficiency:跑测试 + 计时,算 speedup;
- Latency / resource use:与参考编辑比较,用 DiffBLEU 等指标;
- Maintainability / security:静态检查(如 CodeQL)+ 编辑匹配。
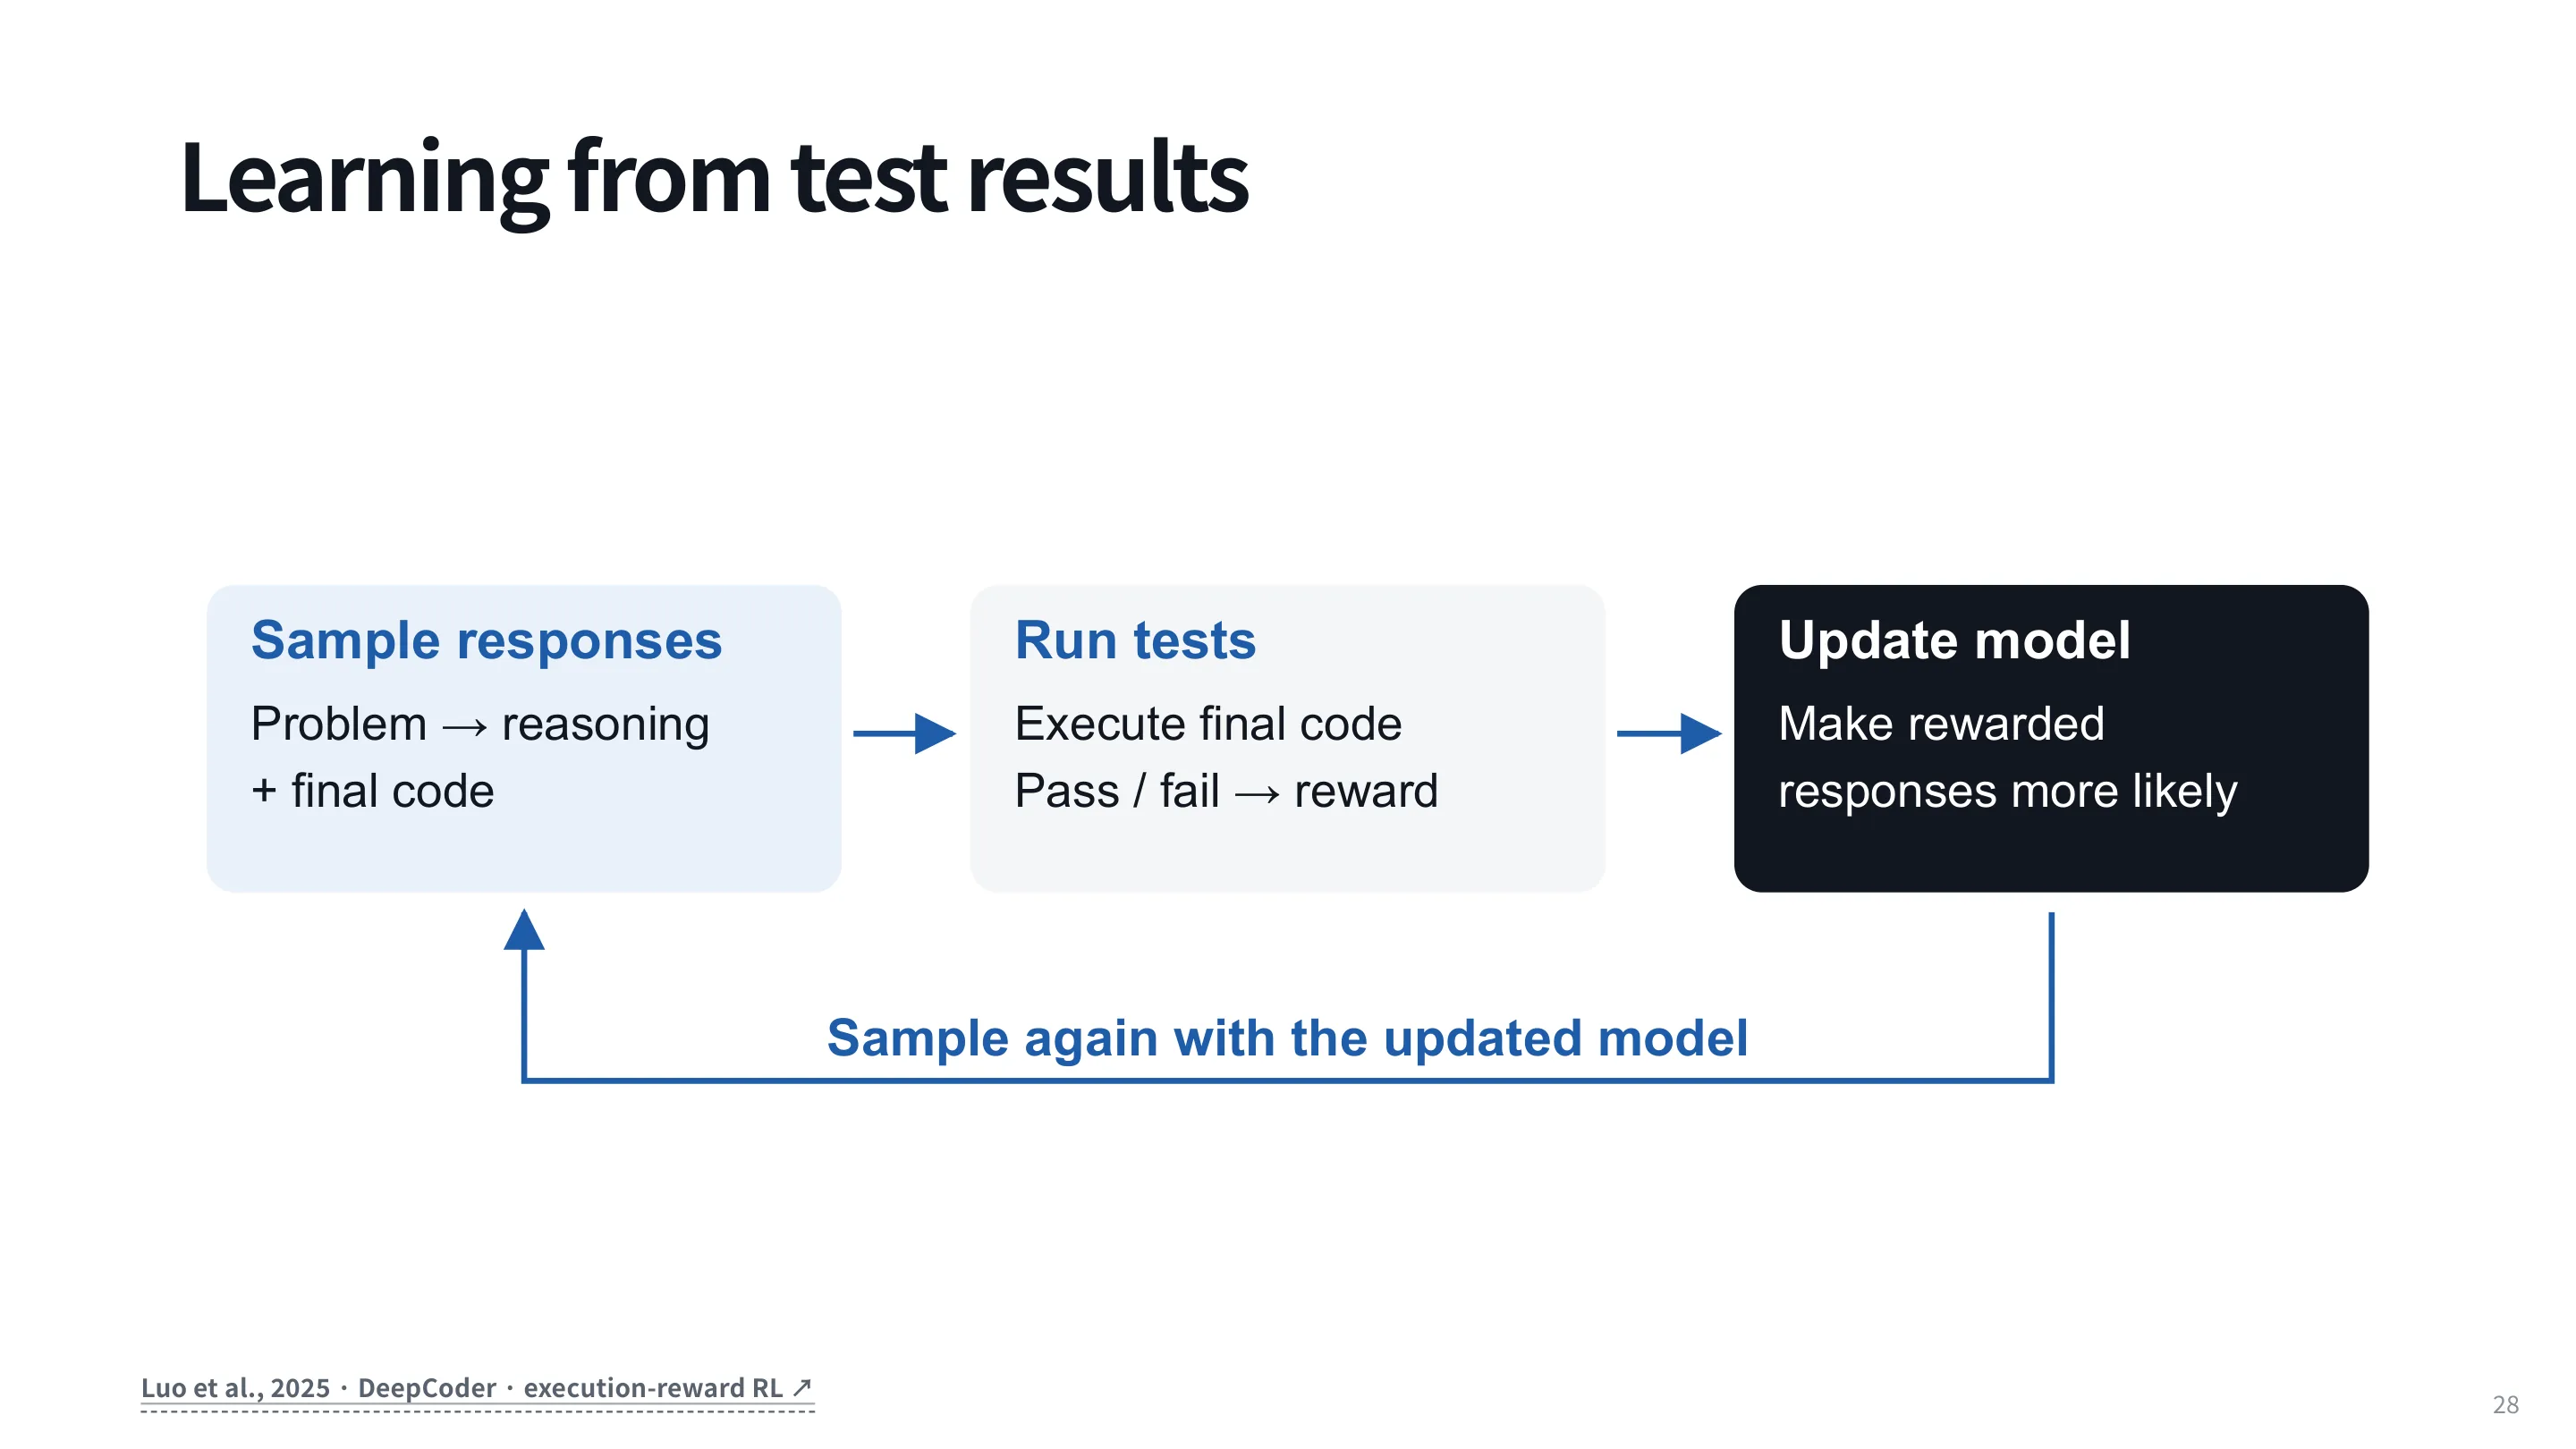
RL 训练则把测试结果直接变成 reward(Slide 28):
- 对问题采样多个 response(reasoning + code);
- 执行代码,跑测试;
- pass/fail 作为 reward;
- 更新模型,让高 reward 的 response 更可能;
- 用更新后的模型继续采样。
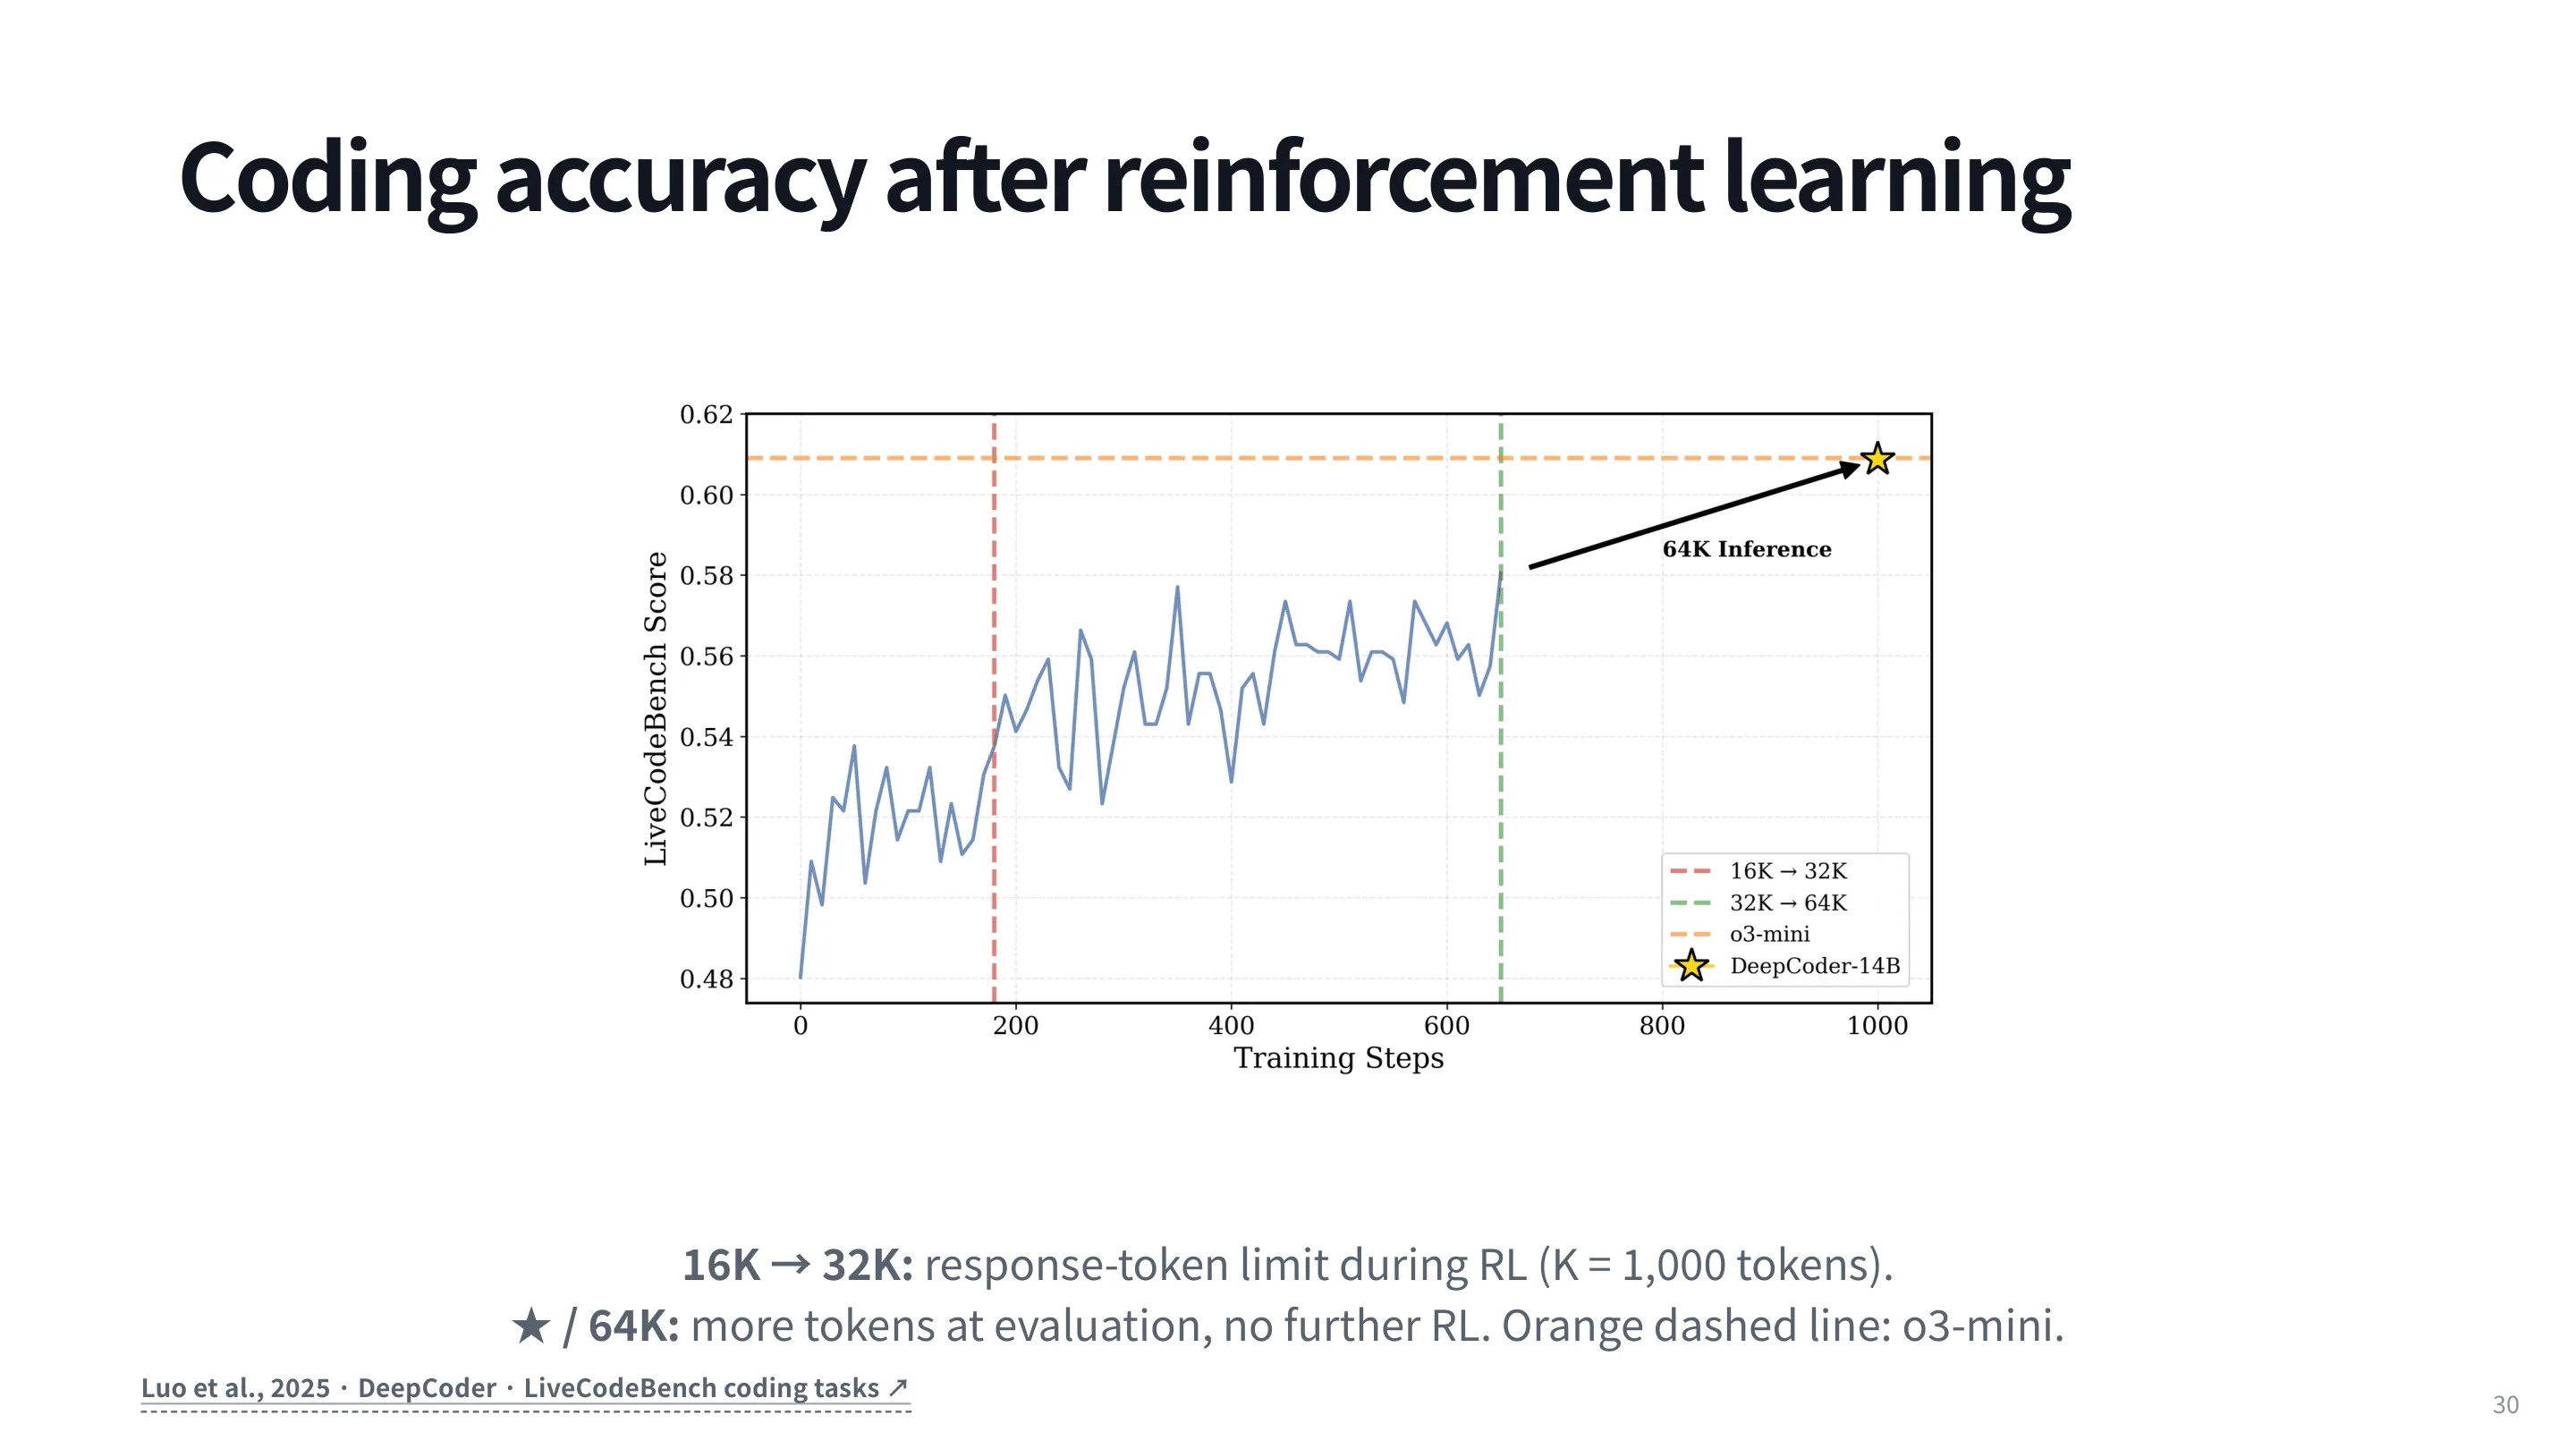
一个很好的例子是求和 1 + … + n(Slide 29):
- 直接
sum(range(n + 1))在 n 很大时超时; - 推导公式
n * (n + 1) // 2才能既正确又高效; - 如果公式记错成
n * (n - 1) // 2,在 n=1 就错了。
这说明 reasoning 不是装饰:它要能把“规格 → 行为 → 复杂度”串起来,并通过测试验证。
5. Agentic coding:localize–edit–verify
单步模型处理的是自包含 prompt;真实仓库里的 issue 需要先找位置、再改、再验证(Slide 32)。
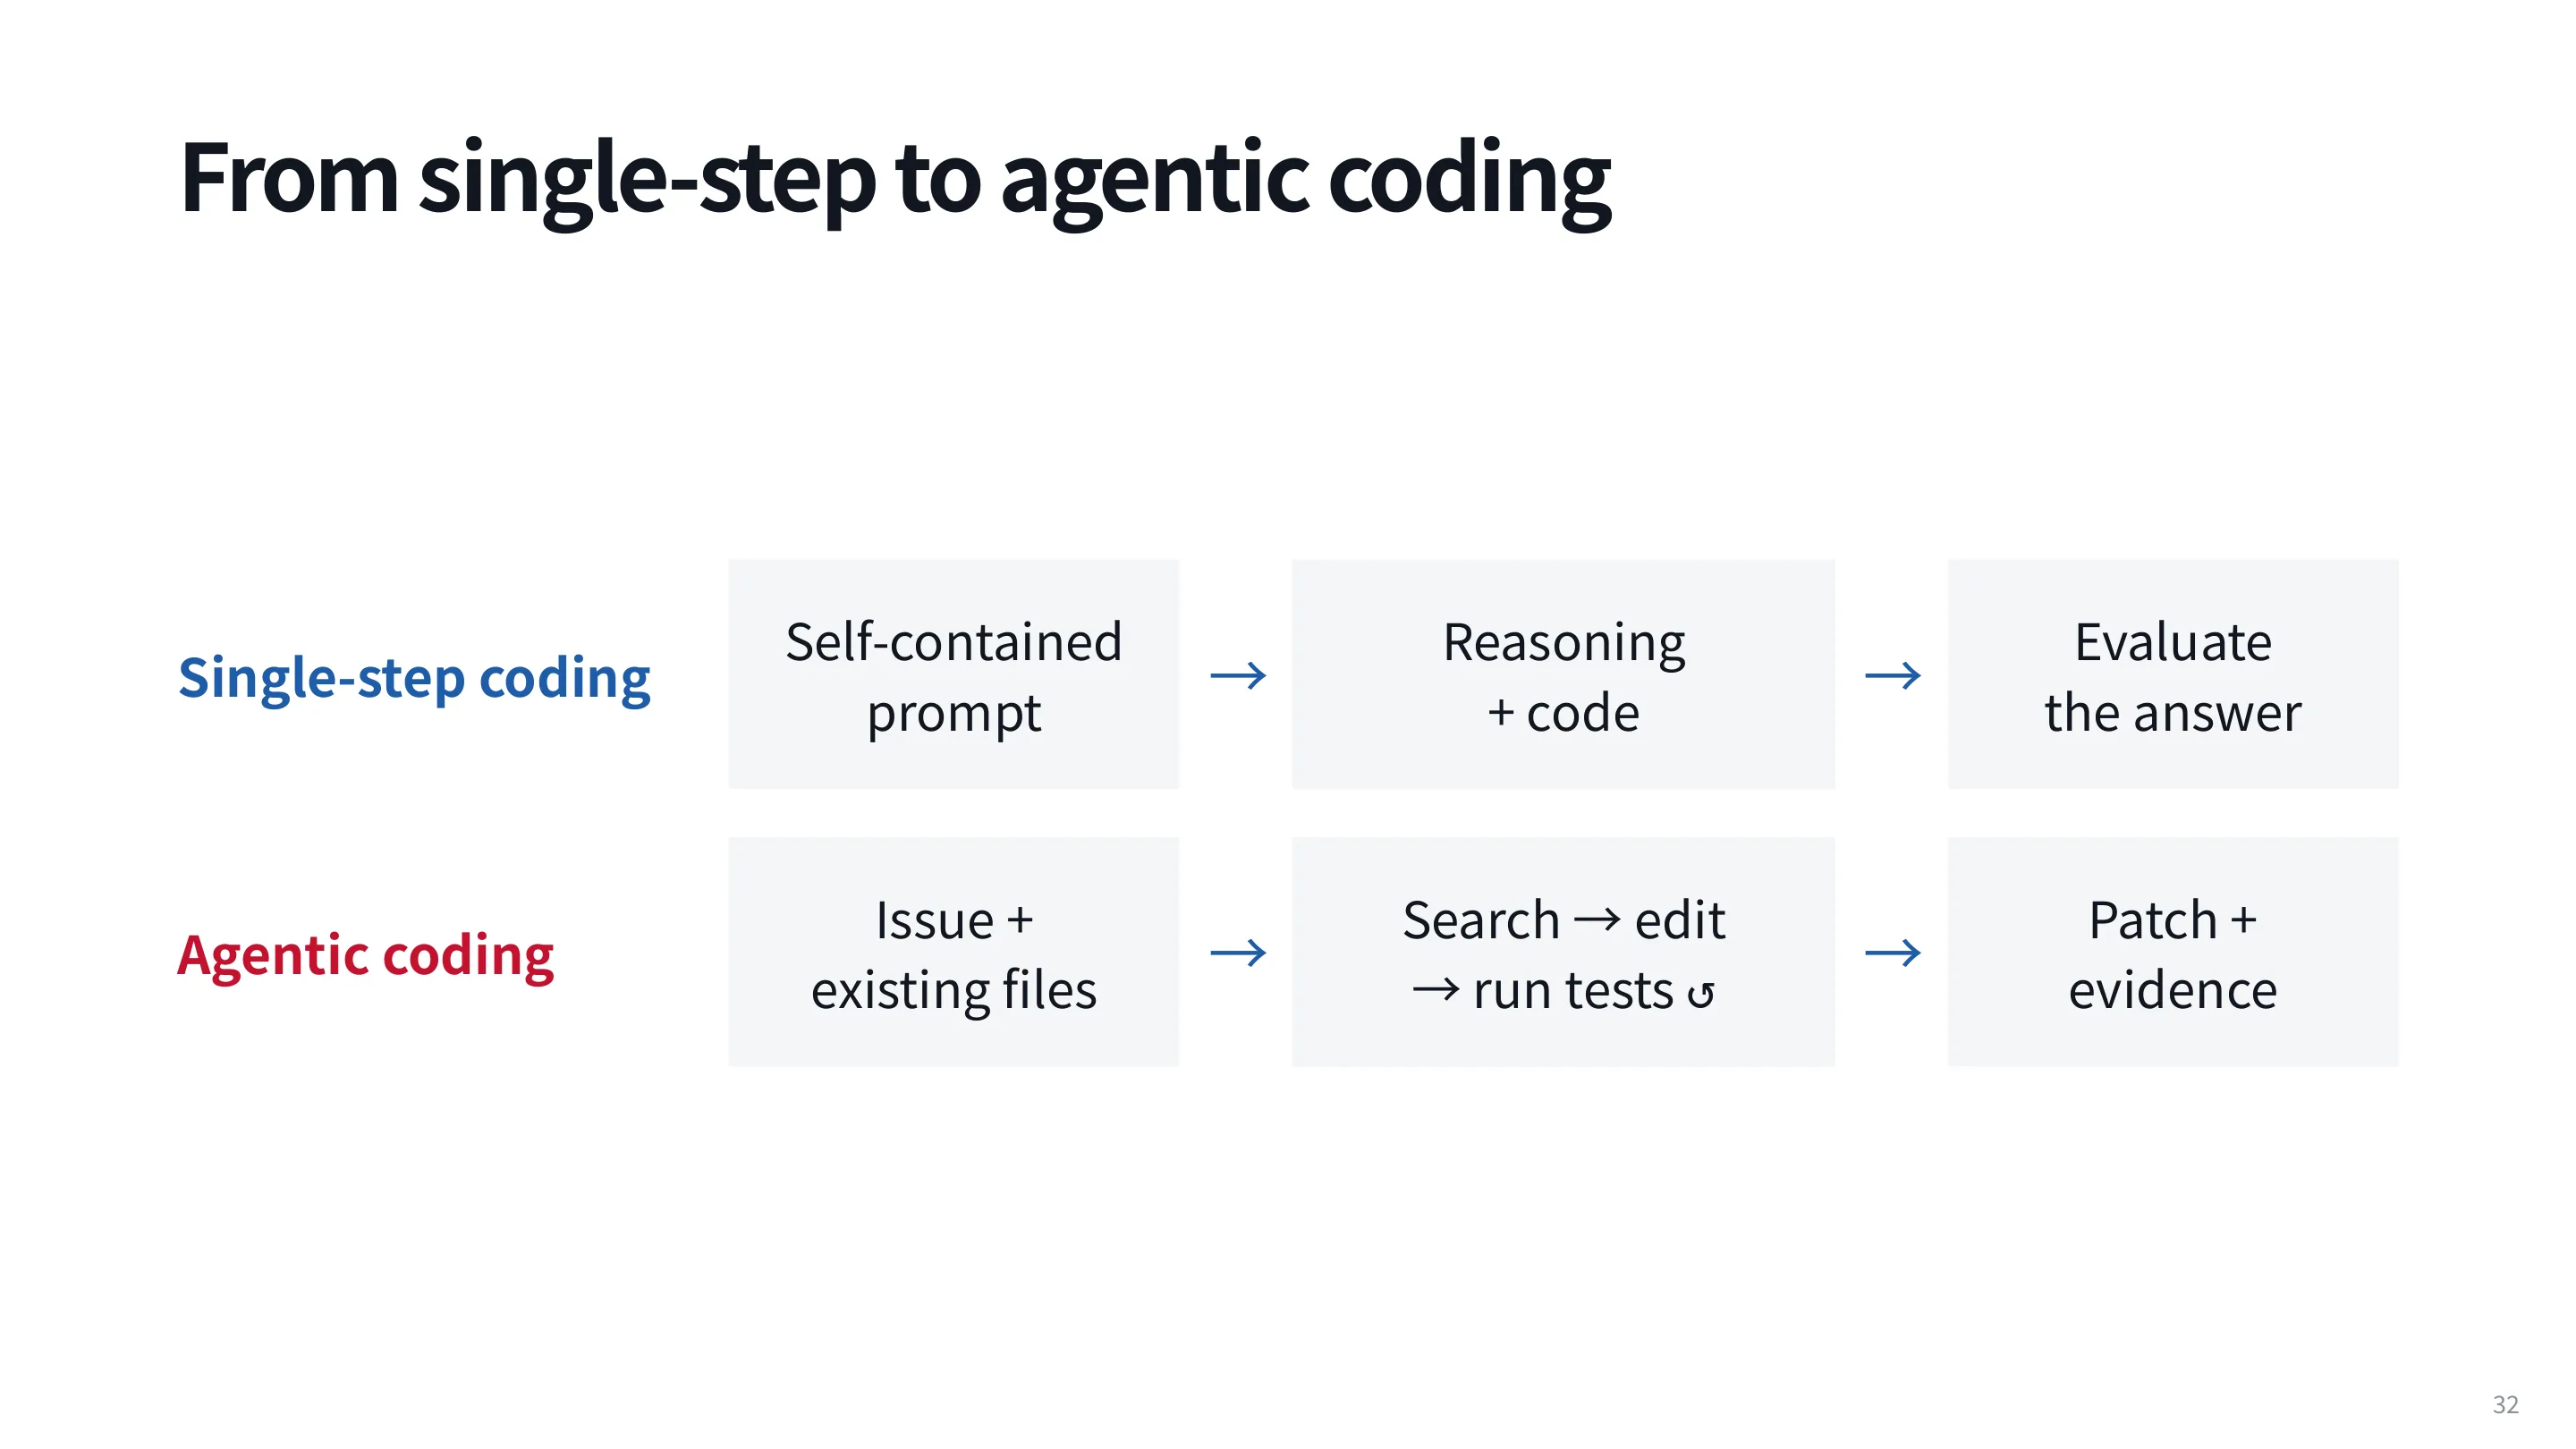
核心循环(Slide 33):
- Localize:定位相关文件、函数、行;
- Edit:修改代码,保留原有行为;
- Verify:跑测试,检查修复与回归;
- 失败 → 修正假设,回到 1/2,而不是重复同一个动作。
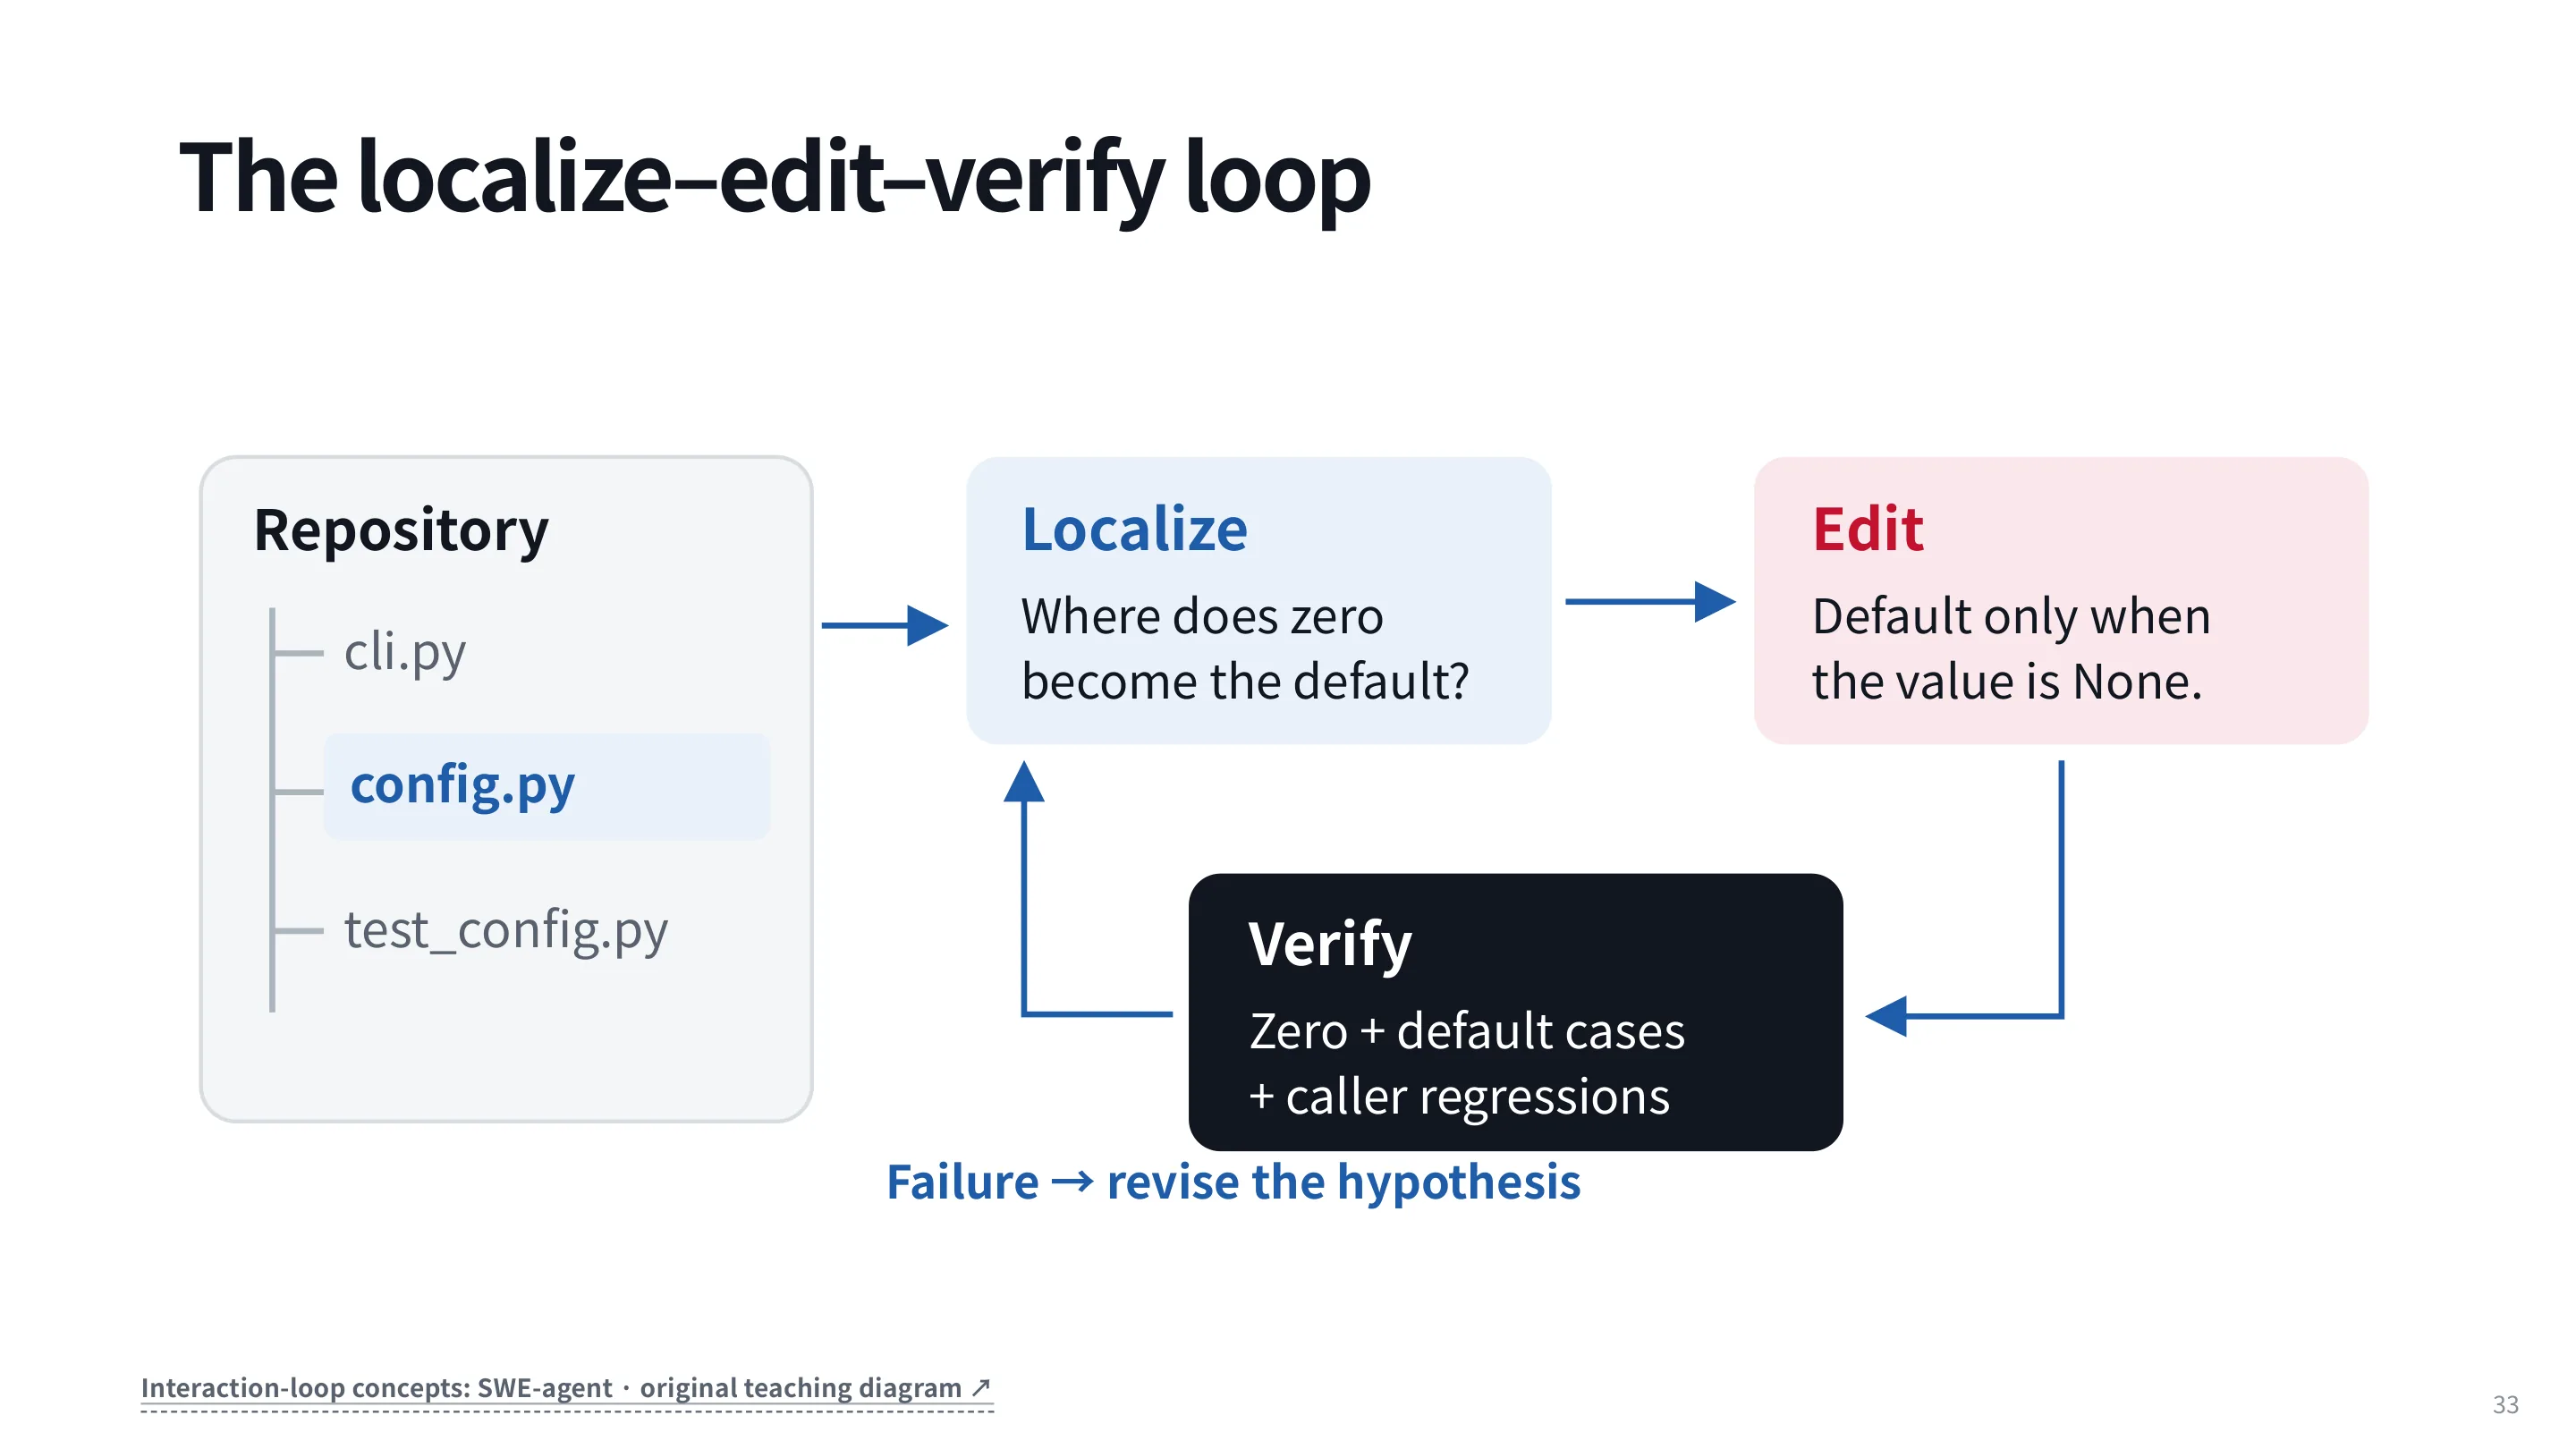
课堂上的 running example 很典型:retries 的默认值逻辑把 0 也当成 falsy,于是传 0 时被替换成 3。
# buggy
return config.get("retries") or 3

# fix
value = config.get("retries")
return 3 if value is None else value定位时先用 rg 'retries' 找到读取点,再复现:
$ rg 'retries' buggy_config.py
return config.get("retries") or 3

$ RETRY_MODULE=buggy_config python3 -m unittest test_config.RetryTests.test_zero
AssertionError: 3 != 0
FAILED (failures=1)修复后跑完整测试:
missing   → 3   PASS
None      → 3   PASS
zero      → 0   PASS
positive  → 2   PASS
Ran 4 tests: OK这里的关键不是“改一行”,而是把失败转化成对行为的假设:0 是合法值,只有 None 才应该触发默认值。验证阶段同时检查零值、None、缺省和回归,避免修一个坏一个。
5.1 另一条路:固定 workflow(Agentless)
Agentless 不做自由形式的工具调用,而是把仓库级修复拆成固定流水线(Slide 37):
- 定位需要修改的文件;
- 定位类/函数;
- 定位具体行;
- 用单步模型生成 patch。
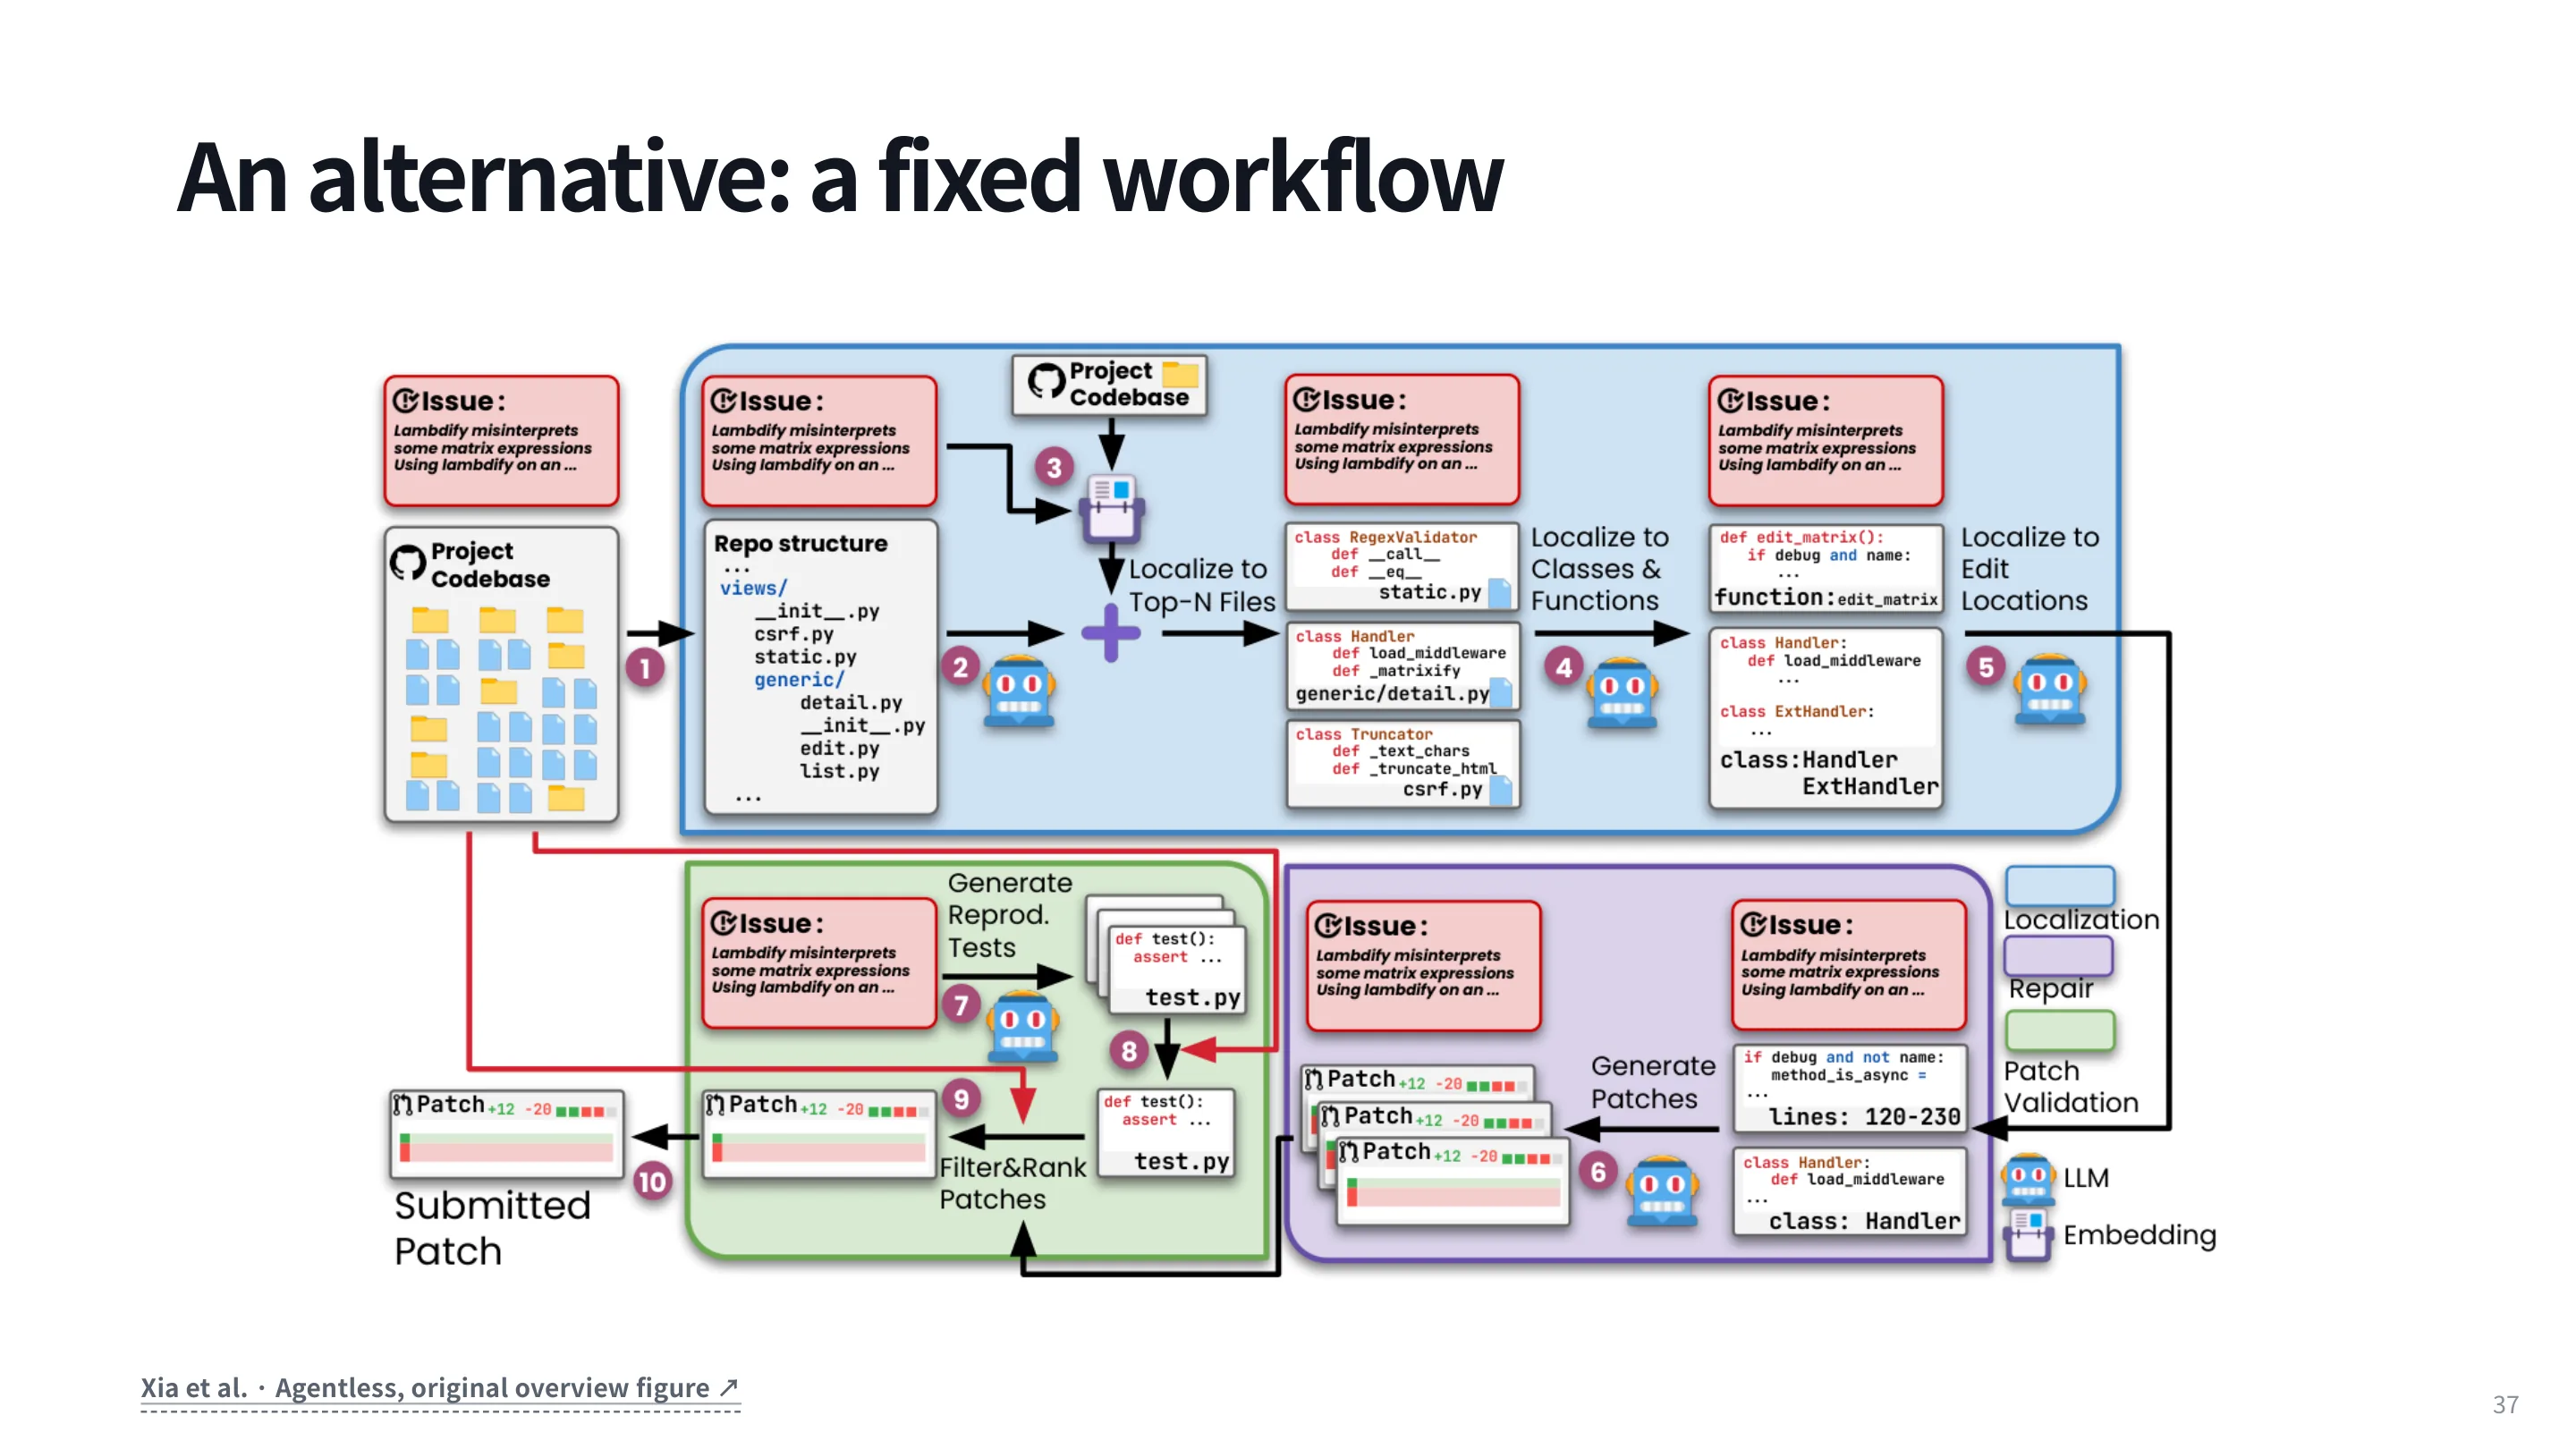
讲师给了一个有意思的历史判断:在模型还不擅长 tool calling、但被大量训练做单步代码修复的时期,固定 workflow 有时反而比 agent 更强。随着模型 tool-use 能力提升,现在主流又回到了 agentic loop。这提醒我们:架构选择要和模型能力匹配,而不是盲目追求“更 agent”。
6. 工具集:shell、edit、search
6.1 只给一个 bash 工具
mini-SWE-agent 的极简设计是:只给模型一个 bash 接口(Slide 39)。
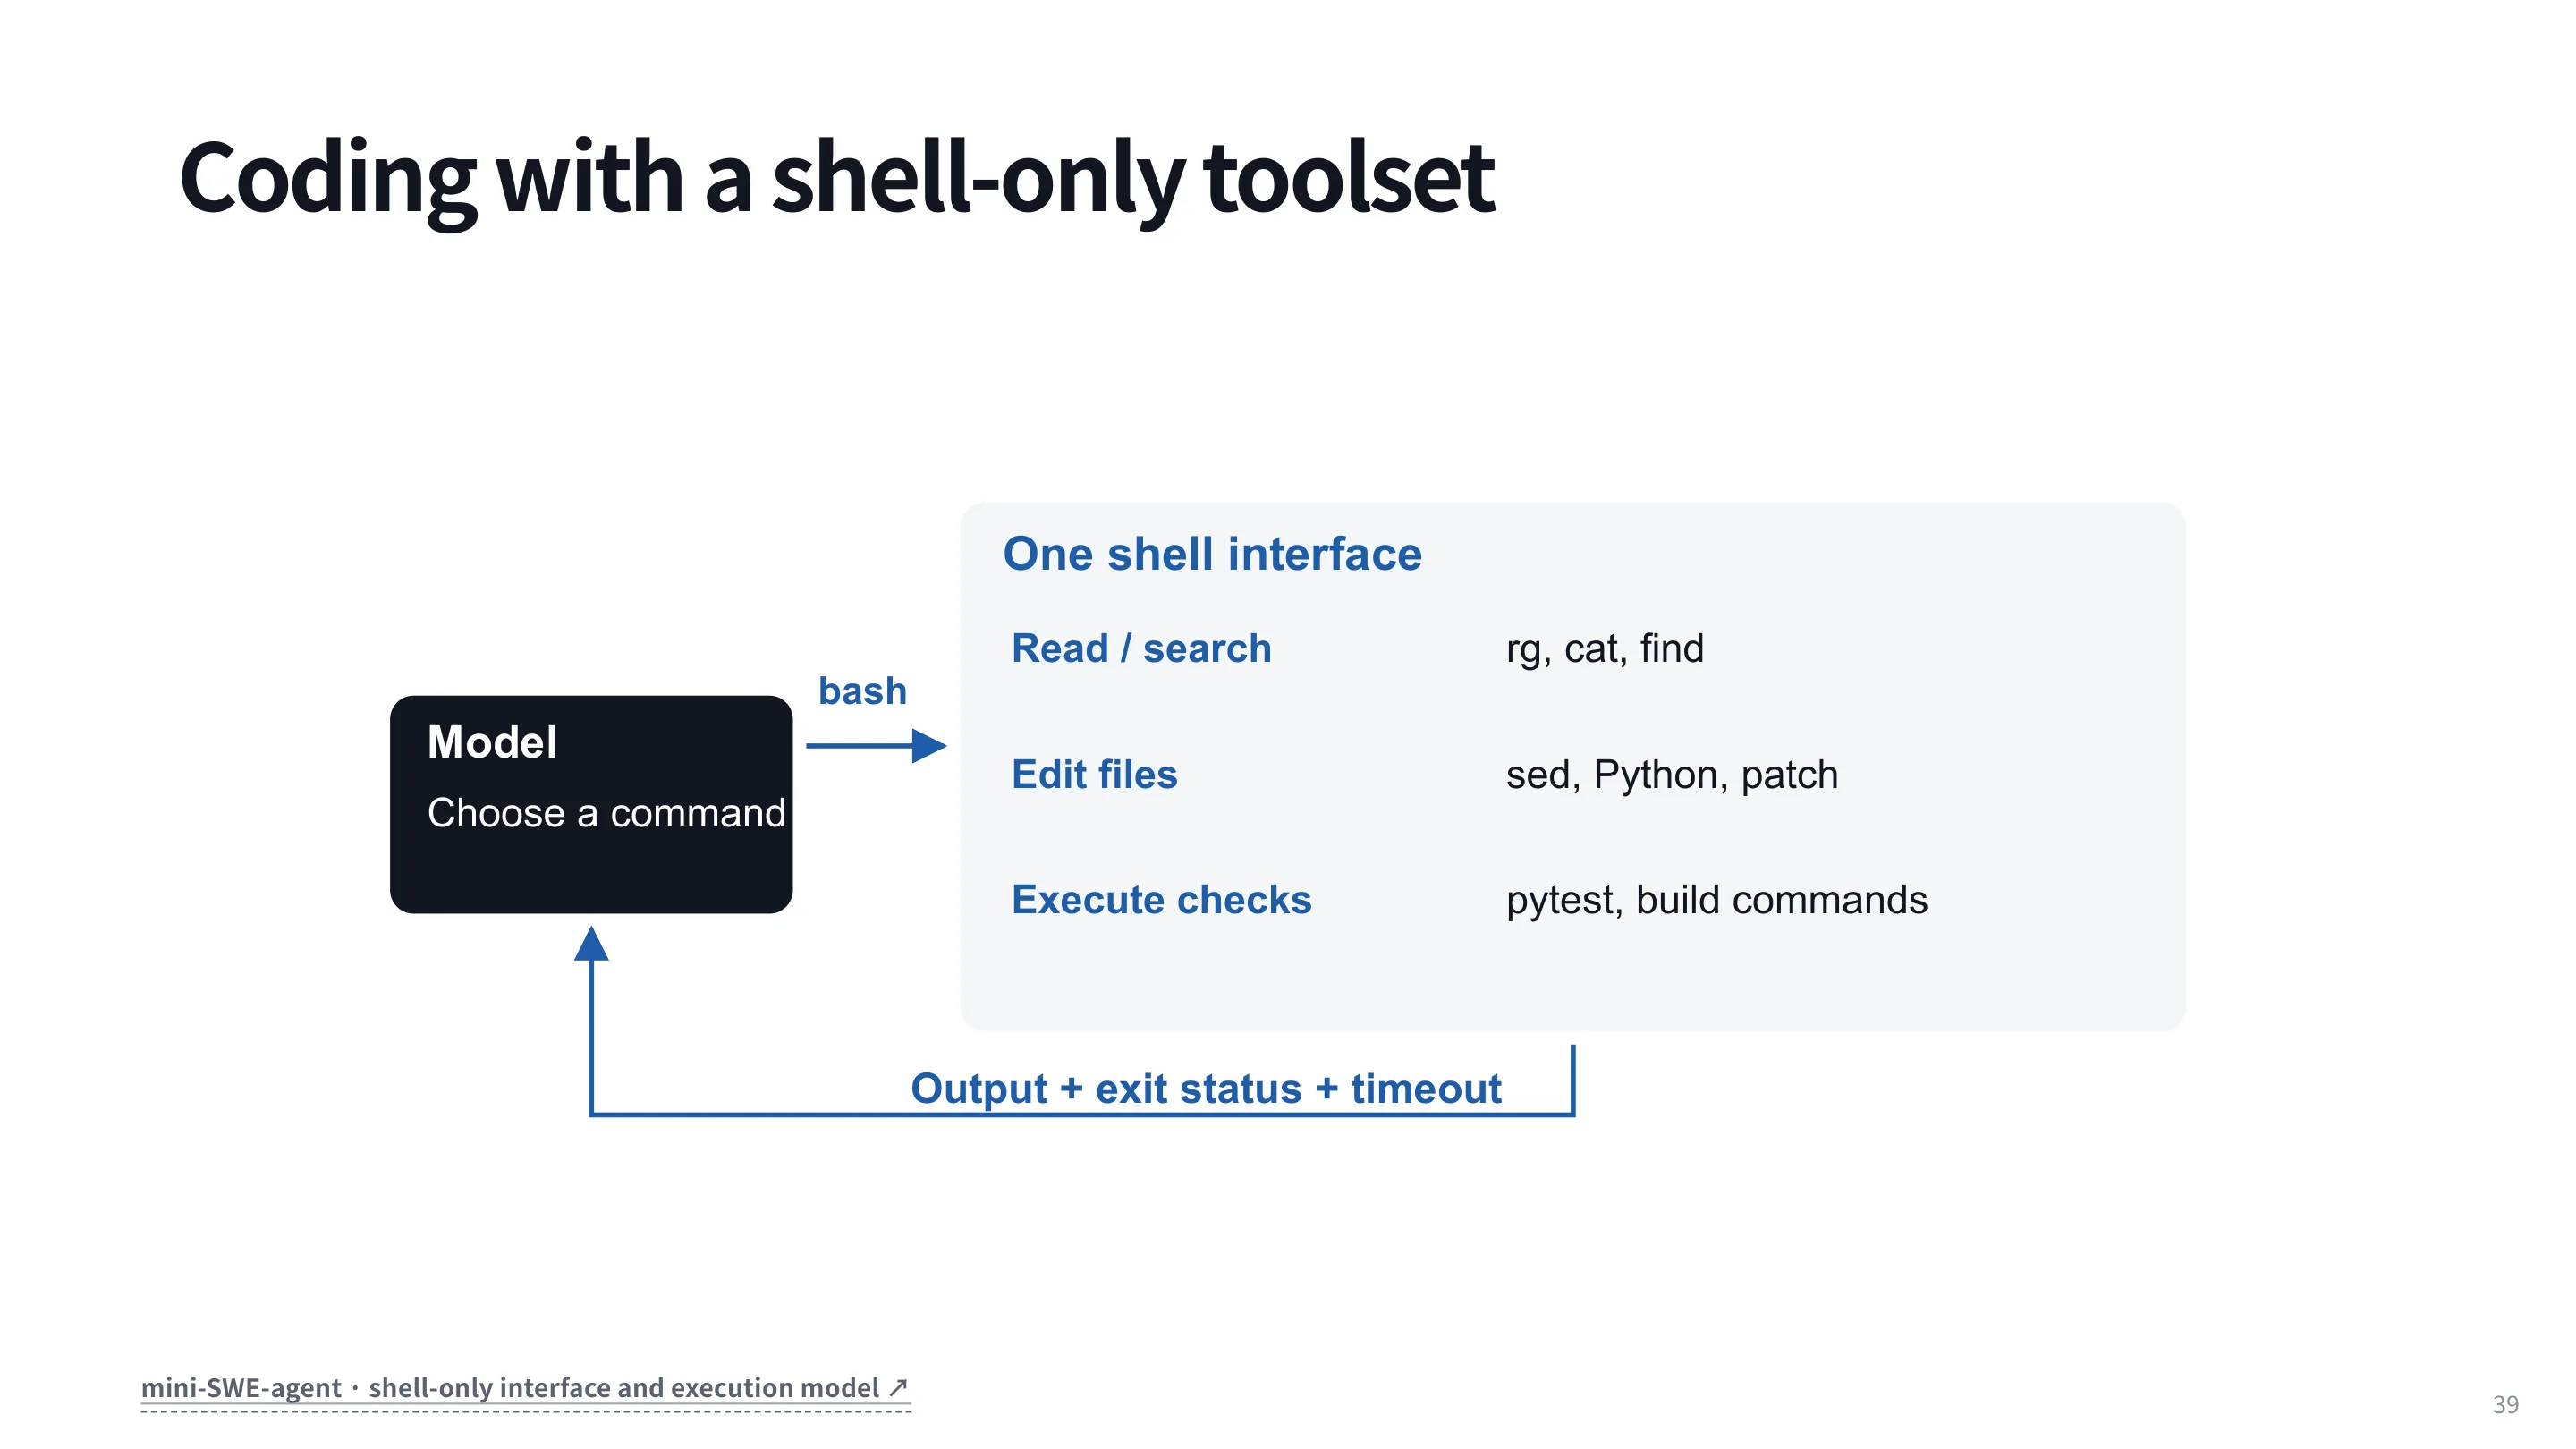
| 操作 | 常用命令 |
|---|---|
| 读 / 搜 | rg、cat、find |
| 编辑 | sed、Python 脚本、patch |
| 执行检查 | pytest、构建命令 |
优点:
- 接口极简,模型不需要学习很多 tool schema;
- 任何能通过命令行完成的事情都能做;
- 输出、退出码、超时都是自然信号。
缺点:
sed的反斜杠转义很容易出错;- 每次编辑都要在
sed/Python/patch之间选择; - 没有统一的“编辑语义”,错误难以恢复;
- shell 的权限和安全边界更难控制。
讲师估计 85–90% 的 tool call 都是这些基本操作。既然大多数调用都集中在少数操作上,把它们封装成更可靠的专用工具,通常比让模型每次都即兴拼 shell 更稳。
6.2 编辑工具:格式决定成败
最常见的三类编辑接口(Slide 41):
- Whole file:直接写整个文件;简单,但重复未修改代码、token 消耗大;
- Search / replace:给 old/new 片段;紧凑,但要求匹配唯一;
- Unified diff / patch:标准行号 + 上下文;表达精确,但模型经常数错行。
Search/replace 的格式通常长这样:
<<<<<<< SEARCH
RETRIES = 3
=======
RETRIES = 5
>>>>>>> REPLACEUnified diff:
--- a/settings.py
+++ b/settings.py
@@ -1,2 +1,2 @@
-RETRIES = 3
+RETRIES = 5
TIMEOUT = 30Codex 的 file-operation patch 则用文件操作 + 上下文,不依赖行号:
*** Begin Patch
*** Update File: settings.py
@@
-RETRIES = 3
+RETRIES = 5
 TIMEOUT = 30
*** End Patch格式的影响有多大?Aider 的 refactoring benchmark(89 个 Python 任务)上,GPT-4 Turbo 的 search/replace 成功率是 20%,简化 unified diff 是 61%(Slide 43)。
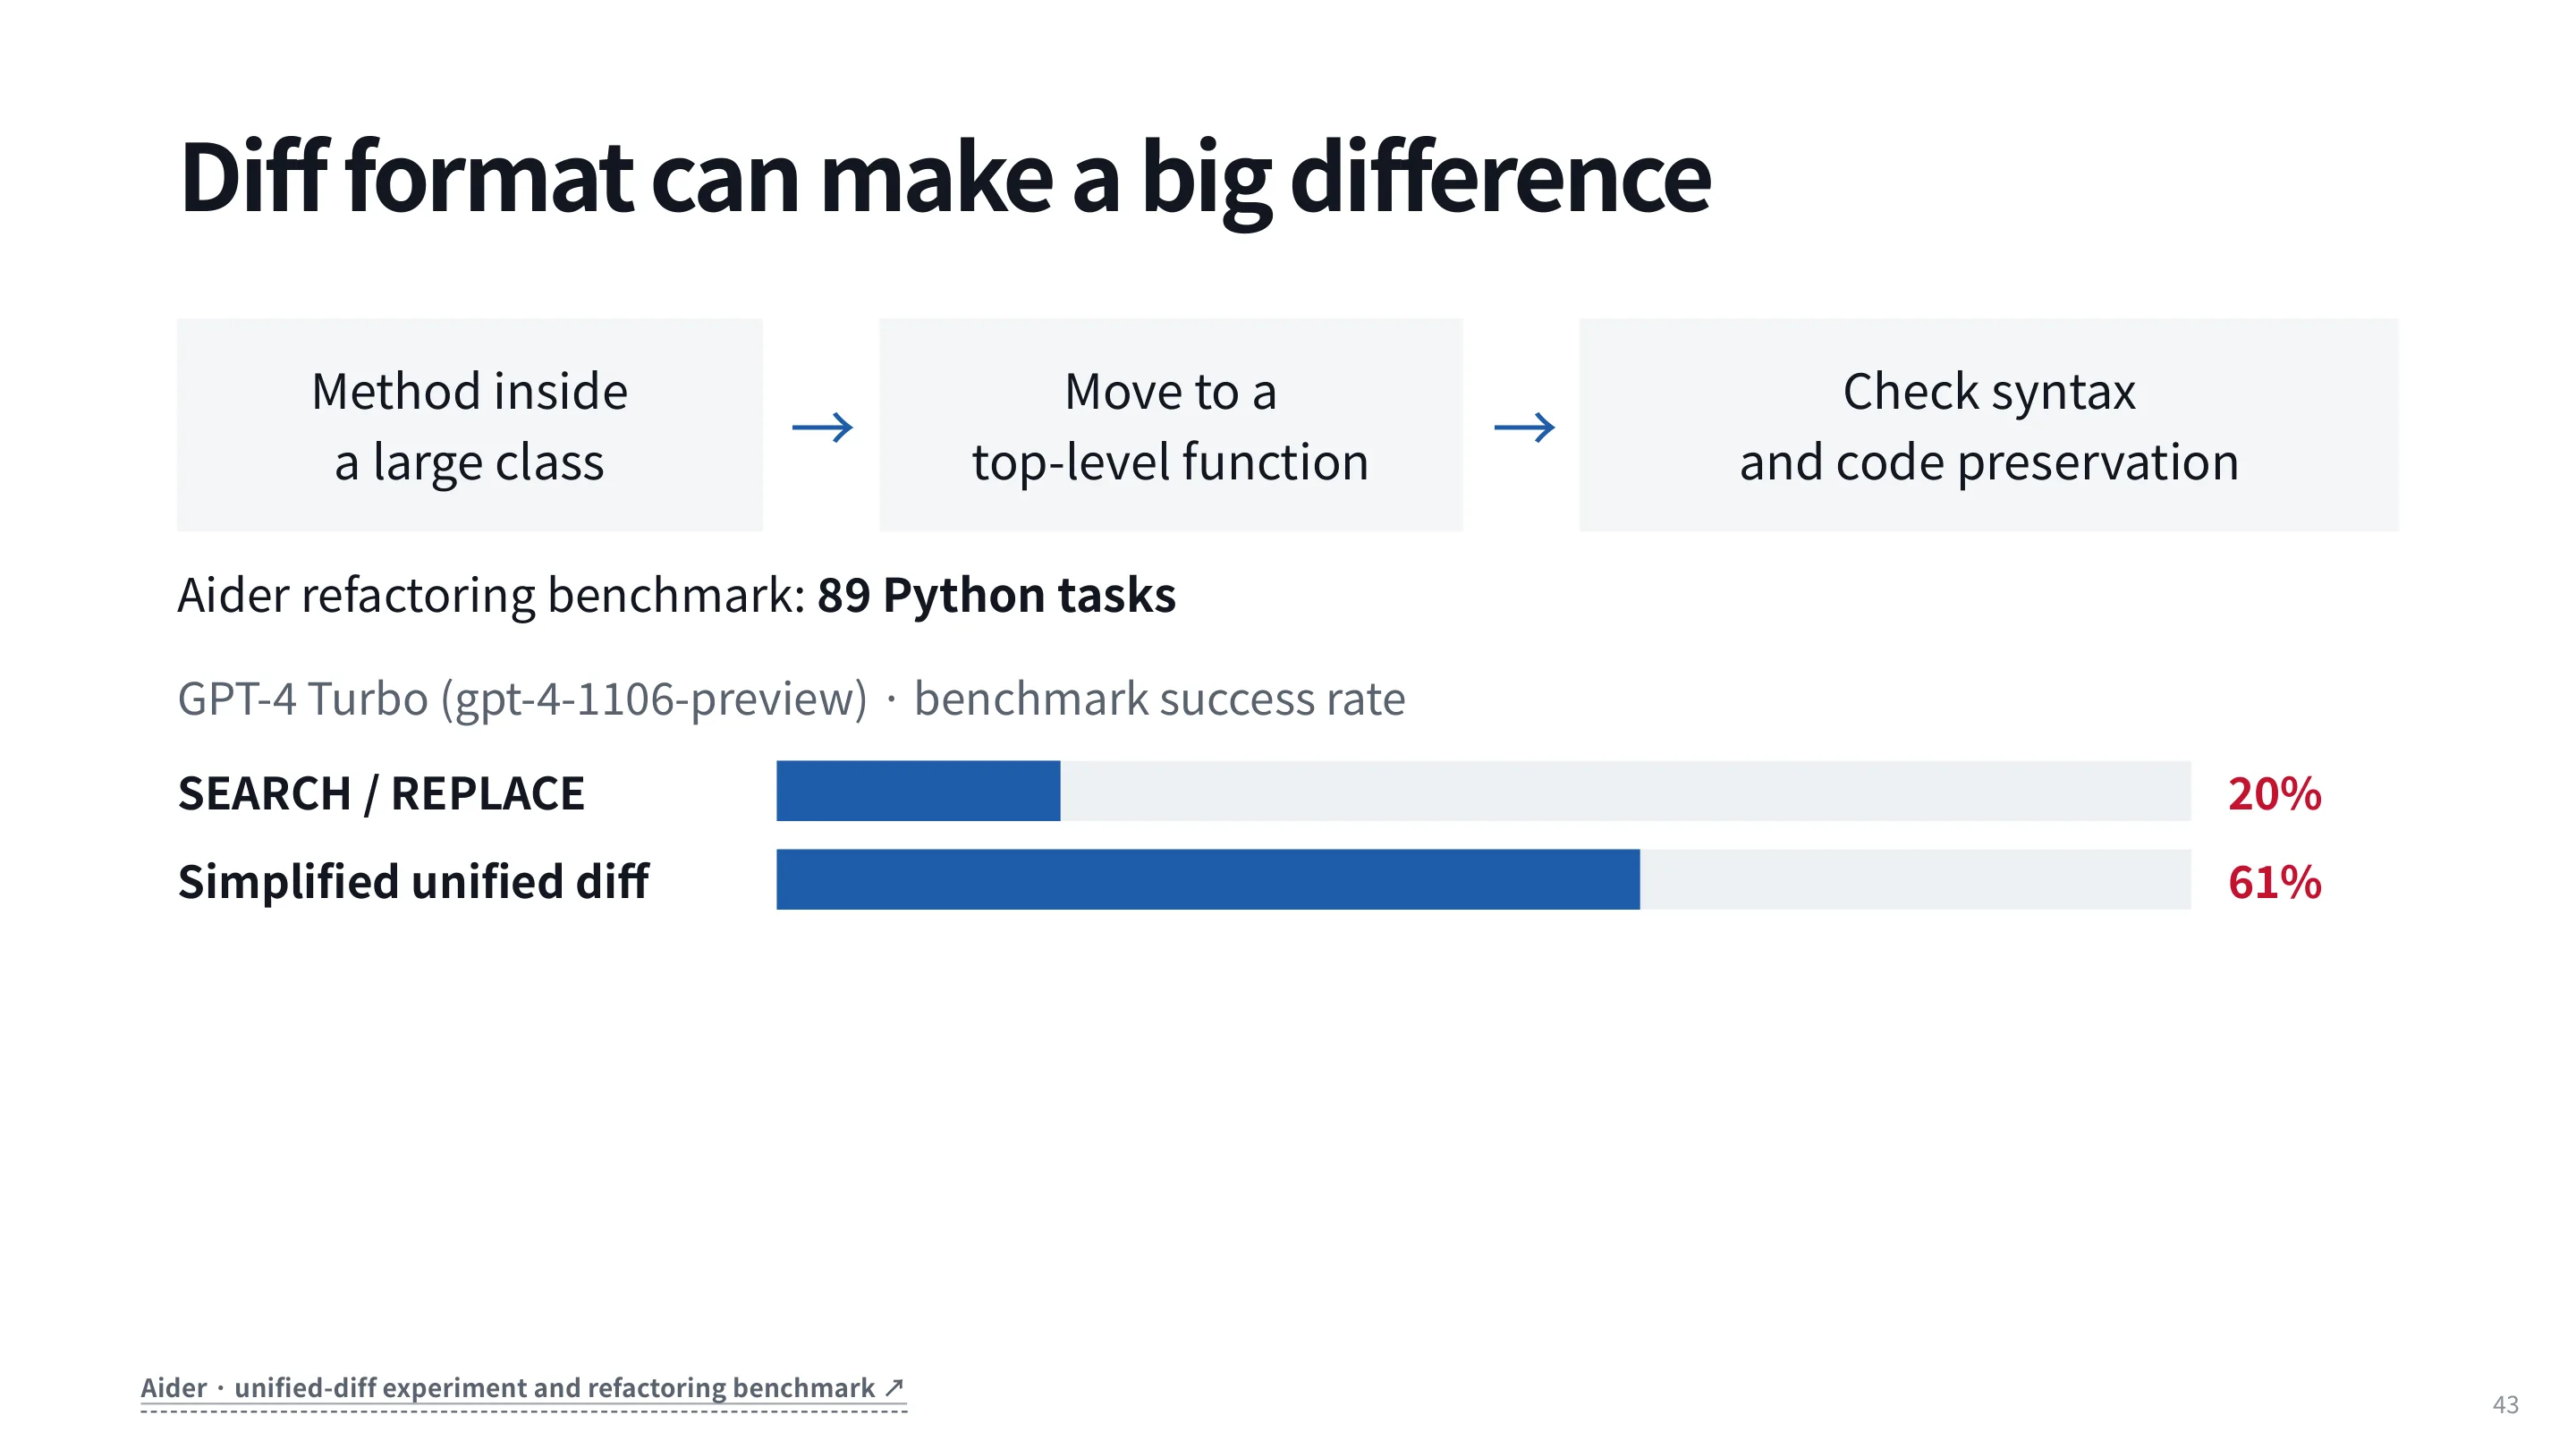
这也解释了 multi-harness training 的必要性:如果模型只见过一种 edit format,换一个 harness 就可能显著掉分。讲师提到 Gemini 曾因使用自家 edit format,在很多 harness 上表现不佳,后来才逐渐适配。
Search/replace 的一个典型失败模式是重复片段:文件里有多处 retries = 3,模型无法消歧。解决办法是让模型写更多上下文,直到匹配唯一。这个代价通常小于 unified diff 数错行号的代价,所以大多数 agent 最终选择 search/replace 或简化 diff。
6.3 找代码:从 rg 到 dependency graph
定位通常从症状出发(Slide 44):一个 flag、一个 loader、一个 retry loop 都可能匹配。更可靠的做法是跟随值:
- 配置从哪里读入?
- 零值在哪里第一次被处理?
- 默认值在哪里生效?
- 调用链上还有谁依赖这个结果?
工具上,rg 是最常用的起点;更复杂的方法会构建 dependency graph,让 agent 沿着 import/call 关系跳转(Slide 45,LocAgent)。
但讲师的经验是:复杂的定位工具不一定比简单搜索更好。很多情况下,rg + 读文件 + 跑测试已经足够;dependency graph 更适合大型仓库或明确的跨文件依赖,否则容易引入额外复杂度。
7. Agent 的评测与训练
7.1 SWE-bench:issue 解析的“黄金标准”
SWE-bench 的构造方式(Slide 47):
- 从 GitHub 收集已解决的 issue;
- 取 issue 解决前的仓库状态;
- 取与该 issue 一起提交的测试;
- agent 生成 patch,应用后跑测试;
- 相关测试全部通过 → 得分 1,否则 0。
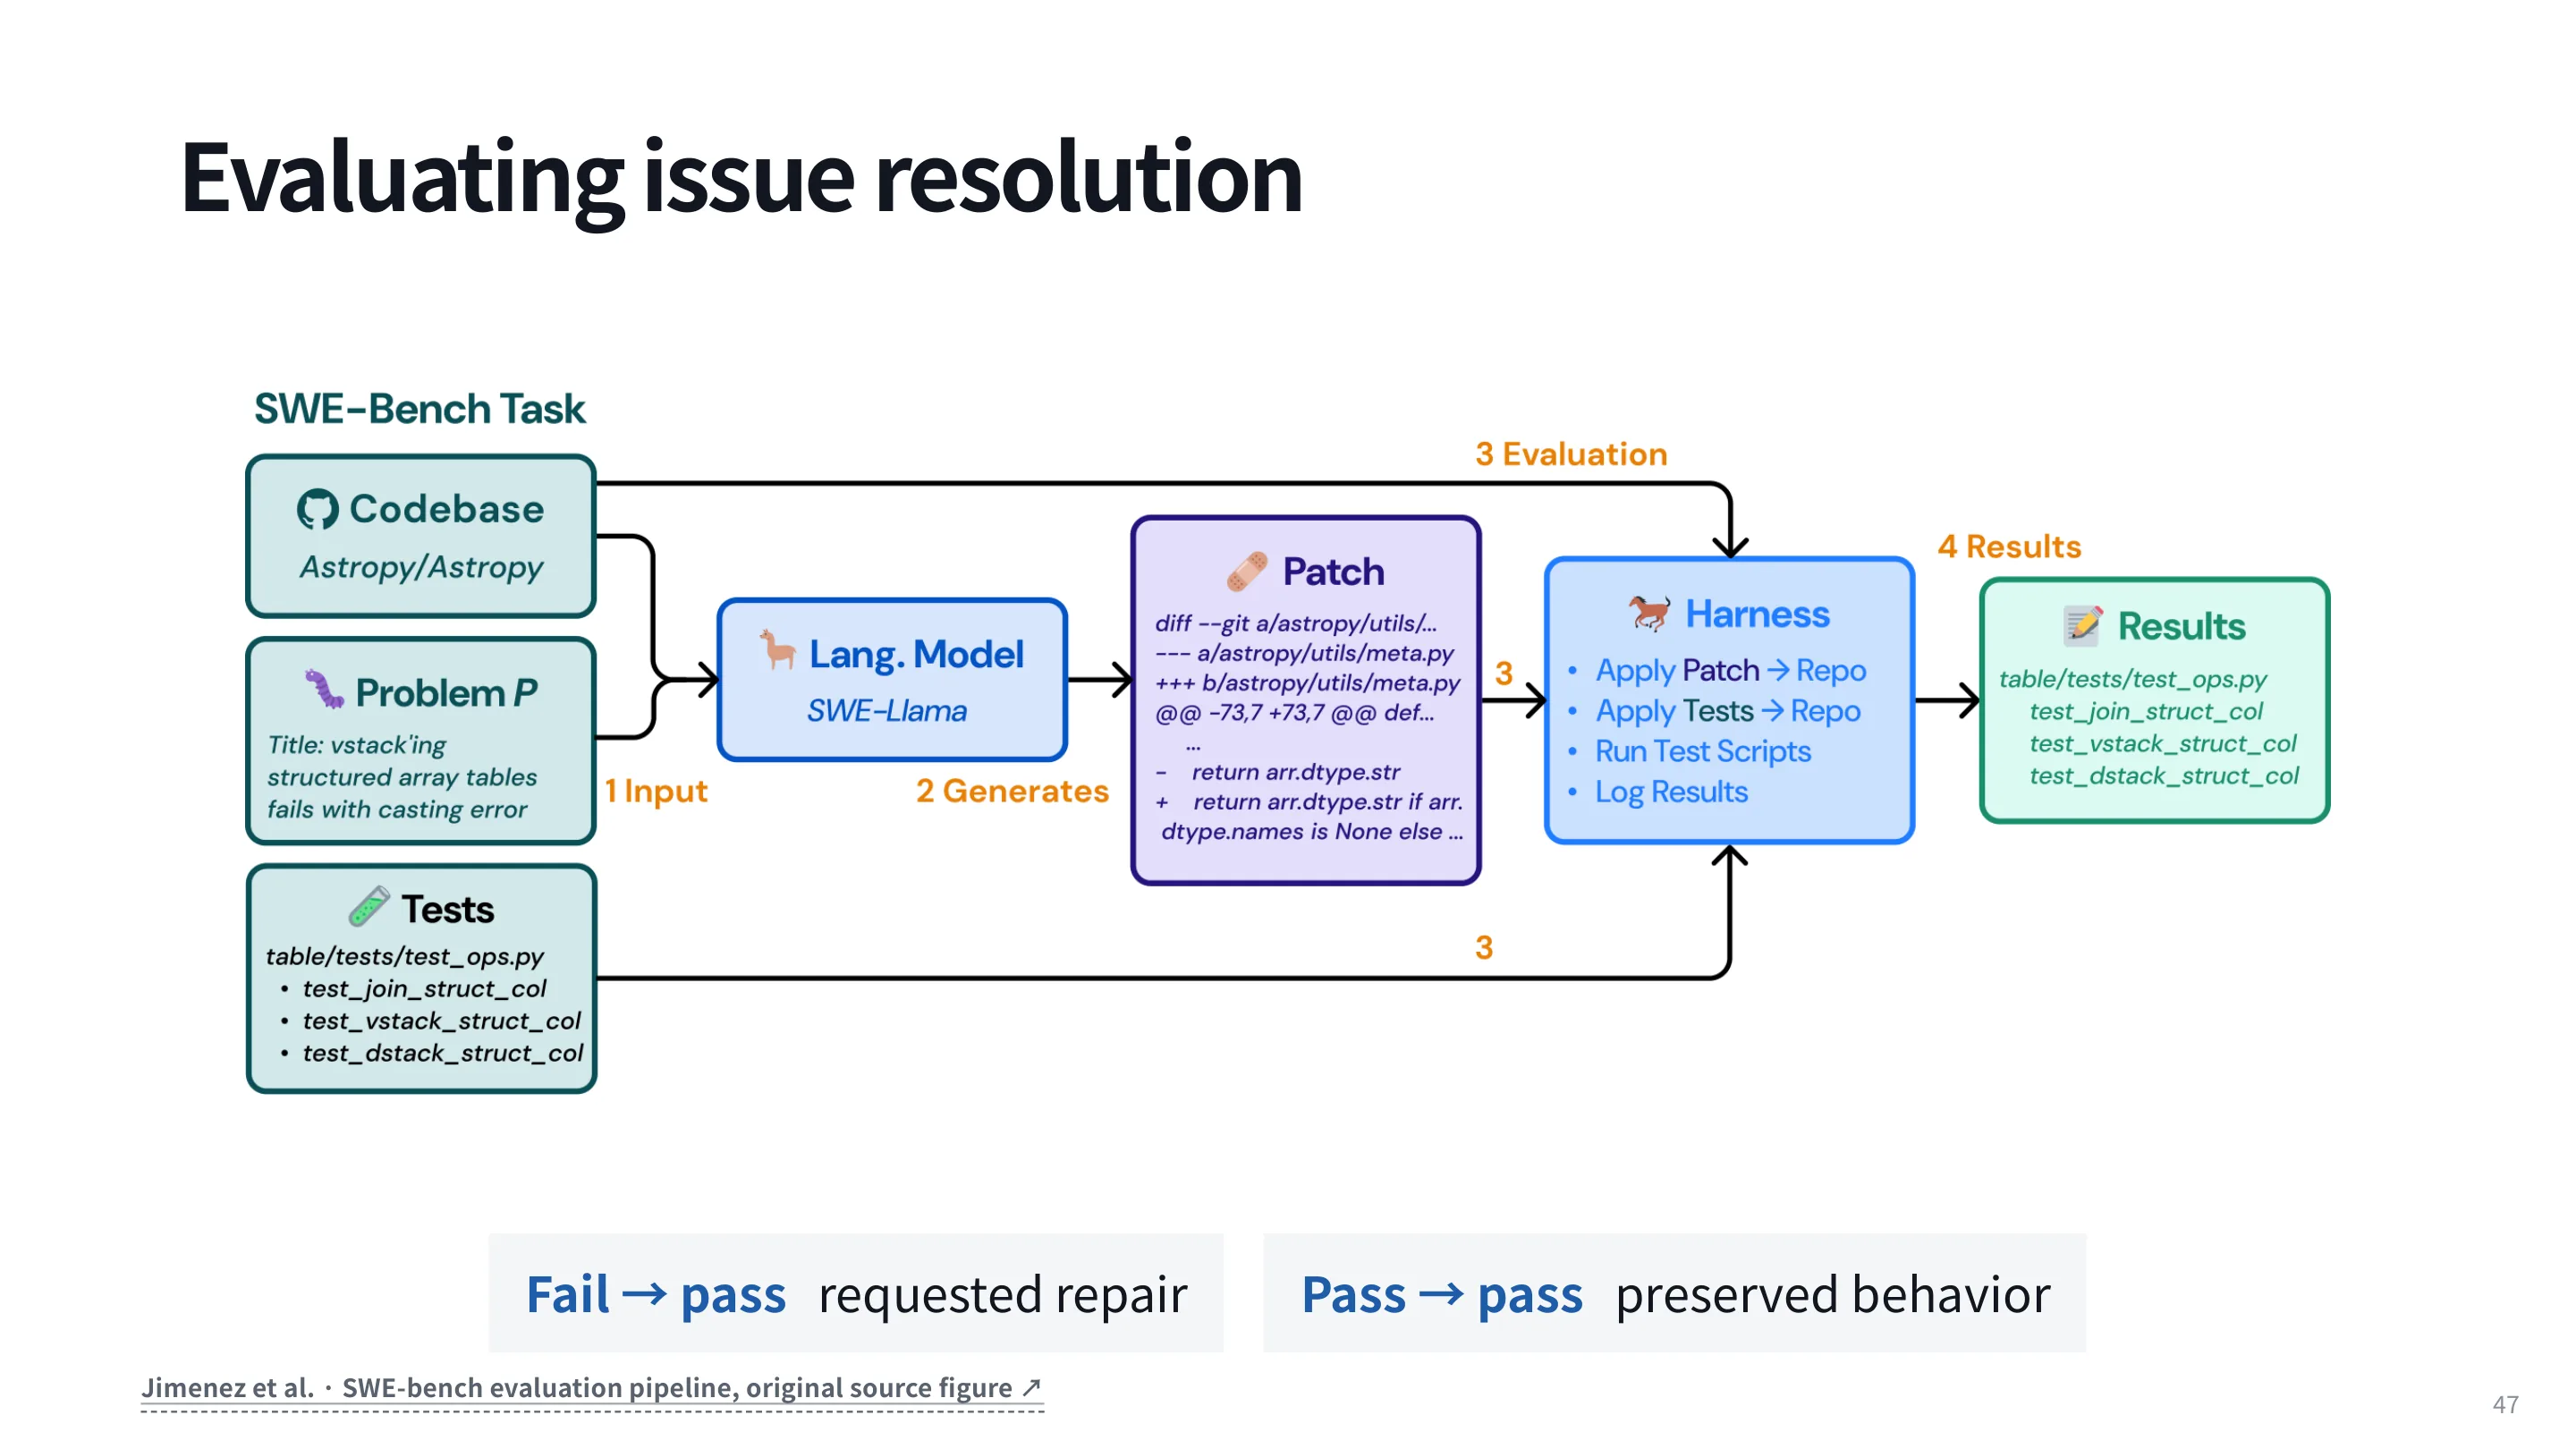
测试分两类:
- Fail-to-pass:修复前失败、修复后通过,验证新功能/修复;
- Pass-to-pass:修复前后都应通过,验证没有回归。
这里的 “harness” 指 test harness(测试执行框架),不是 agent harness,注意区分。
SWE-bench 的工程难点在于环境:Django、NumPy 这类仓库跑全量测试非常慢,所以只选与 issue 相关的子集;依赖版本、镜像、测试命令都必须固定,否则分数不可比。
7.2 可执行训练任务与 RL
要训练 agent,光有评测集不够,还需要可执行的训练环境(Slide 48):
| 组成 | 内容 |
|---|---|
| Starting state | 文件、依赖、测试命令 |
| Issue | 期望行为 + 复现方式 |
| Checks | 修复前失败、修复后通过 |
多步修复的 RL 有一个核心难题(Slide 49):terminal reward 只知道最后有没有修好,无法告诉你是哪一步决策错了。
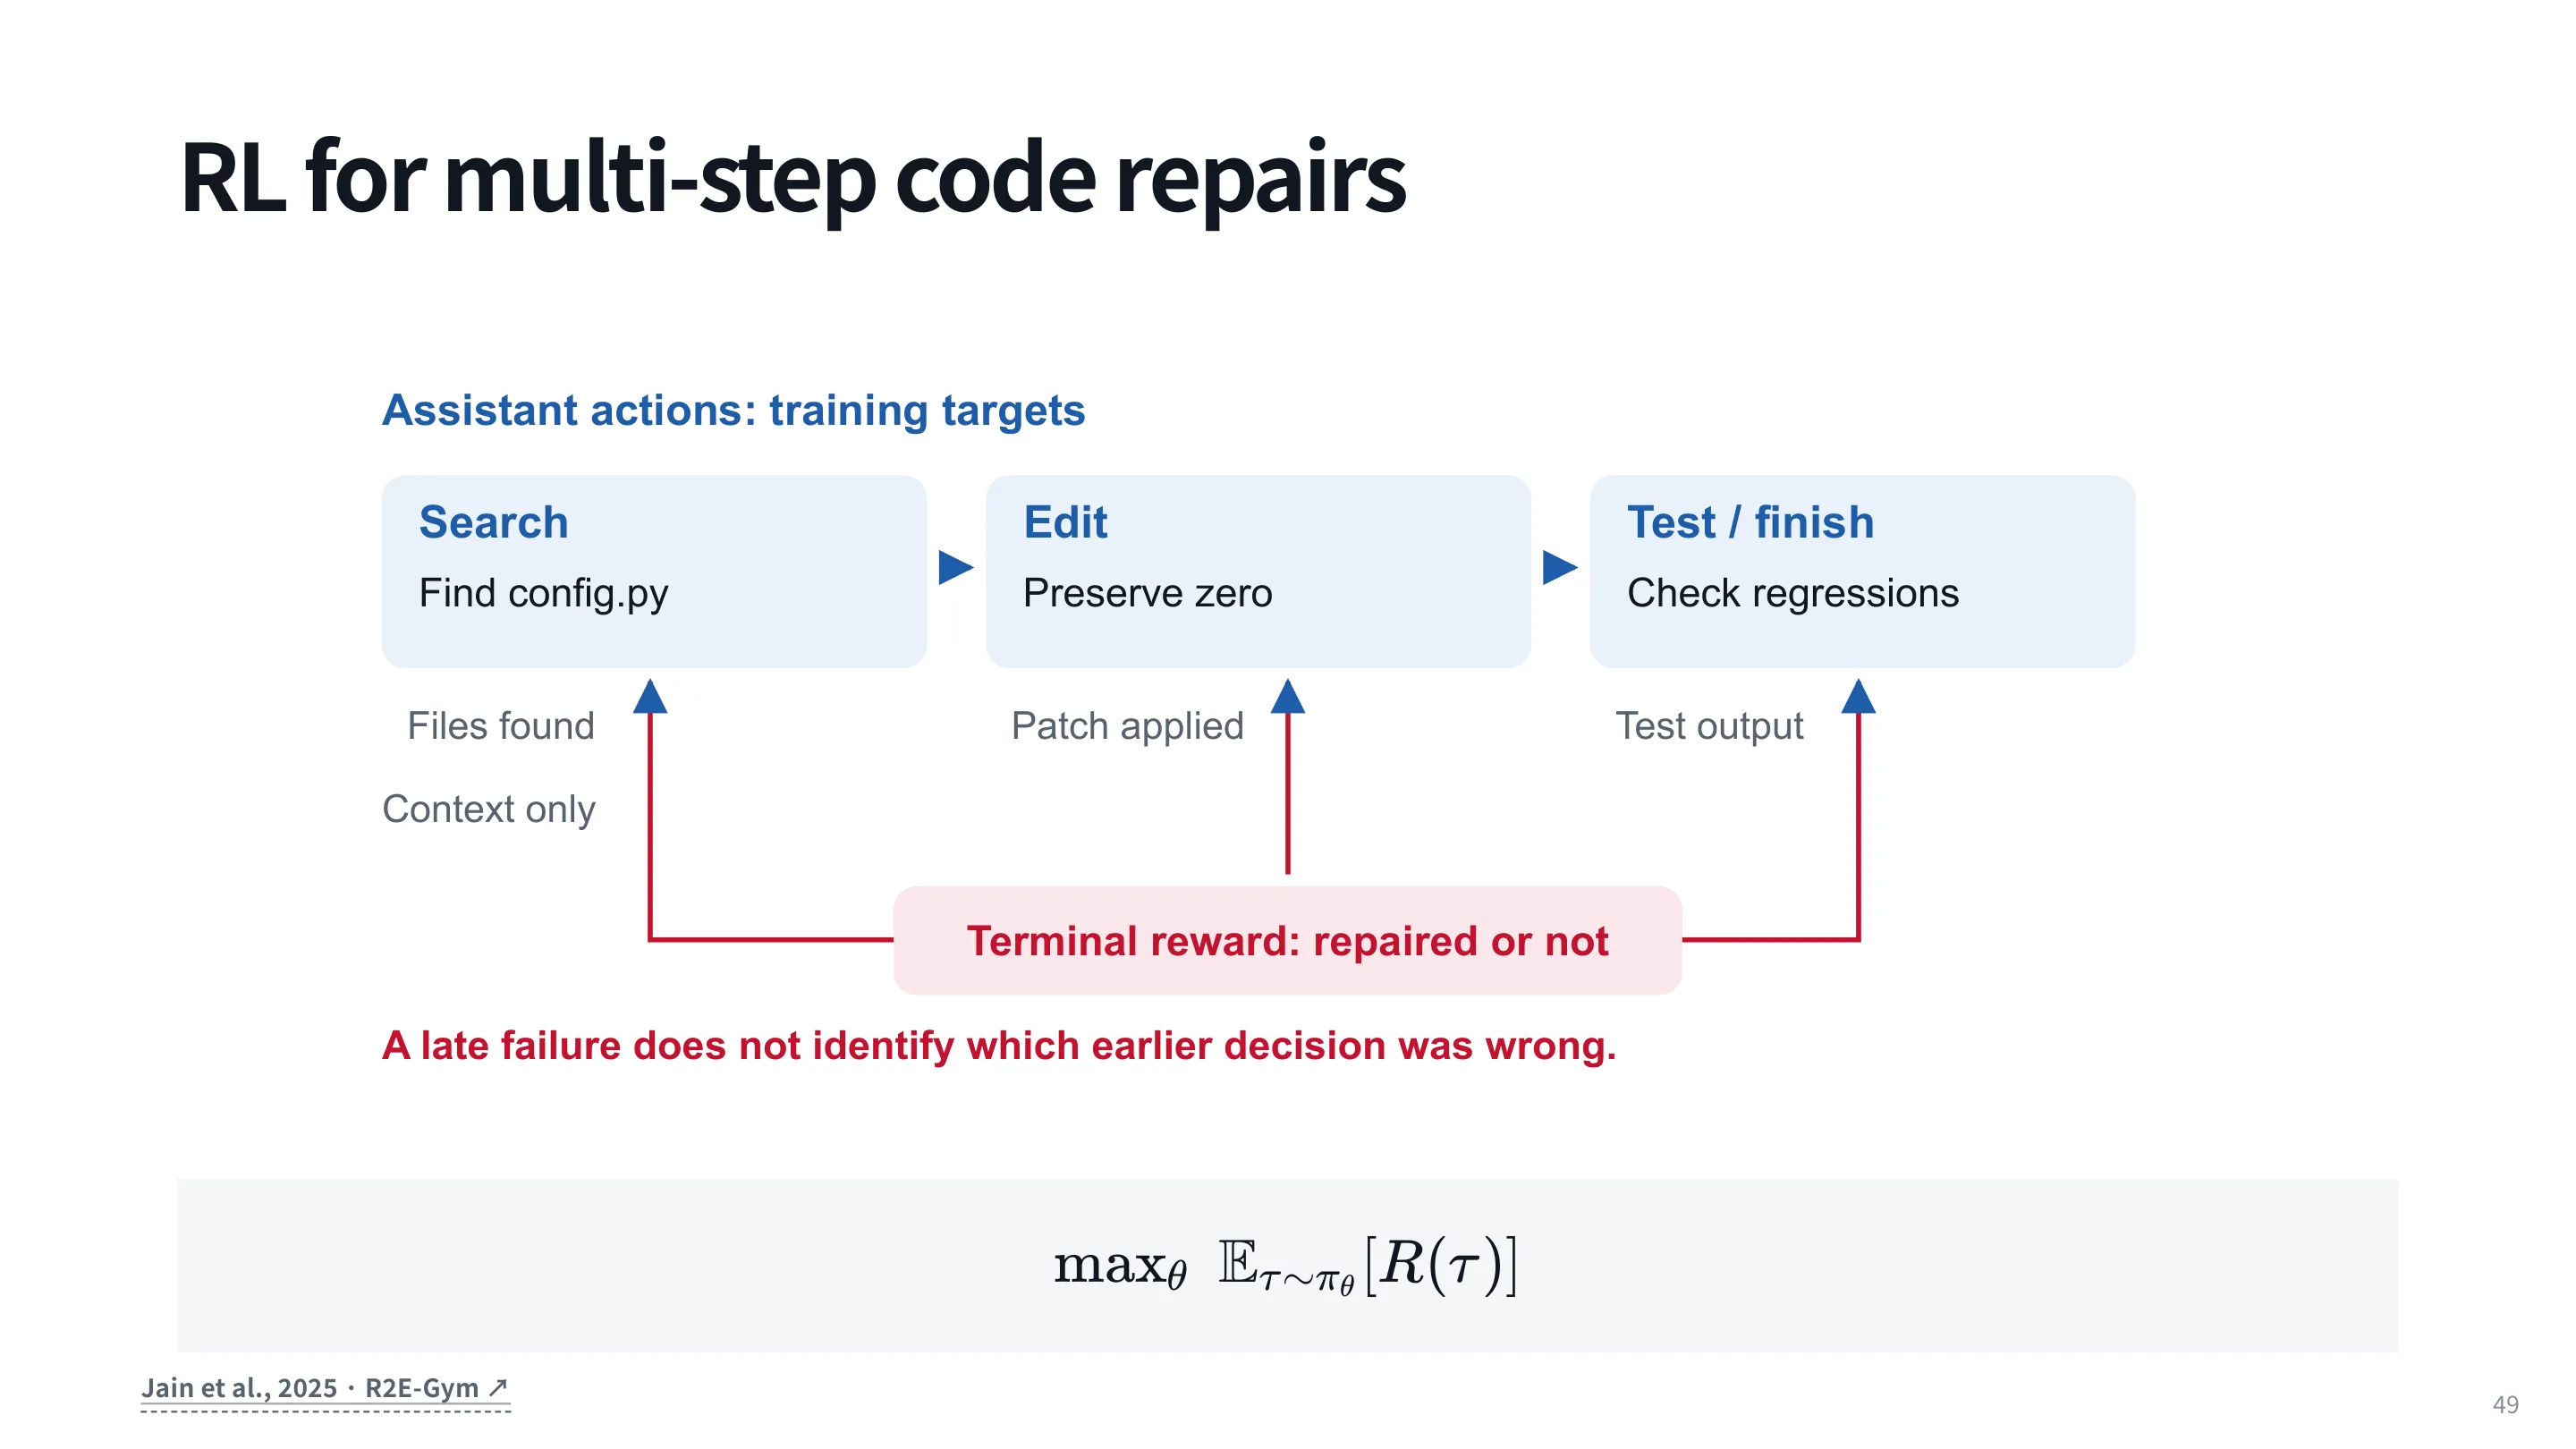
一条轨迹里可能有搜索、编辑、测试等多个动作;最后失败,可能是搜错文件、改错行、或测试命令不对。把最终 reward 分配给每一步,是 agent RL 的核心研究问题之一。
SWE-Gym 的思路是构造大量可执行环境,并在这些环境上做 RL(Slide 50)。讲师提到,一个原本约 11% 成功率的模型,仅用 500 个训练环境就能明显提升;此外还可以在推理时生成多个候选并用 learned verifier 选择,获得 inference-time scaling。
7.3 SWE-smith:用注入 bug 造数据
真实 PR 数据有限,SWE-smith 用变异测试的思路造数据(Slide 51):
- 准备一个所有测试都通过的 baseline;
- 只变异代码,不改测试;
- 保留“变异后测试失败”的样本;
- 把“修复这个失败”作为训练任务。
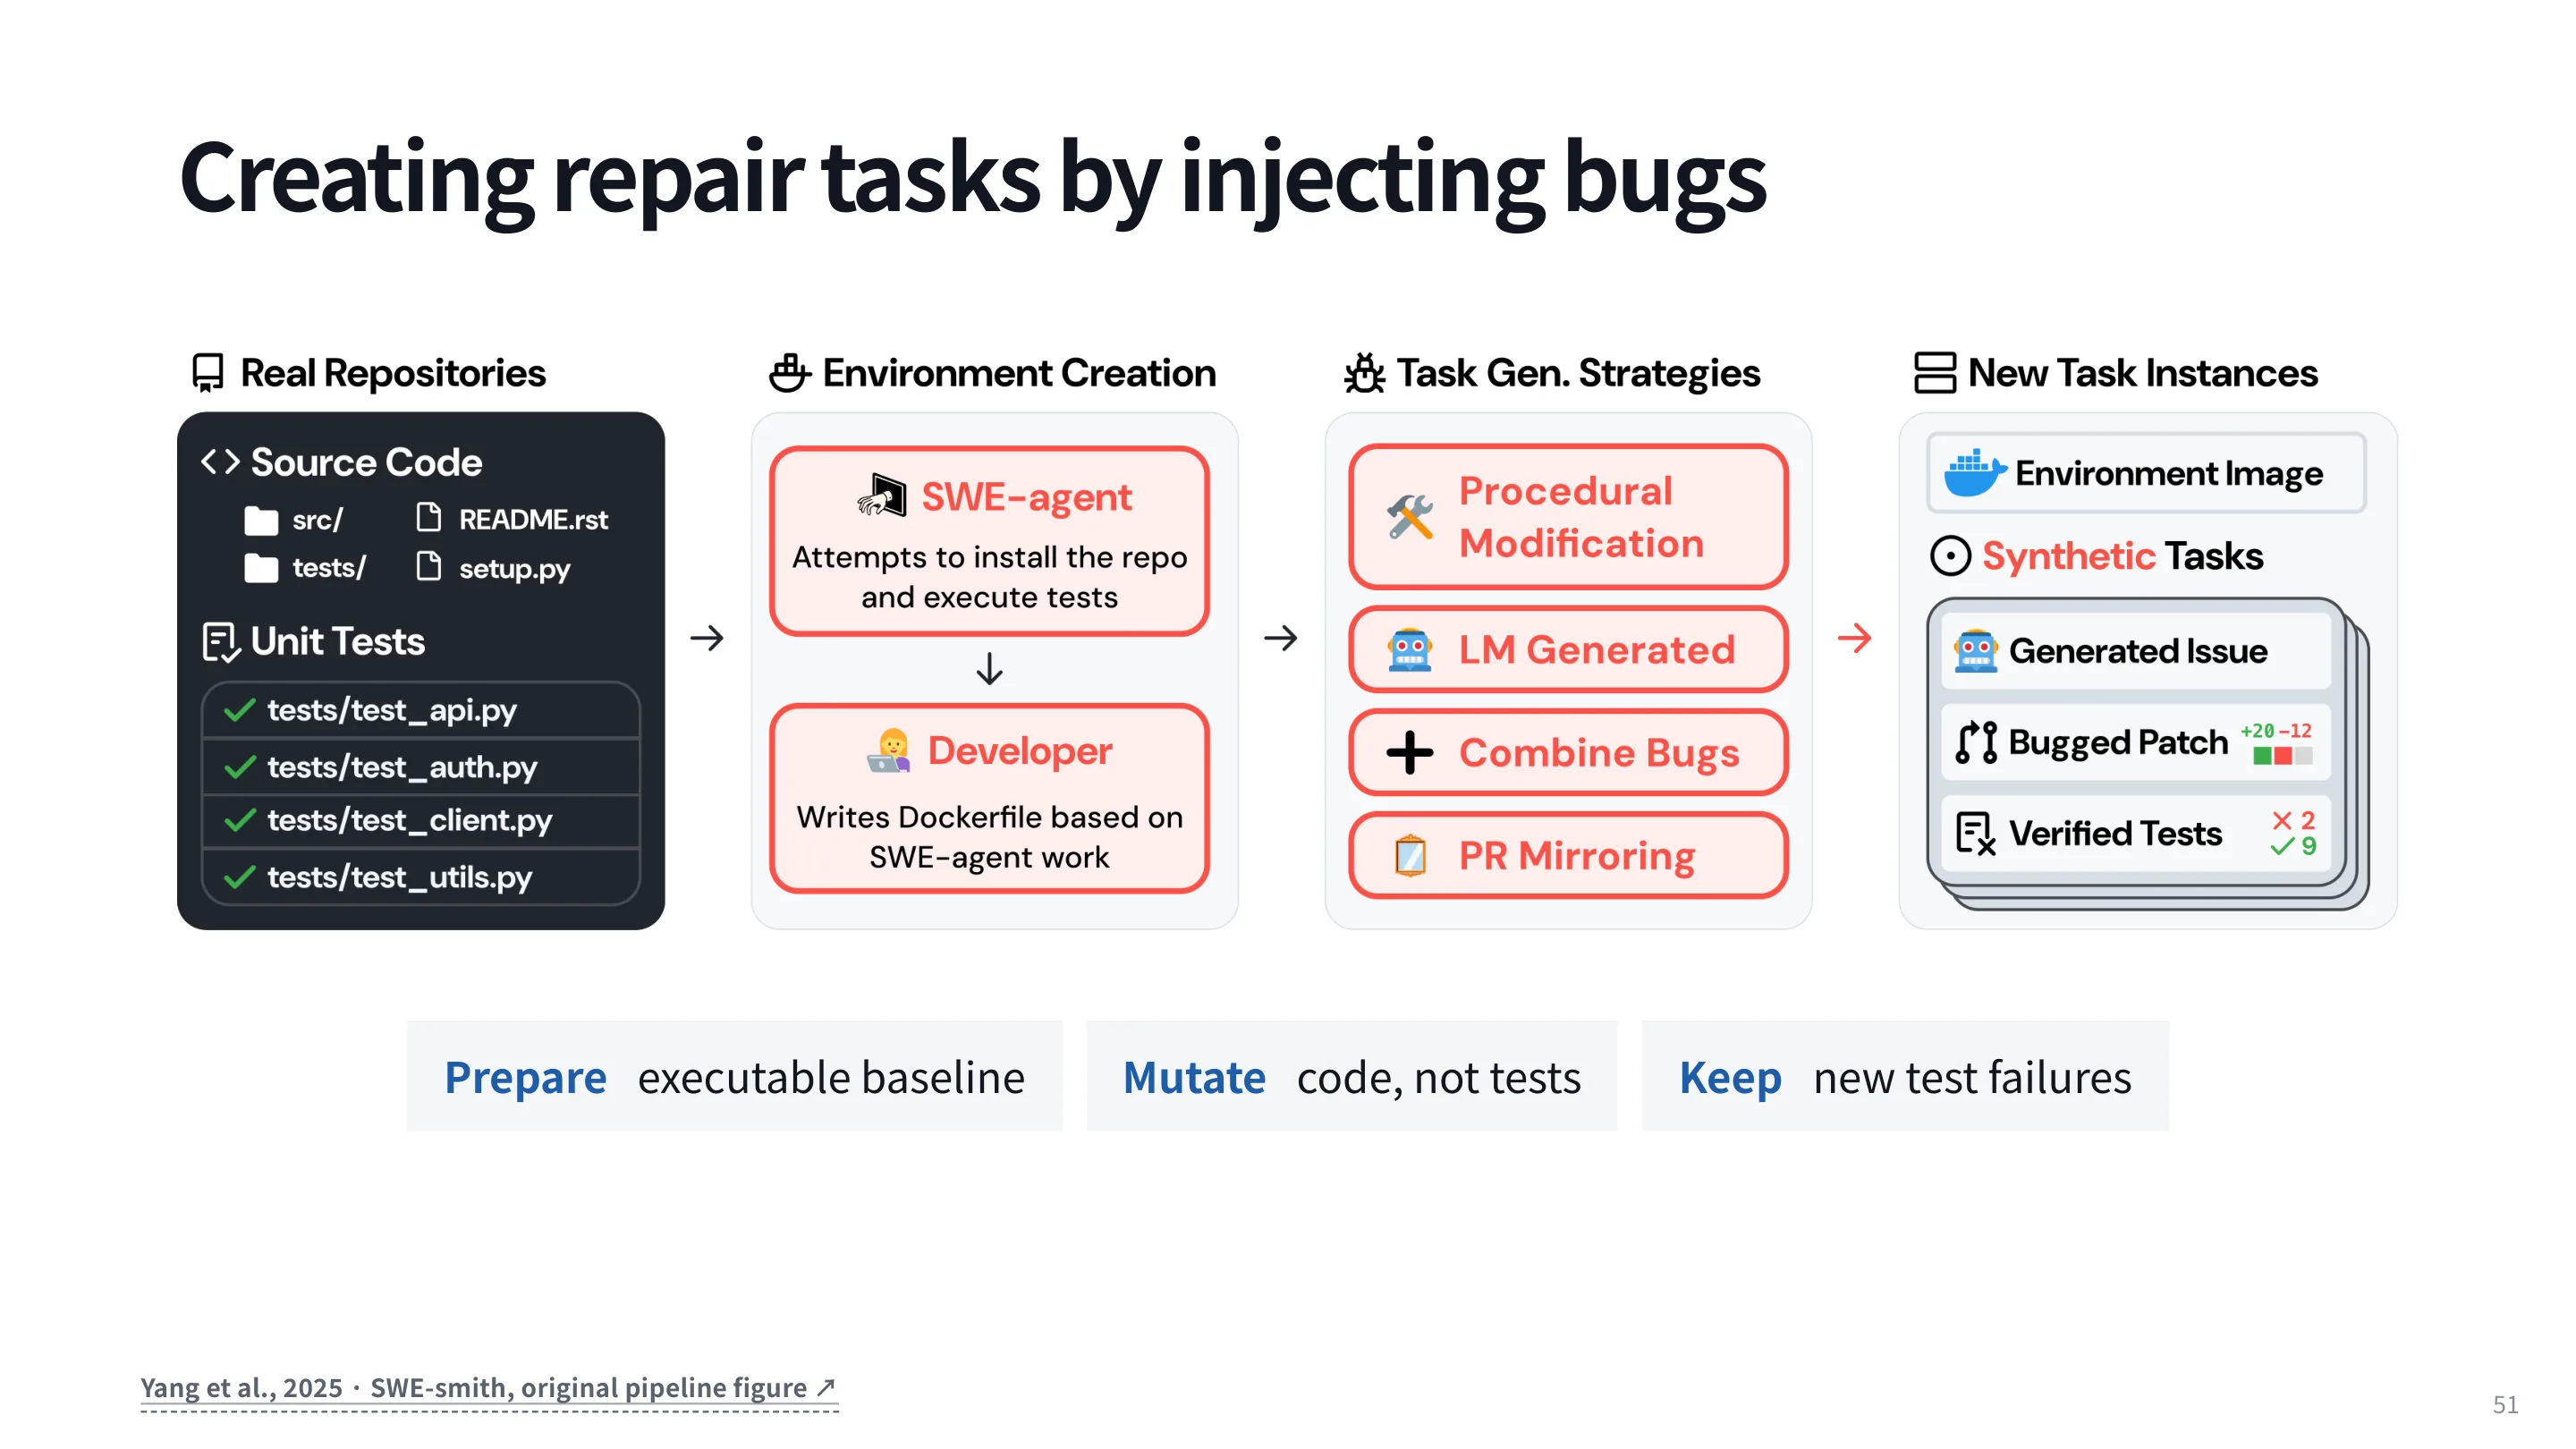
例子(Slide 52):
# 原始:0 是合法值
value = config.get("retries")
return 3 if value is None else value

# 变异:0 被当成 falsy
value = config.get("retries")
return 3 if not value else value优点:
- 非常轻量,几乎可以无限生成;
- 不需要真实 PR,也不依赖人工标注;
- 可以跨语言扩展(Multi-SWE-bench、SWE-bench Multilingual)。
缺点:
- 这些 bug 是人工注入的,不一定代表真实开发中的问题分布;
- 变异可能产生不自然或不可修复的代码;
- 测试仍然是唯一的 verifier,测试弱则数据质量差。
7.4 多语言与 multi-harness
跨语言不是“把 Python 换成 Rust”这么简单(Slide 53):项目配置、依赖管理、测试命令都不同。
| 语言 | 配置文件 | 测试命令 |
|---|---|---|
| Python | pyproject.toml | pytest |
| TypeScript | package.json | npm test |
| Rust | Cargo.toml | cargo test |
Multi-harness training 则解决“模型只适配一个 agent 框架”的问题(Slide 54)。这里的 harness 指 prompts + tools + agent loop + context management:
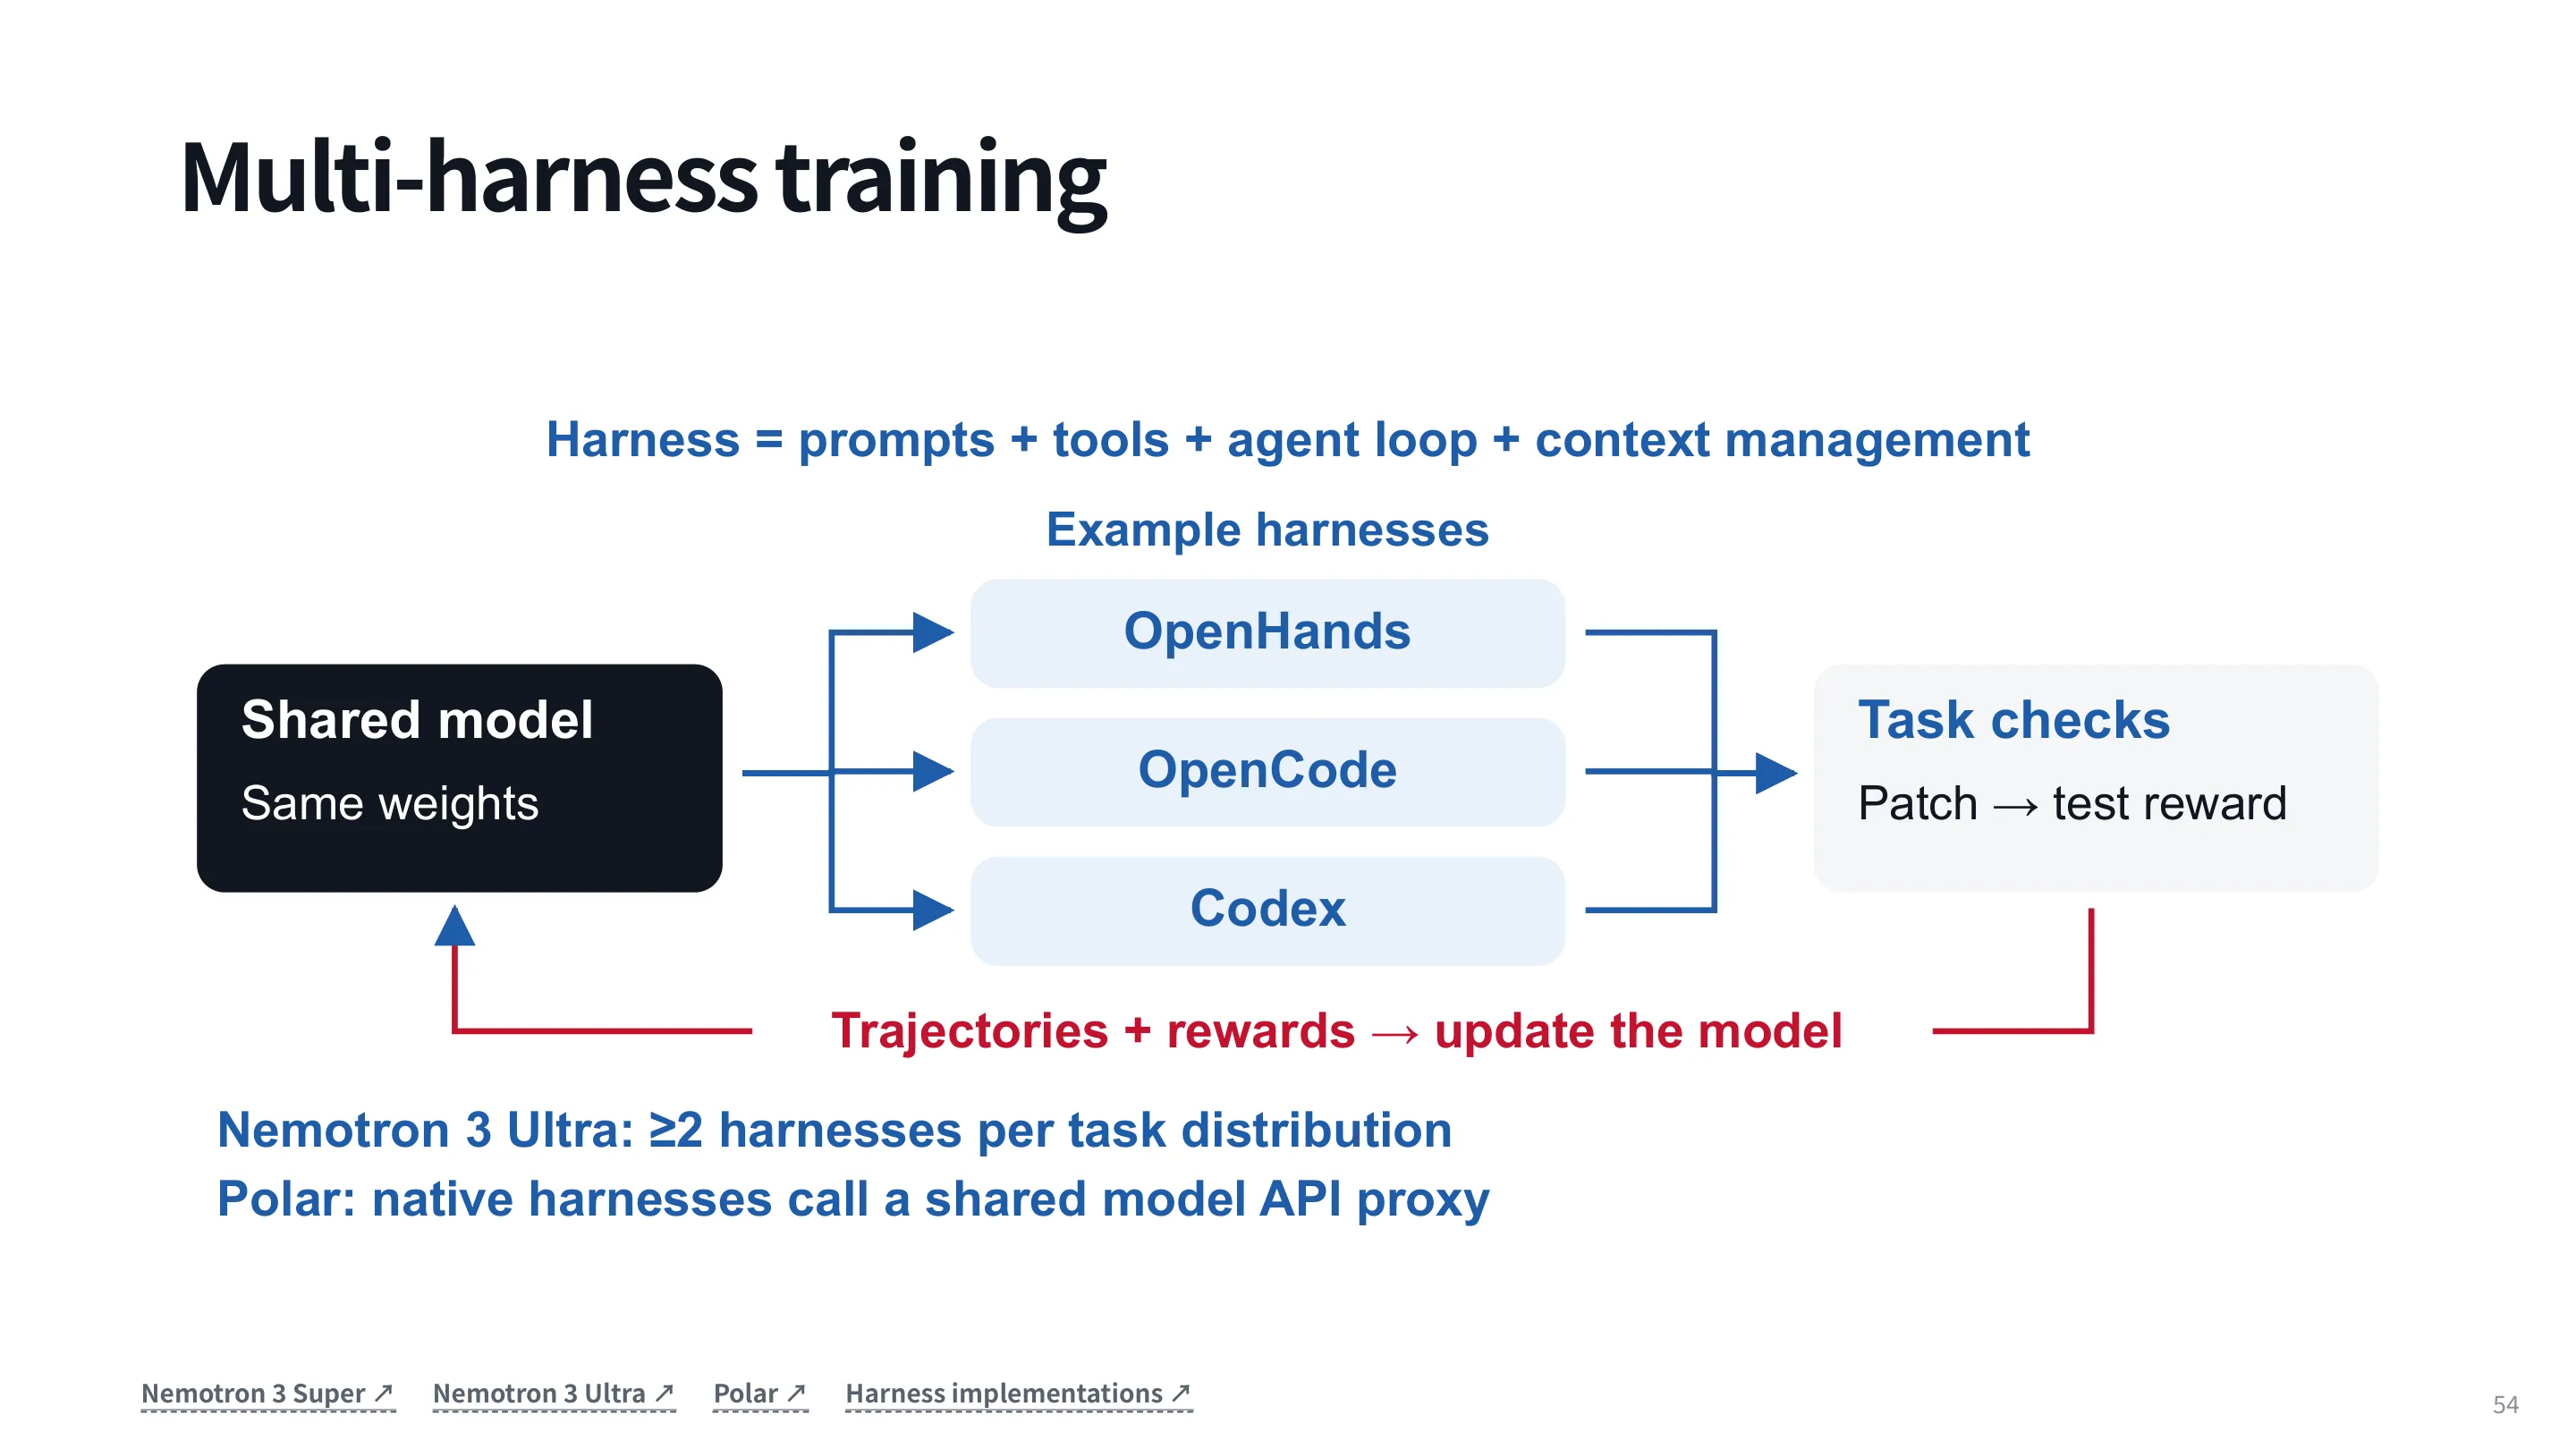
- 同一模型权重,在不同 harness 下表现可能差异很大;
- 训练时混合多个 harness,让模型学会不同的 edit format、工具约定和上下文管理方式;
- Nemotron 3 Ultra 的做法是每个任务分布至少用 2 个 harness;
- Polar 则让原生 harness 调用共享的 model API proxy,统一训练信号。
8. 前端开发:在浏览器里验证
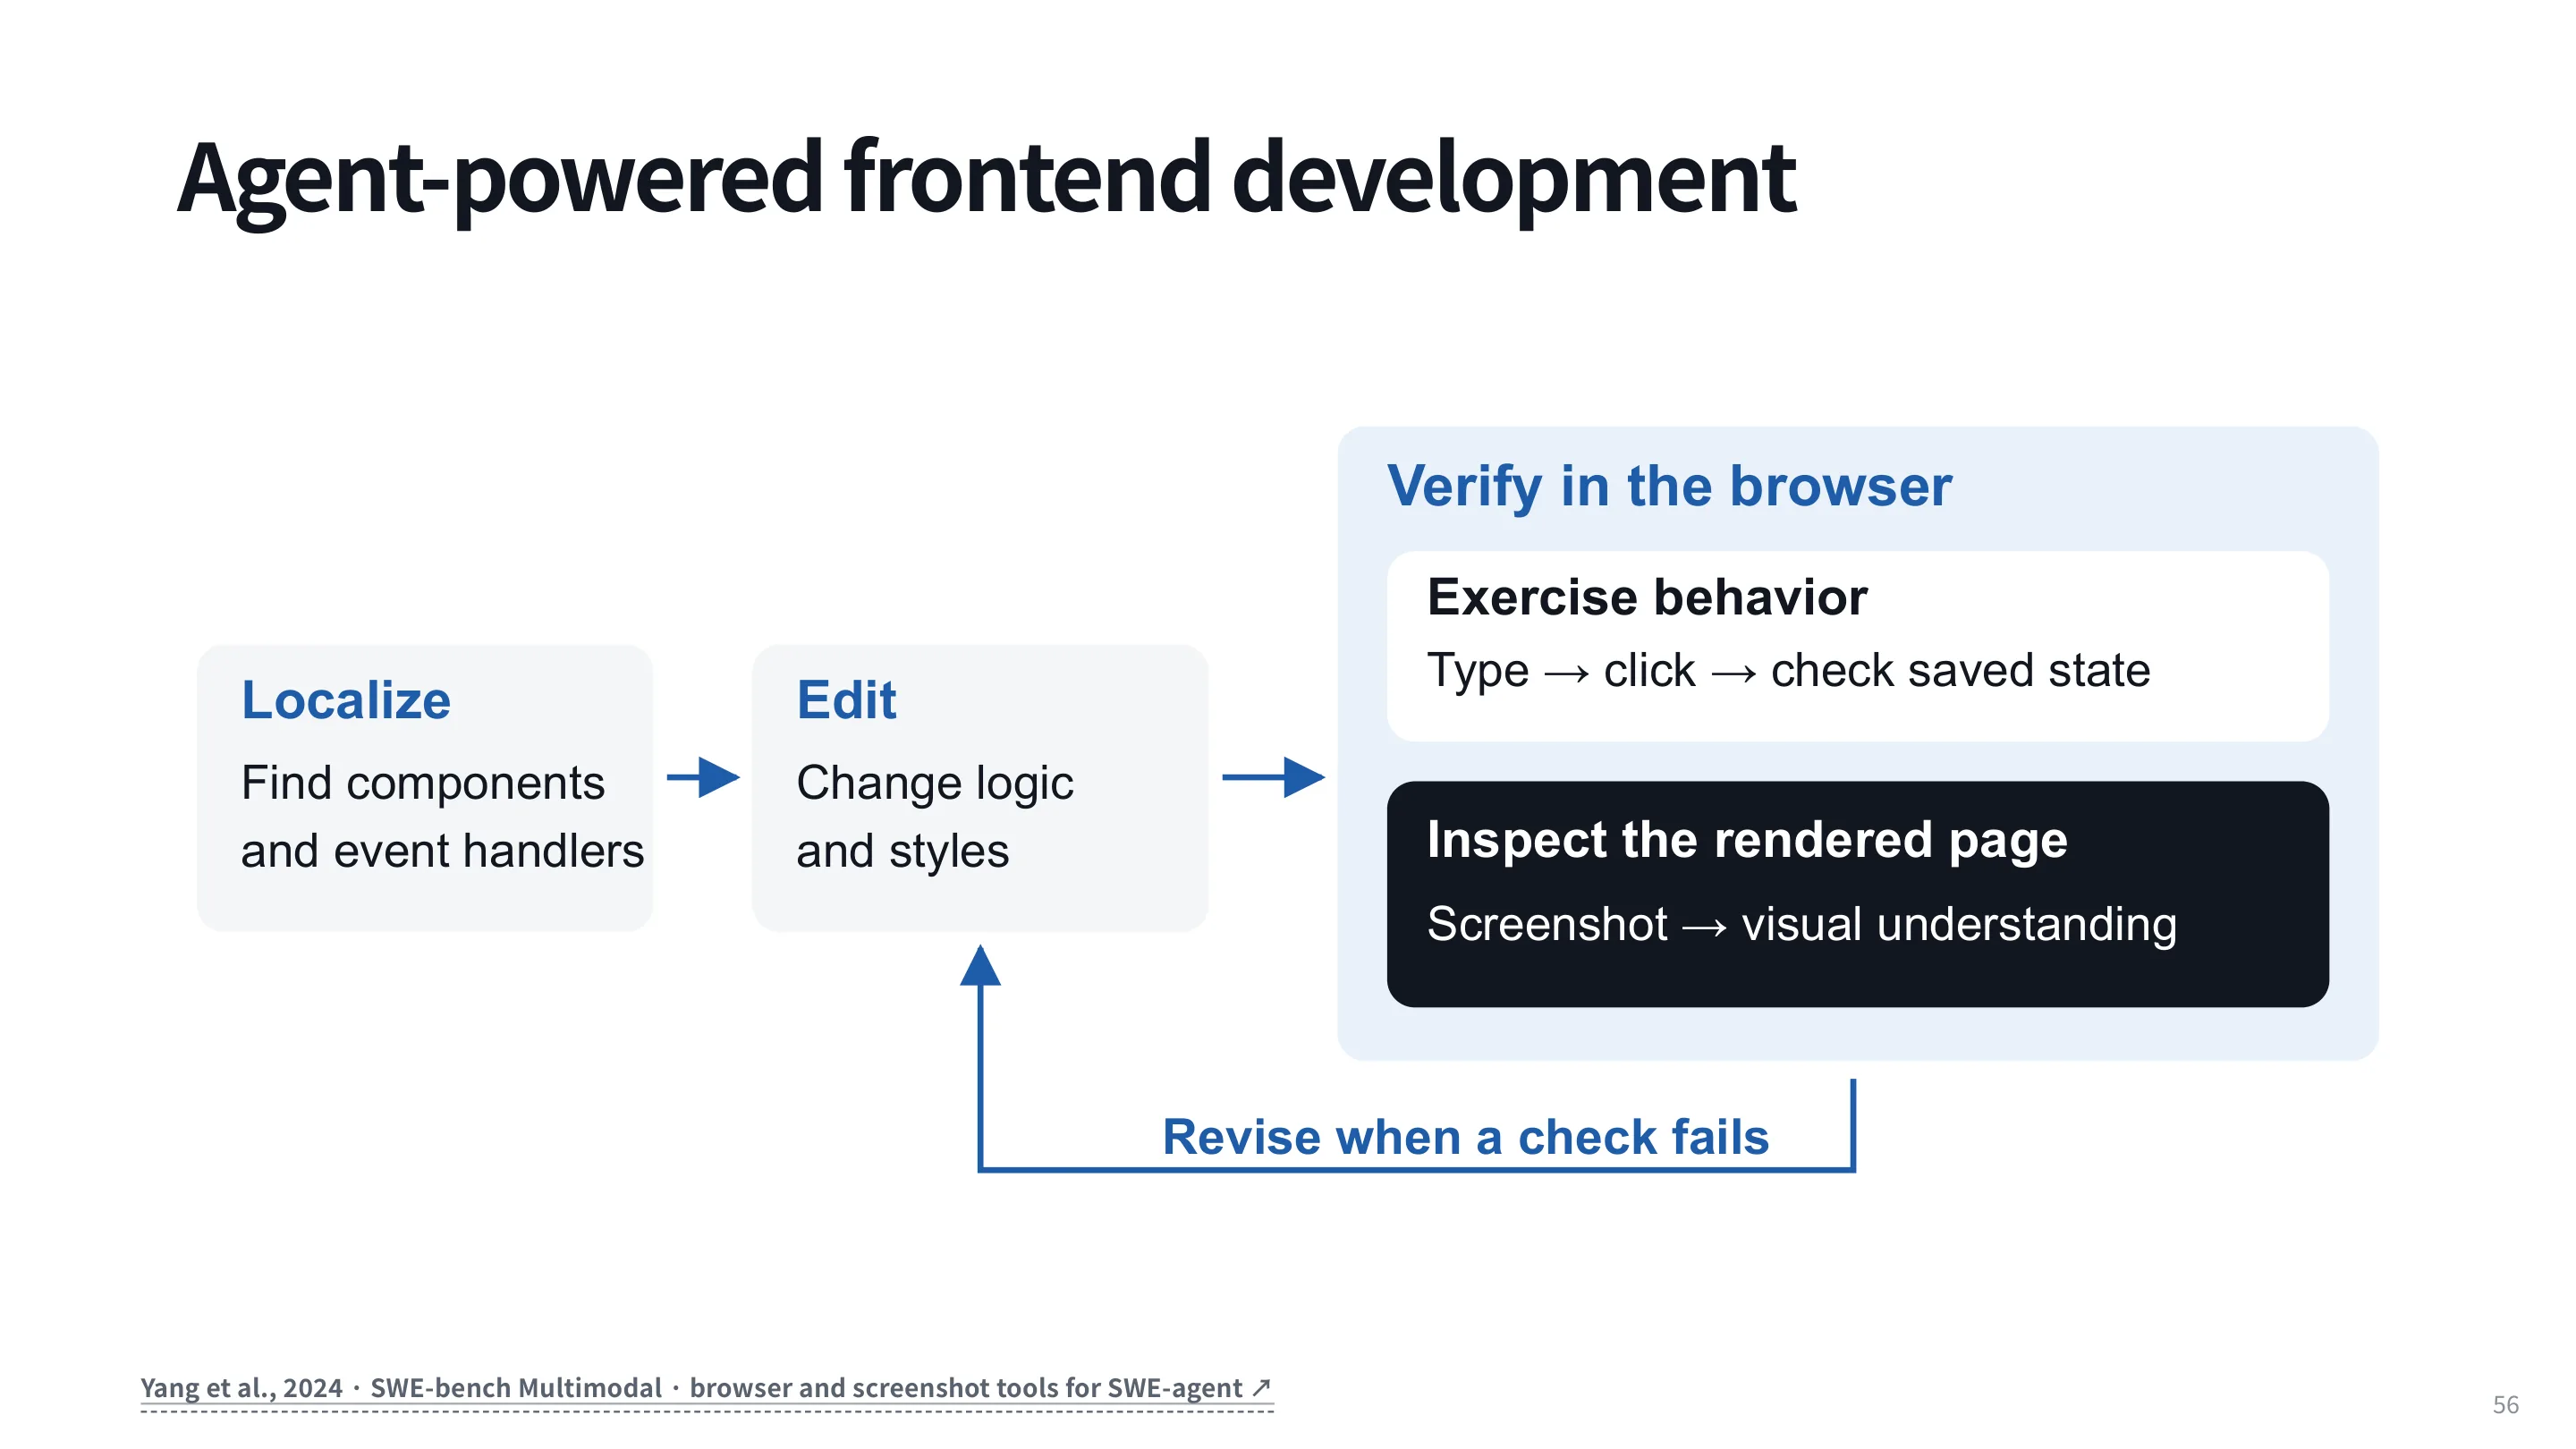
前端任务的循环仍然是 localize → edit → verify,但 verify 发生在浏览器里(Slide 56):
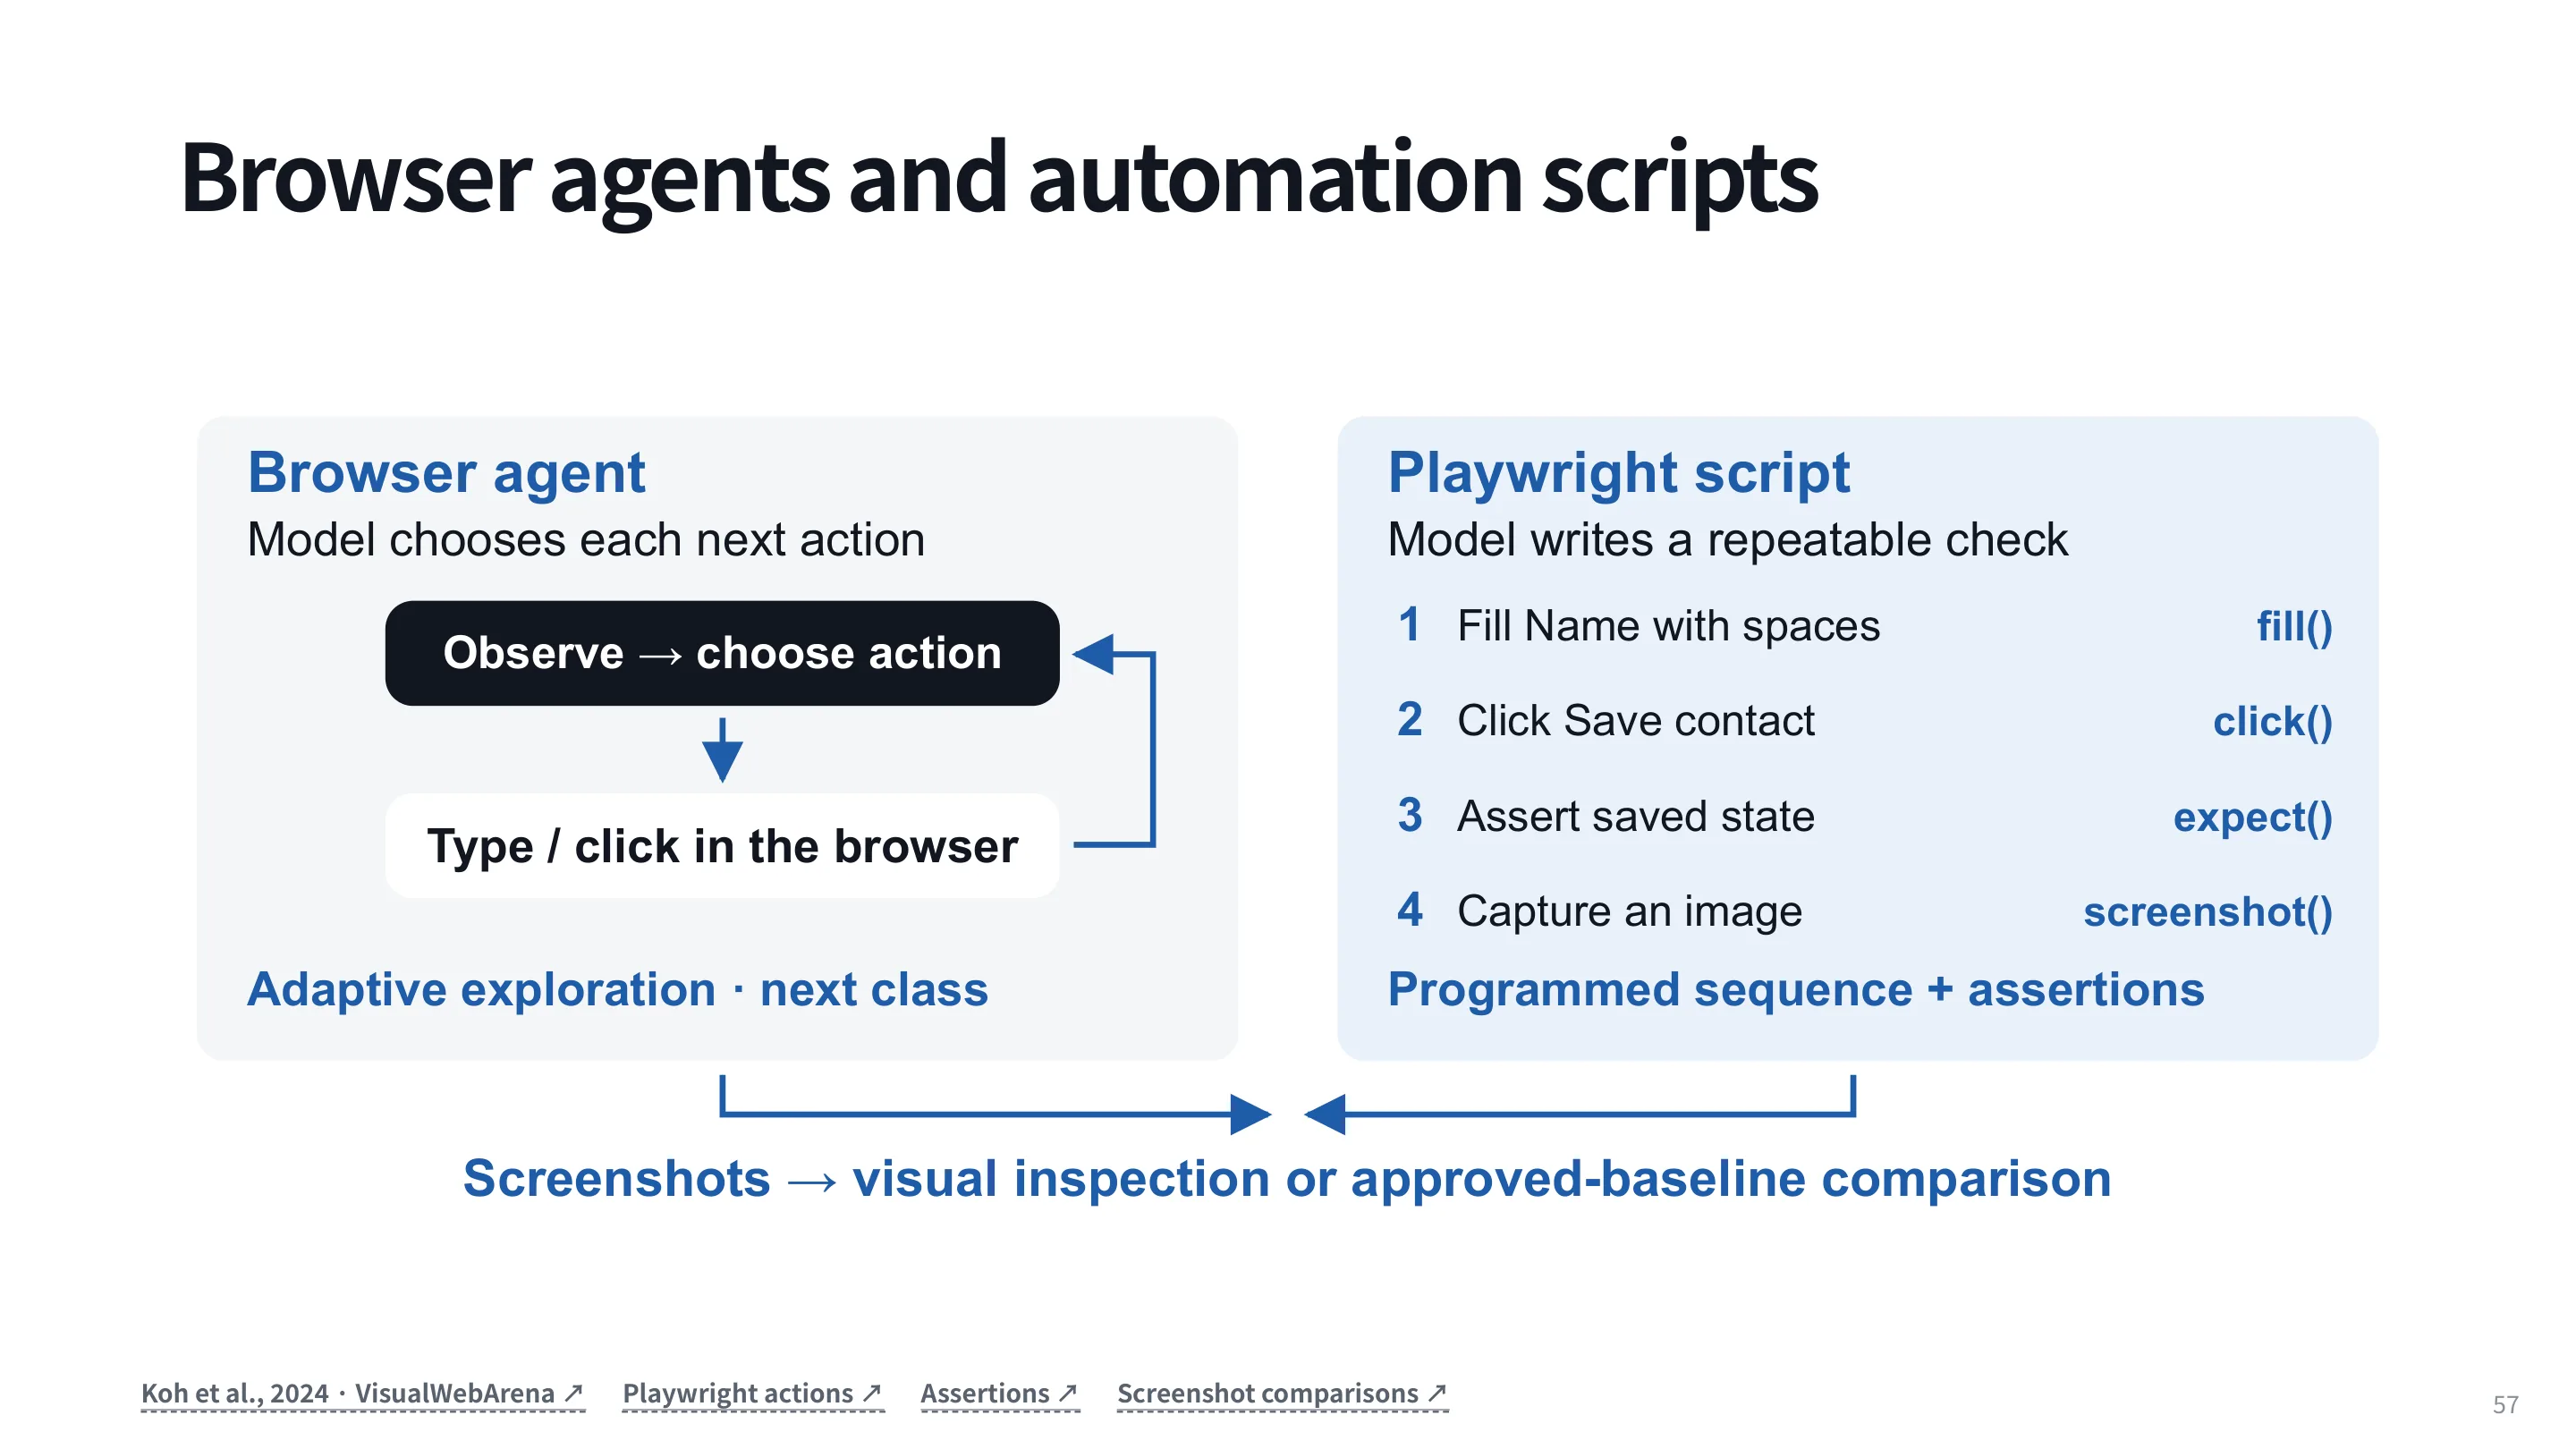
验证方式有两类(Slide 57):
- Browser agent:模型自己观察页面、选择动作、点击/输入,适合探索性任务;
- Playwright script:模型写一段可重复的测试脚本,用
fill()、click()、expect()、screenshot()做断言。
一个具体例子:表单允许空名字保存(Slide 58)。修复是把 value.length 改成 value.trim().length,然后验证:
- 行为:空名字被拒绝,合法名字仍可保存;
- 外观:错误提示在 Name 旁边可见、可读;
- 回归:已有测试全部通过。
讲师特别提醒:issue 里有图片,不代表评测要按图片相似度打分。图片是输入/现象的一部分,最终仍然要用行为测试验证 patch。SWE-bench Multimodal 也是 test-based evaluation,而不是 pixel similarity。
一个反直觉的观察:GLM 5.2 不是多模态模型,却在 frontend design arena 上排到第一。这说明前端能力不只取决于视觉输入,代码生成、布局知识和审美偏好同样重要;但讲师仍认为多模态行为对前端 agent 很重要。
9. 更广泛的软件工程
软件开发生命周期不只包含“改代码”(Slide 61):
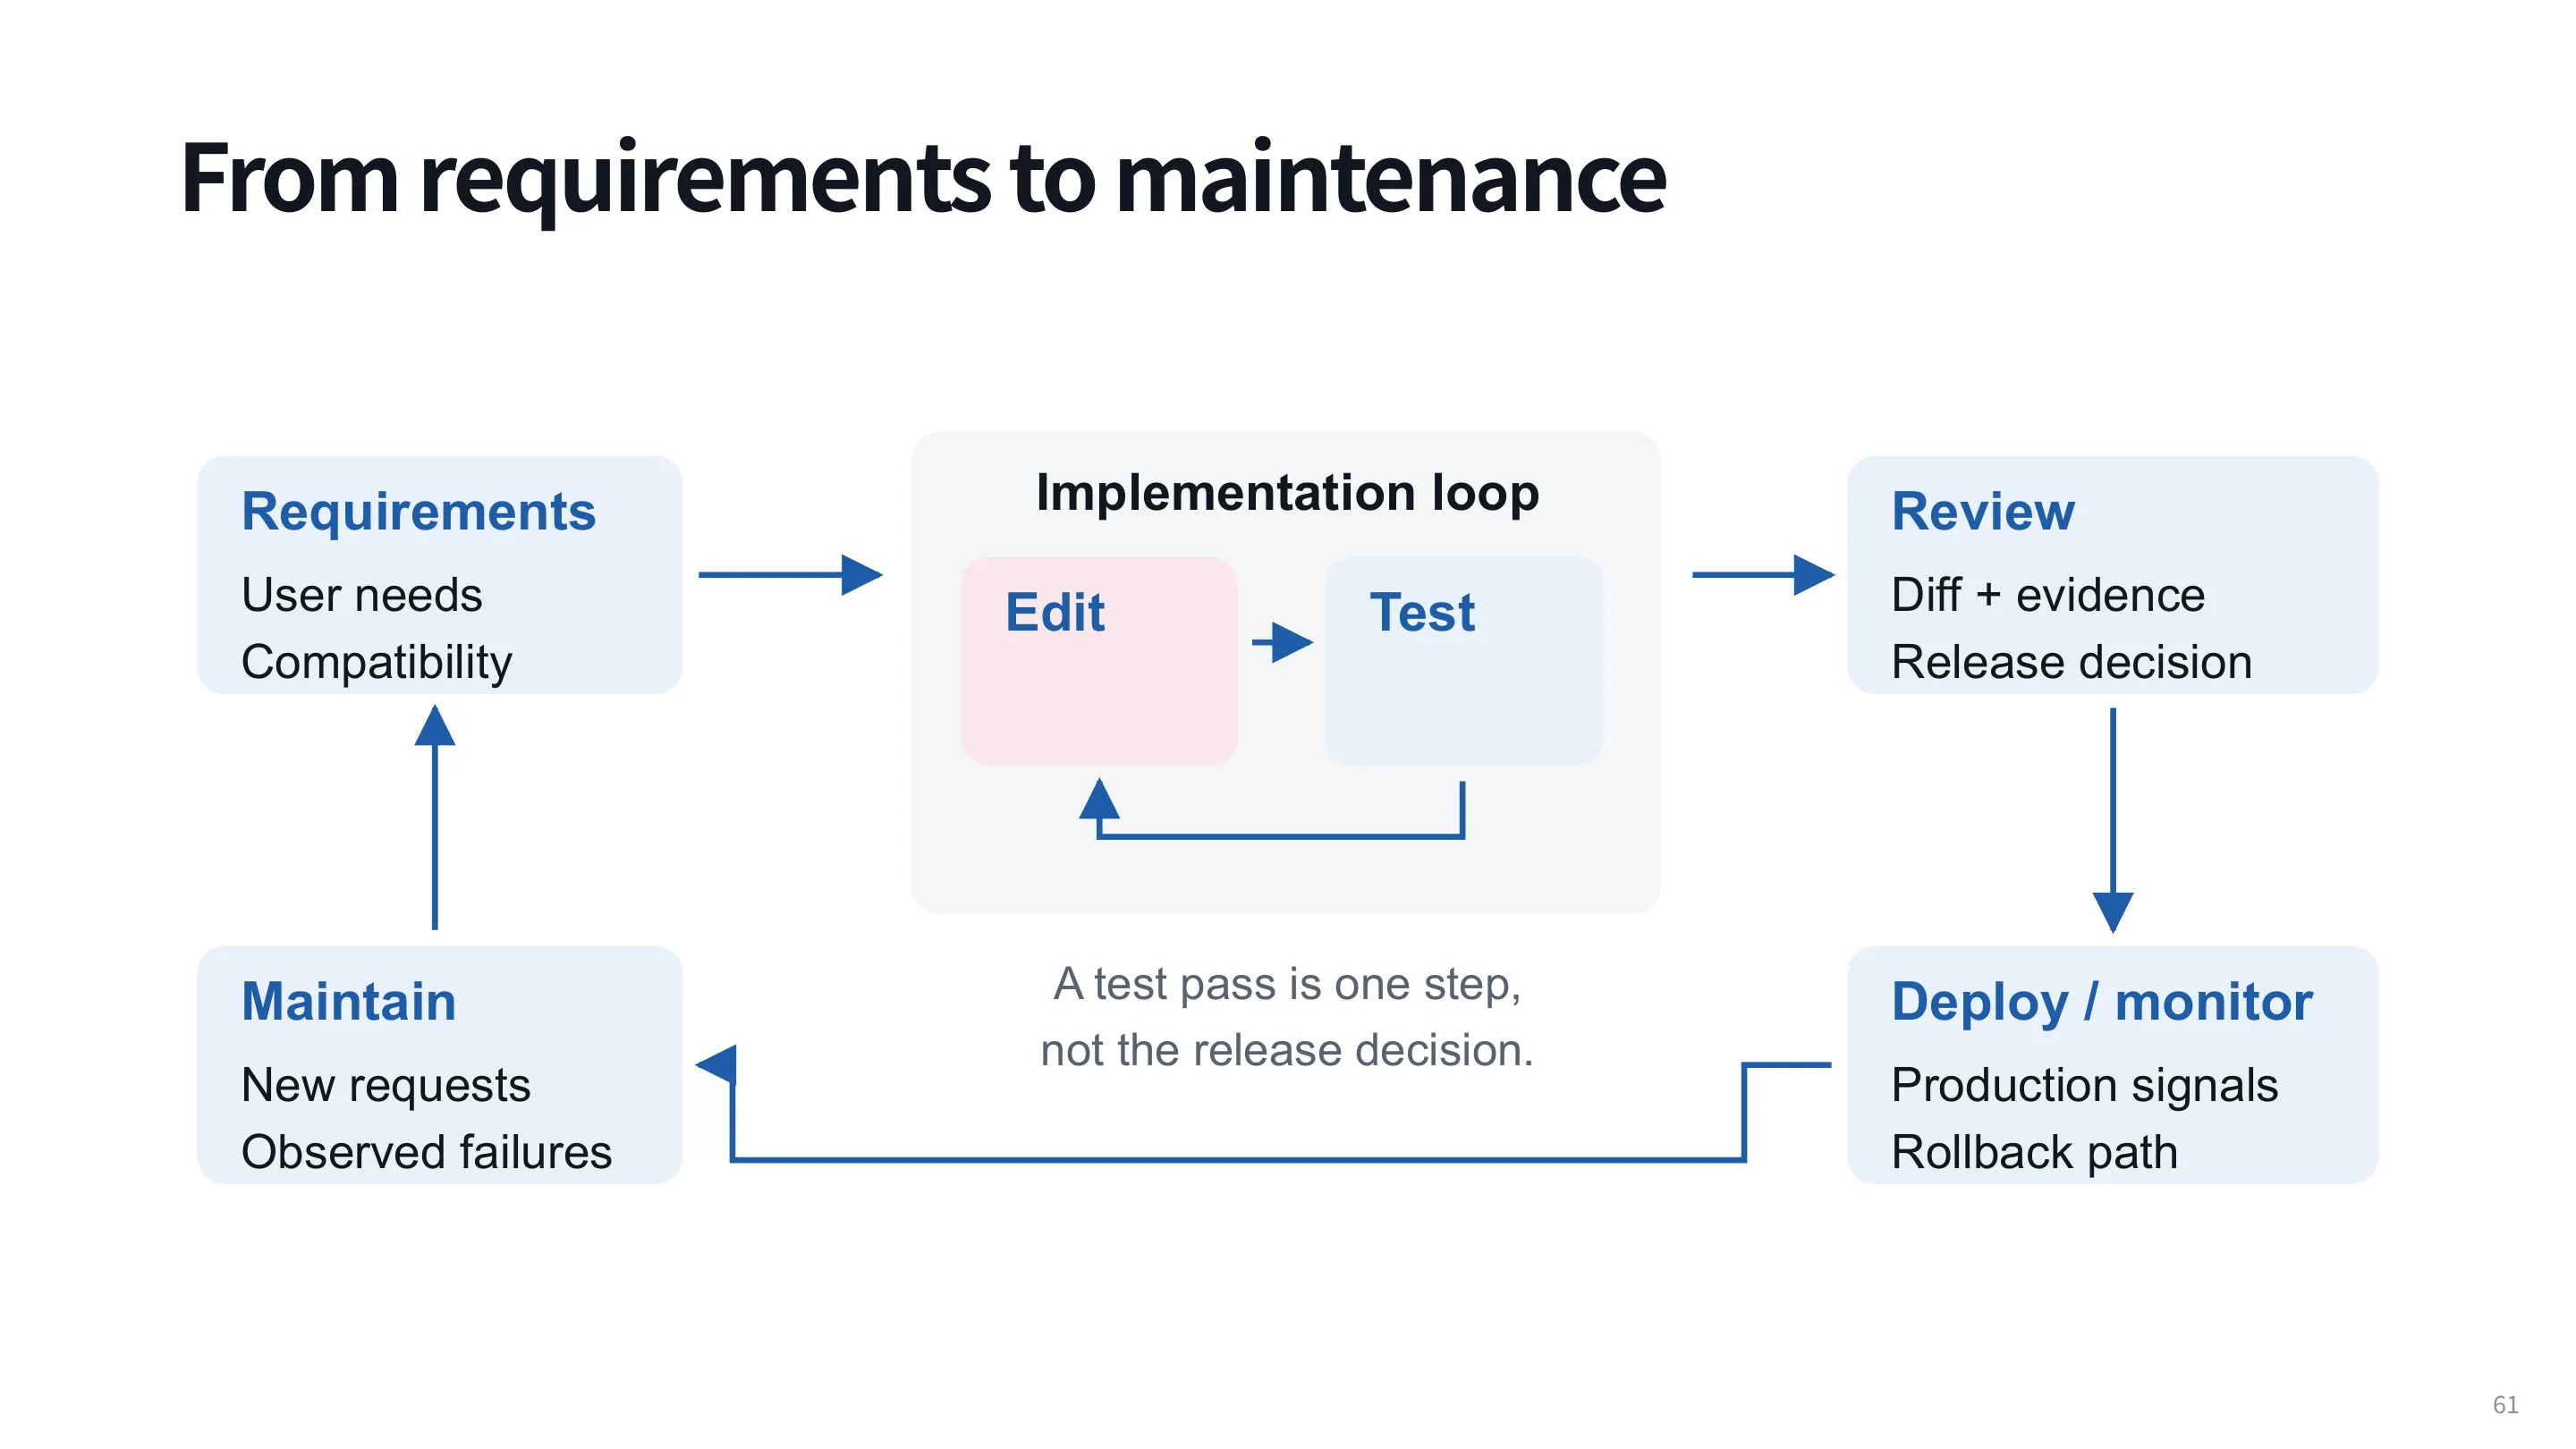
- Inner loop:编辑、测试、调试、修复;
- Outer loop:需求、代码评审、部署、监控、维护、回滚。
Graham 引用 Microsoft 2019 年的开发者时间调查(5,928 个自报工作日,Slide 62):
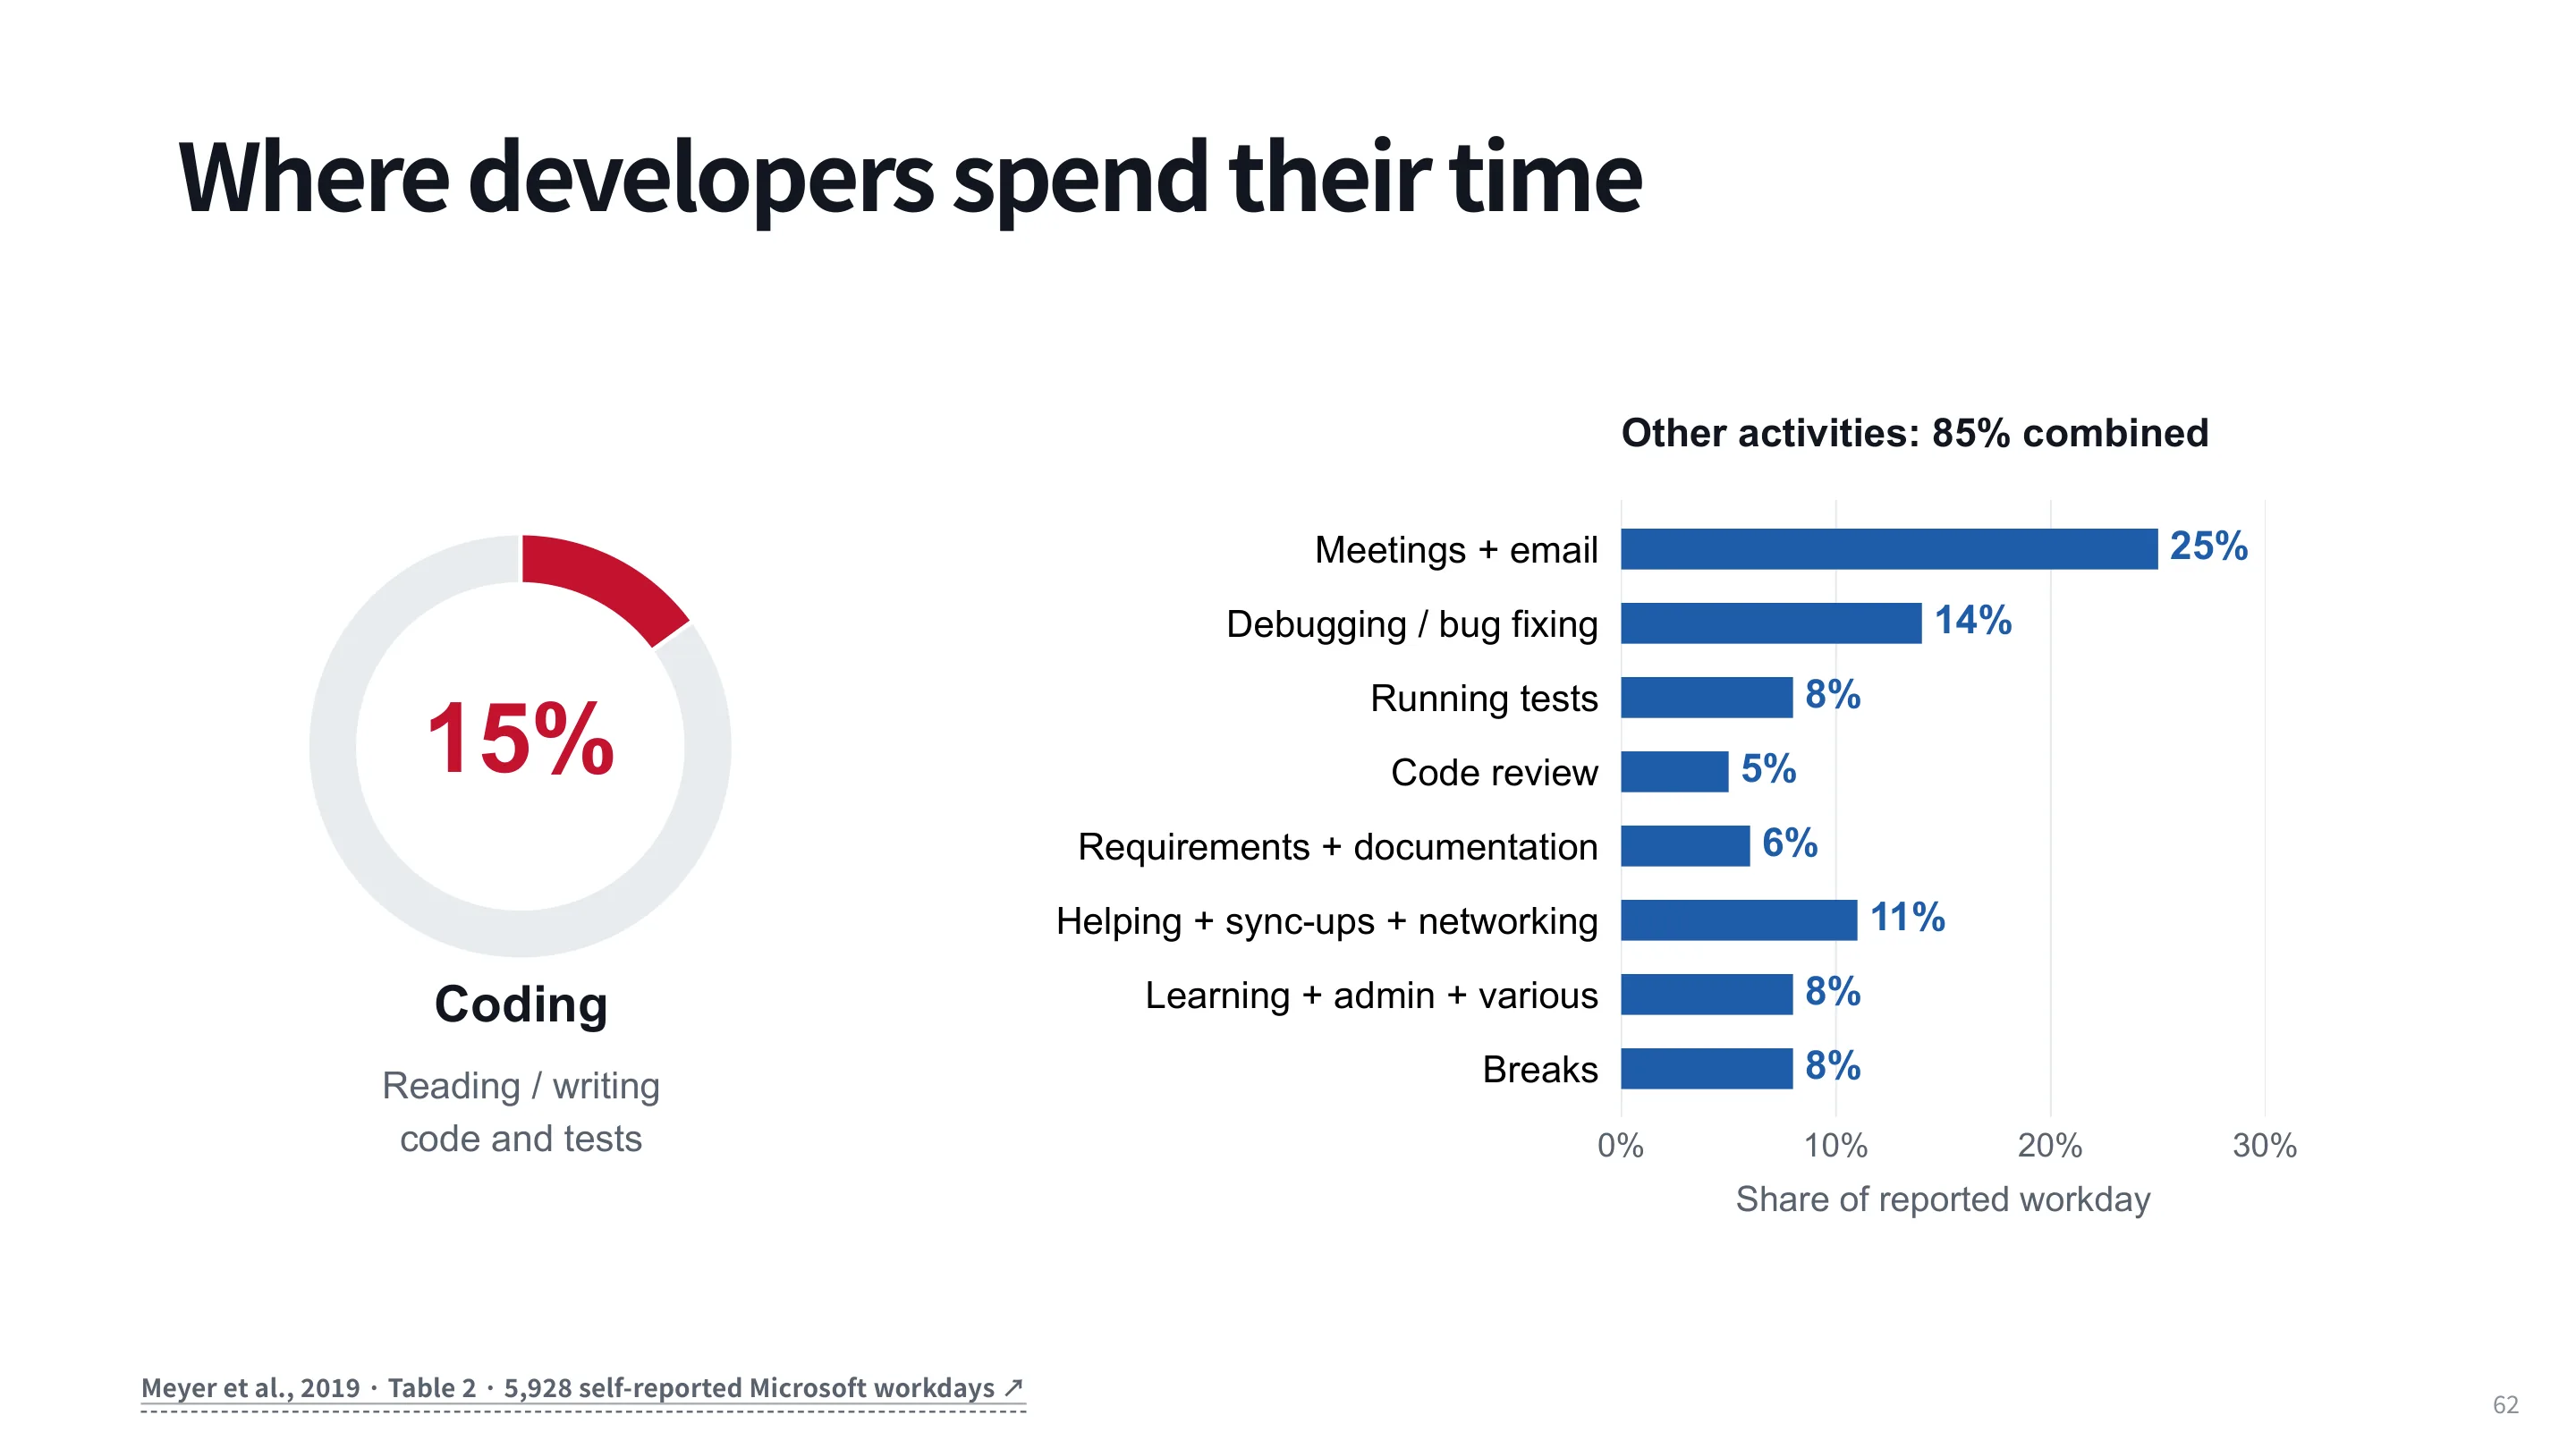
这解释了为什么“会修 issue”只是 coding agent 的起点。真实软件工程中还有大量沟通、评审、运维工作,而它们的训练数据和验证器都更难构造。
不同软件工程任务的形态(Slide 63):
| 任务 | 产物 | 环境 / 验证器 | Horizon |
|---|---|---|---|
| Repair | Patch | 仓库 / 回归测试 | 一个 issue |
| Library creation | Implementation | Scaffold / package tests | 多个函数 |
| Test generation | New test | Buggy + fixed versions / discrimination | 一个行为 |
| CI repair | Code / config | Workflow / required checks | 一次 build |
| Evolution | Accumulated changes | Persistent app / milestone + regressions | 多个依赖任务 |
几个代表性工作:
- Localization(CodeScout):只做“定位”,在文件/模块/函数三级算 F1;比完整修复更可训练,适合小模型(Slide 64);
- App creation(ViBench):Zero-to-One 15 个应用、Vibe-on-Ref 45 个、Vibe-on-Vibe 45 个,用人工编写的 browser test plans 验证(Slide 65);
- Library implementation(Commit0 / ProgramBench):Commit0 给 scaffold + tests,补全函数体;ProgramBench 给一个参考二进制,通过 probe 输入输出反推行为并重写实现(Slide 66);
- Maintenance(SWE-Milestone):在一个 epoch 里连续解决多个 issue,评估是否把代码库越改越乱(Slide 67);
- Test generation(SWT-Bench):给 buggy/fixed 版本,生成能区分两者的测试(Slide 68);
- CI repair:修构建配置,例如 Node 16 不满足
>=18,要把setup-node改成 20(Slide 69)。
技能迁移也已经被验证(Slide 72)。Hybrid-Gym 在多种软件工程任务上训练 32B 模型,再迁到 held-out 任务:
| 任务 | Base 32B | Hybrid-Gym 32B |
|---|---|---|
| SWE-bench Verified(Repair) | 7 | 32.4 |
| SWT-Bench Verified(Test generation) | 9.01 | 16.86 |
| Commit0 Lite(Library building) | 8.34 | 13.45 |
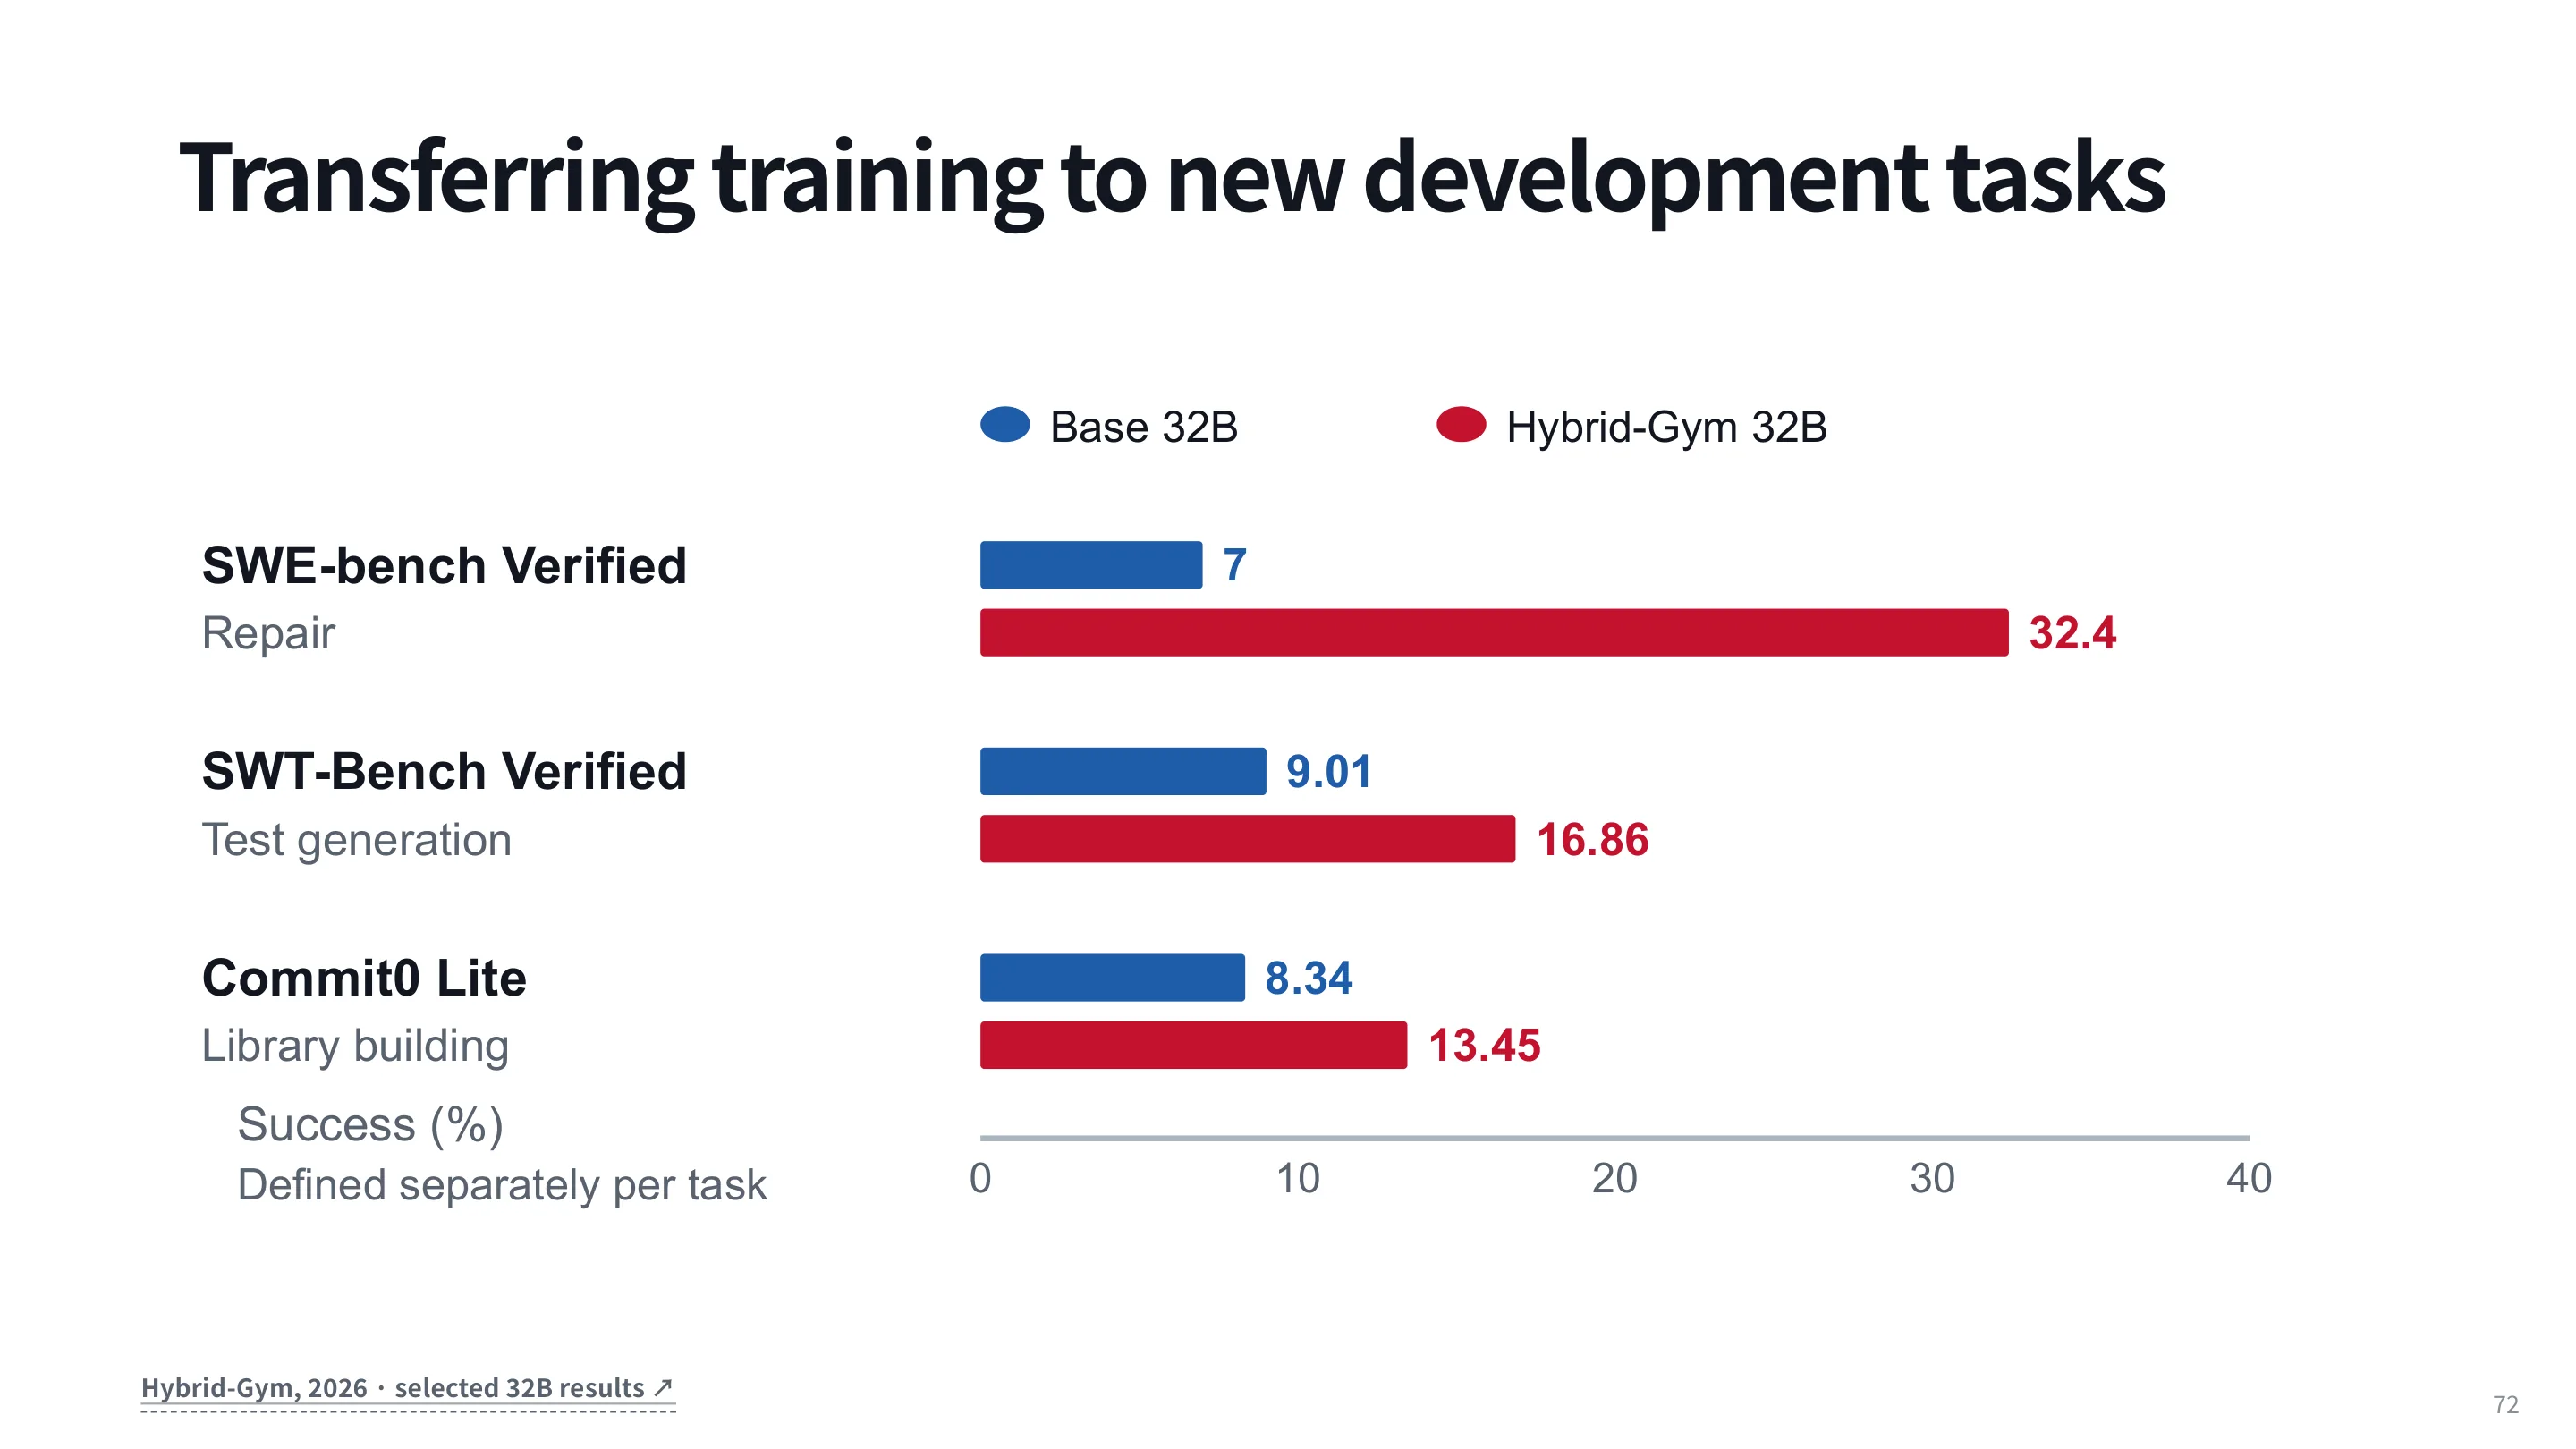
这说明“软件工程技能”并不是完全任务特定的:定位、读代码、写测试、实现函数之间存在可迁移的共性。对课程项目来说,这也是一个值得探索的方向。
10. 预测代码行为(讲师未展开)
说明
这一节对应 Slides 73–79。由于课堂时间不够,Graham 明确说“不展开 code world models”,只保留了 slides。以下内容按课件整理,属于补充阅读,不是课堂讲解。
Agent 每执行一个动作,环境会返回一个 observation。World model 试图学习 :给定历史 h 和动作 a,预测执行结果(Slide 74)。
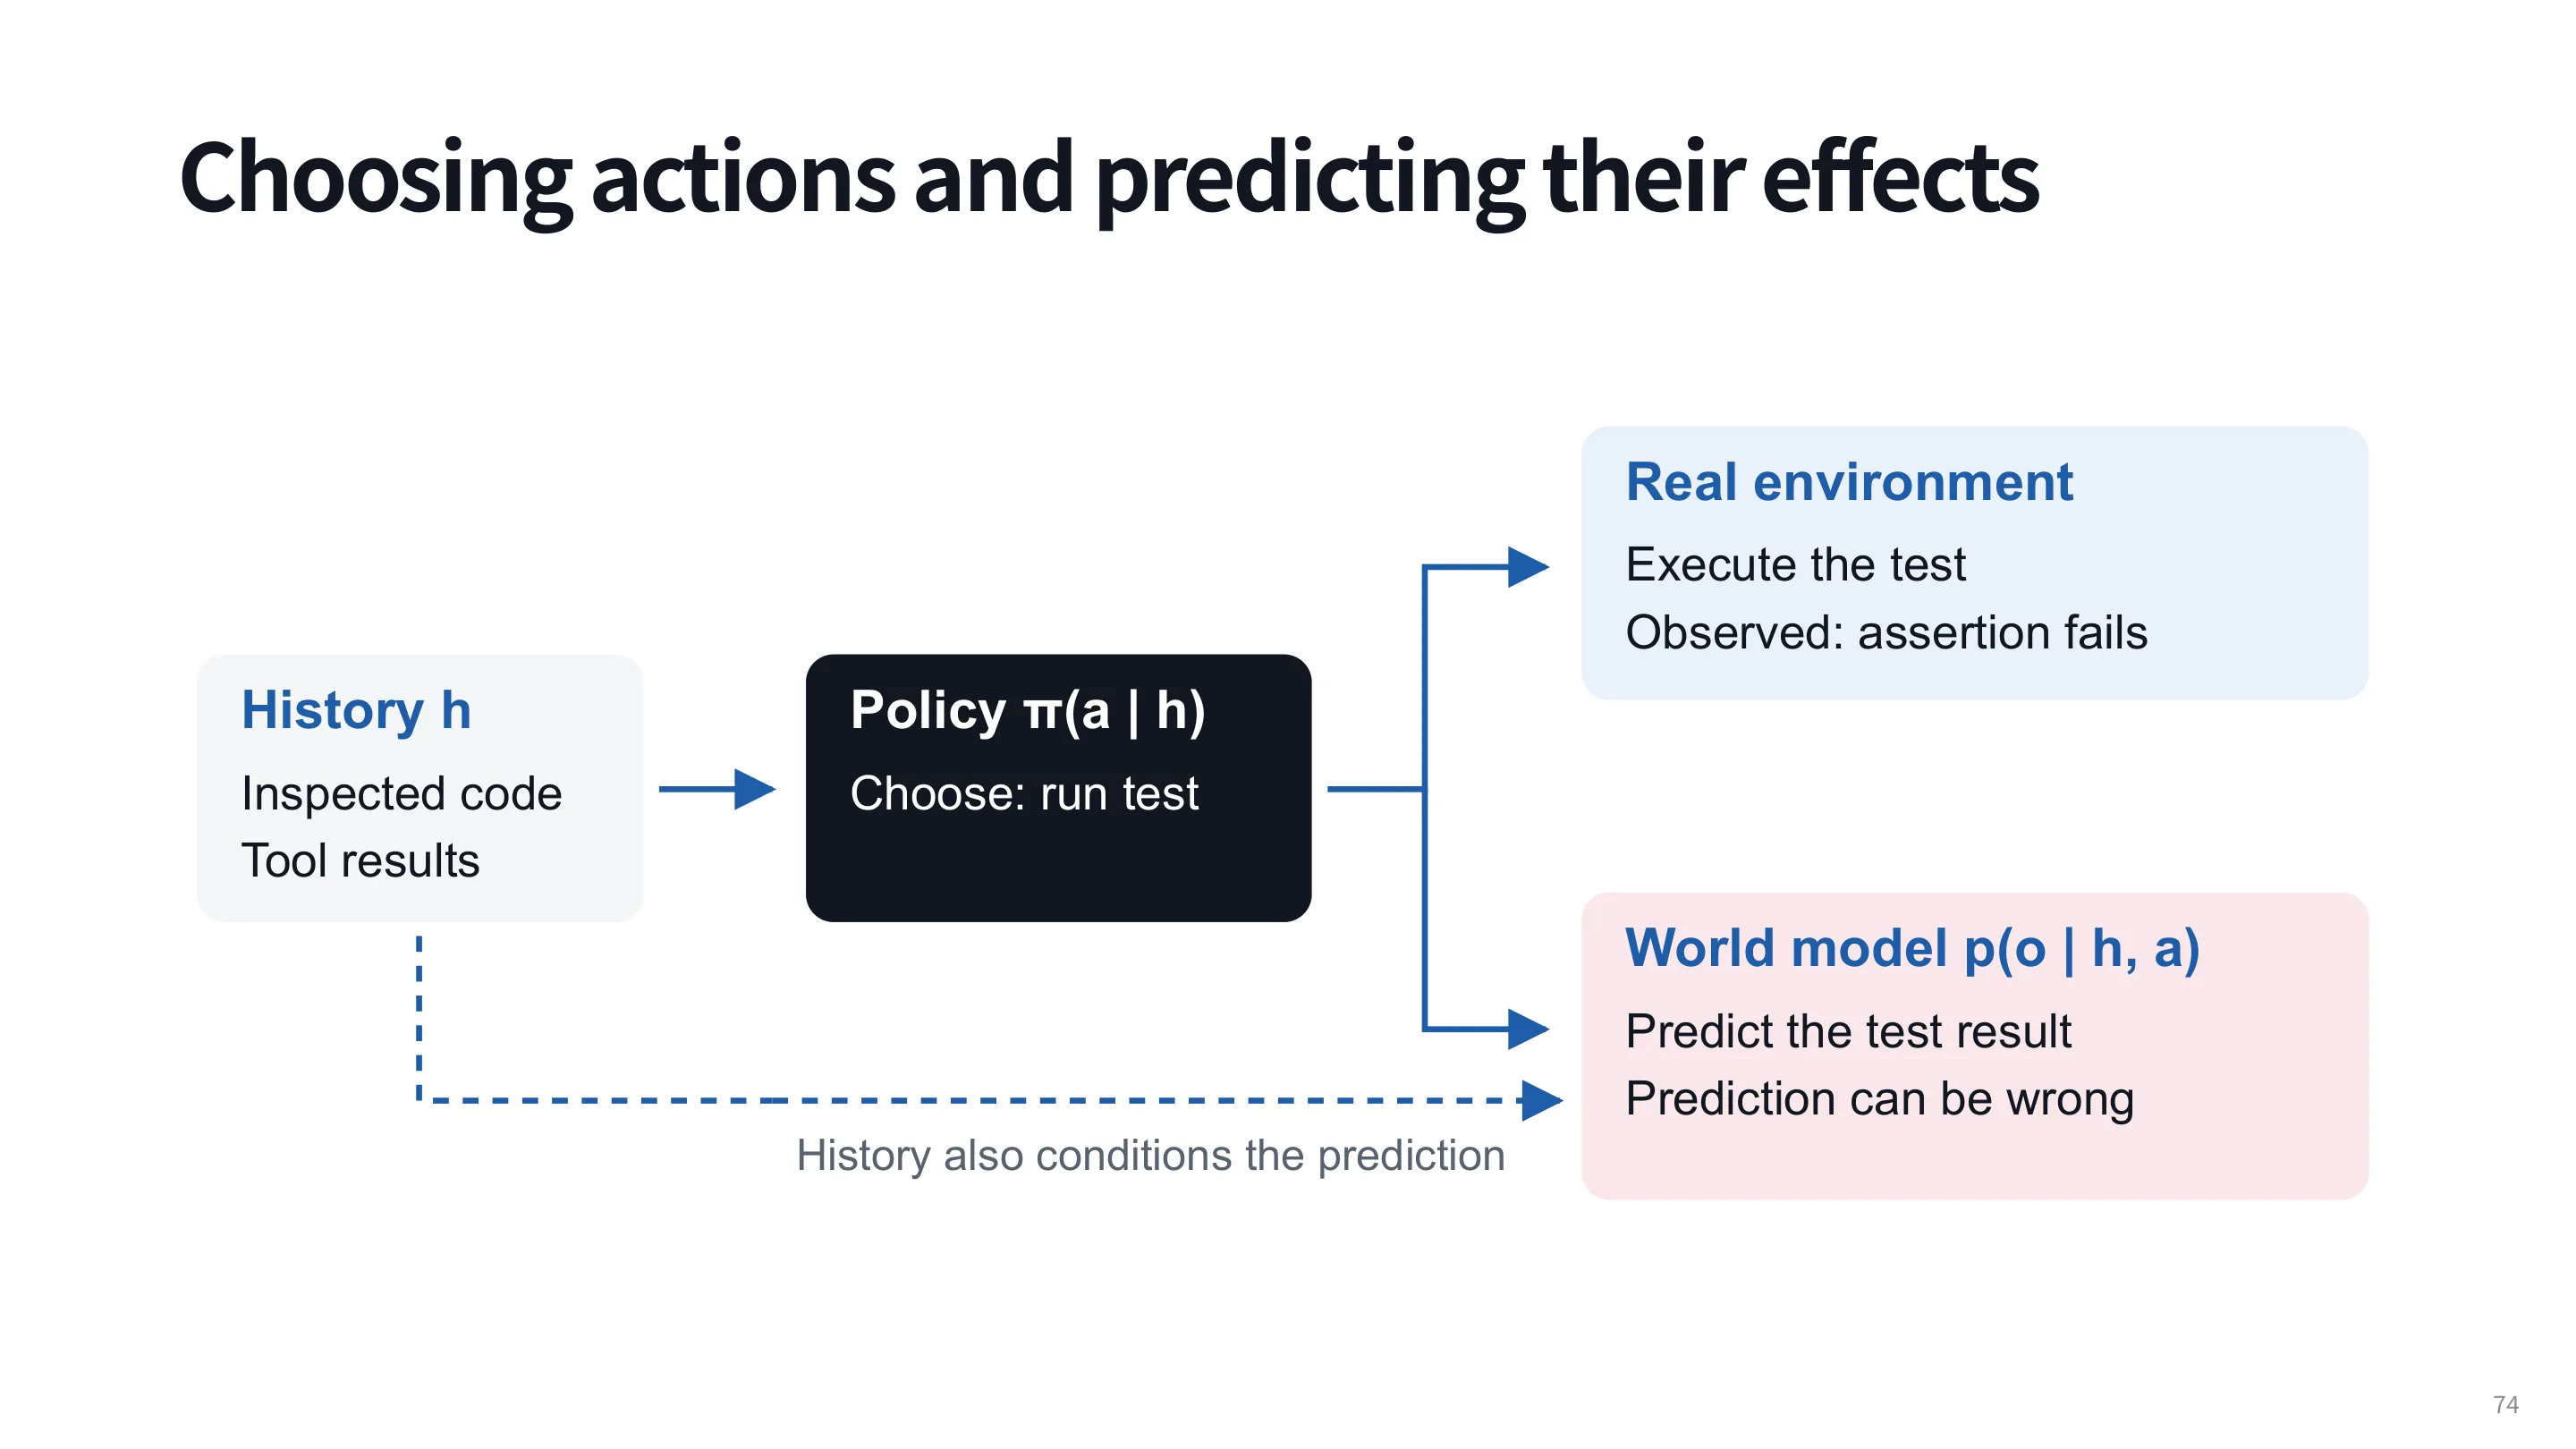
一个经典陷阱是引用/别名(Slide 75):
items = [1]
alias = items
alias.append(2)
result = len(items)真实执行:items = [1, 2],result = 2。如果模型把 alias = items 理解成拷贝,就会预测 result = 1。这类语义细节很难靠表面模式学会。
World model 什么时候有用?(Slide 76)
- 在两个候选 patch A/B 之间选择时,先预测测试结果,避免真实执行;
- 但预测可能错:模型说 A 失败、B 通过,实际可能相反;
- 因此要同时衡量 task success 与 latency / tokens / tool calls,并在预测不确定时回退到真实执行。
开放问题(Slide 79):
- Better decisions? 预测误差和任务成功率要在同一批问题上测;
- Lower cost? 把 latency、token、真实环境调用都算进成本;
- New settings? 按 program、dependency、environment 做 held-out;
- When to execute? 变化 fallback threshold,既测节省也测失败。
11. 设计清单
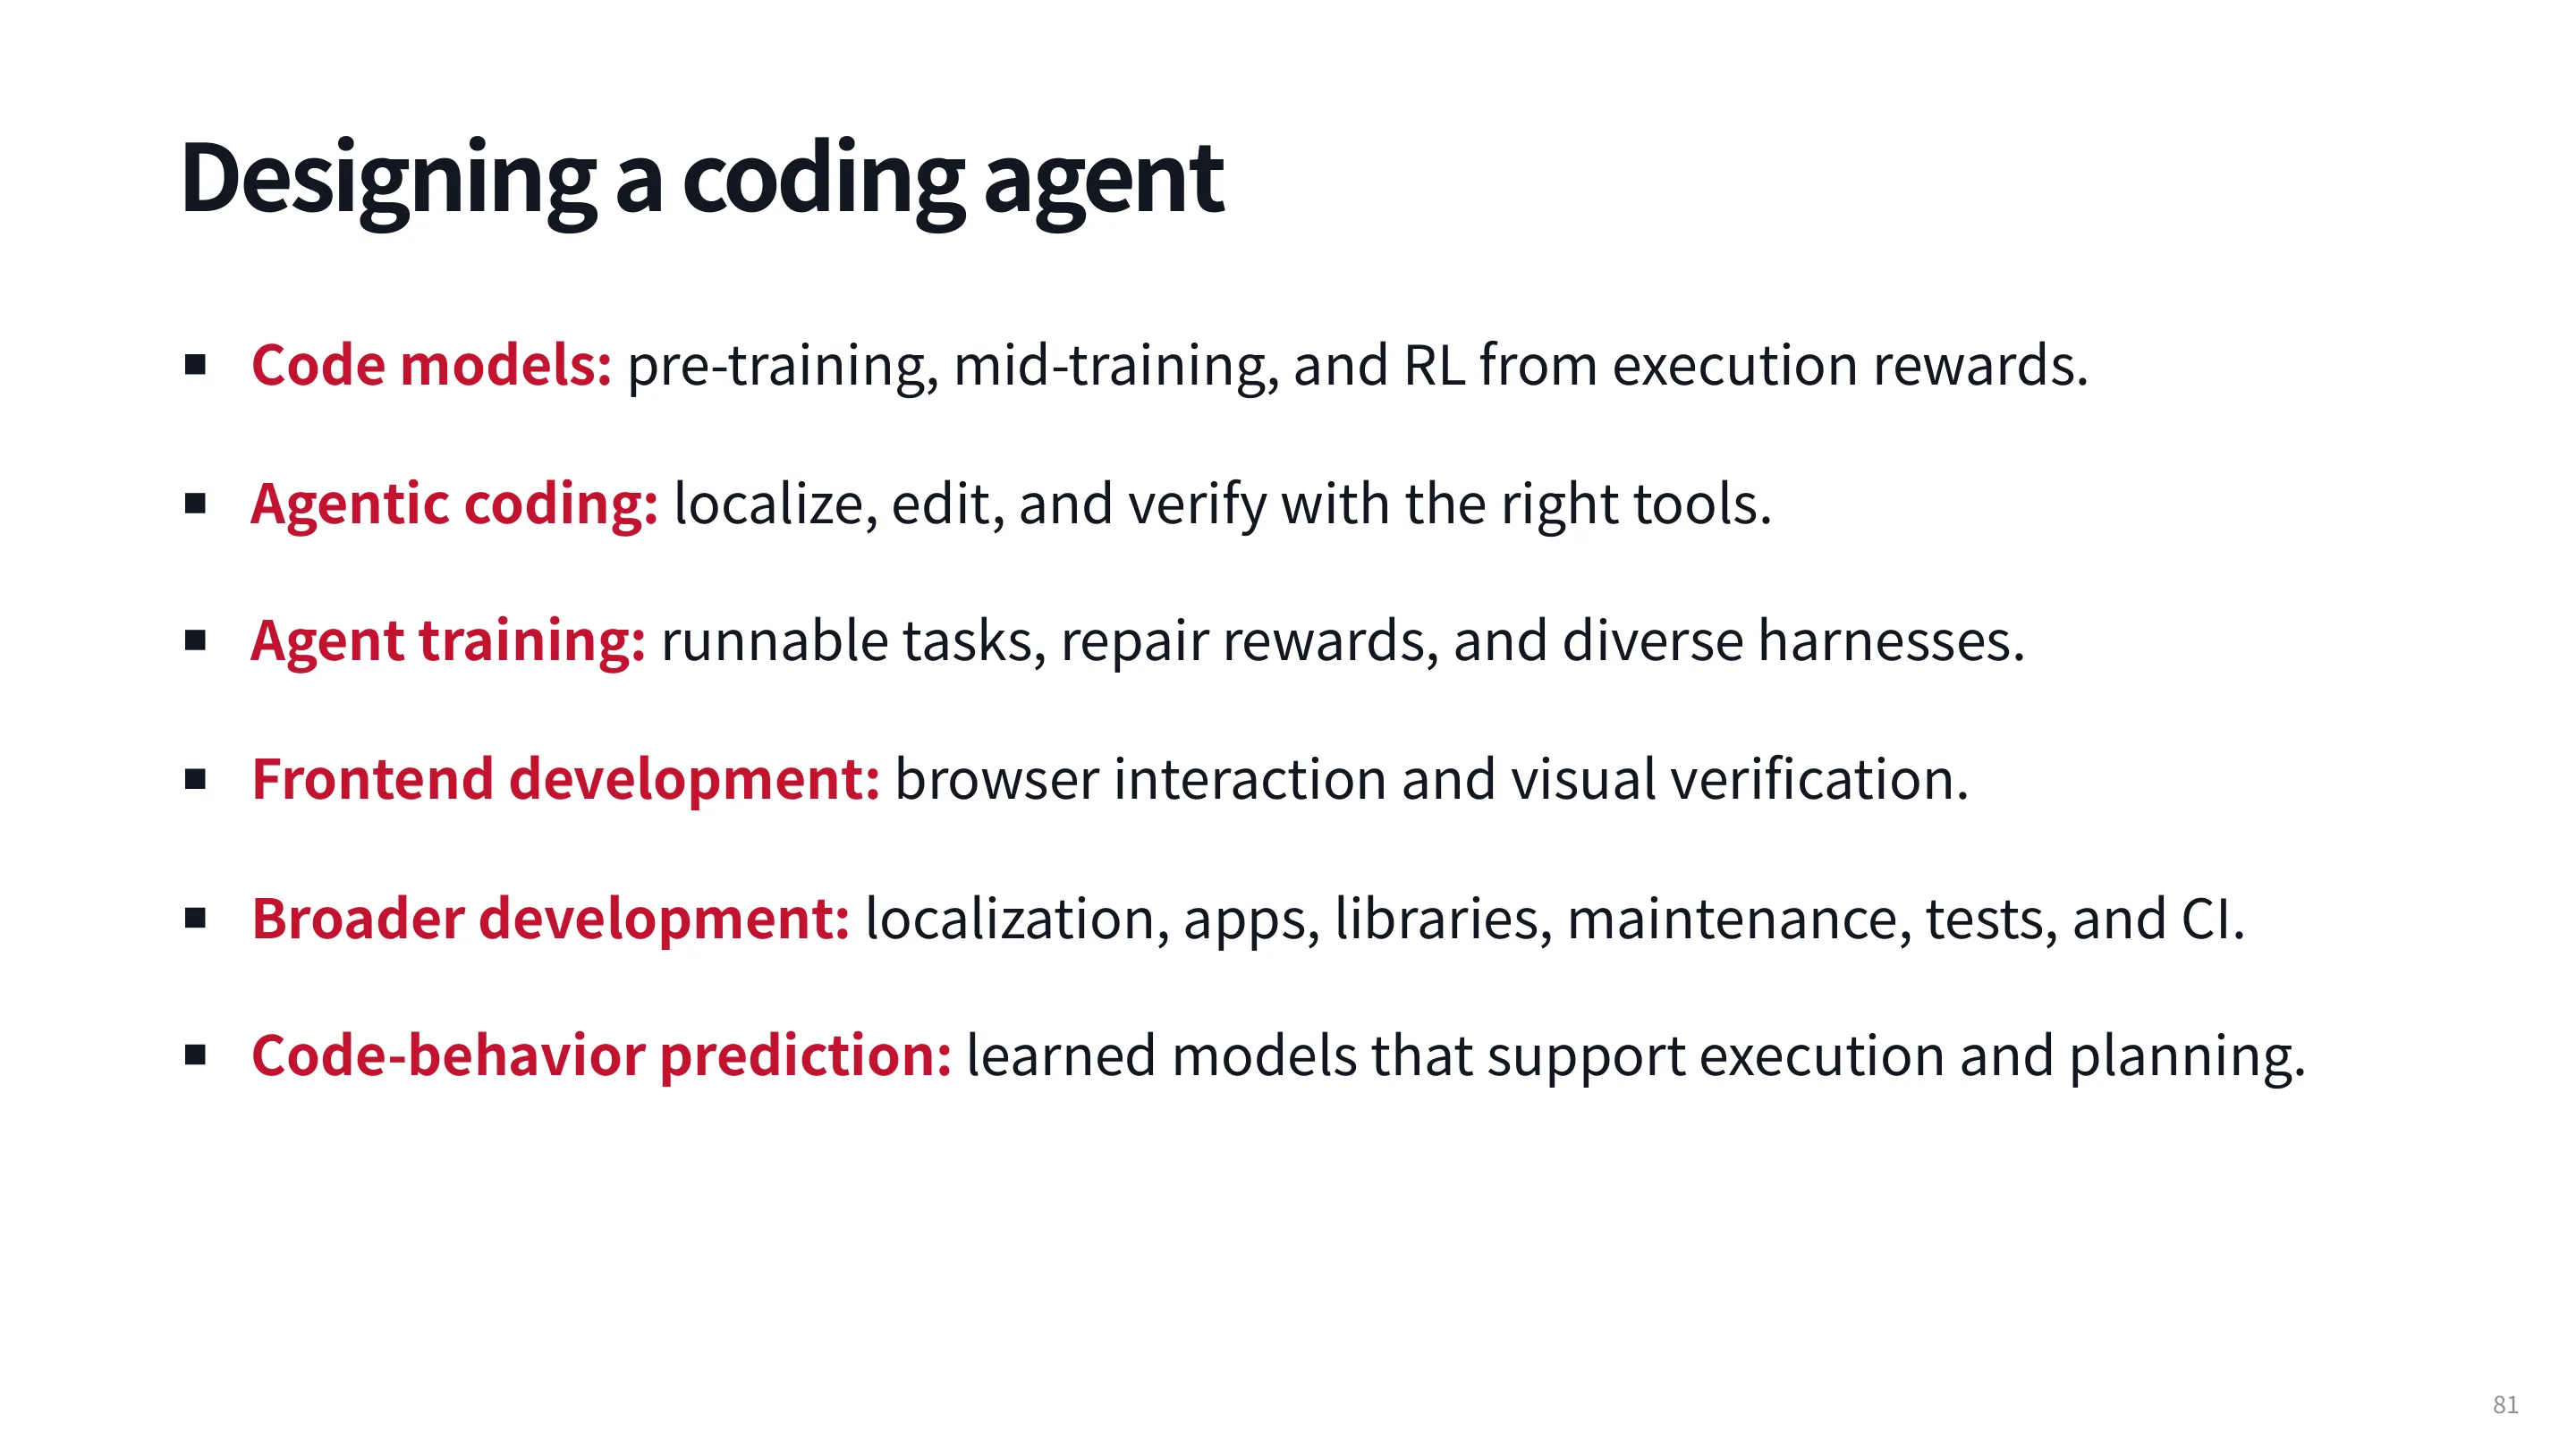
Graham 在结尾给出了一张“设计 coding agent”的清单(Slide 81)。把它展开成可操作的检查表:
1. Code model
- 预训练语料是否包含足够的代码、文档、数学和自然语言?
- 是否处理了 whitespace、文件边界、license、去重和 decontamination?
- 是否需要 FIM/infilling 能力?是否需要长上下文?
- 是否有 execution-reward RL 或 reasoning 训练?
2. Agentic loop
- 是否实现了 localize → edit → verify 的闭环?
- 失败后是否能修正假设,而不是重复动作?
- 是否有终止条件(测试通过、预算耗尽、需要人工确认)?
3. Tools
- 是否至少有一个可靠的 edit tool?
- edit format 是否与模型训练分布匹配?
- 是否有代码搜索、依赖导航、测试执行、日志读取?
- 工具的输出是否结构化、可解析、有明确的错误信息?
4. Training
- 是否有可执行的训练环境(起始状态、issue、checks)?
- reward 是 terminal 还是 step-level?如何处理 credit assignment?
- 是否混合多个 harness,避免过拟合单一框架?
- 是否用 held-out 仓库/任务评估泛化?
5. Evaluation
- 是否同时看 fail-to-pass 和 pass-to-pass?
- 测试是否可信?依赖版本是否固定?
- 是否评估非功能需求(性能、安全、可维护性)?
- 是否报告 pass@k、token 成本、延迟?
6. Beyond repair
- 是否能处理前端/多模态任务?
- 是否能做 localization、test generation、CI repair、维护?
- 是否需要 world model 来减少真实执行?
一句话总结
Coding agent 的竞争力,来自 代码模型能力 × 工具接口可靠性 × 可执行验证闭环。三者缺一不可;只堆模型或只堆工具,都会在真实仓库里遇到瓶颈。
术语表
| 术语 | 含义 |
|---|---|
| Single-step coding | 给定自包含 prompt,一次生成代码,不与环境交互 |
| Agentic coding | 在仓库中多轮搜索、编辑、执行测试,直到问题解决 |
| Harness | 本讲有两种含义:test harness(测试执行框架)与 agent harness(prompts + tools + loop + context) |
| FIM / Infilling | Fill-in-the-Middle,利用左右上下文生成中间 span |
| Sentinel token | FIM 中标记洞位置的专用 token,如 [M0] |
| pass@k | k 次采样中至少一次通过测试的概率 |
| SWE-bench | 基于真实 GitHub issue 的仓库级修复 benchmark |
| Fail-to-pass | 修复前失败、修复后必须通过的测试 |
| Pass-to-pass | 修复前后都必须通过的回归测试 |
| Mutation testing | 变异代码并检查测试是否能发现,SWE-smith 用它造数据 |
| Multi-harness training | 同一模型在多个 agent 框架/工具约定上训练 |
| World model | 预测动作后果 的模型 |
延伸阅读
按主题整理本讲涉及的代表性论文与项目(均为课程 references 中的条目):
代码模型与数据
- OLMo · 开放语言模型训练与数据管线
- StarCoder · 代码预训练、数据清洗与分词
- Code Llama · 代码中训练与长上下文
- Qwen2.5-Coder · 代码/文本/数学配比与长上下文
- InCoder · FIM/infilling
- OctoPack · commit diff 等代码监督信号
评测
- HumanEval · 函数级代码生成
- CodeContests / AlphaCode · 竞赛题评测
- CodeBLEU · AST + data-flow 相似度
- CodeBERTScore · 基于嵌入的代码相似度
- EvalPlus · 测试充分性
- NoFunEval · 非功能需求评测
Agent 与工具
- SWE-agent · agent–computer interface
- Agentless · 固定 workflow 的仓库级修复
- mini-SWE-agent · 100 行左右的 shell-only agent
- Aider edit formats · 编辑格式实践
- LocAgent · dependency graph 定位
Benchmark 与训练
- SWE-bench · 仓库级 issue 修复
- SWE-Gym · 可执行训练环境
- R2E-Gym · 可扩展的 agent 训练环境
- SWE-smith · 注入 bug 造数据
- Multi-SWE-bench · 多语言
- SWE-bench Multilingual · 多语言评测
- SWE-bench Multimodal · 前端/多模态
- Commit0 · 库实现
- ProgramBench · 从二进制反推实现
- SWE-Milestone · 长期维护
- SWT-Bench · 测试生成
- Hybrid-Gym · 跨任务技能迁移
- Code World Models · 代码行为预测
自测题
1. 为什么 coding agent 需要 localize–edit–verify 循环?单步模型缺了什么?
单步模型只看到自包含 prompt,无法获知仓库中的真实位置、依赖和测试反馈。Agent 需要在现有仓库中搜索相关代码(localize)、修改(edit)、运行测试(verify),并根据失败修正假设。循环提供了环境反馈,使 agent 能处理跨文件、长尾和需要试错的任务。
2. FIM 如何把 infilling 转成 autoregressive 任务?sentinel token 的作用是什么?
把原始序列拆成 prefix、span、suffix,训练时重排为 prefix [M0] suffix [M0] span [END],让模型在看到左右上下文后生成 span。[M0] 标记洞的位置;多个洞用不同 sentinel 区分。推理时把 [M0] 放在 prefix 与 suffix 之间,模型续写即可。
3. 为什么 BLEU 不适合评代码?CodeBLEU 增加了什么?
BLEU 只看 token n-gram 重叠,无法区分 x > 0 与 x >= 0 的行为差异,也会低估 not (x <= 0) 这类等价实现。CodeBLEU 在 n-gram 之外加入 AST 结构匹配和 semantic data-flow 匹配,更能反映代码结构;但它仍依赖参考解。
4. pass@k 的含义是什么?为什么比较模型时必须固定 k?
pass@k 是采样 k 个程序、至少一个通过全部测试的概率。k 越大,指标越宽松;不同 k 下的数值不可直接比较,因此要固定 k、采样数 n 和评测预算。常用无偏估计为 。
5. 执行评测的假阳性和假阴性分别来自哪里?
假阳性:测试太弱,错误实现也能通过(覆盖不足、断言太松)。假阴性:题目描述/隐藏测试不完整,正确实现也过不了;或者依赖版本漂移导致老测试失败。两者都会让 benchmark 分数失真。
6. 只给 bash 的 agent 有什么优缺点?为什么还要加专用 edit tool?
Bash 极简、通用,读/搜/编辑/测试都能做;但 sed 转义、工具选择、错误恢复都不可靠。讲师估计 85–90% 的 tool call 是基本操作,把这些操作封装成专用 edit tool 能降低出错率,尤其是 search/replace 和 diff 这类需要精确匹配的操作。
7. Search/replace 与 unified diff 各自的失败模式是什么?
Search/replace 依赖唯一匹配;文件中有多处相同片段时无法消歧,需要模型写更多上下文。Unified diff 依赖行号和 hunk 计数,模型经常数错;但格式标准、表达精确。Aider 的实验显示,仅改变 diff 格式,GPT-4 Turbo 的成功率可从 20% 到 61%。
8. SWE-bench 的 fail-to-pass 与 pass-to-pass 分别测什么?
Fail-to-pass 测“新修复的功能”:修复前失败、修复后必须通过。Pass-to-pass 测“没有回归”:修复前后都应通过。二者同时满足才算解决,避免 agent 通过删测试或破坏已有行为来“修复”问题。
9. SWE-smith 如何生成训练数据?它与 SWE-Gym 的区别是什么?
SWE-smith 先准备所有测试通过的 baseline,然后变异代码(不改测试),保留“变异后测试失败”的样本作为修复任务。SWE-Gym 则从真实 PR/仓库构造可执行训练环境。前者轻量、可无限生成但不够自然;后者更真实但构建成本高。
10. 为什么需要 multi-harness training?
不同 agent harness 的 prompts、工具 schema、edit format、上下文管理不同。模型只在一个 harness 上训练,换框架后可能显著掉分。混合 OpenHands、OpenCode、Codex 等多个 harness 训练,能让同一组权重适配不同工具约定,提升鲁棒性。
11. 前端 agent 如何验证修复?为什么不能只看截图相似度?
可以用 browser agent 自适应操作页面,或让模型写 Playwright 脚本做可重复断言(fill、click、expect、screenshot)。验证要同时看行为(空名字被拒绝、合法名字可保存)、外观(错误提示可见)和回归(已有测试通过)。截图相似度不能证明行为正确,SWE-bench Multimodal 仍以测试行为评分。
12. Code world model 的潜在收益与风险是什么?
收益:在真实执行前预测动作后果,减少测试调用、降低延迟和成本,帮助 agent 在候选 patch 之间选择。风险:预测可能错误(如把 alias 当 copy),导致错误决策;训练分布外容易失效。需要同时衡量预测误差、任务成功率和总成本,并设置回退到真实执行的阈值。