
2b · Agent Capabilities 3: Skills and Memory
本讲速览
- agent 的“学习”有三种落点:上下文窗口、外部工件(文件/数据库)、模型权重。本讲专攻第二种,因为它可检查、可编辑、可迁移到别的模型,代价是必须自己完成归纳、筛选与维护。
- 经验有三种粒度:完整 episode、单条 fact、可复用的 skill。保真度越高越贵、越难迁移;抽象越多越省、越依赖归纳质量。
- skill 有两个来源:人写的 instructions(意图清楚、来源可信,但耗人力)与 agent 自己从经验中归纳的 skills(能发现人说不出的东西,但需要判分与策展)。两者互补,不是替代。
- Agent Skills 标准把 skill 做成一个文件包:必须有
SKILL.md(YAML 元数据 + Markdown 正文),可选scripts/、references/、assets/;靠渐进披露分三层加载,索引常驻 system prompt(Hermes 里约 3k tokens)。 - SkillsBench 给出量级:87 个真实工作任务上,人工策展技能把平均通过率从 33.9% 提到 50.5%;但技能在 13/87 个任务上反而变差,且所需技能越少、
SKILL.md越短的任务收益越大。 - 记忆侧的三块地基:MemGPT 用工具调用在 working context 与外部存储间搬数据;Mem0 把记忆写入拆成 ADD / UPDATE / DELETE / NOOP,解决“事实会变”的问题;Reflexion 用自然语言反思让 agent 在同一任务上越试越好。
- 归纳技能的核心循环是 judge → induce → admit:只有判定成功(或能从失败中提炼出策略)的经验才值得进记忆;代码表示让“先测后存”成为可能,也把技能变成可组合、省步数的工具,但在页面结构变化时会变脆。
1. 定位:为什么“不从头开始”是一个系统问题
上一讲关心任务内部的记忆:在有限窗口里保留哪些观察、动作和消息,如何压缩取舍。这一讲把时间尺度拉到任务之间:昨天在某购物网站摸索出的“怎么搜索商品”,今天换个问题还能不能用?如果每次都要从零试错,agent 的能力就被钉死在单次任务的预算里。
Daniel 用一个很具体的对照开场:任务一是“把 Sony 耳机加进收藏夹”,任务二是“查一下无线键盘的价格区间”。两个任务在同一站点上,前面的动作几乎一模一样——进站点、找搜索框、填关键词、点搜索;只有收尾不同:一个点“加入收藏”,一个读价格并汇报。大量结构在任务间重复,这就是可以被沉淀的东西。
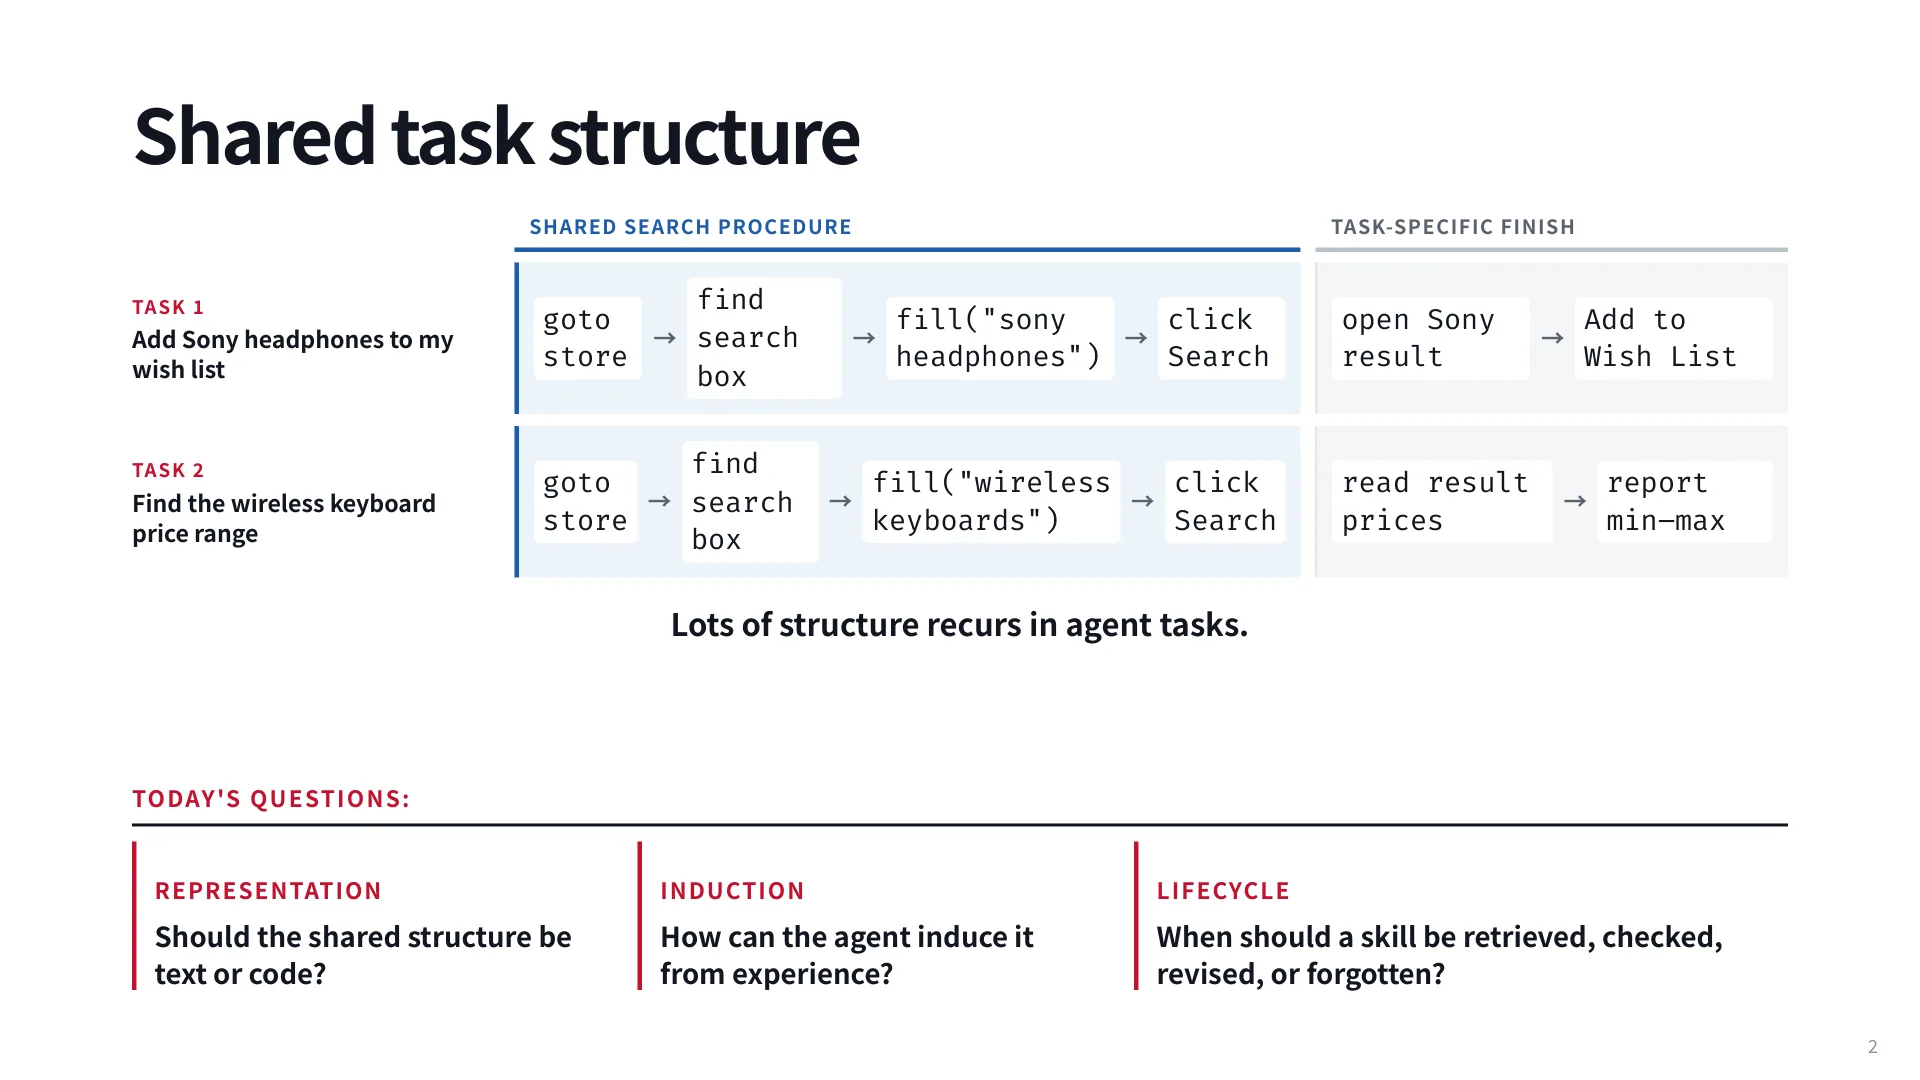
于是本讲的所有工作都可以挂在三个问题上:
- 表示(representation):这段共享结构应该写成自然语言、动作序列,还是一段可执行代码?
- 归纳(induction):agent 如何从自己的经验里把它抽出来,而不是等人来写?
- 生命周期(lifecycle):什么时候该检索它、验证它、修订它、忘掉它?
这三个问题互相牵制:表示越“硬”(代码),可测试性与效率越好,但越难迁移;越“软”(文本),越能适应页面变化,但省不下模型步数;而只要记忆会增长,就必须回答“什么时候删”。
先看“更新 agent”在系统里的位置。Daniel 把它分成三处落点(04:53),这张表定义了课程后半段的版图:
| 位置 | 优点 | 缺点 | 对应讲次 |
|---|---|---|---|
| 上下文窗口 | 与刚刚发生的事高度一致,无需额外设施 | 贵、噪声大、不决定什么重要 | 第 3 讲(Long Context) |
| 外部工件 | 可检查、可编辑、可检索、可跨模型移植 | 必须被归纳、被选择、被维护 | 本讲 |
| 模型权重 | 推理更快,行为改变更广 | 更新慢、不可解释、只对特定模型有效 | SFT / RL 讲次 |
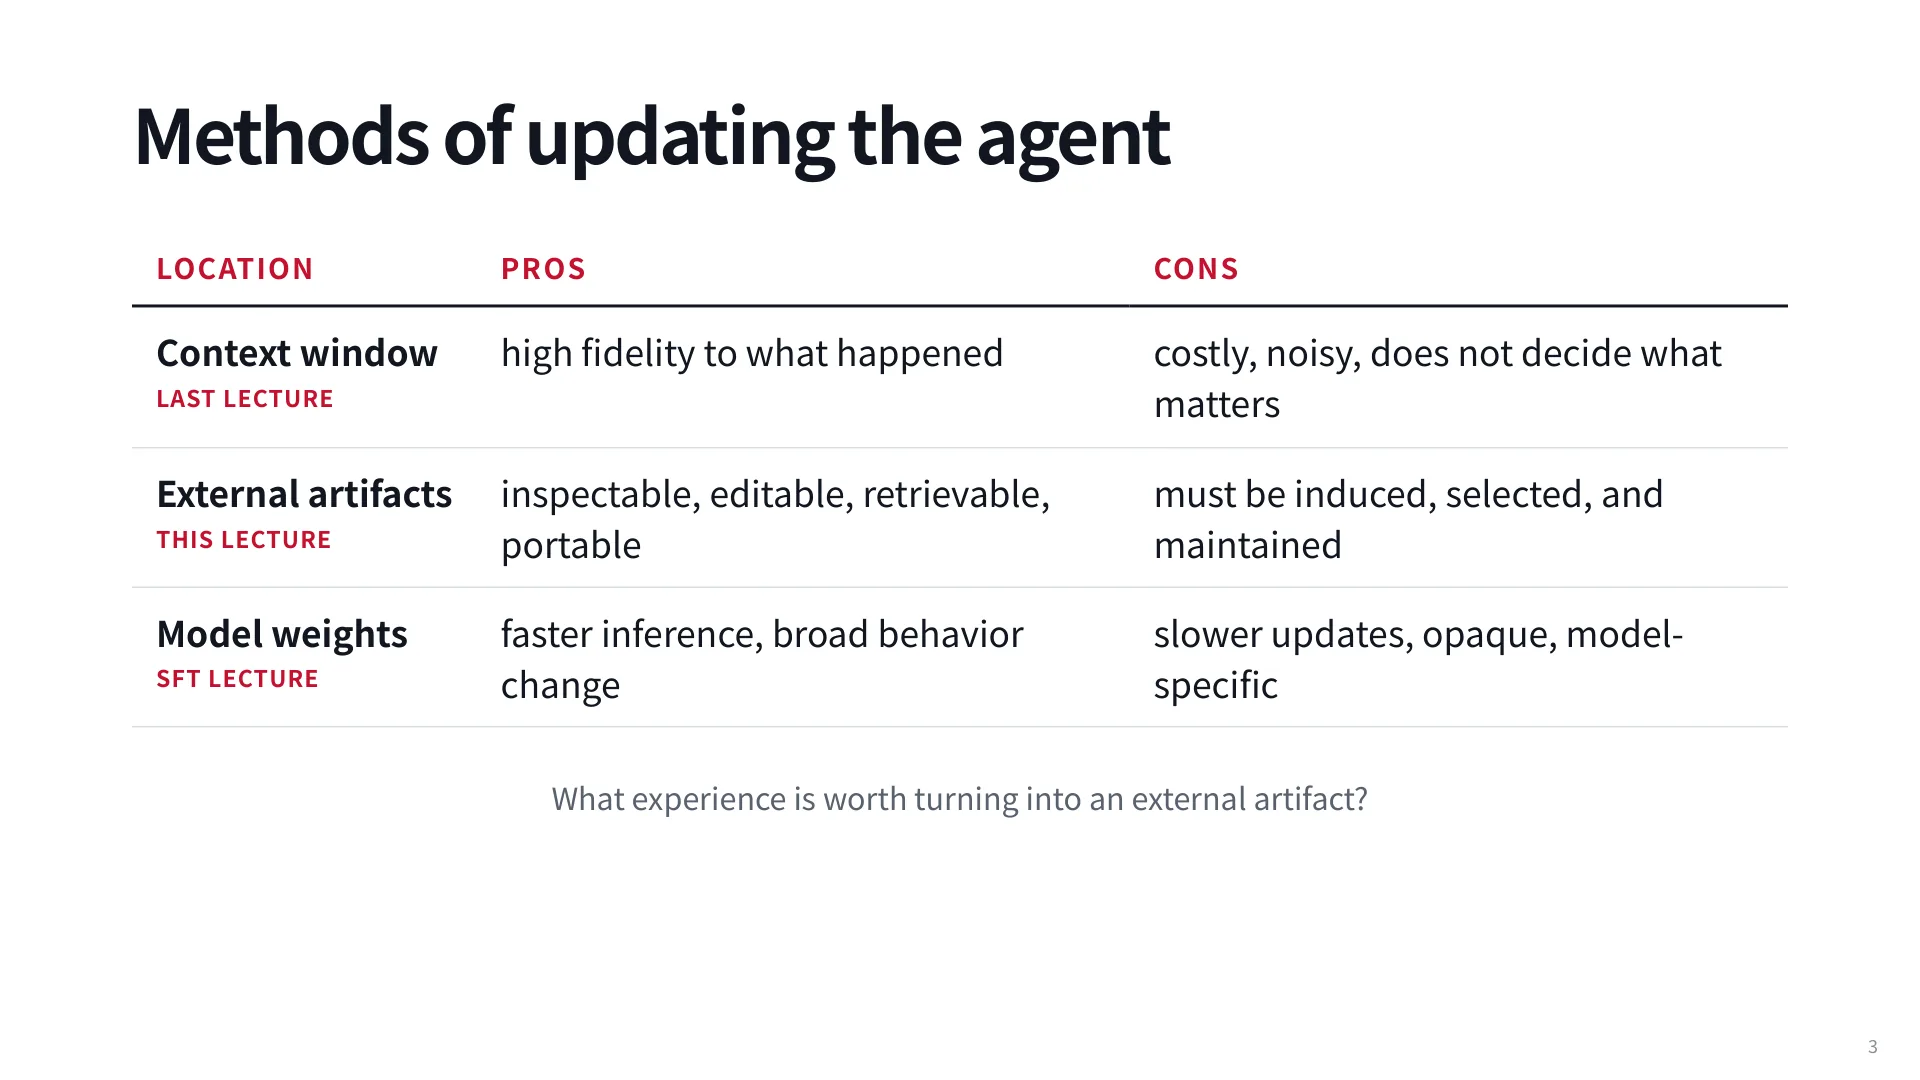
外部工件的价值在可移植与可协商:一份“如何在该站点搜索”的说明,任何模型与 harness 都能读;写错了人可以直接改,agent 也可以提议修改。权重更新做不到这一点(06:31)——它只属于那个模型。代价是负担转移给了设计者:没有训练管线保证一致性,你得自己决定存什么、怎么判对错、何时清理。
讲师提醒:外部记忆不是“免费的长期上下文”。它把一个学习问题换成了一个数据管理问题——写入策略、检索策略、冲突消解、过期清理,一个都不能少。
2. 三类经验,两种来源
在讨论怎么存之前,先要问“存什么”。课件把经验分成三层,粒度从细到粗:
- Episode(轨迹):完整的观察与动作序列,保真度最高(08:57)。如果未来会再次遇到同样的商品、同样的价格、同样的操作顺序,它最有用;但它也最贵(09:44),而且大部分细节与未来无关。
- Fact(事实):“这个站点只在商品详情页显示价格。”当这条信息会反复用到、或者会随时间更新时,值得单独存成一条。
- Skill(技能):一段可复用的行动模式,例如“填搜索框 → 点搜索 → 打开结果”。只有当后续任务会重复同一模式时才有价值。
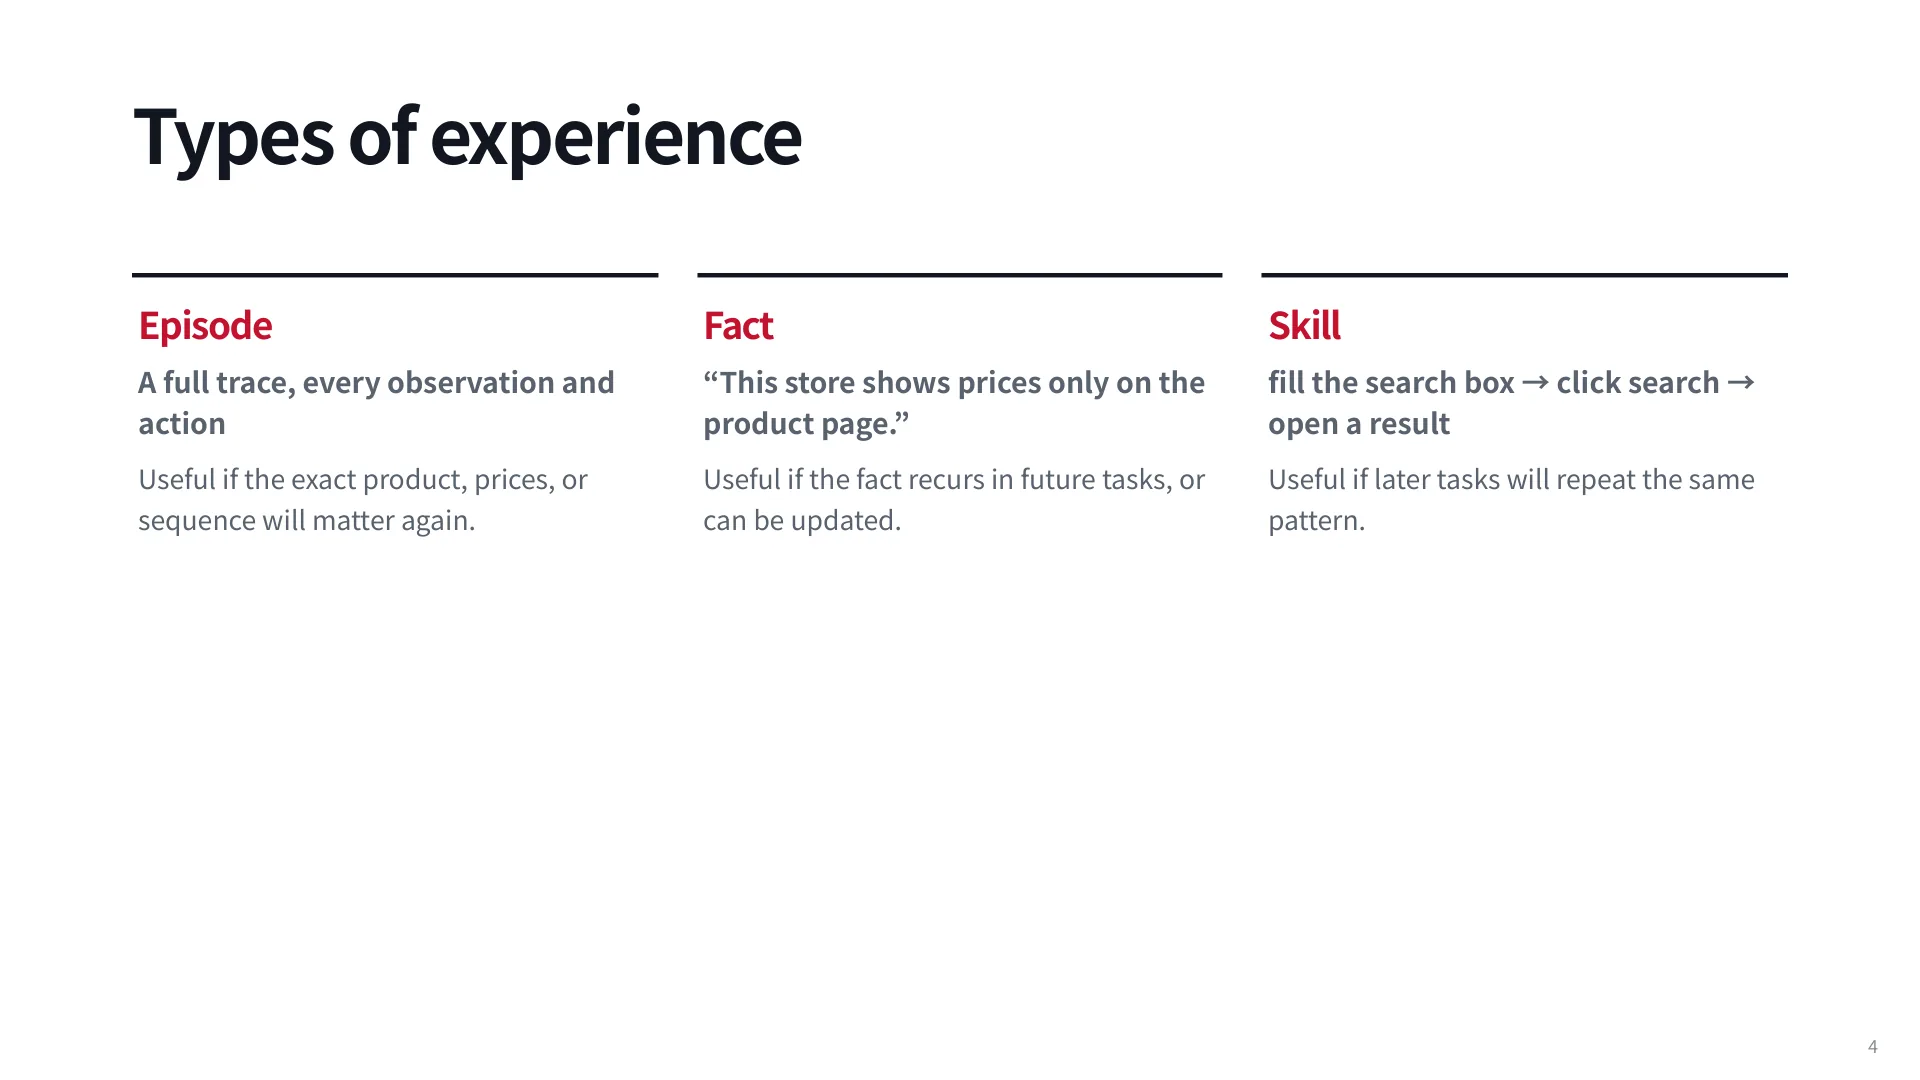
这三层的区别不只是压缩率,而是泛化方式不同。episode 靠“相似性”泛化:新任务和旧轨迹越像,检索越有用。fact 靠“命题复用”泛化:一条关于站点结构的知识可以服务于很多不同任务。skill 靠“抽象”泛化:把具体商品名、具体元素 ID 抽成变量,剩下的控制流才是可复用的部分。
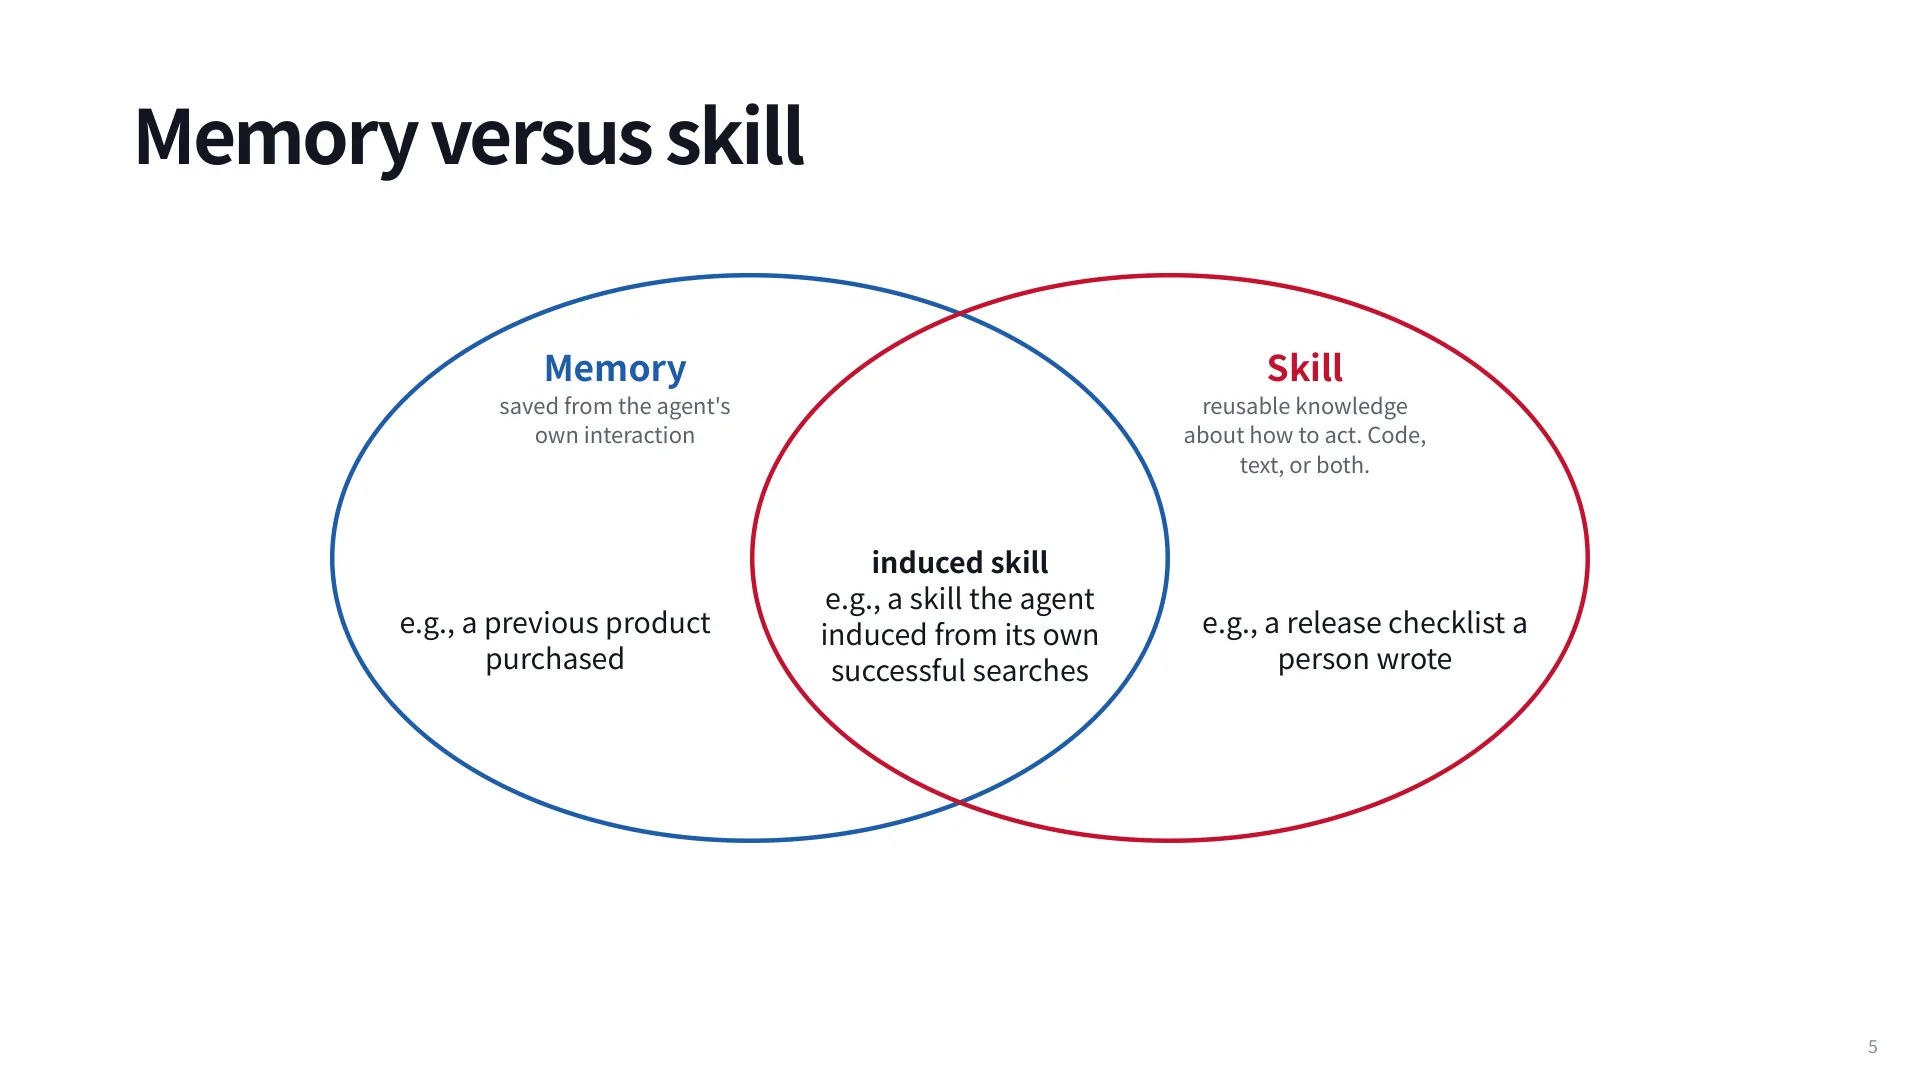
课件还澄清了一个易混边界:memory 与 skill 不是同义词。memory 是“从 agent 交互中保存下来的东西”,如上次买过什么;skill 是“关于如何行动的可复用知识”,可以是人写的发布清单,也可以是从成功搜索中归纳的流程。两者的交集是 induced skill。
按作者划分,技能有两条生产线:
| 维度 | 技能即指令(skills as instructions) | 技能即学习(skills as learning) |
|---|---|---|
| 作者 | 人或组织 | agent 自己 |
| 来源 | 既有专业知识、政策、文档 | 自己的轨迹与结果 |
| 优势 | 意图明确、来源可追溯 | 能覆盖“必须靠交互才能发现”的技能 |
| 主要负担 | 专家写与维护的时间 | 判分、验证、策展 |
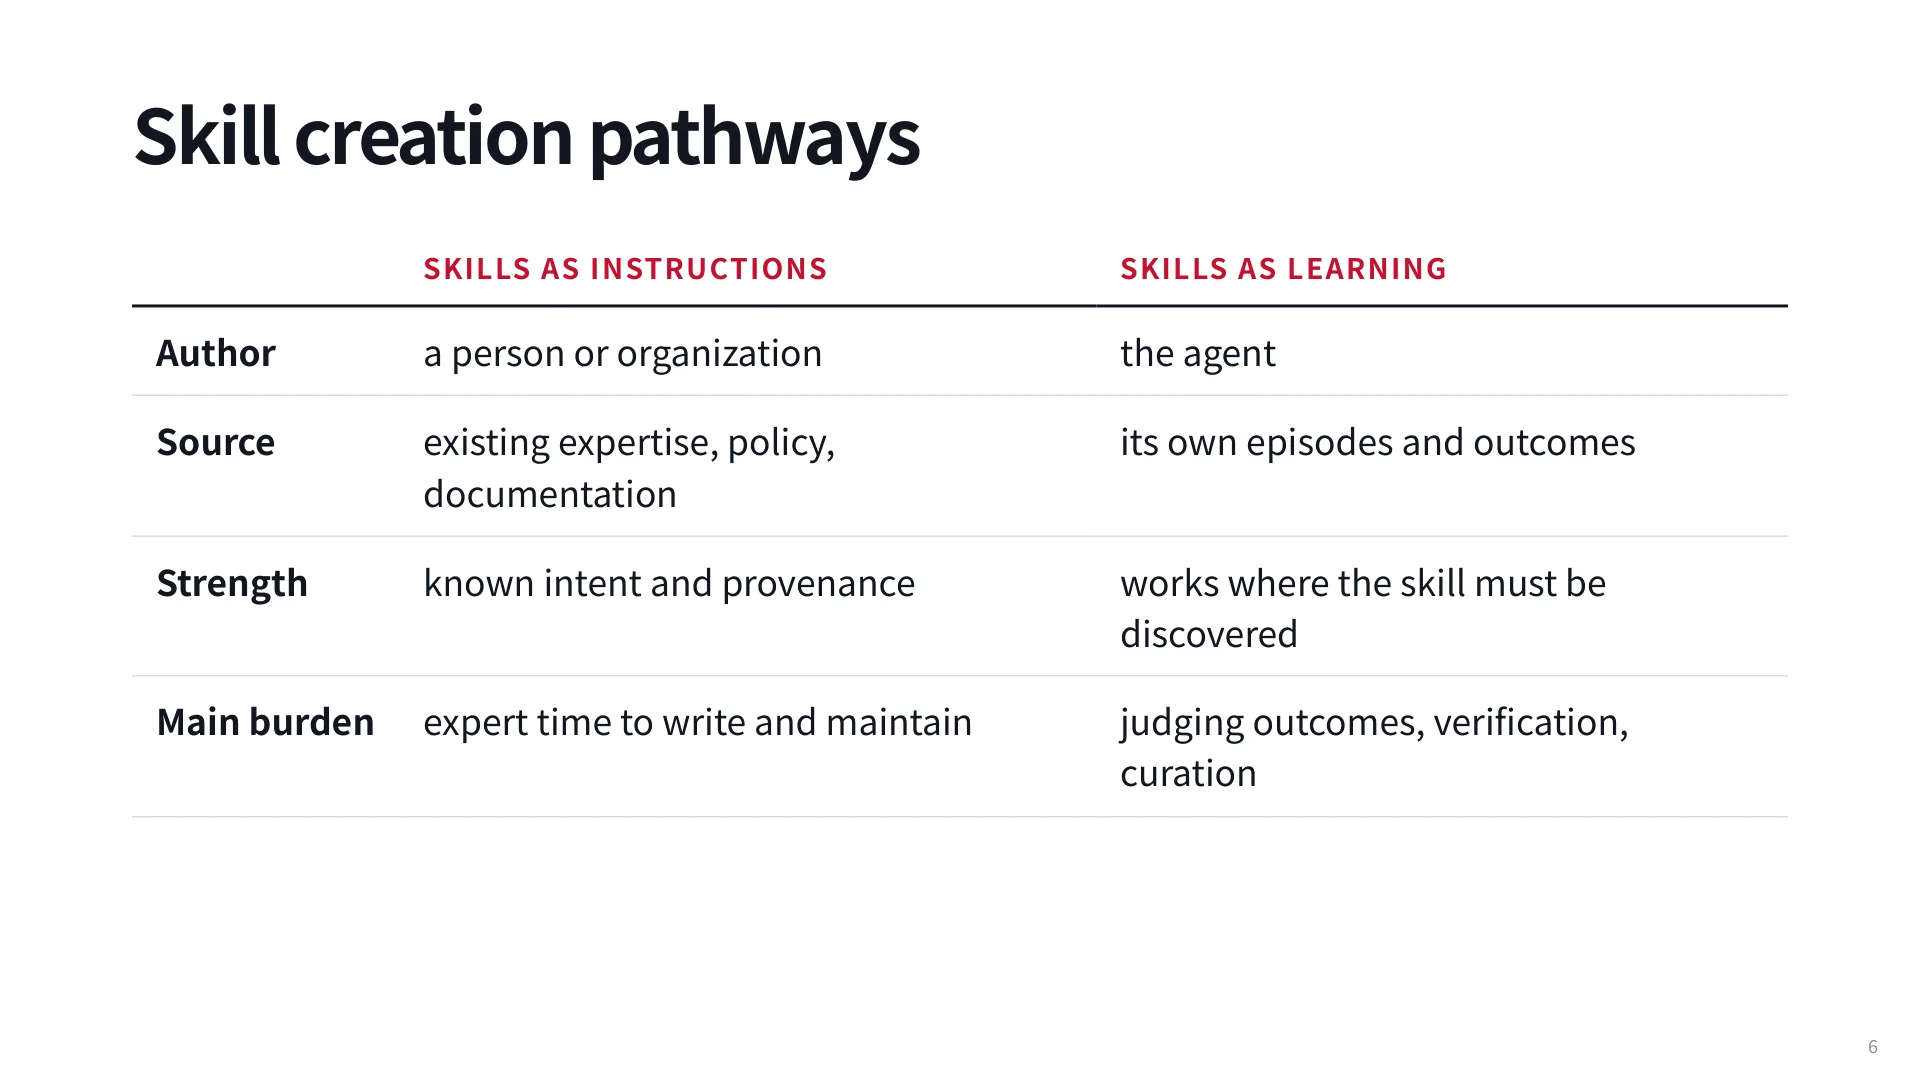
两条线在真实系统里互相喂养:人先写一版粗糙的清单,agent 跑的时候记录哪些建议被采纳,用统计去改清单;或者 agent 先归纳一版流程,人审掉过度概括的部分,再固化成 skill。Daniel 提到,用 agent 写 skill 时一个常见的失败是“写得太多”——模型过度推断意图,把不需要的步骤写进去,下一个模型照着字面执行,做了很多你并不想要的事。
3. 人写的技能:一个文件包与三层披露
什么时候该写 skill?判据很朴素:要反复用同一套固定规格做事时。比如每次提 PR 都要说一遍“Black 行宽 88、Ruff 自定义规则、公开 API 加类型标注、Google 风格 docstring、新函数配 pytest”。每次都打一遍既慢又容易漏;固化成 skill 后,人的意图就从“临时提示”变成“可版本管理的资产”。
课件用 python-review 作例子。一个 skill 就是一个目录:
python-review/
├── SKILL.md          # 必需:指令 + 元数据
├── scripts/          # 可选:可执行代码
├── references/       # 可选:补充文档
└── assets/ # 可选:模板、资源SKILL.md 的开头是一段 YAML 元数据,name 和 description 是硬要求;description 尤其关键,因为它要回答“什么时候该用这个技能”,而不只是“这个技能是什么”:
---
name: python-review
description: This skill should be used when the user asks to
  "review Python code", "check Python style", "lint Python",
  or mentions code quality.
triggers:
  - python review
  - code review
  - lint python
---
# Python Code Review
Review Python code using company standards...元数据之后是正文,写清楚具体怎么做;scripts/ 放能直接跑的东西(比如一个把 Black 与 Ruff 串起来的脚本);references/ 放“不一定每次都要读”的长文档;assets/ 放模板。这个结构之所以成为事实标准,是因为它同时满足两个约束:机器能按需读取,人能像读代码一样 review 和 diff。
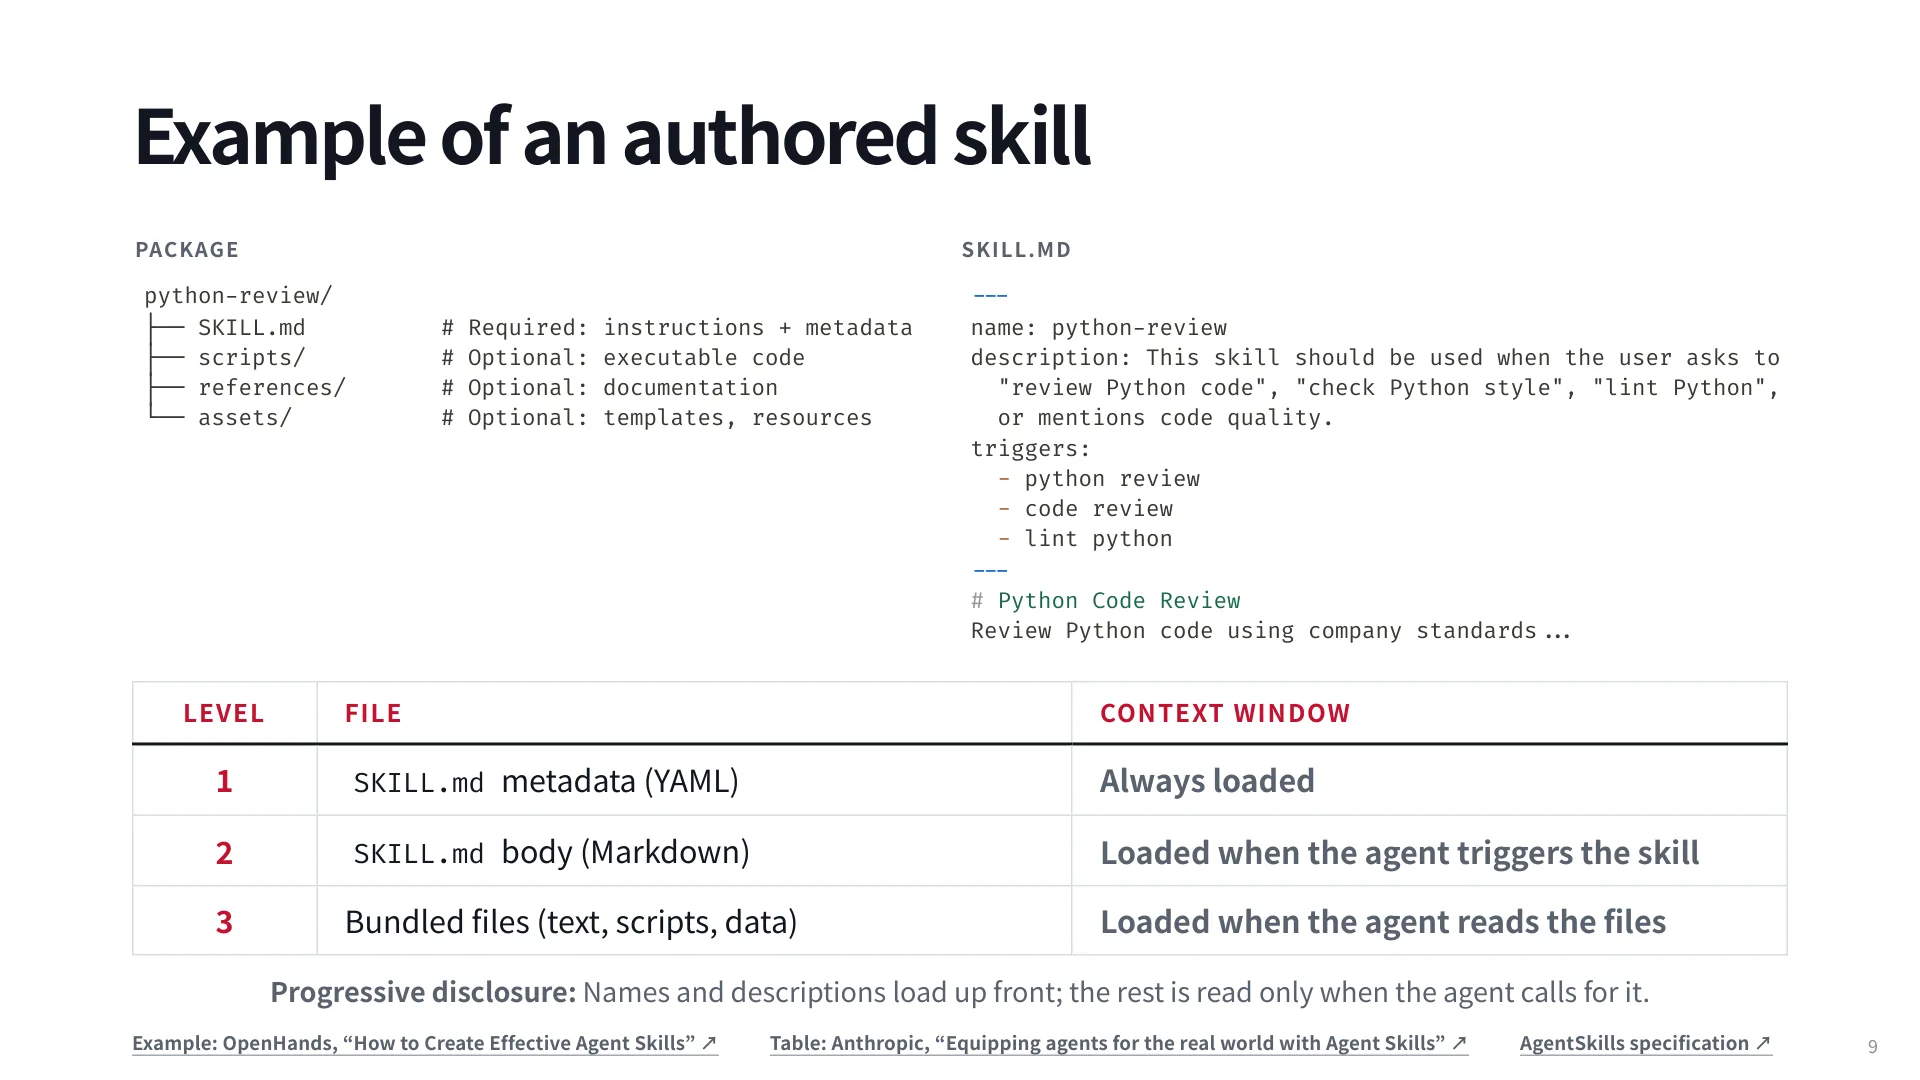
真正让这套结构可扩展的是渐进披露(progressive disclosure)。如果系统里有 50 个技能,把每个技能的全部正文都塞进 system prompt,上下文会被瞬间吃满,而且大部分内容与当前任务无关。于是加载被拆成三层:
- 元数据层:只有名字和描述,常驻 system prompt,永远可见(17:52);
- 正文层:只有当 agent 判断相关、调用
skill_view(name)时才作为工具结果进入上下文; - 资源层:
scripts/、references/里的东西,只有 agent 真的去读、去执行时才出现。
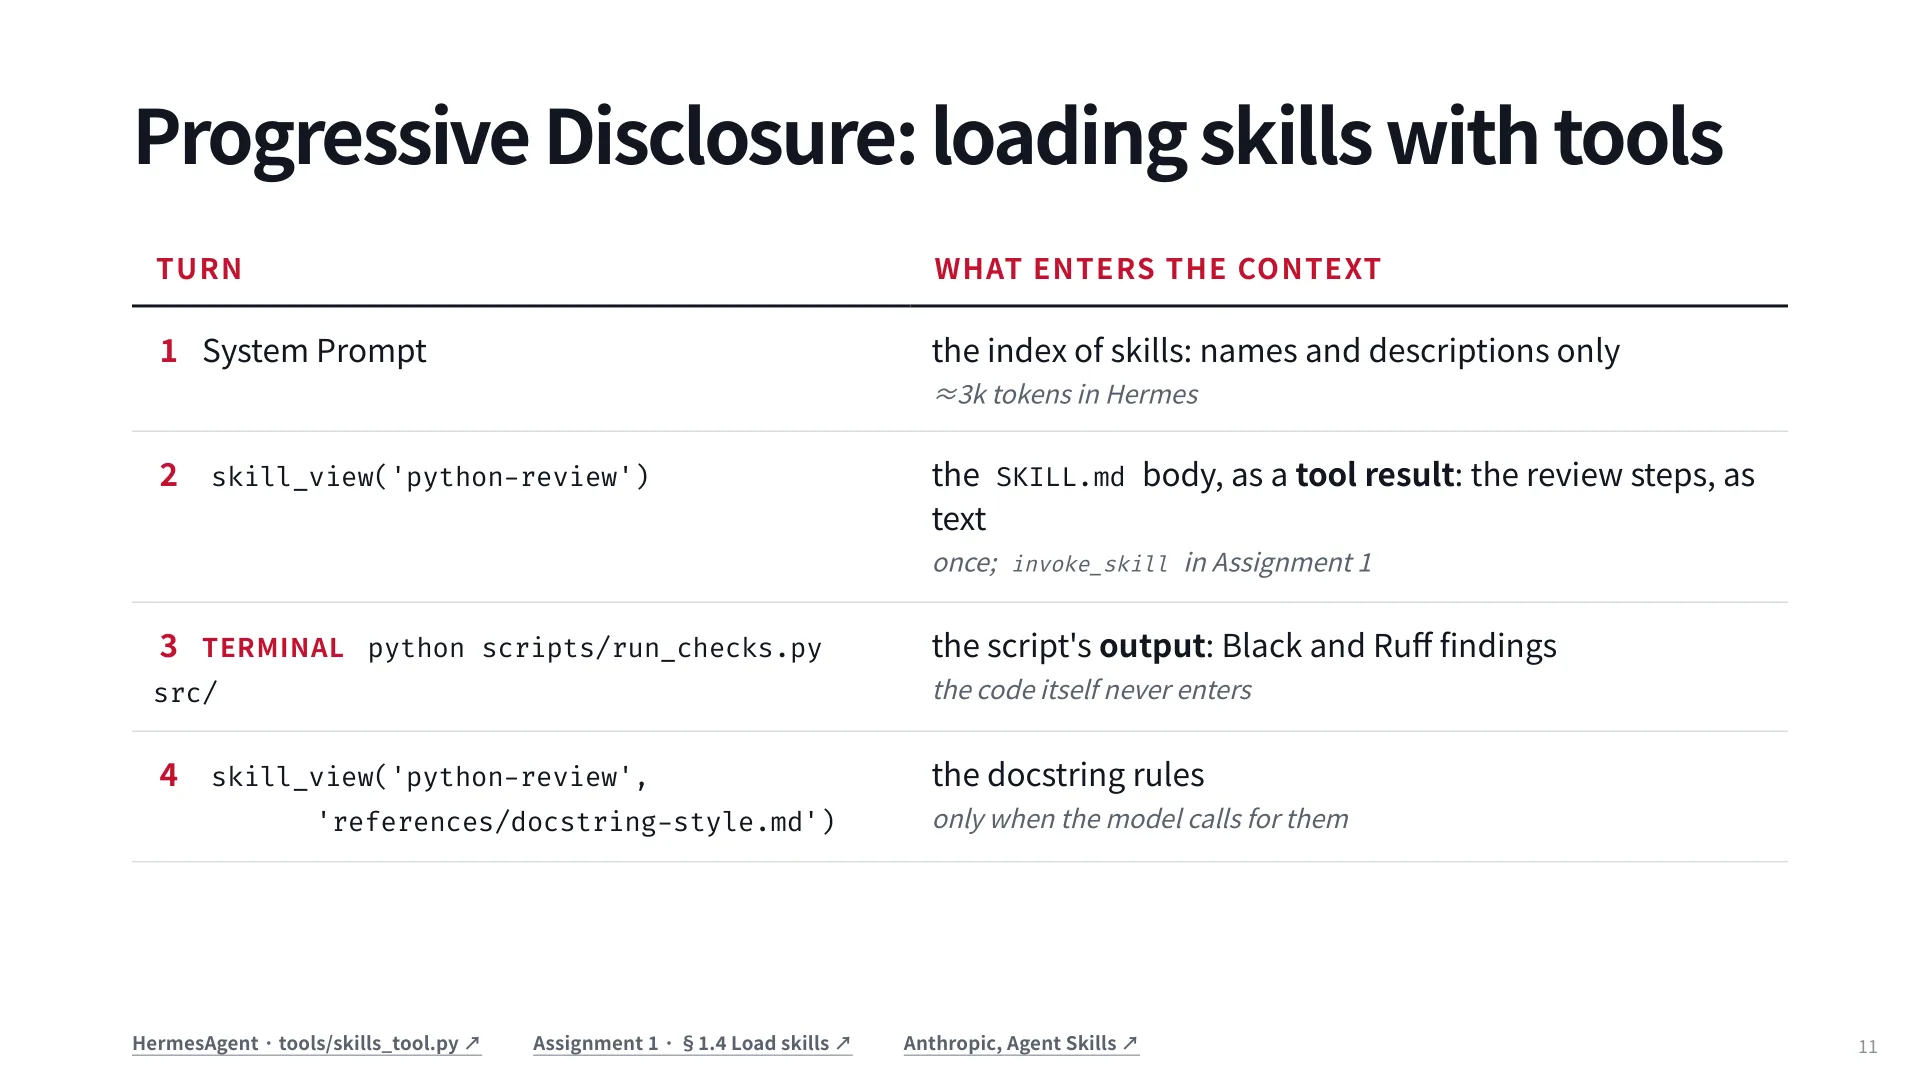
这四轮分工很干净:第 1 轮只有索引(Hermes 里约 3k tokens);第 2 轮 skill_view('python-review') 把正文作为工具结果送进来;第 3 轮直接 python scripts/run_checks.py src/,模型只看到 Black 与 Ruff 的发现,源码从头到尾没有进过窗口;第 4 轮才按需读 references/docstring-style.md。模型负责判断与解释,脚本负责确定性检查,文档负责长尾知识。
索引长什么样?第 10 页的 Hermes system prompt 先声明“回复前先扫一遍技能列表,匹配或部分相关就必须用 skill_view(name) 加载并遵循”,再按类别列出技能名与描述,最后补一句“确实没有相关技能时才可直接继续”。
这里有两个工程上很容易低估的点。第一,description 实际上就是检索键。它写得含糊,agent 就不会在正确的时机触发;写得过宽,又会把不相干的技能拉进来。第二,触发是否发生完全由模型决定。课堂上有人问“trigger 有多敏感”,Daniel 的回答是:trigger 就是模型生成的工具调用,是否触发取决于模型对上下文的理解和你写的描述,因此只能靠评测来调,没有解析式的答案。
成本也是实打实的(19:28)。Hermes 的技能索引约 3k tokens;如果技能数量继续涨,光索引就会挤占任务预算。更麻烦的是,无关技能不只是“占地方”,还会分散注意力——这一点在后面的 SkillsBench 与 ReasoningBank 实验里都有量化证据。
讲师提醒:写 skill 的第一原则是“短而聚焦”。课件反复强调同一个经验规律:所需技能越少、
SKILL.md越短,平均收益越大;一个技能只解决一类事,比一个“什么都能干”的大技能更可靠。
4. 技能到底有没有用:SkillsBench 的证据
技能生态看起来很繁荣,但“用了技能是否真的更好”需要实验回答。SkillsBench 是课件给出的第一个系统性答案。它的构造分三段:
- 建池:从 GitHub、应用市场、企业仓库收集技能,去重后得到约 2,014,000 个唯一技能;
- 造任务:142 位贡献者提交 400 个任务,经自动检查(结构、oracle 100% 通过、AI 生成检测、泄漏审计)与人工复核(数据有效性、任务真实性、oracle 质量、技能质量、反作弊),留下 87 个任务、8 个领域;
- 评测:同一任务分别以“无技能”和“人工策展技能包”运行,覆盖 18 种模型–harness 组合,共 9,396 条轨迹。
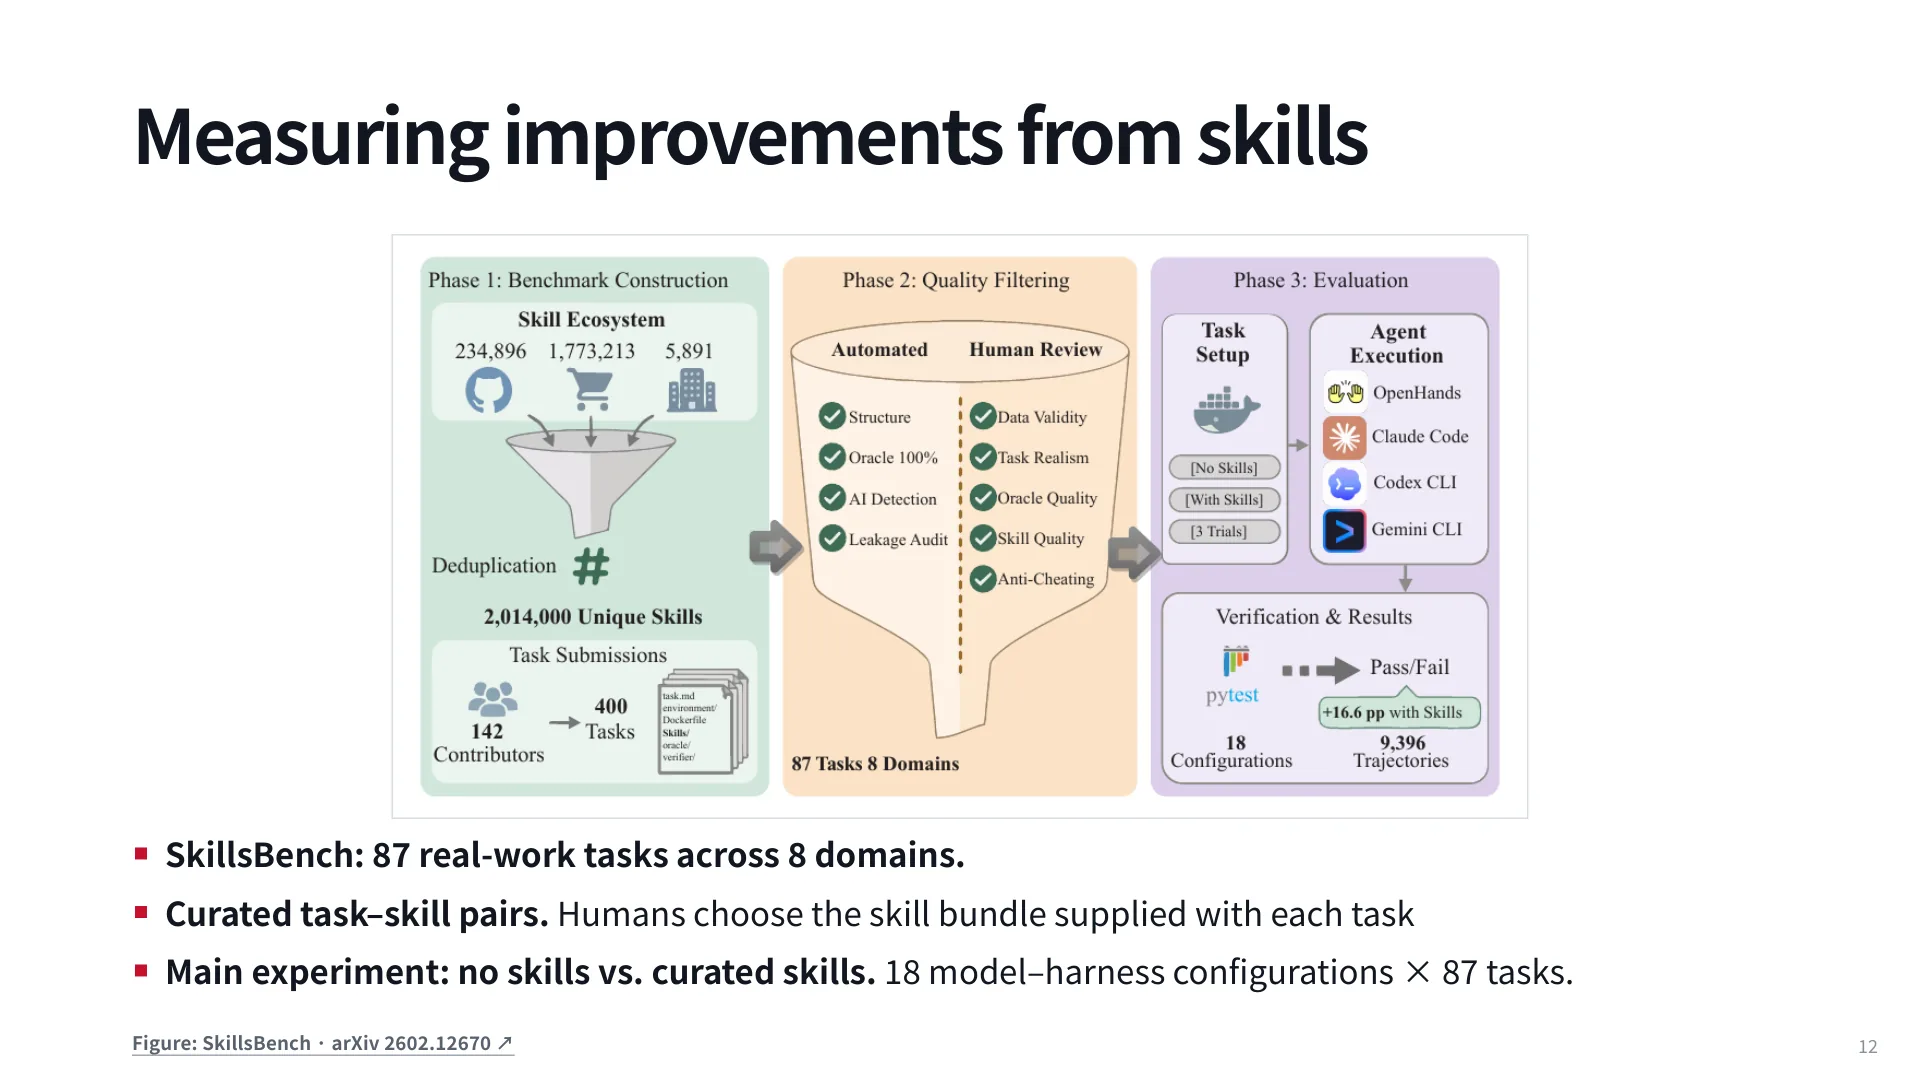
关键设计是“任务与技能独立产生”:任务作者先写任务,再从技能池里挑出“可能有用”的技能打包,因此技能不是为任务量身定制的答案泄漏。评测指标是人工编写的验证标准,比“模型自评”可靠得多。
结果是(28:27):平均通过率从 33.9% 提升到 50.5%,接近 17 个百分点;图上每根柱子下半(实心)是无技能成绩、上半(浅色)是技能带来的增量,几乎全线抬升。但同一页也写了两条限制,而且都很重要:
- 聚焦的技能收益更大:只需 1–3 个技能的任务,提升明显大于需要 ≥4 个技能的任务;
SKILL.md更短的分组同样收益更大。 - 技能仍会在 13/87 个任务上造成退步:一个技能可能“挤掉”本来更好的默认策略。
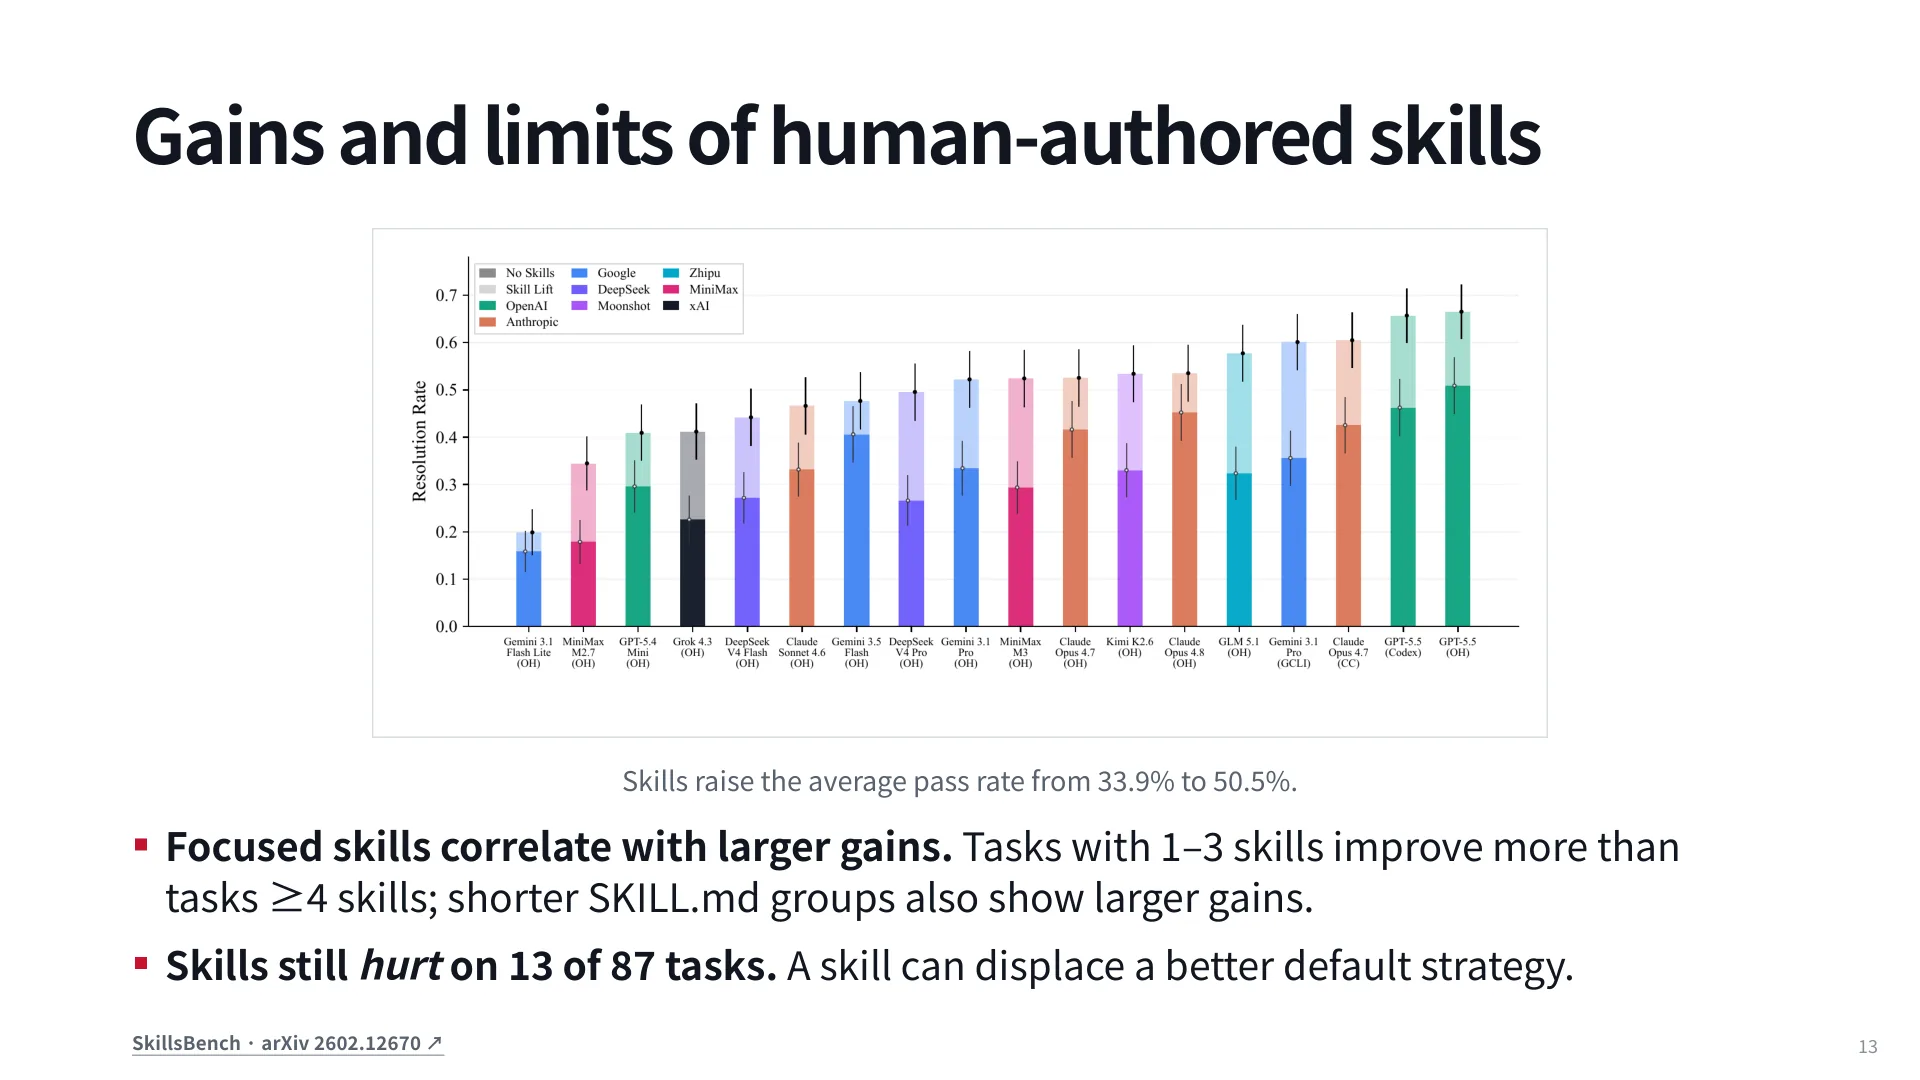
怎么读这两条限制?第一条有两种解释:难度混杂(需要很多技能的任务本来就难)与注意力稀释(更多技能意味着更长上下文、更多误导性指令)。第二条更值得警惕:技能是带倾向性的行为规范,模型可能用错地方,反而偏离它自己更擅长的策略。所以写技能不是无风险的正收益操作,必须配 A/B 评测,否则你不知道自己是在帮忙还是帮倒忙。
这套实验测的其实是两件事的混合:技能本身的质量,以及“模型 + harness 能否在正确时机用对技能”。课件把这项工作称为该方向较早的系统性尝试;87 个任务的覆盖面有限,结论宜看作量级参考而非定论。
5. 技能从哪来,以及怎么维护
技能包有三种来源(29:15):随 harness 内置、人写或安装(写进仓库的 .agents/skills/,或从 registry 装)、agent 自己创建(30:03:Hermes 的 skill_manage 可创建/打补丁/删除,OpenHands 的 /skill-creator 能从刚跑完的流程草拟一份)。
课件给了一条很实用的建议:不要从零开始写技能。让 agent 刚做完一个你想重复的流程,立刻基于这次的轨迹生成技能,然后跑几次验证。原因在课堂讨论里说得很清楚:任务执行过程会暴露你事先想不到的约束;而“凭任务描述凭空写技能”的效果很差——SkillsBench 里有一组结果甚至显示,让模型只看任务描述自造技能,性能反而下降。
技能写出来只是开始,真正决定长期收益的是维护闭环。第 15 页的案例是 OpenHands 在自己仓库上跑的 code-review 技能:
- 每次 PR 都跑这个技能,产出 review 建议;
- 打分:PR 合并后,用模型 judge 数一数“人最终采纳了多少条建议”;
- 找共性失败:让模型读运行记录,归纳反复出现的问题——约 15% 是“忽略仓库约定”,约 10% 是“放过带严重缺陷的 PR”;
- 改
SKILL.md:同一个模型起草补丁——“发现严重问题时必须 request changes”“发建议前先对照仓库检查”。
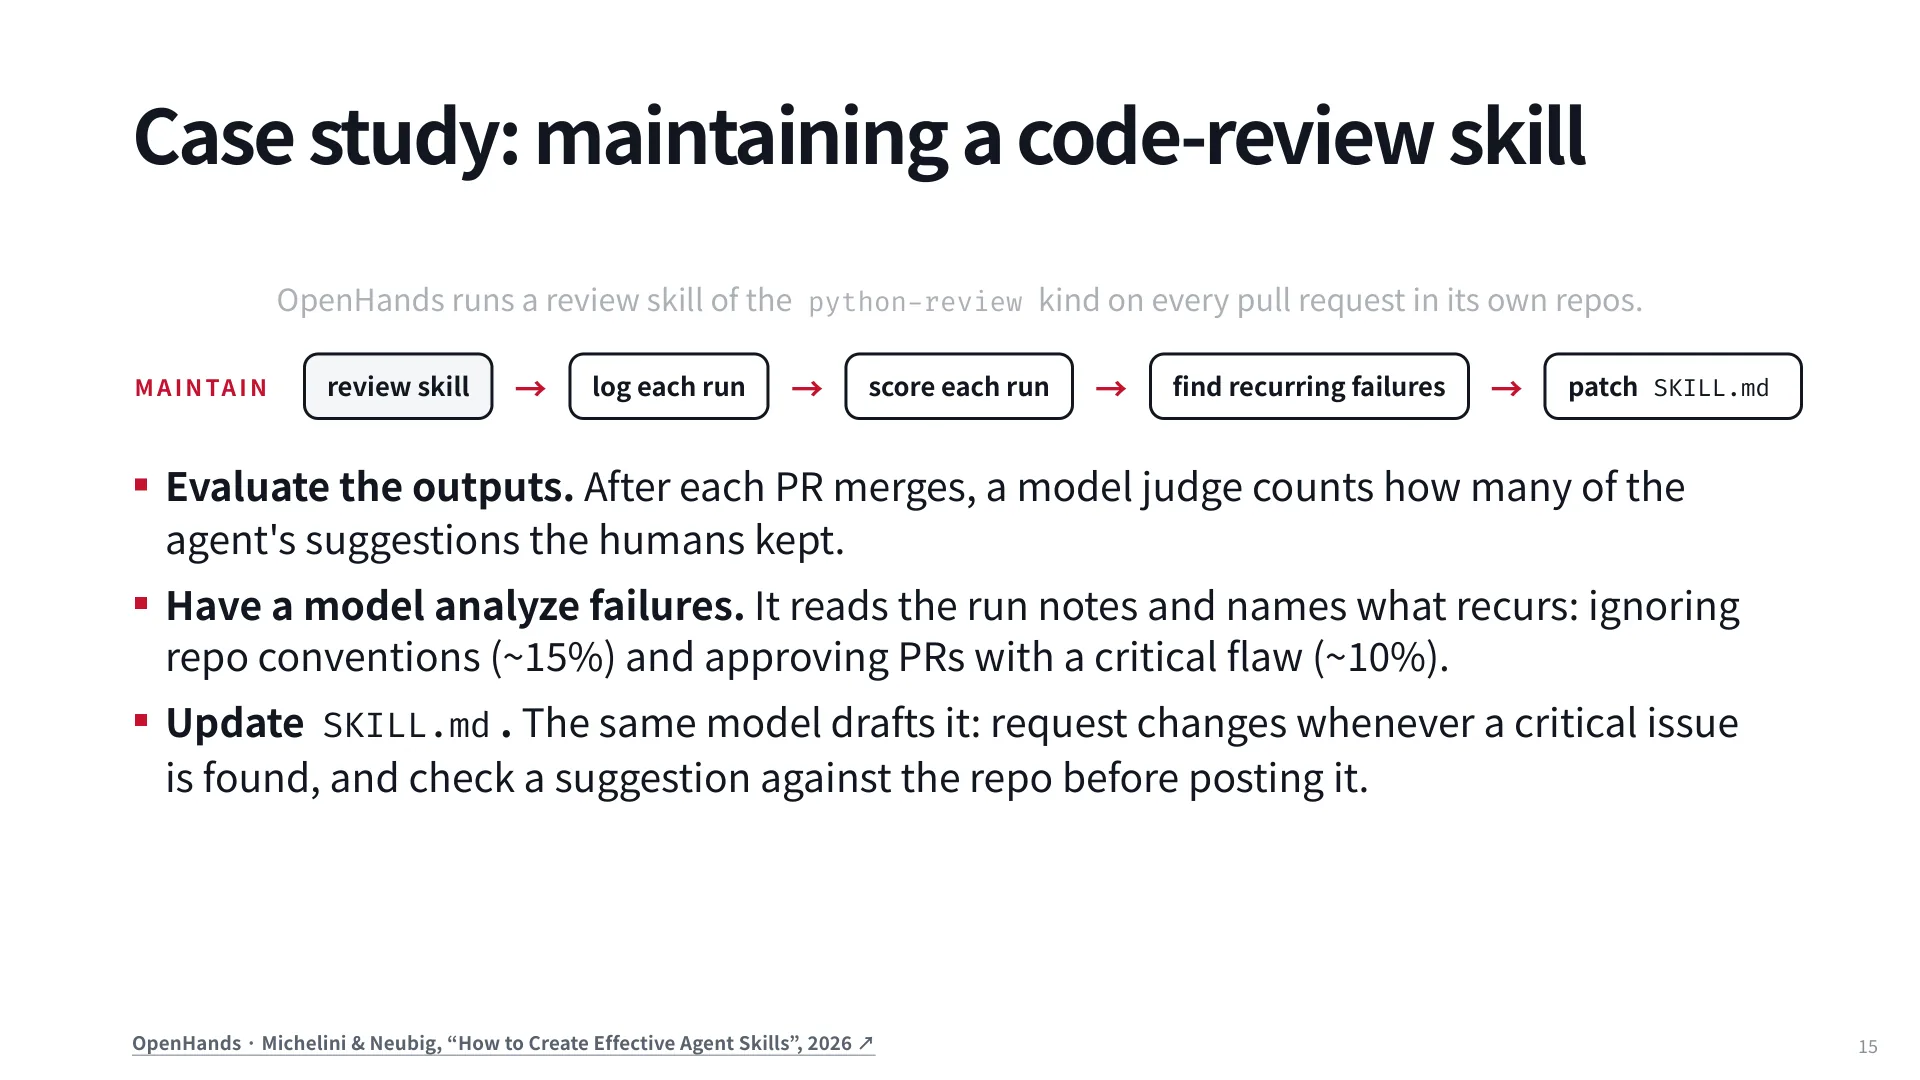
这个闭环把“技能”从静态文档变成了有反馈信号的产品。局限也很明显:用“人是否采纳”作代理指标,会奖励“好听但无关紧要”的建议,惩罚正确但让人不舒服的批评;judge 的系统性偏差还会直接写进技能里。所以最好再加一道人工抽检。
6. 外部记忆的基础设施:MemGPT 与冲突消解
技能是“关于如何行动”的记忆,但 agent 还需要“关于世界与人”的记忆。这块的基础工作来自 MemGPT(Packer et al., 2023),一个明确的操作系统类比:上下文窗口是内存(快、小),外部存储是磁盘(慢、大),模型通过工具调用在两者之间搬运。
具体结构是:固定的 system instructions;一个 working context,装着当前该看的东西;一个外部记忆区,按需检索;再加上消息历史。读和写都是 agent 自己发出的函数调用,而不是外部管线偷偷做的。
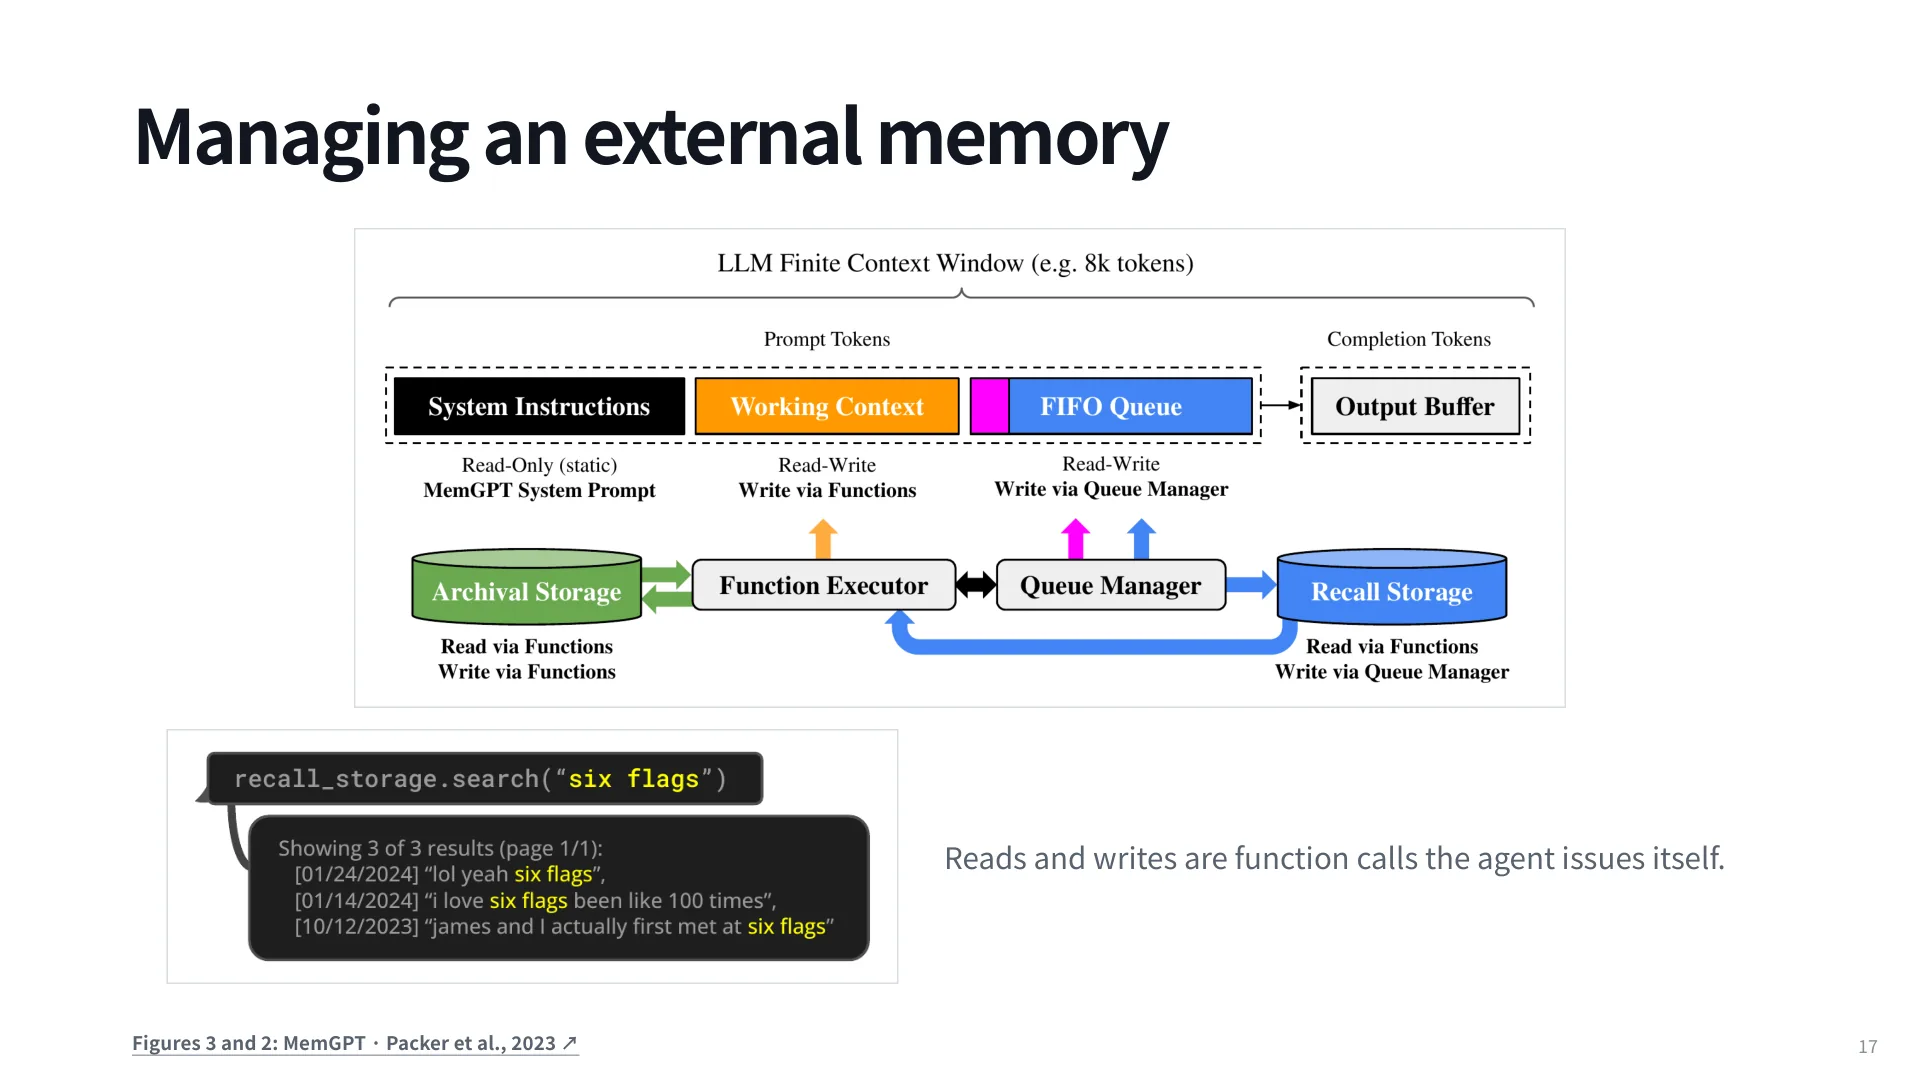
论文写作时上下文窗口只有 8k,这套设计是刚需;今天窗口大了,但“要记的东西”增长得更快——跨几十上百个任务,窗口迟早不够。所以这个思路对 agent 依然成立。
只“追加”是不够的(34:55)。你和助手说“我在 X 公司工作”,半年后说“我跳槽了”,如果系统只会 append,它就会同时相信两件矛盾的事。Mem0(Chhikara et al., 2025)把写入拆成四种操作:
| 操作 | 触发条件 |
|---|---|
| ADD | 记忆里还没有相似内容 |
| UPDATE | 新消息修改了已有记忆 |
| DELETE | 新消息否定了已有记忆 |
| NOOP | 已有记忆里已经包含,或与任务无关 |
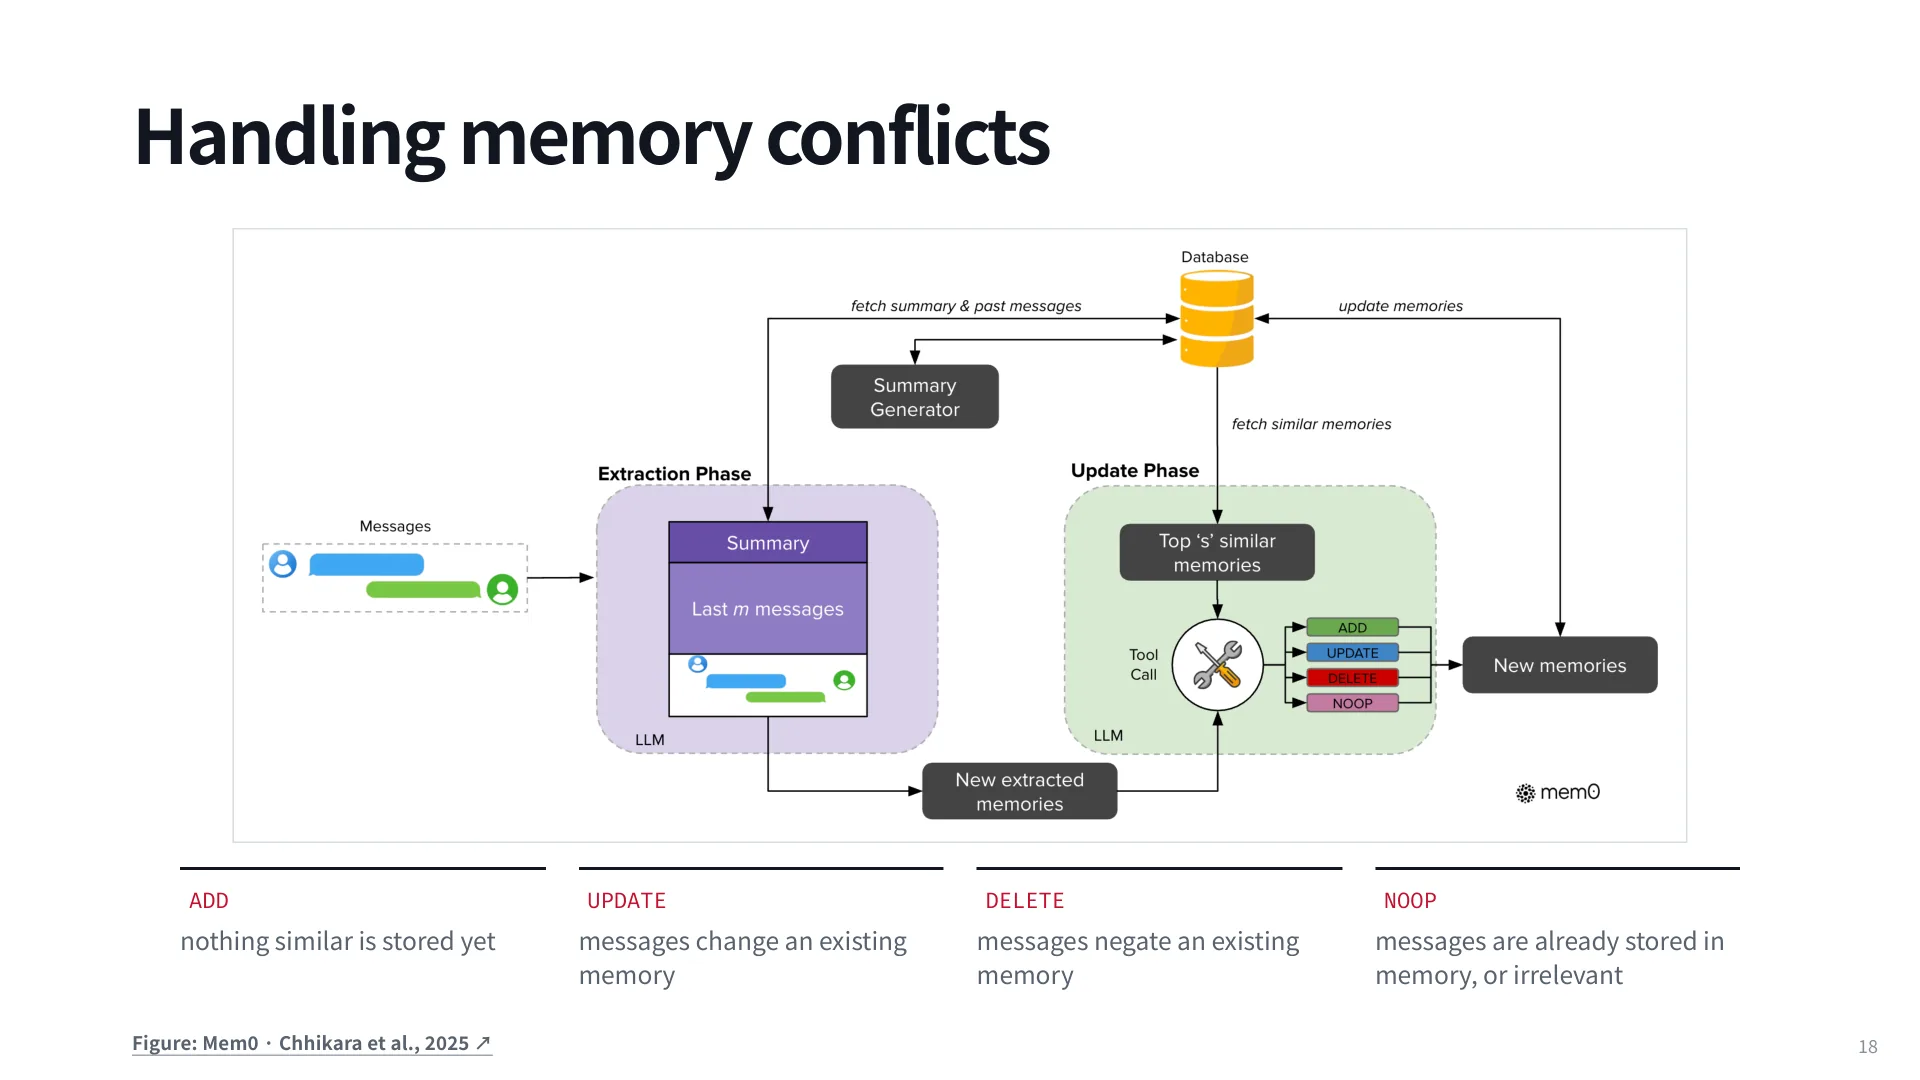
实现上是一个“抽取—检索—裁决”的流水线:每条新消息先由 LLM 抽出候选事实,用 embedding 检索 top-k 相似记忆,再让 LLM 判断每条候选是新增、覆盖、否定还是忽略。
Daniel 在这里做了一个跨讲的连接,很值得记住:上一讲讨论上下文管理时,Delta 那类工作做的其实是同一件事的向量版——线性注意力只能往记忆里 append,而 delta 规则会先检索出与当前 query 相关的存储值,再改写它们。文本记忆的 ADD/UPDATE/DELETE 是它的符号类比。他还提到,如果更新的是权重,同样的需求会以“遗忘/机器遗忘(unlearning)”的形式出现:要让模型忘掉一个过时事实,比让它记住难得多。
在 agent 场景里冲突消解更棘手,因为“事实”常常是环境状态:“这个按钮在左侧栏”可能下周就不成立。记忆需要带上时间、来源和适用范围,否则 UPDATE 会把“某站点的旧布局”覆盖成“所有站点的布局”。
7. 从反馈到轨迹:Reflexion 与“给 agent 做 RAG”
MemGPT/Mem0 处理的是事实;agent 还需要从自己的行为里学习。Reflexion(Shinn et al., NeurIPS 2023)是最简单也最有效的一招:同一任务允许多次尝试,每次失败后让模型用自然语言写一段“我为什么错了、下次怎么改”,把这段反思作为下一次尝试的条件。
课件里的例子很典型:问“1776 年 10 月 28 日发生在 White Plains 附近的一系列战役是什么”,第一次答 Battle of White Plains(单场战役),判错;反思写道“问题要的是 a series of battles,我只给了一场,应该给出 campaign 的名字”;第二次答 The New York and New Jersey campaign,正确。
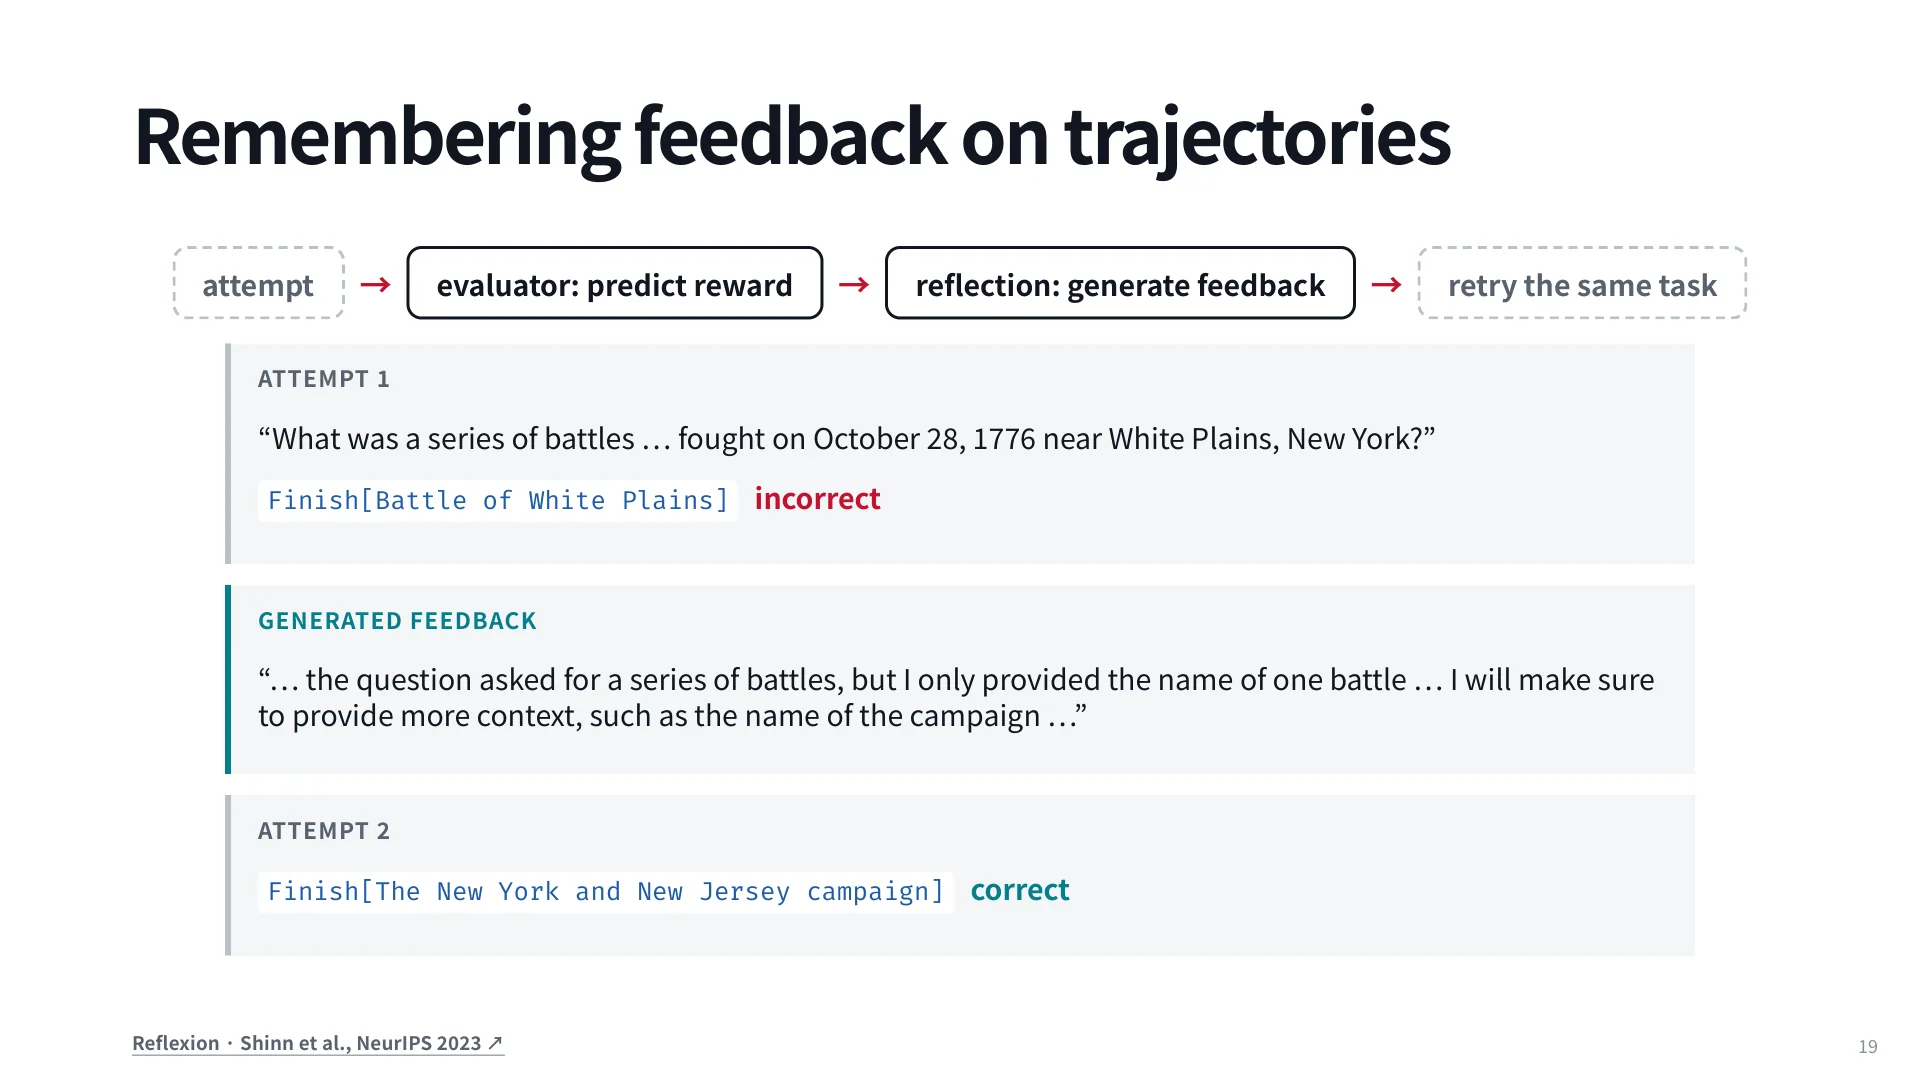
妙处在于反馈是语言而不是分数:标量奖励只说“错了”,自然语言反馈说清“错在哪、往哪改”,而后者正是模型最擅长条件化的东西。代价是它只在“同一任务可重试”时直接有效;要迁移,反思必须写得足够一般,否则就变成对原题的答案泄漏。
再往外推一步,就是记忆整条轨迹(41:34)。这类方法(ExpeL、Agent S、Synapse、ICAL 等)共享一个骨架:维护轨迹池,新任务来时按相似度检索最像的几条,作为 few-shot 示例塞进上下文。
课件把它称为“agent 版的 RAG”,并列出三个设计维度:存什么(整条轨迹,成功与失败都存,有时改写并加注释)、池子从哪来(离线训练阶段收集、在线工作中增长、或人工预先编写)、怎么用(用文本 embedding 检索最相似的任务,作为 few-shot 示例)。检索信号通常只是任务描述的 embedding,也可以加上领域约束(“只检索这个站点的任务”)。
它有效的原因很直白:示例把“环境长什么样、动作空间怎么用、常见坑在哪”一次性展示出来,比任何抽象描述都具体。局限同样直白:轨迹很长,几条就填满上下文;相似度不等于有用性,检索到“看起来像但关键约束不同”的轨迹会把模型带偏;失败轨迹直接当示例,帮助也有限(第 11 节会看到证据)。
8. 归纳技能:从轨迹到 workflow
有了“记忆事实”和“记忆轨迹”的基础,就可以问本讲的核心问题:能不能把轨迹压缩成技能?
先明确评测设定。课件采用的是在线学习(online learning):任务一条一条到达,每成功解决一个任务,就在下一个任务到来前更新记忆;指标是“到目前为止所有任务上的累计成功率”。这个设定比“离线训练集 + 测试集”更接近真实部署——agent 一边干活一边变强,而且要能处理越来越复杂的任务。
围绕这个设定,技能的生命周期可以写成三段流水线:
- LEARN:episode → judge(判最终状态是否正确)→ induce(归纳)→ admit(决定是否入库)→ memory
- USE:memory → select/retrieve → act → outcomes
- MAINTAIN:outcomes → add → repair → retire → memory
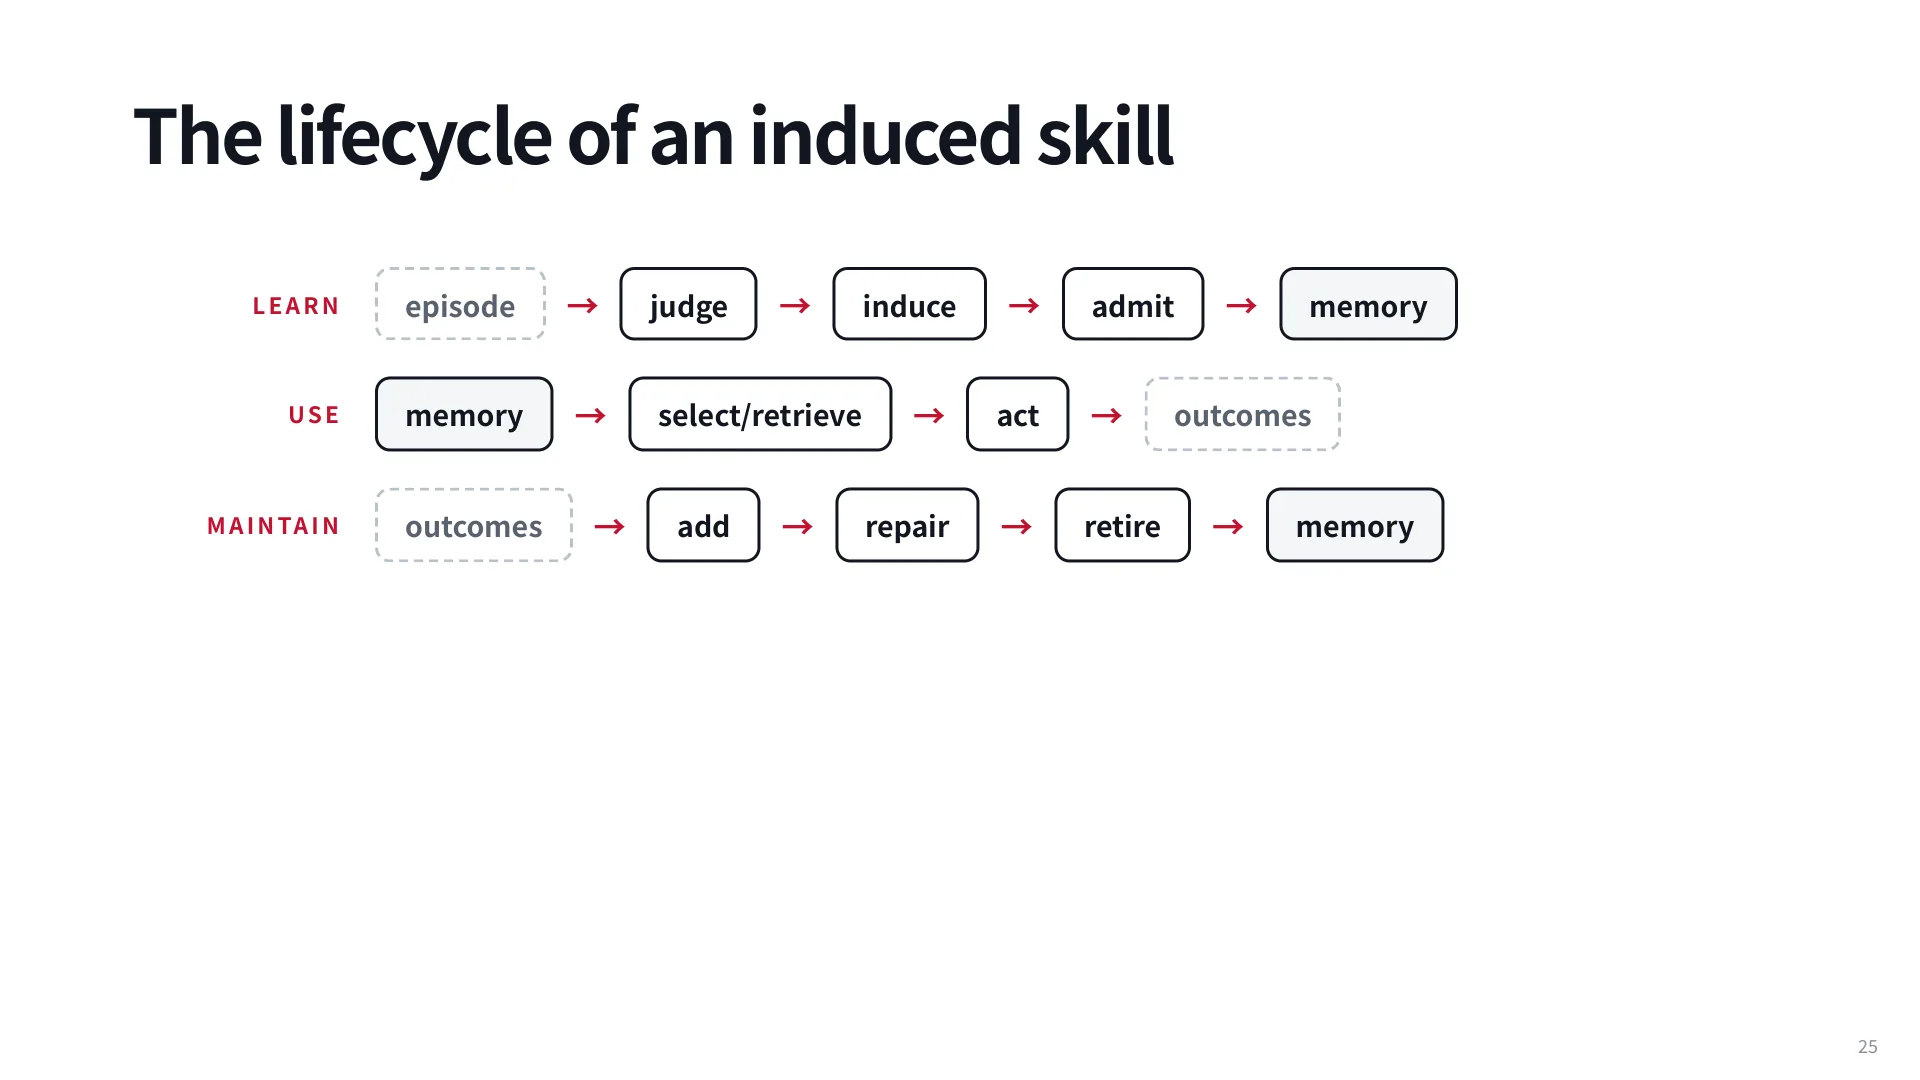
值得注意的是虚线框:episode 和 outcomes 是外部输入,其余都是系统内部决策。这条流水线也解释了为什么“归纳”不是单一模型调用(52:59),而是一串判断:judge 判对错、admit 决定是否入库,任何一环出错都会把噪声写进记忆。
Agent Workflow Memory(AWM,Wang et al., ICLR 2025,CMU 的 Zora Wang 主导)是文本表示的代表性工作。流程是:拿到一条成功轨迹 → judge 判定最终状态正确 → 用 few-shot prompt 让 LLM 从动作序列里抽出重复出现的子序列 → 把具体参数替换成变量 → 得到一条 workflow:
Task: Search for reviews matching "{term}"
Actions:
# To find reviews for {term}, I will search for "{term}" in the reviews page
click("All reviews")
fill(757, "{term}")
click("Search")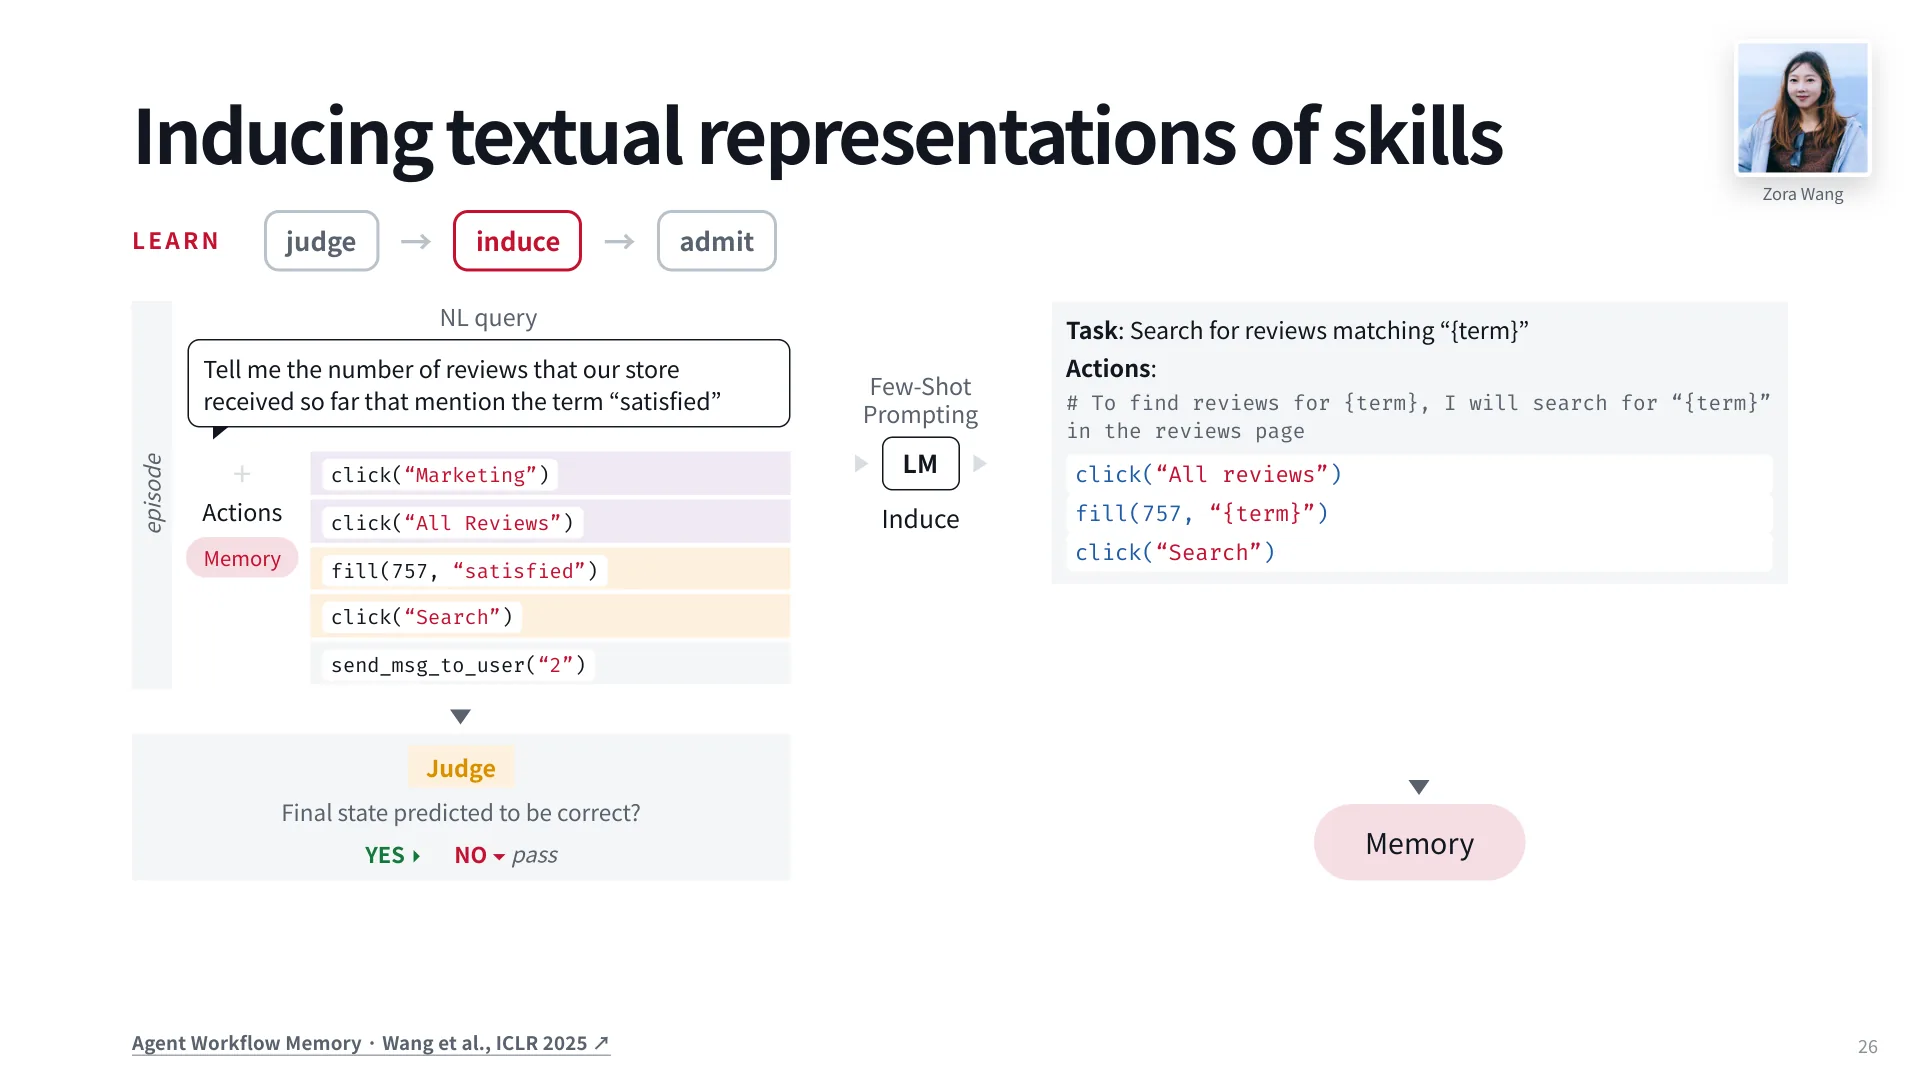
归纳提示词里有几条约束特别关键,它们其实是“什么叫一个好技能”的操作化定义:只抽跨任务重复的动作子集;每个 workflow 至少两步;不要生成相似或重叠的 workflow;用有描述性的变量名替换非固定元素(输入文本、按钮字符串)。最后一条是把“具体”变成“可复用”的关键动作——fill(757, "satisfied") 只能解决这一题,fill(757, "{term}") 才能解决一类题。
注意这套表示已经很像代码:有名字、有参数、有步骤——这正是后面比较“文本 vs 代码”的伏笔。
效果如何?在固定顺序的任务流上,无记忆基线大部分时间在 10–22% 之间,AWM 曲线随后在 25–41% 区间震荡;到第 40 个样例时差距扩大到 22.5 个百分点,还能完成基线做不动的复杂任务(如“找某地点附近的酒店并给出步行路线”)。课件称之为 cross-task memory compounding:前面的成功不只是解决了一个任务,还为后面的任务降低了难度。
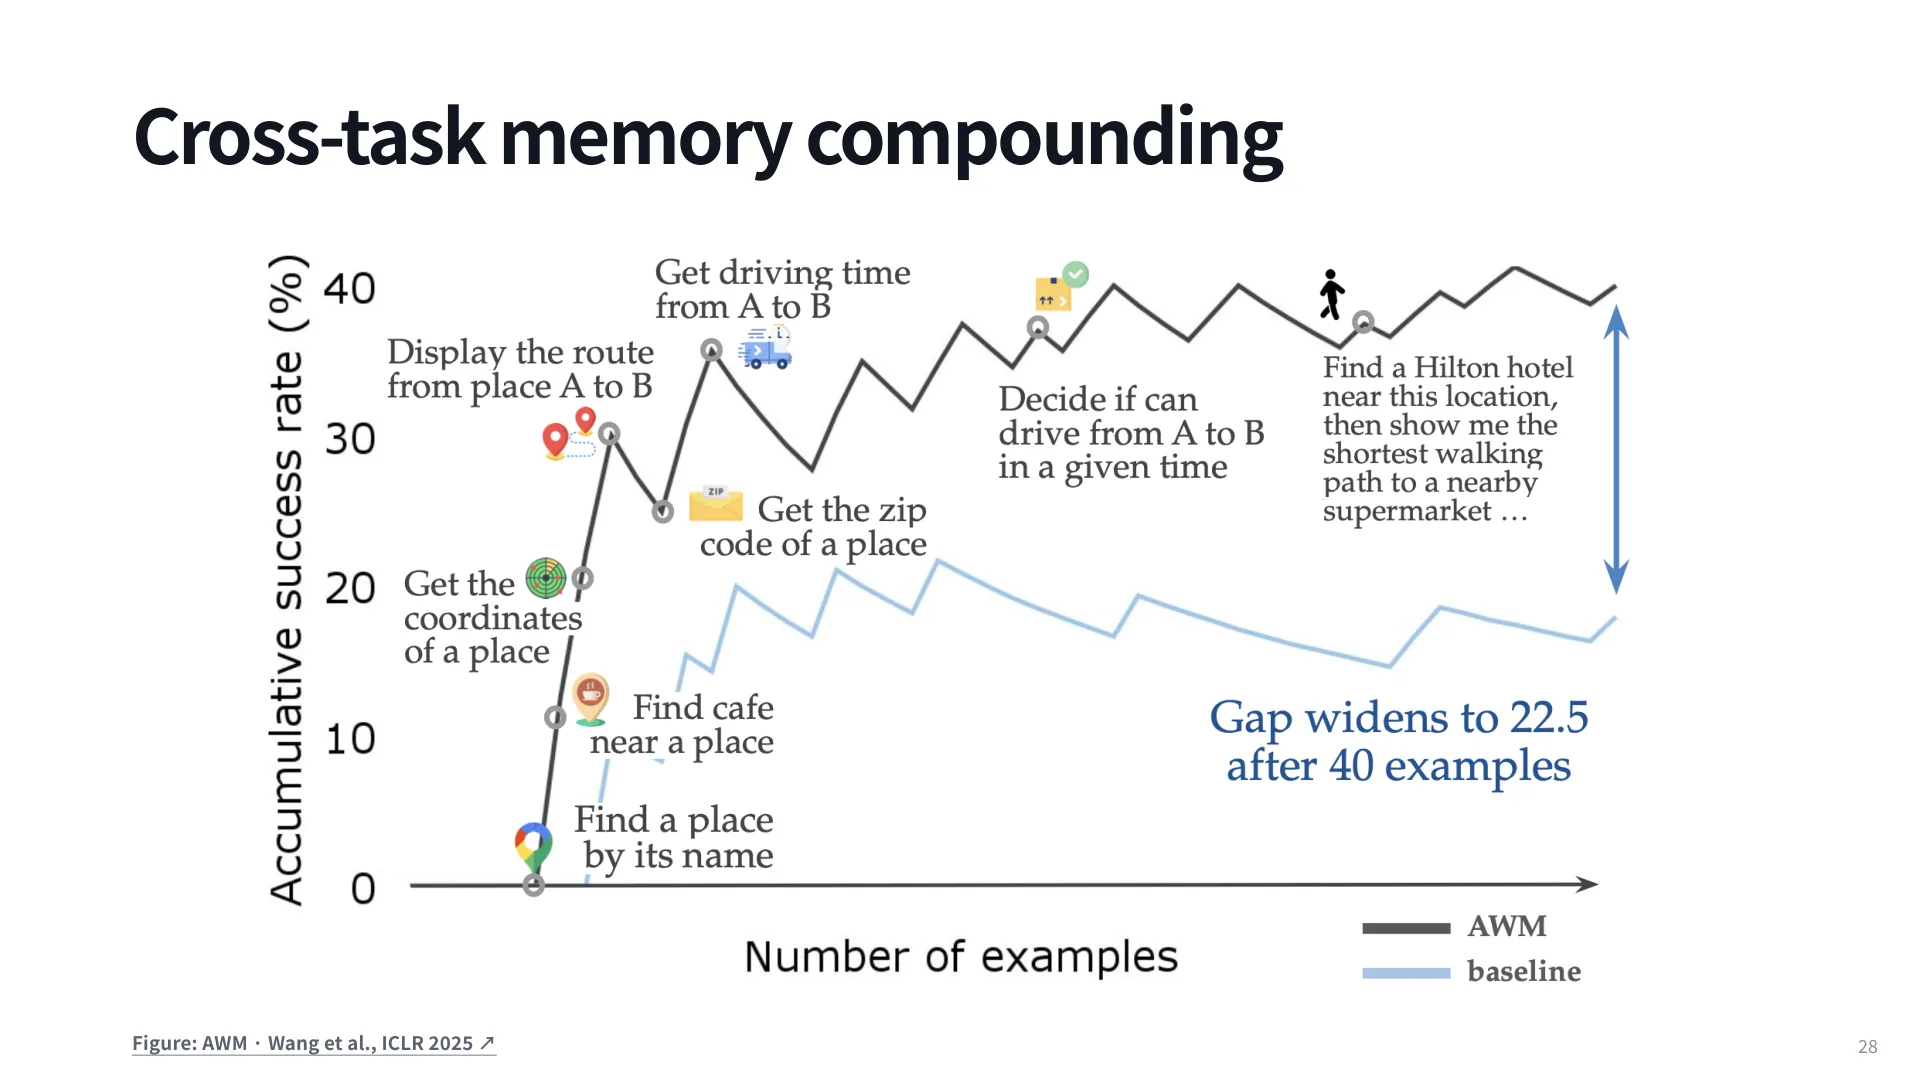
这张图很有说服力,但要小心条件:任务顺序固定、领域相同、技能确实可复用。换个顺序或站点,收益可能大幅缩水——这正是第 10 节要讨论的泛化问题。
9. 文本还是代码
同一个“搜索商品”的技能,可以写成一段带注释的动作示例,也可以写成一个函数:
def search_product(search_box_id: str, query: str):
    """Search for a product using the search box.
    Args:
        search_box_id: ID of the search input field
        query: Search query string to enter
    Returns:
        None
    Examples:
        search_product('595', 'sony bluetooth headphones')
    """
    click(search_box_id)
    fill(search_box_id, query)
    keyboard_press('Enter')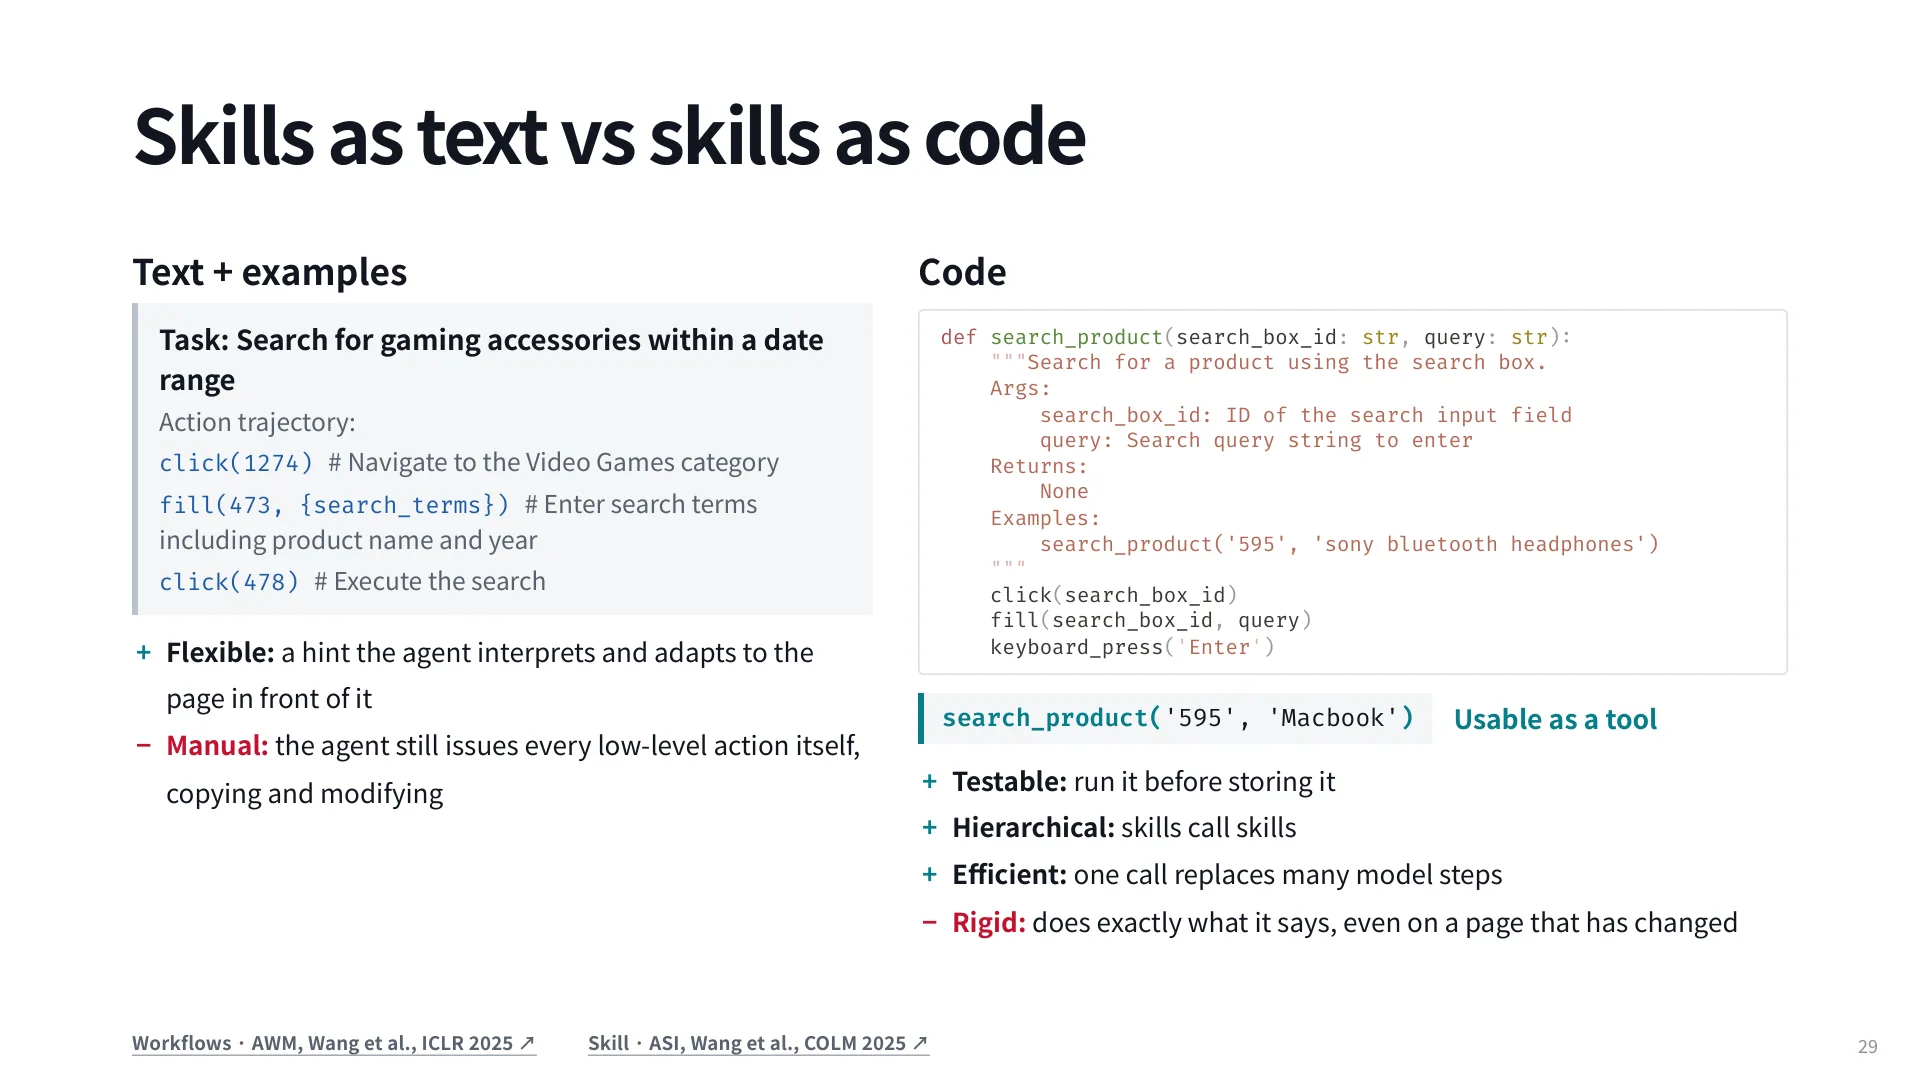
两者的差别不在“写法”,而在谁承担执行。文本技能进上下文后,模型仍要自己发出每个底层动作:重新找搜索框、重新决定填什么、重新点按钮。这带来了灵活性——页面改版时模型可以现场改用新元素;但对已经稳定的流程来说,这些动作全是重复劳动。
代码技能把执行交给环境(56:18):模型只要传对参数,函数内部的三步由运行时完成。于是有了四个额外好处,也有一个明显代价:
| 文本 + 示例 | 代码 | |
|---|---|---|
| 作为工具调用 | 否,模型逐步执行 | 是,一次调用完成 |
| 适应性 | 高,可就地修改 | 低,严格照做 |
| 可测试性 | 难,只能看最终结果 | 高,可单独执行、lint、写用例 |
| 组合性 | 弱,靠模型拼接 | 强,函数可调用函数 |
| 效率 | 与无记忆相近 | 一次调用替代多步 |
这就是课件那句总结的来源:代码“可执行、可组合、高效,但可能很脆”。
把代码技能真正跑起来的是 ASI(Wang et al., COLM 2025)。它沿用 AWM 的流水线,但让模型生成函数与 docstring,并同时生成一条“用这些函数重写原轨迹”的新轨迹;然后执行这条新轨迹,把 judge 用在执行结果上,而不是用在原始轨迹上。这个改动看似小,意义很大:判定对象从“看起来对的动作序列”变成了“跑出来的结果”,这是强得多的证据。
SkillWeaver(Zheng et al., 2025)把“先测后存”做得更彻底,伪代码大致是:
candidates = propose_skill(task)
episode = practice(candidates, task)
if reward_model(episode.actions, episode.screenshots, task):
    memory.add(candidate)
else:
    candidate = revise(candidate, task)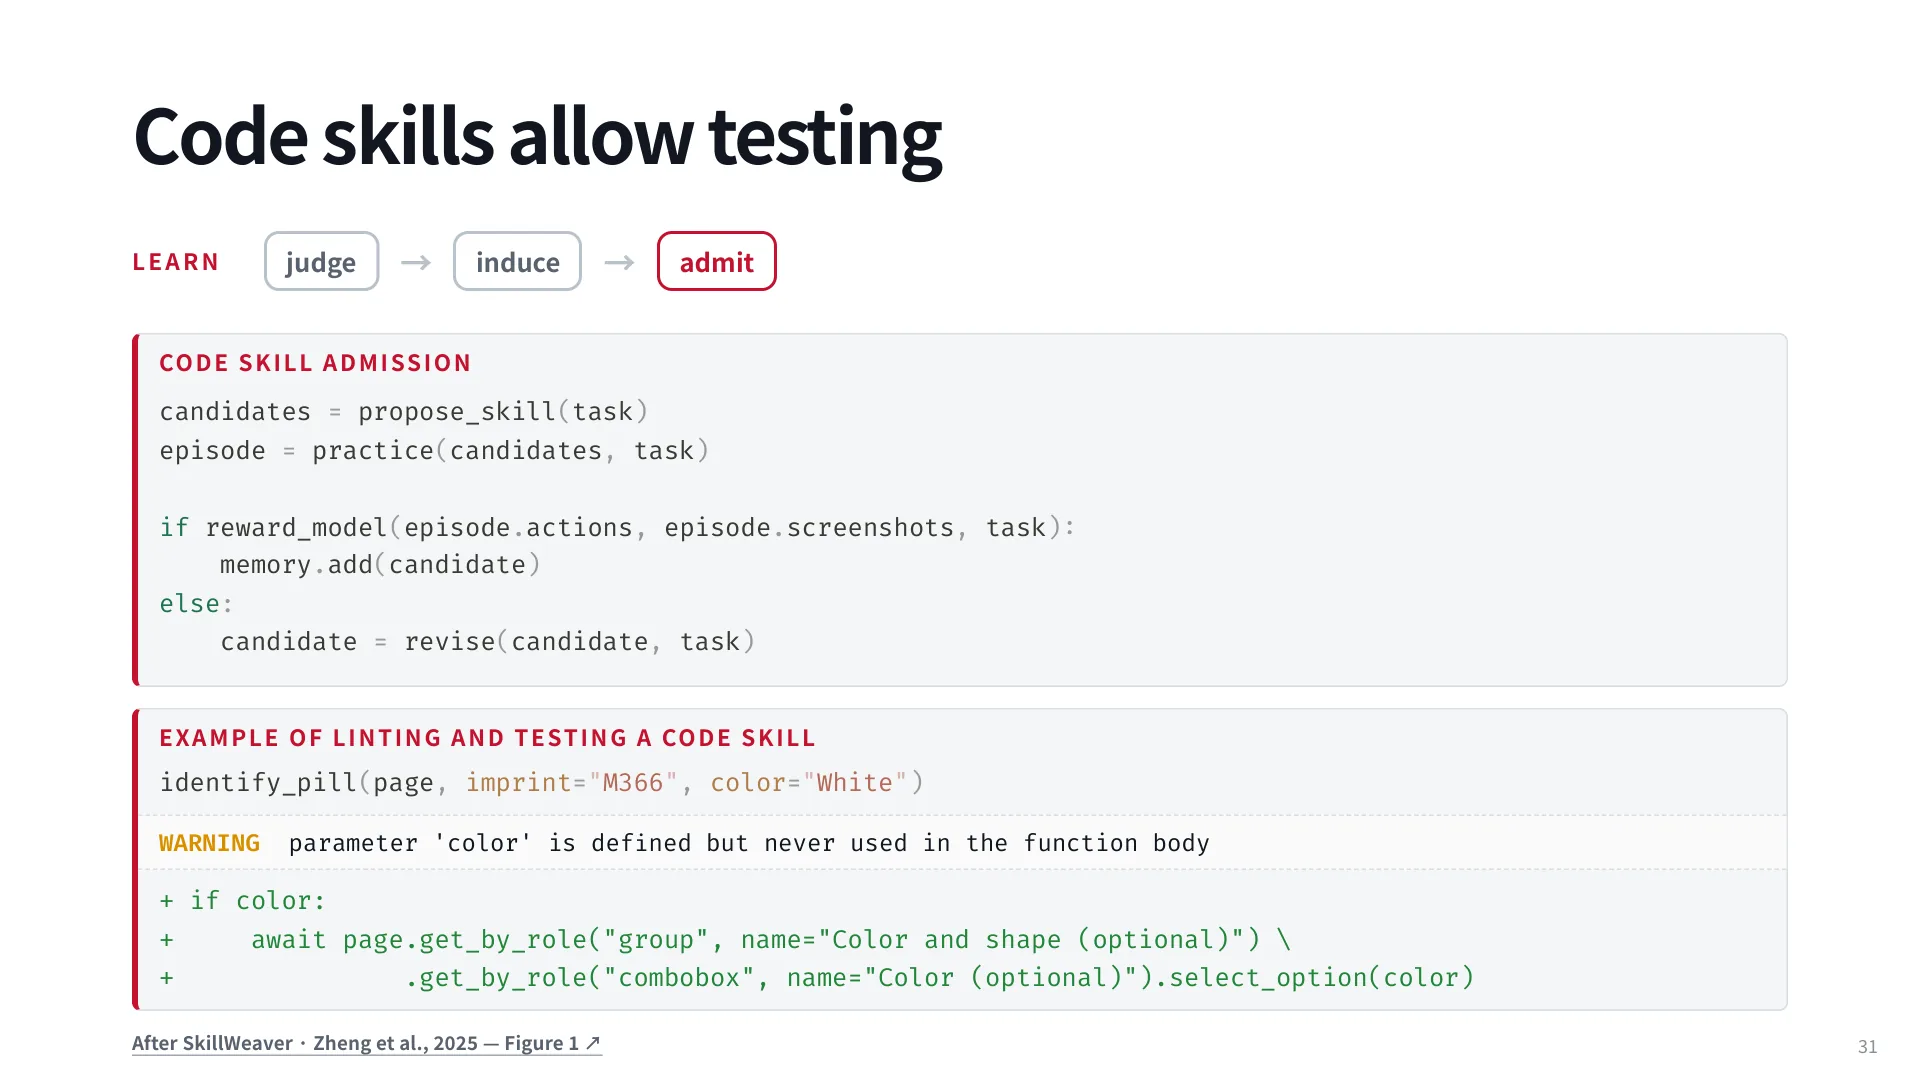
它给出的真实失败案例很能说明“代码可测”的价值:一个操作药品网站的技能 identify_pill(page, imprint="M366", color="White") 声明了 color 参数,但函数体里根本没用它——linter 直接报 “parameter 'color' is defined but never used”。这类错误在文本技能里几乎无法自动发现(文本没有“未使用参数”的概念),在代码里却是一个静态检查就能抓住的信号;把 lint 反馈喂回去,模型补上了 select_option(color) 那段,技能才真正可用。
效率收益是可以量化的。第 32 页的例子是同一页面上的地址修改任务:无记忆时要走完“点进设置 → 找表单 → 逐字段填写 → 保存”的全部底层动作,最多 50 步;有了“进入地址设置”“更新地址详情”两个代码技能后,4 步就完成了。
为什么步数这么重要?因为每一步都意味着“观察(截图)→ 生成思维链 → 发出动作”的完整循环,图像和推理都要消耗大量 token。减少环境交互次数因此是 web agent 的关键瓶颈——每一轮都要重新截图、重新生成思维链。
在五个 WebArena 站点上的平均对照(第 33 页)给出了同一结论的两个维度:checkpoints reached 从 41.3%(无记忆)到 59.5%(文本技能)再到 80.2%(代码技能);每任务步数从 24.5 降到 20.6,再降到 15.0。
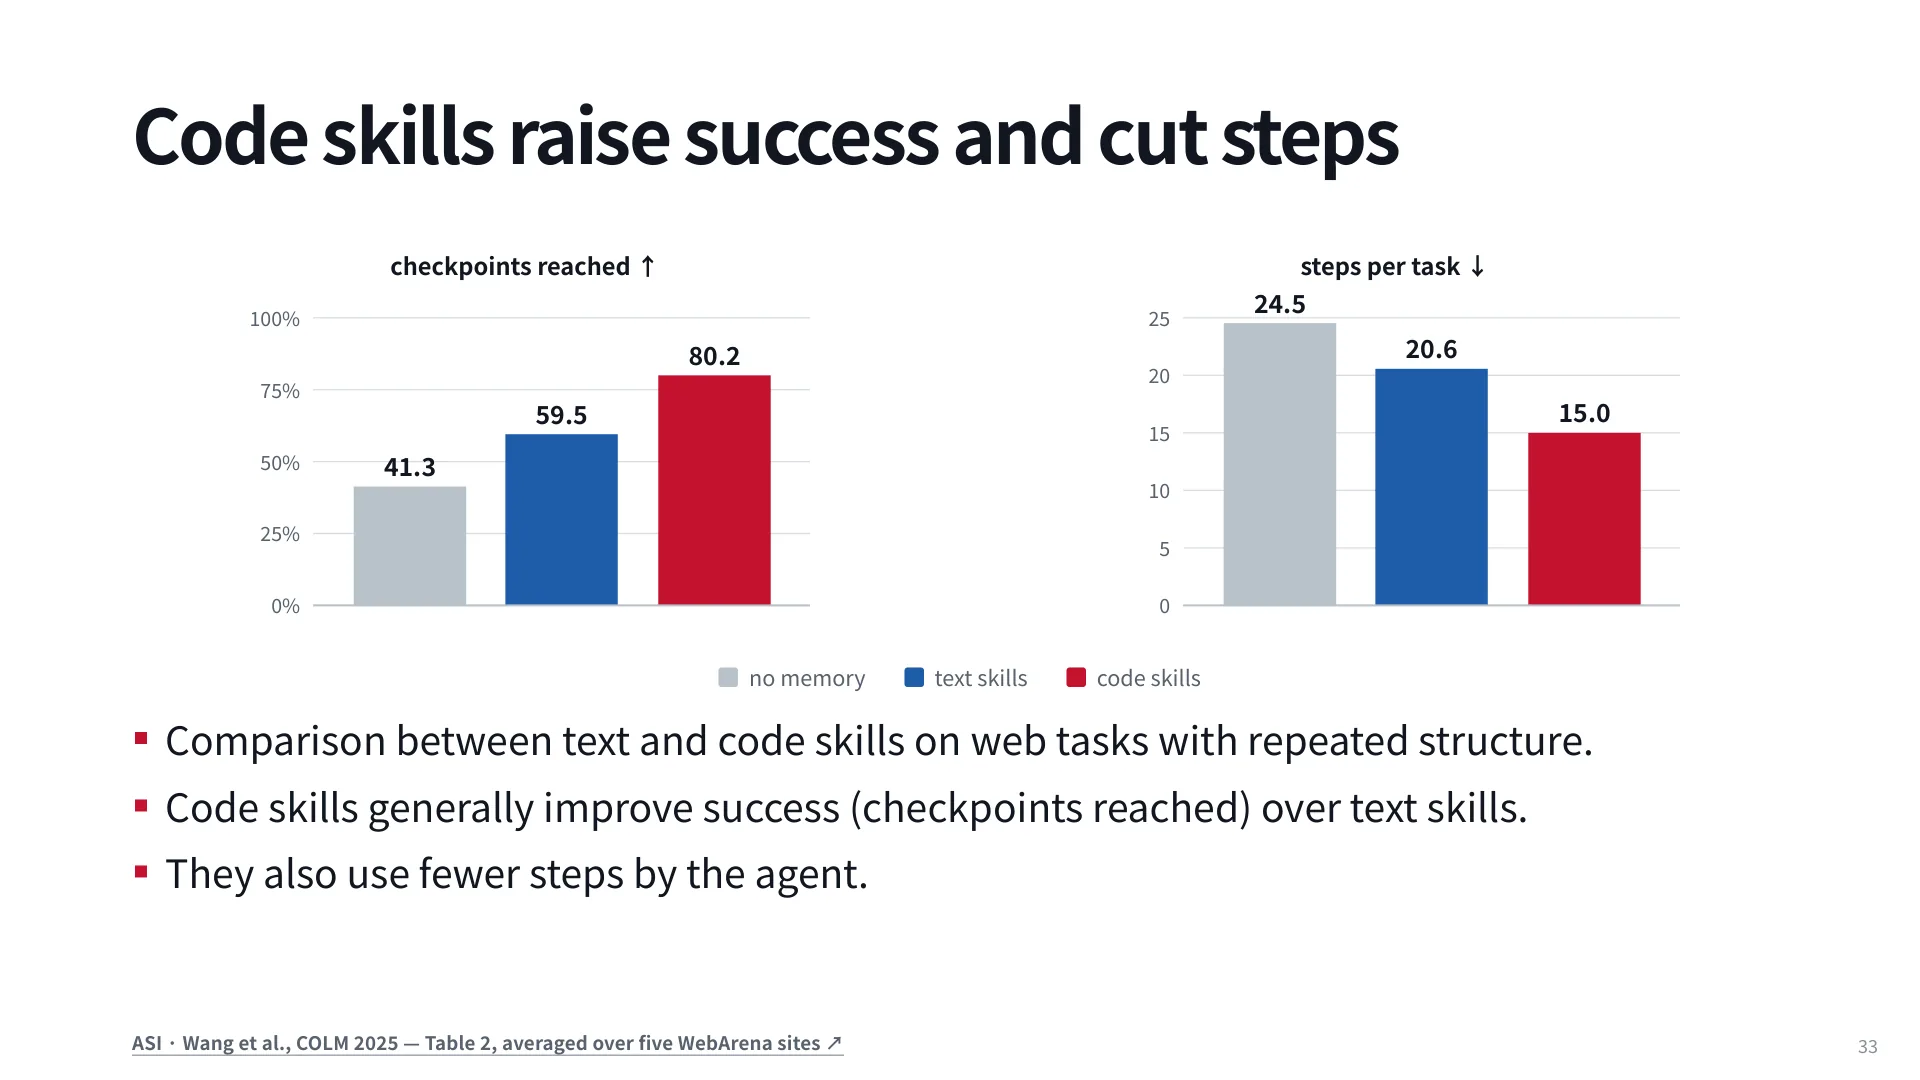
注意这里有个容易被忽略的信息:文本技能几乎不省步数(24.5 → 20.6 的降幅远小于代码的 15.0)。这符合机制——文本技能只是给了模型更好的先验,动作还是它自己一步步发的。如果你的目标只是提高成功率,文本够用;如果目标是降低延迟与成本,代码才是答案。
10. 效率之后:泛化与抽象接口
代码技能的“脆”不是理论担忧,课件给了一个真实的跨站迁移失败案例。在一个站点上归纳出的 sort_listings 假设“排序是一个下拉菜单”,点到 Target 的真实站点上(63:33),排序入口却是一个侧边栏——技能照字面执行,直接失败。
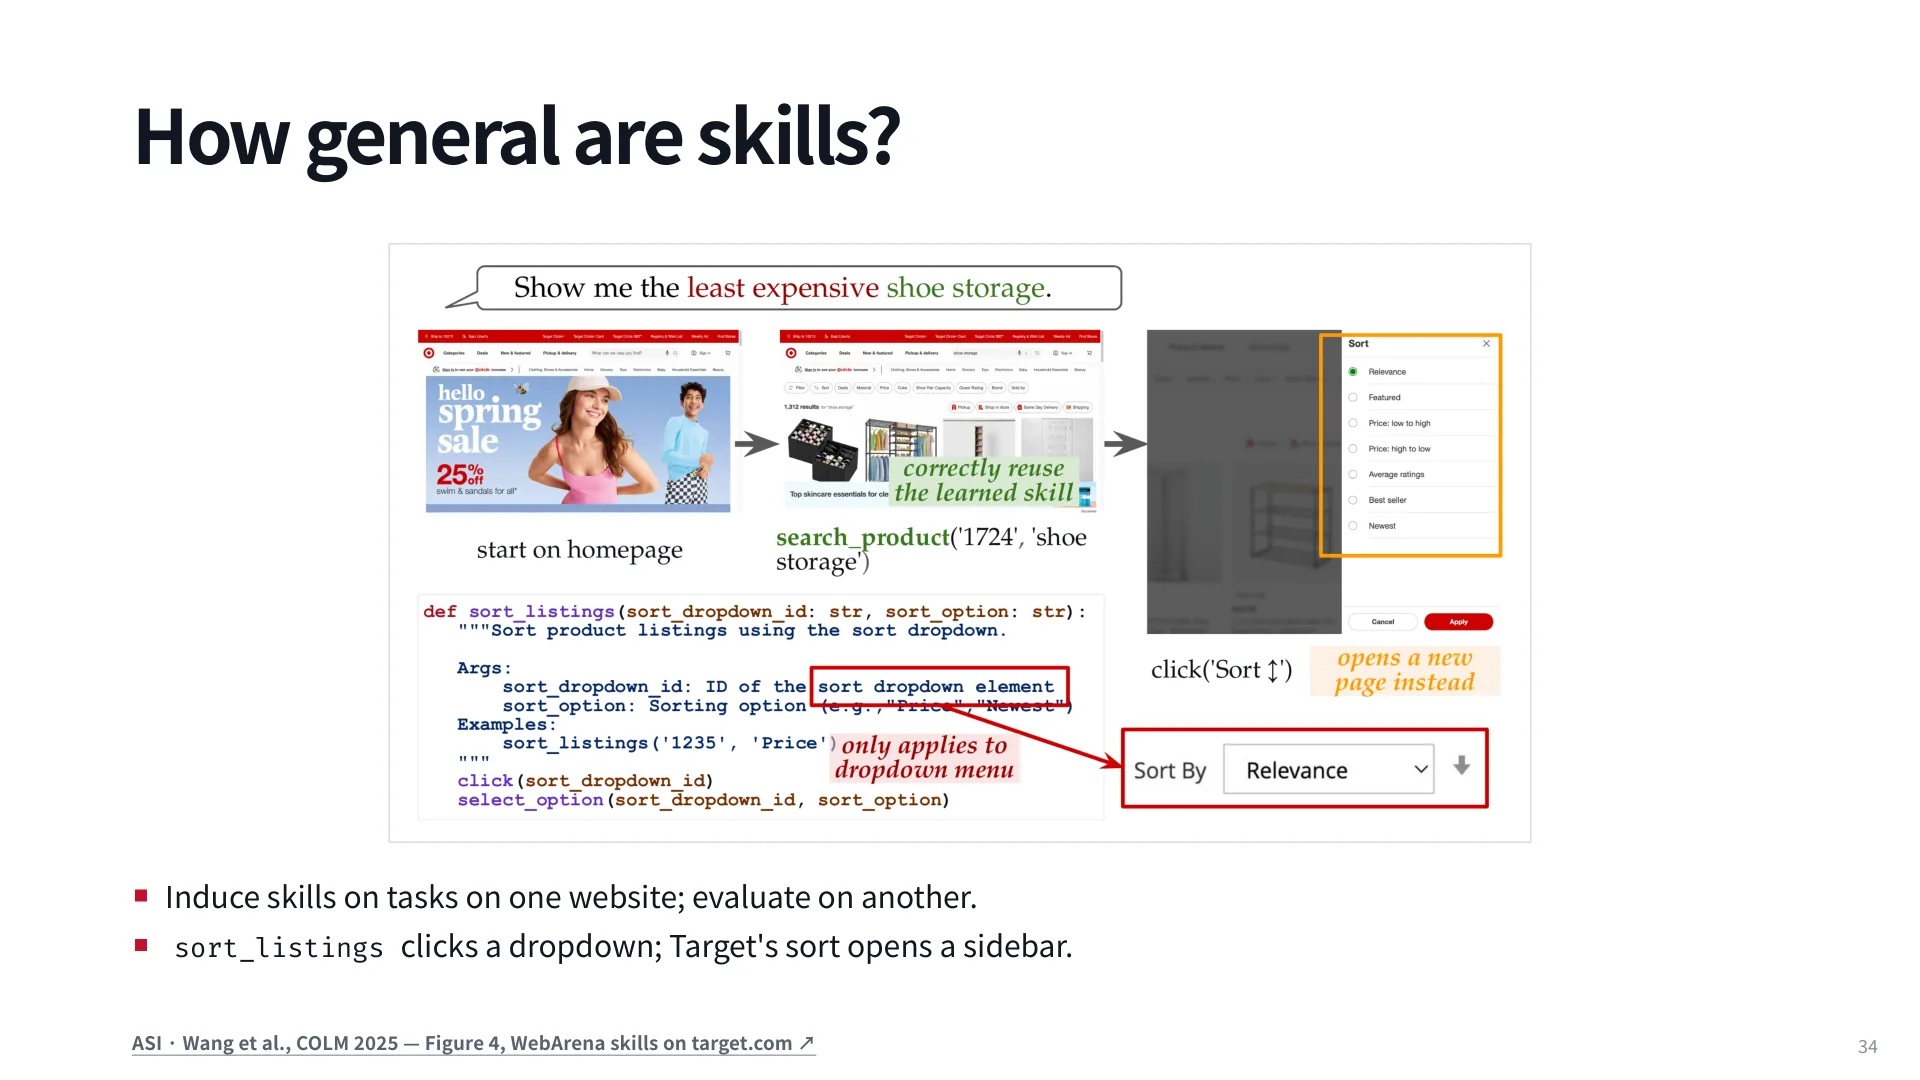
这暴露了表示层的根本矛盾:技能越具体越好用,也越不可迁移。文本技能有天然优势——模型发现页面没有下拉框,会自己找替代路径;代码技能没有这个余地,除非把“找替代路径”也写成代码。
PolySkill(Yu et al., ICLR 2026)用软件工程的标准答案来缓解:抽象类 + 具体实现。第一次接触新站点时,模型写一个不带实现的抽象类,声明 search_product、add_to_cart、checkout 这些原语;然后为当前站点写具体实现(比如 Amazon 版)。换站点时,靠元数据或模型判断“这个实现不再适用”,再写一份新的实现。组合逻辑只写一次,针对抽象方法;每个站点只实现最底层的浏览器动作。
好处有两个:迁移成本从“重写技能”变成“实现接口”;可以同时维护大量站点特定技能,而只让当前站点相关的子集激活,顺带缓解上下文膨胀。这其实是把面向对象的老经验搬到 agent 上——抽象是为了隔离变化。
代价也很真实:抽象层要预判哪些原语跨站稳定,判错就会出现“接口泄漏”;每个站点还要各写一份实现,冷启动成本高于“一个技能打天下”的做法。
11. 从失败中学习、过度检索与遗忘
到目前为止讨论的都是“从成功中归纳”。失败呢?
ReasoningBank(Ouyang et al., ICLR 2026)的案例极具代表性:任务是“给出 Sony 蓝牙耳机的完整型号名,以及各型号的价格区间”。agent 搜了 Bluetooth headphones Sony,得到 5,578 条结果,跨全站所有部门,每页 12 条,于是一路“下一页、下一页”,最后撞上步数上限,什么都没答出来。
从这条失败轨迹里,系统归纳出的是策略而不是流程:
- “查询优化”:模糊查询把答案埋在了几千条弱匹配结果下,浏览前应先收紧查询;
- “调整每页显示数量”:12 条/页让每次翻页只换来很小的覆盖面,性价比极低;
- “使用过滤器”:侧边栏的分类过滤器能在不分页的情况下缩小集合。
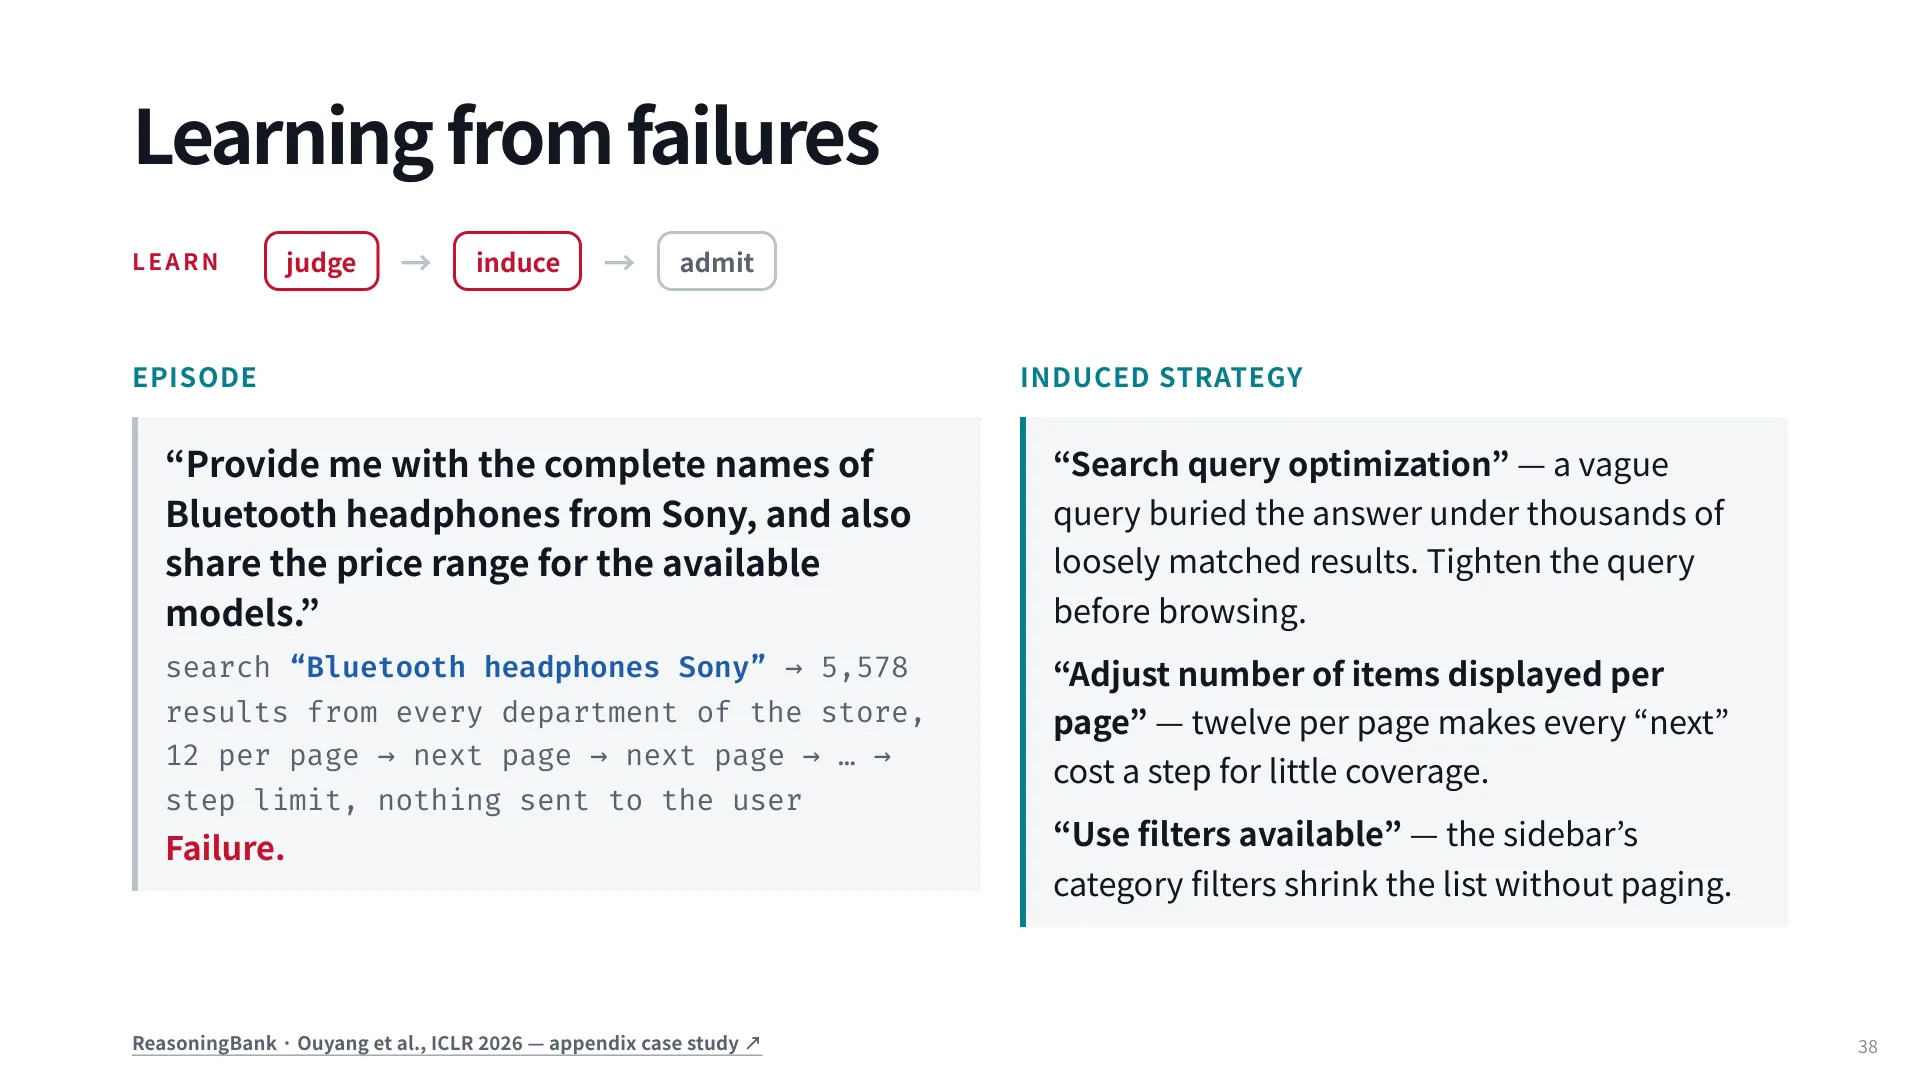
这三条恰好是“人写技能”时会写进去的那类经验,差别只在于它们是自动从一次失败里长出来的。这也解释了第 39 页那个反直觉的结果:失败对不同类型的记忆帮助不同。用失败去归纳“策略文本”收益显著;但把失败轨迹(Synapse)或失败 workflow(AWM)直接塞回记忆,收益不明显。原因不难理解:一条失败轨迹示范的是“不该怎么做”,模型很难从反面例子中稳定地推出正面行为;而一段策略文本直接给出了正面指令。
这套流水线有一个共同的薄弱环节:judge。判断“这条轨迹成功了吗”的模型并不完美,而它的错误会直接决定什么进入记忆。ReasoningBank 做了一个干净的校准实验:把真实标签按固定概率翻转,从 oracle 一直到抛硬币,模拟不同质量的 judge。结论是性能确实随 judge 准确率下降,但在相当宽的一段区间内,记忆仍然带来正收益。
这个结论对工程实践很重要:不必等到有一个完美的验证器才开始做记忆,但必须知道自己的 judge 大致在什么水位,并且在 judge 不可靠的领域(主观质量、长尾任务)降低自动化程度。
另一条被反复验证的经验是检索得越多不一定越好(70:53)。ReasoningBank 的消融显示,随着检索条数增加,性能会下降;SkillsBench 在人工技能上也观察到了同样的现象。课件给了两种解释,对应两种完全不同的应对:
- 数据侧限制:跑过的任务太少,记忆里没有相关经验,多检索只是引入噪声;解法是积累更多对口经验。
- 模型侧限制:模型被过多上下文干扰;可通过训练(学会忽略无关上下文)或减少检索量缓解。
最后是遗忘。TroVE(Wang et al., ICML 2024)的淘汰规则很简洁:一个函数被使用的次数少于 ( 是迄今见过的样例数)就丢掉。直觉是使用频率应随数据量对数增长,长期不用的技能大概率是死代码。这类驱逐既减轻上下文负担,也可能提升成功率——模型不再被无关技能分散注意力。课件还引 “Not All Skills Help” 呼应:对一类任务有用的技能,可能对另一类有害,所以“删除”不是可选项。
12. 训练归纳器与开放问题
前面所有方法都有点“手工”:提示模型看经验、写技能、存进去、下次检索。一个自然的问题是:能不能训练模型做这件事?
答案是可以(73:17),而且这正是最近的方向。做法是把整个“在线学习”过程当作 RL 的环境:任务成对/成串出现,模型在第一个任务上归纳技能并存入记忆,在第二个相关任务上检索使用;奖励来自第二个任务是否成功,以及是否真的复用了之前归纳的技能。
这里有一个很关键的信用分配问题,课件说得很清楚:任务 1 的奖励只说明“这个任务成功了”,并不说明“把解决方案的一部分存下来是值得的”——只有后面的任务才能证明这一点。所以要把后续任务放进同一个训练样本里:要么两个相关任务组成一个 rollout(SAGE),要么一条长轨迹串起多个任务(AgeMem)。奖励可以写成
SAGE 在 AppWorld 上的结果(Qwen2.5-32B)显示了这个奖励设计的价值:只用结果奖励是 55.4,要求两个任务都成功是 56.6,再加上“成功复用技能”这一项是 60.7。也就是说,显式奖励复用比单纯奖励成功更能逼出“可迁移的技能”,否则模型会倾向于把技能写得只对当前任务有效。
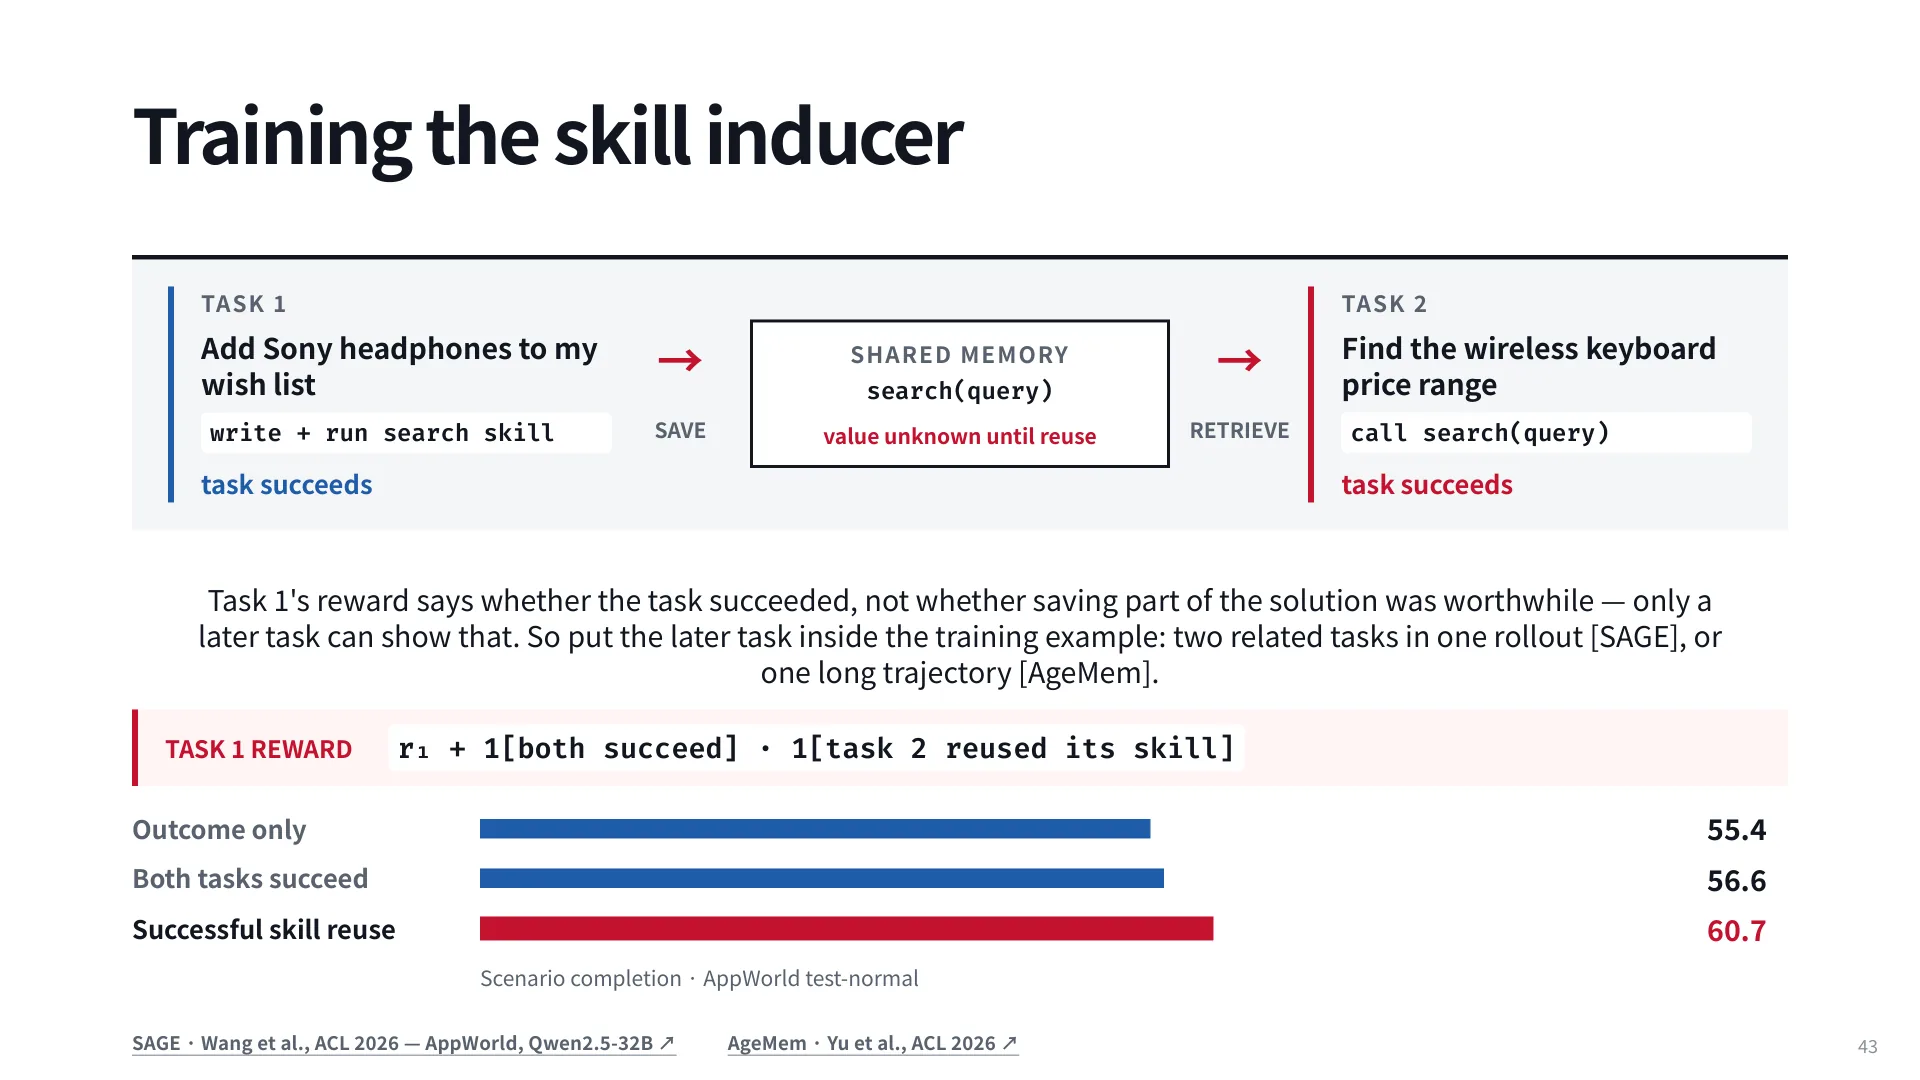
这条路的好处是 RL 不要求流程可微——“归纳→存储→检索→使用”这一长串不可导的操作,只要能给出最终奖励,就可以整体优化。它也打开了新的设计空间:除了复用奖励,还可以加“技能库规模”的正则项,避免归纳出过多过拟合的小技能。
课件把这些张力整理成四组对立(第 44 页),几乎是这一讲的“考点”:
- 精确 episode ↔ 一般技能:保真与迁移的取舍;
- 灵活指导 ↔ 固定执行:文本与代码的取舍;
- 复用已有 ↔ 探索替换:什么时候该相信记忆,什么时候该怀疑它;
- 只增不减 ↔ 更新/合并/删除:记忆的增长与维护。
以及一张“谁来负责”的分工表(第 45 页):技能或政策已经知道时人更值,必须靠交互发现时 agent 更值;验证与准入上,正确性属于规范性或高风险问题时由人把关,结果可执行、可廉价测试时交给 agent;选择与使用上,罕见例外需要人的情境判断,路由重复且有反馈时交给 agent;维护上,需要问责主体时由人承担,漂移在结果里可见可修时交给 agent。
这一讲没有给出“标准架构”,因为目前也确实没有。可用的经验是:技能要短、聚焦、可评测;记忆要能改、能删、带来源;代码表示用在稳定、重复、值得测试的流程上,文本表示用在需要临场判断的地方;judge 的质量决定自动化的上限。
讲师提醒:如果你只从这一讲带走一件事,那就是——技能与记忆不是“加一个向量库”,而是一条带反馈的流水线:经验 → 判分 → 归纳 → 准入 → 检索 → 使用 → 维护。任何一环缺失,收益都会退化成噪声。
术语表
| 术语 | 含义 |
|---|---|
| External artifact | 存在上下文窗口之外的记忆载体,如文件、数据库、技能包;可检查、可编辑、可移植 |
| Episode | 一次任务的完整轨迹:全部观察、动作、消息 |
| Fact | 从交互中抽取的单条命题式知识,可更新、可否定 |
| Skill | 关于“如何行动”的可复用知识,可用文本、代码或两者表示 |
| Induced skill | agent 从自己的成功/失败经验中归纳出的技能 |
| Agent Skills | 以 SKILL.md 为核心的文件包规范,含元数据、正文与可选资源 |
| Progressive disclosure | 分三层加载技能:索引常驻、正文按需、资源再按需 |
| SkillsBench | 87 个真实任务、8 个领域、18 种模型–harness 组合的技能评测基准 |
| MemGPT | 用操作系统式记忆层级与工具调用管理窗口外记忆的系统 |
| Mem0 | 把记忆写入拆成 ADD / UPDATE / DELETE / NOOP 的记忆管理方法 |
| Reflexion | 用自然语言反思失败原因并重试同一任务的方法 |
| AWM | Agent Workflow Memory,从轨迹中归纳带变量的文本 workflow |
| ASI | 归纳可执行代码技能、并以执行结果判定准入的工作 |
| PolySkill | 抽象类 + 站点特定实现的技能组织方式 |
| Judge | 判断轨迹最终状态是否正确(或建议是否被采纳)的模型 |
| Over-retrieval | 检索过多经验导致性能下降的现象 |
| TroVE | 按使用频率淘汰技能的记忆整合方法,阈值 |
延伸阅读
技能规范与工程实践
- OpenHands · Michelini & Neubig, How to Create Effective Agent Skills(课件引用的实践指南,含 code-review 案例)
- Anthropic, Equipping agents for the real world with Agent Skills(渐进披露与技能打包)
- AgentSkills specification(
SKILL.md的事实标准) - HermesAgent 文档与
agent/prompt_builder.py、tools/skills_tool.py(技能索引与加载的参考实现)
技能评测
- SkillsBench · 87 任务、8 领域、18 种配置的技能增益评测
- Not All Skills Help(技能跨任务类型的负迁移)
记忆系统
- MemGPT · Packer et al., 2023,窗口外记忆与工具化读写
- Mem0 · Chhikara et al., 2025,ADD/UPDATE/DELETE/NOOP
- Reflexion · Shinn et al., NeurIPS 2023,语言化反馈与重试
- ExpeL · Zhao et al., AAAI 2024,跨任务经验检索
- Synapse(ICLR 2024)、Agent S(ICLR 2025)、ICAL(NeurIPS 2024)· 轨迹级记忆的不同实例化
技能归纳与表示
- Voyager · Wang et al., 2023,Minecraft 中的代码技能库与自调用
- DreamCoder · Ellis et al., 2021,程序归纳与压缩
- Stitch(Bowers et al., 2023)、LAPS(Wong et al., 2021)、LILO(Grand et al., 2024)· 符号压缩与 LLM 结合
- Agent Workflow Memory · Wang et al., ICLR 2025,文本 workflow 归纳
- ASI / Skill(Wang et al., COLM 2025)· 代码技能归纳与执行判定
- SkillWeaver(Zheng et al., 2025)· lint + 执行反馈的技能修订
- PolySkill(Yu et al., ICLR 2026)· 抽象接口与站点特定实现
生命周期与训练
- ReasoningBank(Ouyang et al., ICLR 2026)· 从失败归纳策略、judge 校准、检索消融
- TroVE(Wang et al., ICML 2024)· 按使用频率整合技能库
- SAGE(Wang et al., ACL 2026)、AgeMem(Yu et al., ACL 2026)· 用 RL 训练技能归纳器
自测题
1. 为什么本讲把“更新 agent”分成上下文窗口、外部工件、模型权重三类?外部工件的独特优势是什么?
三者更新成本、持久性与可迁移性不同:上下文窗口保真但易失且昂贵;权重更新影响面广但慢、不透明、绑定单一模型;外部工件介于两者之间。其独特优势是可检查、可编辑、可检索、可跨模型移植——同一份“如何搜索”的说明任何模型都能读,人也容易审阅修改;代价是归纳、筛选、维护都得自己做。
2. episode、fact、skill 三者的区别是什么?各自适合什么情形?
episode 是完整轨迹,保真与成本都最高,适合“具体商品/价格/顺序会再出现”的情形;fact 是单条命题(如“价格只在详情页显示”),适合反复使用或会更新的信息;skill 是可复用的行动模式(如“填搜索框→点搜索→打开结果”),适合后续任务重复同一模式。三者是保真与泛化的不同折中。
3. 一个 Agent Skills 包由哪些部分组成?`description` 字段为什么关键?
必需 SKILL.md(YAML 元数据 + Markdown 正文),可选 scripts/(可执行代码)、references/(补充文档)、assets/(模板资源)。description 是索引层唯一常驻 system prompt 的内容,实际上充当检索键:它决定 agent 能否在正确时机触发技能。写得含糊会漏触发,写得过宽会把无关技能拉进上下文。
4. 渐进披露的三层分别是什么?为什么它能同时省 token 又保留能力?
三层是:①元数据(名字+描述)常驻;②SKILL.md 正文在被触发后通过 skill_view 以工具结果进入;③打包资源(脚本、参考文档)只在 agent 真的读/执行时出现。省 token 是因为绝大多数技能只以索引形式存在;保留能力是因为 agent 可以在需要时逐层展开,而脚本执行只把输出送进上下文,源码本身可以永远不进入窗口。
5. SkillsBench 的主要结论与两条限制是什么?如何解释“所需技能越多、收益越小”?
主要结论:87 个任务、18 种模型–harness 配置上,人工策展技能把平均通过率从 33.9% 提到 50.5%。限制:①仍让 13/87 个任务变差(技能可能挤掉更好的默认策略);②所需技能越多、SKILL.md 越长,收益越小。解释有两种:需要更多技能的任务本来就难,以及更多技能占用上下文并分散注意力。
6. Mem0 的 ADD/UPDATE/DELETE/NOOP 各自解决什么问题?它与上一讲提到的 Delta 有什么类比关系?
ADD 处理全新记忆;UPDATE 用新信息覆盖旧的同主题记忆(如换工作);DELETE 在信息被否定时移除(如“我被裁员了”使“我在 X 工作”失效);NOOP 避免重复写入或写入无关内容。Delta 类方法在向量记忆上做的是同一件事:不只 append,而是先按 query 检索相关存储值再改写它们;文本记忆的四种操作是它的符号版本。
7. Reflexion 为什么有效?它在什么条件下不能直接迁移到新任务?
它把失败转成自然语言反馈(“问题要的是一系列战役,我只给了一场”),而语言反馈比标量奖励携带更多方向性信息,正好是模型擅长条件化的形式,因此同一任务重试时改进明显。限制:它依赖“同一任务可重试”;要迁移到新任务,反思必须写得足够一般,否则会变成对原题答案的泄漏,对新任务无益甚至误导。
8. AWM 的归纳提示词里有哪几条约束?它们分别对应什么质量要求?
①只抽跨任务重复出现的动作子集——对应“可复用性”;②每个 workflow 至少两步——排除无意义的单动作片段;③不要生成相似或重叠的 workflow——对应“记忆的去重与可检索性”;④用有描述性的变量名替换非固定元素——对应“从具体到可泛化”。这四条基本就是“好技能”的操作化定义。
9. 代码技能相对文本技能有哪些优势与代价?为什么它能省步数?
优势:可作为工具一次调用完成、可单独测试(执行、lint、写用例)、可组合(函数调用函数)、效率高。代价:僵硬——严格照字面执行,页面结构变化就失败。省步数的机制是:文本技能仍要求模型逐步发出底层动作,每步都要“观察→推理→动作”;代码技能把这些步骤交给运行时,模型只需传参,因此环境交互次数大幅下降(如 50 步上限降到 4 步)。
10. 为什么“检索更多经验”可能让性能变差?有哪两类原因,各自的解法是什么?
两类原因:①数据侧——记忆里本来就没有相关经验,多检索只是引入噪声,解法是积累更多对口经验;②模型侧——上下文过长导致模型被无关内容干扰,解法是训练模型忽略无关上下文,或减少检索量、淘汰低频技能(如 TroVE 的 阈值)。
11. 训练技能归纳器时,为什么不能只用任务 1 的奖励?SAGE 的奖励设计说明了什么?
任务 1 的奖励只说明该任务成功,不说明“把部分解法存下来”是否有价值——这只能由后续任务证明。因此需要把相关任务放进同一训练样本(两个任务的 rollout 或一条长轨迹),并用“后续任务是否成功”“是否复用了先前技能”来给存储决策分配信用。SAGE 的结果(55.4 → 56.6 → 60.7)说明显式奖励复用能逼出更可迁移的技能,否则模型倾向于写出只对当前任务有效的技能。