
7b · Frameworks 1: OpenHands
本讲速览
- 本讲的主语不是模型,而是 harness。 OpenHands 是一个开源软件 agent 框架,同时也是 Graham 本人的产品经验总结:一个 agent 系统能不能用,往往取决于工具集、上下文管理、隔离和界面,而不是换一个更强的模型。
- 历史只有两年多。 2023 年还停留在 HumanEval 式的函数补全;2024 年 3 月 Devin 的演示引爆想象,两周后 OpenDevin 出现;2024 年底模型能力跨过门槛;2025 年是"编程能力"之年,2026 年则变成"部署与界面"之年。
- SDK 的哲学是"开箱即用的默认值 + 可拆卸"。 与 pi 那种"只给内核、其余全靠扩展"的极简路线相反,OpenHands 把模型、工具、状态、workspace 都做成有默认实现的组件,允许被替换。
- 上下文压缩(condenser)是这套框架最早押注的技术之一。 做法是把较早的事件摘要化,保留原始指令与最近的工作,用文件与测试结果作为事实证据,而不是逐条屏蔽历史动作。
- 单 agent 优先是多 agent 之前的默认答案。 模型指令遵循变强之后,固定角色的流水线可以被一段"先做这个、再做那个"的 prompt 替代;skills 与 MCP 让一个 agent 在需要时临时获得专门能力。
- 多 agent 只在三种情况下划算: 并行、独立评审、成本控制;这三者都需要付出上下文交接与整合的代价,而且往往并不便宜。
- 自动化把 agent 从"对话工具"变成"生产设施"。 trigger → context → run → artifact → check 构成一次可审计的运行,重复运行积累出的数据又能反过来改进 prompt(SkillRefiner)。
本讲在课程中的位置有点特殊。前面十几讲把 agent 拆成 prompt、工具、记忆、规划、评测等零件,这一讲把零件装成一台机器,再讨论这台机器装在哪里、由谁看着、出了问题谁负责。Graham 开场就说明,他既讲技术,也讲"做一个真的有人用的 agent 产品"学到了什么,以及如何把这些痛点转成研究问题。这种"工程—研究"双线结构,是理解后面所有设计取舍的前提:很多看起来奇怪的决定,背后都是某个真实用户在某个真实场景里踩过的坑。
1. 一个 agent 产品的两个入口
OpenHands 的前端有两种截然不同的使用方式。第一种是人类在环的对话:在聊天窗口里输入今天想做的事,例如"看看我在 OpenHands 仓库里有哪些 open PR、今天该处理什么",agent 建一个 conversation,读取仓库、列 PR、给出待办。第二种是自动化:把反复要做的事情配置成一条流水线,比如 PR 评审、issue 分诊、Slack 频道监控、依赖版本升级失败后的修复。
这两种入口的差别不只是 UI,而是交互契约不同。对话模式下人是持续的参与者,可以中途插话、纠正、追加约束;自动化模式下人退到流程之外,只在两端出现——配置触发条件与指令,以及检查产物。前者优化的是"表达力",后者优化的是"可重复性与可审计性"。把两者混在一个产品里,会带来一个具体的设计问题:同一套 agent 内核,如何既支持长对话里的灵活追问,又支持无人值守的短任务?
Graham 在演示里还强调了一个与竞品的区别:模型无关。Claude Code 与 Codex 各自绑定在一个模型生态里,而 OpenHands 允许在 DeepSeek、GPT、Claude 之间切换,甚至临时换一个模型跑同一段对话(04:54)。这个选择直接决定了框架的形态:如果模型是变量,那么工具描述、上下文格式、错误恢复就不能针对某个模型的偏好做过度优化,只能取"多数模型都能理解"的共同子集。这也是后面"工具集刻意做小"的原因之一。
讲师提醒:模型无关不是免费的美德。它意味着你放弃了针对单一模型做深度调优的空间。Graham 后面承认,OpenHands 的工具集曾经非常刻意地模仿 Claude Code,因为只有这样才能让 Claude 系模型发挥好;"无关"是目标,不是既成事实。
从商业角度看,这个定位也解释了产品走向:OpenHands 的主要客户是希望在自己的云上安全运行编码 agent、并且要求模型可替换的大公司,而不是"跑得最快、不介意数据出境"的初创团队。客户结构反过来塑造了框架重点:隔离、权限、私有部署、可观测性,这些在消费级产品里可以糊弄的东西,在这里是硬需求。
2. 历史:agentic coding 只用了两年
要理解今天的框架为什么长这样,得看它经历的几次断裂。2016 年 Graham 就开始做代码生成,但直到 2023 年,主流形态仍是代码补全:GitHub Copilot 给出建议,HumanEval 用一个函数签名加若干单元测试来衡量"这个函数写对没有",人类负责编辑、执行和检查(06:35)。
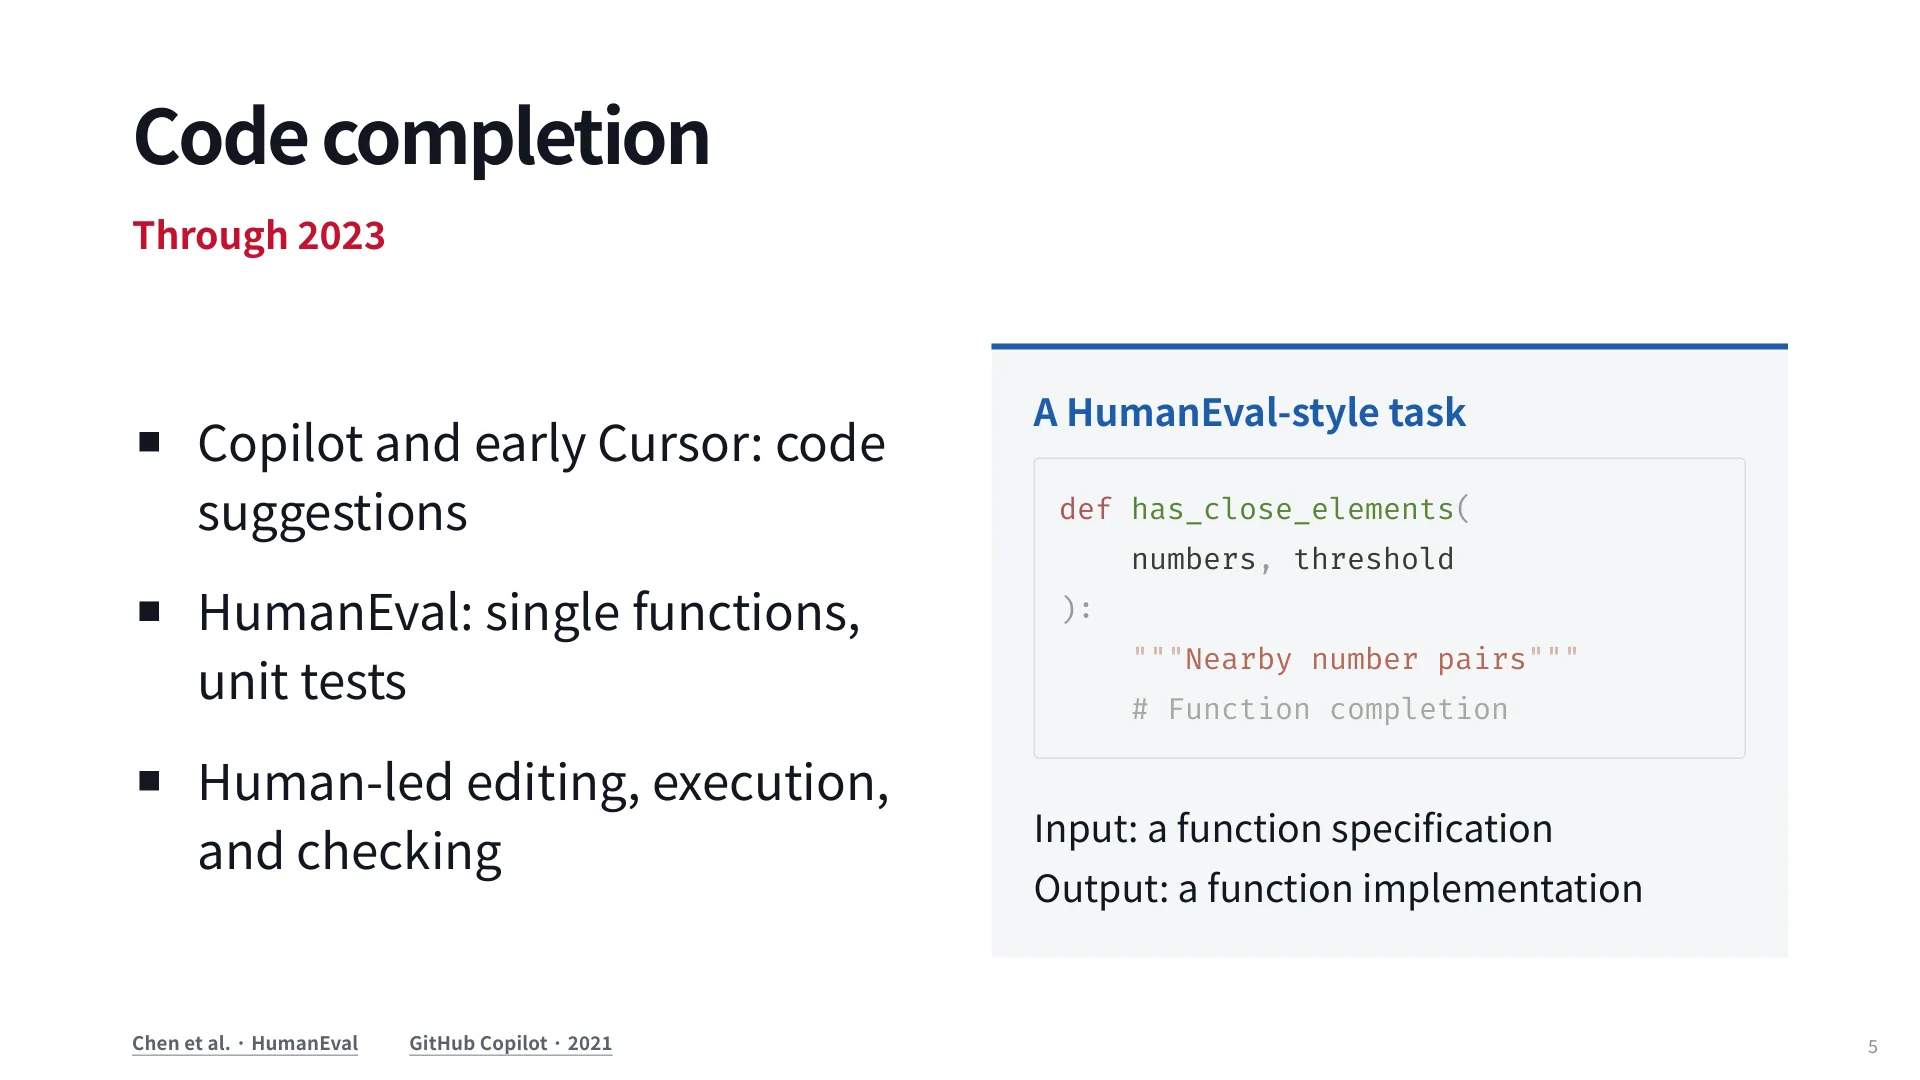
HumanEval 这类基准的隐含假设是:任务边界清晰、上下文自足、验证成本低。真实软件工程一条都不满足。2023 年 10 月的 SWE-bench 把评测搬到仓库级:给一个真实 issue 和仓库快照,要求产出 patch,并用仓库自带的测试判定。它的难点不在于写代码,而在于定位——你要在大型仓库里找到与 issue 相关的那几处,还要保证改动不破坏别的东西。
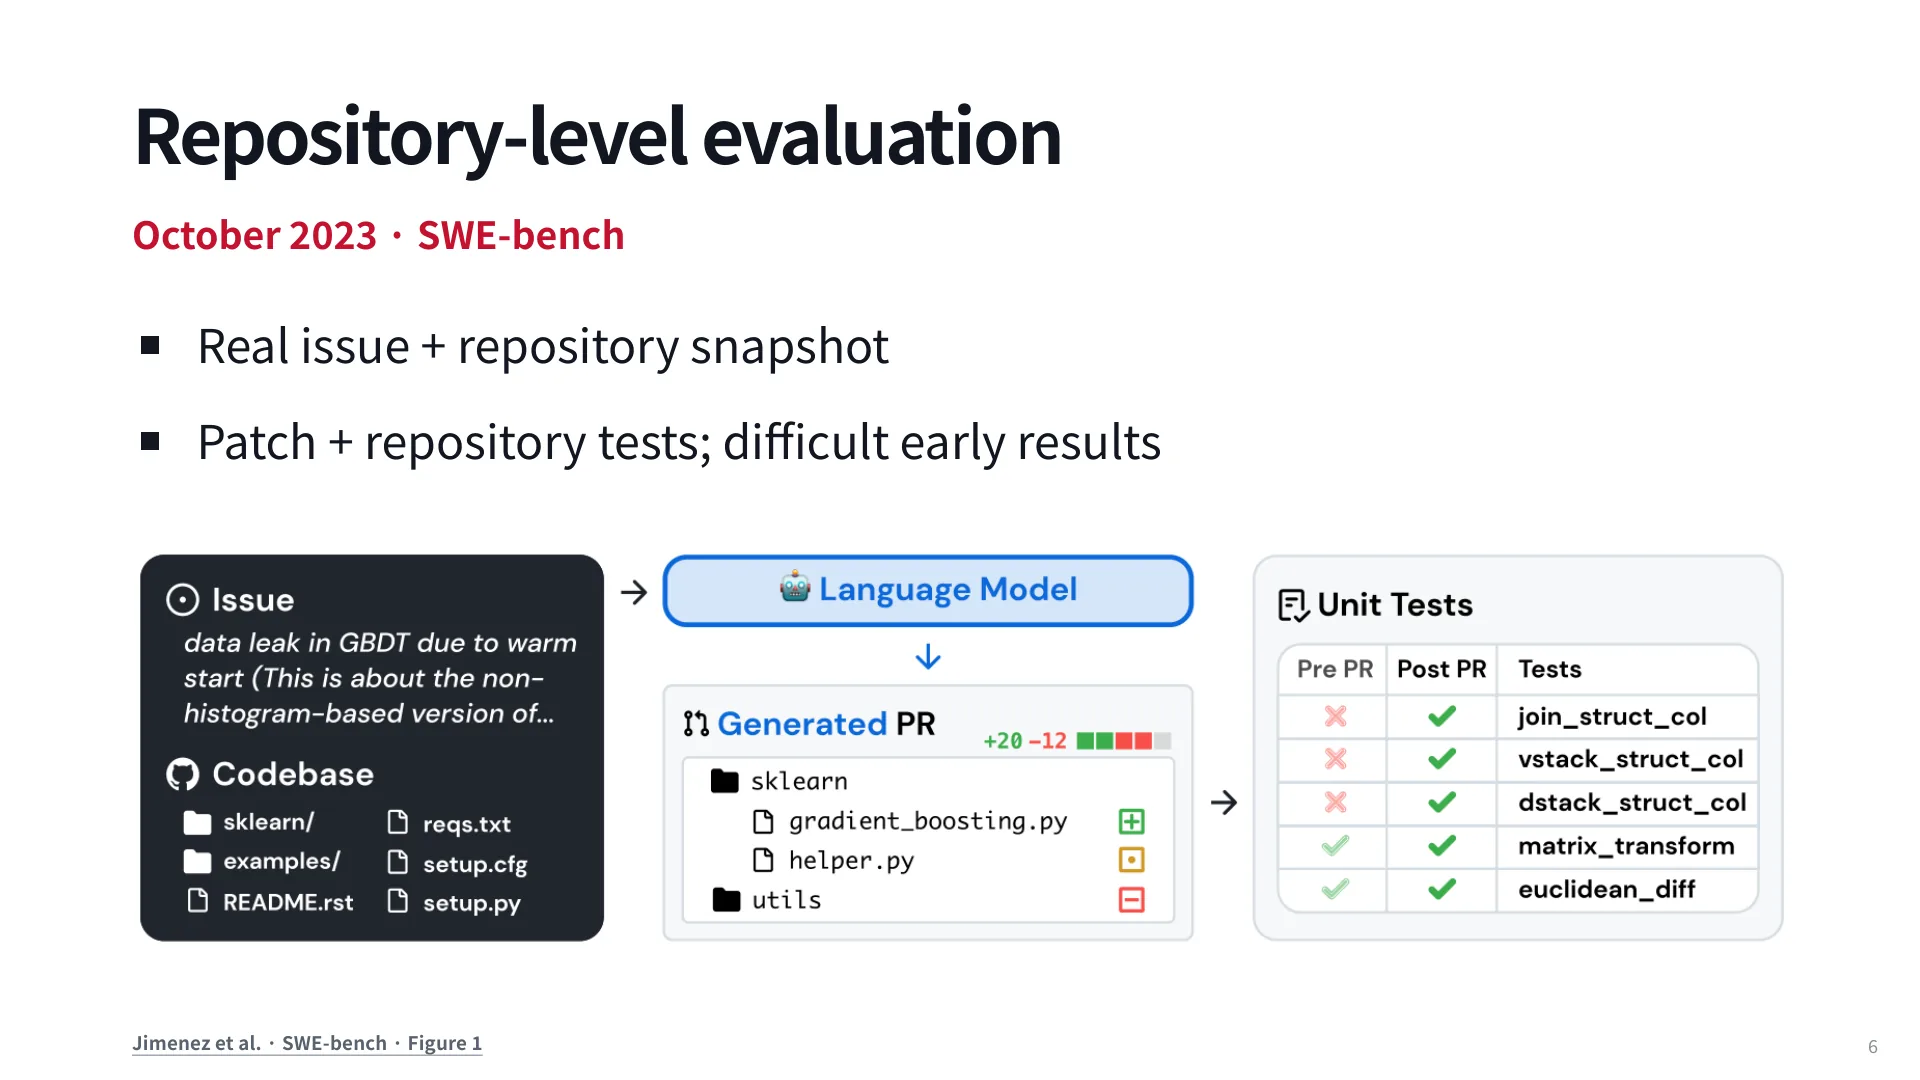
早期成绩惨烈:最好的系统也只有个位数百分比(录像中提到约 5%)。这个数字很重要,它说明"把模型换成更大的"并不能解决问题——缺的是搜索、编辑、执行、验证这一整套循环。真正的转折点不是论文,而是一段演示:2024 年 3 月 12 日 Cognition 发布 Devin,视频里 agent 接收一句自然语言需求,自己列计划、开终端、写代码,短期内获得百万级播放(07:24)。
Devin 的冲击在于包装:同样的能力,被组织成一个"AI 软件工程师"的叙事,就让人相信这件事已经发生了。Graham 的反应是"我知道这是可能的,但它不开源"。于是当 Qwen 团队的人公开号召复现 Devin 时,一个只有 README 的仓库立刻拿到上万 star,OpenDevin 在 3 月 26 日就有了前端、agent 和 Docker 沙箱三个部分。
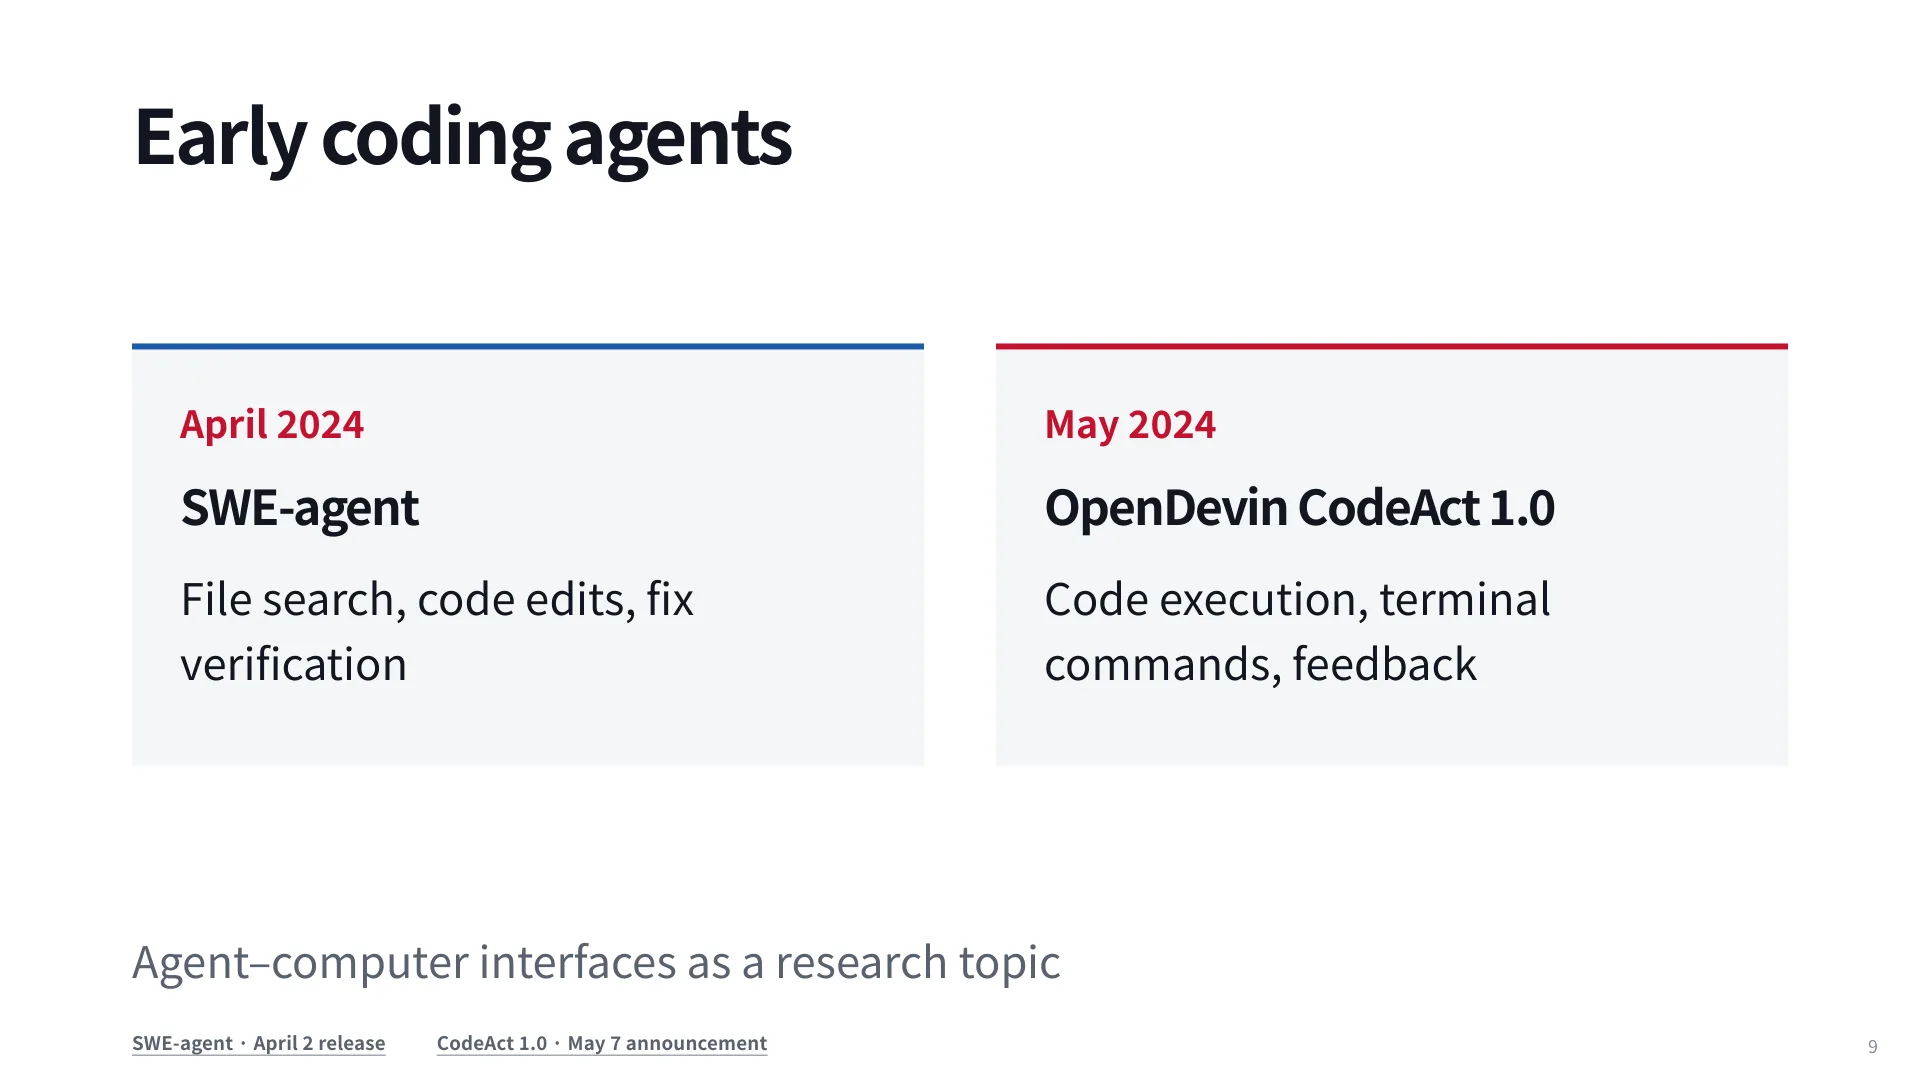
接下来的两个月里,两个开源项目几乎同时出现:SWE-agent 强调为 agent 设计计算机接口(文件搜索、编辑命令、验证流程),OpenDevin 的 CodeAct 1.0 则把"动作即代码"作为统一表示,用代码执行和终端输出作为反馈。这两条路线后来合流成一个共识:agent 的能力很大程度上由动作空间决定,而不是由 prompt 措辞决定。
但共识不等于可用。2024 年大部分时间里 agent 都很难真正完成任务,Devin 自己甚至在公交站投放"Devin,它现在真的行了"的广告,等于承认早期版本不行。转折发生在 2024 年 11 月前后,Claude 3.5 Sonnet(随后是 3.7)在长程工具使用上明显变强,agent 才第一次稳定地跑完多步任务。这也是课程里反复出现的一个教训:框架的收益是有条件的,它需要模型跨过某个阈值才显现;在阈值之下,再精巧的工程也只是让失败更慢一点。
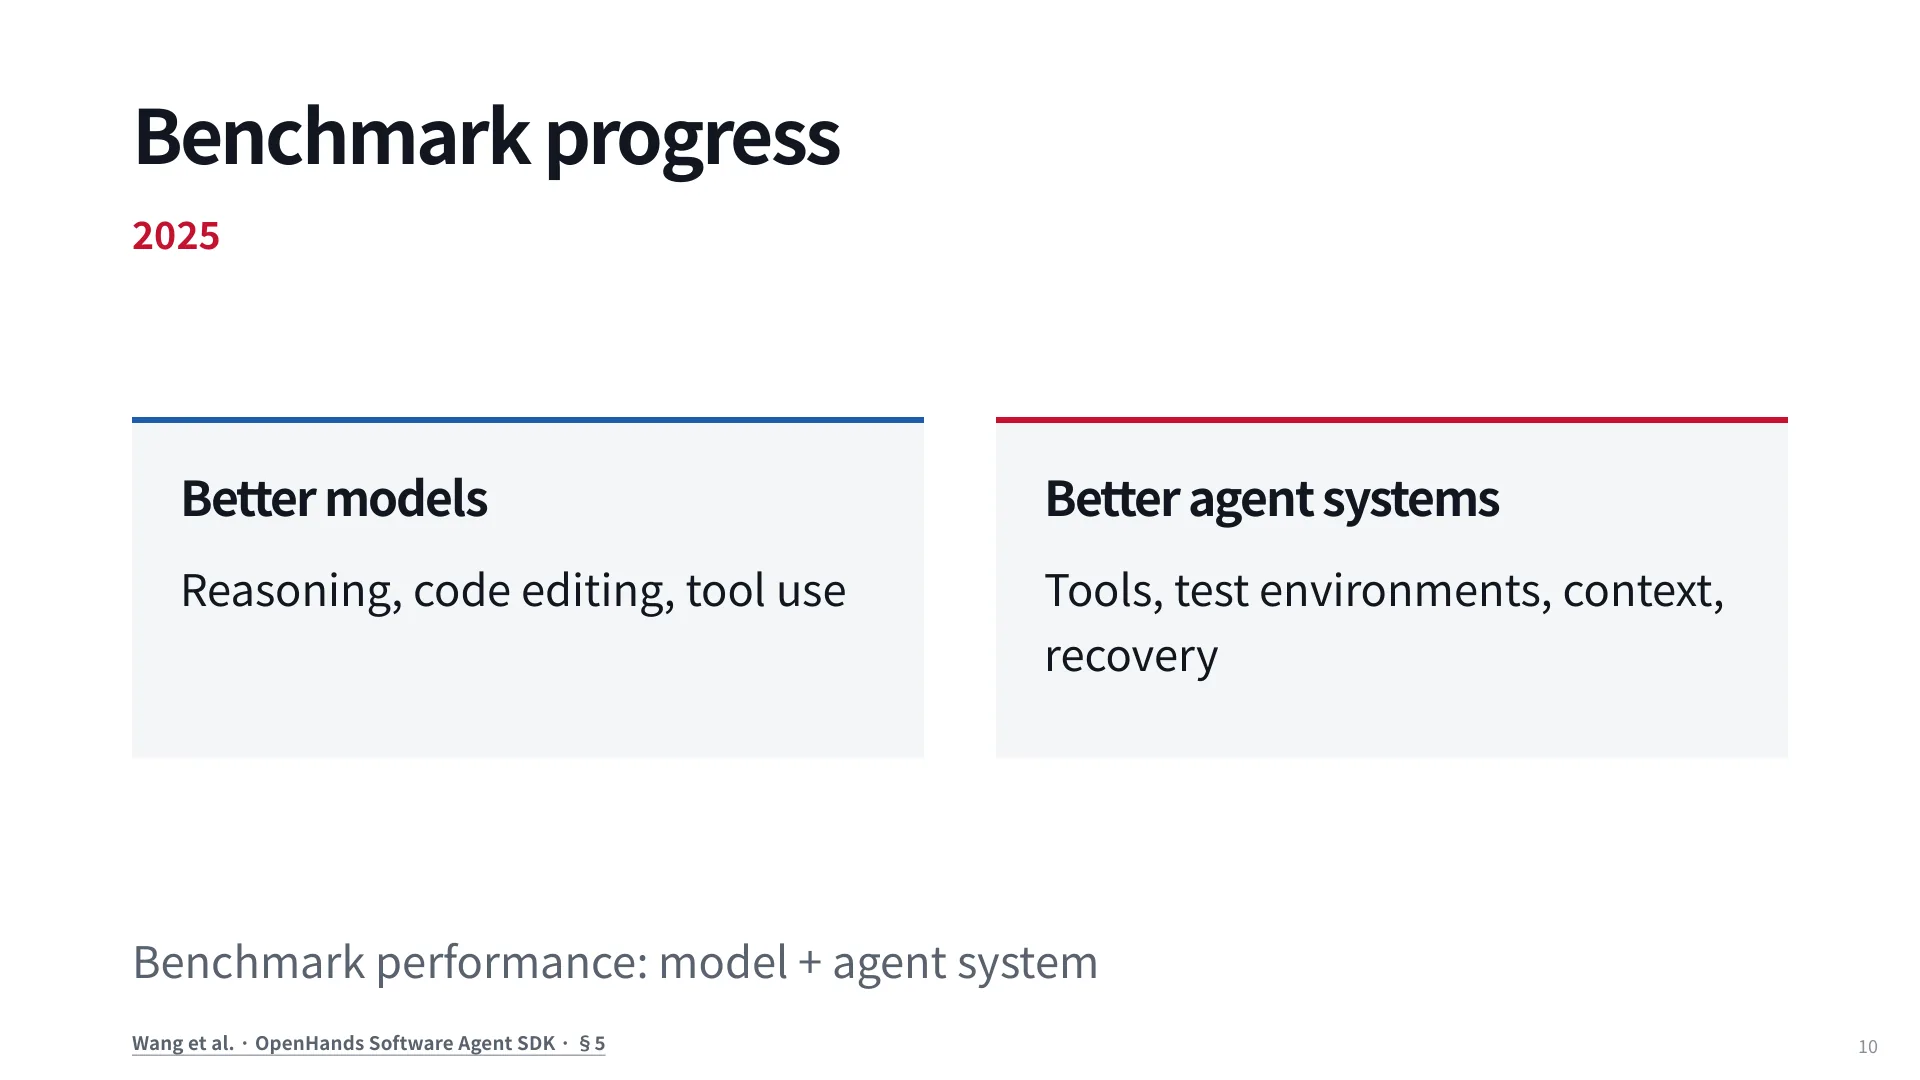
到 2025 年,榜单上的进步不能再归因于单一因素。同一批基准上,模型侧的推理与工具调用能力在提升,系统侧的测试环境、上下文管理、失败恢复也在提升,两者相乘才产生曲线。这带来一个评测上的麻烦:基准分数是"模型 + harness"的联合产物,比较两个模型时如果 harness 不同,结论基本无效;反过来,改进 harness 也能在模型不变的情况下拿到可观涨幅。这一点是理解本讲后半部分(自动化、SkillRefiner)的钥匙。
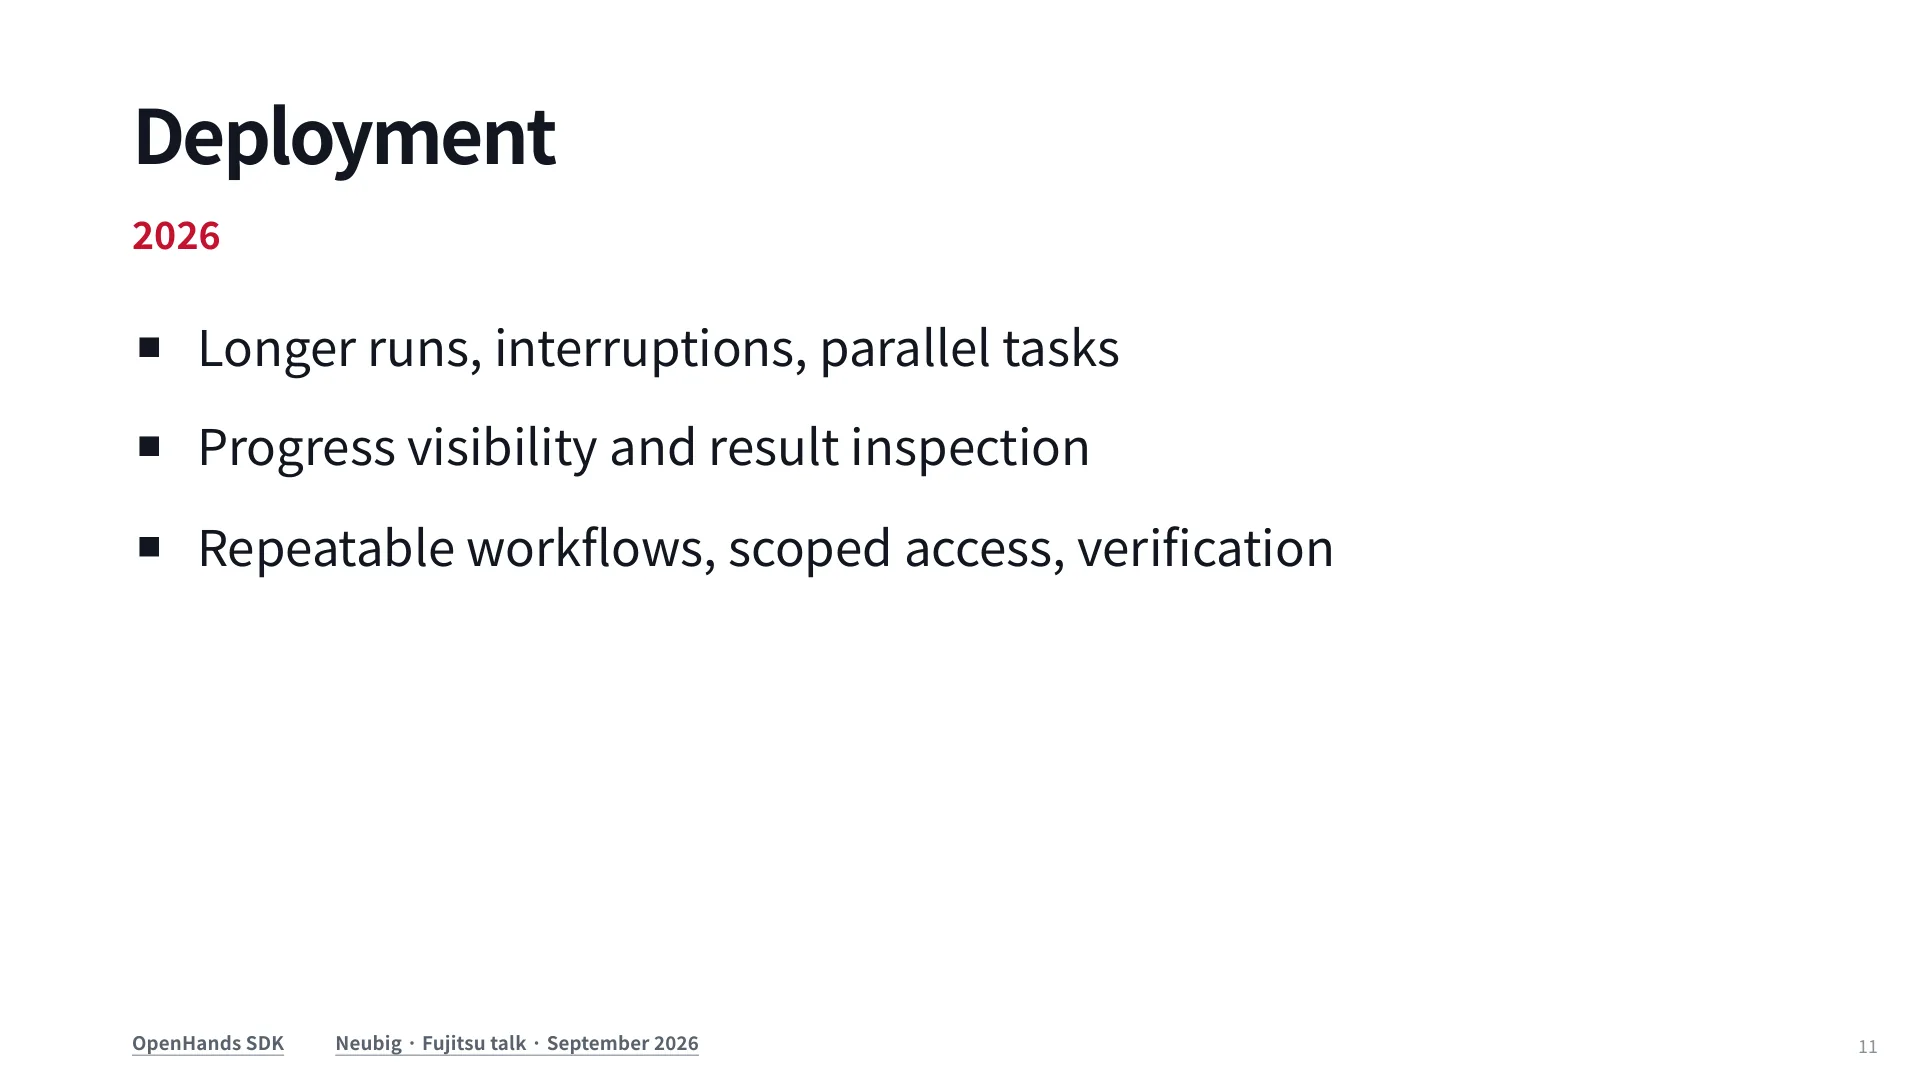
2026 年的关键词变成了部署:运行时间更长、会被打断、需要并行;人需要看见进度、检查结果;流程要可重复,权限要收敛,产物要能验证(12:18)。换句话说,问题从"agent 能不能做"变成"agent 做完的东西我敢不敢合"。这个转向解释了为什么这一讲要用大量篇幅谈界面、托管位置和自动化,而不是继续谈模型。
3. SDK 的立场:batteries included, but flexible
OpenHands 的 Software Agent SDK 是第二代 harness。第一代被 Graham 直接评价为"很糟":难用、难扩展。大约八个月前,团队把内核整个拆掉重写(13:57)。重写后的定位是一句话:给一套能直接跑出好成绩的默认值,但允许你把每一层拆掉换成自己的。
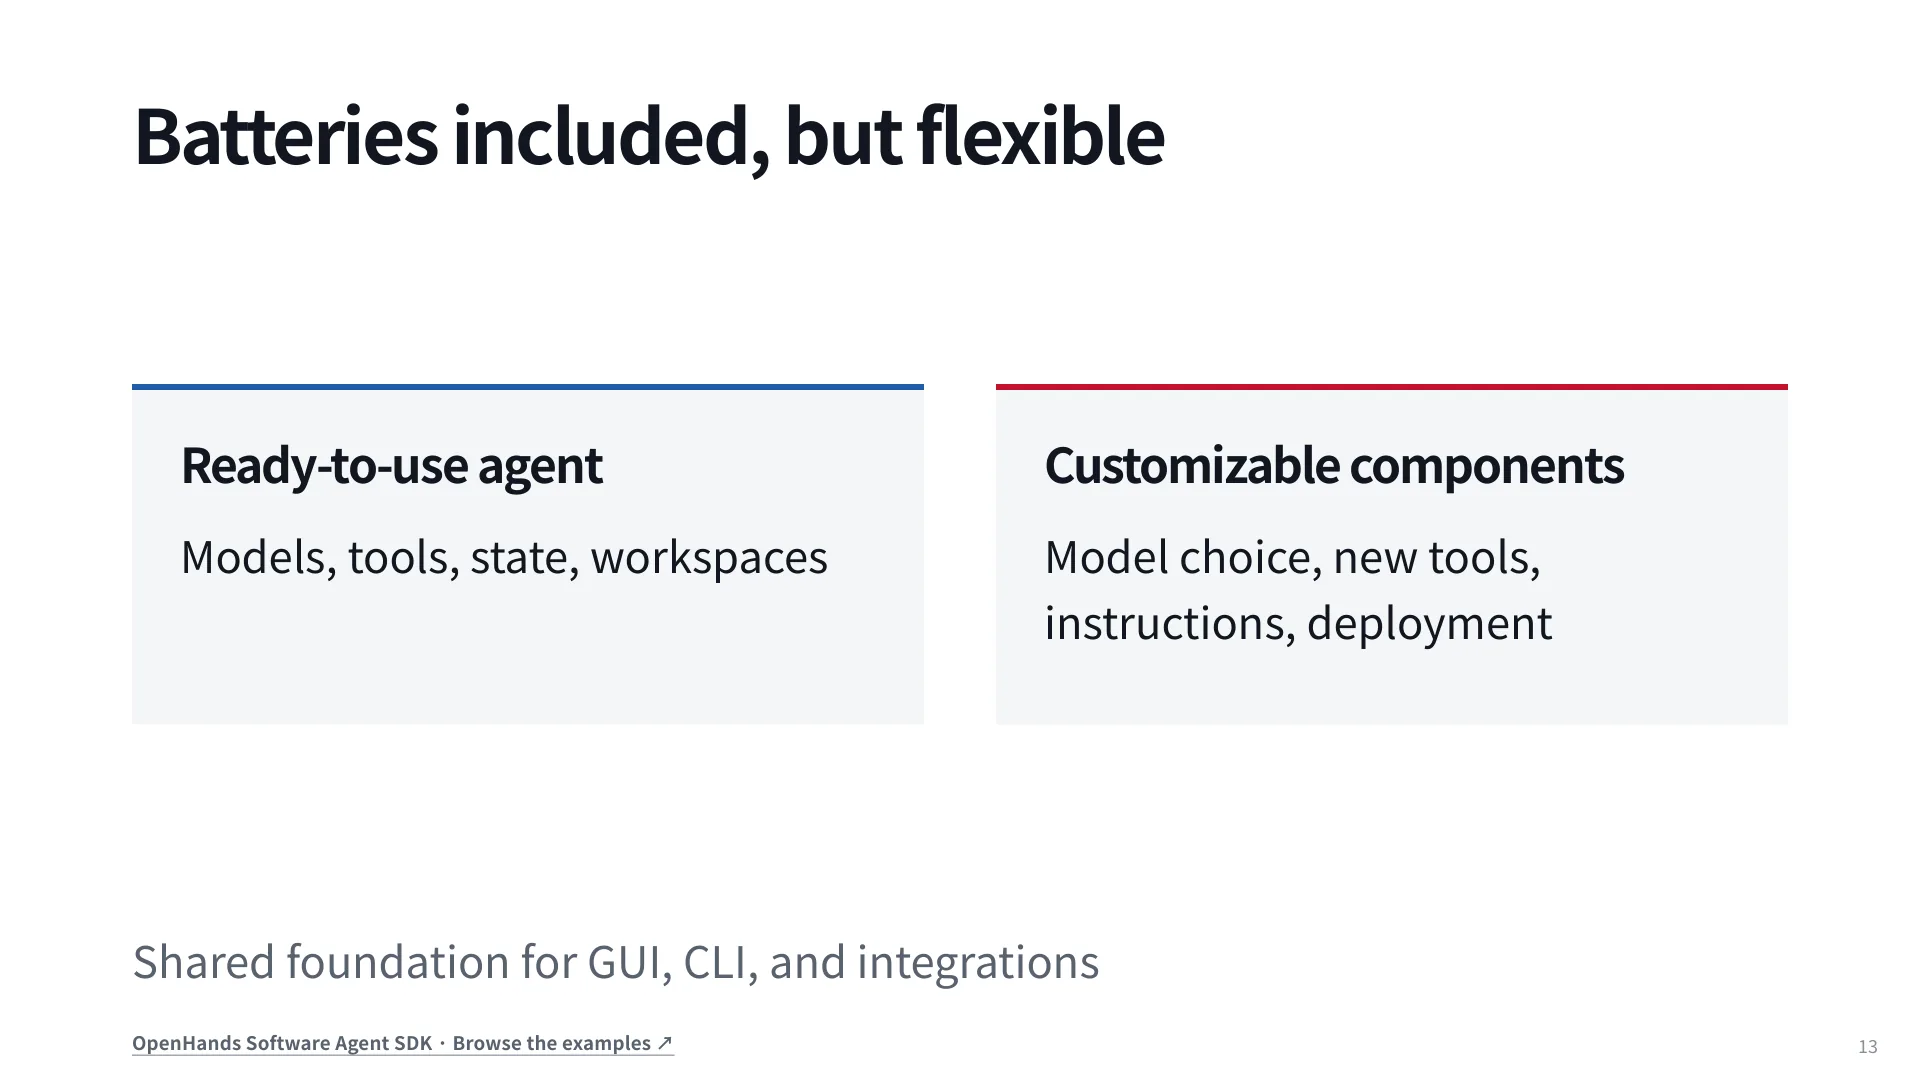
这与 pi 的路线正好相反。pi 的做法是"内核几乎什么都不给,其余全靠扩展";OpenHands 的做法是"默认全给,但接口留足"。两种哲学的适用人群不同:前者适合想完全掌控每一行逻辑的研究者,后者适合想在一周内做出可用系统、又不想被框架锁死的团队。判断标准其实很朴素——你更怕"框架替你做了决定",还是更怕"什么都要自己写"。
最小可用示例只有十来行:选模型、给 API key、挂三个工具(终端、文件编辑器、任务追踪器),得到一个可复用的 agent 配置。
llm = LLM(model=os.getenv("LLM_MODEL", "gpt-5.5"), api_key=os.getenv("LLM_API_KEY"))
agent = Agent(
    llm=llm,
    tools=[
        Tool(name=TerminalTool.name),
        Tool(name=FileEditorTool.name),
        Tool(name=TaskTrackerTool.name),
    ],
)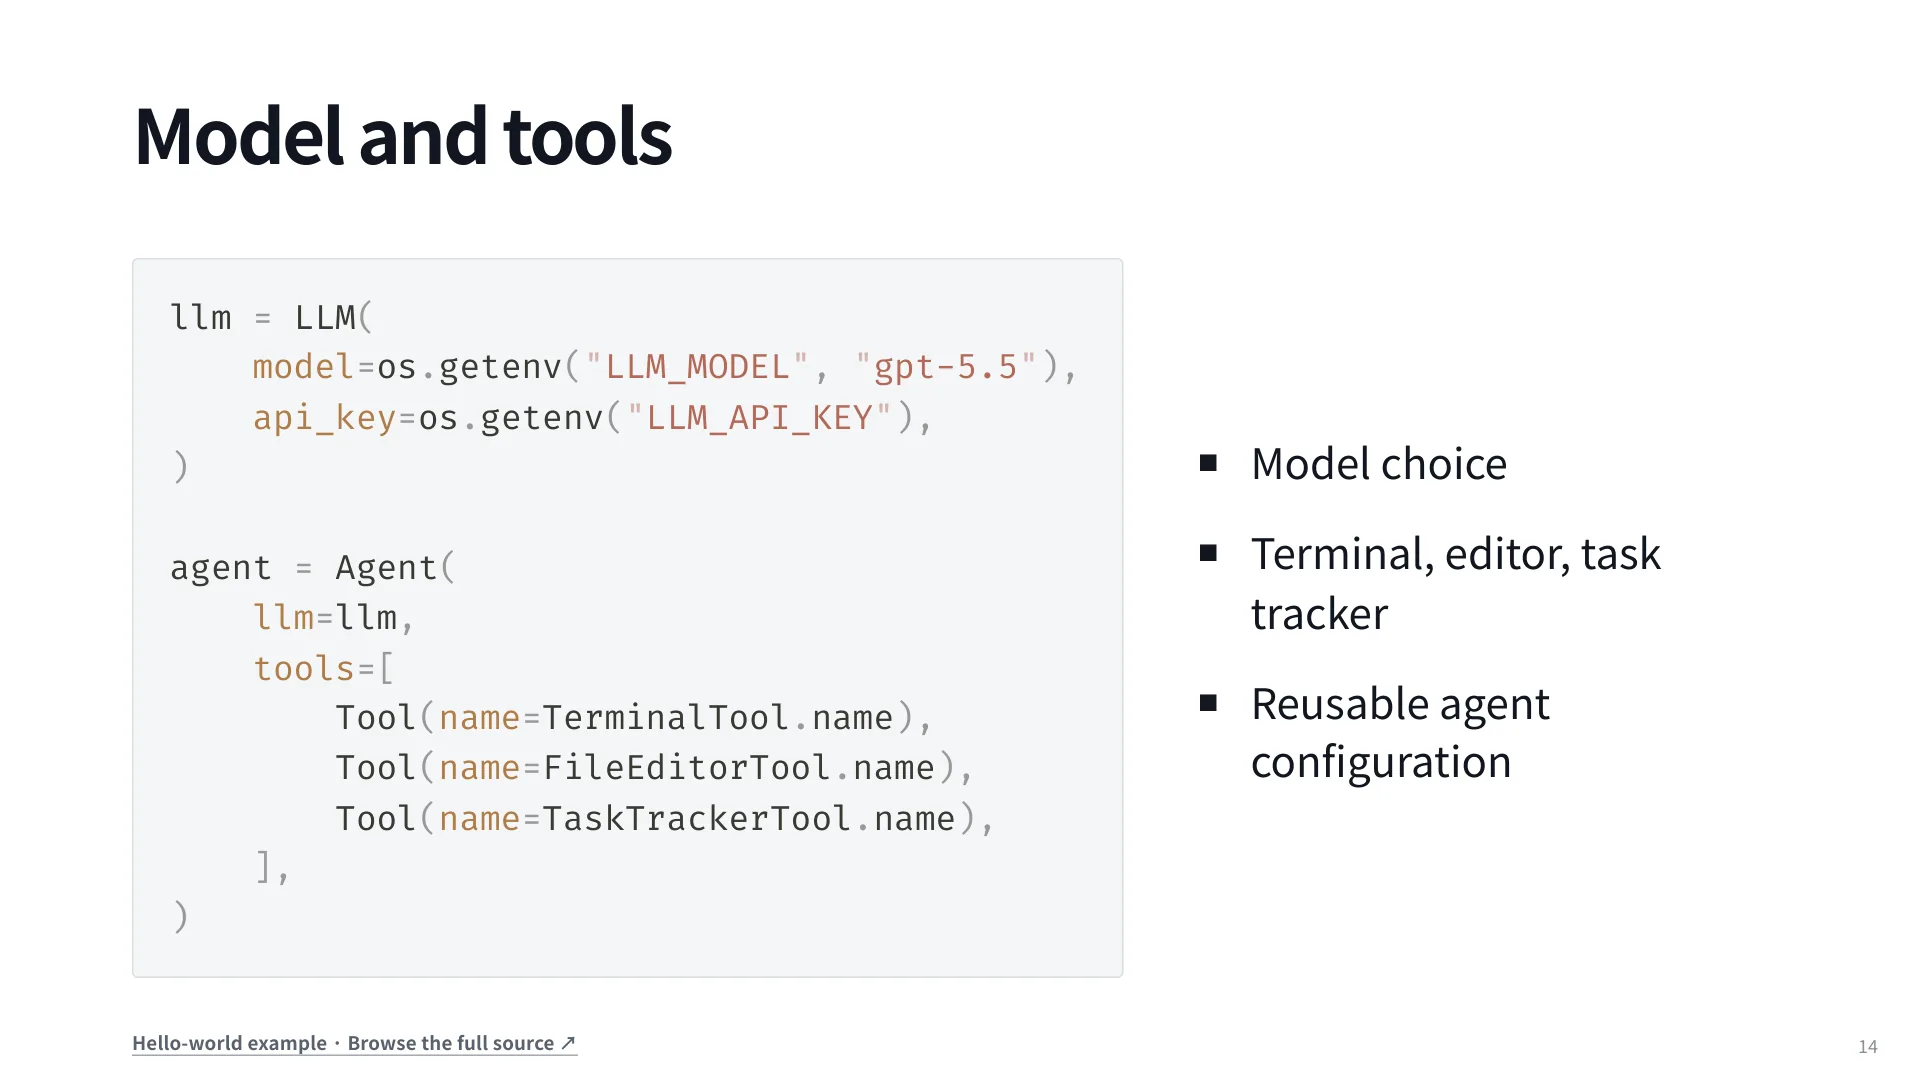
值得注意的不是代码短,而是三个工具的选择。终端负责执行任意命令,文件编辑器负责精确修改,任务追踪器负责在多步任务里维持一个显式的待办列表。这三者覆盖了"看—改—验"的闭环,而任务追踪器解决的是一个纯上下文问题:长任务里模型容易忘记自己做到哪一步,把计划外化成可读写的状态,比在 prompt 里重复叮嘱更可靠。
上层是 conversation。它把三件事绑在一起:workspace(文件与执行环境)、conversation(任务、动作、观察的记录)、run(动作—观察循环)。
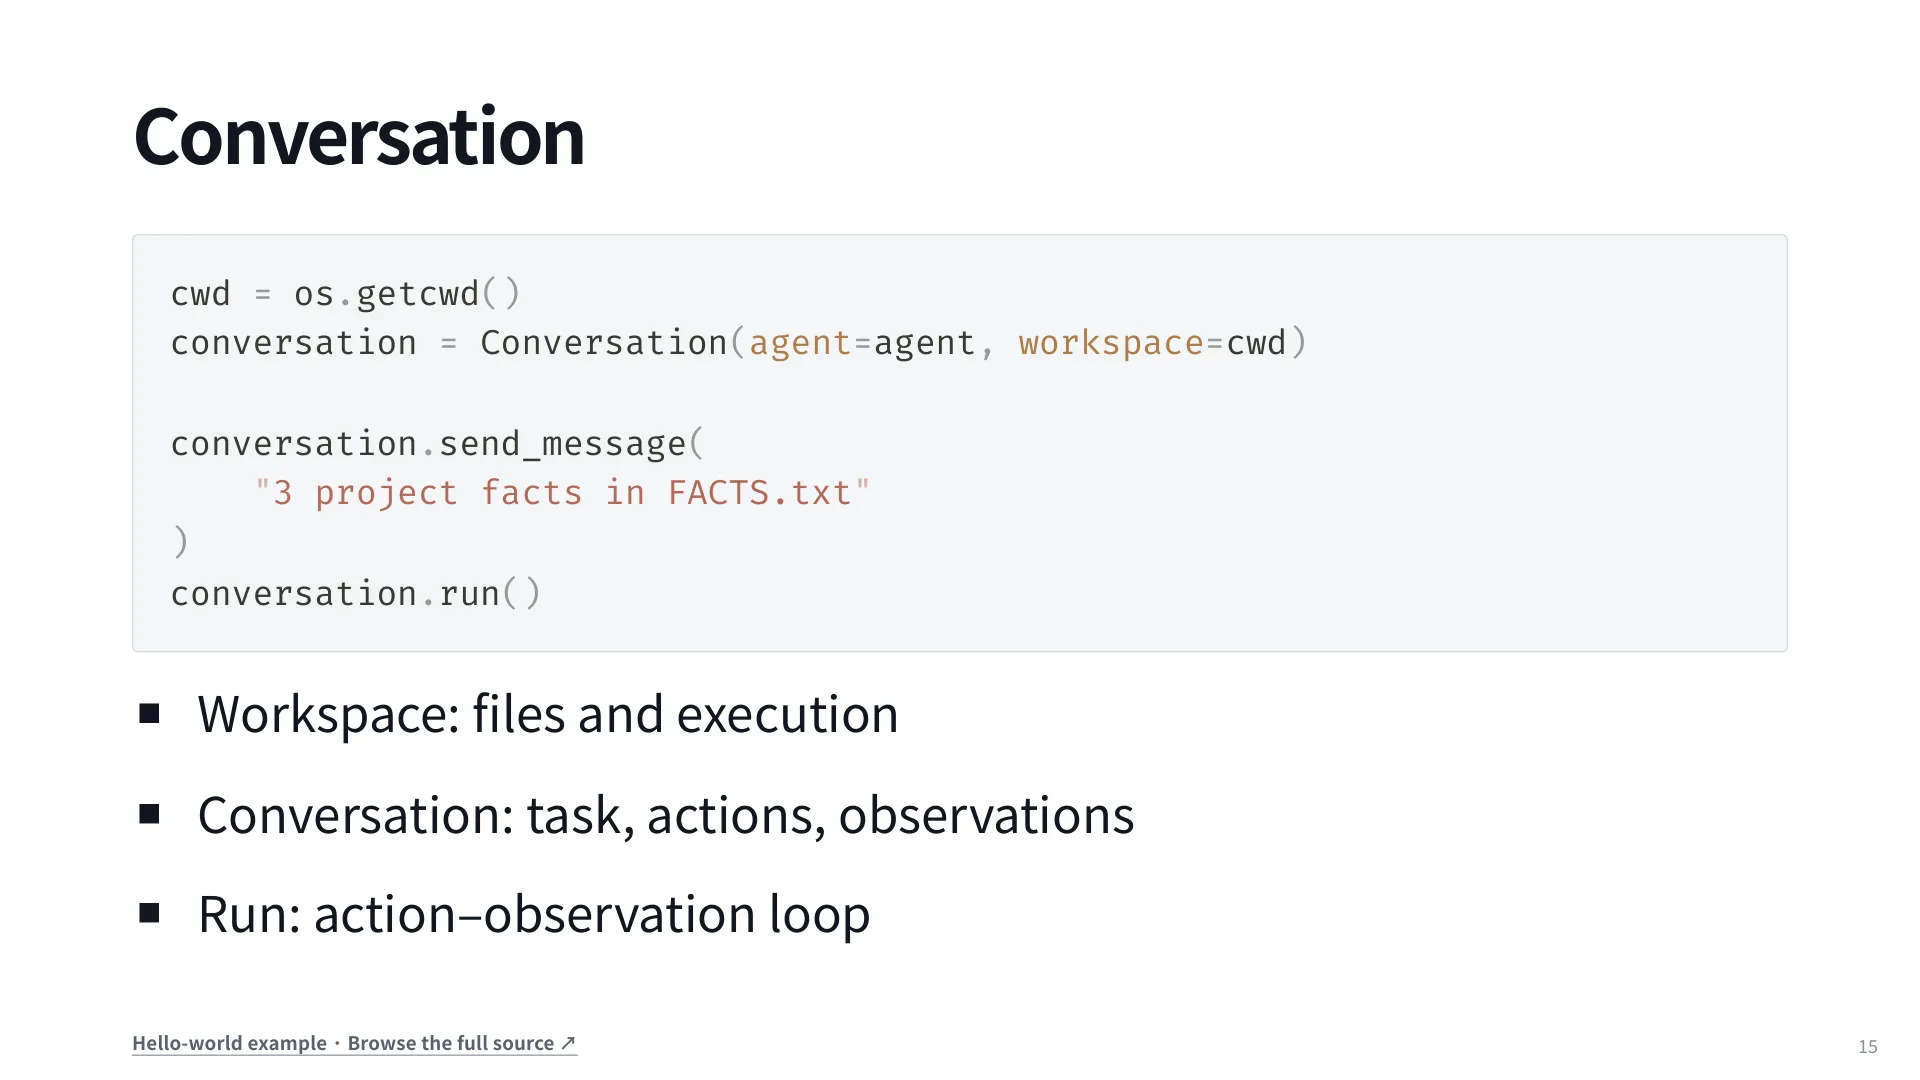
cwd = os.getcwd()
conversation = Conversation(agent=agent, workspace=cwd)
conversation.send_message("3 project facts in FACTS.txt")
conversation.run()这段代码里最容易被忽略的是 workspace 是一个可替换对象。传一个路径意味着在本机执行;传一个 Docker workspace 意味着在容器里执行;传一个远端 server 意味着在另一台机器上执行。执行位置是一个参数,而不是一个架构决定,这是整套 SDK 最重要的抽象。
一个工程细节值得单独说:为什么是 Python?Graham 的回答很诚实——项目由机器学习背景的人发起,而这些人更熟 Python;此外他本人认为读 Python 比读 TypeScript 快,而他现在的工作主要是"读懂 agent 写的代码"而不是写代码。代价是类型安全(agent 改代码时容易引入类型错误,需要用严格类型检查和每次提交都跑 type checker 来兜)和运行速度,但速度在这里几乎不是瓶颈:等待时间要么花在模型上,要么花在 agent 执行的程序上(26:11)。
另一个差异是以库为中心还是以 CLI 为中心。相当多的 agent 通过命令行调用,benchmark 的标准做法就是给 CLI 传参、让它自己跑。这种方式跨语言方便(TypeScript 写的 agent 也能被 Python 脚本调用),但一旦要改内部模块、加一个新组件,CLI 的边界就成了天花板。OpenHands 选择把 SDK 暴露成库,代价是用户得愿意写 Python(17:09)。
4. 工具、持久化、上下文压缩
自定义工具的抽象是 Action / Observation / Executor 三段式:动作是带类型与字段说明的输入,执行器是真正的实现,观察是模型可读的结果。
以 grep 为例,动作只需要两个字段——正则与路径,观察则是命中行的列表:
class GrepAction(Action):
    pattern: str = Field(description="Regex to search for")
    path: str = Field(default=".")

class GrepObservation(Observation):
matches: list[str] = Field(default_factory=list)执行器负责真正读文件、跑正则、把命中行装进 observation。这段代码里没有一行是写给模型看的散文,约束全在类型与字段说明里。
这个划分看似啰嗦,实际解决了三个问题。第一,参数 schema 就是给模型的说明书,字段的 description 直接影响调用正确率;第二,执行逻辑与表示分离,同一个动作可以本地执行也可以远端执行;第三,Observation 是独立类型,可以刻意设计成"信息密度高、token 少"的形式,比如只返回匹配行而不是整个文件。
对话可以持久化:给定 persistence_dir 和一个 conversation_id,事件与状态会被保存,下次用同样的 ID 与存储目录即可恢复。这里有一个容易混淆的点——workspace 的持久化是另一件事。对话记录恢复不代表容器里的文件还在;如果你的 agent 改了代码,容器一销毁,改动就没了。把这两者分开设计是诚实的选择,但也意味着使用者必须自己想清楚"我要恢复的是记忆还是现场"。
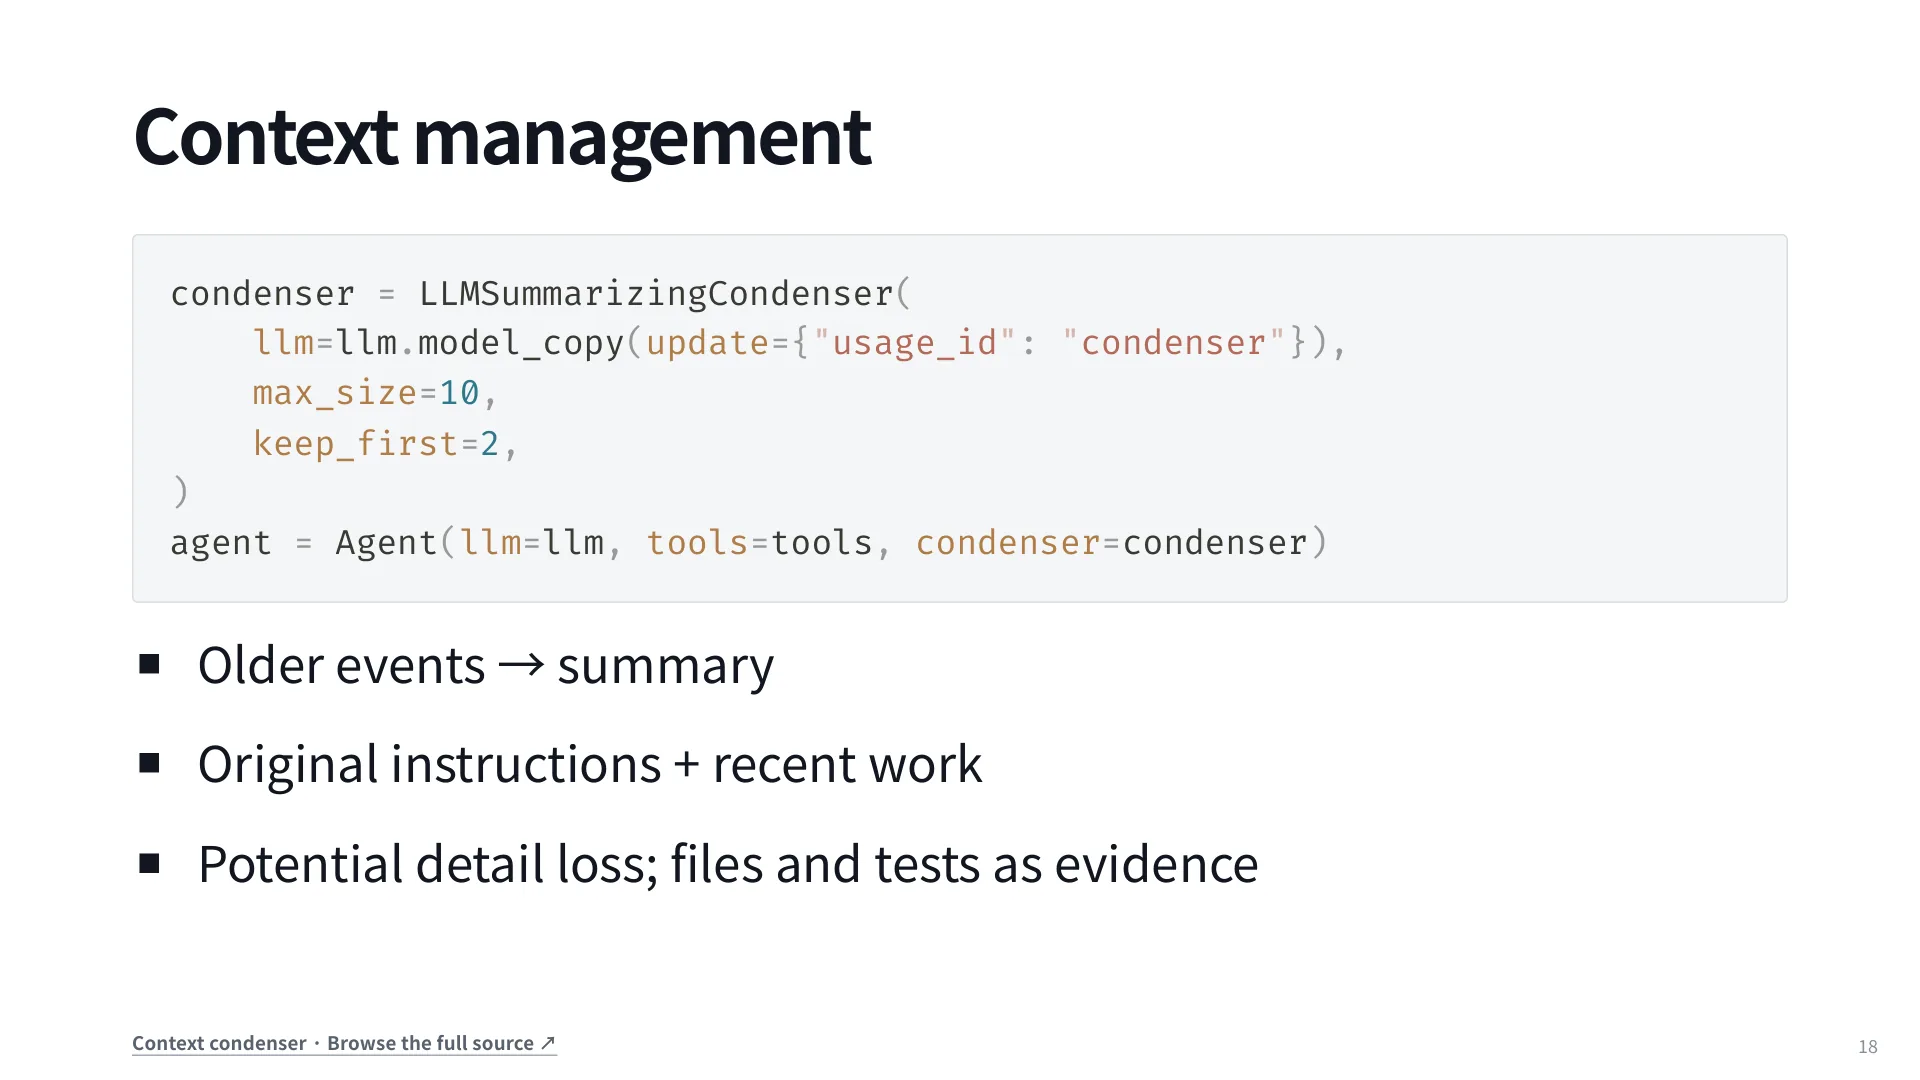
上下文压缩(condenser)是 OpenHands 自认为最早实现的东西,他们叫 condensation,Anthropic 后来把它叫 compaction,名字变了,机制一样(19:36)。做法是把较早的事件摘要成一段文字,保留最初的指令和最近若干轮的工作:
condenser = LLMSummarizingCondenser(
    llm=llm.model_copy(update={"usage_id": "condenser"}),
    max_size=10,
    keep_first=2,
)
agent = Agent(llm=llm, tools=tools, condenser=condenser)团队试过别的方案,比如把个别动作直接屏蔽掉(mask),效果不如摘要。原因不难理解:单个动作脱离上下文后往往无法解释,而一段摘要至少保留了"为什么这么做"的因果链。触发时机有两种:每 N 轮,或者按 token 数——多数 API 会告诉你最大上下文窗口,取四分之三作为阈值。
压缩的代价
摘要是有损的。被丢掉的细节可能是后来定位 bug 的关键线索。所以一个好的 harness 不能只靠对话历史记事:文件系统、测试结果、git 状态是更可靠的外部记忆。判断一个 agent 系统成熟与否,一个简单标准是看它在压缩之后还能不能通过"重跑测试"来恢复事实。
5. 隔离与人类否决权
把 agent 放进沙箱有两种做法。一种是先准备沙箱,把 agent 代码整个放进去跑;另一种是在宿主进程里用 with 语句圈出一段区域,区域内执行的命令都进沙箱。OpenHands 两种都支持:
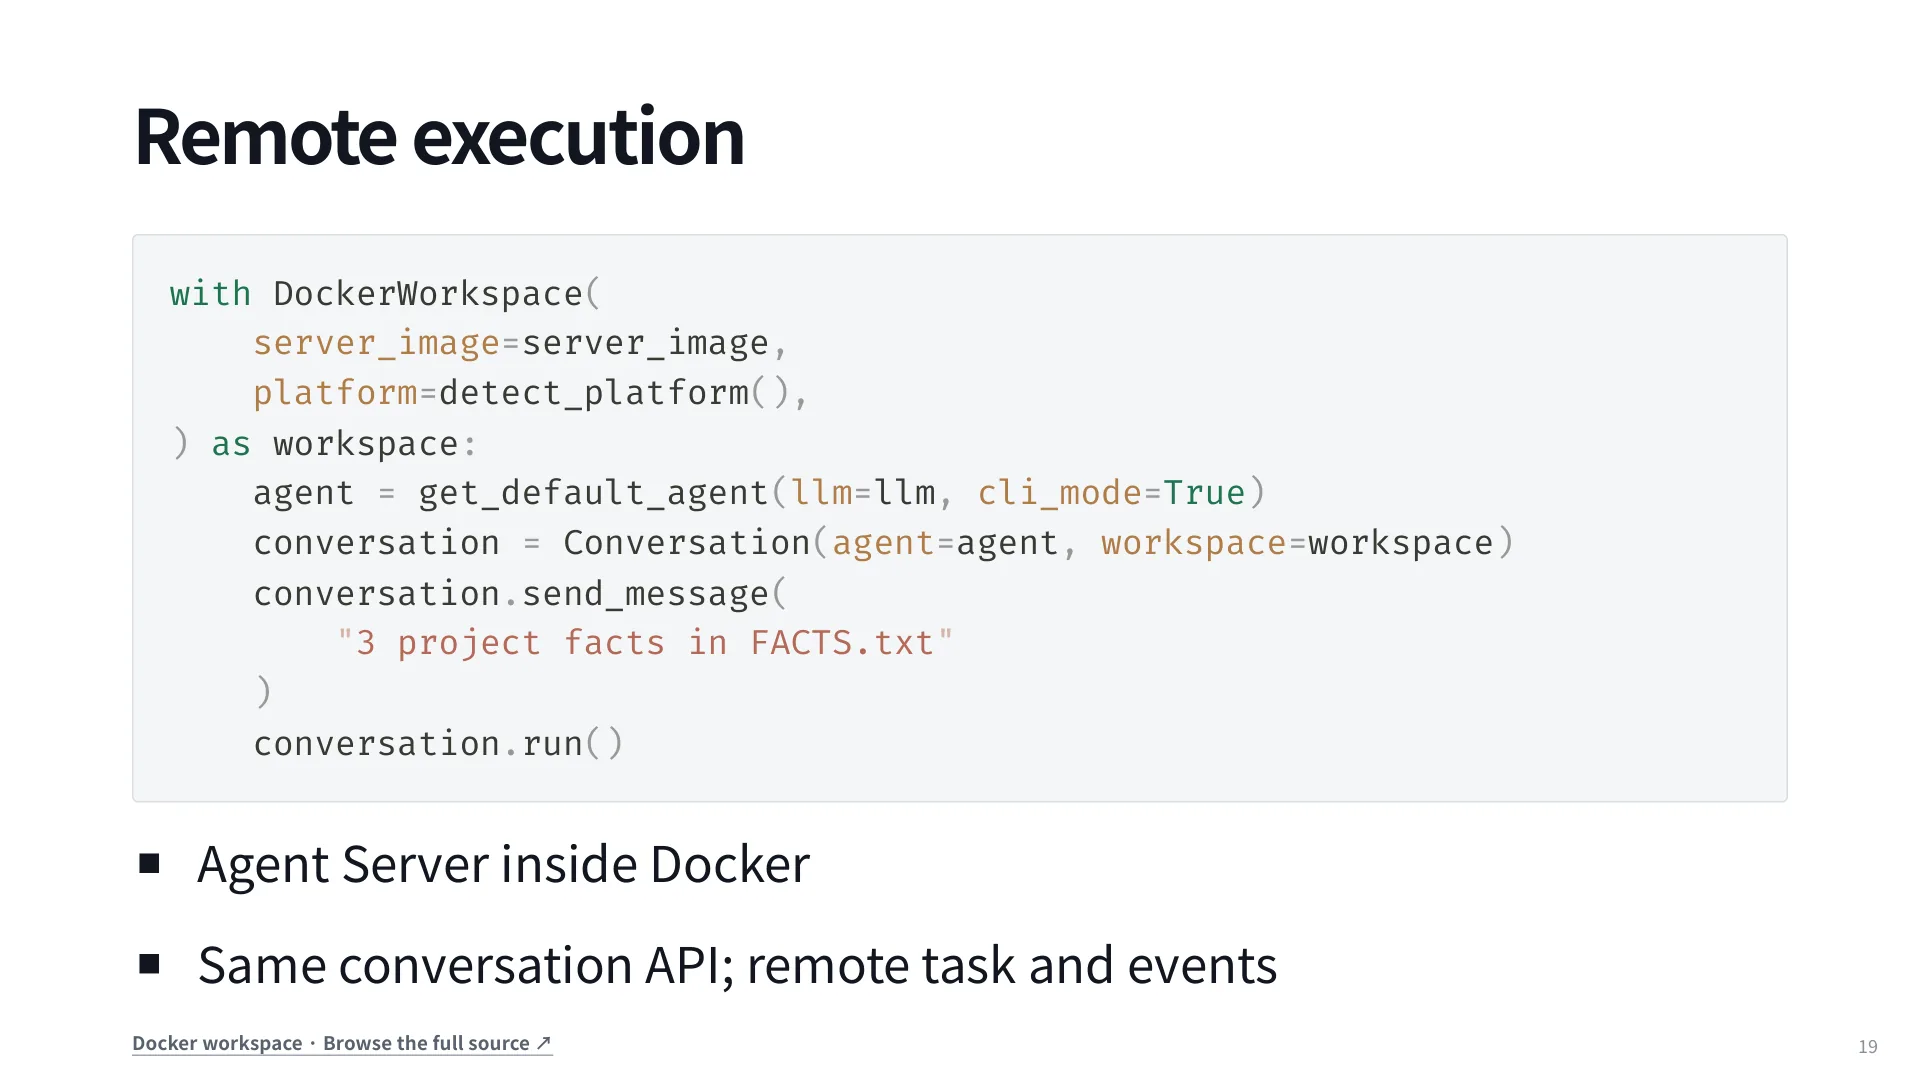
with DockerWorkspace(server_image=server_image, platform=detect_platform()) as workspace:
    agent = get_default_agent(llm=llm, cli_mode=True)
    conversation = Conversation(agent=agent, workspace=workspace)
    conversation.send_message("3 project facts in FACTS.txt")
conversation.run()Graham 自己说不太确定哪种更好。with 写法在代码上更自然,但大量现成工具链是围绕"agent 整个跑在容器里"设计的,比如镜像里预装依赖、日志采集、资源限制。这是一个典型的工程折中:抽象更优雅的方案,未必是生态更支持的方案。
另一层保护是动作确认。确认策略决定哪些动作可以自主执行、哪些必须停下来等人:
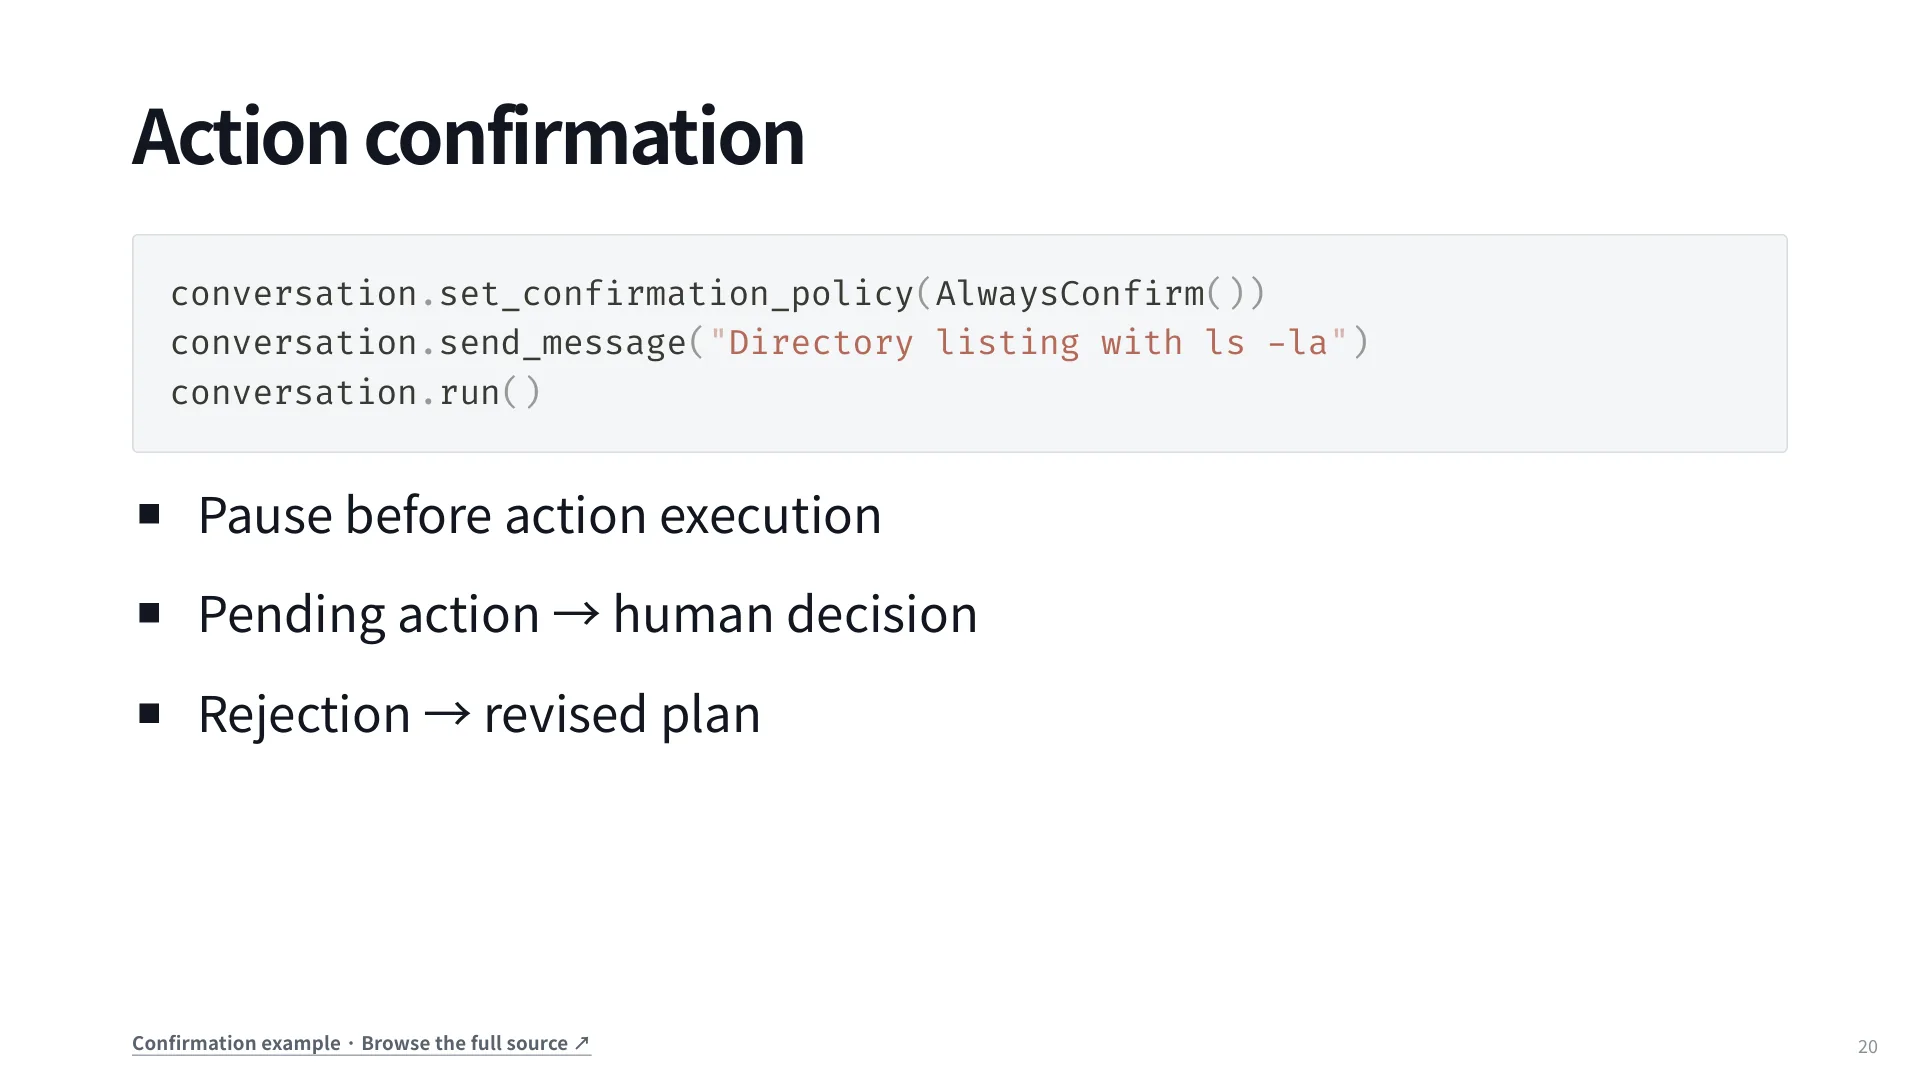
conversation.set_confirmation_policy(AlwaysConfirm())
conversation.send_message("Directory listing with ls -la")
conversation.run()除了静态策略,还可以挂一个 security analyzer,在每一步判断该动作是否足够安全以自主执行(22:04)。这套机制的本质是把"信任"变成一个可分级、可按步回看的量,而不是二值的"敢不敢让它跑"。
讲师提醒:安全不是一个可以事后补的模块。确认策略、沙箱边界、权限范围必须在设计 SDK 时就作为一等公民,因为一旦 agent 的默认行为是"什么都能做",后面所有的限制都会变成体验上的倒退,用户会想办法关掉它。
6. 单 agent 的辩护
2024 年初,多 agent 是显学。CodeR 这类工作把修 bug 拆成五个角色:Manager 出计划、Reproducer 复现、Fault Localizer 定位、Editor 改代码、Verifier 验证,每个角色有自己的 prompt 与工具,串成一条固定流水线。据 Graham 回忆,同期大约有 15 种变体。
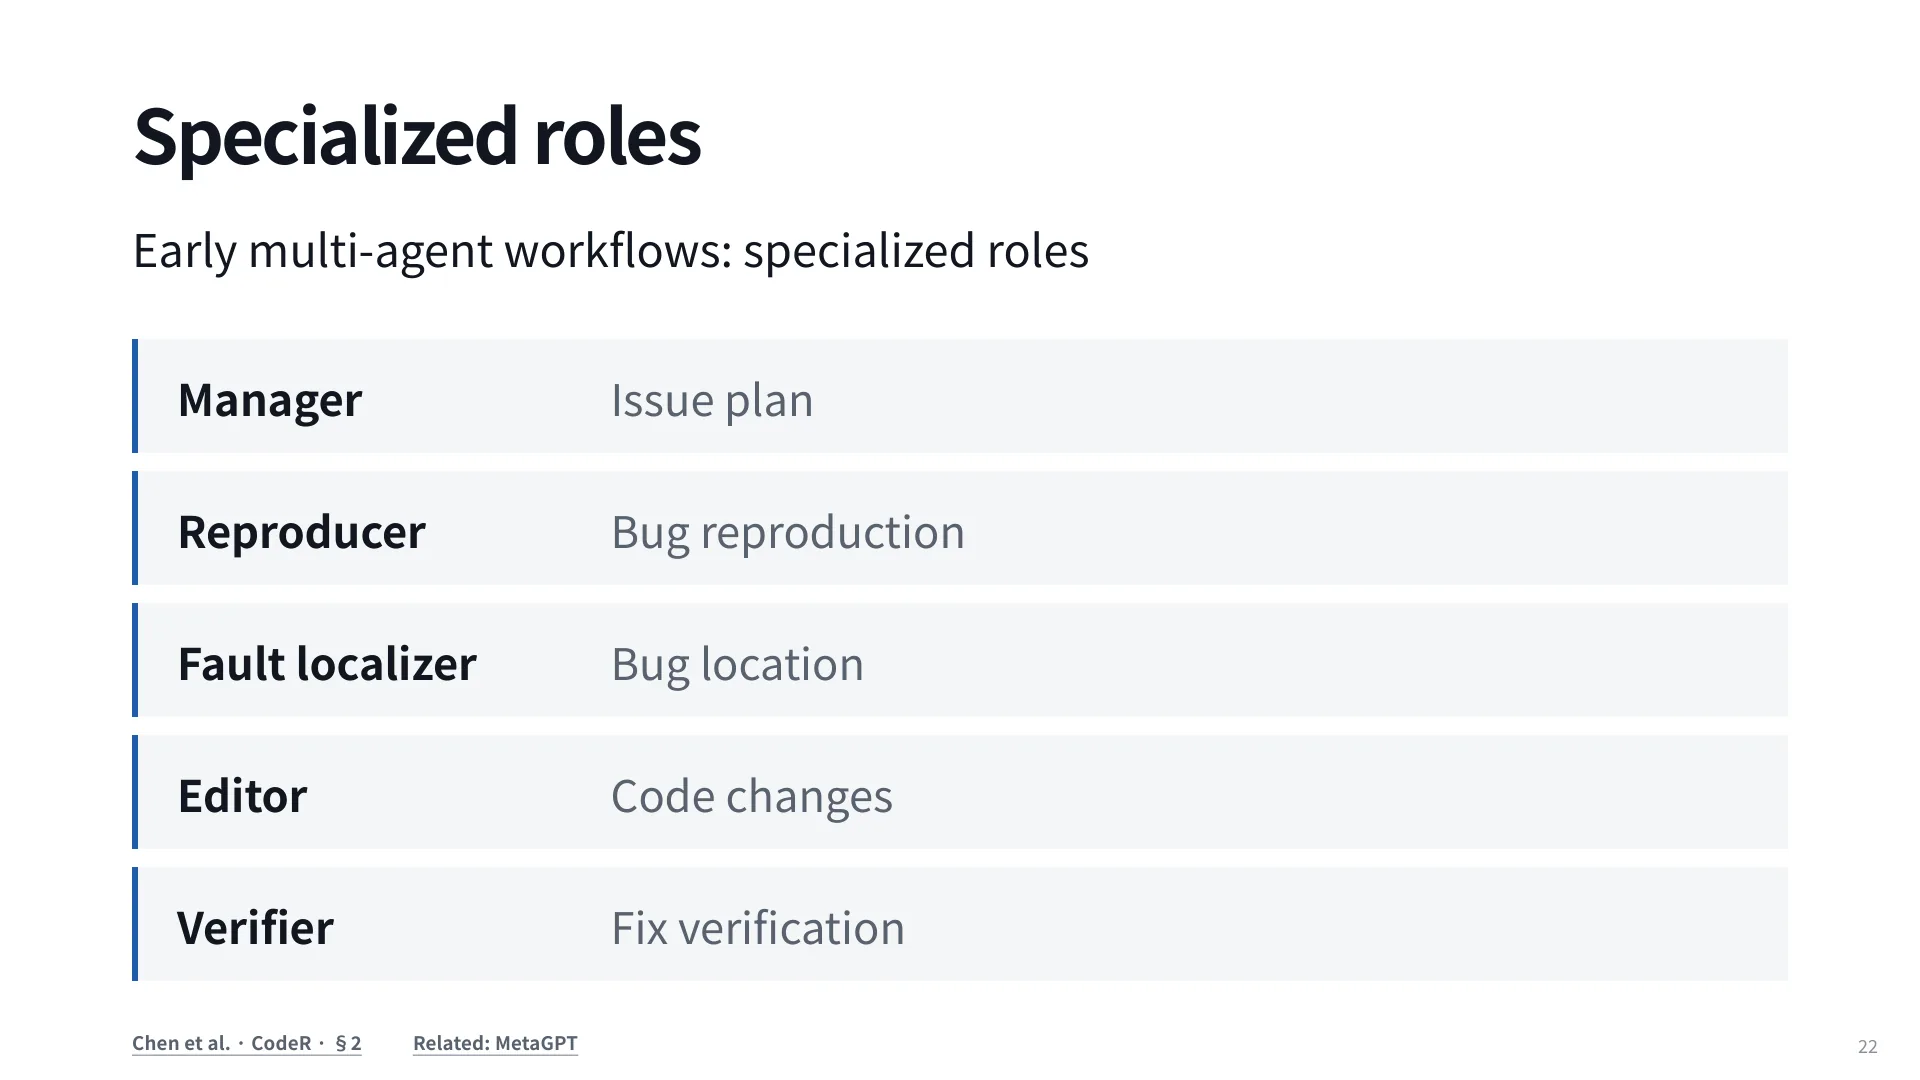
他 2024 年底写了篇博客《Don't Sleep on Single-agent Systems》,论点很直接:如果模型指令遵循能力持续变强,那么"先做这个、再做那个"的固定流程完全可以写进一段 prompt,让一个 agent 顺序执行;多 agent 的收益会被模型进步吃掉,而它的复杂度是永久的(31:03)。
单 agent 的基线设定是:一个 agent 完成复现、定位、编辑、测试四件事,四项活动共享同一份上下文;拆成角色后,每个角色各自维护上下文,交接点就成了新的失败来源。
这个判断在编码任务上基本被验证了。原因不只是"模型变强",还有一个结构性理由:修 bug 是一个高度耦合的任务。复现时看到的栈追踪、定位时读到的调用链、编辑时考虑的兼容性,其实是同一份上下文的不同侧面。把它们分给不同 agent,就要在每次交接时决定"传什么、丢什么",而这个决定本身就容易出错。单 agent 共享上下文,省掉了这个信息瓶颈。
支撑单 agent 的是刻意做小的工具集:编辑文件、运行命令、浏览。三个动词,覆盖源码、配置、文档、依赖、测试、视觉检查。
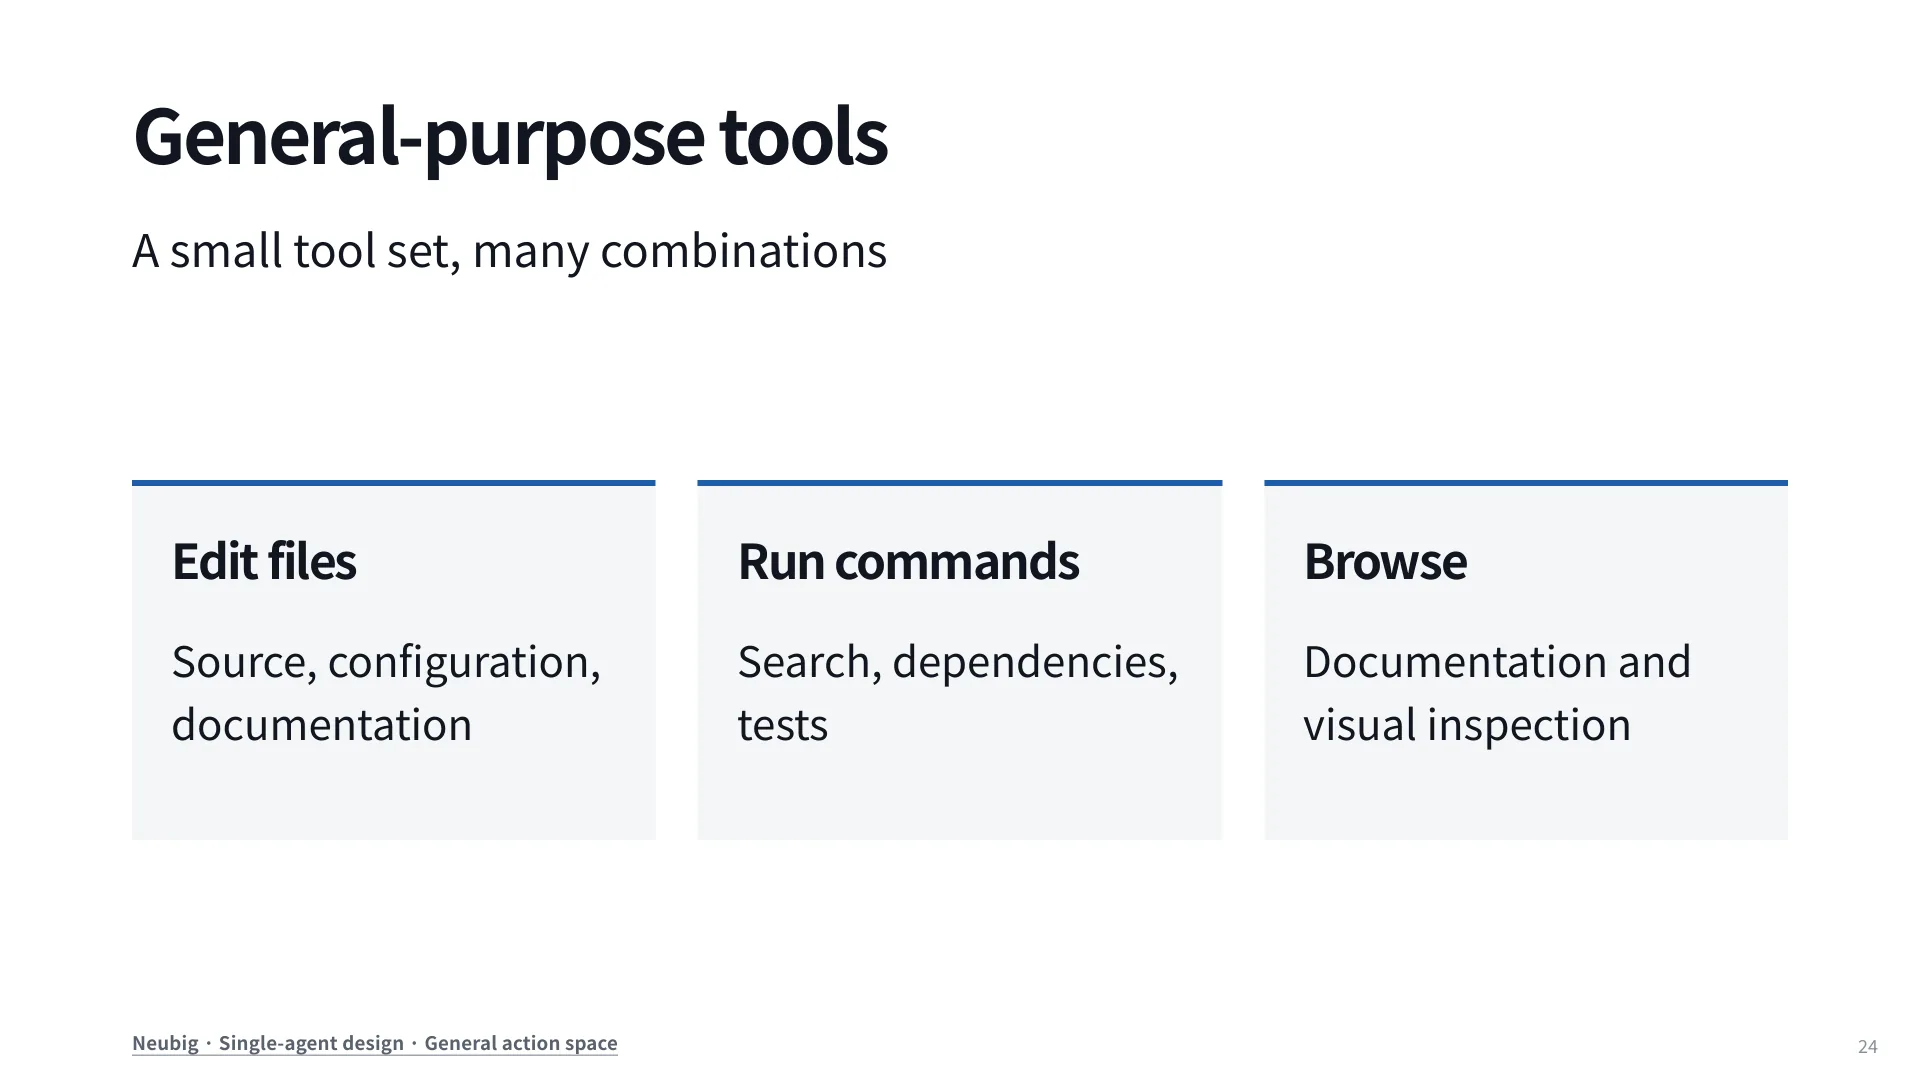
小工具集的另一个好处是组合性。如果给 agent 一个 run_tests 专用工具,它就只能按你设想的顺序跑测试;给它终端,它就能自己拼出 pytest -k foo -x、git bisect、pip install -e .。代价是错误空间变大——终端能做的事太多,误删文件、破坏环境都在射程内。这也是为什么工具集小和沙箱严格必须配套:动作空间越通用,隔离边界就越重要。
7. Skills 与 MCP:把多 agent 摊平成按需上下文
单 agent 有一个副作用:prompt 会膨胀。项目约定、CI 流程、发布步骤、代码风格,全都塞进系统提示,很快就变成一长串清单,而且大部分内容在多数回合里用不上。OpenHands 的解法是 skills——额外指令,按需加载。
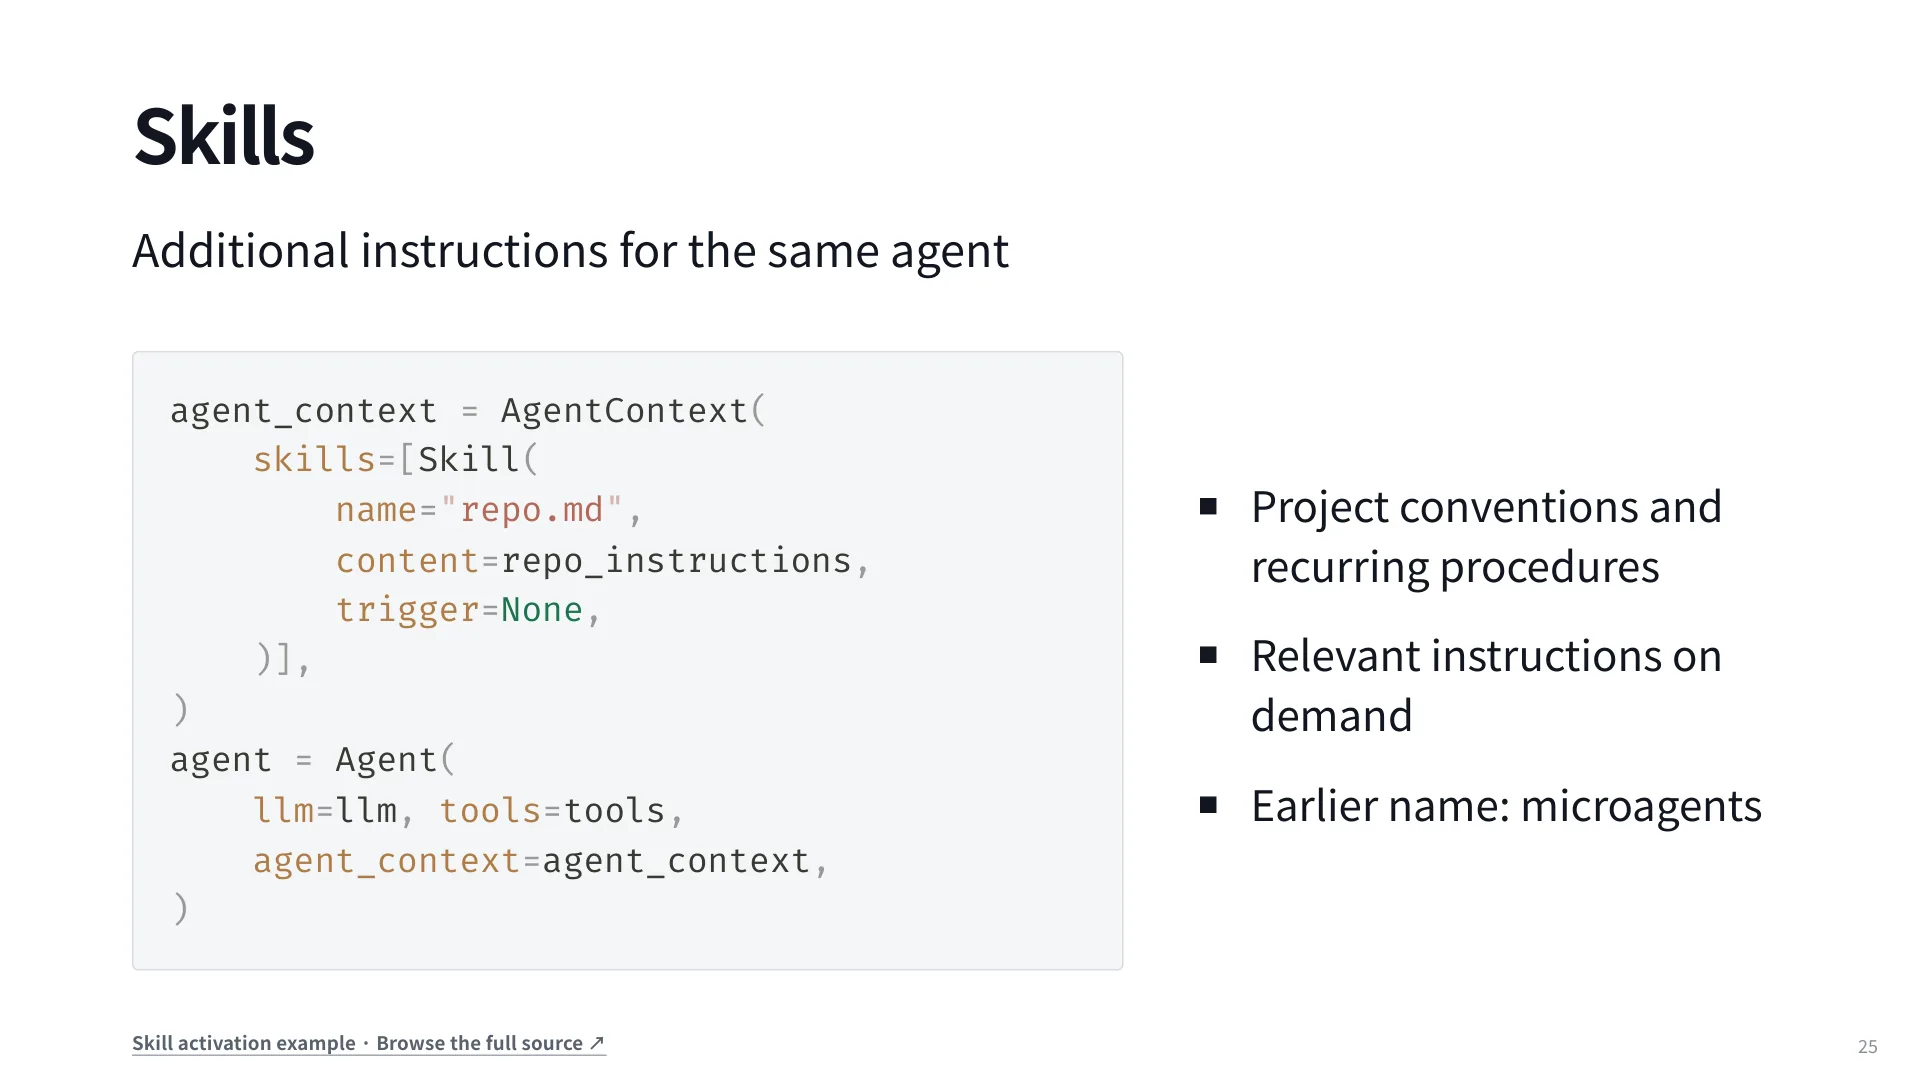
agent_context = AgentContext(
    skills=[Skill(name="repo.md", content=repo_instructions, trigger=None)],
)
agent = Agent(llm=llm, tools=tools, agent_context=agent_context)这个机制最早叫 microagents,后来 Anthropic 用同样的思路做了 skills,Graham 承认"skill 是个好得多的名字",因为 microagent 让人误解为"一个小 agent"。两者有一个实现差异:Anthropic 让 agent 自己决定查哪个 skill 再读文件,OpenHands 早期用关键词显式触发;无论哪种,目标都是在正确的时机把正确的上下文拉进来。
MCP 解决另一半问题:能力不在指令里,而在外部服务里。
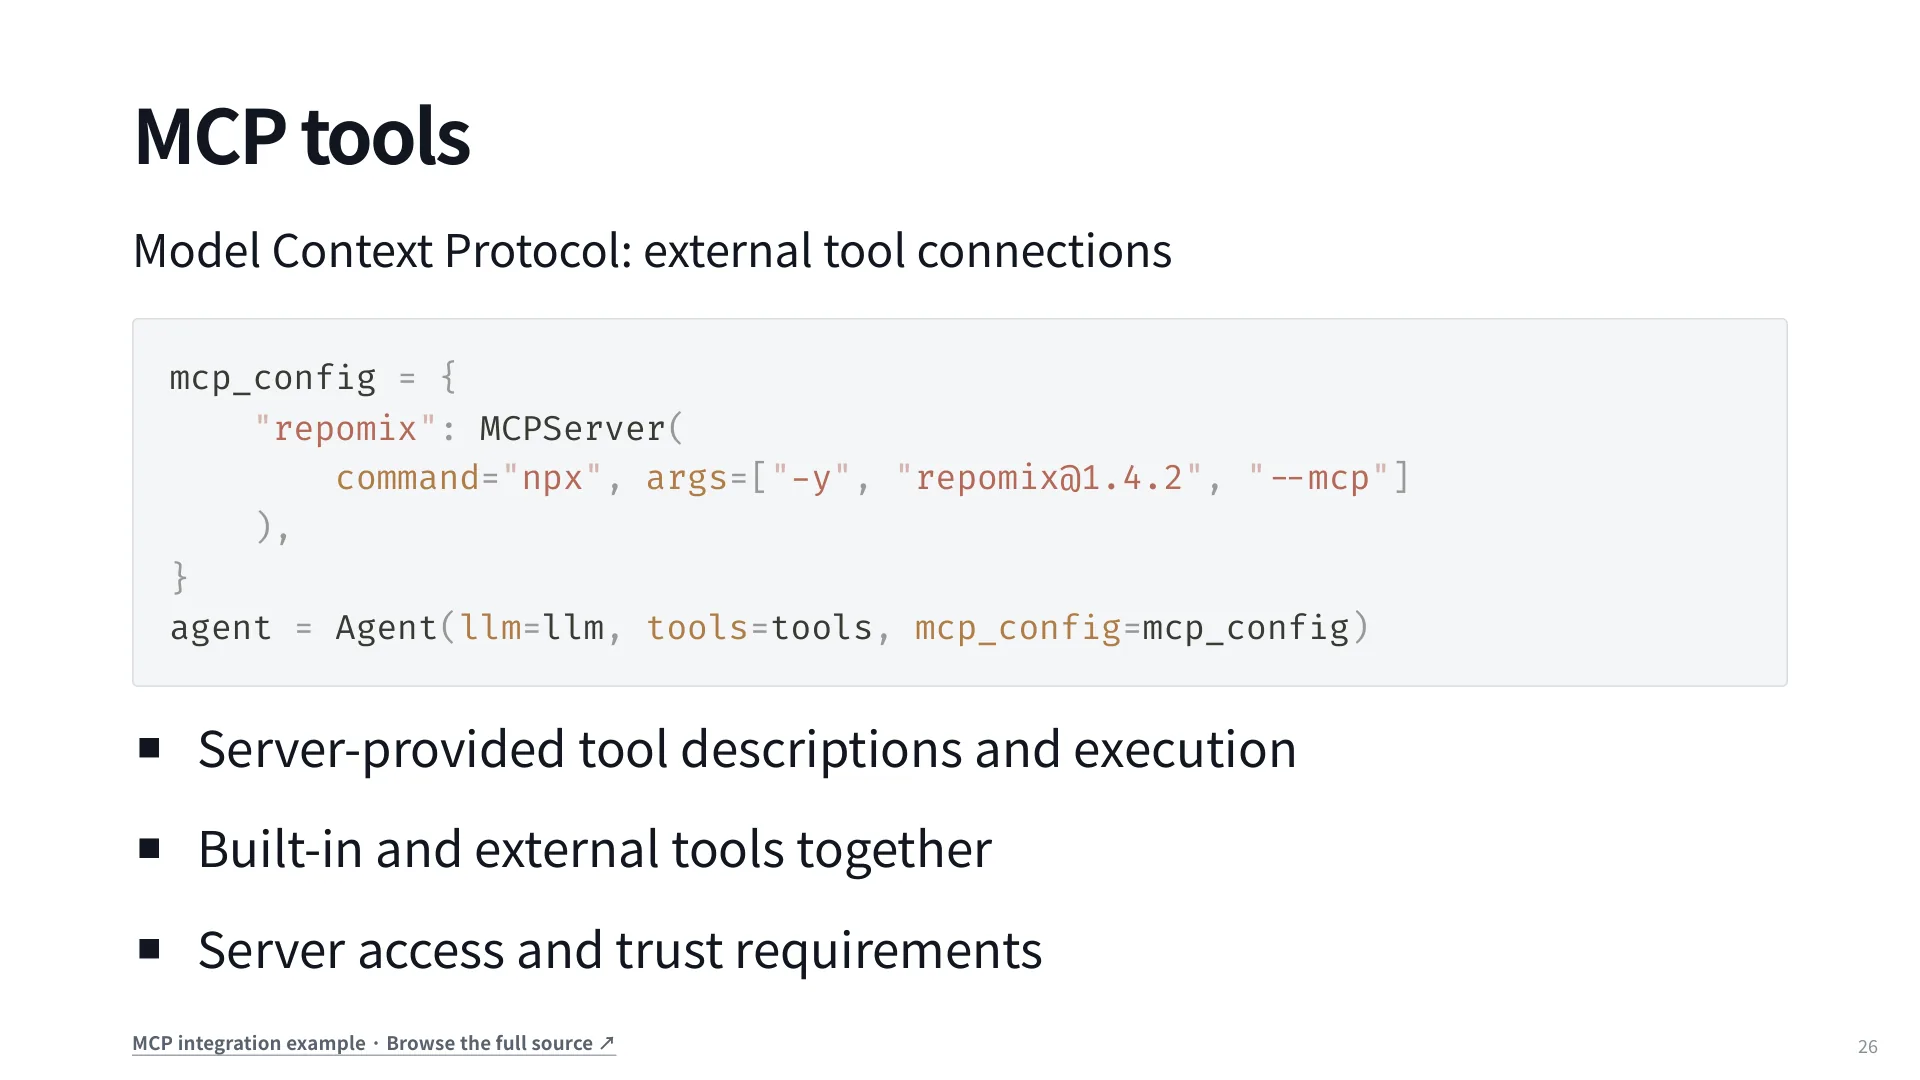
mcp_config = {"repomix": MCPServer(command="npx", args=["-y", "repomix@1.4.2", "--mcp"])}
agent = Agent(llm=llm, tools=tools, mcp_config=mcp_config)把 skills 与 MCP 放在一起看,会发现它们和多 agent 是同一个问题的两种解法(35:14)。多 agent 的方案是:给 Manager 一份 manager prompt 和 manager 工具,给 Reproducer 一份 reproducer prompt 和工具,各自带着自己的上下文。skills + MCP 的方案是:只有一个 agent,但在需要时把对应的指令与工具即时拉进来。前者是空间上的切分,后者是时间上的切分。
时间切分的好处是上下文不必在角色之间搬运,坏处是"什么时候该拉什么"变成了 agent 的判断,判断错了就会缺少关键信息。空间切分的好处是每个角色的上下文干净、职责明确,坏处是交接处的信息损失。
这条思路的极端版本是 OpenHands-Versa:给模型代码能力、多模态浏览、搜索和文件访问,用一个通用 agent 去做编码、研究、办公等各类任务,并在多个原本由专用 agent 占据的基准上取得更好成绩。Graham 特意说明,那篇论文的绝对数字很低,因为时间较早,但它验证的是一个方向性问题——通用工具 + 通用 agent 的组合,可以跨域迁移。
8. 多 agent 什么时候真的划算
尽管长期唱衰固定流水线,Graham 并不否认多 agent。他给了三个理由,前一个关于时间,后两个关于上下文。
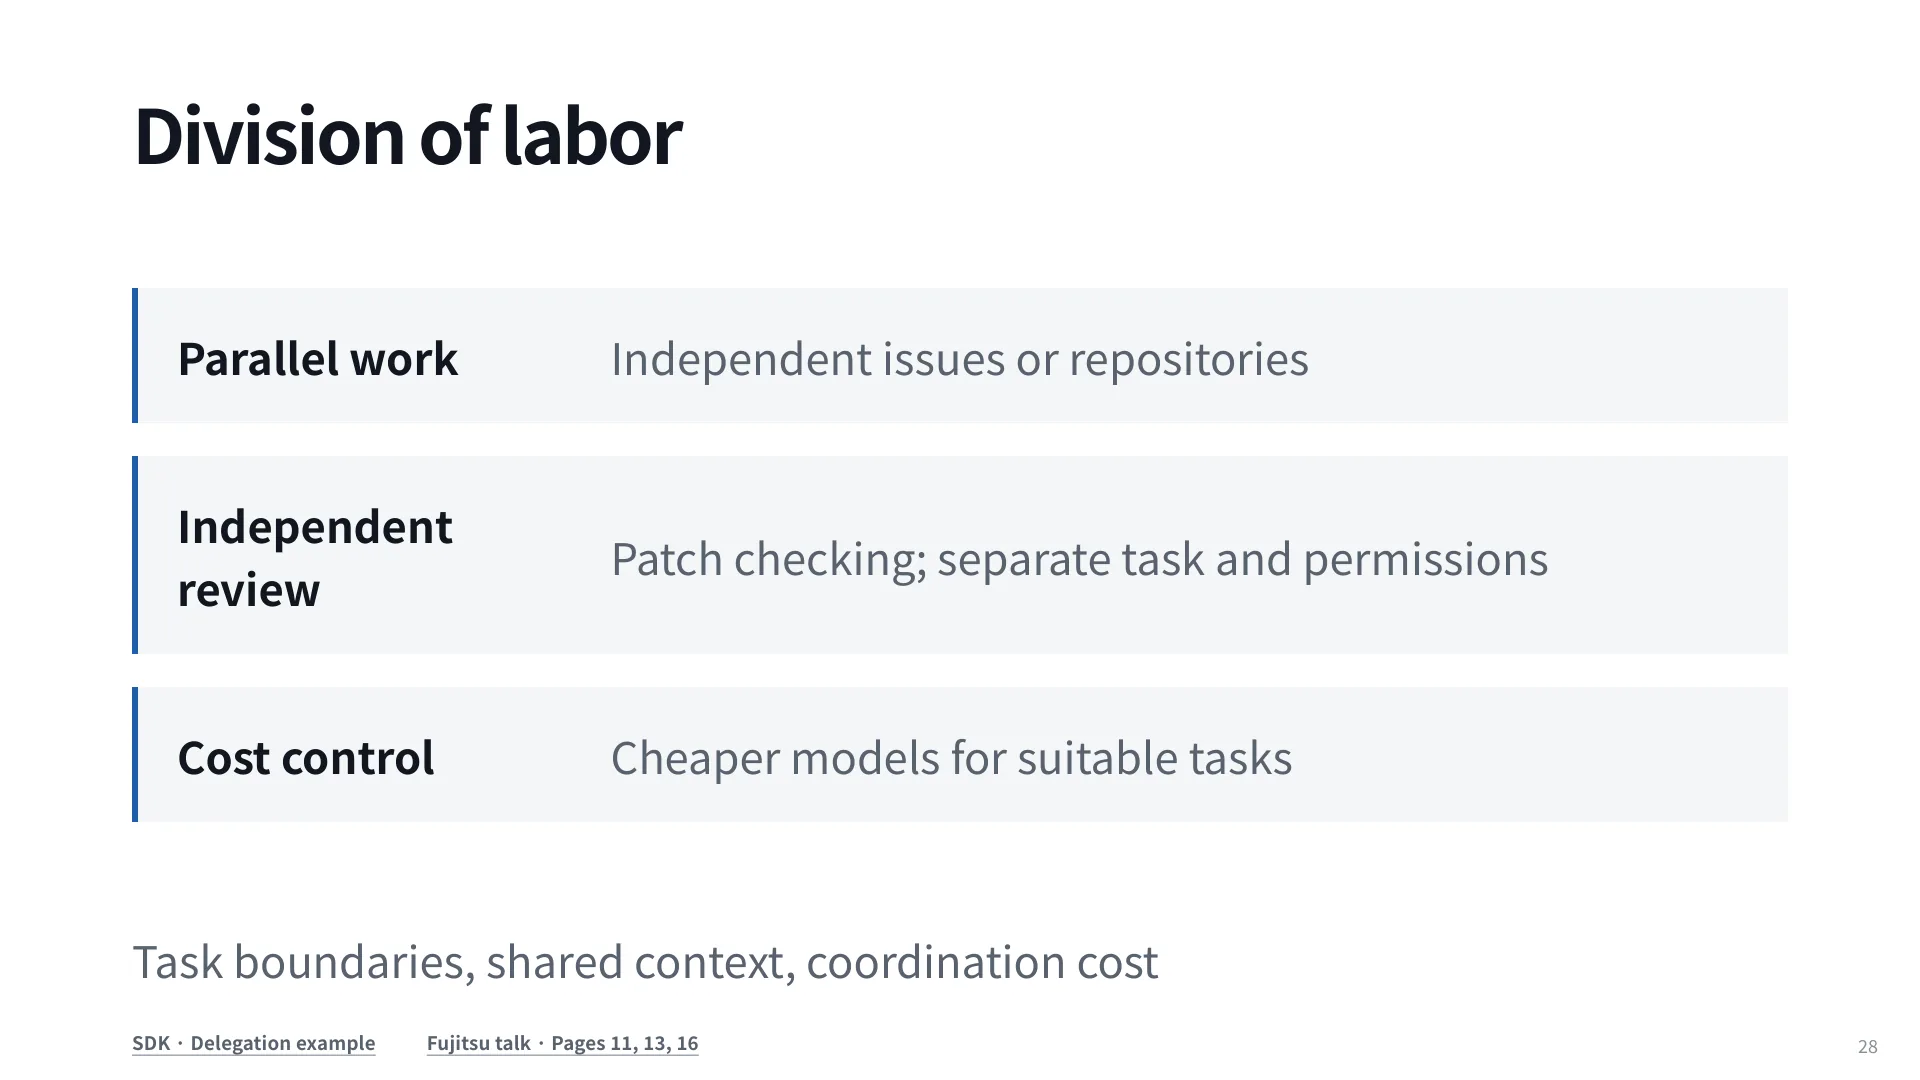
并行最直观:十个互不相关的 PR,可以分给十个 agent 同时做。收益来自墙钟时间,而不是 token。独立评审则有一个反直觉的经验:让 agent 评审自己的工作,它会宽容得多,因为它掌握着当初做决策的全部理由;换一个不带这些理由的 agent 来看,判断会严厉得多,而严厉正是评审需要的(38:29)。成本控制有两个来源:子 agent 汇报时会丢掉过程上下文,只留下结论,主 agent 的上下文因此更干净;以及用便宜模型做实现、贵模型做规划。
但这三种收益都不是白拿的。他们在异步软件工程 agent 上的实验(Manager 把任务分给多个 engineer,在 PaperBench、Commit0 这类长程任务上跑)说明整合极其困难:执行 agent 要回传"恰好够用"的上下文,多了浪费、少了不够;多个 agent 容易重复实现同一个东西;Manager 最后要把散落的改动合回一个仓库,冲突处理非常琐碎(39:26)。
判断该不该上多 agent
先问任务能不能无损切分。能切分(多个独立 PR、多个文档源、深度研究的多路检索),多 agent 收益直接;不能切分(一个 bug 的复现、定位、修改高度耦合),拆开只是在制造信息瓶颈。再问收益来自哪里:如果只是为了"看起来更有结构",那通常是在为协调成本买单。
还有一个现实问题:可观测性。多个 agent 同时跑时,人类几乎无法完整追踪每条推理链。Graham 的做法是向 Manager 提问,让 Manager 自己去读子 agent 的轨迹——把"理解发生了什么"这件事外包给一个 agent。这也说明多 agent 的诊断工具仍是开放问题。
9. 部署形态:执行位置 × 交互界面
接下来是最容易被忽视、却最影响日常体验的部分:agent 在哪里跑,人通过什么界面看它。
Devin 最初是云端 SaaS,OpenDevin 反过来跑在本地,但隔离在 Docker 容器里——原因是不信任 agent 在自己电脑上乱来。Graham 当时认为本地运行不可能被接受:万一 agent 被 prompt injection 攻击,把 API key 传出去怎么办?结果恰恰相反,人们非常喜欢本地(45:12)。原因很实际:本地有你的文件、你的服务、你的上下文,不需要上传代码,不需要配置远端环境。
于是形成了一个大致的分工:人类在环的修 bug、加功能倾向本地;非编码任务和后台任务(代码评审、定时巡检)倾向云端。云端的好处是笔记本合上也能继续跑,代价是要解决仓库、依赖、凭证的远端配置。
界面这一维同样有四条路,交叉起来是一张 4×2 的表:
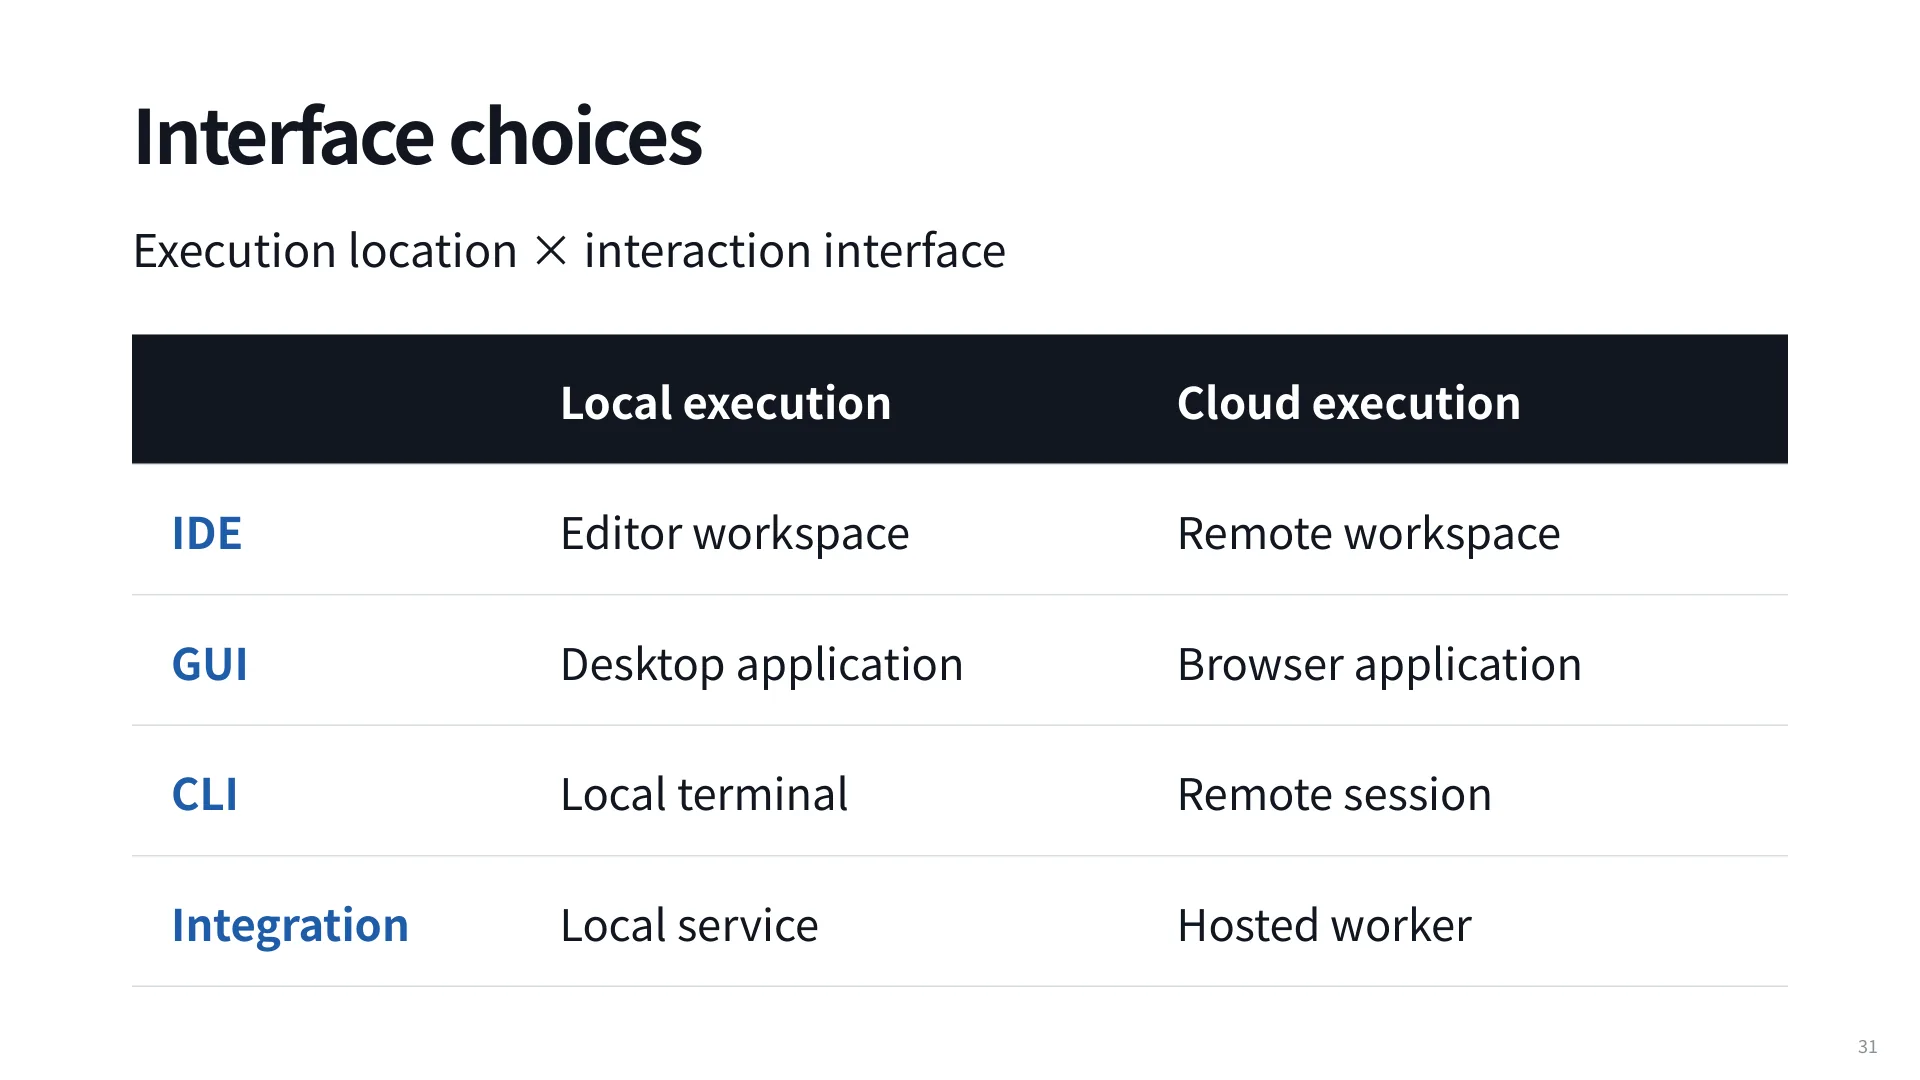
课堂上做了一次小调查:CLI 约六成,IDE 不到一半,GUI 只有 4 个人。这个分布很能说明问题——CLI 胜在"哪里都能用",服务器、家用机器、容器里都一样;IDE 胜在熟悉,文件树、diff、测试、调试器都是现成的;GUI 是 agent 原生界面,把工作区围绕任务而不是文件来组织,但需要用户改变习惯;集成则把 agent 塞进已有的工作流(GitHub、Slack),不需要打开任何新界面。
GUI 的合理性在于:如果 agent 写完了所有代码,IDE 的大部分功能就是为"读代码的人"准备的遗产。一个以任务为单位、能同时看多个并行运行、能预览和批准改动的界面,可能比编辑器更贴合真实工作。但这也是它的问题:多数人现在仍然要读代码,完全脱离编辑器的界面在审查环节会显得单薄。
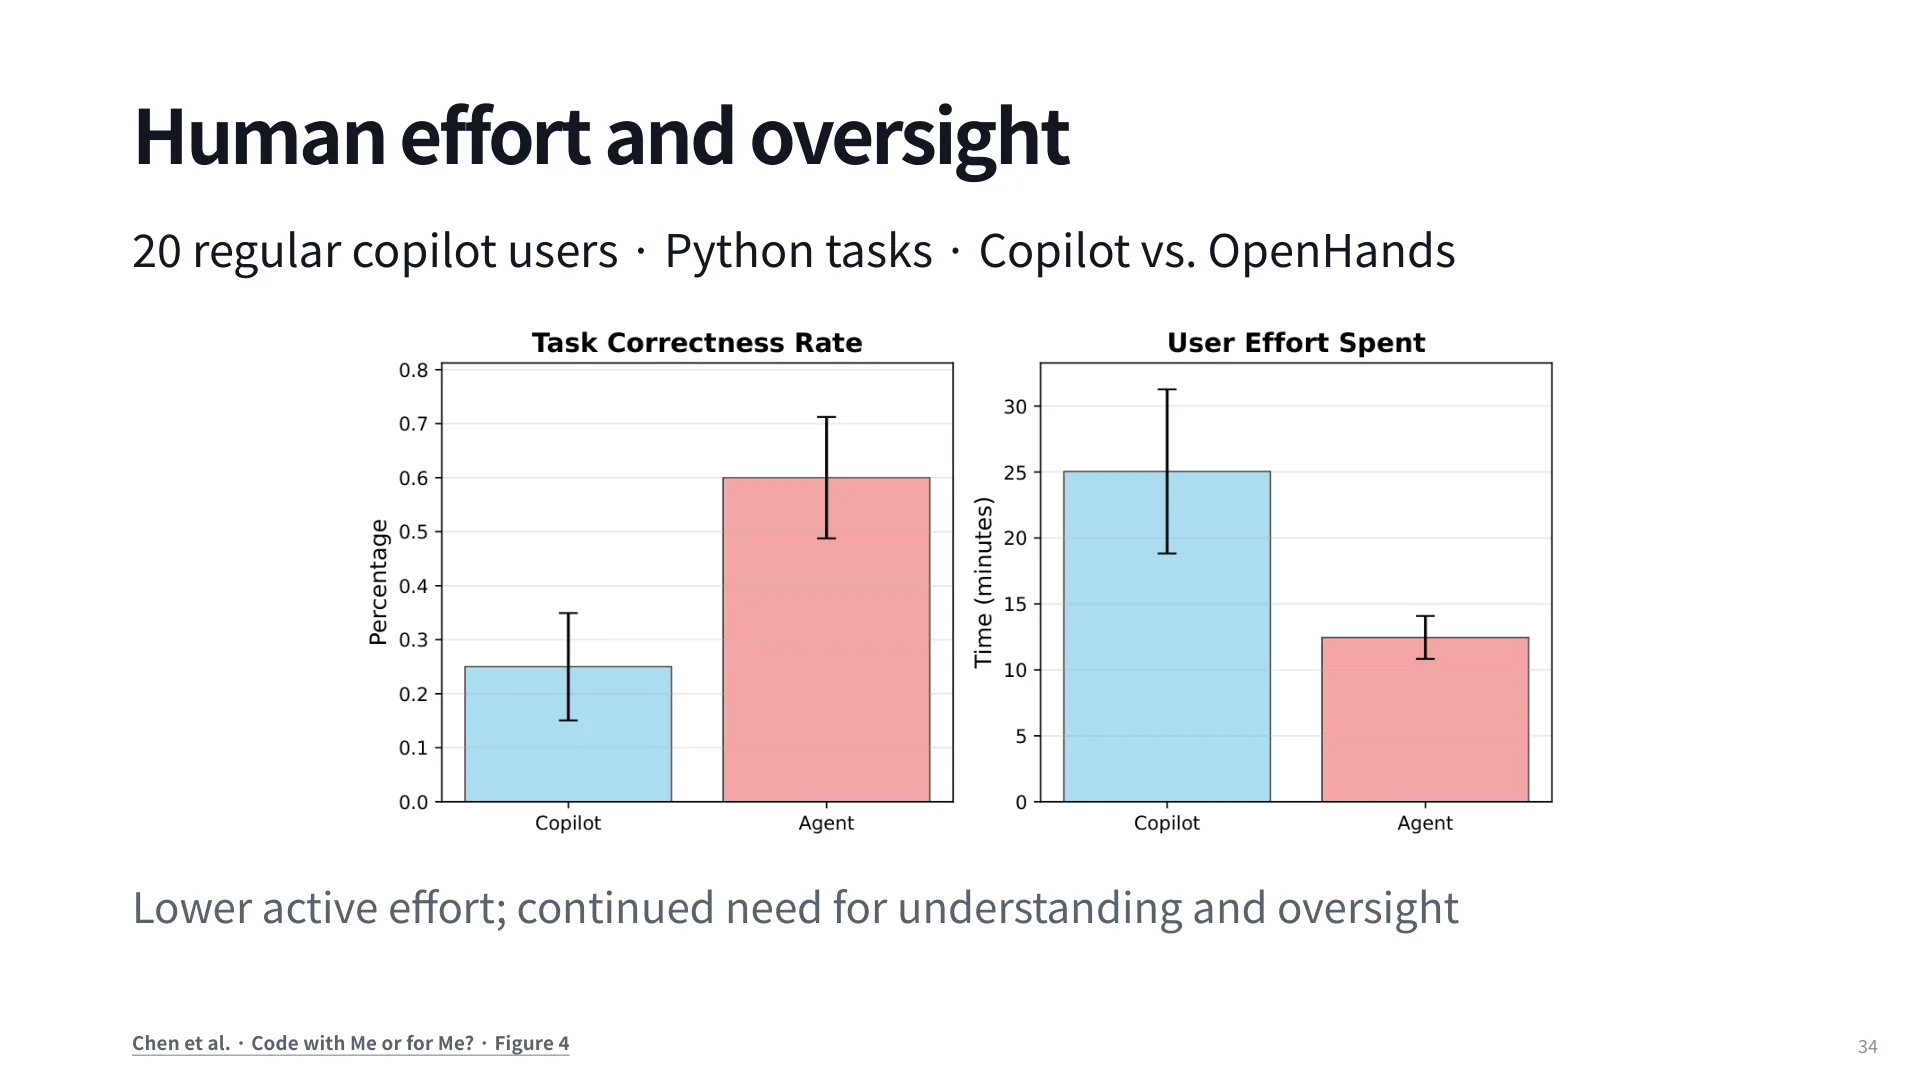
他们做过一个用户研究来量化这件事:20 名常用 Copilot 的开发者,做同一批 Python 任务,比较 Copilot 与 OpenHands agent。正确率从约 25% 升到约 60%,投入时间从约 25 分钟降到约 12.5 分钟。但负面反馈同样重要,而且都指向界面设计:"看着 agent 干活很无聊",以及**"我很难确认它到底做得好不好"**。
这两条抱怨正好对应两个设计目标。无聊意味着界面要支持并行与多任务,让人在等待时做别的事,而不是盯着日志滚动。难以确认意味着界面要把证据摆到人面前:改了哪些文件、跑了哪些测试、哪些测试从红变绿、哪些行为没有覆盖。这不是 UI 美化问题,而是把 agent 的内部状态翻译成可判断的凭证。
10. 自动化与软件工厂
自动化的形态可以用五个方框概括:触发、上下文、运行、产物、检查。
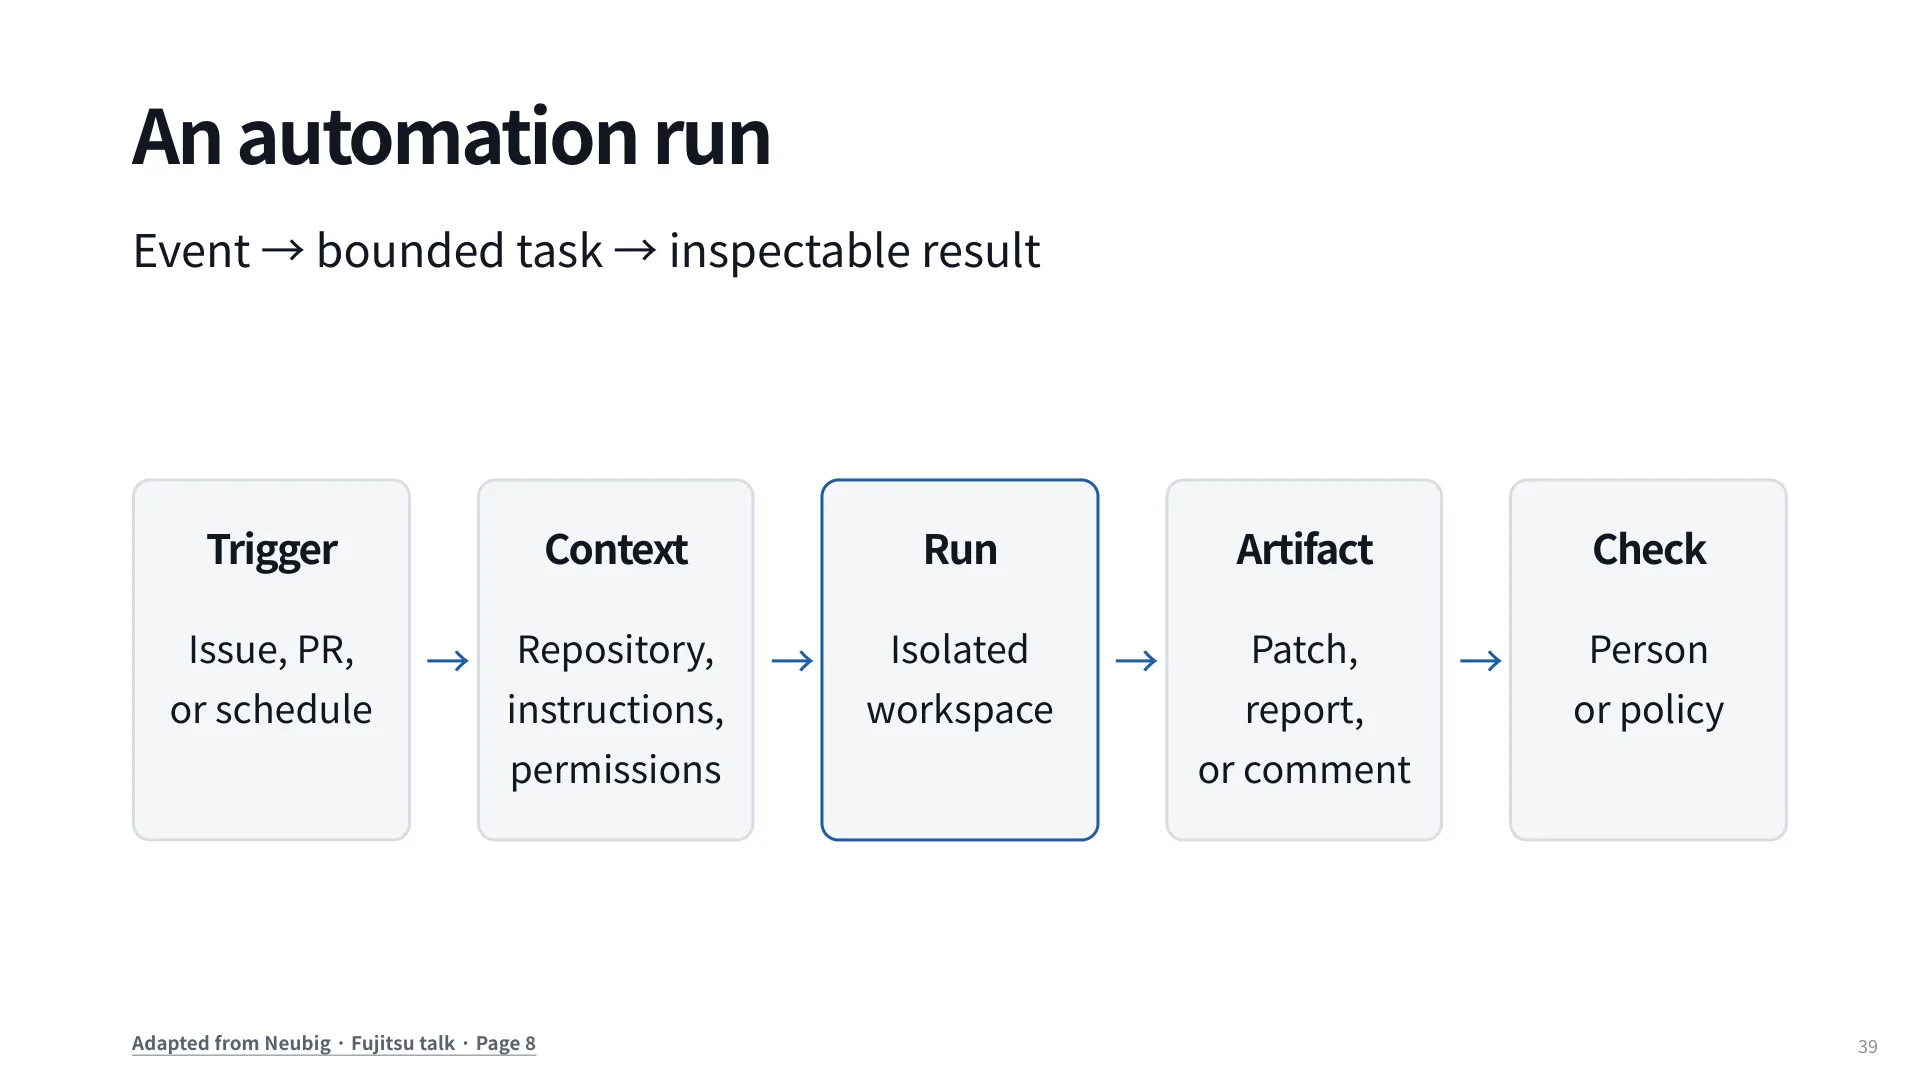
与对话模式相比,这条链的每一环都在收窄自由度。Trigger 决定了任务的来源与边界;Context 决定了 agent 能看到什么、能做什么;Run 在隔离环境里执行;Artifact 要求产出可交付的对象而不是一段解释;Check 把验收交给人或策略(50:53)。OpenHands 自己的流水线包括 PR 评审、issue 分诊、Slack 频道监控,以及依赖版本自动升级失败后的修复。
issue 分诊这个例子很能说明自动化的价值。作为一个热门开源项目,他们收到的 PR 远多于能审的量,而且很多是"vibe coding"出来的低质量补丁——问题不在模型,而在issue 本身没说清楚要做什么。分诊 bot 做两件事:判断这个 issue 是否清晰,列出需要补充的信息;或者给出验收标准,明确"什么情况下算做完"。这实际上是把人类维护者脑子里的隐性标准显式化,收益远超省下的几分钟。
PR 评审则依赖一份高度细化的评审准则:这个 PR 是否在范围内、是否应该进这个仓库、需要检查哪些项。把准则写清楚,agent 才能稳定地执行;准则模糊,agent 就会给出"看起来不错"这种没用的意见。
把这些环节串起来就是"软件工厂":issue 分诊(请求与验收标准)→ 实现(patch、测试、PR)→ 代码评审(独立验证)→ 合并检查(当前 commit 上通过检查并获得批准)。每一步都有明确的输入输出和检查点,人才从"每一步都要参与"变成"在检查点做决策"。
讲师提醒:自动化的门槛不在 agent 能力,而在任务是否被定义清楚。同一段 prompt 在对话里可以靠人追问补救,在自动化里没人补救,模糊之处会直接变成错误产物。
11. 从运行记录里学习:SkillRefiner
自动化的深层意义在于:它把一次性的工作变成了可积累的数据。每次分诊、每次评审,要么做对了,要么做错了,而且对错往往能在几天后从人类行为里读出来——bot 说 LGTM,维护者后来说"这有问题",这就是一个负样本。
SkillRefiner 就是把这个信号变成 prompt 改进的流程:收集成功与失败的轨迹(带证据),用嵌入聚类,分别提炼模式,生成对指令的修改提案;再用一个 evidence gate 回查支持证据,必要时用新指令重跑,确认这次评审确实更好,最后合并成新的 skill(56:40)。
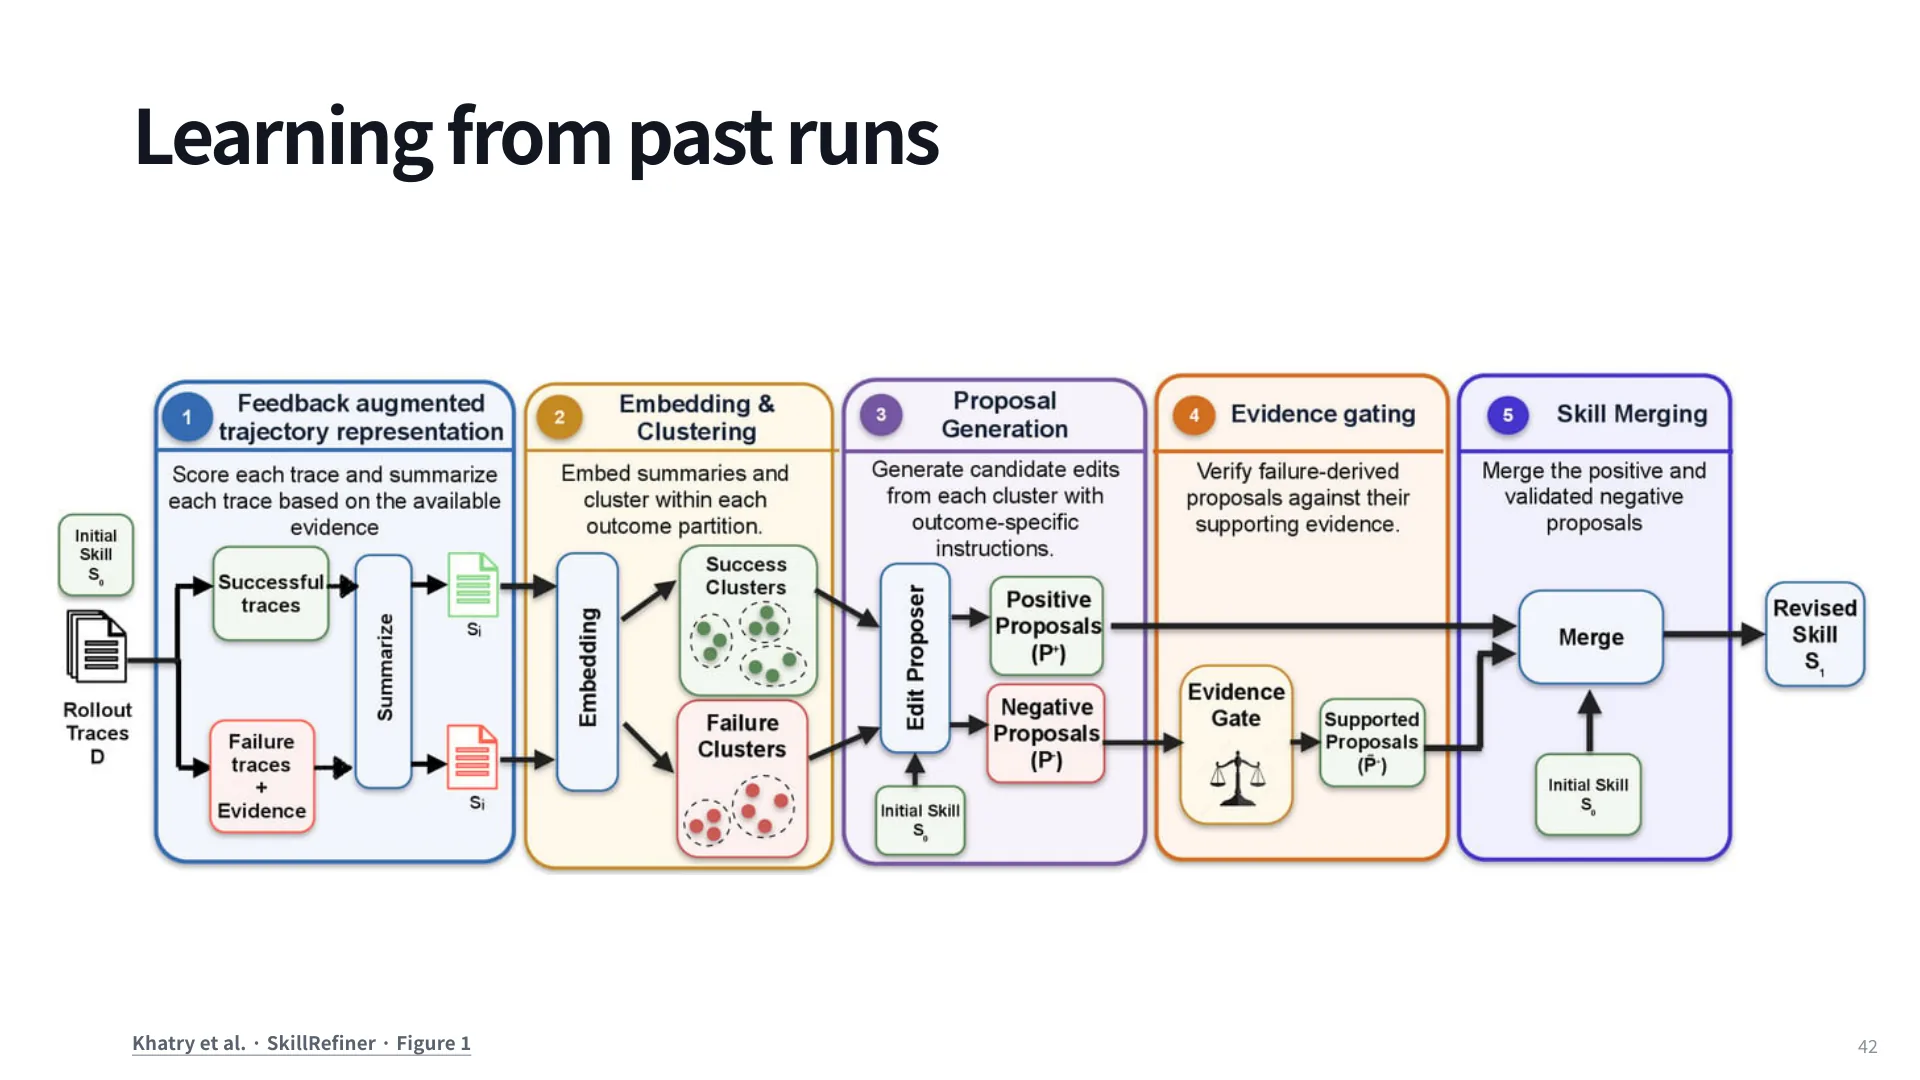
整条流水线可以拆成五步。第一步把每条轨迹按可得证据打分并摘要,分成成功与失败两堆;第二步对摘要做嵌入,在两堆内部各自聚类;第三步针对每个簇生成候选修改,正例与反例分别产出提案;第四步用支持该提案的证据做核对,必要时用新指令重跑一次;第五步把正向提案与通过验证的负向提案合并进初始 skill,得到修订版。关键在于第四步:没有这道门,聚类出的"模式"很容易是噪声,改完反而更差。
结果值得细看。SpreadsheetBench 上,LLM 初始 skill 配 GPT-5.4-mini 是 77.5,GEPA 78.5,T2S 79.0,SkillRefiner 84.0;换成 MiniMax-M2.7 从 68.0 升到 76.0。人类撰写、配 GPT-5.4-mini 的初始 skill 起点更高(86.0),最终 86.5,基本持平;但同一批人类 skill 换到 MiniMax-M2.7 上则是 79.0 升到 84.5,说明"人类写得更好"并不总能抵消模型差异。DAPO-Math 上,强模型从 90.0 到 91.0,弱模型从 53.5 到 64.0,提升集中在弱模型一侧。PR 评审 F1 从 0.16 到 0.18、0.11 到 0.15。
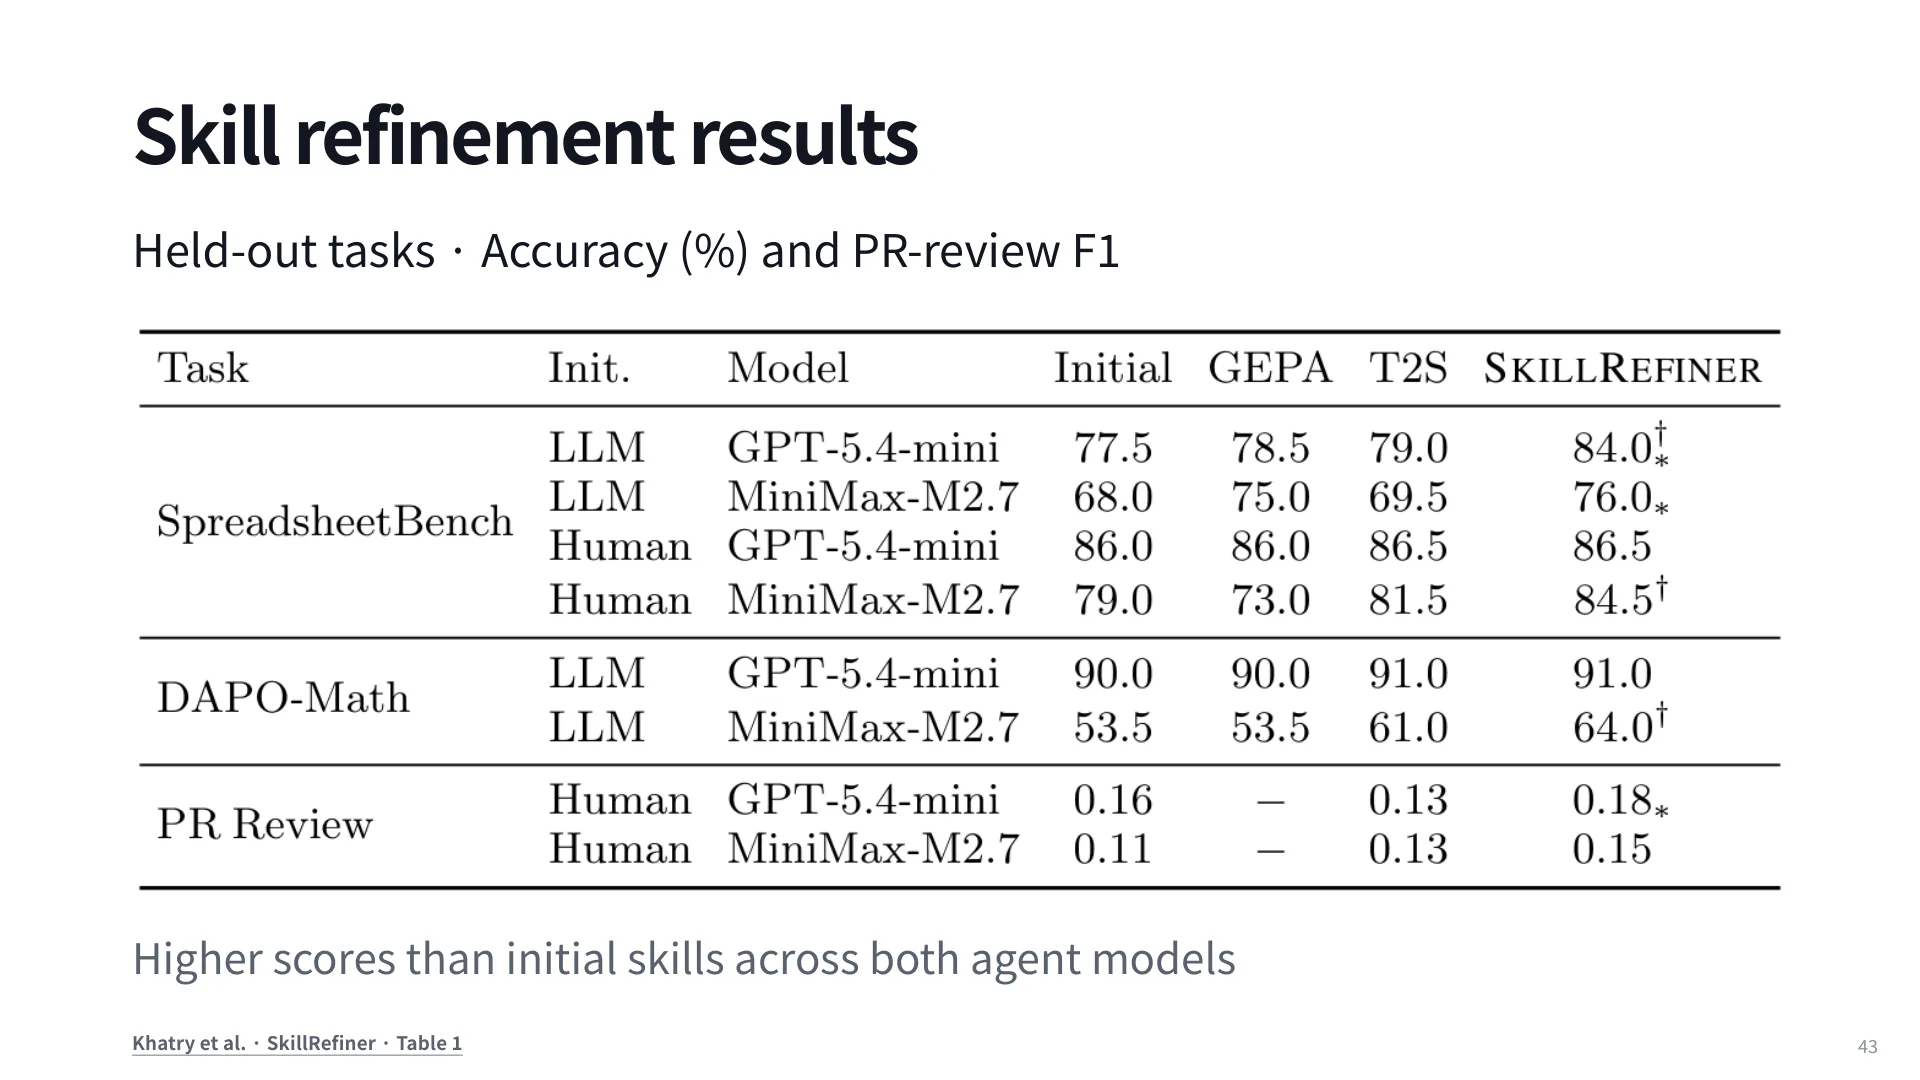
这个模式说明两件事。第一,自动改进擅长把弱基线拉起来,不擅长突破强基线——人类专家写的 skill 起点已经很高(配 GPT-5.4-mini 时 86.0),在强模型上几乎没有余量,剩下的差距要靠模型或评测。第二,收益的大小取决于反馈信号的质量:PR 评审有维护者的真实行为作为标签,所以能稳定改进;如果只有"看起来合理"这种弱信号,闭环就会退化成自我强化。
Graham 进一步提出一个更大的设想:现在这些工作流大多是声明式地写出来的,未来可以从大量轨迹里挖掘出来——把用户的实际用法聚类,自动生成自动化配置,再交给 SkillRefiner 迭代。他甚至认为,改 prompt 只是改进系统的一条路,另一条是训练模型;而要做后者,先得有针对定义模糊任务的严格评测——issue 分诊、代码评审这类任务没有唯一正确答案,怎么评是开放问题。
12. 局限、争议与可做的研究
把整讲收束一下,有几处明显的张力值得记住。
第一,模型无关与深度优化之间的矛盾。 OpenHands 想要跨模型通用,但工具集曾经刻意贴近 Claude Code,因为这样 Claude 系模型表现最好;OpenAI 的模型"什么 harness 都能用",Gemini 一度在多 harness 训练上落后,分数很低,后来才改善(28:37)。这说明 harness 与模型之间存在协同进化:模型在流行 harness 的轨迹上训练,harness 又模仿强模型偏好的工具格式。所谓"通用",是在这个循环里维持一个不太差的平均值。
第二,多 agent 的收益被高估、成本被低估。 并行带来的墙钟收益是真的,独立评审带来的判断质量提升也有道理,但成本未必更低:在他们那篇异步软件工程 agent 的论文里,多 agent 配置往往花得更多,只是完成得更好、更少半途而废(65:53)。上下文管理与整合的难度是实打实的工程债。
第三,可观测性仍然原始。 多个 agent 并行时,人几乎无法重建完整的因果链。把"读轨迹"外包给 Manager 是一种务实但脆弱的办法,它把理解的责任又交给了一个可能出错的 agent。
第四,评测跟不上部署。 基准分数是模型与 harness 的联合产物,而真实任务(分诊、评审、维护)没有标准答案。没有可靠评测,就无法判断一次 prompt 修改或一次模型替换到底有没有用,也就无法形成 SkillRefiner 那样的闭环。
第五,基础设施本身可能是瓶颈。 一个具体例子:如果让 agent 通过 SSH 连进集群跑命令,那么 agent 一旦被攻破,所有机器一起沦陷;而且实验室集群的登录节点会因为大量 agent 反复建立连接而被拖慢。更稳的做法是让 agent 直接住在目标机器上,用隧道把外部连接接进来。这类问题不在论文里,但决定了系统能不能长期运行。
作为他本人在本课程的最后一讲,Graham 也给出了几个他认为值得做的方向:从轨迹中挖掘工作流;为定义模糊的任务设计严格评测;重新想象代码托管与验证界面(GitHub 未必是 agent 时代的最优形态);以及本地与云端之间的上下文迁移。这些问题的共同点是——它们都不是"再训练一个更强的模型"能解决的,而是系统设计与交互设计的问题。
术语表
| 术语 | 含义 |
|---|---|
| Harness | 承载模型的运行时框架:工具、循环、上下文管理、执行环境的集合。同一模型换 harness,成绩可以差很多。 |
| OpenHands | 开源软件 agent 平台与 SDK,前身是 2024 年 3 月的 OpenDevin;支持对话与自动化两种入口,模型无关。 |
| Software Agent SDK | OpenHands 的第二代内核,提供 LLM、Agent、Conversation、Workspace、Tool 等抽象。 |
| Workspace | agent 的文件与执行环境。可以是本地目录、Docker 容器或远端 Agent Server,对上层 API 一致。 |
| Action / Observation / Executor | 自定义工具的三段式抽象:带类型的输入、给模型看的结果、真正执行的实现。 |
| Condenser(condensation) | 上下文压缩:把较早事件摘要化,保留原始指令与最近工作。Anthropic 称之为 compaction。 |
| Confirmation policy | 动作确认策略,决定哪些动作可自主执行、哪些需人工批准;可配合 security analyzer 按步评估风险。 |
| Skill | 按需加载的附加指令,承载项目约定与固定流程;早期名为 microagent。 |
| MCP | Model Context Protocol,用统一协议连接外部工具服务,由服务端提供工具描述与执行。 |
| Automation | 由 trigger → context → run → artifact → check 构成的无人值守运行。 |
| SkillRefiner | 利用延迟反馈(评审、返工)自动修改 skill 指令的方法,含聚类、提案与证据门。 |
延伸阅读
- Graham Neubig, Don't Sleep on Single-agent Systems(2024,博客)——本讲第 6 节的核心论点来源。
- Wang et al., OpenHands Software Agent SDK(2025)——SDK 的设计与基准分析,见第 10 页。
- Soni et al., Coding Agents with Multimodal Browsing are Generalist Problem Solvers(OpenHands-Versa)——通用 agent 跨域迁移的实验,见第 27 页。
- Chen et al., Code with Me or for Me?——20 名开发者的 Copilot 与 agent 对照研究,第 34 页图表出处。
- Khatry et al., SkillRefiner——从历史运行中自动改进 skill,第 42–43 页。
- Chen et al., CodeR 与 MetaGPT——专门化多 agent 工作流的代表,作为第 6 节的反例阅读。
- Jimenez et al., SWE-bench(2023)——仓库级评测的起点。
自测题
1. 为什么说"基准分数是模型与 harness 的联合产物"?举一个本讲中的例子。
参考答案
同一个模型在不同 harness 下的成绩可能相差很大,因为工具集、上下文管理、测试环境和失败恢复策略都由 harness 决定。本讲第 10 页把 2025 年的基准进步拆成"更好的模型"和"更好的 agent 系统"两侧;Graham 也提到 Gemini 曾因不擅长适配新 harness 而分数很低,后来通过多 harness 训练才改善。2. 单 agent 方案在编码任务上为什么常常优于固定角色的多 agent 流水线?
参考答案
两个理由。其一,模型指令遵循能力提升后,一段"先复现、再定位、再修改、再验证"的 prompt 就能驱动单个 agent 顺序完成,固定流程的收益被模型进步吃掉。其二,修 bug 各阶段高度耦合,单 agent 共享上下文,避免了每次交接时"传什么、丢什么"的决策;多 agent 则在交接处引入信息瓶颈和维护成本。3. skills 与 MCP 如何构成"多 agent 的替代方案"?
参考答案
多 agent 按空间切分:每个角色拿自己的 prompt 和工具,上下文彼此隔离。skills + MCP 按时间切分:只有一个 agent,需要时把对应指令(skill)和工具(MCP 服务)即时拉进来。前者上下文干净但交接有损,后者无交接但依赖 agent 判断"何时拉什么"。4. 上下文压缩(condenser)为什么选择"摘要早期事件"而不是"屏蔽个别动作"?
参考答案
团队试过 mask 掉个别动作,效果更差。原因是单个动作脱离上下文后往往无法解释,而摘要至少保留了"为什么这么做"的因果链。压缩必然有损,所以还需要文件系统、测试结果等外部事实作为补充证据。5. Docker workspace 的两种沙箱方式各有什么取舍?
参考答案
一种是把 agent 整个跑在容器里,另一种是在宿主进程里用 `with DockerWorkspace(...)` 包住一段,区域内命令进沙箱。后者在代码上更自然、更适合库式调用;但大量现成工具链(镜像预装依赖、日志采集、资源限制)是围绕"agent 整体在容器内"设计的,所以两种方式各有生态支持上的差异。6. 为什么"独立评审"通常比"自评审"更严格?
参考答案
自评审的 agent 掌握当初决策的全部理由,会用这些理由为自己辩护,因此更宽容;独立 agent 只看到产物,没有辩护材料,判断更严厉——而严厉正是评审需要的。代价是需要额外的上下文传递与权限隔离。7. 自动化运行中,五个环节各自"收窄"了什么自由度?
参考答案
Trigger 限定任务来源与边界;Context 限定 agent 能看到的信息与可用权限;Run 把它放进隔离环境;Artifact 要求产出可交付对象(patch、报告、评论)而非解释;Check 把验收交给人或策略。整体效果是把开放对话变成可审计、可重复的短任务。8. SkillRefiner 的结果显示"弱基线提升大、强基线提升小",这说明什么?
参考答案
说明自动改进主要是在逼近人类专家已表达出的规范上限:SpreadsheetBench 上人类初始 skill(配 GPT-5.4-mini)已 86.0,最终 86.5;而 LLM 初始 skill 从 77.5 提升到 84.0,弱模型从 68.0 到 76.0。要进一步突破,需要靠模型能力或更严格的评测,而不是继续改写 prompt。9. 为什么说"人看着 agent 干活很无聊"是一个界面设计问题?
参考答案
因为等待是结构性的:agent 的运行时间由模型与它执行的命令决定。界面应当支持并行任务,让人在等待时做别的事;同时要把证据(diff、测试结果、覆盖情况)呈现出来,降低"无法确认它做得好不好"的焦虑。这两点正是 agent 原生 GUI 相对传统 IDE 的核心差异。10. 如果一个团队打算为 issue 分诊搭建自动化,按本讲的思路应该先解决什么?