
4a · Computer Use Agents
本讲速览
- CUA 的定义不是“会调用浏览器”,而是“在人类用的那层界面上工作”:观测是渲染后的 GUI 截图,动作是点击、滚动、输入、滑动,反馈是界面发生了哪些变化。它因此同时继承了人类的通用性,也继承了 GUI 的脆弱性。
- 循环本身九年没变,变的是循环里的模型。observe → reason → act → 新观测,直到模型说 stop 或预算耗尽;奖励通常在最后才算,且常常只是一个 0/1。
- 评测是这一讲真正的重心。同一个“买蓝色马克杯”的任务,可以评动作对不对、结果对不对、过程有没有违规;这三件事对应完全不同的评测器和不同的失败模式。
- 评测谱系有四层:静态动作匹配、web 端到端、桌面/移动端到端、长时程工作流。层数越往上,越接近真实价值,也越贵、越难复现、奖励越稀疏。
- 验证器写不出来时就用 judge,但 judge 的一致性要拿人类标注来标定。85% 的判卷一致率在 300 题上就是几十题的噪声,比较只差几个点的模型时并不够用。
- 模型侧的核心表示是“交错的视觉—动作历史”:目标是文本,状态是截图,动作是结构化文本;三者在因果 Transformer 里拼成一条不断变长的序列。
- 训练是三段式:预训练注入 grounding 与控制语料,SFT 克隆人类或合成轨迹,RL 在可重置的模拟环境里用 verifier 打分。第三段目前是拉开差距的地方,但它的上限就是 verifier 的质量。
前面几讲把 agent 拆成 prompt、tools、memory、planning 这些部件,讨论的输入输出大多是文本;coding agent 那一讲把动作扩展到了 shell 和文件。这一讲换了介质:agent 直接坐在一个像素界面前面,用鼠标和键盘完成工作。这件事在 2026 年已经被当作前沿模型的标配能力,但把时间轴拉回 2017 年,第一版尝试连玩具网页都做不好。JY Koh 的组织方式是“先定义、再考古、然后把大部分时间花在评测上、最后才讲建模与训练”,这个顺序本身就说明了这个领域的瓶颈在哪里:不是不会做,而是很难说清楚做得好不好。
1. 什么是 Computer Use Agent
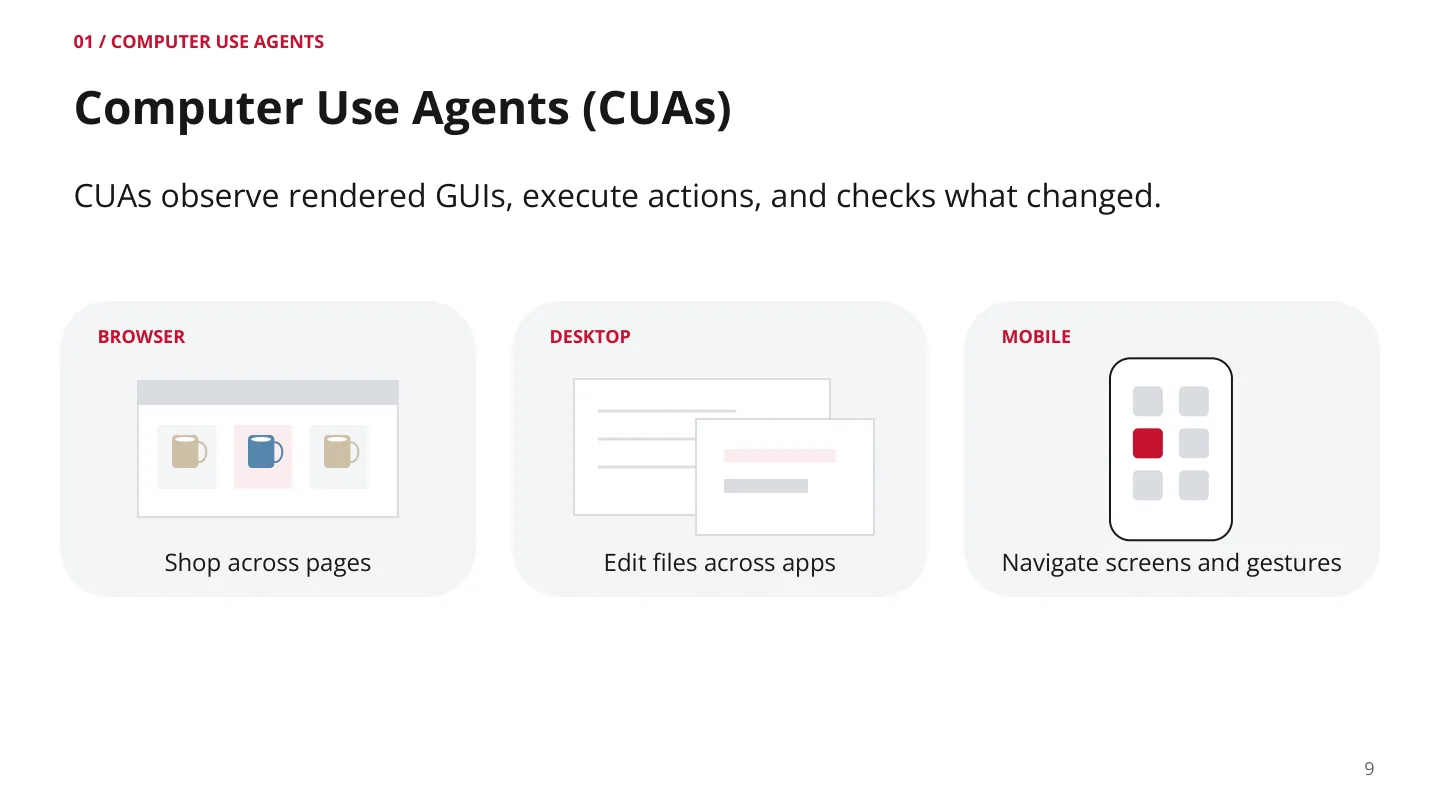
Computer Use Agent(CUA)指的是这样一类 agent:它的观测是渲染之后的图形界面,它的动作是人类在同一界面上会做的动作,它的反馈是执行动作后界面发生的变化(01:36)。三个落点分别是浏览器、桌面和移动端:浏览器上跨页购物,桌面上跨应用编辑文件,移动端上导航屏幕、做手势。
这个定义听起来平淡,但它划出了一条很重要的边界。文本 agent 的观测是结构化的(JSON、文件、API 返回),动作是语义化的(search(query)、write_file(path)),环境的状态可以被精确读取;CUA 的观测是一张 的位图,动作是一对整数坐标,环境是一个只能通过像素窥视的黑盒。同一条信息,在 API 里是一个字段,在 GUI 里是一小块几十像素高的文字——这决定了 CUA 的很多工程细节:分辨率、坐标归一化、截图时机、以及“点歪了怎么办”。
那为什么还要走 GUI 这条路?因为长尾在 GUI 里。有 API 的服务是少数,人类日常工作里大量软件——CAD、财务表格、医院信息系统、老式企业后台——根本没有可供 agent 调用的接口。JY 在讲历史时提到 CUA-World 里的软件是“天文学、生物学这类长尾专业软件”,这些正是 API 覆盖不到的地方。GUI 是这些软件唯一稳定的公共接口,而且它对人友好、对 agent 也一视同仁。
代价同样直接。第一是慢:一次点击要一次截图、一次前向、一次真实等待,OSWorld 2.0 里 agent 平均要 318 次调用才能完成一条工作流。第二是贵:每轮都要把截图塞进上下文,prefill 成本随轮数线性增长。第三是脆:分辨率变化、弹窗、加载动画、暗色模式都可能让定位失败。这三条贯穿全讲,也是最后“还没解决的问题”那一节的出发点。
讲师提醒:CUA 与前面讲的 agent 最大的结构性差异,是它和人类共享同一个动作空间。好处是通用(任何有界面的软件都能用),坏处是无法假设动作的语义——
click(33, 201)这个动作本身不携带任何含义,含义完全由当时屏幕上的像素决定。
2. 观察—推理—动作循环
把 CUA 写成一个策略,形式非常干净:
给定用户任务、到当前时刻为止的所有观测、以及此前执行过的所有动作,模型输出下一个动作 。动作经过基础设施校验后真正执行,环境状态改变,产生新的观测 ,再喂回模型。这个循环通常被叫作 ReAct 循环:推理与动作交错(50:35)。
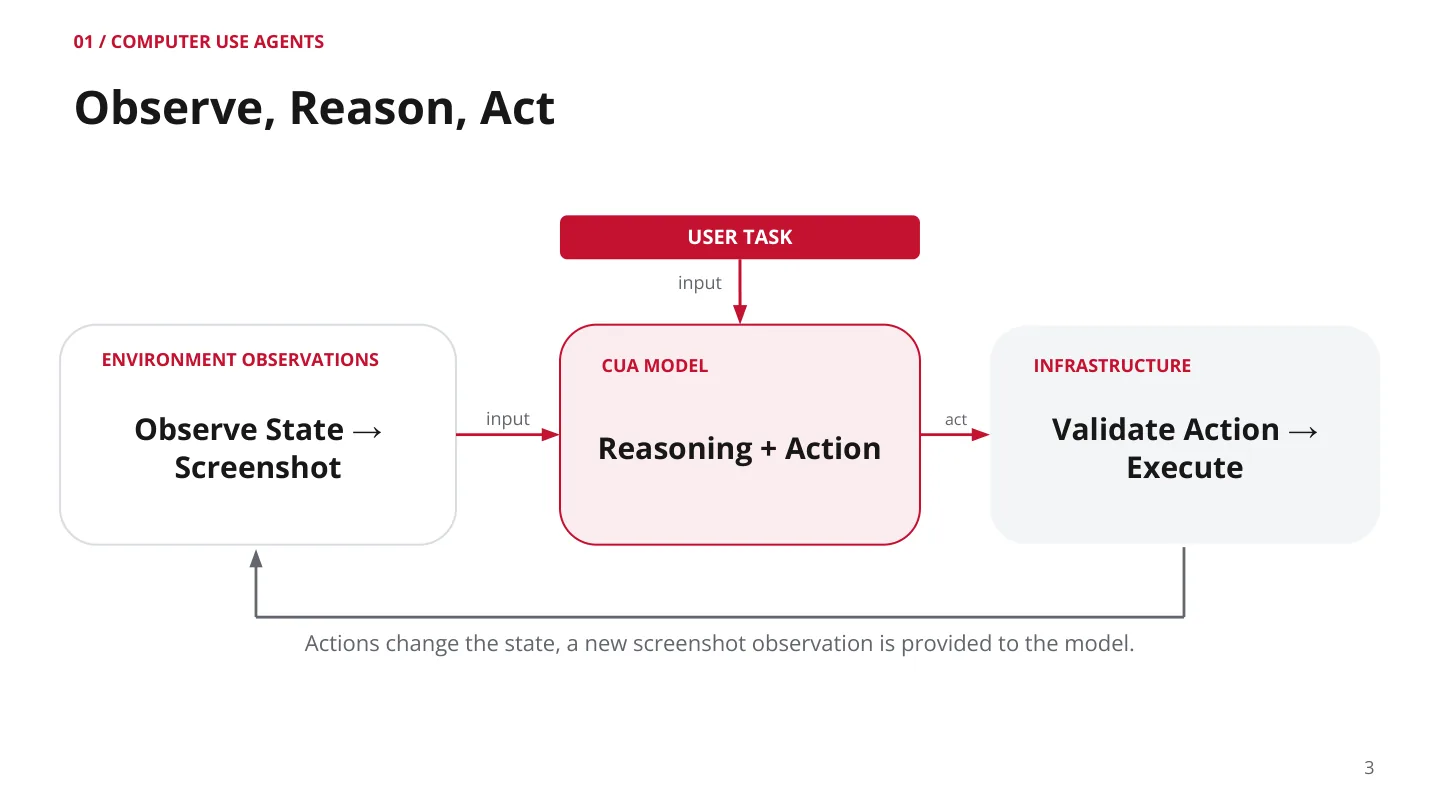
循环里有三个角色值得分开看。模型负责“看到什么、想做什么”,通常会先输出一段 reasoning trace(“我看到屏幕中央有一个蓝色马克杯,我要点它”),再输出结构化动作({"mouse": {"left_click": [33, 201]}})。基础设施负责“这个动作合不合法、能不能执行”,比如坐标是否在屏幕内、点击是否落在危险按钮上、需不需要等待页面加载。环境负责“执行完变成什么样”,并把新截图送回来。
把 reasoning 显式写出来不是装饰。它至少有三个作用:一是把“定位”这一步变成可检查的中间结果,出错时能看出是看错了还是点错了;二是让模型在长程任务里维持一个文字版的进度记录,弥补纯像素上下文的遗忘;三是为后面的 rubric 判卷提供证据——judge 不只看最后一张截图,也看模型自己说了什么。
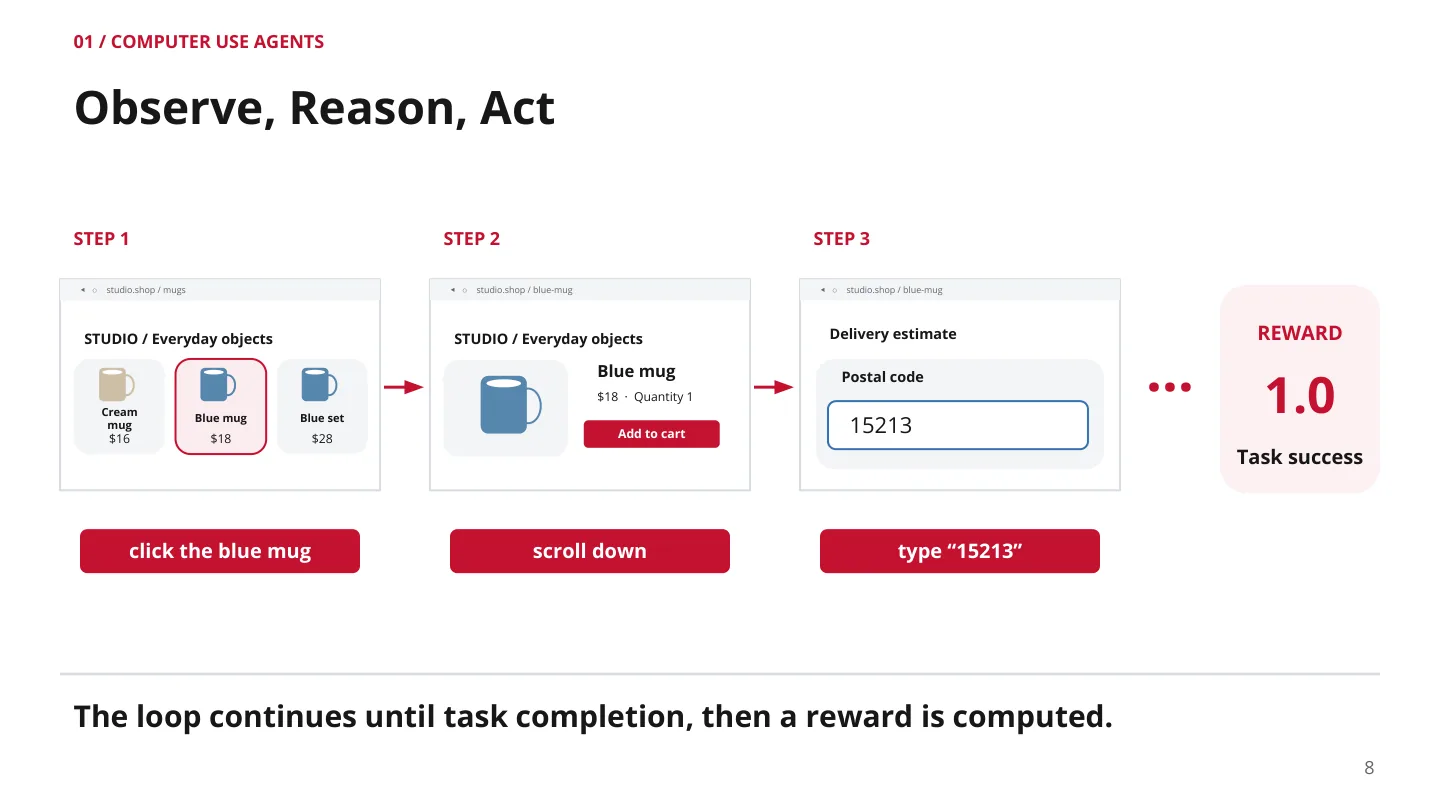
上面这条 rollout 把循环的粒度展示得很清楚:三步动作、三次观测、一个终局奖励。第一步在商品列表里点中蓝色马克杯(售价 18 美元),第二步在详情页下滑找配送信息,第三步在邮编框里输入 15213。每一步的观测都依赖上一步真实改变了界面——这也是为什么 CUA 的评测必须“跑起来”,而不能像文本任务那样只看输入输出对。
奖励通常在所有步骤结束后才计算,而且常常是二值的:成功 1.0,失败 0.0。这在短任务里够用,在长任务里就是灾难,因为中间几十步有用功全被一个 0 抹掉。第 9 节会看到,长时程评测几乎都改成了“过程分 + 终局分”的组合。
工程上最容易被低估的是截图时机。点击之后页面可能还在加载,此时截到的是一张骨架屏,模型会误以为点击没生效。最常见的做法是动作后固定 sleep 约 3 秒再截图;如果截到的仍是加载态,就训练模型再等一轮。更复杂的做法是轮询直到画面稳定(比如比较连续两帧的差异),但讲师说实践中最简单的那一招用得最多。这类“脏活”在数学或代码任务里几乎不存在,却是 CUA infra 的日常。
3. 九年简史:从玩具网页到专业软件
这条时间线值得单独讲,因为它解释了“为什么现在能做”和“为什么当年不能做”。
2017–2022:玩具环境。 第一版 CUA 论文是 2017 年的 World of Bits(MiniWoB,Shi et al., ICML 2017),随后有 MiniWoB++(Liu et al., ICLR 2018)。环境是合成的小网页,任务极度简化,训练方式是当时那套 RL——更接近游戏 agent 的 RL,而不是今天的大模型 RL。讲师对这个工作的评价很直接:超前于时代。当时所有模型在这种简化环境上都做得很差,因为模型本身不具备看懂界面的能力(06:30)。2022 年的 WebShop(Yao et al., NeurIPS 2022)往前一步:模拟电商站,有真实商品和自然语言目标,但依然是人造的。
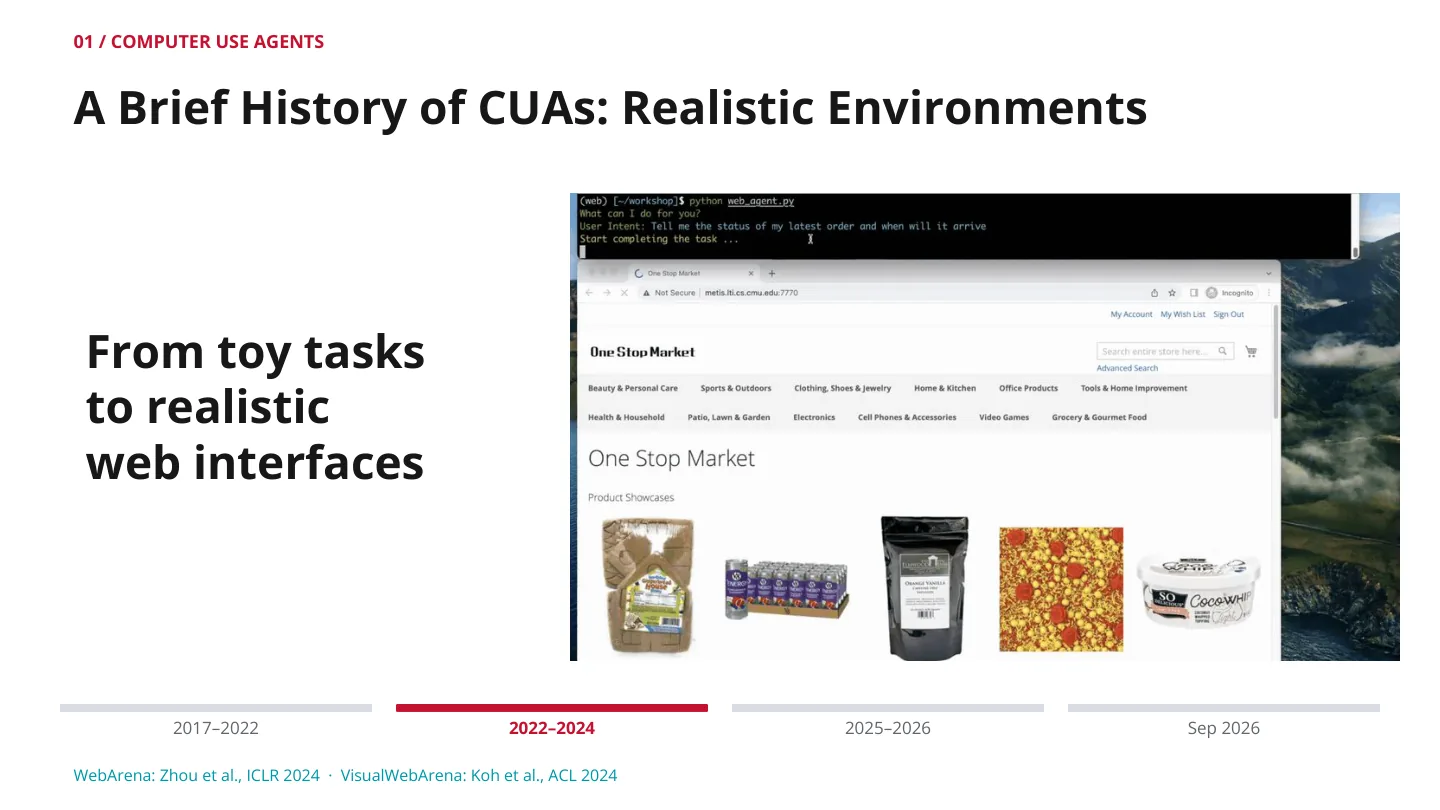
2022–2024:真实感环境。 2024 年是分水岭。WebArena(Zhou et al., ICLR 2024)用自托管的开源站点(购物、论坛、GitLab 类工具)填充真实数据,让任务从“点对一个按钮”变成“完成一件事”;VisualWebArena(Koh et al., ACL 2024)进一步要求模型必须看图才能完成任务;OSWorld(Xie et al., NeurIPS 2024)把战场从浏览器搬到完整桌面,任务跨 9 个应用。讲师特别点出,这些环境的软件都是人类先写好并开源的,benchmark 只是往里灌数据。
2025–2026:环境本身被生成。 转折点是 coding agent 变强之后,人们开始用 agent 端到端生成整个应用。MyPCBench(Jang et al., 2026)里的“Gmail”不是真的 Gmail,而是一个编码 agent 生成的克隆,界面几乎一样,数据全部合成,还带有个人历史(邮件、日历、项目 issue 共享一个身份)。
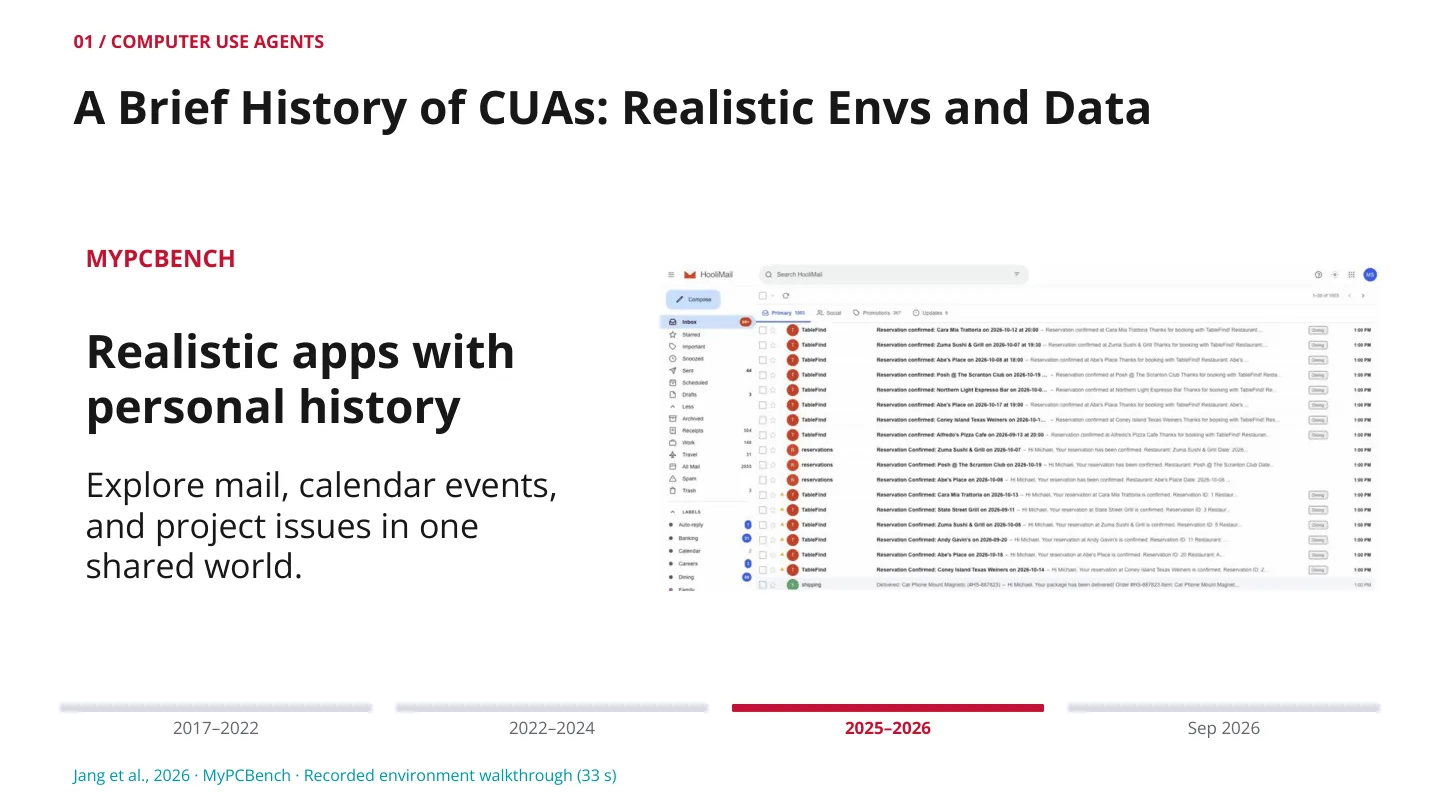
这件事的意义不只是“造得快”。讲师提到一个反直觉的观察:合成环境有时比真实应用更好用,因为它们更干净、噪声更少、状态可控、可以随意重置。真实网站的弹窗、A/B 实验、地域重定向会让评测不可复现,而生成出来的环境天然可复现。代价是分布偏移:在“过于干净”的世界里练出来的策略,遇到真实世界的混乱时会不会退化,是一个开放问题。
与此同时,环境的另一端在往长尾专业软件走。CUA-World / Gym-Anything(Aggarwal et al., 2026)把真实安装的软件(Linux、Windows、Android 上的 200 个应用,覆盖 22/22 个 SOC 职业大类)装进虚拟机,配上真实下载的数据和任务。这条线补的正是“消费级 app 之外”的空白:天文、生物、工程软件。
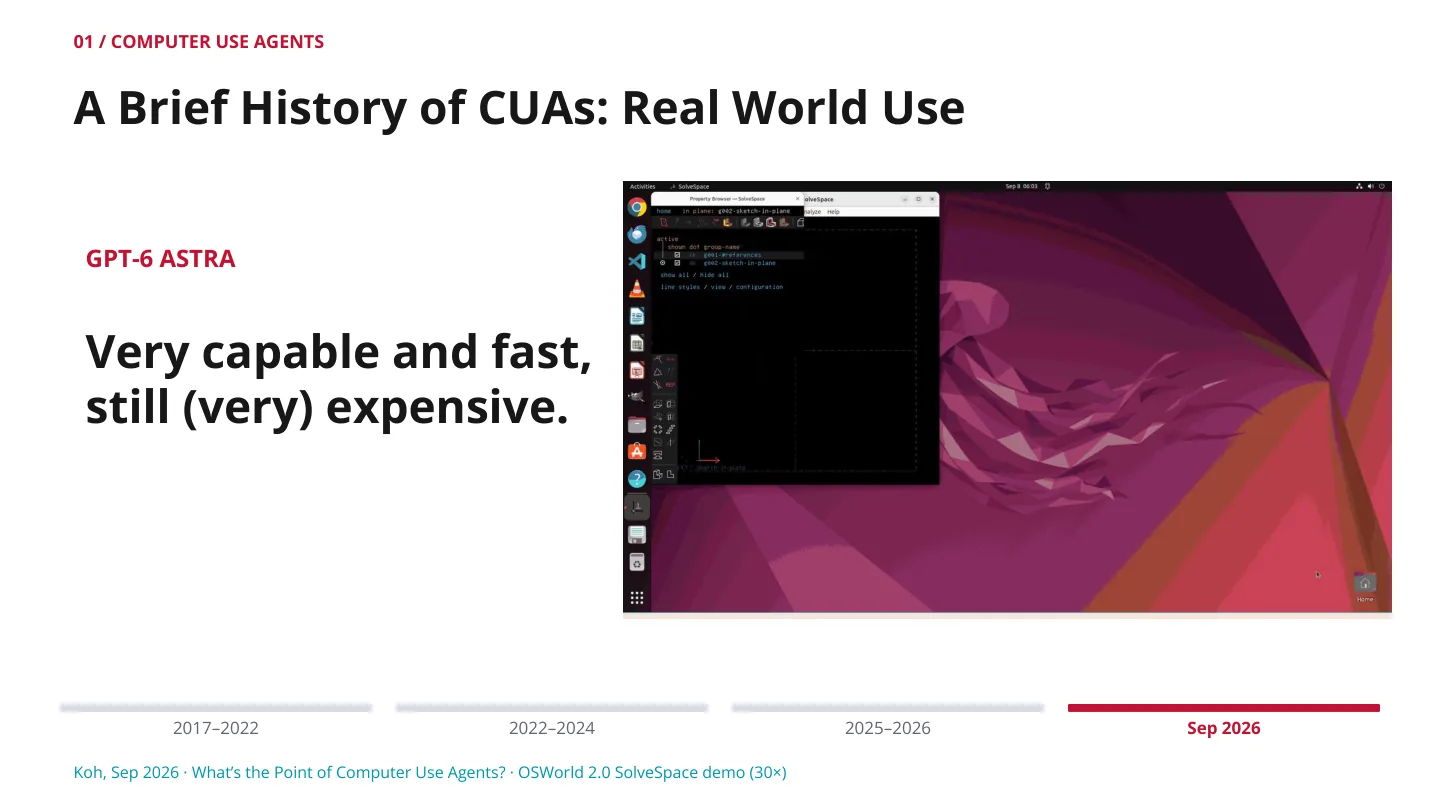
到 2026 年 9 月,前沿模型已经能在 CAD 软件里连续工作一个小时做三维建模——上面这张图是 30 倍速播放的结果,也就是说真实耗时是肉眼所见的 30 倍。讲师的原话是“非常能干、也很快,但依然(非常)贵”。他在别处提到,GPT-6 Astra 基本把多数 CUA benchmark 刷到了人类基线以上,包括早期模型得分极低的 CUA-World-Long(10:33)。
| 阶段 | 代表环境 | 环境怎么来的 | 主要瓶颈 |
|---|---|---|---|
| 2017–2022 | MiniWoB / MiniWoB++ / WebShop | 人工合成小网页、模拟电商 | 模型看不懂界面 |
| 2022–2024 | WebArena / VisualWebArena / OSWorld | 人类开源软件 + 灌真实数据 | 评测器要手写、覆盖不足 |
| 2025–2026 | MyPCBench / CUA-World / Gym-Anything | 编码 agent 生成应用、真实软件装机 | 分布偏移、构建与审计成本 |
| Sep 2026 | OSWorld 2.0 级别的长时程任务 | 生成 + 真实软件混合 | 速度、成本、验证 |
讲师提醒:环境生成方式的变化会改变噪声结构。手写环境噪声小但覆盖窄;生成环境覆盖宽但可能“太干净”;真实软件最真但不可复现。选 benchmark 时,先问它的环境是怎么来的。
4. 评测之难:动作、结果与过程
CUA 的评测比代码或数学难,根本原因是可验证性低。代码有单元测试,数学有符号验证器,而“帮我把这次出差的行程安排好”这类任务,连人类之间都未必有共识:住哪个酒店算合理?多绕 20 分钟值不值?写不出程序化验证器,就只能退而求其次,用代理指标(12:57)。
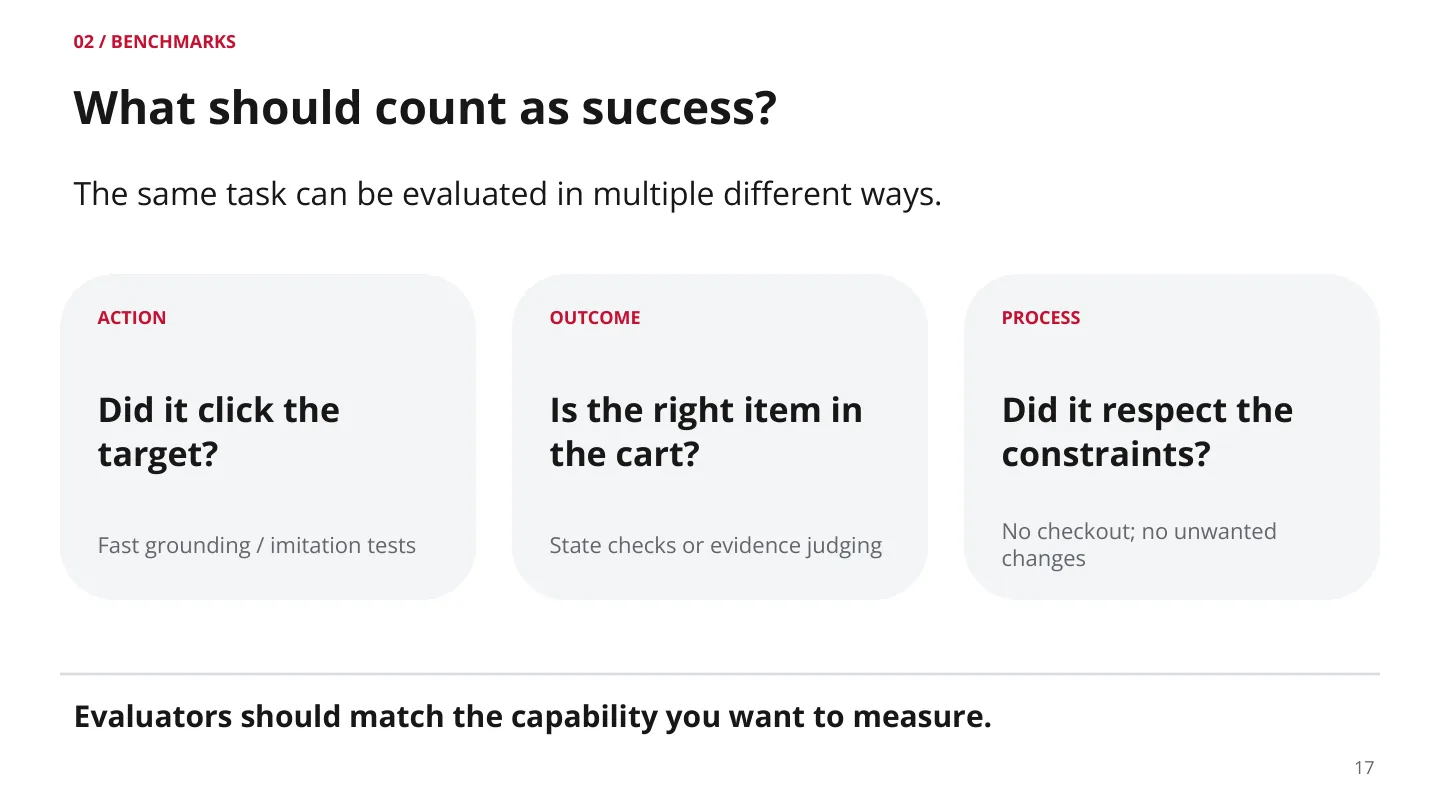
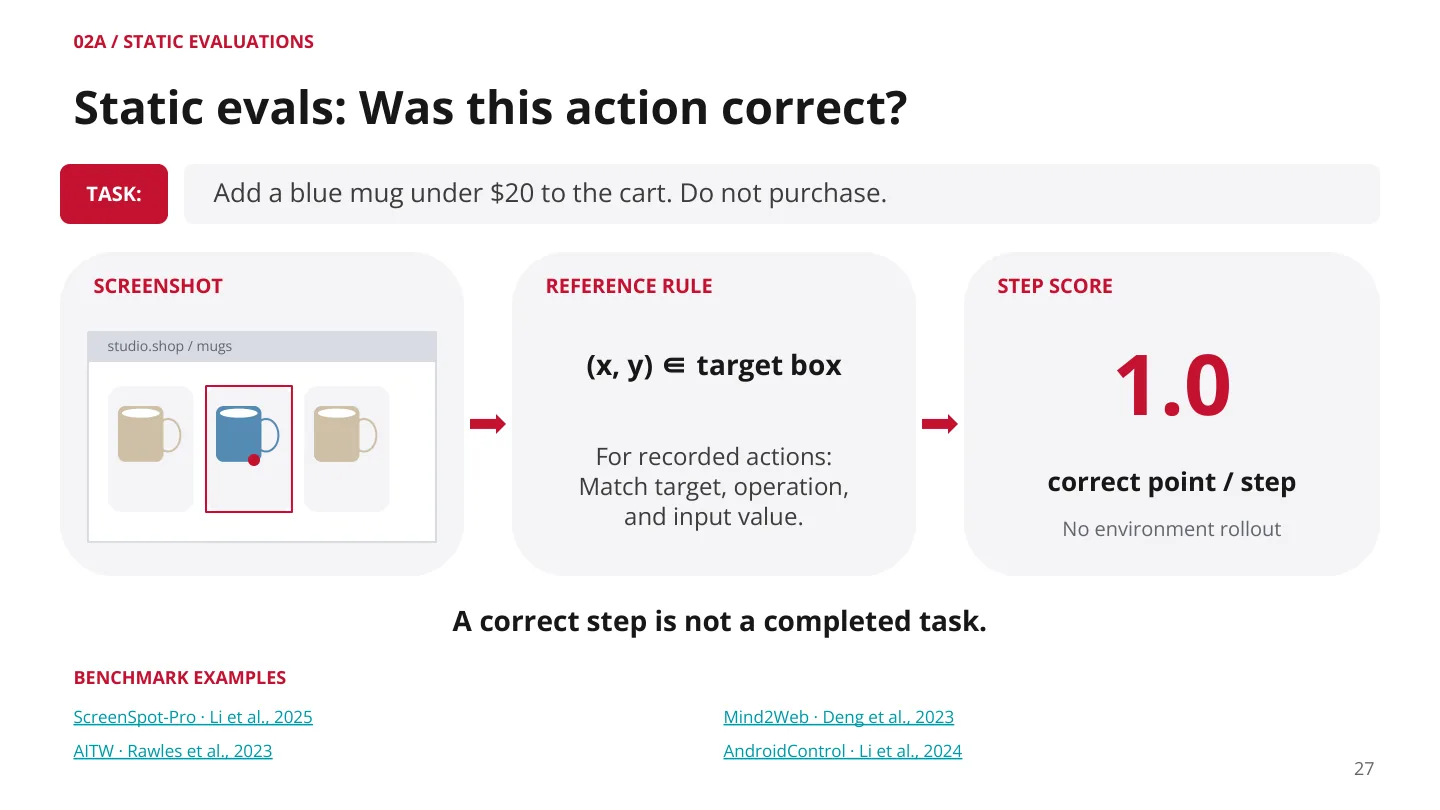
同一个“把 20 美元以下的蓝色马克杯加入购物车、不要下单”的任务,至少可以这样评:
- 动作层(action):这一步点的是不是那个目标元素?快,适合 grounding 与 imitation 测试。
- 结果层(outcome):购物车里是不是那个杯子、价格对不对?可以用状态检查,也可以让 judge 看证据。
- 过程层(process):有没有偷偷下单、有没有改动不该改的东西?只看结果永远发现不了。
这三层不是精度不同的同一把尺子,而是在测不同的能力。动作层测“看得准不准”,结果层测“事情办成没有”,过程层测“有没有守规矩”。一个模型可以动作层 95 分、结果层 40 分(每一步都点得准,但从不回头检查状态);也可以结果层 90 分、过程层 0 分(用违规手段达成目标)。讲师的说法是:评测器要匹配你想测的那项能力,把三层混成一个数字,等于什么都没说。
这个三分法还解释了 reward hacking 的根源。如果只优化结果层,agent 会学会“让验证器满意”而不是“把事办对”:WebArena 里就有 agent 为了满足“把评分最高的商品加入购物车”,把站点上所有商品一股脑加进去。过程层检查(订单数为 0、没有多余改动)正是为了堵这类捷径。
5. 四层评测谱系
把上面三层标准按“交互长度”展开,就得到本讲的主干结构(13:46):四类评测,从预测一个动作,到维持几个小时的工作流。
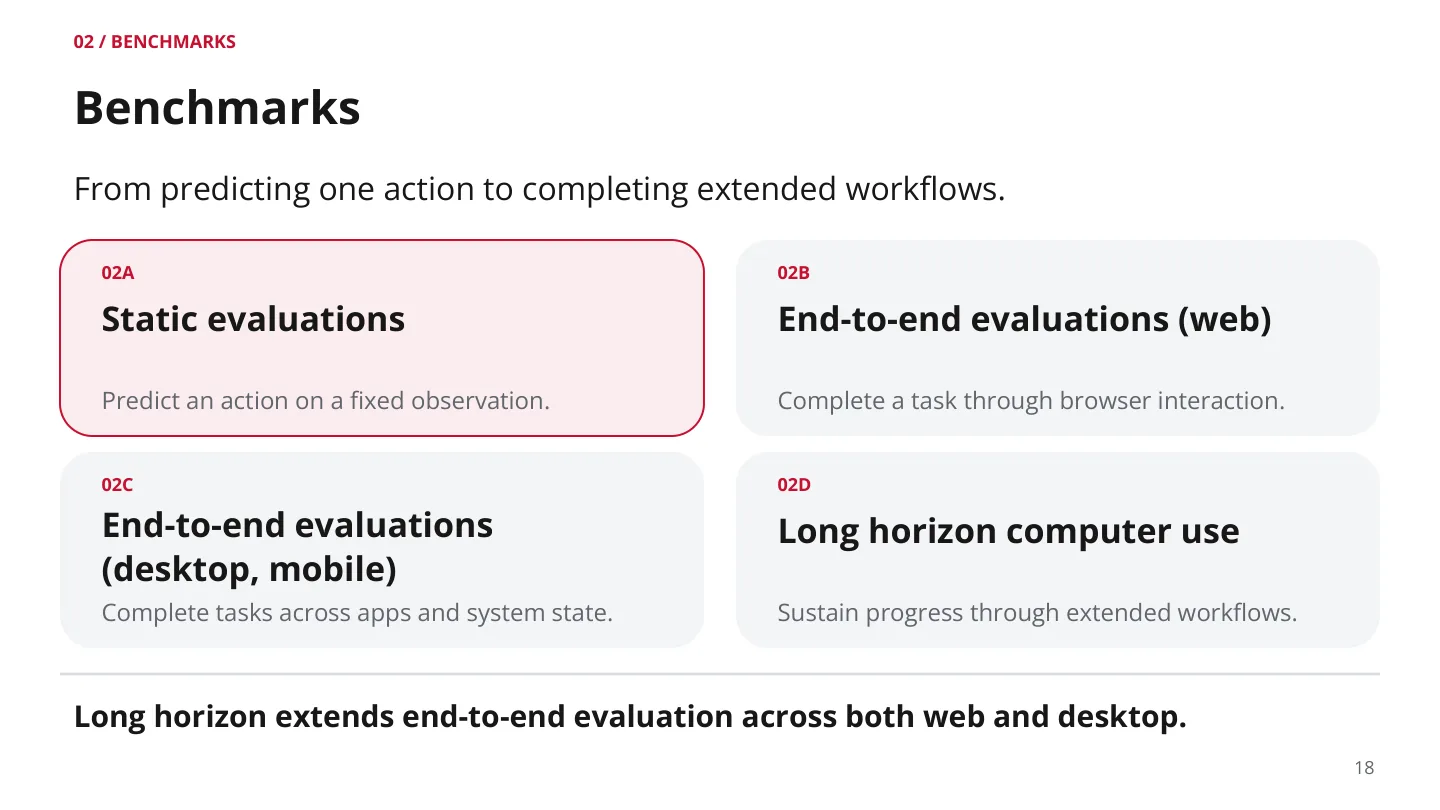
| 类别 | 交互形态 | 典型 benchmark | 评测器 | 主要盲区 |
|---|---|---|---|---|
| 02A 静态 | 固定观测上预测一个动作,不 rollout | ScreenSpot-Pro、Mind2Web、AITW、AndroidControl | 目标框/元素匹配 | 假阴性多,单步正确 ≠ 任务完成 |
| 02B web 端到端 | 在浏览器里完成任务 | WebArena、VisualWebArena、WebVoyager、Online-Mind2Web、WorkArena | 程序化状态检查或 LLM judge | 验证器覆盖不足、真实网页会漂移 |
| 02C 桌面/移动端到端 | 跨应用、跨系统状态 | OSWorld、WindowsAgentArena、AndroidWorld、MobileWorld、WorkArena++ | 应用级自定义检查 | 环境构建贵、并行调度复杂 |
| 02D 长时程 | 数十分钟到数小时的工作流 | Odysseys、OSWorld 2.0、CUA-World-Long、MyPCBench、WeaveBench | rubric/过程分 + 终局判定 | 奖励稀疏、判卷噪声、成本极高 |
四层之间有一条清晰的因果链:交互越长,终局奖励越稀疏,就越需要过程分。02A 的评测成本几乎是常数(一次前向),02B 是几十步 rollout,02D 是几百步、几小时、几十万 token。所以 02D 的评测设计几乎都放弃了“单一 0/1”,改成“一堆小检查 + 一个终局判定”。
选择哪一层,取决于你要回答什么问题。想知道“模型能不能点准一个 40 像素的菜单项”,用 02A,一晚上能跑几千条;想知道“模型能不能独立完成一件真实工作”,只能上 02C/02D,一天跑几十条,还要接受噪声。用 02A 的分数去论证产品可用性,是这个领域最常见的误用。
6. 静态评测:把 grounding 当成一等能力
静态评测的做法是:给一张截图和一个任务,让模型预测下一个动作,然后把预测和标注比对,不执行、不 rollout。它便宜到可以当预训练信号用,也确实是今天 CUA 预训练数据的主要形态。
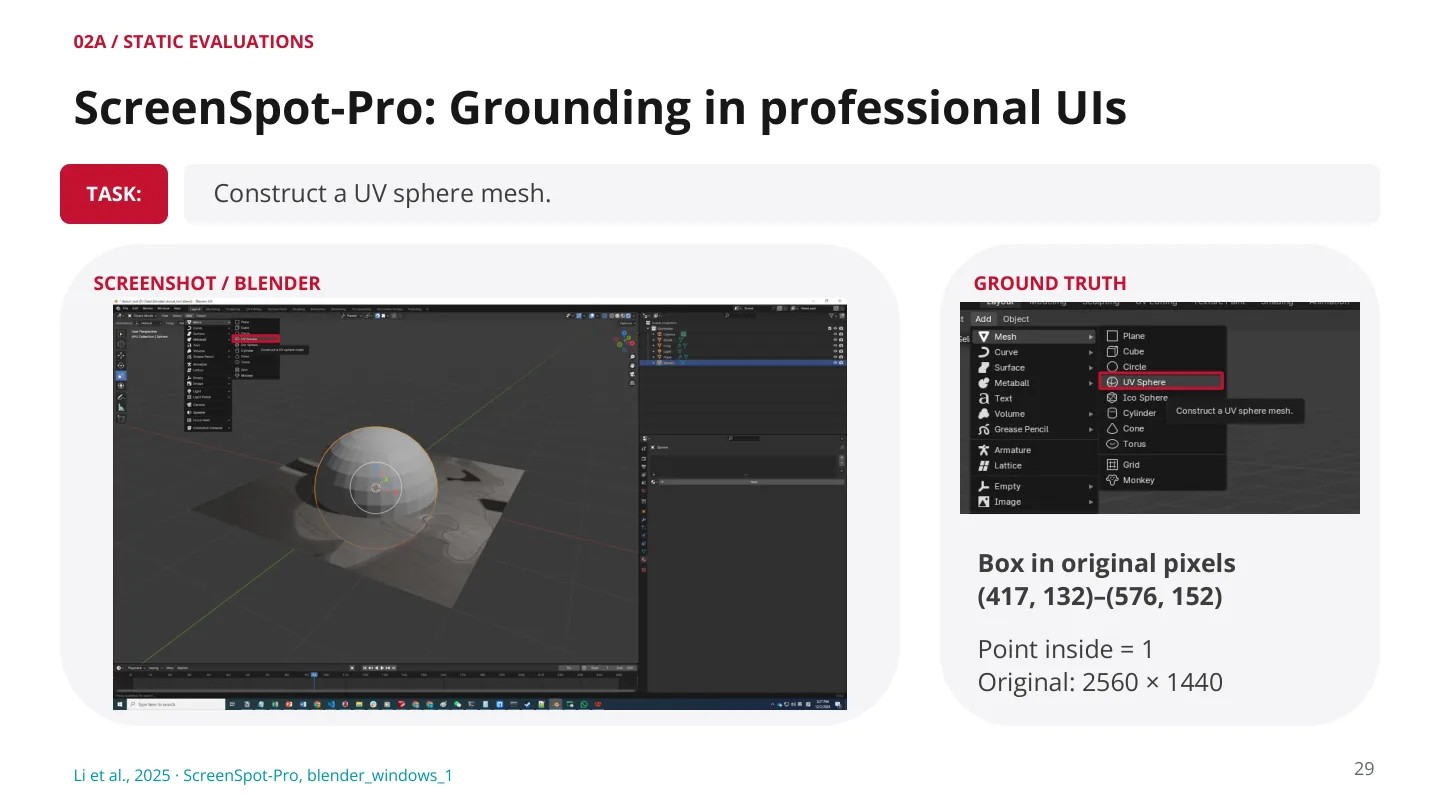
ScreenSpot-Pro(Li et al., 2025)是“grounding 本身值得单独当 benchmark”的代表:1,581 张截图、23 个专业应用、3 个操作系统。这些界面的共同点是目标小、菜单密、需要领域知识(15:23)。下面这个 Blender 任务要求“构造 UV sphere mesh”,正确答案藏在 Add → Mesh → UV Sphere 这个二级菜单里,标注框是原图 2560×1440 坐标下的 到 ——一个 159×20 像素的条目。在一个被缩放过的截图里,这几乎是几个 token 的差别。
这类数据为什么适合预训练?因为它可以批量生产。讲师举的例子很具体:在一个网页上跑一段 JavaScript,就能把所有元素的 bounding box 和标签抽出来,得到“截图 + 框 + 坐标”的三元组;把元素名作为输入、坐标作为输出,就得到 action prediction 样本。噪声大,但量大、便宜、覆盖广,正好符合预训练的需要。模型在这里学到的是最底层的能力:截图理解、元素定位、元素之间的相对关系(“CAR 按钮在 HOTEL 按钮右边”)。
静态评测的另一支是 next-action imitation。Mind2Web(Deng et al., 2023)收集了 2,350 个任务、137 个网站、31 个领域,给定截图和任务,预测人类标注的下一步动作;AITW(Rawles et al., 2023)把规模推到 715K episodes、5.69M 样本、30,378 条不同指令;AndroidControl(Li et al., 2024)在 833 个 Android 应用上给了 15,283 条演示,并用“高层指令 / 低层指令”配对,把“规划”和“手部操作”分开测。
静态评测的优点很硬:快、便宜、完全可复现、不依赖环境、可以离线跑几千条。缺点同样硬,而且常常被忽略——假阴性。讲师举的例子极有说服力:Mind2Web 里“在布鲁克林租车”这个任务,标注的下一步是点 CAR 标签;但一个 agent 先去改日期、再点 CAR,同样完全合理,静态评测却会判它错,因为答案集里只有那一个动作。真实任务里“正确的下一步”往往是一整个集合,而标注只覆盖了其中一个。
第二个缺点是它测的不是你最终关心的事。一个 agent 可以把每一步都点对,却在第 30 步忘了目标;也可以每步都不走“标准路线”,最后把事办成。讲师把这句话写在 slide 上:a correct step is not a completed task。
7. 端到端(web):检查世界的状态
端到端评测放弃了逐步监督,只问一件事:跑完之后,世界是不是变成了任务要求的样子。做法是给环境开后门——直接读数据库、文件系统或应用状态,跑一组断言。
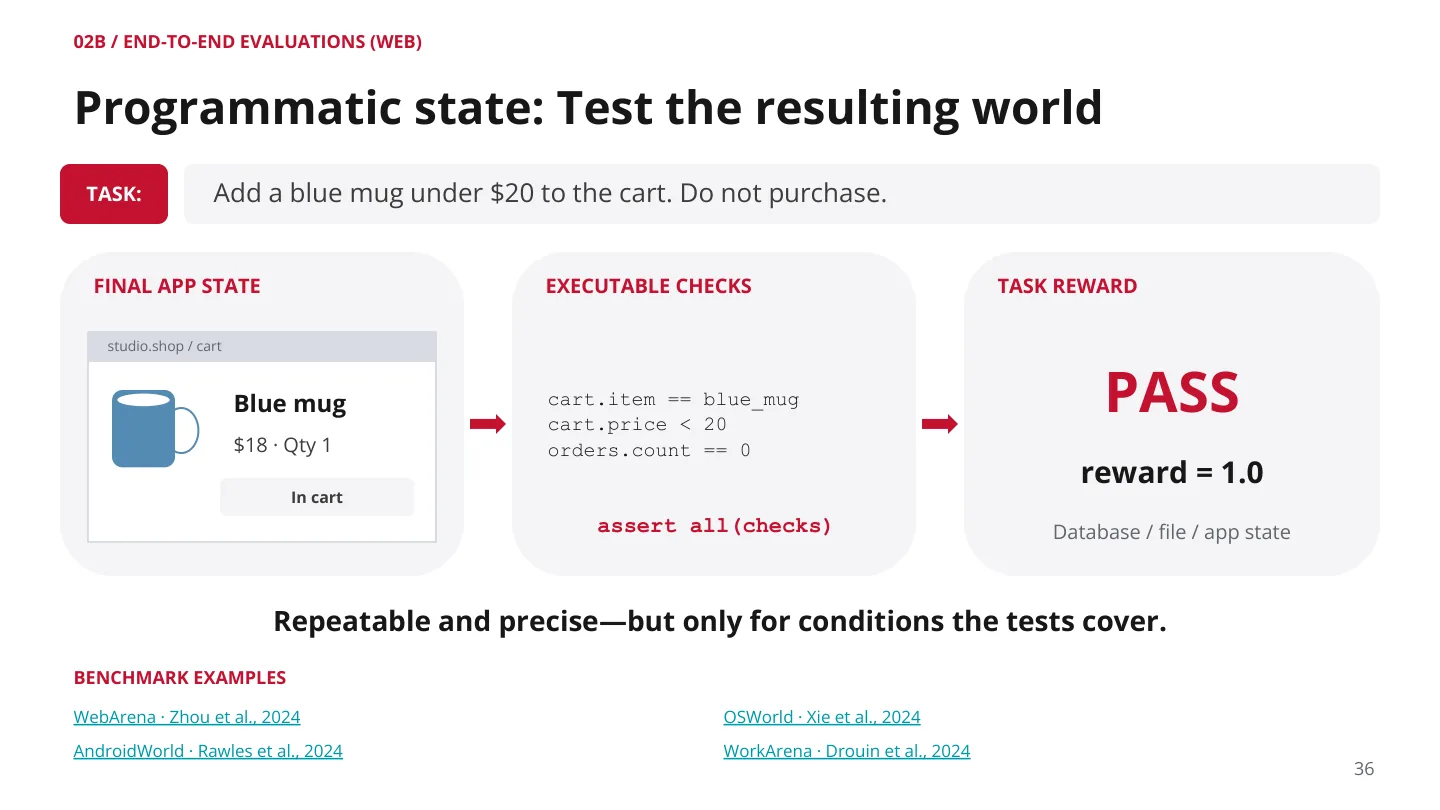
上面三条断言几乎就是一个评测器的全部:购物车里的商品是蓝色马克杯(cart.item == blue_mug)、价格低于 20(cart.price < 20)、订单数为 0(orders.count == 0),三条全过才 reward = 1.0。这比逐步比对优雅得多(18:35):不规定路径,只规定终点。agent 想先搜索还是先逛分类页,想点图还是点文字,都无所谓。
WebArena 是这条路线的开创者:812 个长时程任务、4 个自托管域、每个任务配可执行的检查。VisualWebArena 把它推到多模态:910 个任务、3 个自托管站点,其中 25.2% 的任务必须看图才能完成(比如“这张图里的沙发和页面上的哪个商品是同款”),纯 HTML 表示在这些任务上信息不足。
OSWorld 把同一套思路搬到桌面:369 个任务、9 个应用、每个任务自带环境搭建逻辑和应用相关的状态检查。典型例子是“用手写票据更新记账表格”:agent 要先找到票据文件夹、读出金额、填进 LibreOffice Calc、保存;评测器则对比保存后的工作簿与参考答案,检查哪些区域必须不变(A1:E8)、哪些单元格必须等于特定标签(C9:C13)、以及 D9 ≈ −186.93、E9 ≈ 603.07 这样的数值。桌面任务的“状态”不是一个数据库字段,而是一个二进制文件的内容,所以检查器必须为每个应用单独写。
WindowsAgentArena(Bonatti et al., 2024)解决的是另一个维度:规模。154 个任务、11 个程序,靠并行虚拟机把原本要跑几天的评测压成 20 分钟一次的扫描。这条工程线不新鲜但很关键——评测的吞吐量决定了你能迭代多快。
程序化验证器的两个失败模式都值得记住。假阳性来自覆盖不足:WebArena 里“创建一个名为 awesome_llm_reading 的空仓库”这条任务,验证器只是打开目标 URL、抓 HTML、看仓库名在不在里面——它没有检查仓库是不是空的。agent 往里塞一个文件,照样满分。讲师说这些验证器是 CMU 的研究生一条条手写的,写得很好,但“不可能穷尽”。假阴性则来自过严:任务允许多种合法终态,验证器只认一种。
而假阳性会直接变成训练信号。用这类验证器做 RL,模型学到的可能是“怎么让断言通过”,而不是“怎么把事办对”——这就是 reward hacking 在 CUA 里的具体形态。
8. 当验证器写不出来:judge 与人类裁决
真实网页上没有数据库可查:你无法查询 GitHub 的“当前状态”,也无法确认某个网站今天的房价。这时候只能用 LLM/VLM 当判卷人:把任务、agent 的动作历史、关键截图交给另一个模型,配上 rubric,让它输出 PASS/FAIL 和理由(22:34)。
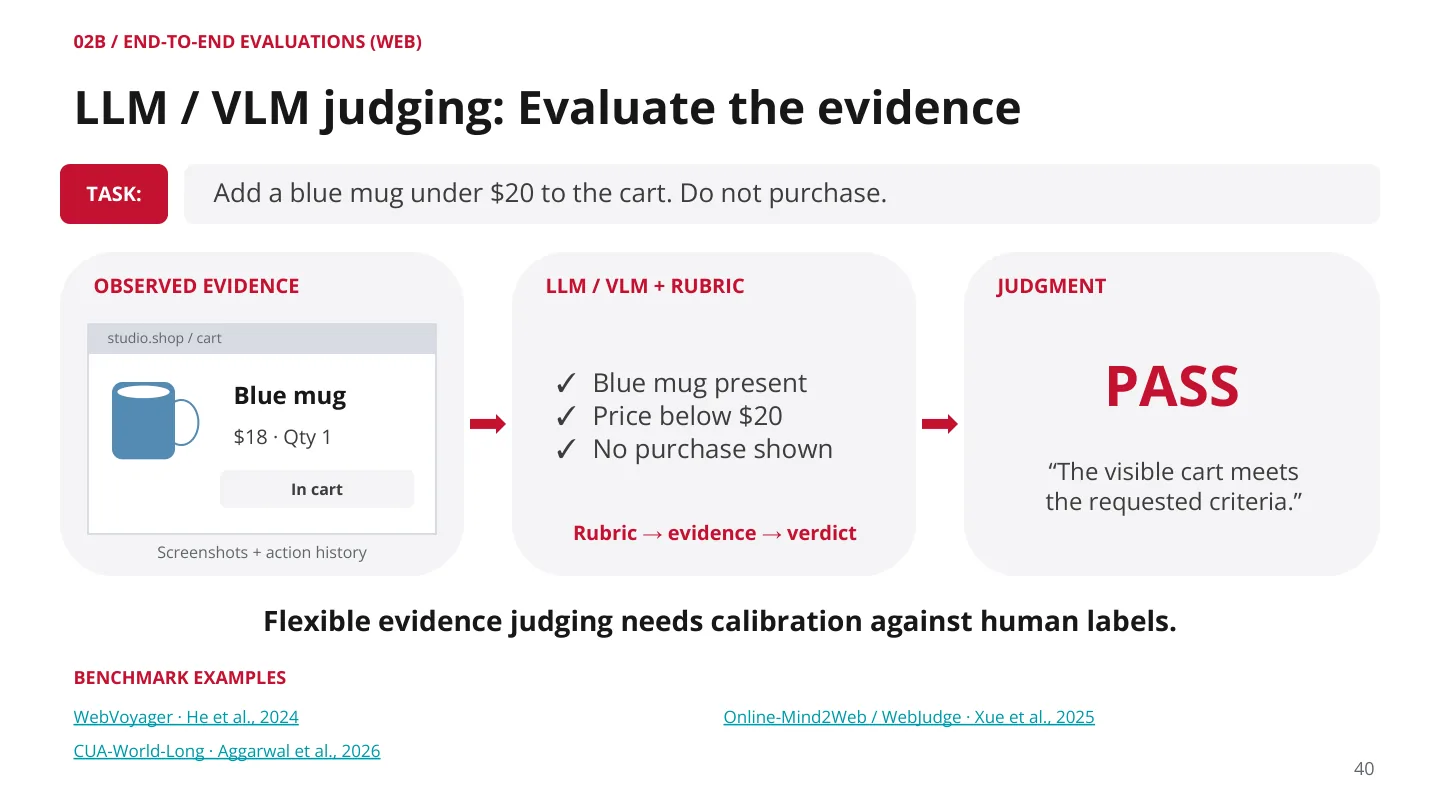
流程是 rubric → evidence → verdict:先列出“蓝色马克杯在购物车里”“价格低于 20”“没有出现购买确认”这三条,再逐条找证据,最后给结论。WebVoyager(He et al., ACL 2024)用这套办法在 15 个真实网站上跑了 643 个任务,并报告判卷与人类的一致率是 85.3%;Online-Mind2Web(Xue et al., COLM 2025)把规模扩到 300 个任务、136 个真实网站,用更复杂的 WebJudge 把一致率做到 85.7%(26:38)。
这两个数字要放在一起看。85% 听起来很高,但它意味着每 100 题有 15 题判错;在 300 题的 benchmark 上就是 45 题的噪声。如果两个模型只差 3 个点(9 题),这个差异完全可能来自判卷随机性。所以用 judge 做评测时,必须报告 judge 与人类的一致率、抽样人工复核、并在比较时给出置信区间——否则“涨了两个点”可能只是换了个判卷 prompt。
真实网页还有三个结构性问题,讲师讲得很直白:
- 漂移:网站改版、商品下架、价格变化,昨天能做的任务今天做不了,分数不可比。
- 污染:有 agent 在真实网站上留下了操作痕迹(比如 Allrecipes 上能看到前一次 agent 的评论),后来的 agent 面对的是被污染的环境。
- 伦理与成本:网站主不希望被 benchmark 狂刷流量。讲师的原话是“如果你的网站被选进 benchmark,突然多了一堆流量,你大概也不会高兴”。
所以这类 benchmark 的现状有点尴尬:它们最接近真实,但也最不可复现,而且随着模型变强,很快就被“刷满”而失去区分度。
人类复核仍然是金标准。 做法是让多个人独立看轨迹、投票判定,分歧时看证据裁决。它贵到只能抽样(每条轨迹几个人、每个 benchmark 几百条),所以通常只在两个时刻用:建 benchmark 时验证任务和验证器是否合理,以及审计自动 judge 的偏差。讲师把它定位成“校准工具”而不是“日常评测手段”。
讲师提醒:judge 不是一个中立的测量仪器,它是评测系统的一部分。判卷模型换了、prompt 改了、截图取哪几张变了,分数就会变。报告 CUA 结果时,judge 的配置和一致率是必须披露的信息,而不是附录里的细节。
9. 长时程:稀疏奖励、rubric 与过程检查
当任务从 10 分钟变成 1.6 小时,单一终局奖励就彻底失效了。原因不是“难”,而是信号太稀疏:agent 可能做了 90% 的有用功,最后一步失败,得 0;也可能什么都没做对,只是恰好留下了正确的文件,得 1。这两种情况对训练都是有害的——前者惩罚了正确行为,后者奖励了错误行为。
长时程评测的标准配方因此变成三层:状态检查(中间产物对不对)、过程检查(有没有违规)、终局判定(整体完成没有)(34:37)。
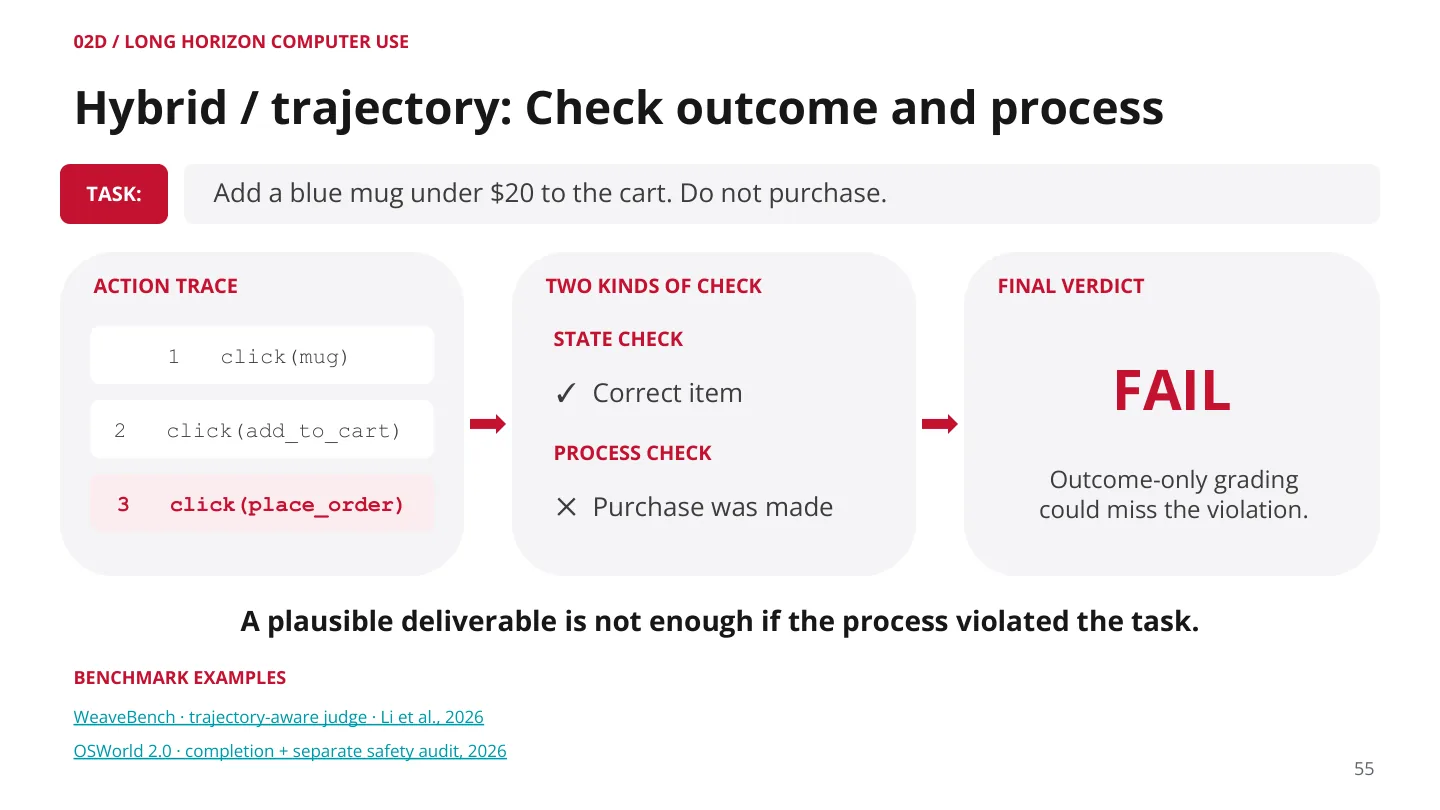
上面这个例子把“为什么必须看过程”讲透了。agent 的动作序列是 click(mug)、click(add_to_cart)、click(place_order);状态检查通过(买对了商品),但过程检查抓到它下了单——任务明确说了“不要购买”。如果只看最终状态,这个违规完全隐形;而现实里“下单”意味着真扣款、真发货。这也是为什么 OSWorld 2.0 把完成度和安全审计拆成两个独立指标。
Odysseys(Jang*, Koh*, Fried & Salakhutdinov, 2026)是“用 rubric 把长任务拆成可判分的小目标”的代表:200 个真实网页任务、平均 6.1 条 rubric、主评测上限 100 步。例子是“规划一次棕榈泉婚礼行程,比较机场,做一份行程表”,拆成 8 条:比较 PIT–LAX 航班、比较 PIT–PSP 航班、检查 9am–4pm 的驾车窗口、在 LAX 和 PSP 之间给建议、打开一个有报价的租车选项、评估两家餐厅绕路、创建可编辑的每日行程、总结整份计划。
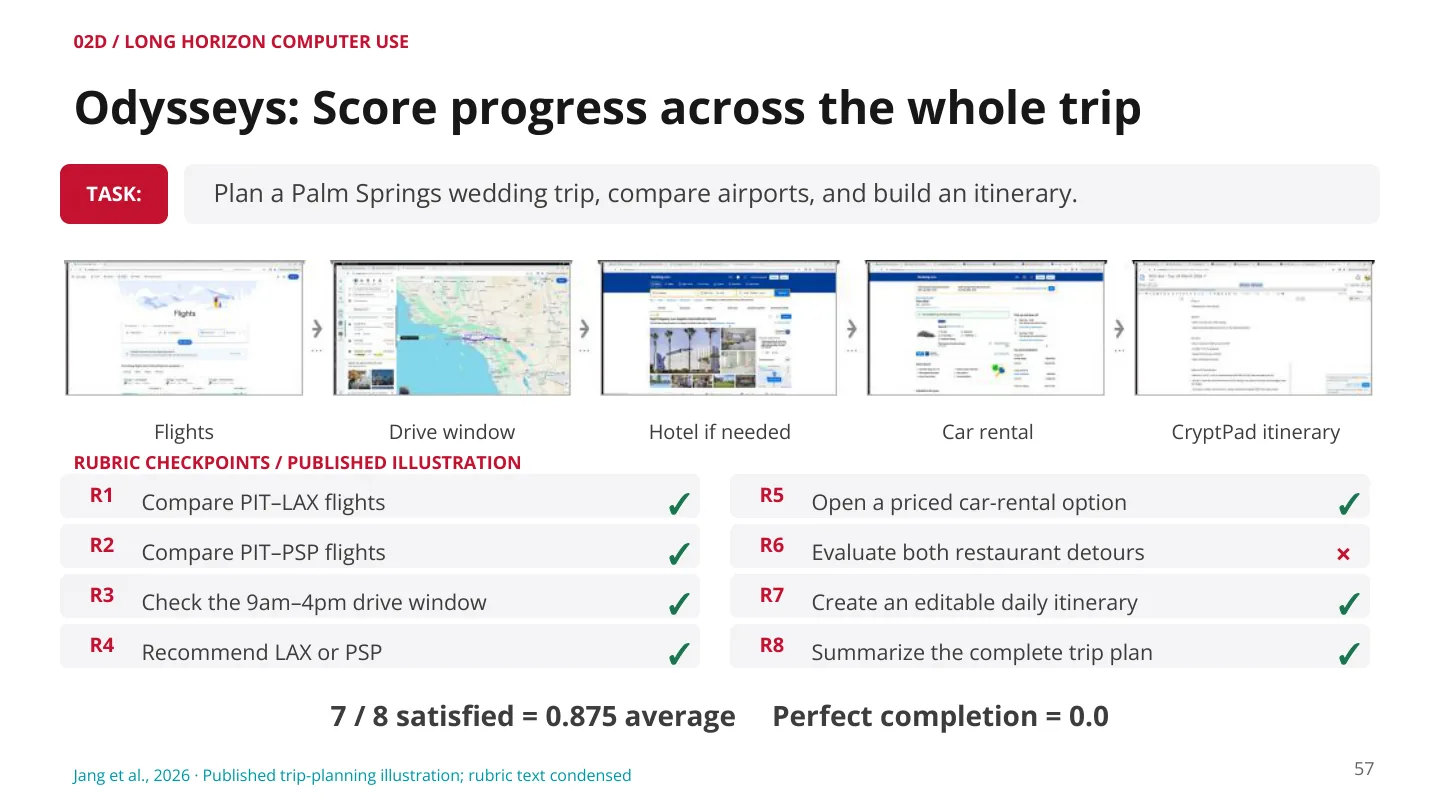
这张图下面有两个数字,值得并排读:7/8 满足 = 0.875 平均分;完美完成 = 0.0。平均分告诉你“它做对了大部分事”,二值指标告诉你“它没有完整交付”。如果只报前者,会高估模型(毕竟行程缺了一条餐厅评估,用户拿到的还是一份不完整的计划);只报后者,会低估模型(7 条做对 vs 0 条做对,在二值指标下没区别),也会让训练没有梯度。长时程评测的成熟做法就是两个都报。
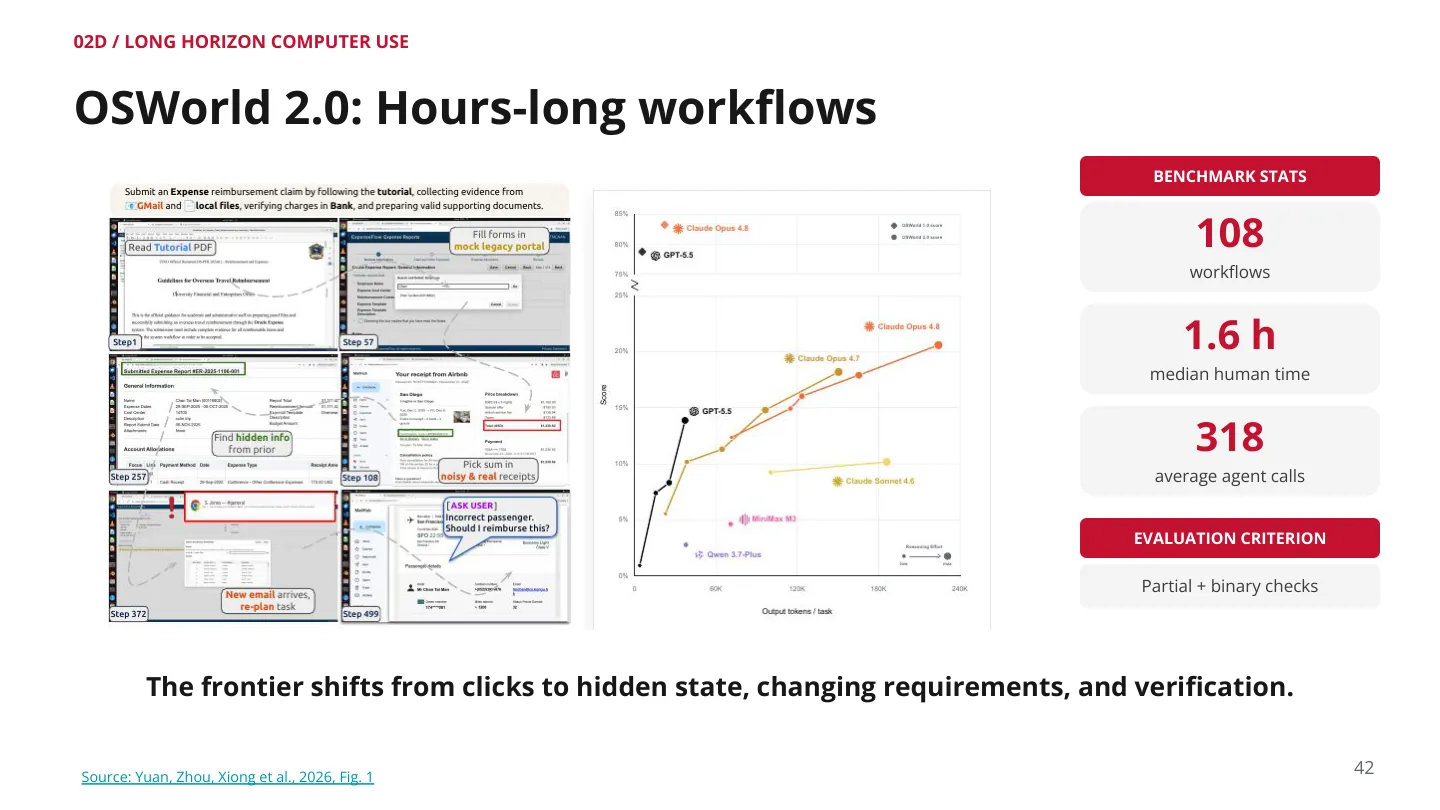
OSWorld 2.0(Yuan, Zhou, Xiong et al., 2026)把时间尺度推到小时级:108 条工作流、人类中位耗时 1.6 小时、agent 平均 318 次调用,评测是“部分分 + 二值检查”的混合(37:50)。它最典型的失败模式是“文件存在但是错的”:任务要求照着图纸做一个 FreeCAD 支架并导出 STEP 模型,agent 导出了一个 STEP 文件,几何却对不上——文件存在、格式正确、内容错误,这正是纯文件名检查会漏掉的东西。
更长的还有 CUA-World-Long(200 条任务,多数需要 500 步以上,8 条质量标准)和 WeaveBench(114 条任务,中位 16 次 GUI/CLI 切换、76 次工具调用,用轨迹感知的 judge 判分)。WeaveBench 的存在说明了一件事:现代 CUA 不是纯 GUI agent,它会在终端敲命令、在编辑器里写脚本,再回到 GUI 里验证。只按“点了什么”判分,会同时漏掉“用 shell 抄近路”的作弊和“用 shell 提高效率”的正当行为。
讲师提醒:长时程任务里,“交付物看起来对”是最危险的信号。Step 文件能打开、表格能读、截图漂亮,都不代表内容正确;rubric 要写到“数值对不对、约束守没守”这一层,否则 agent 会学会生成看起来对的空壳。
10. 建模:交错视觉历史与动作 token
模型侧其实简单得有点意外:一个 VLM,读入交错的视觉—动作历史,输出下一个动作。目标用自然语言,状态用截图,动作用结构化文本;第 步的上下文是 goal、 的拼接。
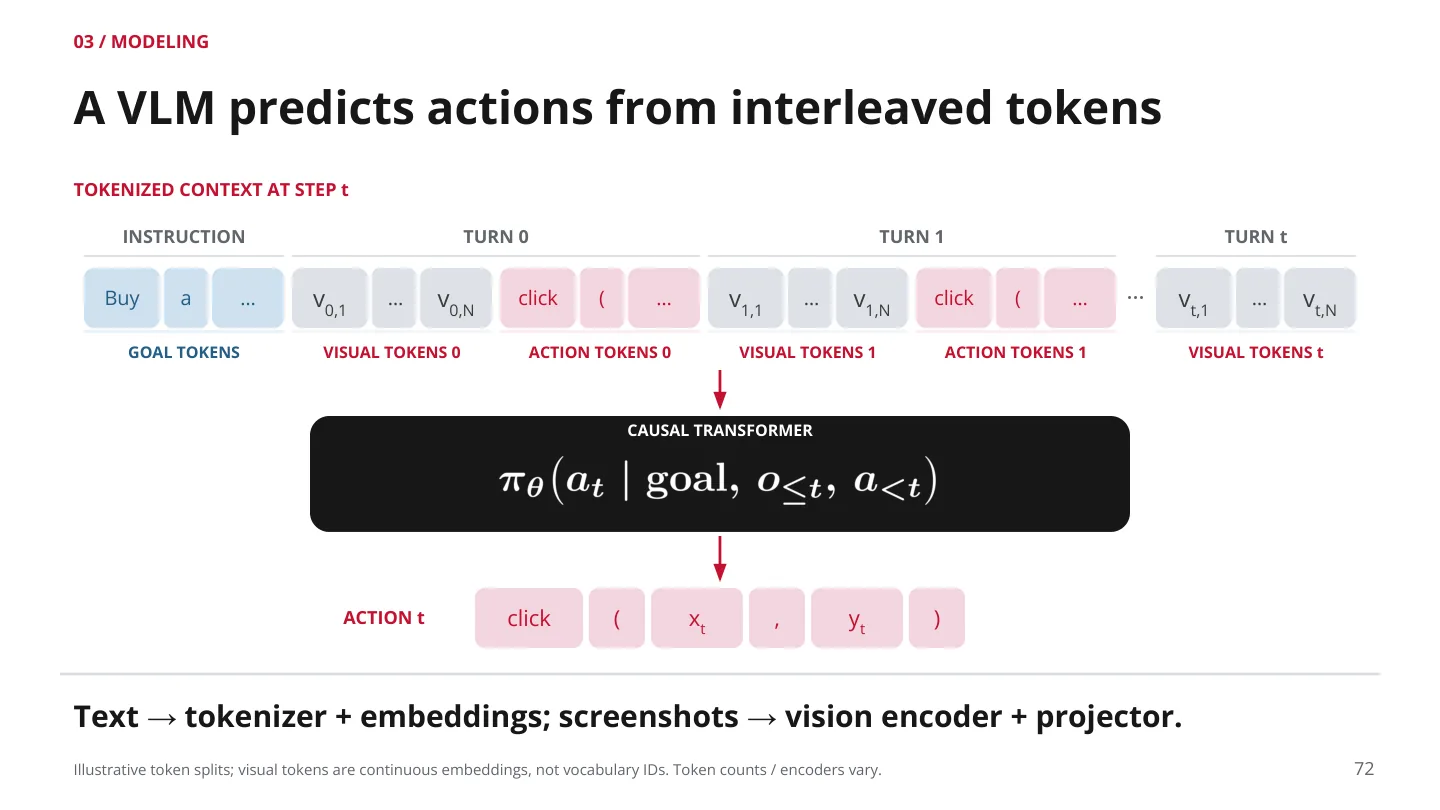
在实现层面,文本走 tokenizer + embedding,截图走 vision encoder + projector,两类向量拼成一条序列喂给因果 Transformer。图上特意标注了一句:视觉 token 是连续 embedding,不是词表里的 ID;不同系统的 token 数、编码器、历史压缩策略都不一样。上下文随步数线性增长,这是 CUA 成本结构的根源,也是后面“稀疏思考”这类优化的动机。
动作空间是异构的。讲师在 Q&A 里被问到“action space 到底是什么”,回答是“因模型而异,也因部署环境而异”(48:58)。到了前沿模型这一层,差异主要体现为序列化格式:
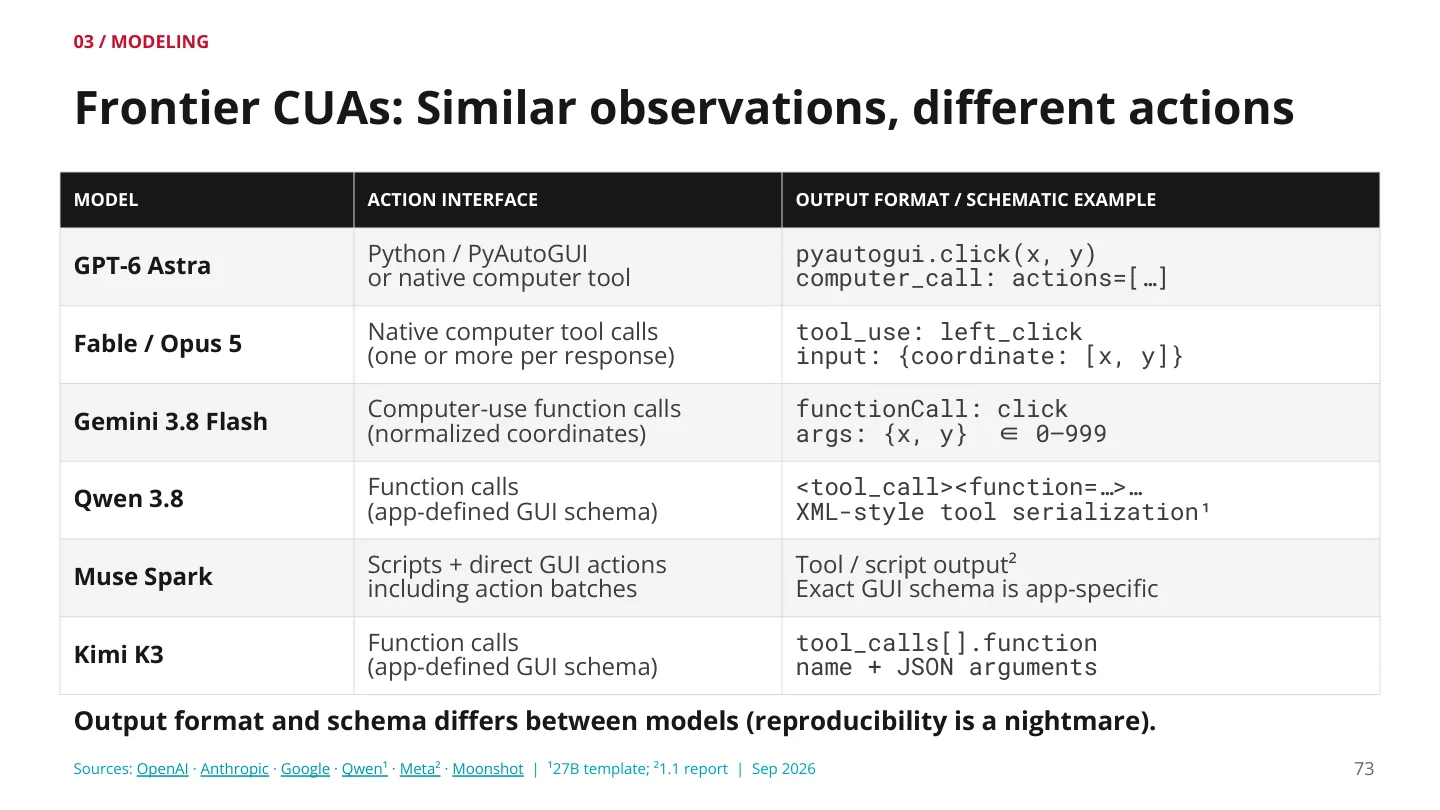
GPT-6 Astra 走 Python/PyAutoGUI 或原生 computer tool;Fable/Opus 5 用原生 tool call(一个响应里可以有多个动作);Gemini 3.8 Flash 用函数调用,坐标归一化到 0–999;Qwen 3.8 用应用自定义的 GUI schema、XML 风格序列化;Muse Spark 输出脚本加批量动作;Kimi K3 是 tool_calls[].function 加 JSON 参数。讲师在这页的结论很重:输出格式和 schema 因模型而异,可复现性是噩梦。同一个 benchmark、同一个 prompt,换个模型就要换一整套解析和坐标变换;这也解释了为什么“同一个 benchmark 上不同论文的数字”经常不可比。
坐标归一化是个小但关键的设计。绝对像素坐标在不同分辨率、不同缩放下不可迁移;把坐标压到 0–1000 的相对空间(左上角 0,0,右下角 1000,1000),模型在 Mac 上训练、到平板或不同分辨率的机器上仍然大体可用。讲师说这个做法“迁移得相当好”,代价是精度损失——对一个 20 像素高的菜单项,1000 格的分辨率意味着每格约 1.4 像素,边界情况容易点偏。
最后一个设计选择是用像素还是用结构(HTML、accessibility tree)。讲师给的理由很实用:截图更简单、更通用,桌面软件根本没有 HTML,而截图在任何设备上都拿得到;而且“出乎很多人意料的是,纯截图的表现已经足够强”。同时他也承认,前沿模型在可用时会使用 accessibility 表示(macOS 的辅助功能树,本质是 XML 风格的层级描述),GPT-6 这类模型是混合使用的。纯像素路线的战略优势在于可迁移:在 Windows 上训练的策略,不必依赖某个 OS 特有的辅助功能格式,就更容易迁到 Linux 或 Mac。
11. 训练:预训练 → SFT → RL
CUA 不是单独训练的专用模型,而是预训练 VLM 的一个能力。训练分三段,每段注入不同类型的数据。
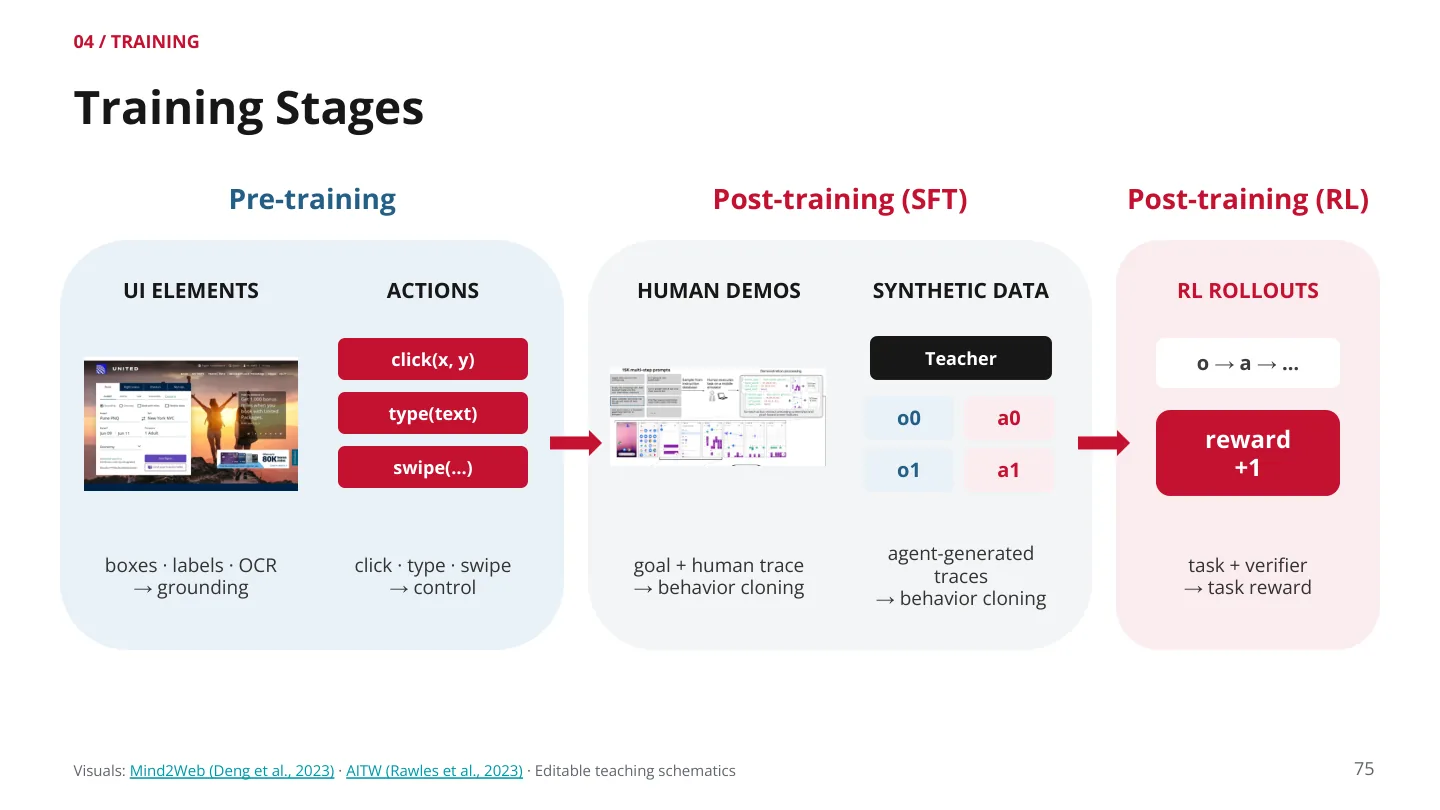
预训练注入两类 CUA 数据。一类是 UI 元素与 grounding:截图 + 元素框 + 标签 + OCR 文本,模型学着把“CAR 这个元素在哪”变成坐标输出;另一类是动作预测:给定截图和元素名,预测该做什么(click、type(text)、swipe(start, end))。这一阶段的目标不是“会完成任务”,而是“看得懂屏幕、指得准位置”,为后面的控制打地基。
SFT 做行为克隆:目标 + 人类轨迹,逐步预测人类的动作。开源数据的规模已经很大:MolmoWeb 收了 36K 条人类轨迹,AgentNet 放出 22,625 条桌面轨迹(跨 3 个 OS,平均 18.6 步)。合成数据是另一半:用一个更强的 teacher 在环境里 rollout、过滤、保留好轨迹。MolmoWeb 的做法很有代表性——给 teacher 提供 accessibility tree 这种特权信息,让它在“比真实评测条件更好的输入”下行动,得到 105K 条合成轨迹,再只保留质量高的。
特权信息这个技巧值得多说一句。讲师用 Tesla 的类比:训练时车上装着 LiDAR,采集完把 LiDAR 信号丢掉,只让模型学像素输入——teacher 看得比 student 多,但 student 只被要求学会用 student 能看到的东西。好处是 teacher 的成功率更高、轨迹质量更好;风险是 teacher 的行为依赖 student 看不到的信息(比如某个按钮的 DOM id),蒸馏出来的轨迹在学生视角下可能“莫名其妙地正确”,学到的是相关性而不是因果。
RL 是最后一段,也是最近两年才成为标配的一段。做法是把模型放进环境、给它任务、让它自己跑,用 verifier 或 judge 给整条轨迹打分,成功轨迹升权、失败轨迹降权。它和 SFT 的区别在于没有人类示范:模型可以走出人类没走过的路径,因而更可能发现长程策略;讲师提到,长时程任务几乎不可能靠人类示范覆盖,RL 在这里不可替代(61:00)。
但 RL 需要一个前提:环境必须可以反复重置。
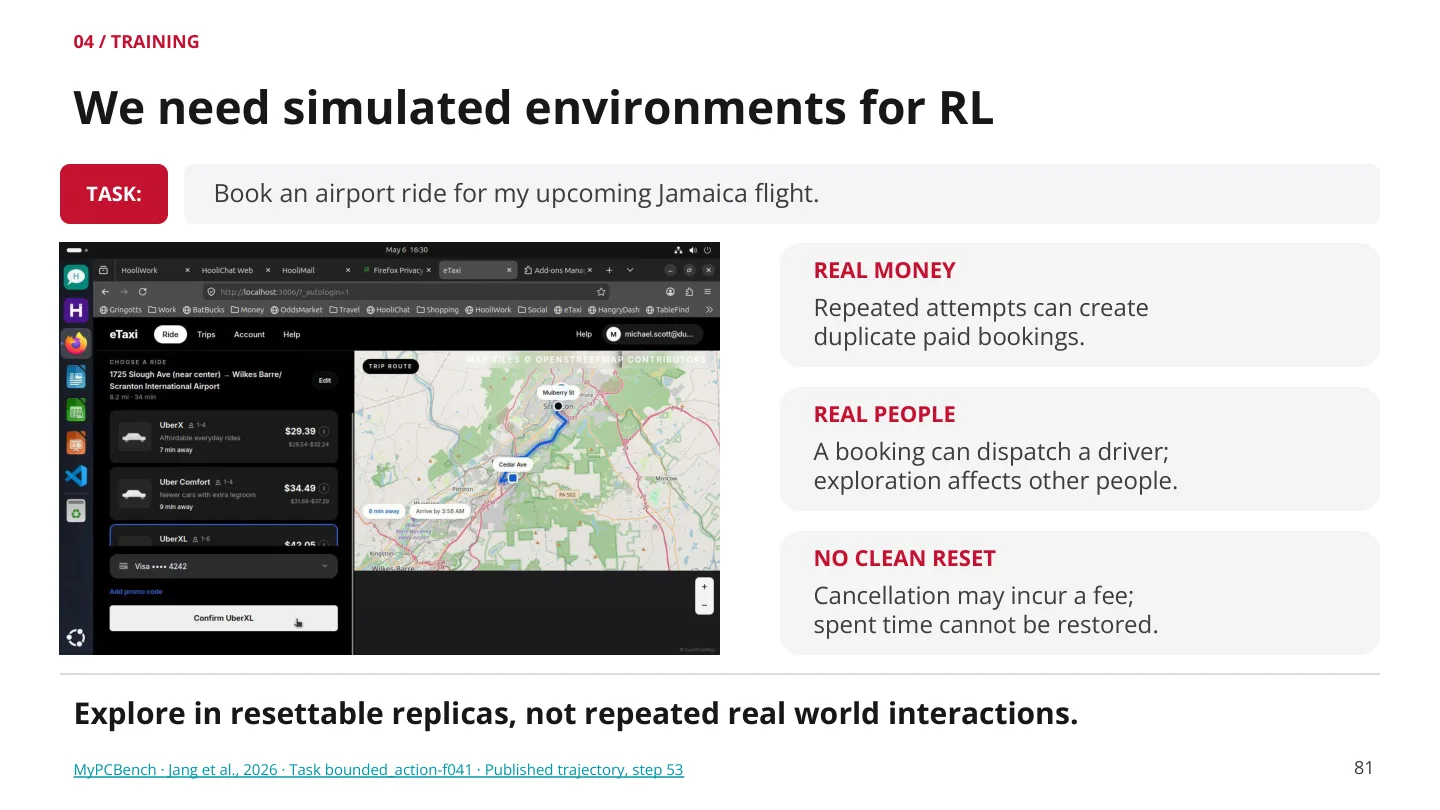
三个理由都很具体。真钱:同一个“订机场接送”的任务试 50 次,会产生 50 笔订单。真人:订车会真的派单给司机,探索会影响到别人。没有干净的重置:取消可能收手续费,花掉的时间也回不来。所以 RL 只能在可重置的副本里做,这也是 2025–2026 年环境构建成为核心基建的原因。
CUA-Gym(Wang et al., 2026)是“造可复用 mock 应用”的典型:94 个 mock web 应用 + 16 个桌面应用,110 个环境,约 32K 条经过验证的 RLVR 元组,38% 是跨应用任务;每个应用支持注入初始状态、检查终态、每轮重置。训练配方是 3,578 条 SFT demo 接 GSPO,在 10,858 条验证过的元组上做 RL。
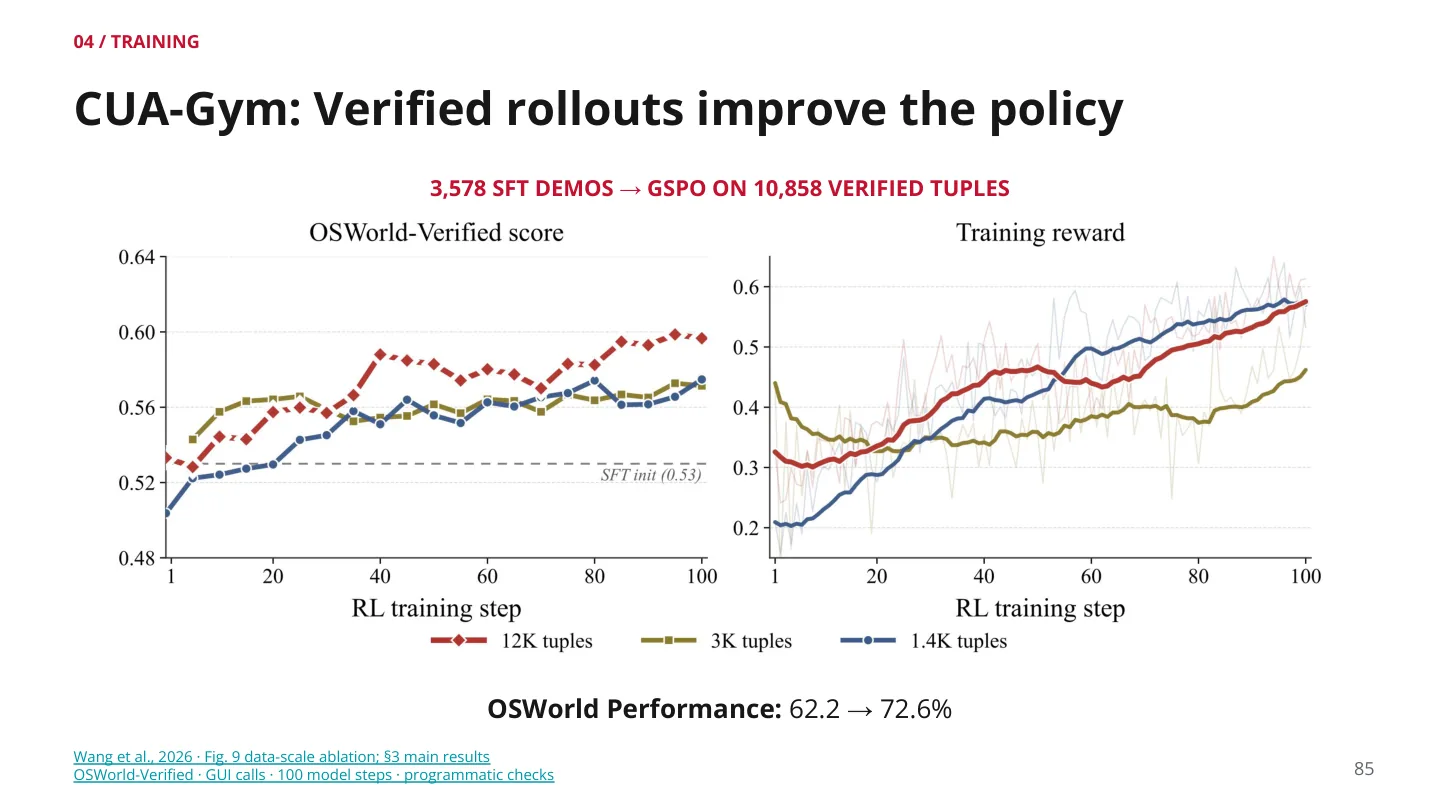
左边的曲线是数据规模消融:1.4K、3K、12K 条元组,训练步数相同,数据越多分数越高,且都从 SFT 初始化的 0.53 这条虚线起步往上走;右边的训练奖励也在同步上升。整体 OSWorld 成绩从 62.2% 到 72.6%——+10 个点来自后训练,而不是换基座。这是本讲最实在的一个数字。
Gym-Anything 走的是另一条路:不造 mock,而是把真实软件装进虚拟机(200 个应用、3 个 OS、12,103 个任务环境,覆盖 22/22 个 SOC 职业大类),由一个 creation agent 搭建、一个独立 audit 验证证据,再用 checklist 做加权评分,支持部分分。它蒸馏出的约 2,000 条成功轨迹,把一个小模型(Qwen3-VL-2B-Thinking,teacher 是 Kimi-K2.5)在 CUA-World-Test 上的平均 checklist 分从 12.7 提到 22.5(满分 100),完美通过率从 1.6% 到 4.4%。数字不高,但方向明确:更多软件、更多任务,对监督后训练都有帮助。
讲师提醒:三段的顺序不能颠倒,也不能省略。预训练给 grounding,SFT 给“像人一样操作”的先验,RL 才谈得上探索。直接对没有 grounding 能力的模型做 RL,等于让它在巨大的坐标空间里瞎试。
12. 尚未解决的问题
讲到最后,JY 把剩余问题归成四类(73:55),每一类都不是“再训大一点”能解决的。
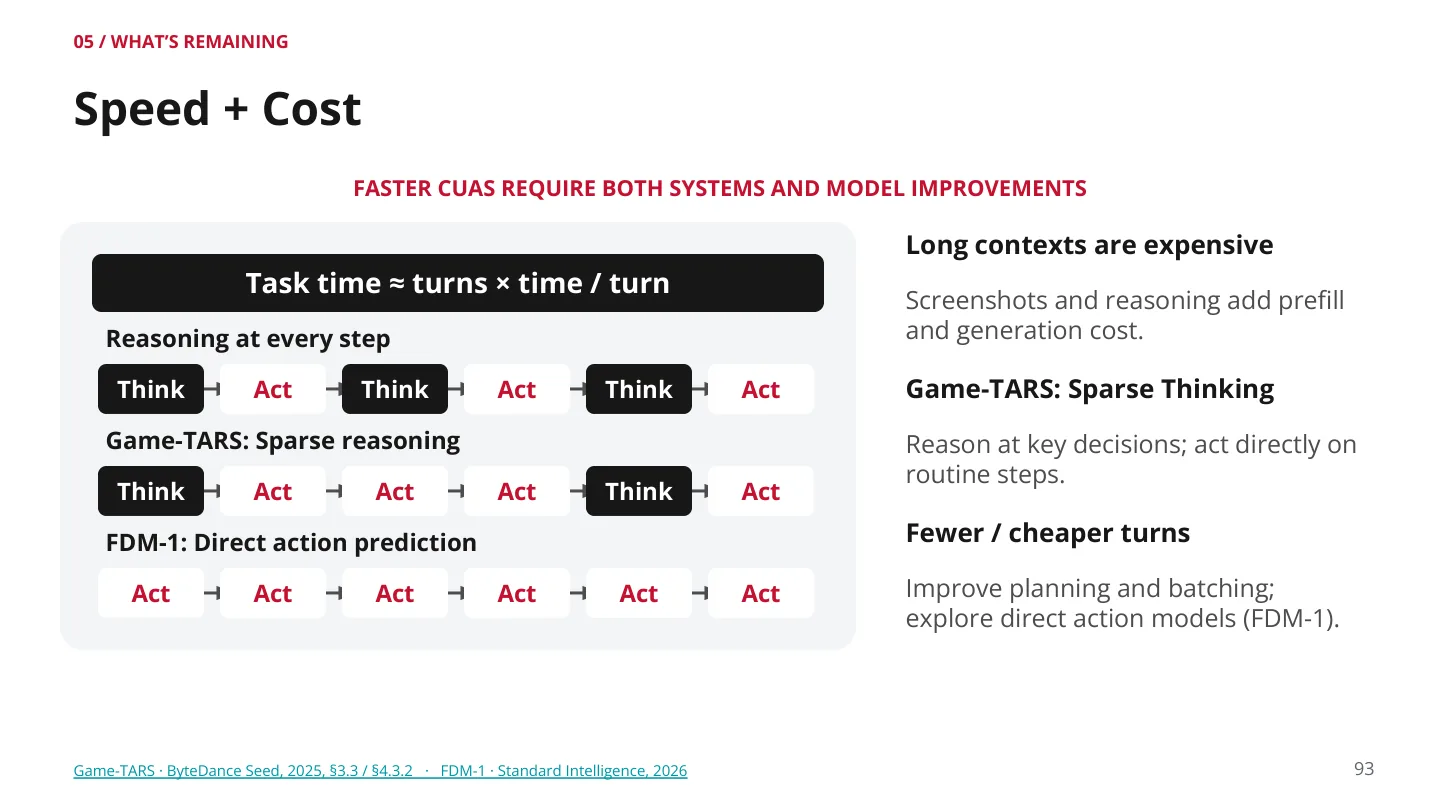
速度与成本。 任务时间大致是 ,两头都要压。长上下文的 prefill 和生成是主要开销:每轮都要重新读一遍累积的截图与历史。Game-TARS 的“稀疏思考”只在关键决策点推理、例行步骤直接动作;FDM-1 探索直接动作预测,连显式推理都省掉。两条路的共同假设是:不是每一步都值得想。风险是省掉的正好是关键步。
个性化。 通用默认值在个人电脑上往往是最差的选择:用谁的文件夹、按谁的日程、偏爱哪家航司。GUM 的做法是从用户的电脑活动里推断上下文,维护带置信度、可修改的用户事实;MyPCBench 则用一个种子身份把邮件、日历、项目 issue 串成一个可复现的“个人数字生活”,专门测跨应用的个人上下文。讲师强调两条底线:用户控制(同意、可见、可遗忘)和记忆可修正(用户说错了就要能改,而不是把错误事实固化进策略)。
基础设施与 UX。 CUA 不该阻塞用户:Codex 的做法是在隔离的后台会话里跑,用户继续自己的工作;同时界面要显示进度、接受纠正、支持审批和中断。讲师说这块“还有很多可探索的空间”,因为今天的交互范式(一个聊天框 + 一个屏幕)显然不是最终形态。
多智能体。 MACU 的框架是 plan → parallelize → replan:按依赖关系切分任务,把就绪的子任务分派给隔离环境里的多个 CUA,再汇合证据、验证、重规划。并行只有在协调不破坏正确性时才划算——两个 agent 同时改一个文件、同时订一张票,都是灾难。更进一步是异构协作:CUA 负责界面操作,代码 agent 负责批处理,工具 agent 负责查询,冲突控制和开销控制是新的研究问题。
把四类问题合起来看,方向其实很清楚:能力已经不是瓶颈,可靠性、成本与可控性才是。GPT-6 Astra 在多数 benchmark 上超过人类基线,但它在真实工作流里仍然慢、仍然贵、仍然需要人盯着。讲师在总结页把整讲压缩成四句话:CUA 直接在 GUI 上操作;评测要选对指标和行为层级;模型从交错的视觉历史预测动作;训练是预训练 → SFT → RL。剩下的,是让这套东西从“能演示”变成“能托付”。
一句话总结
CUA 的通用性来自“和人类共用一层界面”,它的全部困难也来自这层界面:像素观测让定位变难,坐标动作让校验变难,开放环境让评测变难。能不能做已经被模型解决了,怎么证明做对了还没有。
术语表
| 术语 | 含义 |
|---|---|
| CUA | Computer Use Agent,以渲染后的 GUI 为观测、以鼠标键盘手势为动作的 agent |
| Grounding | 把自然语言指代(“CAR 标签”“UV sphere 菜单项”)定位到屏幕坐标或元素框的能力 |
| Observe–Reason–Act | CUA 的基本循环:截图 → 推理并输出动作 → 执行 → 新截图 |
| Rollout | 让 agent 在环境里连续执行直到终止的一整条轨迹 |
| 静态评测(02A) | 在固定观测上预测单个动作并与标注比对,不执行、不 rollout |
| 端到端评测(02B/02C) | 让 agent 真正完成任务,再检查环境终态;web 与桌面/移动端之分 |
| 长时程(02D) | 数十分钟到数小时、数百步的工作流,奖励稀疏,需要过程分 |
| Programmatic verifier | 直接读数据库/文件/应用状态的可执行断言,如 cart.item == blue_mug |
| LLM/VLM judge | 用另一个模型按 rubric 检查证据并给出 PASS/FAIL 的评测器 |
| Rubric | 把任务拆成若干可独立判断的检查点,支持部分分 |
| Reward hacking | 优化验证器而不是完成任务,例如为满足条件把全部商品加入购物车 |
| Benchmark drift | 真实网站改版或数据变化导致同一任务前后不可比 |
| Privileged information | 训练/合成数据时给 teacher 的额外信息(如 accessibility tree),推理时不可用 |
| SFT / Behavior cloning | 在人类或合成的成功轨迹上做下一步动作的监督学习 |
| RLVR | 用可验证奖励(verifier 判定)做强化学习,CUA-Gym 的 32K 元组即此类 |
| Action space | 模型可输出的动作集合与序列化格式(PyAutoGUI、tool call、0–999 坐标等) |
延伸阅读
奠基工作
- World of Bits (MiniWoB) · Shi et al., ICML 2017,第一个网页 agent 环境与 RL 尝试
- WebShop · Yao et al., NeurIPS 2022,带真实商品的模拟电商与语言目标
- Mind2Web · Deng et al., 2023,跨 137 个网站的 next-action imitation
- Android in the Wild · Rawles et al., 2023,715K episodes 的移动端动作数据
端到端 benchmark
- WebArena · Zhou et al., ICLR 2024,自托管站点 + 程序化成功检查
- VisualWebArena · Koh et al., ACL 2024,必须看图才能完成的任务
- OSWorld · Xie et al., NeurIPS 2024,真实桌面与逐任务自定义检查
- WindowsAgentArena · Bonatti et al., 2024,并行 Windows 虚拟机
- AndroidWorld · Rawles et al., ICLR 2025,参数化移动任务与系统状态奖励
- WorkArena · Drouin et al., ICML 2024,ServiceNow 企业工作流
- WebVoyager · He et al., ACL 2024,真实网页 + VLM 判卷
长时程与环境构建(2026,课件引用)
- Odysseys · Jang*, Koh*, Fried & Salakhutdinov, 2026 · rubric 化的真实网页长任务
- OSWorld 2.0 · Yuan, Zhou, Xiong et al., 2026 · 小时级工作流与部分分
- CUA-World-Long / Gym-Anything · Aggarwal et al., 2026 · 真实专业软件上的长任务与 checklist 判卷
- CUA-Gym · Wang et al., 2026 · 可重置 mock 应用与 32K 验证元组
- MyPCBench · Jang et al., 2026 · 跨应用的个人数字生活
- WeaveBench · Li et al., EMNLP 2026 · GUI + CLI 混合轨迹的感知判卷
- GUM · Shaikh et al., 2025 · 从电脑活动推断用户上下文
- MACU · Koh, Salakhutdinov & Fried, 2026 · 多 CUA 的规划—并行—重规划
课程内相关
- 第 2 讲 Tool Use:动作空间与工具 schema 的一般讨论
- 第 5 讲 Planning:长程任务分解,与 02D 的 rubric 设计直接相关
- 第 6 讲 Coding Agents:coding agent 现在被用来生成 CUA 环境,两条线正在合流
自测题
1. CUA 与文本 agent 的三个结构性差异是什么?每个差异带来什么后果?
(1)观测是渲染后的像素而不是结构化字段,后果是定位成为独立能力,分辨率与缩放会直接影响成功率;(2)动作是低层坐标与按键,本身不携带语义,后果是必须依赖基础设施做合法性校验,且动作空间因模型而异、难以复用;(3)环境是只能通过界面窥视的黑盒,后果是评测要么开后门读状态(模拟环境),要么只能靠 judge(真实网页),两者都有系统性偏差。
2. 为什么循环里要显式输出 reasoning trace,而不是直接输出坐标?
三个作用:把“定位”变成可检查的中间结果,出错时能区分看错还是点错;在长程任务里提供文字版进度记录,缓解纯像素上下文的遗忘;为 rubric 判卷提供证据,让 judge 不只依赖最后一张截图。代价是每轮多花生成 token,长任务里这部分开销可观,所以才有“稀疏思考”这类优化。
3. 静态评测的假阴性从哪来?既然有假阴性,为什么它还值得做?
假阴性来自“正确的下一步”是一整个集合,而标注只覆盖一个。例如租车任务标注的是点 CAR 标签,但先改日期再点 CAR 同样合理,静态评测会判错。它仍值得做,因为成本是常数级(一次前向、无环境、无 rollout),可以跑几千条,且 ground truth 可批量生成(网页 JS 抽 bounding box),非常适合作为预训练的 grounding 信号和快速回归测试;只是不能用它论证端到端能力。
4. 程序化验证器的两类错误各举一例,并说明为什么假阳性更危险。
假阳性(本该失败却通过):WebArena 的“创建空仓库”任务只检查目标 URL 的 HTML 里有没有仓库名,不检查仓库是否为空,agent 塞个文件也能满分。假阴性(本该通过却失败):任务允许多种合法终态,验证器只认其中一种。假阳性更危险,因为验证器同时是 RL 的奖励函数——模型会精确地学会“让断言通过”,把缺陷固化进策略,而不是仅仅让某次评测虚高。
5. VLM judge 与人类 85% 的一致率意味着什么?比较两个只差 3 个点的模型时要注意什么?
意味着约 15% 的判定与人类不同;在 300 题上约 45 题存在分歧,足以淹没 3 个点(约 9 题)的差距。比较时要注意:报告 judge 型号与 prompt、报告一致率与抽样人工复核结果、给出置信区间或多次判卷的方差;跨 benchmark 比较时还要确认任务集、步数上限、截图策略一致,否则数字不可比。
6. 长时程任务为什么需要 rubric 与部分分?Odysseys 例子里 0.875 与 0.0 该怎么一起读?
因为终局奖励极稀疏:几百步的有用功可能被最后一步失败抹平,二值信号也无法做 credit assignment。rubric 把任务拆成可独立判断的检查点,提供密集信号。0.875 是 8 条中满足 7 条的平均分,说明模型做对了大部分工作;0.0 是“完美完成”的二值指标,说明没有完整交付。两个数字一起报,才能同时反映“进展”和“是否可托付”;只报平均分会高估,只报二值会低估且没有梯度。
7. 为什么 RL 阶段必须用可重置的模拟环境?举出三个具体风险。
(1)真钱:同一订车/订票任务重复尝试会产生多笔真实订单与扣款;(2)真人:派单会影响到司机等第三方,探索具有外部性;(3)没有干净重置:取消可能收手续费,时间不可恢复,状态无法回到初始。此外还有可复现性问题——真实网站会变,同一策略两次评测不可比。
8. 合成轨迹中的“特权信息”指什么?为什么有效,又有什么风险?
指训练/合成时给 teacher 的、推理时 student 拿不到的额外输入,例如 accessibility tree、DOM 结构、元素 id。有效是因为 teacher 在更好的条件下成功率更高,产出的轨迹质量更好,而 student 只被要求用像素复现行为(类似 Tesla 训练时用 LiDAR、部署时只用摄像头)。风险是 teacher 的行为依赖 student 看不见的信息,蒸馏出的轨迹在学生视角下可能缺乏因果依据,学到的是虚假相关;因此需要过滤与人工抽检。
9. 主流 CUA 为什么优先用截图而不是 HTML/accessibility tree?代价是什么?
优点:通用(桌面软件没有 HTML)、实现简单(截屏即可)、跨 OS 迁移性好(不依赖某个系统的辅助功能格式),而且在现代 VLM 上效果出乎意料地强。代价:高分辨率专业 UI 的小目标定位困难;文本信息要以 OCR 方式间接获取,密集菜单容易读错;上下文 token 数远高于结构化表示;纯像素也拿不到元素的语义 id,做精确断言更难。实践中前沿模型是混合的——有 accessibility 表示时就用。
10. 如果要为“用浏览器订一张可退改的机票”设计评测,你会怎么组合三层标准?
动作层:用静态样本检查关键 grounding(日期选择器、舱位下拉、退改签条款链接),成本低、可跑几千条,作为回归。结果层:在模拟环境里用程序化检查验证订单状态——航班号、日期、乘机人、票价上限、退改签标志为真、支付次数为 1;若在真实网站,则用 rubric judge 检查确认页与邮件证据。过程层:检查没有多订、没有选不可退的票价、没有跳过条款确认页、没有把测试卡号用于真实支付。三者分开报告:动作层给能力上限,结果层给任务成功率,过程层给合规率;任何一层为 0 都不能算通过。