
1b · Agent Capabilities 1: Tool Use
本讲速览
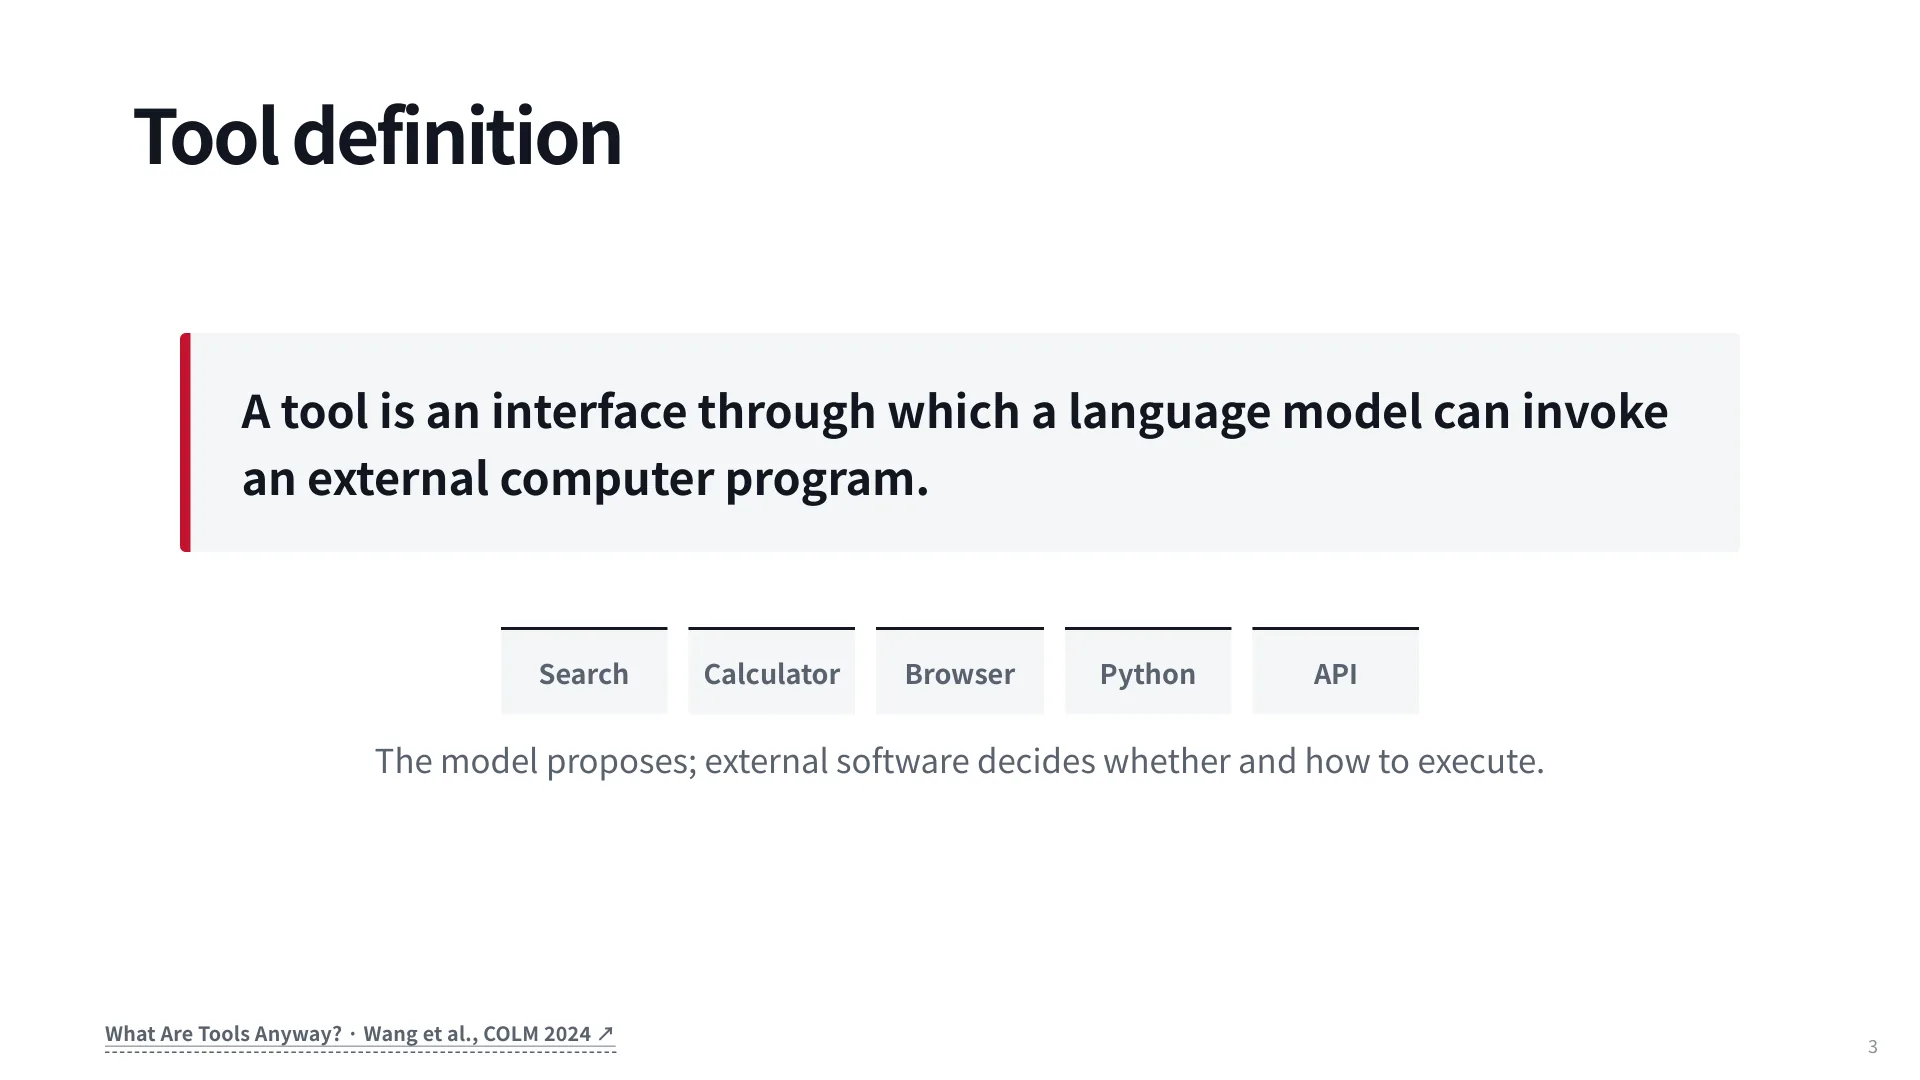
- 工具是模型调用外部程序的接口。模型只负责“提议”一次调用,是否执行、怎么执行由外部软件决定;这条边界是后面所有安全性讨论的起点。
- 工具的价值只有两类:extend(参数里根本没有的信息或动作)与 facilitate(模型能做,但外部程序更快更稳)。判断该不该调工具,本质是拿收益去换延迟、成本、失败率与风险。
- 代码是一种特殊的“元工具”。它把控制流、库和多次调用压进一个动作里;CodeAct 的实验显示代码动作在多数模型上成功率更高、交互轮数更少,代价是更难约束、影响面更大。
- 工具调用在实现层面只是 token。schema 通过 chat template 进入 prompt,模型按自己的协议吐出调用块;Qwen、Mistral、DeepSeek 的格式互不通用,解析代码不能跨模型假设。
- harness 承担了大部分工程负担:注册与解析、schema 校验、执行、用 call ID 把结果配回调用,还要处理 Anthropic 这类“历史不完整就拒绝生成”的严格实现。
- 约束解码保证形式,不保证语义。JSON Schema → 上下文无关文法 → 下推自动机 → token mask 这条链路能消除语法错误,但错的城市、错的参数、错的任务依然会发生。
- 接口有两种风格:直接 REST(OpenAPI 自带 schema,但凭据会落进 agent 的 shell)与 MCP(多一层 server 做凭据代理)。评测则要分层看选择、参数、轨迹、任务,再叠加 provider 侧的运行时差异。
1. 定位:把“会说话”变成“会做事”
语言模型本质上是一个 token 预测器:给定前缀,输出下一个 token 的分布。这个机制足以让它写诗、写代码、做总结,却不足以让它知道今天的天气、读到你邮箱里的那封邮件、或者把一个购物车真的提交出去。工具调用要解决的正是这个断层——不是让模型“更聪明”,而是给它一条通往外部世界的窄门。
Graham 在开场把这件事定位成 agent 最根本、也最能与语言模型区分开的特征:ChatGPT 早期只是文本进、文本出,今天它在回答前会搜网页、算数、画图、调内部 API,这个“迭代地调用工具”的行为本身就构成了 agent 的定义。换句话说,本讲讨论的不是某个可选功能,而是 agent 与 chatbot 的分界线。
开场他就给了一个很朴素的定义(00:00):工具是语言模型可以借以调用外部计算机程序的接口。这句话里有两个容易被忽略的词。“接口”意味着工具有固定的形状——名字、参数、返回类型;“可以借以”意味着模型并不直接执行任何东西,它只是生成一段请求,真正的执行发生在模型之外。后面讲约束解码、讲 MCP 凭据、讲沙箱,全部是从这条边界长出来的。
2. 工具是什么:两类收益与一张决策表
定义之外,更需要判断力的是“什么时候值得调”。课件把收益拆成两类,这个划分比看起来更有用。
Extend(扩展):给模型它参数里根本不存在的能力。参数是训练时冻结下来的,所以“四个月前的新闻”“你账户里的余额”“这台机器上 /tmp 目录的内容”对模型而言不是难,而是原理上不可得。检索、账户 API、文件系统都属于这一类。
Facilitate(便利化):模型其实做得到,但交给外部程序更划算。Graham 举的例子是算术:今天的大模型算术已经相当不错,但乘两个七位数要逐位展开推理,比计算器慢得多;计算器是常数时间且正确的。这一类常被忽视,因为它的收益是工程质量而不是能力边界——但当你在生产里跑几万次调用时,“更慢更贵”就是决定性的。
这两类收益落到具体场景,就形成一张“需求 → 工具 → 收益”的对照表。值得注意的是表格最后一列写的不是“能力”,而是收益的性质:新鲜证据、可靠执行、被授权的应用数据、对环境产生改变。这暗示了评估工具设计的一个角度——如果一个工具既不带来新信息,也不带来更可靠或更高效的计算,还不能改变环境,那它大概只是把一次函数调用包装成了 token。
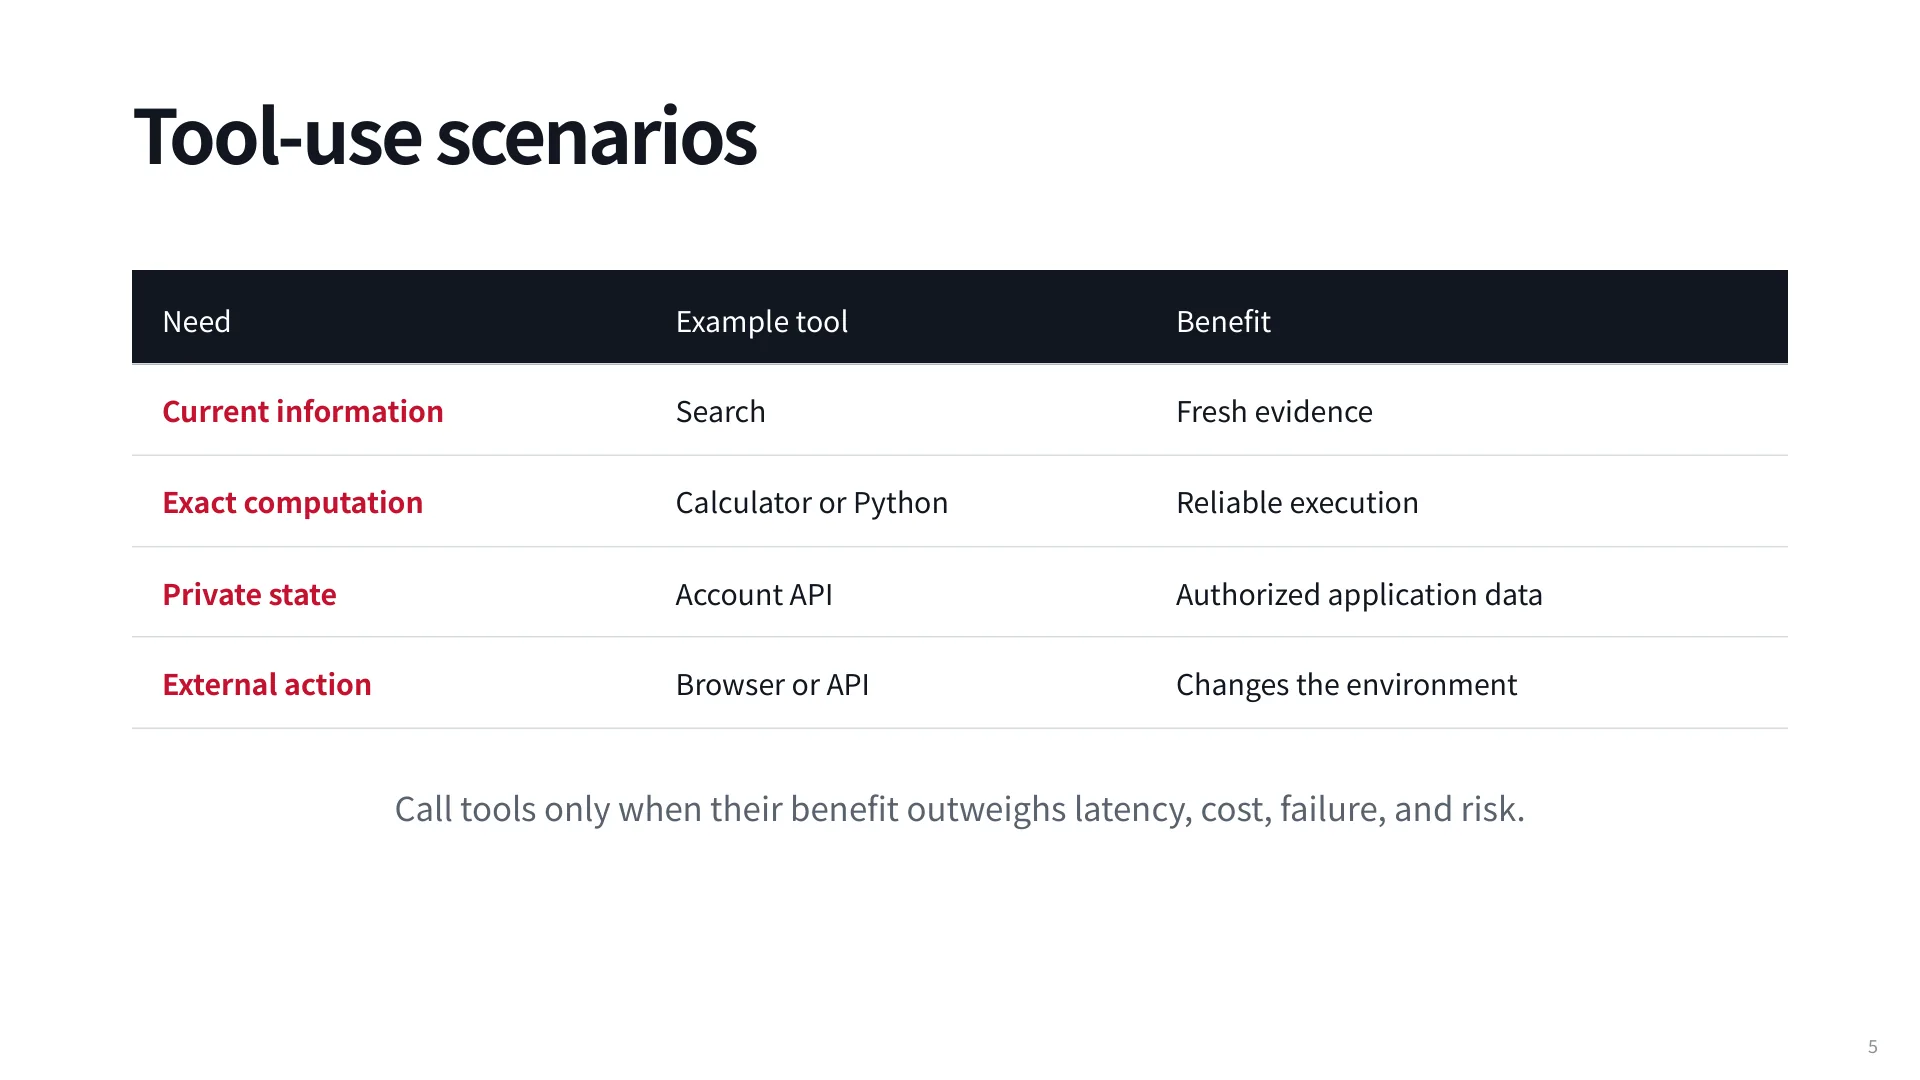
课件的判据只有一句:只有当收益超过延迟、成本、失败与风险的总和时才调用工具。这句话在实际系统里可以展开成几个具体问题。延迟上,一次工具往返往往比一次生成慢得多,几次串行往返叠加起来就足以让用户放弃。成本上,工具本身可能按次计费,token 也在计费。失败上,任何外部依赖都有超时和错误码,而模型未必能优雅恢复。风险上,写操作可能不可逆。四者叠加,就解释了为什么“能调”不等于“该调”。
02:22 处他用“四个月前的信息”和“算乘法”对比了这两类收益。这个对比还有一层含义:extend 类工具的错误通常表现为“不知道”,容易被发现;facilitate 类工具的错误表现为“慢、贵、偶发不一致”,往往要等系统上线才暴露。
设计工具时的第一个问题
不要问“模型能不能做这件事”,而要问“这件事由模型做,和由外部程序做,哪一边的错误更可观测、更可恢复”。可观测性往往比准确率更能决定一个 agent 是否可维护。
3. 工具谱系:从文本回答到自定义函数
课件把常见工具归成几类,并强调“大多数具体工具都能塞进这几类里”。这个归类法是教学用的,但它确实覆盖了工程中反复出现的形态。
最基础的一类是文本回答。它有两种实现:一是显式的 finish(text),二是模型不调用任何工具、直接输出文本从而结束循环。前者看起来多余——为什么不直接停?因为把“结束”做成一个显式动作,harness 就能区分“我不想再调工具了”和“我这条消息只是中间说明,后面还有调用”。在 ReAct 风格的输出里,同一轮既有给用户看的文字,又有工具调用,显式 finish 让状态机更干净。课件也点明:finish 是 harness 的控制动作,不是外部程序,这是它和其他工具的本质区别。
第二类是信息检索,典型接口是 search_web(query)。它在系统里的位置很特殊:RAG 已经被讨论到“过时”的程度,但 Graham 的反驳是——它没有死,而是变得太普通以致于没人再把它当技术名词。今天任何一个聊天产品在回答时效性问题时都在做“检索上下文再生成”,只是这一步被包装成了工具调用。
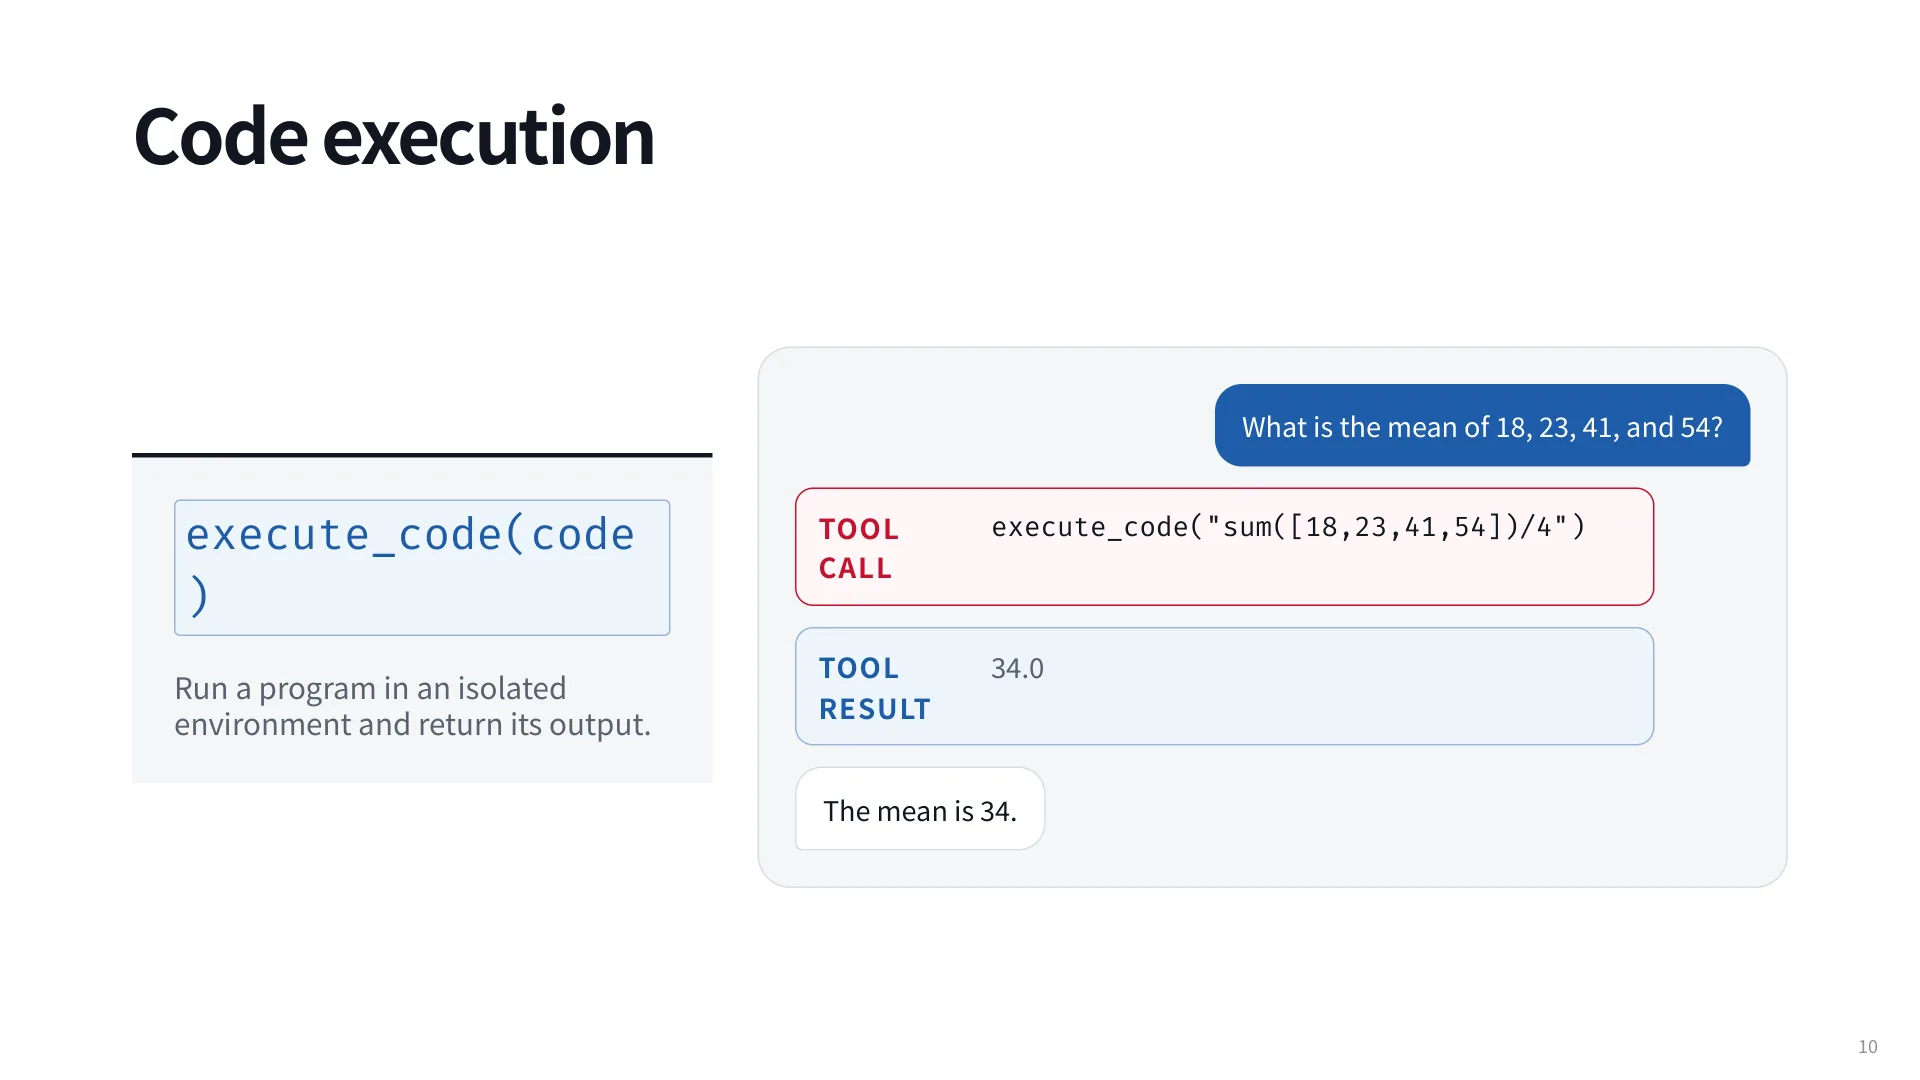
第三类是代码执行,例如 execute_code(code),在隔离环境里跑一段程序并取回输出。它的价值在数值计算上最直观:sum([18,23,41,54])/4 返回 34.0,模型不需要展示推理过程,也不需要在算术上冒险。
第四类是图像生成。它和前几类的差别不只是模态,还在于“参数本身需要被创作”:用户说“画一个在图书馆里学习的水彩风格机器人”,模型往往会把 query 扩写成更长、更具体的描述再发给图像工具。这带来一个有意思的可解释性问题——你看到的提示词和你写下的提示词并不是同一个,早期的 ChatGPT 在下载图片时保留的 caption 就泄露了这个中间 query。
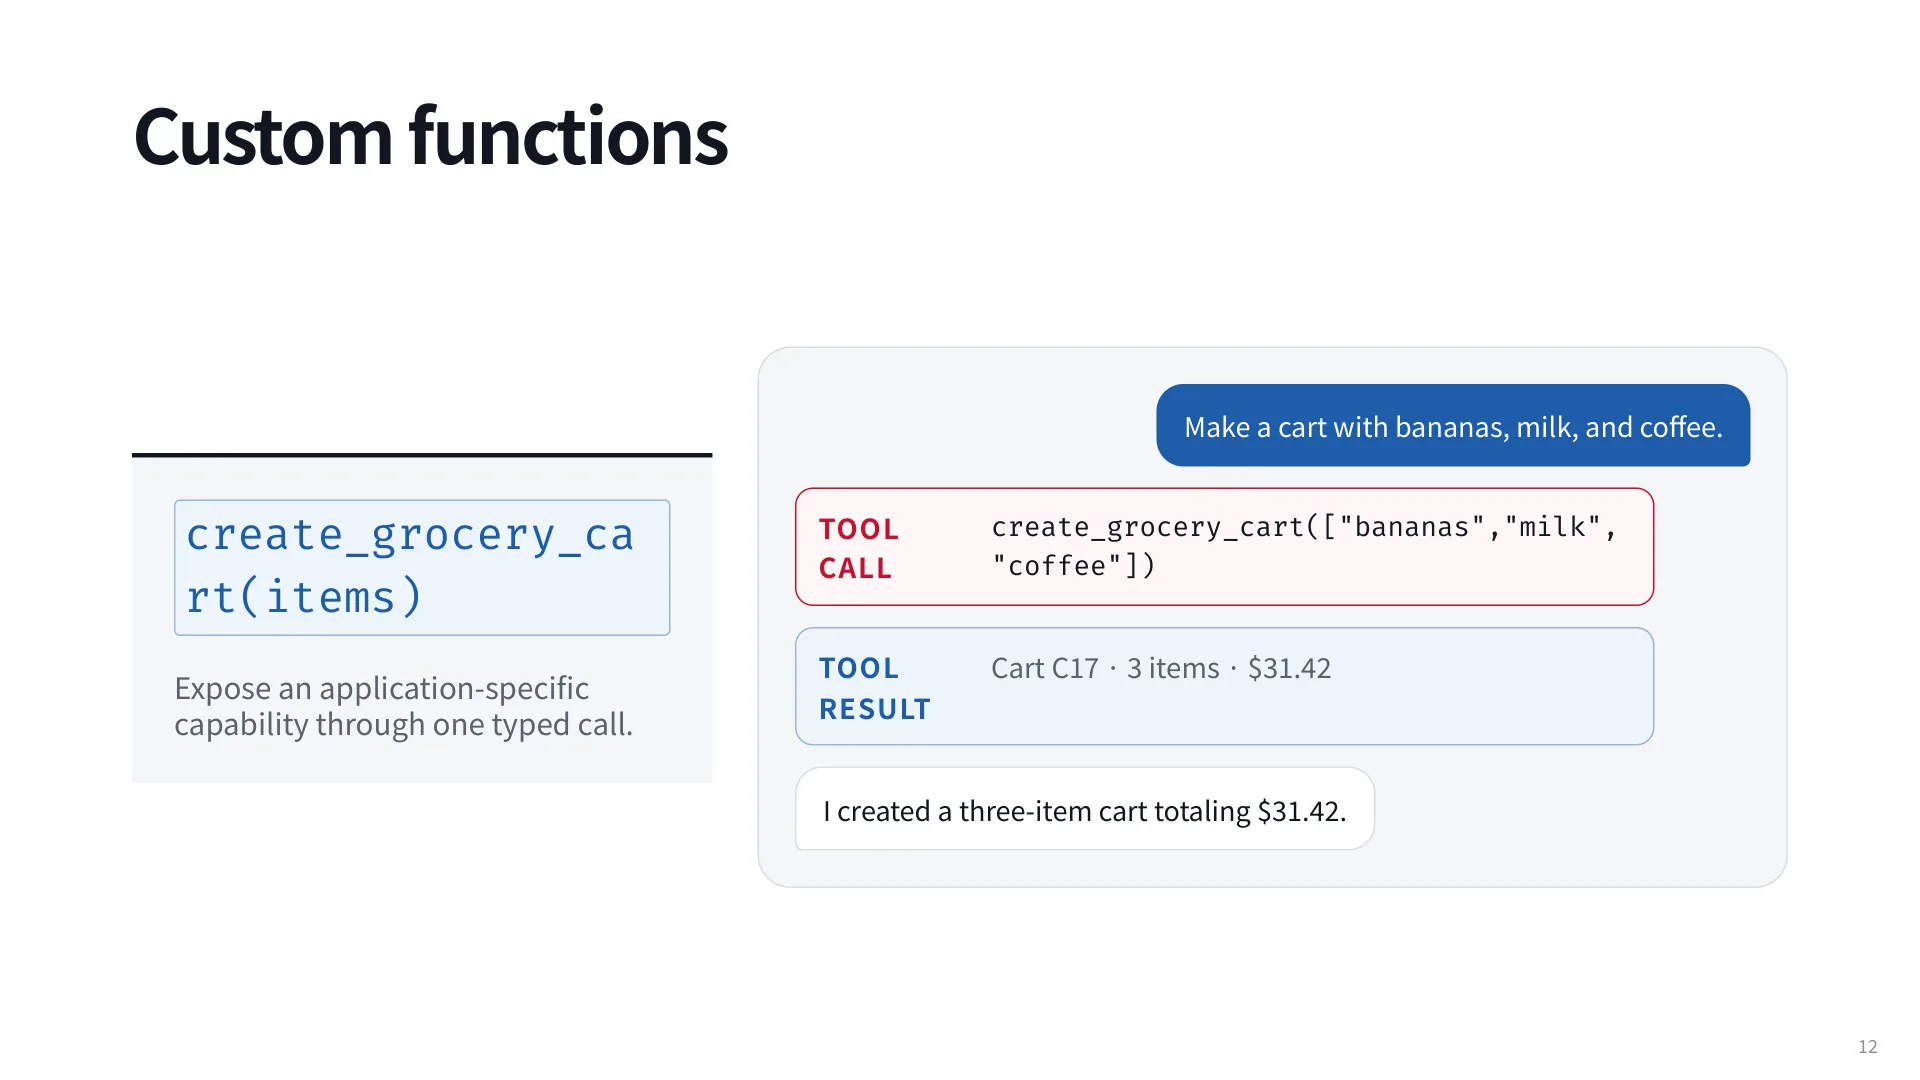
第五类是自定义函数,也就是把某个应用的能力封装成一次带类型的调用。课件用的例子是 create_grocery_cart(["bananas","milk","coffee"]),返回 Cart C17 · 3 items · $31.42。这类工具是产品差异化的主要来源:搜索、算数、画图是通用能力,而“把这三样东西加进购物车并告诉我总价”只有接了具体业务才存在。
04:00 起课堂讨论了各自常用的 ChatGPT 功能:写代码、渲染 LaTeX/生成 PDF、推荐商品、连 Slack。这些例子说明一件事——工具列表实际上定义了产品的边界,而“要不要为某个能力做工具”往往取决于它是否需要访问模型之外的资源。纯前端渲染就不需要工具,生成 PDF 就需要。
4. 代码作为元工具:表达力与风险的同一枚硬币
如果把工具列表看成 50 或 70 个 API,模型每一轮挑一个调用,这是最直觉的设计。代码是这套设计里的例外:它不是“又一个 API”,而是能组合其他 API 的介质。
课件用“面包店烤了 200 个面包,还剩多少”这个例子拆解了这层意思:赋值是一个工具、减法是另一个工具,而一段代码就是这些调用的树,树上还能长出循环和条件。再往外一层,import pandas 等于一次性打开了 pandas 里的所有函数,自定义的 utility function 也能被同一段代码调用。所以代码是“元工具”——它不增加单点能力,它增加的是组合方式。
12:58 处对比了两种范式。传统做法面对“比较某款手机在美、日、德、印四国的最优购买地”这类问题时,需要反复调用查汇率、查价格、算税、再查汇率的工具,一轮一轮往前挪;写成程序则是一次性表达整个计算过程。这不是效率上的小优化,而是把“多轮决策”压缩成“一次程序合成”。
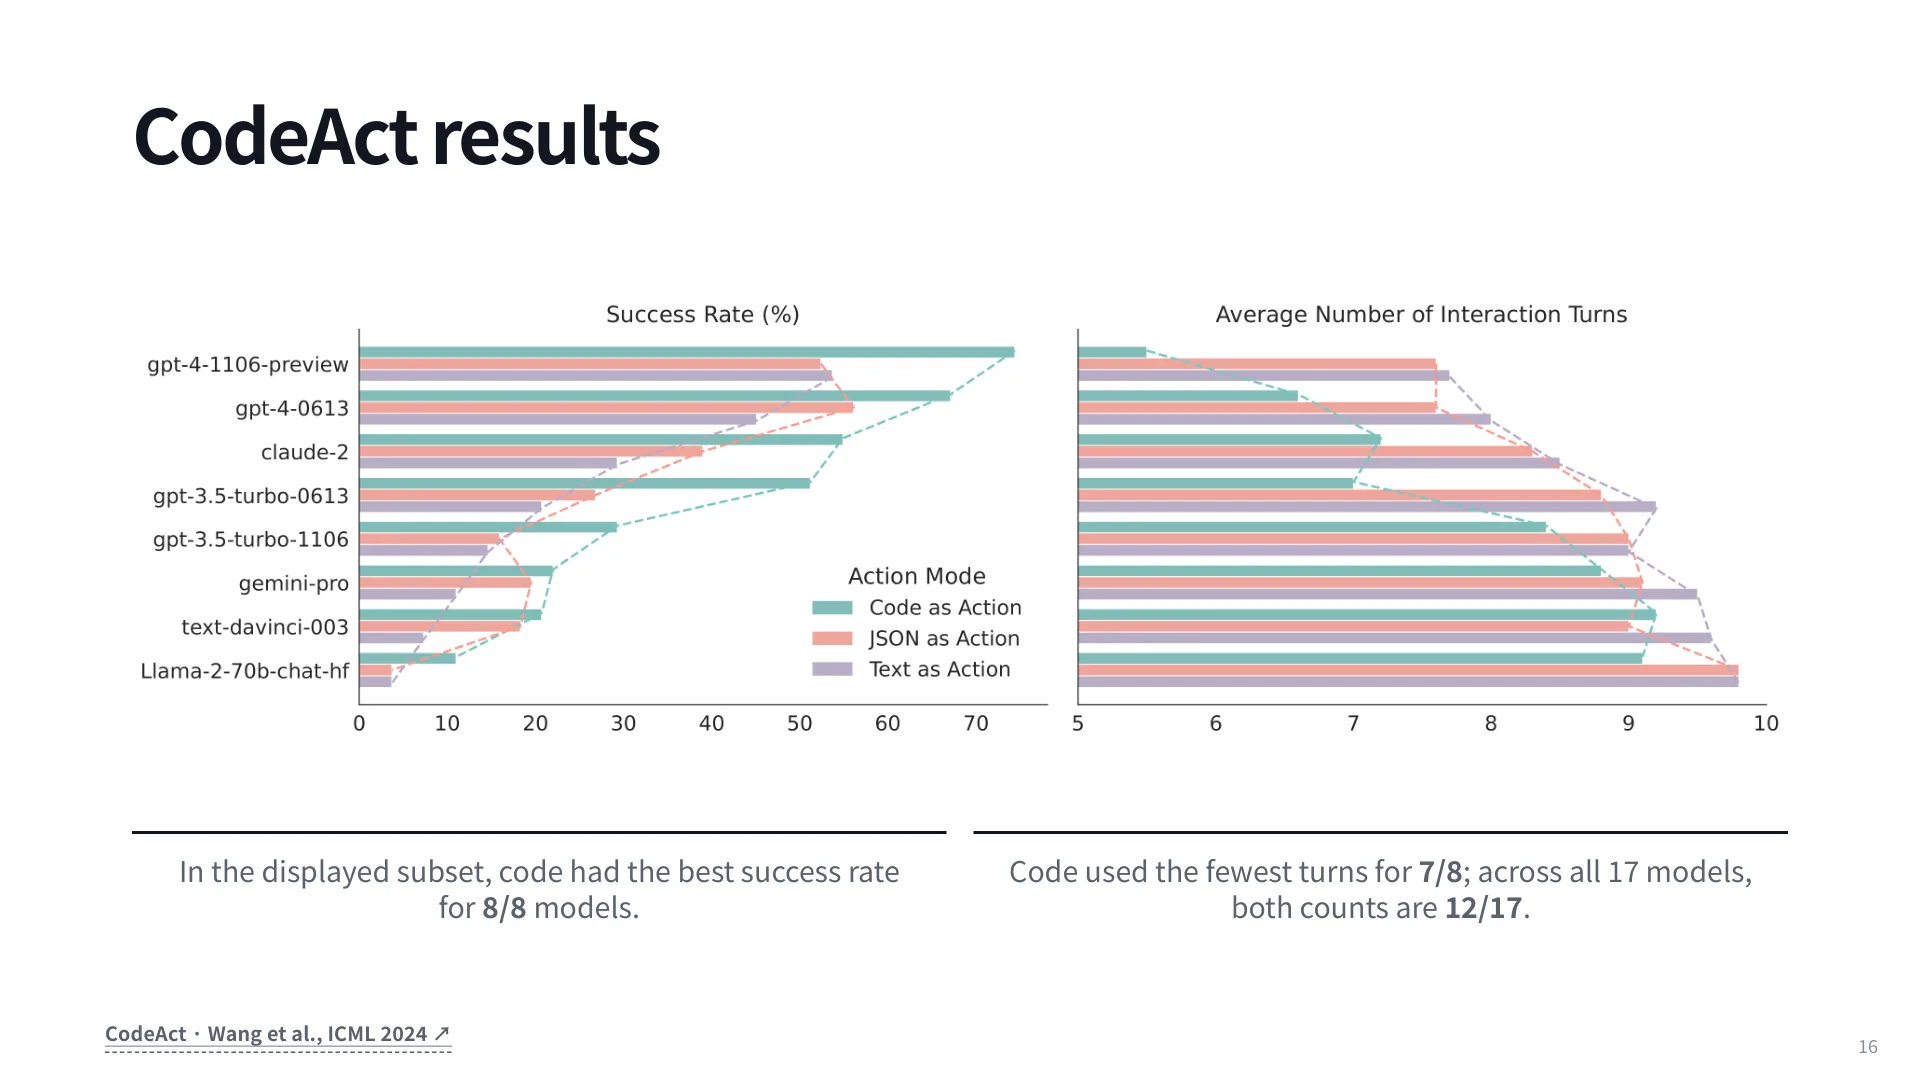
CodeAct 的实验给了这条直觉一个量化支撑。在展示的 8 个模型(GPT-4 两个版本、Claude-2、GPT-3.5 两个版本、Gemini Pro、text-davinci-003、Llama-2-70b)上,代码动作在成功率上 8/8 最优,在交互轮数上 7/8 最少;扩展到全部 17 个模型,两项都是 12/17。这两个数字需要一起读:成功率和轮数是两个不同方向的收益,代码同时改善了它们,说明瓶颈不只是“模型会不会写代码”,而是“多轮接口调用本身在损耗信息”。
别把 CodeAct 读成“代码永远更好”
12/17 意味着仍有 5 个模型不符合这个规律,课件也没有声称代码在所有任务上占优。论文的任务是工具调用类任务,不是所有 agent 任务;在这些任务上代码恰好是更自然的表达媒介。
代价同样明确。表达力带来的是无限循环的可能——一段 while True 就足够让 agent 卡死,harness 必须有超时和中断。库带来的是供应链风险:课件提到当前 agent 安全的一个主要问题是 agent 会拉进一个已被投毒的依赖,于是一个工具的漏洞变成整个系统的漏洞。动作空间变宽之后,校验精度下降:一个窄接口函数的参数可以逐字段检查,一段任意 Python 只能检查它能不能跑。影响面也更大——内存、磁盘、CPU、网络、进程,都是代码能碰到的东西。
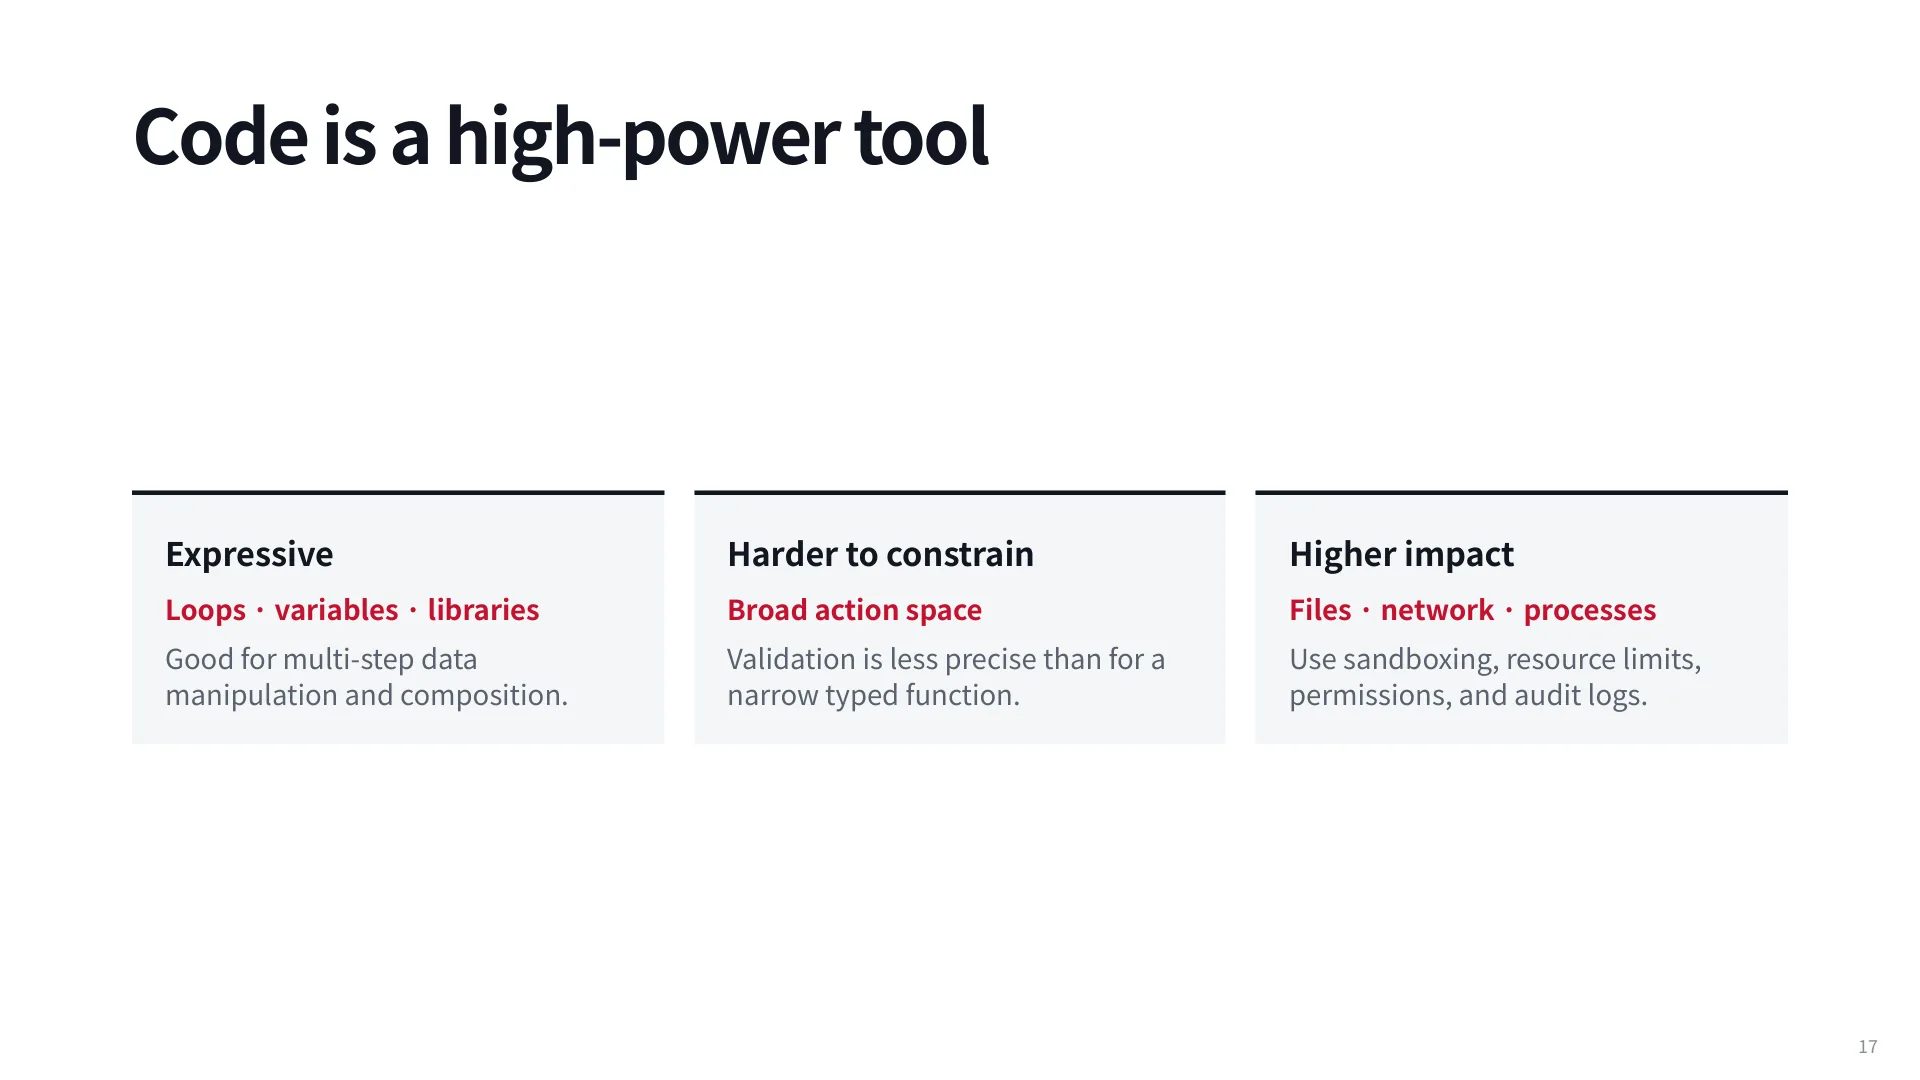
因此课件给出的对策是工程性的而不是算法性的:沙箱、资源限额、权限、审计日志。这四条对应四种失效模式——沙箱限制它能碰什么,限额限制它能用多少,权限限制它能代表谁行动,审计让事后追责成为可能。15:21 处他明确说这些会在安全那一讲展开,这里的结论只是:一旦选择程序化工具调用,隔离与约束就是必须同步设计的东西,而不是上线前再补。
5. 机制:token、模板与协议
5.1 工具调用就是 token
理解了“该不该调”,接下来是“怎么调”。这一层最容易被高层框架掩盖,但它决定了大量实际 bug。
模型输出文本时,是在做文本续写:“The weather is sunny.” 输出工具调用时,是在做另一种续写:先吐出一个特殊的分隔标记,再吐出调用块,最后再吐一个结束标记。两者在解码层面没有区别,都是 token 序列。课件强调这一点,是因为很多人把工具调用想象成某种结构化输出通道,实际上它只是模型学会了在特定标记之间写 JSON。
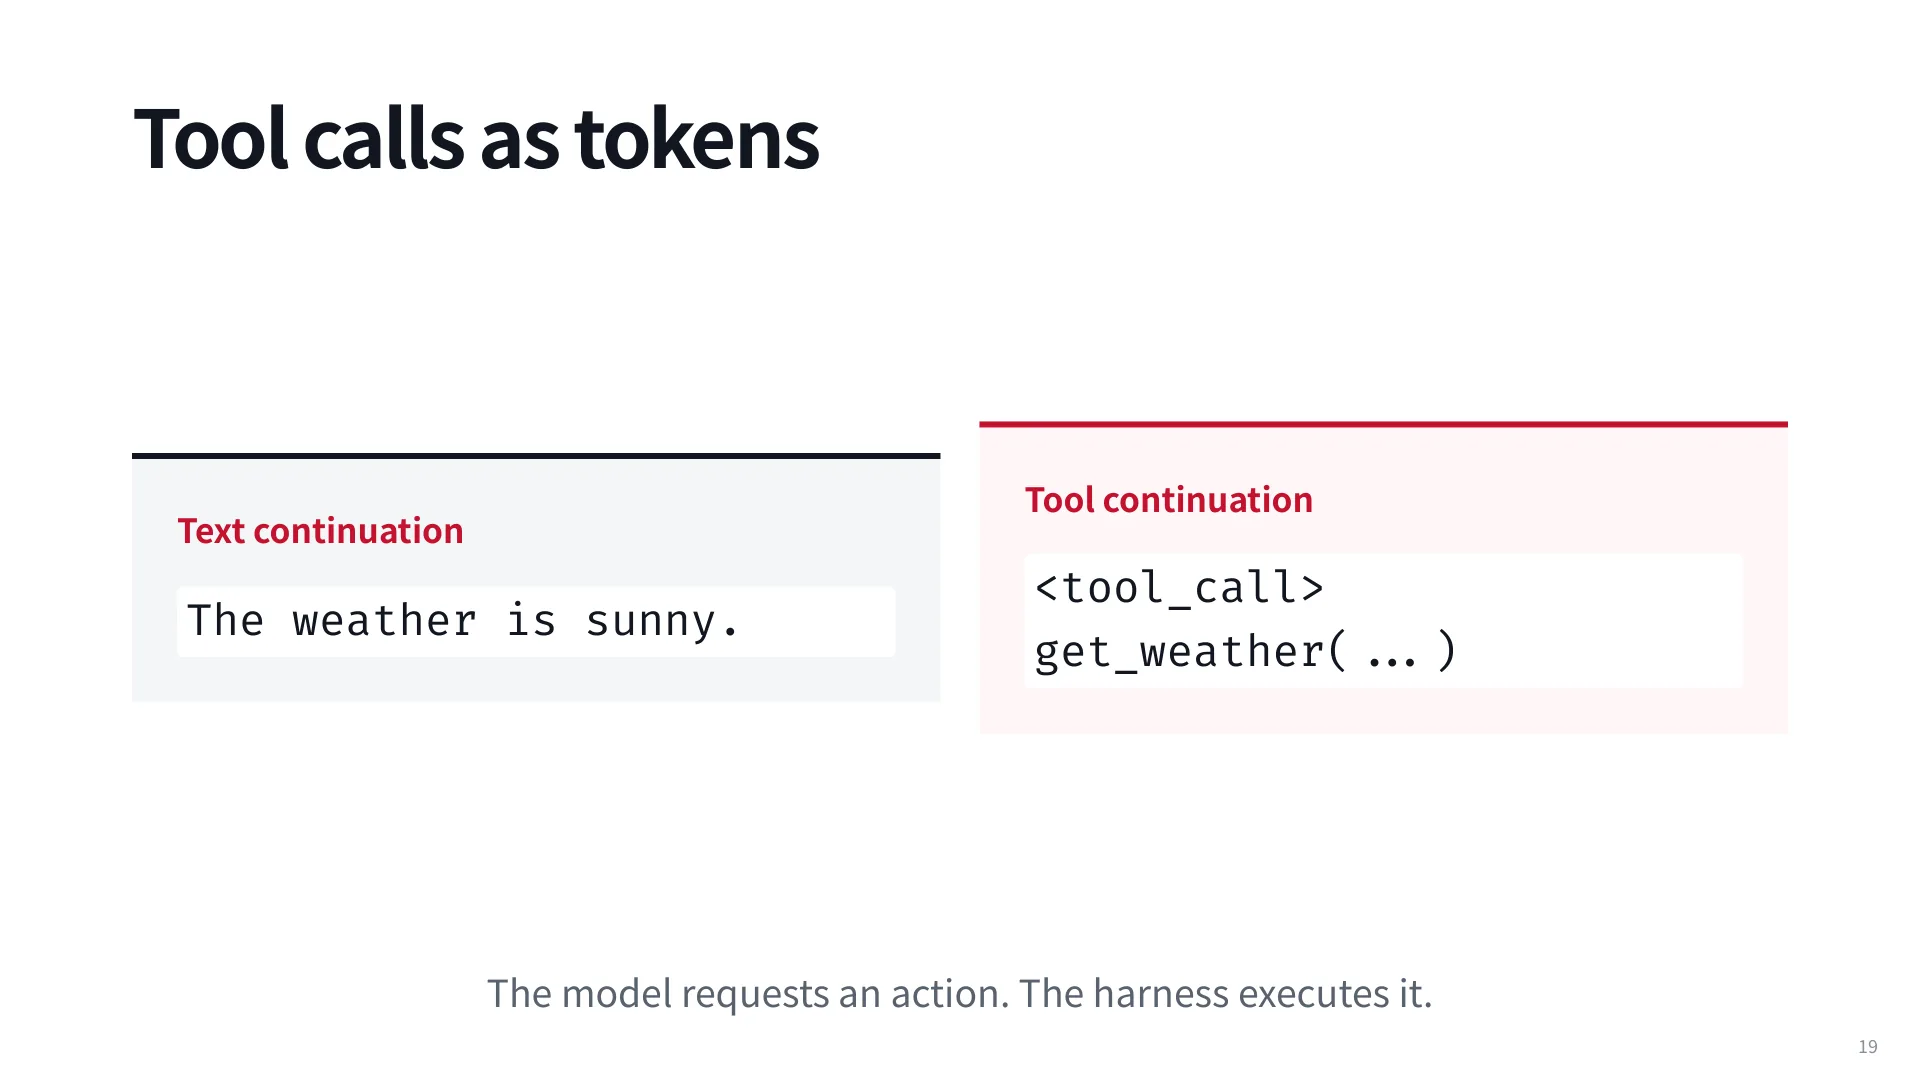
这个视角立刻解释了几件事。第一,ReAct 不再需要外部的循环代码去拼接“Thought/Action/Observation”,它可以被压进一次 completion:先一段给用户看的文字,再一个工具调用块,模型自己就把“说”和“做”排好了。第二,推理模型可以在这之前再插一段更长的 thinking token——那段不展示给用户,展示的是简短消息,执行的才是调用块。第三,既然全是 token,那么这些标记就必须出现在模型词表里,并在中训练或后训练阶段被专门训练过。17:50 处有学生追问“这些特殊 token 是不是预训练时就在词表里”,Graham 的回答很细:在整网语料上预训练时不一定有,更常见的做法是在中训练阶段引入格式数据,再做 RL;所以“模型天生会调工具”是个错觉,它是被专门训练出来的。
这也解释了为什么不同模型的工具调用能力差异很大:格式是训练出来的,训练数据里的格式、标记、字段顺序都会影响模型在边缘情况下的稳定性。
5.2 schema 如何进入 prompt
有了 token 层的认识,下一步是“模型怎么知道有哪些工具”。答案比想象的朴素:工具定义被序列化进 prompt。
在 API 层,你写的是消息列表(system / user / assistant)加一个 tools 参数;在模型层,这些都会被 chat template 渲染成一条扁平的 token 序列。课件用 Qwen 的模板举例:每条消息被 <|im_start|>role ... <|im_end|> 包起来,system 的“Be concise.”和 user 的“Weather in Pittsburgh?”最终变成同一段文本的不同片段。角色是 API 的概念,模板才是模型的输入。
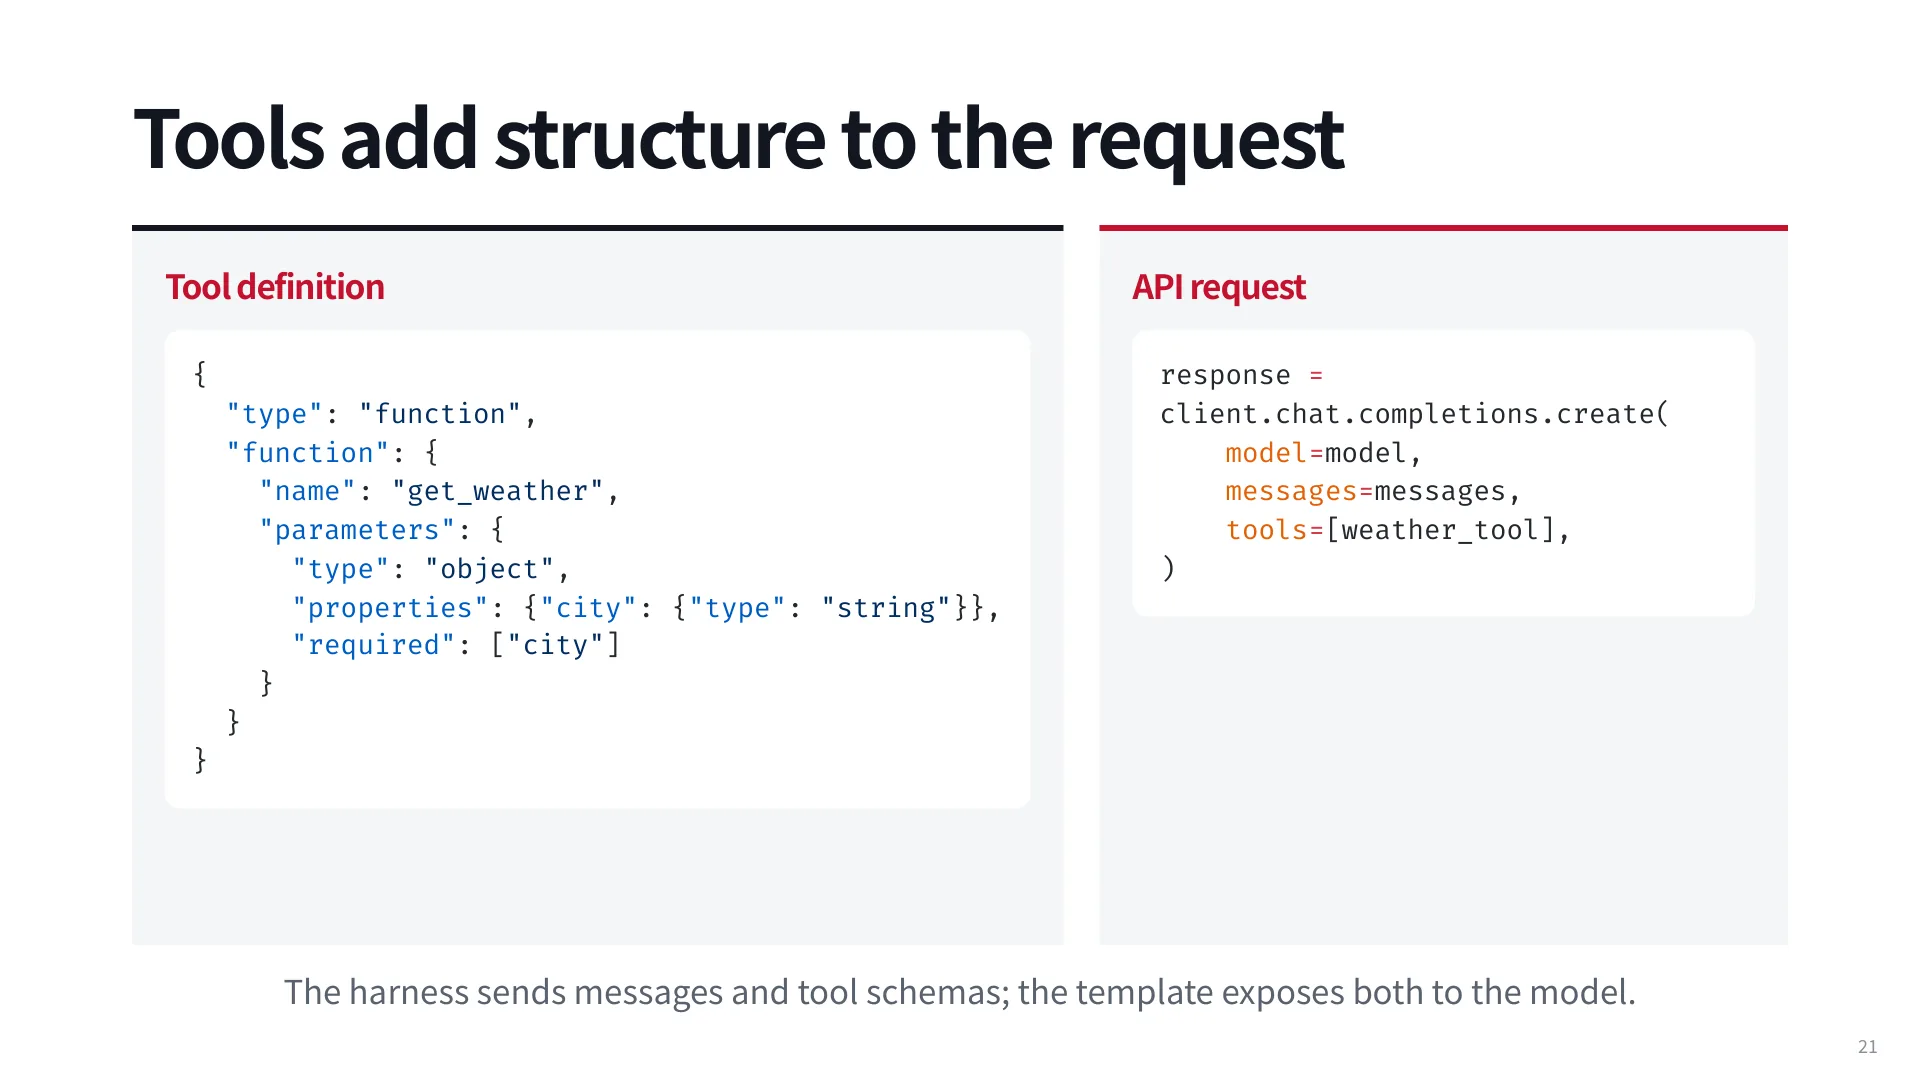
一个工具定义至少包含三样东西:类型(function)、名字(get_weather)和参数对象(city 是 string 且 required)。这份 JSON 会被塞进 prompt 的 <tools> 段。模型看到之后,如果决定调用,就输出 <tool_call>{"name":"get_weather","arguments":{"city":"Pittsburgh"}}</tool_call> 这样的块。注意分工:调用内容由模型生成,call ID 由 API 层附加。这一点在后面配结果时很关键。
5.3 一份 schema,多种协议
真正的麻烦在于,“同一种 schema”并不等于“同一种序列化”。Qwen 用 <function=...> 和 <parameter=...> tag;Mistral 用 [TOOL_CALLS] 控制 token 加一段带 id 的 JSON;DeepSeek 用自己的 DSML 标记,把 function_calls / invoke / parameter 嵌成 XML 风格。三种格式表达的是同一个调用,但字面完全不同。
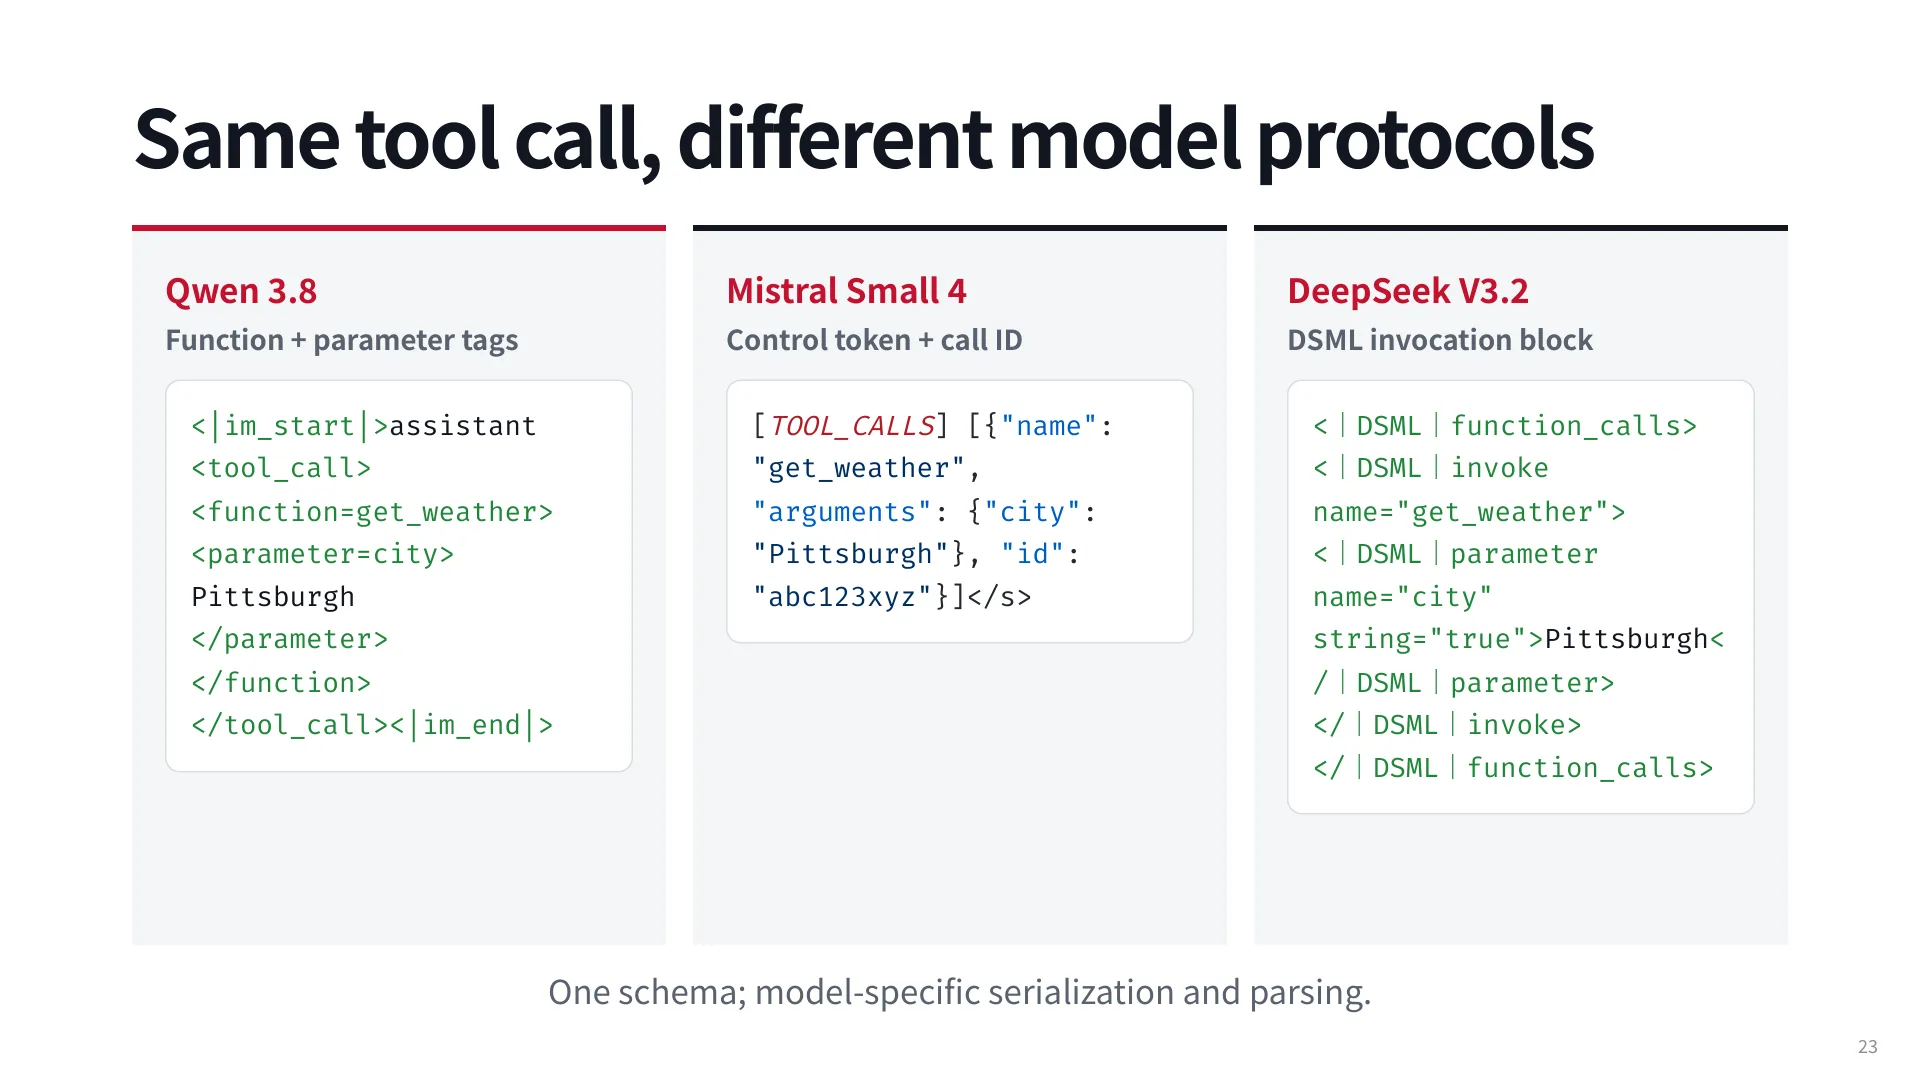
工程含义很直接:解析器不能跨模型复用。你在 DeepSeek 上写好的正则,换到 Qwen 大概率会失效——而且往往不报错,只是解析出空调用,然后 agent 空转。缓解手段是使用 tokenizer 自带的 apply_chat_template,让模板负责序列化与反序列化;如果某个模型的模板没实现好,你要么自己补,要么换模型。Graham 提到微调时的原则更强:如果你在一个已经训练过工具格式的模型上做 SFT,必须严格匹配它原本的格式,不要试图教它一种新协议。
21:05 处他说得很直白:不能假设某段解析代码在 DeepSeek 上能用,在 Qwen 上也能用。这类 bug 的恶劣之处在于它不崩溃,只是让 agent 变得“莫名其妙不调工具”。
6. harness 如何分发:从注册到 call ID
模型吐出调用块之后,控制权交回 harness。OpenHands 的实现把这一过程拆成两个阶段,这个拆法很值得作为设计模板。
初始化阶段:拿到工具规格(比如 BashTool),调用 resolve_tool(spec, state) 把它解析成具体配置,存进 tools_map[name]。每个条目是一个 ToolDefinition,包含三部分:schema(给模型看的)、Action(参数的类型化表示)、executor(真正执行的函数)。把“给模型看的描述”和“给机器执行的代码”放在同一个结构里,是为了保证两者不会漂移。
每次调用阶段:解析 {name, args} → 查表 → 校验(action_from_arguments(args),这一步会把 dict 转成 Action,类型不对就在这里炸)→ 执行 executor(action) → 返回一个带 call_id 的 ObservationEvent。
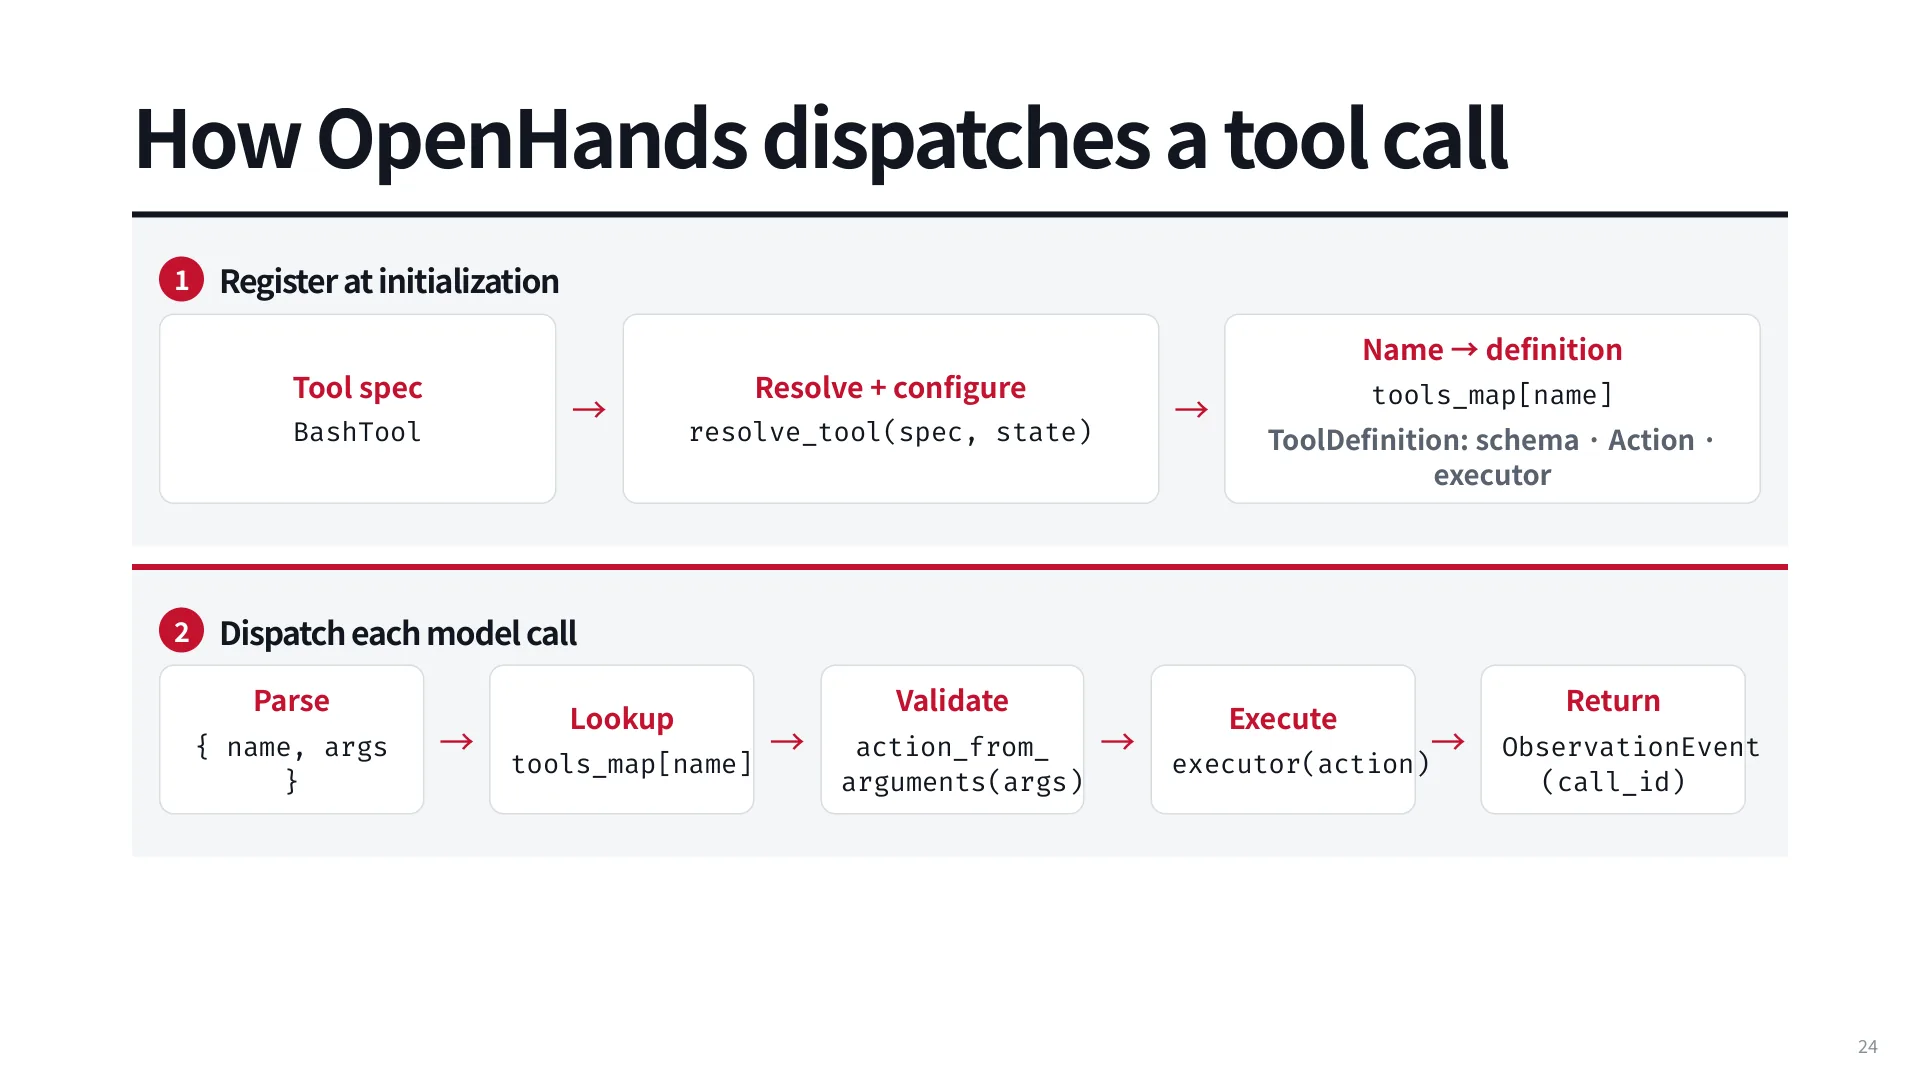
这条流水线里有两个失败点,性质不同。校验失败是显式的:参数缺字段、类型不对、枚举值不合法,schema 能拦住。执行失败是隐式的:一个 execute_code 工具可以接受任何字符串,因为任何字符串都是合法的“代码参数”,但那段代码可能语法错误、可能抛异常、可能长时间不返回。课件专门点出这个区别,因为很多人以为“有 schema 就安全了”,实际上 schema 只覆盖了第一类。
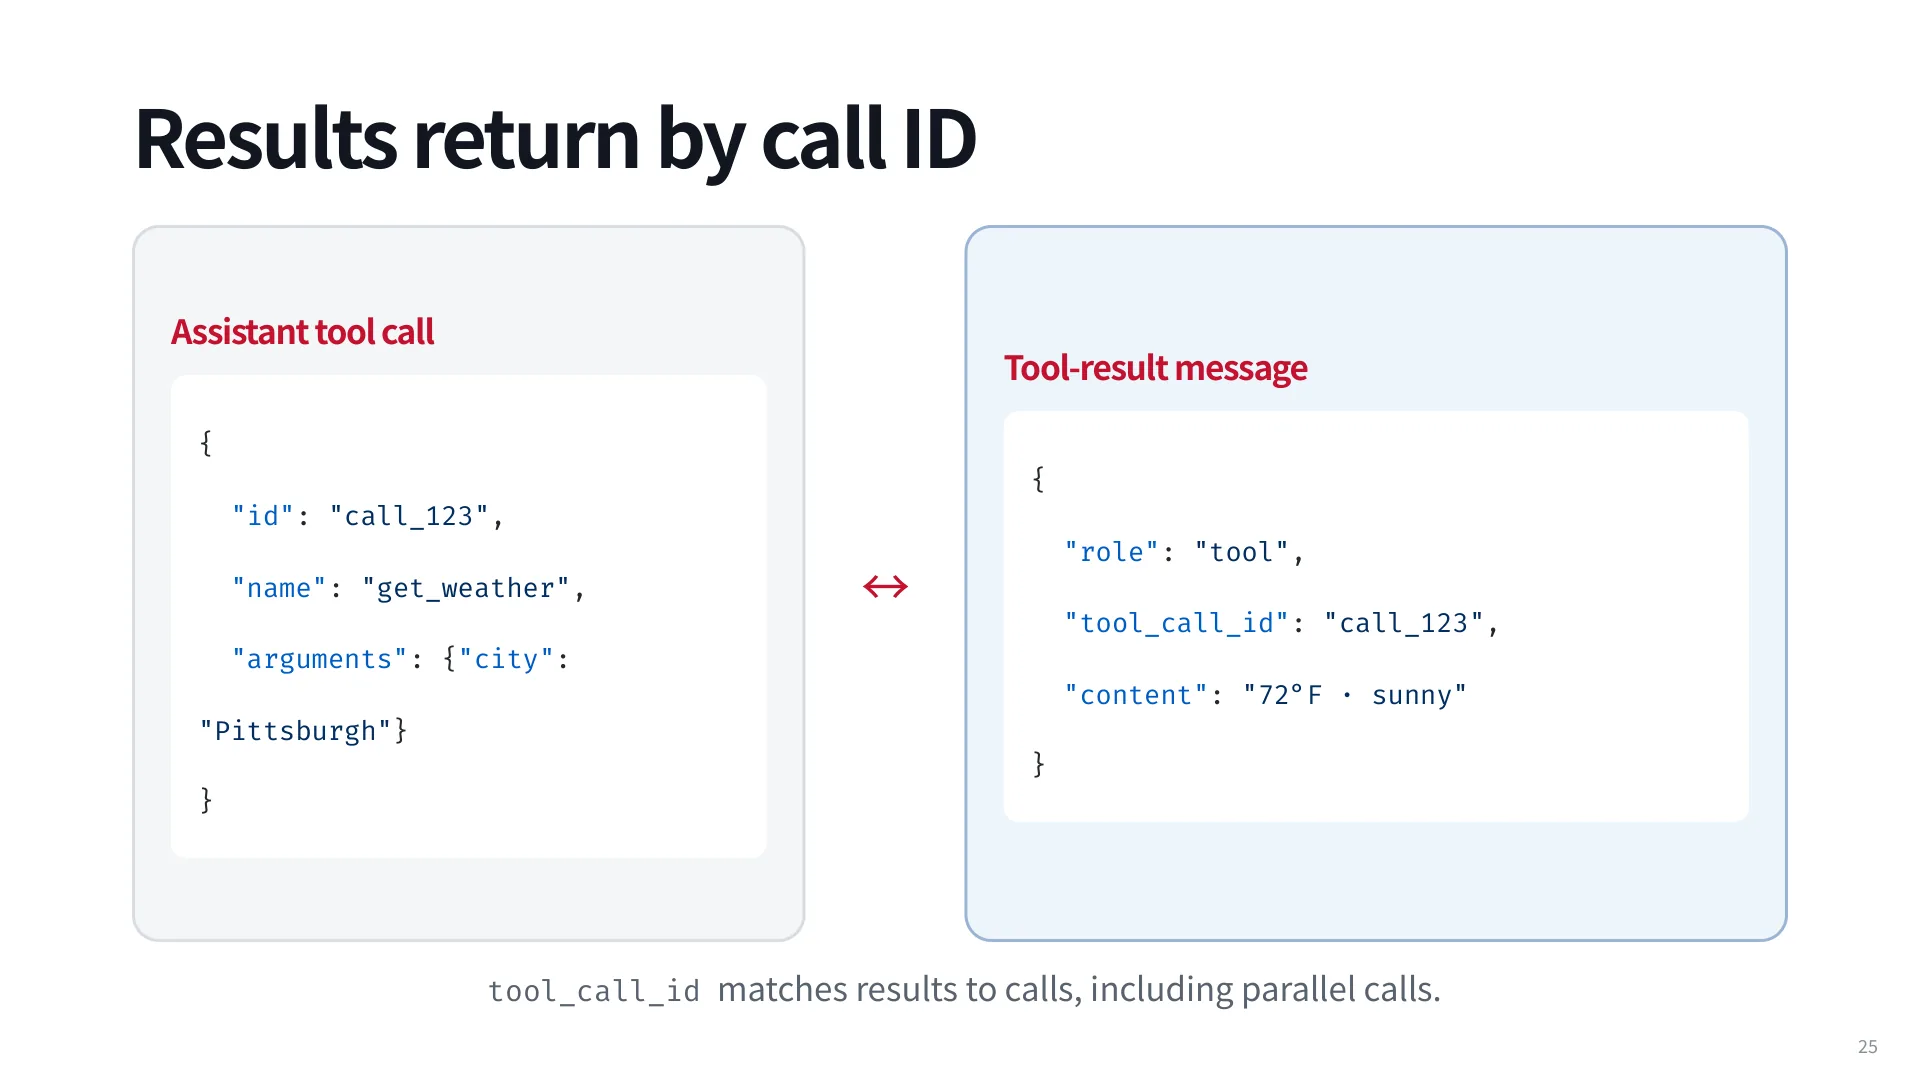
结果回传依赖 call ID。assistant 消息里的调用带 id: "call_123",工具结果消息用 role: "tool" 加 tool_call_id: "call_123" 配对。串行时这看起来多余——顺序不就是对应关系吗?并行时就不是了:三个调用同时发出,谁先返回不确定,只有 ID 能保证配对正确。课件用“including parallel calls”一句带过,但这是并行工具调用能成立的前提。
25:53 处有一个非常实操的坑:Anthropic 的 API 在遇到“有 tool call 但没有对应 tool result”的历史时会直接拒绝生成。这在正常流程里不会发生,但进程崩溃、结果没写回、断点续跑时会。于是你会遇到一个看似无解的状态:模型说“我要调工具”,历史里却没有结果,而 API 不允许你继续。工程上的解法是补一个占位的错误结果,或者回滚到最后一条完整消息——这类细节不会出现在论文里,但会占掉你写 harness 的第一个下午。
7. 约束解码:从 JSON Schema 到 token mask
到这里,模型可能吐出格式错误的调用——比如少一个右花括号的 JSON。最糟的应对是写正则去补括号,课件明确反对这种做法:它不可靠,而且掩盖了真正的问题。正确的方向是让错误在生成时就不可能出现。
课件把约束分成四层,层层递进:syntax(是合法 JSON)、shape(该有的字段都有)、types(city 是字符串)、values(units 只能是 C 或 F)。这四层都可以用 JSON Schema 表达,而 JSON Schema 本身是机器可读的,于是“校验”可以前移成“约束”。
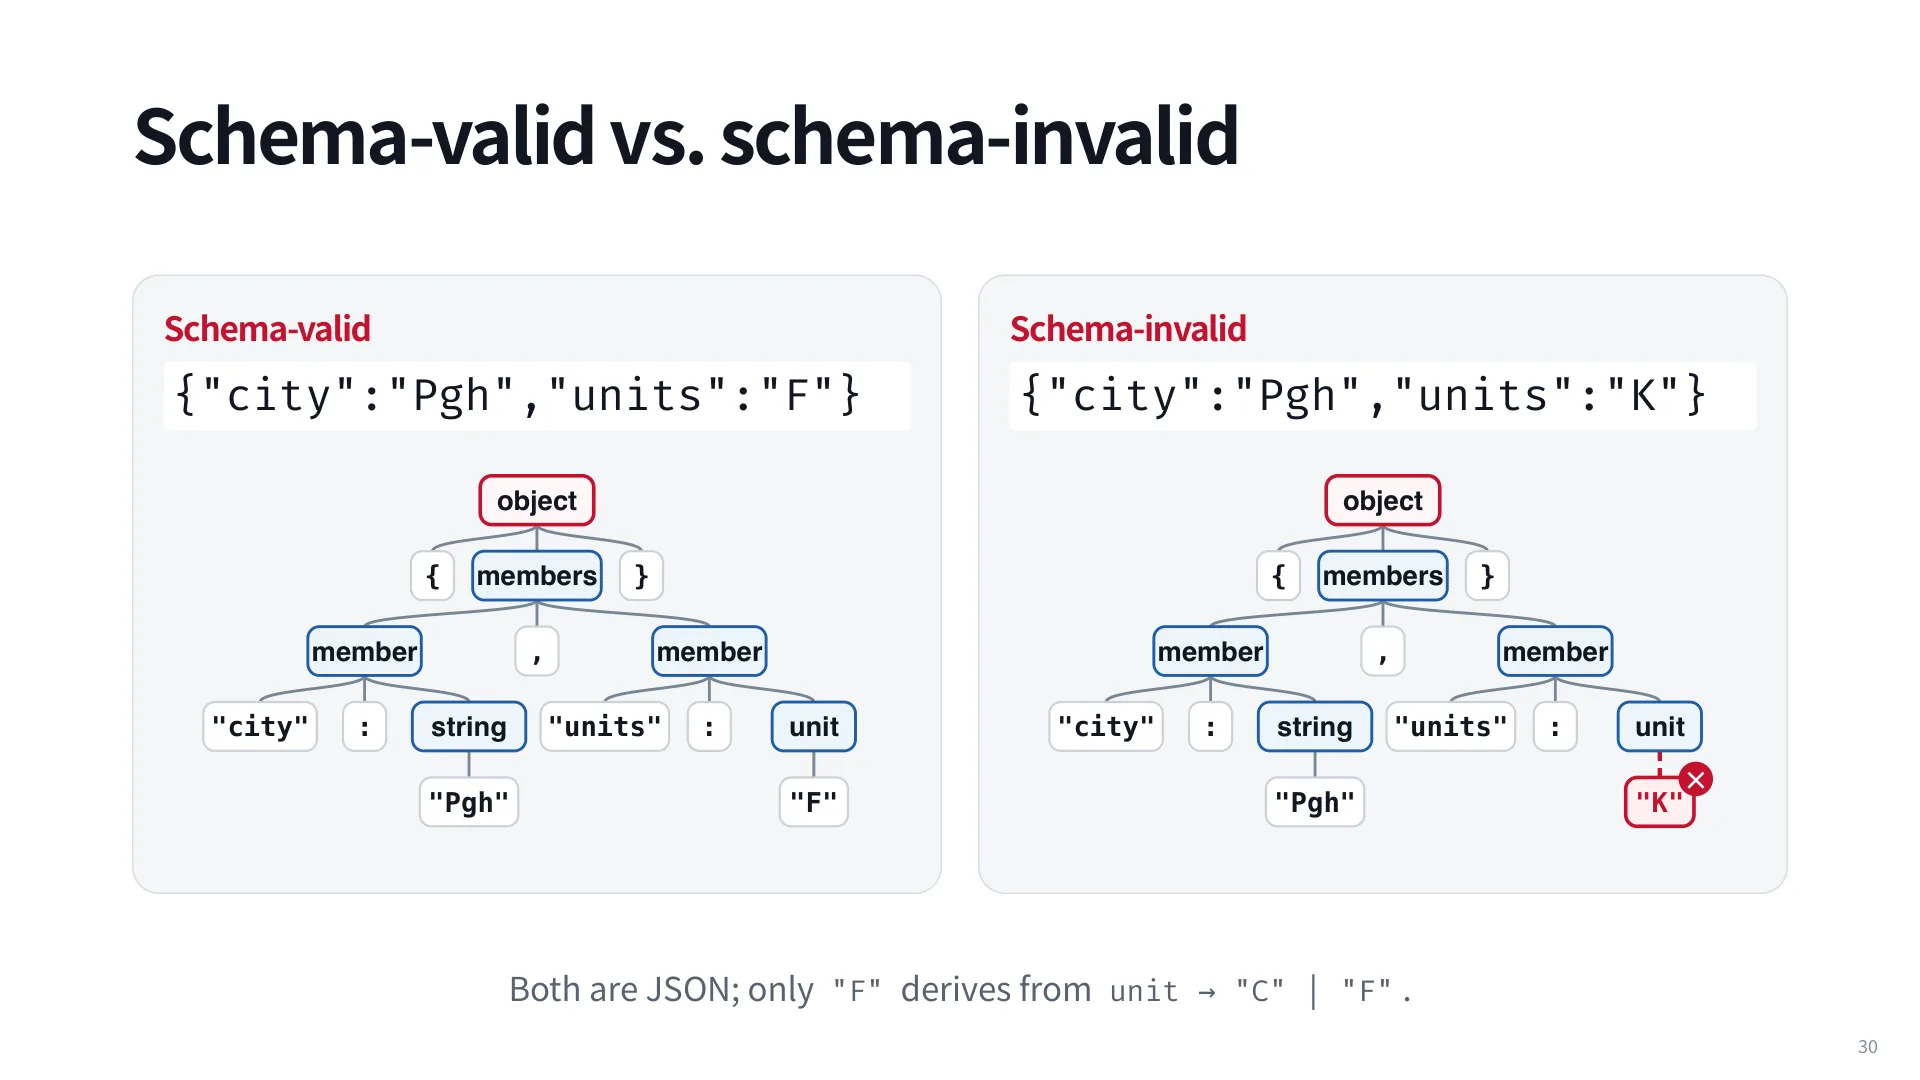
课件用两棵树说明这个区别。{"city":"Pgh","units":"F"} 能推导出 object → member, member,其中 "F" 来自 unit → "C" | "F",树完整。{"city":"Pgh","units":"K"} 的 JSON 结构同样合法,但推到 unit 时 "K" 不在产生式右侧,树长不出来。这就是“语法正确”和“schema 正确”的分界:前者是 JSON 解析器的事,后者是文法的事。
JSON Schema 无法用正则表达,因为它需要任意深度的嵌套。正则对应有限状态自动机,而嵌套需要记忆——所以要用下推自动机(PDA):在有限状态之外加一个栈,遇到 { 压栈、遇到 } 弹栈,栈空且到达接受状态才算合法。30:53 处他由正则表达式过渡到 CFG,31:42 处再引出 PDA;这条线索是理解 XGrammar 的前提:状态记录“当前在文法的哪条规则里”,栈记录“嵌套该返回到哪里”。
真正棘手的地方在 token 与字符的错位。文法的终结符是字节级的,而模型的输出单位是 token;一个 token 可能跨越好几个文法符号,也可能停在一个符号中间——比如 "F"} 这个 token 解码出来是 22 46 22 7D 四个字节,横跨字符串、闭引号、闭括号。所以不能把 token 边界当文法边界,必须在字节层面推进 PDA。
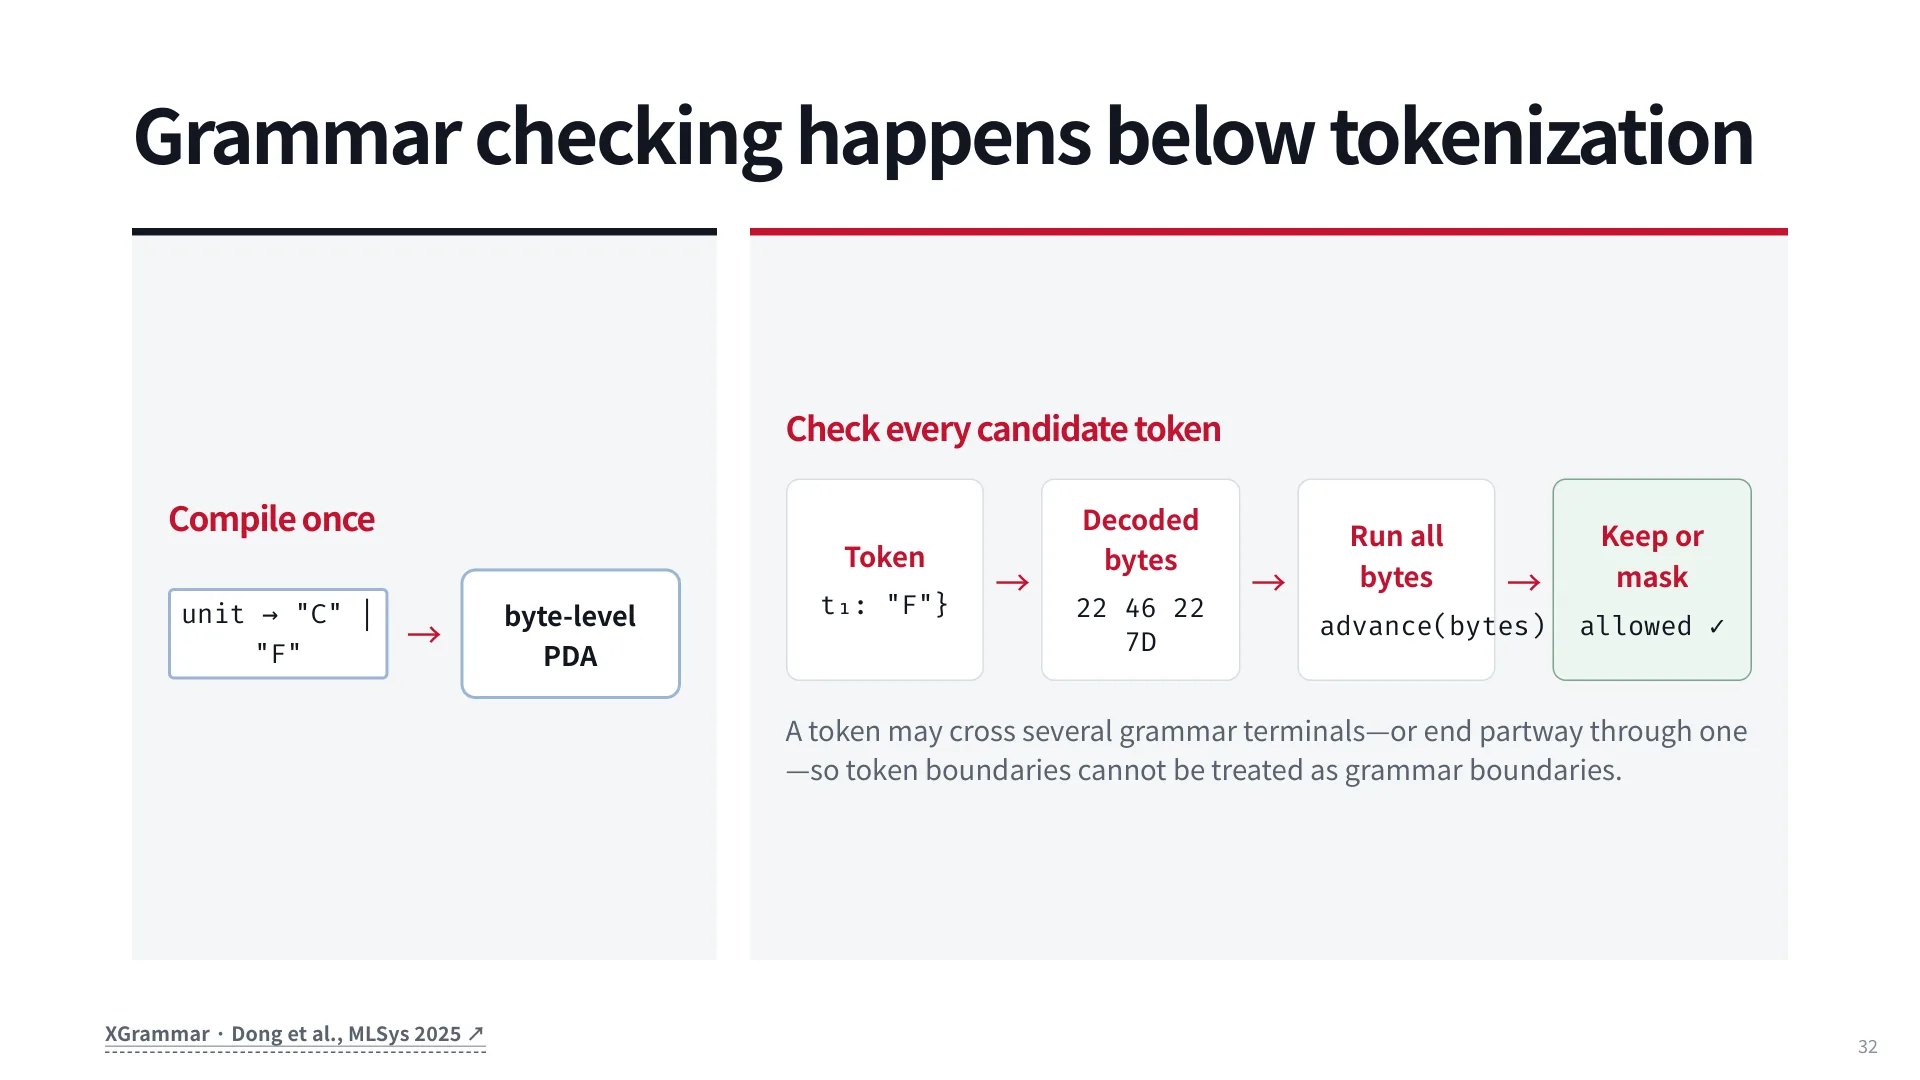
XGrammar 的做法可以概括为“编译一次,逐 token 掩码”。整份 schema 先编译成字节级 PDA;每步解码时,把候选 token 解码成字节序列,喂给 PDA,能走通的保留、走不通的 mask 成 ,再对剩余 logits 重新归一化后采样。形式上,如果 是词表里的第 个 token, 是当前 PDA 状态下合法的 token 集合,那么
这个式子的代价是每步都要对词表做一次合法性判断,而词表规模远大于文法符号的数量,逐 token 跑 PDA 是不可接受的。所以工程上的关键在于缓存:大多数 token 的合法性只取决于栈顶节点而与上下文无关,可以预计算成一张表;只有少数依赖完整栈的 token 才需要现场判断;同时把 CPU 上的文法计算与 GPU 上的前向重叠起来。
34:17 处有一个很好的边界问题:什么情况下约束解码也会失败?答案是token 预算耗尽。你可能一直走在合法路径上,但还没走到接受状态就没 token 了,输出被截断,JSON 依然不完整。理论上可以在接近上限时优先走向可终止的路径,但这需要把“还剩多少 token”接进文法状态,课件把它留成了开放问题。这个细节提醒我们:约束解码消除的是“模型不会写 JSON”,不是“系统保证有结果”。
形式正确 ≠ 语义正确
约束解码保证的是语法、结构、类型、枚举值。它不保证城市拼对了、不保证参数在业务上合理、不保证选对了工具、更不保证任务成功。把 schema 当成正确性保证,是这一层最常见的误解。
8. 接口之一:库、REST 与 OpenAPI
工具最终要落到某个可调用的东西上。课件从最朴素的形式讲起:一个进程内的 Python 函数。
# weather_lib.py
from typing import Literal
from pydantic import BaseModel

class Weather(BaseModel):
    summary: str
    temperature: float

def get_weather(city: str, units: Literal["C", "F"] = "F") -> Weather:
return provider.lookup(city, units)这个函数有名字、有类型、有返回值模型,对同进程的调用者来说信息是完整的。但它不能被远程调用——网络客户端还需要地址、协议、序列化、认证。库 API 是编程接口,不是网络服务,这个区别在“程序化工具调用”里无所谓(agent 就在同一个进程里跑代码),在“标准工具调用”里就是硬伤。
把库函数变成 REST 端点,FastAPI 的改动很小:一个 APIKeyHeader 声明鉴权头,一个 @app.get("/weather", operation_id="get_weather") 装饰器绑定路径,函数体里验证 key 再转发。这一步的收益有两个:一是访问控制,你能拦住没有 key 的调用者;二是免费的 schema——整个 API 会被自动描述成 OpenAPI 文档,而 OpenAPI 里的每个参数都内嵌 JSON Schema。
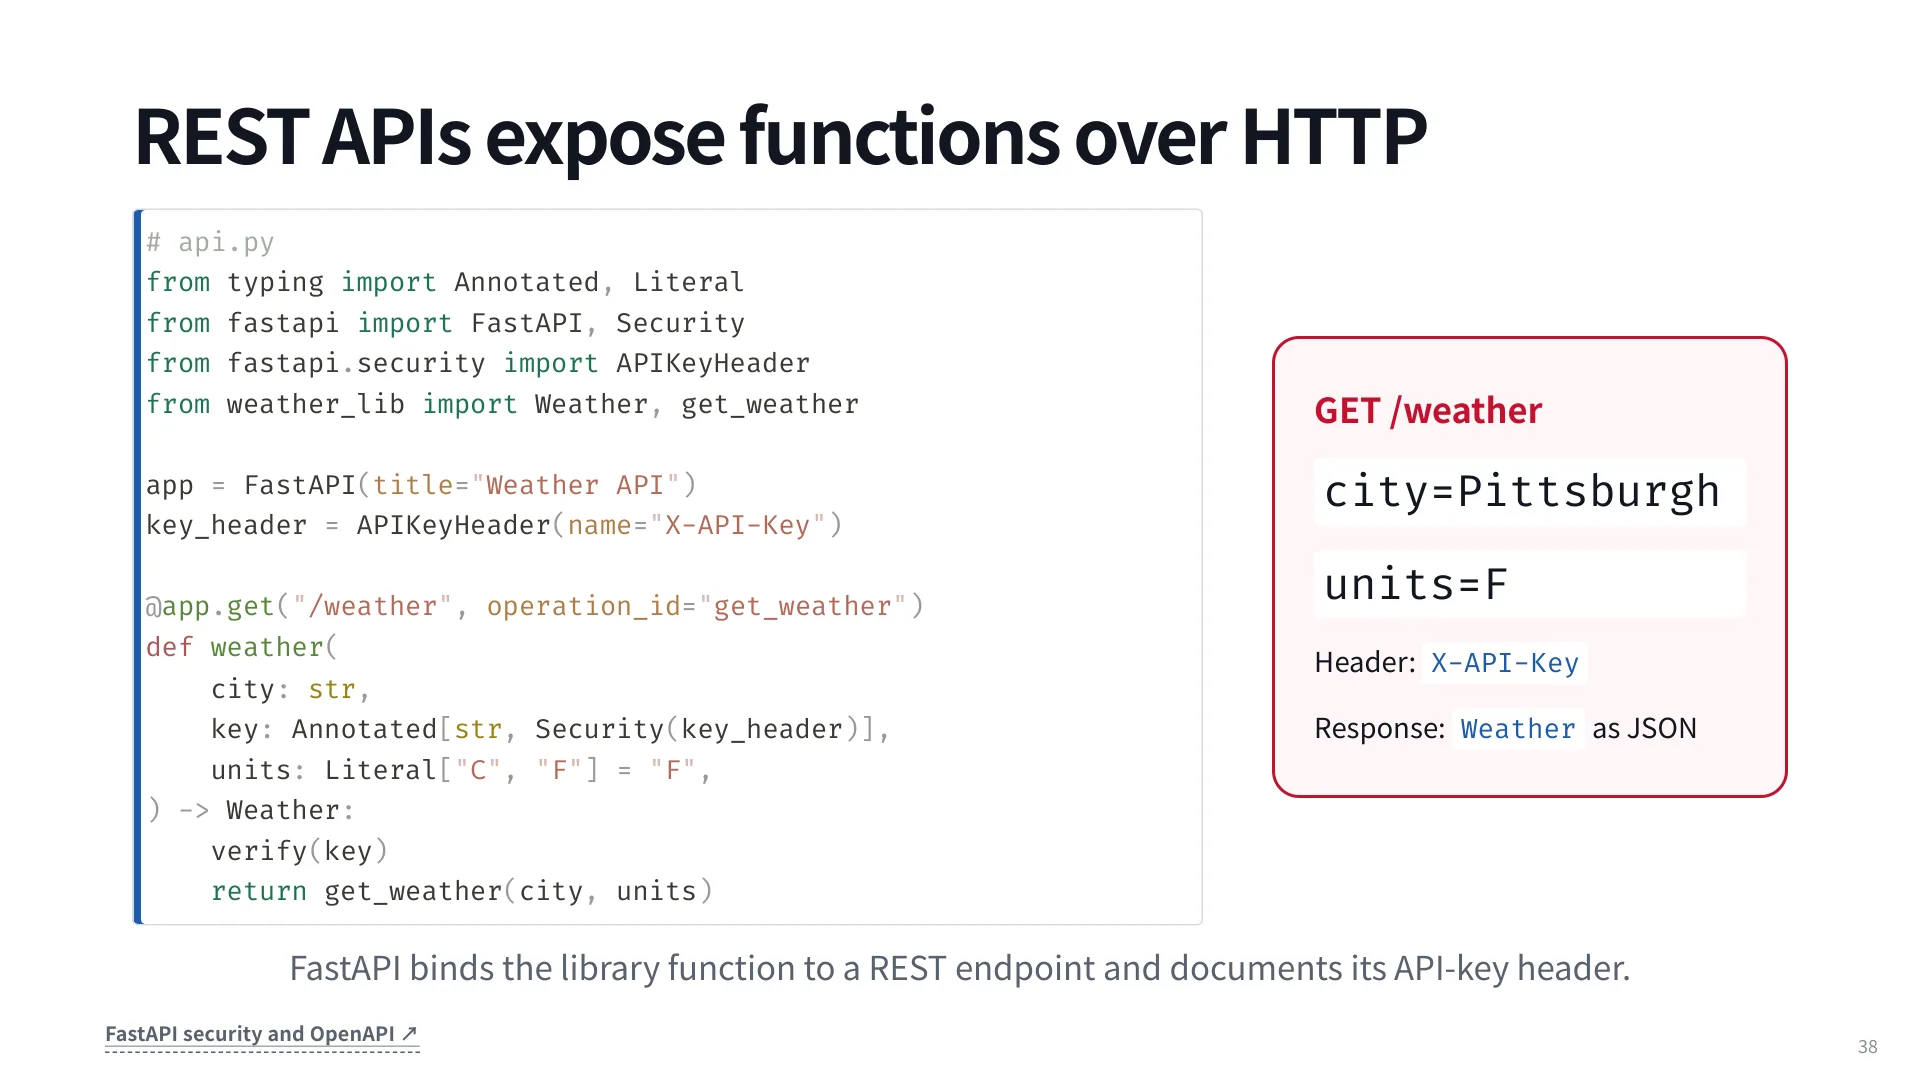
这份 OpenAPI 文档可以几乎原样喂给模型:operationId 变成工具名,parameters 里的 schema 变成参数约束,securitySchemes 告诉调用方需要哪个头。也就是说,写好后端就等于写好了工具定义,这是 REST 路线最实际的优势。
如果 agent 有 shell,还有一条更短的路:curl。构造一条带 --data-urlencode 和 -H "X-API-Key: $WEATHER_API_KEY" 的命令,shell 展开环境变量,请求就发出去了。对 coding agent 来说这几乎是零成本,因为它本来就会用 bash。38:26 处他演示了 curl 这条路,课件 Slide 40 则点出了它的根本问题:凭据落在了 shell 里。agent 能读环境变量,就能把它写进日志、提交到仓库、或者发给别的地方。这个风险不是理论上的——把 GitHub token 交给一个会 git push 的 agent,是最经典的翻车场景。
9. 接口之二:MCP 与凭据代理
MCP(Model Context Protocol)由 Anthropic 提出,目标是给模型提供上下文的标准方式。Graham 坦白他最初的反应是“为什么需要这个,直接调 API 不就行了”——这个怀疑值得保留,因为理解 MCP 的价值必须先理解它解决的不是“能不能调”,而是“谁来持有凭据”。
拓扑上,MCP 是 host-client-server:AI 应用作为 host,内部跑若干个 client,每个 client 连一个 server。传输可以是本地 stdio(比如文件系统 server 直接跑在你机器上),也可以是远程 HTTP(比如 Sentry server)。这个结构本身不新鲜,任何插件系统都长这样。
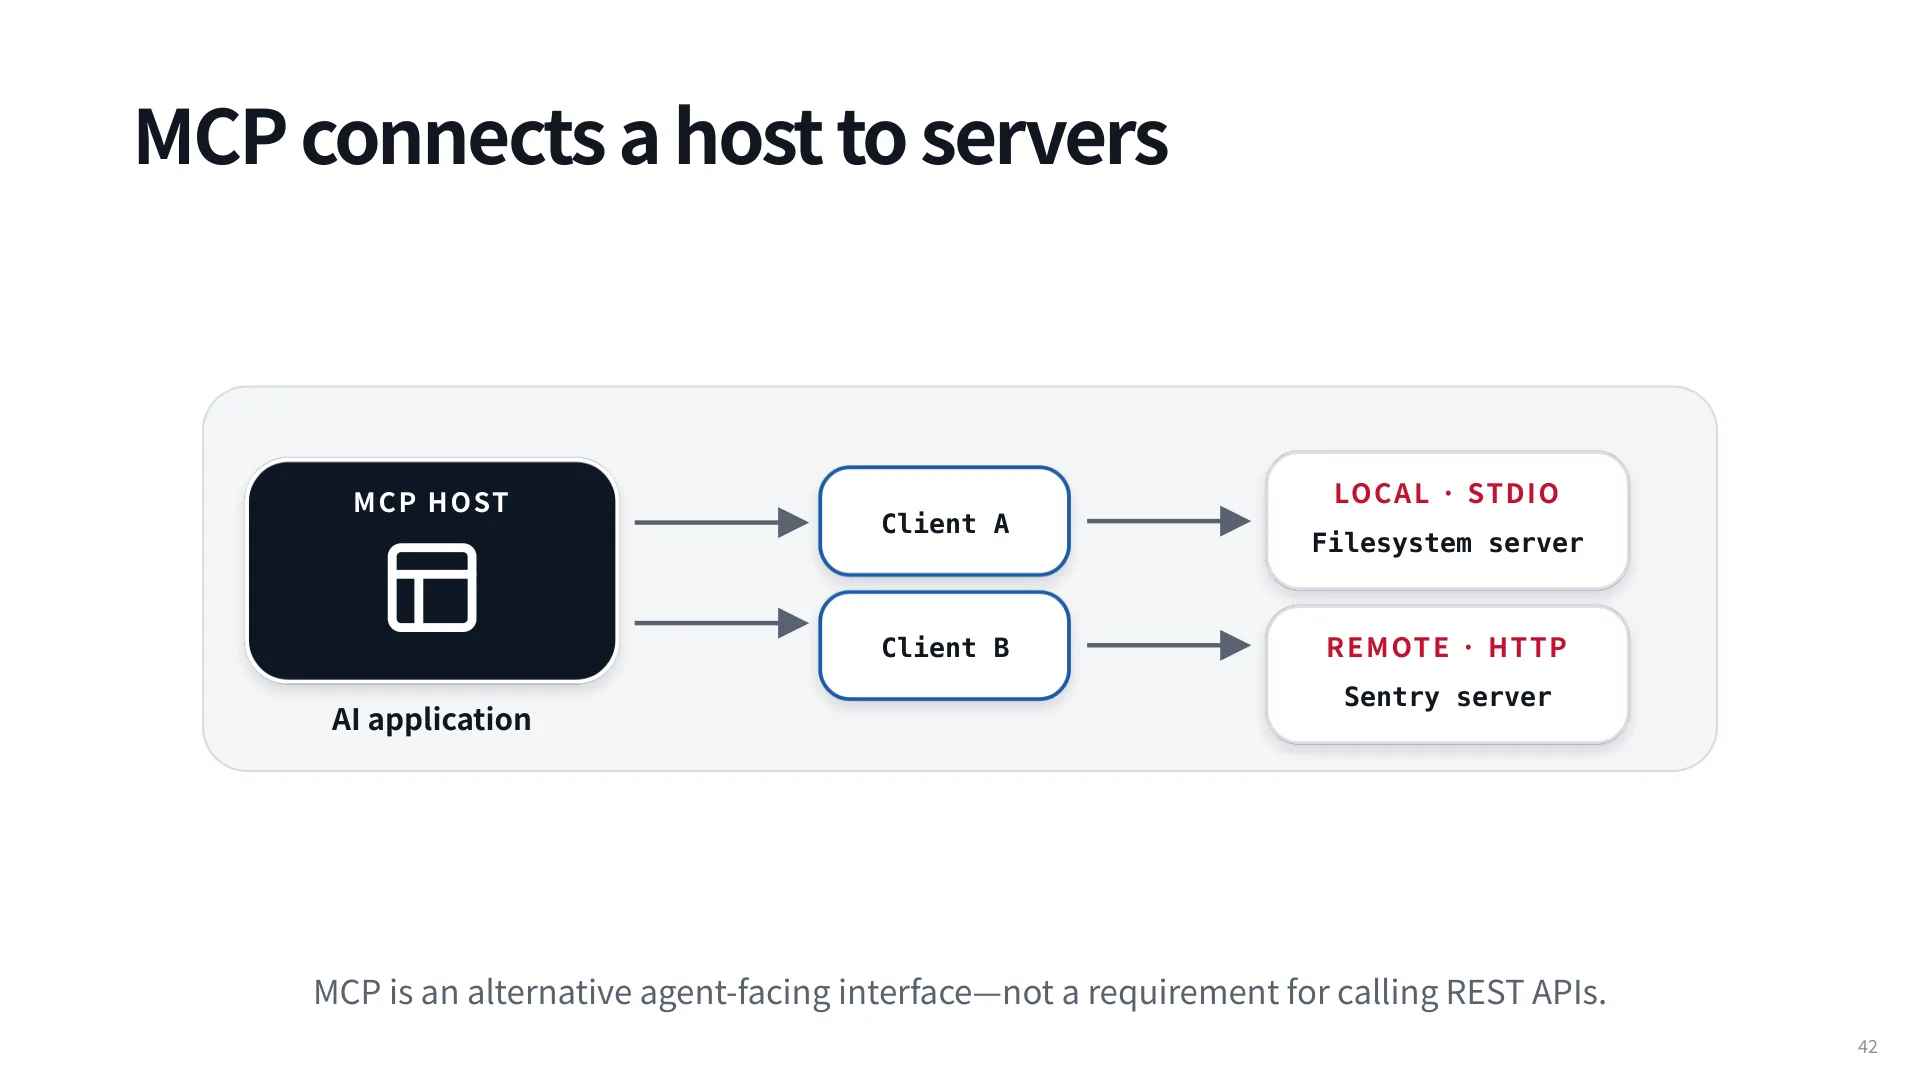
真正的差别在鉴权。MCP 把凭据拆成两把:MCP API key 给 agent 侧,用来连 MCP server;upstream API key 给 server 侧,用来连真正的服务。agent 只持有前者。41:48 处他把这个动机讲得很具体:如果 agent 拿到的是你的 GitHub token,而它某天决定把这个 token push 到公开仓库,你的账号和所有仓库就都完了;如果它拿到的是一个只能访问特定 MCP 端点的 key,即使泄漏,损失也被限制在服务端愿意代理的范围内。
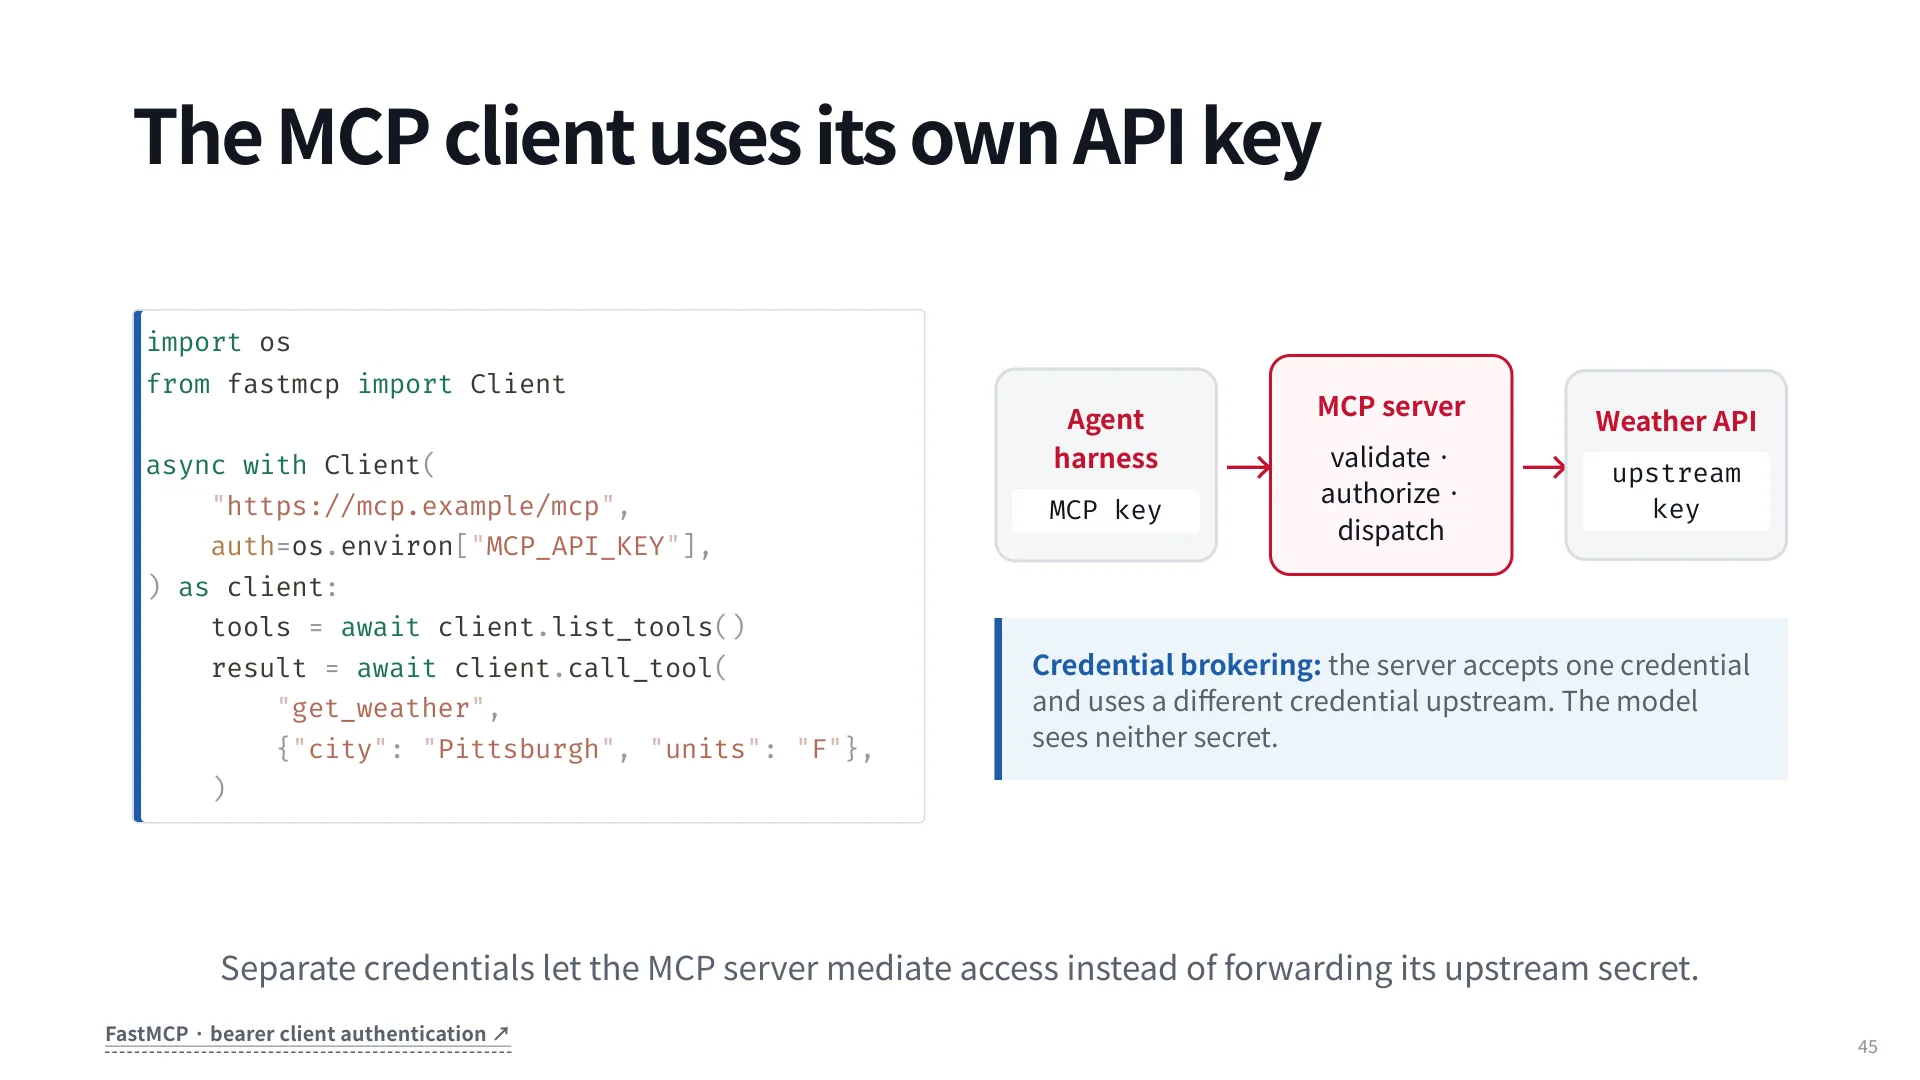
这个模式叫凭据代理(credential brokering):server 接受一种凭据,用另一种凭据向上游发请求,模型两个都看不到。它还带来两个附带好处——审计集中在 server 侧(谁在什么时候调了什么,一目了然),权限可以在 server 侧收窄(同一个上游 key,只暴露读接口)。课件也提醒,教学里用的静态 token 只适合开发,生产应该验 JWT 或走 OAuth。
MCP 与 REST 的对照可以整理成一张表。共享的部分是名字、描述和 JSON Schema;不同的部分是发现、调用、鉴权、范围。
| 维度 | OpenAPI / HTTP API | MCP |
|---|---|---|
| 发现 | 拉取 OpenAPI 文档 | 运行时 tools/list |
| 调用 | HTTP 动词 + 路径 + 参数 | 通过传输层发 tools/call |
| 鉴权 | client 直接对 API 认证 | client 对 MCP 认证,上游认证另行处理 |
| 范围 | 描述 HTTP 操作 | 还支持 resources、prompts、extensions |
从工程角度看,MCP 并没有让“调工具”变简单,它让“分发工具”和“管理凭据”变简单。FastMCP 这类库的存在说明两件事可以低成本互转:给定一份 OpenAPI spec,FastMCP.from_openapi 能把每个路由投影成一个可发现的 MCP 工具。所以选择往往不是技术性的,而是组织性的——谁负责保管上游密钥,谁负责审计,谁负责限流。
10. 多调用编排:串行、并行与依赖
单个调用的成本可以接受,串起来就不一定了。课件给了一组具体数字:生成 0.8s、天气 1.2s、生成 0.8s、日历 0.9s、生成 0.8s、航班 1.1s、生成 0.8s,总和约 6.4 秒。四个生成阶段加三个工具,每个都要等前一个结束。
如果这三个工具互不依赖,就可以让模型在一轮里吐出三个调用块,harness 并发执行,再把三个结果一起送回。此时只需要两个生成阶段加最慢的那个工具:
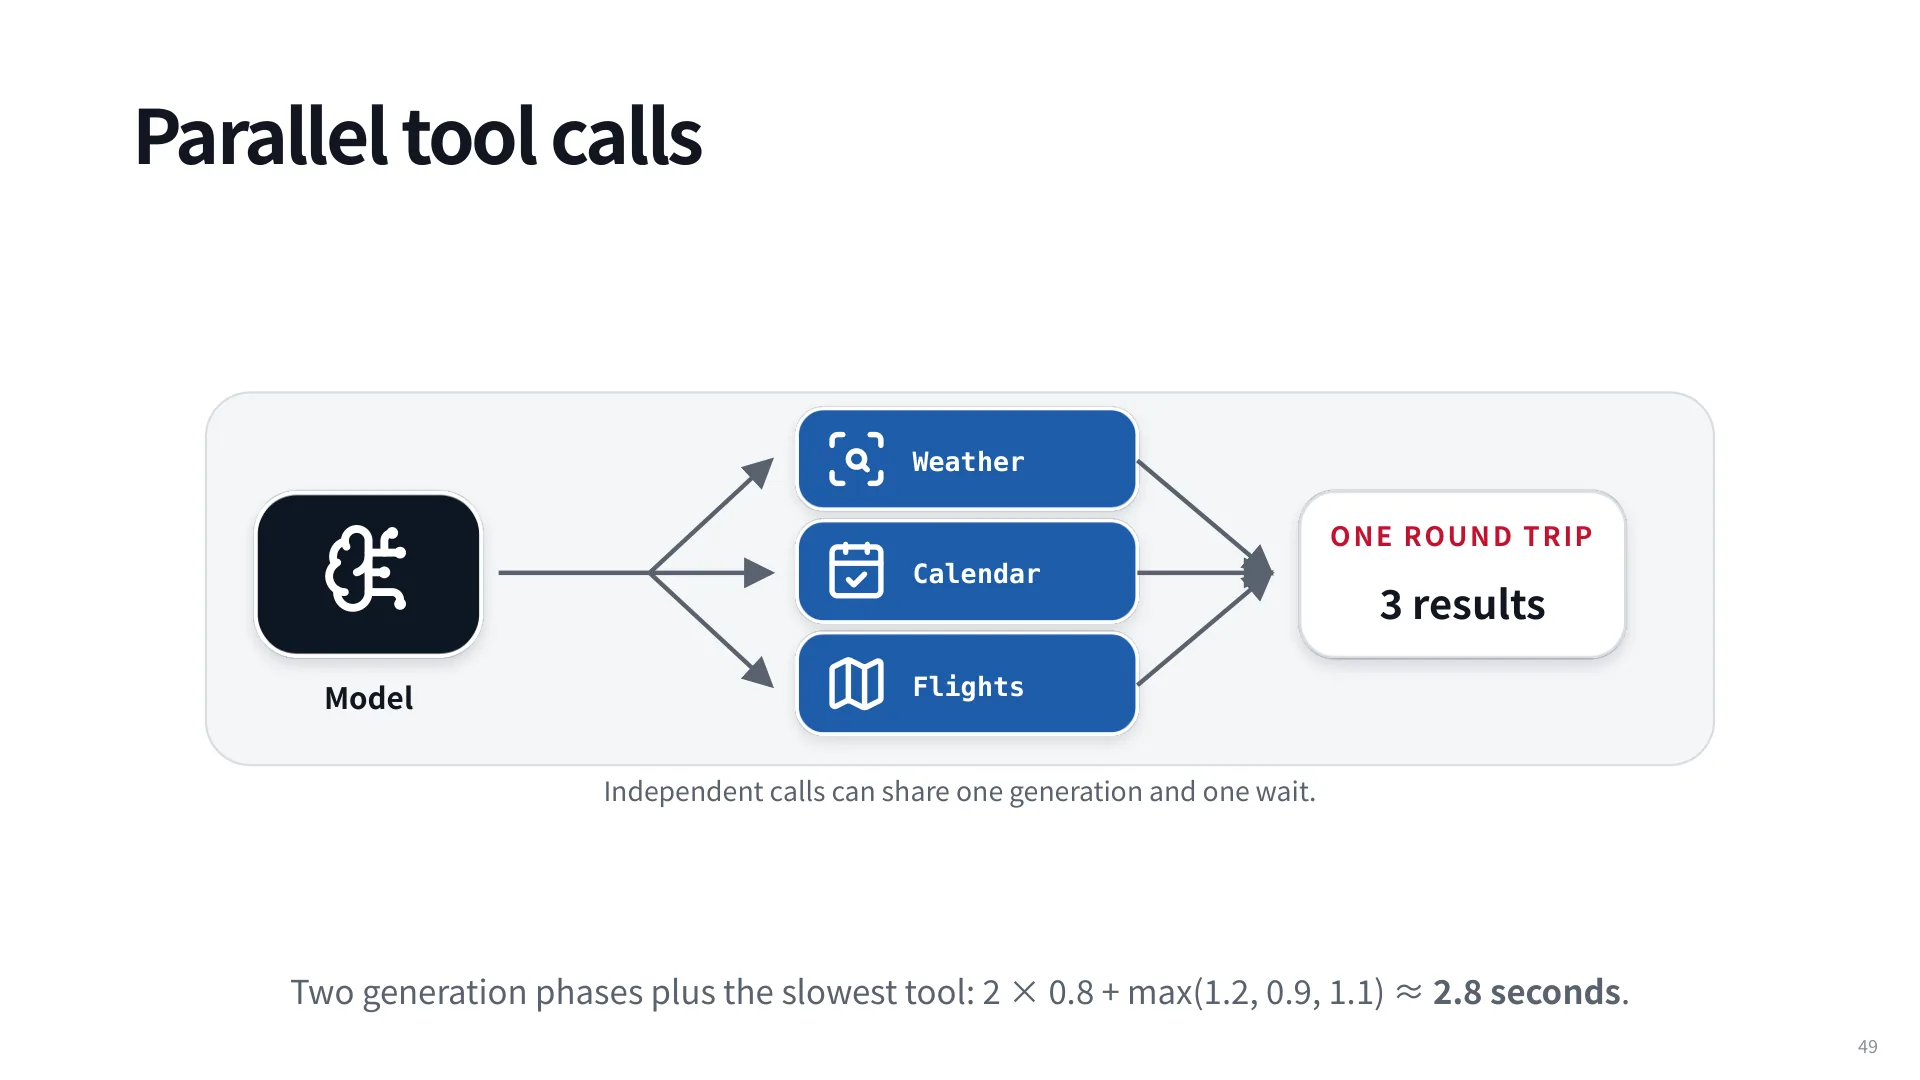
这个 2.3 倍的差距解释了为什么并行调用是 agent 体验的分水岭。它也解释了一个反直觉的现象:更贵的模型可能更便宜。按 token 单价算贵,但更强的模型更快选对方案,而且更擅长并行——一次并发发起多个文件读取或写入,而不是串行十轮——按任务总算反而更省。48:26 处有学生问“为什么模型突然变擅长并行了”,答案是 RL:当训练目标里带有强烈的步数/时延惩罚时,并行调用是降低惩罚的最直接手段,于是被强化出来。机制早就存在,是激励让它普及。
并行的前提是独立。查匹兹堡天气、读今天的日历、查航班状态可以并发;先查 customer ID、再用 ID 拉订单、再对选中订单退款,必须串行。判断标准不是“看起来相关”,而是“后一个调用的参数是否依赖前一个的返回值”。这条规则听起来显然,但模型经常违反——它会在同一轮里既查 ID 又用 ID,因为生成时已经按某种假设把 ID 写出来了。
实现上,并发执行的关键仍是 call ID。课件给了一段 asyncio.gather 的骨架:每个调用是一个协程,返回 (call_id, value) 元组,return_exceptions=True 保证一个失败不会取消其他调用。
async def execute(call):
    args = json.loads(call.arguments)
    value = await TOOLS[call.name](**args)
    return call.call_id, value

results = await asyncio.gather(
    *(execute(call) for call in function_calls),
    return_exceptions=True,
)return_exceptions=True 这个参数值得单独说:默认的 gather 在第一个异常时向上抛,其余协程继续跑但结果丢失。对 agent 来说这是最糟的行为——你付了三个工具的钱,只拿到一个错误。捕获异常并把它当作该调用的“观察结果”返回,模型才有机会重试或换路。
11. 评测:从工具选择到 provider 差异
工具调用可以独立于端到端任务来评,这是它作为“前置能力”的价值。最有名的基准是 Berkeley Function Calling Leaderboard,到 V4 已经分出四个维度:单轮(simple、multiple、parallel、multiple-parallel)、多轮(base、missing function、missing parameter、long context)、agentic(web search、memory)、鲁棒性(幻觉度量、格式敏感性)。
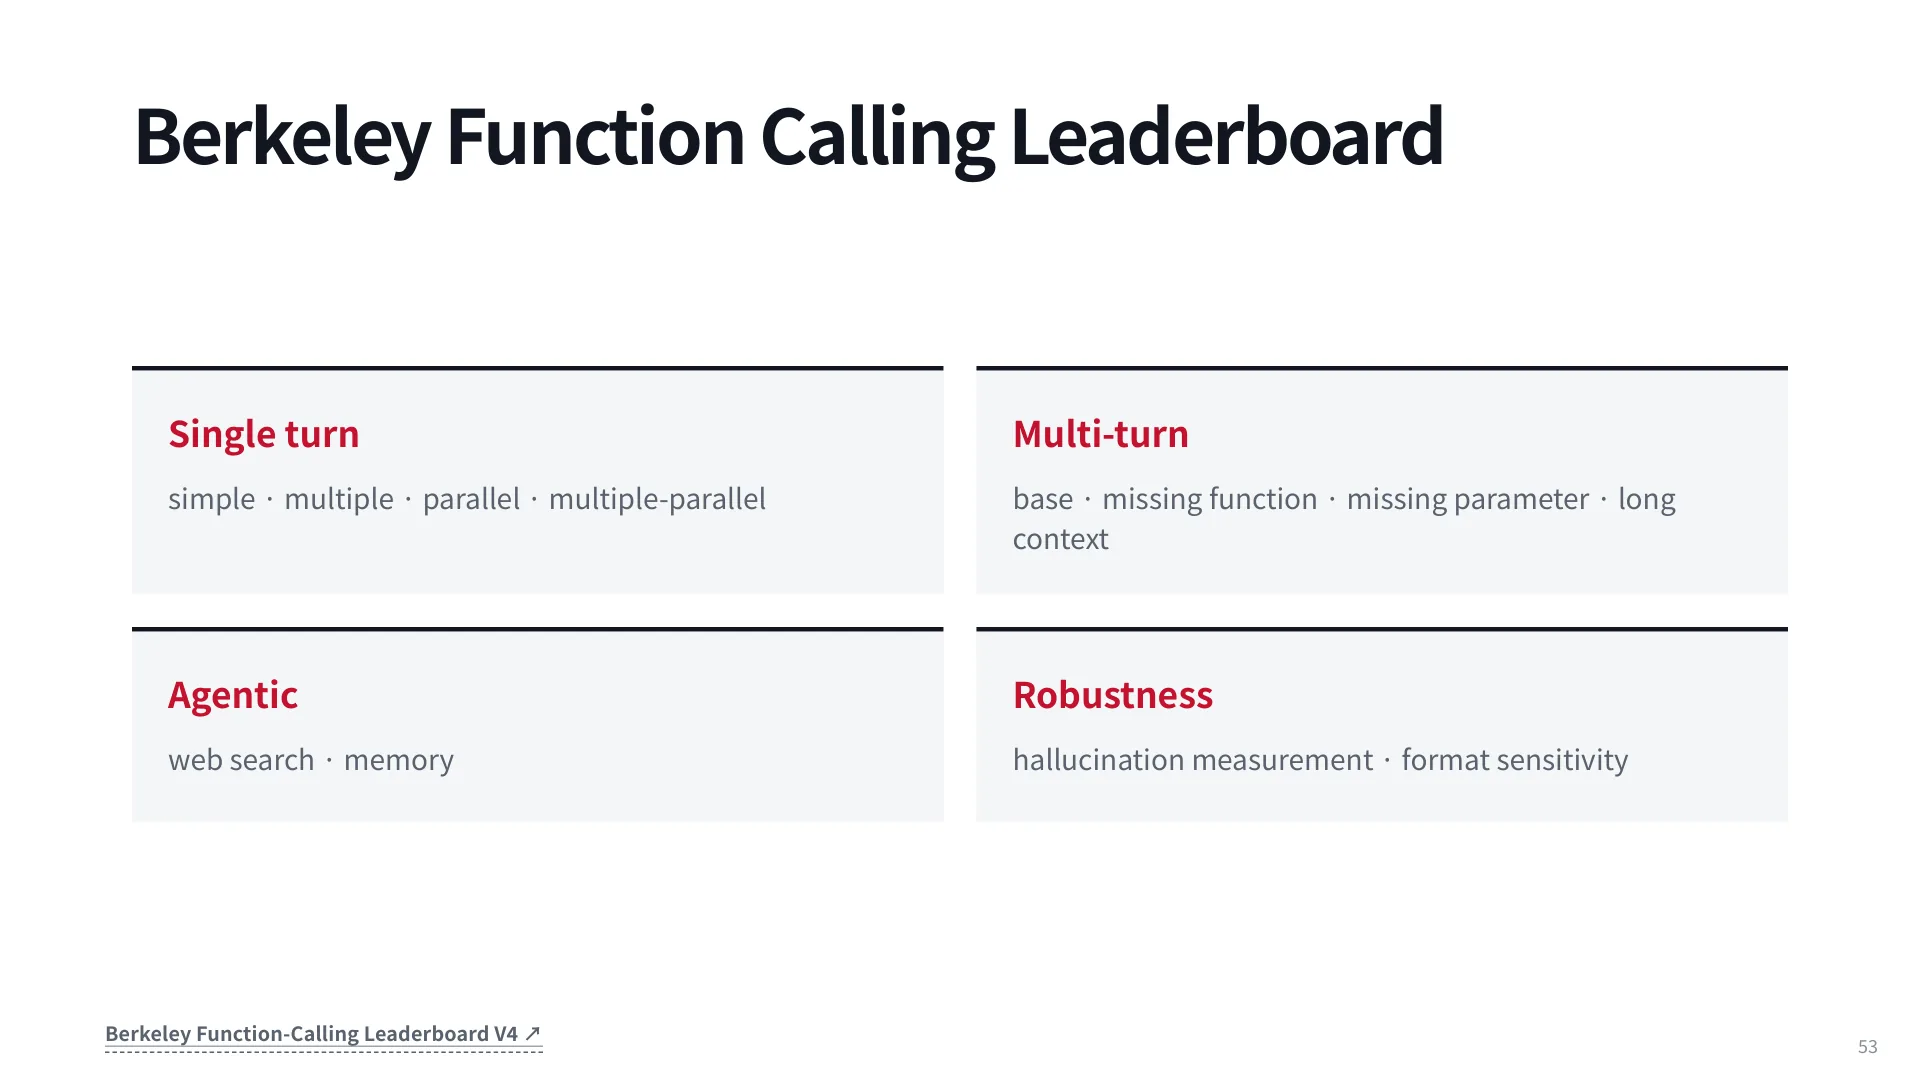
这个分类法的好处是它对应了四种不同的失败。单轮考“会不会调”,多轮考“缺函数/缺参数时会不会瞎编”,agentic 考“在真实工具环境里能不能完成任务”,鲁棒性考“换个格式还灵不灵”。格式敏感性这一项和前面讲的协议差异直接呼应:同一个模型,工具定义换个排版,成功率可能就变了。
更细的评测要分层看整条栈。课件给了四级:selection(选对工具了吗,指标是 precision/recall,不需要执行,典型失败是漏调或多调)、arguments(参数值对吗,用 AST 或 schema 匹配,不需要执行,典型失败是字段或值错)、trajectory(顺序对吗,看序列成功率,通常需要执行,典型失败是依赖关系搞错)、task(目标达成了吗,看端到端成功率,需要执行,典型失败是“看起来合理的错误答案”)。
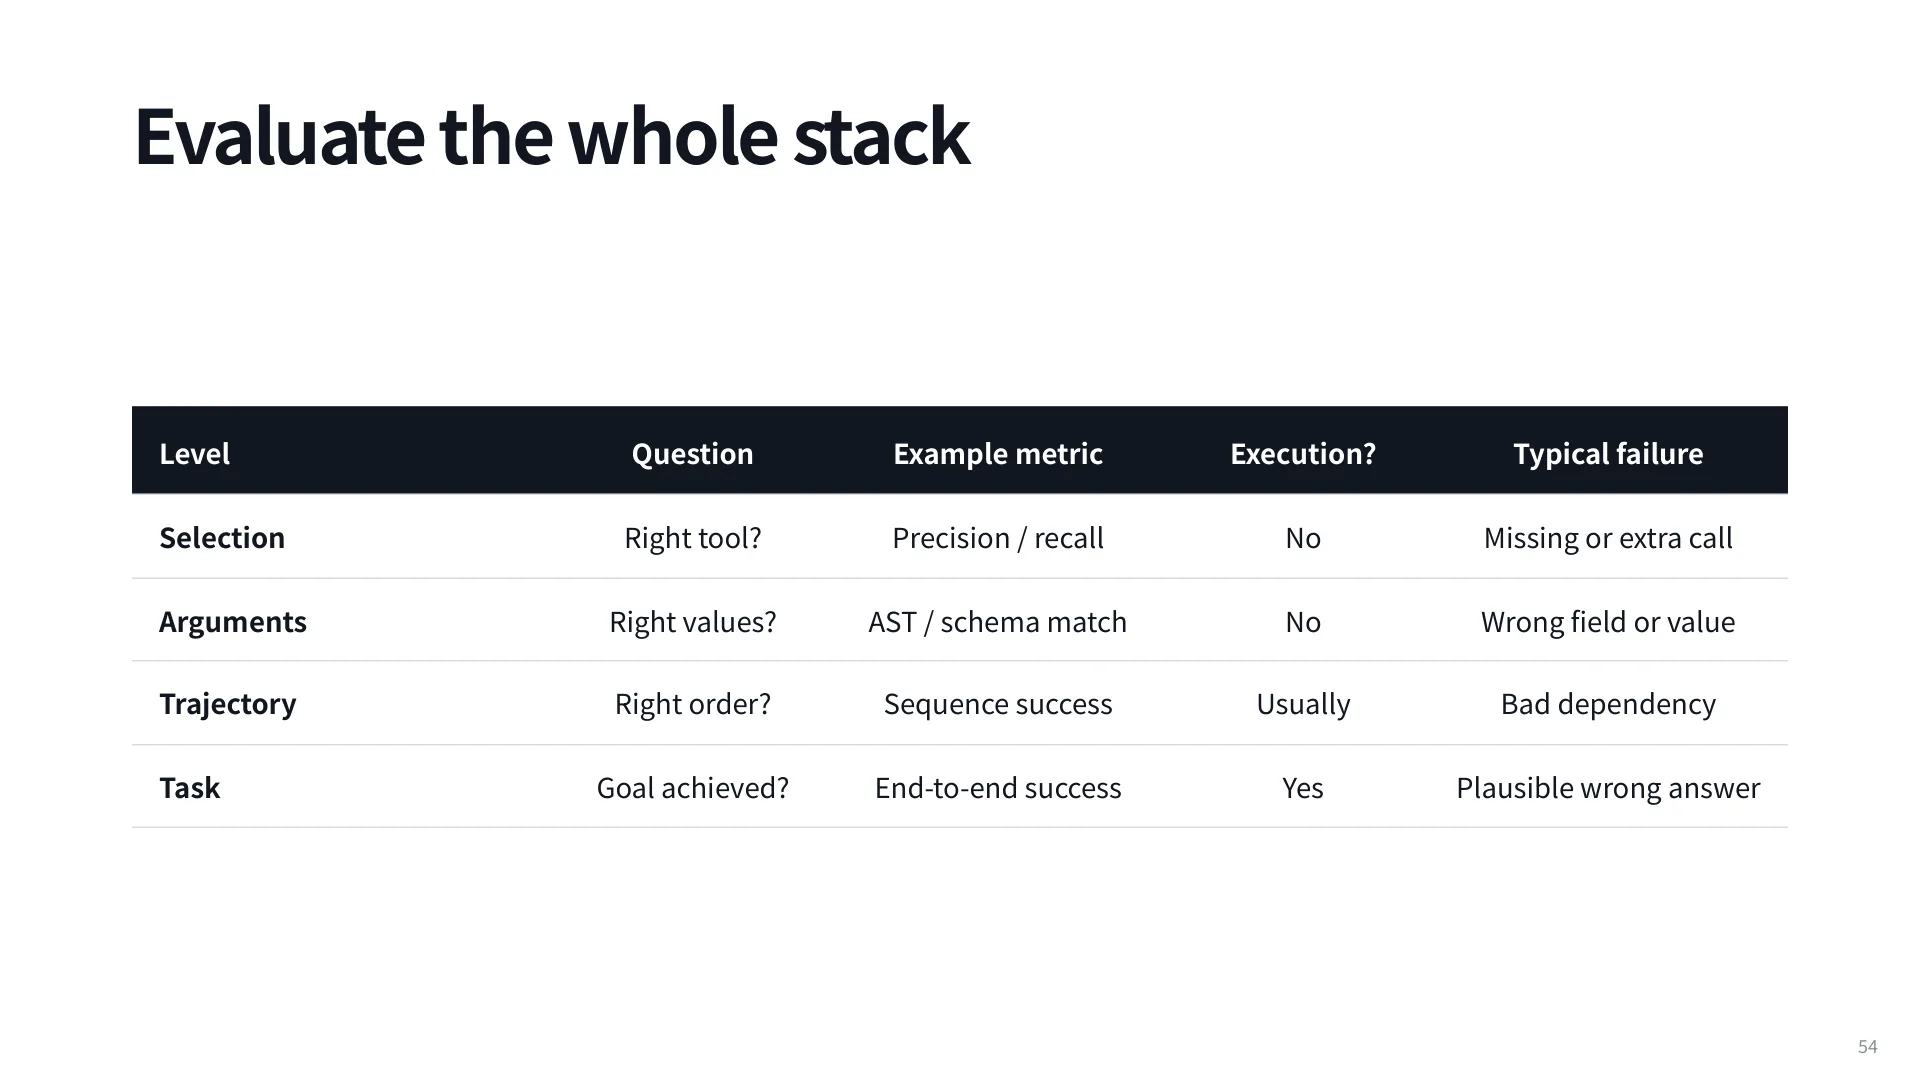
50:06 处他把这四个问题并列摆出来。它们不是替代关系:只测 selection 会漏掉参数错误,只测 task 则无法定位问题——任务失败时你分不清是选错工具、传错参数还是顺序错。分层的好处是每一层都能给出可行动的诊断。
除正确性之外,还有三个运营维度:效率(延迟、调用次数、token、成本)、可靠性(超时、重试、部分失败)、安全(策略、权限、副作用)。课件的一句话很到位:一个正确的 agent 仍然可能慢到不可用、贵到不可用。
最后一组数据来自 OpenRouter 的 provider 分析。同一个模型,只换服务提供商,工具调用错误率从 15.1% 一路到 0.01%,相差约三个数量级。52:42 处他给了几个原因,按可能性排序:量化水平(FP8 通常明显好于 FP4,后者省钱但掉能力)、投机解码(无损的不该有影响,有损的会)、是否实现了约束解码(很多 provider 用自己的推理栈,vLLM 或 SGLang 支持文法解码,自研的未必)、以及最无聊的那个——服务本身不稳定。
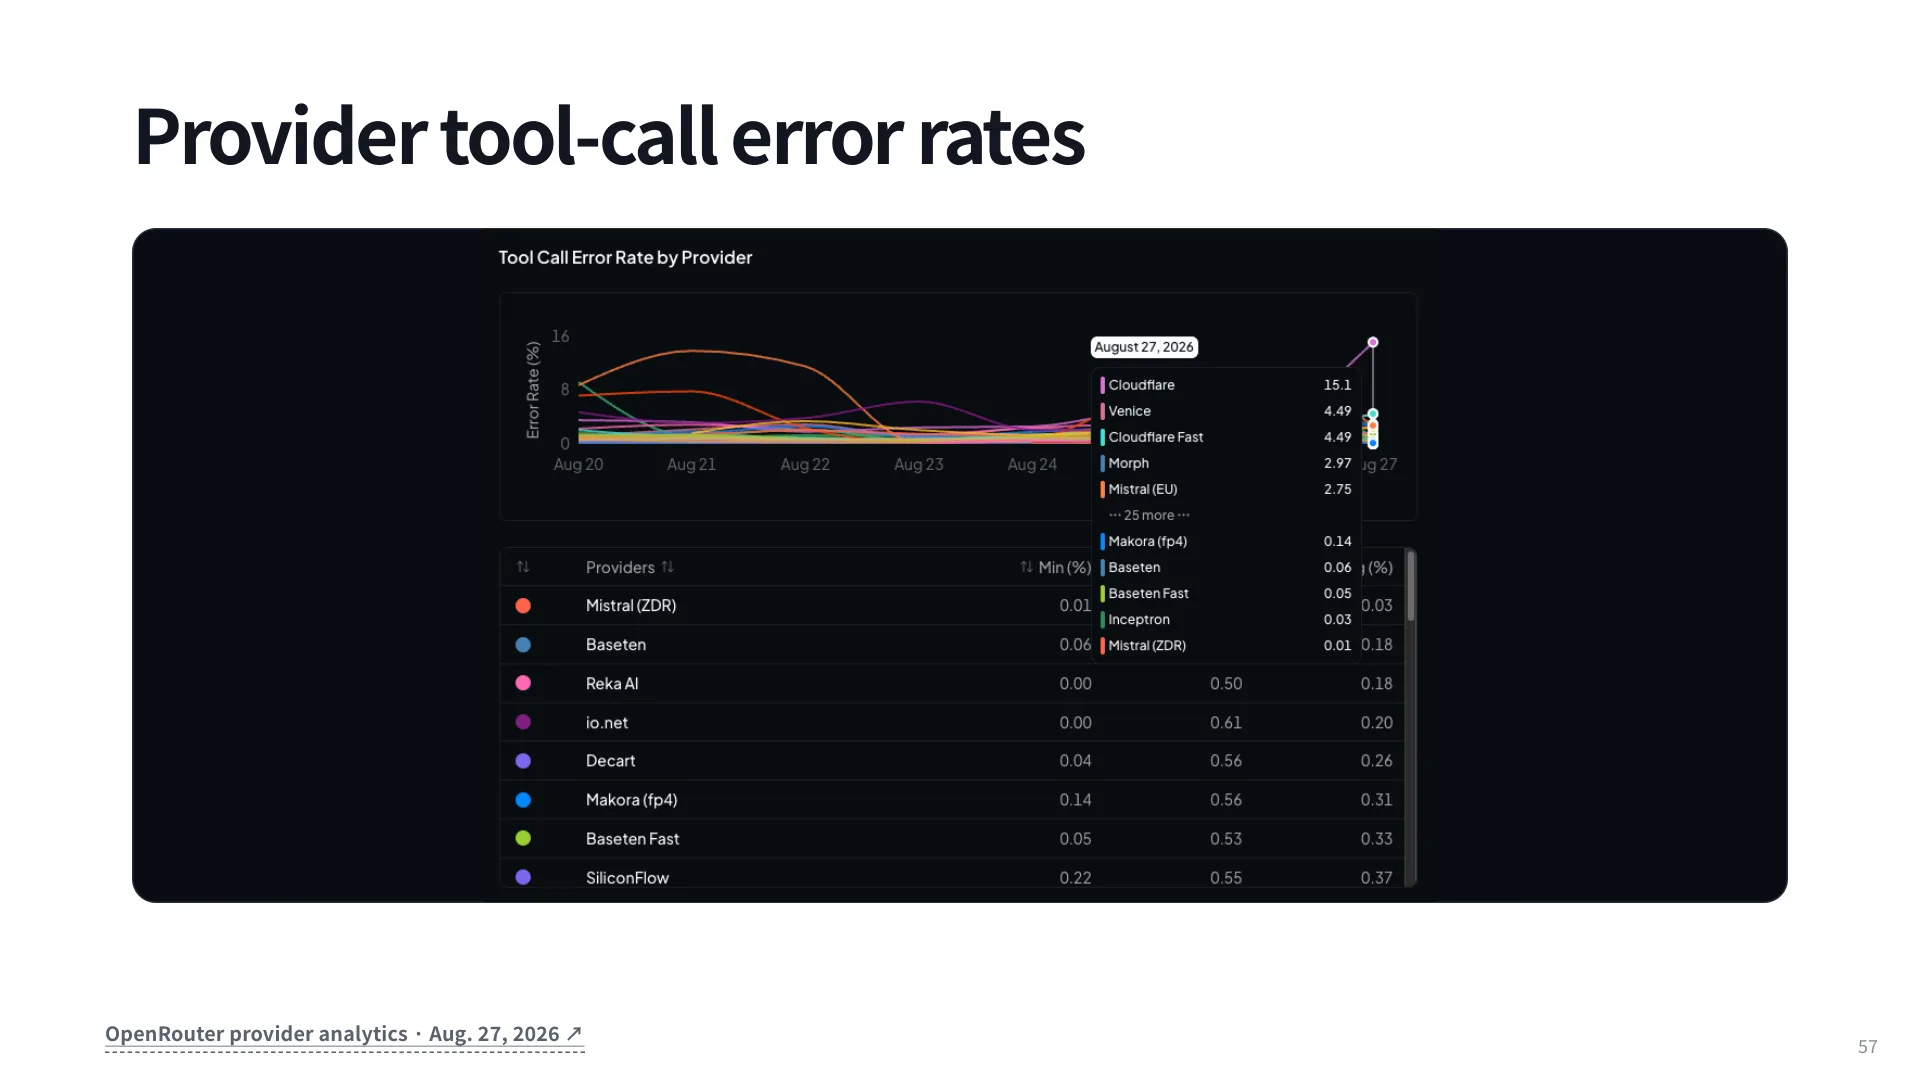
这组数字的方法论意义大于它的具体数值:“我用的是某个模型”不是一个充分的描述。量化、解码算法、文法约束、服务水平都会改变工具调用的成功率,而这些在模型卡片上通常不写。做生产评测时,provider 必须作为一个变量被显式记录。
12. 收束:五层系统
把整讲压成一句话:工具使用是一个分层的系统,每一层都有自己的失败模式。
- 能力层:工具带来检索、执行、生成、应用动作。选错工具,后面全错。
- 机制层:schema 进 prompt,模型按自己的协议吐调用,harness 校验、分发、按 ID 配对结果。
- 约束层:JSON Schema 与文法掩码保证形式,不保证语义。
- 接口层:直接 REST 与 MCP 是暴露能力和管理凭据的两种方式,取舍在组织而非算法。
- 系统层:编排依赖与并发,评测选择、参数、结果、成本与运行时故障。
这五层之间不是松耦合的。约束层能让机制层的解析变简单,接口层的凭据设计会改变能力层的工具粒度(一个“代发邮件”的 MCP 工具比“任意 HTTP + token”安全得多),系统层的并行能力又反过来要求机制层的 ID 配对绝对可靠。Graham 在结尾说这些会在第一个作业里全部遇到——这不是夸张,写一个能跑通的 agent loop 并不难,把它写到不崩、不泄漏、不空转,才是这一讲剩下的全部内容。
术语表
| 术语 | 含义 |
|---|---|
| Tool | 模型可借以调用外部程序的接口;模型提议,外部软件执行 |
| Extend / Facilitate | 工具的两类收益:扩展模型参数外的能力 / 让模型已具备的能力更可靠高效 |
| Agent loop | 生成 → 调用工具 → 观察结果 → 再生成的迭代过程 |
| Chat template | 把角色化消息序列化成模型输入 token 序列的模板(如 Qwen 用 im_start / im_end 标记包裹每条消息) |
| Tool schema | 描述工具名、参数类型与必填项的 JSON Schema 片段 |
| Call ID | 为每次调用分配的唯一标识,用于把工具结果配回对应调用 |
| Constrained decoding | 在解码时把不合文法的 token logits 置为 ,保证输出形式合法 |
| PDA(下推自动机) | 带栈的有限状态机,可解析 JSON 这类嵌套结构 |
| XGrammar | 把 JSON Schema 编译成字节级 PDA 并缓存 token mask 的约束解码系统 |
| OpenAPI | 描述 HTTP 接口的规范,参数内嵌 JSON Schema,可自动生成 |
| MCP | Model Context Protocol,标准化 host 发现与调用工具的方式 |
| Credential brokering | server 接受一种凭据、用另一种凭据访问上游,模型看不到密钥 |
| BFCL | Berkeley Function Calling Leaderboard,工具调用能力基准 |
延伸阅读
- Wang et al., What Are Tools Anyway? A Survey from the Language Model Perspective, COLM 2024 —— 本讲工具定义与两类收益的来源。
- Wang et al., Executable Code Actions Elicit Better LLM Agents(CodeAct), ICML 2024 —— 代码作为动作空间的实验依据。
- Dong et al., XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models, MLSys 2025 —— 字节级 PDA 与缓存掩码。
- JSON Schema Core, Draft 2020-12 —— 语法、结构、类型、枚举四层约束的规范定义。
- Berkeley Function-Calling Leaderboard V4 —— 单轮、多轮、agentic、鲁棒性四类评测。
- FastAPI 与 FastMCP 文档 —— OpenAPI 自动生成、OpenAPI 到 MCP 的投影、token 校验。
自测题
1. 为什么 finish(text) 被称作 harness 的控制动作而不是工具?
参考答案
它不调用任何外部程序,只改变 agent loop 的状态(结束循环并返回最终文本)。把它显式化的好处是 harness 能区分“本轮只是中间说明”和“任务结束”,避免把普通文本误判为终止。
2. 举一个 extend 类工具和一个 facilitate 类工具,并说明区别。
参考答案
search_web 是 extend:模型参数里没有今天的新闻,原理上不可得。计算器是 facilitate:模型能算,但要逐位推理,慢且易错。区别在于前者扩展能力边界,后者用更可靠的外部实现替代模型内部能力。
3. CodeAct 的两个主要结论是什么?为什么不能据此说“代码永远更好”?
参考答案
在展示子集上代码动作成功率 8/8 最优、轮数 7/8 最少;扩展到 17 个模型两项均为 12/17。12/17 意味着仍有模型不符合,且任务限于工具调用类,代码的优势来自它是自然的组合媒介,而非普遍规律。
4. 工具调用的 token 视角能解释哪三件事?
参考答案
(1)ReAct 的“思考 + 调用”可以压进一次 completion;(2)推理模型可在前面加不展示的 thinking token;(3)特殊标记必须在中训练/后训练中被训练过,所以“模型天生会调工具”是错觉。
5. 为什么解析器不能跨模型复用?给出两个不同协议的例子。
参考答案
因为工具调用是各模型自己训练出的序列化格式。Qwen 用 <function=...> / <parameter=...> 标签,Mistral 用 [TOOL_CALLS] 控制 token 加带 id 的 JSON,DeepSeek 用 DSML 的 invoke / parameter 块。复用解析代码往往不会报错,只是解析出空调用。
6. schema 校验失败与执行失败有何不同?各举一例。
参考答案
schema 校验失败是显式的:units 传了 "K",action_from_arguments 直接拒绝。执行失败是隐式的:execute_code 接受任何字符串,但那段代码可能语法错、抛异常或超时,只有真正运行才知道。
7. 约束解码已经保证合法 JSON,为什么还可能拿到不完整的输出?
参考答案
token 预算耗尽。模型可能一直走在合法路径上但尚未到达接受状态就被截断,输出因此不完整。需要在接近上限时引导走向可终止路径,或把剩余预算接进文法状态。
8. MCP 的凭据代理解决了什么问题?为什么它比直接给 agent 一个 GitHub token 安全?
参考答案
agent 只持有 MCP key,上游 key 保存在 server 侧。即使 MCP key 泄漏,损失被限制在 server 愿意代理的范围内;而 GitHub token 泄漏意味着账号与所有仓库失守。server 侧还集中了审计与权限收窄。
9. 串行与并行工具调用的延迟公式分别是什么?并行成立的前提是什么?
参考答案
串行 ,课件例子约 6.4s;并行 ,约 2.8s。前提是调用之间没有数据依赖:后一个调用的参数不能依赖前一个的返回值。
10. 为什么同一个模型在不同 provider 上的工具调用错误率能相差约三个数量级?
参考答案
量化水平(FP8 通常优于 FP4)、投机解码是否有损、是否实现文法约束解码(自研推理栈未必支持)、以及服务本身的可用性。这说明 provider 应作为评测变量被记录。