
5a · Training 2: Reinforcement Learning Basics
本讲速览
- SFT 优化的是“像示教”,不是“完成任务”。 任务失配、数据失配、exposure bias 三个问题在 agent 场景里被放大,因为 agent 必须在自己产生的历史上继续决策。
- RL 的通用配方只有三步:从当前策略采样轨迹、用环境给轨迹打分、按分数调整参数,让高回报轨迹更可能。后面所有算法都是这条循环的变体。
- ReST / expert iteration 是“能用的最简版本”:采样、按 reward 过滤、对留下的轨迹做 SFT。它复用全部 SFT 工程;在二值 reward 下只保留成功轨迹,因而丢掉全部失败样本。
- 策略梯度的全部难点在于“采样与环境都不可导”。log-derivative trick 把 变成“reward × SFT 梯度”的期望,所以实现上只是给 SFT loss 加一个 mask、再乘一个标量。
- reward 的绝对值没有意义,相对值才有。 减去 baseline 不改变梯度期望,却能显著降低方差;这也解释了为什么失败轨迹在朴素 REINFORCE 里完全学不到东西。
- GRPO 用“同一道题采 G 次”的组内均值代替 value model;DrGRPO 再去掉组内标准差与长度归一化,修掉难度偏置与“越错越长”的长度偏置。
- 在损失形式上,所有方法只差一个权重 :ReST 是 0/1,REINFORCE 是 ,GRPO 是 。理解这一点就理解了本讲的骨架。
1. 本讲的定位:SFT 之后还剩什么问题
这是 RL 三部曲的第一讲。按课程安排,本讲只讲最基础的 policy gradient——agent 与环境交互、拿到反馈、把成功的动作调高概率、把失败的动作调低概率;下一讲处理 off-policy、重要性加权与训练稳定性;第三讲落到 RL 系统工程与超参;这些内容共同服务于 assignment 3,而 assignment 3 的两个环境之一,正是本讲从头用到尾的 running example(00:48)。
先明确记号。被训练的 agent 是策略 , 是驱动它的语言模型的参数。给定历史 ,策略输出下一个动作的分布;动作可能是“下一个 token”,也可能是“调用一次工具”“点击一个按钮”。环境接收动作后返回观测 与奖励 。整套 RL 讨论都建立在这个循环之上,与前面讲过的 agent 架构没有冲突——harness 负责把 token 变成动作、把环境返回变成观测,RL 只负责决定参数往哪走。
真正的困难不在“循环”本身,而在两件事:第一,SFT 的数据分布与 agent 自己生成的历史分布不一致;第二,环境给出的反馈是一个标量分数,而不是“正确答案”。本讲就是在解决这两个困难的过程中,把 REINFORCE、baseline、GRPO 一步步推出来。
值得先说明一个常见误解:既然 SFT 学不好,那就“只对成功的轨迹做 SFT”行不行?这正是第 5 节要介绍的 ReST,它在二值 reward 下确实能用。但它的信息利用是粗暴的——成功轨迹整体加权为 1,失败轨迹整体丢弃,中间没有任何“好多少”的度量。要走到更细的加权,就必须先把“一次交互”形式化成可求导的目标,这正是本讲前半段的主要工作量。
2. Running example:Number Search
这个环境小到可以手算,却保留了 agent 任务的全部结构:多步决策、部分可观测、稀疏奖励、成功路径不唯一。
规则是:一个 1 到 16 之间的整数藏在环境里,agent 最多猜四次;每次猜错后环境只回答 higher 或 lower(没有“接近了”这种提示);猜中立刻结束并得 1 分,四次用完还没中就是 0 分(02:25)。奖励是二值的,这正好对应现在最流行的 RLVR(reinforcement learning with verified rewards)设定:写代码跑单测、解数学题对答案,成功 1 分、失败 0 分。课件也提醒,方法本身不要求二值,用“通过测试的比例”这类连续分数同样成立。
奖励设计值得多花一句。RLVR 之所以好用,是因为“判分”这件事被外置成了可信的验证器:单测跑过就是 1,答案匹配就是 1。它把“评价”从模型手里拿走,避免了用一个模型去给另一个模型打分的循环论证。代价是奖励只覆盖验证器能看到的东西——单测通过不代表代码可维护,答案正确不代表推理过程可信。验证器写得越窄,策略越容易钻空子,这就是后面要反复提到的 reward hacking 的根源。
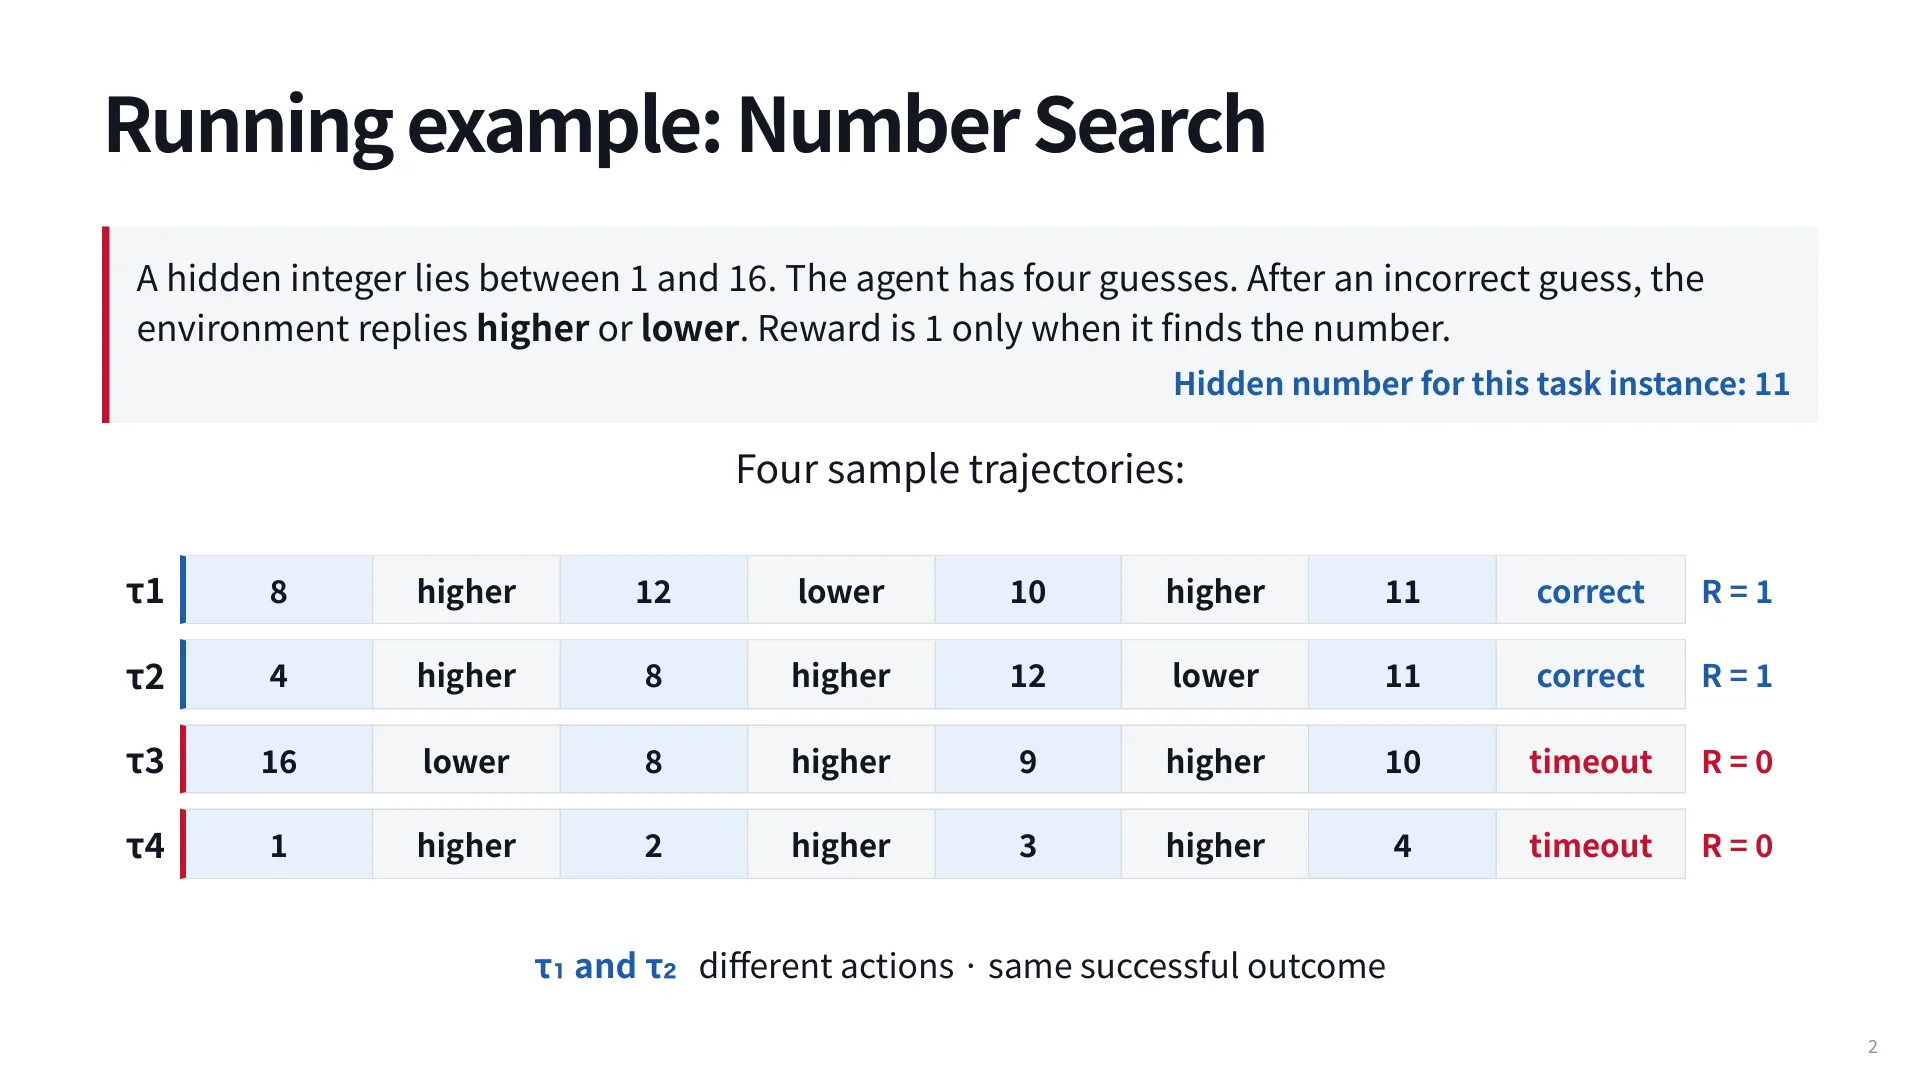
取隐藏数为 11,四条轨迹很能说明问题:
| 轨迹 | 动作序列 | 结果 | 质量 |
|---|---|---|---|
| 8 → 12 → 10 → 11 | 命中, | 接近最优 | |
| 4 → 8 → 12 → 11 | 命中, | 成功但有浪费 | |
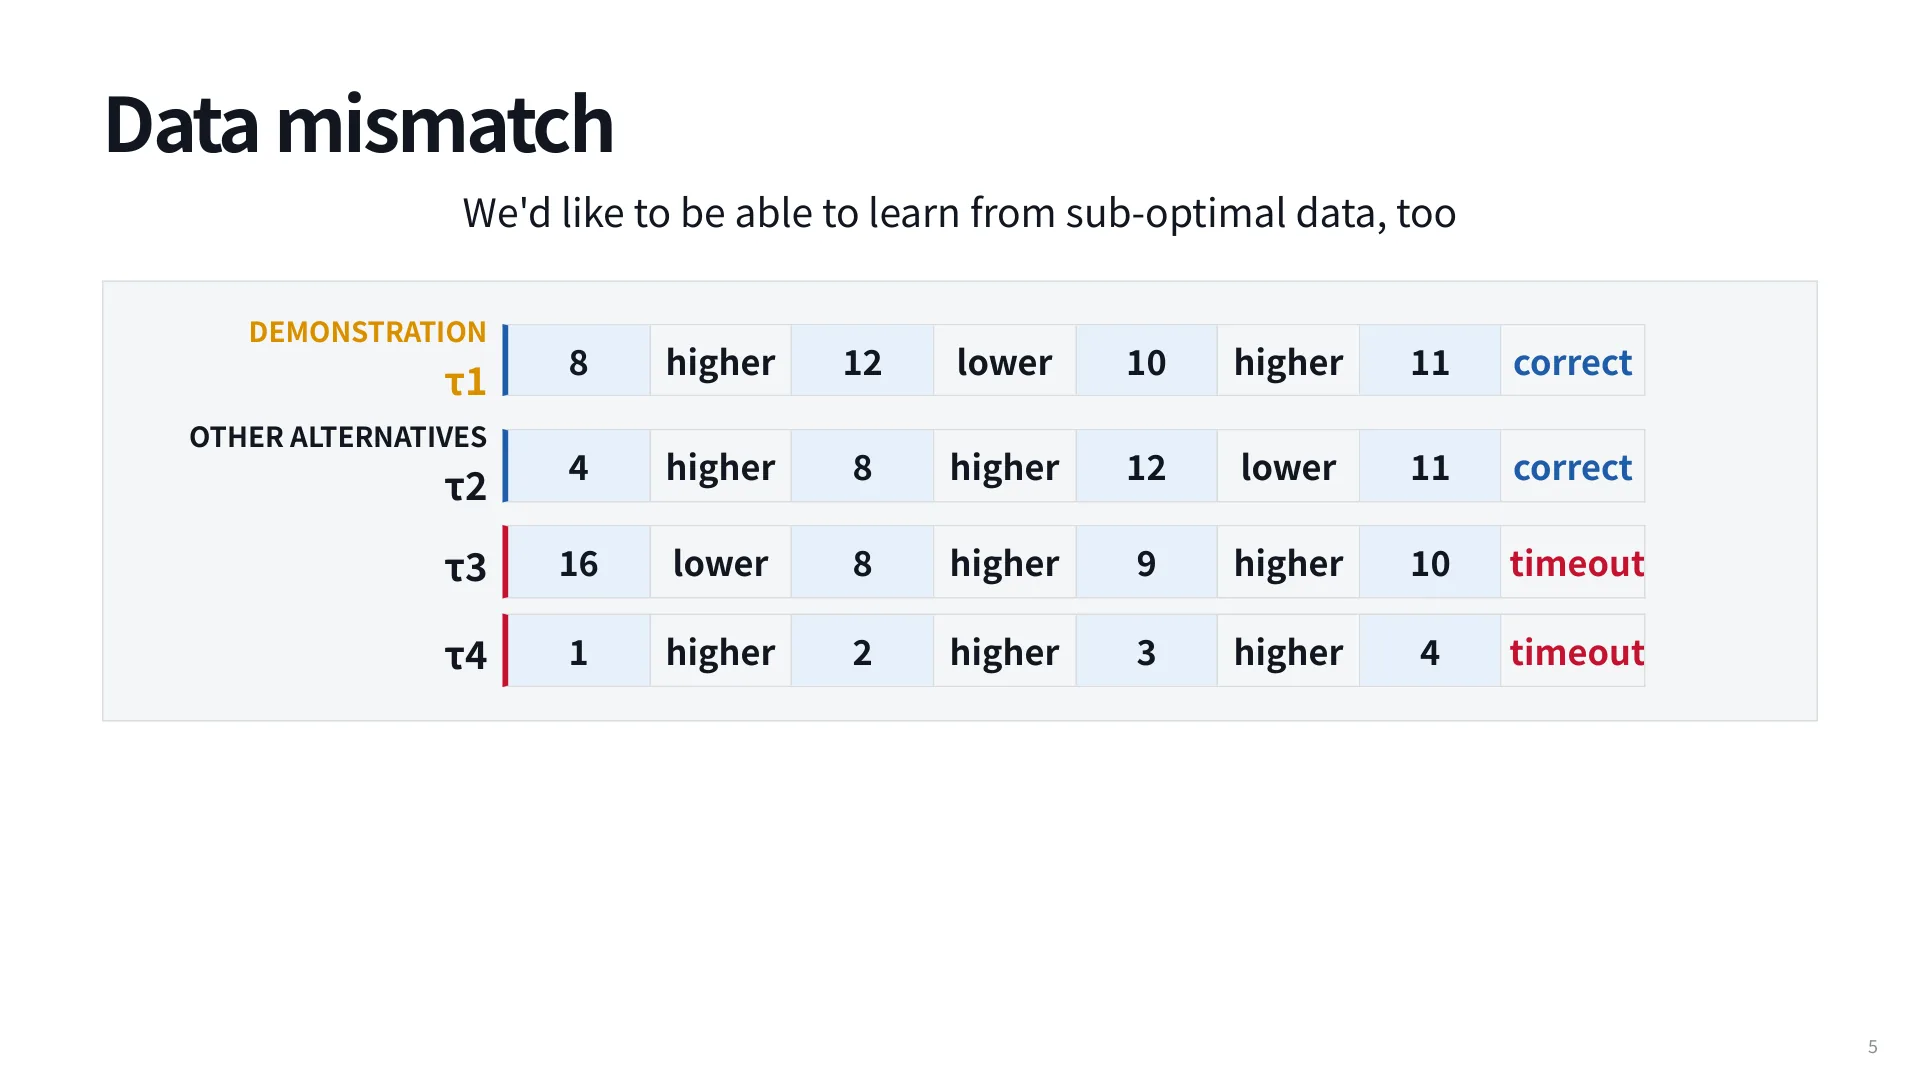
| 16 → 8 → 9 → 10 | 超时, | 收尾错误 | |
| 1 → 2 → 3 → 4 | 超时, | 线性扫描 |
和 的动作序列并不相同,结局却一样。 的问题出在第一步:猜 4 只排除了 1–4,候选集仍有 12 个;随后猜 8 把范围压到 9–16(8 个候选),再用 12 试探,最后只剩一次机会去猜 9–11 中的一个。它这次能中 11,有运气成分——换个隐藏数就未必。“成功”与“好”不是一回事,这是后面 advantage 概念要解决的问题。
再看最优性。16 个候选、4 次机会,满足 ,意味着每一次猜测都必须把候选集切得足够均匀,才能保证命中;所以理想的第一步是 8(或 9),把最坏的一侧压到 8 个候选。这也解释了为什么这个任务像 20 questions,也像 Wordle 里那个“信息量最大的开局词”。 从 1 开始线性扫描,是最差的策略之一:即使运气好,也要靠 higher 一个数一个数往上蹭。
3. SFT 与它的三个失配
SFT 的目标写出来很干净:给定示教轨迹里每一步的目标动作 ,最大化它们的条件概率,
目标动作可以来自人类示教、更强的模型(蒸馏),也可以来自 agent 自己某次成功的轨迹。问题是,这个目标与“把任务做成”并不是同一件事。
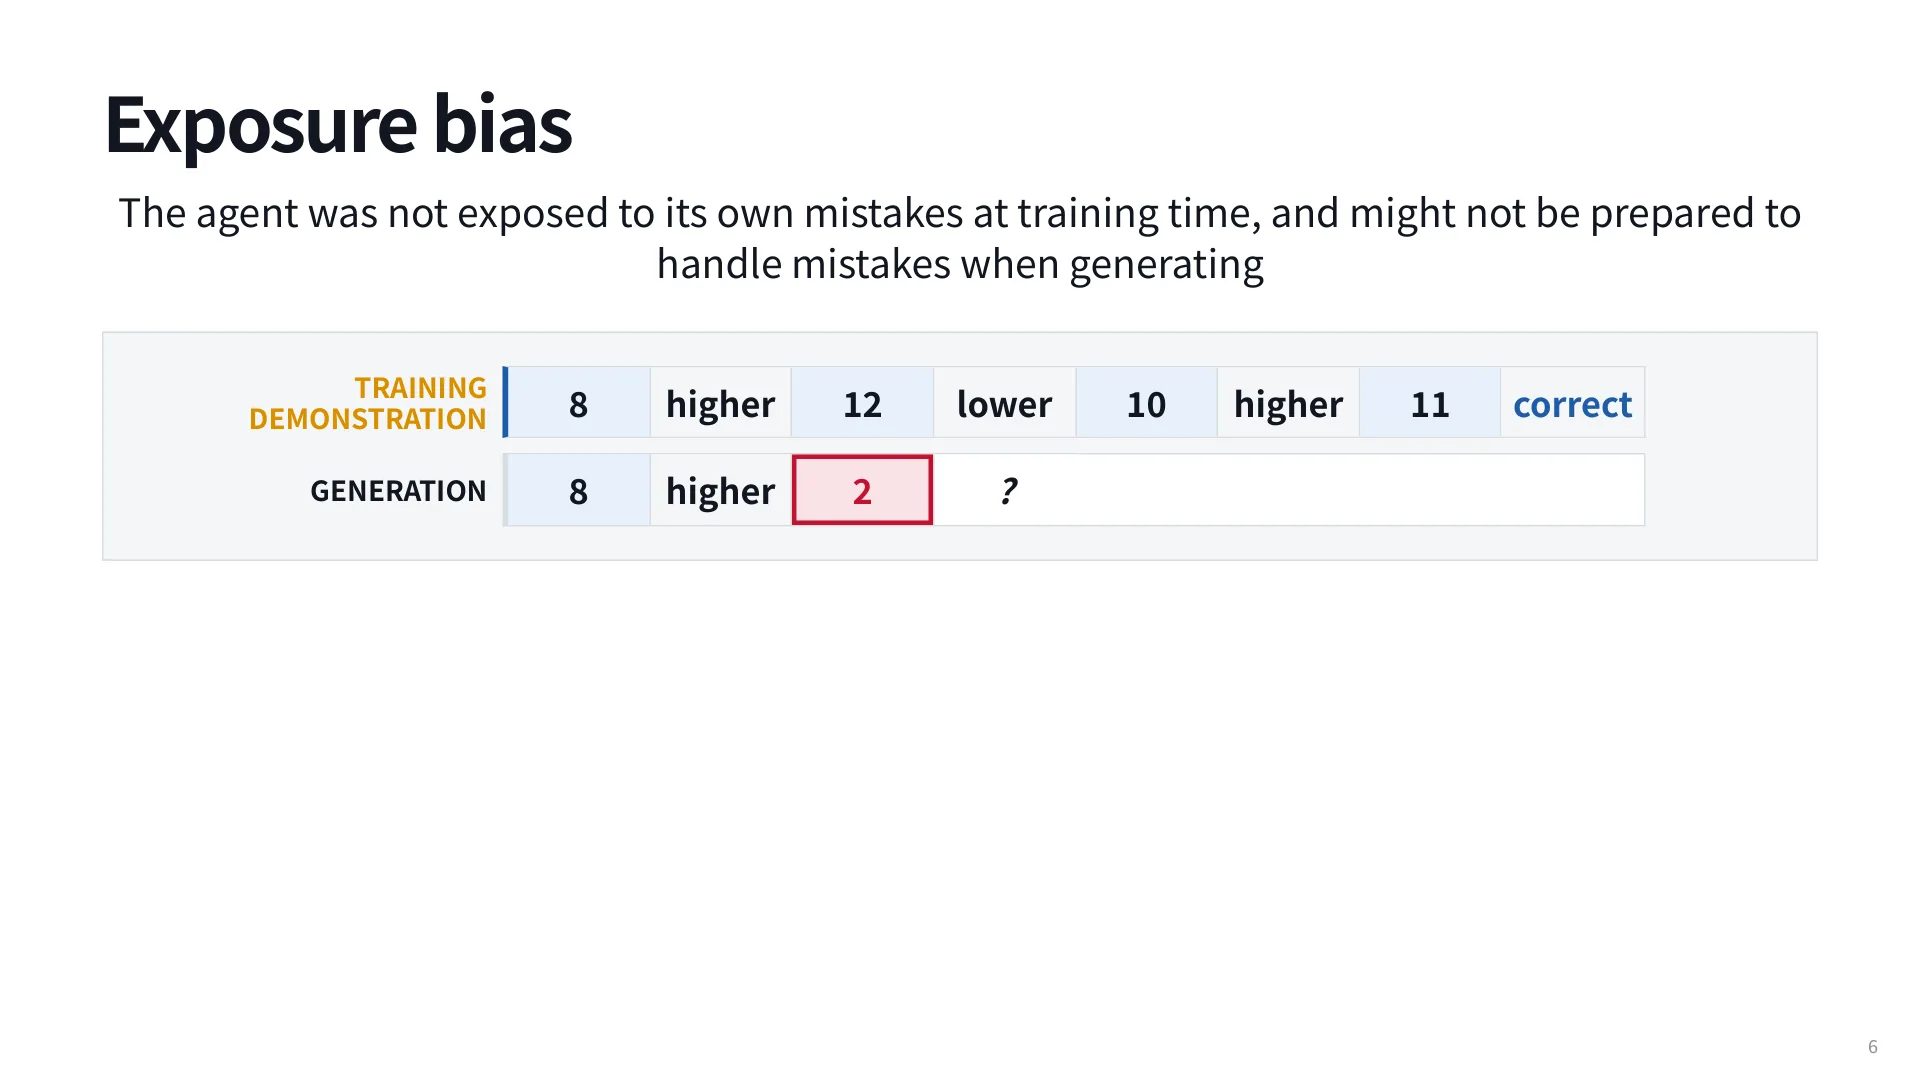
任务失配(task mismatch)。 同一任务有多条成功路径,示教只展示其中一条;更严重的是,SFT 对“未被示教的动作”一视同仁。课件举了一个很直观的例子:历史是“猜 12 → lower”,此时猜 13 应该被永久排除,猜 11 显然比猜 13 好,但只要两者都不是示教动作,SFT 对它们的处理就没有区别(08:56)。也就是说,SFT 只把示教动作的概率往上推;未被示教的动作虽然会因 softmax 归一化而相对降权,却不会按“好/坏”排序——它没有“排序”能力。
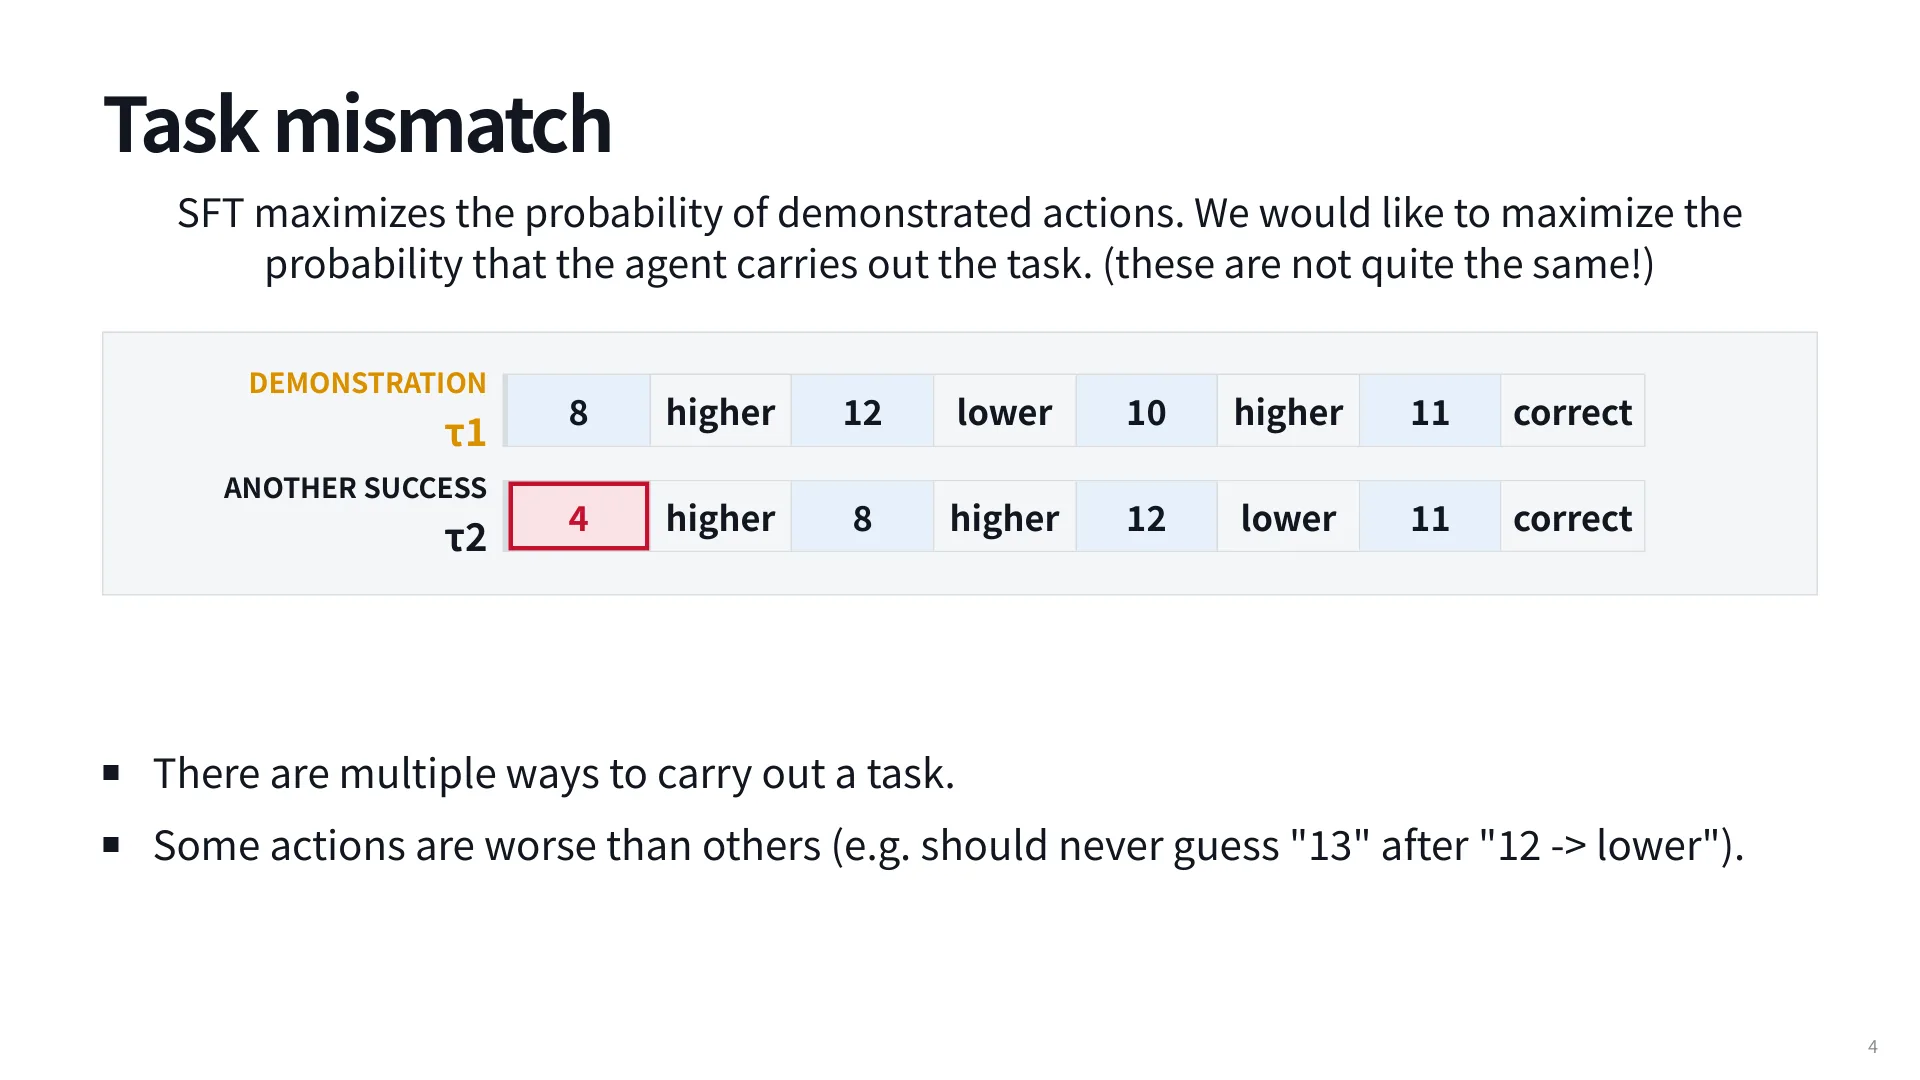
数据失配(data mismatch)。 我们希望也能从次优数据里学习。 和 是失败轨迹,直接做 SFT 会把错误动作也学进去;但完全丢掉又浪费了“这样走会超时”的信息。理想的方法应该能利用“负样本”,而这正是 reward 的用武之地。
Exposure bias。 训练时模型看到的历史永远来自示教(8 → higher → 12 → …),推理时历史却由模型自己产生。一旦第一步采样出“8 → higher → 6”这种训练中从未出现的错误历史,模型没有在类似状态上被训练过,后续行为可能彻底失准(11:24)。这个现象在早期对话模型上表现为复读、绕圈、越错越乱;加入 RL 后训练之后,模型“见过自己犯错”,恢复能力明显变好。
误差是会累积的。可以做一个粗略估算:若单步正确率 0.95,二十步任务的端到端成功率只有 ;而一旦某一步出错,后续历史就进入训练分布之外。SFT 只优化单步条件概率,对这种复合误差无能为力;RL 则因为在训练时就采样到“已经走歪”的历史,能让模型学会在坏状态下把损失控制住——这也是长程 agent 任务比单轮生成更依赖 RL 的原因。
RL 同时回应这三点:训练目标是期望回报,所以任何成功轨迹都会被强化(任务失配);reward 让失败轨迹也能贡献梯度(数据失配);轨迹由当前策略生成,模型在自己的错误上学习(exposure bias)。第三条有个专门的名字——on-policy。
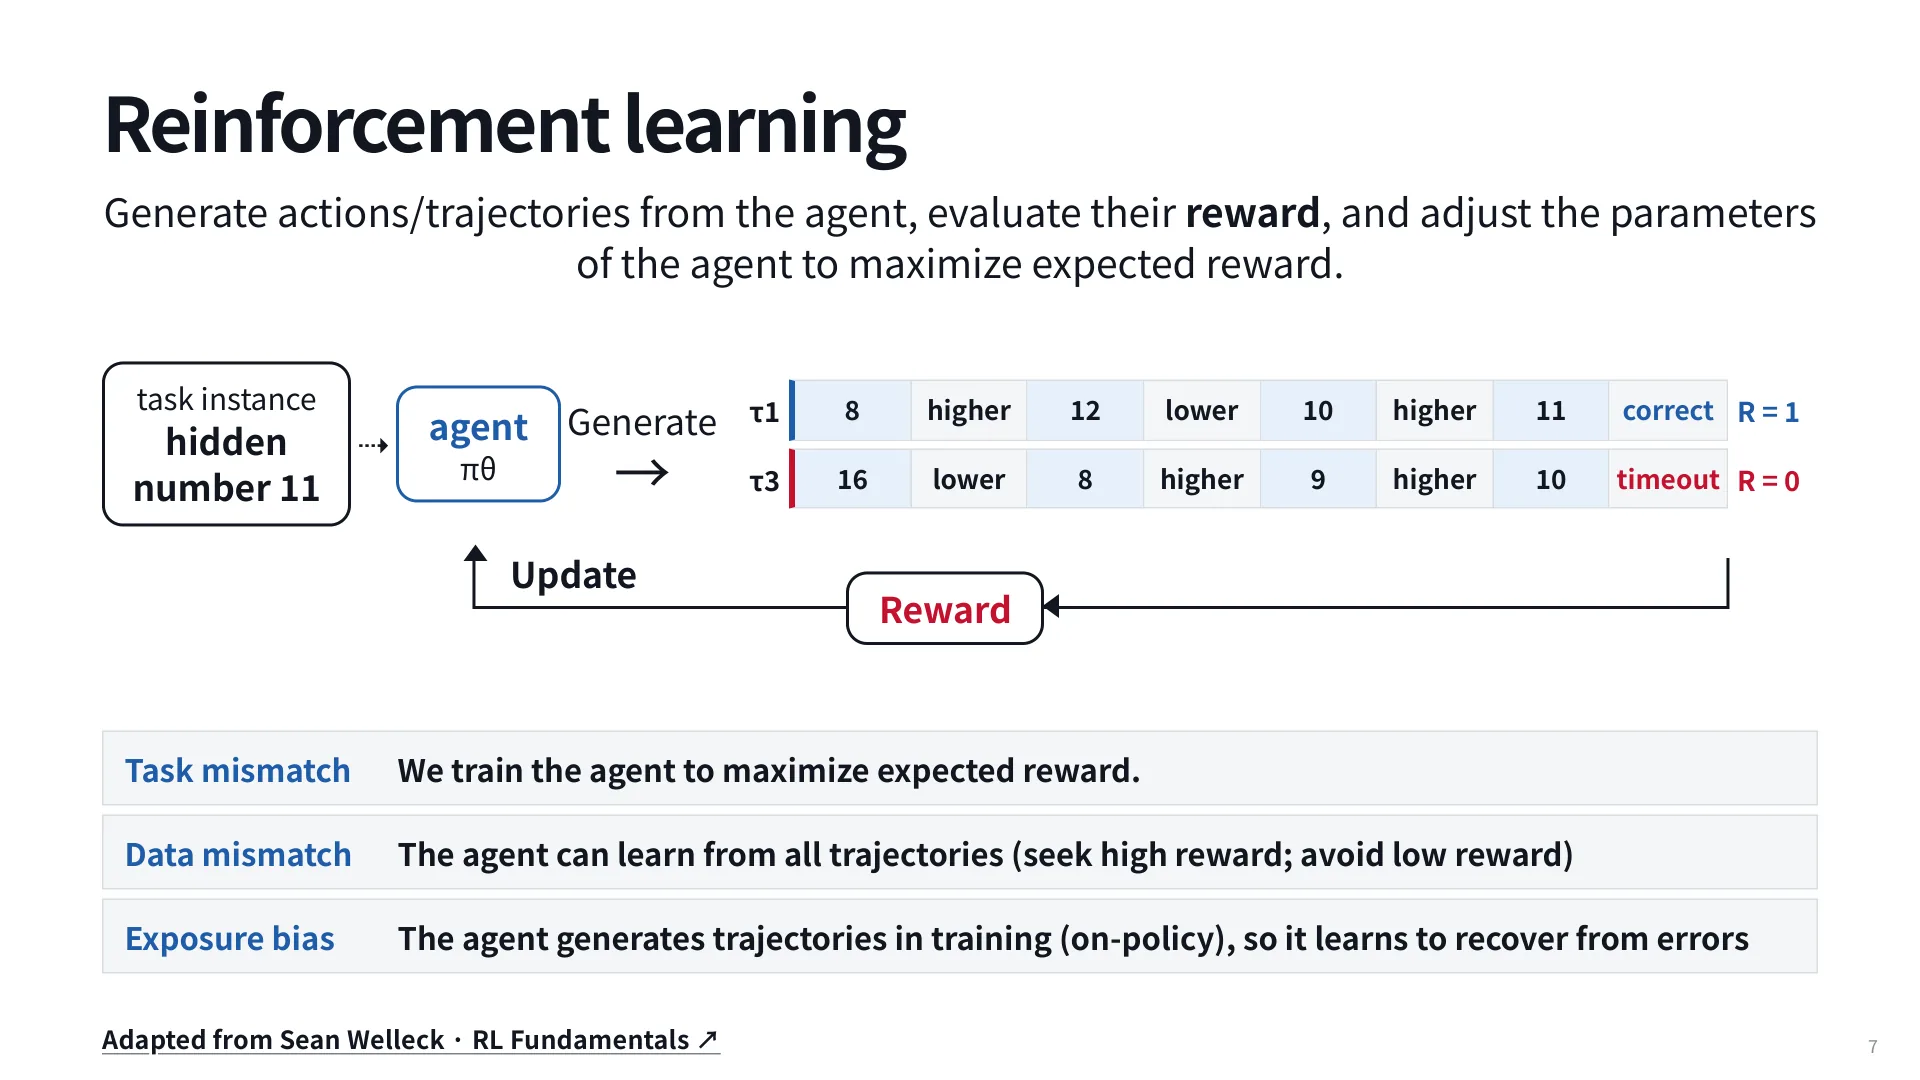
on-policy 的收益与代价
on-policy 让监督信号与模型当前能力匹配,也让模型学会从错误中恢复。代价是采样即训练数据:更新一次就要重新与环境交互,样本效率低,rollout 成本高。后面两讲讨论的 off-policy、异步 RL、重要性加权,本质上都是在为这条约束松绑。
4. 把一次交互写成轨迹
强化学习的第一个技术动作,是把“agent 跑一遍任务”形式化成一条轨迹。策略 在历史 上输出动作分布,环境返回观测与奖励;历史是到当前时刻为止的观测与动作序列:
这里有个容易被忽略的细节:策略只能看到历史,看不到环境的真实状态。Number Search 里隐藏的 11、web agent 背后数据库的内容,都是 agent 无法直接读取的;它只能看到渲染出的页面。这在形式上叫 POMDP(部分可观测马尔可夫决策过程),也是为什么策略的条件项是 而不是状态 。用历史做条件对语言模型最自然:把对话与工具返回拼成上下文即可。
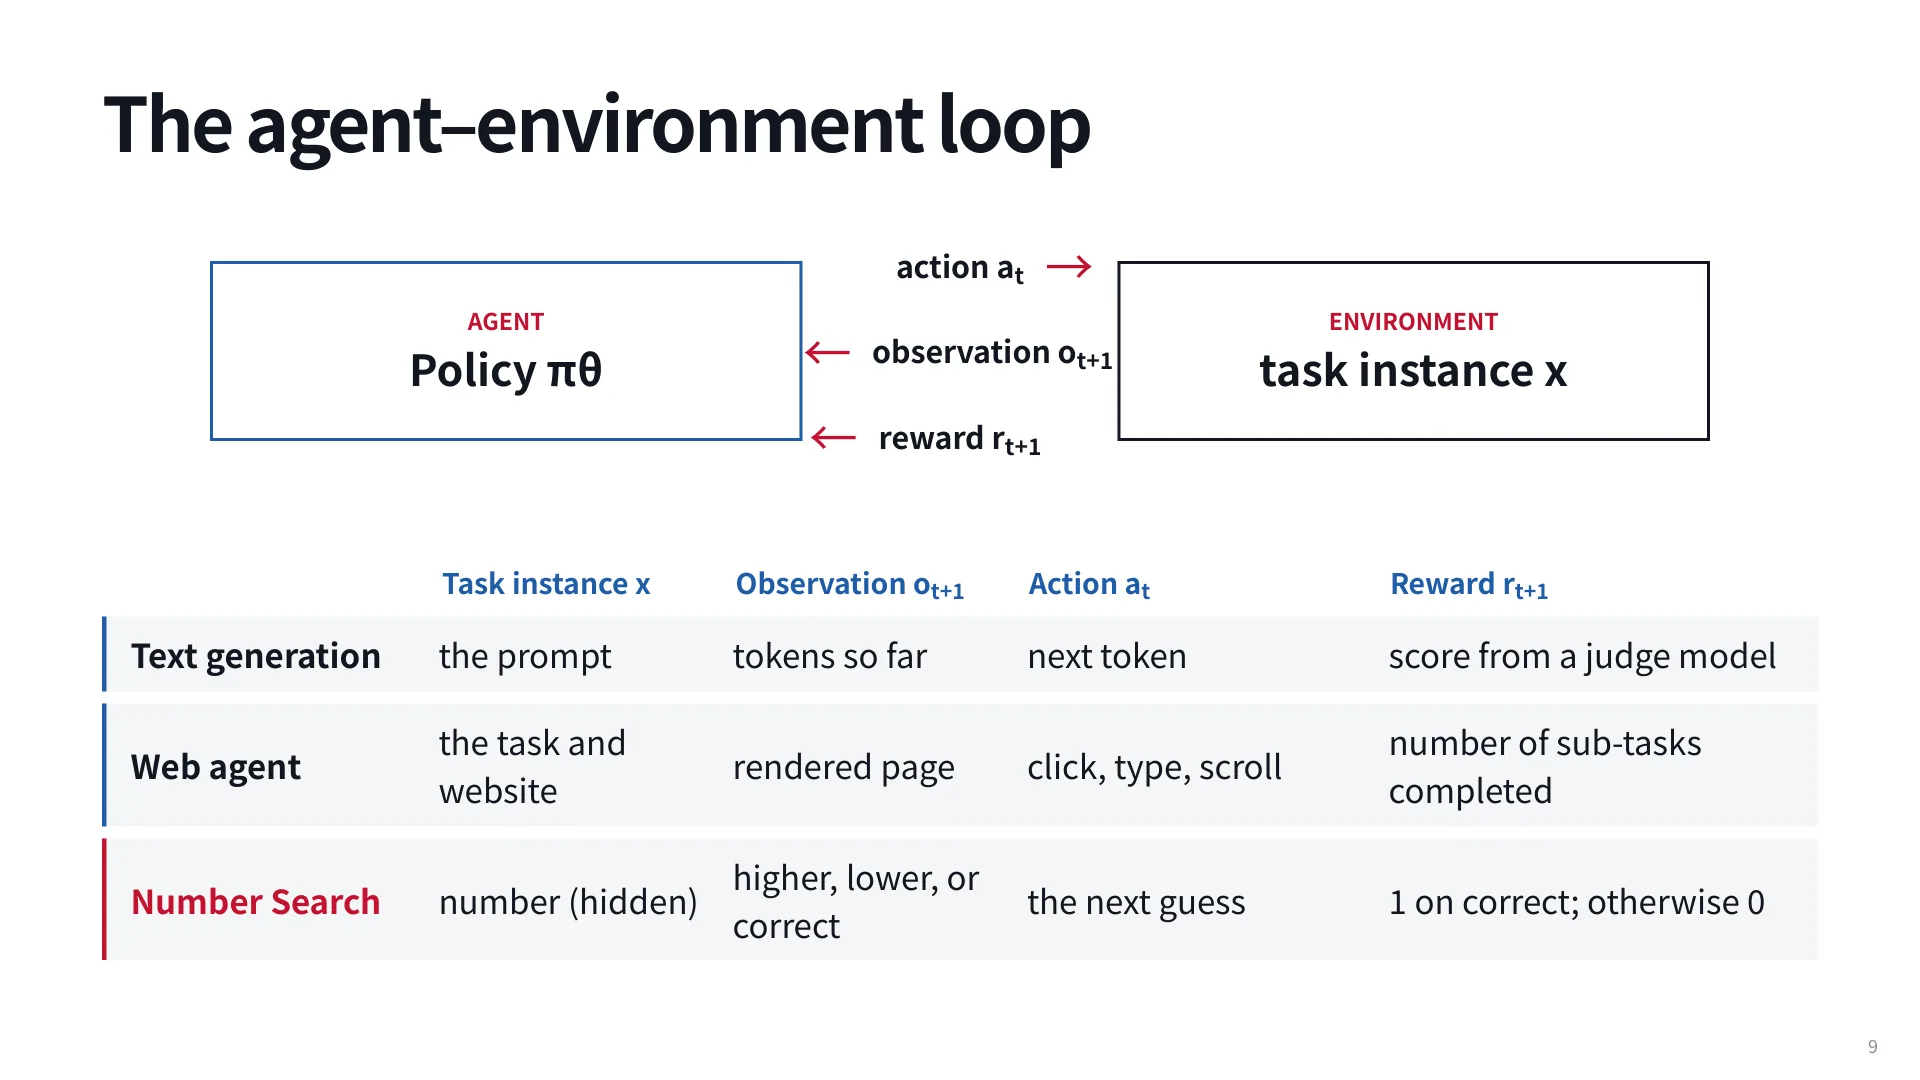
同一套抽象可以套住几乎所有 agent 任务,差别只在四元组怎么填:
| 任务 | task instance | 观测 | 动作 | 奖励 |
|---|---|---|---|---|
| 文本生成 | prompt | 已生成的 token | 下一个 token | judge model 打分 |
| Web agent | 任务 + 网站 | 渲染出的页面 | click / type / scroll | 完成的子任务数 |
| Number Search | 隐藏整数 | higher / lower / correct | 下一次猜测 | 猜中为 1,否则 0 |
奖励可以是终局一次性给出,也可以是每步都有。Number Search 只在最后给分,于是整条轨迹的回报就是各步奖励之和 ,在这种设定下退化为一个 0/1 标量。注意“轨迹”通常也把 reward 写进去,。
轨迹的概率则要拆成两部分:策略选动作的概率,环境给观测和奖励的概率。
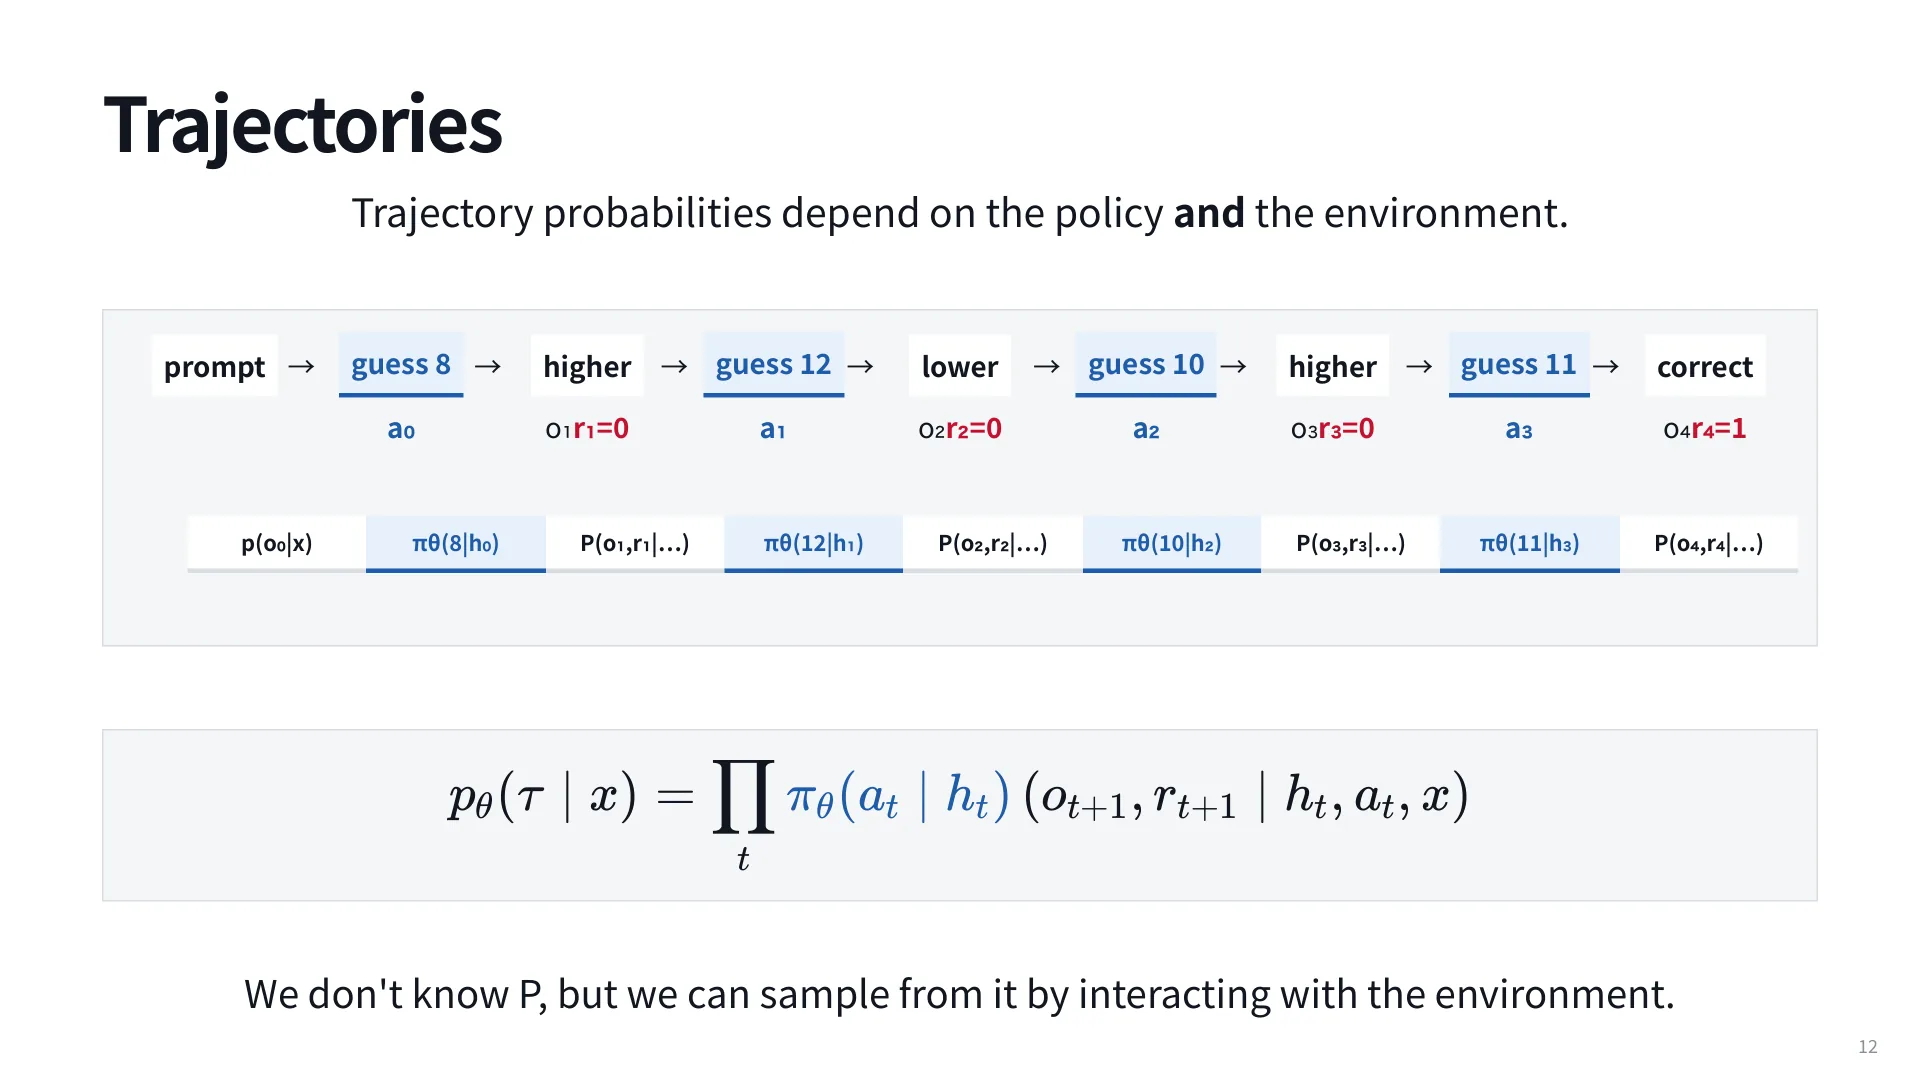
这个分解是后面所有推导的基础,也是 RL 与监督学习最本质的区别:我们不知道 ,也不需要知道。要估计它,只要真的去环境里试一次——采样就是对 的采样(22:01)。“靠试错拿梯度”既是 RL 优雅的地方,也是它昂贵的地方:每个梯度估计背后都是一次真实 rollout,写文件、跑单测、开浏览器,都要花时间与算力。
有了轨迹,目标函数就一句话:最大化期望回报。
课件用一个只有四条轨迹可采的“锐化”策略做算术:概率 0.30、0.20、0.25、0.25 分别对应回报 1、1、0、0,于是 。训练的目标就是把概率质量从红色(失败)搬到蓝色(成功)——理想情况下全部搬到成功轨迹上。
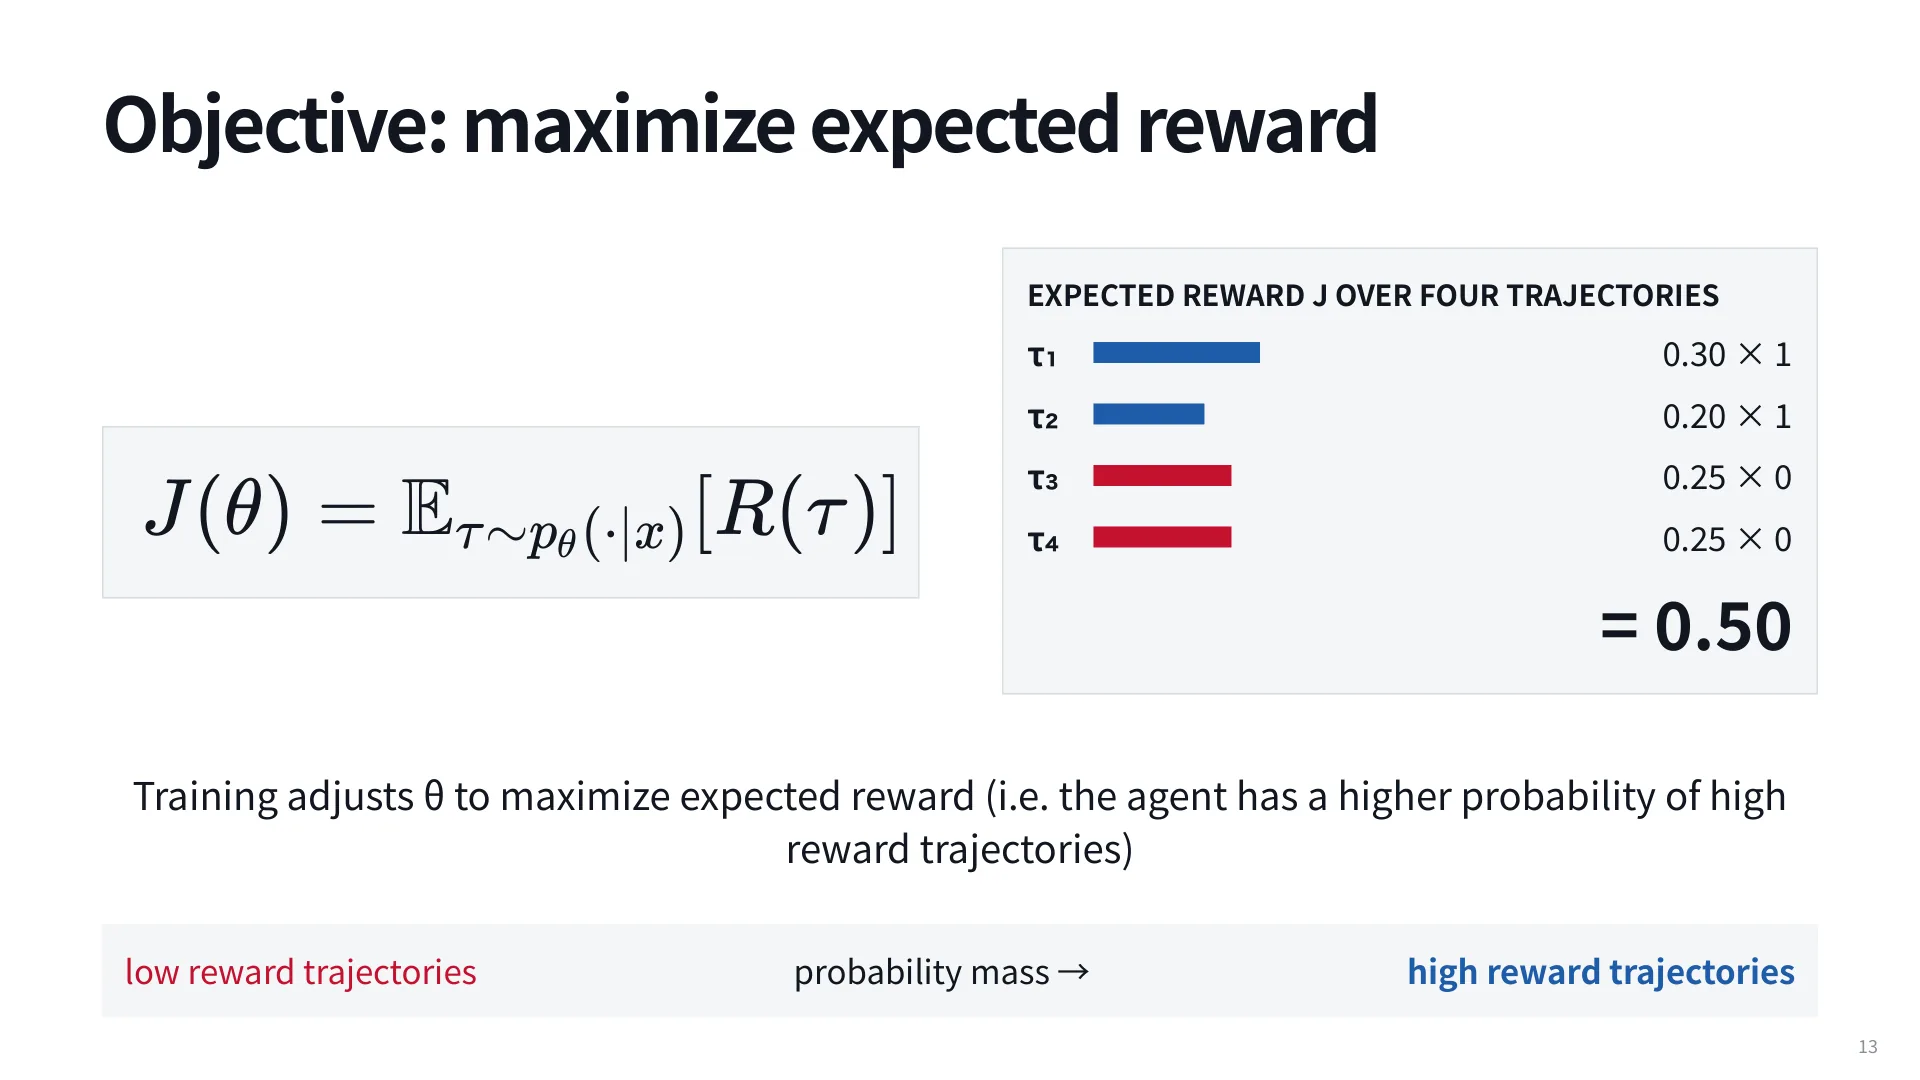
这里要抵抗一个诱惑:既然知道 的定义,为什么不直接对所有轨迹求和再求导?因为轨迹数量随步长指数增长,真实任务里根本枚举不完。只能采样估计,这就把问题推到了“如何对采样估计求导”上。
还有一层容易被略过的结构: 是在 task instance 给定后定义的,实际训练时我们在一批 instance 上求平均。这意味着梯度估计的方差有两个来源——同一道题内部的采样随机性(策略采样、环境随机)与不同题之间的难度差异。前者靠 baseline 压缩,后者靠归一化与采样设计处理;本讲后半段的 GRPO 其实就是把这两件事分开处理的一个方案。
5. Expert iteration:ReST 这一族
在进入策略梯度之前,先看一个几乎不改工程就能落地的方案:ReST(reinforced self-training),属于 expert iteration 家族。它把 RL 拆成“生长—改进—重复”三步:从当前策略采样轨迹并算奖励;用奖励过滤数据、把留下的样本并入数据集、训练策略;再用更新后的策略继续采样(26:55)。
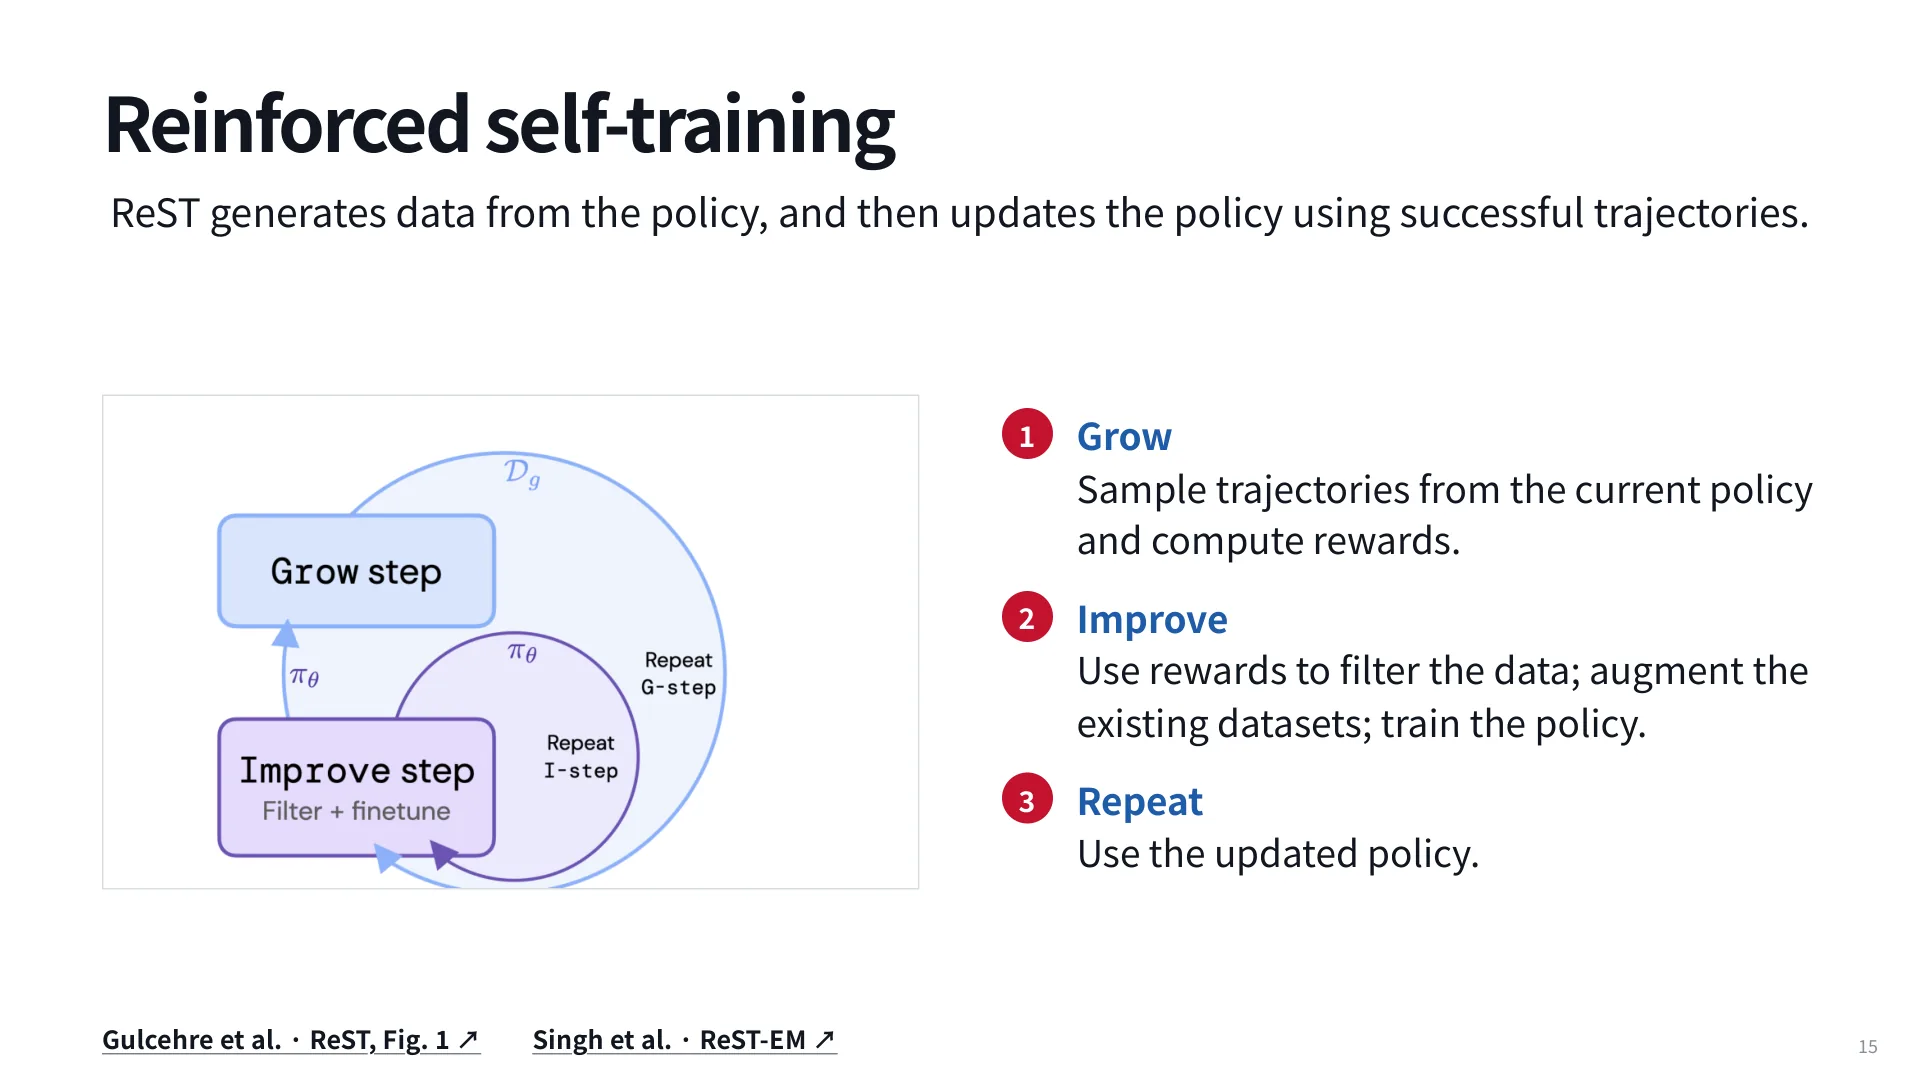
机制上极简单。二值奖励时,“过滤”就是保留 、丢掉 ;损失函数就是这些保留轨迹上的标准 SFT 损失:
、 留下做 SFT,、 丢弃。它与“自蒸馏”的唯一区别就是用 reward 做了筛选:自蒸馏会照单全收模型自己的输出,ReST 只收成功的那些。
ReST 有三个现实优势。其一,复用全部 SFT 基础设施,不需要在线训练框架;其二,数据集可以累积,同一批数据能跑多个 epoch,样本利用率高;其三,二值 reward 下的过滤规则最简单,不需要额外的 critic 或 ratio/clipping 机制。局限也同样明显:失败轨迹被整条丢掉,而“为什么失败”恰恰是最有价值的信息;如果当前策略一次都成功不了,数据集就是空的,训练直接停摆。
最后一点在实践里非常致命。讲师在问答里给了三条思路(31:05):先用示教做 cold start(R1 一类推理模型的做法),让策略至少有非零成功率;用 curriculum 先训简单题、随着能力提升再上难题;设计中间奖励(比如先奖励“找到相关文件”),用 reward shaping 把长任务拆成可学的子目标。第 10 节还会看到第四条——直接换一批更适合当前能力的 task instance。这些做法在后面的 GRPO 里会以另一种形式再次出现,因为它们本质上都在解决“组内没有正样本”的问题。
讲师提醒:ReST 严格来说不算 RL 算法,但它与后面的策略梯度共享同一个直觉——用自己的成功样本来重塑自己。先把它当作 baseline 跑通,再换成 REINFORCE/GRPO,通常能快速定位问题出在数据还是算法。
6. 策略梯度:为什么不能直接反传
现在正面处理 。直接反传有两条路被堵死:
- 采样不可导。 动作是从 里采样出来的离散符号。 变化会改变动作的概率,但几乎处处不改变“这一次采样到了哪个动作”,所以 。
- 环境不可导。 环境是黑盒:怎么对一段代码的单测结果求“关于代码的导数”?怎么对浏览器的下一个页面求导?
所以链式法则在这里断了。REINFORCE(Williams, 1992)给出的解法是纯代数变换,四步:
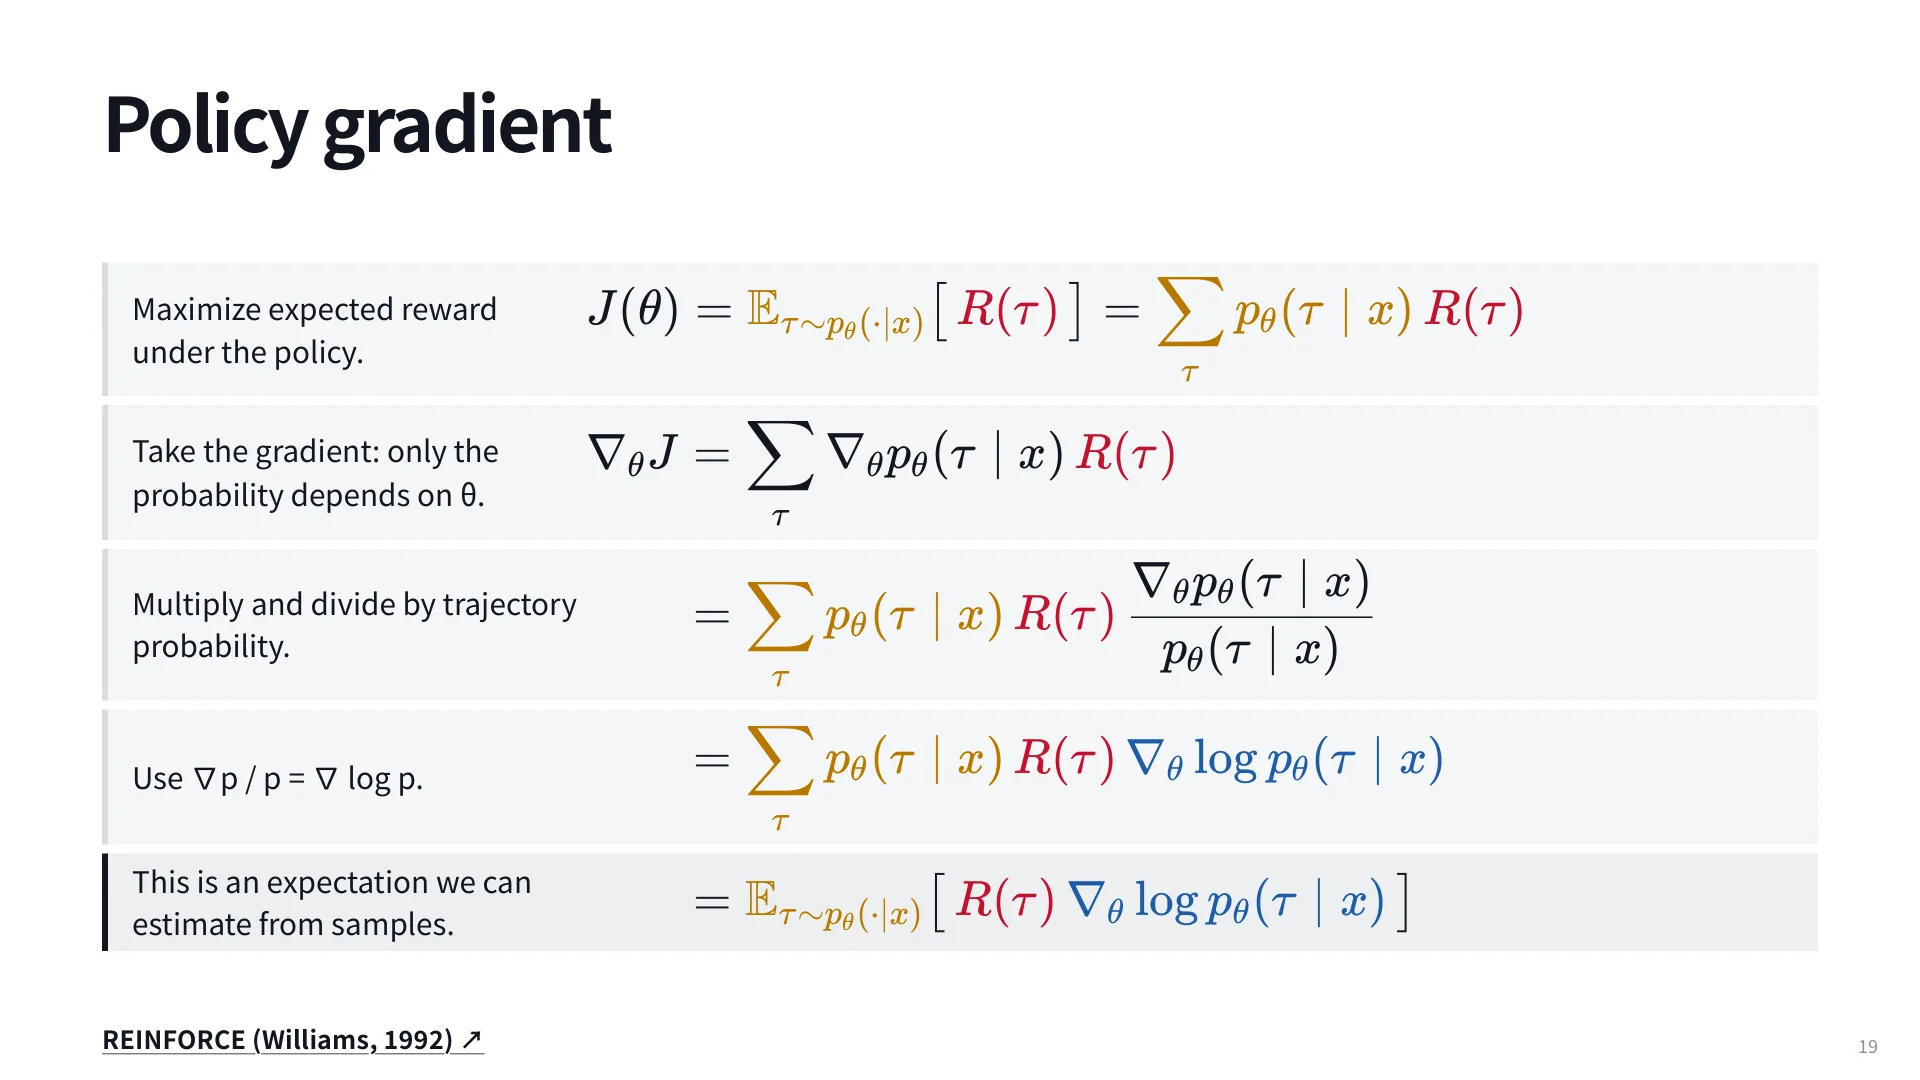
关键在第二步到第三步的恒等式 (score function trick)。它把“对概率求导”换成“对对数概率求导”,而后者正好是语言模型训练时天天算的东西。第四步则把求和变成期望——于是可以用采样平均来估计,不再需要枚举轨迹。梯度从此只依赖两样东西:采样到的轨迹,以及这条轨迹的回报。
展开 还能再简化一层:环境项 不含 ,求导后整项消失,只剩策略项
这一步的意义是:环境的复杂性被彻底甩掉了。不管环境是单测、编译器还是浏览器,只要能把动作序列和最终分数拿回来,梯度就只跟策略自己的 log prob 有关。
落到实现层,一个动作往往由多个 token 组成(一次工具调用可能拆成多个 token),于是
即把一个动作的 log prob 拆成 token 级 log prob 之和——和 SFT 里完全一样的计算,只是 token 由策略采样而来,而不是示教给定。把整条轨迹加起来,就得到可以直接反向传播的损失:
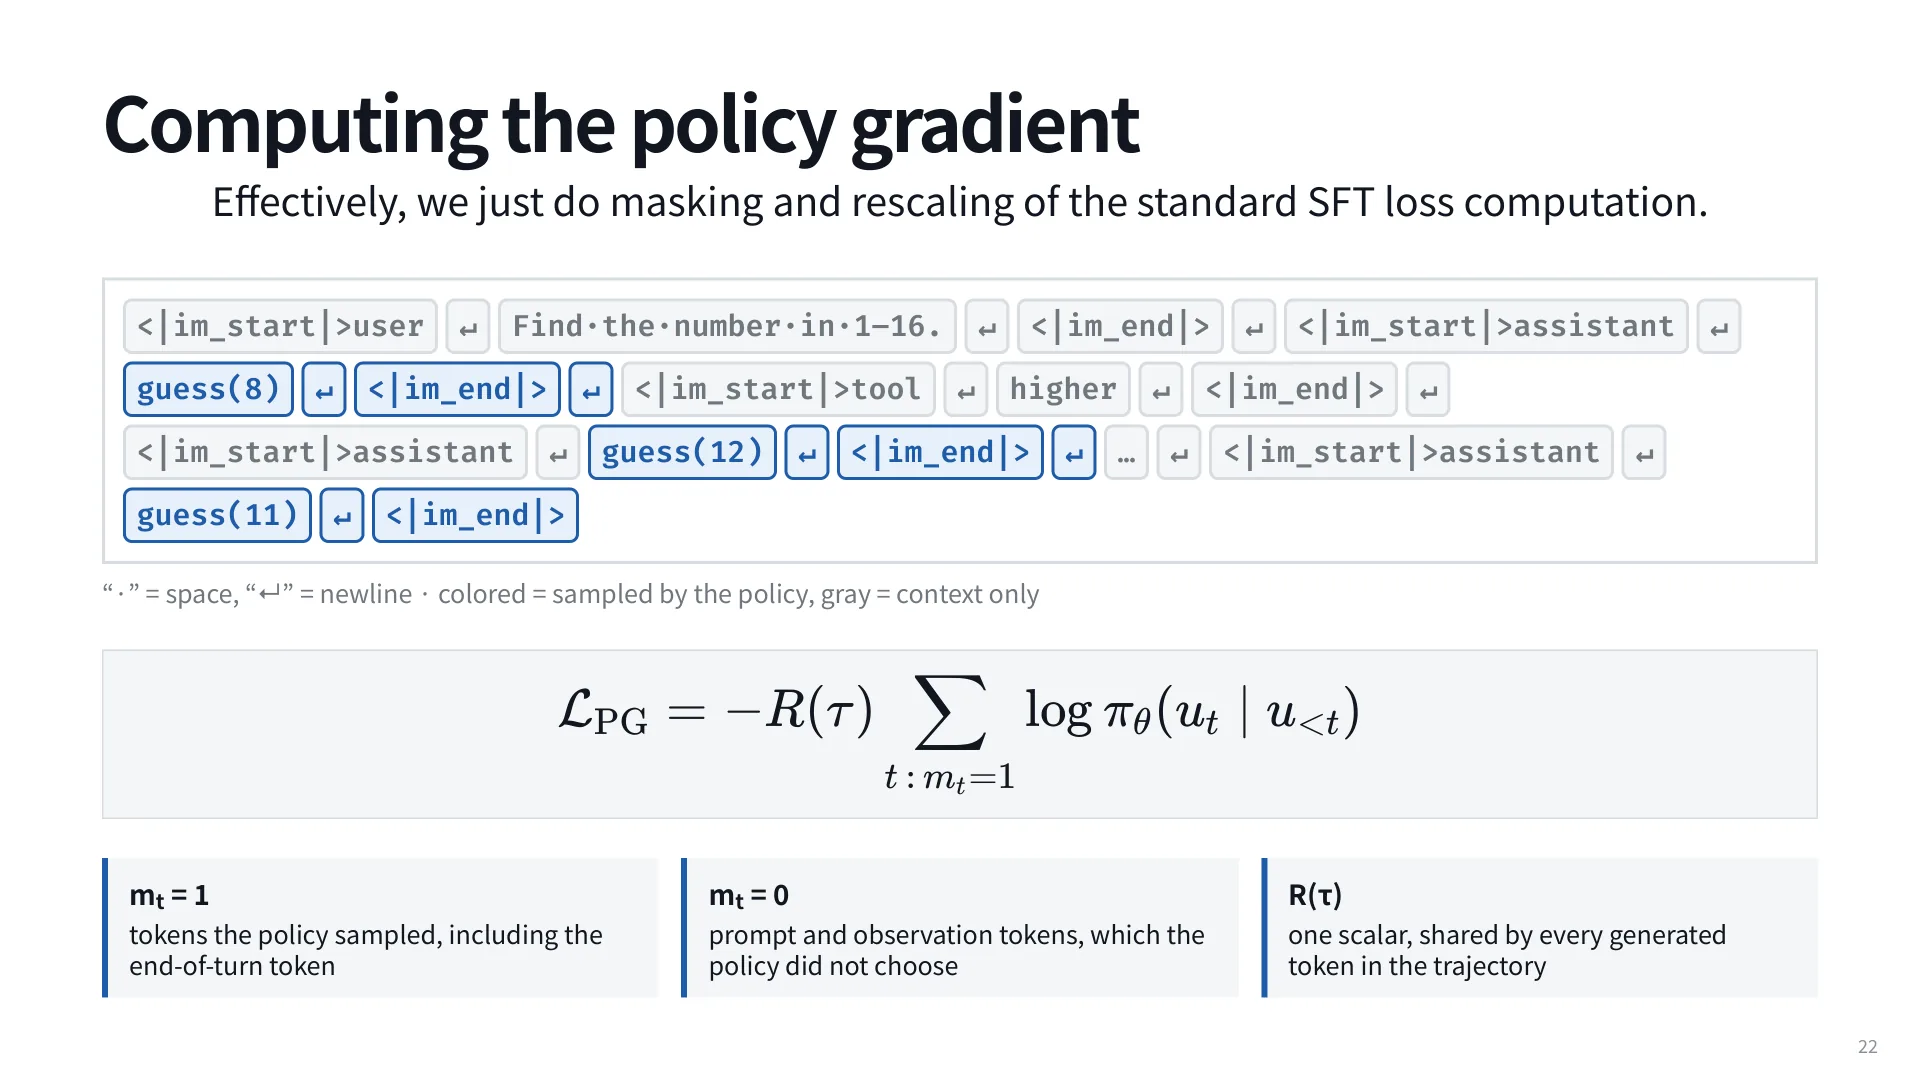
看这张实现图就能明白为什么策略梯度的代码短得惊人。整条序列里,只有策略采样出来的 token参与损失:prompt、工具返回、<|im_start|> 这类由模板或环境写入的 token 全部被 mask 掉,而每轮结束的 <|im_end|> 是策略自己采样的,仍然计入; 是一个标量,乘在整条轨迹所有生成 token 上。也就是说,策略梯度 = 带 mask 的 SFT loss × 回报(41:46)。
讲师在这里讲了一个很有说服力的轶事:他第一次读到用 REINFORCE 训练对话模型的代码(Deal or No Deal? End-to-End Learning for Negotiation Dialogues)时很惊讶——实现居然就是把 SFT 的梯度算出来,再乘一个 reward。数学确实就这么简单,难的是让它稳定工作。
从工程角度看,策略梯度还带来两个隐性成本。第一,必须保证用于更新的 log prob 与产生轨迹的策略一致:朴素 REINFORCE 可以在更新时重新前向计算;但若 rollout 与训练异步,或在同一批数据上做多步更新,就需要保存采样时的 log prob(或引入重要性权重)来修正分布偏移。换了模型或 chat template,这些数值就对不上,梯度会悄悄错掉。第二,rollout 与训练是串行的:采完一批才能更新一次,GPU 在采样阶段大量空转,这也是后面“异步 RL”要解决的问题。理解这两点,再看各种 RL 框架的设计,很多取舍就顺理成章了。
7. 训练循环与 REINFORCE 的失效模式
有了损失,训练循环是标准的四拍:采样 task instance 并从策略 rollout;用环境算每条轨迹的 reward;用 reward 加权动作 log prob 形成损失;反向传播更新 ,然后重新采样。朴素 REINFORCE 下每个 instance 只采一条轨迹,batch size 就等于 instance 数;GRPO 会改成每个 instance 采一组。
二值奖励时,REINFORCE 与 ReST 在数学上几乎重合: 的轨迹贡献 SFT 损失, 的轨迹贡献为零,等价于“只在成功轨迹上做 SFT”。差别在于节奏——REINFORCE 完全在线,采完立刻更新;ReST 先把数据攒成数据集,再跑若干 epoch。前者新鲜但噪声大,后者稳定但会用旧策略的数据。
批量的组织方式直接影响方差。朴素 REINFORCE 每个 instance 只采一条轨迹,一条轨迹只提供一个标量回报,于是“这批数据好不好”几乎完全由运气决定;要压住噪声只能把 batch 开得很大,而每条样本都要真实跑一次环境,成本随 batch 线性上涨。这也是为什么后来的方法普遍改成“同一道题多采几条”:同一道题内部的对比能把“题目难度”这个最大的方差来源消掉,只留下“策略在这道题上的表现差异”。
真正的问题出在 这一侧。看 与 的对比:成功轨迹里每一个动作(包括猜 8 这种常规动作)都被同一个 往上推;失败轨迹里每个动作的权重都是 0,于是整条轨迹一点梯度都不产生(45:50)。模型做错了,却得不到“别这么做”的信号——这正是数据失配没有被真正解决的地方。
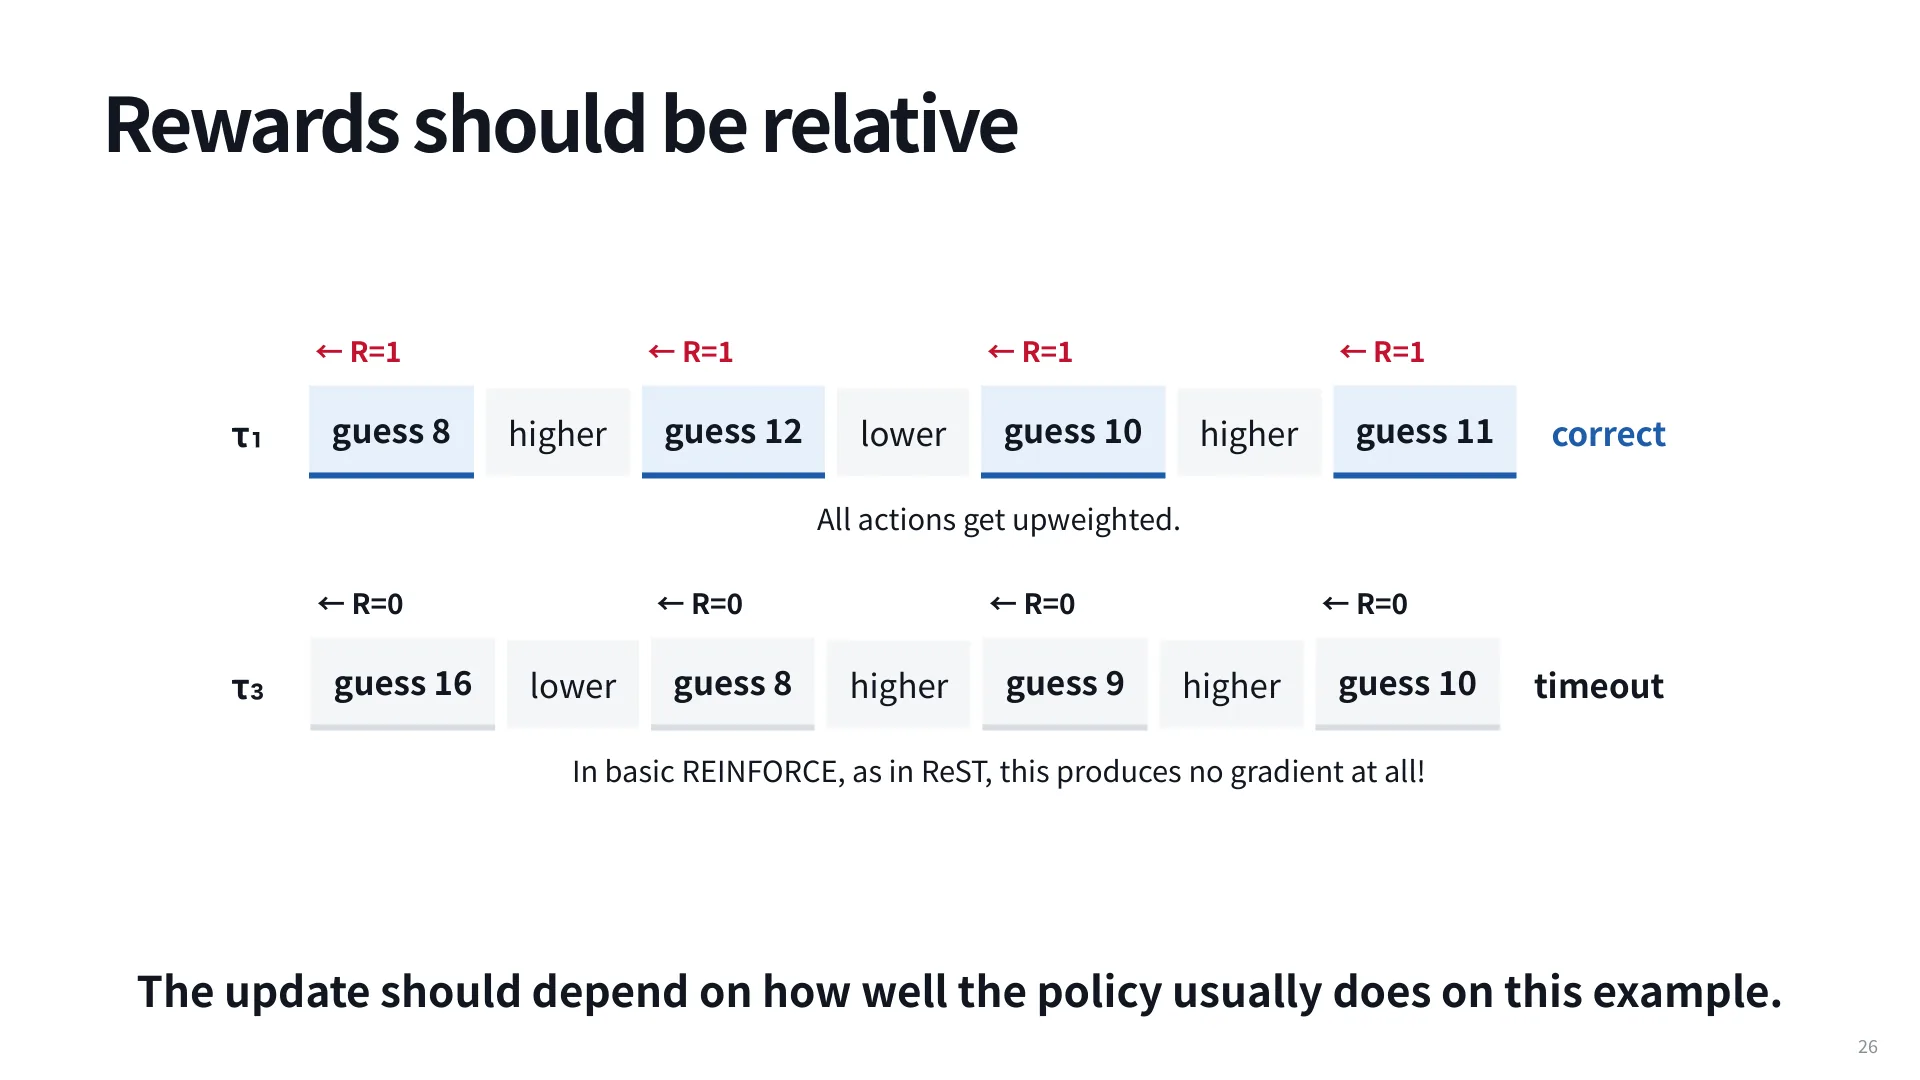
更细一层:即使在同一批成功轨迹里,(最优)和 (浪费了一步)拿到的权重都是 1。而 里那个次优的“猜 4”被强化了,这不是我们想要的。奖励应该相对于“这个策略在这道题上通常能拿多少”来解读:如果一道题模型有 95% 的概率做对,偶尔一次失败就该被重罚;如果一道题只有 5% 的成功率,成功一次则值得大幅上调。绝对分数无法表达这种相对性。
8. Baseline 与 advantage
形式化“比预期好多少”的量叫 advantage:
其中 是“在 处执行 、之后继续按策略行动”的期望回报, 是“从 开始按策略行动”的期望回报。两者相减,衡量的就是这个动作比策略的平均水平好多少。
课件给了一个能直接心算的例子:历史是“猜 8 → higher,猜 12 → lower”,于是数字在 9、10、11 之中,还剩两次机会。此时猜 11 很糟——如果不对,只剩 9 和 10 两个候选却只剩一次机会,;猜 10 很好——即使错了也只剩一个候选、一次机会,(48:19)。两个动作得到的反馈都只是 higher 或 lower,价值却完全不同,这个差别只有用“后续还能不能赢”才能算出来。
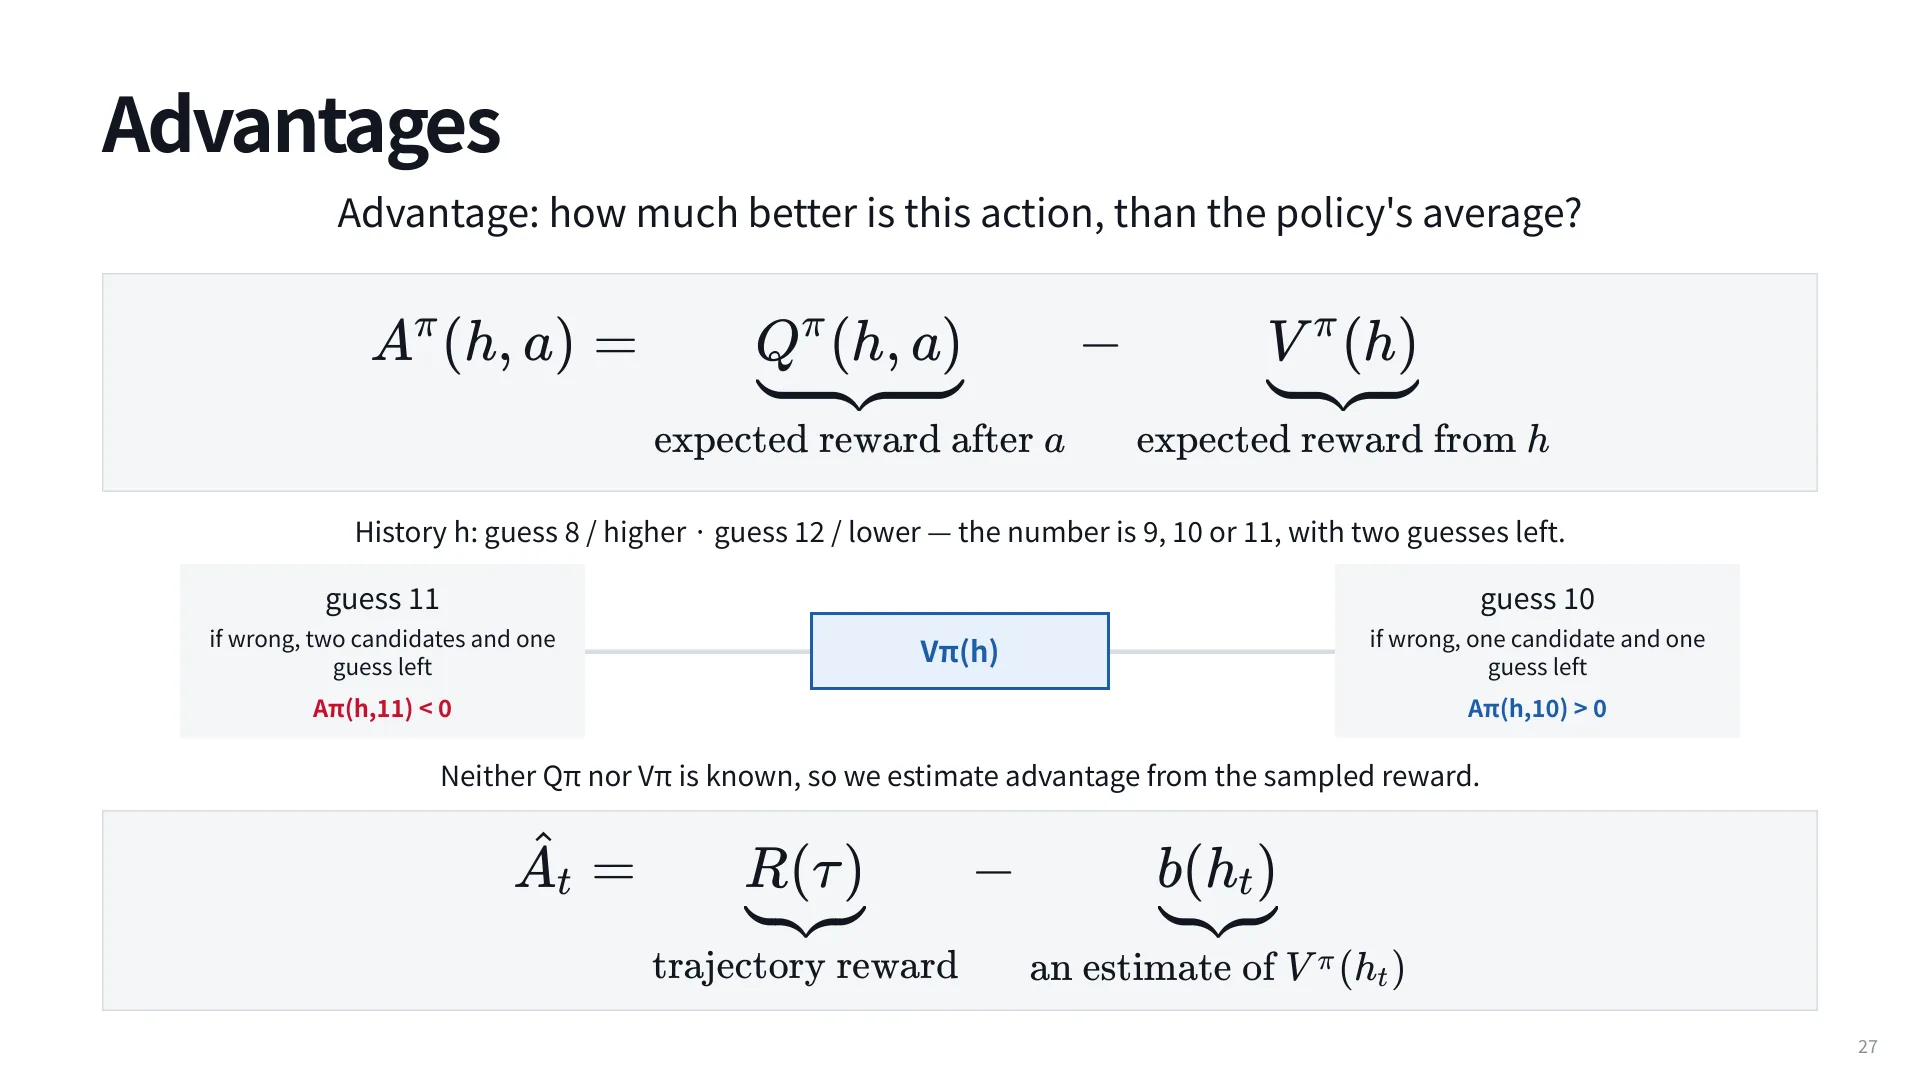
和 都未知,但可以估:拿采样到的轨迹回报 当作“这个动作之后实际发生了什么”,拿一个只依赖历史的函数 当作 的估计,于是
的选择直接决定算法:
| baseline | 典型算法 | 特点 |
|---|---|---|
| 常数 | 教学示例、bandit | 简单,几乎无成本 |
| reward 的滑动平均 | REINFORCE 变体 | 随策略变强自动调整 |
| 训练出来的 value model | actor–critic、PPO | 准,但要额外模型与显存 |
| 同一道题一组 rollout 的均值 | GRPO / DrGRPO | 不需要额外模型 |
8.1 一个能算清的两臂 bandit
为了看清 baseline 到底做了什么,课件把问题压缩到最小:只有一步决策、两个动作、一个参数。策略是 选 A, 选 B;A 的奖励是 1,B 的奖励是 0。取 使得 ——这是个坏策略,因为它把 75% 的概率放在没有奖励的动作上,我们希望 变大。
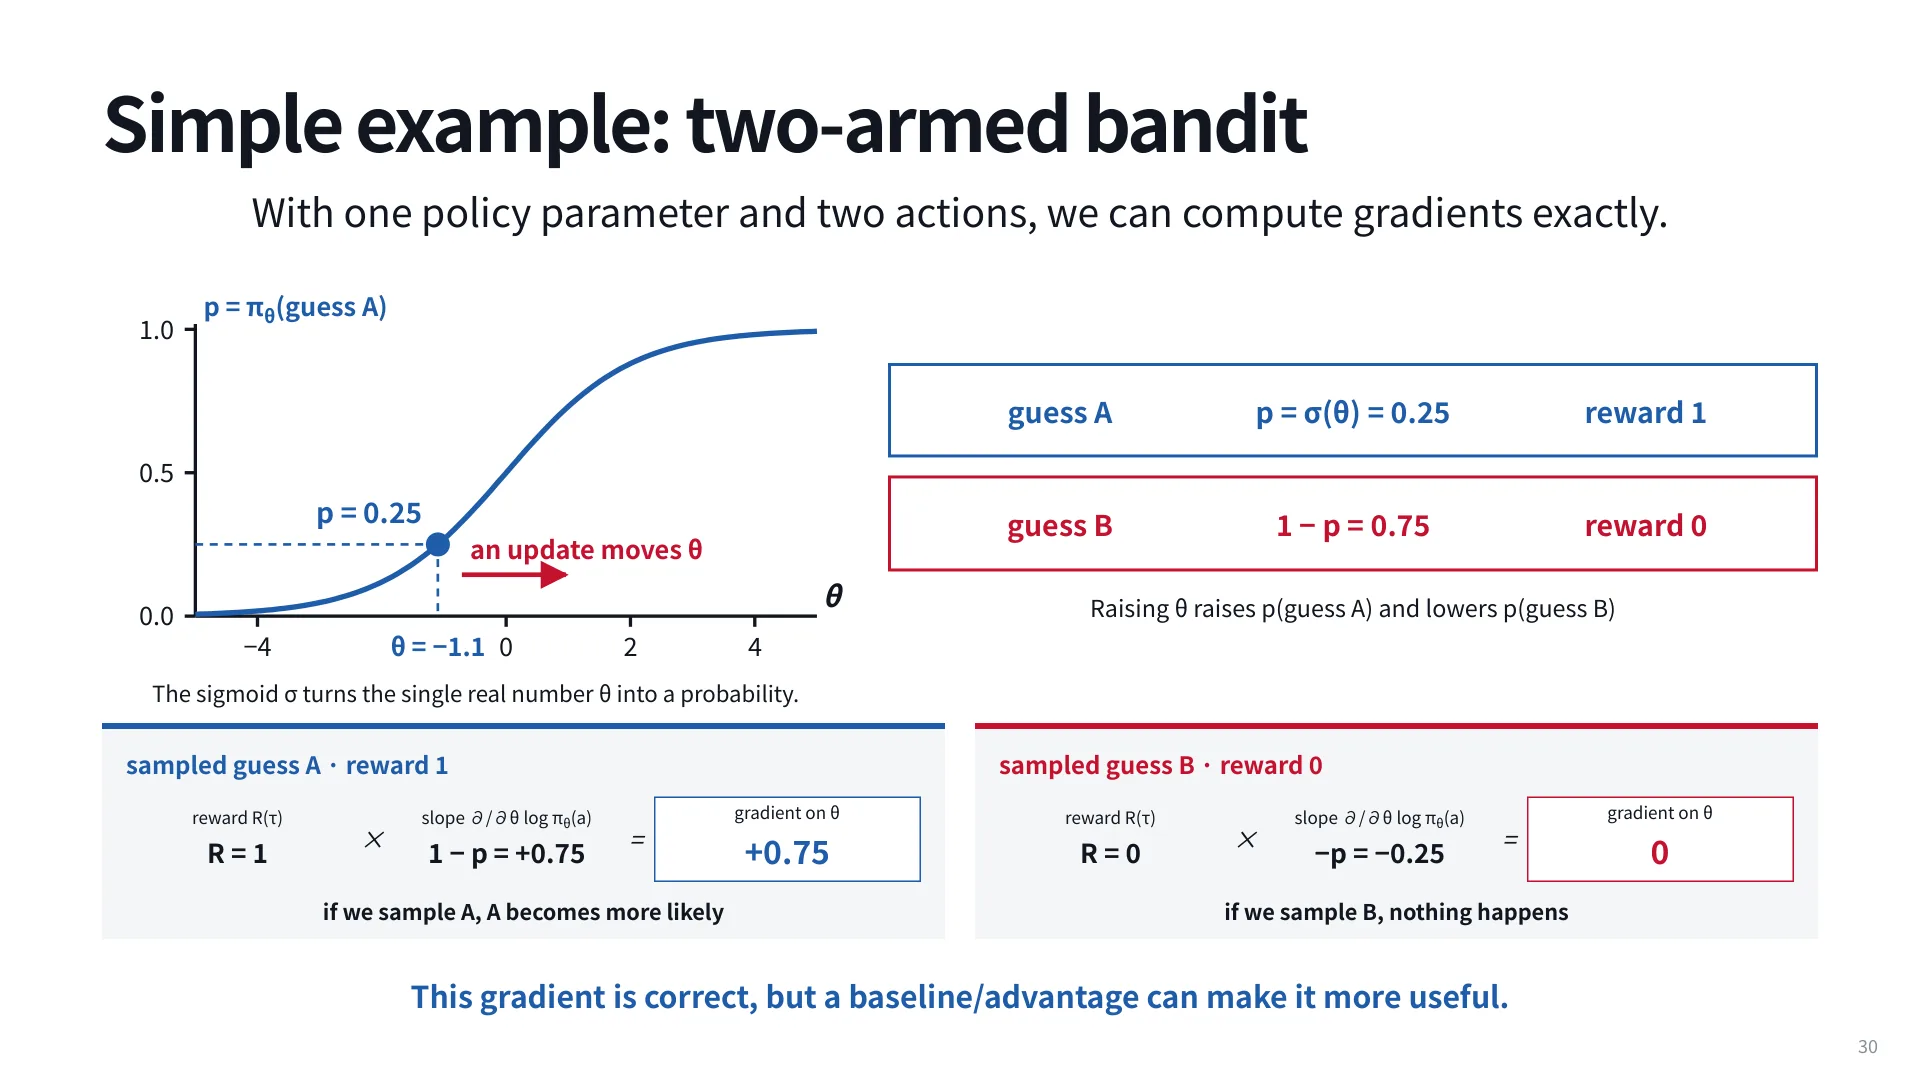
按 算:
- 采样 A:,,梯度估计 ;
- 采样 B:,,梯度估计 (乘上 0 就没了)。
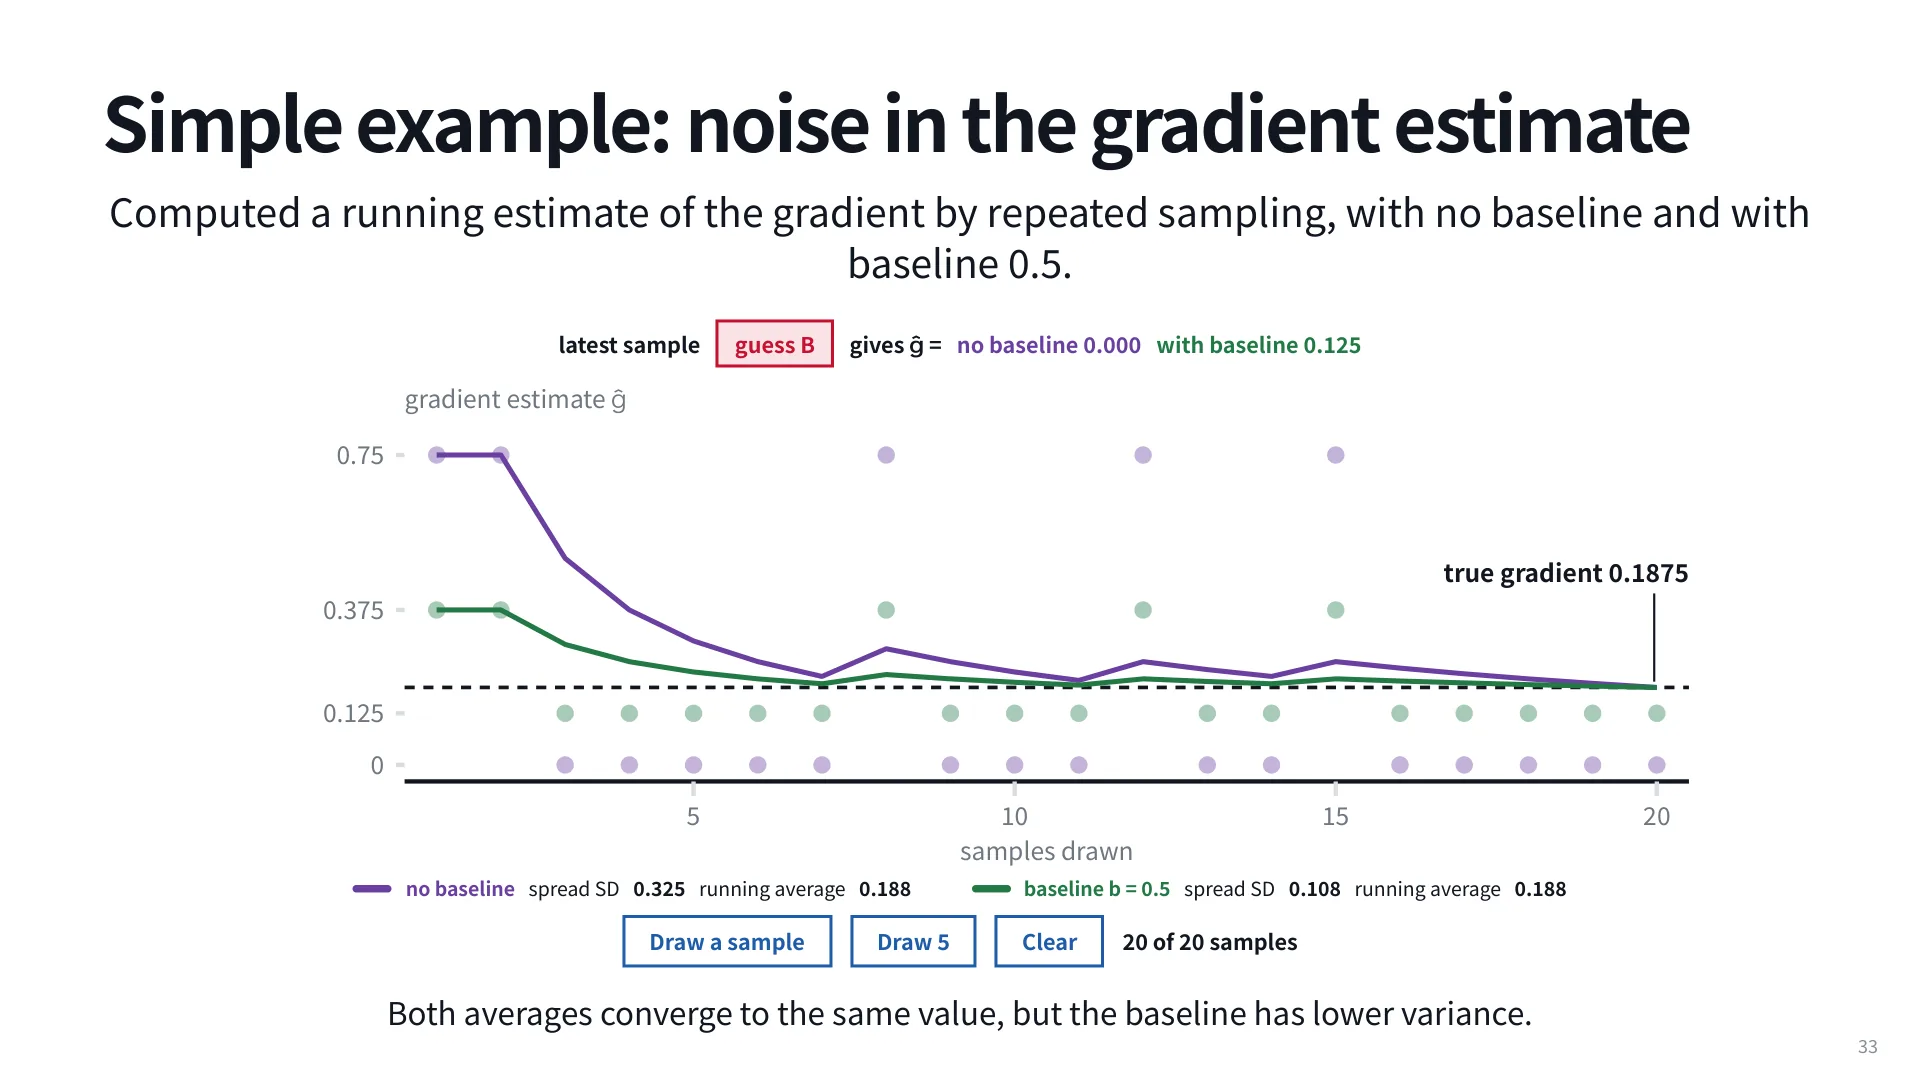
真实梯度是 。也就是说,25% 的时候我们拿到一个比真值大四倍的更新,75% 的时候什么都不做。方向没错,但噪声极大。
加上 之后,同样的两次采样变成:
- 采样 A:,梯度 ;
- 采样 B:,梯度 。
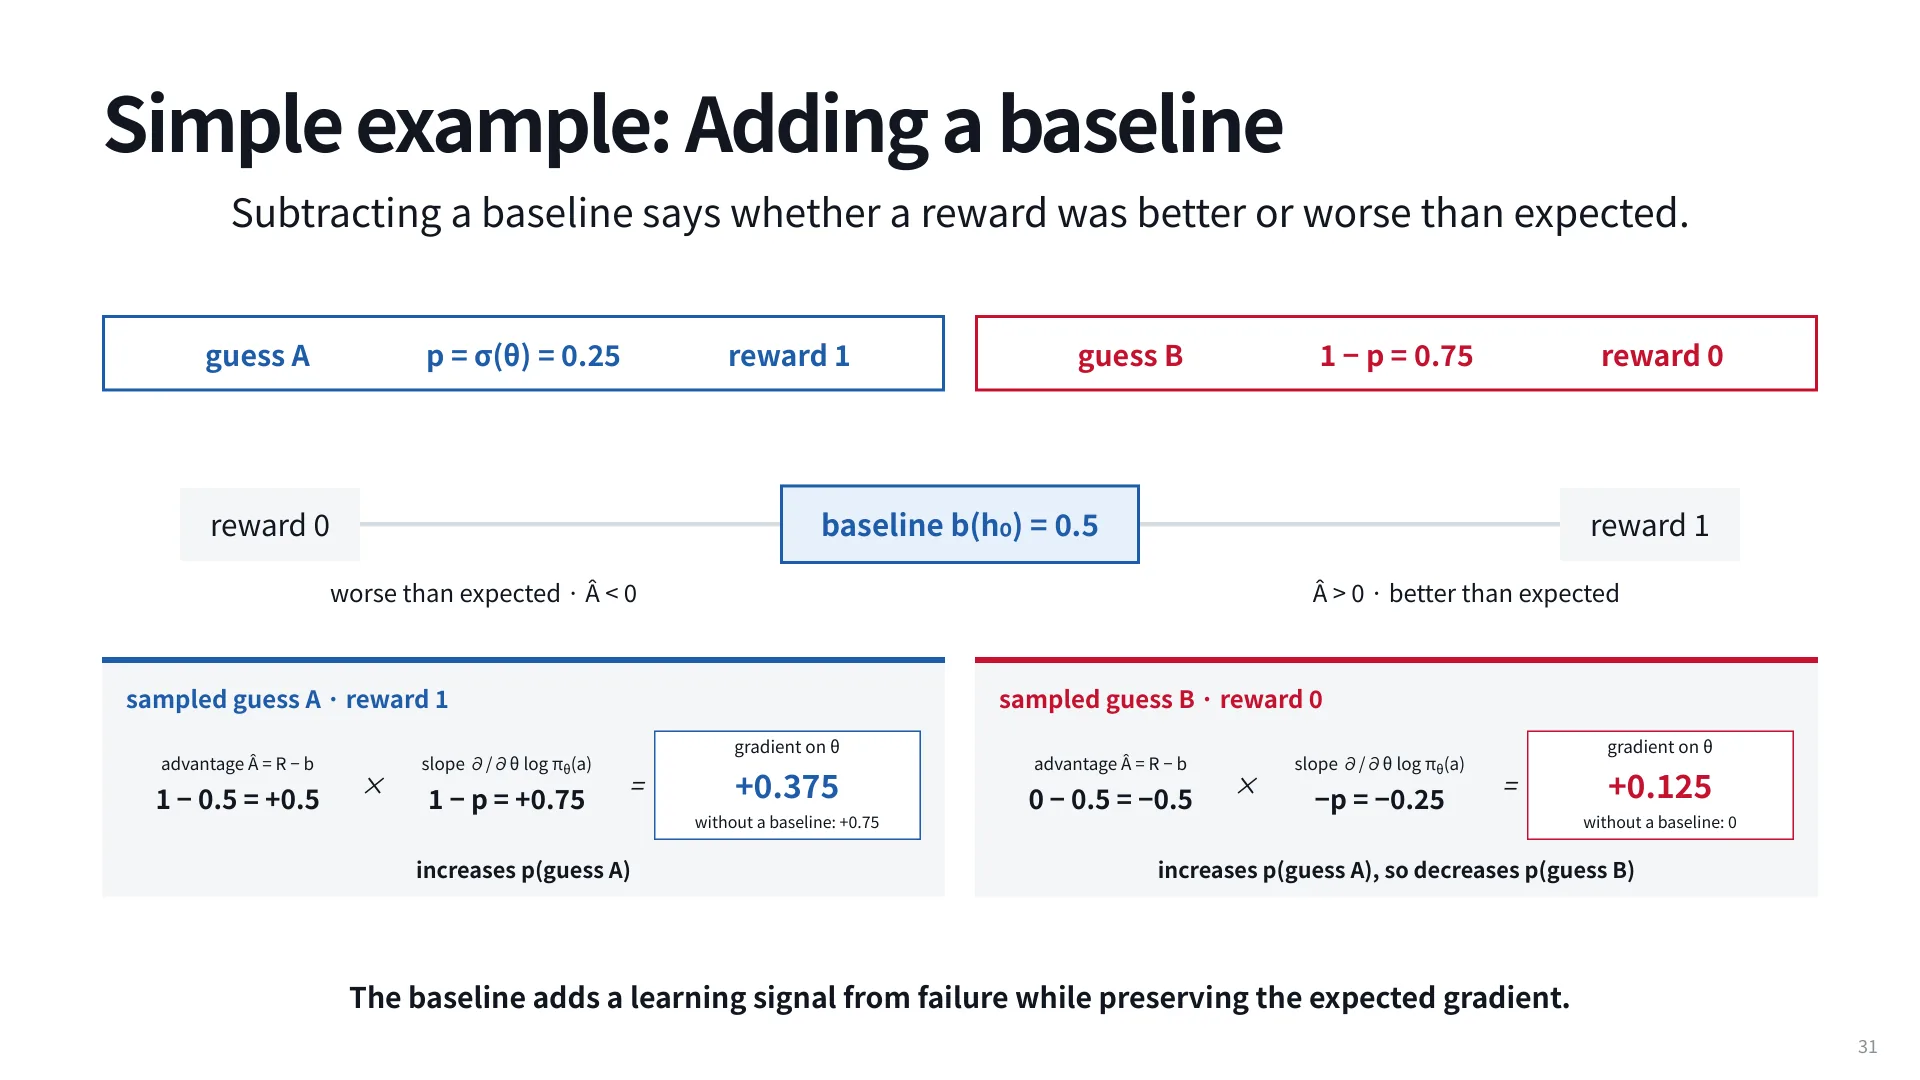
期望仍是 ,一点没变。但两个采样值都往真值靠拢了:标准差从 0.325 降到 0.108,20 次采样的运行平均很快贴着 0.1875 走(59:46)。这就是 baseline 的双重作用——给失败样本一个负号,同时压缩梯度估计的方差。
8.2 为什么减 baseline 不会引入偏差
这件事值得亲手证一遍。把带 baseline 的估计展开:
看第二项里单个 的部分,并对动作取期望:
最后一步用到“所有动作的概率之和恒为 1”,它的梯度必然为零。只要 不依赖当前动作 、只依赖历史,偏差就是零。 这条约束很实际:如果 baseline 里偷偷用了当前动作的信息(比如“这个动作的 Q 值”),无偏性立刻失效,估计就变成有偏的。反过来, 可以任意复杂——常数、滑动平均、神经网络——只要它只看历史。
8.3 baseline 解决不了什么
课件很诚实地列了边界。有帮助的是:标记“比预期好/差”、降低方差、稳定训练。没解决的是:
- credit assignment。 一条轨迹里所有动作共享同一个 ,所以“猜 8”和“猜 11”得到的权重一样。哪一步才是关键的,baseline 不管。
- 本身要估。 用 value model 意味着多一个模型、多一份显存与训练成本,还要保证它跟得上策略的变化。
如果环境在中间步骤就给奖励,还有一个几乎免费降方差的手段:reward-to-go。把动作 的权重换成“它之后所有奖励之和”
因为更早的奖励跟 无关,丢掉它们不引入偏差,却能进一步缩小方差。Number Search 只在终局给分,所以 恒等于 ;但在“每完成一个子任务给 0.2 分”的环境里,这个改动很关键。
讲师提醒:RL 研究里很大一部分工作,本质是在设计更好的 baseline / advantage 估计。选 baseline 时优先问三个问题:它是否只依赖历史(无偏)?它能否跟上策略变化(低偏差)?它需不需要额外模型(成本)?
9. GRPO:拿同一道题的多次 rollout 当 baseline
GRPO(Group Relative Policy Optimization)出自 DeepSeek 的 DeepSeekMath 工作(后来在推理模型上被大量使用),动机非常工程化:value model 很贵,而“期望回报”其实可以直接用同一道题多采几次来估(66:23)。
做法是:对每个 task instance 采 条轨迹(实践中常见 ),算各自的 reward,用组内均值当 baseline:
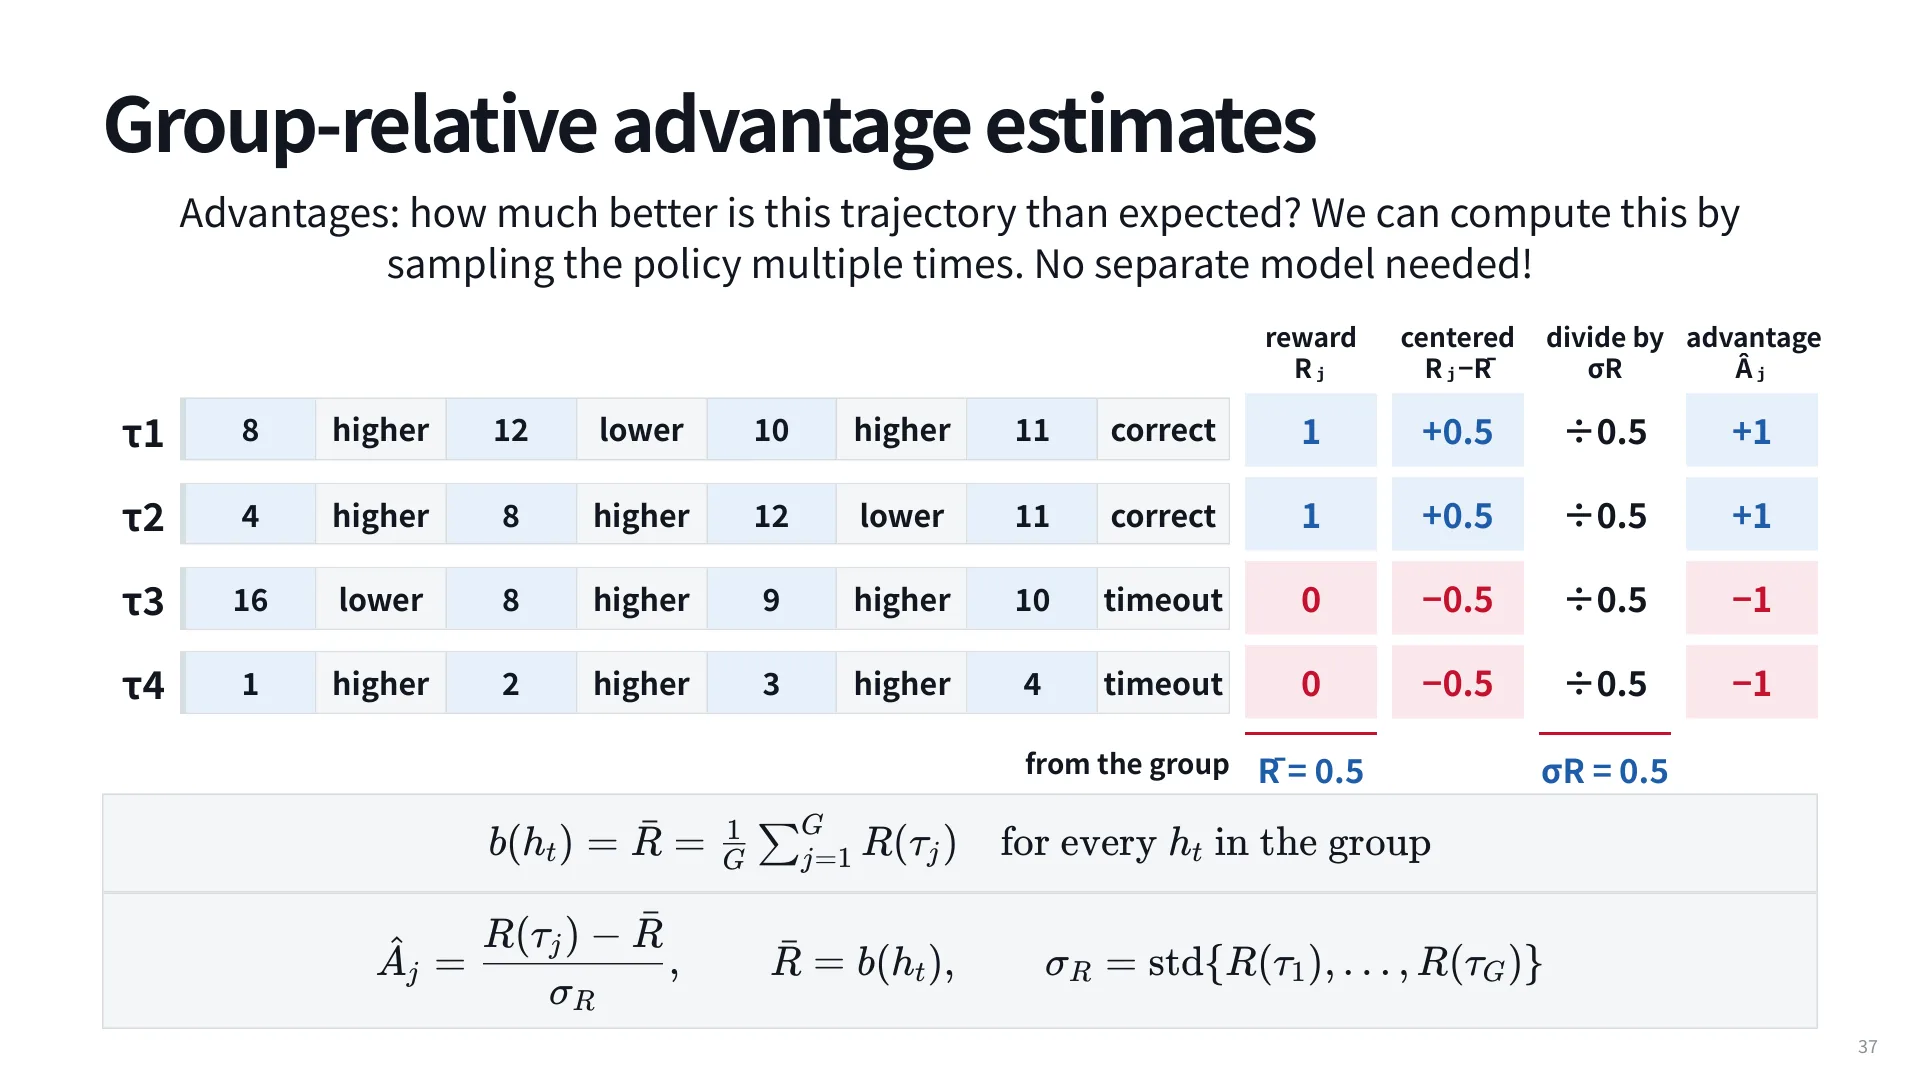
拿前面四条轨迹举例:,,,于是优势变成 。失败轨迹第一次真正带上了负号——这正是第 7 节那个“失败没有梯度”的问题的解药。而且它是无偏的:baseline 只依赖 prompt 和策略本身,不依赖被评估的那个动作。
批量的组织方式也有讲究:一个 batch 里可以放多个 instance,每个 instance 各自一组 rollout,归一化只在组内进行,跨 instance 不混。原因很直白——value 应该回答“这道题上你表现如何”,而不是“你比别的题表现如何”。
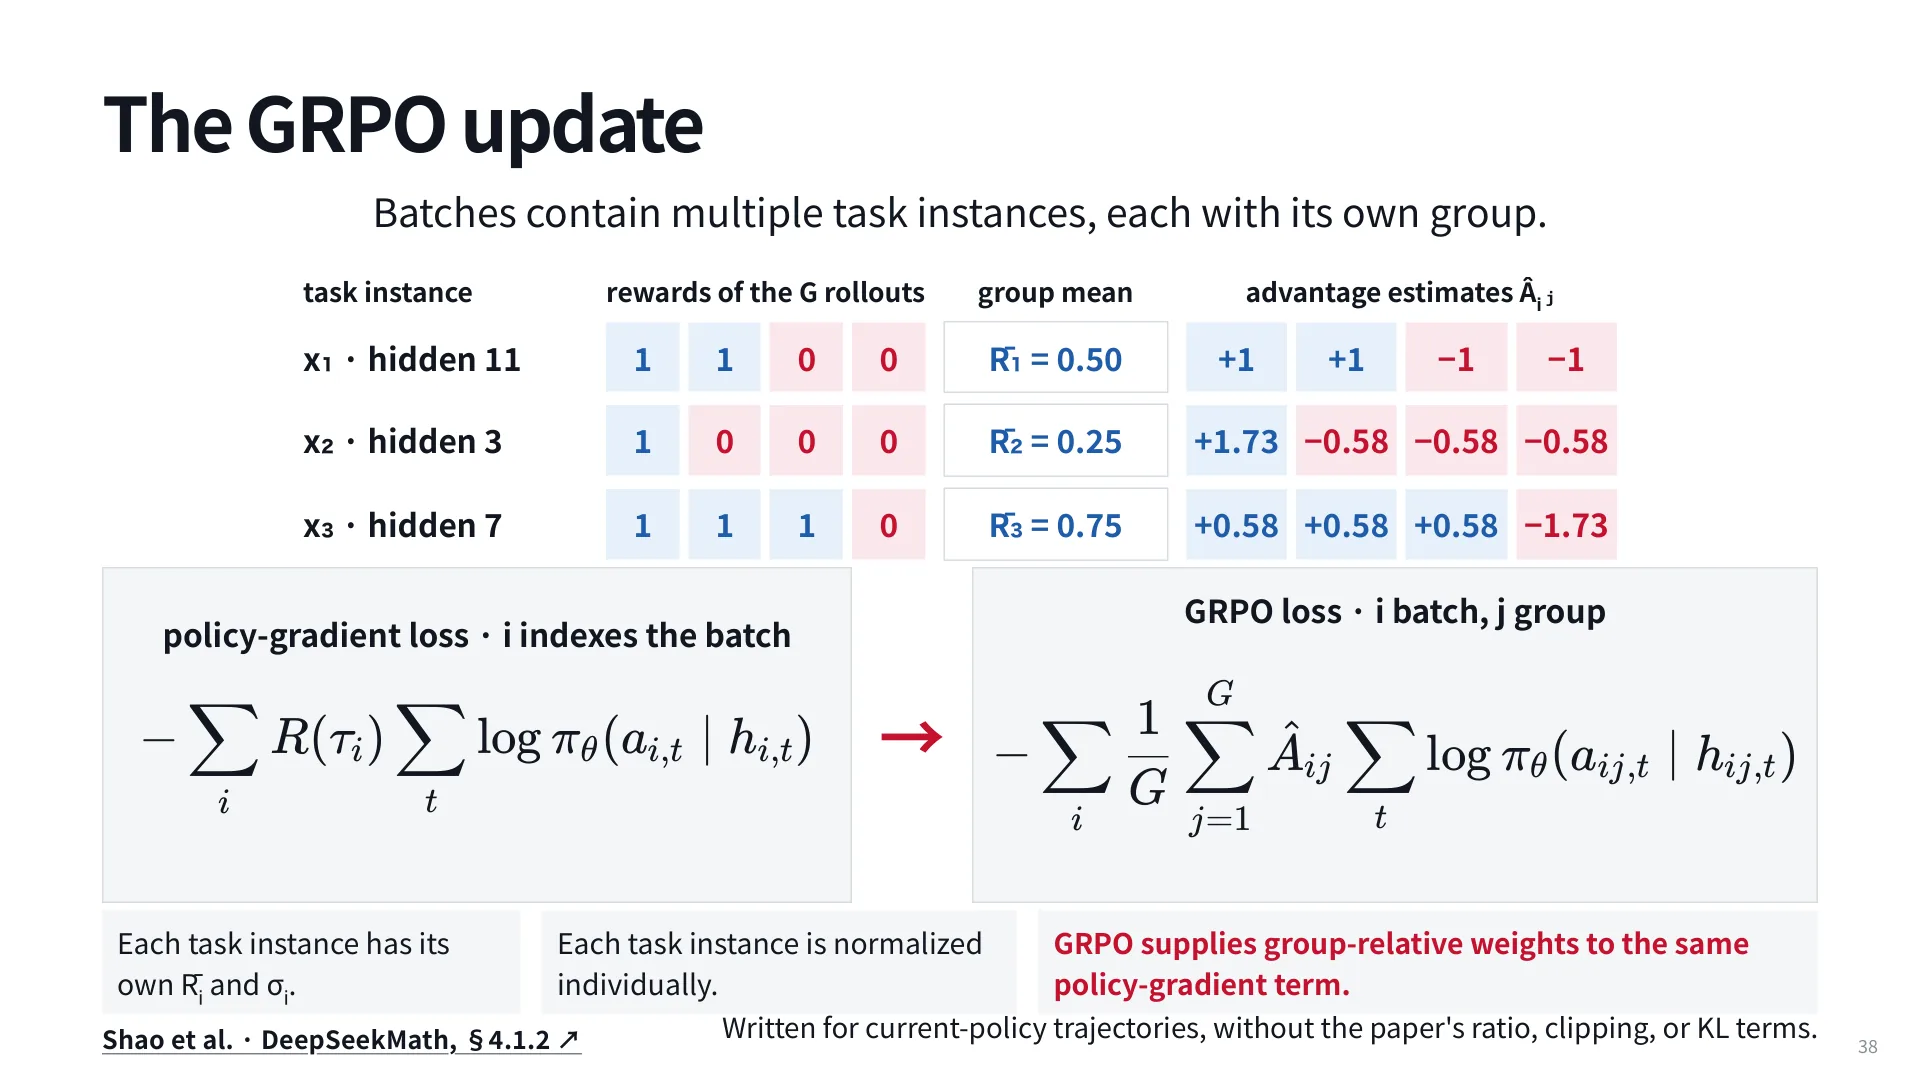
课件把三组数摆在一起: 的 reward 是 ,均值 0.50,优势 ; 是 ,均值 0.25,优势 ; 是 ,均值 0.75,优势 。可以看到同样“答对一次”,在难题 上得到的正权重远大于在简单题 上——这正是“相对难度”的体现。
损失形式几乎不用改:
必须说明的是,这里写的是去掉 ratio、clipping、KL 项之后的简化版。原论文的目标函数还有重要性采样比、裁剪和参考模型正则,用来限制单步更新幅度、防止策略跑偏;这些留到下一讲。本讲只关心 advantage 怎么来。
组大小 是 GRPO 最重要的超参之一。 太小,组内均值本身就是高噪声估计,优势几乎等于噪声; 太大,采样成本线性上升,而且同一道题的 rollout 高度相关,边际收益递减。实践经验通常是 8 左右,具体还要看任务的成功率分布:成功率极端的题(接近 0 或 1)需要更大的组才能采到有区分度的样本。
10. DrGRPO 与退化组
GRPO 里那两个“看起来无害”的归一化,其实各带一个偏置。DrGRPO 把它们都拆了(72:06)。
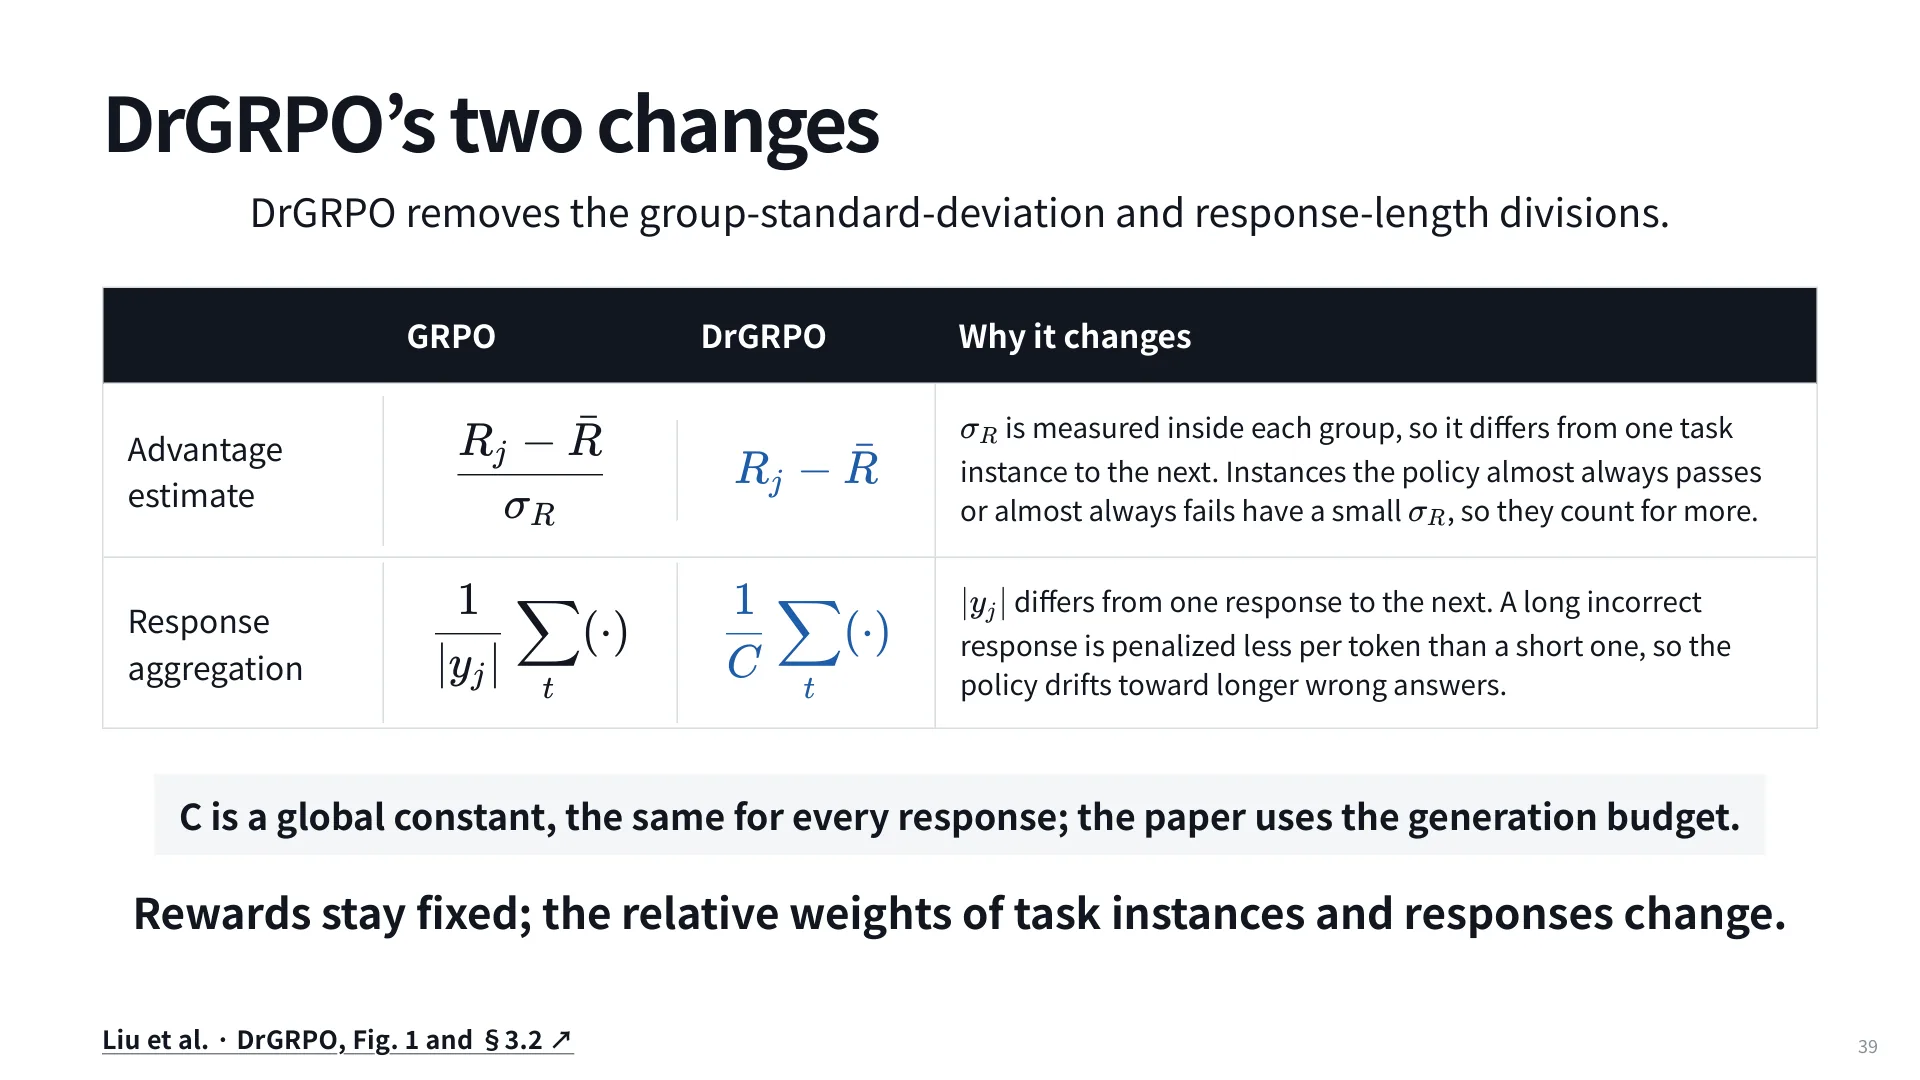
第一个偏置来自 。 标准差是在组内算的,于是不同 instance 的尺度不同:模型几乎全对或几乎全错的题, 很小,除以它之后优势被放大,这些题反而占据了更大权重。结果是“已经会了的题”和“完全不会的题”声音最大,真正有学习价值的中等难度题被压低。DrGRPO 直接去掉除法,只减均值,,让优势保留“绝对差距”的含义。
第二个偏置来自 。 按生成长度归一化,意味着长回答的每个 token 分摊到的权重更小。对错误回答来说,这等于“写得越长,罚得越轻”,于是策略会缓慢漂向又长又错的输出——这是训练中真实出现过的退化。DrGRPO 换成一个全局常数 (论文里用生成长度预算),所有回答用同一把尺子:
两处改动的共同点是:reward 本身没变,变的是不同 instance、不同长度回答之间的相对权重。
10.1 退化组:当一整组拿不到信息
GRPO 有一个 REINFORCE 没有的失效模式:如果组内所有 reward 都相同,减完均值后优势全为 0,这一组对梯度毫无贡献(74:33)。
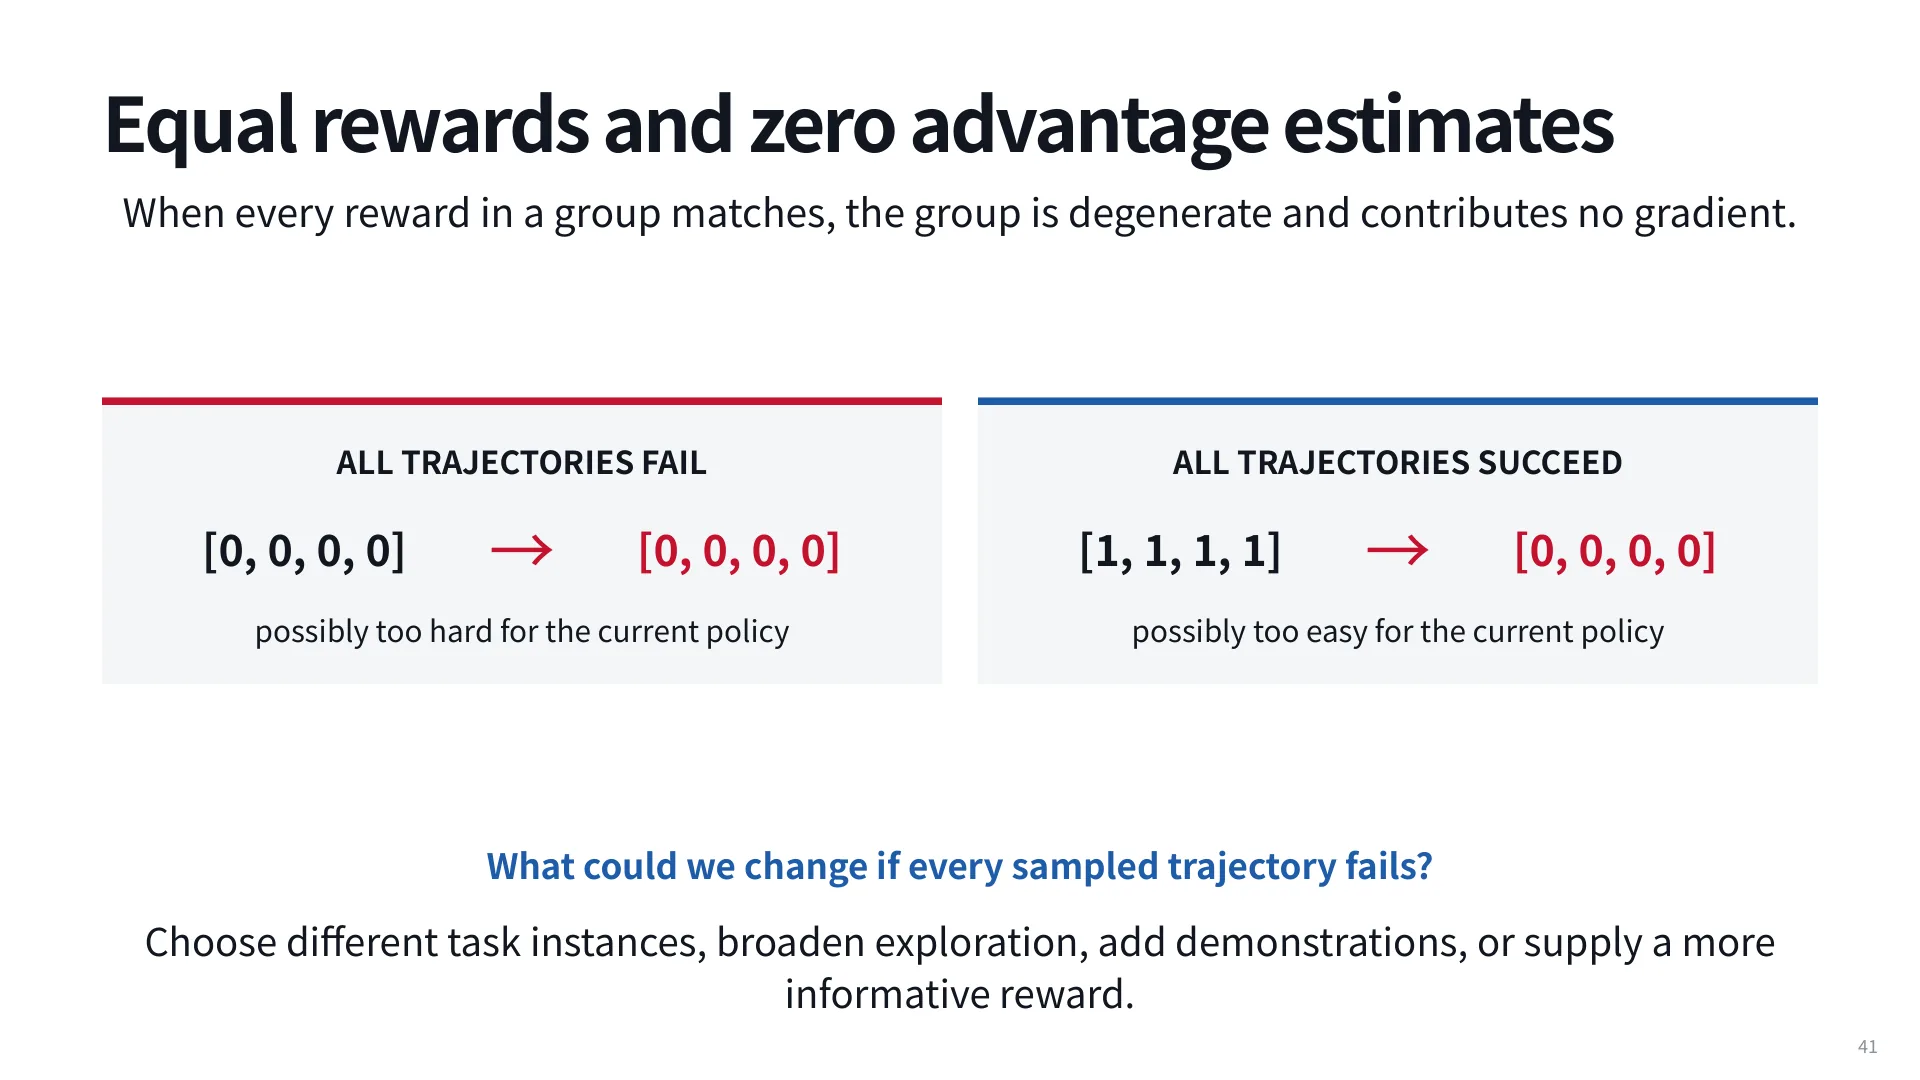
全 0 说明题太难——当前策略一次都做不对;全 1 说明题太简单——做了也没有区分度。两种情况下继续训练都是浪费算力。可选的处理方式包括:换一批 task instance(难度匹配)、扩大探索(例如提高采样温度或增大组大小)、注入示教或冷启动、换更细的奖励(reward shaping,比如先奖励“定位到正确的文件”)。这与第 5 节 ReST 面临的“没有正样本”是同一个问题,只是在 GRPO 里它变成了“没有方差”。
顺带对比一下 PPO:PPO 通常用一个与策略共享 backbone 的 value model 预测 baseline,GRPO 用组内统计量代替。前者省样本、费显存,后者费采样、省模型。GRPO 被提出时的主要卖点正是后者——不需要再训练一个 value model。
不过“省掉 value model”并不等于“免费”:GRPO 的每条样本都必须完整 rollout,长任务上这一步可能比一次前向与反向传播更贵;而 PPO 的 value model 可以在同一批样本上反复使用。选择哪一种,本质上是在“采样贵”与“显存贵”之间做权衡,而不是哪个算法更先进。
11. 统一视角:损失形式只差一个权重
把今天讲的方法排在一起,会发现它们是同一个式子的不同参数化(76:13):
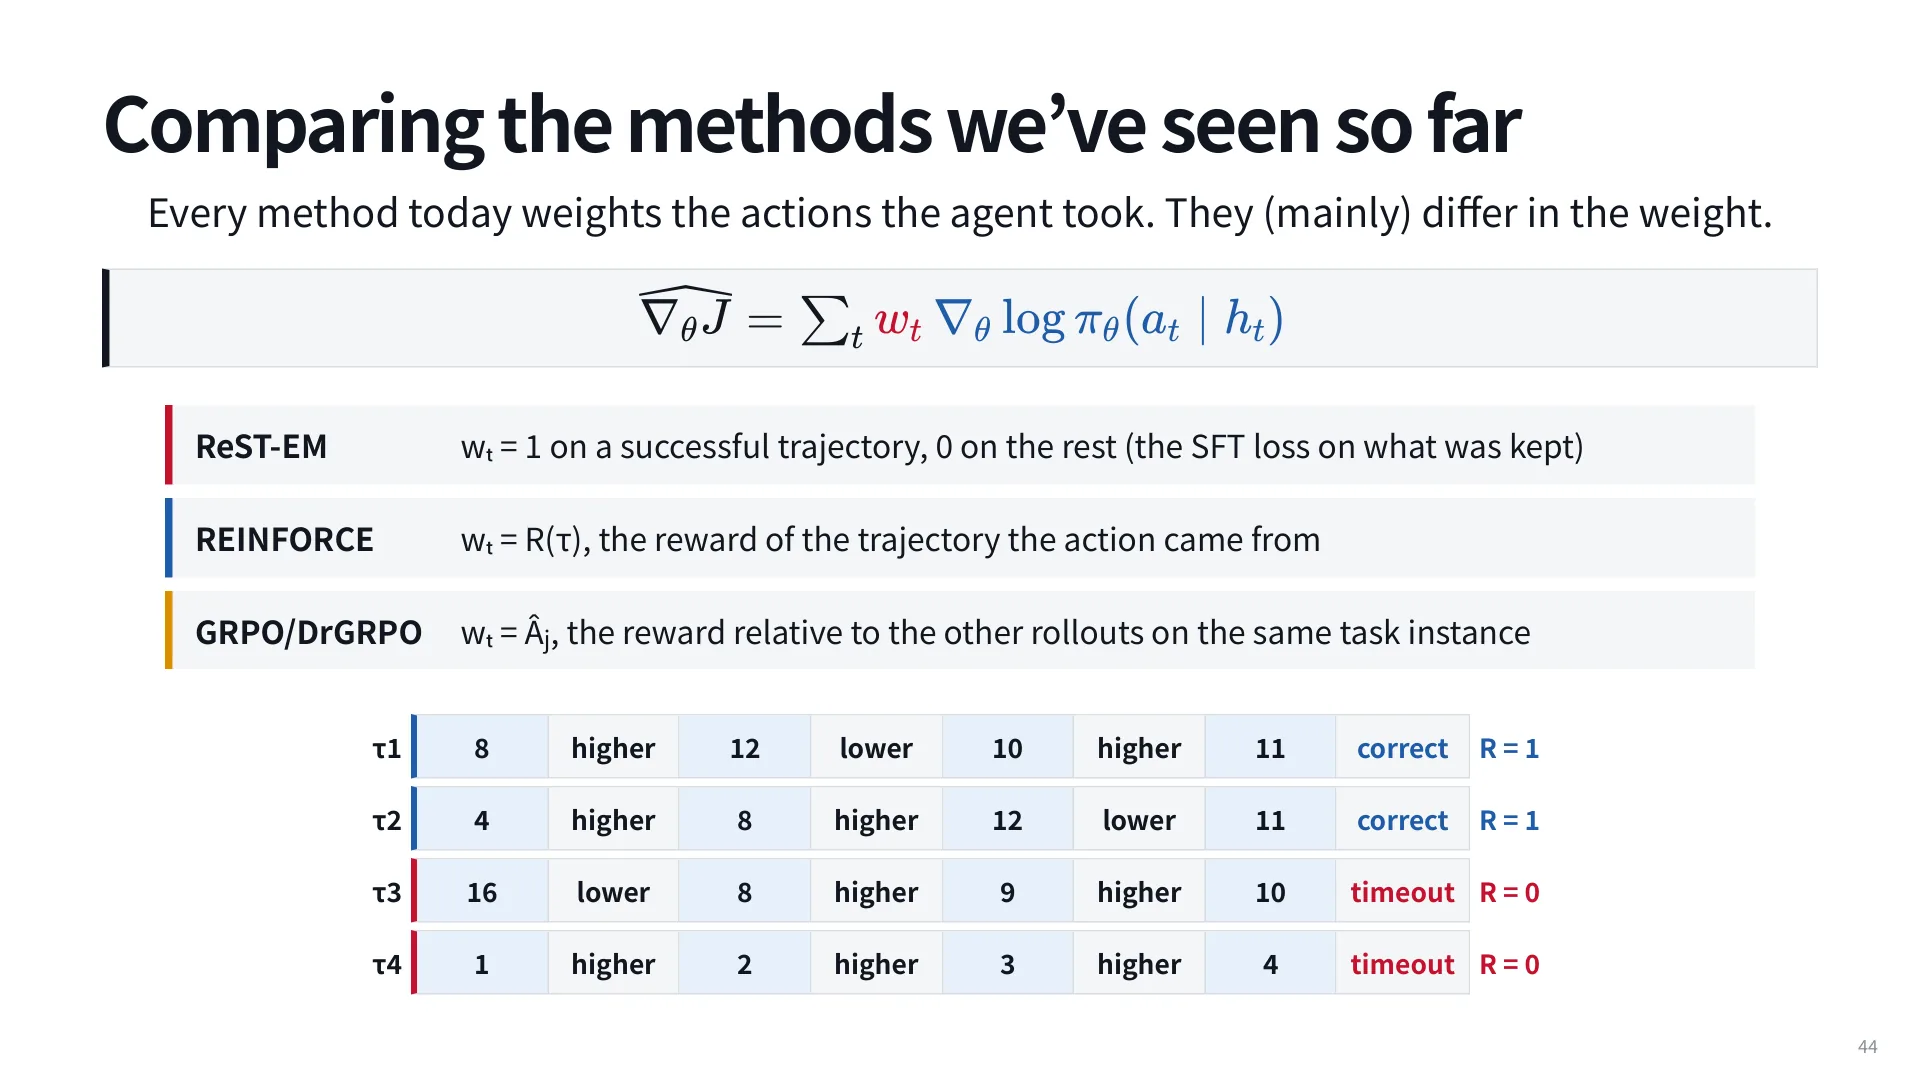
| 方法 | 权重 | 直觉 |
|---|---|---|
| ReST-EM | 成功轨迹为 1,其余为 0 | 只模仿成功的自己 |
| REINFORCE | 按绝对回报加权 | |
| GRPO / DrGRPO | 按“相对同题其他 rollout 的好坏”加权 |
这张表也解释了为什么 assignment 3 里换算法往往只是换几行权重计算:采样、mask、log prob、反向传播全都不变。
回到开头的三个失配,可以给出本讲的结论:任务失配靠“直接优化期望回报”解决;数据失配靠“失败轨迹也能进损失”(baseline 提供负号);exposure bias 靠 on-policy 采样解决。代价是采样成本、梯度噪声,以及一系列工程细节(mask 是否正确、reward 是否有区分度、组是否退化)。
也要清楚这些方法的边界:
- reward 决定上限。 reward 写错,策略会精准地优化错误目标(reward hacking)。单测、judge model、子任务计数都只是代理指标。
- credit assignment 仍然粗糙。 一条轨迹一个标量,中间哪一步关键,只能靠 reward-to-go、过程奖励或更细的建模。
- 方差与成本。 on-policy 意味着每次更新都要重新 rollout;组采样进一步放大成本,长任务上尤其明显。
- 稳定性靠外围机制。 ratio、clipping、KL 正则、参考模型这些“本讲没讲”的部分,恰恰是让训练不崩的关键。
从实践角度看,还有一个反复出现的退化值得警惕:长度漂移。按回答长度归一化会让长错误回答的每个 token 罚得更轻,策略因此可能漂向更长的输出;DrGRPO 的 就是在修这个问题。训练时同时监控每组的 reward 分布与长度分布,通常比只盯 loss 曲线更能提前发现退化。
讲师提醒:如果你要动手训一个 agent,先把 ReST 跑通——它能验证 reward、数据管线、评测三者是否自洽。确认“成功样本存在且可判分”之后,再上 REINFORCE/GRPO,否则你调的是超参,坏的是数据。
术语表
| 术语 | 含义 |
|---|---|
| policy | 给定历史输出动作分布的策略, 为语言模型参数 |
| trajectory | 一次完整的观测—动作—奖励序列 |
| history | 截至 时刻的观测与动作序列,策略唯一的条件输入 |
| POMDP | 部分可观测马尔可夫决策过程;状态不可见,只能用历史做条件 |
| reward | 轨迹级标量评分;RLVR 场景下常为 0/1 |
| expected reward | ,本讲优化的目标 |
| on-policy | 训练数据来自当前策略的采样 |
| RLVR | reinforcement learning with verified rewards;用单测、答案匹配等验证器给出 0/1 奖励的设定 |
| exposure bias | 训练只见示教历史、推理面对自己生成历史的分布偏移 |
| expert iteration / ReST | 采样—按 reward 过滤—对保留样本做 SFT 的迭代方法 |
| REINFORCE | Williams (1992) 的策略梯度算法,用 估计梯度 |
| score function trick | 恒等式 ,把梯度变成可采样的期望 |
| baseline | 只依赖历史的期望回报估计,用于降低方差且不引入偏差 |
| advantage estimate | ,动作相对策略平均水平的好坏 |
| reward-to-go | ,只用动作之后的奖励加权 |
| GRPO | 用同一 instance 的 条 rollout 的组内均值作 baseline |
| DrGRPO | 去掉组内标准差与长度归一化的 GRPO 变体 |
| degenerate group | 组内 reward 全相同、优势全为 0 的采样组 |
延伸阅读
- Williams, Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning(1992)——REINFORCE 原始论文,本讲第 6 节的推导出处。
- Gulcehre et al., Reinforced Self-Training (ReST) for Language Modeling——grow / improve / repeat 流程与过滤式自训练。
- Singh et al., Beyond Human Data: Scaling Self-Training for Problem-Solving with Language Models(ReST-EM)——把 ReST 解释成期望最大化式的迭代,课件 Slide 15/16/24 的引用来源。
- Shao et al., DeepSeekMath(§4.1.2)——GRPO 的提出与组内归一化细节。
- Liu et al., Understanding R1-Zero-Like Training: A Critical Perspective(DrGRPO)——难度偏置与长度偏置的分析,以及两处改动的实验依据。
- Schulman et al., Proximal Policy Optimization Algorithms——ratio、clipping 与 value model 的标准做法,下一讲会展开。
- 课程后续:11 · RL Advanced(off-policy、重要性加权、稳定性)、12 · RL Systems(框架、超参、吞吐)。
自测题
1. SFT 的三个失配分别是什么?为什么 RL 能同时缓解它们?
参考答案
任务失配:SFT 最大化示教动作的概率,而我们要的是任务成功率;成功路径不唯一,且未示教的坏动作与好动作受到同样对待。数据失配:SFT 无法利用失败或次优轨迹。Exposure bias:训练历史来自示教,推理历史由模型自己生成,分布不一致。RL 直接优化期望回报(任务失配),用 reward 给失败轨迹负权重(数据失配),并用当前策略采样(exposure bias)。
2. Number Search 中隐藏数为 11,为什么说 (4 → 8 → 12 → 11)是“成功但不好”?
参考答案
第一次猜 4 只排除了 1–4,候选集仍是 5–16(12 个),第一步就把局面弄得很差;猜 8 后范围压到 9–16,再用 12 试探后只剩 9–11 三个候选、一次机会,最后猜中 11 有运气成分。它说明二值 reward 只看结果、不看过程质量,需要 advantage 之类的相对度量。
3. 写出 REINFORCE 的梯度估计,并说明为什么它不需要知道环境转移概率 。
参考答案
,而 ,因为环境项 不含 ,求导后消失。 只需通过“真的去环境里执行动作”来采样,无需显式建模。
4. 策略梯度的损失在实现上具体做了什么? 是什么?
参考答案
。 标记由策略采样出的 token(含每轮结束 token), 是 prompt、工具返回、模板等非策略生成的 token,需要被 mask 掉。 是一个标量,乘在整条轨迹所有生成 token 上。
5. 为什么朴素 REINFORCE 下失败轨迹完全学不到东西?baseline 如何修复?
参考答案
损失被 缩放, 时梯度为零,整条轨迹不产生更新。减去 baseline 后权重变成 ,失败轨迹得到负值,产生“降低这些动作概率”的梯度;同时期望梯度不变,方差下降。
6. 证明:只要 只依赖历史,减去它不会使梯度估计有偏。
参考答案
需要证 。因此带 baseline 的估计期望仍等于 。若 依赖当前动作,则无法提出求和号,偏差出现。
7. 两臂 bandit 中 、A 奖励 1、B 奖励 0。分别给出 与 时的梯度估计,并比较方差。
参考答案
:采样 A 得 ,采样 B 得 。:采样 A 得 ,采样 B 得 。两者期望都是 0.1875,但标准差从 0.325 降到 0.108,运行平均更快收敛。
8. GRPO 的 advantage 怎么算?为什么归一化必须在组内进行?
参考答案
,、 来自同一 task instance 的 条 rollout。因为 baseline 要估计的是“在这道题上策略的期望表现”,跨 instance 混合会把不同难度的题混在一起,优势失去相对含义。DrGRPO 进一步去掉 的除法。
9. DrGRPO 改了什么?分别修复什么偏置?
参考答案
(1) 去掉除以组内标准差 ,改用 :否则几乎全对/全错的题 小、权重被放大,中等难度题被压低。(2) 把按回答长度 归一化改成除以全局常数 :否则长错误回答每 token 罚得更轻,策略会漂向又长又错的输出。
10. 什么情况下 GRPO 的一组 rollout 完全不产生梯度?可以怎么处理?
参考答案
组内 reward 全相同(全 0 或全 1),减去均值后优势全为 0。全 0 往往说明题太难,全 1 说明题太简单。处理方式:换难度匹配的 task instance、增大探索(温度、组大小)、加入示教或 cold start 先做 SFT、设计更细的中间奖励(reward shaping)。