
2a · Agent Capabilities 2: Context Management for Long-Context Agents
本讲速览
- Agent 的成本结构由“循环”决定,而不是由“单次调用”决定:每次工具调用都把历史整体重新送进模型,5 次调用的累计输入就达到 80K,而最终上下文只有 26K,累计处理量约为最后一轮的三倍,且随轮数呈二次增长。
- 长上下文有两条独立的战线:capacity(模型能否真的用上远处的证据)与 efficiency(系统能否负担得起)。前者要靠架构、位置编码、训练数据和评测;后者要靠注意力复杂度、KV 内存、缓存与压缩。
- 当前前沿模型的共识是混合架构:绝大多数层做廉价的地方性计算(滑窗、线性注意力、状态空间模型),少数层做昂贵的全局计算,比例大致 3:1 到 5:1。
- 线性注意力谱系是一条“如何更聪明地遗忘”的路线:从固定矩阵状态(Linear)→ 只写预测误差(DeltaNet)→ 整体衰减(Gated DeltaNet)→ 逐通道衰减(KDA),每一步都在用可计算性换表达力。
- 位置编码不再是必需品:因果掩码本身就让同词在不同位置产生不同表示,因此 NoPE 在自回归模型上可行;但“没位置编码”不等于“不用训练长序列”,长度泛化仍然要在长序列上训练。
- 缓存把重复 prefill 的单价压到十分之一,但极易被无意打破:多数厂商的 cached input 约为 regular input 的 1/10,output 约为 regular 的 3–6 倍;在 system prompt 里加一行时间戳,就能让整条前缀缓存失效。
- 压缩(compaction)是最后手段,也是一次状态估计:目标不是“摘要得好看”,而是让压缩后的未来动作分布逼近原始历史下的分布;它必须保留锚点、可恢复的证据指针和足够的近期尾部,否则会逐轮漂移。
1. 起点:为什么 agent 的上下文一定会爆炸
Graham 开场就说,他一度想把标题写成 “context management for long-context LLMs”,因为今天讲的大部分是通用的 LLM 系统知识;但长上下文对 agent 格外关键,而先修课往往讲不透。所以本讲不是“agent 技巧合集”,而是把 agent 循环放进推理系统的成本模型里重新看一遍。
先看增长本身。设第 次调用的输入是“固定前缀 + 此前全部历史”,每次调用新增约 5K token,那么第 1 到第 5 次调用的输入分别是 6K、11K、16K、21K、26K,而累计被模型处理的 token 数是 6K、17K、33K、54K、80K。
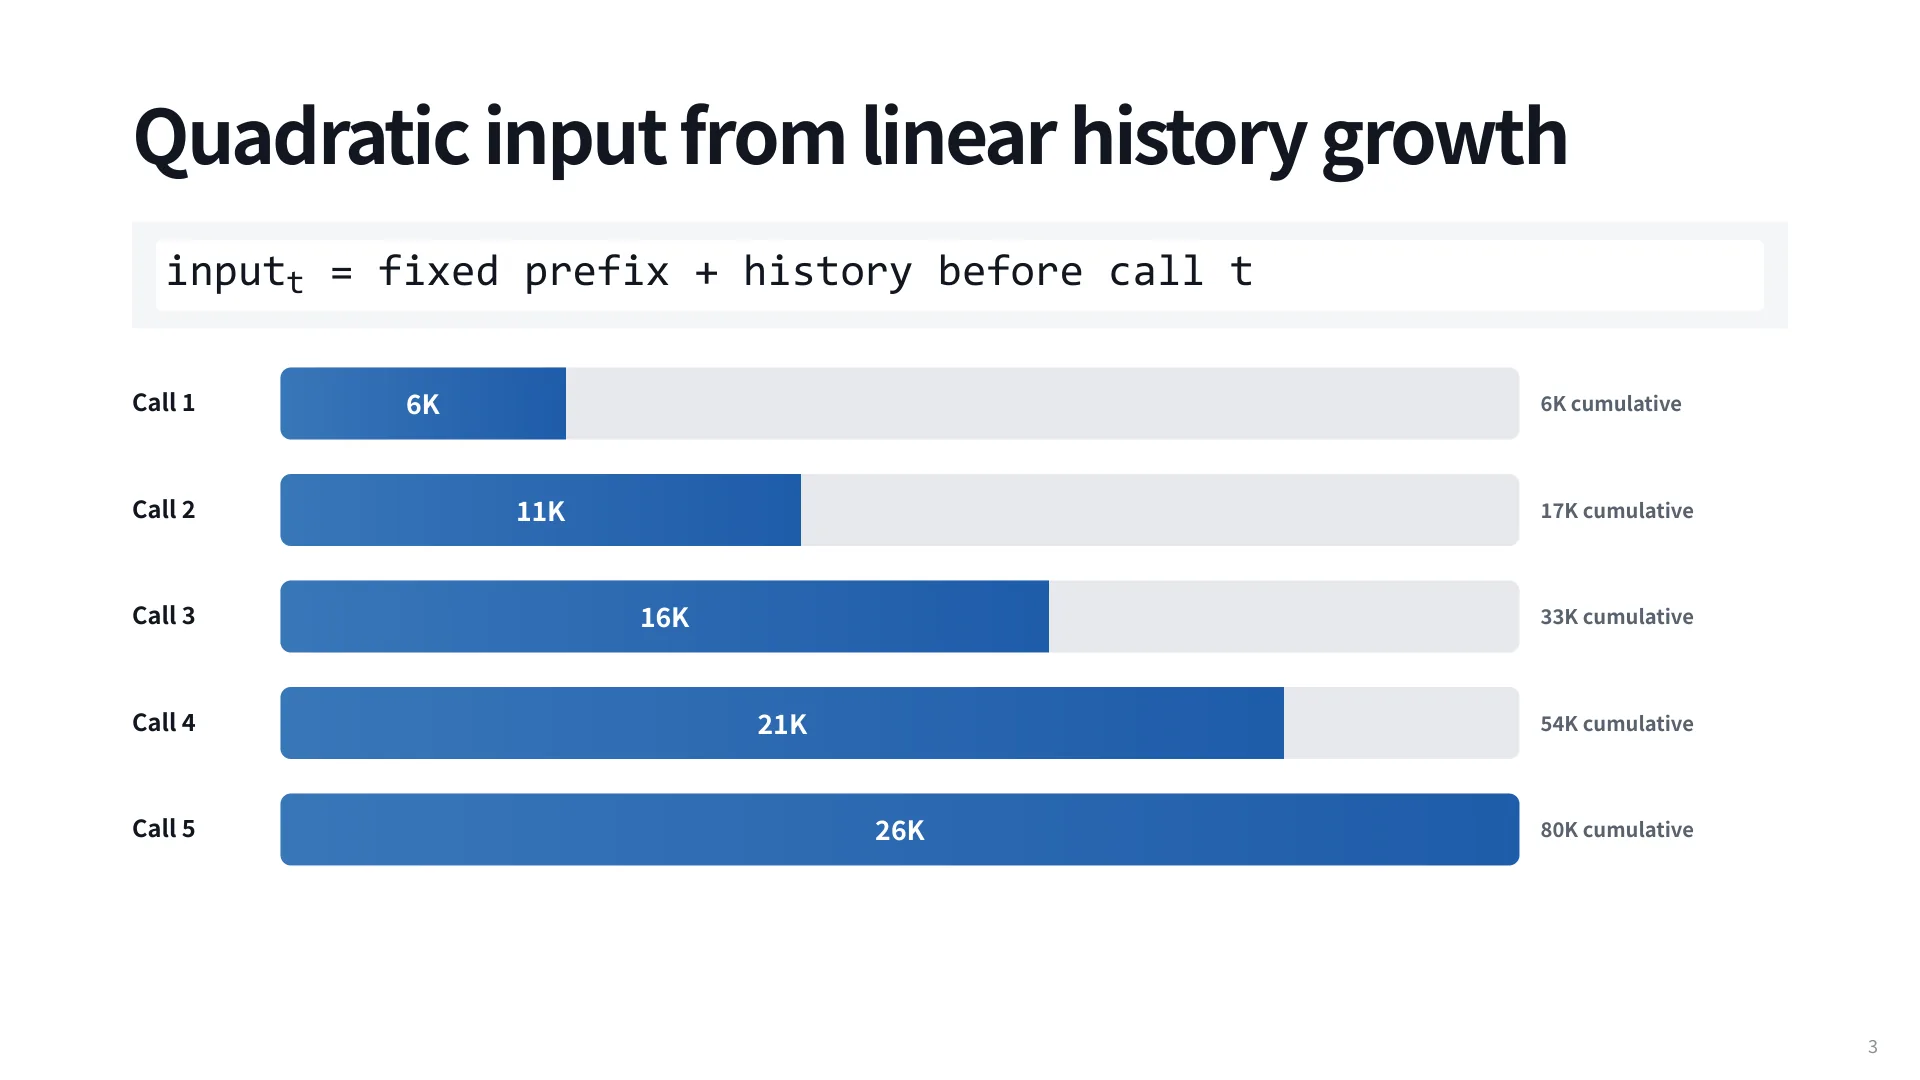
这里有两个容易被混为一谈的量。最后一个量(26K)是容量问题:模型的窗口里到底装了什么、还能不能找到关键证据。累计量(80K)是效率问题:为了产出这一轮的回答,系统实际做了多少 prefill 计算。前者随轮数线性增长,后者随轮数二次增长。如果你只在优化“窗口够不够大”,你会完全看不到后面那一半成本;如果你只在优化“每轮多少钱”,你又可能把关键信息压没了。整讲的骨架就建立在这个区分上。
讲师补了一句经验值:他自己用 coding agent 连续工作过好几天。这类 session 不是“多几轮”,而是每一轮都在为前面所有轮付费,几十轮之后就会把“单次调用”的直觉彻底击穿。
这些 token 从哪来?Graham 统计了自家 coding agent OpenHands 的 1,500 个 session——都是解决单个任务的短 session,不是多日长任务——平均 77,922 token。
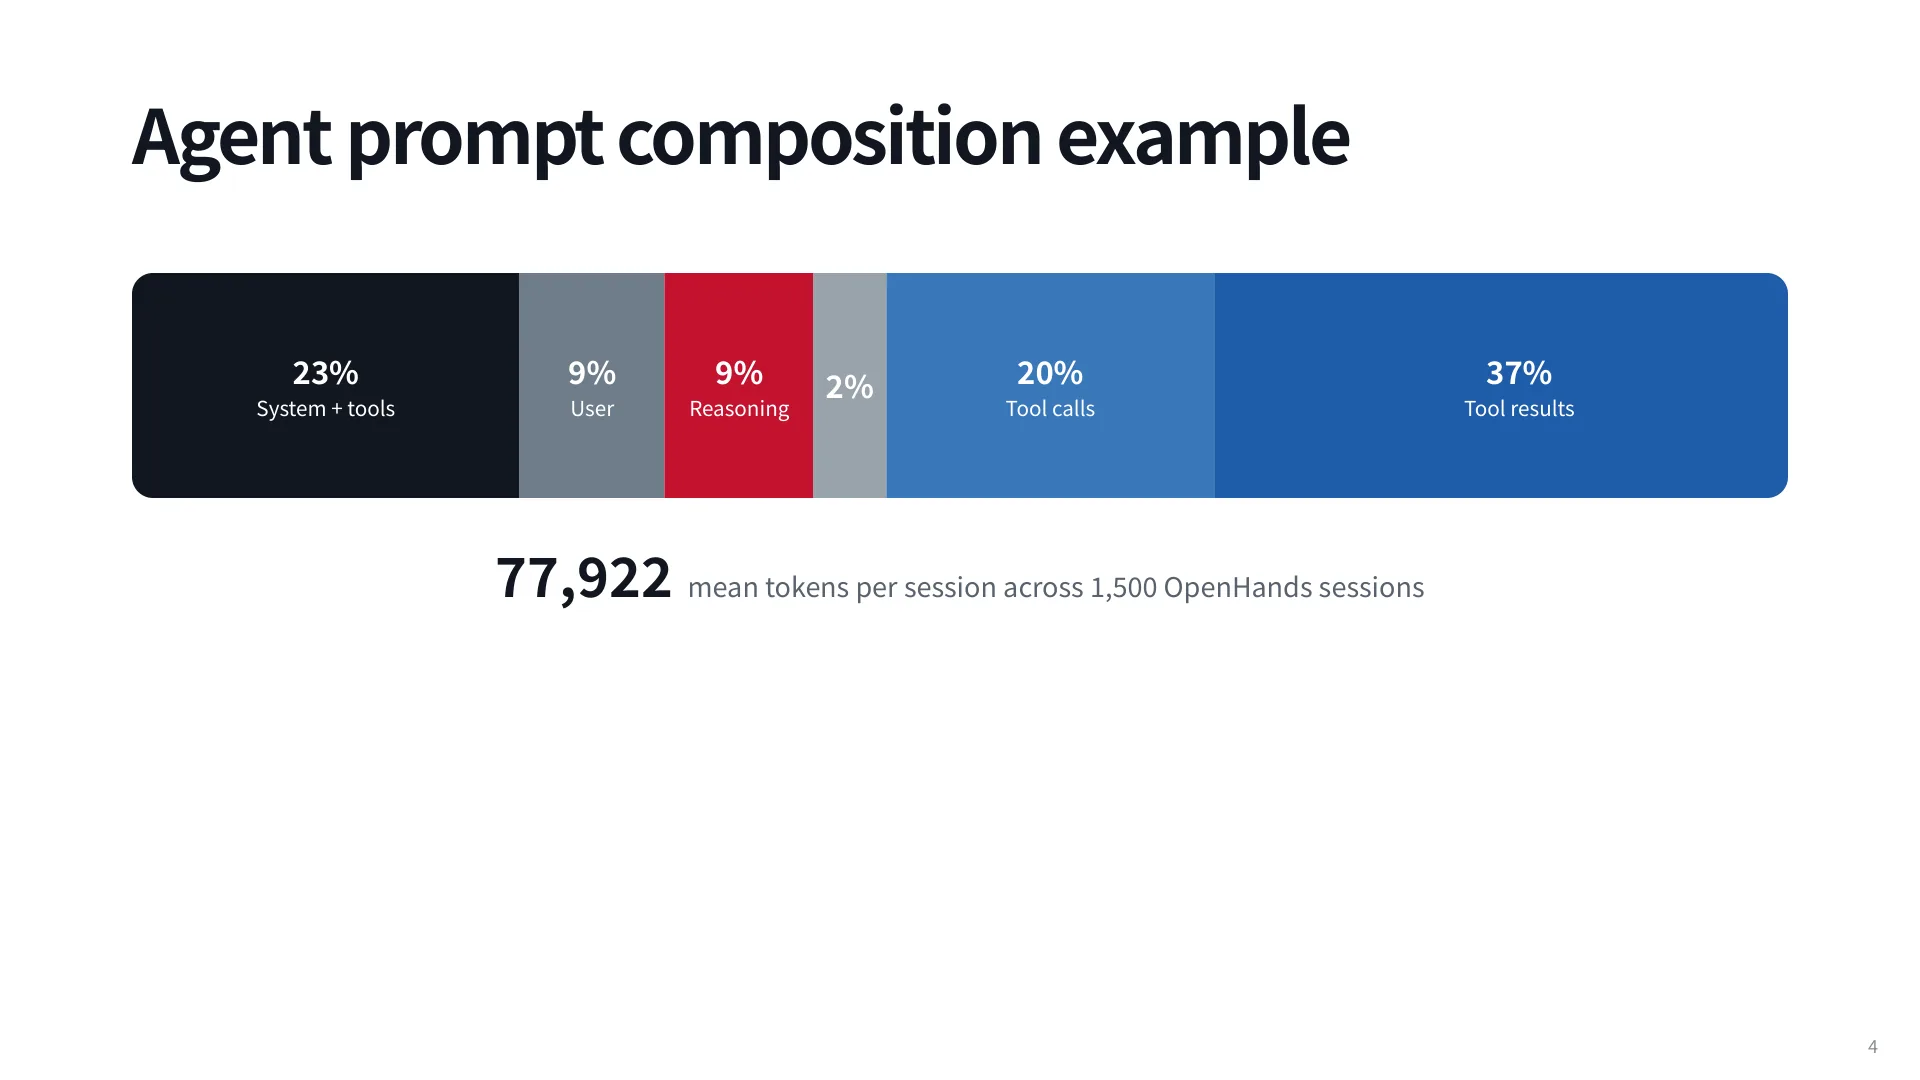
拆开看,system prompt 加工具描述占 23%(他提到 OpenHands 的系统提示词大约 15,000–18,000 token,各家 agent 的系统提示词常见区间是 8,000–20,000,取决于挂了多少工具);用户消息 9%;推理轨迹 9%;工具调用 20%;工具结果 37%。条形图里没有画出来的还有 2% 的模型回复,讲师口头补充了这一点。
这个分布有三层含义。第一,用户只贡献了不到十分之一,其余约三分之二(reasoning + tool calls + tool results)由模型和环境自己生成——上下文的膨胀主要是 agent 自己造成的。第二,信息密度极低:37% 是工具输出,其中很大一部分是文件内容、日志、目录列表,读过一次就不再需要。第三,系统提示词是一个固定的大常数,每一轮都要被重新 prefill,因此它既是缓存设计的主要对象,也是每轮固定成本的主要来源。
2. 两条战线:容量与效率
有了“上下文会长”这个事实,问题就分成两个几乎正交的方向。
**Capacity(容量)**问的是:模型能不能用上需要的证据?决定因素包括架构、位置编码、训练数据的长度分布,而且必须靠评测度量——“支持 1M”是宣称,“在 1M 的输入里准确找到那一句证据”才是能力。
**Efficiency(效率)**问的是:系统付不付得起?要看注意力复杂度、KV 内存、缓存命中与压缩策略。
之所以要强调 capacity 不能靠宣称,是因为有效上下文远小于广告上下文。经典的 needle-in-a-haystack 实验把一句无关紧要的话(“旧金山最好吃三明治的地方是……”)埋进一大堆 Paul Graham 的文章里,然后问模型那句话,随上下文变长,弱一些的模型开始答错。
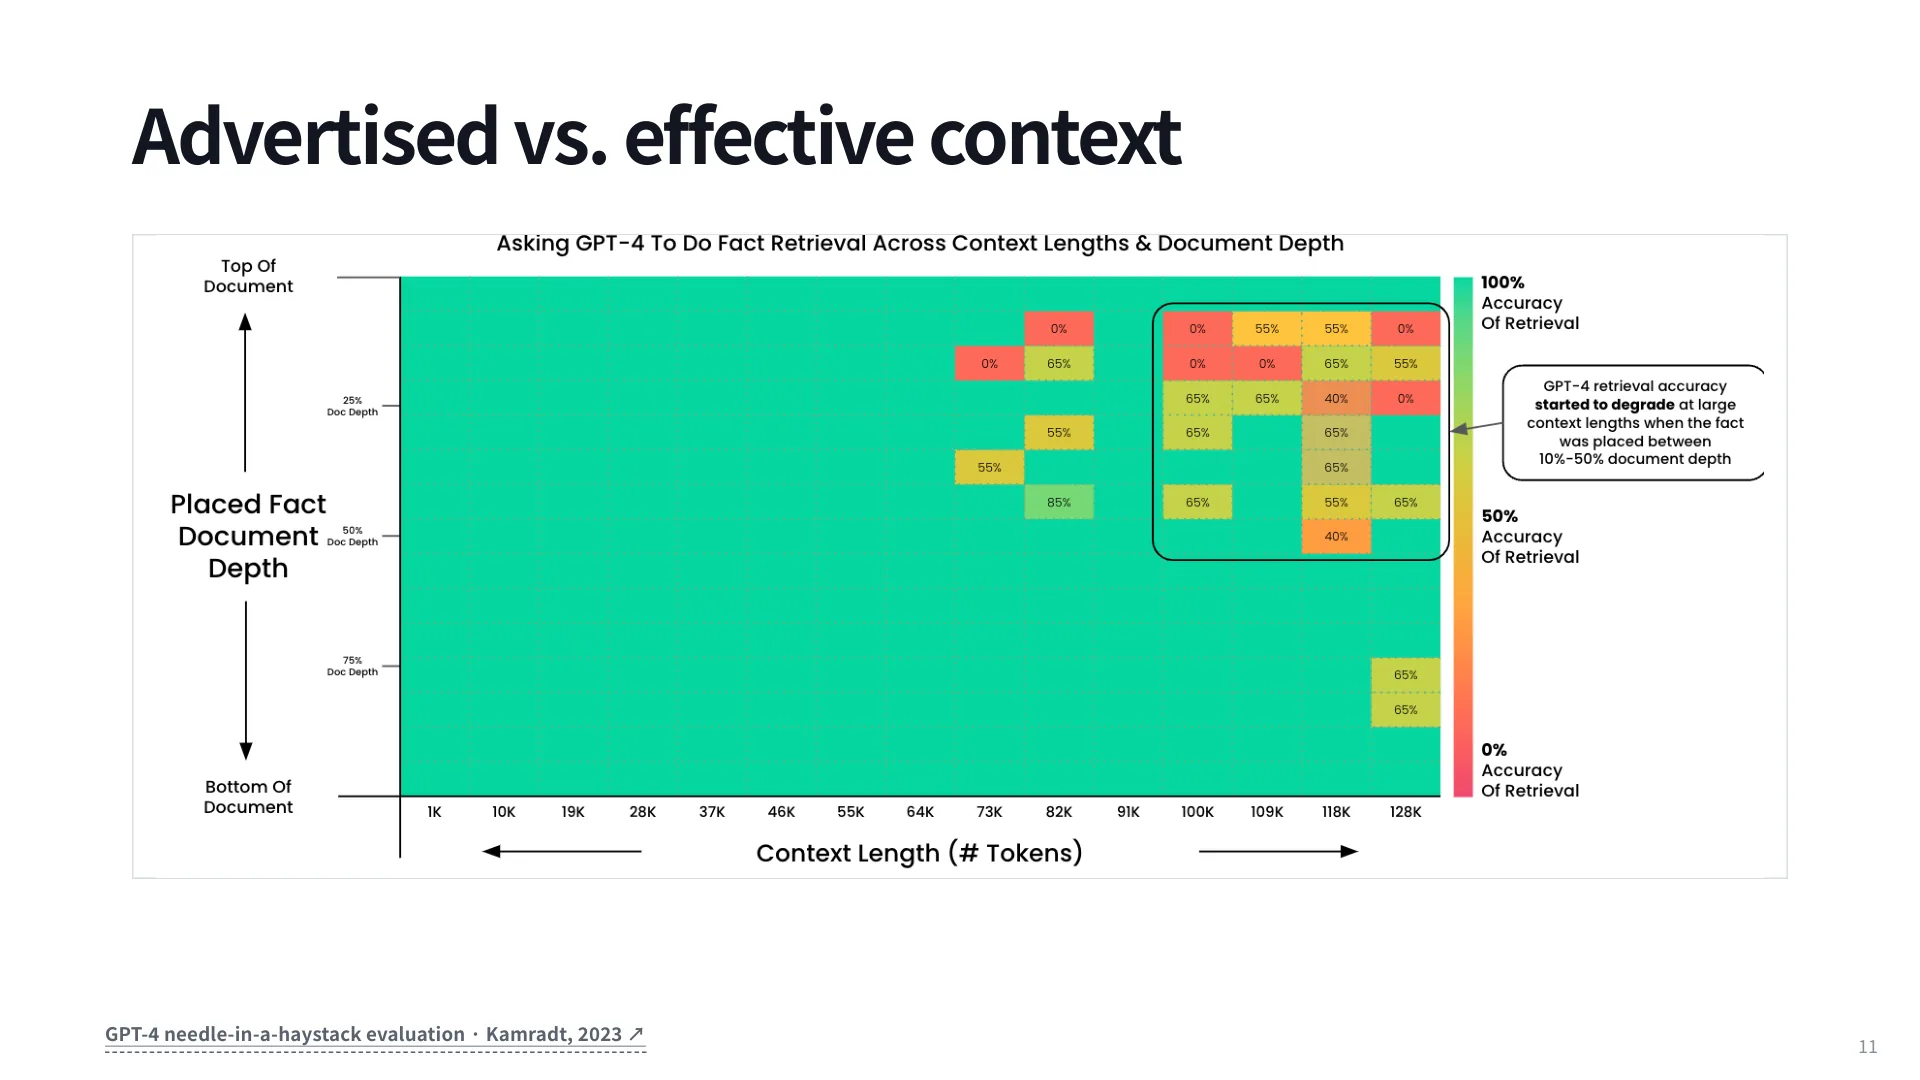
这张热力图读法很直接:横轴是上下文长度(1K 到 128K),纵轴是埋藏事实在文档中的相对深度,颜色是准确率。绝大部分格子是绿色的 100%,说明单针检索对 GPT-4 并不难;但右侧那块黄色和橙色的区域——大致从 73K 之后开始,事实位于文档中部(10%–50% 深度)——会出现 0%、40%、55% 这样的塌陷。也就是说,能力衰减不是均匀发生的,它集中在“长上下文 + 中部位置”这个角落。这也解释了为什么后续的评测从单针检索扩展到 RULER、HELMET 这类更难的基准:单针检索太容易饱和,也太容易被针对性训练“刷”过去。
capacity 失效在 agent 场景里特别难堪,因为它不是“答错一道题”,而是“违反用户中途下达的约束”。讲师现场问听众常见失败,答案是“忘记前面的上下文”,具体例子是用户明说“不要删这个”,agent 还是删了。(13:51) 这类错误不可逆,而且很难归因:是没看见、看见了没在意、还是被压缩掉了?本讲后面每一节都在回答这个问题的一个侧面。
讲师提醒:capacity 和 efficiency 不是同一件事的两面,而是两个独立预算。模型可以“装得下但用不好”,也可以“用得好但服务不起”。做系统设计时要分别度量,否则优化一个指标会悄悄牺牲另一个。
3. 推理速览:prefill、decode 与四个指标
要讨论效率,先得知道钱花在哪。一次 LLM 调用分成两个阶段。
Prefill 把整段输入一次性过一遍模型,为每个位置算出 K、V 并写进 KV cache;它是计算密集的,延迟大致随 prompt 长度增长。Decode 每次只处理一个新位置(上一个生成的 token),从 KV cache 里读出全部历史;它是访存密集的,一个 step 只产出一个 token。
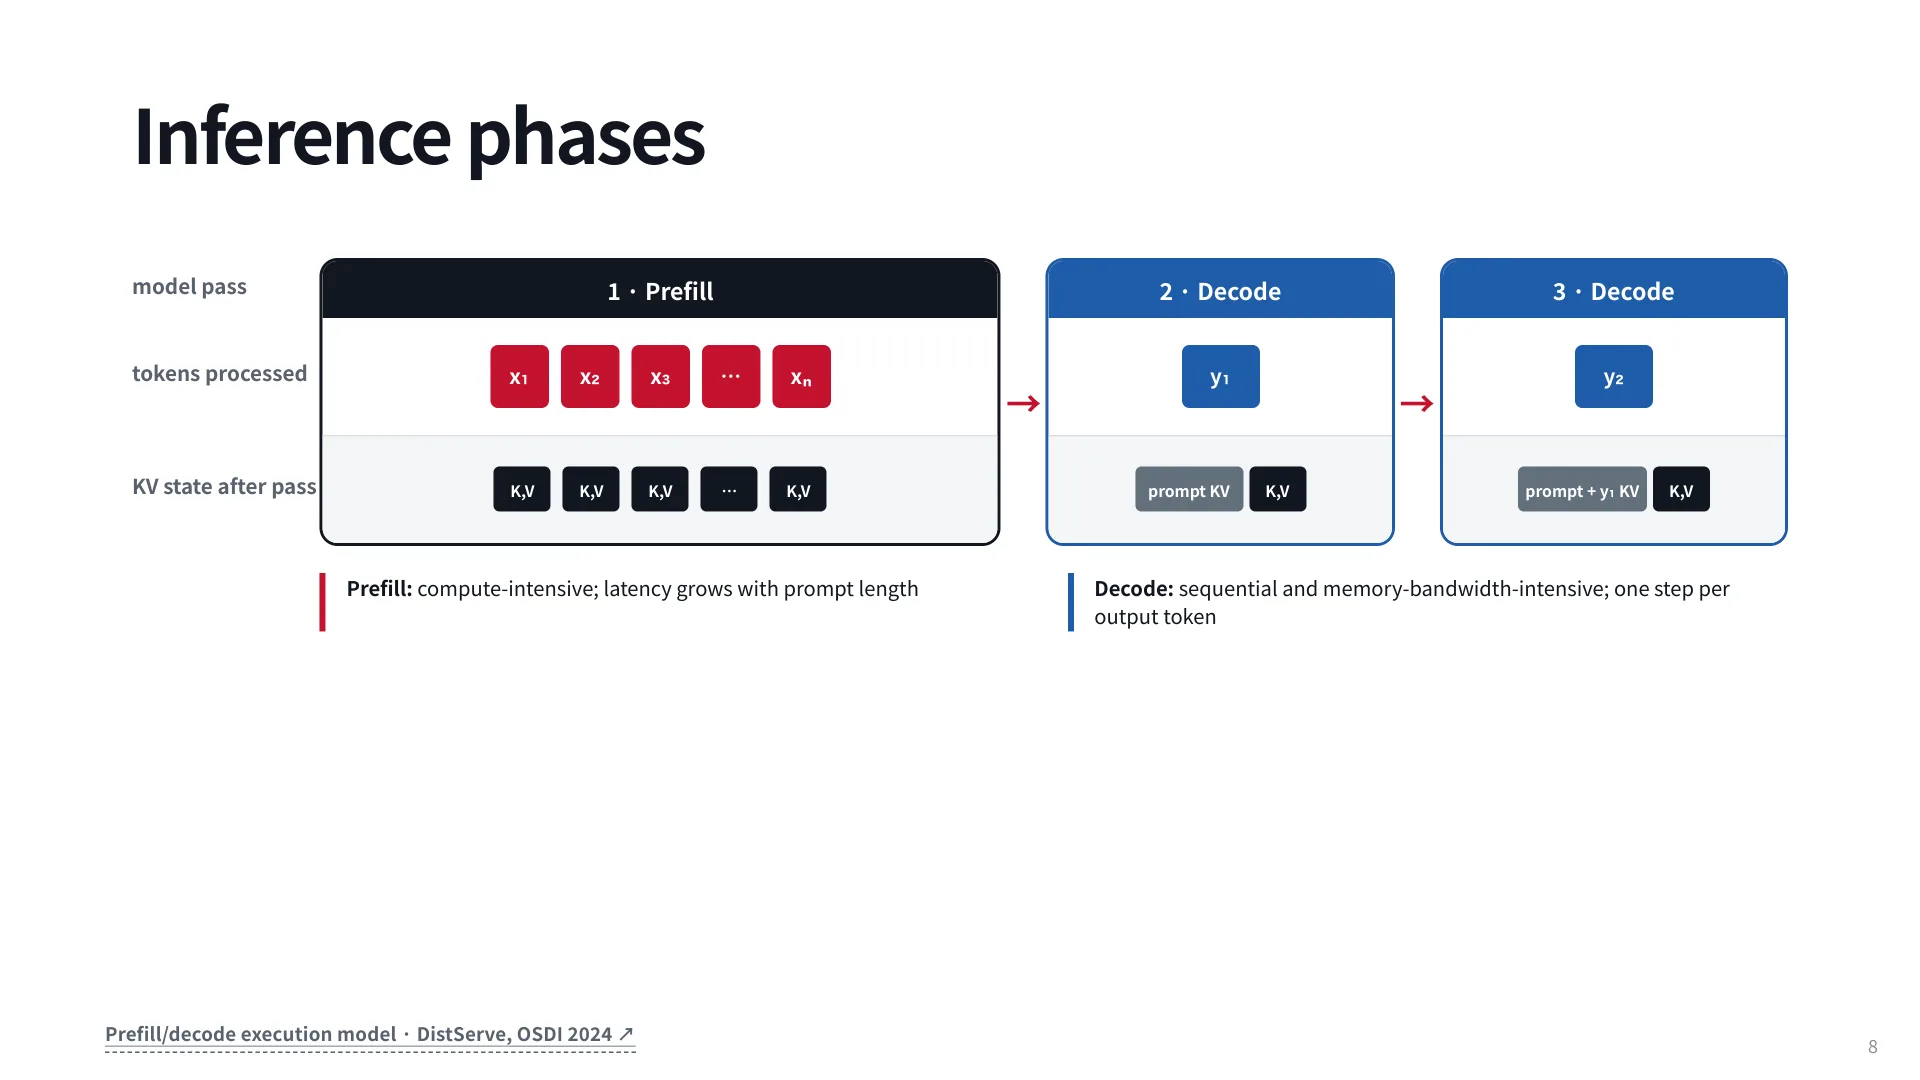
围绕这两个阶段,服务系统有四个常用指标:TTFT(从请求到第一个 token,主要由 prefill 决定)、TPOT(相邻输出 token 的间隔,主要由 decode 决定)、throughput(单位墙钟时间完成的 token 或请求数)、cost(输入 + 缓存输入 + 输出的计费)。
一个对 agent 设计者很实际的推论:TTFT 是每一步都要付的。chat 里只付一次,agent 每一轮工具调用都要重新付一次“读历史”的钱;历史从 6K 涨到 26K,TTFT 跟着涨,而用户在 CLI 前等的是每一步的响应。(08:13)
交互式使用和后台批处理对指标的偏好完全不同:在终端里结对编程,TTFT 和 TPOT 就是体验本身;让 agent 通宵跑批,单步延迟无关紧要,只在乎吞吐和单价。推理提供商会直接问客户“更在意哪个”再针对性调度,所以同一个模型、同一份 prompt 的最优实现取决于服务目标——“某模型很快”这种说法在 agent 语境下经常不成立。
4. 架构:把二次比较变成有界的比较
现在进入模型内部。标准注意力是全局的:每个 query 和此前所有 key 做点积, 个 token 就有 次两两比较。讲师现场做了个心算: 个 token 就是 ,一万亿次比较,而每次比较还要乘上不短的向量;再乘上层数和 head 数,单条序列的计算量就到了 量级。这个数量级不是“慢一点”,而是“物理上不可行”。
几乎所有解法都归结为同一个动作:给每一步的比较次数加一个常数上界,把 压到 。区别只在于这个上界是“局部的窗口”,还是“选出来的子集”。(16:19)
前沿模型的共识不是二选一,而是混合:连续若干层做廉价的地方性计算,然后插一层昂贵的全局计算,再回到地方性计算。讲师列了六个模型的具体配方。
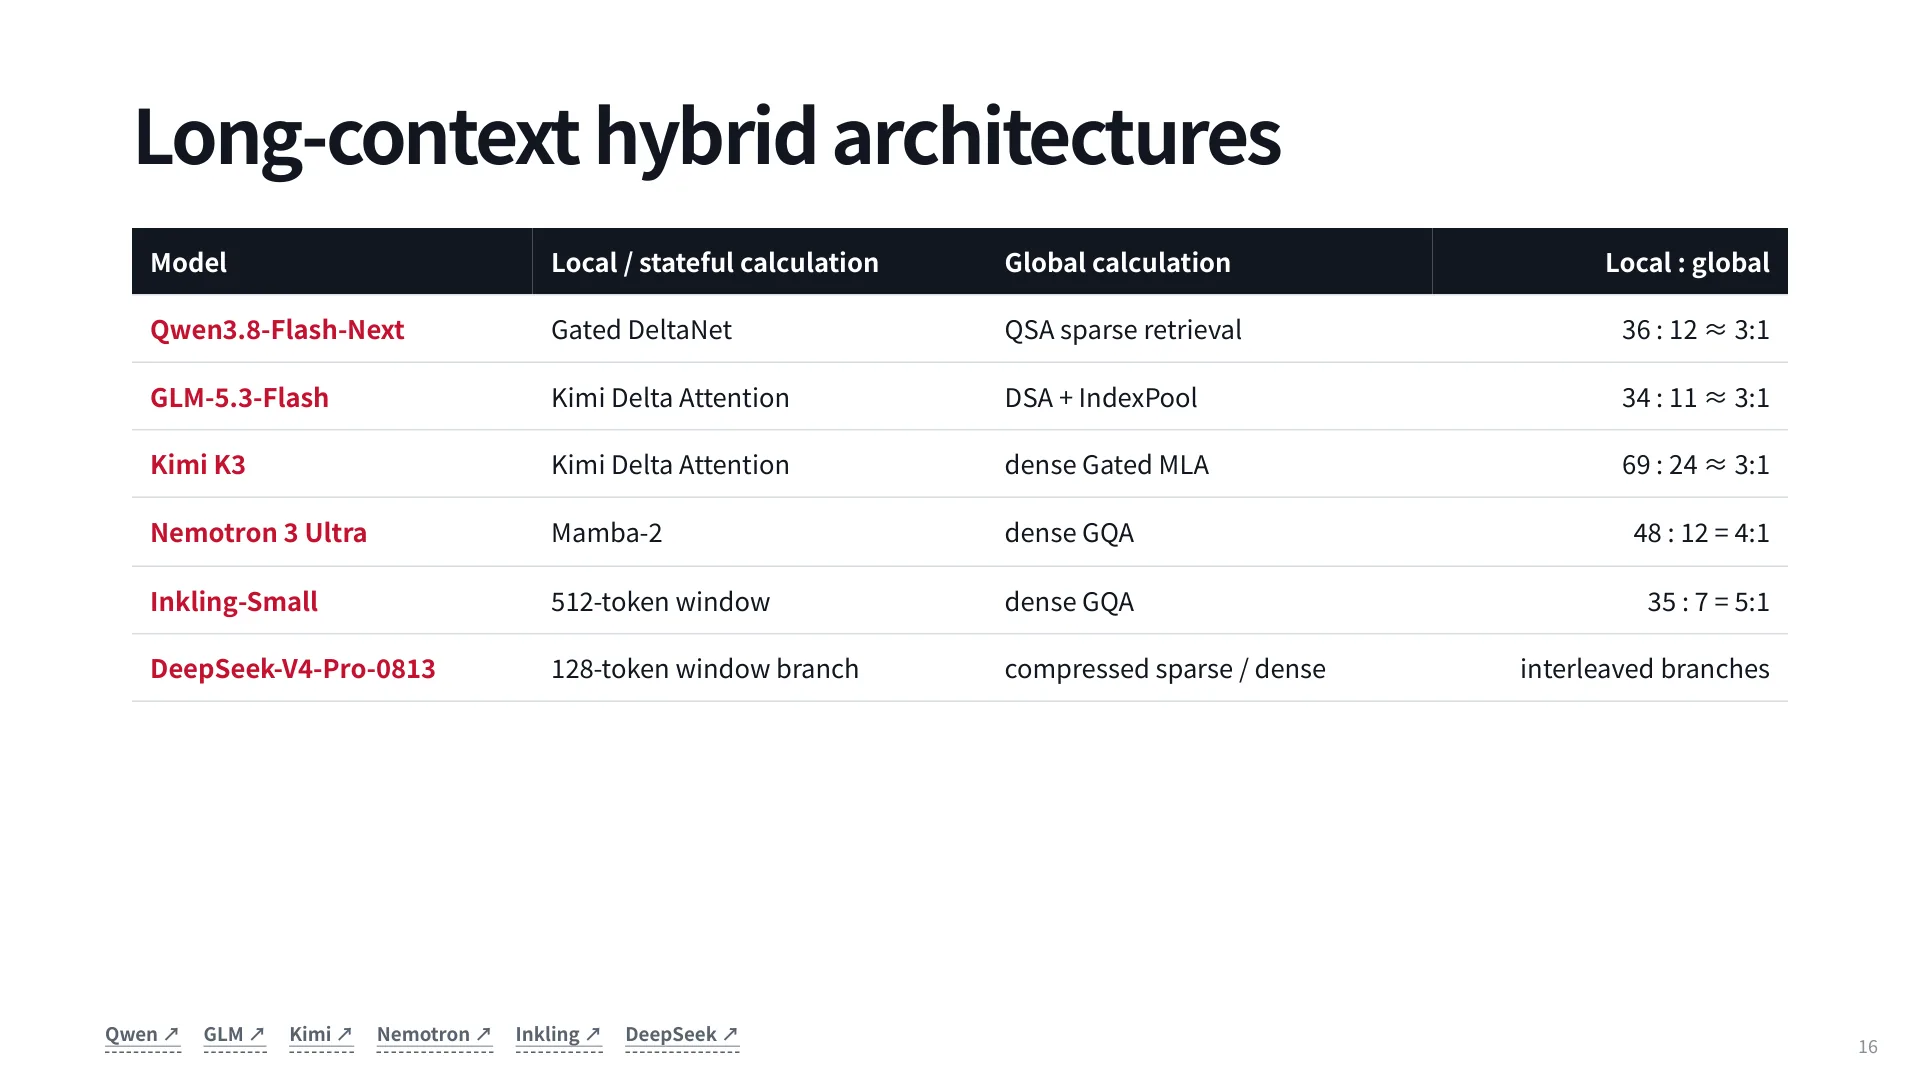
| 模型 | Local / stateful | Global | 比例 |
|---|---|---|---|
| Qwen3.8-Flash-Next | Gated DeltaNet | QSA sparse retrieval | 36:12 ≈ 3:1 |
| GLM-5.3-Flash | Kimi Delta Attention | DSA + IndexPool | 34:11 ≈ 3:1 |
| Kimi K3 | Kimi Delta Attention | dense Gated MLA | 69:24 ≈ 3:1 |
| Nemotron 3 Ultra | Mamba-2 | dense GQA | 48:12 = 4:1 |
| Inkling-Small | 512-token window | dense GQA | 35:7 = 5:1 |
| DeepSeek-V4-Pro-0813 | 128-token window branch | compressed sparse / dense | 交错分支 |
两点值得注意。第一,比例集中在 3:1 到 5:1,说明“大部分层便宜、少数层昂贵”已是收敛的工程结论。第二,local 层有三种完全不同的实现:滑窗、DeltaNet 家族的线性/增量式注意力、状态空间模型(Mamba-2)。它们都是每步常数或 的工作,但在“记住什么、忘记什么”上差别很大。
最简单的 local 机制是滑窗注意力:不改注意力公式,只改掩码。第 个 query 只允许看 的 key。
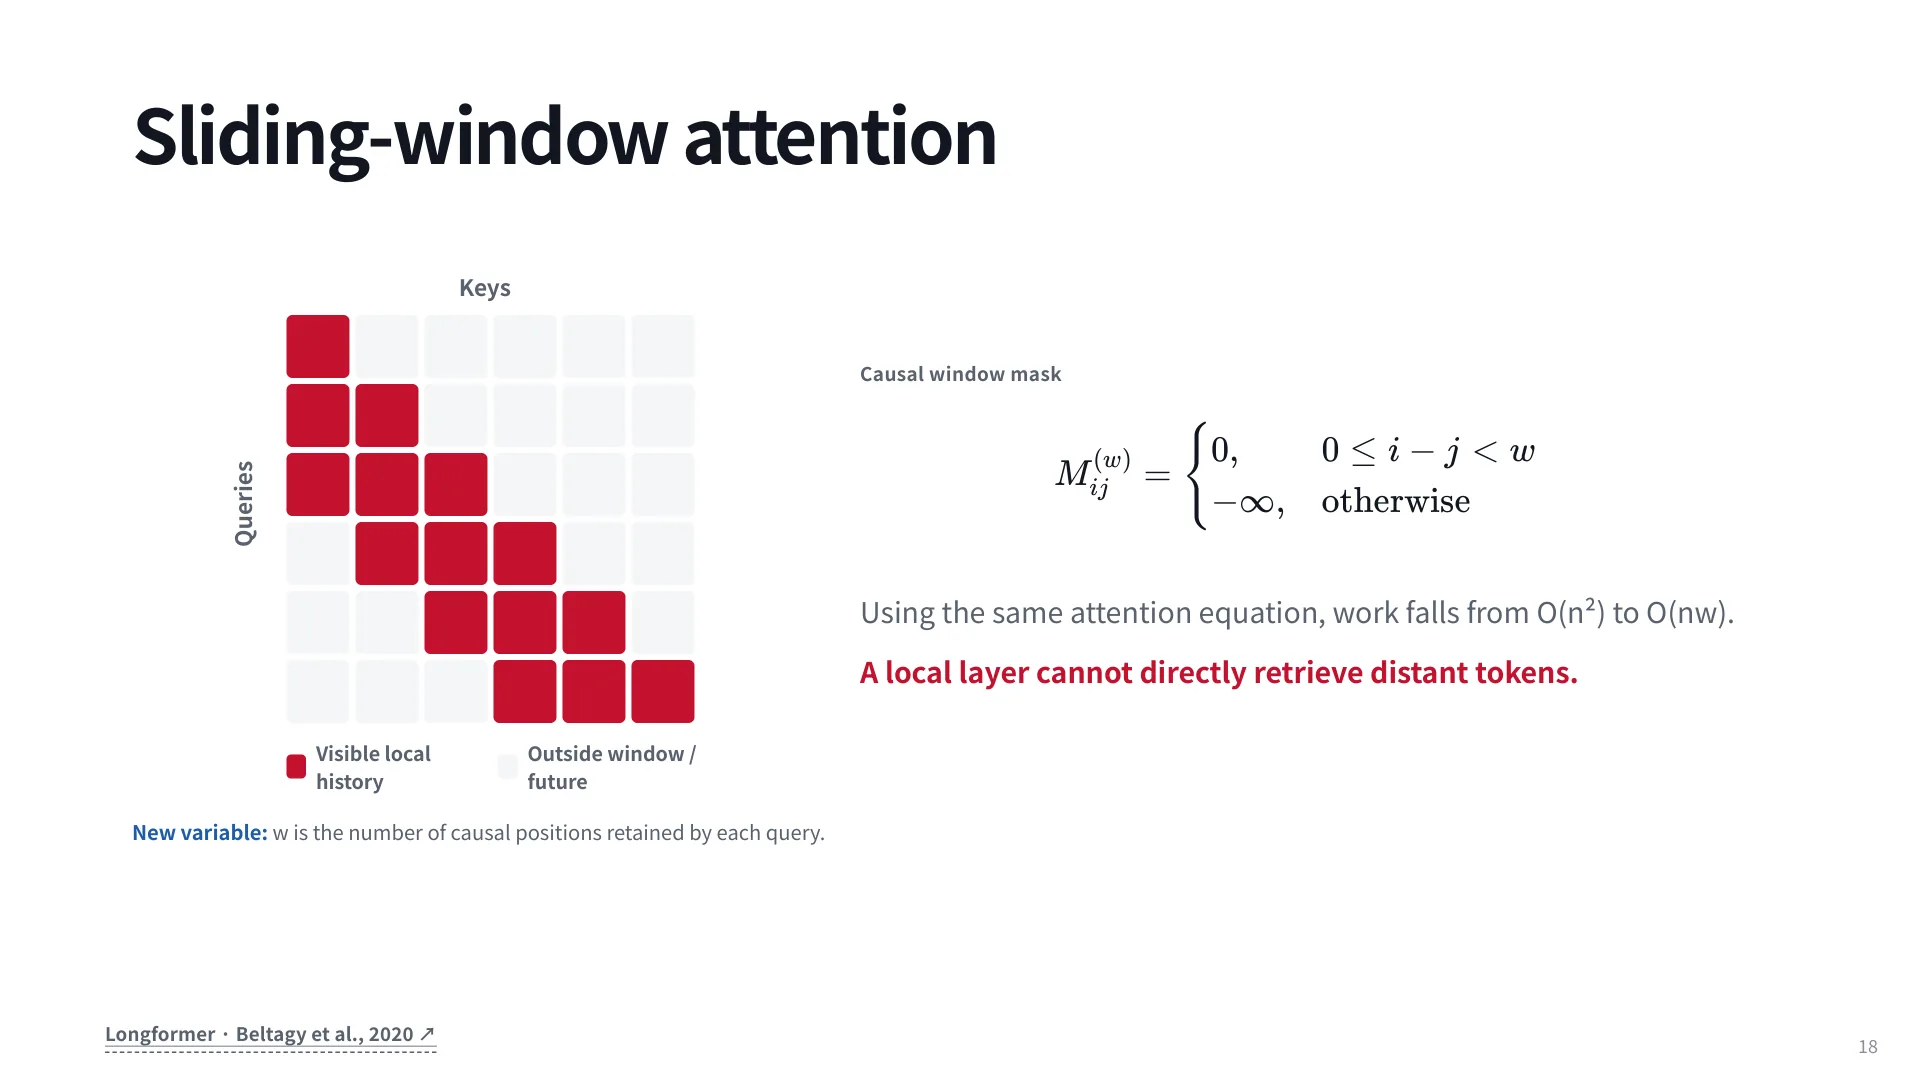
一个常见的误解是“窗口 就限制了感受野”。单层里确实如此,多层叠加后并不成立:第 1 层传一两个 chunk,第 2 层再往前传一两个 chunk,感受野随深度线性扩张。但这个补偿有限:local 层无法直接取回远处 token,长距离信息要经过多次中转,每次中转都是一次有损压缩。所以全局层的预算才是真正的瓶颈——混合架构的上限往往由那 1/6 到 1/4 的全局层决定。
讲师提醒:判断一个长上下文架构,不要只看 local 层有多便宜,要看 global 层能以多高的保真度把远处信息接回来。3:1 的比例是结果,不是原因。
5. 线性注意力谱系:如何更聪明地遗忘
滑窗是“限制看哪里”,线性注意力是“不看了,改成记”。这条路线的起点是一个代数技巧。
标准注意力里,softmax 的归一化项依赖 query,所以求和不能重排;一旦把它换成双线性打分 ,求和就可以重新结合:
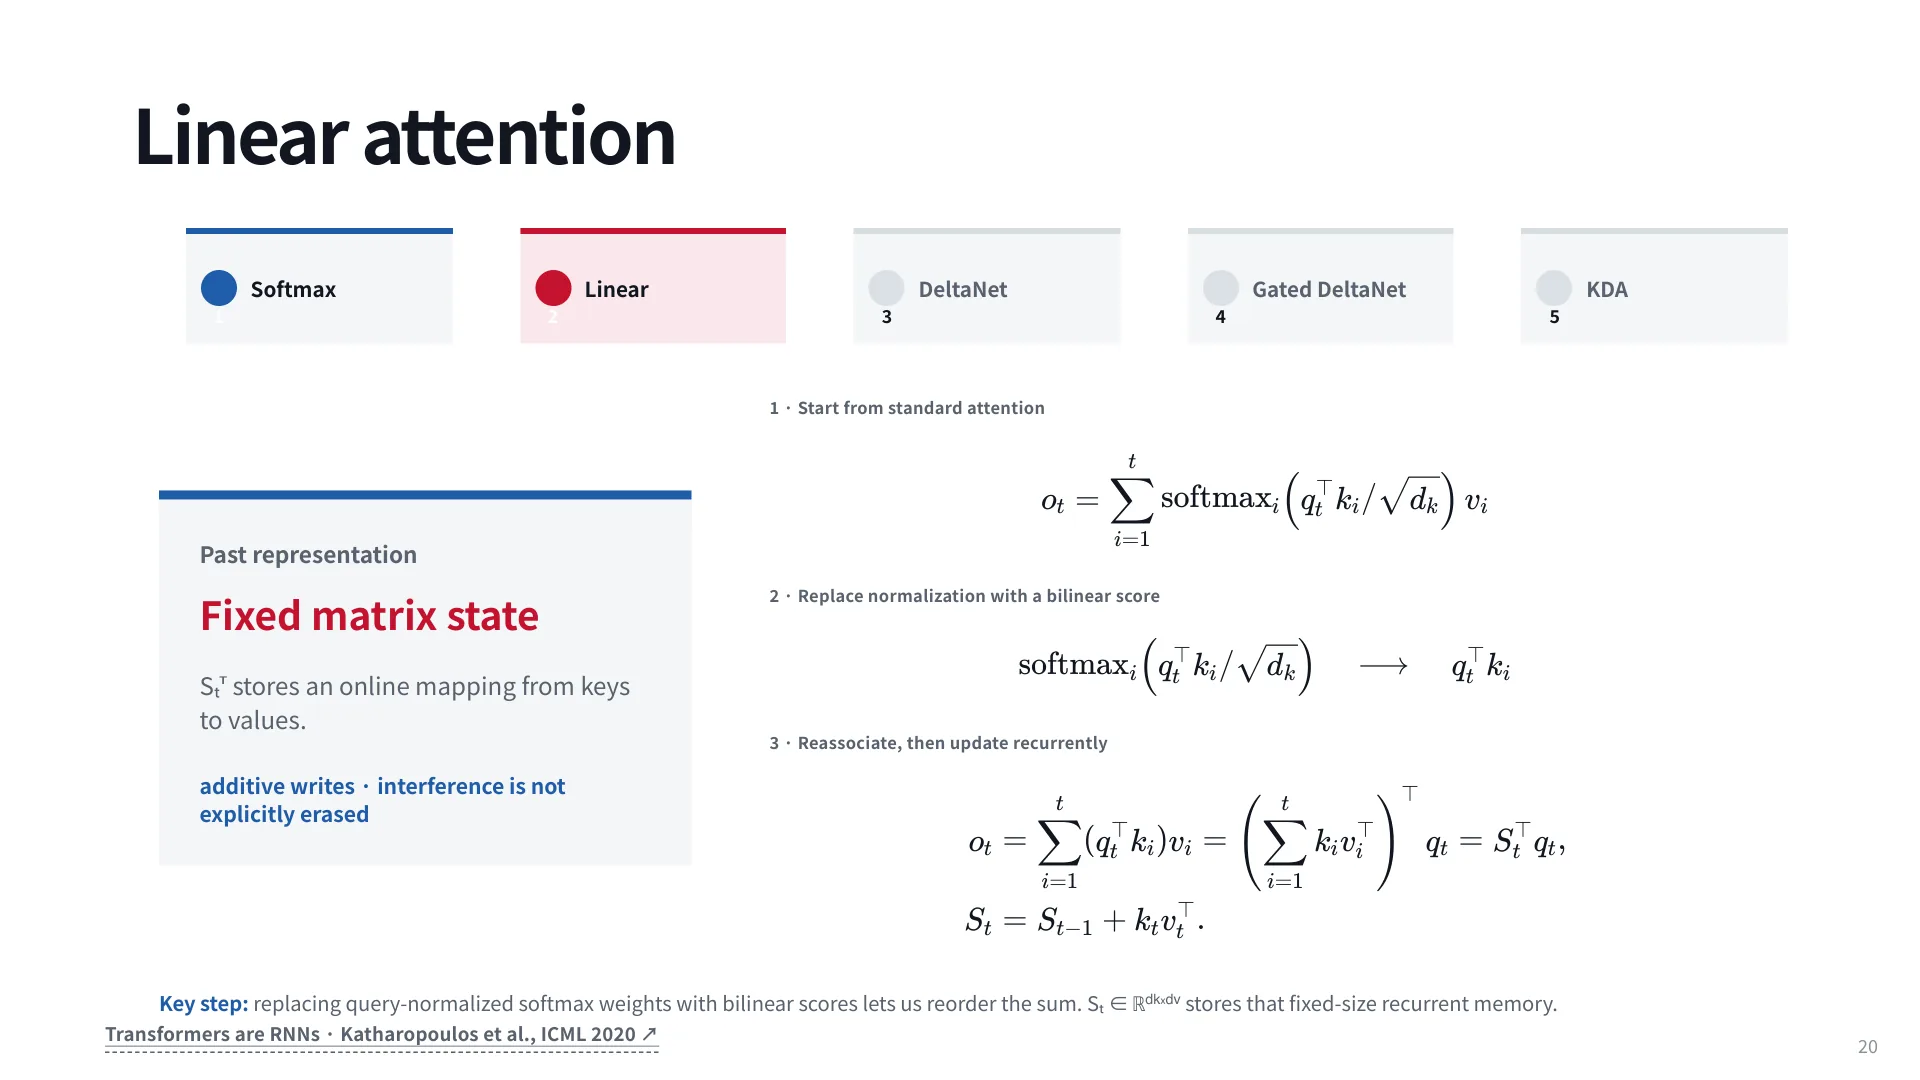
这一行推导换来巨大收益:历史被压成一个 的矩阵,每来一个新 token 只做一次加法写入,解码从 变成 ,整条序列从 变成 。代价写在公式里——softmax 被拿掉了。softmax 提供“在若干候选里挑一个”的非线性选择能力,这是 attention 的核心表达力;换成双线性后只剩线性映射,无法再对“只看那一个 key”做锐利选择。(20:28)
第二个代价在写入方式上: 是纯加法,旧关联不会被显式擦除。很久以前一个奇怪的 key 写入了很大的值,它就会一直留在状态里干扰后续预测——这就是 interference。整个 DeltaNet 家族本质上都在解决“怎么把不要的东西擦掉”。
DeltaNet 的做法是只写“预测误差”。先用当前状态预测一下这个 key 应该对应什么值:;再算误差 ;然后只把这个误差写进去:
相当于学习率,防止单次修正过猛。讲师用“沿 方向定向修正,无关记忆保持不变”来描述:写入后再用 去查,误差就消失了。这与梯度下降的一步更新形式几乎一致,论文标题 “Linear Transformers Are Secretly Fast Weight Programmers” 说的就是这件事。
DeltaNet 解决了干扰,但没解决“该忘的忘不掉”。如果很久以前有一个异常值,它仍然会一直影响下去。Gated DeltaNet 加了一个标量衰减:先整体衰减,再做定向修正。
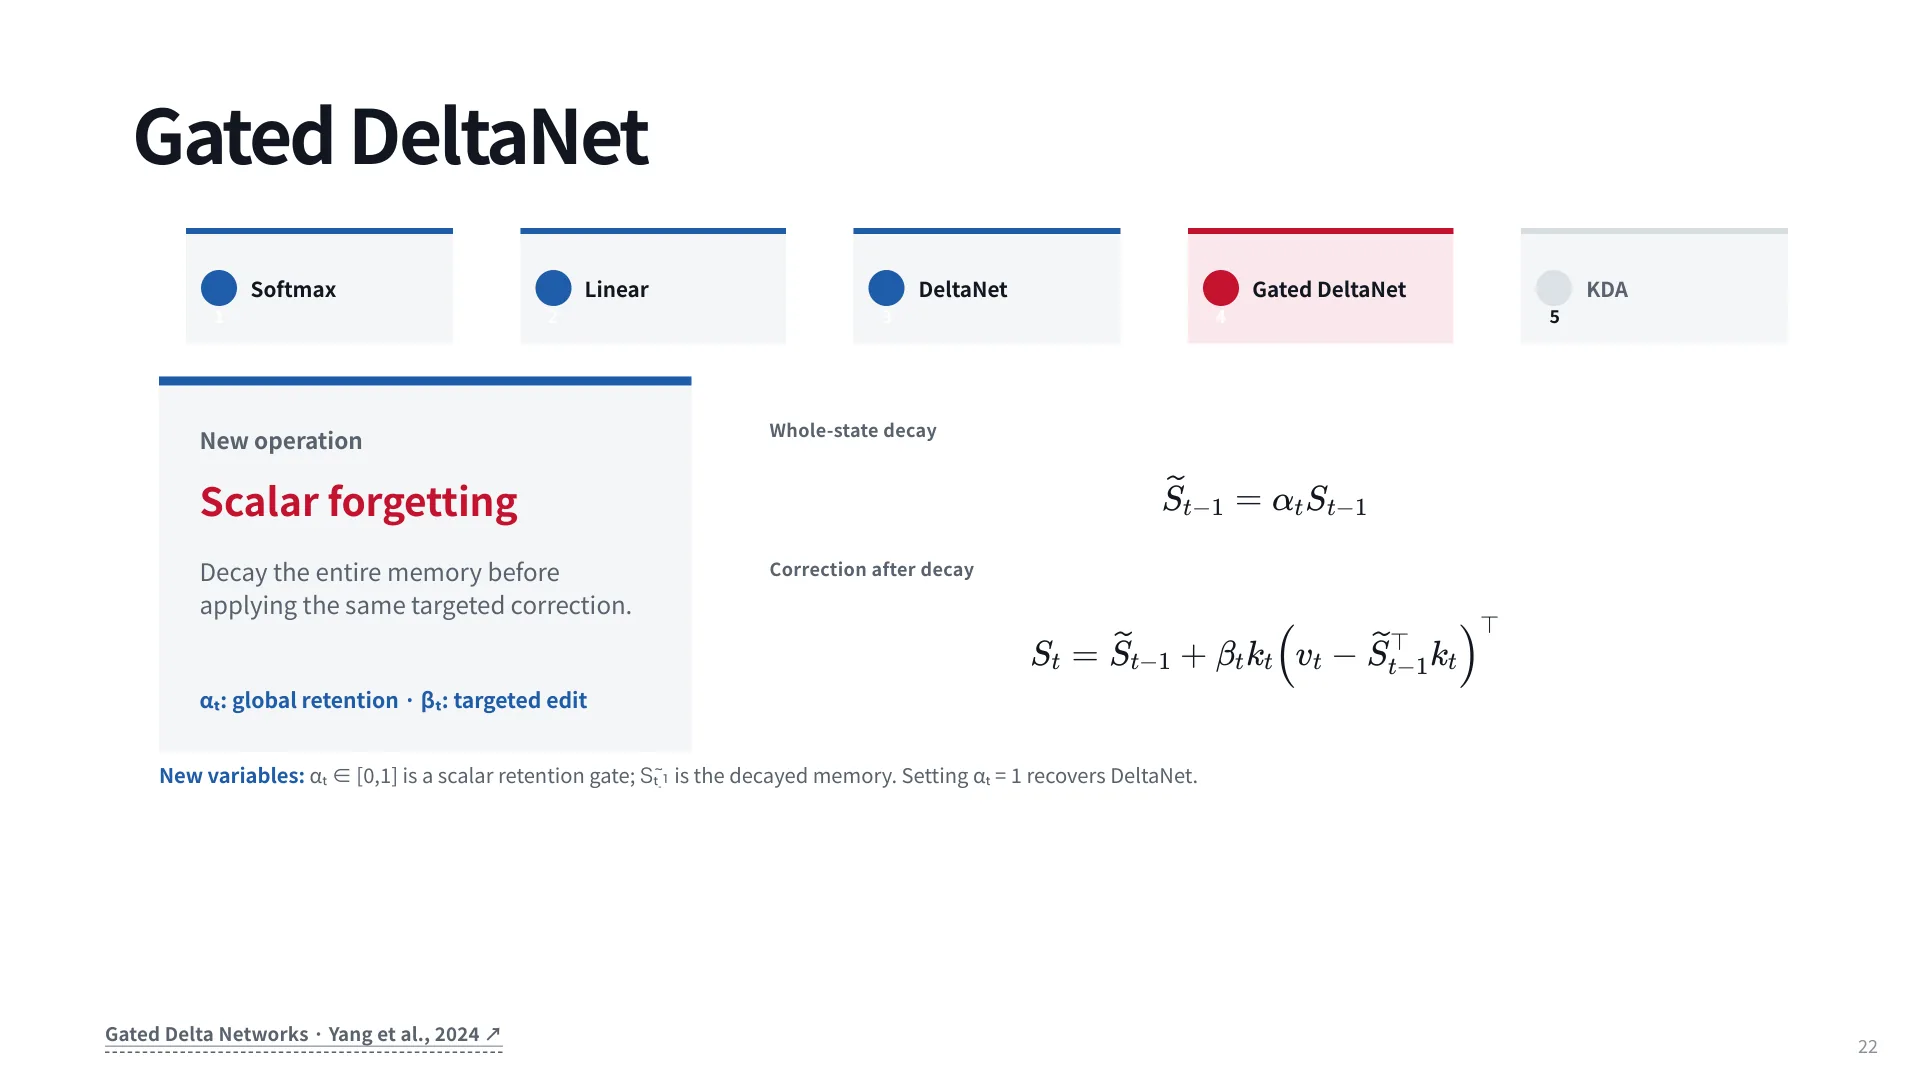
是全局保留率, 是定向编辑强度。这两个门控的分工很清晰: 决定“记忆的平均寿命”, 决定“这一次要改多狠”。 越小,模型越偏局部;越大,越偏全局。这就把“局部性”变成了一个可学习的连续旋钮,而不是滑窗那样的硬截断。(28:54)
KDA(Kimi Delta Attention) 再把标量 换成向量 ,每个 key 空间维度有自己的寿命:
所有通道取相同保留率时,KDA 退化为 Gated DeltaNet。它的动机很直观:上下文里同时存在“需要记住一整场 session 的约束”和“只需要记住上一条命令输出”的信息,让它们共享一个衰减率是浪费的。逐通道衰减让一部分维度长期保留、另一部分快速遗忘。GLM-5.3-Flash 和 Kimi K3 用的都是这一支。
这条谱系可以总结成一张“用表达力换可计算性”的账单:
| 机制 | 历史表示 | 每步代价 | 主要缺陷 |
|---|---|---|---|
| Softmax attention | 全部 K、V | 比较 | |
| Linear attention | 固定矩阵 | 无选择能力、写入互相干扰 | |
| DeltaNet | 固定矩阵 + 误差修正 | 旧异常值无法清除 | |
| Gated DeltaNet | 固定矩阵 + 标量衰减 | 所有维度共享同一寿命 | |
| KDA | 固定矩阵 + 逐通道衰减 | 仍需全局层补精确检索 |
这就是为什么混合架构是必然的:固定大小的状态无论怎么设计,都会在“需要精确复述第 3 轮某个文件第 40 行”这类任务上失败。状态适合承载“大意”和“已确认的结论”,不适合承载“原文”。全局层(稠密或稀疏)存在的意义,就是保留一条精确检索的通道。
6. 稀疏注意力与 KV 压缩
稀疏注意力换了个思路:不改变注意力的形式,只改变“允许看哪些 key”。它有两个分支。
固定模式(input-independent):每个 query 看一个局部窗口加一组固定全局位置 ,,Longformer 是代表。代价可预测、能用一个 kernel 算完,但模式无法随 query 变化——关键证据若在窗口外又不在 里,就永远看不到。
内容相关(content-dependent):用廉价打分函数 (如把 Q、K 降维后算点积)给历史打分,取 TopK 作为可见集合 ,再在子集上做完整 softmax 注意力。
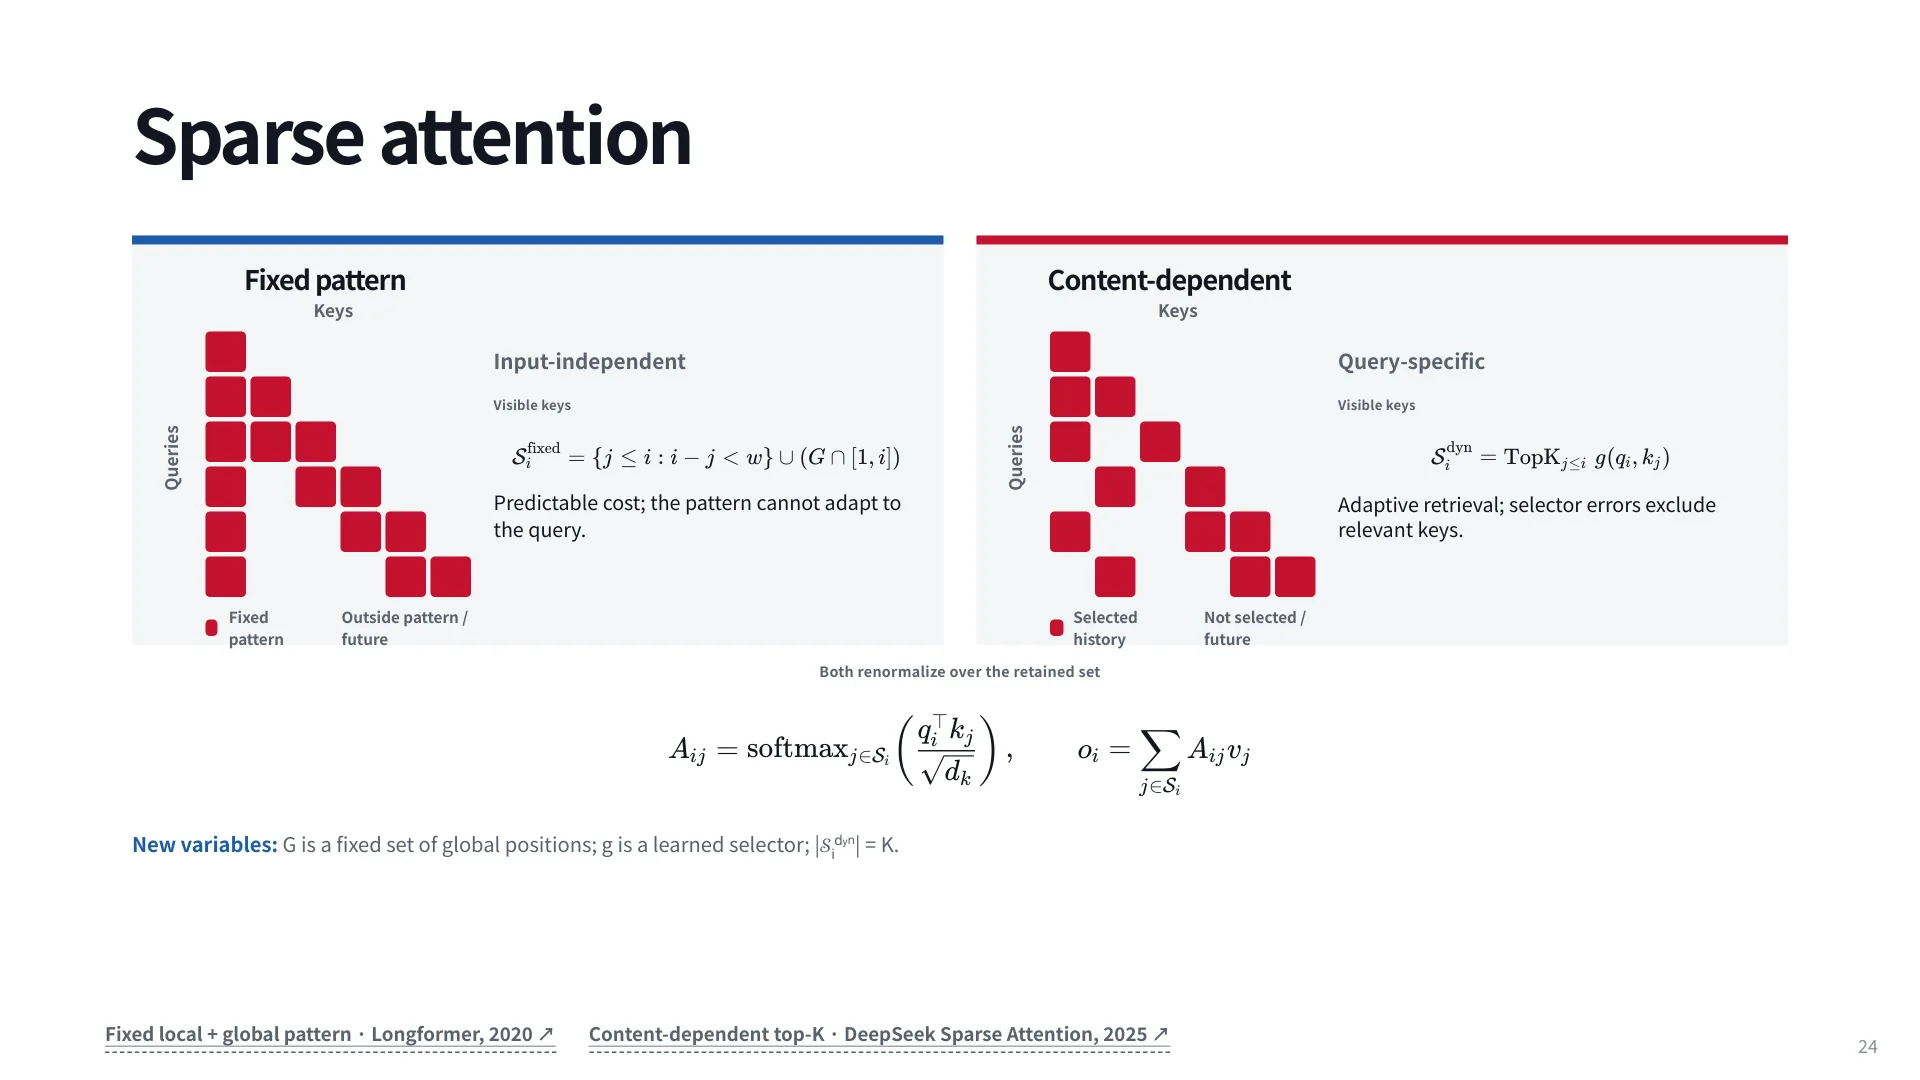
内容相关版本更强大,能跟着 query 走;代价是选择器可能选错。TopK 是硬截断:相关 key 没进前 K 就等于不存在,没有回退机制。这与线性注意力的失败模式相反——后者“模糊地记住了一切”,前者“精确地漏掉了一个”。所以它通常用两阶段实现(先粗筛再精算)。(32:17)
两者都会在保留集合上重新做 softmax 归一化,所以改变的不只是算力,还有注意力的分布形状——保留的 key 会分到更大权重。稀疏模式的选择因此直接影响模型行为。
KV 压缩则从内存侧下手。KV cache 的大小是 (每层),上下文一长,它就把 GPU 显存吃光,直接限制 batch size 和可服务的并发数。有两种压缩维度:
- 减少 head 数:MQA 让所有 query head 共享一组 K、V;GQA 折中,每 个 query head 共享一组 K、V(常见是除以 4 或 8)。讲师强调的细节是:被缓存、被共享的是 K、V 而不是 Q——“缓存的是 KV,不是 KVQ”。
- 压缩每个 head 的宽度:MLA 不减少 head 数,而是把 K、V 压成一个低维隐向量缓存起来,用的时候再投影回去。
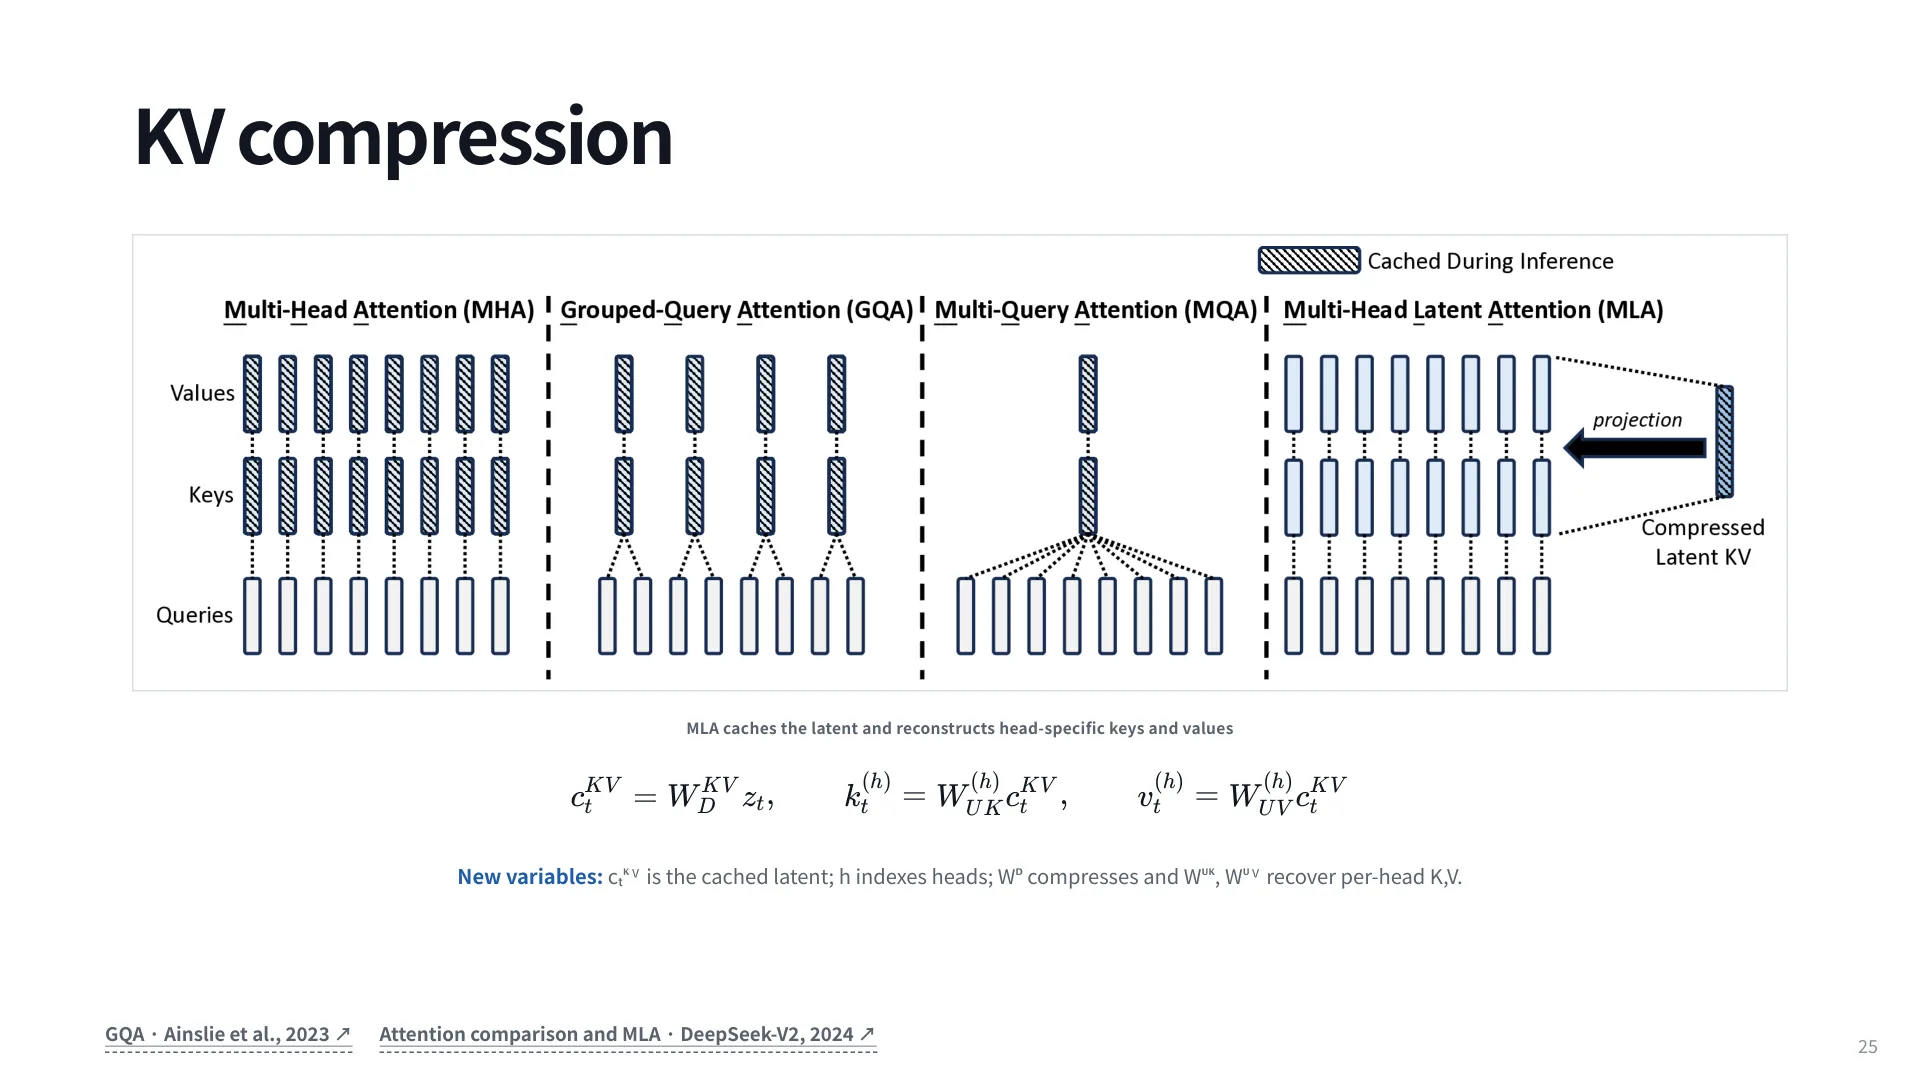
MLA 的巧妙之处是“缓存的不是 K、V,而是生成 K、V 的原料”:每个 head 仍有自己的 K、V(表达力不降),显存里只存一份小向量,代价是每次使用都要上投影。GQA 与 MLA 可以叠加。
这些架构手段让“一百万 token”在效率上成为可能。注意措辞——是效率上可能,不是能力上可用;能力那一半要靠训练。
7. 训练长上下文:数据不够,位置来凑(也不够)
训练长上下文的第一道坎不是算力,是数据。想要 128K token 的连贯文本,你需要的是一本书的体量;互联网上这样的文档并不多。讲师的说法很直白:128K 已经超过大多数维基百科条目,进入“整本书”的量级,而这种数据是稀缺的。(36:29)
标准做法是三段式:短上下文预训练(4K–8K,数据充足、成本低)→ 继续训练(长文档,32K–128K)→ 长适应(任务轨迹、合成课程,128K+)。
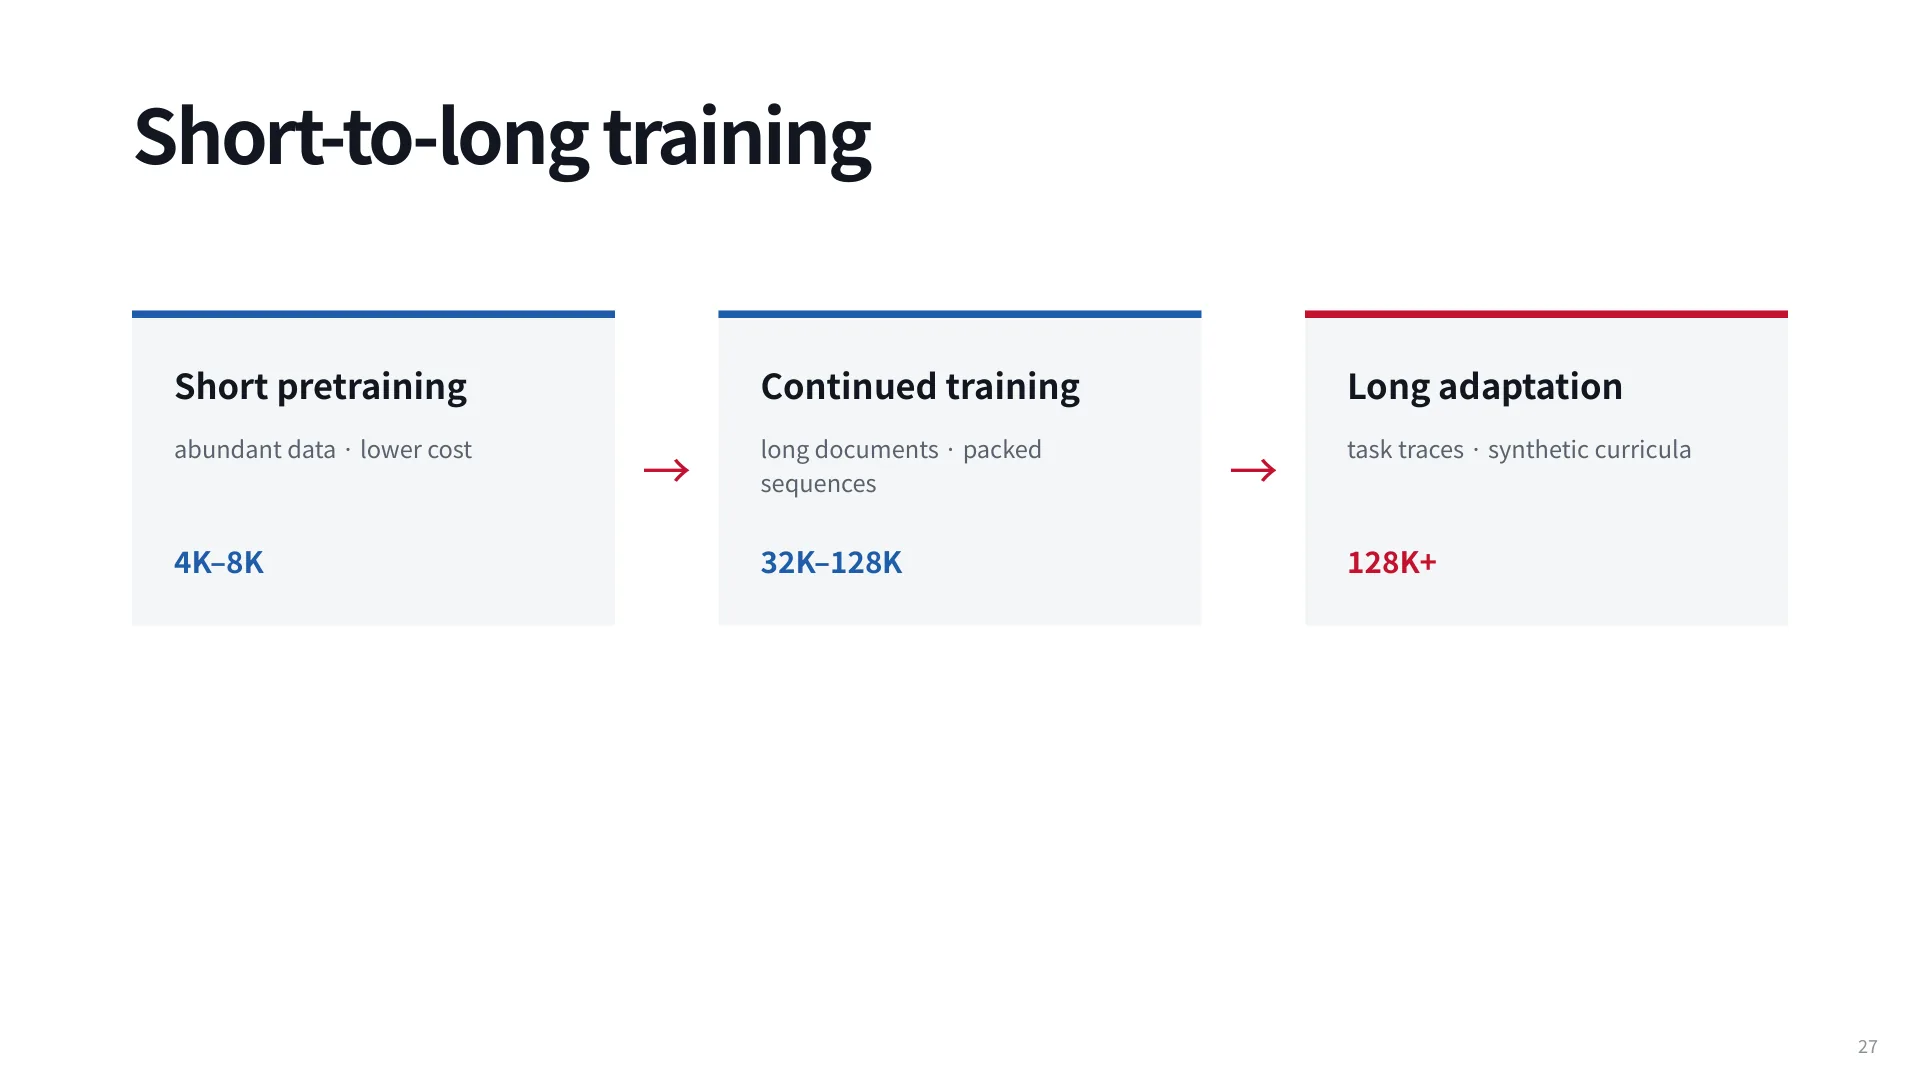
一个反直觉的细节:packed sequences 对效率有用,对“学会长上下文”几乎没用。把 10 篇文档塞进一条长序列,模型学到的是“在序列末尾仍能工作”,而不是跨文档建立联系——跨文档的注意力本来也不是该学的东西,硬学反而是在拟合错误的相关性。(36:29、46:27)
第二道坎是位置编码。三种方案各有各的道理:
绝对位置编码把位置向量直接加到 token embedding 上(正弦函数或可学习的表),位置在进入 Q/K/V 投影之前就混进了表示。
RoPE 的思路是让注意力分数只依赖相对距离。
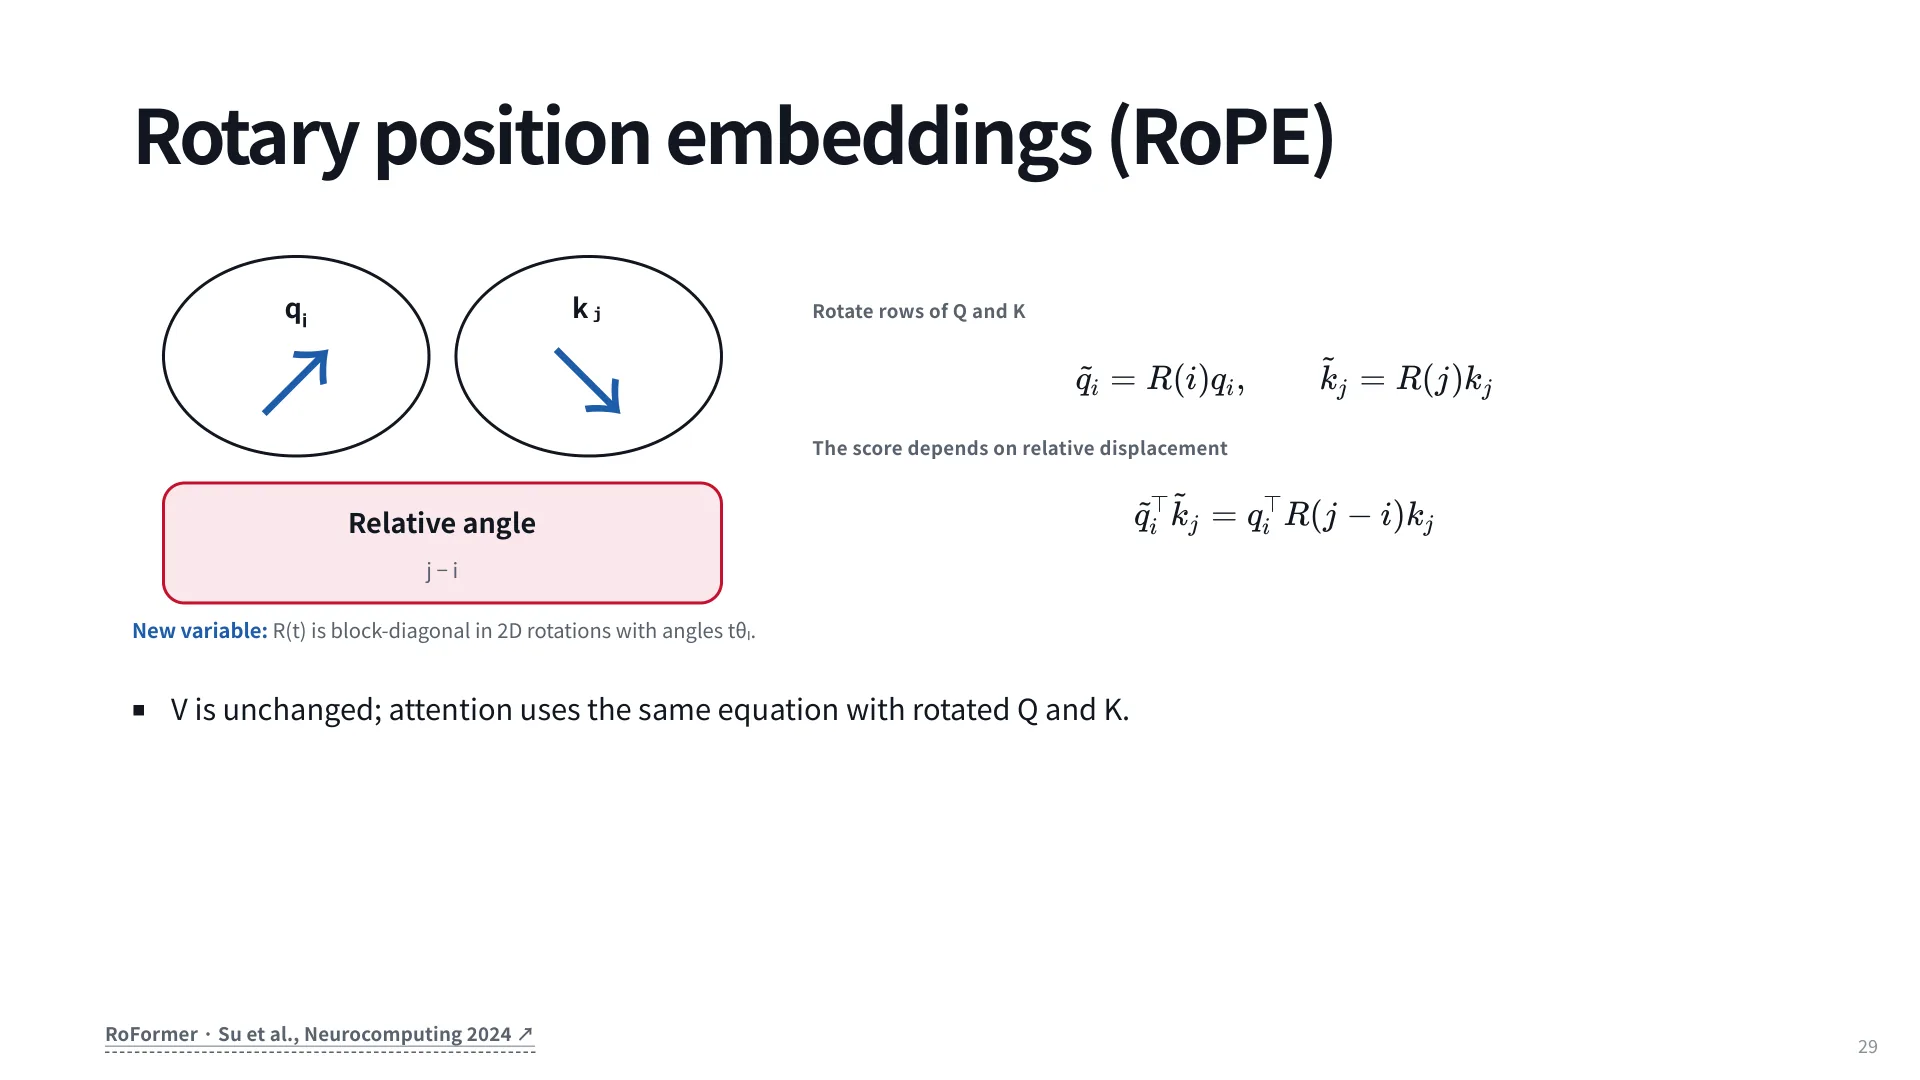
具体做法是把 Q、K 的行按位置做旋转,于是 ,角度里只剩 。这在数学上很优雅,也是过去几年最主流的方案。
NoPE 则彻底不加位置信息。教科书里的“禁忌”理由是:位置 1 和位置 5 的 “cat” 表示相同,模型无法区分。讲师点破了这个禁忌的适用条件——结论来自 encoder-decoder 时代,编码器里所有 token 互相可见。在因果自回归模型里,位置 2 的 cat 只看见 1 个 token,位置 5 的看见 4 个,从第一层起表示就不同。(40:39)
再推一步:一旦模型带了衰减(Gated DeltaNet、KDA)或循环动力学,每个位置的“历史积累”本身就编码了顺序,位置编码更加冗余——这解释了为什么六个前沿模型里有一半干脆不用显式位置编码。
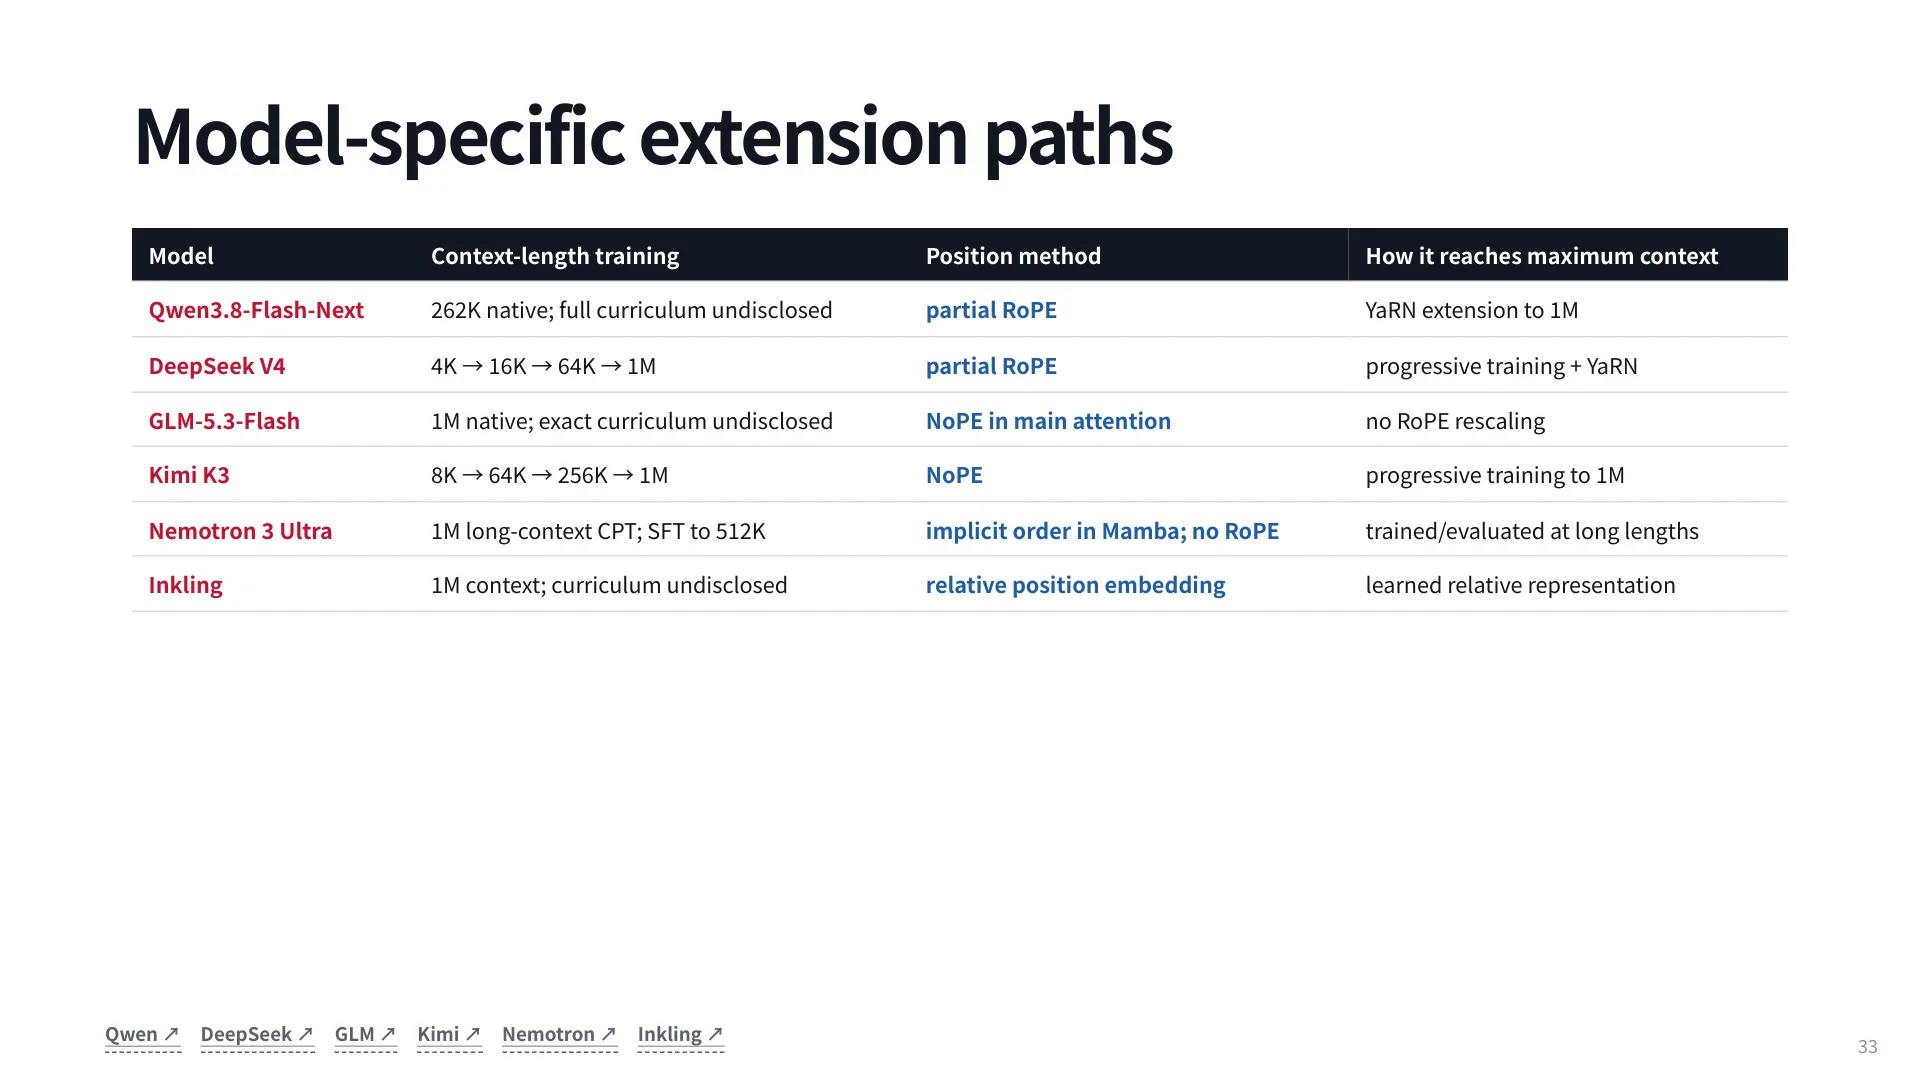
| 模型 | 上下文训练 | 位置方法 | 达成方式 |
|---|---|---|---|
| Qwen3.8-Flash-Next | 262K 原生 | partial RoPE | YaRN 扩展到 1M |
| DeepSeek V4 | 4K → 16K → 64K → 1M | partial RoPE | 渐进训练 + YaRN |
| GLM-5.3-Flash | 1M 原生 | 主注意力 NoPE | 不做 RoPE 重标定 |
| Kimi K3 | 8K → 64K → 256K → 1M | NoPE | 渐进训练到 1M |
| Nemotron 3 Ultra | 1M CPT,SFT 到 512K | Mamba 隐式顺序 | 直接在长序列上训练/评测 |
| Inkling | 1M | 相对位置编码 | 学习到的相对表示 |
如果坚持用 RoPE,那么从训练长度 外推到 会坏在两个地方。第一,训练时从未见过距离超过 的两个 token 互相注意,超出部分的外推没有数据支撑。第二,相对位置只是故事的一半——因果掩码、注意力熵都会随长度漂移,所以“RoPE 只依赖相对距离所以能外推”这个推论是错的。(43:58)
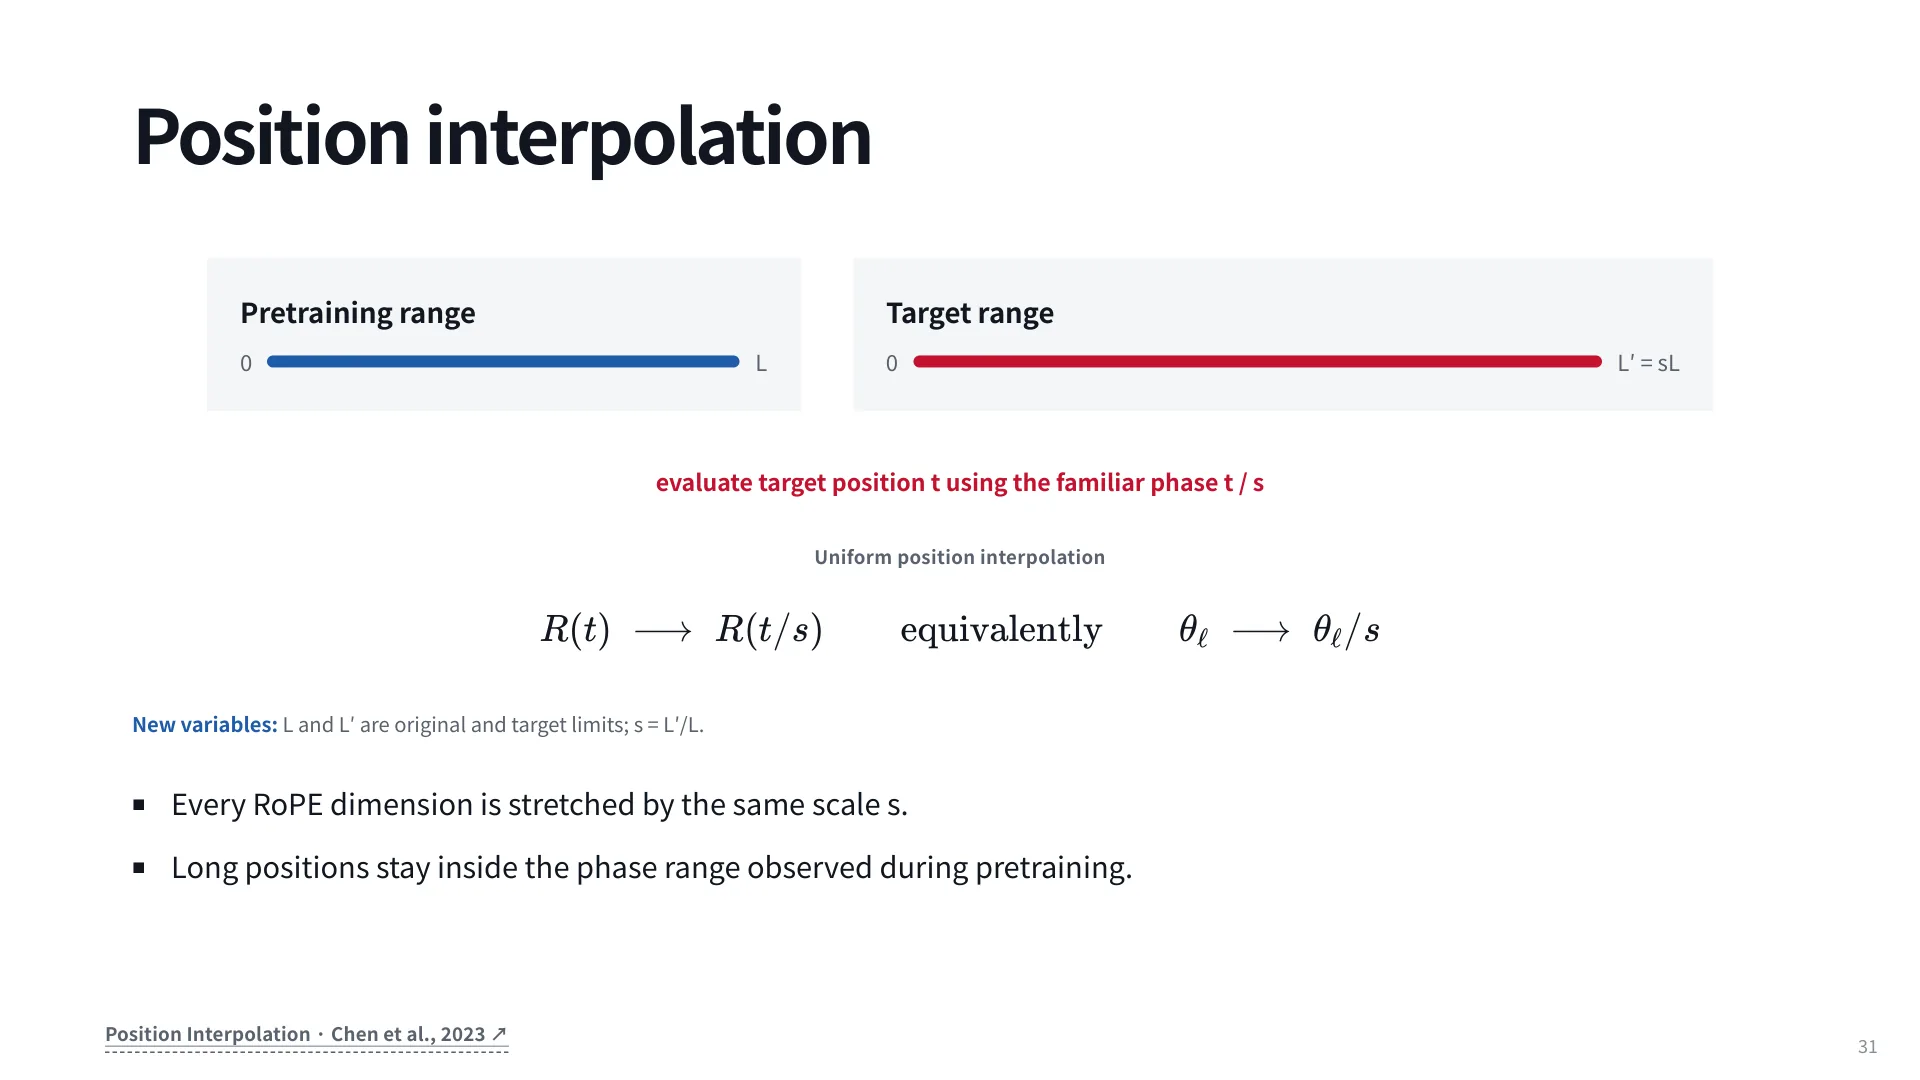
位置插值(PI)的修法是:把所有位置统一除以 ,让长位置落回预训练时见过的相位区间,,等价于 。这相当于把 米长的尺子重新刻回一米:再远的位置也落回预训练时那套刻度。代价是短距离的分辨率被压缩了——原来相邻两个位置差 1 个刻度,现在只差 个刻度。
YaRN 的改进是按频率分别处理:波长很长的维度(负责远距离)充分插值,波长很短的维度(负责局部次序)保持原样,中间地带平滑过渡;再加一个注意力温度修正 来抵消长上下文下注意力熵的漂移。课件在这页注明,这个 的经验公式是在 LLaMA 上拟合出来的(讲师没有展开推导)——它是配方,不是普适常数,换模型要重调。
这一节的实践含义是:长度扩展不是“改一个参数”,而是“位置编码 + 训练课程 + 数据分布”三者一起动。第 33 页那张表里,没有一家是只改位置编码就达到 1M 的。
8. 数据配方与上下文并行
上一节说“需要连贯的长材料”,具体从哪来?课件给了四类:
- 长文档:书、代码库、多文档语料。代码库是特别好的来源——天然连贯、体量往往足够大。
- 打包样本(packed):token 利用率高、成本低,但边界处理和跨样本泄漏要小心;它教不会全局连贯。
- Agent 轨迹:动作 + 观察的序列,教的是长程恢复、状态追踪和工具使用。这是近年来增长最快的来源,因为 agent 自己能生成极长的轨迹。
- 合成任务:把证据和干扰项放在设计好的位置,可以精确控制依赖距离。
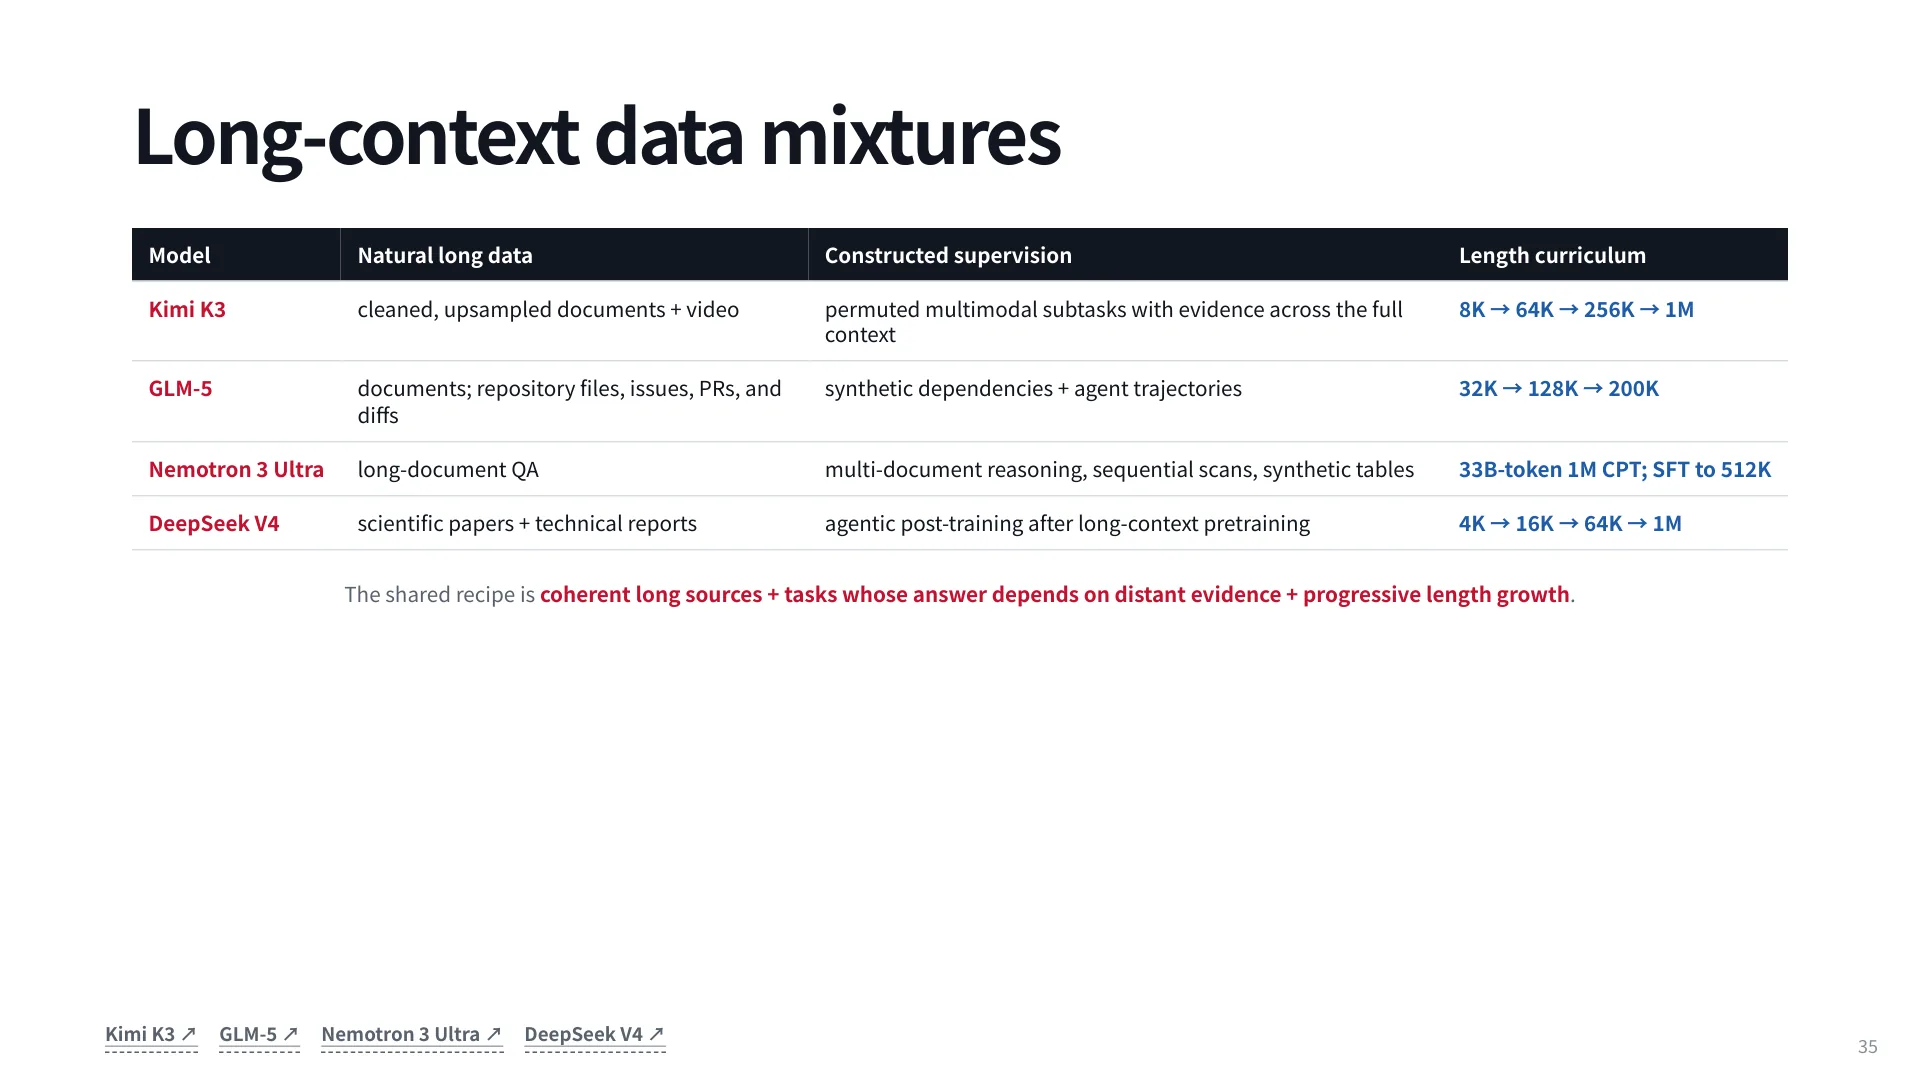
| 模型 | 自然长数据 | 构造监督 | 长度课程 |
|---|---|---|---|
| Kimi K3 | 清洗并上采样文档 + 视频 | 证据铺满全上下文的多模态子任务排列 | 8K → 64K → 256K → 1M |
| GLM-5 | 文档;仓库文件、issue、PR、diff | 合成依赖 + agent 轨迹 | 32K → 128K → 200K |
| Nemotron 3 Ultra | 长文档 QA | 多文档推理、顺序扫描、合成表格 | 33B token 的 1M CPT;SFT 到 512K |
| DeepSeek V4 | 科学论文 + 技术报告 | 长上下文预训练后的 agentic 后训练 | 4K → 16K → 64K → 1M |
课件把共同配方总结成一句话:连贯的长来源 + 答案依赖远处证据的任务 + 渐进增长的长度。缺一不可:没有“必须看远处才能答对”的任务,模型学不会检索;没有自然分布,模型会过拟合到合成任务的表面形式;没有长度课程,直接上 1M 很难学会。
一个生态观察:闭源公司连架构都不公开,开源公司必须公开架构(否则别人跑不起来),于是它们保密的是数据配比和训练策略。所以我们能看到架构图,却很难复现“为什么这个模型在 200K 上比那个好”——上表只能当作公开声明的最佳实践,而不是因果结论。
训练侧还有一个纯工程问题:上下文并行。把序列切成 段分到不同设备,每台只存 的 KV,用环形通信把 K、V 传一圈,计算量仍是精确的 (不是稀疏近似),通信可与分块注意力重叠。(51:20)
这里有一段很有价值的“组织摩擦”:模型组想要 KDA、Gated DeltaNet 这些新结构,系统组要问“谁来写这个结构的 context parallel kernel,能不能反传”。他自己训练一个较小的 Qwen 模型时想用上下文并行,发现网上根本没有 gated delta net 的 kernel,只能自己写或放弃。标准注意力和滑窗有现成 kernel,非标准算子没有——架构创新与基础设施之间是有真实冲突的,这条线在 32K 以上非常明显。
9. 缓存:把重复的 prefill 变成命中
现在回到 agent 循环本身。前面说过,每一轮都要把整段历史重新 prefill 一次。但这里有一个结构性的事实:历史的前缀是不变的。第 轮的前缀就是第 轮的完整输入加输出,只有工具返回的那一小段是新的。
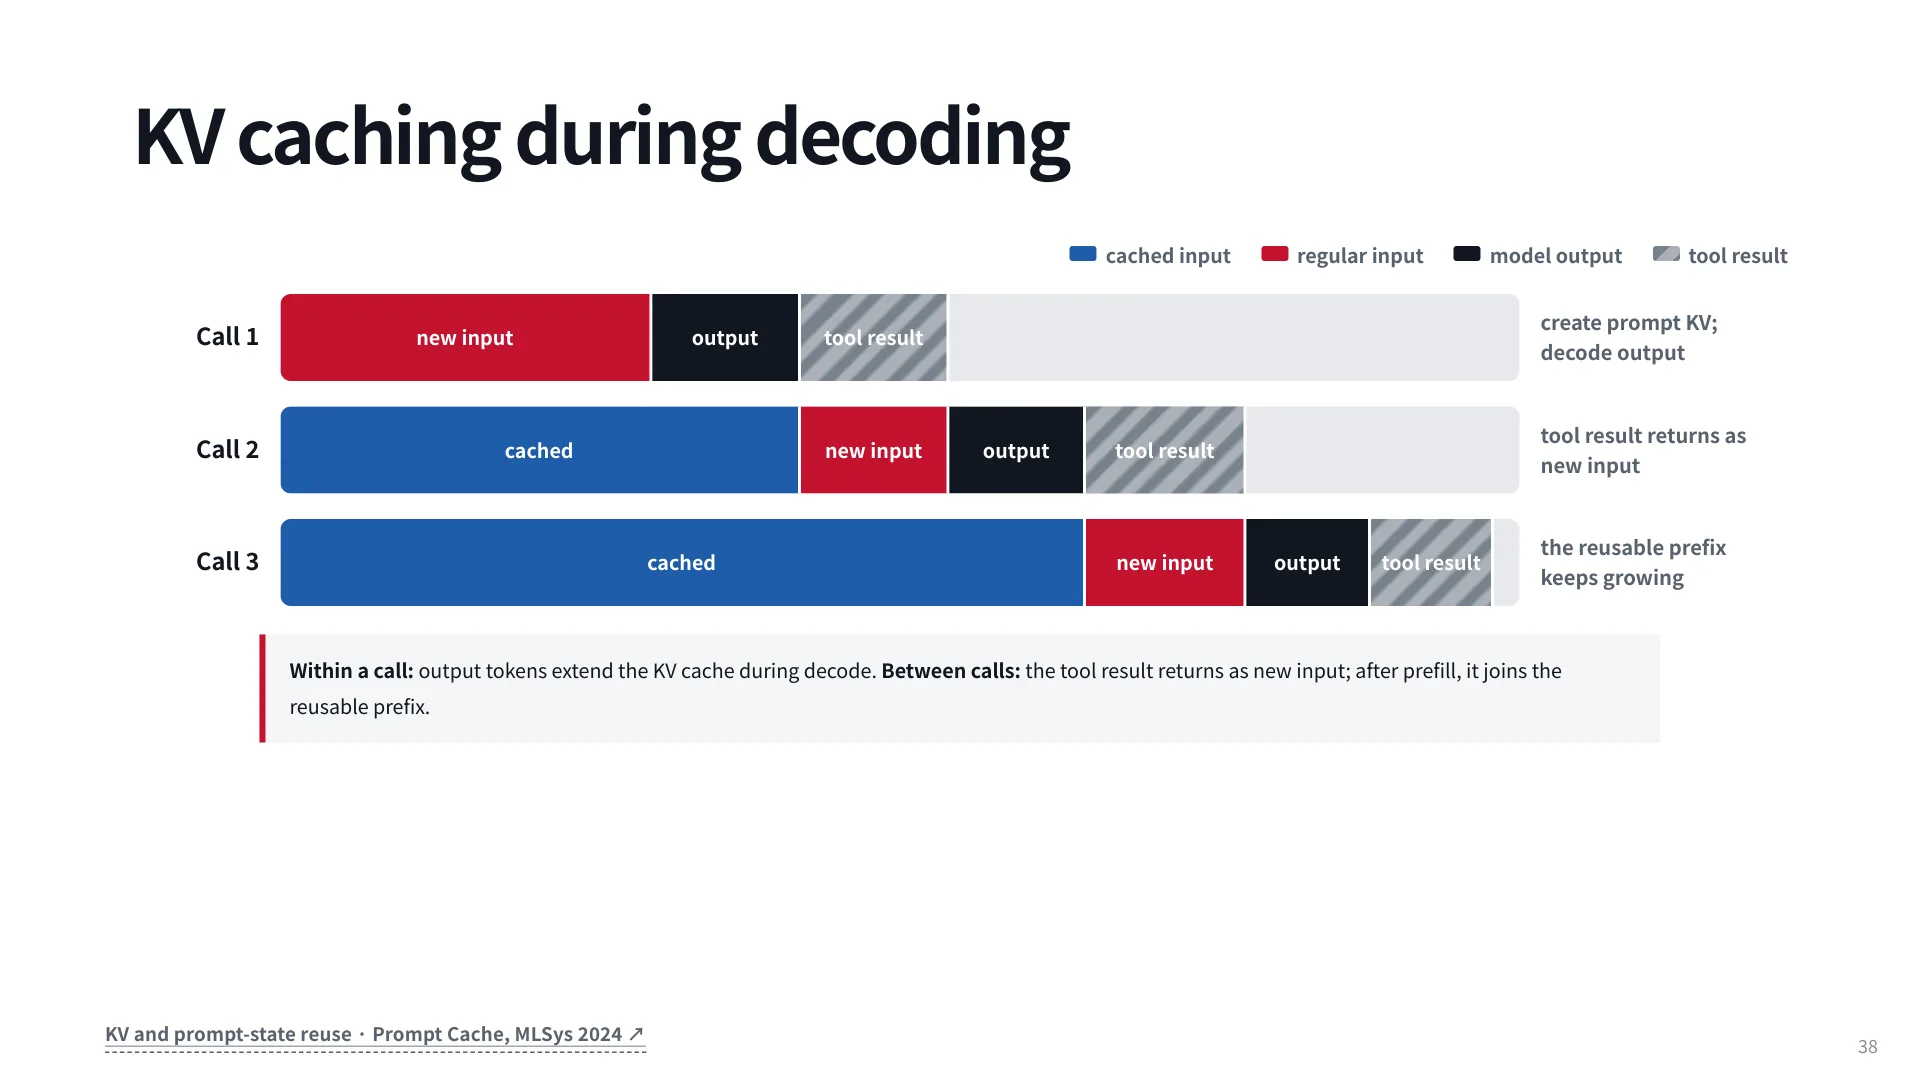
于是可以这样做:把每一轮算完的 K、V 留在显存里,下一轮只 prefill 新增部分。第 50 轮时,新增输入可能只占整体的几十分之一,省下的 prefill 就是几十倍。(53:45)
这件事在价格表上体现得非常直接。
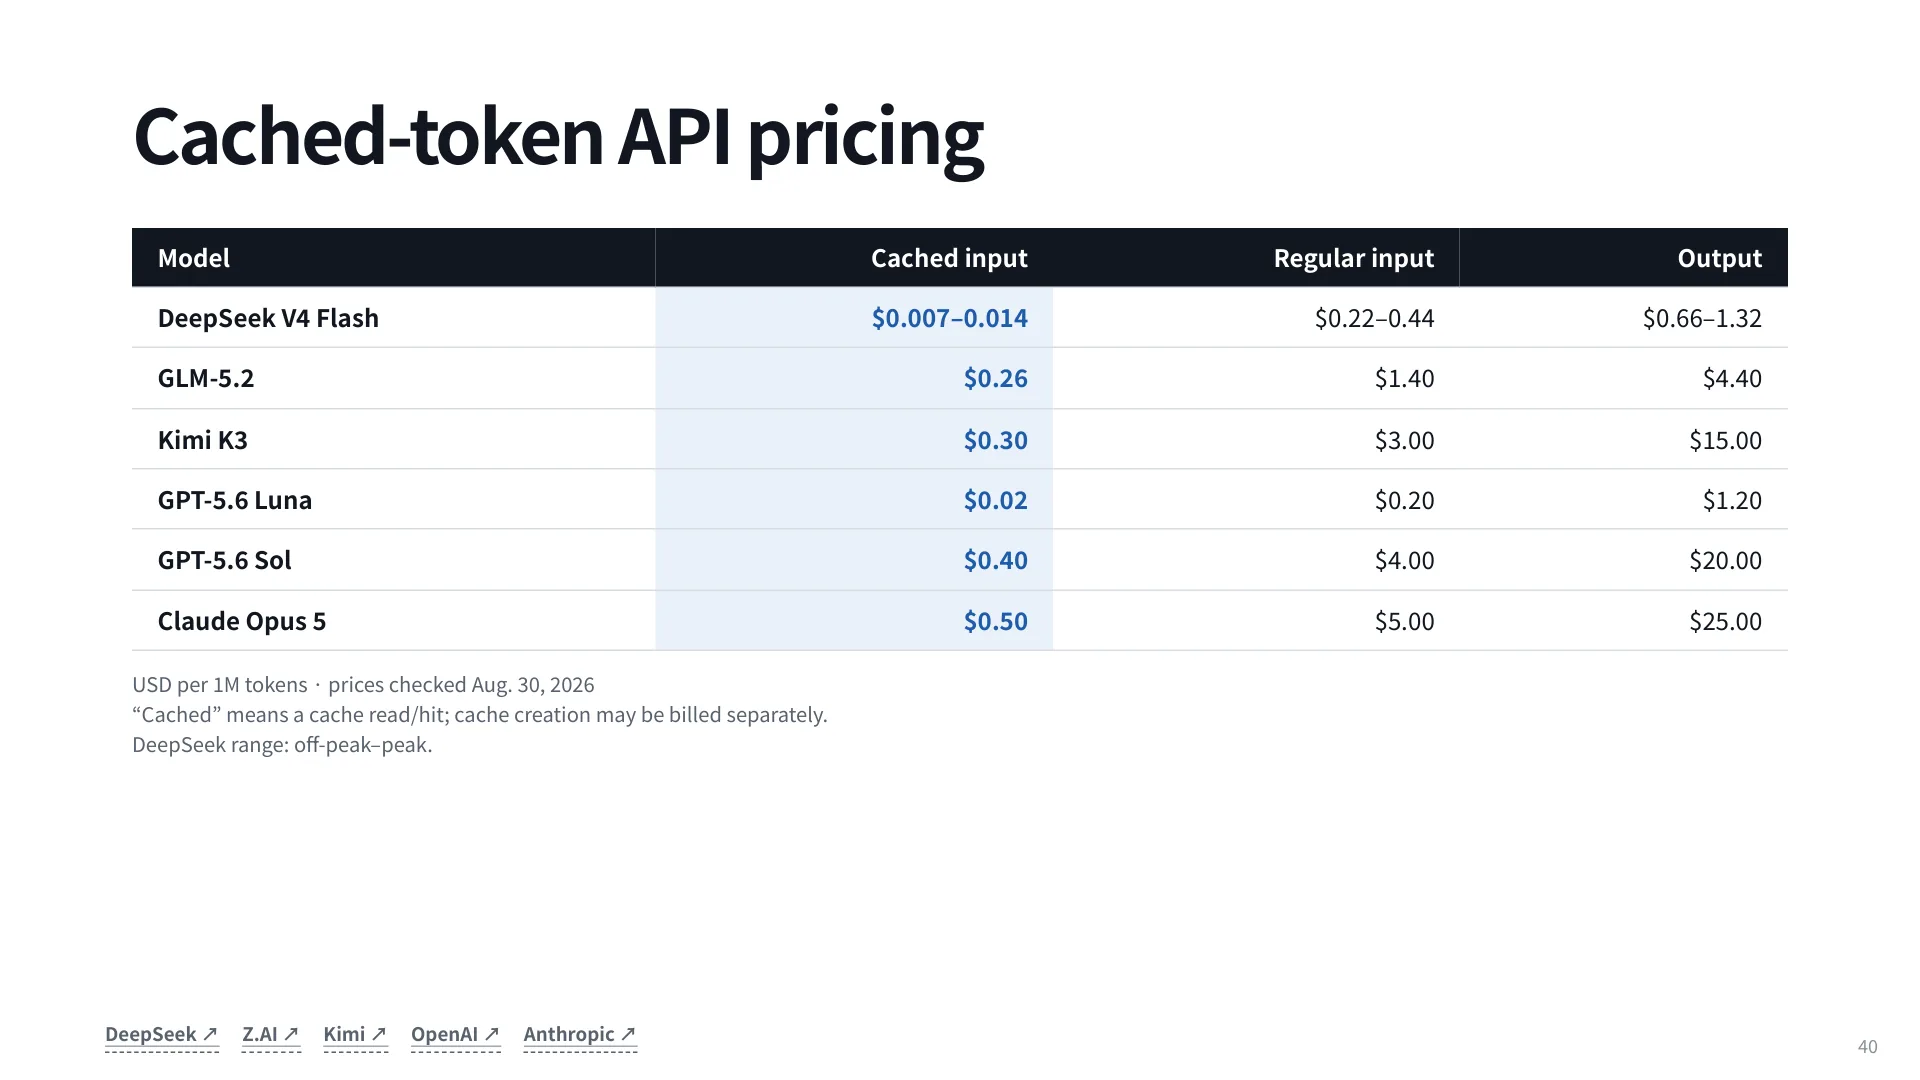
| 模型 | Cached input | Regular input | Output |
|---|---|---|---|
| DeepSeek V4 Flash | $0.007–0.014 | $0.22–0.44 | $0.66–1.32 |
| GLM-5.2 | $0.26 | $1.40 | $4.40 |
| Kimi K3 | $0.30 | $3.00 | $15.00 |
| GPT-5.6 Luna | $0.02 | $0.20 | $1.20 |
| GPT-5.6 Sol | $0.40 | $4.00 | $20.00 |
| Claude Opus 5 | $0.50 | $5.00 | $25.00 |
表中 DeepSeek 是 off-peak–peak 区间价;“cached”指 cache read/hit,cache 创建可能单独计费。
两个经验比例:多数厂商的 cached input ≈ regular input / 10(DeepSeek V4 Flash 低到约 1/31,GLM-5.2 约为 1/5.4,是两端的例外),output ≈ regular input 的 3–6 倍(DeepSeek 与 GLM 约 3 倍,GPT-5.6 Luna 约 6 倍)。讲师把这两条概括成一句“输出比缓存输入贵约 50 倍”,这也解释了为什么缓存命中率对 agent 成本的影响如此之大。(56:11)
由此可以推出一个成本优化顺序(这是本讲的推论,不是讲师的原话):先提高缓存命中率,再减少输出长度,最后才考虑换更便宜的模型。
讲师现场问:agent 场景下合理的 cache hit rate 是多少?听众答 80–90%,他的经验是 90–95% 基本可以放心;低于这个区间不一定出问题,但多半在某个环节漏了钱。之所以能这么高,是因为 agent 的 prompt 天然是“前缀稳定、尾部追加”的结构。
破坏缓存的方式出乎意料地多,而且每一条听起来都很“合理” (64:18):
- 每步改系统提示词。最典型的错误是“把当前时间加到 system prompt 里,好让 agent 知道几号”。时间每秒都在变,前缀第一段就变了,于是整个缓存失效。正确做法是把它放到最后一条 user message 或最后一条工具结果里。
- 动态调整工具列表。工具描述在 system 段;讲师说“中途改工具是可以的”(他并不禁止),但工具定义一变前缀就变了,改一次就要重算一次。
- 每步换模型。不同模型的缓存不通用。你想“这一步用强模型、下三步用便宜模型”,结果切回强模型那一步仍在冷启动,省下来的钱又赔回去。
- 无意义的重排:工具 schema 的顺序、示例的顺序、时间戳、随机 ID。
这条约束可以用一句话概括:prompt 应该是一个只追加的日志,而不是一个每轮重新渲染的模板。这句话对 harness 设计的影响比任何模型选择都大。
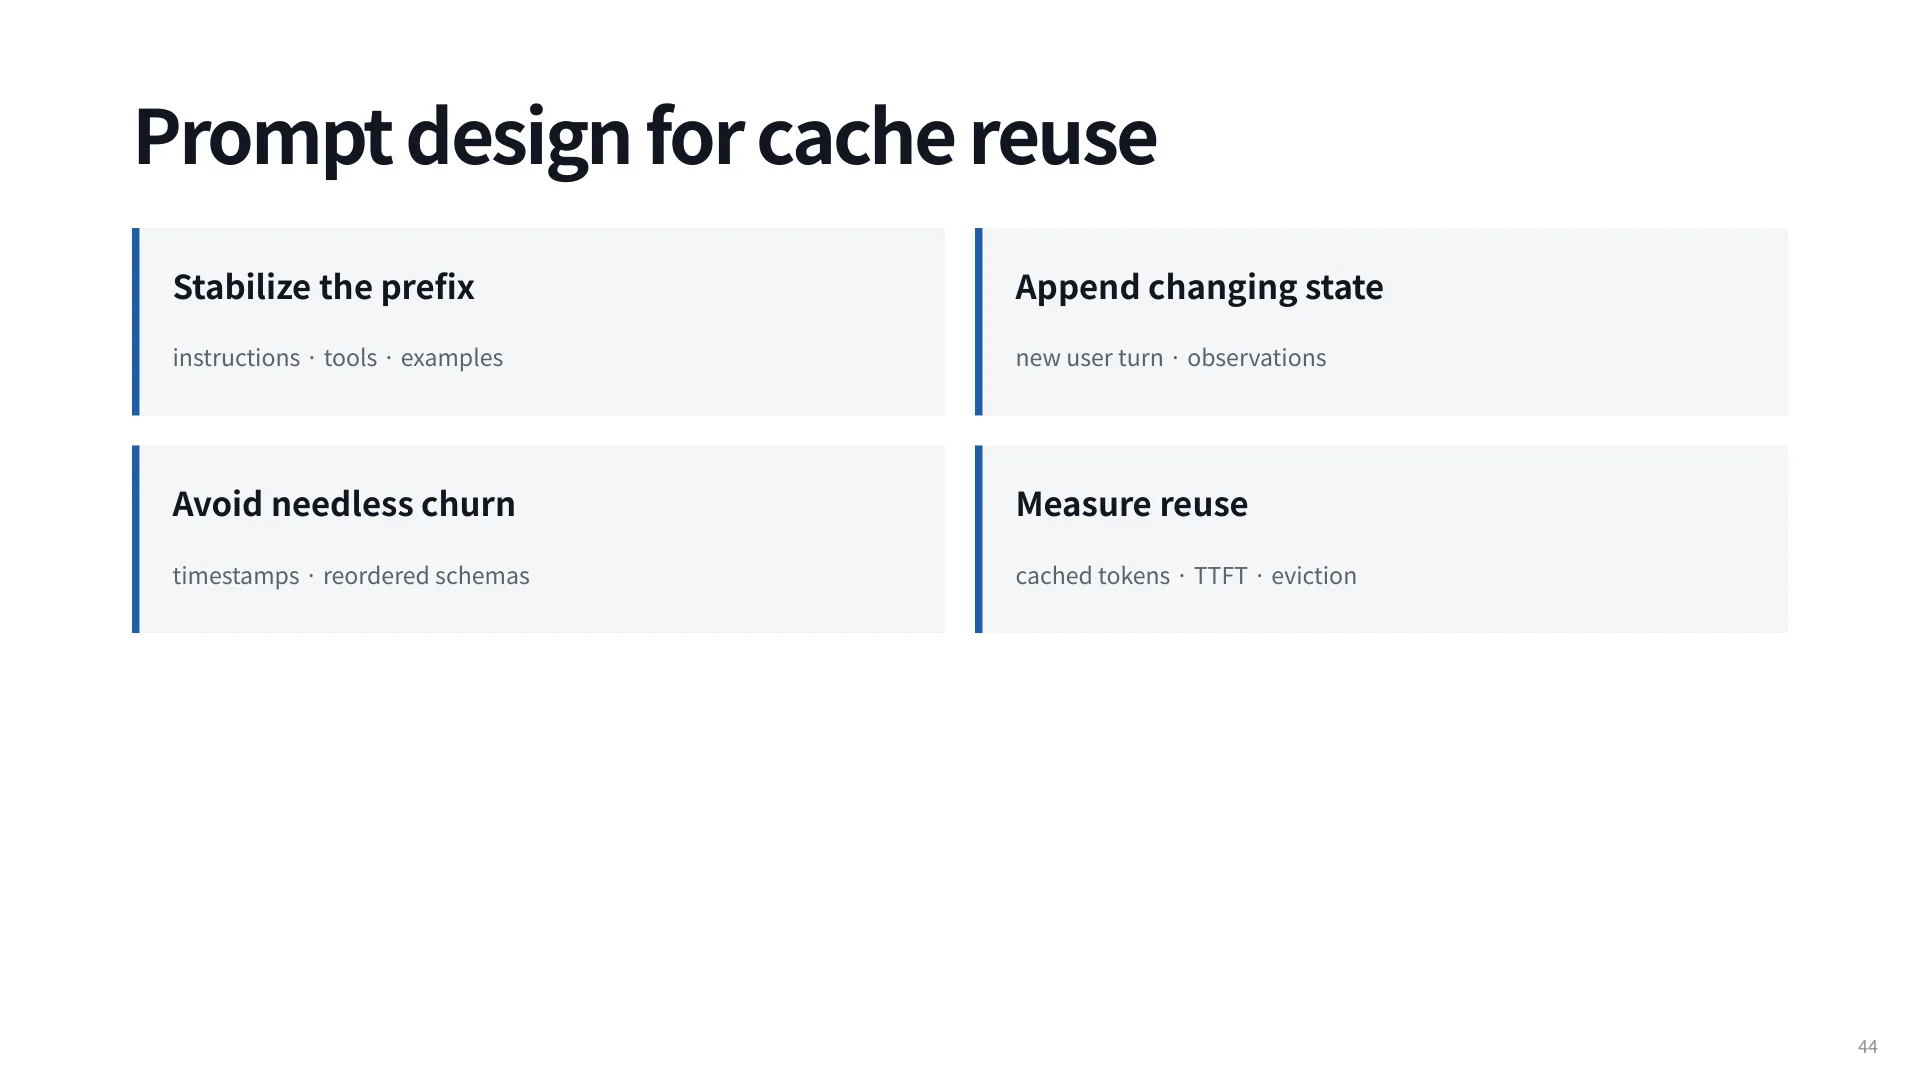
课件把这条原则拆成四个动作:稳定前缀(指令、工具、示例固定在最前)、追加变化的状态(新的用户轮次和观察放在尾部)、避免无谓抖动(时间戳、重排的 schema)、度量复用(cached tokens、TTFT、驱逐率)。四件事都是纯工程改动,却直接决定成本是“每轮读一遍历史”还是“每轮只读新增”。
服务侧有几层机制支撑这个假设。vLLM 的 PagedAttention 把 KV cache 切成固定大小的 block、用 block table 间接寻址,按块分配与回收,避免为每条序列预留连续显存。SGLang 的 RadixAttention 把已缓存前缀组织成 radix tree,新请求沿树匹配最长前缀,命中就复用、只 prefill 后缀,需要腾空间时按 LRU 淘汰叶子。再往上,缓存感知路由在多机部署时把请求发给“前缀匹配最长、队列最短”的 worker——跨机器缓存不共享,路由错了等于没缓存。
还有两个现实约束。缓存会被驱逐:提供商不会无限期保留。讲师记得 Anthropic 早期是 5 分钟,现在可选到 1 小时但更贵(听众补充说常见上限“接近一小时”;其他厂商的具体策略他没有细说)——对话中断太久,下一次就要全量重算。价格不随质量变化:不管缓存做得好不好,你付的都是同一张价目表,命中率低对用户是纯损失。
讲师提醒:缓存优化不是“性能优化”,而是“成本结构优化”。它不减少模型看到的历史长度,只减少重复计算的次数。因此它解决不了 capacity 问题,只能解决 efficiency 问题。
10. 上下文压缩:把历史和未来动作对齐
当历史长到连缓存都救不了——窗口装不下、或者装了也找不到——就只剩压缩。这也是最让人紧张的一步:几乎所有人看到 “compacting context” 的提示都会心里一沉。
先看一个具体的例子。
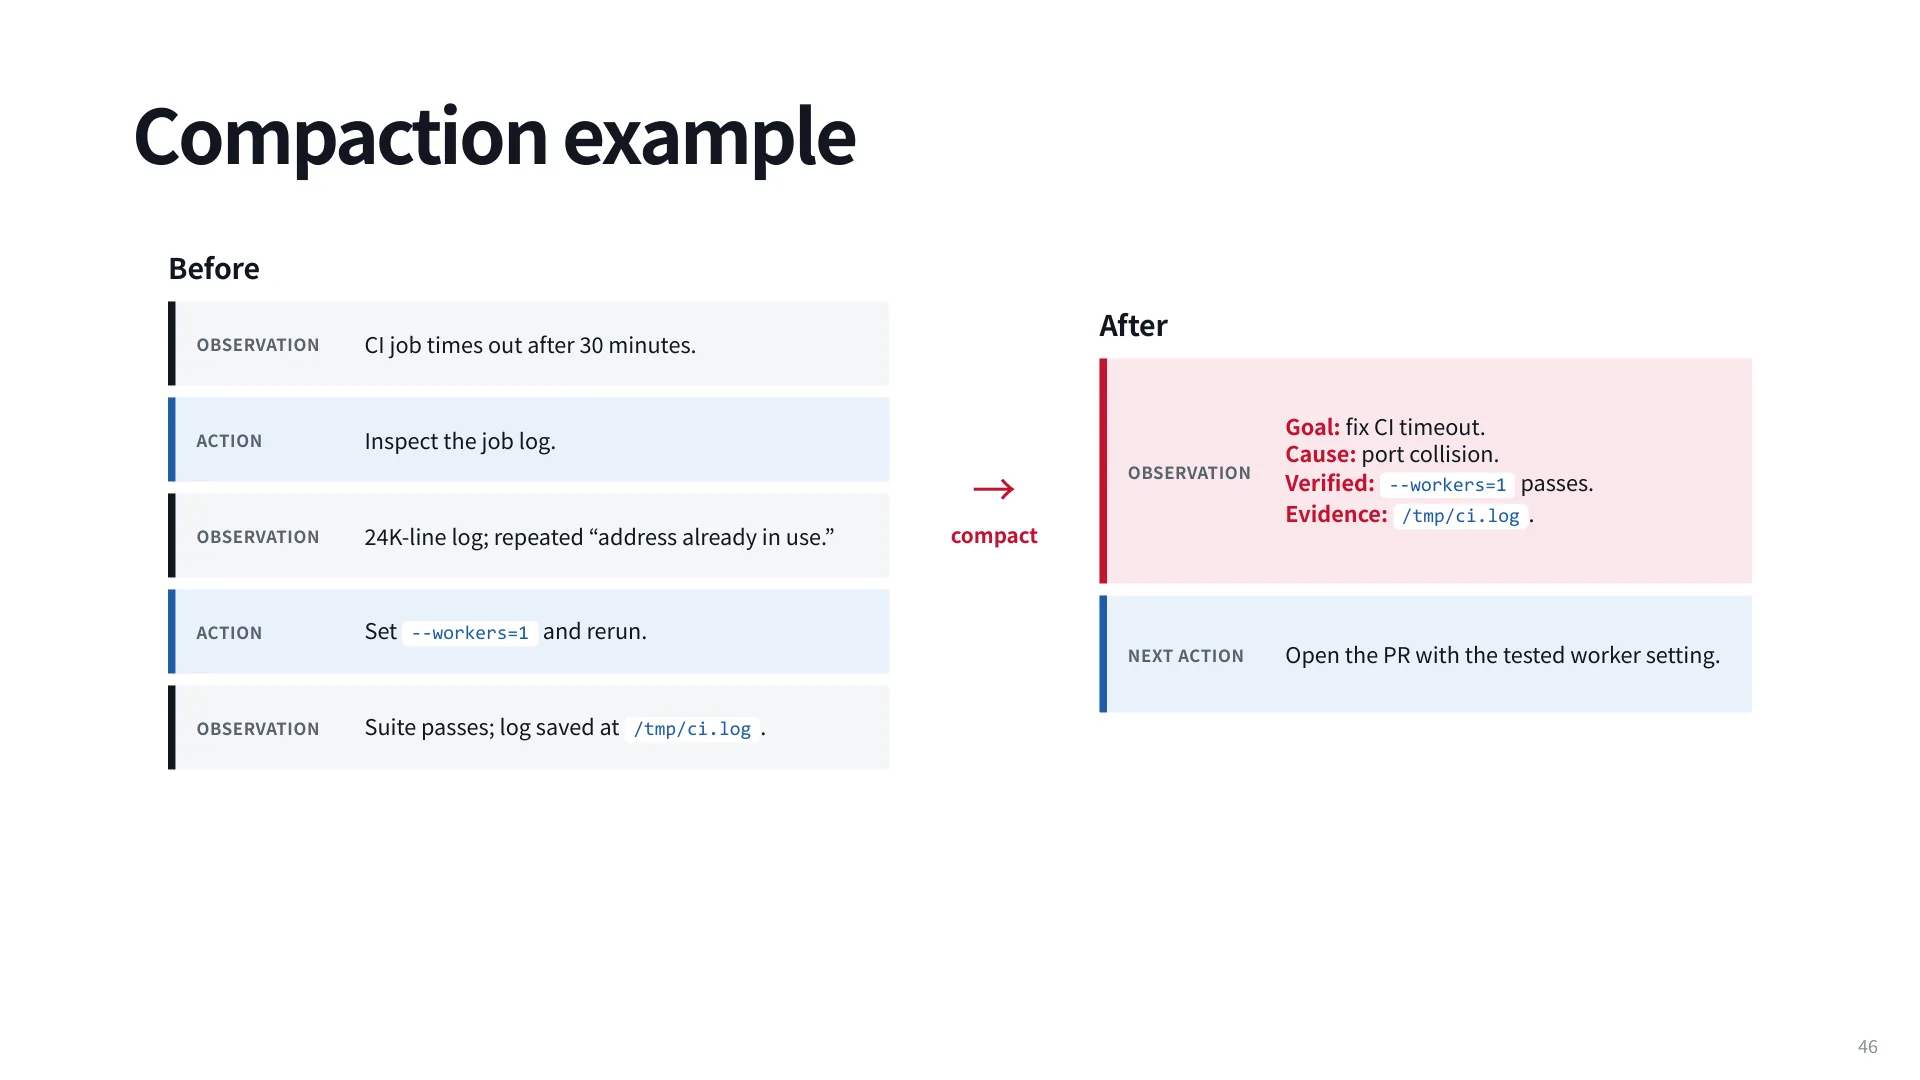
压缩前是动作和观察的流水账:CI 超时 30 分钟 → 看日志 → 24K 行日志里反复出现 “address already in use” → 设 --workers=1 重跑 → 测试通过,日志存在 /tmp/ci.log。压缩后是五行:目标(修 CI 超时)、原因(端口冲突)、已验证(--workers=1 通过)、证据(/tmp/ci.log)、下一步动作(用测过的 worker 设置开 PR)。
注意压缩后的形态:它不是“摘要”,而是一份给下一个动作用的交接单。数字、路径、命令这些“锚点”被逐字保留,因为它们不可重新推导;中间的过程被折叠成因果链,因为过程可以重放;日志被外置成指针,因为体积大且可重新读取。
这就引出形式化。把压缩看成一个状态估计问题:
其中 是完整历史, 是压缩器, 是 token 预算, 是未来的动作序列。这个式子的重点是右边那个近似:压缩的目标不是“还原历史”,而是“保持行为”。两份完全不同的摘要,只要导致同一串后续动作,就是等价的。它同时带来三个互相拉扯的要求:behavioral fidelity(行为不变)、bounded representation(大小有界)、recoverability(能找回原文)。第三个最容易被忽略:只要原始历史还在磁盘上、或者证据被外置到可检索的存储里,压缩就是“可撤销的信息损失”;如果历史被直接丢弃,压缩就是不可逆的。
那么具体保留什么?课件给了一个五分类。
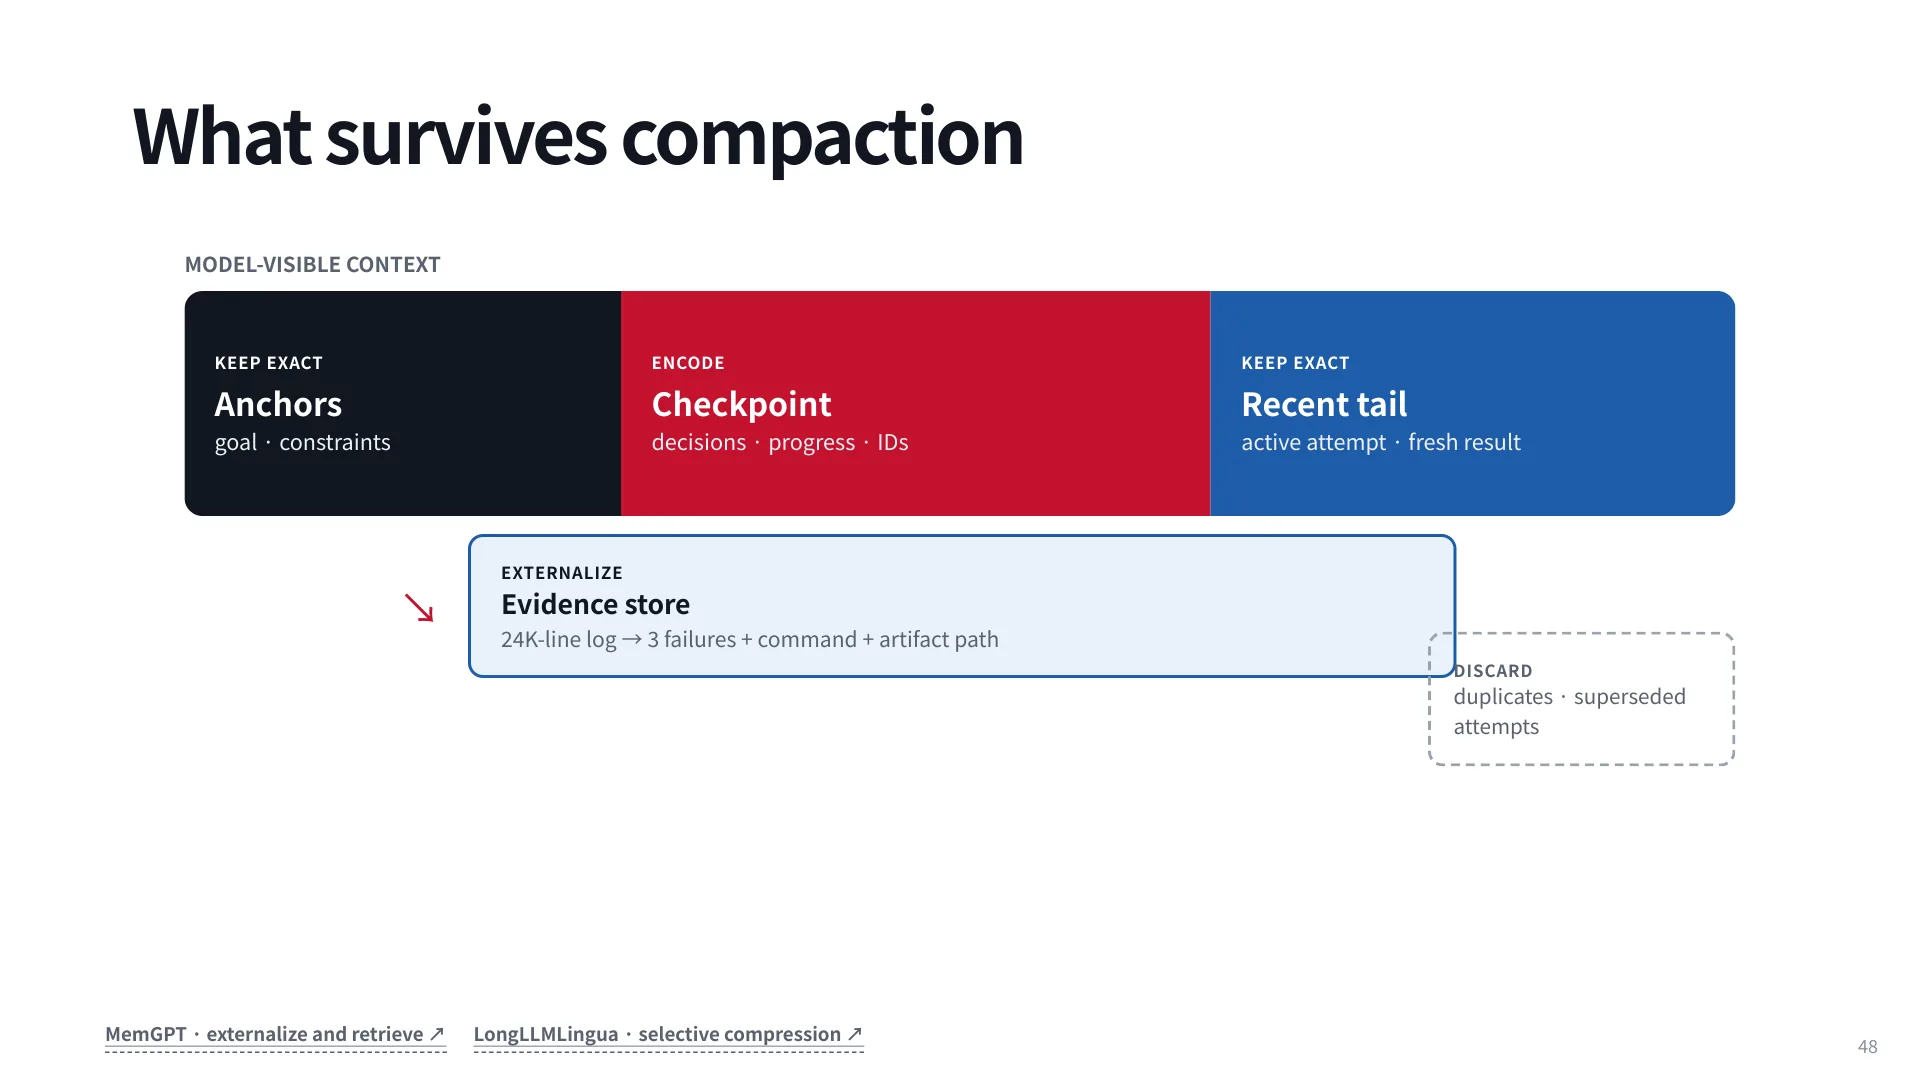
- KEEP EXACT · Anchors:目标、约束,必须逐字保留。讲师特别提到“忘记 session 开头说的话”往往是 harness 的设计缺陷——好的 harness 会刻意保护开头那几条消息。
- ENCODE · Checkpoint:已做的决策、进度、关键 ID,允许改写,因为它是“结论”不是“原文”。
- KEEP EXACT · Recent tail:正在尝试的动作、刚拿到的结果,是下一步动作的直接输入,压缩它等于让 agent 失忆。
- EXTERNALIZE · Evidence store:把 24K 行日志换成“3 个失败 + 命令 + 产物路径”。这是把“上下文压缩”转化成“检索问题”。
- DISCARD:重复的、被后续尝试取代的内容。
课件还给了四步策略:触发(token 阈值 / 提供商溢出 / 手动 /compact,并要为下一次输出预留空间)→ 选择(保护开头、压缩中段、保留尾部,且必须在完整的 turn 或 tool 边界处切)→ 替换(可读摘要 / 结构化检查点 / 不透明的 provider item / 全新上下文)→ 恢复(压缩失败时怎么办:保留历史不动、重试、重置、或保留可搜索的历史)。
第三步的“不透明 provider item”值得单独说一句:讲师推测这是 OpenAI 的做法——把压缩结果加密成不可读的条目,你无法知道 agent 为什么忘了某件事,调试成本极高。
最危险的不是单次压缩,而是反复压缩的漂移。
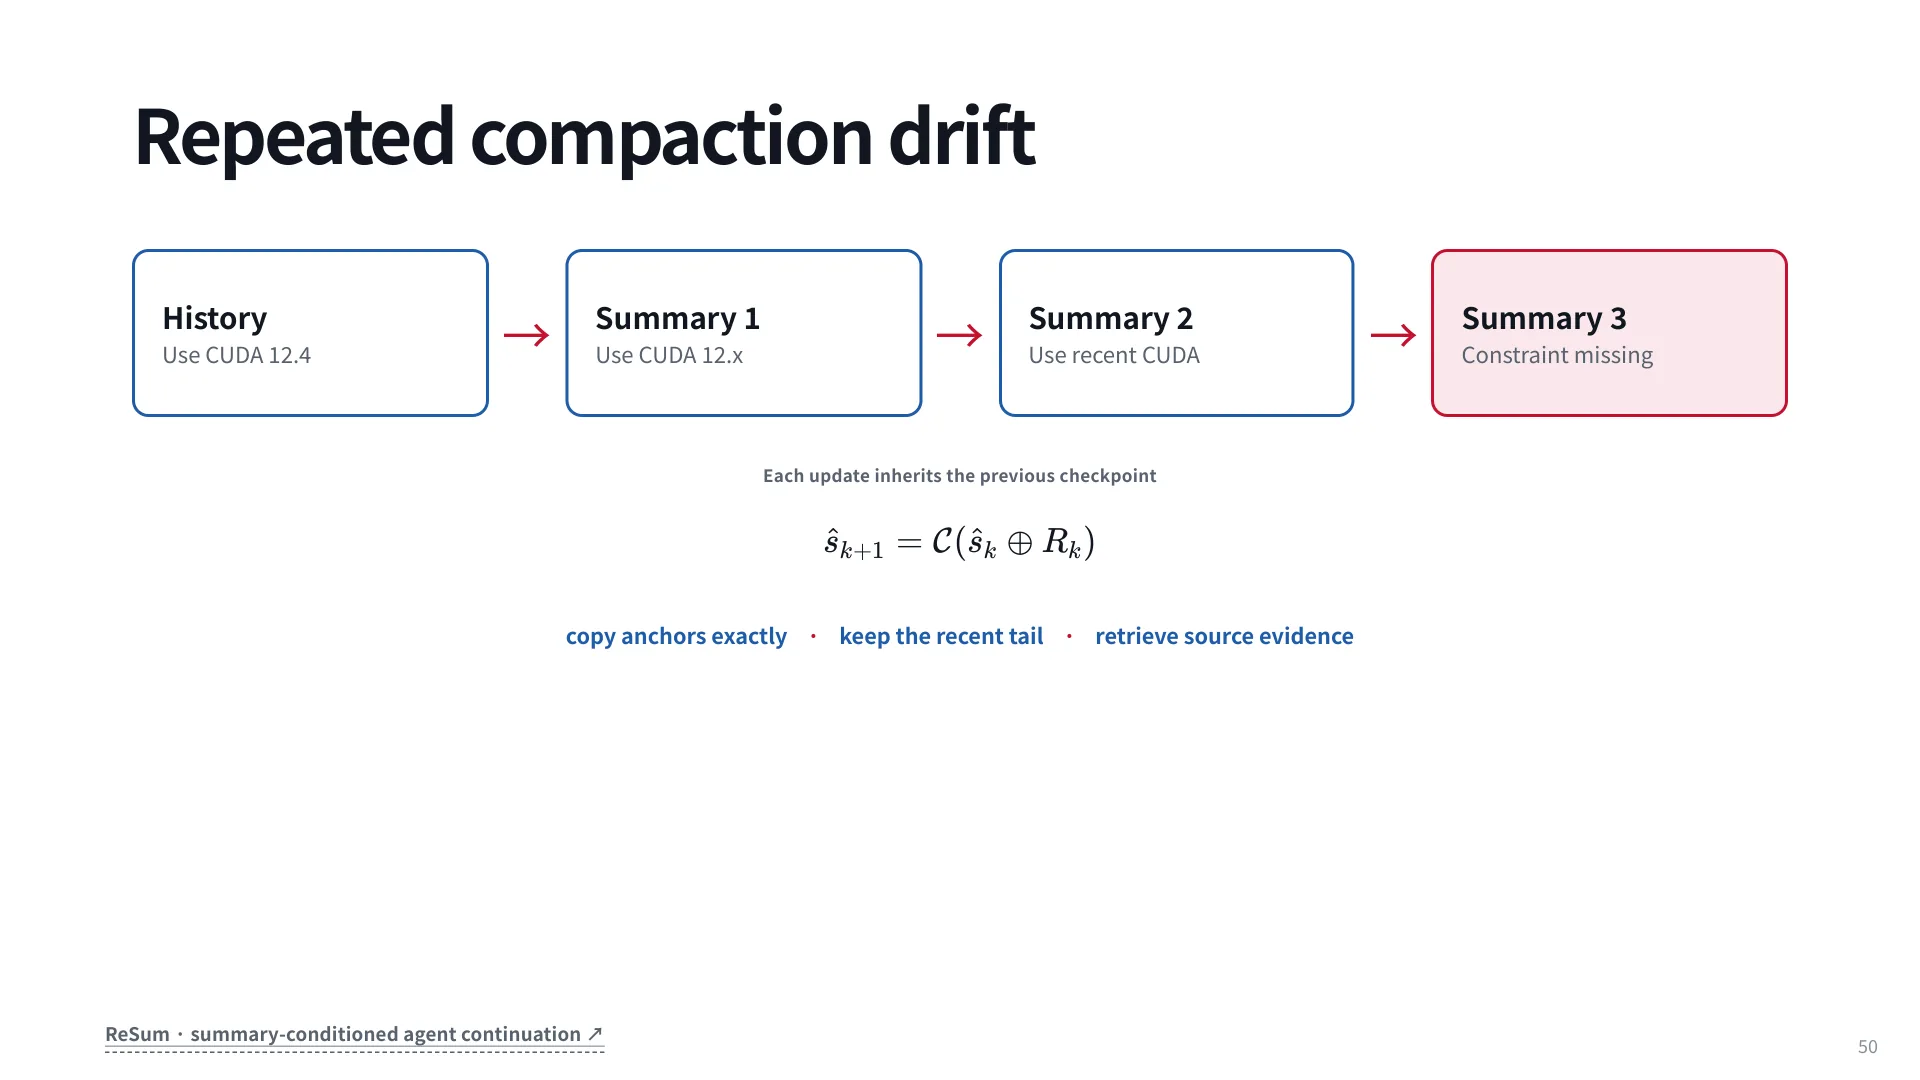
原始约束是 “Use CUDA 12.4”;第一次压缩变成 “Use CUDA 12.x”;第二次变成 “Use recent CUDA”;第三次这条约束直接消失。递推式是
关键在于:第 次压缩的输入是上一轮的摘要,而不是原始历史。于是每一次都是有损压缩叠加在有损压缩之上,误差单调累积,而且没有任何机制能把它纠回来。这解释了一个经验现象——agent 在长 session 里“越跑越飘”,前几轮还很准,若干轮之后开始做一些莫名其妙的事。
缓解手段还是那三条:锚点逐字复制、保留近期尾部、允许回查源证据。只要 /tmp/ci.log 和历史还在磁盘上,agent 就能“回去看一眼”,压缩就从不可逆变成暂时的。
那么怎么评?不能用“摘要质量”来评,要用续跑来评:植入已知状态(约束、决策、产物)→ 用生产环境的压缩策略压一次 → 让 agent 继续做后续任务 → 测量四件事:state recall(约束和标识符还在不在)、task success(后续动作对不对)、efficiency(token、延迟、成本)、stability(连续压多次会不会崩)。
这里有一个很有说服力的失败案例。OpenHands 早期做过一版生产级压缩(当时叫 compression),团队做了一个月,在 SWE-bench 这类 coding benchmark 上分数一点没掉、token 省了很多。上线后却出现了很蠢的错误——每次压缩后都重新开一个 PR,同一个功能开出五个;还会忘掉用户中途追加的指令,因为评测集全是单轮对话,而压缩恰好把中间那些 user message 压掉了。(73:18)
教训不是“压缩不好用”,而是基准的覆盖度决定了你能不能发现失败。这类单轮、任务边界清晰的 benchmark 无法暴露多轮长程、带中途约束的问题;离线评测只能筛掉明显坏的方案,真正的验证必须在真实使用里做。
11. 系统栈:五层各自解决什么
把整讲收拢,长上下文是一个五层的系统栈,每一层解决的是不同的问题。
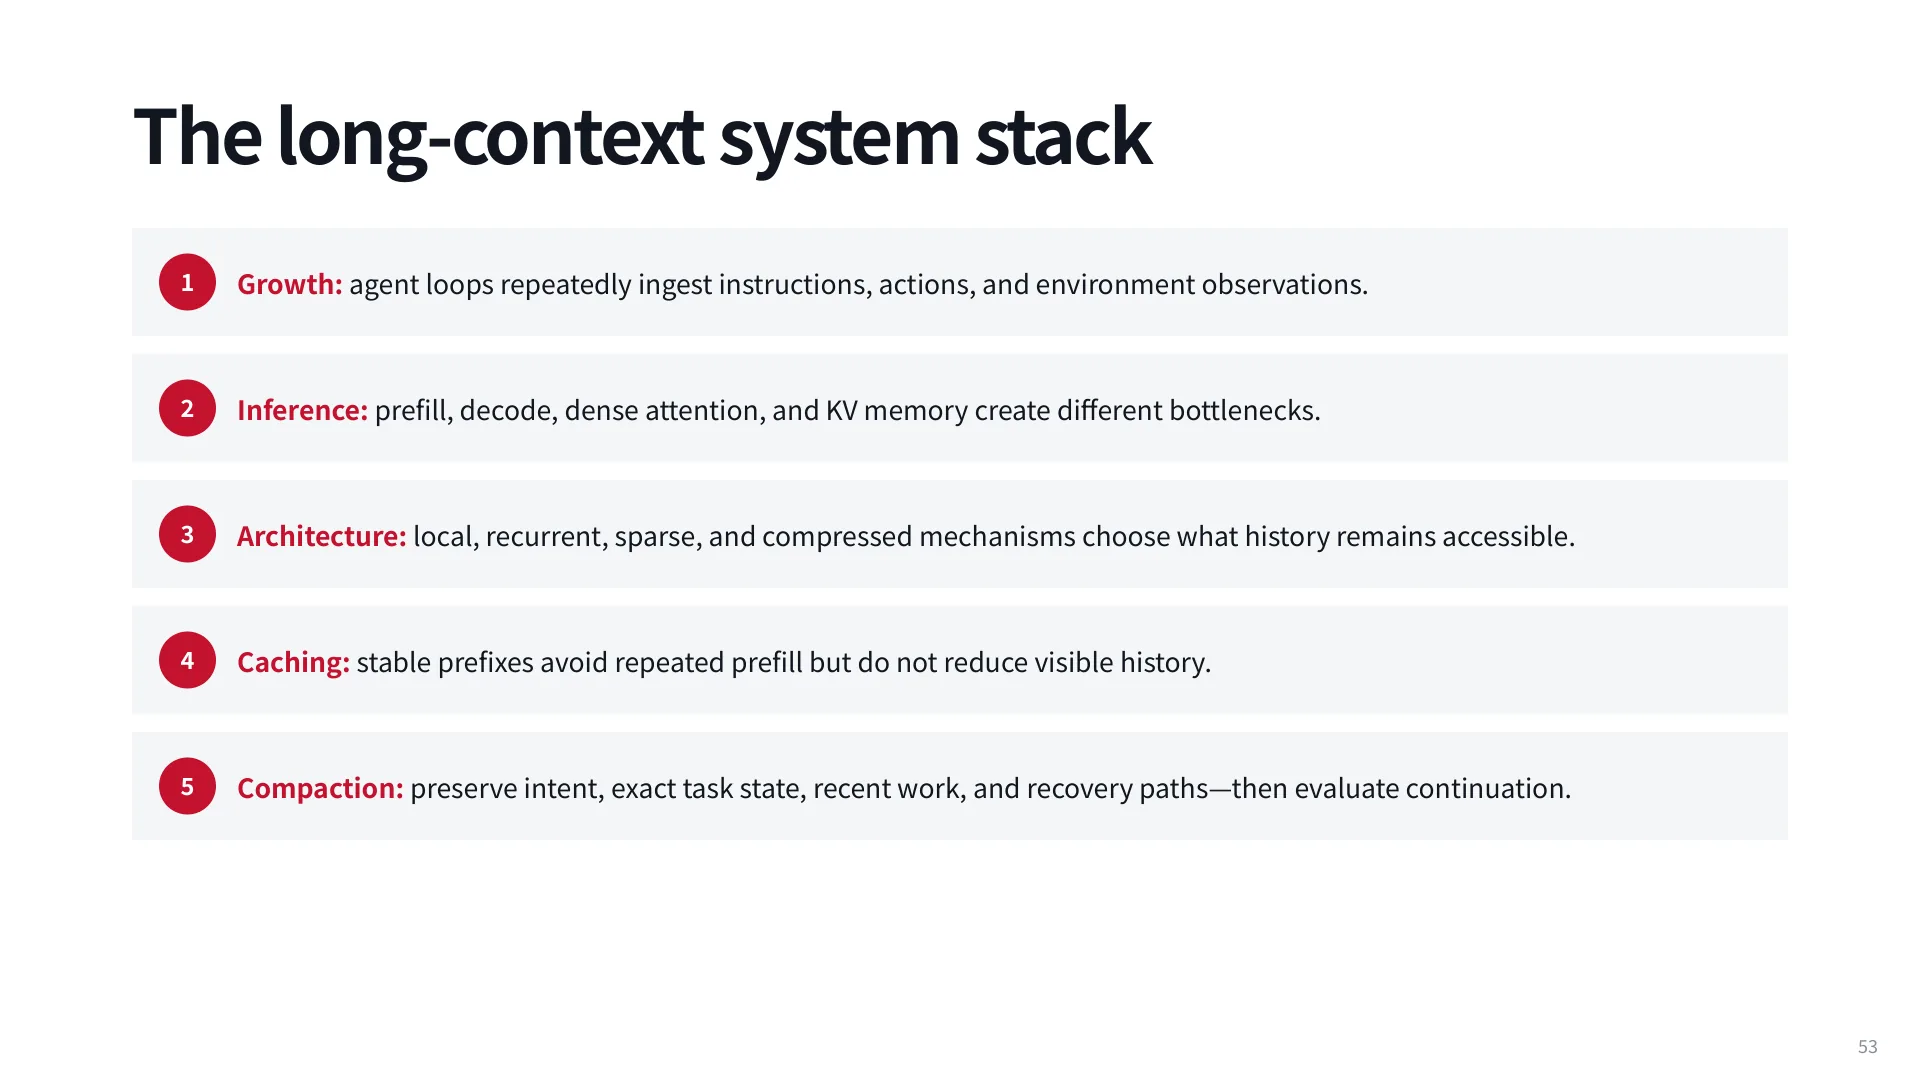
- Growth:agent 循环不断吞入指令、动作、环境观察,历史线性增长,累计计算二次增长。这一层没有“解法”,只有“认清”。
- Inference:prefill、decode、稠密注意力、KV 内存制造不同瓶颈;prefill 影响 TTFT,decode 影响 TPOT,要用不同手段优化。
- Architecture:local / recurrent / sparse / compressed 四类机制决定“哪些历史在原理上可达”,这是模型选择问题,harness 作者只能接受。
- Caching:稳定前缀避免重复 prefill,但不减少可见历史,只把每轮边际成本压到接近“新增 token”的水平。
- Compaction:当历史超出可服务范围时,保留意图、精确任务状态、近期工作和恢复路径,然后用续跑来评测。
这五层不是替代关系,而是不同预算下的不同杠杆。一个常见的误判是“有了 1M 窗口就不需要压缩了”——但容量不等于可用性(第 11 页那张热力图),而且 1M 窗口的每一步都要为 1M 的 prefill 付费(除非缓存命中)。另一个误判是“压缩能省钱”——压缩省的是可见历史,而缓存省的才是钱;如果前缀稳定,缓存已经把成本压到很低,此时压缩的主要收益是让模型不被无关信息干扰,而不是省钱。
实践顺序应当是:先把 prompt 改成“稳定前缀 + 只追加”,把缓存命中率做到 90% 以上;再裁剪工具输出(37% 的 token 在这里);最后才引入压缩,并且必须用多轮、带中途约束的评测集验证。依据是投入产出比——前两步是纯工程改动,第三步会引入不可逆的信息损失。
术语表
| 术语 | 含义 |
|---|---|
| Prefill | 一次性处理全部输入位置、生成 KV cache 的阶段;计算密集,延迟随 prompt 长度增长 |
| Decode | 每步只处理一个新位置、复用历史 KV 的自回归生成阶段;访存密集 |
| TTFT | Time To First Token,从请求到首个输出 token 的时间,主要由 prefill 决定 |
| TPOT | Time Per Output Token,相邻输出 token 的间隔,主要由 decode 决定 |
| KV cache | 缓存每层每个位置的 K、V,避免重复计算;大小随上下文线性增长 |
| PagedAttention | 把 KV cache 切成固定大小 block、用 block table 间接寻址的显存管理方式(vLLM) |
| Prompt caching | 复用跨请求的相同前缀,cached input 通常按普通输入的十分之一计价 |
| Sliding-window attention | 因果窗口掩码,只保留 个历史位置,代价 |
| Linear attention | 用双线性打分替换 softmax,把历史压成固定矩阵状态,可递推更新 |
| DeltaNet | 线性注意力 + 只写预测误差的定向修正(delta rule) |
| Gated DeltaNet | DeltaNet + 标量衰减门 , 时退化为 DeltaNet |
| KDA | Kimi Delta Attention,逐通道衰减(向量门 ) |
| Sparse attention | 只对子集做注意力:固定模式(局部 + 全局)或内容相关 TopK |
| MLA | Multi-head Latent Attention,缓存低维隐向量并按 head 重建 K、V |
| GQA / MQA | 多个 / 全部 query head 共享一组 K、V,压缩 KV cache |
| RoPE | 旋转位置编码,使内积只依赖相对位移 |
| NoPE | 不使用显式位置编码,靠因果掩码与循环动力学隐式编码顺序 |
| PI / YaRN | 位置插值(统一缩放相位)与频率选择性插值 + 温度修正 |
| Compaction | 把历史压成有预算约束的工作状态,要求未来动作分布近似不变 |
延伸阅读
- Beltagy et al., Longformer: The Long-Document Transformer, 2020 —— 滑窗 + 全局 token 的固定稀疏模式。
- Katharopoulos et al., Transformers are RNNs: Fast Autoregressive Transformers with Linear Attention, ICML 2020 —— 线性注意力的重排推导。
- Schlag et al., Linear Transformers Are Secretly Fast Weight Programmers, ICML 2021 —— delta rule 与快速权重视角。
- Yang et al., Gated Delta Networks, 2024 —— 标量衰减门如何恢复“遗忘”能力。
- Kimi Team, Kimi Linear / KDA, 2025 —— 逐通道衰减与混合层配比。
- Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models, 2023;DeepSeek-V2, 2024 —— KV 压缩的两条路线。
- Su et al., RoFormer: Enhanced Transformer with Rotary Position Embedding, Neurocomputing 2024;Kazemnejad et al., The Impact of Positional Encoding on Length Generalization, NeurIPS 2023。
- Chen et al., Extending Context Window of Large Language Models via Positional Interpolation, 2023;Peng et al., YaRN, ICLR 2024。
- Liu et al., Ring Attention with Blockwise Transformers for Near-Infinite Context, 2023 —— 上下文并行。
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023;Zheng et al., SGLang / RadixAttention, 2023。
- Gim et al., Prompt Cache: Modular Attention Reuse for Low-Latency Inference, MLSys 2024;Can I Buy Your KV Cache?, 2026 —— 前缀复用的收益边界,以及“物理成本 ≠ API 标价”。
- Zhong et al., DistServe, OSDI 2024 —— prefill/decode 分离与 TTFT/TPOT 指标。
- Packer et al., MemGPT, 2023 —— 外置记忆与检索。
- Jiang et al., LongLLMLingua, 2023 —— 选择性压缩。
- Kamradt, Needle in a Haystack, 2023 —— 有效上下文评测的起点。
自测题
1. 为什么说“累计输入 token”和“最后一轮上下文长度”是两个不同的问题?
参考答案
最后一轮上下文长度决定 capacity:模型窗口里有多少信息、能不能定位到证据。累计输入决定 efficiency:为了产出这一轮回答,系统做了多少次 prefill。设每轮新增 个 token、固定前缀为 、共 轮,则最后一轮约 ,累计约 ,比值随 线性增长。课件里 5 轮的例子是 26K 对 80K($k=5$K、$p=1$K),约 3 倍。缓存优化的是后者,压缩优化的是前者。
2. capacity 与 efficiency 各自的优化手段有哪些?为什么不能互相替代?
参考答案
capacity 靠架构(local/global 配比、稀疏选择、KV 压缩)、位置编码与长度扩展(PI、YaRN、NoPE)、训练数据与课程、有效上下文评测(needle-in-a-haystack、RULER、HELMET)。efficiency 靠注意力复杂度、KV 内存管理(PagedAttention、GQA/MLA)、前缀缓存与路由、压缩。二者不能互替:缓存降低重复计算但不减少可见历史;压缩减少可见历史但引入信息损失;架构决定原理上哪些历史可达成。
3. 混合架构里 local 层与 global 层各自的作用是什么?为什么比例收敛在 3:1 到 5:1?
参考答案
local 层(滑窗、线性注意力、Mamba)每步只做常数或 工作,负责廉价地维持状态与局部连贯;global 层(稠密或稀疏注意力)提供精确的远距离检索通道。比例收敛是因为 local 层便宜但会丢精确信息,global 层贵但是唯一能“取回原文”的路径;在给定算力预算下,多数层做 local、少数层做 global 是最优折中。课件里六个模型的比例是 3:1 到 5:1。
4. 线性注意力为什么能做到 ?它的两个主要代价是什么?
参考答案
去掉 softmax 归一化、改用双线性打分 后,求和可以重排:,历史被压成固定矩阵 ,每来一个 token 只做一次加法写入,所以是 。代价一是表达力下降——失去 softmax 的“在候选里锐利选择”能力;二是写入是纯加法,旧关联不会被擦除,产生 interference,远期异常值会持续干扰预测。
5. DeltaNet、Gated DeltaNet、KDA 分别在解决什么问题?
参考答案
DeltaNet 用预测误差做定向修正:,,,解决“写入互相干扰”。Gated DeltaNet 在修正前对整个状态做标量衰减 ,解决“旧异常值无法清除”,同时把局部性变成可学习的旋钮。KDA 把标量 换成逐通道向量并用对角矩阵 作用,解决“所有维度共享同一寿命”,让长约束和短观察各自有合适的保留时间。
6. 为什么在因果自回归模型里 NoPE 是可行的?什么情况下仍然需要位置编码?
参考答案
因为因果掩码本身破坏了对称性:位置 2 的 token 只能看前 1 个,位置 5 的能看前 4 个,从第一层起表示就不同;加入衰减或循环后,历史积累进一步编码顺序。仍然需要位置编码的是非自回归/双向注意力(token 互相可见,没有掩码差异),以及要显式外推到训练长度之外而模型又没有相对位置机制的场景。
7. 位置插值和 YaRN 的区别是什么?YaRN 的温度项为什么要小心使用?
参考答案
PI 对所有 RoPE 维度统一缩放 (等价于 ),让长位置落回预训练相位范围,代价是短距离分辨率被压缩。YaRN 按频率分别处理:长波长充分插值、短波长保留局部相位、中间平滑过渡,并加温度 抵消注意力熵漂移。 的公式是在 LLaMA 上拟合的配方而非普适常数,换模型要重新验证。
8. 为什么说“缓存几乎把重复 prefill 变成免费的,却极易被打破”?列举三种常见破坏方式。
参考答案
因为 agent 的 prompt 天然是前缀稳定、尾部追加的结构,缓存命中率可以做到 90% 以上,而 cached input 价格约为普通输入的十分之一。但缓存要求整段前缀逐字节一致,任何前缀改动都会让该位置之后全部失效。常见破坏方式:把时间戳写进 system prompt;动态改动工具列表或其顺序;每步切换模型(不同模型缓存不通用)。正确做法是把变化的内容放到最后一条 user message 或工具结果里。
9. 压缩的目标为什么不是“摘要质量”,而是“行为保真”?如何评测?
参考答案
因为压缩后的状态只需让未来动作分布近似不变:,同时 且可恢复。摘要读起来漂亮但对行为无益没有意义。评测用续跑:植入状态(约束、决策、产物)→ 用生产策略压缩 → 让 agent 继续执行 → 测 state recall、task success、efficiency 与多次压缩后的 stability。OpenHands 的教训是:单轮基准分数不掉,上线后仍会重复开 PR、忘掉中途指令。
10. 反复压缩为什么会导致漂移?怎么缓解?
参考答案
因为第 次压缩的输入是上一轮的摘要而非原始历史:,误差逐轮累积且不可逆,具体表现是约束被逐渐泛化(CUDA 12.4 → 12.x → recent),最后消失。缓解:锚点(目标、约束、ID)逐字复制;保留近期尾部;保留可检索的源证据或原始历史,使压缩成为可撤销的信息损失;同时用多次压缩的稳定性作为评测指标。