
4b · Training 1: Supervised Fine-Tuning (SFT)
本讲速览
- SFT 的本质是“把录制的轨迹编译进权重”。它不改变模型结构,只改数据格式、损失掩码和目标分布,因此工程细节(模板、掩码、打包)比算法本身更容易决定成败。
- 一条 agent 轨迹先被 chat template 渲染成一条 token 序列,再用一位掩码决定哪些 token 参与交叉熵。默认只训练 assistant 段,observation 是条件上下文而不是预测目标。
- 掩码的三个高发错误点是角色头、回合结束符和推理块。角色头在推理时由模板提供,不该学;stop token 必须学,否则模型不会停;推理块是否参与损失是一个独立开关。
- 数据选择比超参数更值钱。轨迹来源(谁跑的、是否过滤)、教师模型的选择、任务源的组合、按新任务还是按同任务扩量,都会带来比调超参数更大的差异。
- “通过测试”不等于“值得模仿”。成功的 rollout 里可能包含只读不改、编辑—测试死循环、补丁里留 print 等坏习惯,而损失会照单全收。
- 训练损失低不代表 agent 能工作。教师强制(teacher forcing)只在录制过的前缀上评分,部署时模型一旦走偏就进入训练从未访问过的状态,必须到目标 harness 里用可验证结果评测。
- SFT 是 RL 的冷启动,而不是终点。没有 SFT 的 RL 几乎推不动 base model,单独 SFT 又远达不到两者组合的水平;好的配方会故意不让 SFT 训到自己的最高分。
前几讲讨论的都是推理时的手段:把更多东西放进上下文、检索外部记忆、写更细的 prompt、设计更好的工具接口。这些手段的共同点是“模型参数不动,靠输入改变行为”。本讲换一个位置——把行为写进权重。这个位置更贵、更慢、更不透明,但它是唯一能让模型“下次不用提示就这么做”的地方。理解 SFT,实际上是在理解一件事:一条人类或强模型留下的交互记录,如何变成下一次生成的概率分布。
1. 一条轨迹,与三种更新它的方式
课程的 running example 来自 SWE-Gym:一个 agent 在沙箱里拿到一个 GitHub issue 和两件工具(bash 与文件编辑器),它要读代码、改代码、跑测试,直到仓库自带的单元测试通过。轨迹由四种角色的消息交替组成:system 放 harness 的系统提示,user 放 issue 文本,assistant 产生思考与工具调用,observation 返回命令的 stdout、diff 或测试结果。
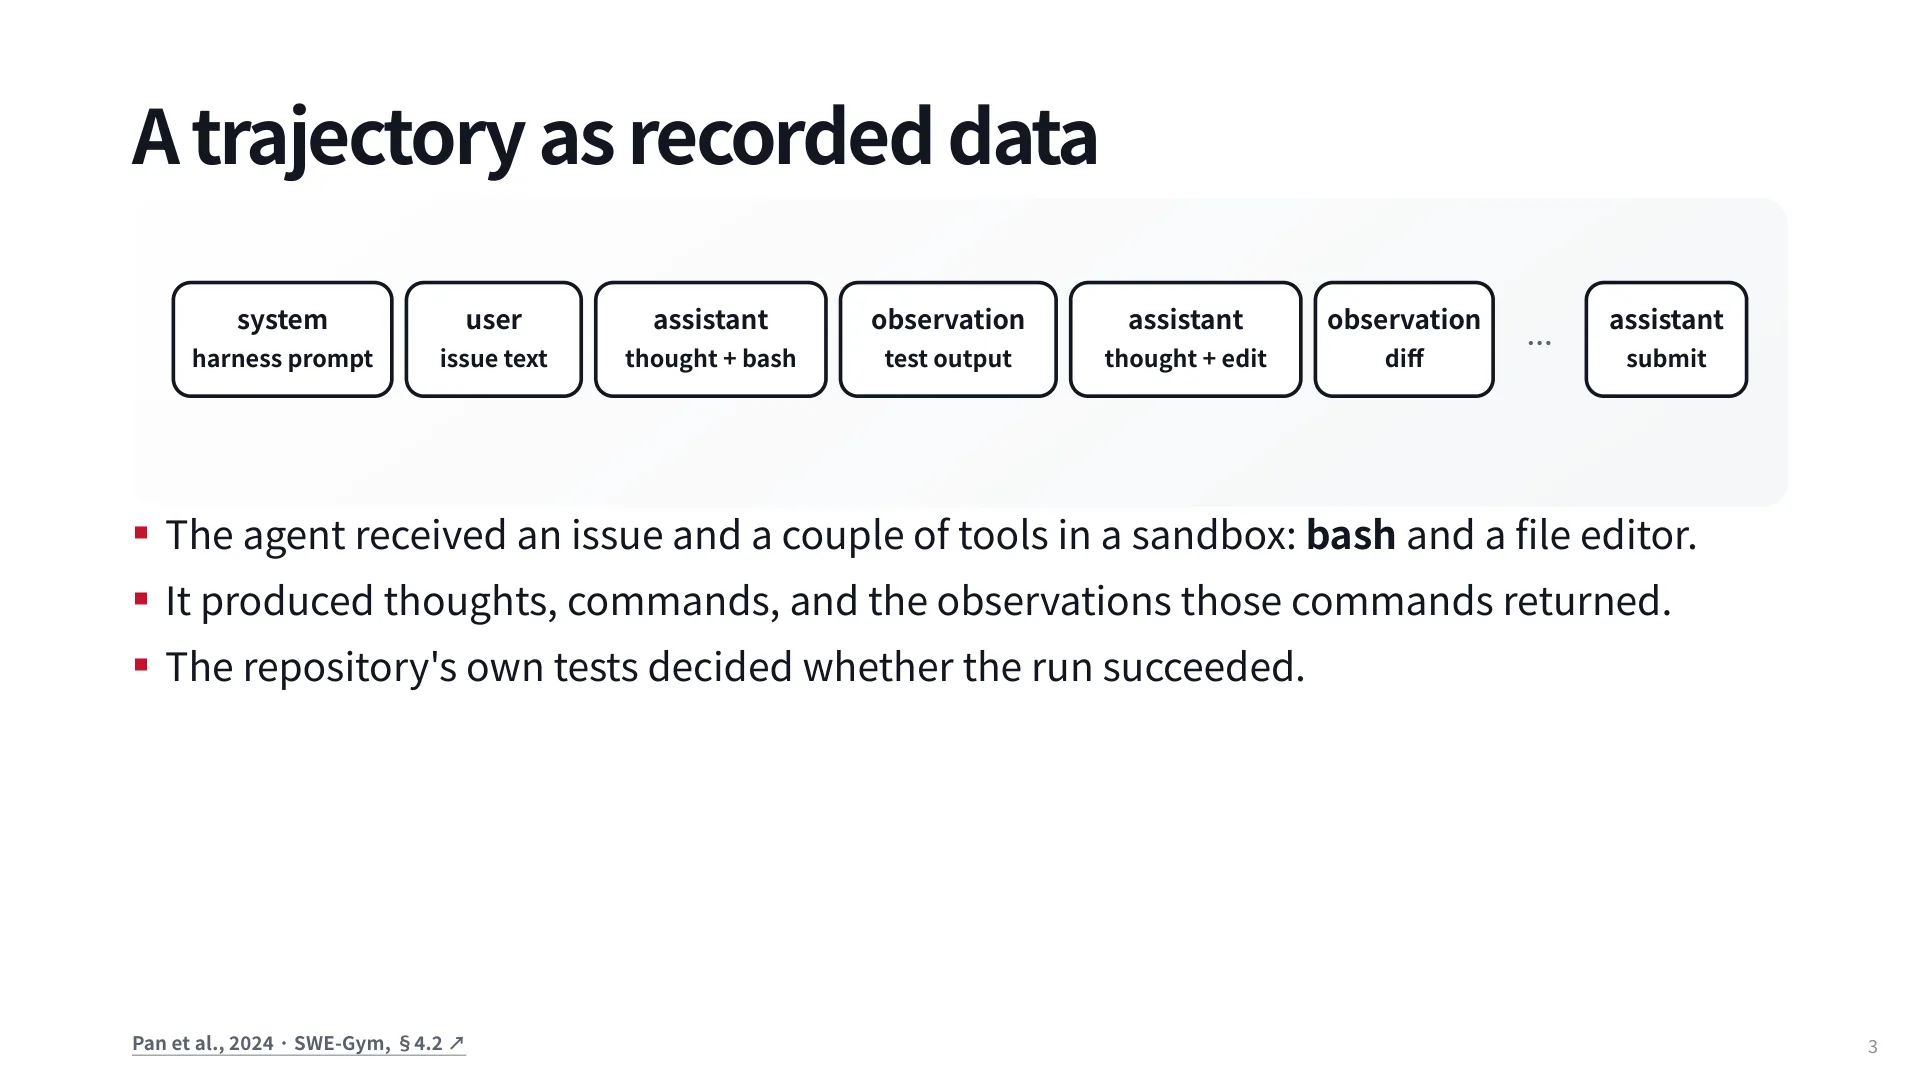
注意两件事。第一,这条样本里只有三条 assistant 消息,但真实的 agent 轨迹可以长达几十轮,长度分布是重尾的。第二,成败不是由人标注的,而是由仓库自己的测试判定的——这一点决定了后面所有数据工程的做法:只要能自动判定对错,就能低成本地批量生产监督信号。这也是 agent SFT 与聊天式指令微调最大的结构差异:后者的“好答案”要靠人写或强模型评,前者的“好轨迹”可以由环境免费验证。课程从这条样本开始,先带学生逐行读它的结构(00:53)。
在进入训练之前,先把“更新 agent”这件事放回它原本的位置。课程把可选位置分成三类(这也是前面几讲反复出现的框架):
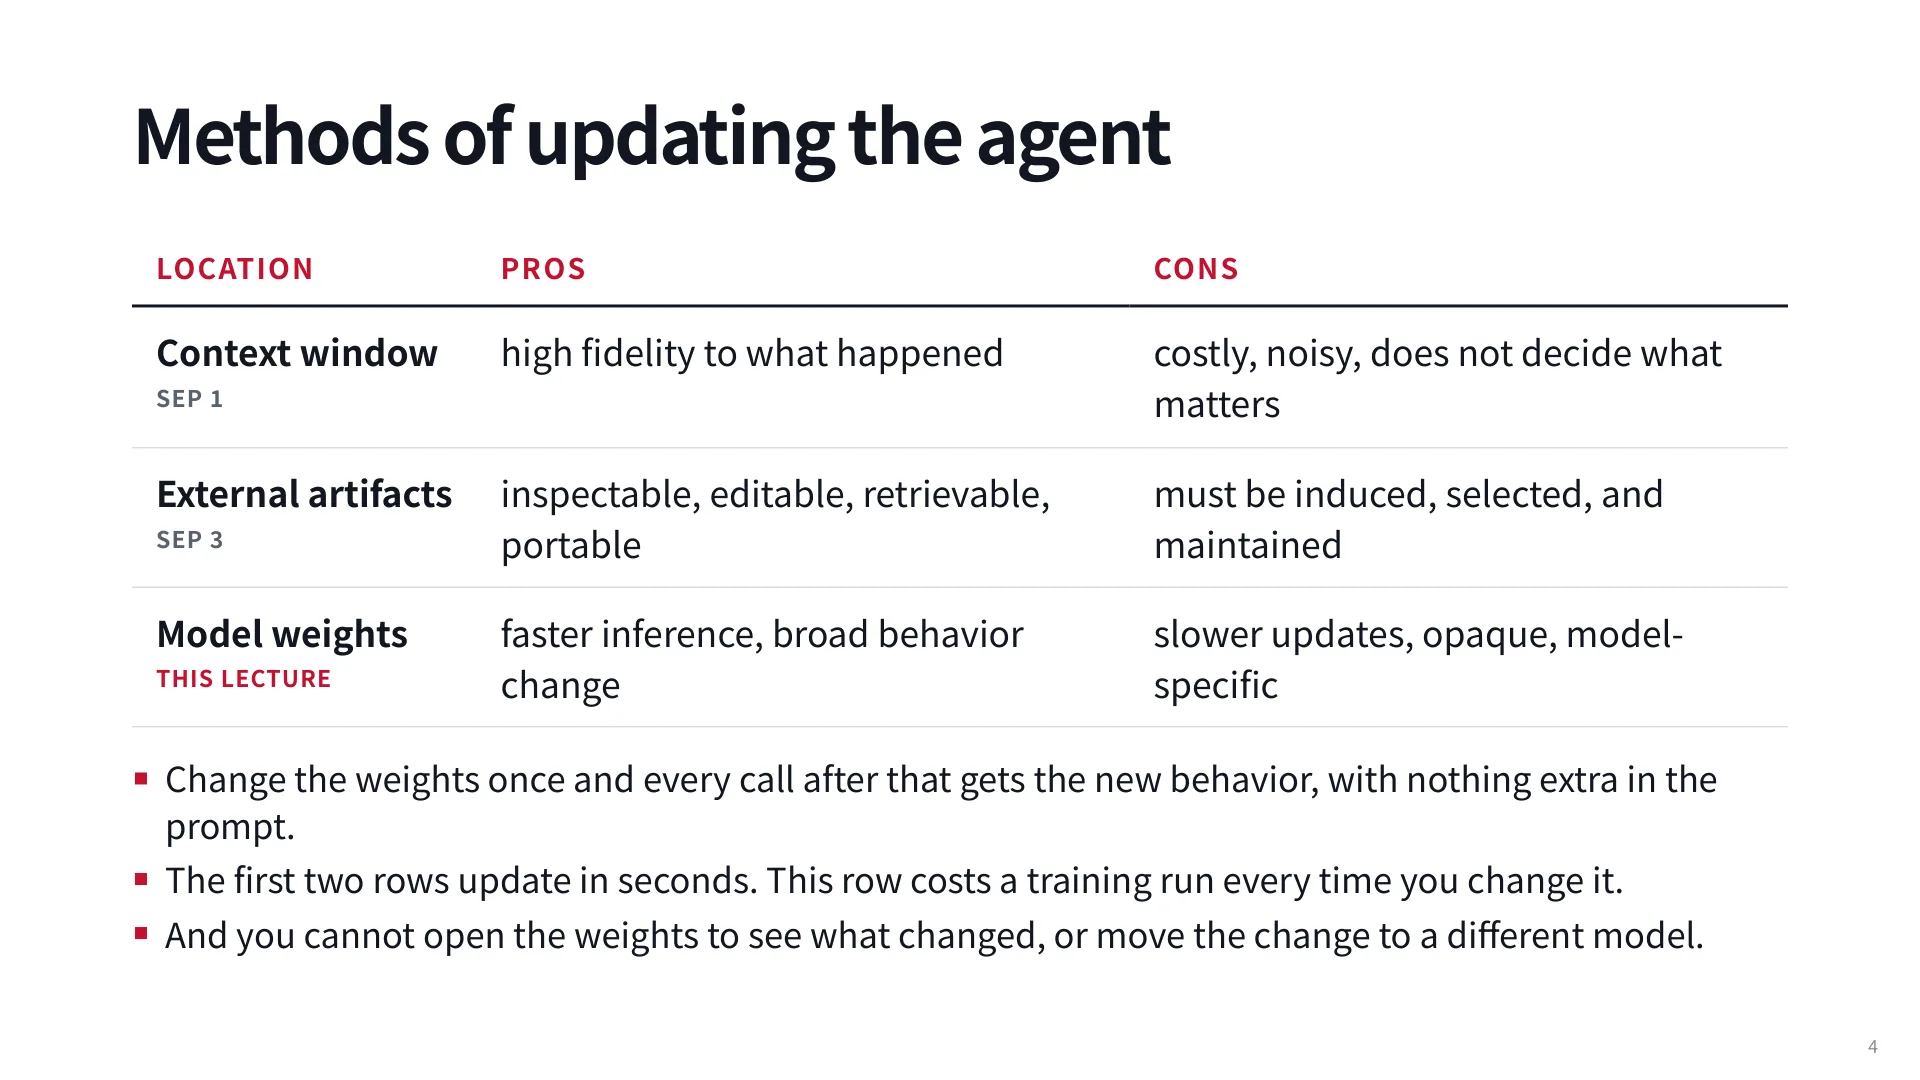
| 位置 | 优点 | 代价 |
|---|---|---|
| 上下文窗口 | 对“刚刚发生了什么”保真度最高 | 贵、噪声大,而且不决定什么重要 |
| 外部工件 | 可检查、可编辑、可检索、可移植 | 必须被归纳、选择、持续维护 |
| 模型权重 | 推理更快,行为改变的面更广 | 更新慢、不可解释、绑定到具体模型 |
这三种位置的差别不只是“快慢”,而是改变的作用域。往上下文里塞一段说明,只影响这一次调用;改一个 skill 文件,影响所有读取该文件的会话;改权重,则影响这个模型之后的所有调用,而且 prompt 里不需要多写一个字。代价也同样结构性:前两者以秒计,权重以“一次训练”计;前两者你可以打开看、可以 diff、可以搬到另一个模型上,权重不行——你只能看 loss 曲线,只能相信评测,而且换一个 base model 就得重来。
讲师提醒:选“改权重”通常不是因为它更好,而是因为前两种位置已经装不下了。当你发现同一段指令要在每个 prompt 里重复、同一套工具约定要靠 system prompt 反复提醒、同一类错误在长任务里反复出现时,才是把行为下沉到权重的时机。
2. 训练流水线中的 SFT:冷启动
把 SFT 放进完整的后训练流水线,才能理解它为什么长这样。课程给出的量级是:pre-training 约 20T tokens(Nemotron 3 Ultra 一档),mid-training 约 1.43T(K2 Horizon),SFT 约 332B(K2 Horizon),再往后是 RL——而 RL 阶段没有固定语料,只有 rollout 与 reward。
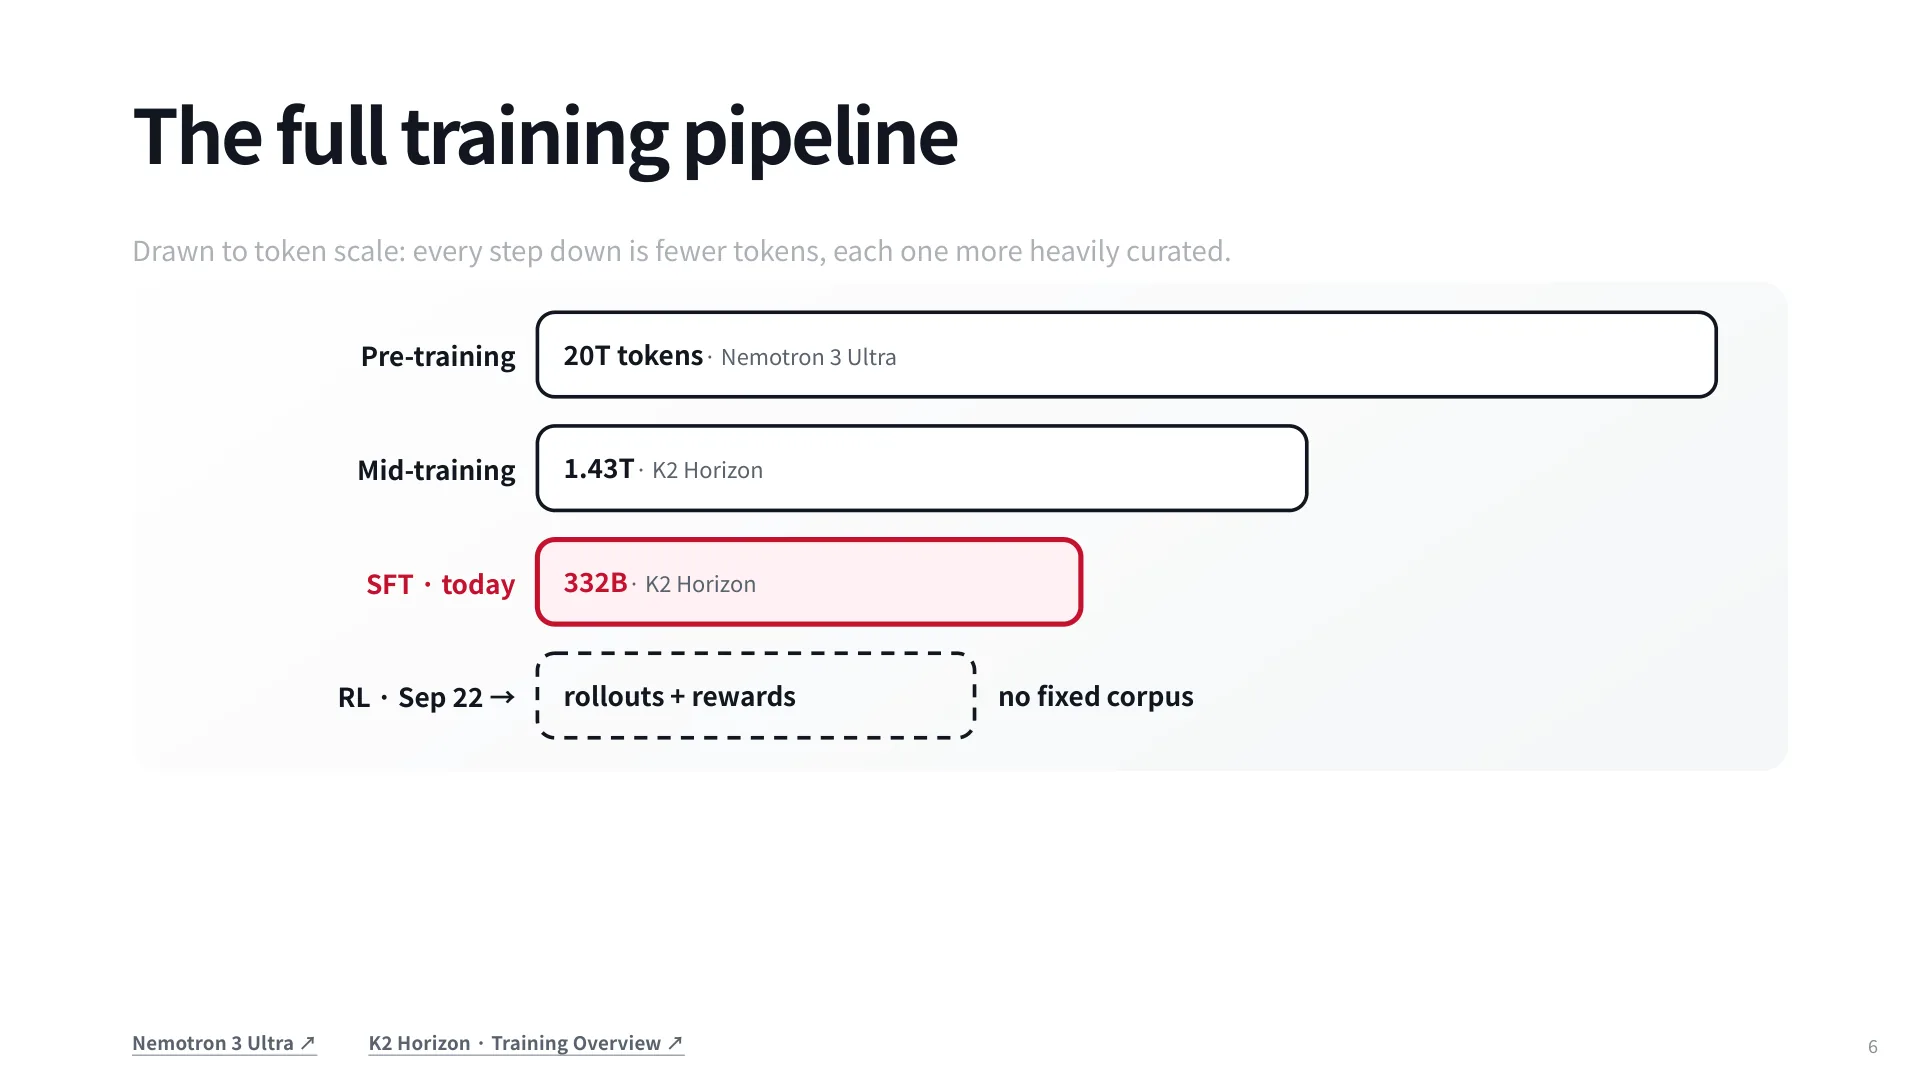
这张图的读法是“越往下 token 越少、curation 越重”。预训练学的是语言与世界知识的统计规律,mid-training 把分布往目标领域挪一点,SFT 用高质量轨迹把“会说话”变成“会按格式干活”,RL 再在可验证的任务上把能力推过教师的上限。SFT 处在承上启下的位置:它拿到的是前两阶段的能力,交出去的是一个可被 RL 继续优化的初始策略。
Kimi K3 的后训练配方把这个角色说得很直白:SFT 用来“initialize baseline agent capabilities”,RL 用来“develop domain experts at varying reasoning effort”,最后用 on-policy distillation 把多个专家合并回一个模型。SFT 阶段模型要学会的是调用工具、把长任务做完——这些都在任何 RL 之前完成。
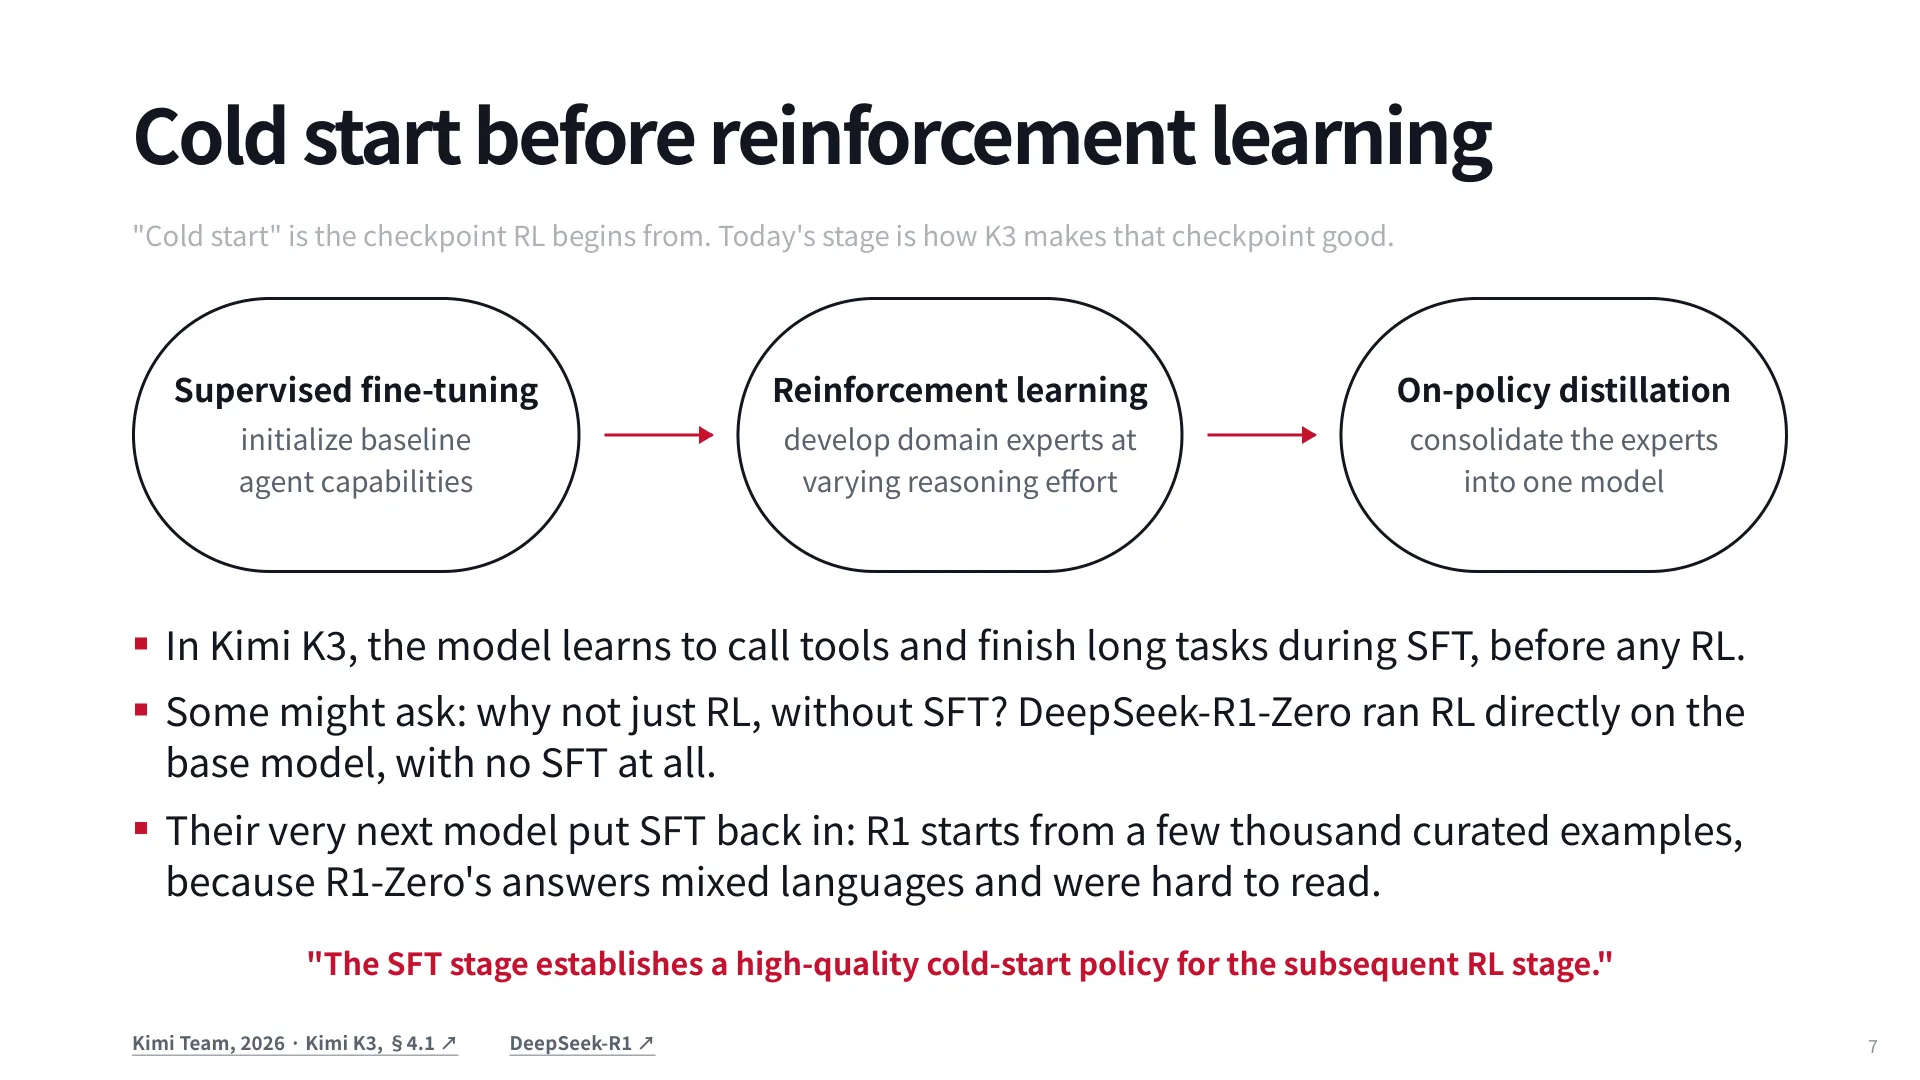
那为什么不直接上 RL?课程给了一个很有说服力的历史案例:DeepSeek-R1-Zero 确实跳过了 SFT,直接在 base model 上做 RL,结果模型会解题,但答案混用语言、格式难以阅读。紧接着的 R1 又把 SFT 加了回来,从几千条精选样例开始。这说明 SFT 的一个常被忽略的作用不是“教会任务”,而是教会可读、可解析、可评分的输出形式。RL 需要能从输出里抽出答案、能自动判分;如果模型连格式都不稳定,奖励信号本身就是噪声。
06:39 讲师把这段历史讲成一句“他们吸取了教训”。这句话的分量在于:SFT 提供的是 RL 的起点分布,而不是最终能力。起点太偏,RL 会在一个坏区域里反复采样;起点格式正确但能力保守,RL 才有空间去提升。
冷启动也有天花板。课程在问答里承认得很直接:SFT 从根本上受教师能力限制,如果你没有更强的模型可蒸馏,就只能更多依赖 RL。这也解释了为什么前沿实验室把 SFT 主要当作冷启动:它的任务是给 RL 一个不坏的开局,能力上限更多靠 RL 去推。
3. SFT 与 RL 的分工
把两者并排看,差异其实只有一句话:监督信号来自记录,还是来自自己跑出来的结果。
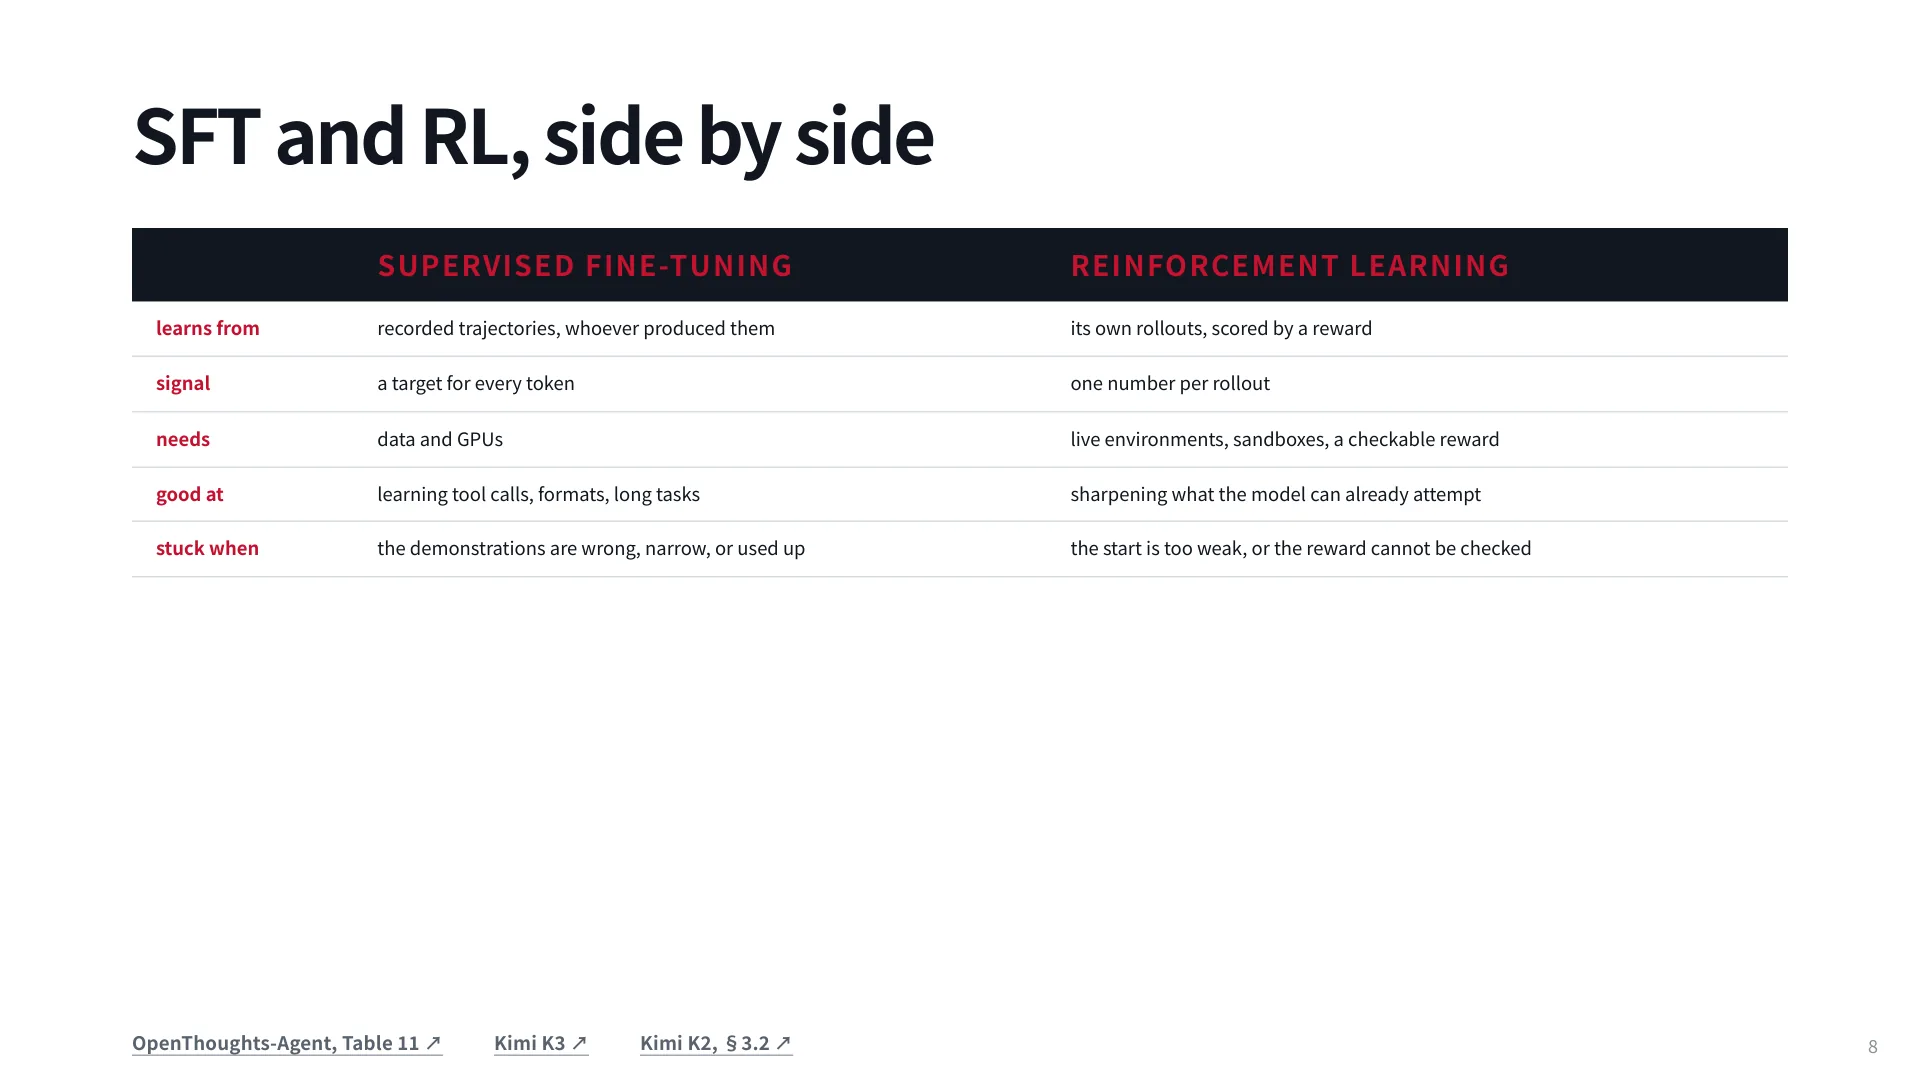
| 维度 | SFT | RL |
|---|---|---|
| 学什么 | 录制的轨迹,不论谁产生 | 自己的 rollout,由奖励打分 |
| 信号粒度 | 每个 token 一个目标 | 每条 rollout 一个数 |
| 需要什么 | 数据 + GPU | 可交互环境、沙箱、可验证的奖励 |
| 擅长 | 工具调用、格式、长任务 | 把“已经会尝试”的能力磨尖 |
| 何时失效 | 示范错误、过窄、或已被用尽 | 起点太弱,或奖励无法判定 |
“每个 token 一个目标”与“每条 rollout 一个数”这句对比值得展开。SFT 是稠密监督:轨迹里每个 assistant token 都有明确的“下一个词应该是什么”。RL 是稀疏监督:一整条几十轮的轨迹最后只得到一个标量。稠密监督学得快,但它只能教“在记录过的状态上该做什么”;稀疏监督学得慢、方差大,但它的状态分布来自模型自己,因此能纠正“模型实际会走到的那些状态”。
这也解释了两者“卡住”的方式不同。SFT 卡在数据上:示范是错的,模型就学错;示范太窄,模型就只会那一种解法;示范被用尽(同一批轨迹反复训),收益就饱和。RL 卡在环境与奖励上:起点太弱,采样不到任何成功样本,奖励全是零;奖励不可验证,模型就去钻空子。这张对照表是理解后续三讲 RL 内容的坐标系(07:28)。课程引用的 Kimi K2、Kimi K3 与 OpenThoughts-Agent 都指向同一件事:SFT 负责获得能力,RL 负责锐化能力。
还有一个常被忽略的差异是成本结构。SFT 是离线的:数据可以反复用,训练可以中断续跑,失败了大不了重来。RL 是在线的:需要活的沙箱、需要能跑起来的评测环境、需要一套不会崩的奖励管线。对整个团队来说,SFT 的边际成本主要是 GPU 时间,RL 的边际成本是工程系统。这也是为什么课程把 SFT 放在 RL 之前讲——它是那条更容易走通的路。
4. 轨迹如何变成 token 序列
模型看不见“角色”,只看见 token。所以训练的第一步是把结构化对话压平成一条字符串,这件事由 chat template 完成。
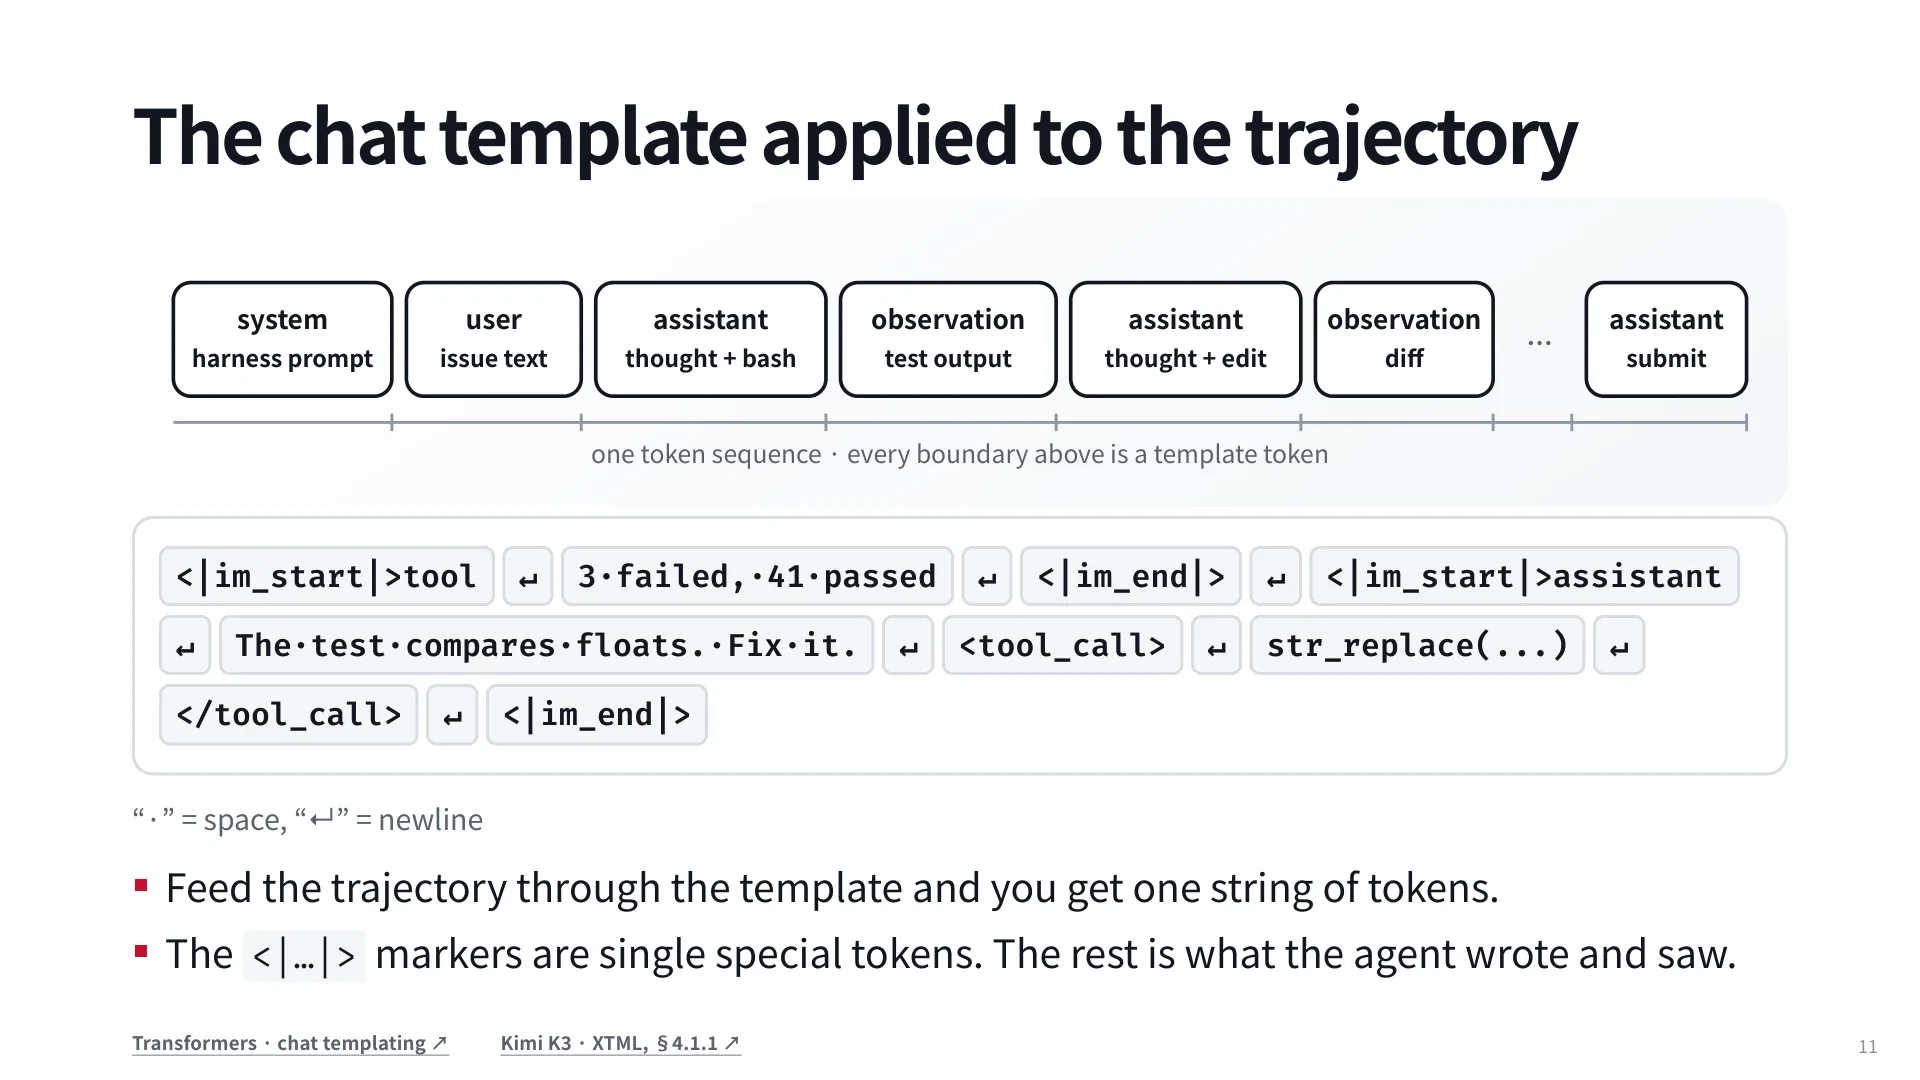
模板的输出长这样(以常见格式示意,具体 token 因模型而异):
<|im_start|>system↵You are a coding agent...<|im_end|>↵
<|im_start|>user↵The test compares floats. Fix it.<|im_end|>↵
<|im_start|>assistant↵I'll run the failing test.↵<tool_call>↵bash(cmd="pytest -q")↵</tool_call>↵<|im_end|>↵
<|im_start|>tool↵3 failed, 41 passed↵<|im_end|>↵两个细节决定了后面的一切。第一,<|im_start|>、<|im_end|>、<tool_call> 这类标记是单个 special token,不是若干普通字符拼起来的;它们在词表里有独立 ID,模型学的是“在这里切换状态”,而不是“拼出这几个字符”。第二,↵ 换行和空格都是真实 token,模板里多一个空格、少一个换行,序列就变了——正确性对空白敏感。
08:19 讲师用 Qwen 系的模板举例,并强调不同模型的模板差异很大。这不是实现细节,而是训练能否收敛的前提:如果训练时用 A 模板、推理时用 B 模板,模型看到的前缀分布就变了,它在训练中学会的“看到 <|im_start|>assistant 就该开始写”的条件反射会失效。
模板还承担了一个隐式职责:把观测和动作放进同一个注意力上下文。一条序列里,observation token 在 assistant token 之前,于是预测下一个 assistant token 时,模型可以 attend 到刚才的测试输出。这正是 agent SFT 和普通指令微调在数据层面的真正区别——不是“有多轮”,而是“轮与轮之间有环境返回的真实反馈”。
5. 损失落在哪些 token 上
有了序列,接下来要决定哪些位置参与损失。默认答案是:只有 assistant 段。
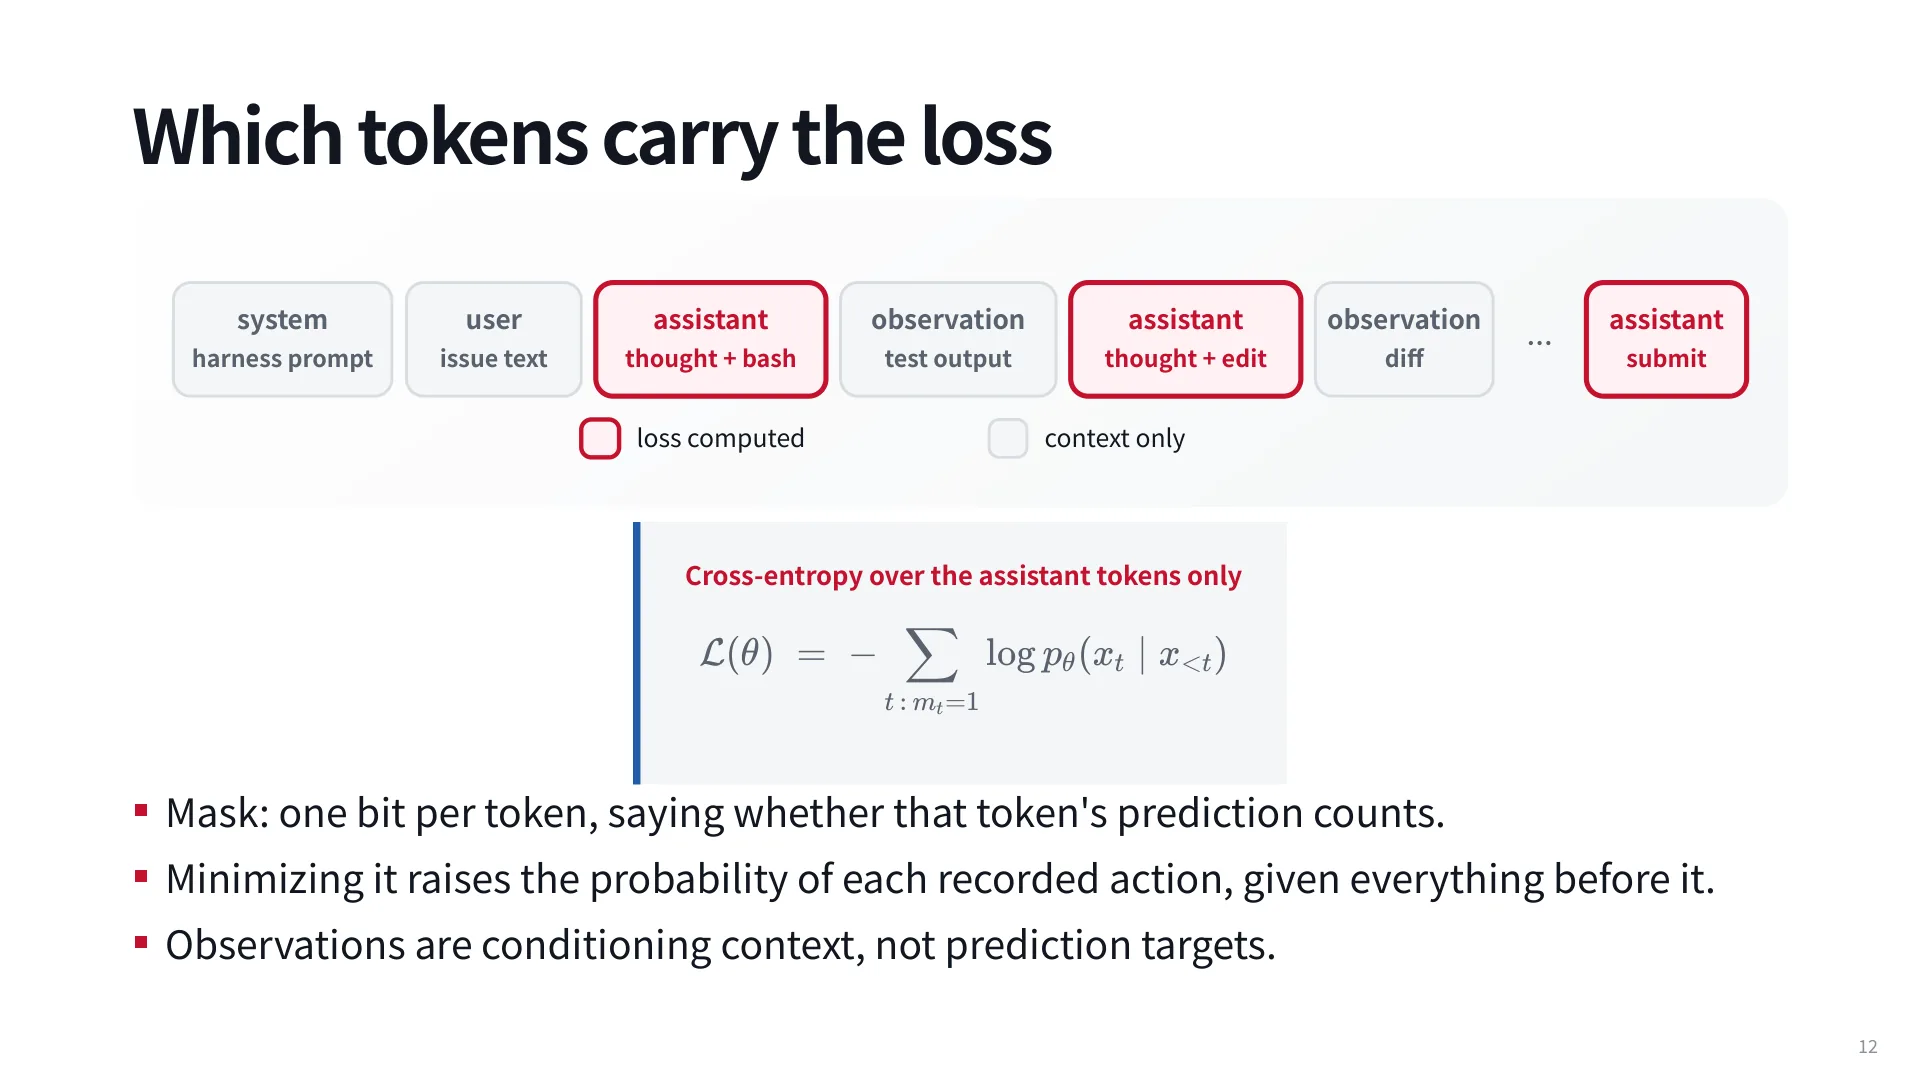
形式化地,设序列为 ,掩码 ,则
的位置是 assistant 写出的 token(包括它的工具调用、参数、结束符), 的位置是 system prompt、user issue、工具返回的观测。最小化这个损失,等价于在给定全部前文的条件下,提高每一个被记录动作的概率。它不直接优化任务成功率,只优化“像不像记录里的那个人”。
为什么默认不训练观测?因为观测是环境给的,不是模型该预测的。如果让模型去拟合“测试输出长什么样”,它学到的可能是编造工具结果——在真实部署里,这正是最危险的失败模式之一:模型不调用工具,直接写出一个看起来合理的 3 failed, 41 passed。课程在问答里补了一个例外:Meta 的 Computational World Model 一类工作确实训练模型预测工具执行结果,在“理解执行语义”相关的任务上有帮助,但这会占用模型容量,对小模型可能有害。所以“只训 assistant”是通用配方,不是不可违反的定律。
10:00 讲师把掩码描述为“每个 token 一位,表示这个 token 的预测算不算数”。这个说法很准确:训练器最终拿到的就是一条 token id 数组和一条 0/1 数组,角色信息在渲染结束后就不存在了。
掩码的构造分三步,顺序不能反:
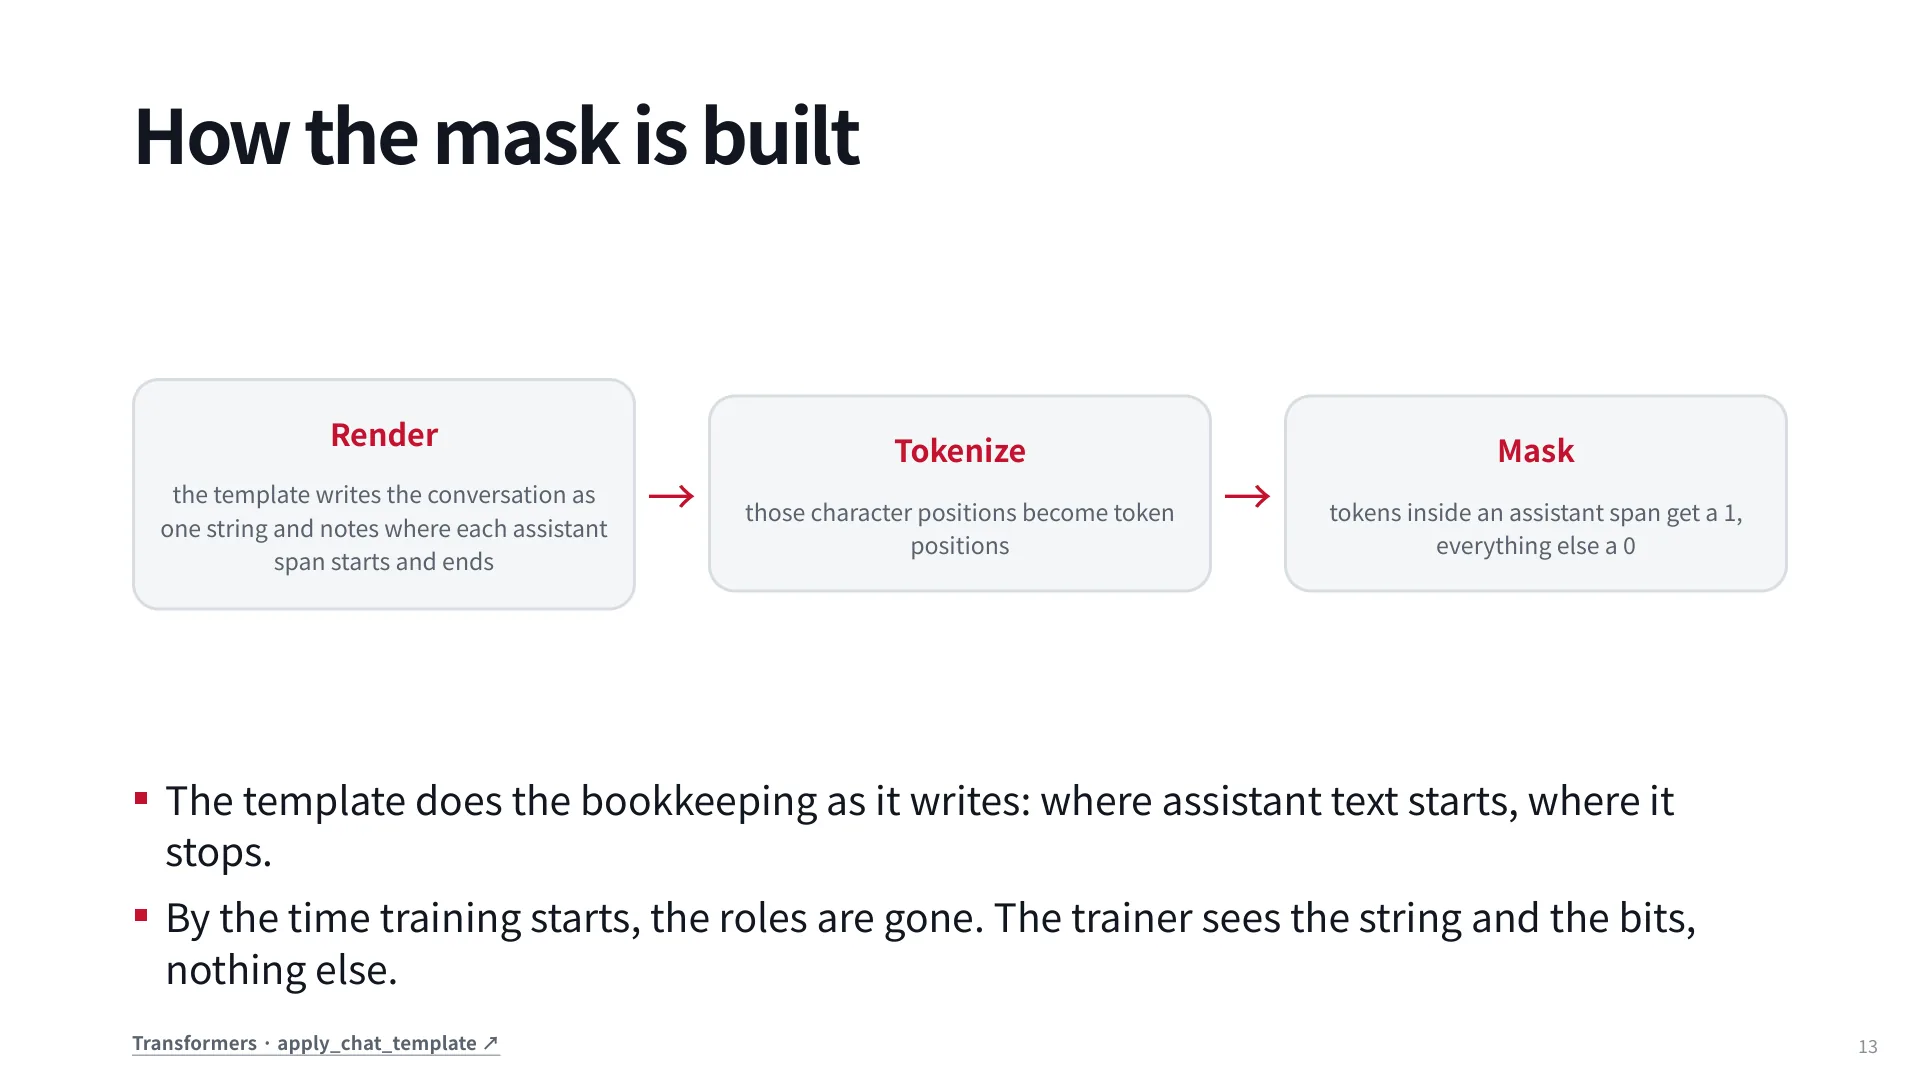
- Render:模板把对话写成一条字符串,同时记录每个 assistant span 的字符起止位置;
- Tokenize:字符位置映射为 token 位置(注意一个 token 可能跨字符边界,映射要按 tokenizer 的 offset 做);
- Mask:落在 assistant span 内的 token 置 1,其余置 0。
这套 bookkeeping 必须由模板或数据加载器完成,因为只有它们知道“这段文本是谁说的”。一旦序列化完成,角色信息就丢失了;训练器看到的是纯字符串加比特位,它无从判断哪一段该学。
不同框架把这个决定放在不同层:
| 框架 | 你需要设置 | 掩码如何产生 |
|---|---|---|
| TRL | assistant_only_loss=True | 模板在渲染时用 {% generation %} 标出 assistant span |
| Axolotl | roles_to_train、train_on_eos | 在渲染后的字符串里定位每个回合的 role header |
| LLaMA-Factory | train_on_prompt、mask_history | 在编码时把整轮标成 train-or-ignore |
三者做的是同一个决定,只是 TRL 把它放进模板,另外两个把它放进数据配置。课件备份页还给了更细的旗标语义:TRL 的 completion_only_loss 用于 prompt–completion 数据集且默认开启;Axolotl 的 roles_to_train 默认就是 ["assistant"],train_on_eos: turn 表示每个被训练回合的 EOS 也计入损失;LLaMA-Factory 的 train_on_prompt: false 是默认值,mask_history: true 则只训练最后一轮(截断时保留最后一轮)。这些默认值看似琐碎,实际上决定了“历史轮到底学不学”,而历史轮学不学,会直接改变模型在多轮场景下的行为。
讲师提醒:掩码是你唯一能告诉模型“哪些 token 值得模仿”的杠杆。它比学习率、batch size 重要得多,因为它改变的是目标函数本身,而不是优化的路径。
一个仍然开放的问题:没有人系统地做过 agent SFT 的掩码消融。课程明确指出,他们找不到“改变掩码、测量 agent 能力变化”的公开实验;做得仔细的掩码研究大多是单轮指令微调,不是 agent。唯一一个“不掩 prompt 反而更好”的案例,条件是长 prompt、短答案、数据量小——而 agent 轨迹在这三点上全部相反。作者认为在 8B 规模上这个实验很便宜,却一直没人跑。这是一个典型的“低垂果实”:问题清晰、成本可控、结论未知。
6. 掩码的细节:回合结束、推理块与配比
掩码的粗糙版本是“assistant 段全 1”,但真实实现里至少有三处需要单独判断,另有一个容易被忽略的配比陷阱。
6.1 角色头与 stop token
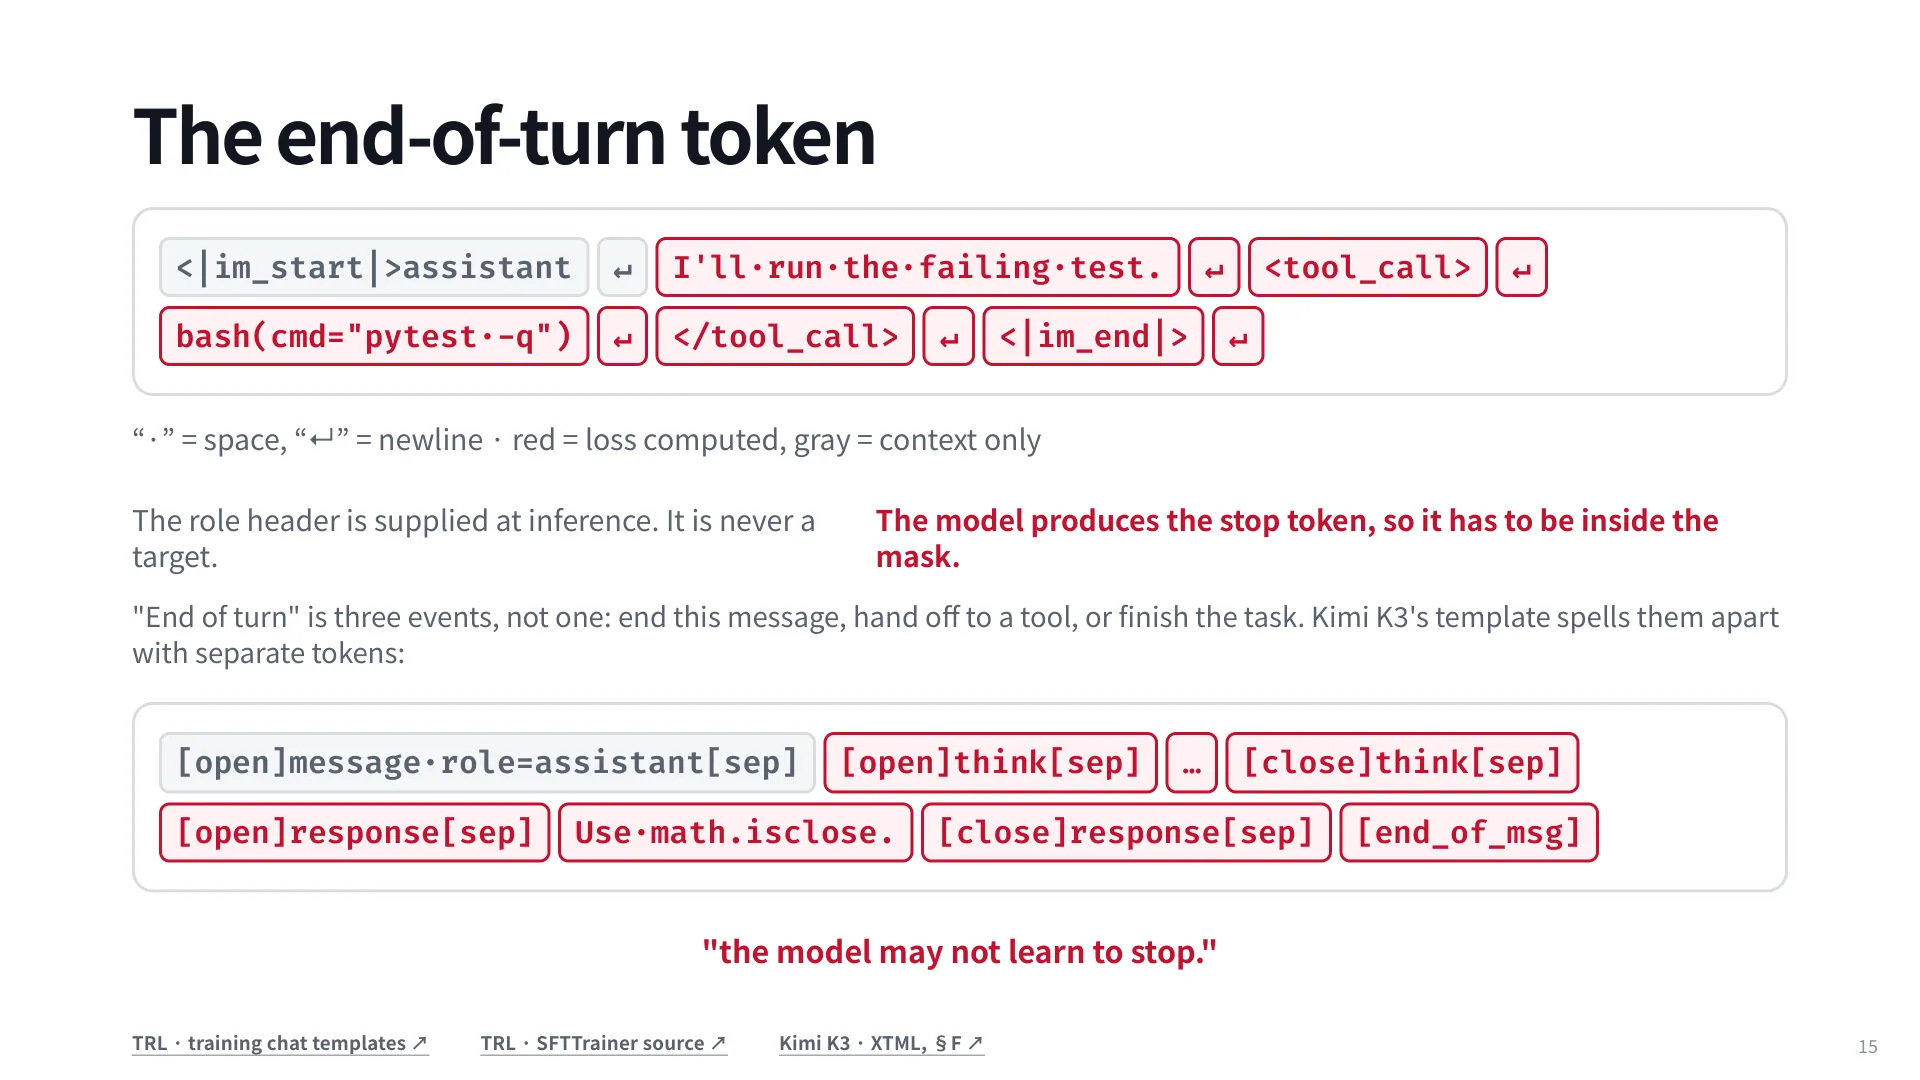
先看消息开头。<|im_start|>assistant 里的角色头在推理时是由模板供给的,模型永远不需要自己生成它;如果把它计入损失,模型学的是“预测一个已经被写好的东西”,纯属浪费容量。所以角色头应当是灰色(context only)。
再看消息结尾。<|im_end|> 是模型自己生成的,必须计入损失——否则模型学不会停。课程的原话很直接:如果 stop token 不在掩码里,“the model may not learn to stop”。这在 agent 场景里是致命的:一个不会停的 agent 会无限调用工具,直到撞上步数上限。
更细的一层是“回合结束”其实包含三种不同的事件:结束这条消息、把控制权交给工具、结束整个任务。Kimi K3 的 XTML 模板把它们拆成不同的 token([end_of_msg] 与 [close]response 等分开),目的是让模型能分别学会这三种语义。用一个 token 表示三件事,模型就只能学到一个模糊的“该停了”。
15:38 讲师特别提醒,这里是最容易搞混的地方之一:role header 不该学、stop token 必须学,两者都在同一条 assistant 消息的边界上,语义却完全相反——一个是模板写好的标签,一个是模型必须自己产出的结束信号。
6.2 推理块:两个独立开关
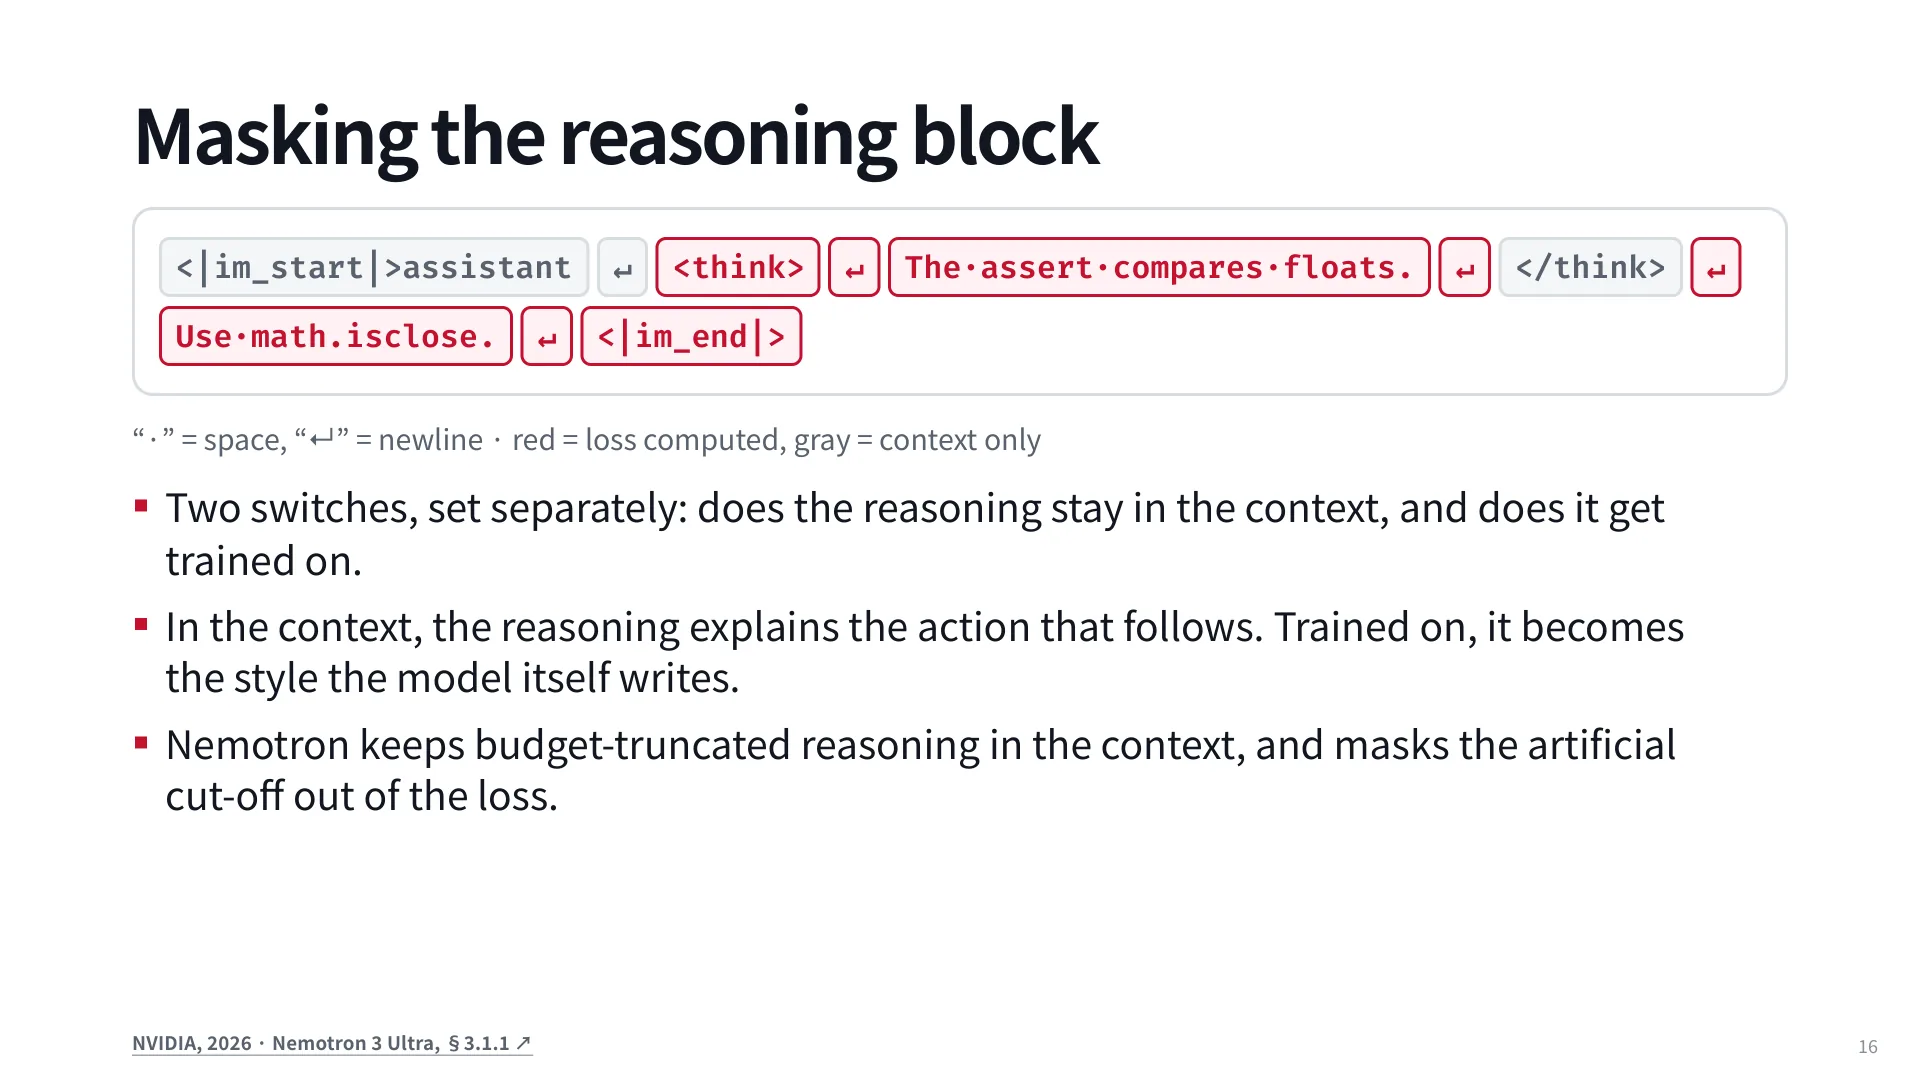
推理块(<think>...</think>)要回答两个互相独立的问题:
- 它是否留在上下文里,供后续动作条件化?
- 它是否参与损失,成为模型自己要模仿的风格?
第一个问题的答案通常是“留”。推理块解释了紧接着的动作,去掉它,模型看到的是“问题 → 突然一个编辑”,条件分布变得更难学。第二个问题的答案则因实验室而异:训练它,模型会学会自己写这种风格的推理;不训练它,模型只学动作,推理能力靠 base model 或 RL 提供。
课程举了 Nemotron 3 Ultra 的做法:把被预算截断的推理留在上下文里,但把人工截断的位置从损失里掩掉。这个细节很讲究——如果你训练模型去预测“思考到这里就被切断”,模型学到的是一种被强行打断的推理风格,而不是自然的收尾。
为什么有人选择不训练推理?因为推理块往往比动作长得多:一条轨迹里,多数 token 花在“怎么想”上,而真正决定正确性的那几行工具调用只占很小一部分。全部计入损失时,梯度几乎被“怎么想”占据,工具调用反而学不好。课程在问答里把这条讲成一句经验:长推理会主导损失。
BalanceSFT 试图用两个机制缓解这个问题:SSB 学一个权重,在损失里重新平衡推理 token 与工具调用 token;HDR 对困难样本重采样。论文报告这种重平衡在多轮任务上比单轮收益更大,且在两个 base model 上都成立。这背后的直觉是:单轮任务里推理和动作的 token 比例本来就接近,重平衡没多少可调的;多轮任务里比例失衡严重,才有调整空间。
18:53 讲师在这里给了一句判断:“reasoning and action or execution are both important”——你不希望模型把推理写得很完整,却没有真的执行下一步。
6.3 按样本配比,还是按 token 配比
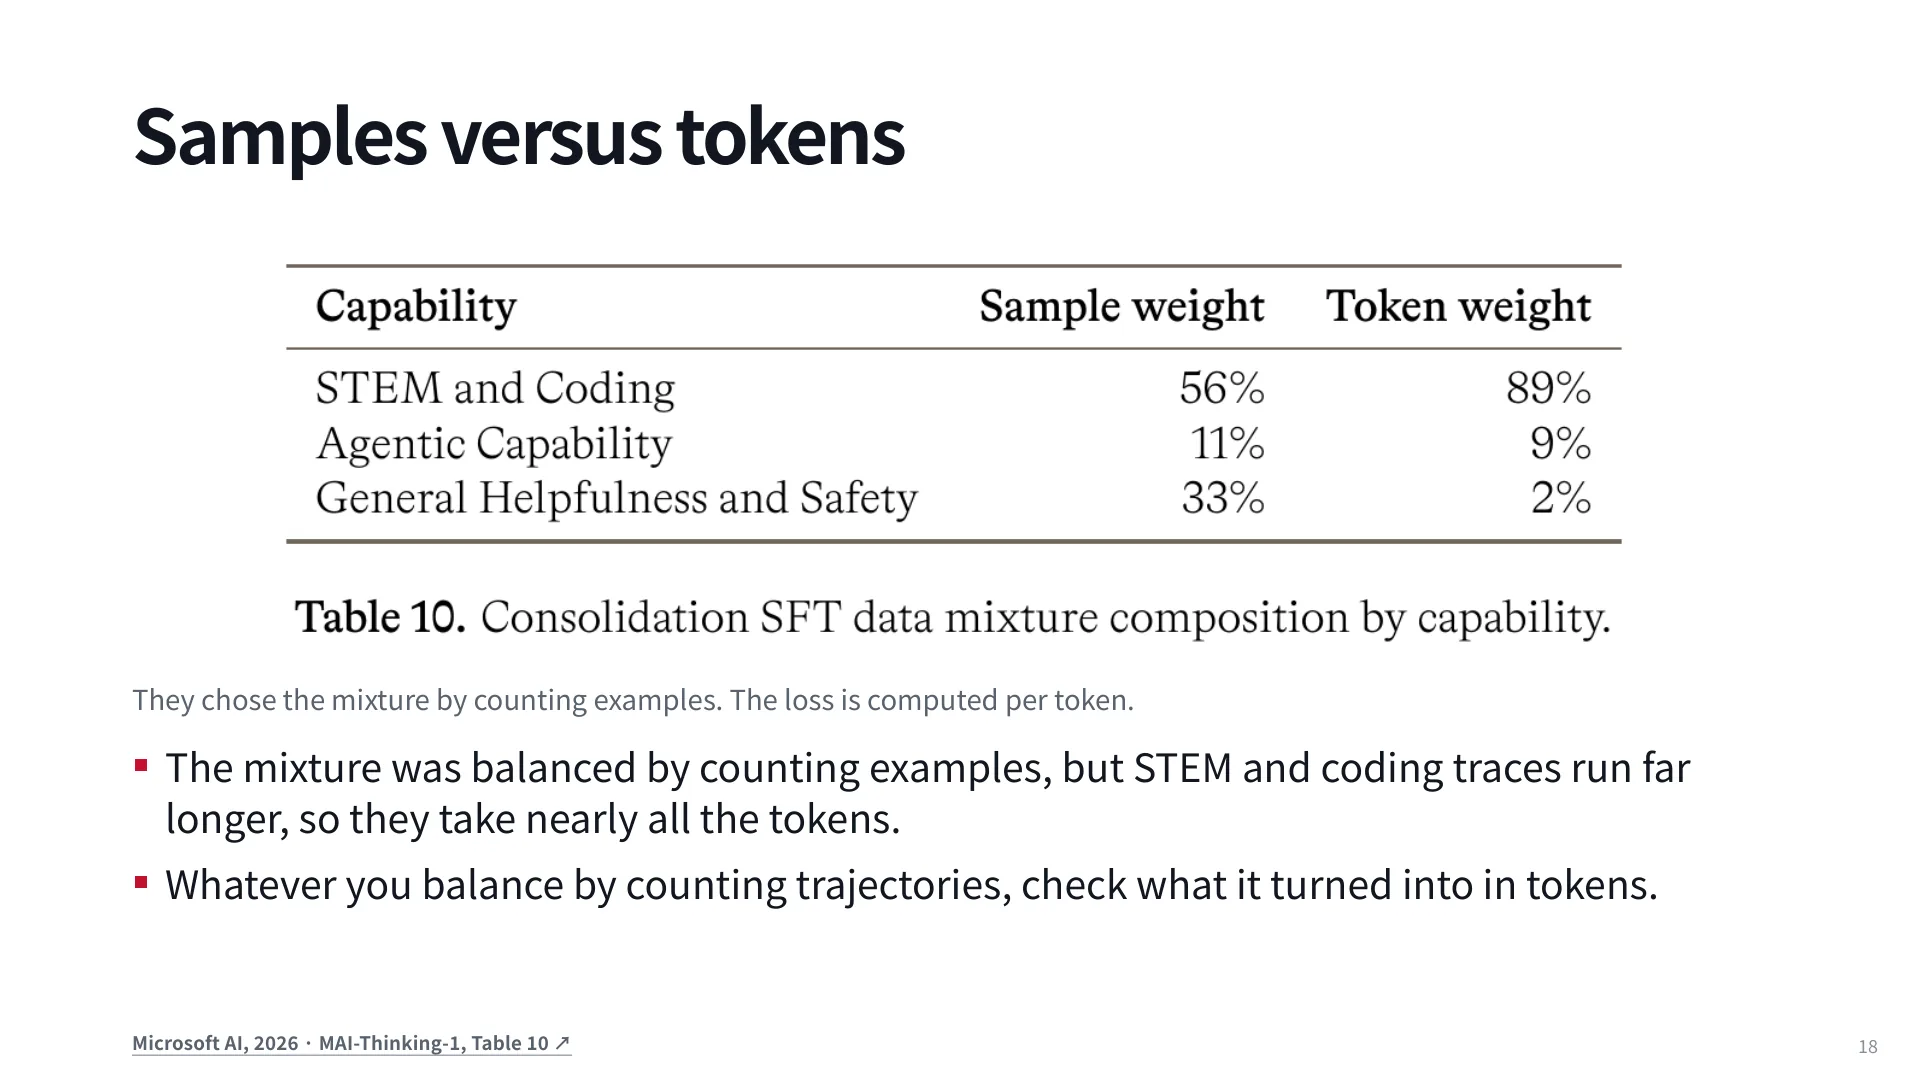
MAI-Thinking-1 的 consolidation SFT 数据配比暴露了一个很容易被忽略的陷阱。他们按能力类别分配样本比例:STEM 与 Coding 56%,Agentic Capability 11%,General Helpfulness and Safety 33%。但损失是按 token 算的,而 STEM/代码轨迹远长于通用对话,于是最终的 token 占比变成 89% / 9% / 2%。
这意味着你以为自己在训一个“均衡”的模型,实际上 89% 的梯度来自代码与数学。课程把教训总结成一句话:按轨迹数量配比之后,一定要检查它在 token 上变成了什么。这个检查很便宜(统计一下每条样本的 assistant token 数即可),但不做就会在评测时被“通用能力退化”打脸。
60:32 讲师还提到,MAI 选择 56% 这个数字本身是经验性的,不是理论推导出来的;这类配比几乎都靠小规模消融确定。
7. 选轨迹:来源、饱和、坏行为、教师
数据工程是 SFT 里回报最高的部分,也是最没有公式的部分。课程把它拆成六组问题。
7.1 轨迹从哪来
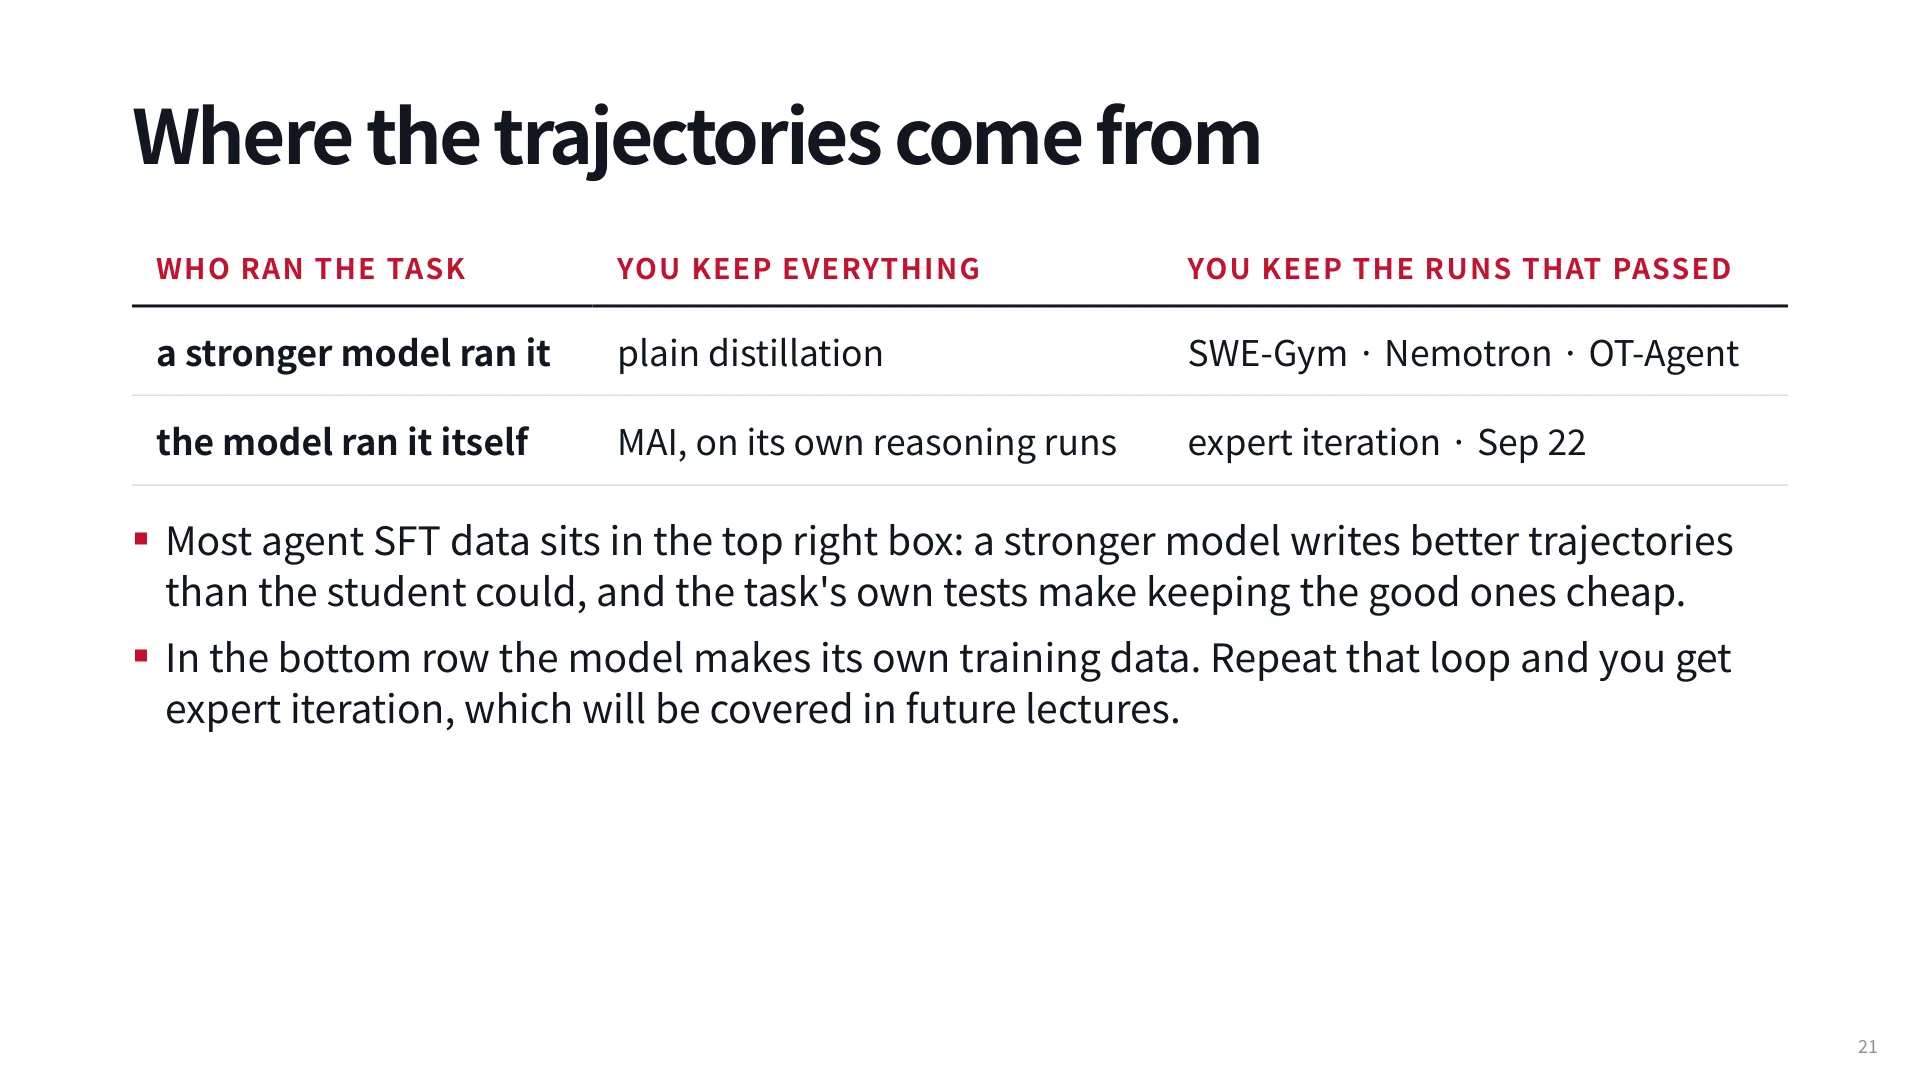
两个维度:谁执行了任务(更强的模型,还是正在训练的模型自己),以及是否只保留通过验证的运行。四个格子对应四种数据策略:
- 强模型 + 全保留 = 朴素蒸馏(plain distillation);
- 强模型 + 只留通过 = SWE-Gym、Nemotron、OpenThoughts-Agent 的主流做法;
- 自己 + 全保留 = MAI 在自己的推理轨迹上做 self-distillation;
- 自己 + 只留通过 = expert iteration,也就是后几讲会展开的自我提升循环。
大部分 agent SFT 数据落在右上格,原因很实际:强模型写的轨迹比学生自己写的好,而任务自带的测试让“筛掉坏的”几乎免费。左下格之所以存在,是因为有些能力没有更强的教师可学(课程在问答里被问到“如果没有更好的模型怎么办”,答案就是 self-distillation,或者更多依赖 RL)。
SWE-Gym 是右上格的标准案例:GPT-4o 与 Claude 跑同一批任务,491 条运行通过了仓库测试;用一个 32B 的 Qwen 只在这 491 条上做微调,SWE-Bench 两个 split 的分数都涨了 10 分以上。这个数字之所以重要,是因为它证明了少量但经过验证的轨迹可以显著改变能力,而不需要百万级数据。
7.2 轨迹数量会饱和
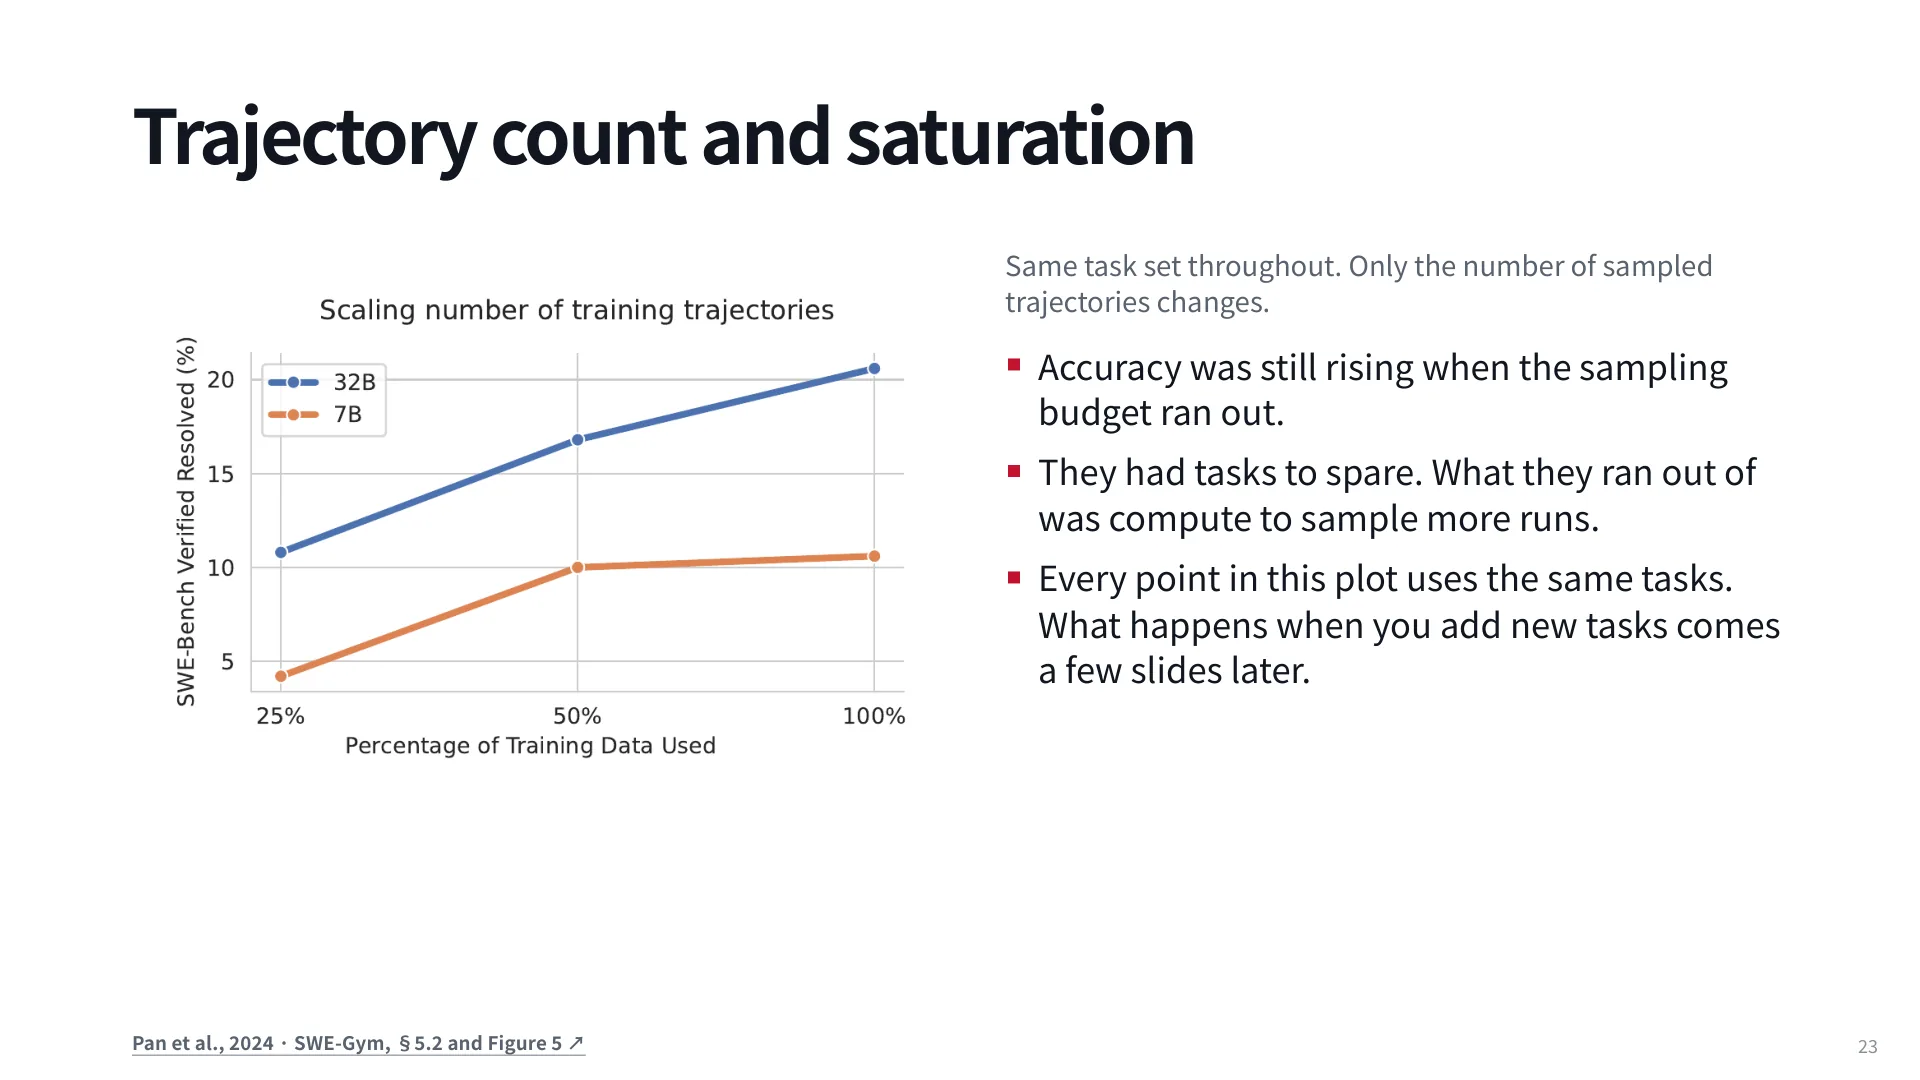
同一批任务,只增加采样轨迹数,精度会上升,但曲线在变平。SWE-Gym 的实验里,精度到预算耗尽时还在涨——他们缺的不是任务,而是采样算力。这个细节说明“饱和”有两种:数据饱和(同任务已经被榨干)与算力饱和(想采但采不动)。前者要靠新任务解决,后者要靠更多 GPU。
课程还提到一个经验规律:模型越小,越早饱和。小模型容量有限,同一分布的轨迹很快就被学完,继续加量只是重复。
7.3 通过测试的轨迹也可能是坏数据
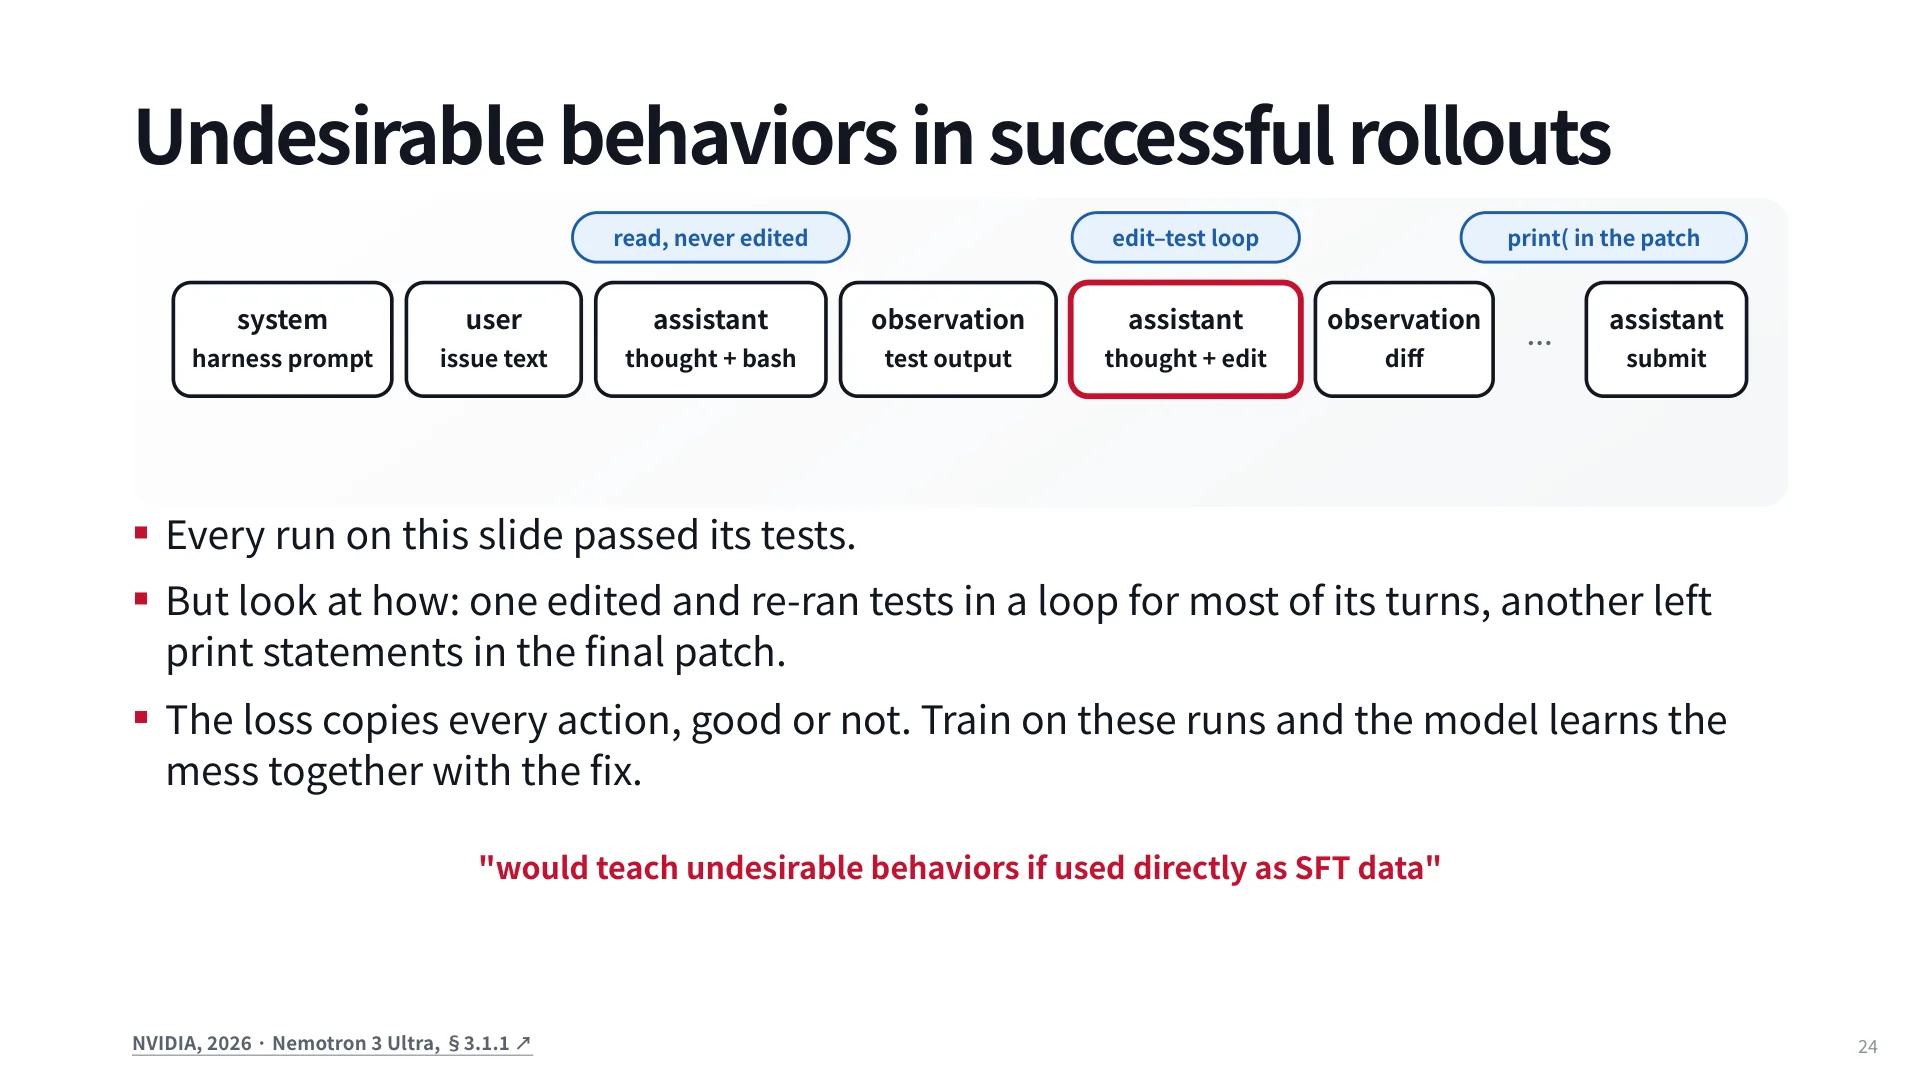
这是本讲最容易被低估的一页。三条轨迹都通过了测试,但过程各有问题:一条大部分回合都在读文件、始终没有编辑,一条大部分回合都在“改—跑测试”的循环里打转,一条在最终补丁里留下了 print( 调试语句。损失不区分“好动作”和“坏动作”,它只是提高所有被记录动作的概率。于是模型学到的是“修复 + 一堆坏习惯”的联合分布。
这类问题的麻烦在于验证器只检查结果,不检查过程。要过滤它,你需要额外的过程信号:编辑次数、读/写比例、补丁里是否含调试语句、测试通过前是否有长时间无进展的循环。这些规则都不难写,但需要有人想到去写。
7.4 按形状过滤:有效但粗糙
OpenThoughts-Agent 做过一组过滤消融,结论有点反直觉:最好的过滤器就是数回合数,把少于五轮的轨迹全部丢掉(28:44)。这个规则显然很粗——一个四轮就干净修好的轨迹会被扔掉,一个四十轮乱七八糟的轨迹会被留下。但平均而言它仍然有帮助。
原因是短轨迹的分布很杂:有的是一次就对的简单任务(学不到错误恢复),有的是模型早早放弃或环境出错(本身就是坏样本)。用长度做代理,等于用一个便宜的启发式换掉了一部分噪声。课程的态度是“它有用,但别把它当成理解”——回合数衡量的是工作量,不是质量。
7.5 教师不等于榜单第一名
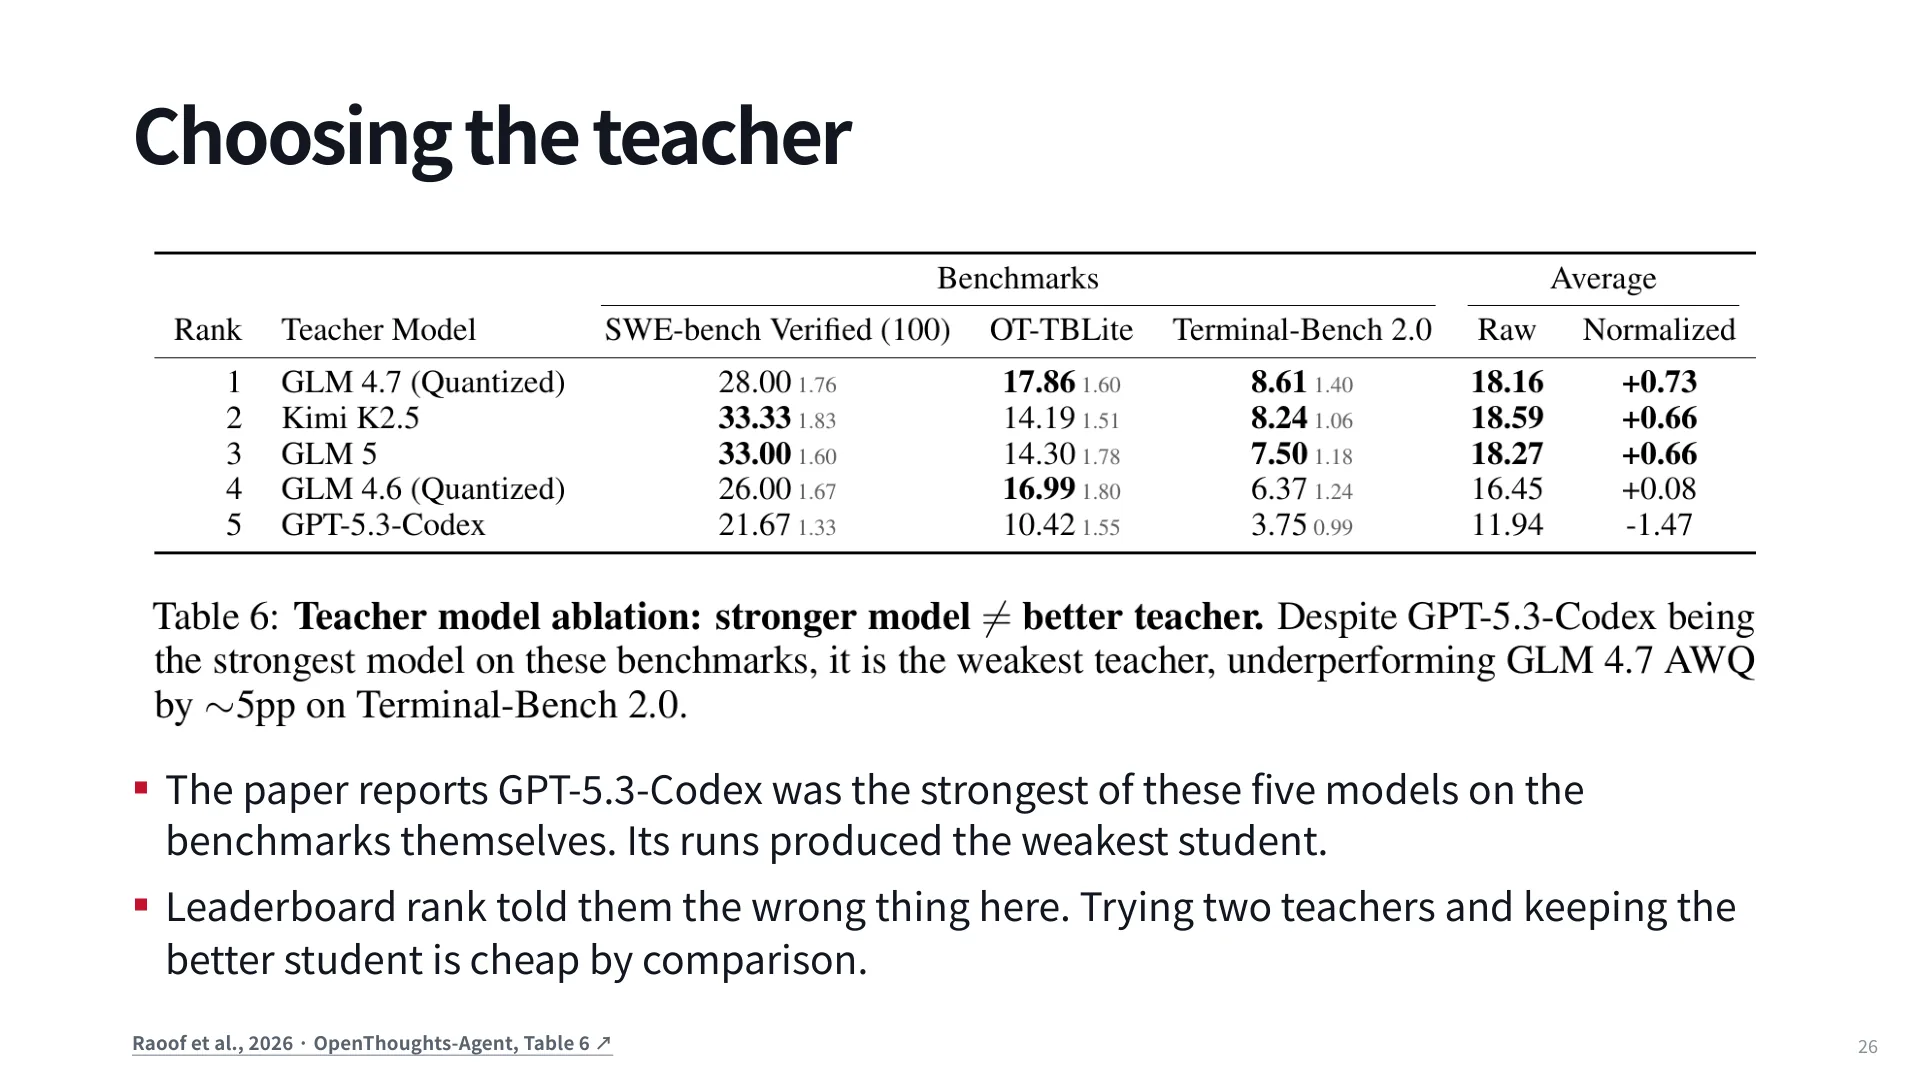
OpenThoughts-Agent 的教师消融给出了一个很值得记住的结果:五个候选教师里,GPT-5.3-Codex 在自身的基准成绩上最强,但它产出的学生最弱——平均 raw 11.94、normalized −1.47,在 Terminal-Bench 2.0 上比 GLM 4.7 (Quantized) 低约 5 个百分点。表里的 Rank 按学生成绩排,排第一的正是 GLM 4.7 (Quantized):它不是自身最强的那一个,却是最好的教师。
为什么会这样?课程的解释是教师与学生的匹配问题,这类差异可以概括为“可教性”(teachability):教师自己的解题方式、思考模式、工具使用习惯,可能与学生的容量和先验不匹配。比如一个靠极强内部推理绕过工具调用的教师,产出的轨迹对学生来说是“看不懂的示范”;一个工具使用规范、步骤清晰的教师,反而更容易被模仿。榜单衡量的是“自己能不能做对”,不是“能不能把别人教会”。
实践含义很直接:选教师要做小规模实验,而不是看排行榜。试两个教师、各训一个学生、比较下游分数,成本远低于押错教师后重训一遍。
30:22 问答里有人追问:Codex 的工具调用是对的,但对其他模型来说效率最低,这怎么解释?讲师把原因落在思考模式与解题方法上——教师的做法可能和学生的先验差得太远,轨迹本身也就不好学。
7.6 任务源与扩量方式
课程引用的消融里,任务源的选择是影响最大的单一因素——课程的建议是把精力先花在这里,再调其他东西。不同来源对不同 benchmark 的贡献不同:SWE-smith 对 SWE-bench Verified 贡献最大,但对 Terminal-Bench 贡献较小。经验结论是混合最好的四到八个来源;再宽,收益就不再增长。
扩量方式也有讲究:
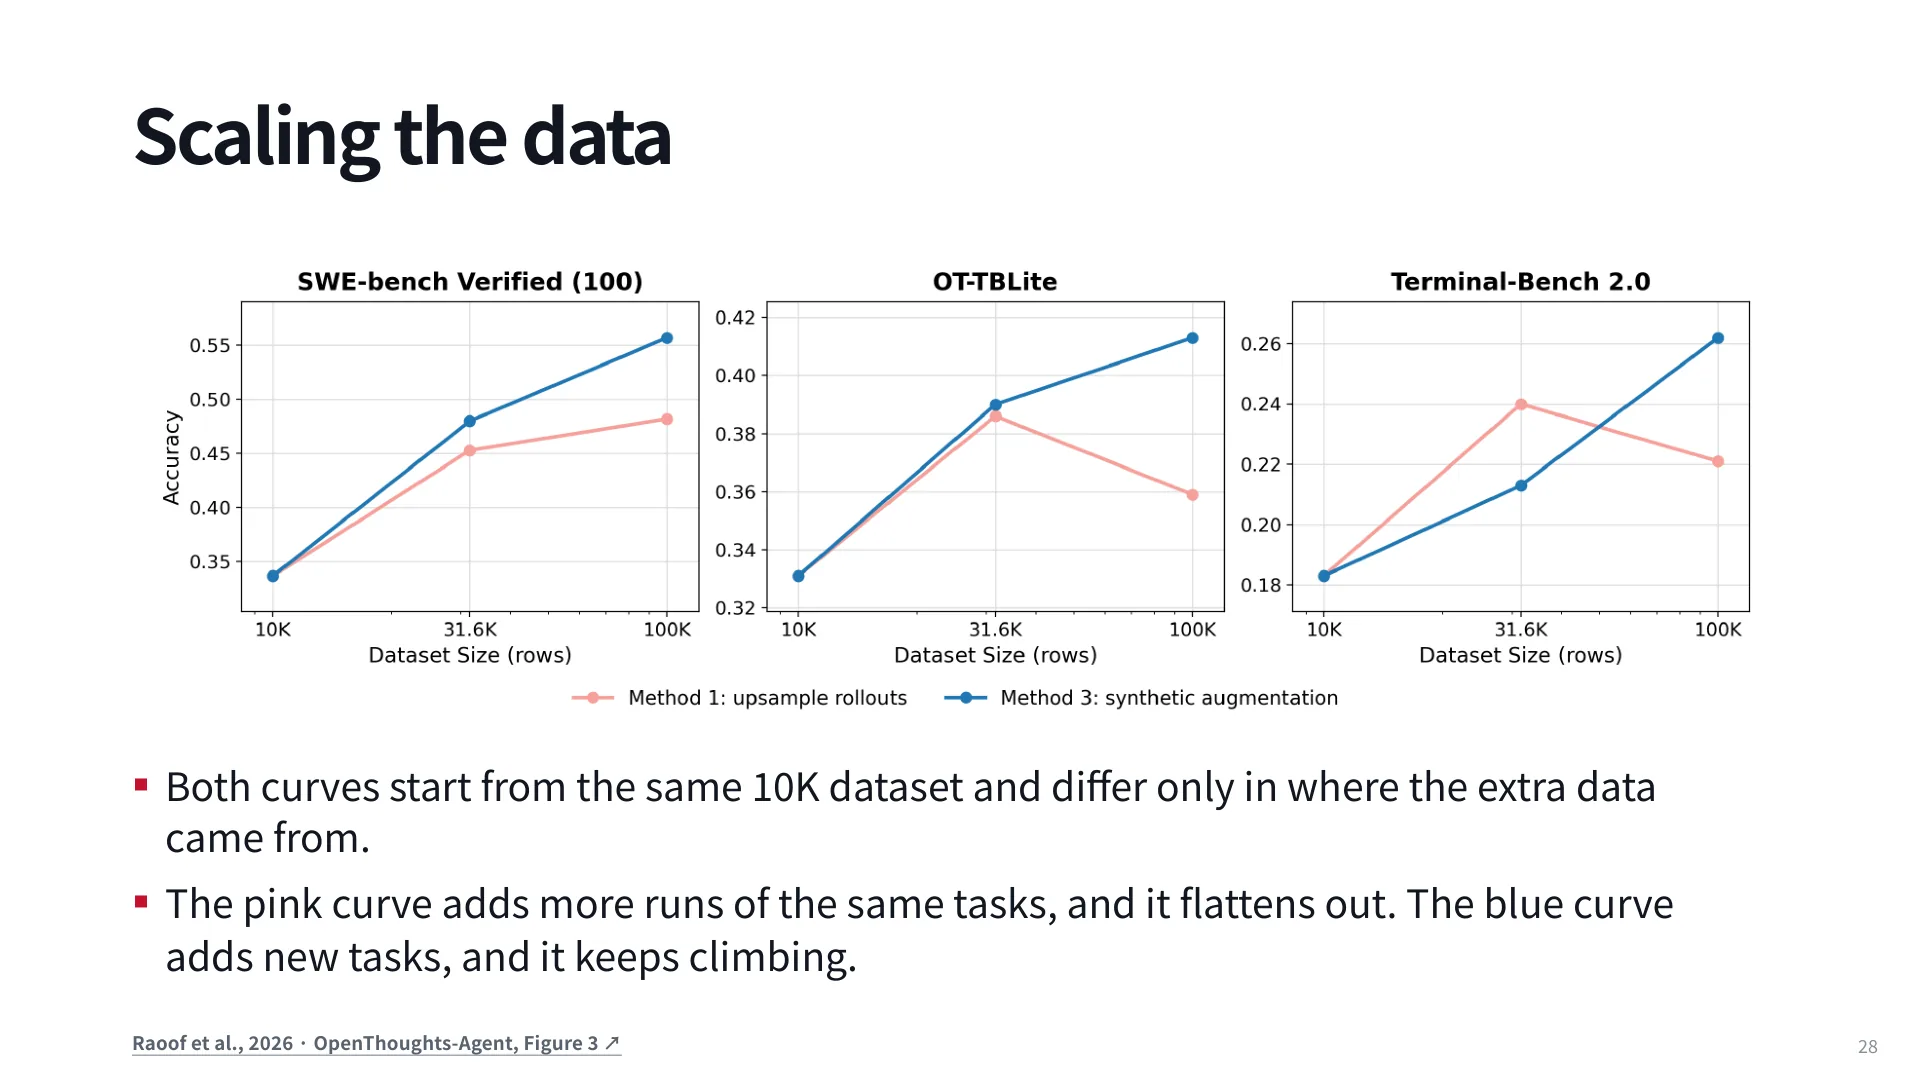
两条曲线都从同一个 10K 数据集出发,区别只在“额外数据从哪来”。粉色曲线增加同任务的更多 rollout(图例写作 upsample rollouts),很快变平;蓝色曲线增加新任务(图例写作 synthetic augmentation),持续上升。这和 6.2 的饱和现象是同一件事的两面:同一任务的边际信息量递减,新任务的边际信息量近似恒定。
课程最后留了一个讨论题,很能检验是否真的理解了上面的取舍:同一个任务回来三条轨迹——A 四轮干净修好;B 长轨迹,改错、看到测试失败、然后恢复;C 十一轮尝试但每次改动都没起作用,最后碰巧通过。留哪些?留下的那些,哪些动作该计入损失?最小回合数过滤器会错在哪?
课堂讨论的结论是 A 与 B 都要:A 教“正确的最短路径”,B 教“错误恢复”,而 C 几乎只教“无效重试”。但 B 有风险——损失会把那次错误编辑也学进去,模型可能学到“先改错再改对”的模式。最小回合数过滤器在这里恰好会做错两件事:它会扔掉 A(四轮,低于阈值),保留 C(十一轮)。这正说明形状过滤只是代理指标。
讲师提醒:讨论题没有标准答案,但有标准思考方式——先问“这条轨迹教什么能力”,再问“损失会不会把坏习惯一起教进去”,最后问“我的过滤器会不会恰好把好的筛掉”。
8. 一种格式吃下所有数据集
当你要混合多个来源时,会遇到一个非常工程化、但足以决定项目能否推进的问题:格式不兼容。
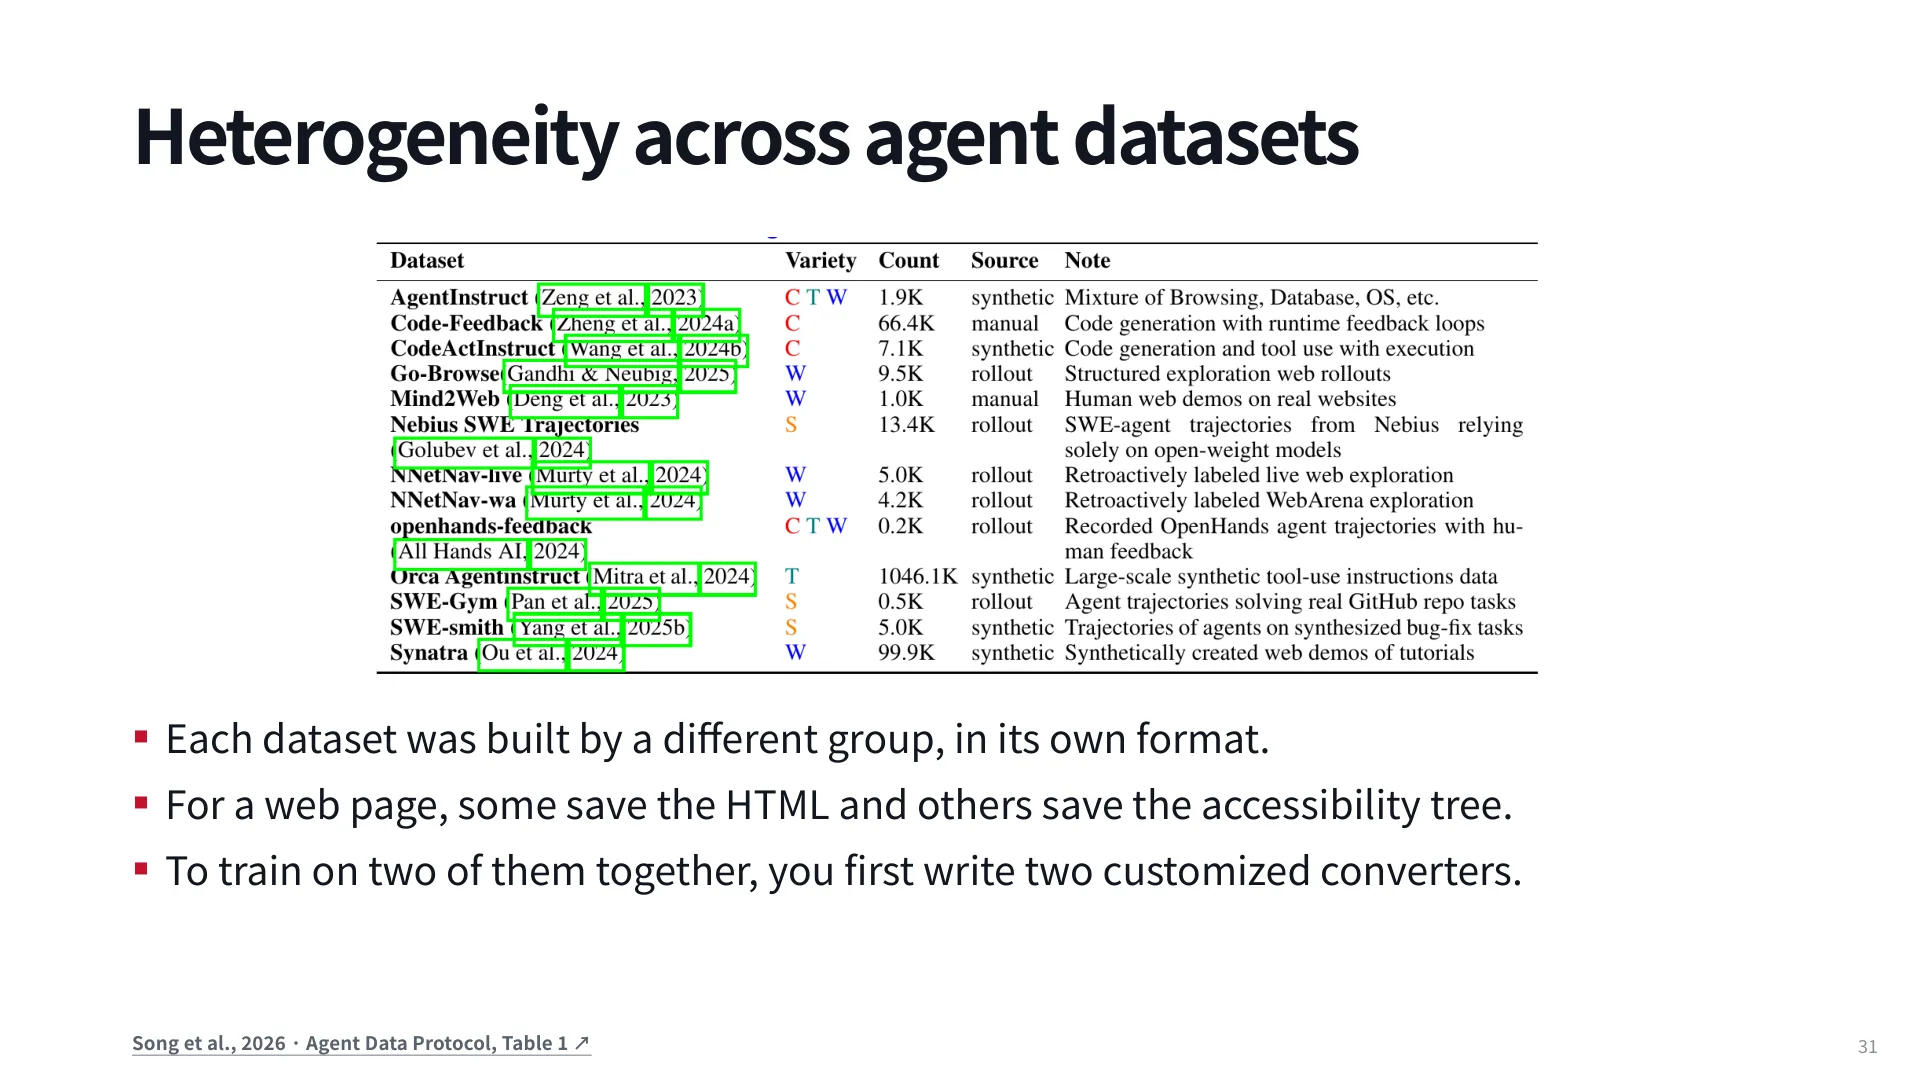
这张表里的数据集覆盖 code、terminal、web、SWE,也有跨类混合的,规模从 0.2K 到 1046.1K 不等,动作空间各不相同。同样是“网页”,Go-Browse 保存的是 accessibility tree,Mind2Web 保存的是 HTML;同样是“工具调用”,字段名、嵌套结构、观测表示都不一样。
朴素做法是给每一对(数据集,harness)写一个转换器。如果有 个数据集、 个 harness,就要写 个转换器,而且每加一个数据集或换一个 harness 都要重写一遍。
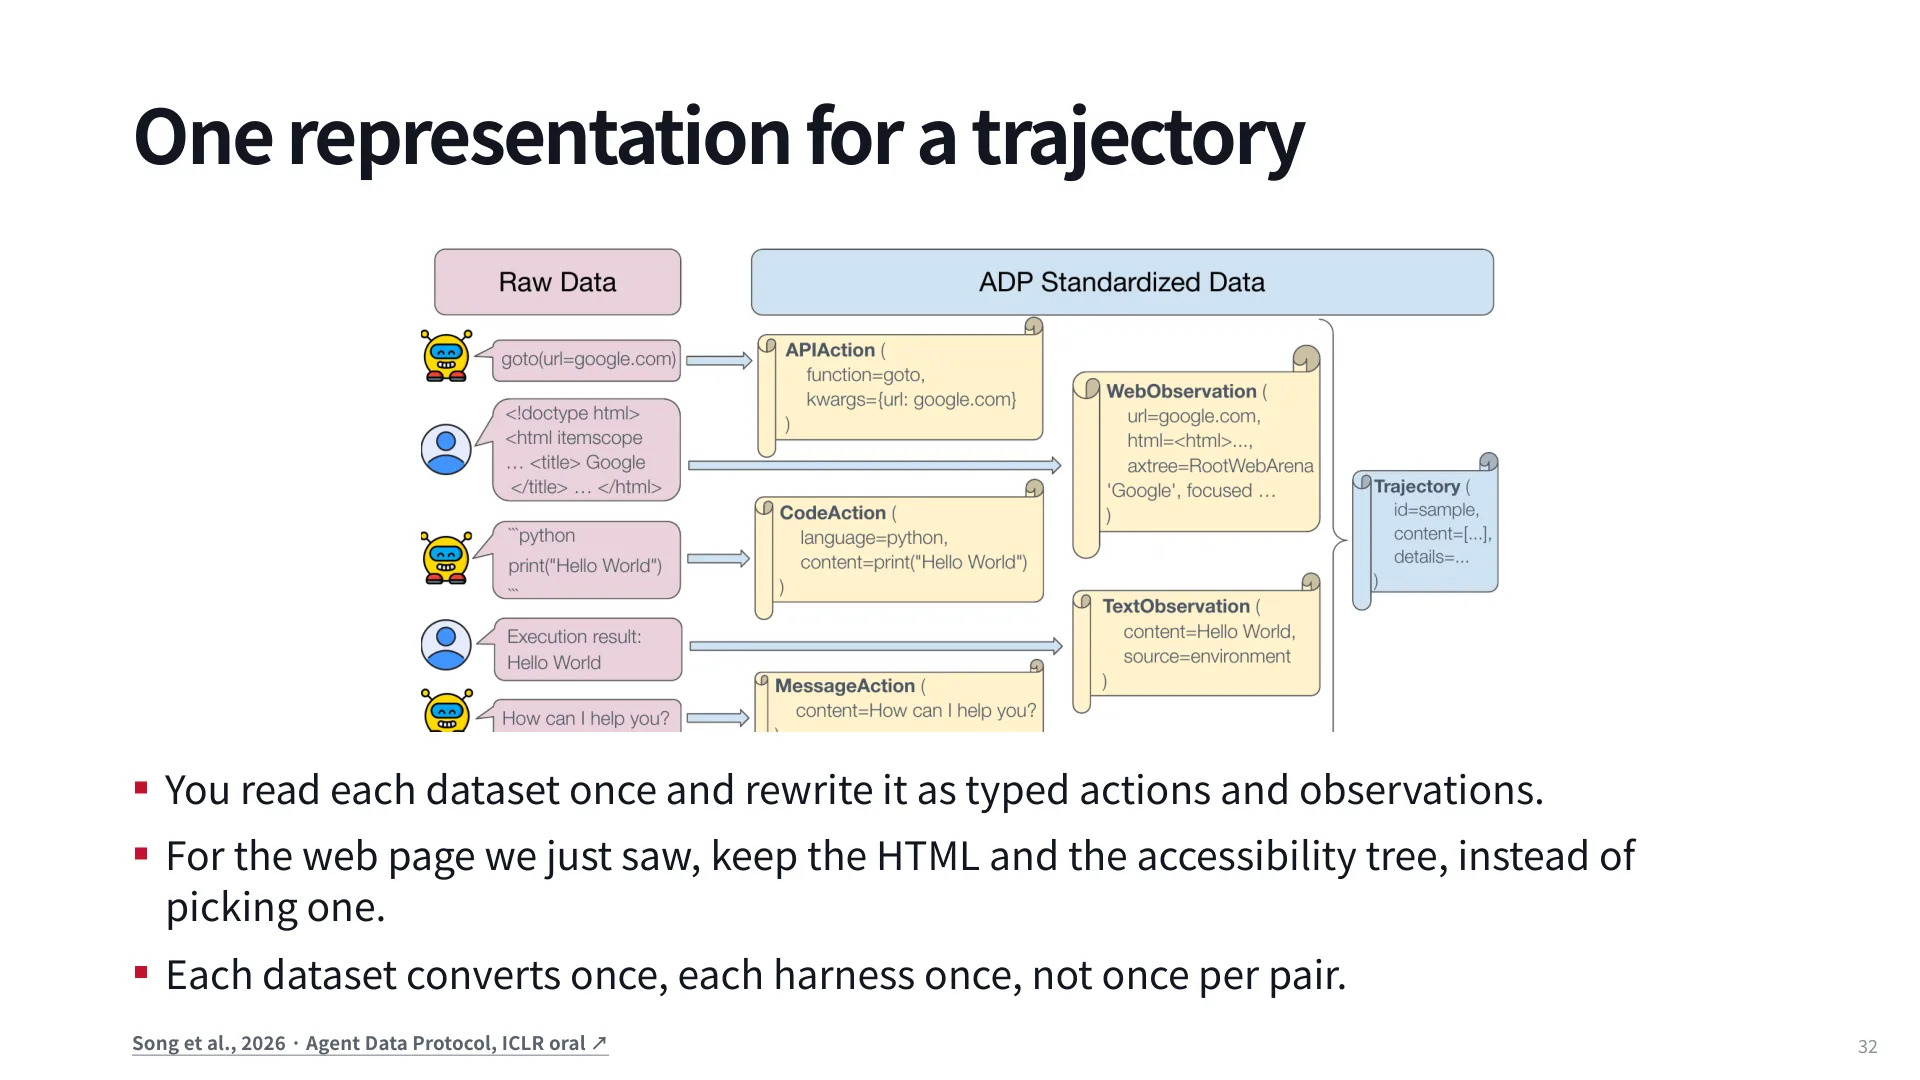
Agent Data Protocol(ADP)的思路是引入一个中间表示:每个数据集只写一个“到统一格式”的转换器,每个 harness 只写一个“从统一格式到自己的动作空间”的渲染器,总量变成 。而且中间表示可以保留多种观测表示——网页同时存 HTML 与 accessibility tree,下游按需取用,而不是在转换时被迫二选一。
统一之后还有一步“渲染回去”。OpenHands、SWE-Agent、AgentLab 接受的工具名、参数 schema、观测格式都不同,同一条轨迹在三个 harness 里会长得不一样。渲染阶段还要处理两件事:注入目标 harness 的 system prompt,以及决定上下文超长时怎么截断。渲完必须做校验:工具调用能否被解析、每个调用是否带思考、对话是否以正确的方式结束。这三项检查能拦掉大部分静默失败。
37:20 讲师在这里说明这是他自己的工作(与 Graham Neubig 合作),动机就是“写转换器写到崩溃”。
统一格式还有一个不太直观的收益:多样性本身能提升单域表现。在相同 harness、相同模型、相同评测下,只改训练混合,训 mixture 的模型在某个领域的 benchmark 上也能超过只训该领域数据的模型。一种解释是跨任务迁移:网页任务教会的“先观察再动作”,会迁移到终端任务;代码任务教会的“读错误信息”,会迁移到 OS 任务。
9. 真正跑一次训练
到了这一步,数据已经格式化好,剩下的是配置与工程。
43:14 讲师强调这不是 parameter-efficient tuning,而是全参数训练——除了数据不同、掩码不同,流程和预训练没有本质区别。
三份公开配置能给出量级感:
| 模型 | 序列 | batch | 学习率 |
|---|---|---|---|
| Nemotron 3 Ultra | packed 294,912 → 515,000 | 64 | 1.5e-5 → 1e-6 |
| MAI self-distillation | packed 128k | 2,048 | 1.7e-5 → 5.2e-6,2% warmup |
| K2 Horizon | 512K,三阶段 | — | 在高量子集上 decay |
三个观察:序列长度都在十万到五十万 token 量级,说明 agent 轨迹真的很长;batch 从 64 到 2048,差别来自模型规模与并行策略;学习率都单调下降,且末端很小,因为 SFT 的目标是“收敛到一个好策略”,不是“继续探索”。
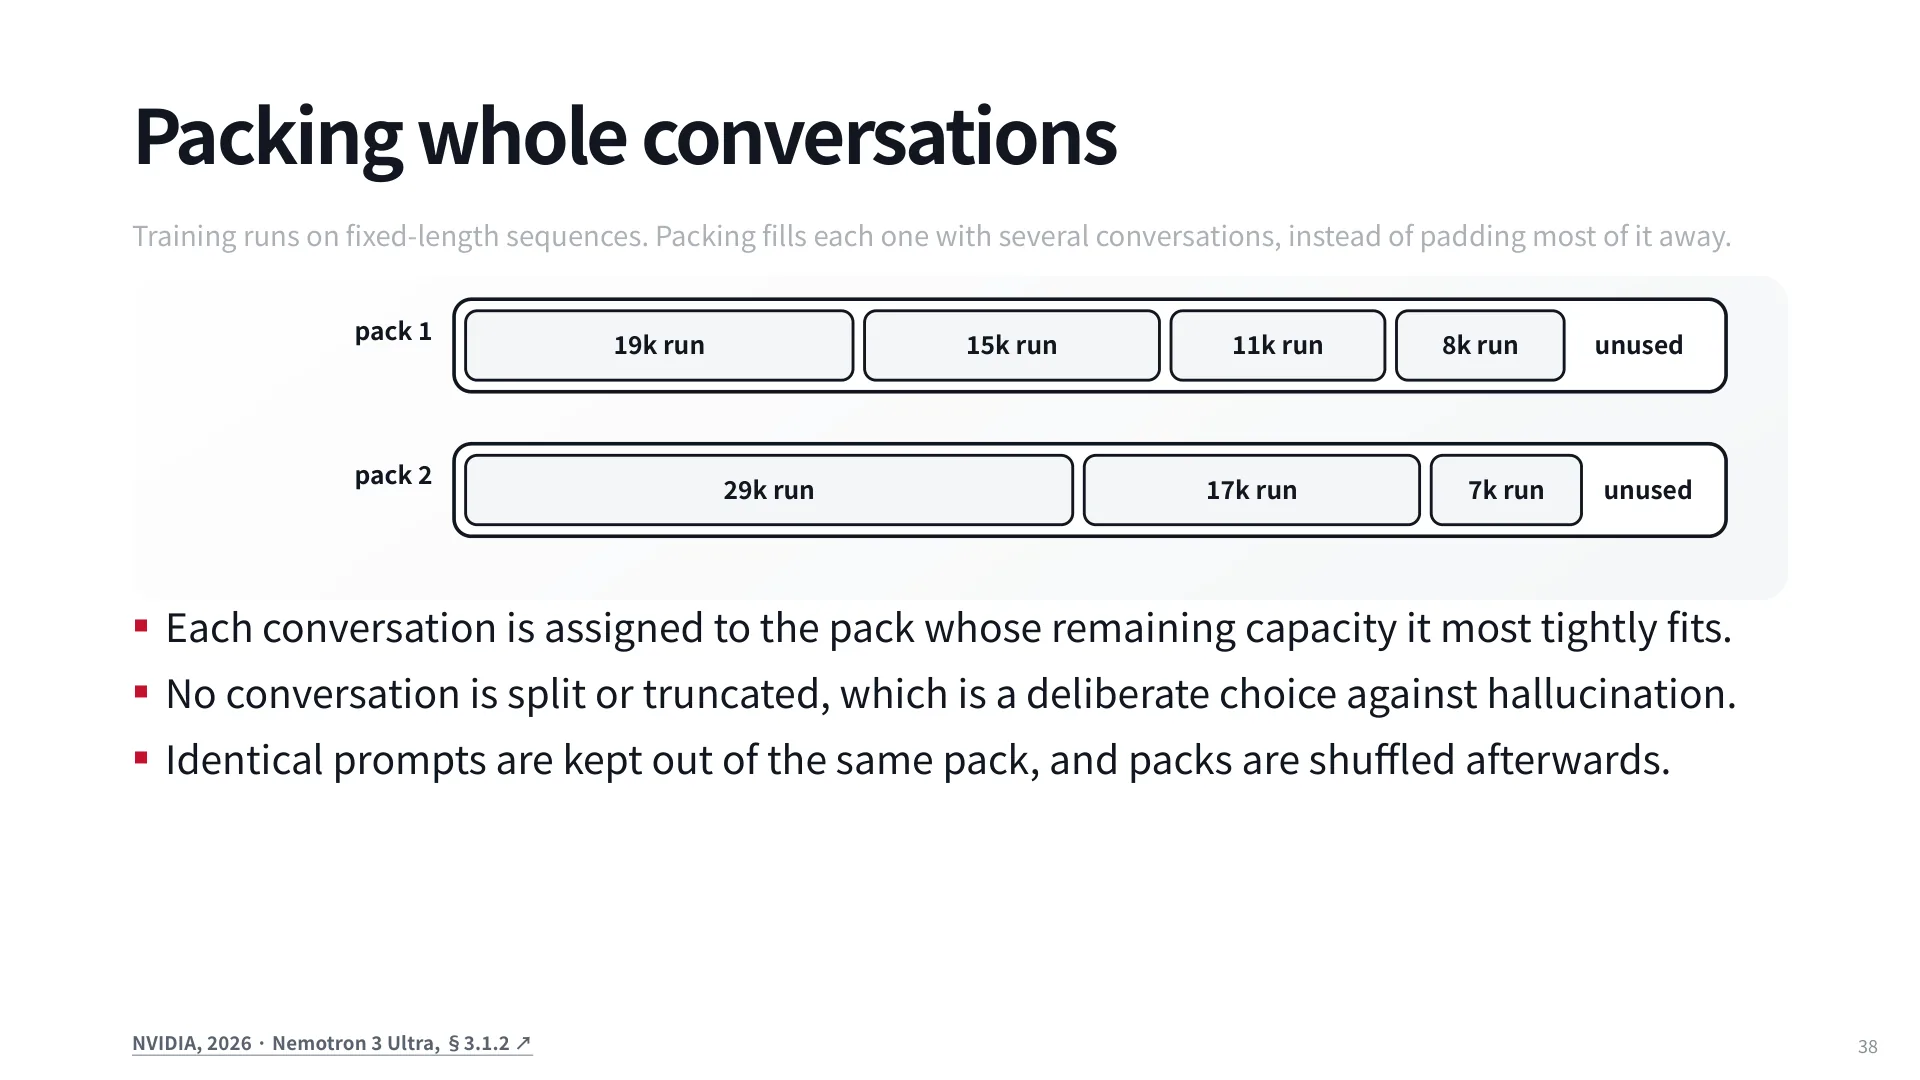
45:41 Packing 是长序列训练的关键工程。训练跑在定长序列上,如果一条轨迹只有 8K 而序列长度是 32K,剩下的 24K 要么 padding 掉(浪费算力),要么塞进别的对话(packing)。Nemotron 的做法是:每条对话分配给“剩余容量最贴合”的 pack,不切分、不截断——这是刻意的选择,因为截断会让模型看到不完整的对话,学到“话说一半就结束”的模式,进而诱发幻觉式收尾。同一 prompt 的多条轨迹不放同一个 pack,pack 之间再打乱。
MoE 模型在 SFT 阶段还有一个问题:窄领域数据会让路由塌缩。前沿模型多是 mixture-of-experts,公开论文里 fine-tune 的模型多是 dense。用窄的 agent 数据训 MoE,少数专家会吃掉大部分 token,其余专家学不到东西。MAI 的解法是在监督阶段把路由平衡调得比 RL 阶段强一千倍,并把 dropout 提到 0.15。这不是通用配方,但说明了“SFT 的工程”远不止学习率。
还有一个隐蔽的坑:template drift。你训练时用的模板必须和推理时用的模板完全一致,包括空白。课程给了一个具体例子:同一条轨迹,渲染两次——一次后面跟一个 tool message,一次不跟——会得到两个不同的字符串。原因是模板里有条件性的 thinking block:一旦后面追加了工具消息,前面 assistant 回合的渲染会变,前缀就不再匹配。在多轮 agent 循环里,这种不匹配是致命的,因为模型每一步都在“续写一个它训练时没见过的前缀”。
讲师给的建议是读一到两份前沿实验室的技术报告再动手,因为配置层面的经验很难从论文正文里获得。
公开的训练工件值得读:K2 Horizon 的 model card 有逐阶段的表(步数、token 数、序列长度、每个阶段的目的),链接了 Weights & Biases 的真实 loss 曲线,还放出每个阶段的中间 checkpoint;Nemotron 则连数据与配方一起放。读一份这样的报告,比读十篇方法论文更能建立“企业级 SFT 长什么样”的直觉。
10. 怎么知道它起作用了
训练 loss 下降是必要条件,不是充分条件。这一节讲的是为什么。
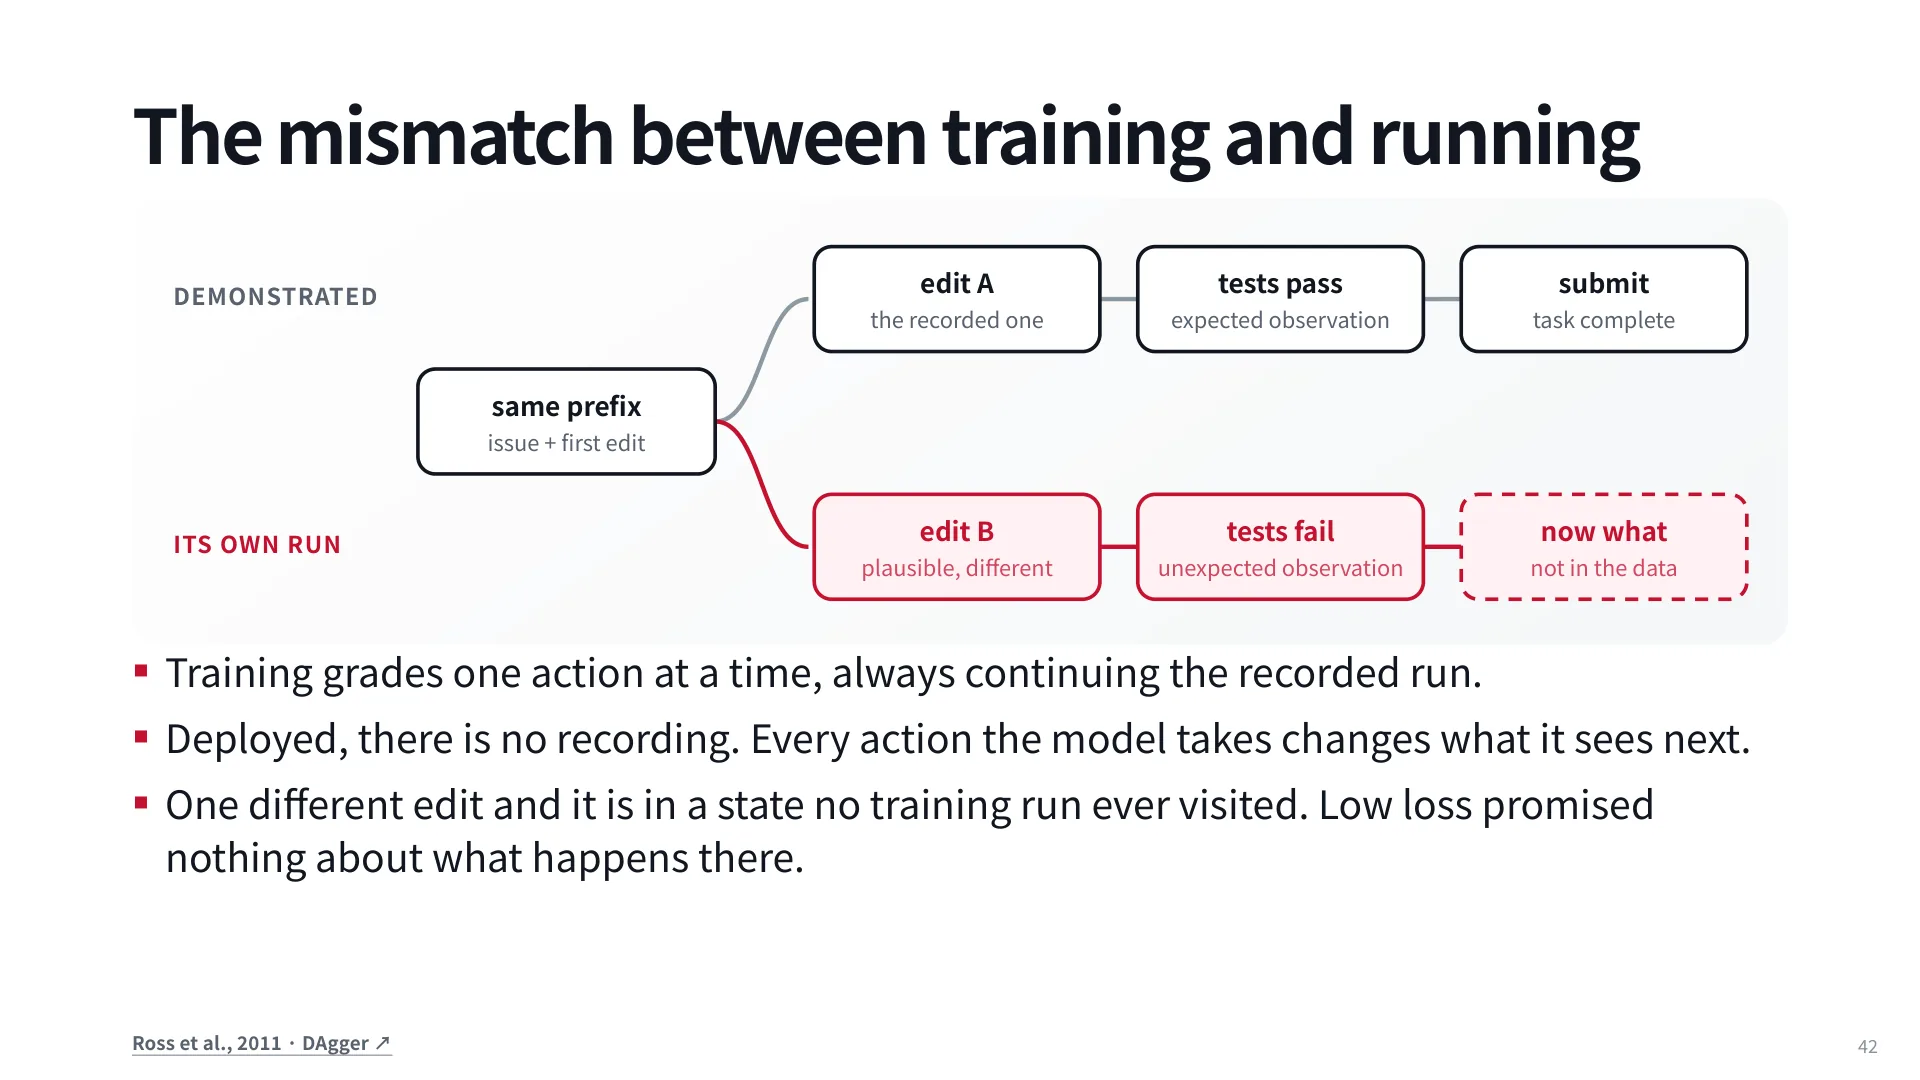
训练是 teacher forcing:给定录制的前缀,模型被要求预测录制里的下一个动作,然后无论它预测什么,下一步的输入仍然是录制里的那个动作。部署不是这样:模型自己采样,它选的每一个动作都会改变接下来看到的状态。
图里把这个错配画得很清楚。同一个前缀(issue + 第一次编辑),录制里走的是 edit A,测试通过,提交,任务完成;模型自己跑时可能选 edit B——一个看起来合理但不同的编辑,测试失败,返回一个训练里没见过的观测,然后“接下来该干什么”不在数据里。这就是 Ross 等人 2011 年 DAgger 指出的协变量偏移(covariate shift):低损失只保证在录制分布上预测得准,不保证在模型自己走到的状态上表现好。
48:55 讲师的说法是:训练永远在“继续录像”,部署永远在“自己往前走”。所以 loss 曲线可以用来监控优化是否正常,不能用来替代评测。
评测的几条实践规则:
- 先过拟合 20 条样本。如果 loss 压不下去,bug 在数据管线(模板、掩码、label shift),不在模型;这是最便宜的分诊手段。
- 在目标 harness 里跑,用可验证结果打分。不要在静态数据集上算 perplexity 就宣布成功;agent 的能力体现在“能不能把任务做完”。
- 小心读公开数字。有些报告的最好成绩是多个 harness 里挑出来的;你的单 harness 结果低几个点未必是退步。
- 切分要匹配结论。要声称“泛化到新任务”,就把同一任务的所有 rollout 放在同一侧,按仓库切分;否则模型可能只是记住了任务。
还有两个容易被忽略的评测维度。第一是跨 harness 的鲁棒性:在 OpenHands 里采的轨迹会连 OpenHands 的约定一起教给模型(工具名、观测格式、甚至 prompt 风格),换到 Claude Code 或 Codex 里可能就不工作。解法是在多个 harness 里采数据,这也是前沿实验室的常见做法。第二是目标域之外的回归:训一个能力会移动其他能力,而混合比就是这里的控制变量。如果你只按样本平衡,实际 token 分布可能严重偏向某一类(见第 6.3 节),通用能力就会退化。所以要评测那些你并不打算提升的东西。
课程把这条讲成一句总结:SFT 给你通用 agent 能力,RL 给你领域专精;但两者都会“顺带”改变别的能力,测不测是你的事。
11. 交棒给 RL
最后一页回到全局:SFT 要训到什么程度,才该交给 RL?
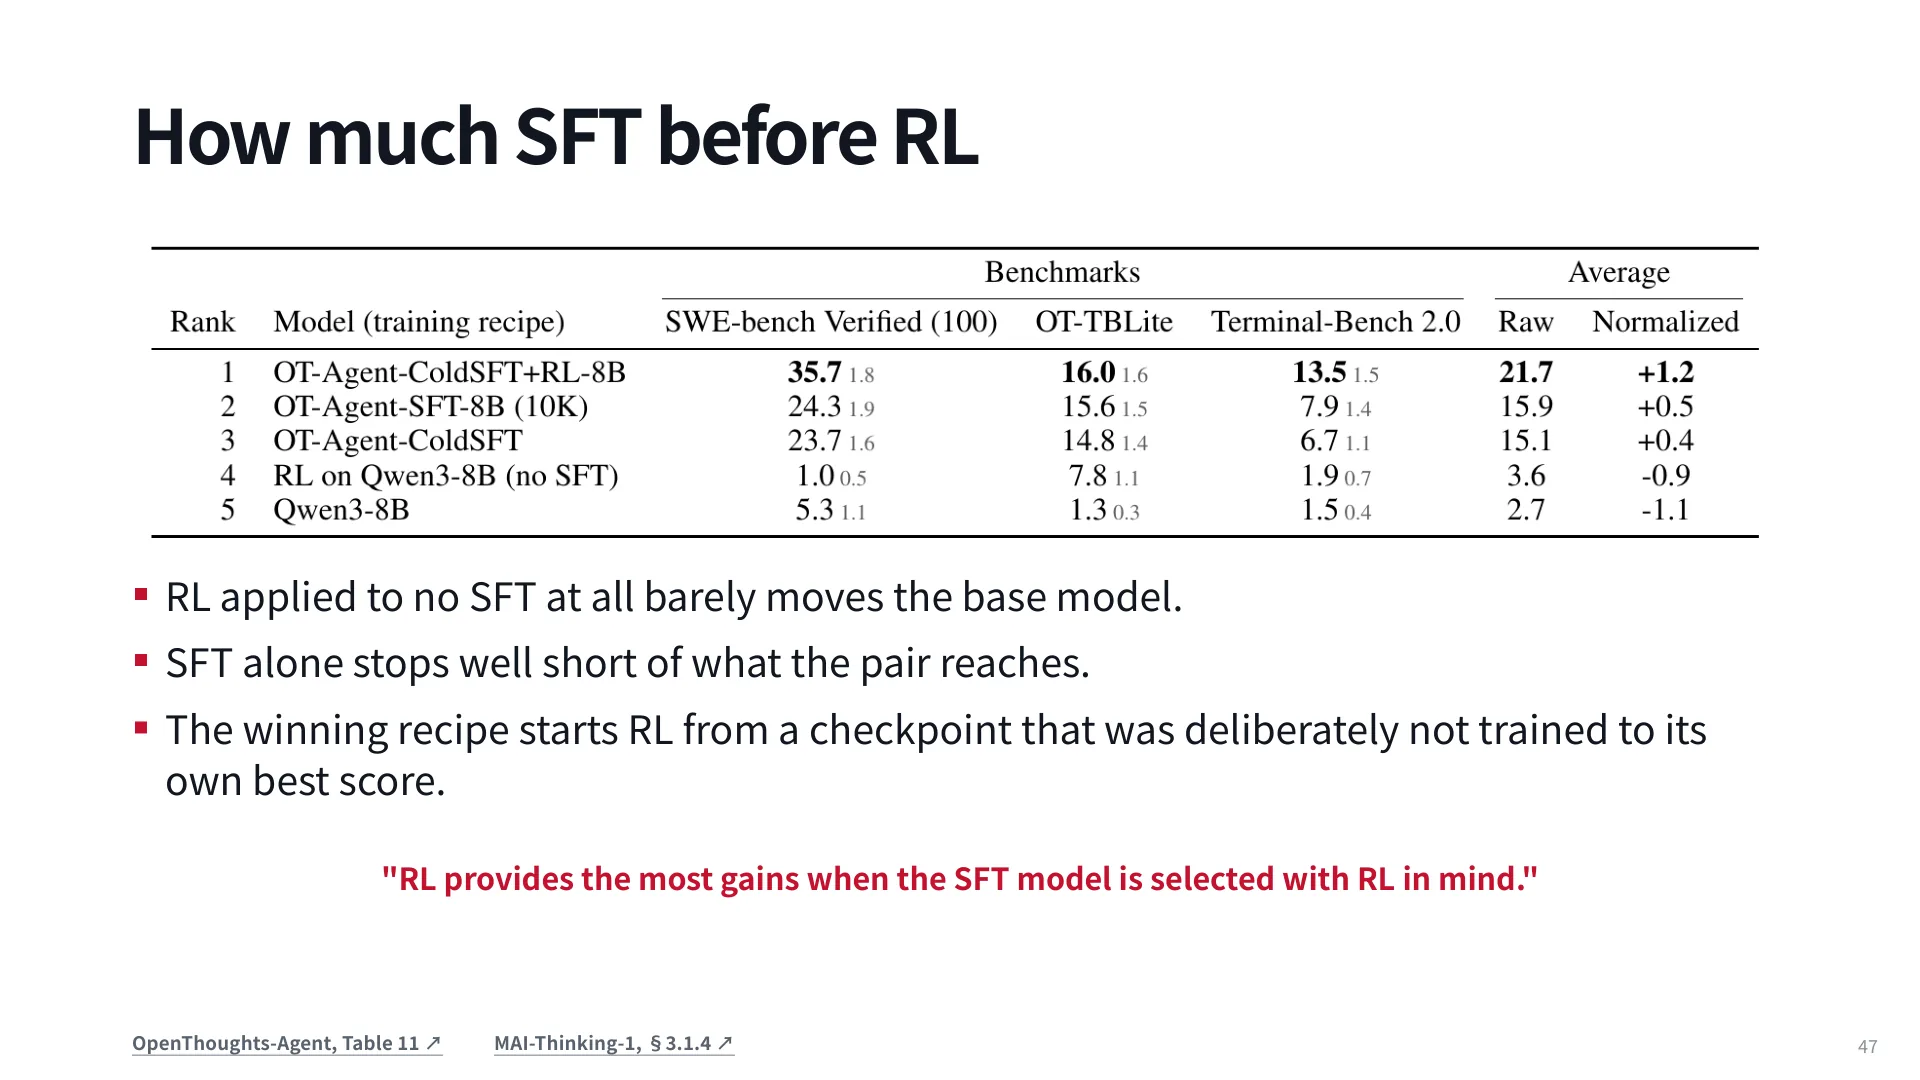
OpenThoughts-Agent 的对照很干净(8B 规模,三个 benchmark 的平均 raw):
| 配方 | 平均 raw | normalized |
|---|---|---|
| ColdSFT + RL | 21.7 | +1.2 |
| SFT only (10K) | 15.9 | +0.5 |
| ColdSFT only | 15.1 | +0.4 |
| RL on Qwen3-8B(无 SFT) | 3.6 | −0.9 |
| Qwen3-8B(base) | 2.7 | −1.1 |
三点结论:不做 SFT 直接 RL,几乎推不动 base model(3.6 vs 2.7);只做 SFT 会停在 15 左右,远低于组合的 21.7;而最好的配方并不是“把 SFT 训到最高分再交给 RL”,而是故意选一个没有训到自己最佳成绩的 checkpoint 去接 RL。
最后一点最反直觉,也最重要。SFT 训得越久,策略越尖锐、越贴近示范分布,探索的余地越小;RL 需要的恰恰是一个“还有改进空间、但格式已经正确”的起点。所以 SFT checkpoint 的选择应该以“RL 之后的表现”为目标,而不是以“SFT 自己的分数”为目标。课程把这三条结论并列放在一张表里(53:50)。MAI 的说法是:RL 的收益最大时,是 SFT 模型“with RL in mind”选出来的。
这也给整个 Training 模块定了调:SFT 负责把模型从“会说”变成“会按格式做事”,RL 负责把“会做事”推到“做得比示范更好”。下一讲从 RL 的基础开始——rollout、reward、策略梯度,以及为什么“可验证的奖励”是这一切的前提。
术语表
- SFT(Supervised Fine-Tuning):在带标签的轨迹上做全参数(或参数高效)微调,损失为 assistant token 上的交叉熵。
- Trajectory(轨迹):一次 agent 运行的完整记录,包含 system、user、assistant、observation 四类消息。
- Rollout:模型(或教师)实际执行一次任务产生的轨迹;在 RL 语境里也指采样过程本身。
- Chat template:把结构化消息渲染成单一 token 序列的规则,决定 special token、空白与角色标记的位置。
- Special token:词表中独立成 ID 的控制标记,如
<|im_start|>、<|im_end|>、<tool_call>,不是由普通字符拼成。 - Loss mask:与 token 序列等长的一位数组,1 表示该位置参与损失,0 表示仅作上下文。
- Teacher forcing:训练时每一步都以录制的前缀为条件,不把自己采样出的动作喂回模型。
- Covariate shift:部署时模型访问的状态分布与训练分布不一致;DAgger 针对的正是这个问题。
- Distillation(蒸馏):用更强模型产生的轨迹训练学生模型;只保留通过验证的运行是常见变体。
- Expert iteration:模型用自己的 rollout、经筛选后继续训练自己,循环往复。
- Cold start:RL 开始前的初始策略;SFT 的质量决定这个起点。
- Packing:把多条完整对话装进一个定长训练序列,避免 padding 浪费,同时不切分、不截断对话。
- MoE(Mixture of Experts):稀疏激活的专家网络;窄领域 SFT 会让路由塌缩到少数专家。
- Template drift:训练模板与推理模板不一致(哪怕只差空白),导致前缀分布错位。
- Turn / 回合:一条 assistant 消息及其触发的 observation;回合数是常用的轨迹形状指标。
延伸阅读
- SWE-Gym(Pan et al., 2024):可执行的软件工程训练环境,491 条通过测试的轨迹即可带来 10 分以上的提升;也是本讲轨迹示例的来源。
- OpenThoughts-Agent(Raoof et al., 2026):系统消融了教师选择、任务源、过滤规则与数据规模,本讲多个“反直觉”结论出自这里。
- Agent Data Protocol(Song et al., 2026, ICLR oral):把异构 agent 数据统一成带类型的动作与观测,再渲染到不同 harness;本讲第 8 节的基础。
- Kimi K3(Kimi Team, 2026):SFT → RL → on-policy distillation 的三段式配方,XTML 模板把“结束消息 / 交接工具 / 结束任务”拆成不同 token。
- Nemotron 3 Ultra(NVIDIA, 2026):packing 策略、路由平衡、以及“保留截断推理但掩掉截断点”的细节。
- MAI-Thinking-1(Microsoft AI, 2026):按能力分配样本配比,以及样本比例与 token 比例严重偏离的实证。
- BalanceSFT(Hao et al., 2025):用可学习的权重平衡推理 token 与工具调用 token 的损失,并重采样困难样本。
- DAgger(Ross et al., 2011):序列预测中的协变量偏移与数据集聚合,是理解“训练—部署错配”的经典起点。
- DeepSeek-R1:R1-Zero 直接对 base model 做 RL,R1 又把冷启动 SFT 加回来,是“为什么还需要 SFT”的最好案例。
自测题
1. 为什么 agent SFT 默认只对 assistant token 计算损失?如果把 observation 也纳入损失,可能发生什么?
参考答案
observation 由环境或用户提供,不是模型应当预测的内容;把它计入损失会让模型学会“生成工具输出”,部署时可能不调用工具而直接编造一个看起来合理的测试结果。例外是刻意做 world model 的训练(如 Computational World Model),它能让模型理解执行语义,但会占用容量,对小模型可能有害。
2. 一条轨迹里,<|im_start|>assistant 这个角色头与结尾的 <|im_end|>,哪个该计入损失?为什么?
参考答案
角色头不该计入:推理时它由模板供给,模型不需要生成。结尾的 stop token 必须计入:它由模型自己生成,若不训练,模型学不会停止,在 agent 循环里会一直调用工具直到撞上步数上限。
3. 掩码是怎样从对话结构构造出来的?为什么训练器最终“看不到角色”?
参考答案
三步:模板渲染时记录每个 assistant span 的字符起止位置;tokenize 时把字符位置映射为 token 位置;再按 span 生成 0/1 掩码。序列化完成后只剩 token id 数组与掩码数组,角色信息已在渲染阶段被消费掉。
4. 推理块有哪两个互相独立的开关?各自会带来什么后果?
参考答案
是否留在上下文:留下能让后续动作有条件可依;是否参与损失:参与则模型学会自己写这种风格的推理,不参与则推理风格由 base model 或 RL 提供。Nemotron 的做法是保留被截断的推理在上下文里,但把人工截断点从损失中掩掉。
5. MAI 的配比表说明了什么陷阱?你应该怎么检查?
参考答案
按样本数配比不等于按 token 配比。STEM/Code 占 56% 样本却在 token 上占 89%,通用能力只剩 2% 的梯度。检查方法是统计每类数据的 assistant token 总量,看实际 token 分布是否与设计意图一致。
6. 为什么“通过测试”的轨迹仍可能是有害的训练数据?举出至少两种坏行为。
参考答案
验证器只检查结果,不检查过程;损失会复制所有动作。坏行为包括:反复读文件却从不编辑、长时间“编辑—跑测试”循环、在最终补丁里留下 print( 调试语句、无效重试后碰巧通过。
7. 教师模型的榜单排名为什么不能直接用来选教师?
参考答案
榜单衡量“自己能不能做对”,不衡量“能不能把学生教会”。OpenThoughts-Agent 的消融里,在基准上最强的 GPT-5.3-Codex 产出的学生最弱(normalized −1.47),而 GLM 4.7 (Quantized) 排第一。原因是可教性:解题方式、思考模式、工具习惯要与学生的容量和先验匹配。
8. 在固定任务集上增加采样轨迹数,与增加新任务,曲线为什么不同?
参考答案
同一任务的边际信息量递减,模型很快把它学完,曲线变平;新任务带来新的状态与解法分布,边际信息量近似恒定,曲线持续上升。SWE-Gym 的实验里前者仍在涨,但受限于采样算力而非任务数量。
9. 训练 loss 很低,能否说明 agent 在真实环境里表现好?为什么?
参考答案
不能。训练是 teacher forcing,每一步都以录制前缀为条件;部署时模型自己采样,一次不同的动作就进入训练从未访问过的状态(协变量偏移,DAgger)。低损失只在录制分布上有意义,必须到目标 harness 里用可验证结果评测。
10. packing 为什么坚持“不切分、不截断”对话?代价是什么?
参考答案
截断会让模型看到不完整的对话,学到“话说一半就结束”的模式,诱发幻觉式收尾;不切分保证每条样本都是完整可学的轨迹。代价是 pack 末尾会留下无法利用的空余容量,需要按“剩余容量最贴合”来分配以降低浪费。