
6b · Training 4: RL Systems
本讲速览
- 策略梯度只有一行公式,但要跑起来需要一整套系统。
forward/backward/optim_step之外,还必须有env.step、env.verify和 agent harness;后三者才是 agent RL 与普通 RLHF 的分水岭。 - 同一个模型被拆成两个引擎。 推理引擎(vLLM、SGLang)做 decode:逐 token、无梯度、围着 KV cache 转;训练引擎(Megatron、FSDP2)做 prefill 式并行前反向:要 autograd、要激活。两者优化方向几乎相反,所以框架宁愿"把 forward 算两遍"。
- 推理侧四件套是 KV cache、prefix caching、continuous batching、speculative decoding;训练侧四件套是 activation checkpointing、prefix sharing、并行切分、microbatch 装箱。"用缓存换计算、用内存换时间"是两侧共同的主旋律。
- 两个引擎之间的接缝才是 bug 温床:权重同步(全量约 2TB vs 增量 20–30GB)、为推理布局 reshard、MoE 路由不一致(R3)、以及数值差异造成的隐性 off-policy。
- agentic RL 的两个"尖刺":多轮轨迹必须满足 sequence extension(前缀严格保留),否则一条轨迹会裂成多个 datapoint、prompt 被重复 prefill;而主流 chat template 会悄悄删掉历史 reasoning,正好破坏前缀。
- 轨迹数据必须以 token 而不是 string 传输(TITO)。 detokenize 是多对一的,训练侧重新 tokenize 会得到与推理不同的 token,直接制造 off-policy 与 loss spike。
- 系统设计有三条路线:harness 无关的中间人代理、SPMD 单程序多数据、everything-as-a-service 单控制器。服务化解耦换来弹性扩缩、异构算力、多策略、在线 RL 与多租户 LoRA。
1. 从公式到系统:RL 框架到底要实现什么
第 9 讲把策略梯度一路推到 GRPO,第 11 讲处理 off-policy 与训练稳定性。这一讲不再引入新算法,而是问一个工程问题:把那个公式真正跑在集群上,需要哪些部件,每个部件被什么物理约束卡住?
从更新式出发最容易看清结构:
每一项都对应一个具体操作。 要一次带梯度的前向与反向;采样动作要一次不带梯度的前向; 的更新要一次优化器步; 来自环境的验证;历史 来自 agent harness 与环境的交互。把箭头标在公式上,就得到一张"框架说明书":
| 阶段 | 需要的操作 | 由谁承担 |
|---|---|---|
| 采样 | env.state / env.step、harness、无梯度前向 | 推理引擎 + 环境 + harness |
| 打分 | env.verify → 、算 baseline 与 advantage | 环境 / 验证器 |
| 训练 | 带梯度前向、反向、optim_step | 训练引擎 |
关键在于:表格上半部分(前向、反向、optim_step)是张量算子,下半部分(env.step、env.verify、harness)是"世界"的接口。 这种 baseline 在 GRPO 里甚至只是同组 reward 的均值,不需要任何额外模型。真正不可能标准化的是环境——跑单元测试、比对最终答案、查数据库、检查浏览器最终状态,每个 benchmark 的 verify 都长得不一样。这既解释了"为什么 vanilla PyTorch 写不出来",也解释了为什么框架要把环境层单独抽象出来。
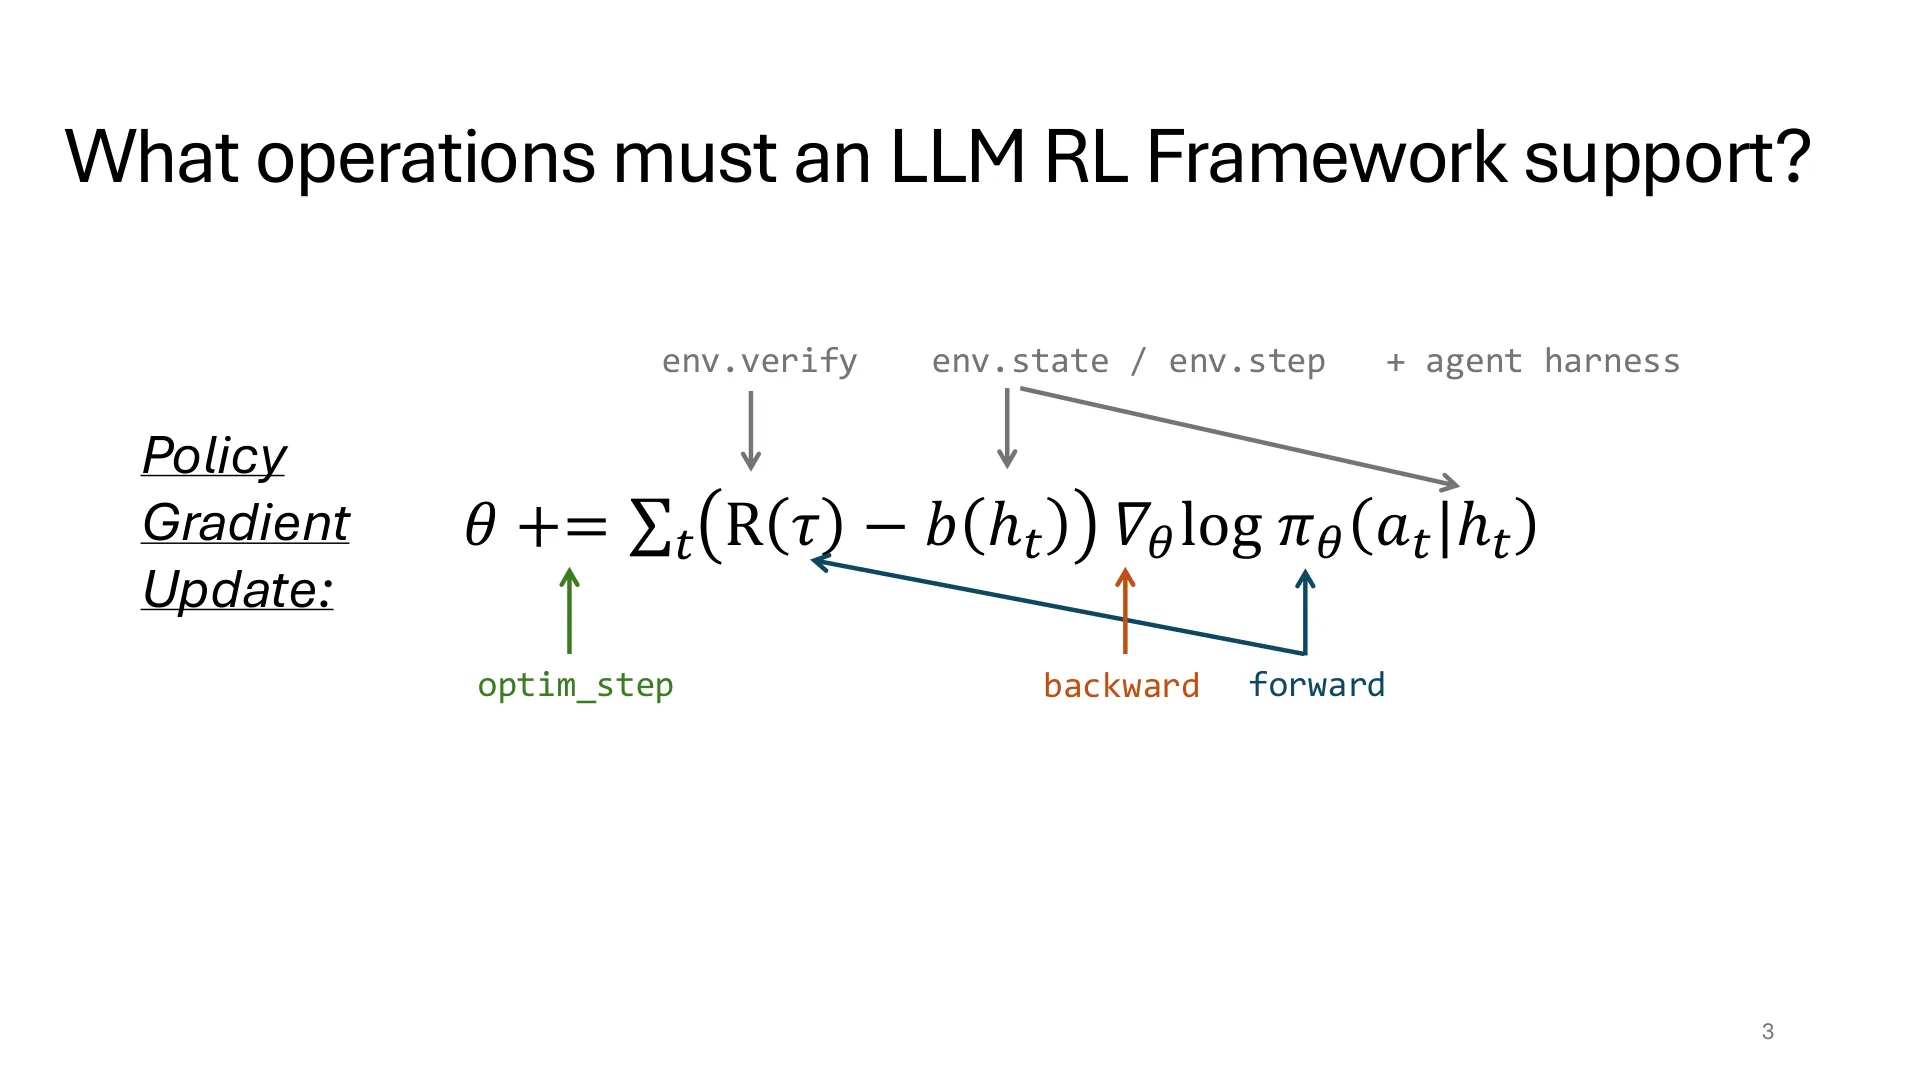
课堂上的提问是沿着公式逐个问出来的:先有人答"inference",再有人答"loss 与 backward",最后补上 optim_step——然后是环境、reward、以及"inference 到底长什么样"这一层(00:50)。这个顺序本身就说明了问题:公式让人以为难点在梯度,实际难点在梯度之外。
讲师提醒:如果你只记住一件事,请记住 RL 系统的复杂度不来自 ,而来自三件事——环境语义不统一、harness 的历史结构不规整、以及两个引擎之间那条又贵又容易出错的通路。
2. 为什么框架要分裂成两个引擎
三段算子都能用 PyTorch 写,为什么还要 vLLM、SGLang、Megatron、FSDP2 这些庞然大物?答案不是"抽象优雅",而是两种工作负载的硬件画像几乎相反。
推理是 decode:一次算一个 token,把它接回输入再算下一个;每一步都要读全部权重和不断增长的 KV cache,GPU 大部分时间在等显存带宽,batch 内序列长度参差,调度本身就是核心问题。训练是 prefill 式:整条序列一次性喂进去,矩阵乘密集、可以并行,而且必须保留激活值和计算图,否则反向传播无从下手(04:57)。
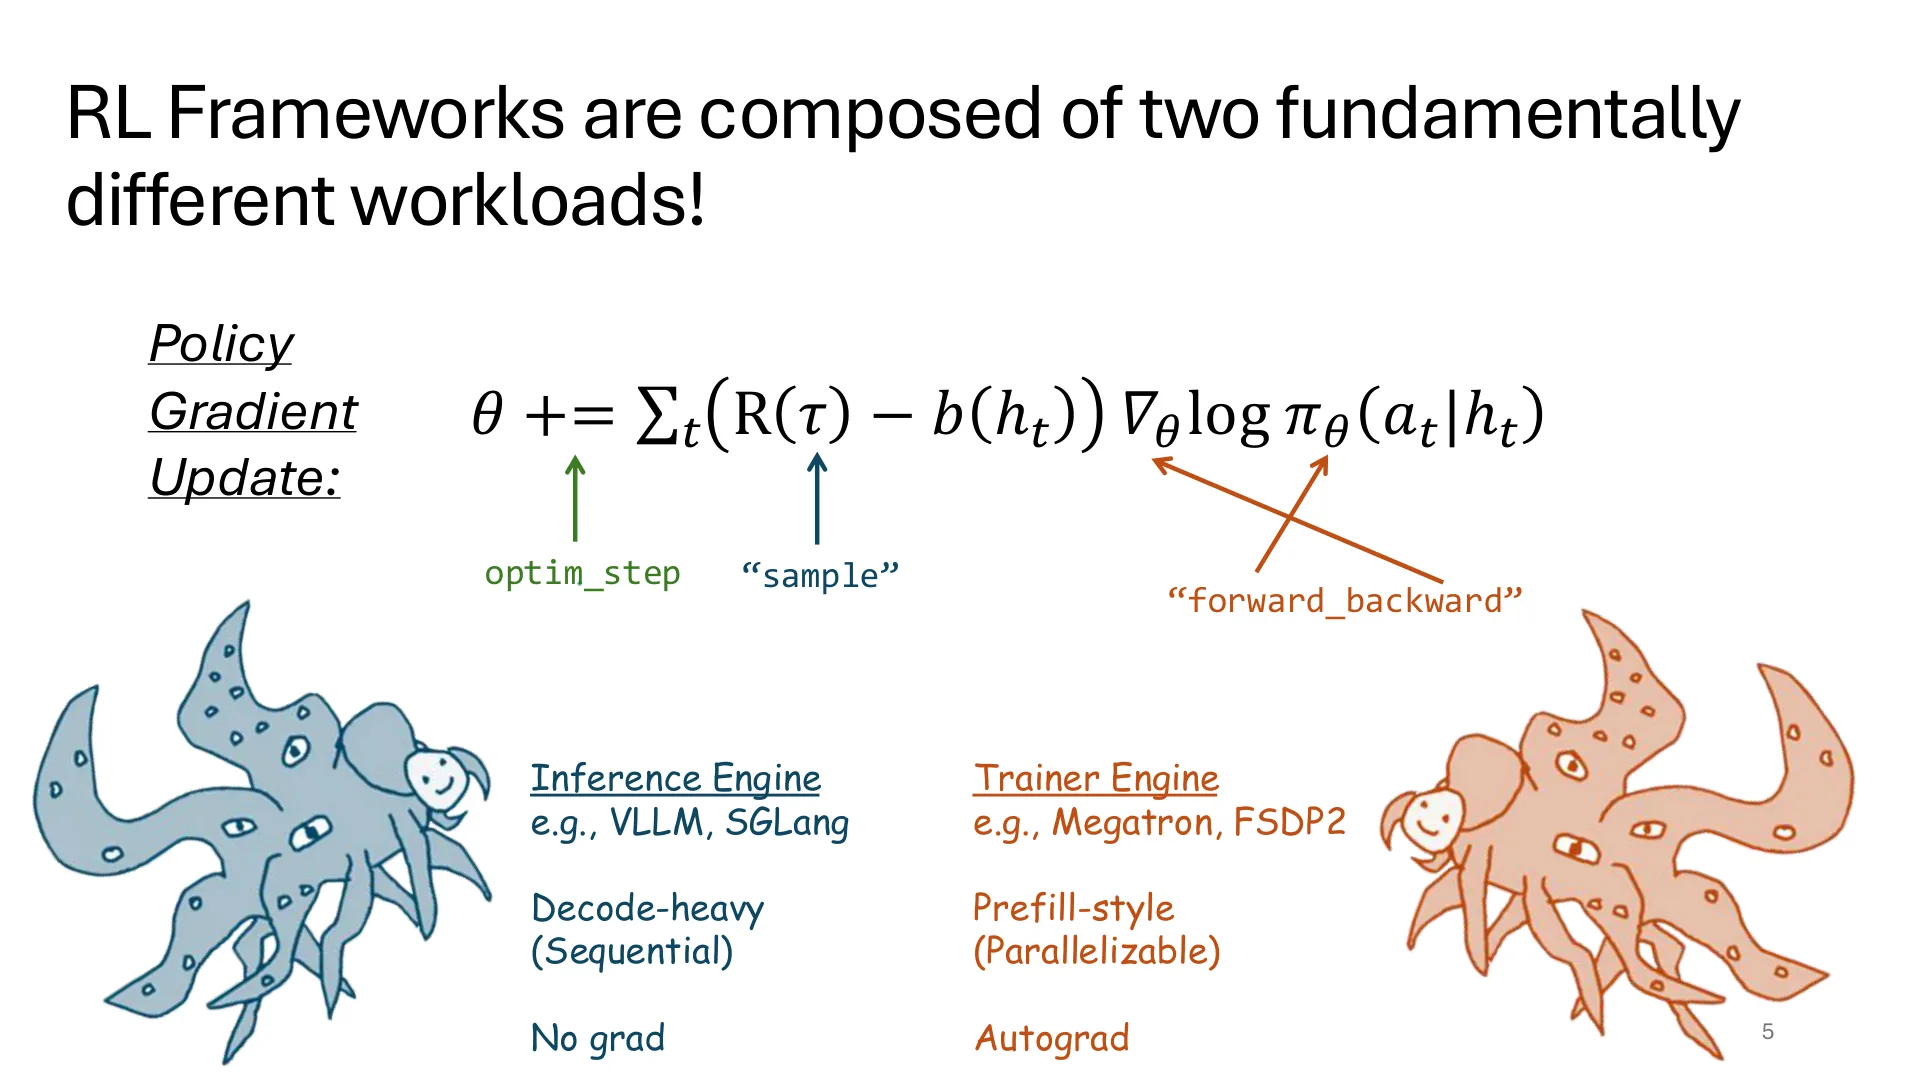
显存账单让分裂变成物理必需。以 Llama-3-8B 的 bf16 为例,KV cache 每 token 约 128 KB,一条 32k token 的轨迹约 4 GB,64 条就是 256 GB——以一张 80 GB 的卡为例,连一小批轨迹的 KV 都放不下。如果硬把训练和推理塞进同一组 GPU,优化器状态和激活会先吃掉显存,剩下的零头根本养不起 KV cache。分离的直接收益是:训练引擎可以放心地为激活花钱,推理引擎可以放心地为 KV 花钱。
第二个理由更隐蔽:即使权重完全相同,两边的前向也不是逐比特一致的。kernel 实现、融合顺序、并行切分都会带来微小数值差异,于是"采样用的策略"和"训练用的策略"严格来说并不是同一个分布。这就是框架必须做重要性修正、必须监控 importance_weight_max 的根源。
第三个理由是布局:训练侧可能用 PP/DP/EP 切分,推理侧用 TP/DP 切分,权重从训练引擎发出来之后必须重新 shard 才能被推理引擎加载。
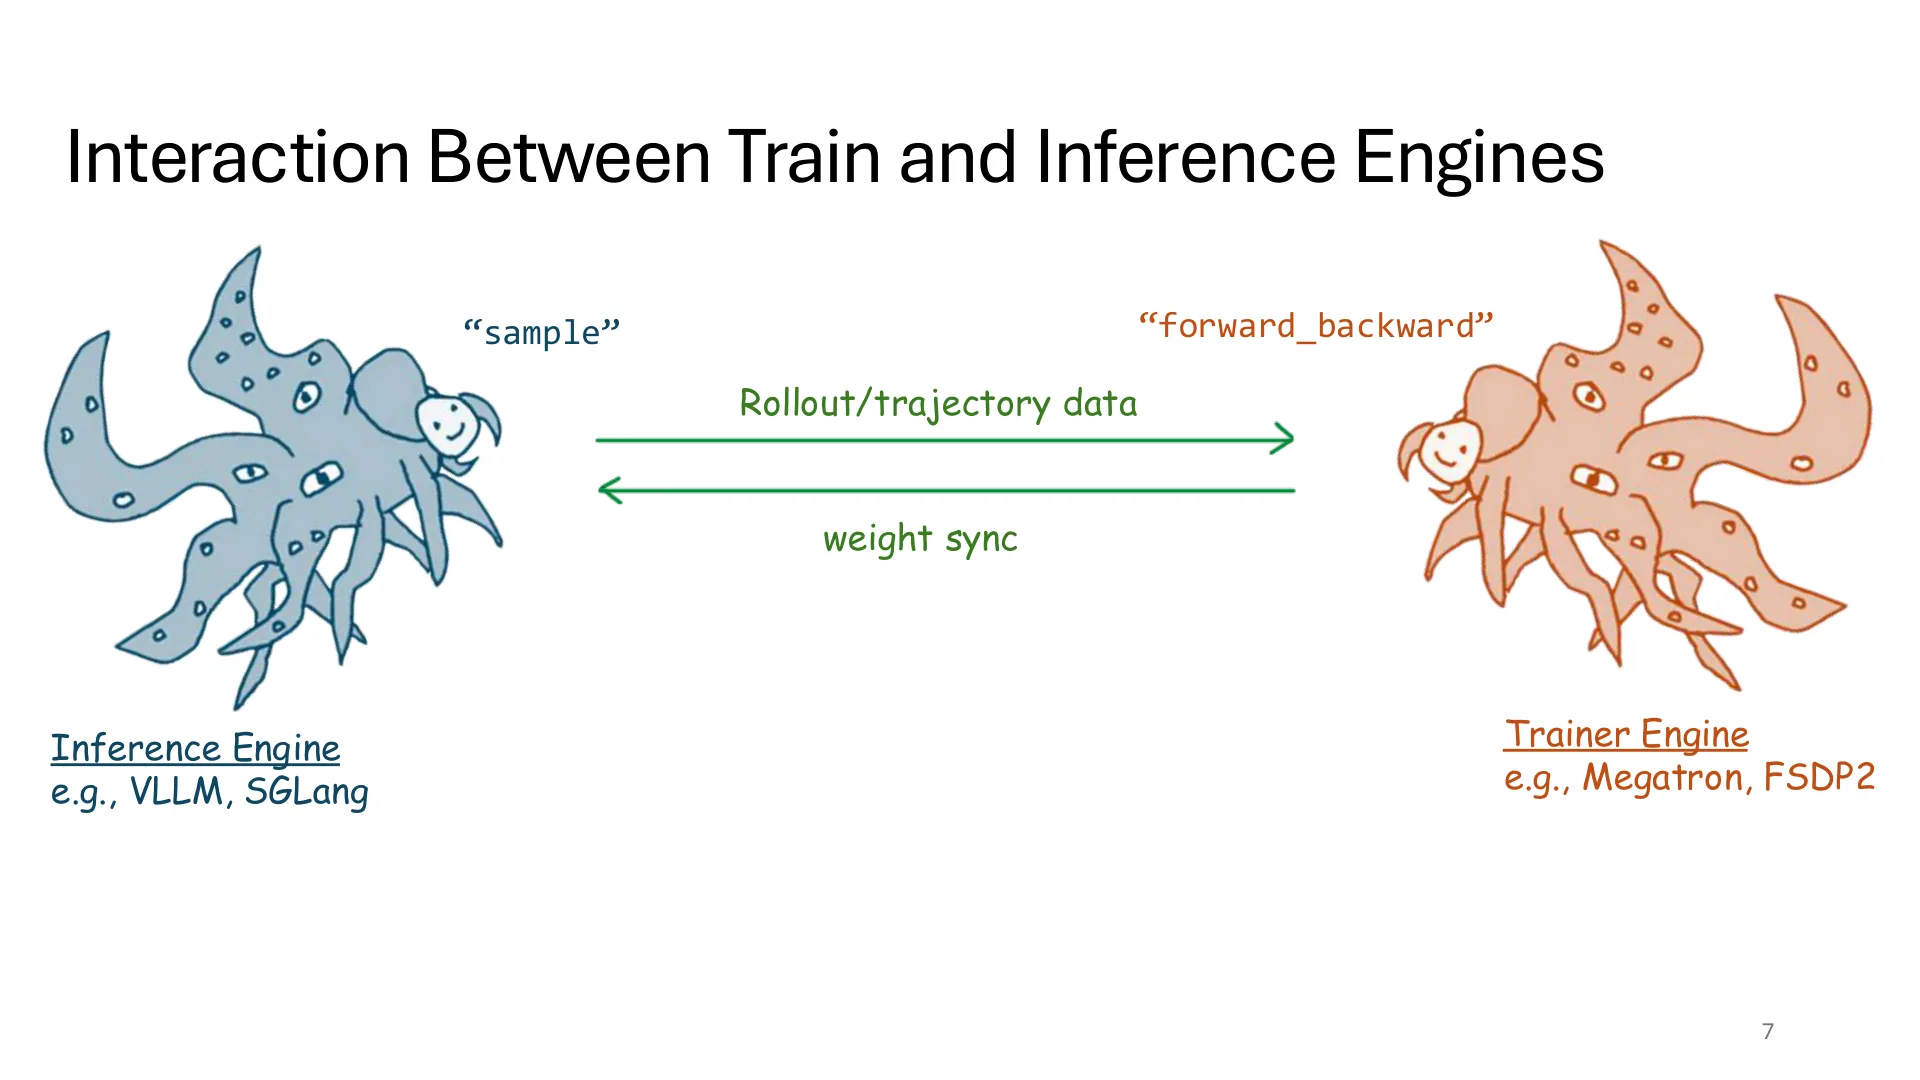
于是整讲的其余部分都可以读成一句话:如何让这两条箭头又便宜又正确。 箭头之上是推理优化与训练优化(各自在自己那侧省算力),箭头之间是权重同步、路由重放、序列契约与异步调度(保证两侧看到的是同一个策略、同一段文本)。
3. 一个训练 step 的解剖
把一次参数更新拆开,会看到五个阶段首尾相接(09:00):
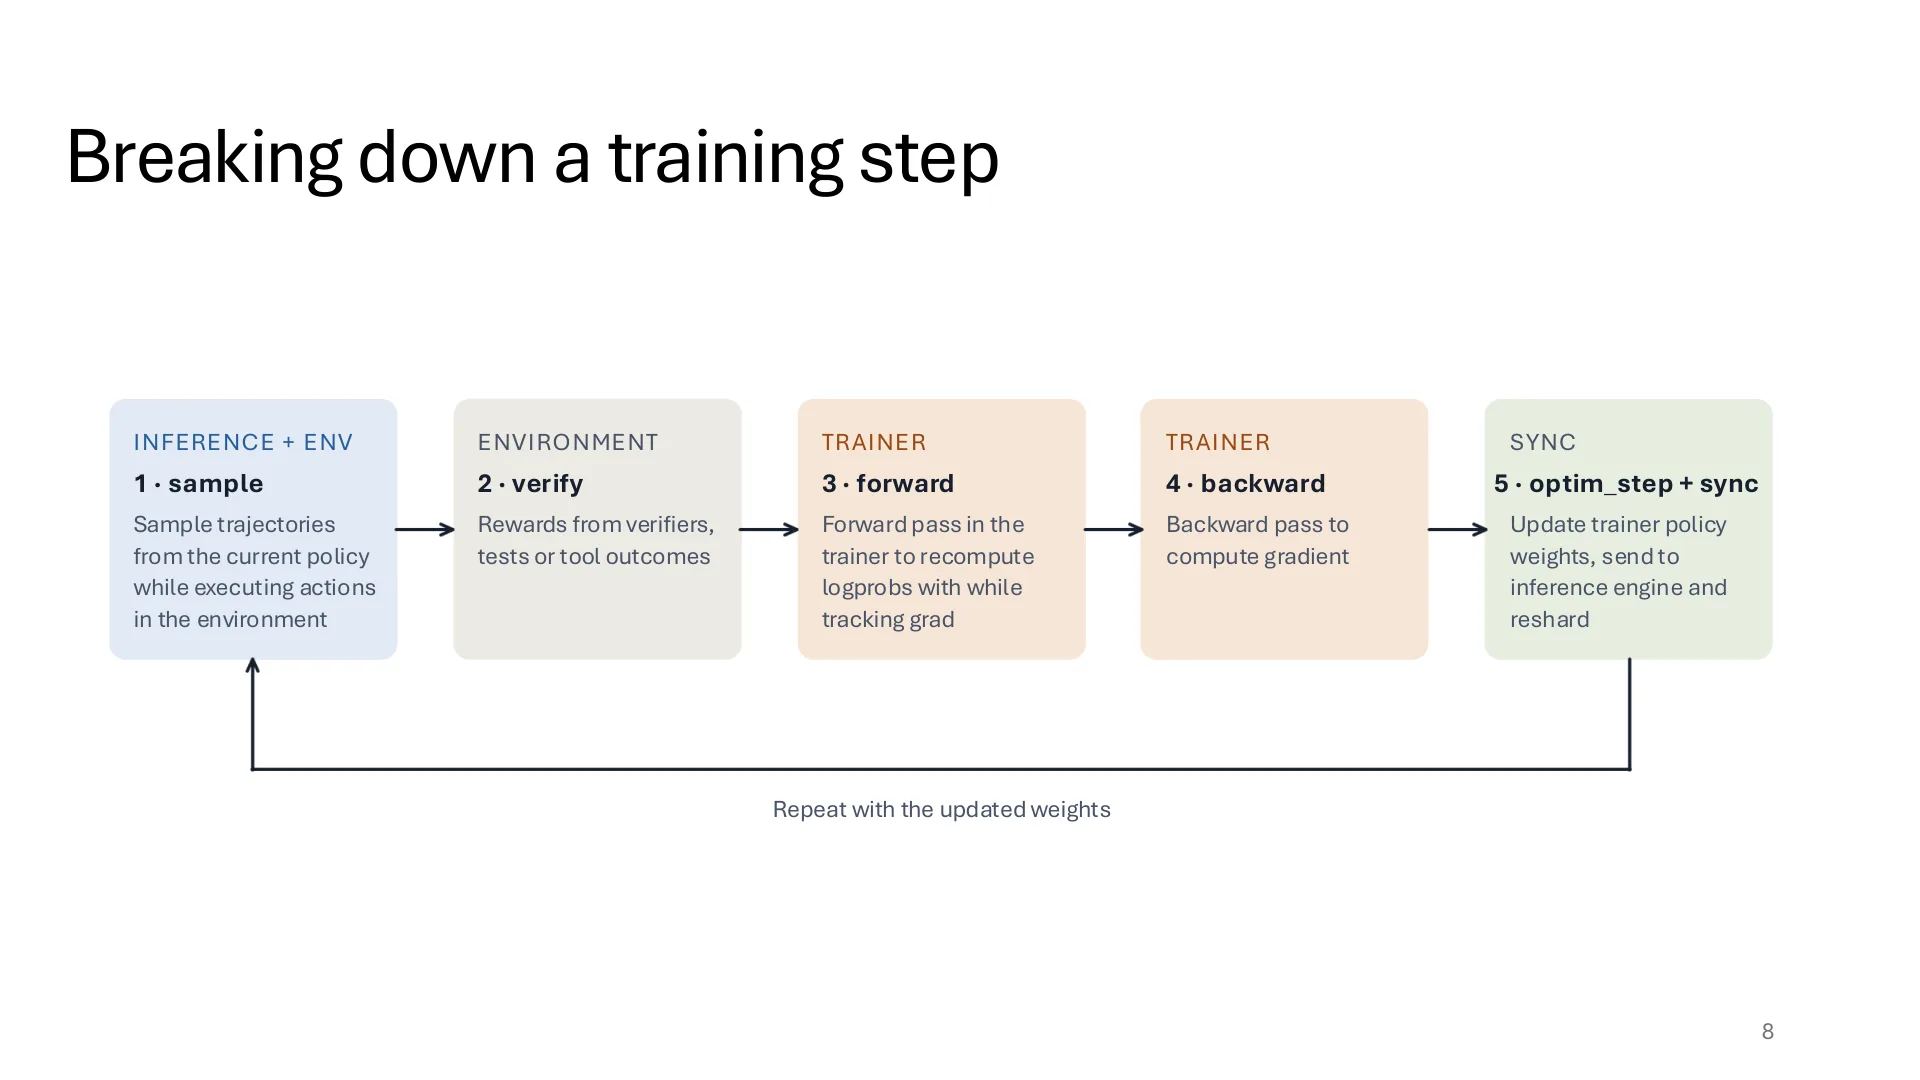
- sample:推理引擎按当前策略逐 token 生成,harness 把 token 变成工具调用,环境执行动作并返回观测,一条多轮轨迹由此长出。
- verify:验证器给这条轨迹打分——跑测试、比对答案、检查最终状态。注意这一步是执行程序,不是查表,所以它可能很慢、可能失败、也可能是整个 loop 里最不可控的延迟来源。
- forward:训练引擎把整条轨迹重新前向一遍,重算 logprob,这次要保留计算图。
- backward:反传得到梯度。
- optim_step + sync:更新参数,把新权重发给推理引擎,必要时按推理侧布局 reshard。
这五步里,第 1 步的耗时由最慢的那条轨迹决定,第 3、4 步随 token 数线性增长,第 5 步随模型大小线性增长。任何一步的等待都会变成 GPU 空转——这就是后面 stall 指标的来源,也是异步 RL 存在的理由。
还有一个容易被忽略的细节:第 3 步"重算 logprob"看似浪费,其实是设计选择。你完全可以把推理时算好的 logprob 直接拿来用,省掉一次前向;但那样梯度就建立在另一套 kernel 的数值之上,off-policy 程度不可控。重算的代价是一次前向,换来的是"训练分布与梯度来源一致"——这是框架愿意付的第一笔重复计算。
4. 推理侧:四种把算力省回来的办法
4.1 KV cache:拿显存换重算
自回归解码时,第 步只需要为新 token 算 ,然后对所有历史 做注意力。若不做缓存,每生成一个 token 都要把整个前缀重新 prefill 一遍,复杂度是平方级的浪费。KV cache 为每个历史 token 存一份 ,让"重算前缀"变成"读一遍缓存"。
代价是显存。单 token 的 KV 大小可以反推:。Llama-3-8B 是 32 层、8 个 KV head(GQA)、head dim 128、bf16,于是 字节,正好 128 KB/token。乘以 32k 就是 4 GB/条,乘以 64 条就是 256 GB。
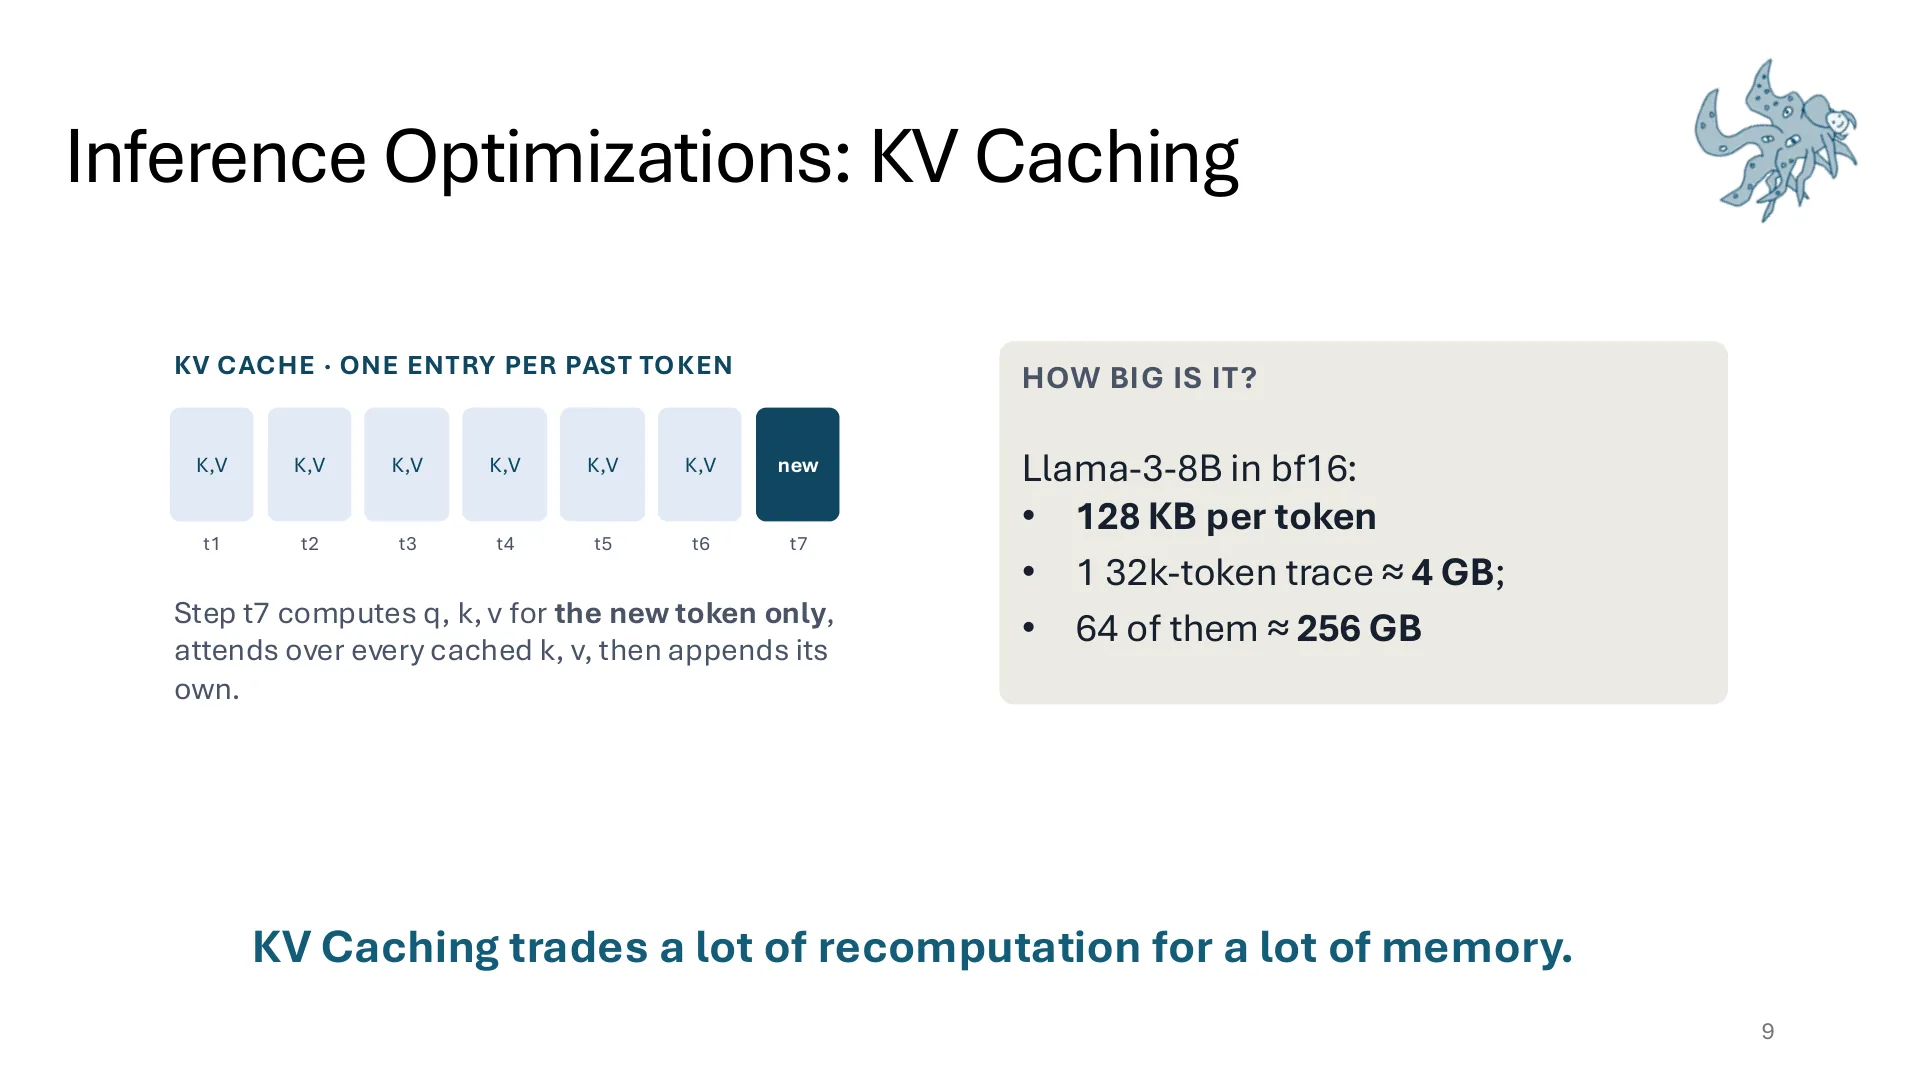
这张账单解释了两件事。第一,为什么推理引擎要发明分页式的 KV 管理(把 cache 切成块、按需分配与回收),因为显存碎片本身就足以拖垮吞吐。第二,为什么 RL rollout 的 batch size 不能像 SFT 那样随便开大——每一条并发轨迹都在按 token 线性吃显存,而 agent 轨迹动辄几万 token。
4.2 Prefix caching:跨请求复用前缀
KV cache 解决的是"一个请求内部"的重复计算;跨请求的重复则是另一笔账。在 agent RL 里,同一组 rollout 共享 system prompt、工具定义和任务描述,GRPO 的一个 group 更是共享同一道题;同一条轨迹的第 步,前缀就是第 步的完整历史。只要新请求的 token 序列以旧请求为前缀,旧请求的 KV 就可以直接搬过来用。
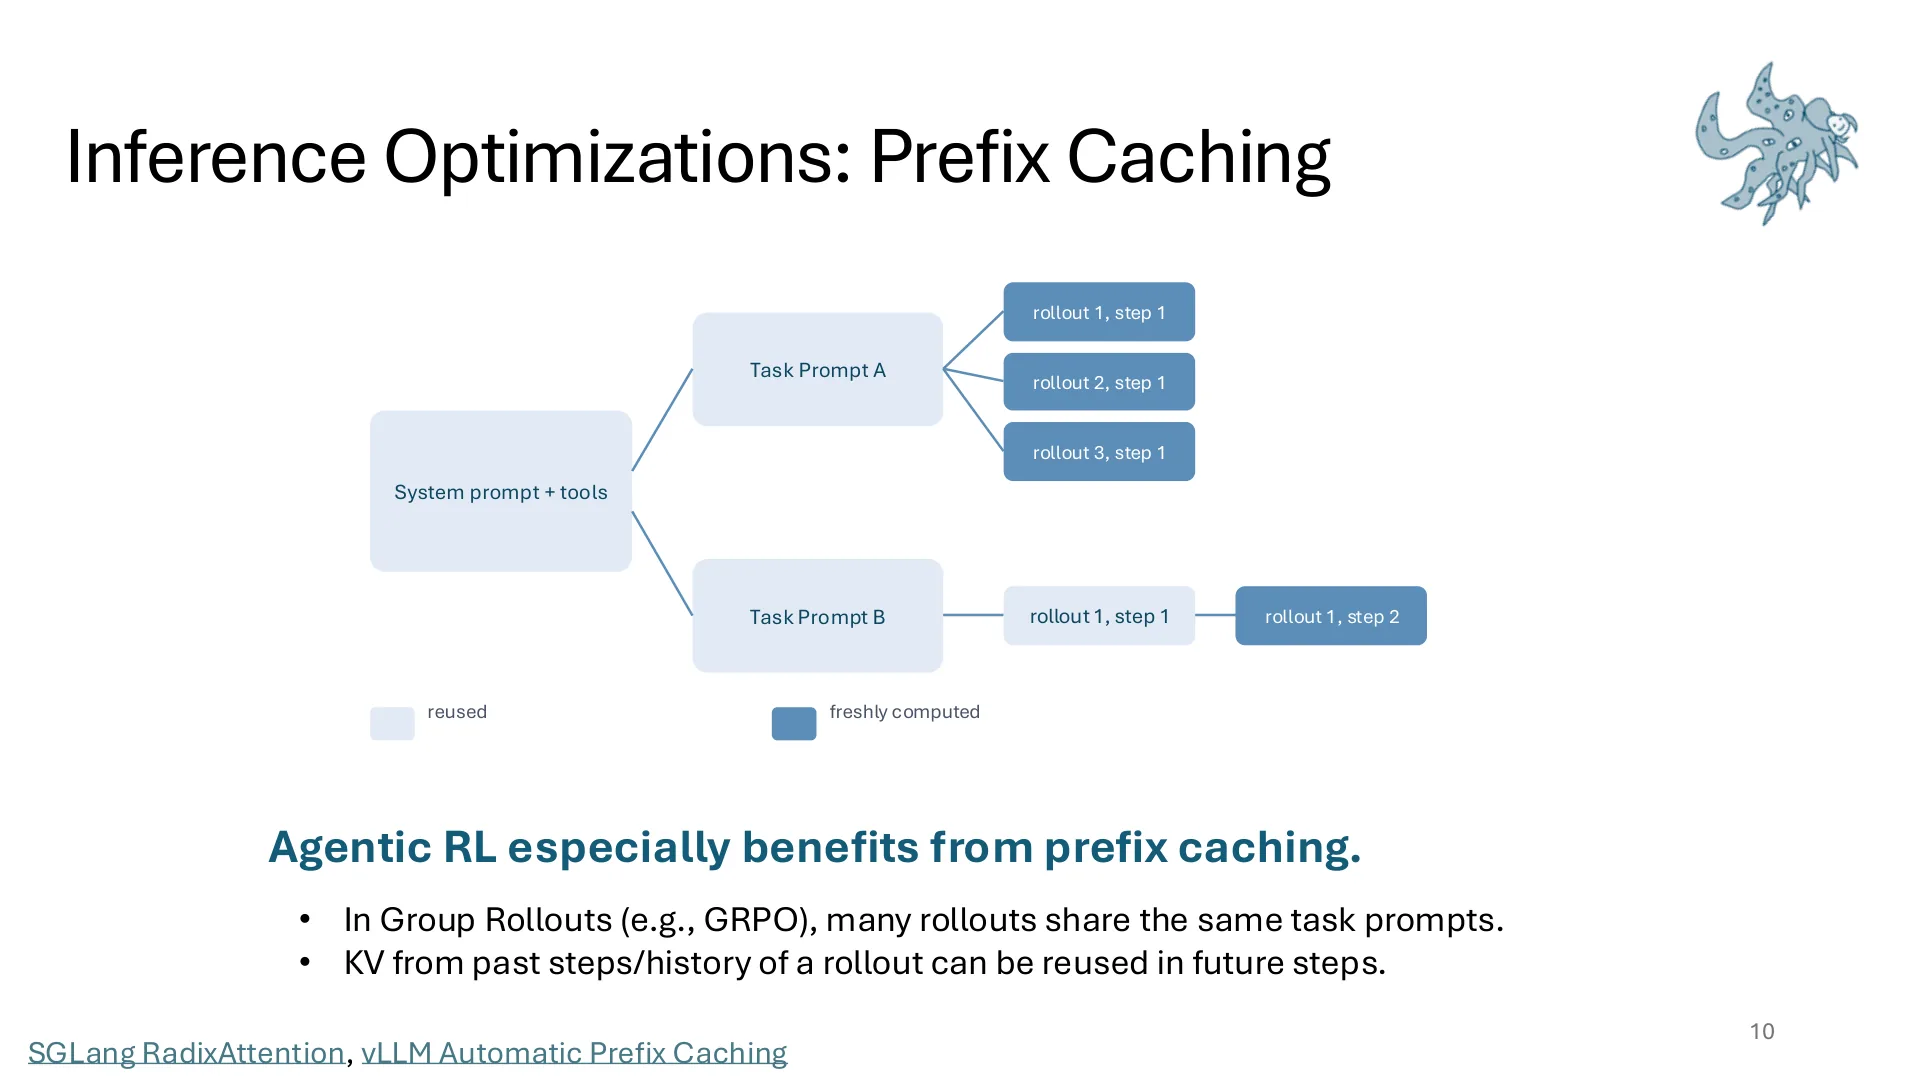
这张树状图值得多看一眼:根节点是 system prompt + tools,中间是 task prompt,叶子才是各个 rollout 新生成的部分。浅色块是命中的前缀,深色块是真正需要计算的。agentic RL 从这项优化里获益特别大,原因是每多一轮,可复用的前缀就长一截,而新增的计算只有这一轮的动作与观测。
它的前提很硬:前缀必须逐 token 完全一致。差一个空格、少一段 reasoning,缓存就命中不了。第 7 节会看到,主流 chat template 恰恰在破坏这个前提。
4.3 Continuous batching:按 decode step 调度
静态批处理把一批请求同时放进去,然后等最慢的那条结束——短请求的槽位从完成那一刻起就空转。agent 轨迹长度分布是重尾的:有的任务三步结束,有的跑几十轮,静态批处理的浪费会非常夸张。
continuous batching 把调度粒度降到单个 decode step:每生成一个 token 就重新检查,谁结束了就立刻把排队请求填进空出的槽位。这项技术出自 Orca 的 iteration-level scheduling(Yu et al., 2022)。
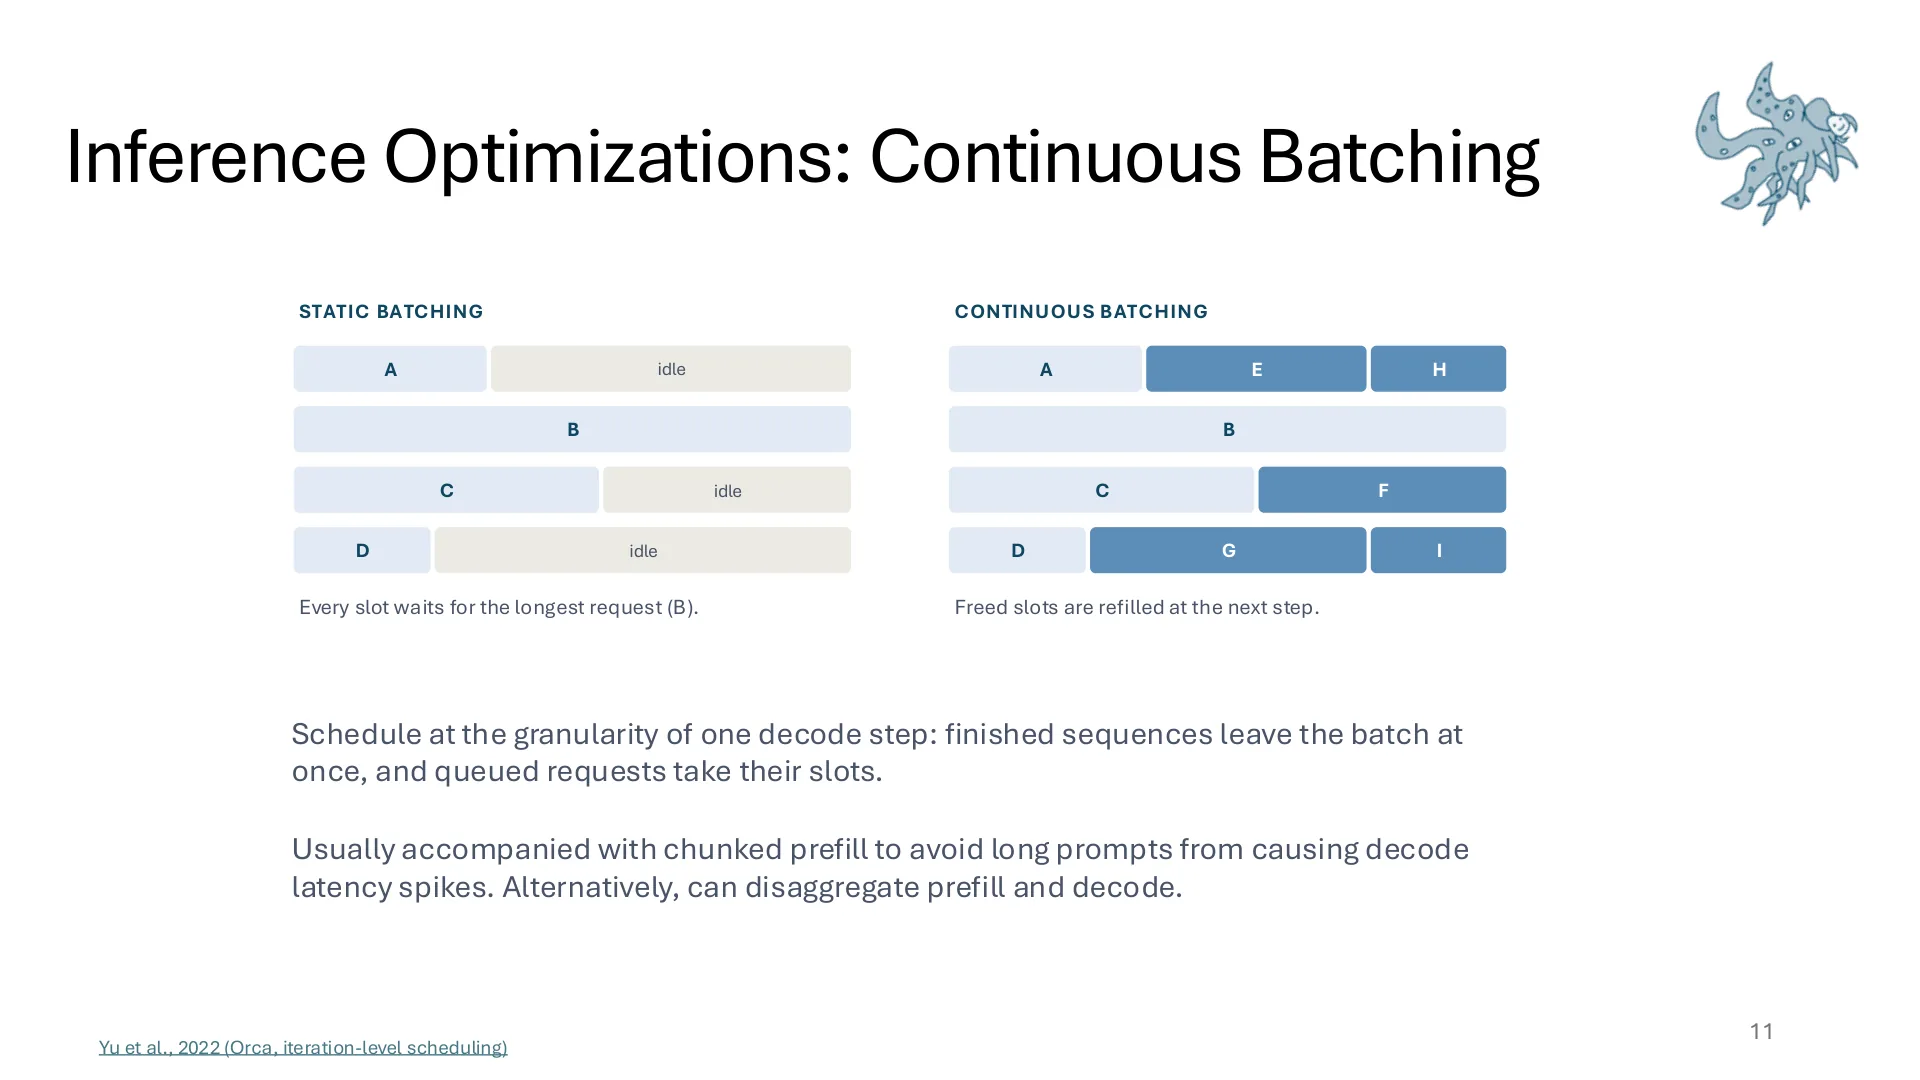
现实比这张示意图复杂一层(13:58):推理不只有 decode,还有 prefill。若把一条超长 prompt 的 prefill 塞进去,所有 decode 都会被阻塞几百毫秒。于是有了 chunked prefill——把长 prompt 切片,与 decode 交错执行;也有了 disaggregated inference——干脆用一组 GPU 专门做 prefill、另一组专门做 decode,中间传 KV。后者还有一个额外好处:prefill 和 decode 对硬件的偏好不同,拆开之后可以为各自挑选更合适的卡。
4.4 Speculative decoding:用小模型猜,用大模型验
做法是让一个小 drafter(单独的模型,或模型自带的 MTP head)连续猜 个 token,再让目标策略一次并行地给这 个位置打分,用拒绝采样决定接受前几个。只要拒绝采样的接受概率设计正确,输出分布与直接用大模型采样完全一致,不是近似(Leviathan et al., 2023)。
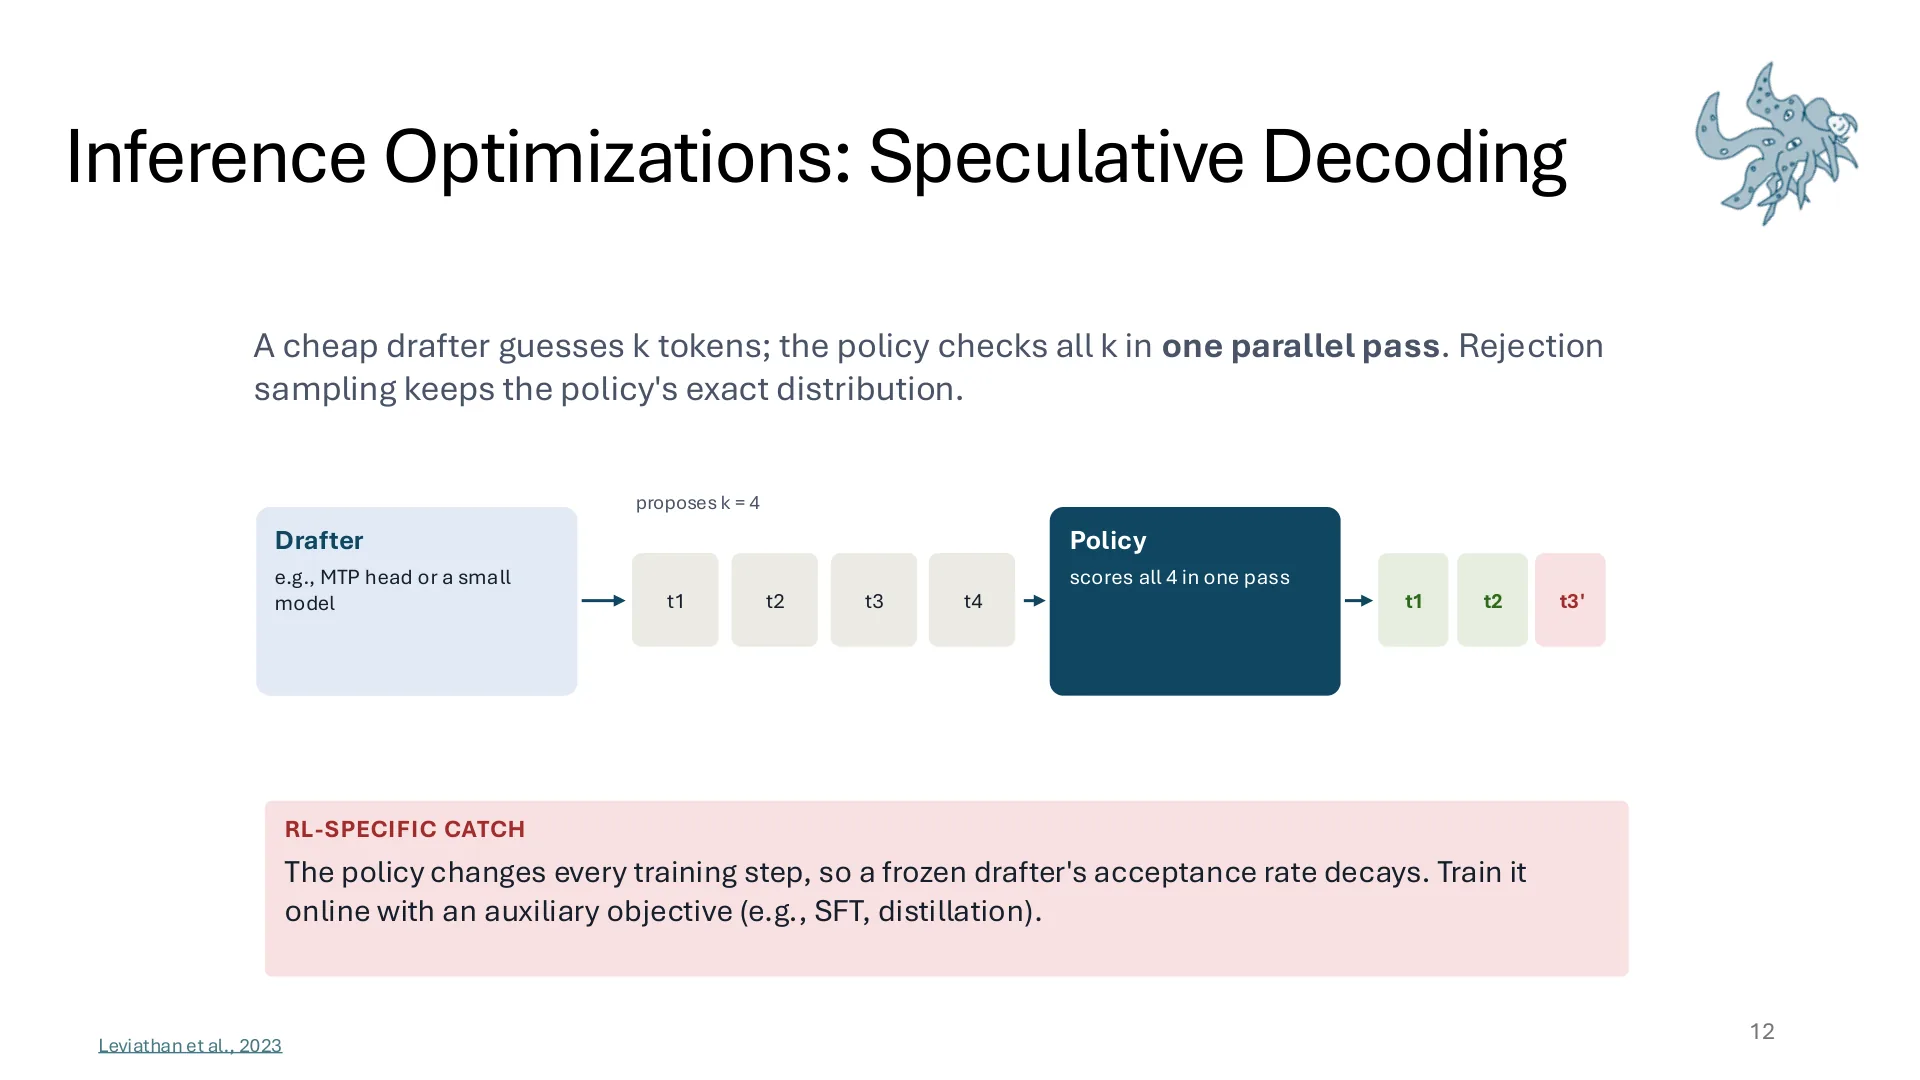
RL 场景有一个专属陷阱:普通推理服务里目标模型是固定的,drafter 训一次可以用很久;RL 里策略每个 step 都在变,冻结的 drafter 会迅速失配,接受率一路下滑,最后"猜四个错四个",投机解码反而变成纯开销。常见的补法是给 drafter 挂一个辅助目标(SFT 或蒸馏),让它跟着策略在线更新。这也说明一个一般规律:推理优化在 RL 里往往要从"一次性配置"变成"持续维护的子系统"。
5. 训练侧:拿计算换显存,拿结构换计算
训练侧的内存压力和推理侧不同:这里的大头不是 KV,而是激活值和计算图。一个 8B 模型、几万 token 的序列、几十层的中间张量,全部留住会直接 OOM。于是训练侧的优化几乎都在做同一件事——用更多计算换更少显存,或用更聪明的批结构换更少重复计算。
5.1 Activation checkpointing
标准做法是前向时把每一层的输入和输出都留着,反向时直接用。checkpointing 只保留每层的输入,把层内激活丢掉;反向走到这一层时,用输入重算一遍内部激活,用完立刻释放。
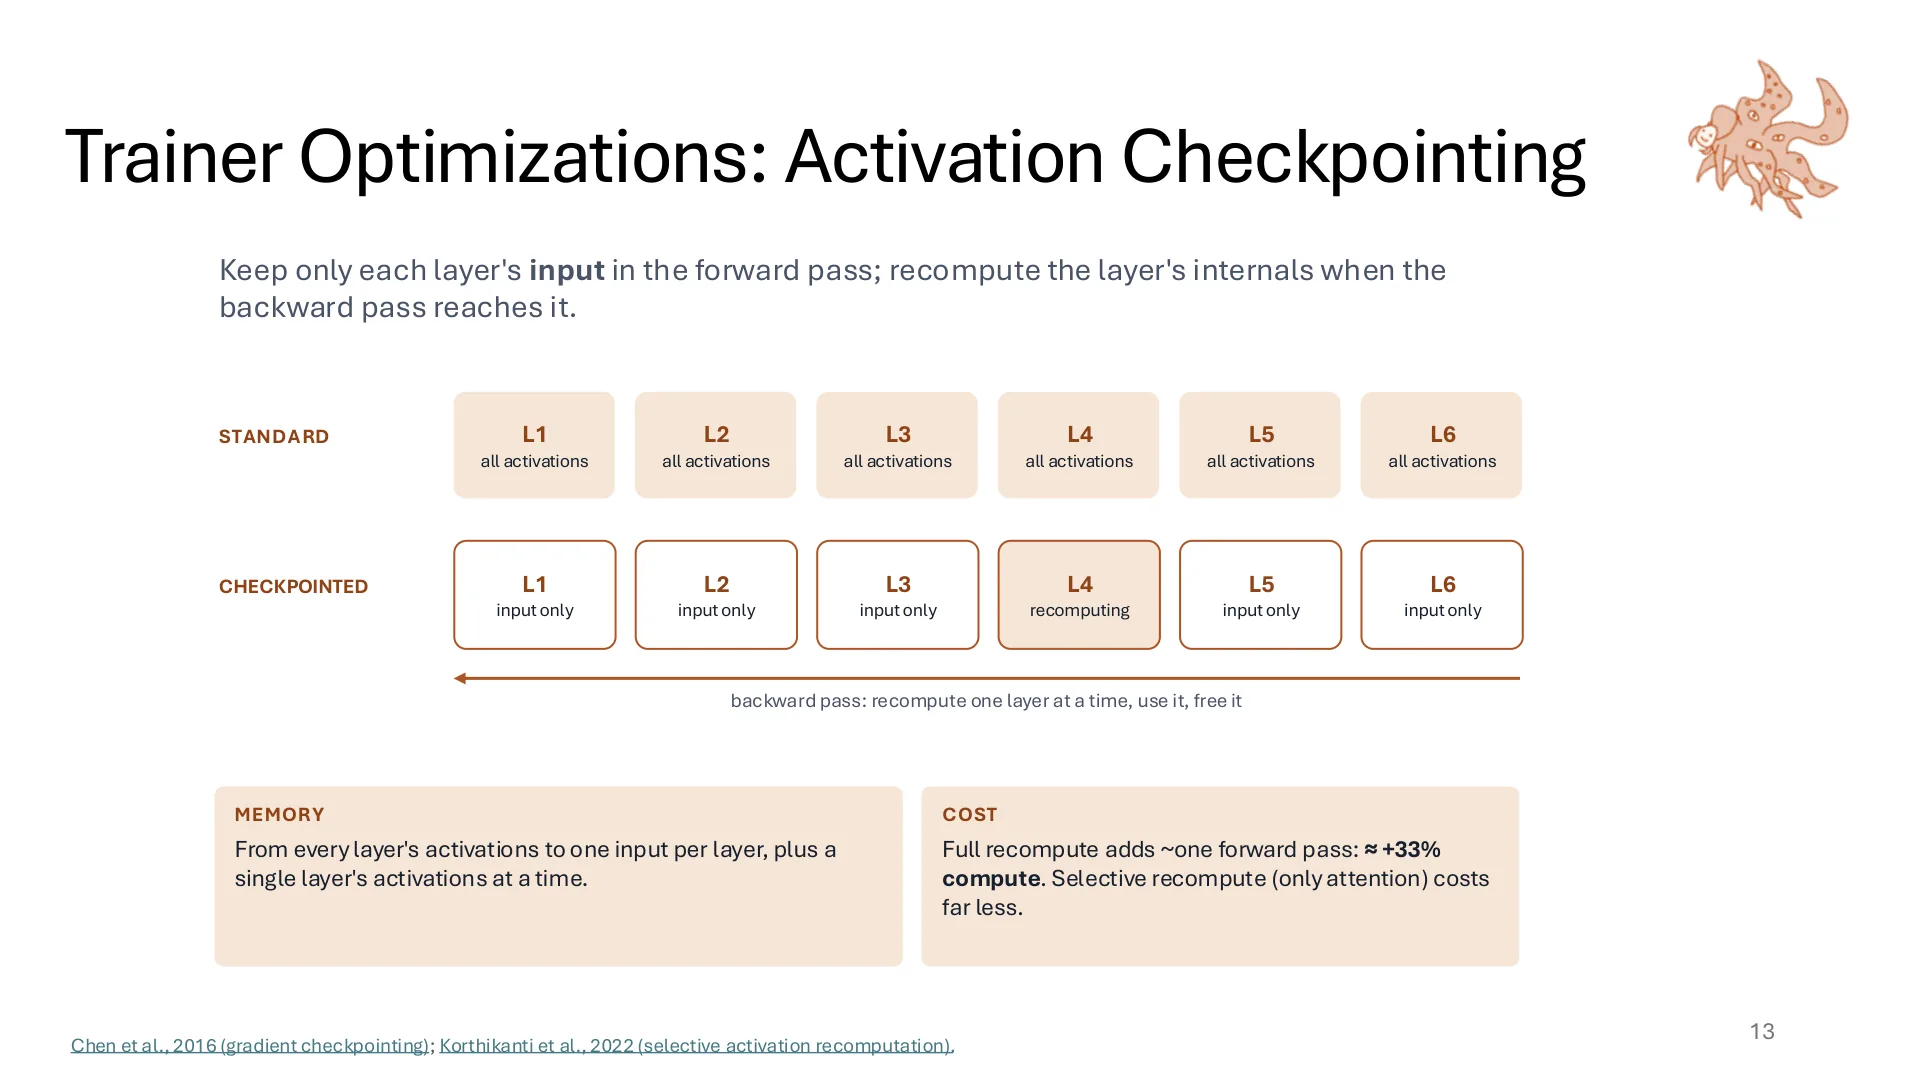
代价很直观:多一次前向,约 +33% 计算(前向约占一次前反向总成本的三分之一)。收益是显存占用从"所有层的激活"降到"每层一个输入,外加同时只有一层的激活"。如果只对注意力部分做选择性重算(Korthikanti et al., 2022),开销还能显著低于 33%。
在显存吃紧时这是"最好的朋友"(21:28):宁可多花 30% 时间,也不要因为 batch 装不下而把有效 batch size 降到梯度噪声失控。
5.2 Prefix sharing:同一件事在训练侧的镜像
推理侧靠前缀缓存省 prefill,训练侧可以做完全对应的事:GRPO 一组的 prompt 相同,多轮轨迹的历史层层嵌套,这些 token 在 batch 里被重复计算了无数遍。做法是把共享前缀只算一次,让各分支挂在它下面。
难点在反向。推理只需要前向,训练却要同时满足三个条件:分支之间不能互相看见(用 tree attention mask 屏蔽跨分支注意力);位置编码要按各自独立序列来编(否则第二条分支的位置会从共享前缀之后继续累加);所有分支的梯度要累加回共享前缀。
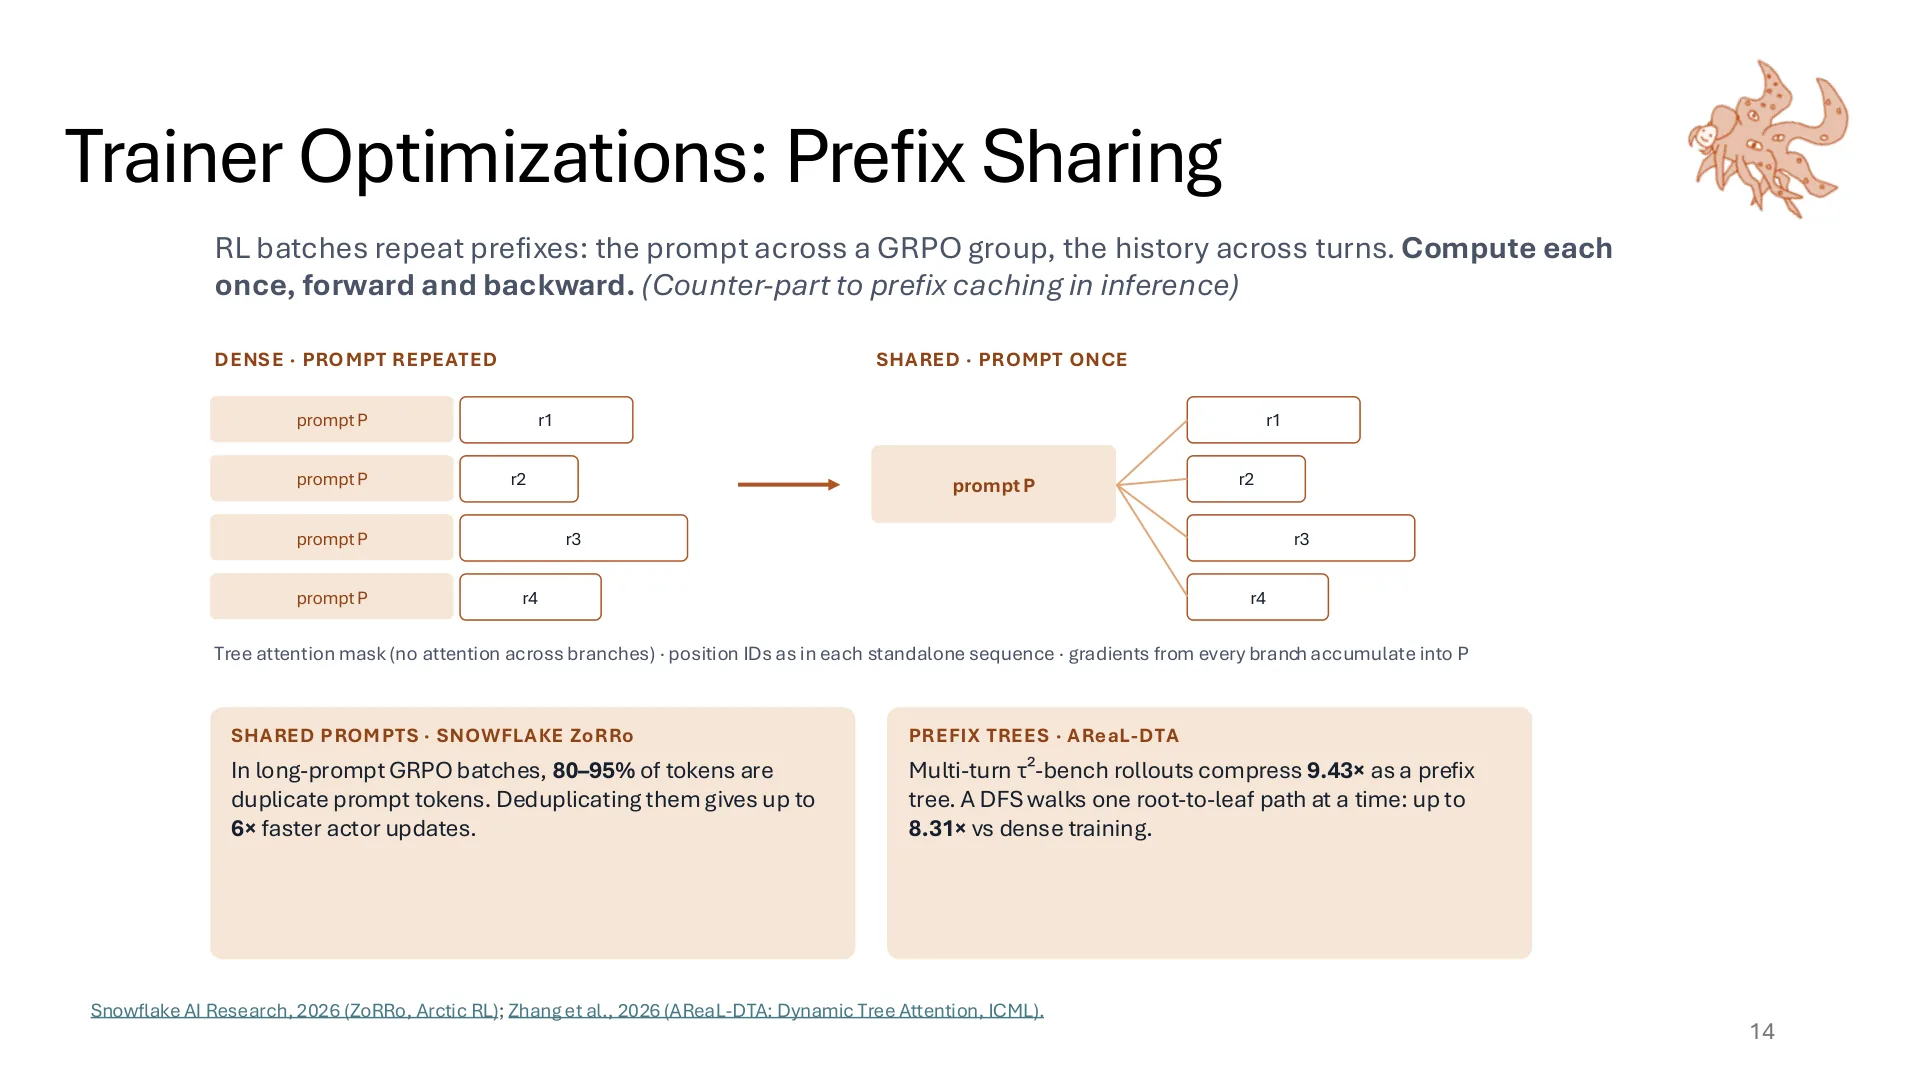
收益已经被量化过。Snowflake 的 ZoRRo 在长 prompt 的 GRPO batch 里观察到 80–95% 的 token 是重复的 prompt token,去重后 actor 更新最多快 6 倍。AReaL 的 Dynamic Tree Attention 把多轮 τ²-bench 轨迹压成一棵前缀树,压缩比 9.43×;由于它用 DFS 一次只走一条根到叶的路径,激活占用不超过单条路径,实测相对 dense 训练最多 8.31×(23:06)。
DFS 这个细节很关键:走到一个分支、做完反向,这条路径的计算图就可以弹栈释放,再回退去走下一条分支。它同时解决了"算力重复"和"激活爆内存"两个问题,代价是调度复杂度——你得先把 batch 组织成树,再按树遍历。
5.3 并行切分:五种刀法,一个取舍原则
模型放不进一张卡,就得切。课程里点到的五种方式各有适用面:
| 方式 | 切什么 | 通信特征 | 典型用途 |
|---|---|---|---|
| Data Parallel | 切 global batch 成 micro batch | 梯度 all-reduce | 首选,通信/计算比最好 |
| Pipeline Parallel | 按层切 stage | 只在 stage 边界传激活 | 层数深、单机放不下 |
| Expert Parallel | MoE 专家分到不同 rank | all-to-all | 稀疏专家模型 |
| Tensor Parallel | 切单个矩阵乘 | 每层都要 all-reduce,最贵 | 单机内、NVLink 域内 |
| Context Parallel | 切序列维度 | 传 KV | 超长序列 |
实践中的经验法则很朴素:尽量把并行度花在 data parallel 上,把 tensor parallel 压到最小,因为它每一步都要通信,且只能待在网络最快的同一个节点里。micro batch 的装箱也有讲究:给定"这张卡能处理 4 万 token"的预算,把长短不一的序列装进固定容量的桶里,是典型的 bin packing 问题,装得好不好直接体现在 MFU 上。
6. 两个引擎之间的接缝
6.1 权重同步:从 2TB 到 20GB
一个 1T 参数的模型,bf16 下约 2TB。如果每个 RL step 都把这 2TB 广播给所有推理 rank,网络会立刻成为瓶颈,跨集群训练更是无从谈起。
但 RL 更新有一个很好的性质:稀疏。在 bf16 下,约 99% 的参数在两次更新之间逐比特未变——原因也不神秘,outcome reward 下每条轨迹的监督信号很弱,很多更新小到落在 bf16 尾数(约 7 位)之下,被直接舍入掉(29:33)。于是可以只同步 delta:传输量从 2TB 降到 20–30GB,这个量级已经可以走对象存储、跨集群搬运了。
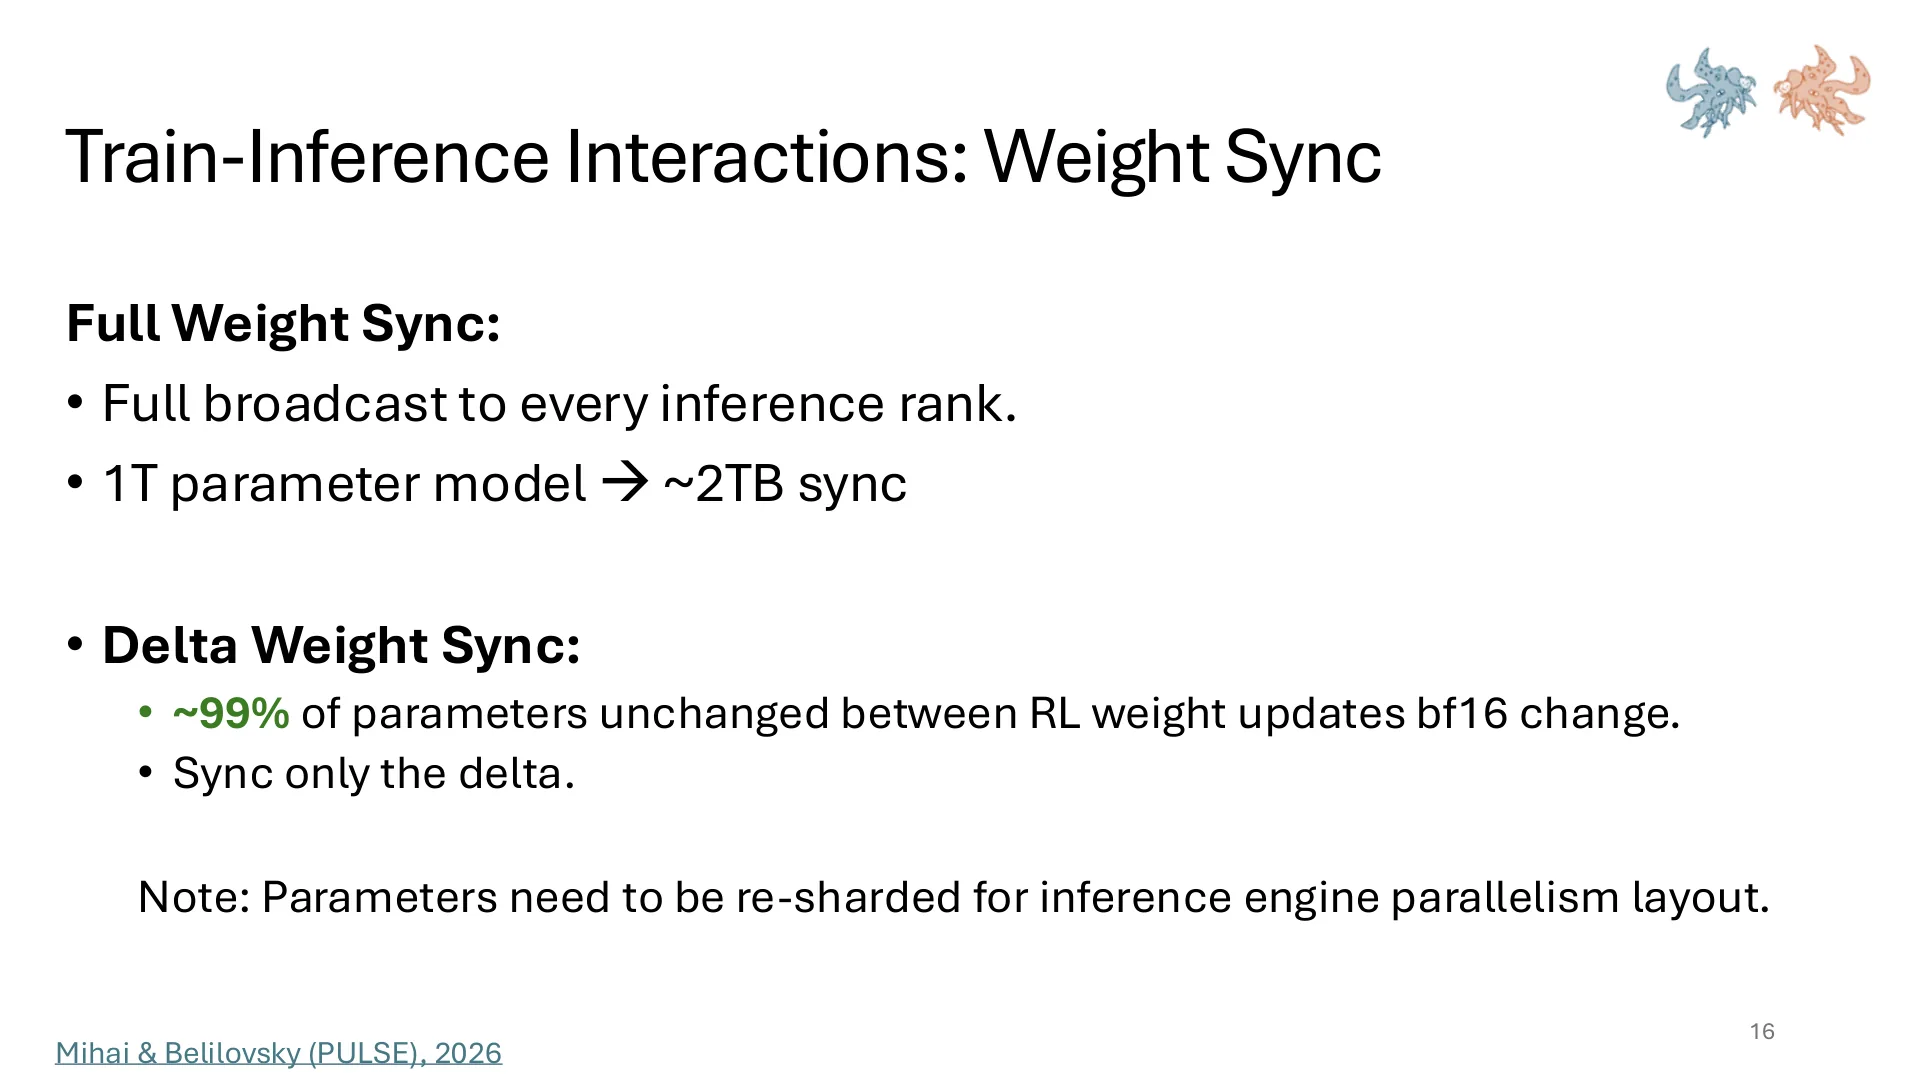
两个必须说清的边界。第一,delta 同步不是无损压缩,它依赖"大部分参数没变"这个经验事实;如果换了全参更新、更高精度或更大的学习率,稀疏性会下降。第二,"99% 没变"听起来像在丢信号,但被舍入掉的更新如果重要,下一个 step 会以更大的幅度出现——这是 bf16 训练本来就接受的近似,不是 delta 同步额外引入的。
6.2 R3:MoE 的路由也会 off-policy
MoE 模型在前向时要为每个 token 选专家。路由是 argmax 或 top-k,在临界点上对数值极度敏感:推理引擎和训练引擎的 kernel 有微小差异,就可能一个选专家 1、另一个选专家 3。一旦路由不同,训练引擎算出的前向就和产生这条轨迹的前向不是同一个函数——即使权重一模一样,也已经是 off-policy。
R3(Rollout Routing Replay, Ma et al., 2025)的解法直白到有点笨:rollout 时把每个 token 的专家选择记下来,随轨迹数据一起交给训练引擎;训练引擎前向时丢弃自己的路由结果,强制重放记录下来的选择。
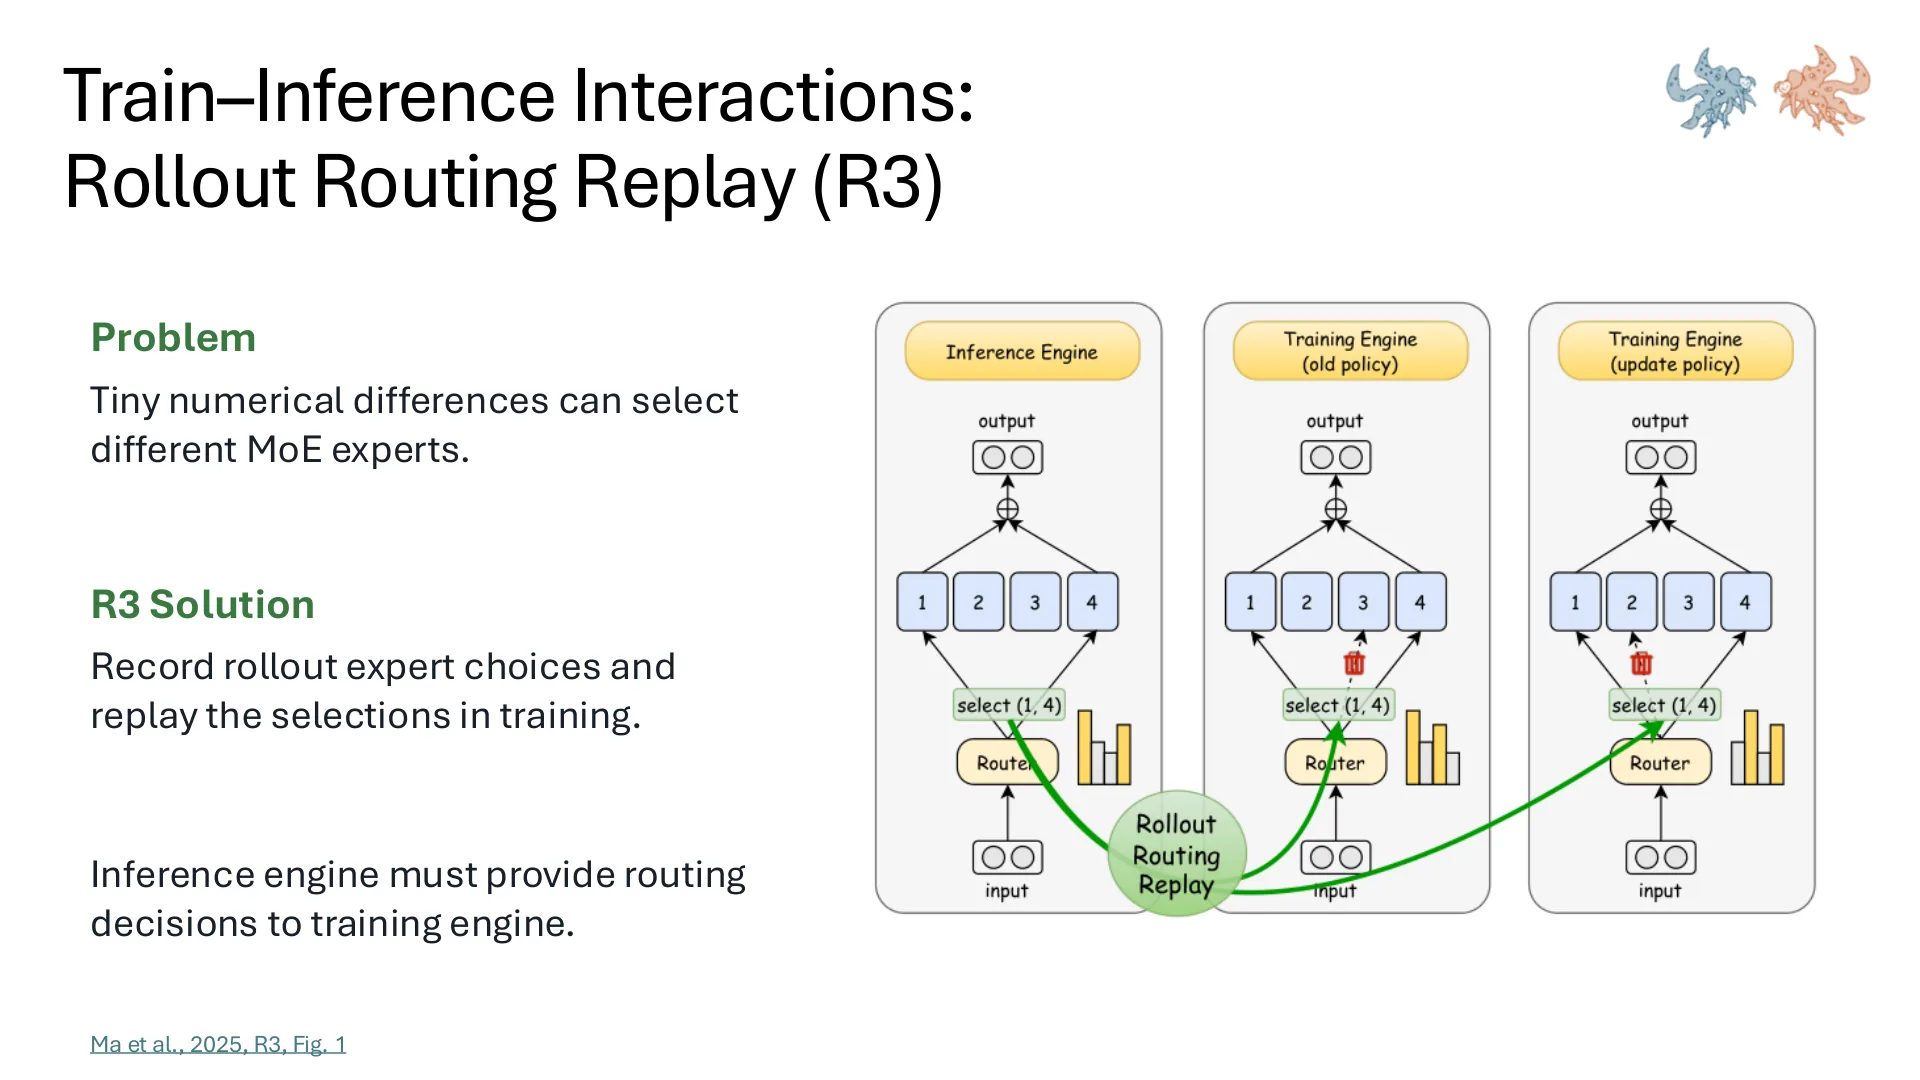
这项工作带来一个系统性后果:推理引擎必须把路由决策暴露给训练引擎,这不是任何标准推理 API 都有的字段。也就是说,一项训练稳定性的需求,反向塑造了服务之间的接口(33:35)。实践建议也很直接:训练 MoE 时如果 reward 长期不涨,先确认 R3 有没有开。
7. Agentic RL 的尖刺:序列延展与 chat template
到这里为止的讨论对 reasoning RL 也成立。真正让 agent RL 与众不同的是轨迹的结构:它不是一段文本,而是"任务、动作、观测、动作、观测……"的交替,而且每一步都是独立的 LLM 请求。
7.1 两种 harness,一个问题
考虑两种构造历史的方式。Harness A 老老实实追加:第 步的历史就是前 步的完整拼接。Harness B 定期压缩:每两步把之前的动作与观测摘要成一段 ,后续只带 和 (这就是 Codex、Claude Code、OpenHands 在生产里做的 context compaction)。
课堂上先做了投票,多数人猜 B 更省——毕竟历史变短了。答案是 A 更适合训练(38:35),理由不在长度,而在前缀是否连续。
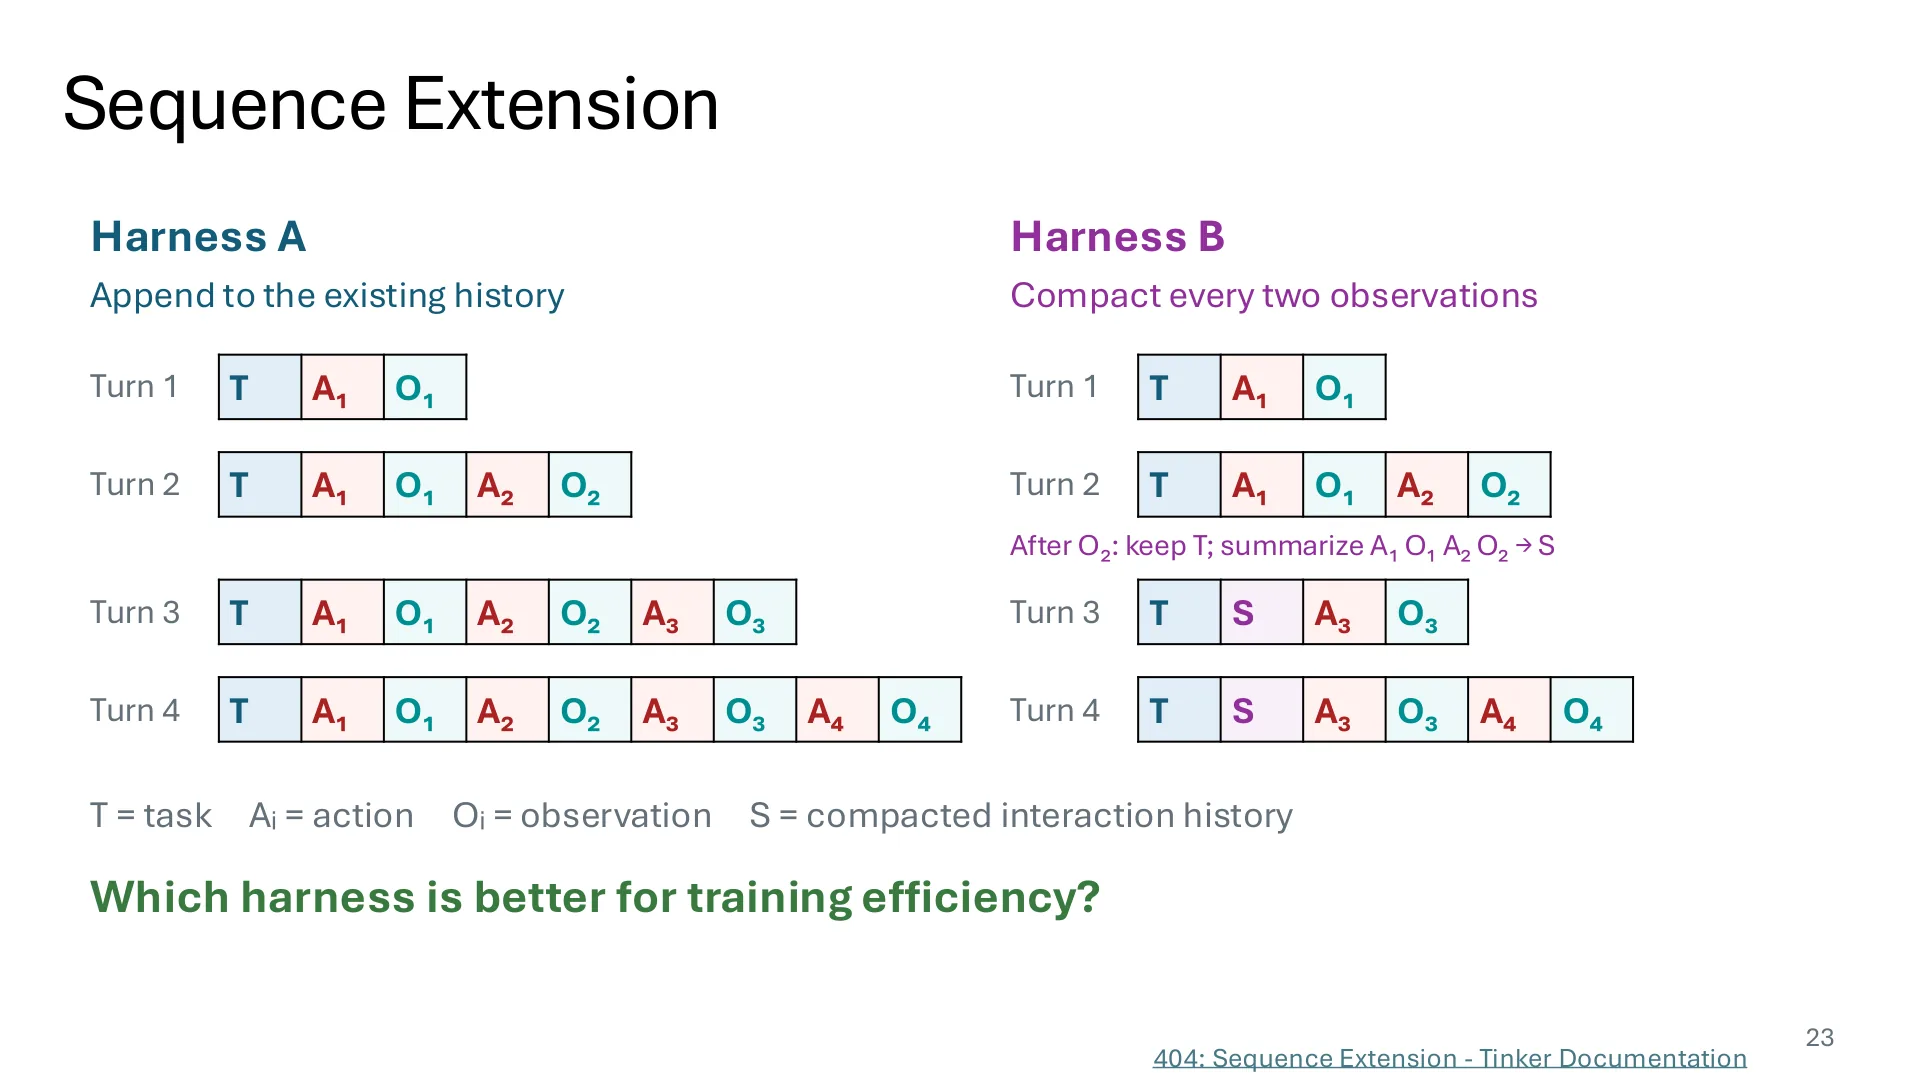
在 A 里,第 4 轮的历史严格以第 3 轮为前缀,整条轨迹可以当成一个 datapoint:一次前向覆盖全部 token,共享前缀只算一次。在 B 里,压缩点把序列切成两段互不为前缀的序列,你被迫拆成两个 datapoint,而这两个 datapoint 都要带 task prompt——于是同一段 prompt 被 prefill 了两遍。
7.2 训练 batch 长什么样
拆开看更清楚。Harness A 的一个 datapoint 里,token 分三类:任务与观测是"上下文",动作是"要学的部分"。loss mask 在动作 token 上置 1、其余置 0;优势 是整条轨迹一个标量,广播到每个动作 token。
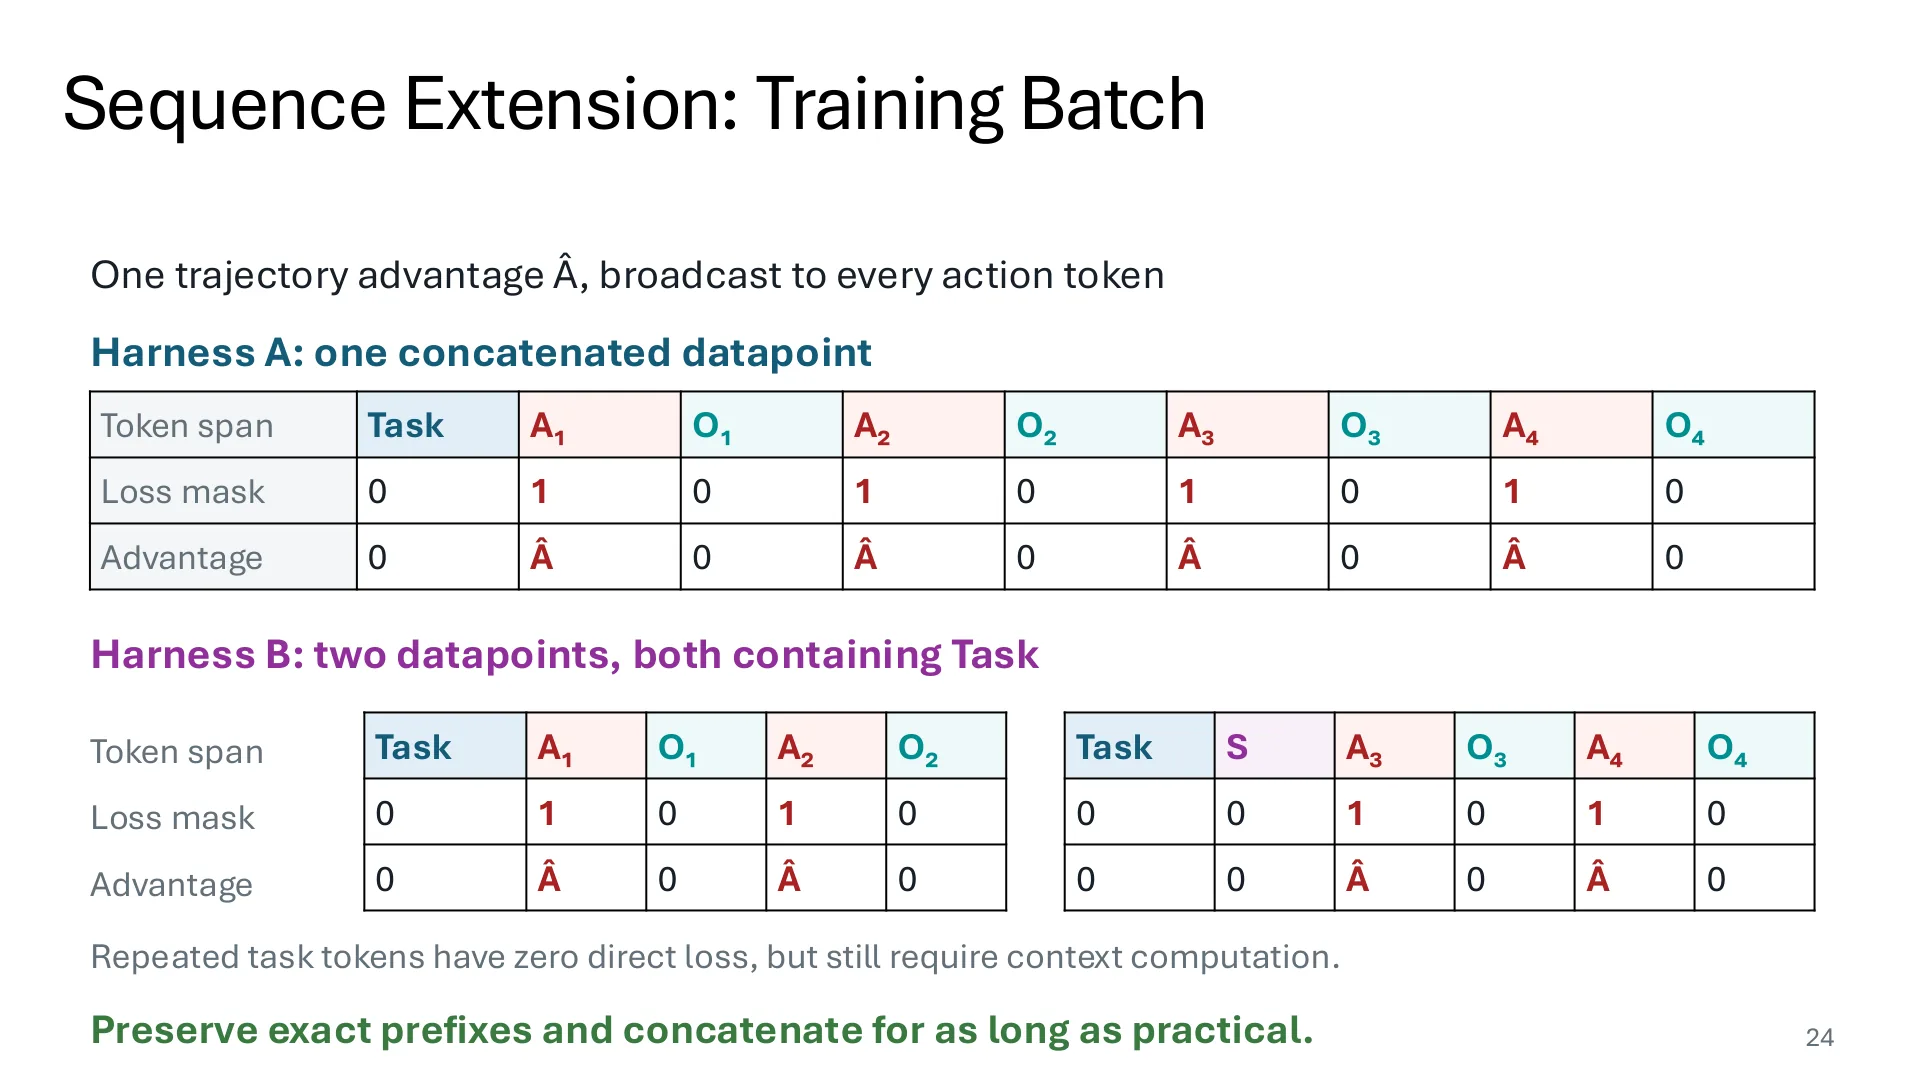
Harness B 的问题在图上一目了然:两个 datapoint 都含 Task,重复的 task token 虽然 loss mask 为 0(不直接产生梯度),却仍然要走完前向的上下文计算。省下的历史长度,被重复的 prompt 和断开的缓存又吃回去了。
结论是一句可以直接当规范用的话:尽量保留精确前缀,能拼多长就拼多长。 这也是为什么 AReaL-DTA 那类前缀树技术不是"锦上添花"——一旦 harness 必须压缩,你就只能靠树结构把重复的 prompt 计算救回来。
这里还藏着一个更深的教学点:整条轨迹共用一个 ,意味着 credit assignment 被粗化了。第 1 步的关键决策和第 9 步的无关动作拿到同样的权重。这是 outcome reward 的固有代价,也是 process reward、turn-level advantage 等方向存在的动机。
7.3 Chat template:一个不起眼的正确性 bug
前缀能被复用的前提是"逐 token 一致"。而主流模型的默认 chat template 恰恰不保证这一点。Qwen 3 / Qwen 3.5 的默认模板在渲染下一条 user turn 时,会把历史里的 reasoning 内容删掉——大概是为了省 context、也避免思维链干扰后续判断。
后果是灾难性的:第 2 轮的 prompt 不再以第 1 轮为前缀,两者在 reasoning 那一段就分叉了(41:02)。前缀缓存全部失效,训练侧也无法把多轮拼成一个 datapoint,等于强制退化到 Harness B。
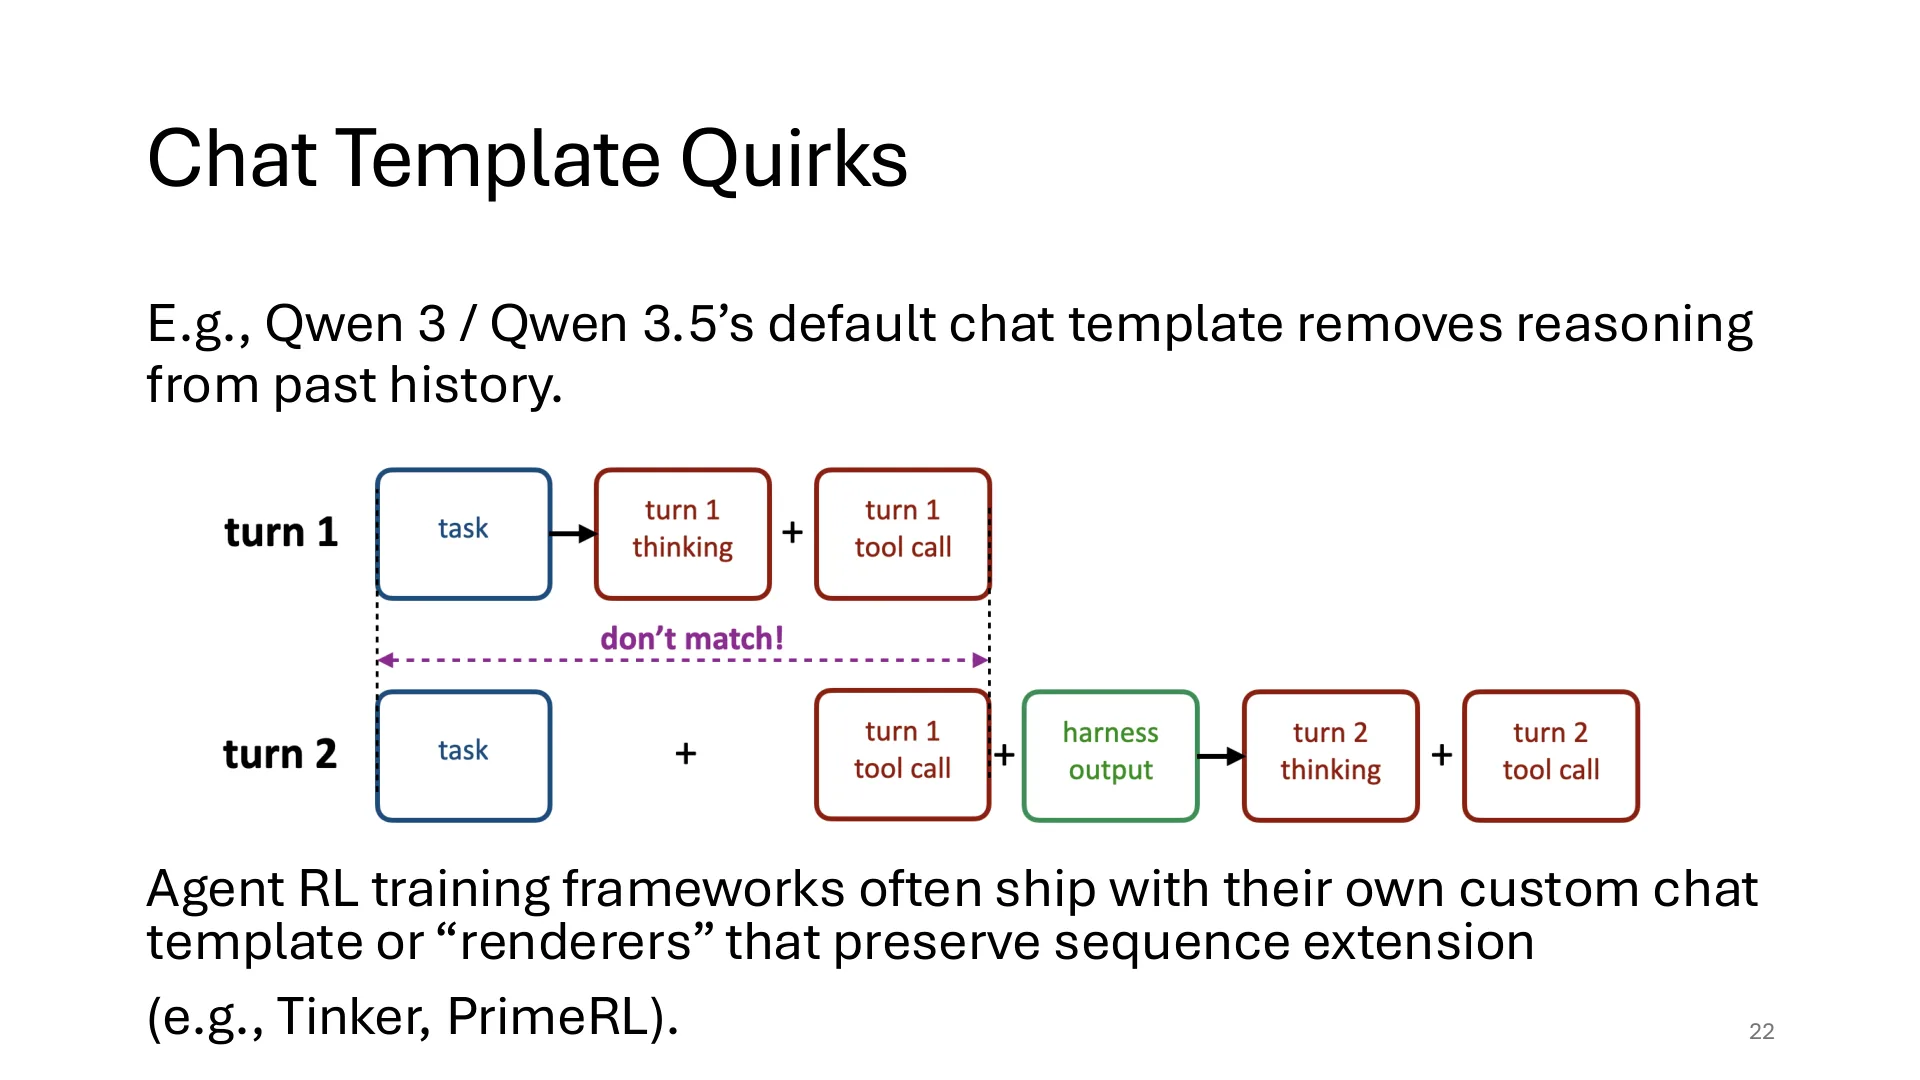
所以 agent RL 框架普遍自带 chat template,现在多称为 renderer:它把"如何把消息列表渲染成 token 序列"从模型厂商的默认行为里接管过来,并提供开关(保留历史 reasoning / 一律不保留)。这类组件看起来像格式化工具,实际上是训练正确性的一部分——它决定了缓存能否命中、batch 能否合并、梯度是否对应你采样时的那个分布。
8. TITO:为什么轨迹要以 token 传输
一个看似无害的设计问题:推理引擎把轨迹交给训练引擎,用什么格式?
最自然的选择是 string——毕竟 OpenAI 风格的 API 都是 messages + content 字符串,prompt 工程、输出解析也都在字符串空间里做。早期框架大多这么干,然后普遍遇到 loss spike 与训练不稳(45:03)。
第一个原因是字符串空间的微小变换会改变 tokenization。训练侧的模板多插一个空格、换行位置差一点,重新 tokenize 出来的 token 序列就和推理侧不同。你于是在用 A 序列的梯度去更新 B 序列上采样的策略。
第二个原因更本质:tokenize 是一对一的,detokenize 是多对一的。 "Hello" 可以编码成单个 token 4,也可以编码成 1 和 5 两个 token;两者 detokenize 回字符串都是 "Hello"。如果轨迹以字符串形式传回训练侧,训练侧重新 tokenize 只会得到它心里的那个"规范"编码(比如 4),而推理时模型实际产出的是 1 和 5。
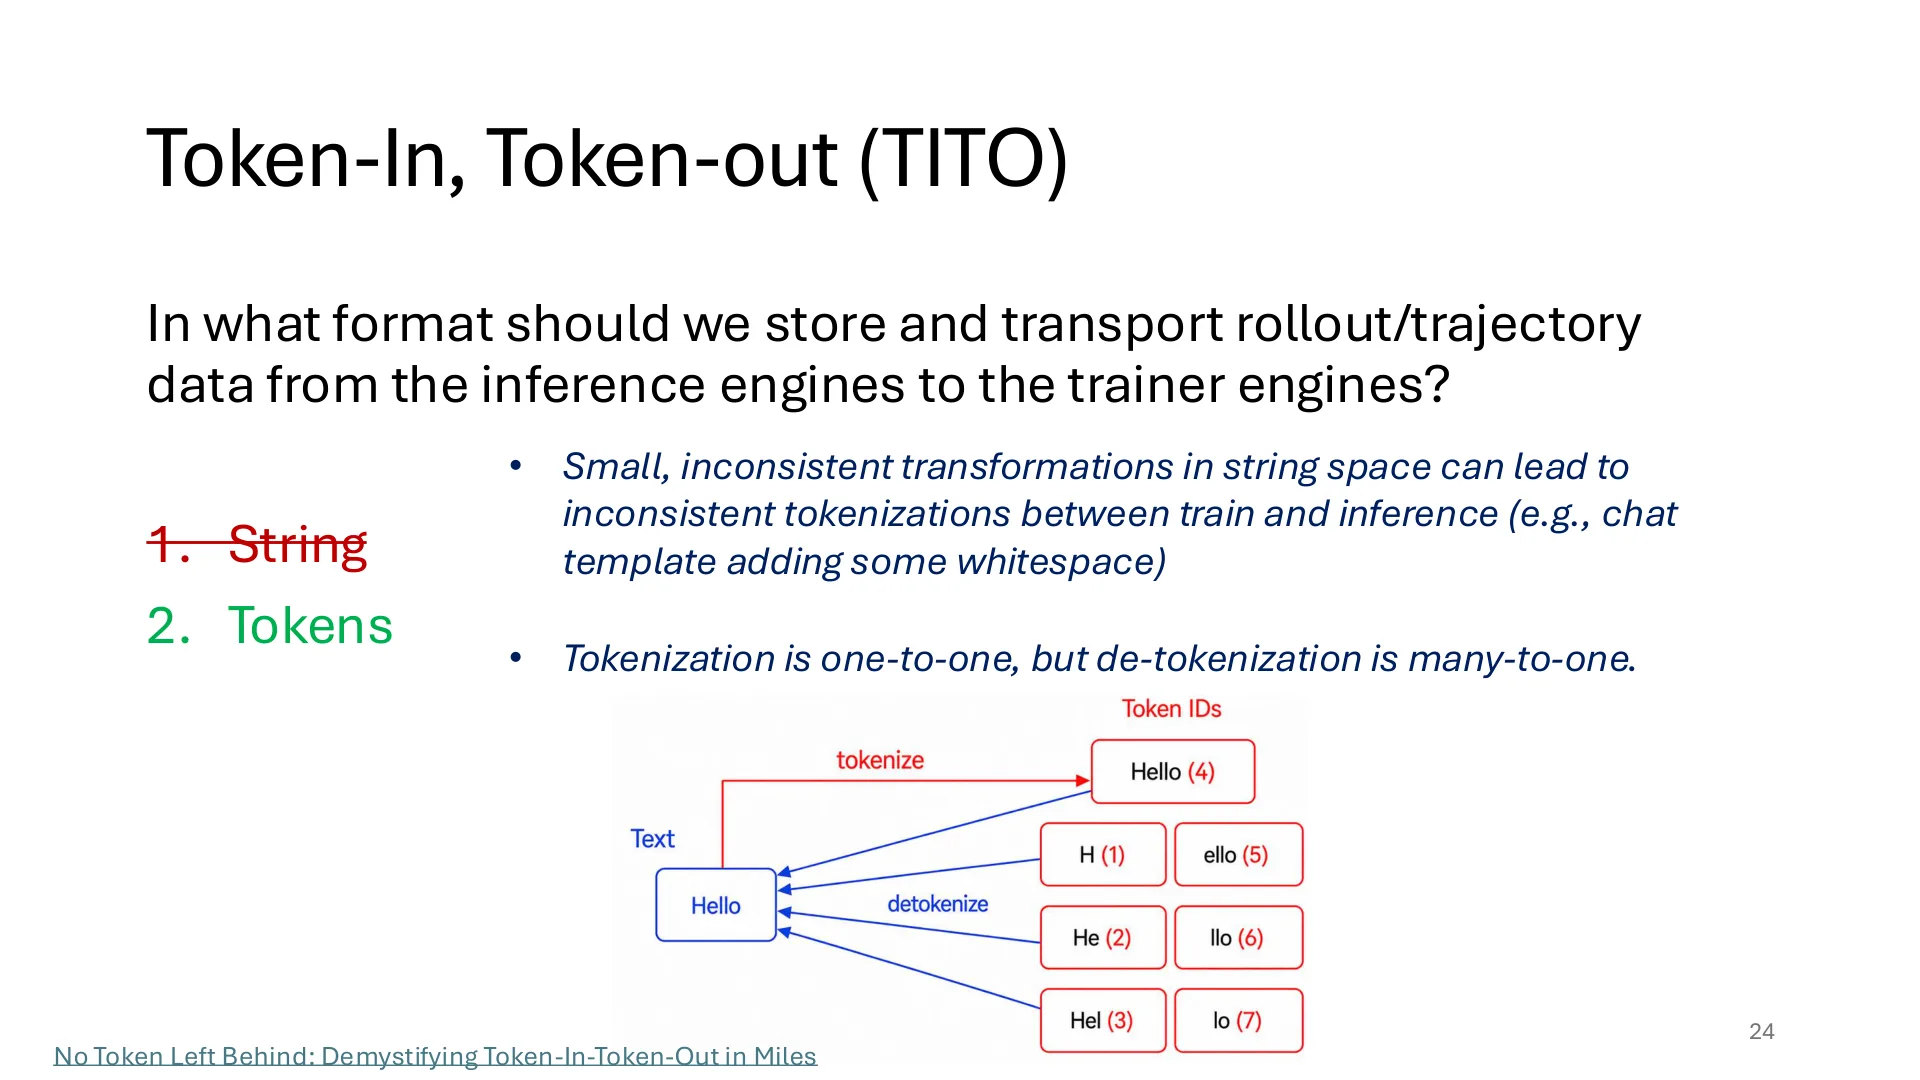
后果不只是 token 不同,而是概率对不上:同一个字符串在不同切分下概率完全不同,重要性比率 会凭空出现偏差。这也解释了为什么现在的框架几乎都把 token ID(以及 rollout 时的 logprob)作为一等公民存下来、直接送进训练引擎。
讲师提醒:凡是"把结构化数据序列化成文本再解析回来"的地方,都在引入不可见的分布偏移。TITO 是这条原则在 RL 系统里最典型的应用:能让下游拿到原始 token,就不要让它重新编码。
9. 同步、异步与“飞行中”的权重更新
同步 RL 的做法是让训练与推理共置:8 张卡先全用于训练,训完把训练引擎挂起、唤醒推理引擎做 rollout,做完再换回来。简单、正确,但在 agent 场景里浪费严重——轨迹长度差异极大,一批里只要有一条超长轨迹,其余卡就全在等。而 rollout 恰恰是 agent RL 的瓶颈(47:30)。
异步 RL 把 GPU 池切开:一部分常驻推理、一部分常驻训练,两者始终同时工作。这样还能按负载分配比例——常见的是 3:1,把更多算力给推理,因为长轨迹的 decode 是主要开销。代价是数据变旧:训练时用的轨迹可能来自几个版本之前的策略,必须做 staleness 修正与 off-policy 校正。
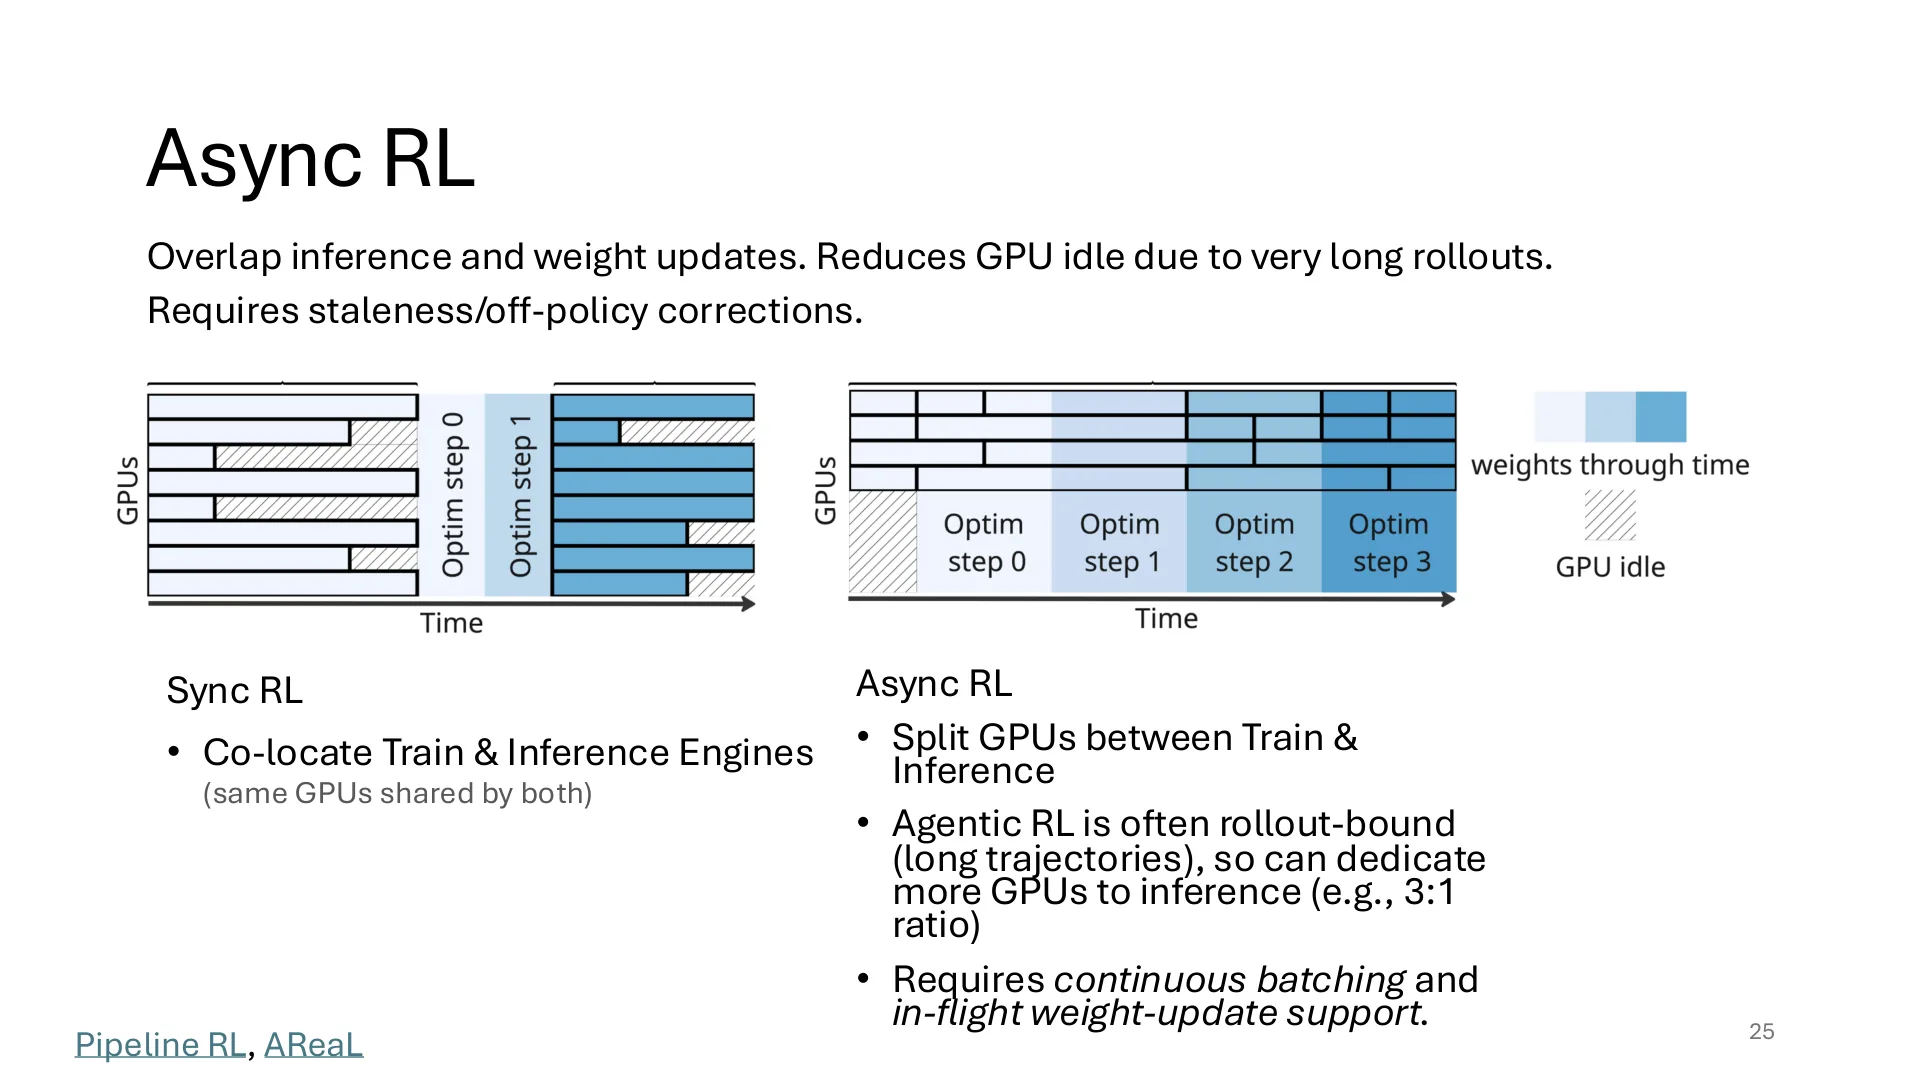
异步还带来一个非常"RL 特有"的工程需求:in-flight weight update。推理服务可能正在生成一条很长的轨迹,此时新权重到了,系统需要在不杀死请求的前提下切换模型。SGLang 为此提供了 pause generation 一类的接口,其中 retract 模式不仅暂停,还会清空 KV cache——因为前缀的 KV 是用旧权重算出来的,权重一换,这些 KV 就是错的,必须用新模型重算。
这一步很能说明"两个引擎"的代价:在单体系统里根本不存在"KV 过期"这个问题,因为你不会在生成中途换权重;一旦拆开,缓存的一致性就成了必须显式处理的协议。
10. 系统设计:三条路线
10.1 Harness 无关:中间人代理
agent harness 生态极其碎片化:Codex、Claude Code、OpenHands、Pi、Hermes、Prime Agent……每隔几周就有新的。如果每接一个 harness 就要改一次训练框架,工程上不可持续。
主流解法是在 harness 与推理引擎之间放一个中间人(middleman / proxy):它对外伪装成 harness 已经在说的那套 API(chat completions、responses、anthropic messages),把请求转发给推理引擎,把响应转发回 harness,同时在中间把训练需要的东西存下来——每个 token 的 logprob、MoE 路由(R3 需要)、以及其他元数据(54:00)。
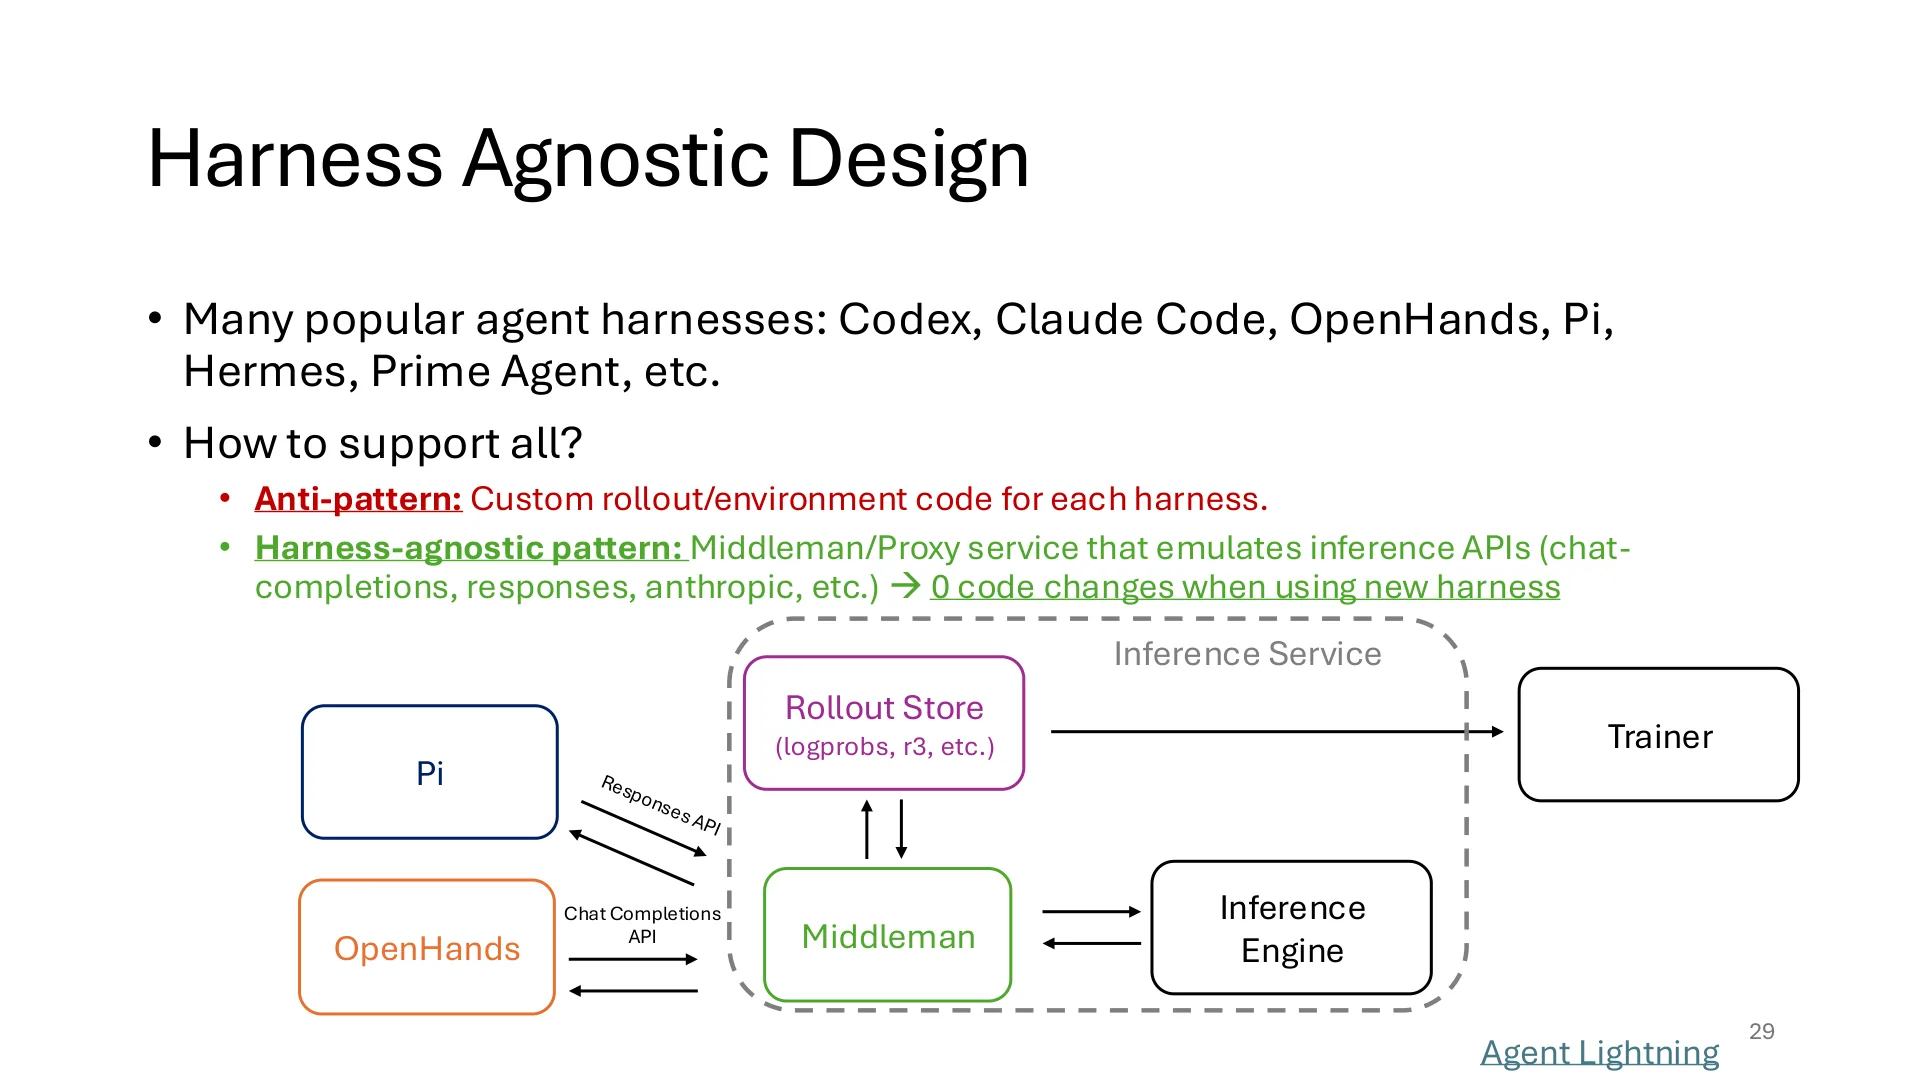
这个模式的好处是"零代码改动":因为 harness 本来就说标准 API,所以换 harness 只是换一个客户端。反模式则是为每个 harness 写一套 rollout/环境适配层——那是 O(harness 数量) 的维护成本。代价是中间人处在关键路径上,它的延迟与可靠性直接影响 rollout 吞吐,而且它必须理解多种 API 方言。
10.2 SPMD:一个程序跑遍所有卡
另一种经典写法是 Single Program Multiple Data:所有 rank 跑同一份 Python 程序,靠 rank 分支决定自己干训练还是推理。
rank = dist.get_rank()
train = dist.new_group([0, 1, 2, 3])
infer = dist.new_group([4, 5, 6, 7])

if rank < 4:                      # 训练侧
    while True:
        batch = next_batch_shard(train)
        forward_backward(batch, train)
        optimizer.step()
        publish_weights_async(train)
else:                             # 推理侧
    while True:
        refresh_weights_if_ready(infer)
        prompt = next_prompt(infer)
        trace = rollout(prompt, infer)
        enqueue_trajectory(trace, infer)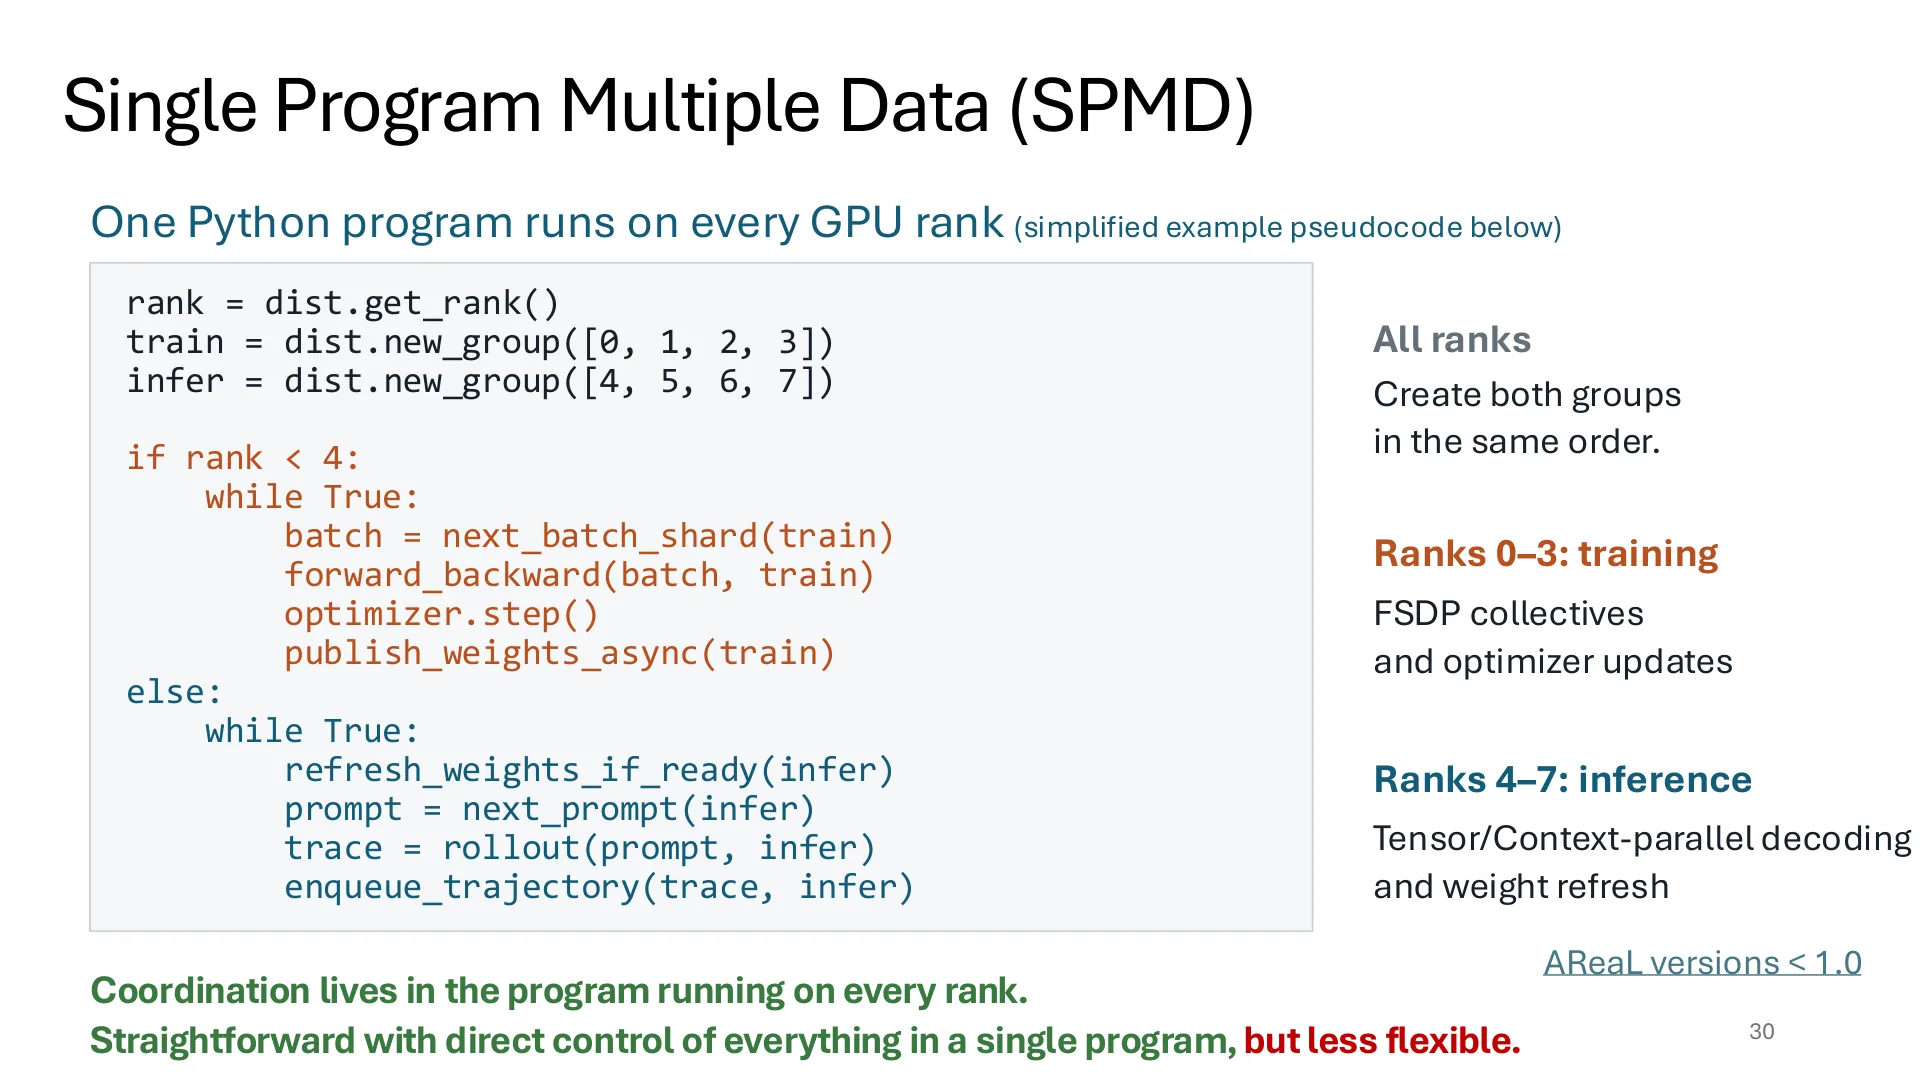
它的优点是一切都在一个程序里:谁在等谁、权重从哪来到哪去,读代码就能看懂,改起来也直接。AReaL 1.0 之前就是这么写的。缺点是扩展性差:想加一类服务、想接异构硬件、想在不重启的情况下换拓扑,都要动主程序;任何一处阻塞都会拖住所有 rank。
10.3 Everything-as-a-service:单控制器 + 标准协议
第三条路是把每个部件做成独立服务,由一个轻量控制器编排:Agent Service、Env/Reward Service、Inference Service、Trainer Service、Weight Sync Service,各自说自己的标准协议。
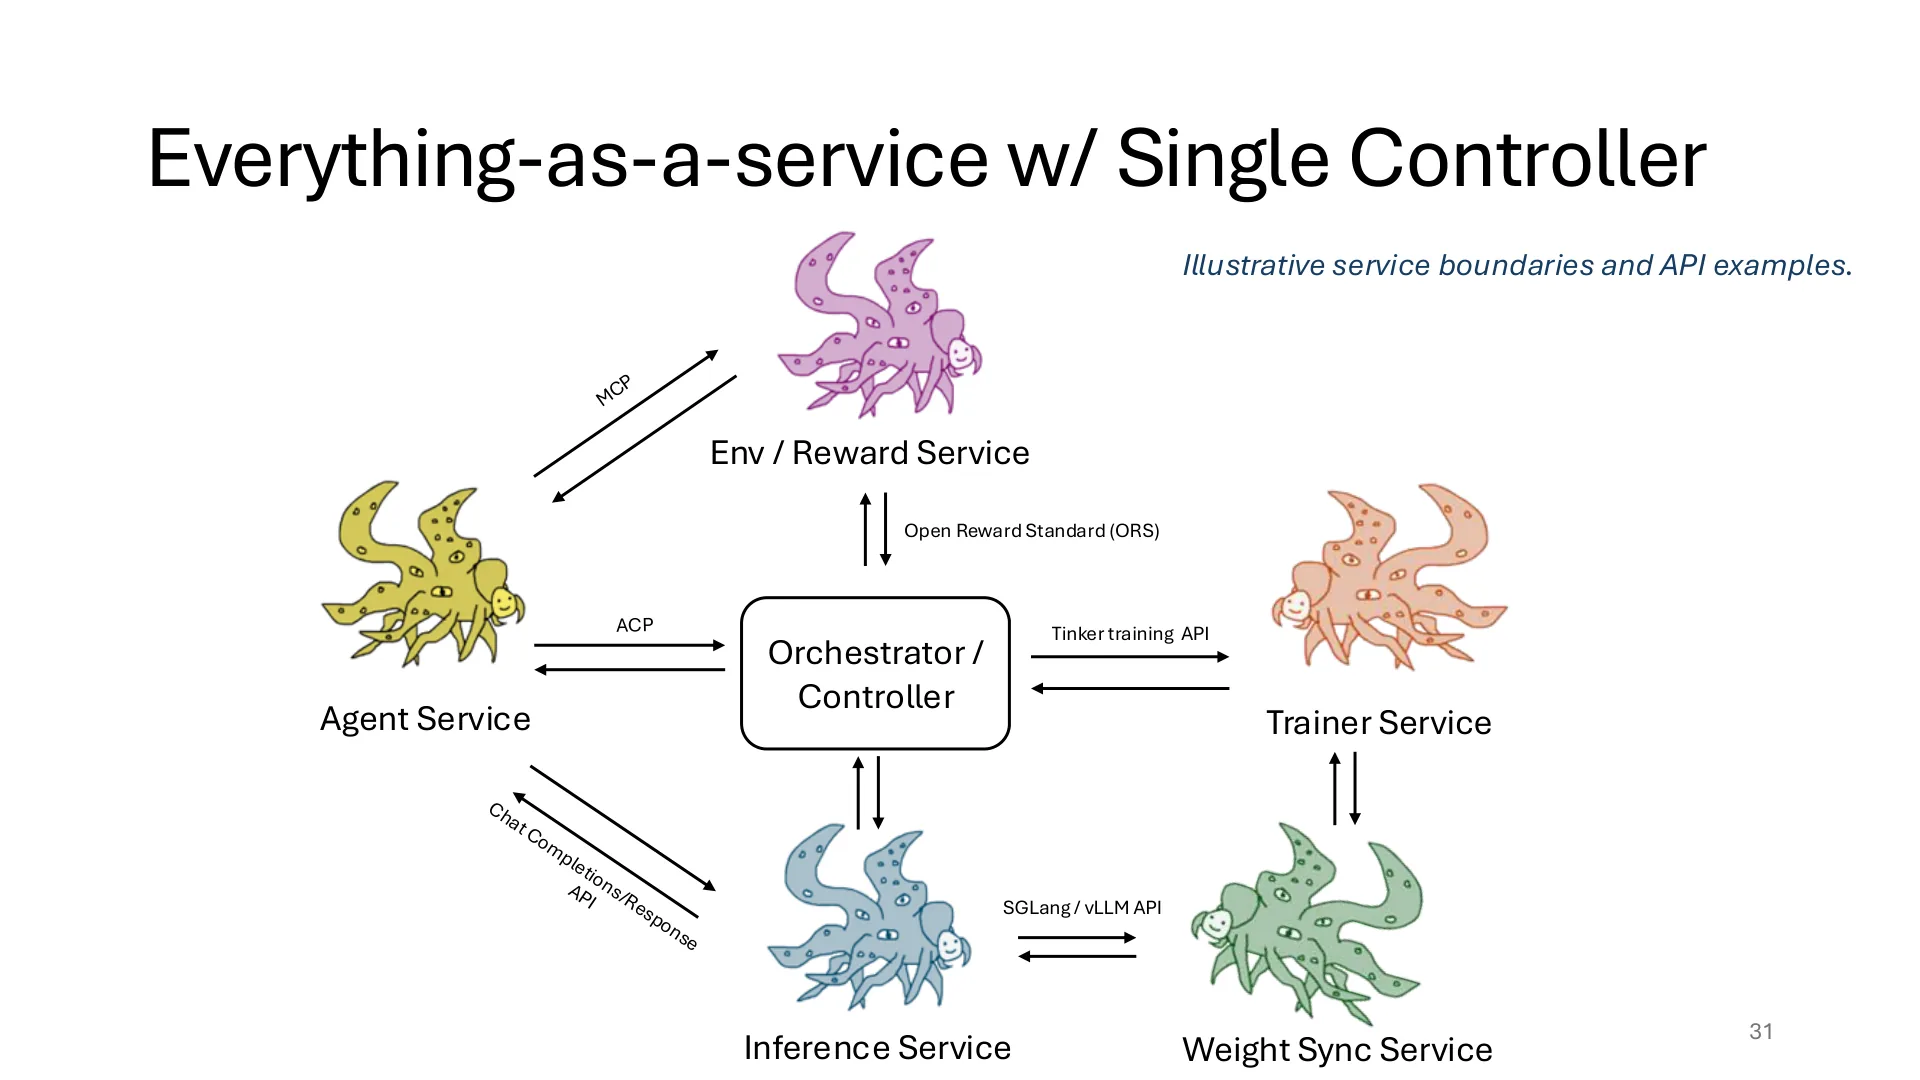
好处可以逐条对上前面讲过的痛点:
- 关注点分离:推理与训练各自是极复杂的系统,独立演进;控制器只是一个 CPU 上的轻量 loop,不需要 GPU、不需要重依赖,研究者可以在一台笔记本上改算法。
- 可替换性:只要协议一致,推理引擎可以在 vLLM 与 SGLang 之间换,训练后端可以在不同实现之间换;Tinker API 已成为事实上的训练接口,多个开源框架都实现了它。
- 弹性与异构:推理服务可以从一个扩到多个,控制器按需调度;不同服务甚至能跑在不同厂商的卡上(8×H100 与 4×Mi350 并存)。
- 多策略:不同 trainer 服务不同模型,就能做异构多智能体训练。
代价是运维复杂度上升:服务发现、容错、跨服务数据一致性都要自己处理;调试一个跨五个服务的 bug 也比读一个 Python 文件难得多。这不是"更好",而是"规模变了之后的必然"。
11. 服务化之后能做什么
解耦不是为了架构图好看,它解锁了几类以前很难做的事。
弹性扩缩与异构算力:训练中临时拿到一批卡,直接多起一个推理服务挂到控制器上即可;不同集群、不同型号的机器可以混用,因为服务之间只通过 API 通信。
在线 RL:把生产中的 harness 当成一个持续产出轨迹的服务,就能在部署之后继续训练。Cursor 公开的做法是 Tab 与 Composer 两条线都在持续收集真实交互;Composer 每 5 小时就能产出一个新 checkpoint(62:03)。这要求系统能长期稳定运行、能处理分布漂移、还要有回滚机制。
多租户、多 LoRA:一个训练服务同时服务很多用户,每人训自己的 LoRA adapter。SkyRL 与 Trajectory Labs 的实测(GSM8K、Qwen3-4B,8 条并发 vs 8 条串行)显示:并发总吞吐显著更高,但单条 run 的端到端时间变长。
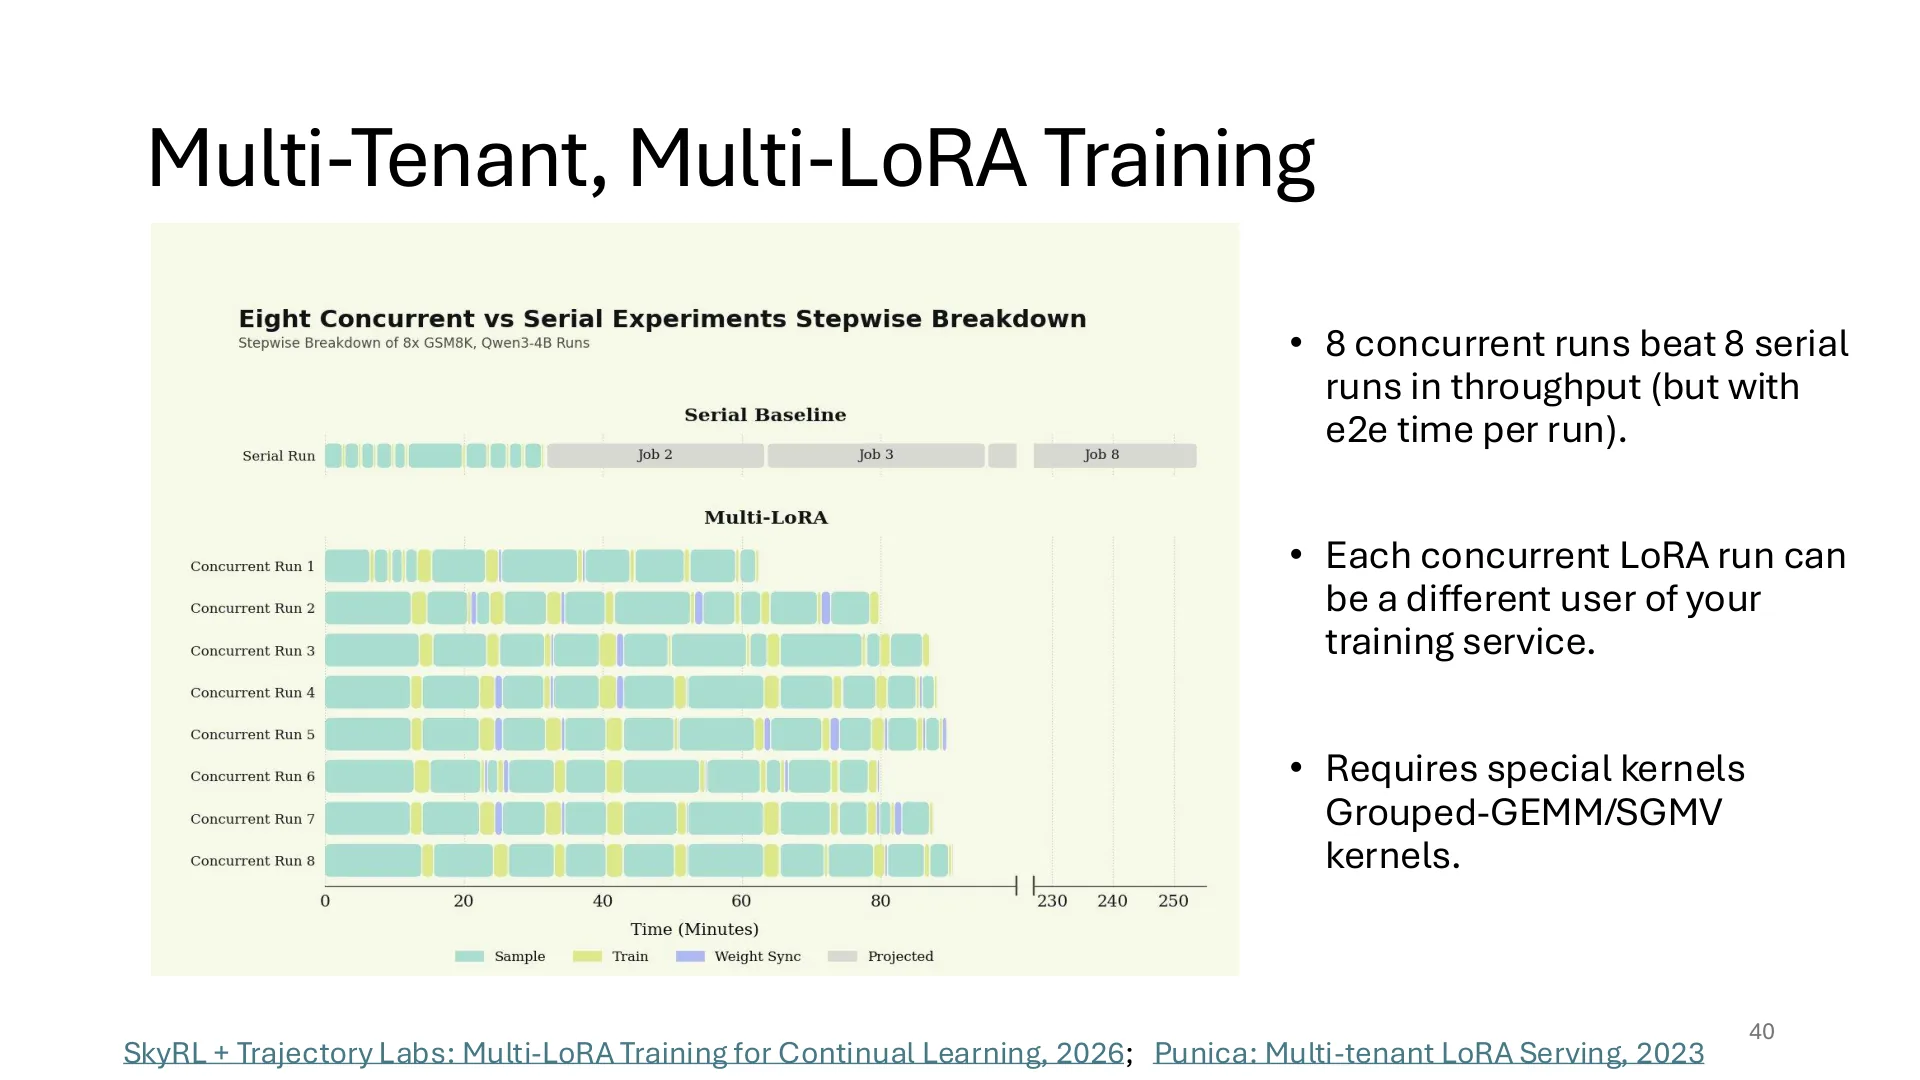
这张甘特图把权衡画得很清楚:串行基线里 8 个 job 首尾相接,总时长被拉长;并发版把 8 条 run 的 sample、train、weight sync 交错排布,总吞吐上去了,但每条 run 自己要多等。技术上它依赖能同时处理多个 LoRA 的 kernel(Grouped-GEMM / SGMV),以及 Tinker 首创的客户端抽象:每次训练 run 一个 training client,每个 LoRA checkpoint 一个 sampling client。
12. 该盯哪些指标
系统再复杂,最后都要落到"这一步为什么慢/为什么不涨"。这张表值得贴在显示器边上:
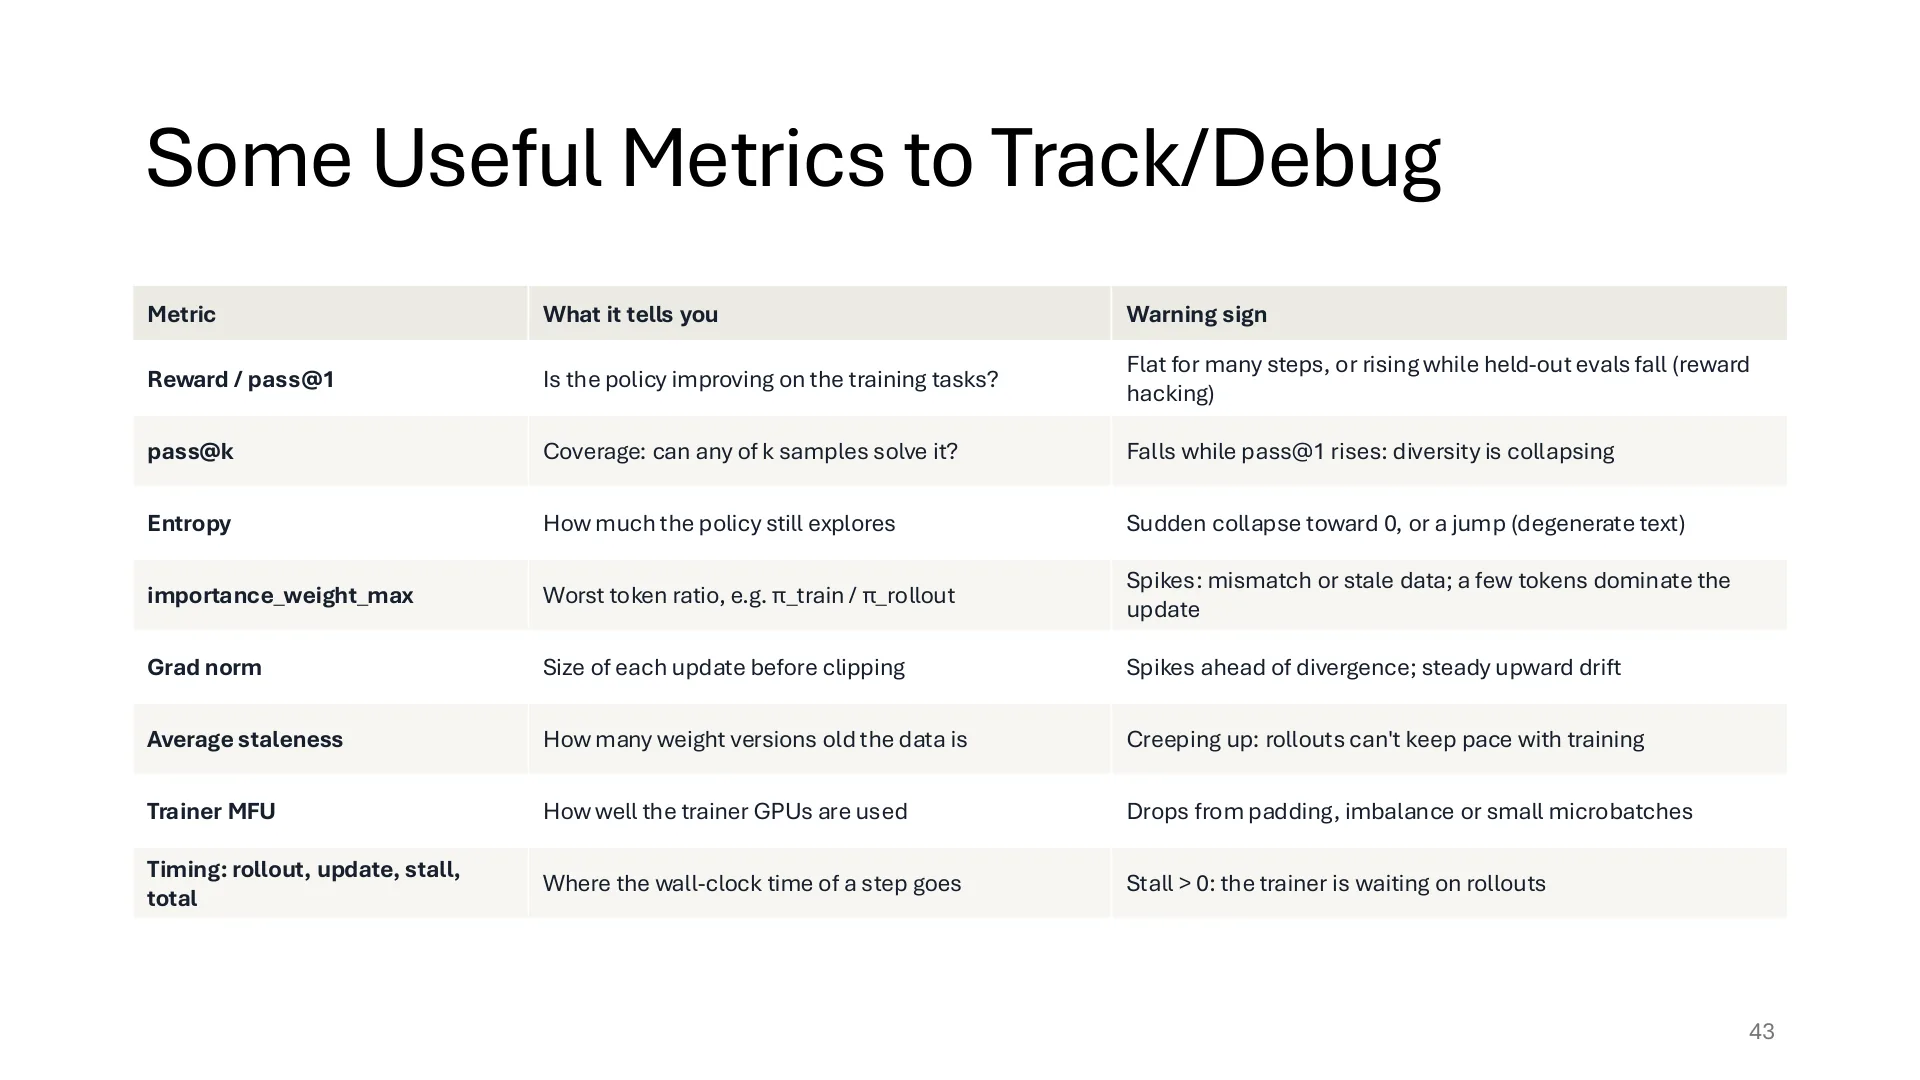
按"症状 → 指标"来读会更实用:
- reward 涨但 held-out 掉:典型的 reward hacking。训练集分数是优化目标,不是能力度量,必须同时看留出集。
- pass@1 涨而 pass@k 掉:多样性塌缩。策略把所有概率压到一条路径上,探索能力消失,熵会同步向 0 掉。
importance_weight_max尖刺:说明某些 token 上训练策略与 rollout 策略差得离谱。常见来源正是前面讲过的 TITO 不一致、MoE 路由不一致、或异步导致的 staleness。- grad norm 持续上行:更新在变大,通常是发散前兆,尤其是 clipping 之前就已经在涨。
- 平均 staleness 持续爬升:rollout 追不上训练,异步比例失衡,该加推理卡或减小 batch。
- trainer MFU 下降:padding 太多、长短序列装箱不均、micro batch 太小。
stall > 0:训练引擎在等 rollout。这是同步 RL 的典型病症,也是异步 RL 的直接动机。
术语表
| 术语 | 含义 |
|---|---|
| Inference Engine | 负责 rollout 的推理服务(vLLM、SGLang),decode 为主、不保留计算图 |
| Trainer Engine | 负责前反向与参数更新的训练后端(Megatron、FSDP2) |
| Rollout / Trajectory | 一次完整的多轮交互记录:任务、动作、观测、reward |
| KV Cache | 为每个历史 token 缓存 K,V,避免解码时重算前缀,代价是显存 |
| Prefix Caching | 跨请求复用相同前缀的 KV(SGLang RadixAttention、vLLM APC) |
| Continuous Batching | 以单个 decode step 为粒度调度,空出槽位立刻补入新请求 |
| Speculative Decoding | 小模型猜 个 token、大模型一次验证,拒绝采样保证分布不变 |
| Activation Checkpointing | 只存每层输入,反向时重算层内激活,约 +33% 计算换大幅省显存 |
| Prefix Sharing(训练侧) | batch 内共享前缀只算一次前反向,配合 tree attention mask 与梯度累加 |
| Weight Sync | 把训练后的权重发给推理引擎,全量或增量(delta),通常需要 reshard |
| R3 | Rollout Routing Replay:记录 rollout 的 MoE 专家选择并在训练时重放 |
| Sequence Extension | 第 轮 prompt 以第 轮为严格前缀的性质,决定能否拼成单个 datapoint |
| TITO | Token-In, Token-Out:轨迹以 token ID 而非字符串在引擎间传输 |
| Staleness | 训练所用数据比当前权重旧了几个版本,异步 RL 的核心旋钮 |
| MFU | Model FLOPs Utilization,衡量训练卡的实际利用率 |
延伸阅读
- Yu et al., Orca: A Distributed Serving System for Transformer-Based Generative Models, OSDI 2022 —— iteration-level scheduling 与 continuous batching 的源头。
- Leviathan et al., Fast Inference from Transformers via Speculative Decoding, ICML 2023(arXiv:2211.17192)—— 拒绝采样如何保证分布精确。
- Chen et al., Training Deep Nets with Sublinear Memory Cost, 2016(arXiv:1604.06174)—— gradient checkpointing 的原始动机。
- Korthikanti et al., Reducing Activation Recomputation in Large Transformer Models, 2022(arXiv:2205.05198)—— 选择性重算,把 +33% 降到更低。
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023(arXiv:2309.06180)—— KV cache 的分页式管理,vLLM 的基础。
- Ma et al., Rollout Routing Replay (R3), 2025 —— MoE 训练中路由不一致导致的隐性 off-policy。
- Snowflake AI Research, ZoRRo / Arctic RL, 2026 —— 长 prompt GRPO batch 的前缀去重,最多 6× 加速。
- Zhang et al., AReaL-DTA: Dynamic Tree Attention, ICML 2026 —— 前缀树 + DFS 遍历,9.43× 压缩、8.31× 加速。
- Tinker 文档中的 Sequence Extension 一节 —— 多轮轨迹如何组织成训练 batch 的一手说明。
- Miles 团队的 No Token Left Behind: Demystifying Token-In-Token-Out —— TITO 问题的系统梳理。
自测题
1. 既然 forward / backward / optim_step 都能直接用 PyTorch 写,为什么 RL 框架还要把推理和训练拆成两个引擎?
参考答案
三个层面。硬件画像相反:推理是逐 token 的 decode,受显存带宽限制且需要大量 KV cache;训练是整序列并行的 prefill,需要保留激活与计算图,两者对显存和 kernel 的偏好冲突。数值不一致:即使权重相同,两边 kernel 不同会让 forward 有微小差异,采样分布与训练分布严格来说不同,必须显式做 off-policy 修正。布局不同:训练侧 PP/DP/EP 的切分与推理侧 TP/DP 不同,权重需要 reshard。分离的代价是"forward 算两遍",收益是两侧都能各自专门优化。
2. Llama-3-8B bf16 的 KV cache 为什么是 128 KB/token?这个数字对 RL 的 batch size 意味着什么?
参考答案
每个 token 每层要为 K 和 V 各存一份,大小 。Llama-3-8B 有 32 层、8 个 KV head(GQA)、head dim 128、bf16 两字节,于是 字节 = 128 KB。一条 32k token 轨迹约 4 GB,64 条就是 256 GB,超过单卡显存。因此 RL rollout 的并发度被 KV 显存硬性限制,而 agent 轨迹动辄几万 token,这个限制比 SFT 时更紧。
3. 为什么说 Harness A(纯追加)比 Harness B(定期压缩)更适合训练?B 的额外成本具体在哪?
参考答案
A 保证第 轮以第 轮为严格前缀,整条轨迹可以作为一个 datapoint:一次前向覆盖所有 token,共享前缀只算一次,KV/激活都能复用。B 在压缩点切断了前缀,必须拆成多个 datapoint,而每个 datapoint 都要带 task prompt;这些重复 token 的 loss mask 为 0、不产生梯度,但仍要走完上下文的前向计算,同时前缀缓存也命中不了。B 在生产里存在是因为序列实在太长,此时要靠前缀树(如 AReaL-DTA)把重复计算救回来。
4. TITO 想解决的两个问题分别是什么?
参考答案
其一,字符串空间的微小变换(chat template 多一个空格、换行位置不同)会让训练侧重新 tokenize 出的序列与推理侧不同,等于在别的序列上采样、在这个序列上求梯度。其二,tokenize 是一对一而 detokenize 是多对一,"Hello" 既可能是 token 4,也可能是 1 和 5;只传字符串再重新编码,必然选到"规范"切分,与模型实际产出的 token 不一致,导致概率与重要性比率失真。所以轨迹应以 token ID(外加 rollout logprob)传输。
5. Delta weight sync 为什么能成立?它的适用边界在哪?
参考答案
RL 的更新很稀疏:outcome reward 下每条轨迹的监督信号弱,很多参数更新小到落在 bf16 尾数(约 7 位)以下被舍入掉,因此约 99% 的参数在两次更新间逐比特未变。只同步变化的 delta,可把 1T 模型约 2TB 的广播降到 20–30 GB。边界是:这依赖"绝大多数参数没变"的经验事实;若改成更大学习率、更高精度或全参密集更新,稀疏性会下降;被舍入的更新若重要,会在后续 step 以更大幅度体现,这是 bf16 训练本身的近似而非 delta 引入的额外损失。
6. R3 解决的是什么问题?为什么它会影响服务接口设计?
参考答案
MoE 的路由(top-k / argmax)对数值极度敏感,推理引擎与训练引擎的 kernel 差异会让同一个 token 选中不同专家;此时训练侧前向与产生轨迹的前向不是同一个函数,即使权重相同也构成隐性 off-policy。R3 在 rollout 时记录专家选择,训练时强制重放。由于这个信息只有推理引擎知道,推理服务必须把路由决策暴露出来——一项训练稳定性需求因此反向定义了引擎间的 API。
7. 同步 RL 与异步 RL 各自的代价是什么?为什么常见 3:1 的 GPU 配比?
参考答案
同步 RL 共置训练与推理引擎,同一批 GPU 轮流使用:实现简单、数据总是新鲜的,但一批里最长的轨迹会拖住所有卡,rollout 期间训练卡空转。异步 RL 拆分 GPU 池、让两者重叠,减少空转并把长尾轨迹的影响推到后续 batch,代价是数据变旧(staleness)需要 off-policy 修正,且推理引擎要支持 in-flight weight update(如 SGLang 的 pause / retract,retract 还要清空已过期的 KV)。agent 场景 rollout 常是瓶颈,所以把更多卡分给推理,3:1 是常见的经验配比。
8. Harness 无关的"中间人代理"为什么能做到接新 harness 零代码改动?它引入了什么风险?
参考答案
因为主流 harness 本来就在说标准推理 API(chat completions / responses / anthropic messages),中间人只要假装成这些 API,把请求转发给推理引擎、把响应转回 harness,同时在中间记录 logprob、R3 路由等训练所需数据即可;换成另一个 harness 只是换客户端,训练框架不动。风险在于它位于关键路径上:延迟和可用性直接影响 rollout 吞吐;还要维护多种 API 方言的兼容性,并且必须保证记录的 token 与 harness 看到的完全一致,否则又回到 TITO 那类问题。
9. SPMD 与服务化架构各自适合什么阶段?
参考答案
SPMD 把所有逻辑放在一个程序里,靠 rank 分支区分训练与推理,读代码就能掌握全局、改动直接,适合早期快速迭代与单集群固定拓扑(AReaL 1.0 之前)。服务化把每个部件做成独立服务、由轻量控制器编排,换来关注点分离、可替换、弹性扩缩、异构算力、多策略与在线 RL,但引入运维、容错与跨服务一致性成本。规模变大、需要混用硬件或对外提供训练服务时,服务化才划算。
10. 训练中看到 stall 持续大于 0、同时平均 staleness 也在上升,你会先查什么?
参考答案
stall > 0 表示训练引擎在等 rollout,staleness 上升说明数据比当前权重旧得越来越多,两者合起来指向"推理侧产能不足或轨迹过长"。先看 rollout 时长分布是否有超长尾(单条轨迹拖住整批),再看 GPU 配比是否该向推理倾斜;然后检查连续批处理与前缀缓存是否真正生效(命中率低会让 prefill 成本暴涨),以及是否有 in-flight weight update 造成的反复重算。若这些都不奏效,才考虑缩小 batch 或放宽 staleness 上限并加强 off-policy 修正。